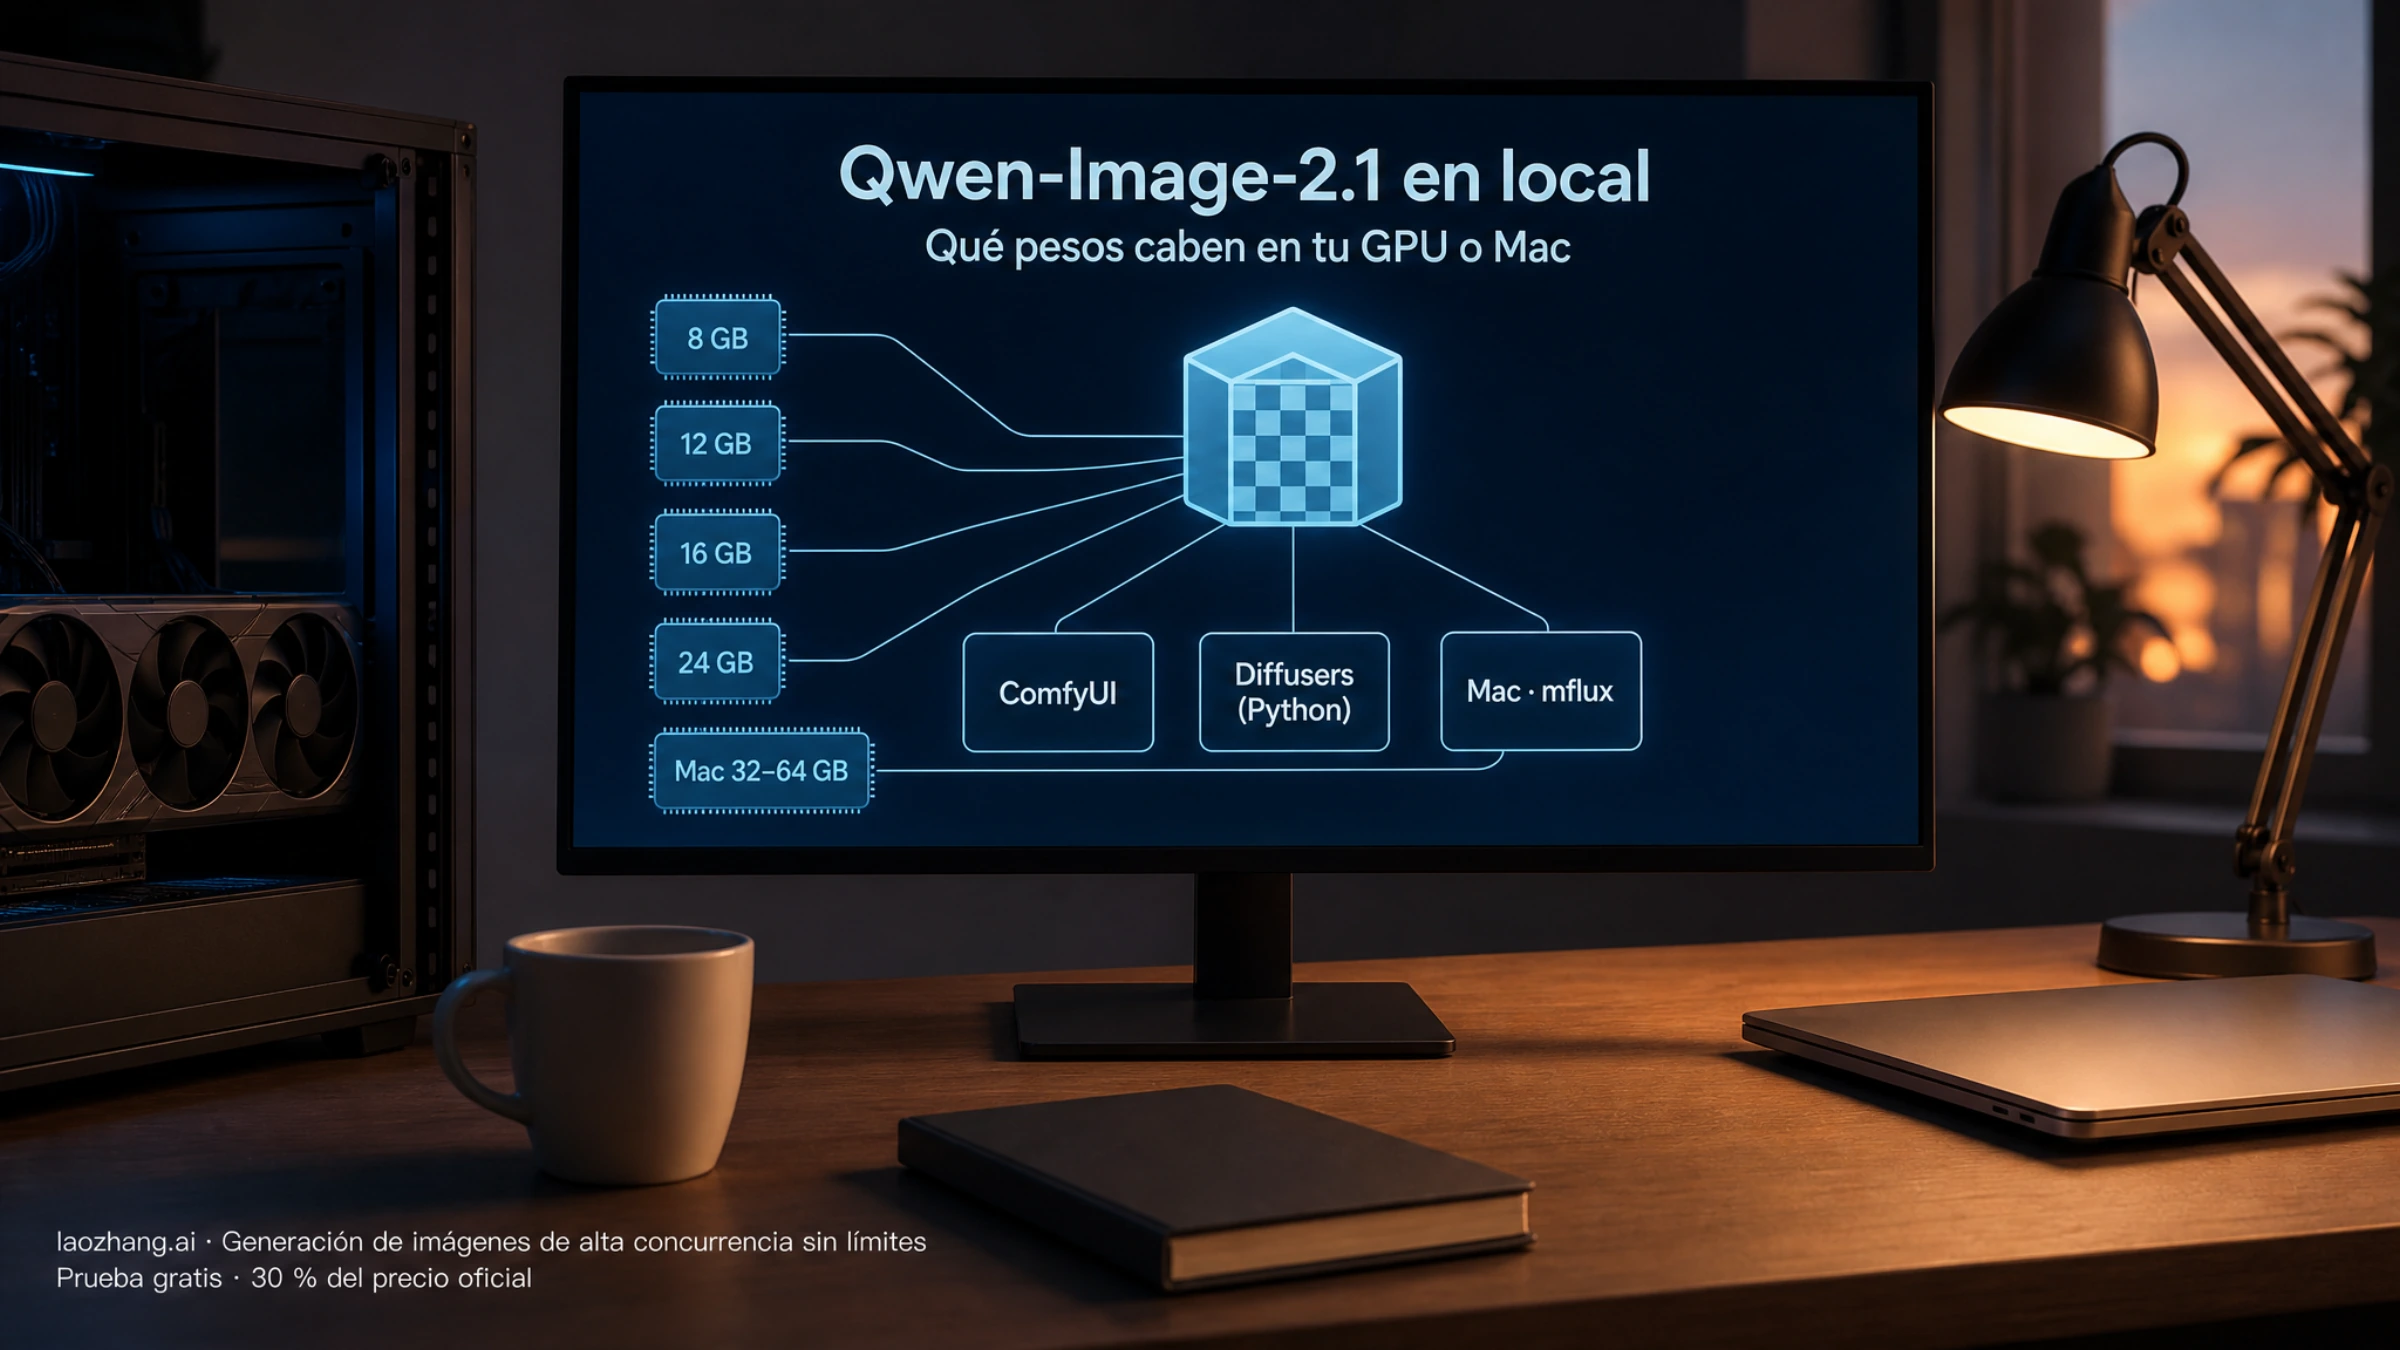
Qwen-Image-2.1 se puede ejecutar en local desde el 20 de septiembre de 2026, y la ruta correcta depende casi por completo de cuánta memoria tienes. Con una NVIDIA de 24 GB o más, el conjunto INT8 oficial para ComfyUI (unos 17 GB en disco) es el punto de partida. Con 16 GB, el mismo conjunto cambiando el codificador de texto por la variante W4A8 es la opción más segura; un usuario con RTX 5070 Ti ha reportado picos de unos 13,9 GB a 1024×1024. Con 8 o 12 GB entras en el terreno de los GGUF comunitarios, donde hay resultados contradictorios que explico más abajo. En un Mac con Apple Silicon la vía es mflux; el autor del soporte midió un pico de ≈30,7 GB con cuantización de 8 bits a 1024×1024, lo que deja un Mac de 32 GB al límite y hace de 48 o 64 GB la configuración cómoda. No existe ningún "mínimo oficial de VRAM": ni el repositorio de Qwen ni el tutorial de ComfyUI publican una cifra, así que todos los números de esta guía llevan quién los midió y en qué condiciones.
Antes de descargar nada conviene saber dos cosas más. La primera: el modelo cambia de licencia respecto a su antecesor. Qwen-Image-2512 estaba bajo Apache 2.0; Qwen-Image-2.1 sale bajo la Qwen Research License, que solo permite fines no comerciales. La segunda: el archivo que más memoria consume no es el modelo de difusión (7B parámetros, 14,23 GB en BF16) sino el codificador de texto Qwen3-VL de 8B (17,53 GB en BF16). Por eso casi todas las optimizaciones que funcionan atacan primero al codificador.
Qué trae Qwen-Image-2.1 y por qué pesa lo que pesa
Qwen-Image-2.1 es un único modelo para generar imágenes a partir de texto y para editarlas. La parte de generación visual tiene 7.000 millones de parámetros repartidos en 32 capas DiT de flujo único; el texto y las imágenes de referencia los procesa Qwen3-VL 8B, y el VAE es un autocodificador RGBA de 64 canales con compresión espacial de 16×. Esa combinación explica las tres capacidades que lo diferencian de la versión anterior según el README oficial:
- Transparencia nativa. Genera y edita imágenes RGBA directamente; también puede extraer un sujeto de una foto RGB y devolverlo con canal alfa, sin nodos de recorte ni matting.
- Hasta 10 imágenes de referencia en una misma edición, útil para mantener una persona o un producto entre escenas.
- Edición local por región: rodear la zona con un círculo, pintarla, o pasar la imagen original y una máscara como dos entradas separadas.
También incorpora una atención de granularidad mixta con caché de prefijo: las imágenes de condición y la instrucción se codifican una sola vez en el primer paso y se reutilizan en los demás (causal_condition: true por defecto). En la práctica, eso reduce el coste de las ediciones con varias referencias, aunque no reduce la memoria que hace falta para cargar el codificador.
La versión oficial en Hugging Face (Qwen/Qwen-Image-2.1) ocupa 33,13 GB en disco en BF16: 17,5 GB de codificador de texto en cuatro fragmentos, 14,2 GB de transformer en dos y 1,35 GB de VAE. Son gigabytes decimales tal como los reporta la API de Hugging Face, y son espacio en disco, no VRAM.
Cuánta memoria hace falta: lo que han medido otros
Como no hay cifra oficial, lo útil es agrupar las mediciones publicadas por tramo y con sus condiciones. Todas son de una sola sesión o de un solo equipo; sirven para orientarte, no como garantía.
| Configuración | Memoria observada | Quién y en qué condiciones |
|---|---|---|
| Diffusers BF16 sin optimizar | ≈31 GB de pico | Usuario kun432 en Zenn, A100 de 80 GB en Google Colab, 21 de septiembre de 2026 |
Diffusers BF16 con enable_model_cpu_offload() | ≈17 GB de pico | Misma sesión |
| Diffusers con bitsandbytes nf4 (4 bits) en transformer y codificador | ≈7 GB de pico | Misma sesión |
| RTX 4090, BF16 residente | ≈30,2 GB en total del sistema; ≈21 s a 1024² y ≈56 s a 1536² | Reporte recogido por AIReiter; pasos no indicados |
| RTX 5070 Ti de 16 GB, 1024×1024, 20 pasos | ≈13,9 GB de pico, ≈25 s por imagen | Atribuido a @BenjaminDEKR en X y recogido por AIReiter; cuantización no indicada |
| Servidor GB200/GB300 con vLLM-Omni, 1024², 40 pasos | 34,0 GB en BF16; 27,5–28,1 GB con codificador en FP8; 32,0–32,7 GB con DiT en FP8 | Receta oficial de vLLM |
| mflux en M5 Max, 1024², 40 pasos | ≈46 GB en bf16; ≈30,7 GB con -q 8 | Autor del soporte en el PR #736 de mflux |
La fila de vLLM es de centro de datos y no te sirve como referencia de consumo, pero enseña algo que sí importa en tu equipo: cuantizar el codificador de texto ahorra unos 6 GB, mientras que cuantizar el DiT ahorra unos 2 GB. Es el mismo motivo por el que ComfyUI ofrece tres variantes del codificador (BF16, INT8 y W4A8) y solo dos del modelo de difusión. Fuentes: scrap de kun432, análisis de AIReiter, receta de vLLM y PR #736 de mflux.
Qué ruta elegir según tu equipo
| Tu equipo | Ruta recomendada | Archivos | Espacio en disco aproximado |
|---|---|---|---|
| NVIDIA con 24 GB o más | ComfyUI con el conjunto INT8 por defecto; Diffusers BF16 con offload si trabajas en Python | qwen_image_2.1_int8_convrot + qwen3vl_8b_int8_convrot + VAE | ≈17,3 GB (ComfyUI) o ≈33 GB (Diffusers BF16) |
| NVIDIA con 16 GB | ComfyUI con difusión INT8 y codificador W4A8 | qwen_image_2.1_int8_convrot + qwen3vl_8b_w4a8 + VAE | ≈14,3 GB |
| NVIDIA con 12 GB | ComfyUI con GGUF Q8_0 o Q6_K + codificador W4A8 | GGUF comunitario + qwen3vl_8b_w4a8 + VAE | ≈12,8–14,6 GB |
| NVIDIA con 8 GB | ComfyUI con GGUF Q4_K_M o Q5_K_M + codificador W4A8, a 1024² y sin imágenes de referencia grandes | GGUF comunitario + qwen3vl_8b_w4a8 + VAE | ≈11,6–12,2 GB |
| Mac con Apple Silicon | mflux (mflux-generate-qwen-2.1) con -q 8 o -q 4 | Pesos oficiales BF16 ≈33 GB, o pack MLX q4 comunitario ≈10,7 GB | ≈30,7 GB de pico con -q 8: un Mac de 32 GB va al límite; 64 GB, cómodo |
| Menos de 8 GB o GPU AMD/Intel | No hay ruta verificada; usa el Space de Hugging Face o una API alojada | — | — |
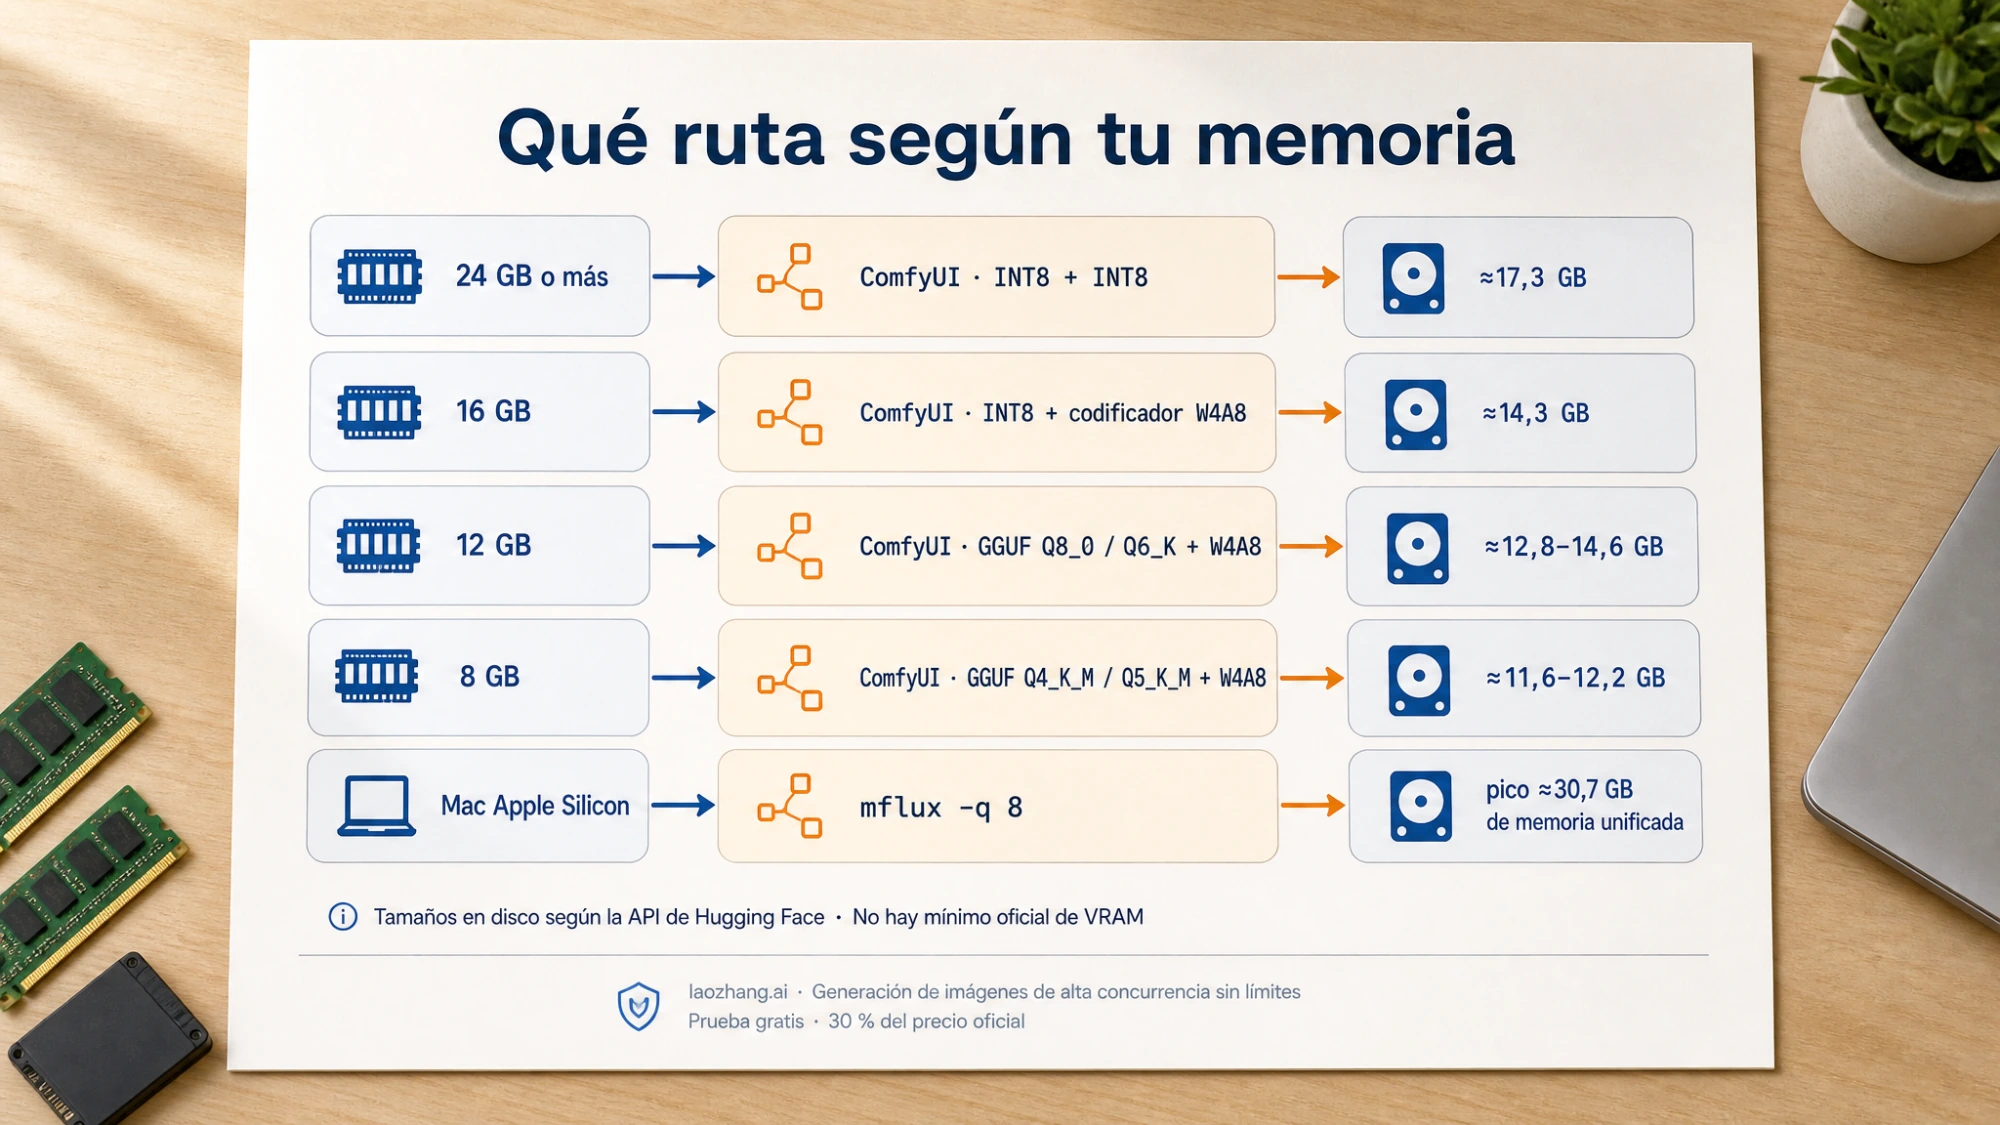
Los tamaños son sumas de los archivos que reporta la API de Hugging Face y no incluyen el entorno de Python, la caché ni las imágenes generadas. Si tu tarjeta es de 16 GB y estás decidiendo entre modelos, en la comparación de GPU de 16 GB para trabajo local hay más contexto sobre qué cabe en ese tramo.
Ruta 1: ComfyUI con los pesos oficiales de Comfy-Org
Es la ruta con menos fricción: Comfy-Org publica los pesos ya convertidos y ComfyUI incluye tres plantillas. Necesitas una versión actualizada de ComfyUI (el tutorial pide actualizar antes de cargar las plantillas, porque dependen de nodos nuevos del núcleo) y tres archivos, no el repositorio entero de 74 GB.
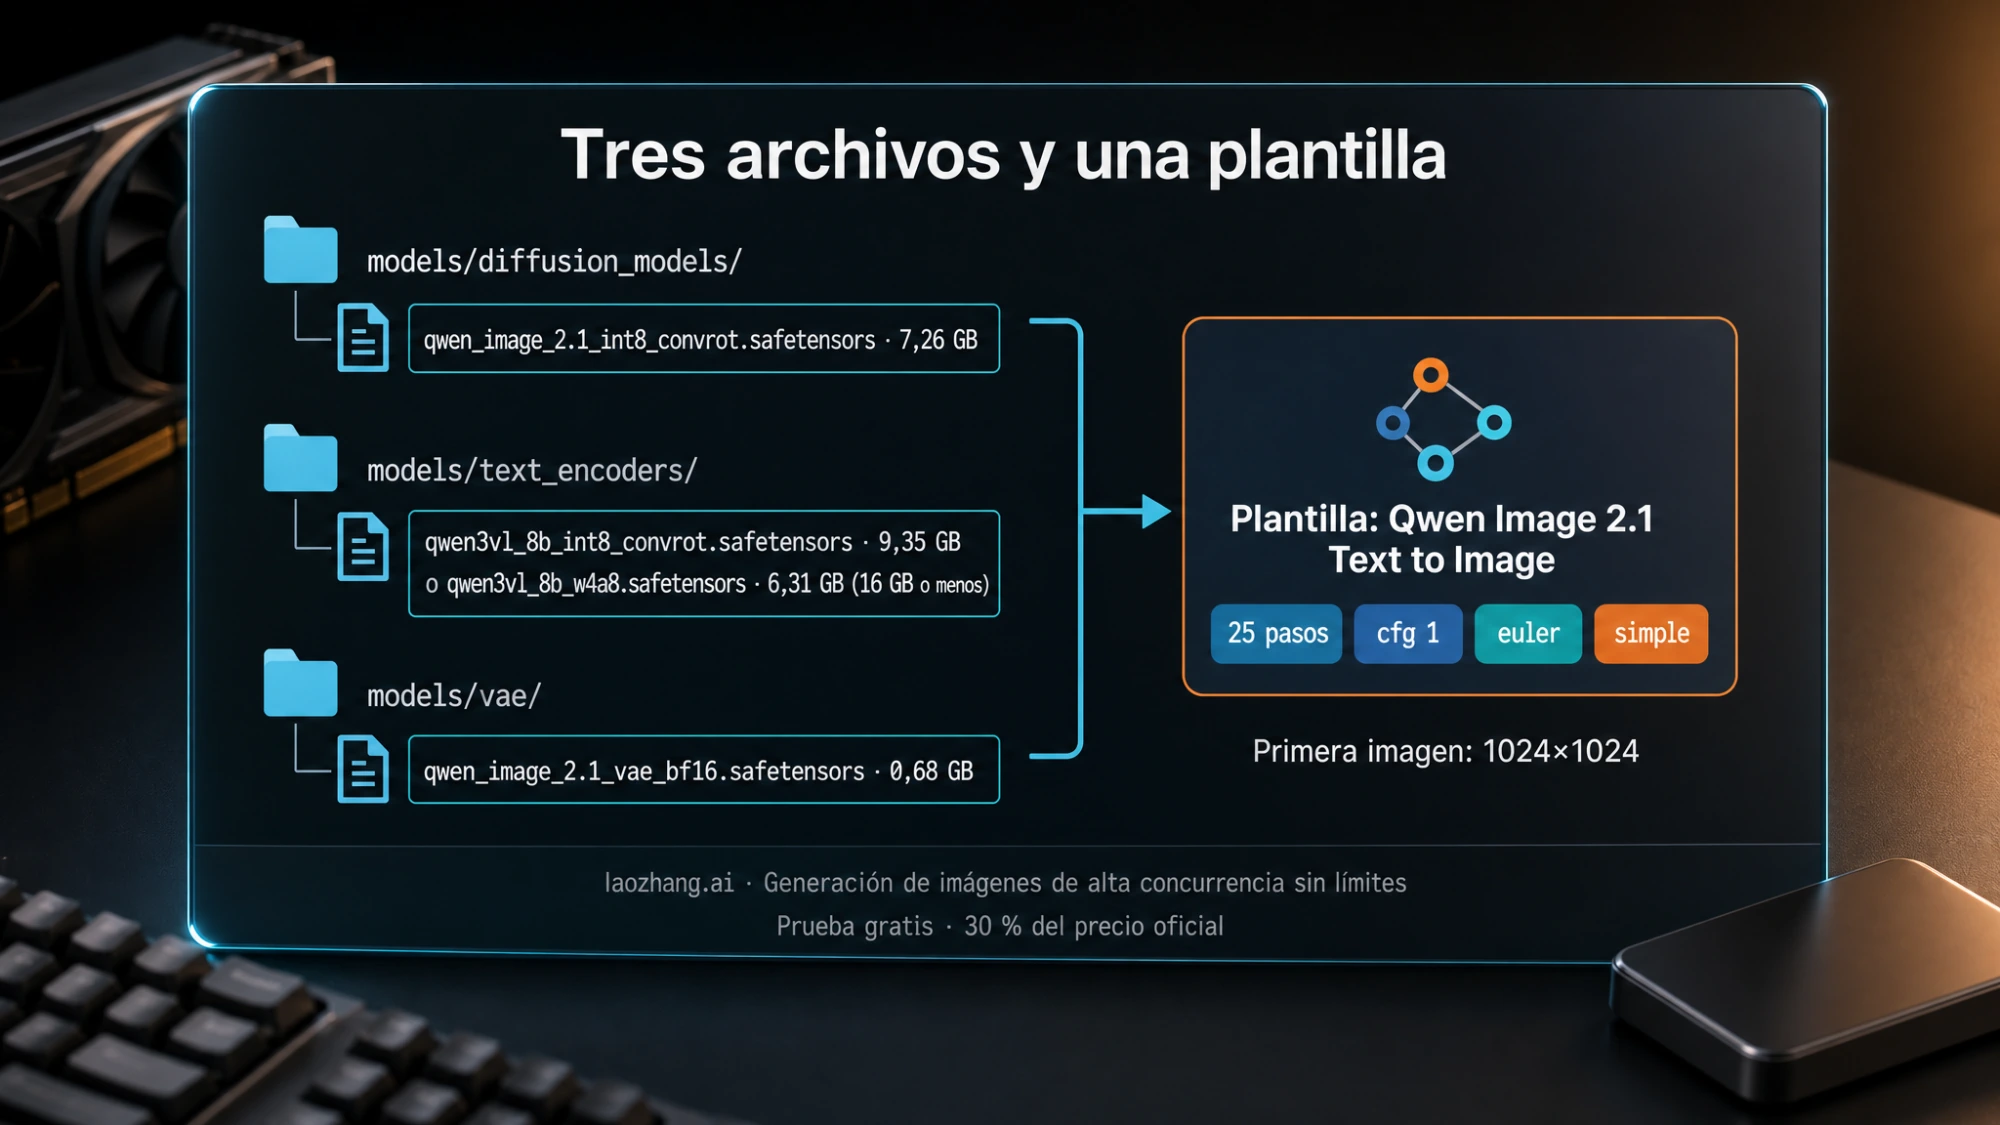
- Descarga desde Comfy-Org/Qwen-Image-2.1 un archivo de cada grupo y colócalo en su carpeta:
| Carpeta | Archivo | Tamaño | Cuándo elegirlo |
|---|---|---|---|
ComfyUI/models/diffusion_models/ | qwen_image_2.1_int8_convrot.safetensors | 7,26 GB | Por defecto en las plantillas |
ComfyUI/models/diffusion_models/ | qwen_image_2.1_bf16.safetensors | 14,23 GB | Solo con memoria sobrada; el tutorial avisa de que necesita más VRAM |
ComfyUI/models/text_encoders/ | qwen3vl_8b_int8_convrot.safetensors | 9,35 GB | Por defecto en las plantillas |
ComfyUI/models/text_encoders/ | qwen3vl_8b_w4a8.safetensors | 6,31 GB | Tarjetas de 16 GB o menos |
ComfyUI/models/text_encoders/ | qwen3vl_8b_bf16.safetensors | 17,53 GB | Máxima fidelidad, 24 GB o más |
ComfyUI/models/vae/ | qwen_image_2.1_vae_bf16.safetensors | 0,68 GB | Siempre |
- Abre la biblioteca de plantillas y carga Qwen Image 2.1 Text to Image. Si los archivos están en las carpetas correctas, los selectores los detectan solos; si cambiaste el codificador a W4A8, elígelo en el nodo correspondiente.
- Escribe el prompt en el nodo Text Encode Qwen Image 2.1 y ejecuta. Los ajustes de las tres plantillas oficiales son los mismos: 25 pasos, cfg 1, sampler euler, scheduler simple, con un selector de resolución que apunta a unos 4 megapíxeles (2048×2048) por defecto. Para la primera imagen baja a 1024×1024: reduce el pico de memoria y el tiempo, y confirma que la instalación funciona antes de subir.
Sobre si este conjunto cabe residente en 24 GB: el análisis de ai.rs calcula ≈16,1 GiB para difusión INT8 más codificador INT8 y concluye que cabe en una RTX 4090; es un cálculo a partir de los tamaños, no una medición, pero coincide con los reportes de 16 GB que usan el codificador W4A8.
Las otras dos plantillas cubren los casos de edición. Qwen Image 2.1 Image Edit admite varias imágenes de referencia que se insertan en el codificador en orden de ranura (entradas image_1 a image_16, aunque el README fija el máximo en 10 referencias). Remove Background: Qwen Image 2.1 aprovecha que el VAE tiene cuatro canales: la salida ya lleva alfa, sin nodos de matting intermedios. El tutorial oficial de ComfyUI documenta las tres, pero no publica cifras de VRAM ni tamaños de archivo; los tamaños de la tabla proceden de la API de Hugging Face.
En el mismo repositorio de Comfy-Org hay dos archivos más, qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors y su variante pe_i2i (9,47 GB cada uno). Por el nombre corresponden a los modelos de reescritura de prompts, pero el tutorial que he leído no explica cómo se usan en ComfyUI. No los necesitas para que las plantillas funcionen.
Ruta 2: GGUF en ComfyUI para 8 y 12 GB
Los GGUF disponibles cuantizan solo el transformer; siguen necesitando el codificador de texto en safetensors y el VAE de la ruta anterior. Dos usuarios publicaron paquetes en los primeros días:
| Paquete | Variantes y tamaño | Fecha |
|---|---|---|
AlperKTS/Qwen-Image-2.1-GGUF | Q5_K_M 4,89 GB · Q6_K 5,84 GB · Q8_0 7,62 GB | 20 de septiembre de 2026 |
JohnsonHsu/Qwen-Image-2.1-GGUF | Q4_0 4,05 GB · Q4_K_M 4,60 GB · Q5_K_M 5,22 GB · Q6_K 5,88 GB · Q8_0 7,59 GB | 22 de septiembre de 2026 |
La ficha de AlperKTS sugiere Q8_0 a partir de 12 GB, Q6_K entre 8 y 12 GB y Q5_K_M para 8 GB. Son sugerencias del autor del paquete, no mediciones; el propio uploader avisa de pérdida de calidad en Q4. Para cargarlos hace falta el nodo personalizado ComfyUI-GGUF (git clone dentro de custom_nodes y pip install --upgrade gguf), y luego sustituir el cargador del modelo de difusión por Unet Loader (GGUF) en la plantilla oficial.
Aquí aparece el primer tropiezo documentado. Una guía de Local Model Watch reporta que versiones antiguas de ComfyUI-GGUF fallan con el mensaje Unknown model architecture! al cargar estos archivos, y que el problema desaparece actualizando el nodo (ellos usaron la bifurcación de leejet). El README de city96 no lista Qwen-Image-2.1 entre las arquitecturas soportadas, así que la compatibilidad depende de la versión concreta del nodo que tengas instalada: si ves ese error, actualiza el nodo antes de tocar nada más. Fuentes: guía de kombitz y aviso de Local Model Watch.
El segundo tropiezo es que los 8 GB no están resueltos. Hay tres observaciones que no coinciden:
- El uploader de AlperKTS sugiere Q5_K_M para 8 GB.
- kun432 midió ≈7 GB de pico en Diffusers con nf4 en transformer y codificador, en una A100 de 80 GB donde nada más competía por la memoria.
- El autor de la guía japonesa de negi-lab dice que Q4_K_M "en teoría" corre en 8 GB, pero se le cerraba al introducir una imagen de entrada.
Las condiciones son distintas en cada caso: resolución, presencia de imágenes de referencia, offload y cuánta memoria consume el resto del sistema. La lectura prudente para 8 GB es esta: generación de texto a imagen a 1024×1024 con Q4_K_M o Q5_K_M y codificador W4A8 tiene posibilidades; edición con referencias grandes, no cuentes con ello hasta probarlo. Con 12 GB, Q8_0 más W4A8 suma unos 14,6 GB en disco y deja margen razonable a 1024².
Ruta 3: Diffusers en Python
Es la ruta oficial del equipo de Qwen y la que da más control, pero en su forma por defecto es la que más memoria pide: carga el pipeline BF16 completo (≈33 GB en disco) y genera a 2048×2048 con 40 pasos.
bashpip install "torch>=2.4.0" "transformers>=5.17" accelerate pillow
pip install git+https://github.com/huggingface/diffusers
pythonimport torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
)
pipe.enable_model_cpu_offload()  # quita esta línea si tienes 32 GB o más

image = pipe(
    prompt="Cartel tipográfico de un mercado de Valencia, letras grandes que dicen 'Mercado Central', luz de mañana",
    width=1024, height=1024,
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]
image.save("mercado.png")
El ejemplo del README usa .to("cuda") sin offload; yo he puesto enable_model_cpu_offload() porque es la única instrucción de ahorro de memoria que documenta el propio README ("para GPU con memoria limitada") y porque en la sesión de kun432 bajó el pico de ≈31 GB a ≈17 GB. Para editar se usa el mismo pipeline con image= (una imagen PIL o una lista de hasta 10). Los tamaños preajustados del modelo son 2048×2048 (1:1), 2400×1792 (4:3), 2528×1696 (3:2) y 2752×1536 (16:9), con sus verticales correspondientes.
Tres observaciones de esa misma sesión te ahorran tiempo:
- Con 4 bits nf4 de bitsandbytes en transformer y codificador el pico bajó a ≈7 GB, así que Diffusers también es viable en tarjetas pequeñas si aceptas la cuantización.
- Una L4 de 24 GB dio OOM a 2048×2048 incluso con offload hasta activar
vae.enable_tiling(), y el tiling produjo líneas verticales en la imagen. Si te ocurre, genera a 1024 o 1536 en lugar de activar tiling. - La misma A100, sin optimizaciones, tardó poco más de un minuto por imagen a 2048×2048 y 40 pasos.
Sobre los modelos de reescritura de prompts: Qwen/Qwen-Image-2.1-PE-T2I y Qwen/Qwen-Image-2.1-PE-I2I (≈18,8 GB en BF16 cada uno) expanden un prompt corto en una descripción detallada y proponen la relación de aspecto. kun432 apreció una mejora clara de resultados con ellos, incluidos prompts en japonés. Son opcionales y añaden otro modelo de 9B a la memoria; si vas justo, escribe el prompt largo tú mismo y déjalos para más adelante.
Ruta 4: Mac con Apple Silicon
En Mac la vía es mflux, que fusionó el soporte de Qwen-Image-2.1 el 21 de septiembre de 2026 con el comando mflux-generate-qwen-2.1:
bashmflux-generate-qwen-2.1 --prompt "Un cartel de cerámica de Talavera con la palabra 'Bienvenidos'" \
  --width 1024 --height 1024 --steps 40 -q 8
Las cifras del autor del PR en un M5 Max a 1024×1024 y 40 pasos: ≈1,5 s por paso, ≈78 s de principio a fin, pico de ≈46 GB en bf16 y ≈30,7 GB con -q 8. Un revisor en M3 Ultra midió ≈2,95 s por paso, unos dos minutos por imagen. Ojo con dos detalles: -q 8 y -q 4 cuantizan el DiT pero el codificador de texto se mantiene en bf16, y esos gigabytes son memoria unificada compartida con el sistema. Con un Mac de 32 GB queda poco margen; la guía de negi-lab calcula unos 20 GB utilizables en esa configuración y recomienda 64 GB. El pack comunitario toxicdog/Qwen-Image-2.1-MLX en q4 (DiT 4,00 GB, codificador 6,02 GB, VAE 0,68 GB) es la opción más ligera en disco, con la pérdida de calidad esperable a 4 bits.
En ese PR quedaron fuera la edición con instrucciones, LoRA y la caché de prefijo; un PR posterior (#741) dice añadir edición con referencias, RGBA y caché, pero no lo he verificado. Si tu prioridad en Mac es editar y no solo generar, comprueba el estado de mflux antes de instalar.
Fondo transparente, referencias y máscaras
Las tres funciones nuevas se piden de forma parecida en cualquiera de las rutas.
PNG con transparencia. El modelo genera RGBA cuando el prompt lo declara. La plantilla recomendada en el README es literal:
textThis is an RGBA image with transparency. <tu descripción>. The image has alpha channel and the background is transparent.
Guarda siempre en PNG; JPEG descarta el canal alfa. En ComfyUI la plantilla de eliminación de fondo hace esto mismo a partir de una foto RGB. En SGLang-Diffusion el equivalente es "background": "transparent" en la petición.
Edición con referencias. Pasa hasta 10 imágenes; el orden importa porque se insertan en el codificador por ranura, así que si el prompt dice "la persona de la primera imagen con la camisa de la segunda", la primera de la lista debe ser la persona. Cada referencia añade tokens al codificador y, por tanto, memoria: es el escenario donde el usuario de negi-lab vio cerrarse su GGUF de 8 GB.
Máscaras. Puedes rodear la zona con un círculo dibujado sobre la propia imagen, pintarla encima, o pasar la imagen original y una máscara en blanco y negro como dos entradas. Si vienes de otros flujos de edición, en la comparativa de generadores imagen a imagen están las diferencias entre las rutas abiertas y las de API.
Licencia: qué permite y qué no la Qwen Research License
Este es el punto que más confusiones genera en los hilos de lanzamiento, así que conviene leer el texto y no los resúmenes. La licencia del repositorio es la Qwen Research License Agreement:
- Concede uso, reproducción, distribución y modificación "FOR NON-COMMERCIAL PURPOSES ONLY", entendidos como investigación o evaluación.
- "You shall not use the Materials for any commercial purpose without obtaining a separate commercial license"; el contacto es model-business@notice.qwencloud.com.
- Si redistribuyes (por ejemplo, un GGUF o un pack MLX), debes incluir el acuerdo, marcar los archivos modificados, conservar el aviso y mostrar "Built with Qwen" o "Improved using Qwen"; no puedes usar "Qwen" como nombre principal de un derivado. Los packs comunitarios de GGUF y MLX heredan estas condiciones y aparecen en Hugging Face con la etiqueta
license:other. - El texto no contiene ninguna cláusula explícita sobre las imágenes generadas.
Sobre ese último vacío, el 21 de septiembre de 2026 la cuenta de Qwen Developers publicó en X que las salidas no forman parte de los "Materials" licenciados y que los usuarios conservan los derechos sobre las imágenes que generan. No he podido leer la publicación directamente (solo el fragmento en resultados de búsqueda), y en la discusión #6 del repositorio varios comentaristas responden que una publicación social no reescribe el archivo LICENSE. La lectura práctica: usar el modelo como parte de un servicio de pago, un SaaS o un flujo de producción de una empresa requiere la licencia comercial aparte; qué puedes hacer con una imagen concreta generada en tu casa es una zona gris que el texto no resuelve y que ningún blog, incluido este, puede resolver por ti. Si el uso es comercial, escribe al contacto de la licencia antes de construir nada encima.
Si no cabe en tu equipo o necesitas uso comercial
Para probar el modelo sin instalar nada, el Space oficial en Hugging Face está activo; sirve para comprobar si el estilo te convence antes de descargar 15 GB. ModelScope aloja los mismos pesos y DiffSynth-Studio, que es el único entrenador de LoRA que el README menciona.
Si lo que te bloquea es la licencia, las salidas son dos: pedir la licencia comercial de Qwen o usar un modelo distinto servido por API. El catálogo de laozhang.ai no lista ningún modelo de imagen de Qwen a fecha de 22 de septiembre de 2026, así que no sirve para ejecutar Qwen-Image-2.1; lo que ofrece son otros modelos de imagen comerciales, con precios publicados en docs.laozhang.ai: gemini-3.1-flash-image a 0,055 por llamada, seedream-5-0-260128 a 0,035 por millón de tokens de entrada y 30 $ por millón de salida. Los precios cambian; confírmalos en la página antes de decidir. Si ya trabajas en ComfyUI y quieres una alternativa alojada dentro del mismo flujo, el nodo oficial de GPT Image 2.5 en ComfyUI es una ruta ya documentada.
Preguntas frecuentes
¿Cuánta VRAM necesita Qwen-Image-2.1 exactamente? No hay cifra oficial. Las mediciones publicadas van de ≈7 GB (Diffusers con nf4 de 4 bits, una sola sesión en A100) a ≈31 GB (BF16 sin optimizar). Para ComfyUI, el conjunto INT8 más el codificador W4A8 ha funcionado en 16 GB según reportes de usuarios; en 8 GB los resultados con GGUF son contradictorios y dependen de la resolución y de si usas imágenes de referencia.
¿Qué archivos descargo para ComfyUI? Tres: un modelo de difusión (qwen_image_2.1_int8_convrot.safetensors, 7,26 GB), un codificador de texto (qwen3vl_8b_int8_convrot.safetensors de 9,35 GB, o qwen3vl_8b_w4a8.safetensors de 6,31 GB si tienes 16 GB o menos) y el VAE (qwen_image_2.1_vae_bf16.safetensors, 0,68 GB). Van en models/diffusion_models, models/text_encoders y models/vae respectivamente.
¿Cuántos pasos y qué CFG uso? Las plantillas oficiales de ComfyUI usan 25 pasos, cfg 1, euler y scheduler simple. Diffusers usa 40 pasos por defecto y la CLI de SGLang, 40 pasos con guidance 1. Son pipelines distintos, no una contradicción; empieza con el valor por defecto de tu ruta.
¿Puedo usar las imágenes generadas comercialmente? La licencia del modelo es solo para uso no comercial y exige una licencia aparte para cualquier fin comercial. El equipo de Qwen afirmó en X que los usuarios conservan los derechos sobre las imágenes, pero eso no está en el texto de la licencia. Si tu uso es comercial, pide la licencia al contacto indicado en el acuerdo.
¿Cómo consigo un PNG con fondo transparente? Declara en el prompt que es una imagen RGBA con canal alfa y fondo transparente (la plantilla exacta está en la sección de transparencia), y guarda en PNG. En ComfyUI, la plantilla "Remove Background: Qwen Image 2.1" hace lo mismo a partir de una foto existente.
¿Funciona en una GPU AMD o Intel? El README solo documenta CUDA y vLLM-Omni es exclusivo de NVIDIA. Esta guía no ha verificado ninguna ruta en ROCm ni en Intel Arc; en Mac la vía verificada es mflux sobre MLX.
¿Necesito los modelos PE de reescritura de prompts? No. Mejoran los resultados con prompts cortos, según kun432, pero son otro modelo de 9B (≈18,8 GB en BF16 o ≈9,5 GB en INT8 para ComfyUI). Si vas justo de memoria, escribe prompts detallados tú mismo.