Cómo usar GPT-5.6 en Kiro: modelos, créditos y prueba de adopción
GPT-5.6 es un modelo prémium integrado en Kiro, no una integración que se configure con una clave de API de OpenAI. Verifica acceso, créditos y región, y decide con una tarea real comparable.
En esta página
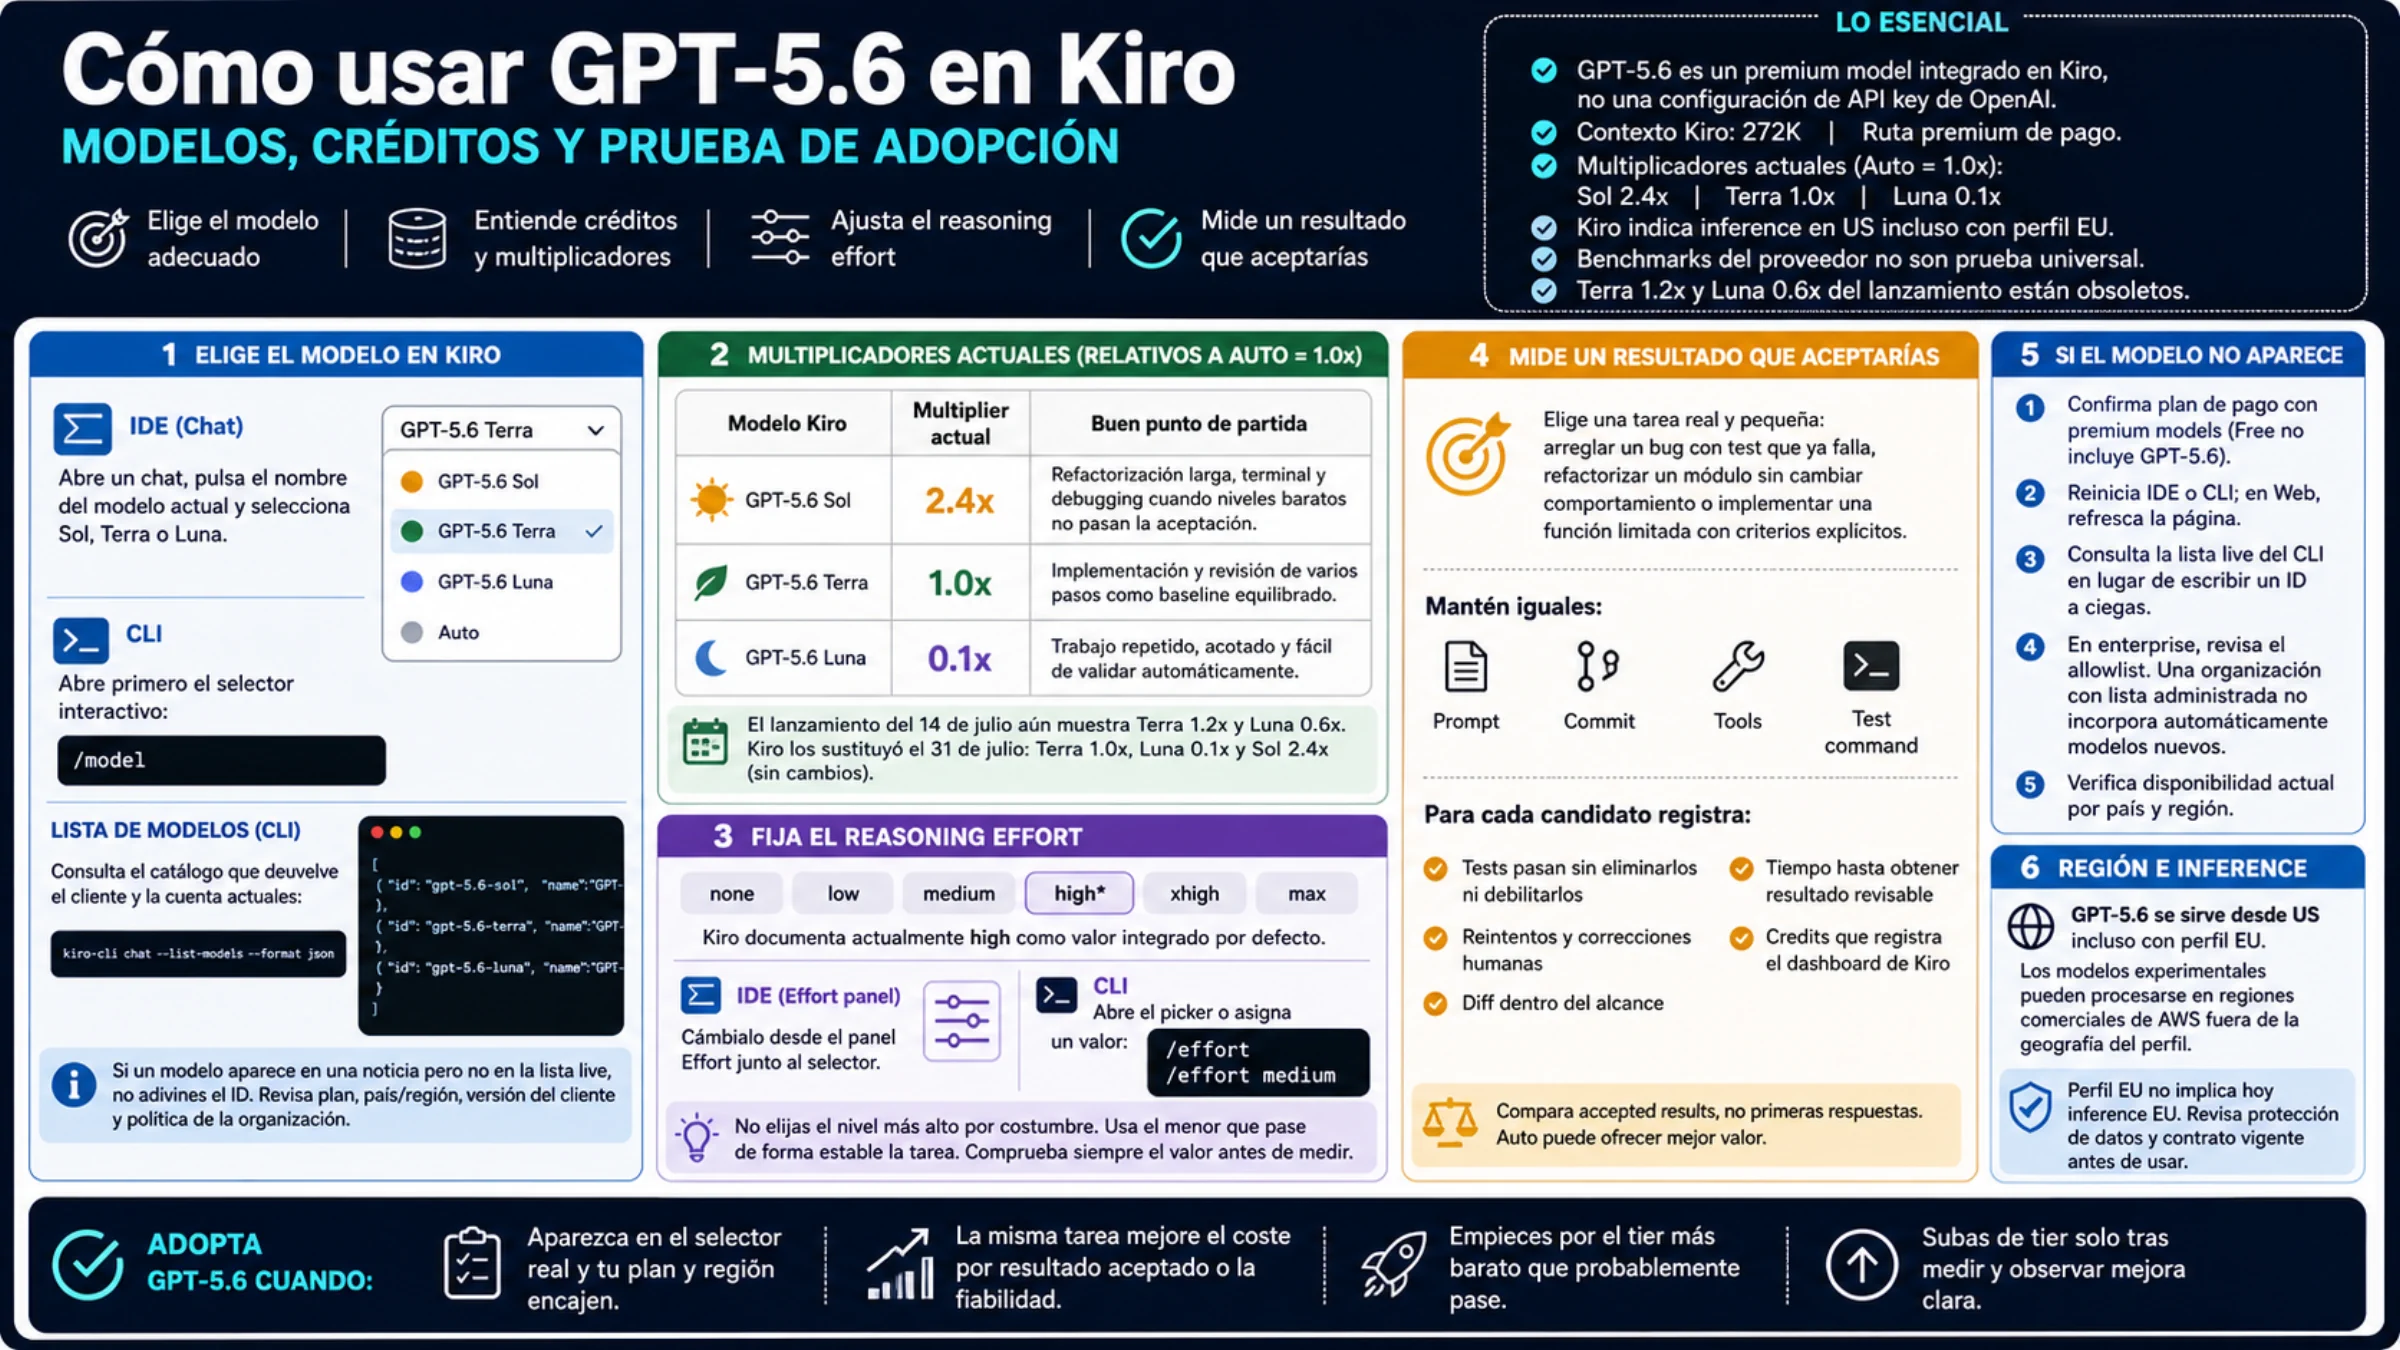
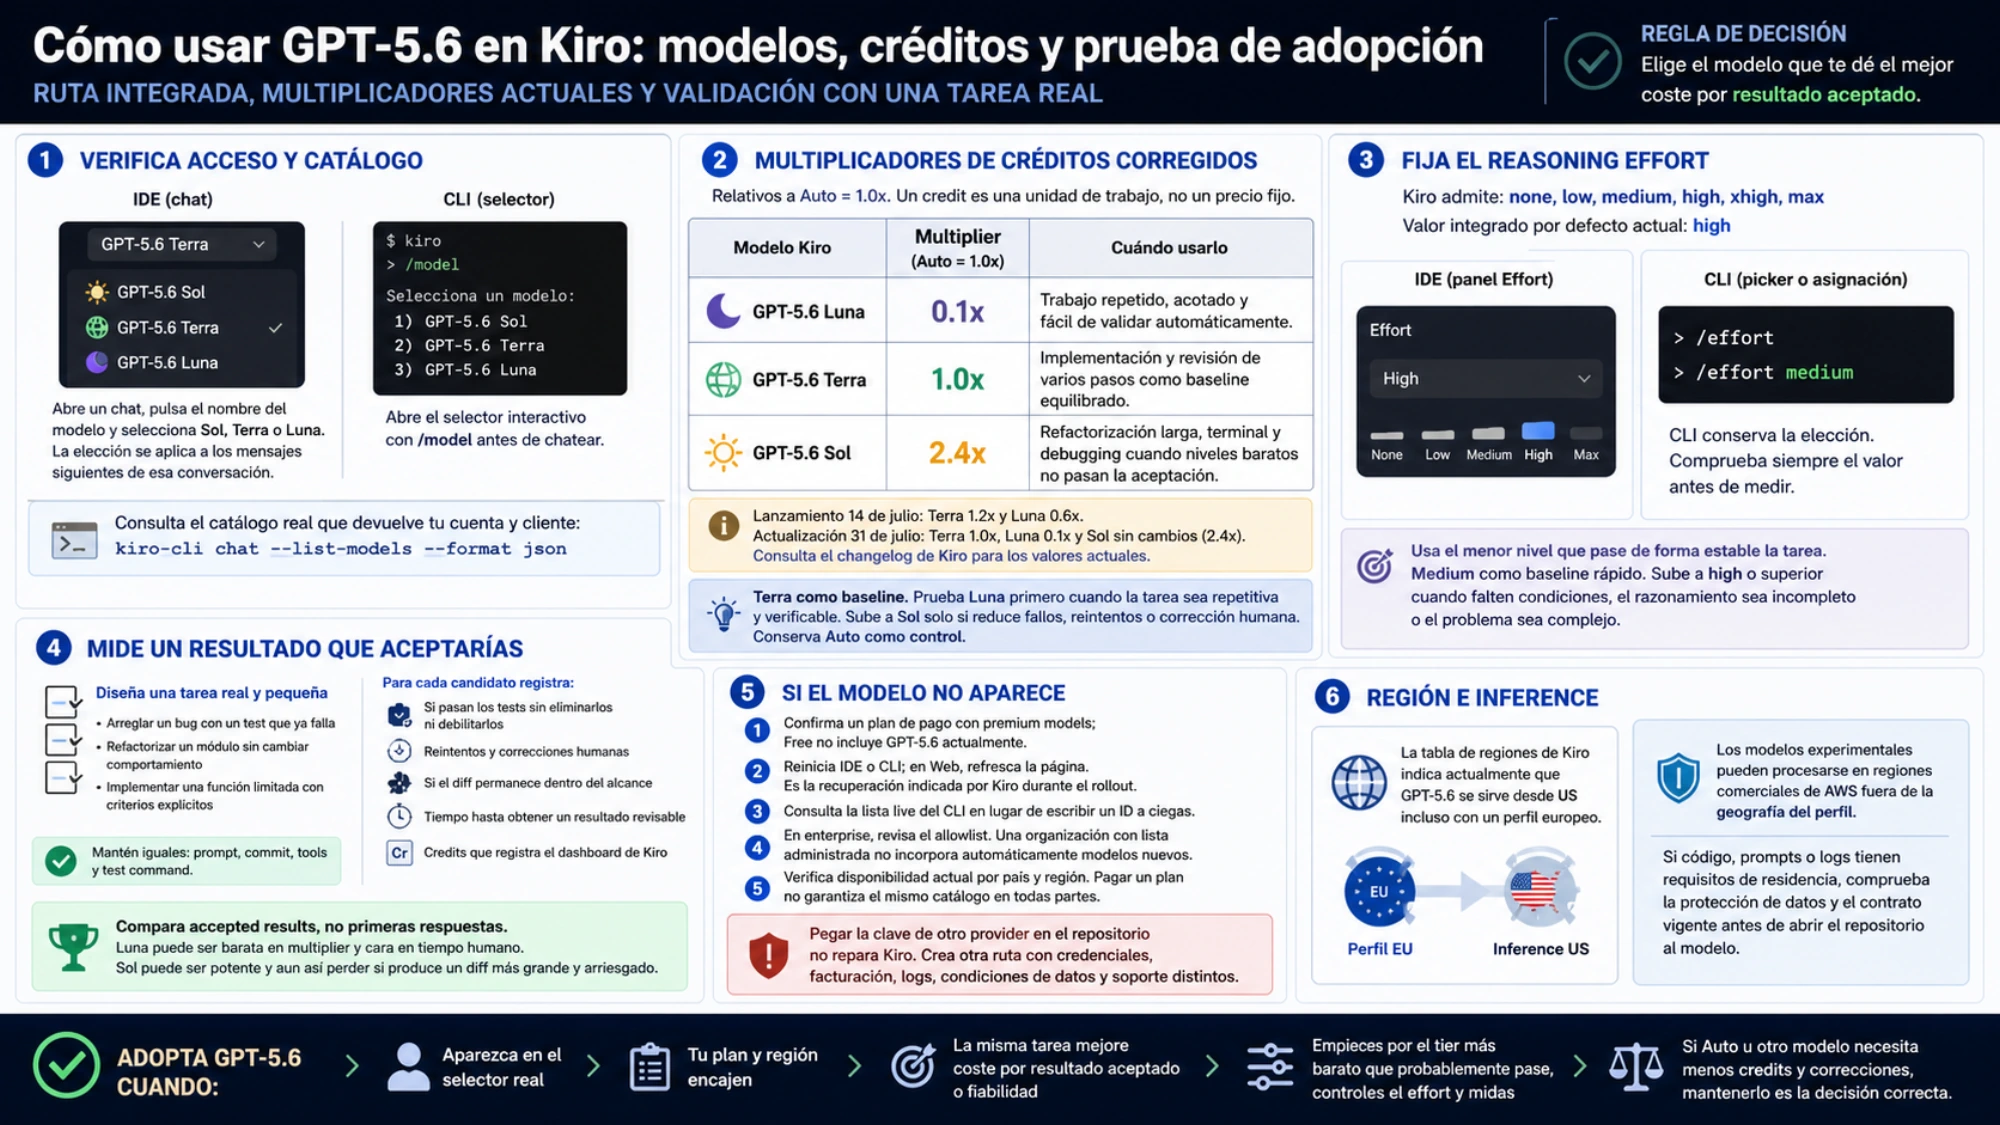
Kiro permite elegir GPT-5.6 Sol, Terra y Luna como modelos integrados. La ruta normal consiste en iniciar sesión en Kiro, usar un plan con modelos prémium y cambiar el modelo desde los controles de Kiro. No exige pegar una clave de API de OpenAI Platform ni sustituir una URL base.
La distinción cambia todo el cálculo: Kiro mide el trabajo en créditos y documenta un contexto de 272K en Kiro. La API directa de OpenAI factura tokens y publica un contexto de 1,05M con sus propias condiciones.
Comprueba el catálogo de tu cuenta
La tabla actual de modelos de Kiro muestra GPT-5.6 para Pro, Pro+, Pro Max y Power, pero no para Free.
En el IDE, abre un chat, pulsa el nombre del modelo actual y selecciona Sol, Terra o Luna. La elección se aplica a los mensajes siguientes de esa conversación. En CLI, abre primero el selector interactivo:
/modelPara consultar el catálogo que devuelve el cliente y la cuenta actuales:
kiro-cli chat --list-models --format jsonSi un modelo aparece en una noticia pero no en la lista disponible, no adivines el ID. Revisa plan, país/región, versión del cliente y política de la organización.
Usa los multiplicadores corregidos
Un crédito de Kiro es una unidad de trabajo. Una tarea compleja basada en una especificación puede consumir más que una consulta breve incluso con el mismo modelo. El multiplicador es relativo a Auto; no es un número de tokens ni un precio fijo por petición.
| Modelo Kiro | Multiplicador publicado con Auto = 1,0× | Buen punto de partida |
|---|---|---|
| GPT-5.6 Luna | 0,1× | Trabajo repetido, acotado y fácil de validar automáticamente |
| GPT-5.6 Terra | 1,0× | Implementación y revisión de varios pasos como referencia equilibrada |
| GPT-5.6 Sol | 2,4× | Refactorización larga, terminal y depuración cuando opciones más baratas no cumplen los criterios de aceptación |
El lanzamiento del 14 de julio aún muestra Terra 1,2× y Luna 0,6×. Kiro los sustituyó en la actualización del 31 de julio: Terra 1,0×, Luna 0,1× y Sol sin cambios en 2,4×.
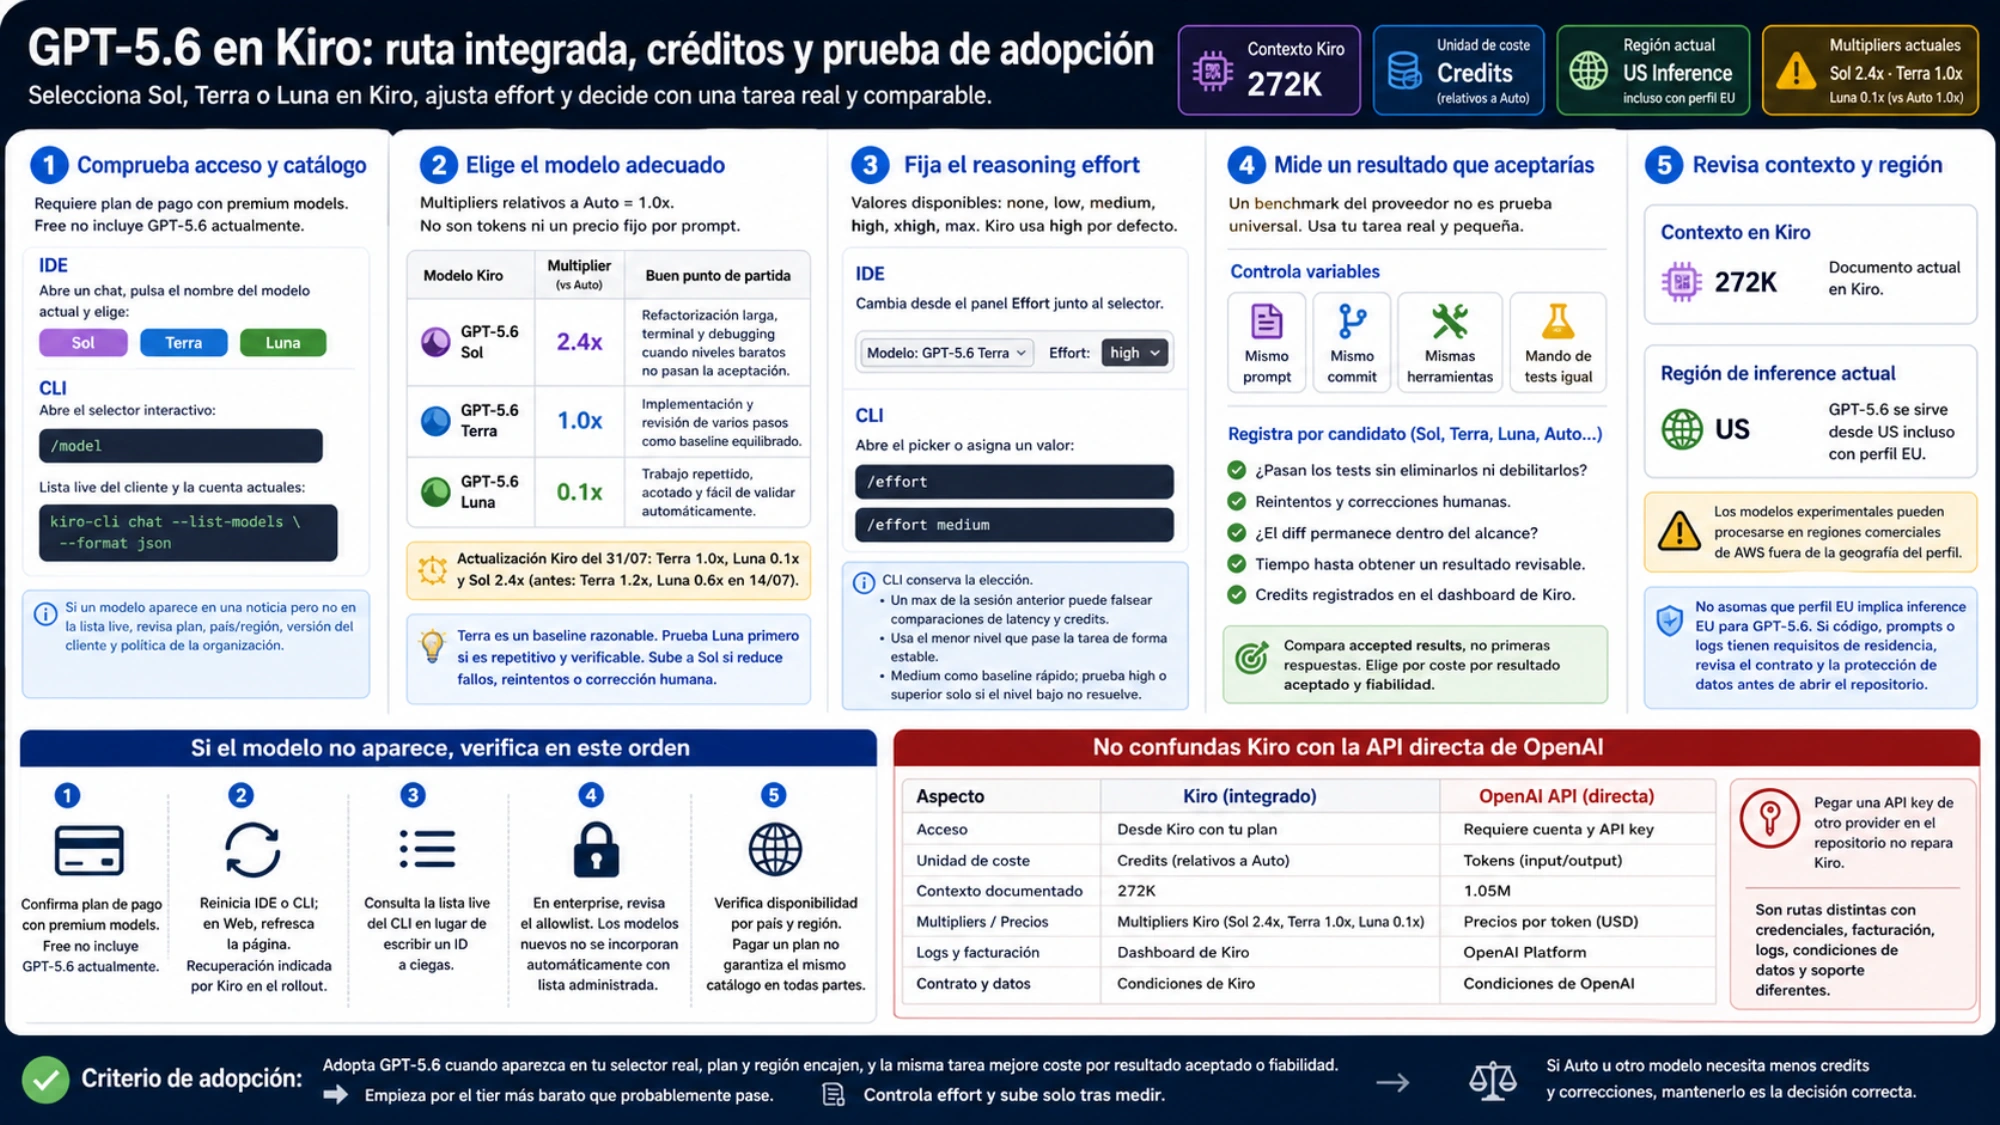
Terra es una referencia razonable para desarrollo cotidiano. Luna merece la primera prueba cuando la tarea es repetitiva y verificable. Sube a Sol si reduce de forma observable fallos, reintentos o corrección humana. Conserva Auto como control: elegir un modelo concreto no garantiza mejor valor.
Para precios por token de la API directa, consulta la comparación de GPT-5.6 Sol, Terra y Luna. Esos dólares no calculan los créditos de Kiro.
Fija el nivel de esfuerzo
La documentación del nivel de esfuerzo de Kiro admite none, low, medium, high, xhigh y max para los tres modelos. Kiro documenta actualmente high como valor integrado por defecto.
En IDE se cambia desde el panel Effort junto al selector. En CLI puedes abrir el selector o asignar un valor:
/effort
/effort medium
CLI conserva la elección. Un max de la sesión anterior puede falsear una comparación de latencia y créditos. Comprueba siempre el valor antes de medir.
No elijas el nivel más alto por costumbre. Usa el menor que complete la tarea de forma estable. medium sirve como punto de partida; compara high o superior cuando observes condiciones omitidas, razonamiento incompleto o un problema complejo que el nivel bajo no resuelve.
Mide un resultado que aceptarías
Un benchmark del proveedor evalúa sus condiciones, no la revisión inicial de tu código, los permisos, las pruebas ni tus criterios de finalización. Elige una tarea real y pequeña: corregir un error con una prueba que ya falla, refactorizar un módulo sin cambiar comportamiento o implementar una función limitada con criterios explícitos.
Mantén iguales las instrucciones, la revisión del código, las herramientas y el comando de prueba. Para cada candidato registra:
- si pasan las pruebas sin eliminarlas ni debilitarlas;
- reintentos y correcciones humanas;
- si el diff permanece dentro del alcance;
- tiempo hasta obtener un resultado revisable;
- créditos que registra el panel de Kiro.
Compara resultados aceptados, no primeras respuestas. Luna puede ser barata según el multiplicador y cara en tiempo humano. Sol puede ser potente y aun así perder si produce un diff más grande y arriesgado.
Si el modelo no aparece
- Confirma un plan de pago con modelos prémium; Free no incluye GPT-5.6 actualmente.
- Reinicia IDE o CLI; en Web, refresca la página. Es la recuperación indicada por Kiro durante el despliegue gradual.
- Consulta la lista disponible del CLI en lugar de escribir un ID a ciegas.
- En una cuenta empresarial, revisa la lista de modelos permitidos. La guía de administración de modelos explica que una organización con lista administrada no incorpora automáticamente modelos nuevos.
- Verifica disponibilidad actual por país y región. Pagar un plan no garantiza el mismo catálogo en todas partes.
Pegar la clave de otro proveedor en el repositorio no repara Kiro. Crea otra ruta con credenciales, facturación, registros, condiciones de datos y soporte distintos.
Un perfil europeo no implica procesamiento en la UE
La tabla de regiones de Kiro indica actualmente que GPT-5.6 se procesa en Estados Unidos incluso con un perfil europeo. También advierte que los modelos experimentales pueden procesarse en regiones comerciales de AWS fuera de la geografía del perfil.
Eso no resume cada condición de almacenamiento o contrato empresarial, pero impide una suposición insegura: un perfil europeo no garantiza procesamiento en la UE para GPT-5.6. Si el código, las instrucciones o los registros tienen requisitos de residencia, comprueba la protección de datos y el contrato vigente antes de abrir el repositorio al modelo.
Adopta GPT-5.6 cuando aparezca en el selector real, plan y región encajen, y la misma tarea mejore coste por resultado aceptado o fiabilidad. Empieza por el modelo más barato que probablemente cumpla la tarea, controla el nivel de esfuerzo y sube solo tras medir. Si Auto u otro modelo necesita menos créditos y correcciones, mantenerlo es la decisión correcta.
Fuentes4
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 30 ago 2026.
Fuentes4
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 30 ago 2026.
- 1.tabla actual de modelos de Kirokiro.dev/docs/models
- 2.actualización del 31 de juliokiro.dev/changelog/models/gpt-5-6-lower-credit-multipliers-for-terra-and-luna
- 3.documentación del nivel de esfuerzo de Kirokiro.dev/docs/models/effort
- 4.guía de administración de modeloskiro.dev/docs/enterprise/governance/model