Gemini Omni 1.2 Flash API gateway: 4 rutas, precio y prueba real
Vercel, OpenRouter y LaoZhang sirven Gemini Omni 1.2 Flash con peticiones distintas. Por clip compensa desde 5 s; más de 10 s o 4K solo se cobra por segundo.
En esta página
Sí, a 12 de noviembre de 2026 puedes llamar a Gemini Omni 1.2 Flash sin abrir una cuenta de facturación en Google: Vercel AI Gateway y OpenRouter lo sirven desde el 5 de noviembre y LaoZhang desde el 11. Lo que no vas a encontrar es el modelo en un endpoint de chat completions. Google solo lo expone en su Interactions API, así que cada gateway ha definido su propia petición de vídeo y hasta su propio ID: google/gemini-omni-1.2-flash en Vercel y OpenRouter, gemini-omni-1.2-flash en el POST /v1/videos de LaoZhang.
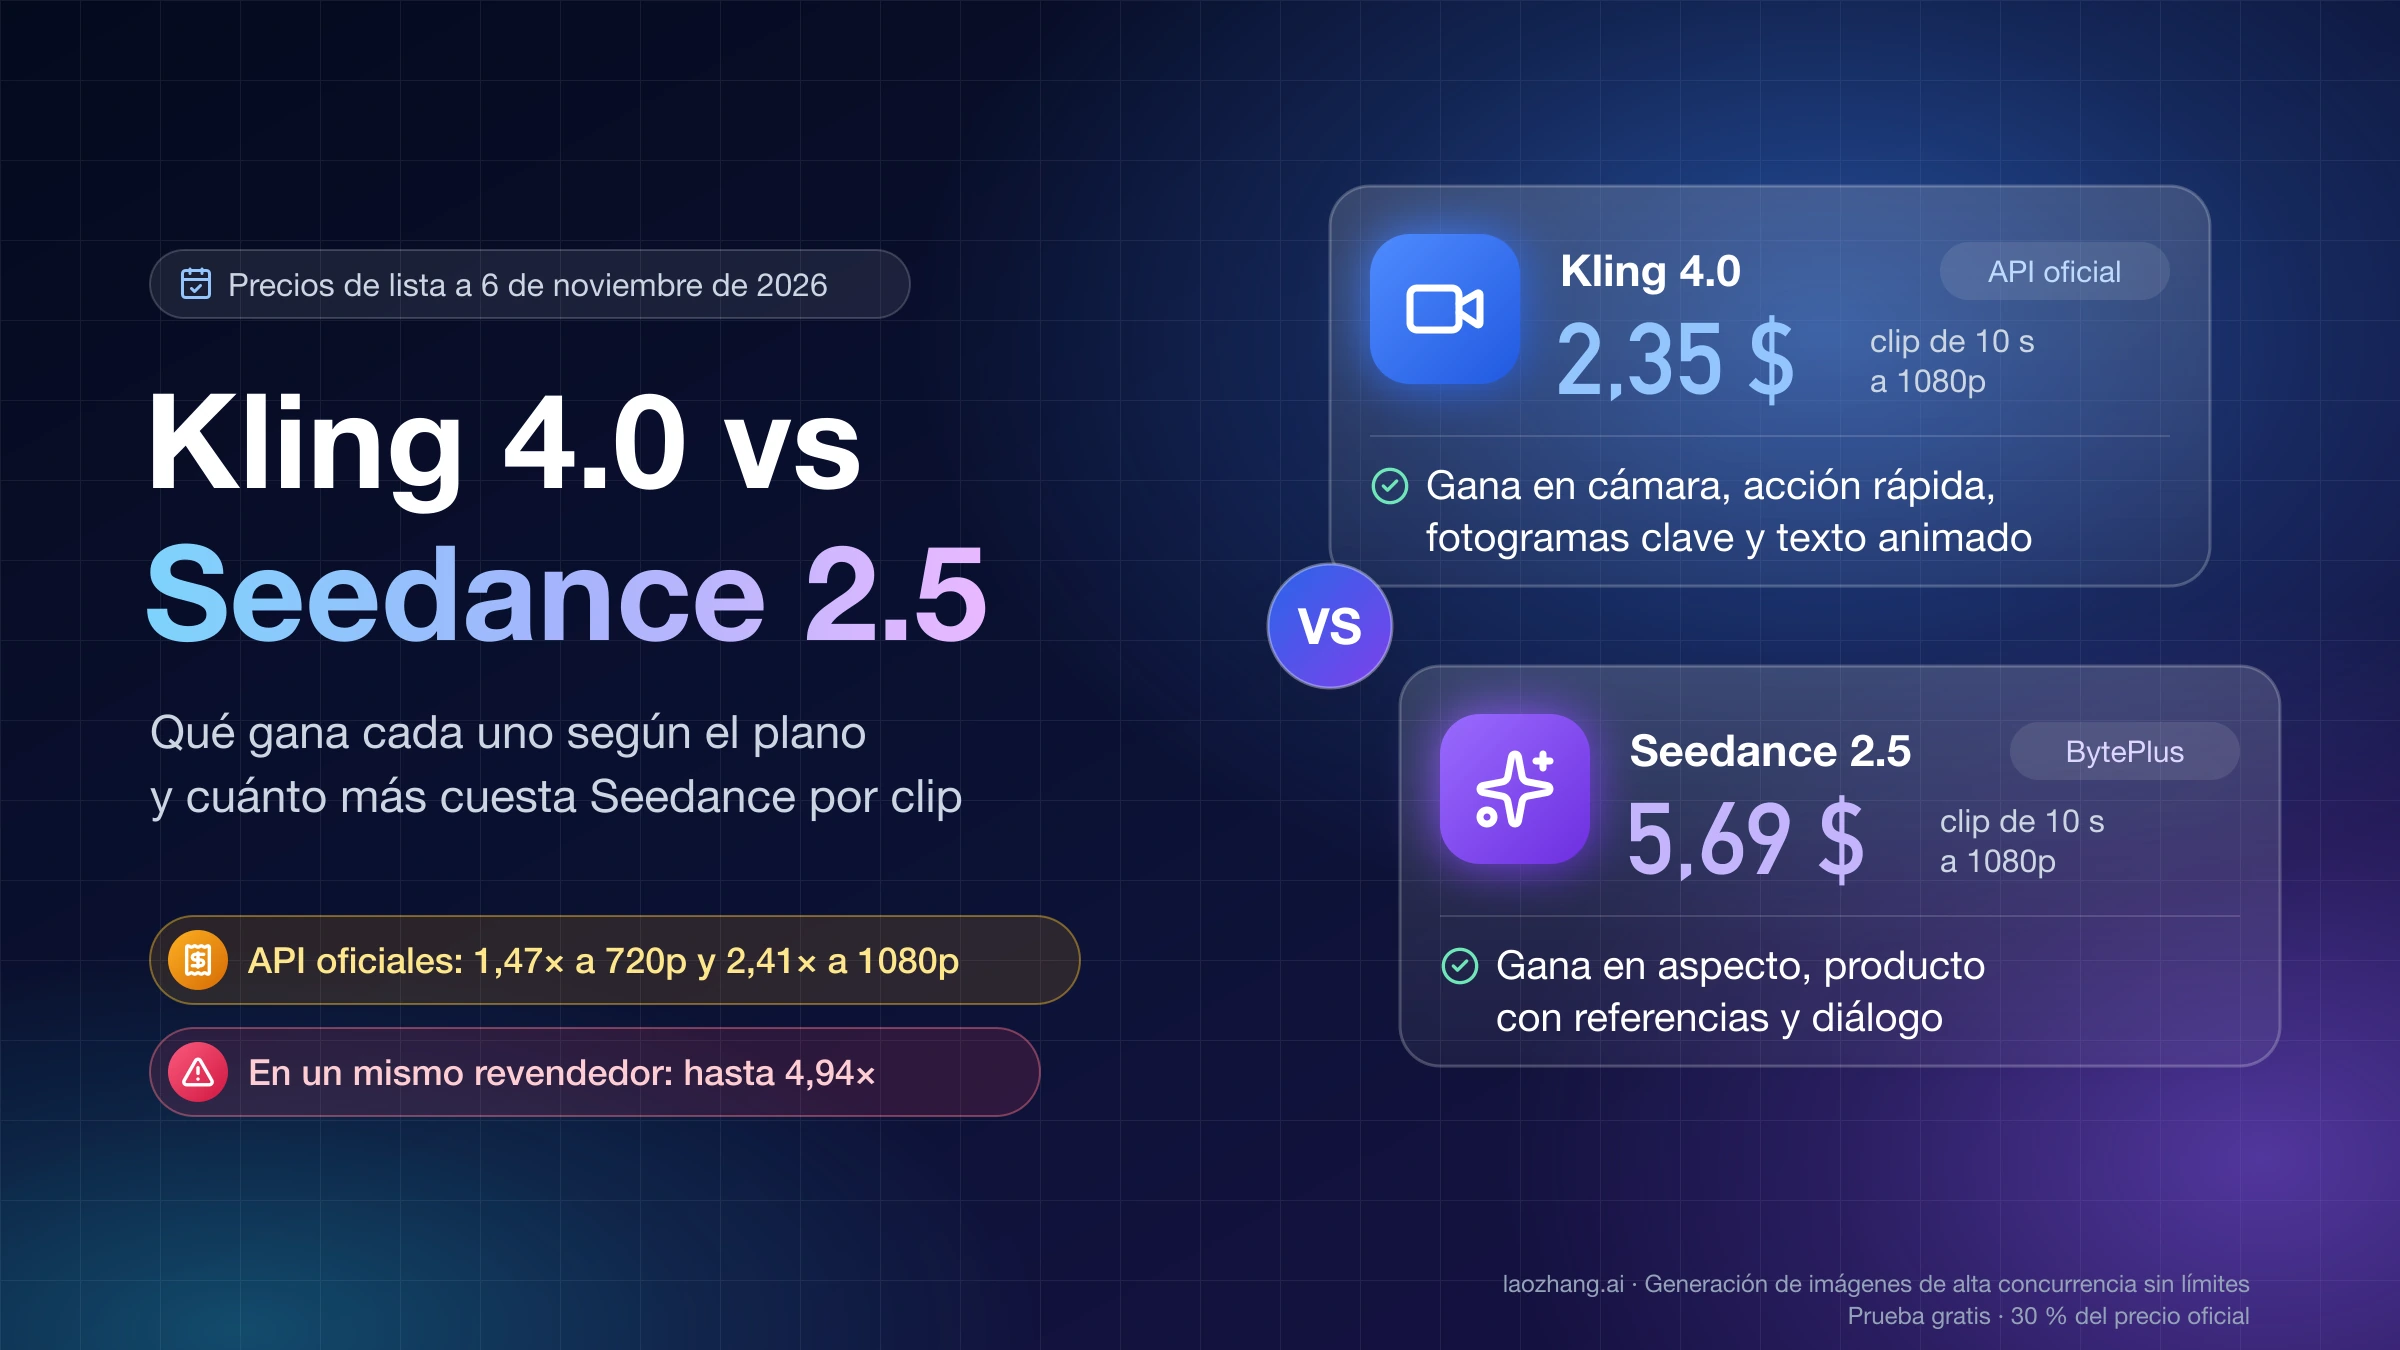
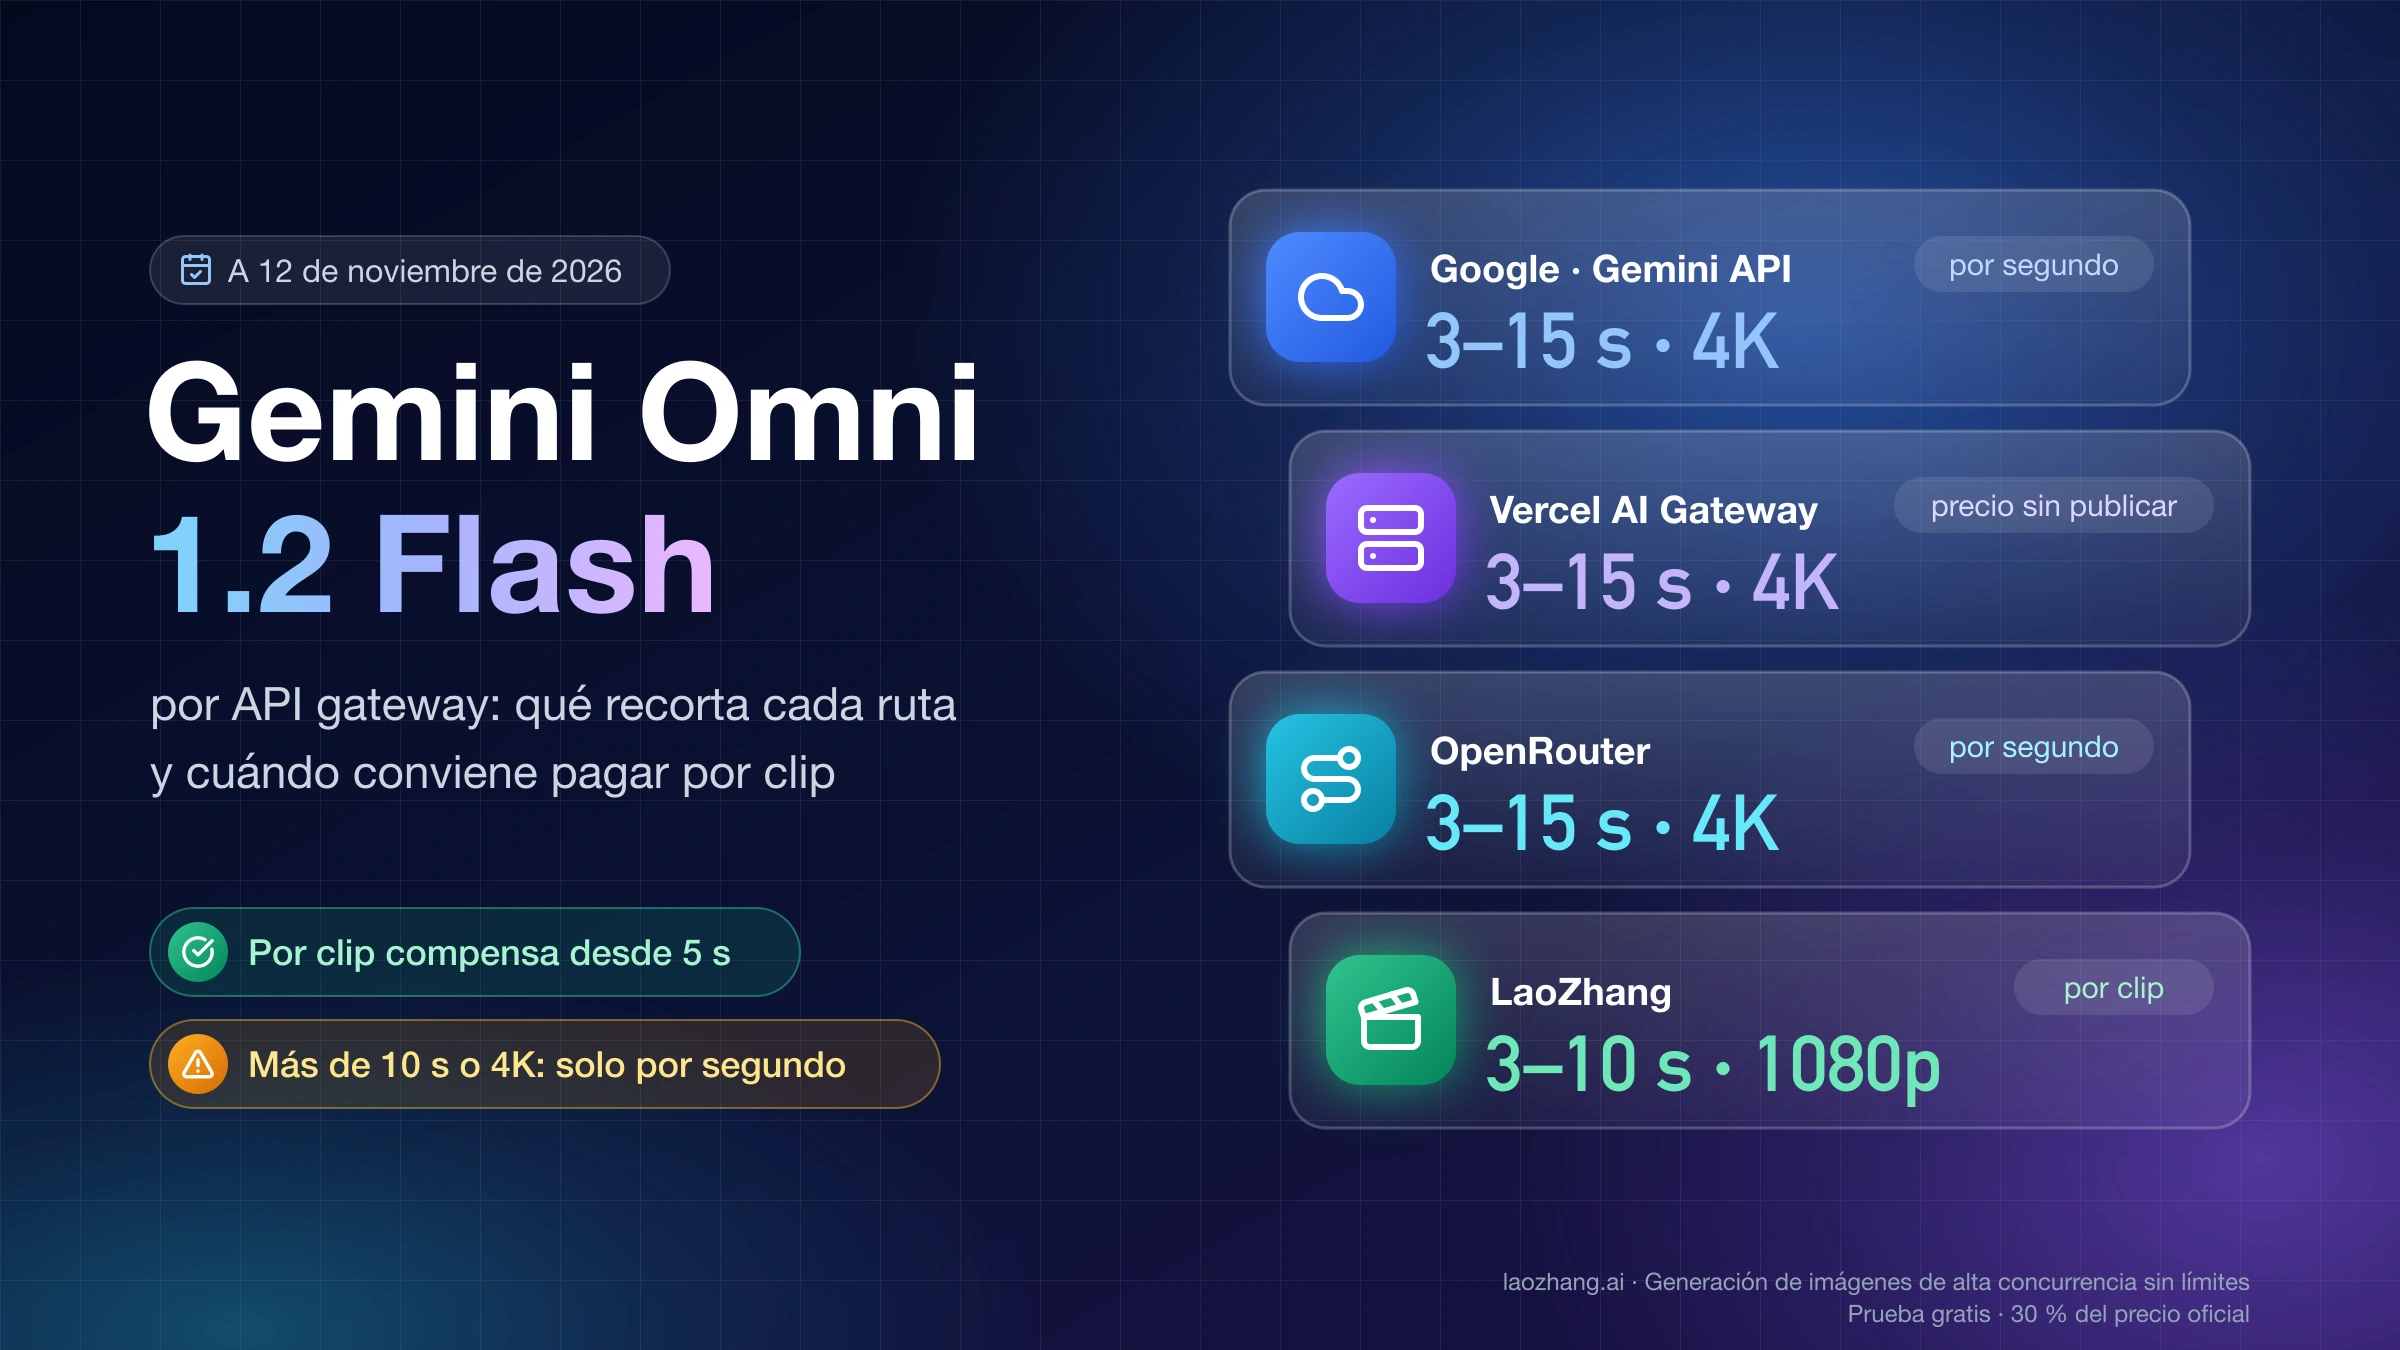
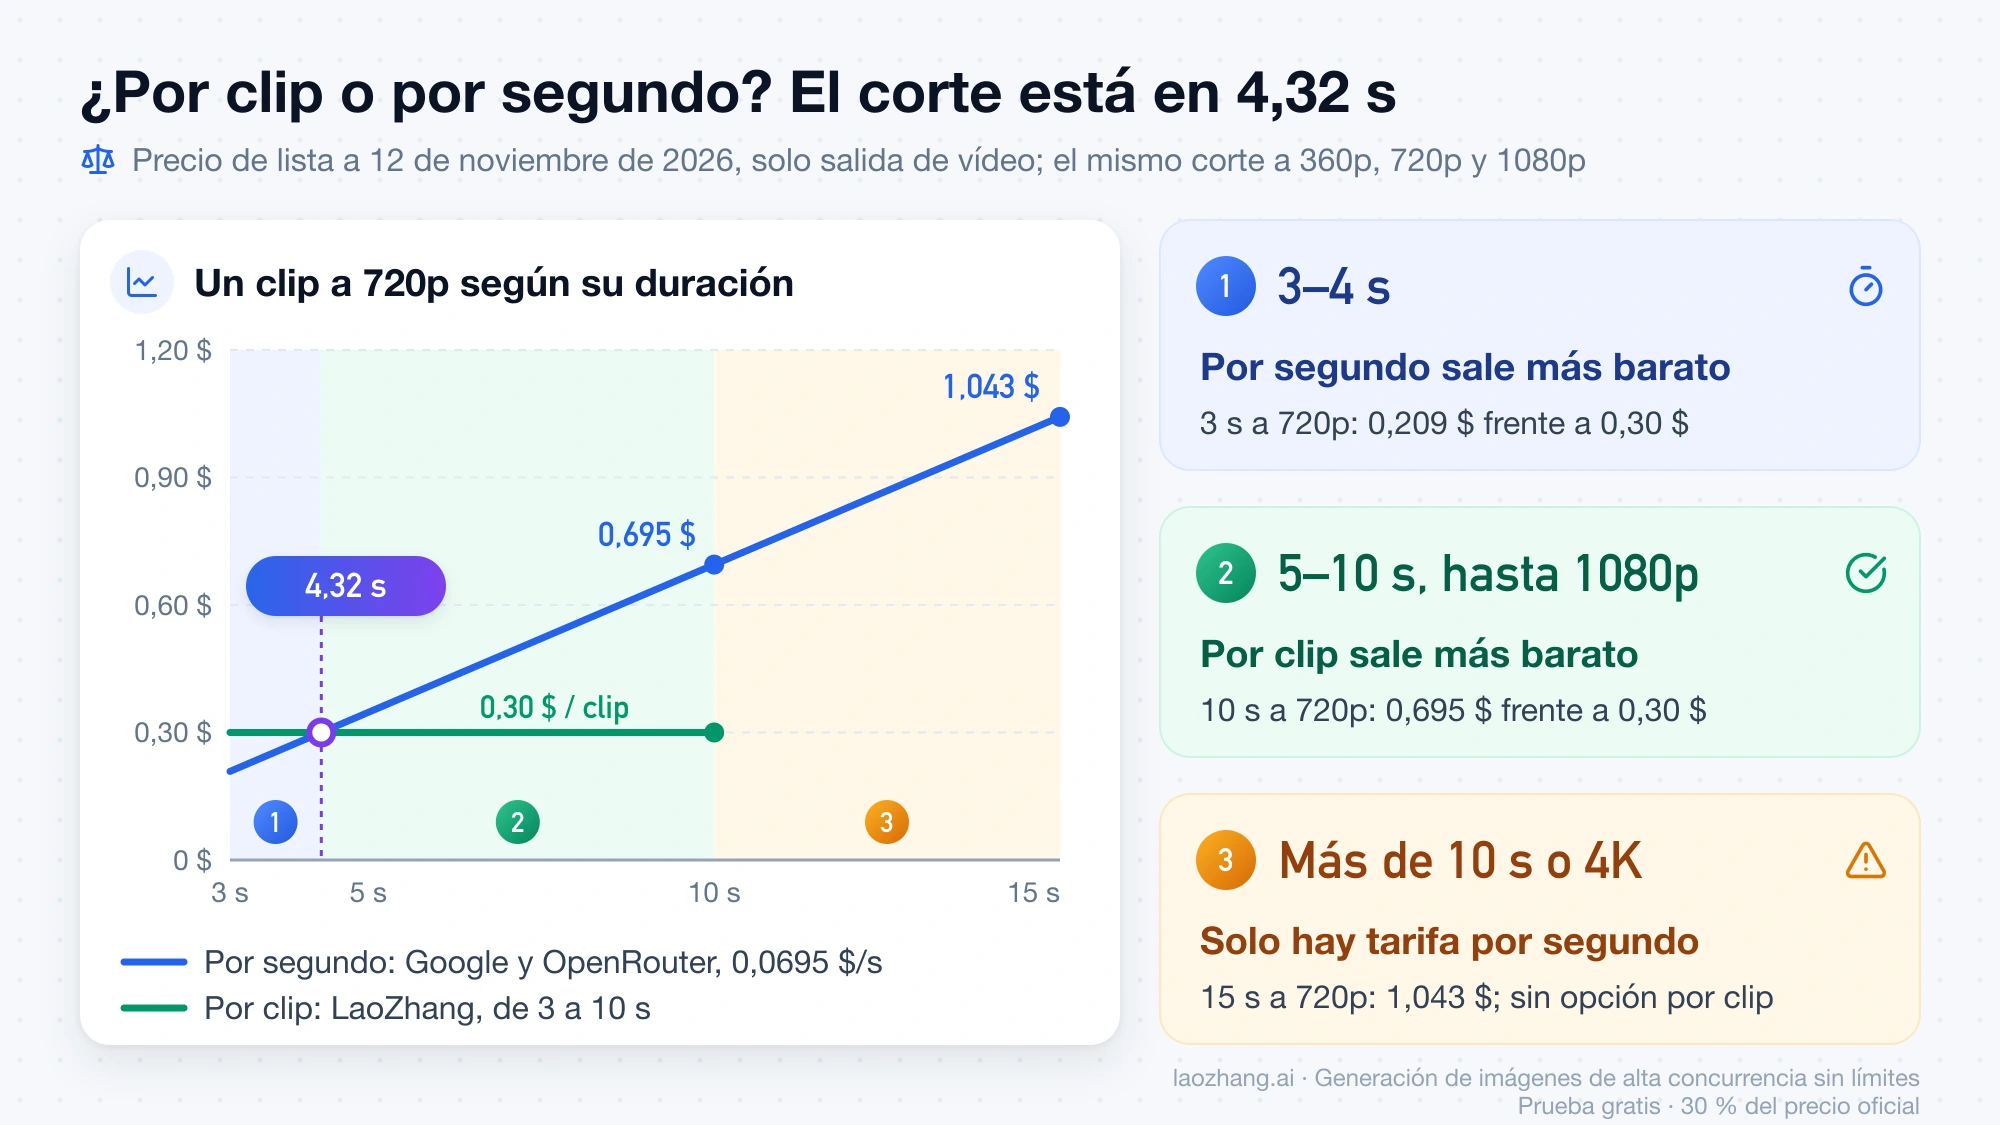
La ruta se elige por el clip que necesitas. Si tus vídeos duran de 3 a 10 segundos, no pasan de 1080p y parten de texto o de imágenes, te sirve cualquiera de las tres. Si necesitas 11–15 s, 4K, extender un clip, editar un vídeo, usar un vídeo de referencia o fijar el último fotograma, tienes que ir a la API de Google o a OpenRouter, que reenvía cada petición a Google y lista todas esas funciones. Vercel anuncia en su changelog 11–15 s, 4K, extensión hasta 30 s y ediciones con hasta seis imágenes de referencia, pero no menciona vídeo de referencia ni último fotograma. En precio, la tarifa por segundo de Google (la misma que publica OpenRouter) y la tarifa fija por clip de LaoZhang (0,10 $, 0,30 $ y 0,45 $ a 360p, 720p y 1080p) se igualan en 4,32 segundos: por debajo cuesta menos pagar por segundo y de 5 s en adelante, por clip.
El 12 de noviembre de 2026 se generaron seis clips a través del gateway de LaoZhang con una sola clave, en unos seis minutos. Los seis terminaron en completed entre 31 y 67 segundos después de enviarse, llegaron como MP4 H.264 a 24 fps con pista de audio y llevan el manifiesto C2PA firmado por Google LLC. Es una muestra pequeña, no una tasa de éxito, y las otras rutas se describen según su propia documentación.
Cuatro rutas a Gemini Omni 1.2 Flash: petición, ID y funciones
Gemini Omni 1.2 Flash no se llama con chat completions en ninguna de estas rutas, porque Google lo publica solo en la Interactions API (POST https://generativelanguage.googleapis.com/v1beta/interactions), no en generateContent ni en el formato de OpenAI, y encadena las ediciones en varios turnos con previous_interaction_id. Cada gateway traduce esa llamada a su propia interfaz, y de esa traducción depende qué funciones de Google llegan hasta ti.
| Google (Gemini API) | Vercel AI Gateway | OpenRouter | LaoZhang | |
|---|---|---|---|---|
| Forma de llamar | Interactions API | AI SDK, generateText o streamText | API de vídeo asíncrona /api/v1/videos | /v1/videos asíncrono, estilo OpenAI |
| ID del modelo | gemini-omni-1.2-flash | google/gemini-omni-1.2-flash | google/gemini-omni-1.2-flash | gemini-omni-1.2-flash |
| Cuenta | Proyecto de Google con nivel de pago | Clave de Vercel, sin cuenta de Google | Clave de OpenRouter | Token de LaoZhang, sin cuenta de Google |
| Duración | 3–15 s | 3–15 s | 3–15 s | 3–10 s |
| Resolución máxima | 4K | 4K | 4K | 1080p |
| Extensión y edición | Sí, extensión hasta 30 s | Sí, según su changelog | Sí, con previous_job_id | No documentadas |
| Vídeo de referencia y último fotograma | Sí | No los menciona su changelog | Sí | No; rechazados al enviar |
| Precio | Por segundo | No figura en su ficha | Por segundo, igual que Google | Por clip, según resolución |
Solo la columna de LaoZhang se ha ejecutado (pruebas del 12 de noviembre de 2026, más abajo). Las de Google, Vercel y OpenRouter salen de la guía de Omni en Gemini API, del changelog de Vercel sobre Gemini Omni 1.2 Flash y de la ficha de Gemini Omni 1.2 Flash en OpenRouter. Según esa ficha, OpenRouter tiene un único proveedor para este modelo, Google AI Studio, y le reenvía cada petición directamente.
El ID no se puede copiar de un gateway a otro. Enviar google/gemini-omni-1.2-flash a LaoZhang el 12 de noviembre de 2026 devolvió HTTP 503 con Current group default has no available channels for model google/gemini-omni-1.2-flash; con gemini-omni-1.2-flash la misma petición funcionó. Si cambias de proveedor, cambia también el nombre del modelo y el campo de duración: seconds en LaoZhang, duration como número entero en OpenRouter y duration: '3s' dentro de responseFormat en Vercel.
Qué ruta sale más barata: por clip o por segundo, el corte en 4,32 s
Si tus clips duran 5 segundos o más y no pasan de 1080p, a precio de lista sale por menos una tarifa fija por clip; si duran 3 o 4 segundos, la tarifa por segundo. Google cobra el vídeo como tokens de salida a 12 $ por millón y su página de precios fija cuántos tokens consume cada segundo: 1.931 a 360p, 5.792 a 720p, 8.688 a 1080p y 17.376 a 4K. Multiplicando, sale 0,0232 $, 0,0695 $, 0,1043 $ y 0,2085 $ por segundo, que son exactamente los precios por segundo que lista OpenRouter para este modelo. LaoZhang cobra 0,10 $, 0,30 $ y 0,45 $ por clip de 3 a 10 s, y 0,30 / 0,0695 = 4,32 s; el cociente da lo mismo en los tres niveles.
| Duración | 360p por segundo | 720p por segundo | 1080p por segundo | 4K por segundo | Por clip (360p / 720p / 1080p) |
|---|---|---|---|---|---|
| 3 s | 0,070 $ | 0,209 $ | 0,313 $ | 0,626 $ | 0,10 / 0,30 / 0,45 $ |
| 4 s | 0,093 $ | 0,278 $ | 0,417 $ | 0,834 $ | 0,10 / 0,30 / 0,45 $ |
| 5 s | 0,116 $ | 0,348 $ | 0,521 $ | 1,043 $ | 0,10 / 0,30 / 0,45 $ |
| 8 s | 0,185 $ | 0,556 $ | 0,834 $ | 1,668 $ | 0,10 / 0,30 / 0,45 $ |
| 10 s | 0,232 $ | 0,695 $ | 1,043 $ | 2,085 $ | 0,10 / 0,30 / 0,45 $ |
| 15 s | 0,348 $ | 1,043 $ | 1,564 $ | 3,128 $ | No disponible |
Cálculo a 12 de noviembre de 2026 con la tabla de precios de Gemini API y la documentación de LaoZhang; solo cuenta la salida de vídeo. Con 100 clips de 10 s a 720p, la diferencia es de 69,50 $ por segundo frente a 30 $ por clip; con 100 clips de 3 s a 720p se invierte: 20,85 $ frente a 30 $. Por encima de 10 s y en 4K no hay alternativa por clip en esta tabla.
Ojo con dos cifras que despistan al presupuestar. La tarifa por segundo de Google añade la entrada a 1,50 $ por millón de tokens (texto, imágenes y vídeo que envías), que la tarifa por clip no suma. Y el «9 $ por millón de salida» que muestran algunas fichas de gateways es la tarifa de salida de texto, no la de vídeo: el catálogo público de Vercel lista este modelo a 1,50 $ / 9 $ por millón de tokens y, a 12 de noviembre de 2026, ni ese catálogo ni su ficha muestran un precio por segundo de vídeo, así que consulta tu panel de Vercel antes de hacer cuentas. La misma regla vale para cualquier otro intermediario que anuncie el modelo: mira primero si cobra por clip o por segundo.
Primera petición por un gateway: token, crear, consultar y descargar
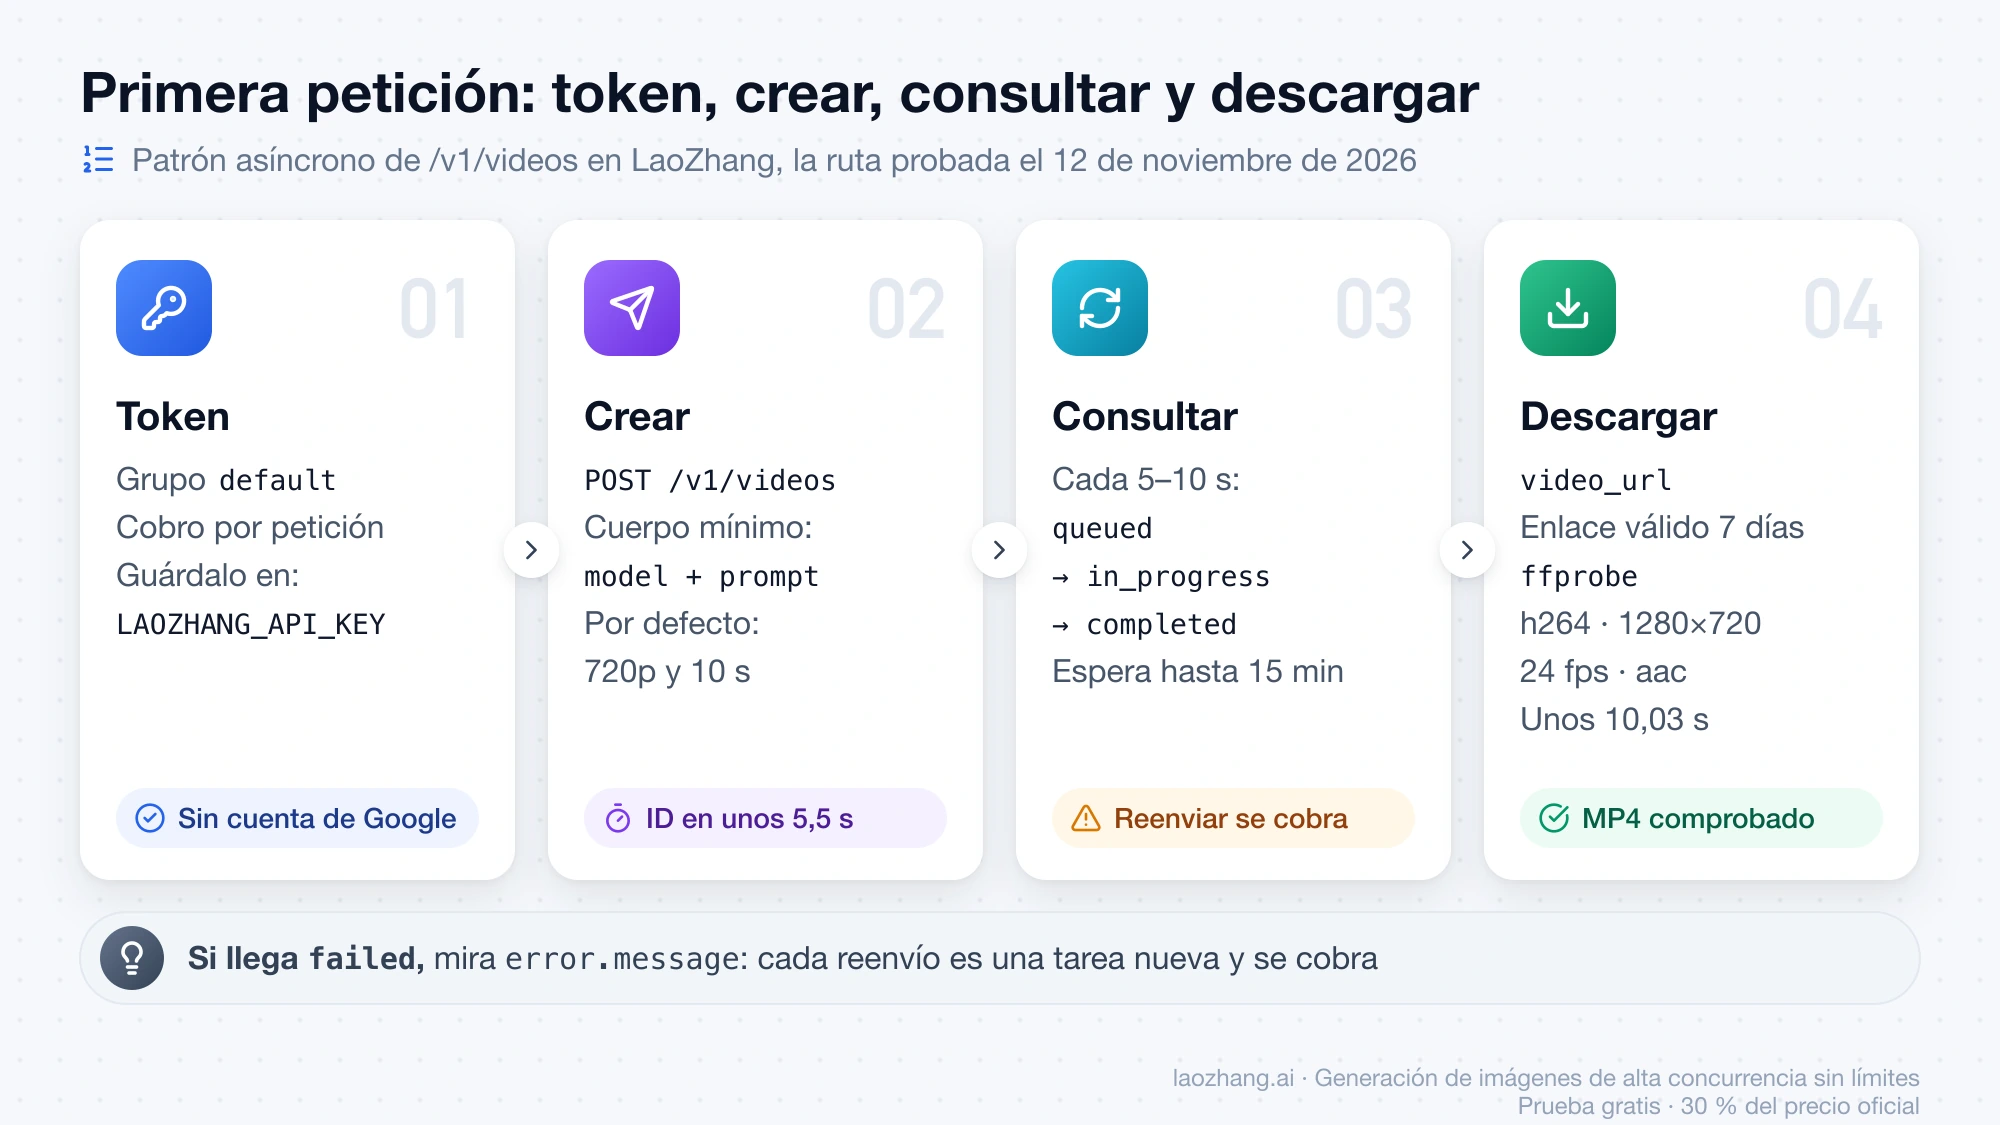
En LaoZhang la llamada sigue el patrón asíncrono de /v1/videos: envías la petición, recibes un ID de tarea en unos 5,5 segundos, consultas el estado hasta que pasa a completed y descargas el MP4 desde video_url. Es la ruta que se probó el 12 de noviembre de 2026; los pasos siguientes usan los mismos campos que esa prueba y la documentación de LaoZhang.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
-
Crea un token. En la página de tokens de LaoZhang, crea uno en el grupo
defaultcon facturación por petición o con el modo que prioriza el uso; un token configurado solo para facturación por uso no puede llamar al modelo. No necesitas cuenta de Google ni clave de Gemini API. Guarda el token en la variable de entornoLAOZHANG_API_KEYen lugar de escribirlo en el código. -
Crea la tarea. El cuerpo mínimo lleva
modelyprompt;resolutionadmite360p,720p(por defecto) y1080p,secondsva de 3 a 10 (10 por defecto) yaspect_ratioacepta16:9o9:16. Para partir de una imagen, añadeimagecon una URL o un data URL en base64 (en multipart, el campo se llamainput_reference);reference_imagesadmite más imágenes, hasta 6 en total.VIDEO_ID=$(curl -s https://api.laozhang.ai/v1/videos \ -H "Authorization: Bearer $LAOZHANG_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "gemini-omni-1.2-flash", "prompt": "Una violinista toca bajo una farola en una calle empedrada mojada tras la lluvia; la cámara se acerca despacio. Se oyen las gotas y el violín.", "resolution": "720p", "seconds": "10" }' | jq -r '.id') -
Consulta el estado cada 5–10 segundos. Pasará de
queuedain_progress(con un campoprogress) y terminará encompletedofailed. Si tarda, sigue consultando el mismo ID hasta 15 minutos antes de volver a enviar nada, porque cada envío crea una tarea nueva y se cobra otra vez; las tareas que siguen sin terminar a los 30 minutos se marcan como fallidas y se devuelven.while true; do STATUS=$(curl -s "https://api.laozhang.ai/v1/videos/$VIDEO_ID" \ -H "Authorization: Bearer $LAOZHANG_API_KEY" | jq -r '.status') echo "$STATUS" [ "$STATUS" = "completed" ] || [ "$STATUS" = "failed" ] && break sleep 10 done -
Descarga el vídeo y comprueba el archivo.
video_urlse descarga sin cabecera de autorización y el enlace dura 7 días, así que guarda tu copia; con la clave también puedes pedirGET /v1/videos/{id}/content. Unffprobeconfirma que recibiste lo que pediste: para esta petición deberías verh264a 1280×720 y 24 fps, una pistaaacy unos 10,03 segundos.curl -s "https://api.laozhang.ai/v1/videos/$VIDEO_ID" \ -H "Authorization: Bearer $LAOZHANG_API_KEY" | jq -r '.video_url' | xargs curl -sL -o omni.mp4 ffprobe -v error -show_entries stream=codec_name,width,height,r_frame_rate:format=duration -of compact omni.mp4
Una tarea terminada devuelve id, object: "video", model, status, progress, resolution, seconds, size, created_at, completed_at y video_url. Si en lugar de eso llega failed, el motivo está en error.message.
La misma tarea en OpenRouter y en Vercel AI Gateway
OpenRouter usa su propia API de vídeo, también asíncrona: POST https://openrouter.ai/api/v1/videos con model: "google/gemini-omni-1.2-flash", prompt, duration (entero de 3 a 15), resolution y aspect_ratio, y para los fotogramas, frame_images con first_frame o last_frame. Responde con un trabajo en estado pending y su polling_url; se consulta con GET /api/v1/videos/{jobId} hasta completed (o failed, cancelled, expired) y el vídeo se baja de GET /api/v1/videos/{jobId}/content?index=0 enviando la clave en Authorization. Su guía de generación de vídeo de OpenRouter sugiere consultar cada 30 segundos o configurar un webhook con callback_url.
Vercel AI Gateway no expone una tarea que consultar: con el AI SDK llamas a generateText y el vídeo vuelve completo como archivo en files, también con streamText. Este es el ejemplo de su changelog, que genera 3 segundos a 360p:
import { writeFile } from 'node:fs/promises';
import { generateText } from 'ai';

const { files } = await generateText({
  model: 'google/gemini-omni-1.2-flash',
  prompt: 'A red ball rolls across a white table.',
  providerOptions: {
    google: {
      responseModalities: ['text', 'video'],
      responseFormat: [{ type: 'video', resolution: '360p', duration: '3s' }],
    },
  },
});

const video = files.find((file) => file.mediaType === 'video/mp4');
if (!video) throw new Error('No MP4 video returned');
await writeFile('video.mp4', video.uint8Array);
Estas dos formas de llamada vienen de la documentación de OpenRouter y de Vercel a 12 de noviembre de 2026 y no se ejecutaron en la prueba. En Vercel, al no haber tarea, la petición queda abierta mientras se genera el vídeo, y la documentación no dice cómo se comportan los tiempos de espera con un clip largo en 4K.
Qué devolvió la prueba del 12 de noviembre de 2026: tiempos y archivos
Los seis clips generados por LaoZhang el 12 de noviembre de 2026, entre las 03:42 y las 03:48 UTC, terminaron en completed, y todos respetaron la resolución, la proporción y la duración pedidas. El tiempo de la tabla va desde el envío hasta ver completed, consultando cada 5 segundos, así que incluye esos 5,5 segundos iniciales y puede pasarse en hasta 5 segundos.
| Petición | Hasta completed | Archivo recibido | Precio de lista |
|---|---|---|---|
| 360p, 3 s, desde texto (3 veces) | 30,8 s, 30,9 s y 30,7 s | 640×360, 3,03 s, 1,29 MB | 0,10 $ cada uno |
| 360p, 5 s, desde una imagen | 37,2 s | 640×360, 5,03 s, 1,62 MB | 0,10 $ |
| 720p, 10 s, desde texto | 67,2 s | 1280×720, 10,03 s, 4,99 MB (unos 3,98 Mbit/s) | 0,30 $ |
| 1080p, 5 s, vertical 9:16 | 61,1 s | 1080×1920, 5,03 s, 5,01 MB (unos 7,95 Mbit/s) | 0,45 $ |
Según ffprobe, todos son MP4 con vídeo H.264 a 24 fps y audio AAC estéreo a 48 kHz, y el audio no es silencio: el volumen medio está entre −23 y −33 dB. Que se oiga algo no significa que la frase de un personaje se pronuncie bien; la sincronía labial no se evaluó. La prueba con imagen envió como image un fotograma de 640 píxeles de ancho sacado del clip de 720p, en forma de data URL.
El coste de los seis fue de 1,15 $ a precio de lista (4 × 0,10 $ + 0,30 $ + 0,45 $). El contador de uso de la cuenta subió exactamente el precio de lista en tres casos: el primer clip de 360p, el de 1080p y el de imagen. En los otros tres la clave la estaba usando a la vez otra sesión y aparecieron 0,018 $ de más que no se pueden atribuir a estas tareas. Fíjate también en que los clips de 3 y 5 segundos costaron lo mismo que habría costado uno de 10.
Los tiempos encajan con lo que anuncia LaoZhang (30–60 s para un clip corto a 360p, alrededor de un minuto para 10 s a 720p). Para OpenRouter, la ficha del modelo mostraba el 12 de noviembre de 2026 hacia las 03:35 UTC una latencia mediana (P50) de 41,51 s y una disponibilidad (uptime) del 44,18 % en los tres días anteriores para su único proveedor, Google AI Studio. Es una cifra de su panel, medida de otra forma y cambiante cada día, así que no compares directamente con estos seis clips ni la leas como la disponibilidad de la API de Google.
Parámetros que rechaza el gateway: 15 s, 4K, 1:1 y vídeo de referencia
Lo que Google ofrece más allá de 10 segundos, 1080p y las imágenes (inicial o de referencia) lo rechaza LaoZhang en el momento del envío, sin crear tarea. El 12 de noviembre de 2026, cada una de estas peticiones devolvió en torno a un segundo después HTTP 400 con type: invalid_request_error, y no se observó ningún cargo:
| Lo que se envió | Mensaje devuelto |
|---|---|
seconds: "15" o seconds: "2" | seconds must be a whole number from 3 to 10. |
resolution: "4k" | resolution must be one of 360p, 720p, 1080p (2K and 4K are not available). |
aspect_ratio: "1:1" | aspect_ratio must be one of 16:9, 9:16. |
video_url (vídeo de referencia o para editar) | video_url is not supported by gemini-omni-1.2-flash; send a prompt and up to 6 images. |
last_frame | last_frame is not supported by gemini-omni-1.2-flash; send a prompt and up to 6 images. |
| 7 imágenes de referencia | Send at most 6 images in total (input_reference plus reference_images). |
Son mensajes de validación del propio gateway, no errores de Google: la API de Google sí acepta 15 s y 4K, aunque tampoco admite 1:1. Si te aparece uno de estos textos, la solución no es reintentar, sino ajustar el valor o cambiar de ruta para esa petición. Tampoco hay campo documentado para extender o editar en varios turnos.
¿El MP4 sale de verdad de Google? C2PA y SynthID tras el gateway
Sí, el archivo lo genera Google y conserva sus credenciales después de pasar por el gateway. Google marca toda la salida de Omni con una marca de agua invisible SynthID y con credenciales de contenido C2PA, y c2patool lo confirmó el 12 de noviembre de 2026 en los seis archivos de la prueba: manifiesto válido emitido por «Google LLC», generador «Google C2PA Core Generator Library», acciones «Created by Google Generative AI.» y «Added imperceptible SynthID watermark», y tipo de origen trainedAlgorithmicMedia. Eso demuestra que el vídeo salió del generador de Google; no demuestra por sí solo qué versión de Omni lo hizo. Si publicas el clip, ten en cuenta que esas credenciales y la marca SynthID viajan con él.
Prompt bloqueado: la tarea acaba en failed y reenviar se cobra de nuevo
Un prompt bloqueado no se rechaza al enviarlo: se acepta, se cobra y la tarea termina en failed, con el importe devuelto. El 12 de noviembre de 2026, una petición que nombraba a una celebridad real recibió HTTP 200 con su ID y, 11,6 segundos después, pasó a failed con error.code: video_generation_failed y el mensaje The prompt or images were blocked: the model can't create videos of real people's names or likenesses. This request is not charged. Remove the person's name or photo and retry. El contador de uso subió 0,10 $ al enviarla y volvió a su valor unos 30 segundos más tarde.
Lo que cuesta dinero es reenviar sin cambiar nada. Según la documentación de LaoZhang, las tareas fallidas, incluidos los bloqueos de moderación, se devuelven enteras y lo rechazado al enviar no se cobra, pero cada reenvío es una tarea nueva con su propio cargo. Según esa misma documentación, el modelo bloquea nombres o caras de personas reales, contenido sexual y personajes con derechos de autor, así que quita el nombre o la foto antes de volver a intentarlo.
Clips de 11–15 s, 4K, extensión o edición: Google o un gateway que reenvía
Si necesitas cualquiera de las funciones que el gateway por clip no acepta, usa la API de Google directamente o un gateway que pasa la petición completa; OpenRouter, además, cobra la misma tarifa por segundo que Google. En la Gemini API, Omni 1.2 Flash genera de 3 a 15 segundos en pasos de 1 segundo, a 360p, 720p, 1080p o 4K, con hasta 6 imágenes de referencia, interpolación entre primer y último fotograma de 3 a 10 s, vídeos de referencia (uno para clips de 11–15 s, hasta tres para 3–10 s), extensión de 3 a 10 s por turno hasta 30 s en total y edición conversacional de un clip generado o subido. OpenRouter lista de 3 a 15 s, hasta 4K, primer y último fotograma, edición y extensión con previous_job_id y vídeos de referencia; Vercel anuncia extensión hasta 30 s, ediciones de clips de 3 a 15 s y refinado con previousInteractionId.
Ir directamente a Google exige un proyecto con nivel de pago y, según la página de límites de Gemini API, en el nivel 1 se queda en 8 peticiones por minuto y 40 al día. Cómo dar la primera petición a la Interactions API, qué pasa desde el 3 de diciembre de 2026 con las llamadas a gemini-omni-1.1-flash y qué no se puede hacer con vídeos subidos en el EEE lo explica Gemini Omni 1.2 Flash en España: API, precio y límites del EEE. Si lo que buscas son clips continuos de 20 a 60 segundos, Omni no llega; mira Muse Video API: cómo generar vídeos de hasta 60 s sin API de Meta, que usa el mismo /v1/videos.
Gemini Omni 1.2 Flash por API gateway: otras preguntas
¿Hay alguna forma gratuita de usar Gemini Omni 1.2 Flash por API?
No en la Gemini API: a 12 de noviembre de 2026, Google marca el nivel gratuito de gemini-omni-1.2-flash como no disponible. Vercel da 5 $ de créditos cada 30 días a los usuarios gratuitos de AI Gateway, pero la ficha del modelo no aclara si se pueden gastar en Omni. Si no necesitas API, los límites diarios de las apps están en Veo 3: límite diario de vídeos en Flow (5 gratis) y en Gemini.
¿Un gateway tiene los mismos límites de peticiones que la API de Google?
No se sabe. Los límites que Google publica para este modelo (de 8 a 40 peticiones por minuto según el nivel) se aplican al proyecto de quien llama a Google directamente, y ni Vercel, ni OpenRouter, ni LaoZhang publican, a 12 de noviembre de 2026, cómo se reparten entre sus clientes. Si vas a lanzar muchas tareas en paralelo, prueba con un volumen pequeño antes.
Fuentes6
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 12 nov 2026.
Fuentes6
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 12 nov 2026.
- 1.guía de Omni en Gemini APIai.google.dev/gemini-api/docs/omni
- 2.changelog de Vercel sobre Gemini Omni 1.2 Flashvercel.com/changelog/gemini-omni-1-2-flash-now-available-on-ai-gateway
- 3.ficha de Gemini Omni 1.2 Flash en OpenRouteropenrouter.ai/google/gemini-omni-1.2-flash
- 4.tabla de precios de Gemini APIai.google.dev/gemini-api/docs/pricing
- 5.guía de generación de vídeo de OpenRouteropenrouter.ai/docs/guides/overview/multimodal/video-generation
- 6.página de límites de Gemini APIai.google.dev/gemini-api/docs/rate-limits