Vídeo IA con varios personajes: diálogo en un plano o por planos
Dos personajes con réplicas cortas caben en un solo plano. Con tres voces, contacto físico o frases que vas a reescribir, genera plano a plano y monta.
En esta página
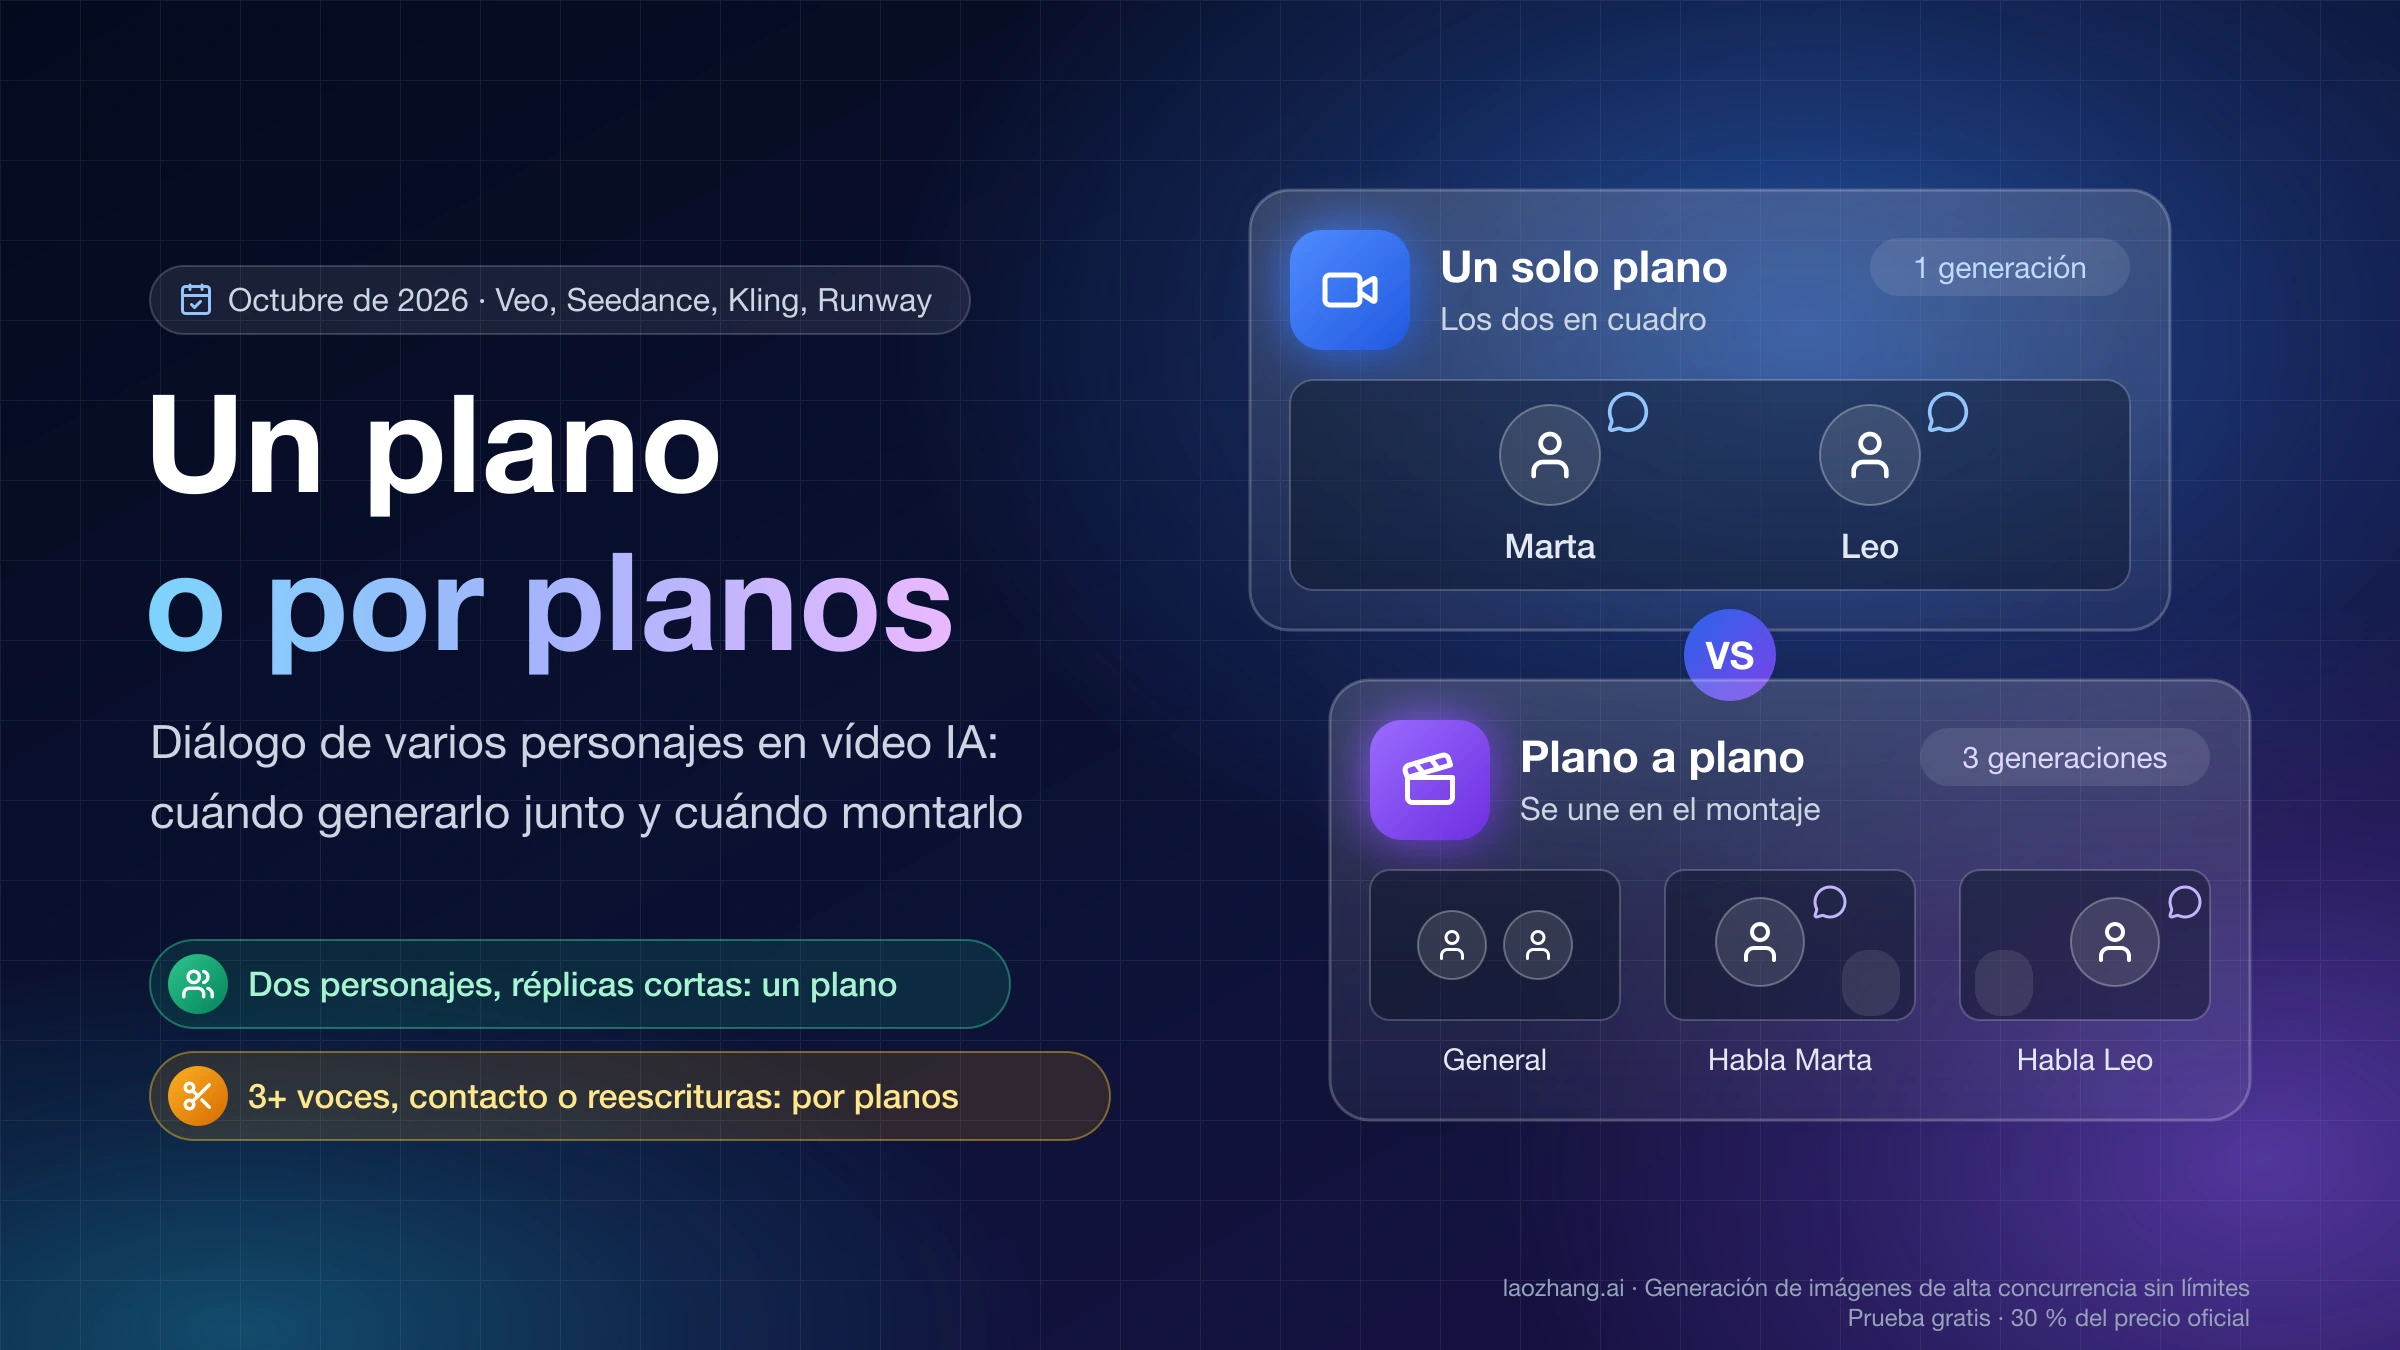
Si tu escena tiene dos personajes, réplicas cortas y ninguna interacción física complicada, puedes generar el diálogo en un solo plano con los dos en cuadro: una generación te da voz, sincronización labial y reacción del que escucha a la vez. En cuanto aparece una de estas condiciones, compensa dividirlo en planos separados (plano/contraplano, sobre el hombro, primeros planos) y montarlo después: tres o más personajes que hablan, réplicas que superan la duración máxima del modelo, contacto físico, o un guion que vas a reescribir varias veces.
El motivo es práctico. Cuando dos personas hablan en la misma generación, el modelo tiene que decidir qué boca mueve, qué voz va con qué cara y en qué orden entran. Seedance es el único proveedor que describe ese fallo por escrito: en vídeos con varios sujetos, los personajes pueden cruzarse con sus imágenes de referencia, sus timbres de voz o su orden de aparición. Plano a plano reduce cada generación a un solo hablante, a cambio de más generaciones y más trabajo de montaje.
Los límites y la sintaxis que aparecen abajo salen de la documentación oficial de cada modelo a 19 de octubre de 2026. Cada comportamiento de fallo descrito procede del proveedor o del tercero que se cita en ese punto.
¿Un plano o plano a plano? Decide con los datos de tu escena
Revisa tu guion con esta tabla antes de escribir una sola línea de prompt. Basta una fila en la columna de la derecha para que el plano único deje de ser la opción por defecto.
| Dato de la escena | Favorece el mismo plano | Favorece plano a plano |
|---|---|---|
| Personajes que hablan | Dos | Tres o más |
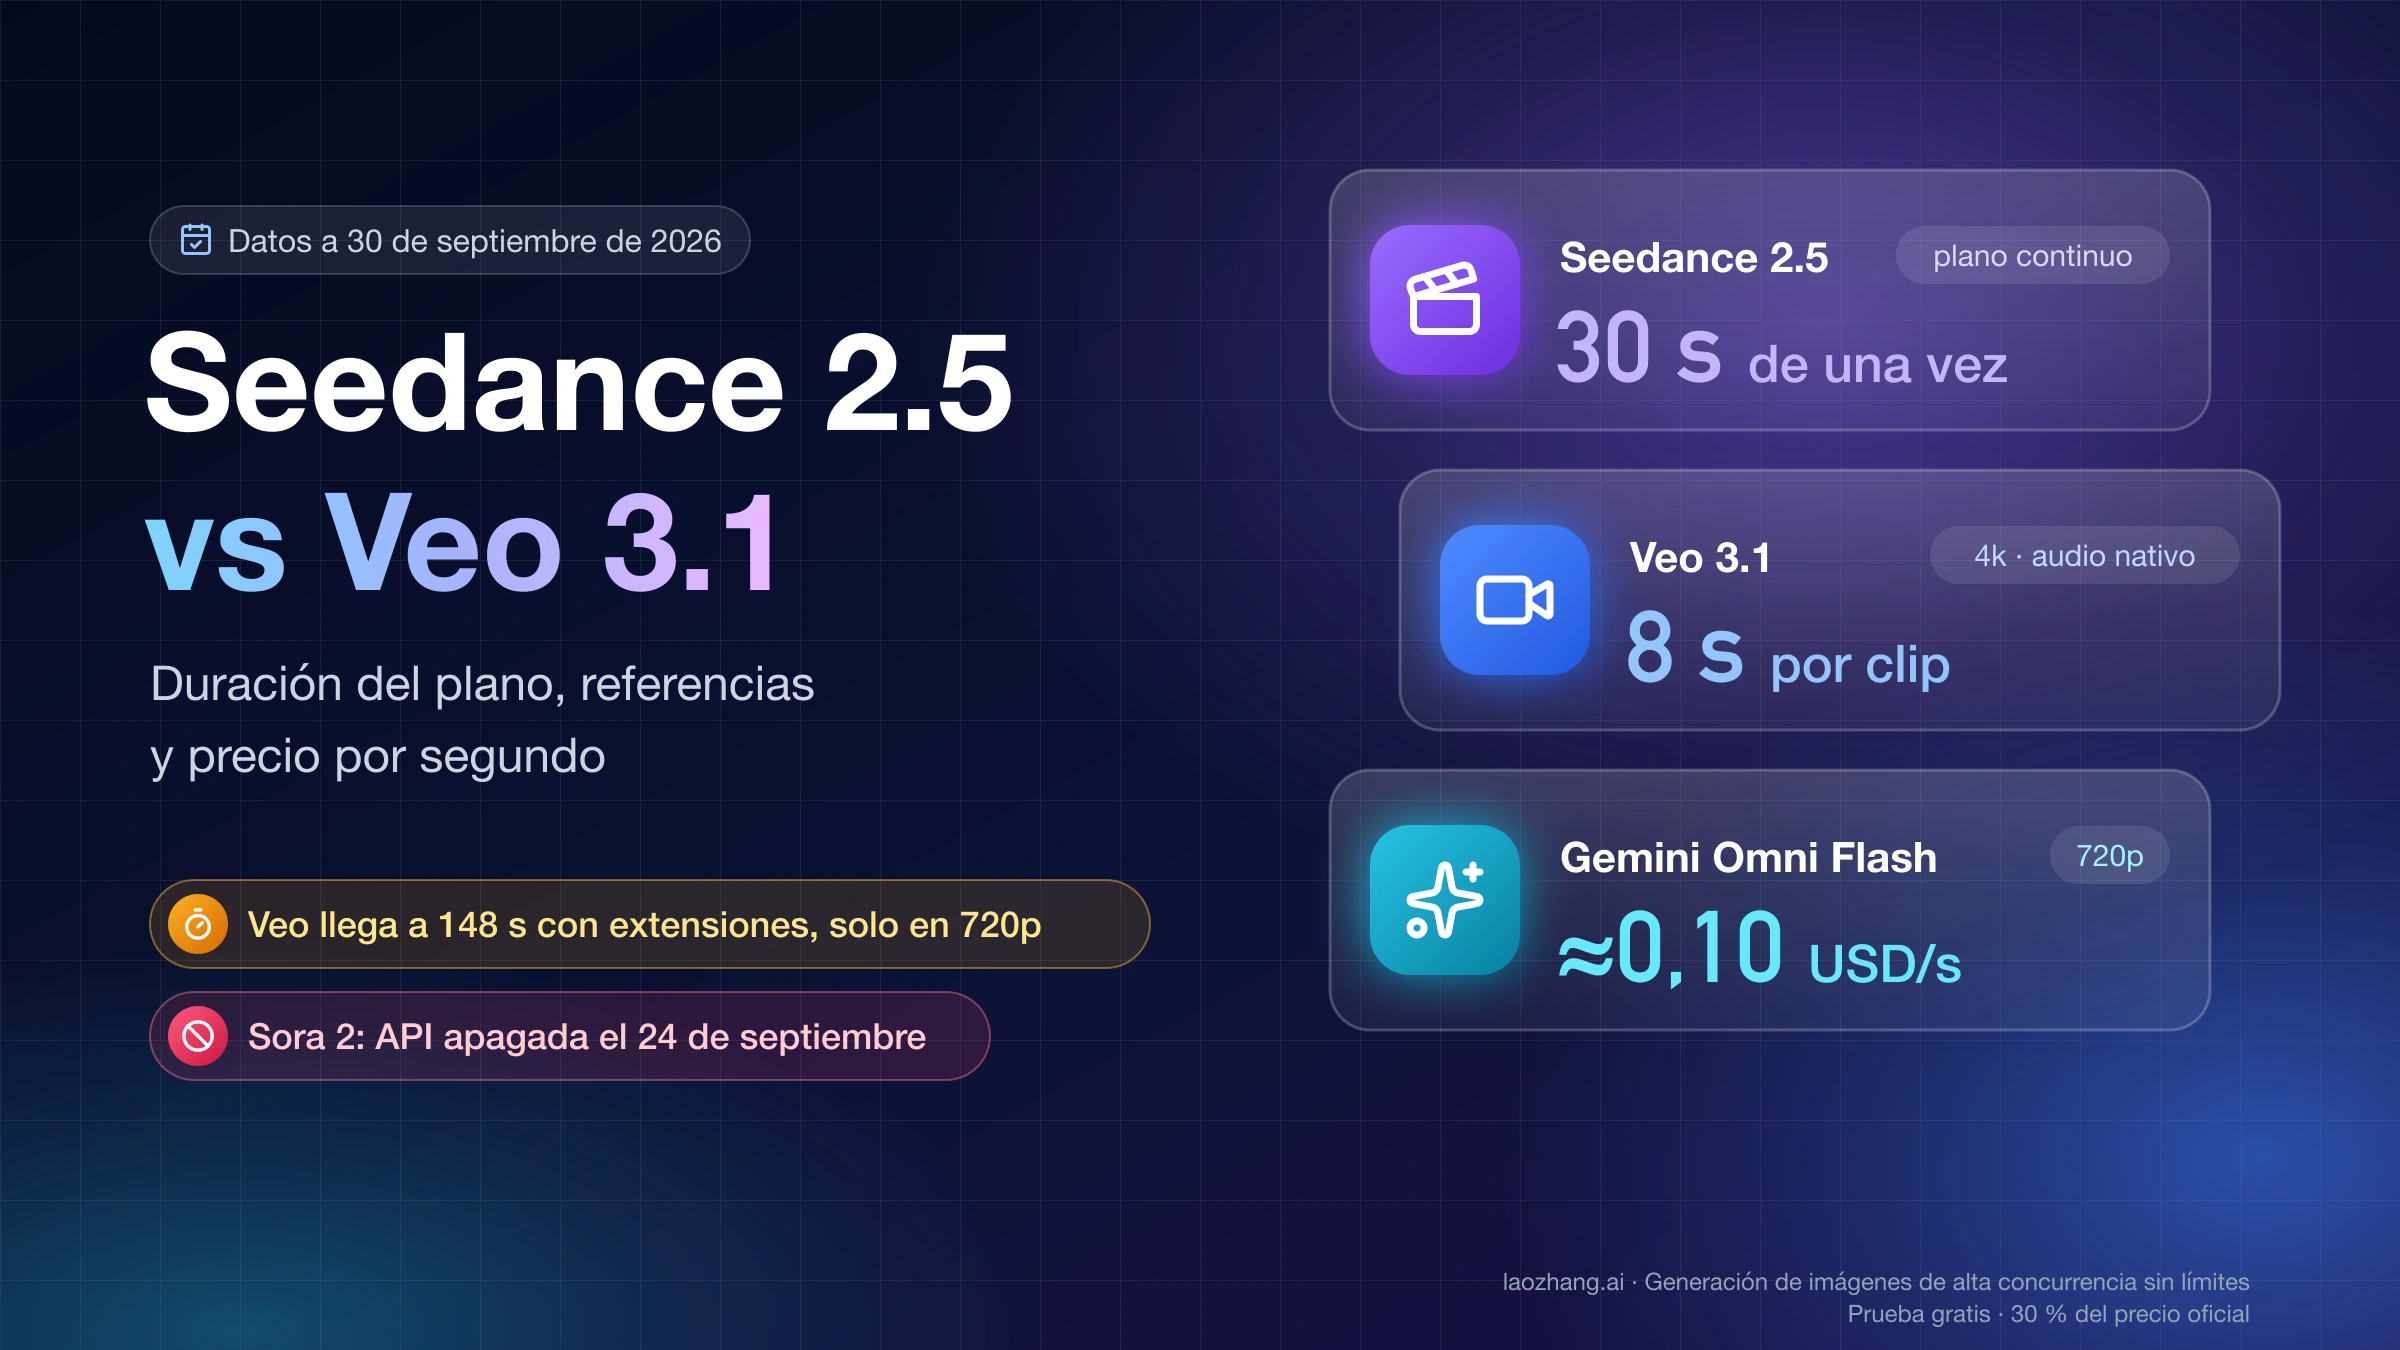
| Duración del intercambio | Cabe en un clip del modelo (8 s en Veo 3.1, hasta 15 s en Kling 3.0 o MiniMax H3) | Más largo que un clip; exige extender o cortar |
| Interacción | Se miran, gesticulan, se pasan algo sencillo | Abrazos, peleas, uno toca la cara del otro |
| Reescrituras previstas | Guion cerrado | Vas a cambiar frases sueltas tras ver el resultado |
| Lo que importa | La reacción del que escucha, el ritmo entre réplicas | Que cada cara y cada voz sean exactamente las mismas en toda la serie |
| Presupuesto por toma aprobada | Repetir un clip entero sale barato | Repetir el clip entero por una frase sale caro |
Entre los dos extremos hay dos híbridos que conviene conocer:
- Multiplano integrado: Kling 3.0, MiniMax H3, Seedance 2.5 o Gemini Omni Flash generan varios planos con cortes dentro de una sola petición. Te ahorras el montaje, pero sigues teniendo varios personajes en una misma generación.
- Interpretación por personaje y composición: el flujo de Runway con Act-Two. Los dos aparecen en el mismo cuadro, pero cada uno se anima en una pasada distinta y se superponen en un editor.
Por qué sale la boca equivocada: lo que documentan Seedance y los terceros
Antes de elegir modelo, ayuda saber qué se rompe y por qué. La sección de problemas de la guía de prompts de Seedance 2.5 en BytePlus lo resume así: en vídeos con varios sujetos, los personajes pueden emparejarse mal con sus imágenes de referencia, sus timbres de voz o su orden de aparición; por ejemplo, el primer personaje que aparece puede sustituirse por otro de los referenciados. La misma guía avisa de que escribir el nombre del personaje solo dentro de la imagen, sin vincularlo en el texto, «puede causar fácilmente confusión o duplicación de personajes».
Los demás proveedores no describen el fallo, pero sus documentos dejan ver el mismo punto débil:
- Gemini Omni Flash no admite referencias de audio ni edición de voz. No hay forma documentada de decirle qué voz pertenece a qué personaje.
- MultiTalk, el modelo de código abierto para conversaciones entre varias personas, menciona en su artículo los «problemas de vinculación incorrecta entre audio y personas» como uno de los retos que intenta resolver.
- Seedance TV, un blog de terceros que no pertenece a ByteDance, pone nombre a tres síntomas en su artículo sobre diálogos con Seedance 2.5 (28 de agosto de 2026): la «fuga de identidad» (un personaje toma el pelo o la ropa del otro tras un corte), la «fuga de rol» (habla la imagen de A mientras el prompt describe la acción de B) y «habla la persona equivocada». Según ese mismo artículo, dos personajes es la configuración más controlable.
- Elser AI, en su blog, recomienda directamente no generar la conversación completa en un solo clip.
La conclusión práctica es que el fallo no es mala suerte. Aparece cuando la petición deja ambiguo quién habla, quién escucha y qué referencia corresponde a quién. Cuantos más personajes y réplicas metes en una generación, más ambigüedad tiene que resolver el modelo.
Qué documenta cada modelo sobre diálogo con varios personajes
La matriz recoge solo lo que dicen las páginas oficiales. Un hueco significa que el proveedor no lo documenta, no que el modelo no pueda hacerlo.
| Modelo | Duración por generación | Cómo se escribe el diálogo | Varios planos en una petición | Vincular voz a personaje |
|---|---|---|---|---|
| Veo 3.1 (API de Gemini) | 4, 6 u 8 s; 8 s obligatorios con imágenes de referencia o 1080p | Entre comillas, con el hablante etiquetado | No documentado como función | No documentado |
| Gemini Omni 1.1 Flash | Extensión de 10 s en 10 s hasta 40 s | Descripción en el prompt | Sí, por defecto; para un plano continuo hay que pedirlo | No; sin referencias de audio |
| Seedance 2.5 (BytePlus) | 4–30 s | Llaves para el diálogo e idioma indicado antes de la frase | Sí, con «Shot N» y marcas de segundos enteros | Sí: imágenes y audios numerados y vinculados en el texto |
| Kling 3.0 | 3–15 s | Personaje etiquetado y su frase entre comillas | Sí: de 1 a 6 planos por API | El proveedor afirma que puedes señalar qué personaje habla |
| Kling 4.0 | 3–30 s | Sin guía específica publicada | No lo especifica | Audio de referencia «solo para voz»; no repite la afirmación de 3.0 |
| MiniMax H3 | 4–15 s | Diálogo en 11 idiomas | Sí, multiplano nativo | No documentado |
| Wan 2.7 | 2–15 s | En el prompt, por planos con tiempos | Sí, por prompt | No documentado; acepta un audio de 2–30 s |
| Runway Act-Two | Interpretación de hasta 30 s | La grabas tú: tu voz y tu cara mueven al personaje | No | Por diseño: una pasada por personaje |
| MultiTalk / InfiniteTalk | Hasta 15 s / 40 s por defecto | Un audio por persona | No | Sí: un audio para cada persona |
Algunos matices cambian la decisión:
- Veo 3.1 y las referencias de dos personajes: la documentación de Veo en la API de Gemini admite hasta tres imágenes de referencia, descritas como «imágenes de una sola persona, personaje o producto». No queda claro si puedes repartir esas tres imágenes entre dos personajes distintos. Si tu escena depende de eso, pruébalo con una generación corta antes de planificar toda la secuencia.
- Veo 3.1 y el sonido al extender: cada extensión añade 7 s, pero la voz no se extiende bien si no hay voz en el último segundo del clip. Si encadenas un diálogo extendiendo, termina cada tramo con alguien hablando o corta en el cambio de réplica y empieza un plano nuevo.
- Kling 3.0 frente a 4.0: la nota de lanzamiento de Kling 3.0 presenta el multiplano «desde el clásico plano/contraplano» y dice que en escenas con varios personajes puedes indicar con precisión quién habla. Es una afirmación del proveedor, sin pruebas independientes publicadas. La nota de Kling 4.0, disponible para todos desde el 15 de octubre de 2026, mejora la sincronización labial pero no repite esa afirmación ni da un número de planos, y la documentación de la API sigue describiendo la 3.0.
- Omni corta por su cuenta: según la guía de Gemini Omni Flash, el modelo intenta por defecto crear un vídeo con varios planos. Si quieres a los dos en un plano continuo, escríbelo («No scene cuts», «in a single continuous shot»). Tampoco puedes extender un vídeo subido en el que alguien habla para añadir más diálogo; solo las extensiones encadenadas de vídeos generados por el propio Omni admiten diálogo nuevo. Si trabajas desde España, el acceso tiene sus propias condiciones: lo explica Gemini Omni 1.1 Flash en España: acceso, API y límites del EEE.
- Caras reales: Seedance 2.5 no acepta subir rostros reales sin más; pide resultados previos de la misma cuenta, personajes digitales predefinidos o activos de personas verificadas. Omni no admite «ciertas personas reconocibles». Para una microserie con actores reales, eso limita qué modelos puedes usar.
- Sora ya no es una opción: la app cerró el 26 de abril de 2026 y los modelos Sora 2 y su API de vídeo se apagaron el 24 de septiembre de 2026.
Si tu duda es qué modelo probar primero por precio y duración, se trata en Seedance vs Veo: diferencias, precio por segundo y cuál elegir y en Wan 3.0 vs MiniMax H3 vs Seedance 2.5: cuál probar primero.
Diálogo en el mismo plano: cómo escribir el prompt con los dos en cuadro
El plano único funciona mejor cuando eliminas toda ambigüedad sobre quién habla. Tres reglas que se desprenden de la documentación:
- Vincula cada referencia en el texto, en orden de aparición. Seedance pide numerar las imágenes y audios según el orden de subida y asignarlos uno a uno: «Las imágenes 1-2 son el Personaje 1 y corresponden al Audio 1; las imágenes 3-4 son el Personaje 2 y corresponden al Audio 2». Para el cruce de personajes, su solución es subir las referencias en el orden en que cada sujeto aparece por primera vez y renumerar el prompt en consecuencia.
- Nombra al que habla y al que escucha. Las dos sintaxis de Google lo hacen: la de la API de Gemini pone cada frase entre comillas detrás de su hablante, y la guía de Vertex AI usa «el detective dice: … el informante responde: …». Añade dónde está el que escucha y qué hace mientras tanto.
- Fija posiciones y no las cambies. Si Marta está a la izquierda en la primera réplica, sigue a la izquierda en la segunda.
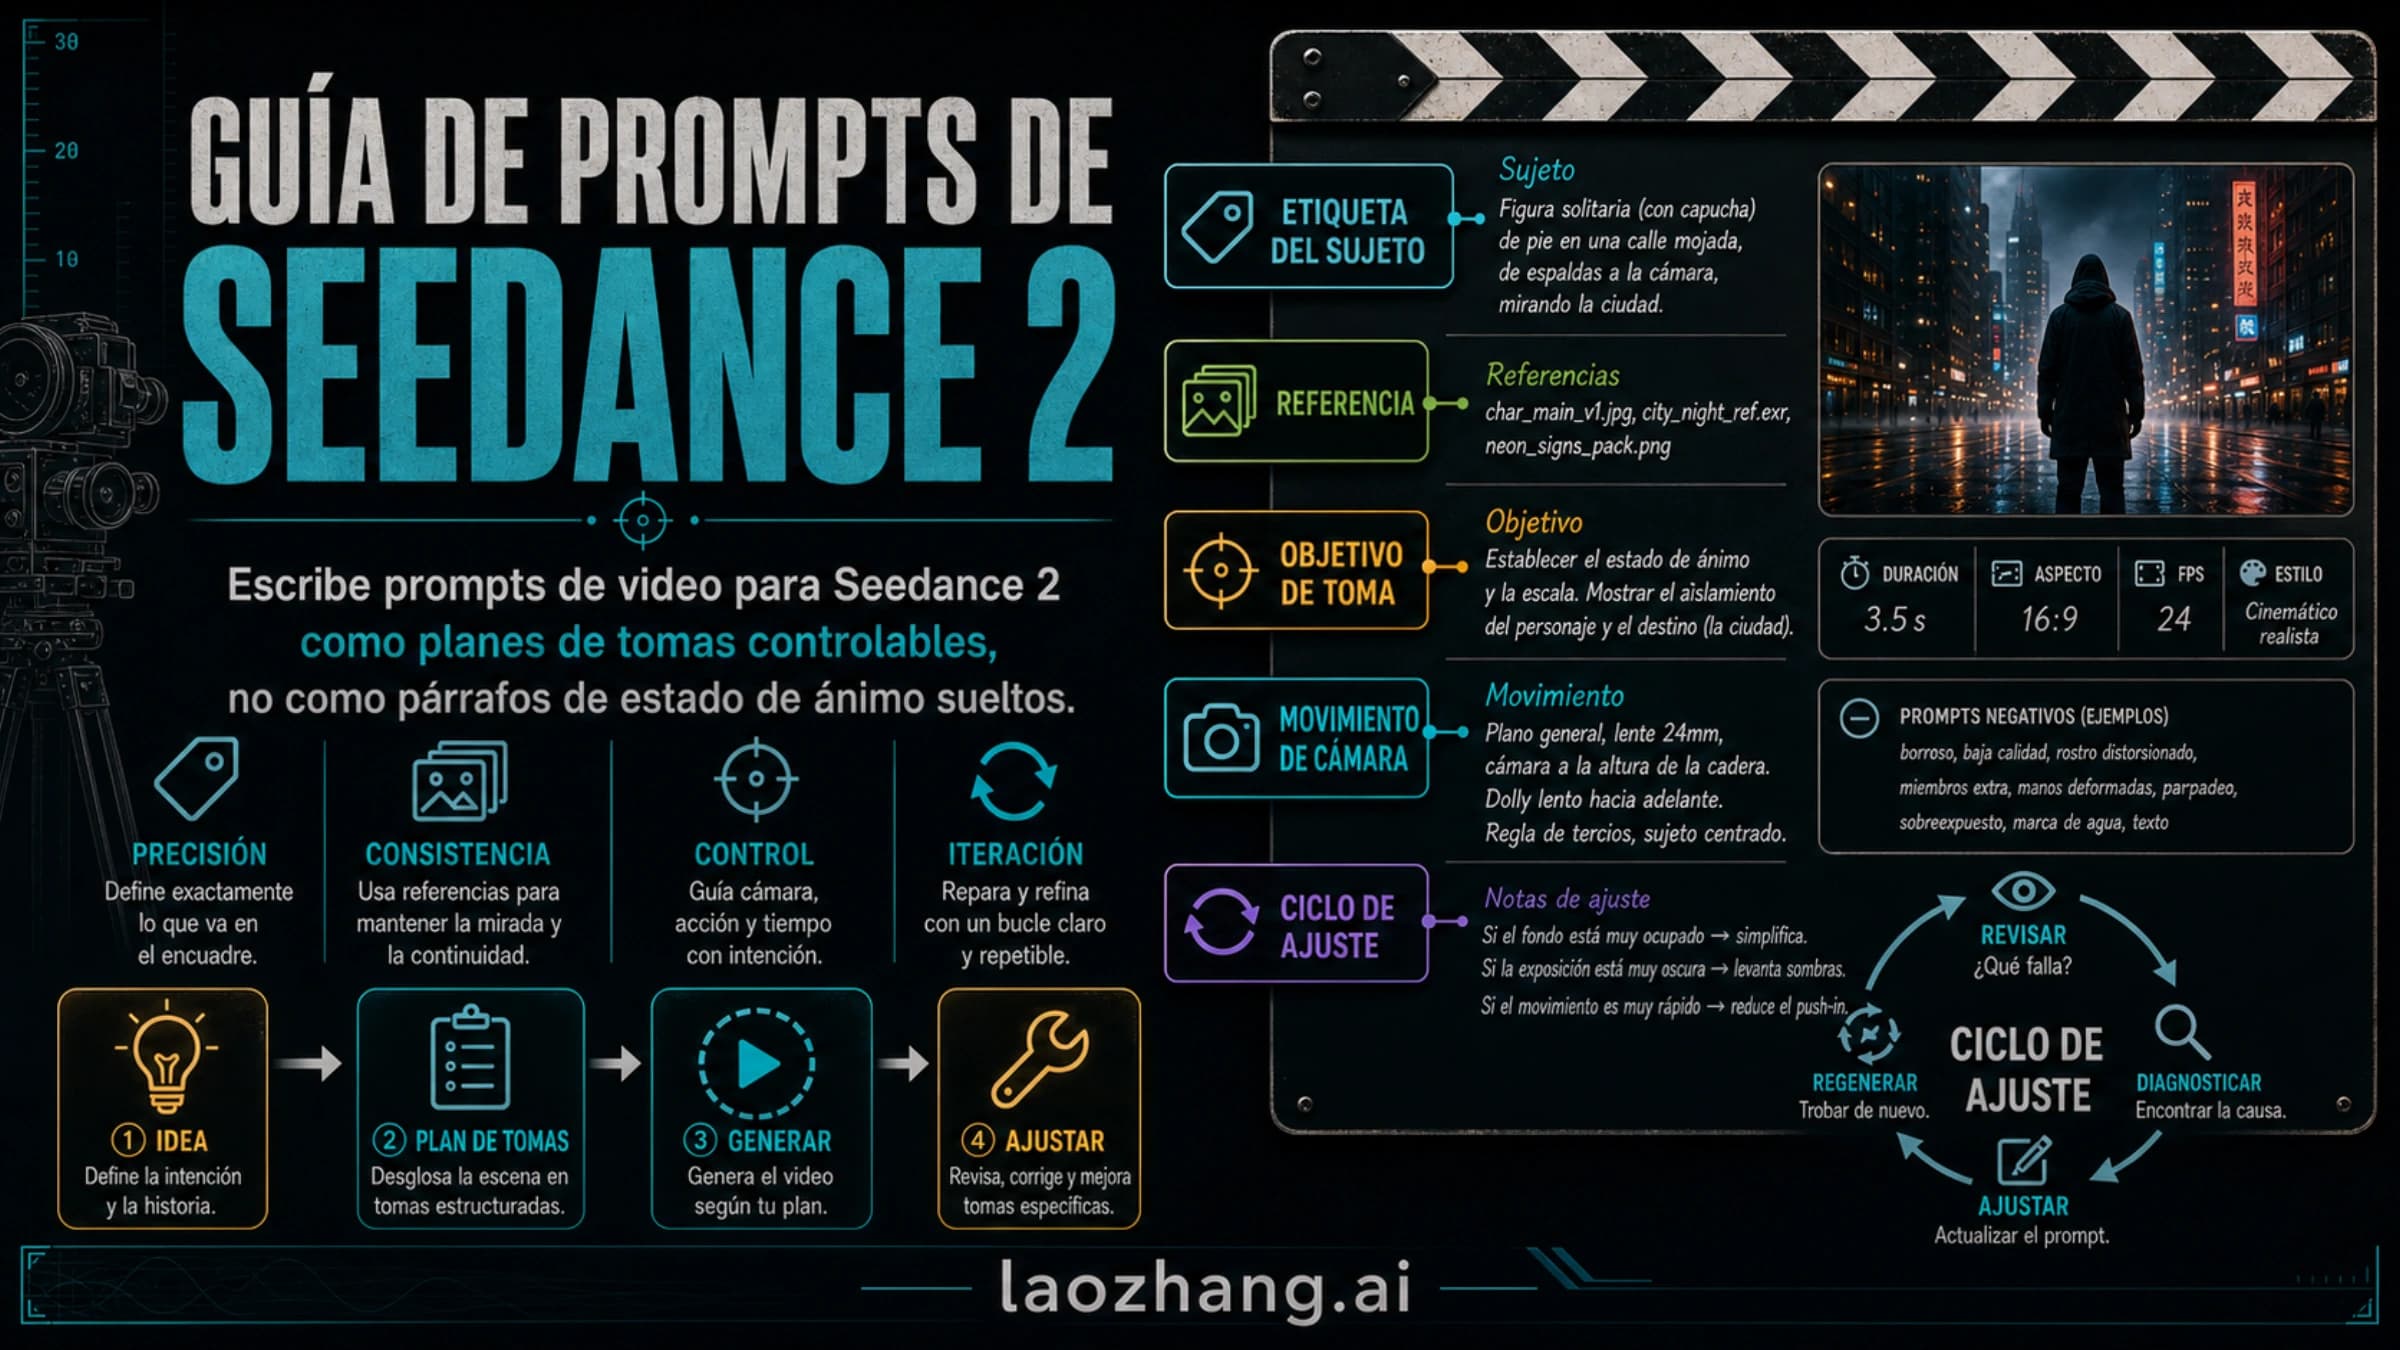
Plantilla para Seedance 2.5 con la sintaxis documentada (llaves para el diálogo, idioma antes de la frase, marcas de segundos). Es una plantilla no probada: adáptala a tus referencias.
Imagen 1 es el Personaje 1 (Marta) y corresponde al Audio 1.
Imagen 2 es el Personaje 2 (Leo) y corresponde al Audio 2.

Plano medio fijo. Marta y Leo sentados a la mesa de una cocina de noche,
Marta a la izquierda del cuadro y Leo a la derecha. Luz cálida de lámpara.

0-4 s: Marta habla mirando a Leo; Leo escucha a la derecha, inmóvil.
Diálogo en español: {Marta: ¿Has vuelto a abrir la carta?}
4-8 s: Leo responde sin levantar la vista; Marta escucha a la izquierda.
Diálogo en español: {Leo: No. Ábrela tú.}

Sin subtítulos. Sin música.
Dos detalles de la guía de Seedance que afectan a esta plantilla: no repitas las palabras del diálogo después de la frase ni añadas indicaciones de tono pegadas a palabras concretas, porque eso puede generar subtítulos; y si combinas muchas referencias y ediciones en una sola tarea, el resultado puede ser inestable, así que la propia guía recomienda dividir las tareas complejas en varias simples. Para el resto de la sintaxis (sonido, referencias, correcciones de un tramo), consulta Prompts de Seedance 2 y 2.5: planos, referencias y correcciones.
Plano a plano: plano/contraplano y sobre el hombro sin perder la continuidad
Dividir el diálogo significa que cada generación tiene un solo hablante. El que escucha aparece de espaldas, desenfocado o fuera de cuadro, y la conversación se construye en el montaje. Es lo que recomiendan los terceros que han documentado el problema, desde Elser AI hasta un usuario del foro de la comunidad de OpenAI que proponía generar cada personaje por separado y unirlos a mano.
Lo que tienes que mantener entre planos:
- Las mismas referencias en todas las generaciones. Usa los mismos archivos, en el mismo orden y con la misma descripción de cada personaje. Cambiar una palabra del vestuario entre planos es la forma más rápida de que derive una cara.
- El eje de la conversación. Si en el plano general Marta mira a la derecha, en su primer plano también mira a la derecha y Leo mira a la izquierda. Si saltas el eje, el montaje parece que los dos miran al mismo lado.
- La luz y el decorado. Repite la misma frase de ambiente en cada prompt. Seedance recomienda listar al final los elementos que deben mantenerse constantes en toda la secuencia.
- Un hablante por plano, con su réplica completa. No cortes una frase entre dos planos generados por separado: la voz y el gesto no casarán.
Plantilla de tres planos (formato de la API de Gemini para Veo: frase entre comillas detrás del hablante). Plantilla no probada; cada bloque es una generación distinta.
Plano 1 (plano medio, 8 s): Marta y Leo sentados a la mesa de una cocina de noche,
Marta a la izquierda y Leo a la derecha. Luz cálida de lámpara. Silencio, solo el
zumbido de la nevera.

Plano 2 (sobre el hombro de Leo, 6 s): Marta, a la izquierda del cuadro, mira hacia
la derecha y dice: "¿Has vuelto a abrir la carta?" Leo, de espaldas y desenfocado,
no habla.

Plano 3 (sobre el hombro de Marta, 6 s): Leo, a la derecha del cuadro, mira hacia
la izquierda sin levantar la vista y dice: "No. Ábrela tú." Marta, de espaldas y
desenfocada, no habla.
Ten en cuenta que en Veo 3.1 las imágenes de referencia obligan a generar 8 s, así que si las usas para fijar las caras, los planos 2 y 3 también saldrán de 8 s y tendrás que recortarlos al montar.
Si generas muchos planos por API con Seedance y necesitas que un personaje virtual sea idéntico en todos, laozhang.ai ofrece la API de Seedance 2.0 y 2.5 junto con un flujo de activos de personaje virtual y persona real para Seedance: el personaje virtual se crea a partir de una imagen HTTPS pública y se reutiliza como imagen de referencia en cada petición.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Los híbridos: el flujo de Runway Act-Two y el multiplano en una sola petición
Runway: los dos en cuadro, cada uno interpretado por separado
Act-Two solo acepta un personaje por entrada, y Runway documenta un flujo para sortearlo en su artículo de ayuda sobre diálogos con varios personajes en Act-Two:
- Graba una interpretación por personaje (tu voz y tu cara), de 30 s como máximo en total.
- Crea una imagen con los dos personajes, por ejemplo con referencias en Gen-4 Image.
- Genera un vídeo base de 10 s a partir de esa imagen; si el diálogo dura más, extiéndelo desde el último fotograma.
- Recorta el vídeo para que solo se vea un personaje y aplica su interpretación con Act-Two. Repite con el otro.
- Superpón las dos salidas sobre el vídeo base en un editor.
El resultado se ve como un plano único, pero cada boca la controla una interpretación grabada, así que el cruce de voces desaparece por diseño. A cambio necesitas grabar y saber componer capas. Act-Two cuesta 5 créditos por segundo. Si buscabas la antigua herramienta Lip Sync de Runway, quedó retirada el 27 de mayo de 2026 y Act-Two es su sustituta.
Multiplano integrado: varios planos sin montar
Kling 3.0 (de 1 a 6 planos por API, cada uno de al menos 1 s y hasta 512 caracteres de prompt), MiniMax H3, Wan 2.7, Seedance 2.5 con «Shot N» y Omni Flash por defecto generan cortes dentro de una misma petición. La app Multi-Shot Video de Runway, que funciona sobre Kling Pro 3.0, llega a 5 planos conectados en 10 s, aunque sin audio por defecto.
Te da el lenguaje del plano/contraplano sin montar, pero no resuelve el problema de fondo: los dos personajes siguen dentro de una misma generación. Si un plano sale mal, repites la petición entera. Sirve para guiones cortos y cerrados; para frases que vas a reescribir, el plano a plano real sigue siendo más barato de corregir.
Cuánto cuesta cada método: la cuenta por toma aprobada
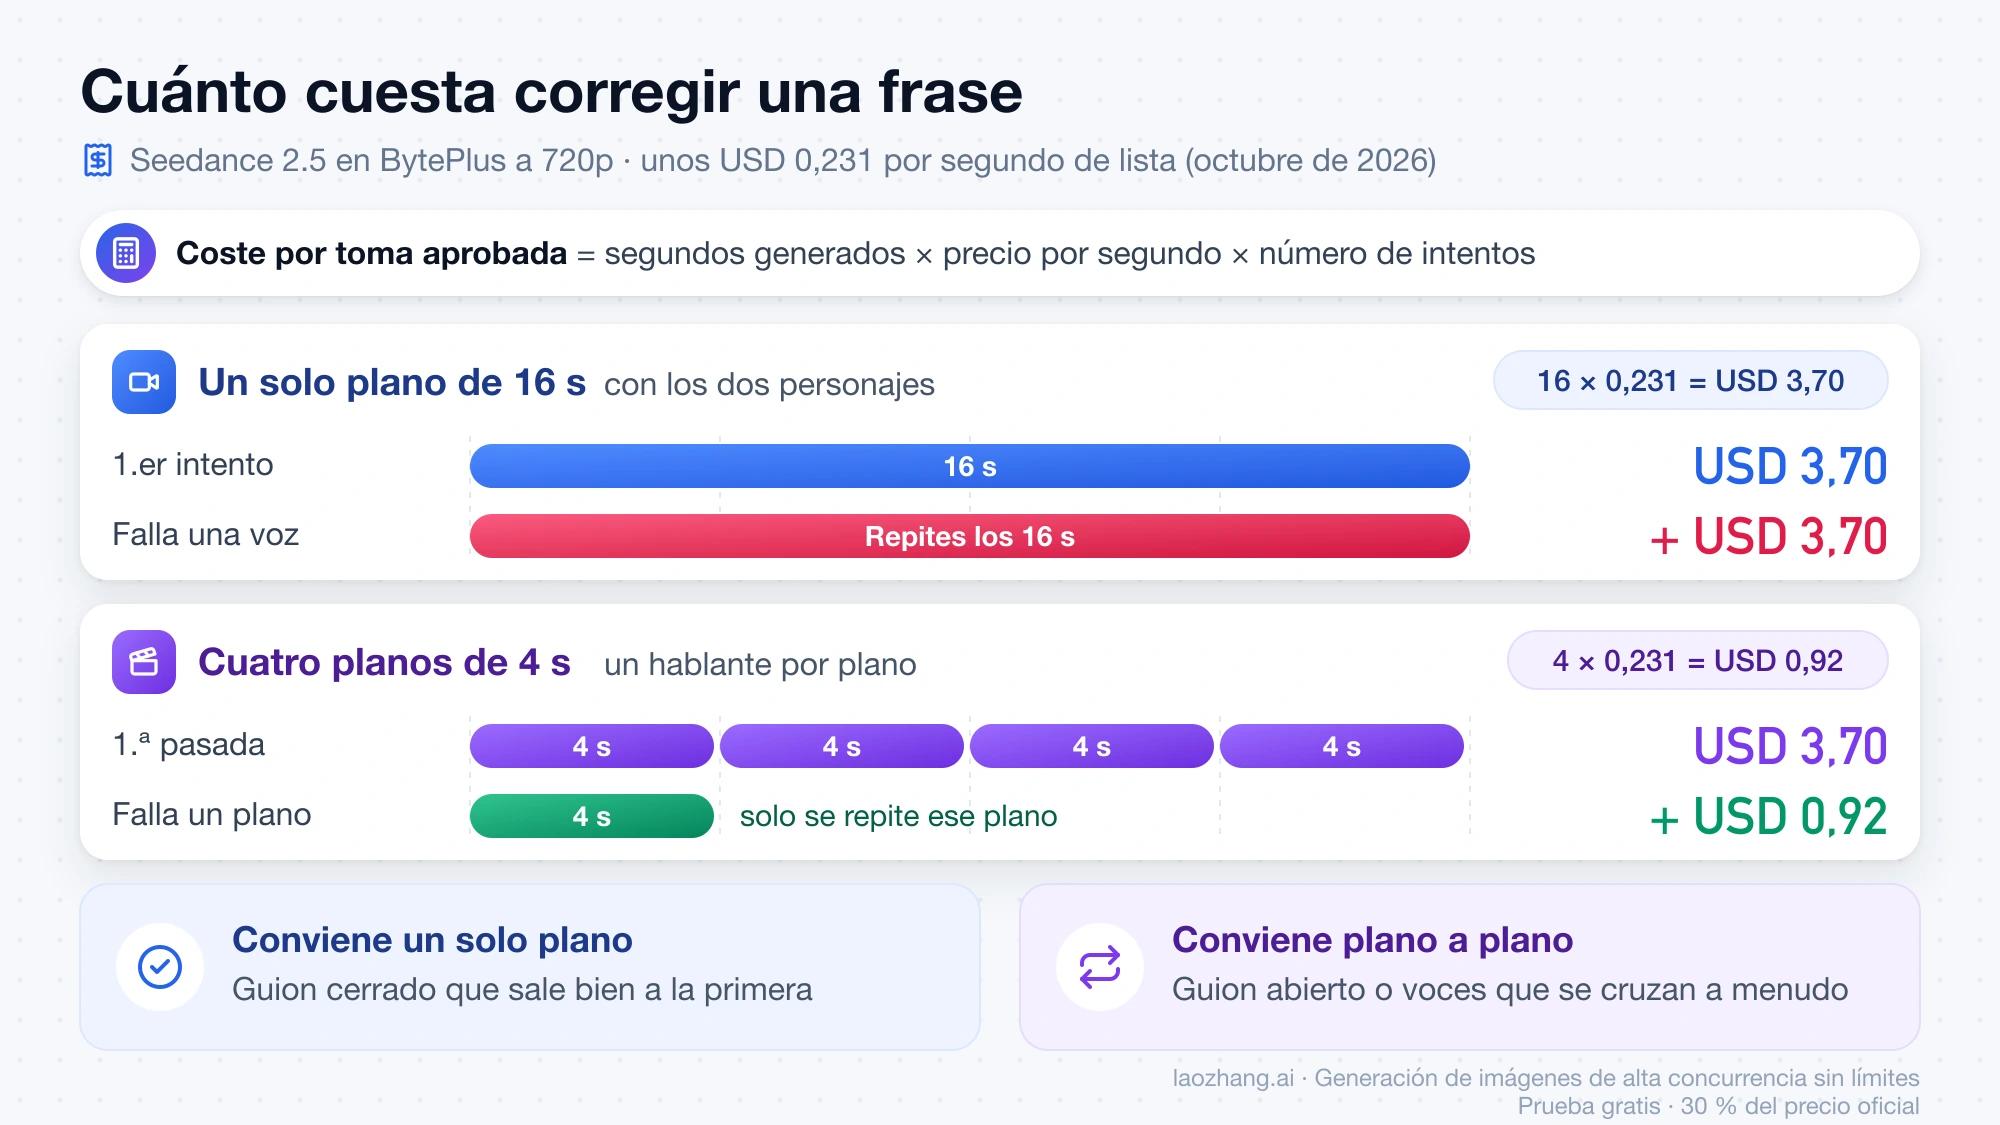
El precio por segundo es el mismo en los dos métodos. Lo que cambia es cuántos segundos vuelves a generar cuando algo falla. La fórmula:
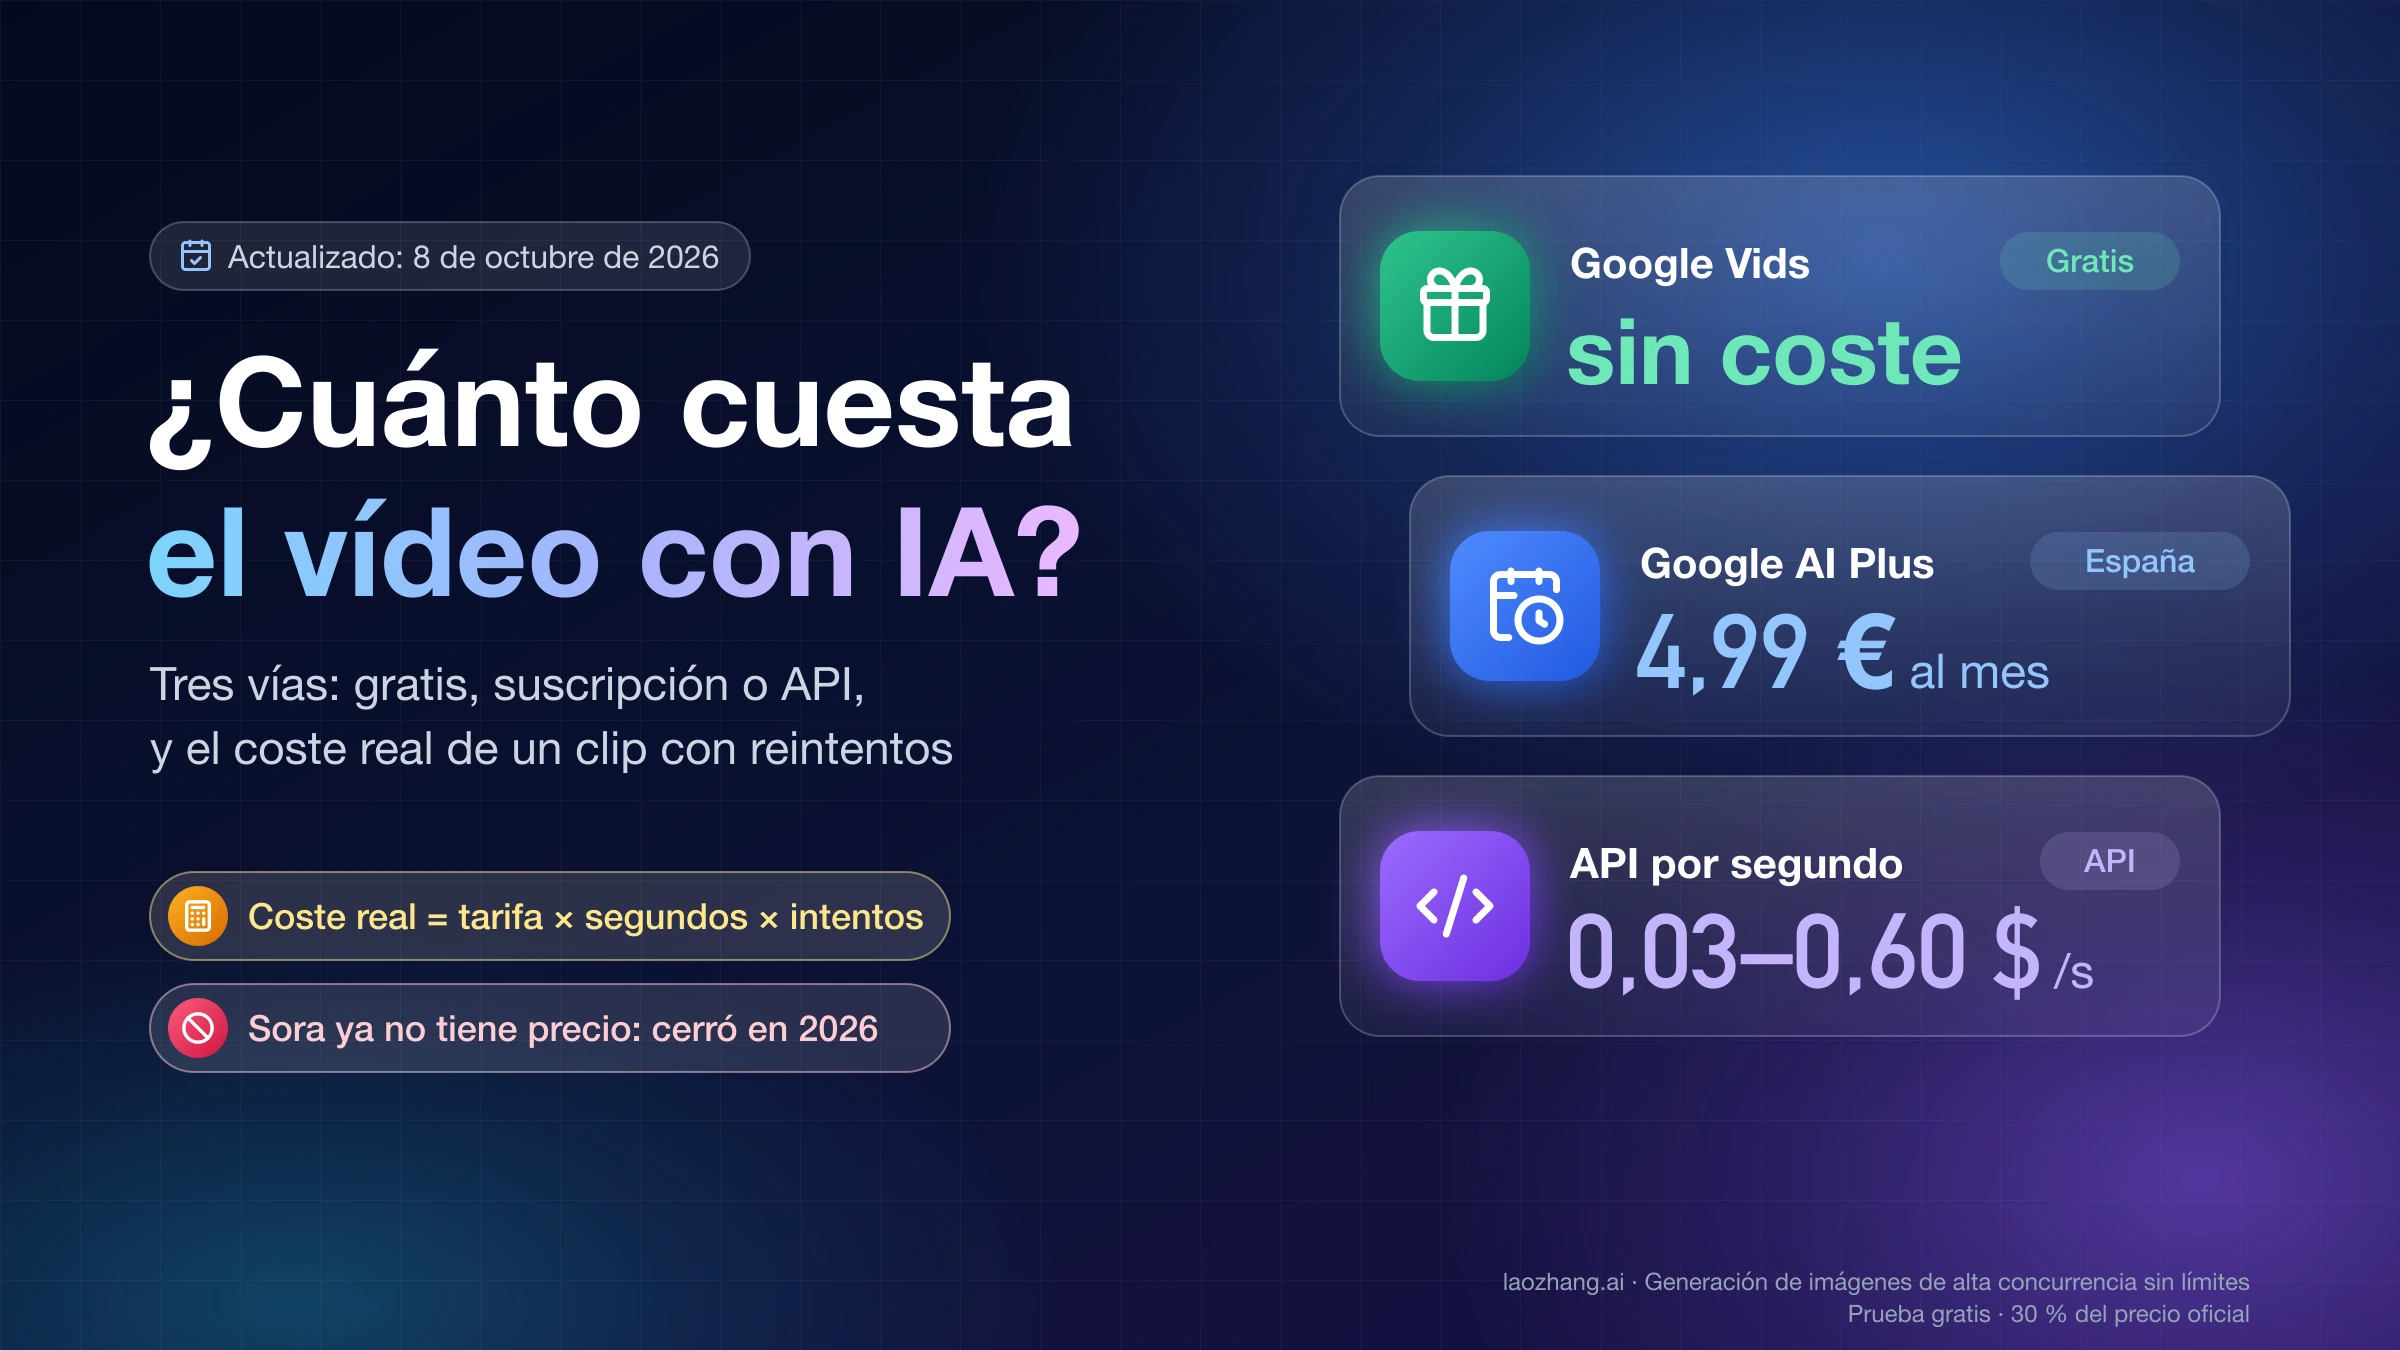
coste por toma aprobada = segundos generados × precio por segundo × número de intentos
Ejemplo con Seedance 2.5 en BytePlus a 720p, con un precio de lista de unos USD 0,231 por segundo en octubre de 2026 (los precios cambian a menudo):
- Un solo plano de 16 s con los dos personajes: 16 × 0,231 = USD 3,70 por intento. Si Leo dice bien su frase pero Marta sale con la voz cambiada, repites los 16 s: otros USD 3,70.
- Cuatro planos de 4 s: también 16 s, USD 3,70 en la primera pasada. Si falla un plano, repites solo ese: 4 × 0,231 = USD 0,92.
Con la misma lógica, en Veo 3.1 Standard (USD 0,40 por segundo de lista) un clip de 8 s cuesta USD 3,20 por intento, y cada plano adicional que necesites para cubrir reacciones suma otros 8 s si usas imágenes de referencia.
Plano a plano no sale más barato en la primera pasada; suele salir más caro, porque añades planos de reacción y recursos para el montaje. Gana cuando prevés repetir: con un guion abierto o un modelo que cruza voces a menudo en tu escena, pagar 4 s por corrección en lugar de 16 s compensa rápido. Con un guion cerrado de dos réplicas que sale bien a la primera, el plano único es más barato y más rápido.
Diagnóstico: síntoma, causa probable y qué cambiar
| Síntoma | Causa probable | Qué hacer |
|---|---|---|
| Se mueve la boca del que debería escuchar | El prompt nombra la frase pero no al que escucha | Escribe quién habla y qué hace el otro («Leo escucha a la derecha, inmóvil»); si persiste, pasa a plano a plano |
| Las voces están cambiadas | Audios sin vincular a cada personaje, o en un orden distinto al de aparición | En Seedance, sube las referencias en orden de aparición y vincula «Imagen N … Audio N» en el texto; en modelos sin vinculación (Omni), separa los planos |
| El primer personaje que aparece tiene la cara del otro | Cruce de referencias descrito por Seedance | Reordena las referencias según el orden de aparición y renumera el prompt |
| Un personaje toma el pelo o la ropa del otro tras un corte | Personajes descritos de forma parecida o cambios de descripción entre planos | Diferencia los personajes con rasgos claros y repite la misma descripción en todos los planos |
| Aparecen cortes que no pediste | Omni Flash divide en varios planos por defecto | Añade «No scene cuts» o «in a single continuous shot» |
| La voz se corta al extender en Veo 3.1 | No había voz en el último segundo del clip anterior | Termina el tramo con alguien hablando o corta en el cambio de réplica |
| Salen subtítulos que no querías en Seedance | Palabras del diálogo repetidas o indicaciones pegadas a palabras concretas | Escribe la frase una sola vez y añade «Sin subtítulos» |
| El resultado es inestable con muchas referencias | Demasiadas referencias y ediciones en una sola tarea | Divide la tarea en varias más simples, como recomienda la guía de Seedance |
| Con tres o más personajes, todo se mezcla | Demasiada ambigüedad en una sola generación | Genera parejas o planos de reacción por separado y monta |
Preguntas frecuentes sobre vídeos de varios personajes hablando con IA
¿Cómo hacer vídeos de personajes hablando con IA?
Para un solo personaje basta con un modelo de vídeo con audio nativo (Veo 3.1, Kling, Seedance 2.5, MiniMax H3) y la frase en el prompt. Para dos o más, decide primero si van en el mismo plano o en planos separados con la tabla del principio, vincula cada voz a su personaje si el modelo lo permite y deja claro en el texto quién habla y quién escucha.
¿Qué IA puedo usar para hacer vídeos con varios personajes que hablen?
De los modelos con documentación pública, Seedance 2.5 es el que explica cómo vincular imágenes y audios a cada personaje, y Kling 3.0 afirma que puedes señalar quién habla. Runway Act-Two resuelve el problema con una interpretación grabada por personaje. Veo 3.1 y MiniMax H3 generan diálogo con audio, pero no documentan la vinculación de voces. Si tu prioridad es el precio o la duración, empieza por Seedance vs Veo: diferencias, precio por segundo y cuál elegir.
¿Hay alguna opción gratis para generar diálogos entre dos personajes?
Los modelos de código abierto MultiTalk e InfiniteTalk generan conversaciones entre varias personas y asignan un audio a cada una, sin pagar por segundo. A cambio necesitas tu propia GPU y saber instalarlos: revisa los requisitos de cada repositorio antes de empezar. MultiTalk llega a 15 s por vídeo e InfiniteTalk a 40 s con su configuración por defecto.
¿Cuántos personajes pueden hablar en un mismo clip?
Ningún proveedor fija un límite oficial de hablantes por clip. Kling 3.0 anuncia correferencia de tres o más personajes, y el blog de terceros Seedance TV considera que dos es la configuración más controlable. En la práctica, cada personaje que añades aumenta la ambigüedad sobre quién habla; con tres o más, lo razonable es partir la escena en planos.
¿Puedo usar mi cara o la de un actor real?
Depende del modelo. Seedance 2.5 no admite subir rostros reales directamente: pide personajes digitales predefinidos, resultados previos de tu cuenta o activos de personas verificadas. Gemini Omni Flash no admite ciertas personas reconocibles. Runway Act-Two parte de tu propia interpretación grabada para animar a un personaje.
Fuentes5
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 19 oct 2026.
Fuentes5
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 19 oct 2026.
- 1.guía de prompts de Seedance 2.5 en BytePlusdocs.byteplus.com/en/docs/modelark/seedance-2-5-prompt-guide
- 2.documentación de Veo en la API de Geminiai.google.dev/gemini-api/docs/veo
- 3.nota de lanzamiento de Kling 3.0kling.ai/release-note/release-notes/whbvu8hsip
- 4.guía de Gemini Omni Flashai.google.dev/gemini-api/docs/omni
- 5.artículo de ayuda sobre diálogos con varios personajes en Act-Twohelp.runwayml.com/hc/en-us/articles/41748090660499