Gemini 3.5 Flash vs Gemini 3.1 Flash-Lite: qué usar y cómo migrar
Empieza con Gemini 3.1 Flash-Lite para trabajo ligero y masivo. Si mantienes gemini-3.5-flash, Google ya dirige esas llamadas a 3.6: compara la ruta actual antes de migrar.
En esta página
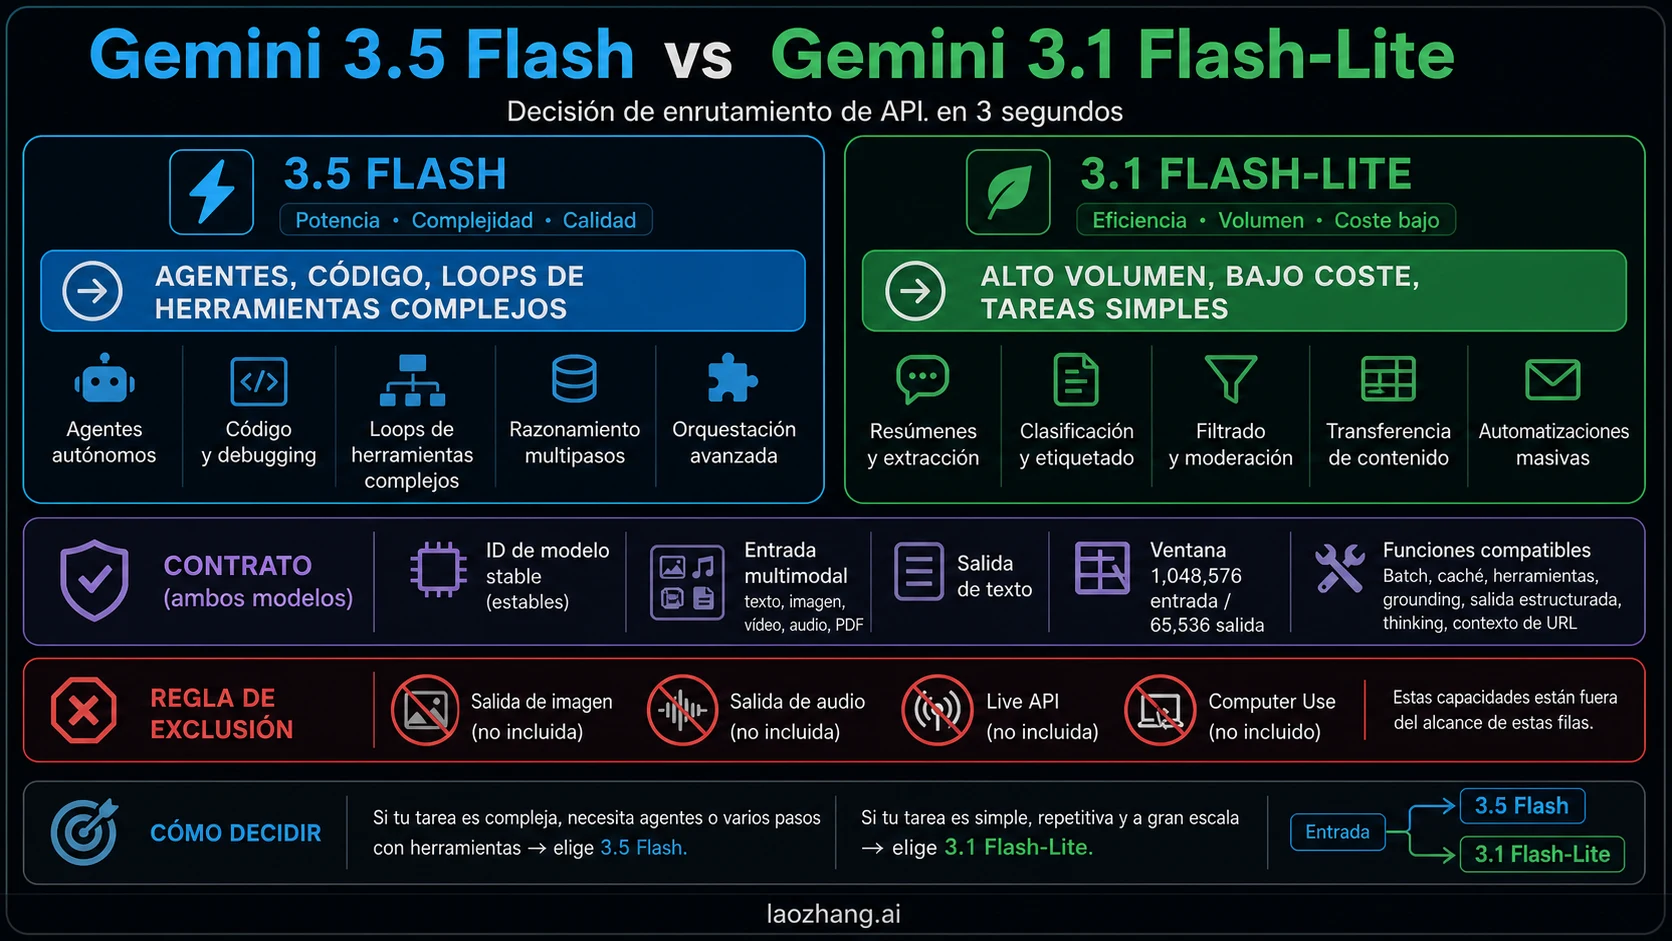
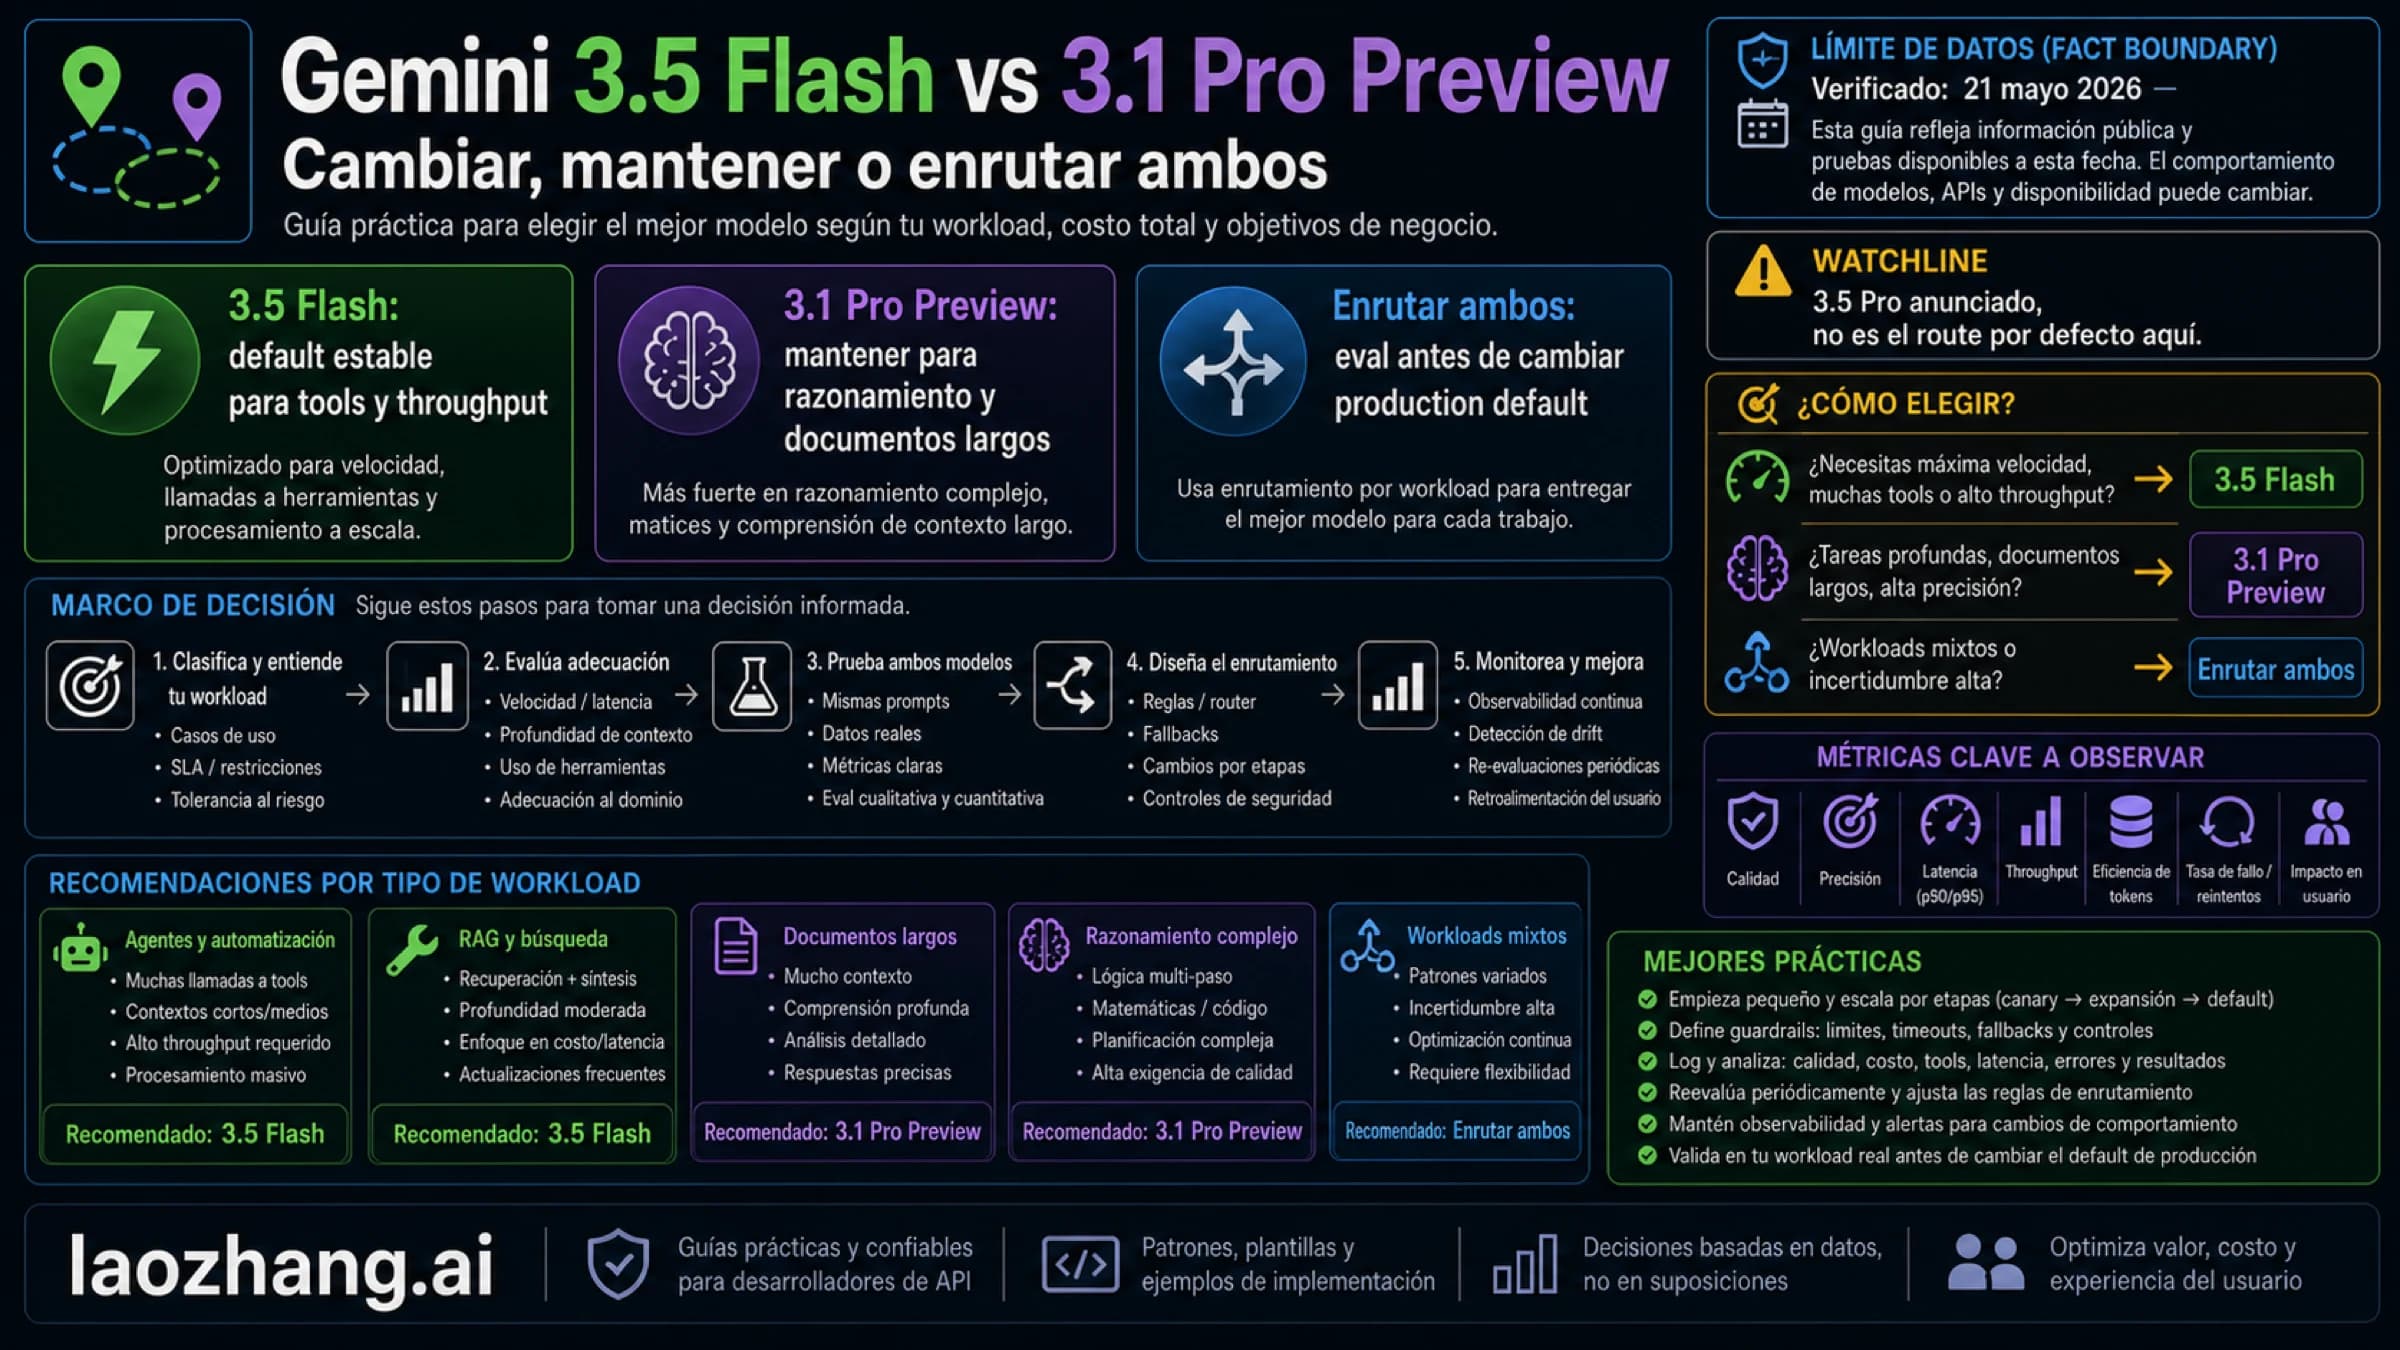
Para traducciones breves, clasificación y extracción sencilla a gran escala, Gemini 3.1 Flash-Lite es un buen punto de partida. Para agentes de código o cadenas complejas de herramientas, evalúa un Flash actual. Hay un cambio esencial respecto a la comparación original: a 13 de octubre de 2026, Google ha declarado obsoleto gemini-3.5-flash y dirige automáticamente sus llamadas a gemini-3.6-flash. Su endpoint no se está cerrando; lo que ha cambiado es el modelo que atiende la solicitud. Así lo indican la ficha de 3.5 Flash y el calendario de retirada.
La elección práctica sigue siendo la misma: pagar menos por tareas bien delimitadas o probar una ruta más capaz cuando los errores salen caros. Pero ya no puedes comparar el antiguo 3.5 con Lite como si ambos siguieran siendo dos modelos independientes sin cambios. Esta guía usa la documentación de Gemini Developer API; las aplicaciones de Gemini, la plataforma de Google Cloud y los intermediarios tienen condiciones propias.
Qué modelo estás eligiendo realmente
Si conservas una configuración de mayo, revisa el identificador antes de atribuirle cualquier resultado. gemini-3.5-flash, gemini-3.5-flash-lite y gemini-3.1-flash-lite son nombres distintos.
| Identificador | Situación actual en Developer API | Decisión útil |
|---|---|---|
gemini-3.5-flash | Obsoleto; sus llamadas se dirigen a 3.6 Flash y ya no se puede seleccionar en AI Studio | Haz explícito el destino actual con gemini-3.6-flash y comprueba tu integración |
gemini-3.1-flash-lite | Estable | Conserva esta ruta si resuelve bien tu trabajo ligero |
gemini-3.1-flash-lite-preview | Retirado el 25 de mayo de 2026 | Sustituye el identificador Preview por el estable |
gemini-3.5-flash-lite | Modelo Lite estable diferente | Es el reemplazo que Google recomienda para 3.1 Flash-Lite; evalúalo como una migración propia |
Fuente: calendario oficial de retirada de modelos, consultado el 13 de octubre de 2026. Para 3.1 Flash-Lite, Google señala el 7 de mayo de 2027 como la fecha más temprana posible de retirada; no es una garantía de servicio hasta ese día ni una fecha exacta de cierre anunciada.
Si tu aplicación ya llama al alias 3.5, cambiarlo por el ID directo de 3.6 aclara la configuración, pero no recupera el antiguo modelo. Tampoco una prueba del alias frente a 3.6 constituye una comparación entre generaciones independientes. Registra tanto el ID solicitado como modelVersion, el campo que la referencia de generateContent define como la versión utilizada para generar la respuesta.
Cuándo empezar con Lite y cuándo evaluar Flash
Empieza con 3.1 Flash-Lite cuando puedas definir y comprobar fácilmente qué es un resultado correcto: conservar importes en una traducción, asignar una categoría válida o extraer campos presentes en un documento. Google lo orienta a traducción de alto volumen, transcripción, extracción sencilla, procesamiento de documentos y tareas ligeras de agentes. Esa orientación oficial justifica incluirlo en la primera prueba; no demuestra que gane en todos los idiomas o documentos.
Evalúa 3.6 Flash cuando el trabajo combine interpretación, código, llamadas a herramientas e iteraciones en las que un fallo obligue a rehacer varios pasos. Es el destino actual del alias 3.5 y Google lo presenta para ejecución de agentes y ciclos de programación. 3.8 Flash también es estable y se orienta a trabajos de ingeniería de software y agentes de mayor duración. Son candidatos según las fichas de 3.6 y 3.8, no un ranking medido aquí.
Un catálogo de comercio electrónico ilustra la diferencia. Traducir descripciones con un glosario y verificar que las tallas no cambian es un trabajo acotado: empieza con Lite. Interpretar una reclamación ambigua, consultar un pedido y proponer una resolución exige comprobar una cadena más compleja: compara Lite con Flash usando el mismo caso y las mismas herramientas. Tener herramientas disponibles no determina por sí solo quién responde mejor.
Ambos aceptan documentos y audio, pero devuelven texto
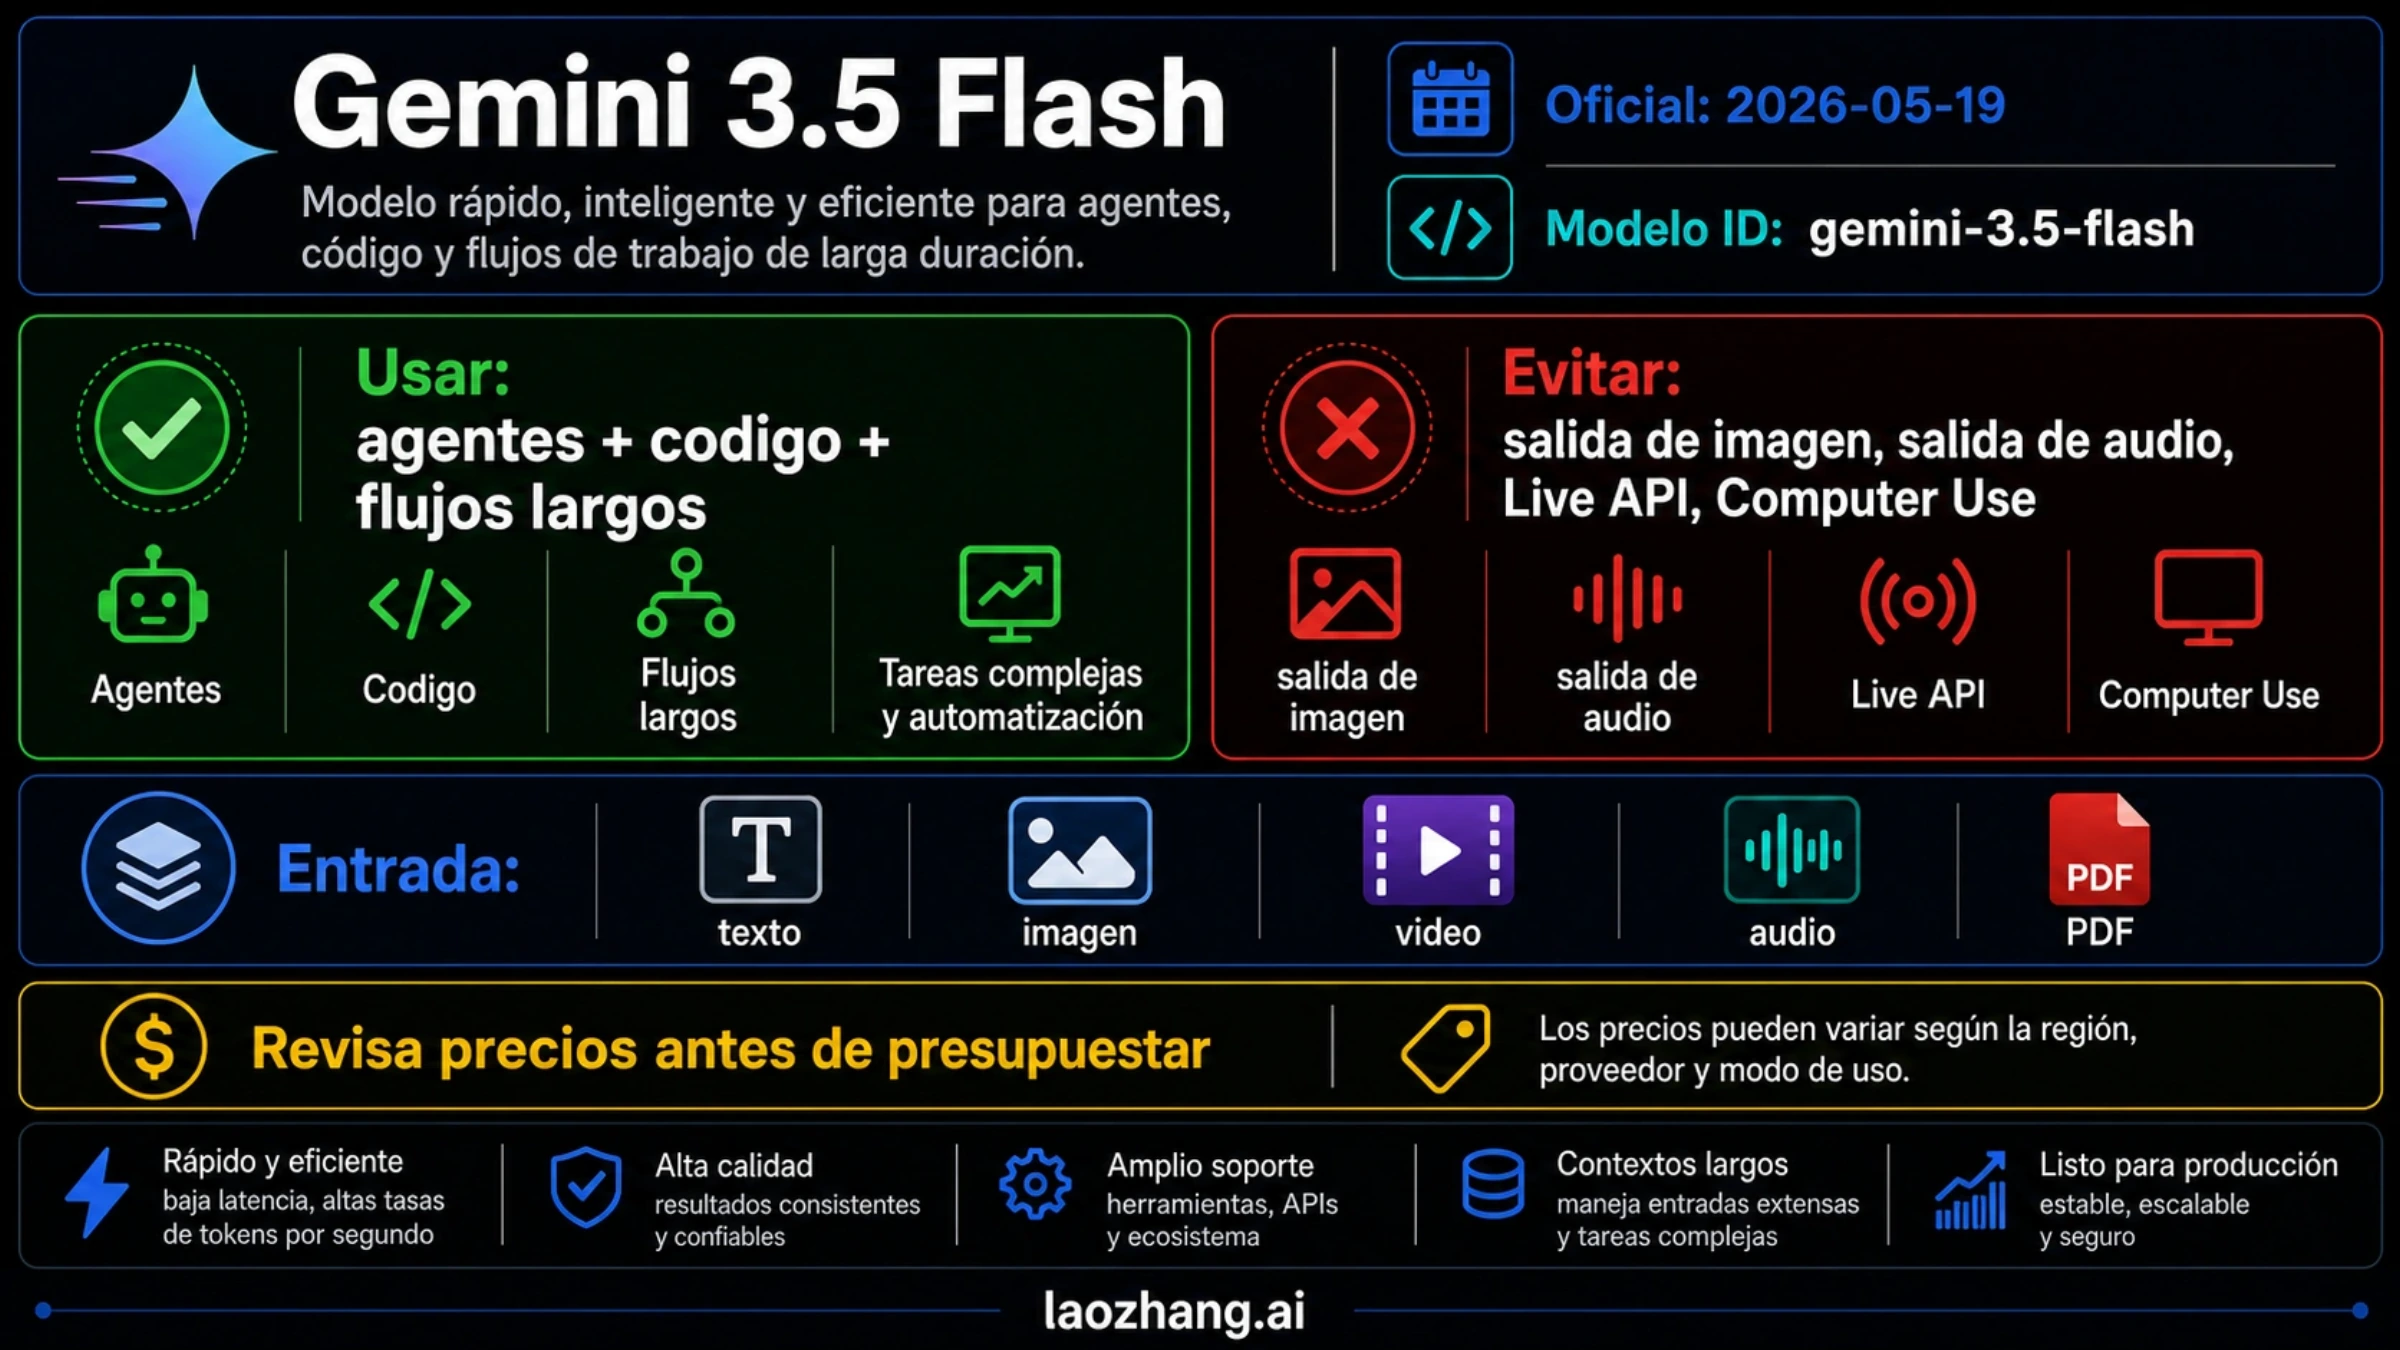
Las fichas de 3.1 Flash-Lite y 3.6 Flash indican entradas de texto, imagen, vídeo, audio y PDF, con salida de texto. Ambas muestran 1.048.576 tokens de entrada y 65.536 de salida. No confundas un millón de tokens de contexto con un millón de tokens disponibles para traducir un libro en una sola respuesta: planifica la división del contenido y verifica que no falten fragmentos.
Las dos rutas admiten llamadas a funciones, salida estructurada, ejecución de código, búsqueda de archivos, caché y razonamiento. 3.1 Flash-Lite no admite Computer Use; 3.6 sí lo lista como Preview. Ninguna de estas dos rutas de texto ofrece generación de imágenes, generación de audio o Live API. Para elegir entre Developer API y los controles de la plataforma Cloud, consulta la comparación de servicios y migración.
Precios actuales: separa modelo, modalidad, modo y fecha
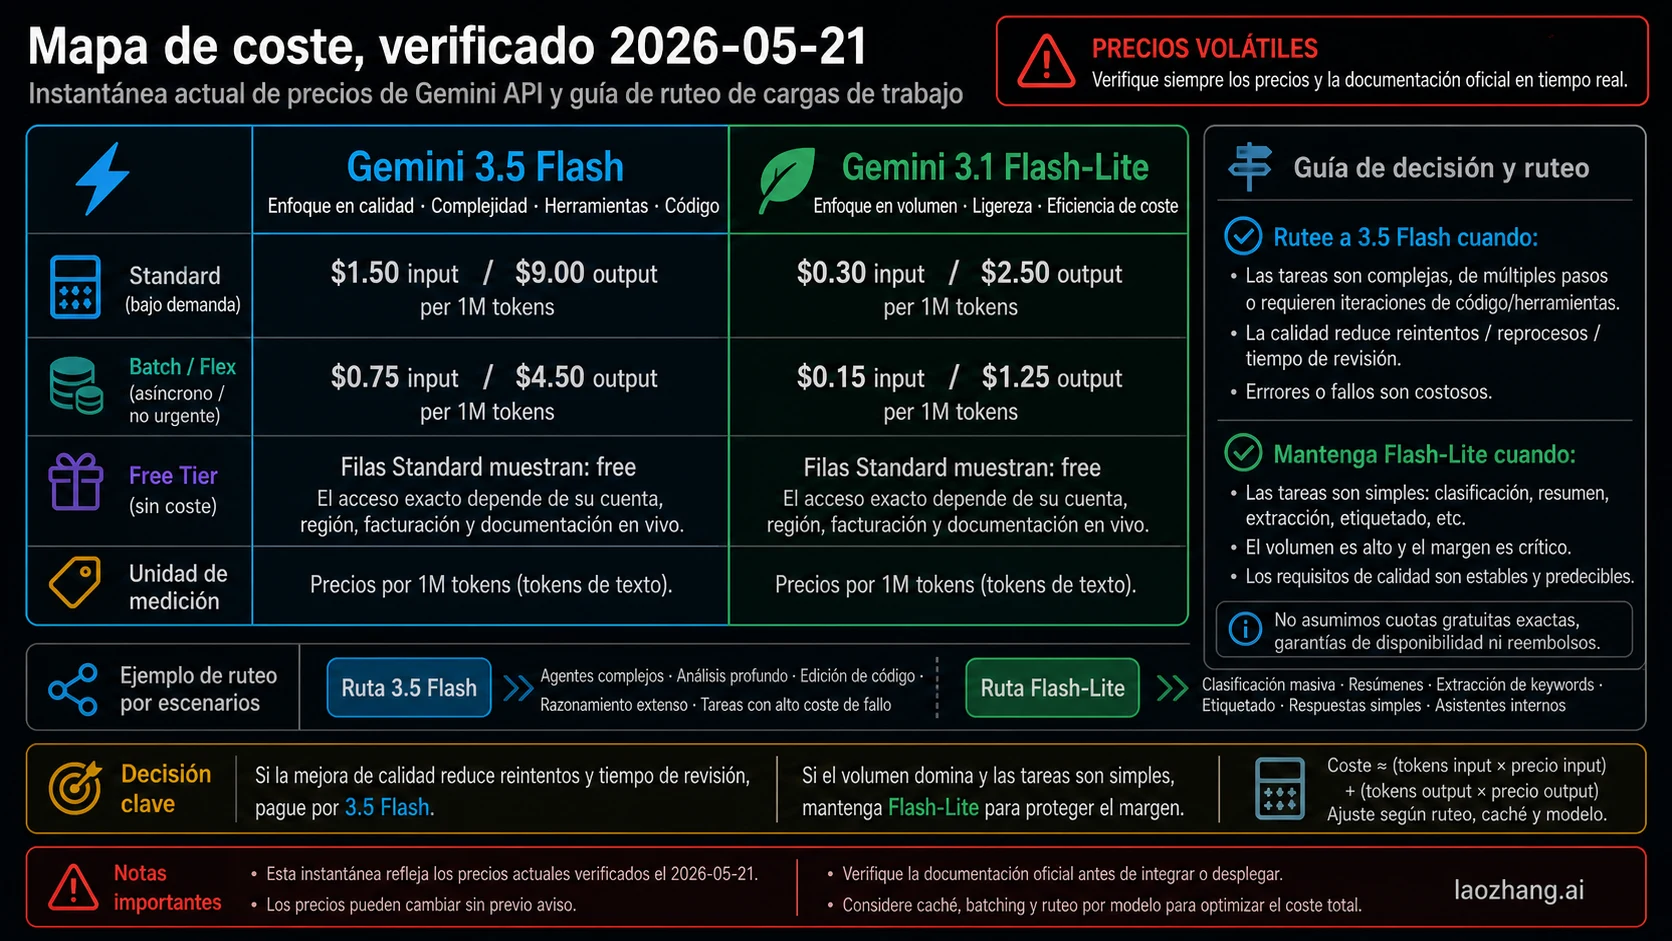
Ilustración de la comparación original de mayo. Para presupuestar ahora, utiliza las tarifas y las fechas de la tabla siguiente.
La tabla muestra USD por millón de tokens en el nivel de pago de Gemini Developer API, según la página oficial de precios, consultada el 13 de octubre de 2026. La salida incluye los tokens de razonamiento. Los importes de Flash corresponden al ID directo de 3.6 o 3.8, no a una factura observada del alias 3.5 ni al precio de un intermediario.
| Modelo y periodo | Modo | Entrada de texto, imagen o vídeo | Entrada de audio | Salida, incluido razonamiento |
|---|---|---|---|---|
| 3.1 Flash-Lite, tarifa actual | Standard | 0,25 | 0,50 | 1,50 |
| 3.1 Flash-Lite, tarifa actual | Batch / Flex | 0,125 | 0,25 | 0,75 |
| 3.1 Flash-Lite, tarifa actual | Priority | 0,45 | 0,90 | 2,70 |
| 3.6 / 3.8 Flash, hasta el 31 de diciembre de 2026 | Standard | 0,75 | 0,75 | 3,75 |
| 3.6 / 3.8 Flash, hasta el 31 de diciembre de 2026 | Batch / Flex | 0,375 | 0,375 | 1,875 |
| 3.6 / 3.8 Flash, hasta el 31 de diciembre de 2026 | Priority | 1,35 | 1,35 | 6,75 |
| 3.6 / 3.8 Flash, desde el 1 de enero de 2027 | Standard | 1,50 | 1,50 | 7,50 |
| 3.6 / 3.8 Flash, desde el 1 de enero de 2027 | Batch / Flex | 0,75 | 0,75 | 3,75 |
| 3.6 / 3.8 Flash, desde el 1 de enero de 2027 | Priority | 2,70 | 2,70 | 13,50 |
Por separado, 3.5 Flash-Lite cuesta actualmente 0,30 USD de entrada y 2,50 USD de salida en Standard. Es otra fila de precios, no la tarifa de 3.1 Flash-Lite. No reutilices una diferencia histórica de «seis veces» para presupuestar la pareja actual: el cociente cambia según la entrada, la salida y la fecha.
Un presupuesto que puedes recalcular
Supón un conjunto de tareas que consume 4 millones de tokens de entrada de texto y 800.000 tokens generados, contando respuesta y razonamiento. Sin caché, herramientas, reintentos, impuestos ni revisión humana, el cálculo en Standard es:
- 3.1 Flash-Lite:
4 × 0,25 + 0,8 × 1,50 = 2,20 USD. - 3.6 Flash directo hasta el 31 de diciembre de 2026:
4 × 0,75 + 0,8 × 3,75 = 6,00 USD. - 3.6 Flash directo desde el 1 de enero de 2027:
4 × 1,50 + 0,8 × 7,50 = 12,00 USD.
Es una estimación con cantidades supuestas y las tarifas citadas, no una factura ni una prueba de calidad. Si cambias el modelo y este genera más razonamiento o necesita menos reintentos, cambia también el consumo: no basta con conservar los mismos números en una hoja de cálculo.
Para decidir, divide el gasto completo entre el número de tareas que pasan tu validación. Incluye los intentos rechazados, el modelo de respaldo, las herramientas y el tiempo de revisión. En el ejemplo, la diferencia inicial es de 3,80 USD; Flash sólo compensa ese sobrecoste si aporta una mejora que tu aplicación necesita o evita reparaciones cuyo coste supera la diferencia.
Si utilizas caché, separa entrada nueva, entrada almacenada y almacenamiento por hora. La guía de Batch remite a tarifas estándar de caché, mientras la tabla de precios contiene filas específicas para Batch; esas referencias no permiten asumir sin más una reducción uniforme del 50 % para toda la caché. Contrasta ese componente antes de incorporarlo al presupuesto. Precios y detalles de Batch.
Batch y Flex ahorran a cambio de otro plazo de respuesta
Batch encaja con descripciones, documentos o evaluaciones que no necesitan respuesta inmediata. Es asíncrono, está disponible mediante generateContent y su objetivo es completar el trabajo en 24 horas, sin garantizar ese plazo. Envía el trabajo una sola vez: crear un Batch no es una operación idempotente y reenviarlo crea otro trabajo. Al terminar, comprueba cada resultado o error; el estado general no sustituye la validación de cada elemento. Guía de Batch API.
Flex, actualmente Preview, mantiene una llamada síncrona con disponibilidad según capacidad y latencia variable; Google indica un objetivo de 1–15 minutos. Puede devolver 503 por falta de capacidad o 429 por límites. No pasa automáticamente a Standard: si tu cliente decide hacerlo, debe asumir la nueva tarifa y registrar ese cambio. Para una conversación que necesita respuesta rápida, no elijas Flex sólo porque comparte el precio reducido de Batch. Guía de Flex.
La tarifa gratuita tampoco equivale a capacidad ilimitada. La tabla actual marca tokens gratuitos para 3.1 Flash-Lite en Standard, Batch, Flex y Priority; las filas gratuitas de Batch y Flex para 3.6 y 3.8 dicen «Not available». Comprueba siempre el modelo, el modo y la cuota de tu proyecto en lugar de aplicar una regla genérica de «todos los lotes son de pago». Tarifas por modo.
Cómo comprobar una integración con la API nativa
Para una integración que ya usa generateContent, conserva ese protocolo al comprobar el cambio de modelo. Necesitas una clave válida de Gemini Developer API, acceso al modelo y cuota en su proyecto. España figura entre las regiones admitidas; AI Studio también exige ser mayor de edad y cumplir los requisitos de verificación de la cuenta. El idioma de la página no determina la elegibilidad.
Este ejemplo documental usa REST y texto, sin instalar un SDK. Supone que tu entorno seguro ya contiene GEMINI_API_KEY y dispone de curl; aquí no se ha ejecutado una llamada real. La referencia nativa documenta contents, parts, generationConfig y serviceTier:
curl --fail-with-body --show-error \
  -X POST \
  'https://generativelanguage.googleapis.com/v1beta/models/gemini-3.1-flash-lite:generateContent' \
  -H "x-goog-api-key: ${GEMINI_API_KEY}" \
  -H 'Content-Type: application/json' \
  -d '{
    "contents": [{
      "role": "user",
      "parts": [{"text": "Traduce al español de España, conservando el importe y la fecha. Devuelve sólo la traducción: Your refund of EUR 29.90 will arrive by 18 October 2026."}]
    }],
    "generationConfig": {"maxOutputTokens": 2048},
    "serviceTier": "standard"
  }'
Para comparar con la ruta Flash actual, cambia únicamente el segmento del modelo por gemini-3.6-flash y conserva el caso. El límite de salida del ejemplo es una elección para este texto corto; no es una cuota del servicio ni asegura una respuesta completa en cualquier tarea.
Una respuesta útil requiere más que un estado HTTP satisfactorio. Comprueba que hay una respuesta candidata con texto, revisa su motivo de finalización y valida que conserva los 29,90 EUR y el 18 de octubre de 2026. Registra el ID solicitado, modelVersion, responseId, fecha, modo y usageMetadata. En esta última estructura:
promptTokenCountcuenta la entrada e incluye la parte almacenada en caché.cachedContentTokenCountidentifica esa parte; no la sumes de nuevo a la entrada.candidatesTokenCountythoughtsTokenCountdistinguen respuesta y razonamiento.totalTokenCountincluye entrada, razonamiento y candidatos; no lo factures entero como salida.
Son campos documentados en la respuesta de generateContent, no una respuesta observada de este ejemplo. Si utilizas un intermediario, confirma su protocolo, funciones y forma de identificar el modelo: la documentación de Google no demuestra qué backend usa ese proveedor.
Interactions utiliza otros campos
La guía actual de primeros pasos utiliza POST https://generativelanguage.googleapis.com/v1beta/interactions. El cuerpo lleva model e input, la configuración se expresa con generation_config y el modo con service_tier. No pegues el cuerpo anterior en ese endpoint: contents y generationConfig pertenecen al contrato de generateContent.
En Interactions, lee model, steps y usage, incluidos total_input_tokens, total_output_tokens y total_thought_tokens; no busques usageMetadata. Para ajustar el razonamiento, Interactions usa generation_config.thinking_level, mientras generateContent usa generationConfig.thinkingConfig.thinkingLevel. Google documenta medium como valor predeterminado de 3.6 y 3.8; minimal es válido en 3.6 y provoca un error en 3.8. La ficha de 3.1 Lite muestra una configuración high, pero la tabla general consultada no especifica su valor predeterminado. No presupuestes suponiendo que Lite tiene el razonamiento apagado. Guía de razonamiento y ficha de 3.1 Flash-Lite.
Qué revisar si la prueba falla o no escala
Separa un problema de acceso de una respuesta incorrecta. Desde el 28 de mayo de 2026, AI Studio crea por defecto claves de autorización; Google rechaza las claves estándar sin restricciones, aunque las estándar con restricciones explícitas pueden seguir funcionando. Ante un error de autenticación, revisa el tipo de clave y el proyecto con su administrador antes de cambiar de modelo. Documentación de claves.
Ante un 429 RESOURCE_EXHAUSTED, consulta los límites activos de AI Studio. Los límites de peticiones por minuto, tokens de entrada por minuto y peticiones por día se aplican por proyecto, no por clave; crear más claves no aumenta la cuota. El límite diario se reinicia a medianoche, hora del Pacífico. También puede actuar un límite de gasto en una ventana móvil de diez minutos, según la cuenta y su historial. Por tanto, un 429 no demuestra que Lite tenga peor calidad o que un modelo esté retirado. Reglas de límites.
No hay una concurrencia segura universal de 20 o 50 solicitudes. Ajusta la cola al límite real del proyecto, al tamaño de los documentos y al modo elegido. Mantén un presupuesto máximo de reintentos y registra cuándo cambias de modelo o de tarifa. Si el resultado es incorrecto pero la llamada funciona, pasa a la evaluación de calidad; si falta acceso o cuota, resuelve esa condición primero.
Cómo decidir el cambio sin perder una ruta que funciona
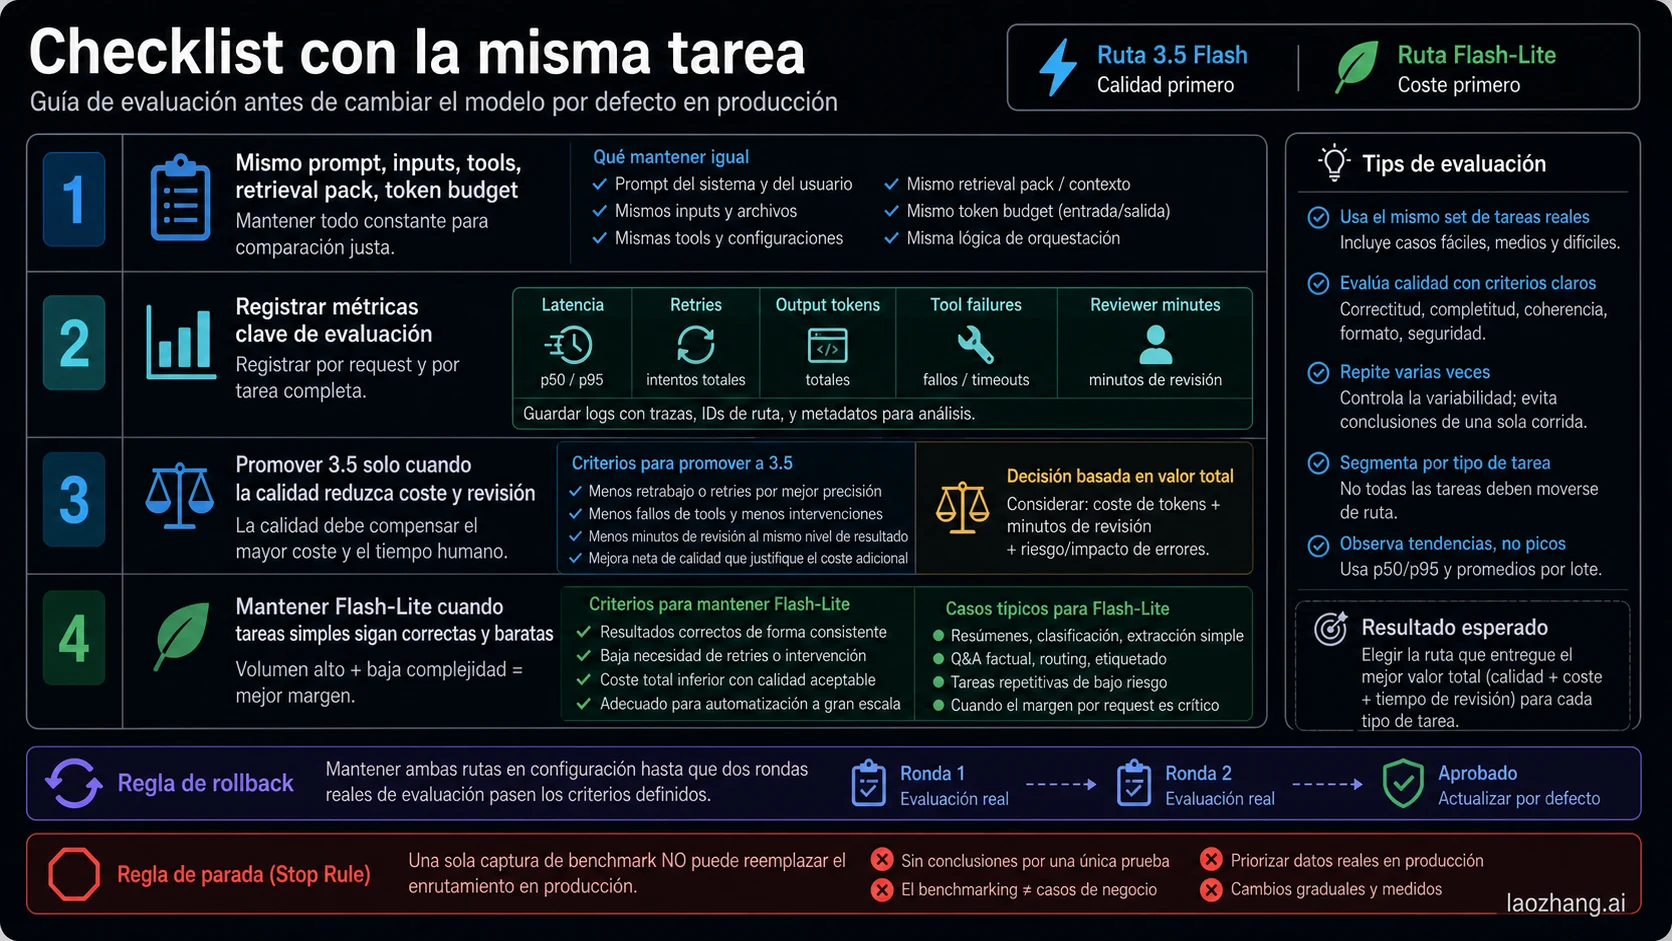
Ilustración de la comparación original de mayo. Aplica los criterios siguientes a los modelos y parámetros disponibles ahora.
Define la aceptación antes de comparar. Para traducción, comprueba importes, fechas, negaciones, glosario y naturalidad en el par de idiomas concreto. Para extracción, verifica el esquema y que cada valor esté respaldado por el documento. Para código o agentes, incluye pruebas funcionales y que las herramientas elegidas, sus argumentos y el resultado final sean correctos.
Usa los mismos documentos, instrucciones, herramientas y condiciones de servicio en cada ruta, con parámetros admitidos por cada modelo. Una configuración idéntica pero incompatible —por ejemplo, minimal en 3.8— no es una comparación válida. Conserva casos normales y casos que ya hayan fallado en tu producto, sin inferir la calidad de traducción de una puntuación de conocimientos multilingües.
Mide respuestas aceptadas, tiempo hasta el resultado útil, consumo total, reintentos y minutos de revisión. Si Lite alcanza la calidad requerida y ofrece el menor coste por resultado aceptado, mantenlo para esa clase de tareas. Si Flash mejora un requisito necesario o reduce el coste completo, aumenta su tráfico gradualmente y conserva una configuración de retorno. No hace falta trasladar de golpe traducción, extracción y agentes al mismo modelo.
Esta propuesta de evaluación es un criterio operativo, no el resultado de pruebas entre modelos. La comparación de esta página se basa en documentación y cálculos explícitos; no hemos medido aquí velocidad, calidad, cuota ni facturación de una cuenta real.
Preguntas frecuentes
¿Gemini 3.5 Flash ha dejado de funcionar por API?
Su endpoint no se está cerrando según el calendario de Google. Las llamadas a gemini-3.5-flash se dirigen automáticamente a gemini-3.6-flash, aunque 3.5 ya no se puede seleccionar en AI Studio. Usa el ID directo si quieres que tu configuración exprese el destino actual.
¿Gemini 3.1 Flash-Lite sigue siendo Preview?
No: gemini-3.1-flash-lite es estable. El ID separado gemini-3.1-flash-lite-preview se retiró el 25 de mayo de 2026. No copies un ejemplo antiguo que todavía lo utiliza.
¿Gemini 3.5 Flash-Lite es lo mismo que 3.5 Flash?
No. 3.5 Flash-Lite es un modelo Lite estable y es el reemplazo recomendado para 3.1 Flash-Lite. 3.5 Flash es el nombre obsoleto cuyas llamadas se dirigen a 3.6. El sufijo -lite cambia el modelo, no sólo su nombre visible.
¿Cuál es más barato para traducir?
Por token de texto, 3.1 Flash-Lite cuesta menos que 3.6 Flash directo: en Standard son 0,25/1,50 USD frente a 0,75/3,75 USD por millón de tokens de entrada/salida hasta el 31 de diciembre de 2026. La salida incluye razonamiento. El coste de una traducción aceptada depende además del consumo y las correcciones que requiera. Precios actuales.
¿Lite sirve para herramientas y documentos largos?
Sí: la ficha de 3.1 Flash-Lite incluye llamadas a funciones, búsqueda de archivos, salida estructurada y entradas PDF. Eso acredita compatibilidad, no precisión en cualquier cadena de herramientas. Su límite de salida tampoco permite devolver una traducción de un millón de tokens de una sola vez.
¿Debo migrar ya de 3.1 a 3.5 Flash-Lite?
Google recomienda 3.5 Flash-Lite como reemplazo, pero la fecha más temprana de retirada publicada para 3.1 es el 7 de mayo de 2027. Planifica la prueba con tus datos y compara el coste del trabajo completo antes del cambio; no interpretes esa fecha como una garantía ni como una orden de migración inmediata. Calendario de retirada.
Fuentes16
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 13 oct 2026.
Fuentes16
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 13 oct 2026.
- 1.ficha de 3.5 Flashai.google.dev/gemini-api/docs/models/gemini-3.5-flash
- 2.calendario de retiradaai.google.dev/gemini-api/docs/deprecations
- 3.referencia de generateContentai.google.dev/api/generate-content
- 4.orientación oficialai.google.dev/gemini-api/docs/models/gemini-3.1-flash-lite
- 5.fichas de 3.6ai.google.dev/gemini-api/docs/models/gemini-3.6-flash
- 6.3.8ai.google.dev/gemini-api/docs/models/gemini-3.8-flash
- 7.página oficial de preciosai.google.dev/gemini-api/docs/pricing
- 8.detalles de Batchai.google.dev/gemini-api/docs/batch-api
- 9.Guía de Flexai.google.dev/gemini-api/docs/flex-inference
- 10.regiones admitidasai.google.dev/gemini-api/docs/available-regions
- 11.primeros pasosai.google.dev/gemini-api/docs/get-started
- 12.Guía de razonamientoai.google.dev/gemini-api/docs/thinking
- 13.Documentación de clavesai.google.dev/gemini-api/docs/api-key
- 14.límites activos de AI Studioaistudio.google.com/rate-limit
- 15.Reglas de límitesai.google.dev/gemini-api/docs/rate-limits
- 16.3.5 Flash-Liteai.google.dev/gemini-api/docs/models/gemini-3.5-flash-lite