Editar vídeos con Claude Code: qué ruta elegir y dónde falla
Claude Code no abre el .mp4: lee una transcripción y ejecuta ffmpeg. Sirve para vídeos a cámara y tutoriales; multicámara y etalonaje siguen en tu editor.
En esta página
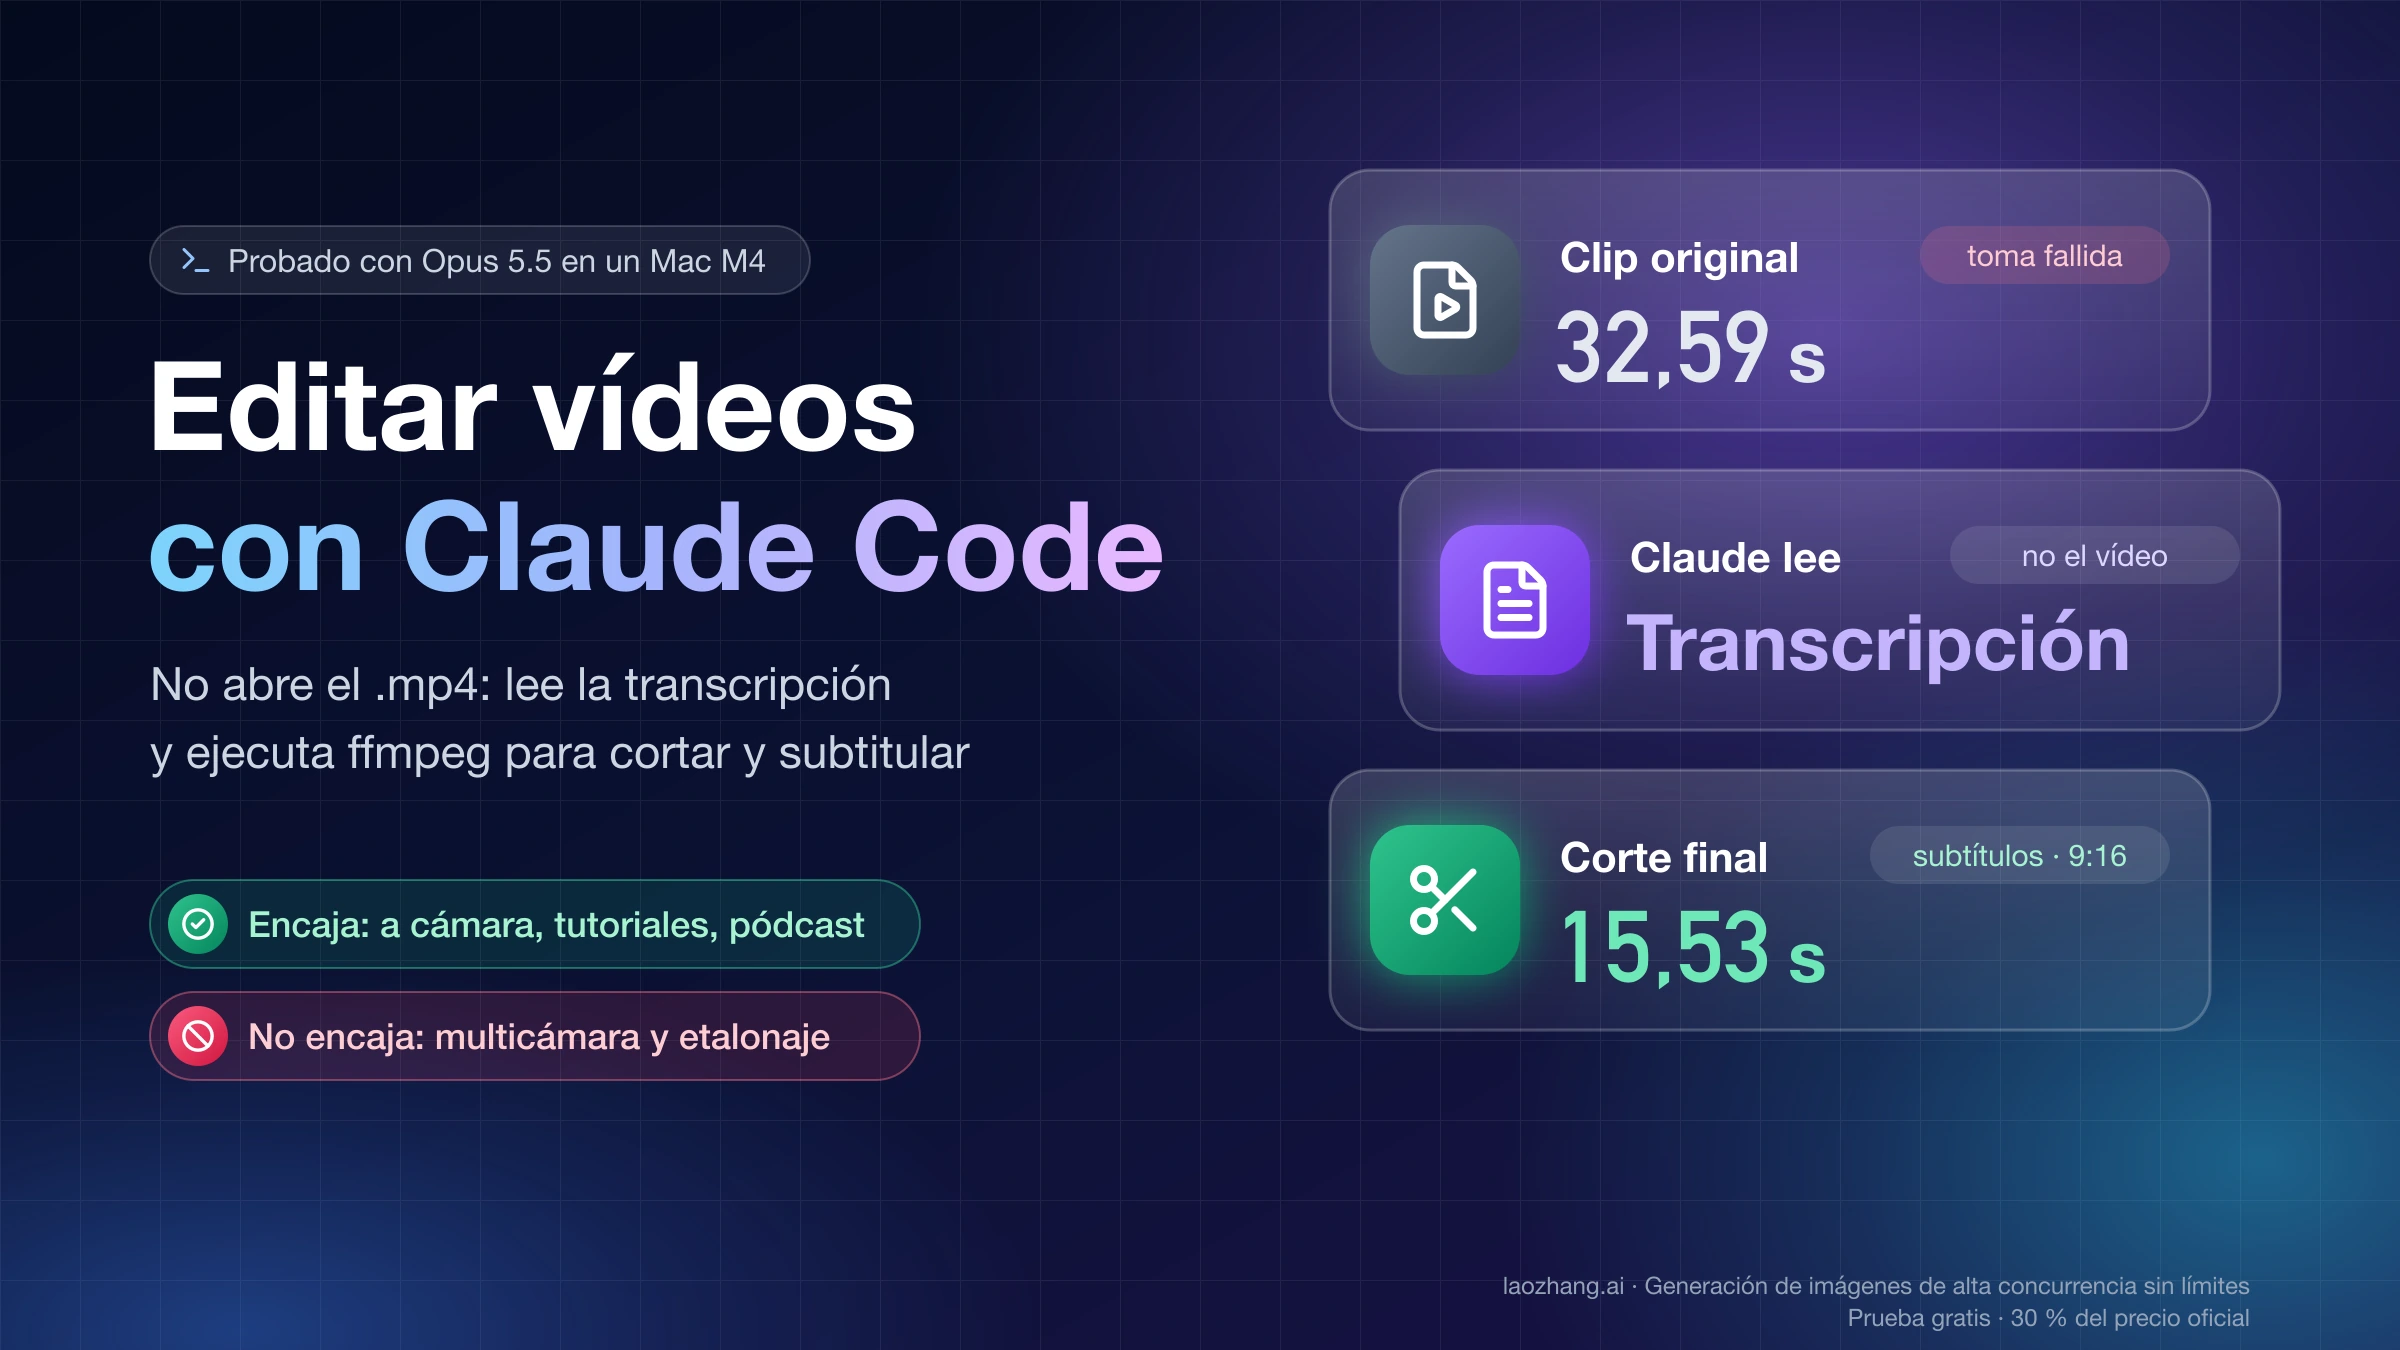
Sí, Claude Code puede editar vídeo que ya tienes grabado, pero no lo hace mirando el archivo. Claude no acepta vídeo ni audio como entrada: trabaja con una transcripción con marcas de tiempo (y, si hace falta, con unos pocos fotogramas extraídos como imagen), decide qué tramos conservar y escribe y ejecuta los comandos de ffmpeg que cortan, subtitulan y reencuadran. Por eso funciona bien cuando las decisiones dependen de lo que se dice: vídeo a cámara, tutorial grabado en pantalla, entrevista, pódcast o directo con pausas y tomas repetidas. Funciona mal cuando dependen de la imagen: multicámara, etalonaje, elegir el mejor plano o el gesto adecuado.
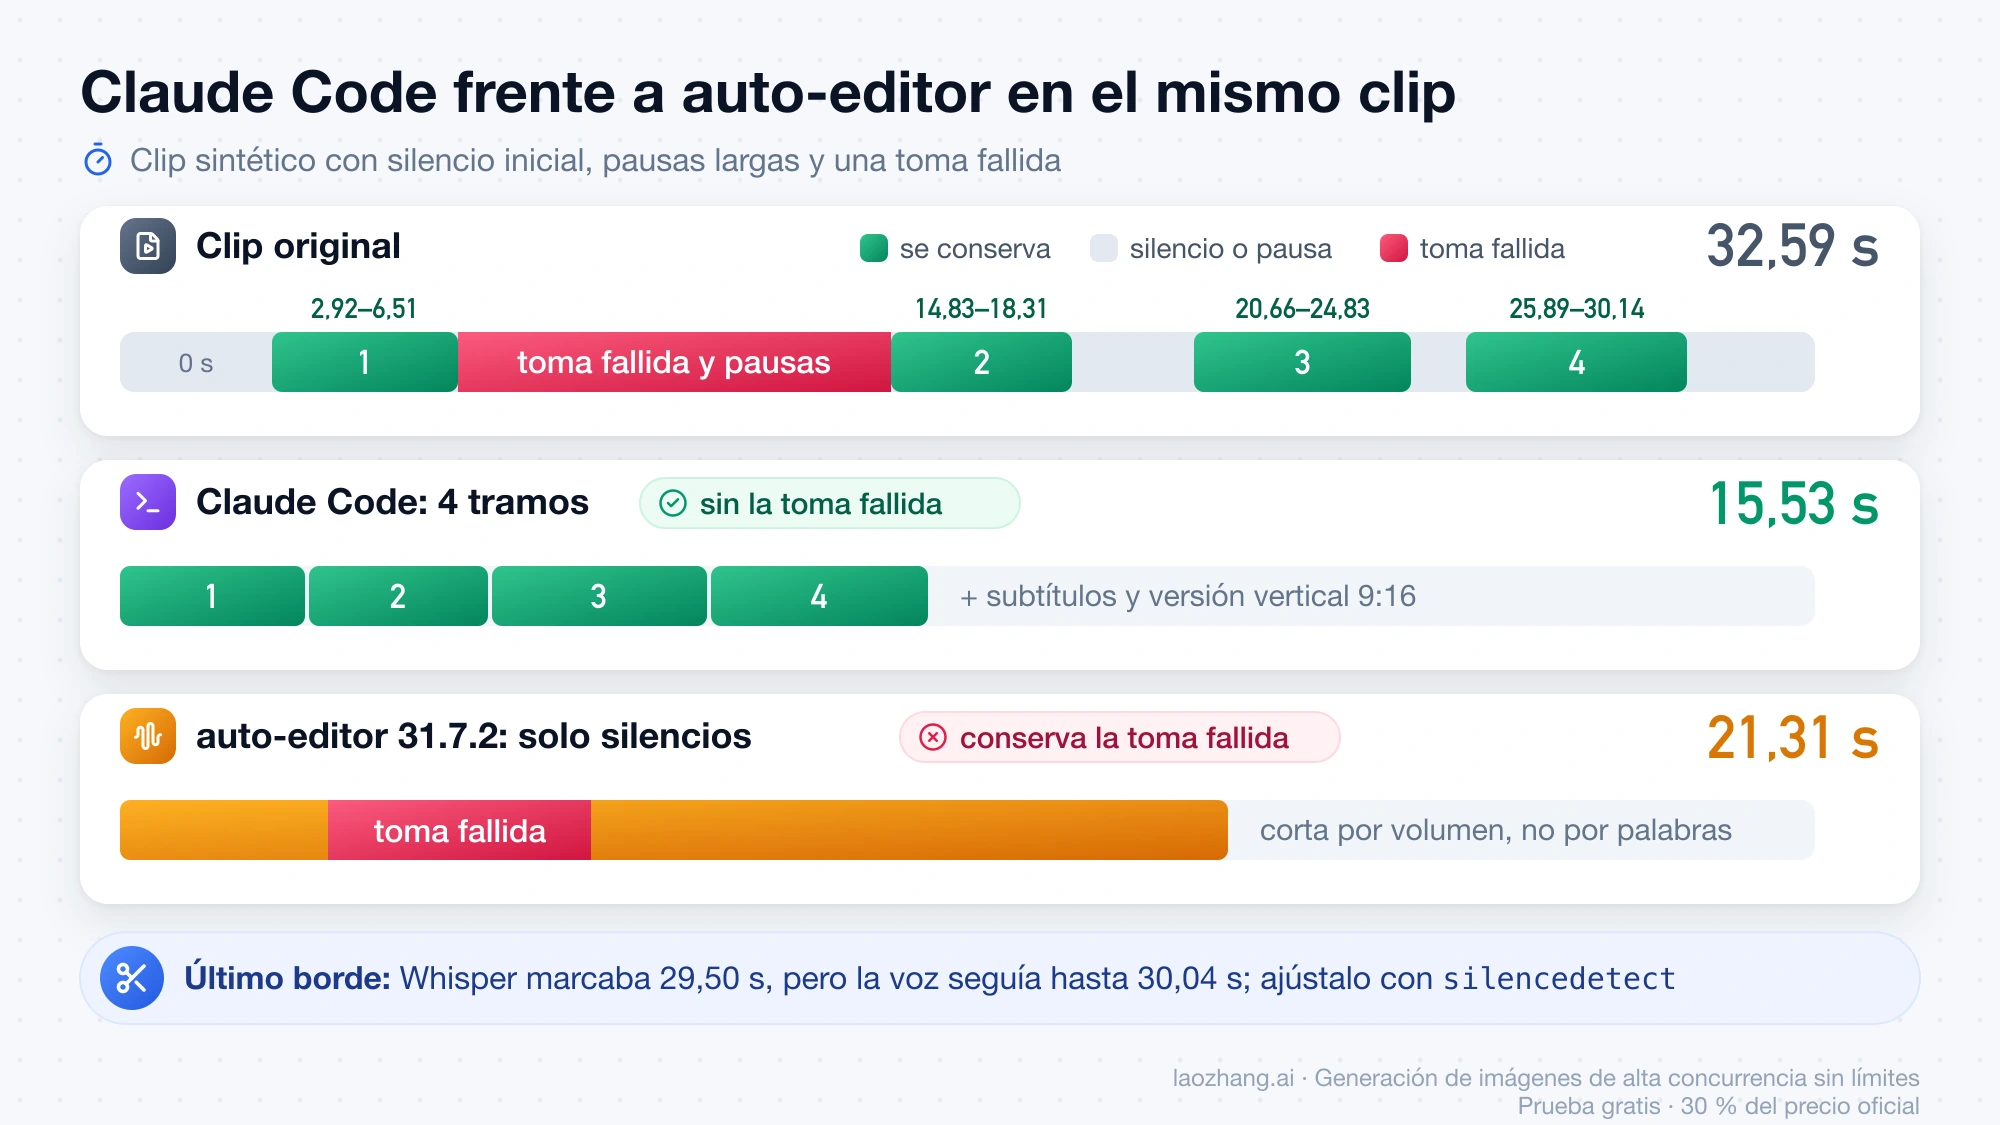
En una prueba con Claude Code (Opus 5.5) en un Mac con chip M4, un clip sintético de 32,59 s con una toma fallida quedó en 15,53 s sin esa toma, con subtítulos y una versión vertical 9:16. Por el camino aparecieron tres fallos de instalación y de corte que también te pueden pasar a ti; están documentados más abajo con su arreglo.
Si lo que buscas es crear un vídeo nuevo a partir de código o animaciones, eso es otra tarea: Crear vídeos con Claude Opus 5.5: qué genera y cómo sacar un MP4. Claude Motion tampoco edita metraje propio; anima texto, gráficos e imágenes en claude.ai (Cómo usar Claude Dashboards y Motion: qué plan pide cada uno).
Cómo edita Claude Code un vídeo si no puede ver el .mp4
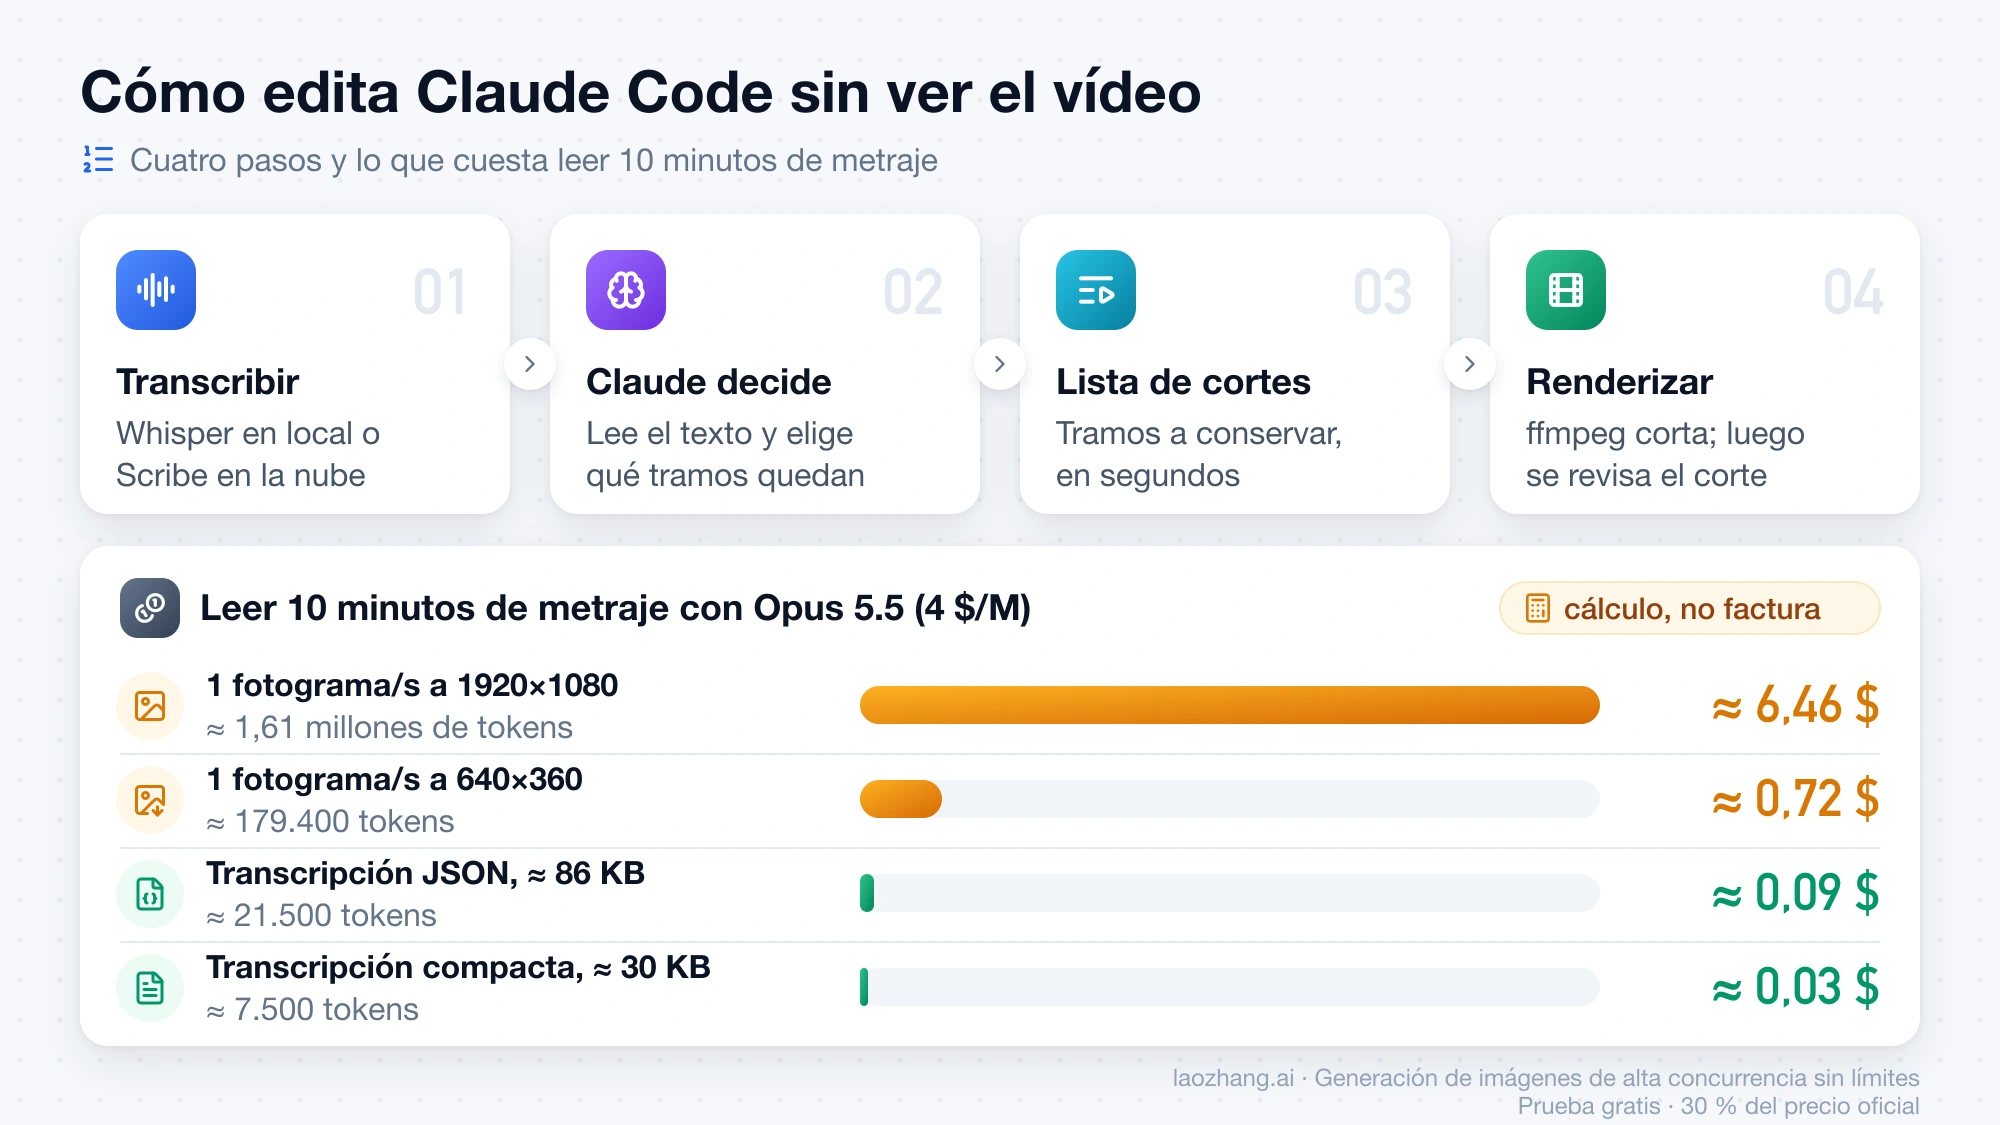
Según la documentación de visión de Claude, los formatos admitidos son JPEG, PNG, WebP y GIF (de este solo se usa el primer fotograma). La herramienta Read de Claude Code devuelve imágenes, PDF y notebooks, como detalla la referencia de herramientas de Claude Code. Ninguna de las dos páginas incluye vídeo ni audio. En la práctica, cualquier flujo de edición con Claude Code sigue el mismo patrón:
- Transcribir el audio con marcas de tiempo por palabra (Whisper en local, ElevenLabs Scribe en la nube u otro motor).
- Leer esa transcripción y decidir los cortes: qué silencios sobran, qué toma está repetida, dónde empieza la frase buena. Este es el único paso en el que interviene el criterio del modelo.
- Escribir una lista de cortes (los tramos que se conservan, en segundos) y ejecutar ffmpeg para renderizarla.
- Comprobar el resultado volviendo a transcribir el vídeo cortado o extrayendo algún fotograma concreto.
Claude Code no tiene una función de edición propia: dirige herramientas que ya existen. Si una herramienta no está instalada o le falta un filtro, el flujo se rompe en ese punto, no en el modelo.
Transcripción frente a fotogramas: el coste en tokens
Una imagen cuesta ⌈ancho/28⌉ × ⌈alto/28⌉ tokens visuales según la documentación de visión de Claude. Los modelos Claude 4.7 y posteriores (Opus 5.5 incluido) usan el nivel de alta resolución, en el que un fotograma de 1920×1080 no se reduce y cuesta 2.691 tokens. Con el precio de lista de Opus 5.5 en la API, 4 $ por millón de tokens de entrada:
| 10 minutos de metraje enviados como… | Cálculo | Tokens de entrada | Coste a 4 $/M |
|---|---|---|---|
| 1 fotograma por segundo a 1920×1080 | 600 × 2.691 | ≈ 1,61 millones | ≈ 6,46 $ |
| 1 fotograma por segundo reducido a 640×360 | 600 × (23 × 13 = 299) | ≈ 179.400 | ≈ 0,72 $ |
| Transcripción por palabras en JSON (≈ 86 KB) | 86.000 caracteres ÷ 4 | ≈ 21.500 | ≈ 0,09 $ |
| Transcripción compacta «inicio fin palabra» (≈ 30 KB) | 30.000 ÷ 4 | ≈ 7.500 | ≈ 0,03 $ |
Supuestos del cálculo: unas 150 palabras por minuto (≈ 1.500 palabras en 10 minutos), unos 57 bytes por palabra en JSON (medido en el clip de la prueba: 57 palabras, 3.275 bytes) y unos 4 caracteres por token, una regla aproximada para inglés. Es un cálculo, no una factura: una sesión real de Claude Code añade el prompt del sistema, las herramientas y el historial. Con un plan Pro o Max no pagas por token, pero la proporción indica cuánto límite de uso consume cada enfoque. Y aunque mandes los 600 fotogramas, el modelo sigue sin oír el audio.
Qué metraje se puede editar con Claude Code y cuál no
La regla práctica: si puedes describir el corte leyendo la transcripción, Claude Code puede hacerlo. Si necesitas ver la imagen para decidir, no.
| Encaja | No encaja (o solo como premontaje) |
|---|---|
| Una persona hablando a cámara con pausas, muletillas y tomas repetidas | Multicámara: elegir cámara según quién habla y cómo se le ve |
| Tutorial grabado en pantalla con narración | Etalonaje y corrección de color fina |
| Pódcast o entrevista que quieres recortar a un clip vertical | Elegir planos o B-roll por lo que se ve (gesto, expresión, acción) |
| Directo largo del que sacar fragmentos por tema | Montaje narrativo largo con ritmo visual |
Dos informes de terceros apuntan en la misma dirección. En la reseña de video-use en Habr (7 de mayo de 2026), el autor concluye que la herramienta sirve para vídeos a cámara, que no trae B-roll de serie y que su autoevaluación detecta fallos técnicos (cortes, chasquidos, subtítulos tapados) pero no semánticos, como haberse quedado con la toma equivocada. La guía de Fyve sobre edición de vídeo con Claude Code (29 de junio de 2026) recomienda tratar el resultado como un borrador: alrededor de un 70 % automático y un 30 % a mano.
Qué skill o herramienta usar para editar vídeos con Claude Code
No hay una skill oficial de Anthropic para editar vídeo; las rutas disponibles son proyectos de terceros o un guion propio. auto-editor y el guion local con Whisper + ffmpeg se ejecutaron en la prueba descrita más abajo. Las demás filas resumen la documentación de cada proyecto a 15 de octubre de 2026.
| Ruta | Qué hace con tu metraje | Qué necesitas además de Claude Code | Dónde falla |
|---|---|---|---|
| video-use (skill, MIT) | Quita muletillas, arranques en falso y tiempos muertos; corrige color por tramo; fundidos de 30 ms; subtítulos incrustados; rótulos con HyperFrames, Remotion, Manim o PIL. Te enseña la estrategia y espera tu visto bueno antes de cortar | Clave de API de ElevenLabs: la transcripción solo funciona con Scribe | Sin Whisper local en la rama principal; pensado para vídeo a cámara |
| Guion local: faster-whisper + ffmpeg | Lo que Claude Code programe: cortes por transcripción, subtítulos, vertical 9:16 | Python, ffmpeg (y ffmpeg-full si quieres subtítulos incrustados) | Instalación y marcas de tiempo; ver los tres fallos más abajo |
| auto-editor (Unlicense) | Corta silencios por volumen (o por movimiento) y exporta la línea de tiempo | Nada de pago; brew install auto-editor o binario de GitHub | No entiende palabras: deja las tomas fallidas si tienen voz |
| ButterCut | Transcribe en local con WhisperX, analiza la imagen y monta un premontaje que exporta como XML a Final Cut Pro, Premiere o DaVinci Resolve | Ruby, Python, ffmpeg completo, WhisperX; orientado a Mac con Apple Silicon | Licencia no comercial para la herramienta (el vídeo final sí puede ser comercial); B-roll multipista solo en la versión Pro, 49 $ al año |
| MCP para el editor: DaVinci Resolve, Premiere Pro, Palmier Pro | Claude Code maneja la línea de tiempo real: ensamblar, marcadores, render | Resolve Studio (de pago) para un scripting fiable; Premiere con un panel CEP; Palmier pide macOS 26 y Apple Silicon | Proyectos de la comunidad, no de Blackmagic ni Adobe. El MCP de Resolve no juzga cortes: entrega «a first-pass assembly» |
| Plugin de ChatCut para Claude Code | Recortes, reducción de ruido, subtítulos, gráficos animados, B-roll generado, voz en off y línea de tiempo en el navegador | Suscripción a ChatCut de 25 a 160 $ al mes (100–800 créditos), además de tu uso de Claude | Subes el metraje a un servicio externo; sin plan gratuito en esa página |
Dos proyectos aparecen a menudo en vídeos de «editar con Claude Code» pero resuelven otra cosa. claude-code-video-toolkit sobre todo crea vídeo nuevo (plantillas de Remotion, voz sintética, imágenes y clips generados); con metraje existente se limita a redoblar, añadir música, recortar, unir y reencuadrar, sin cortes por silencio ni subtítulos. HyperFrames (Apache-2.0) y Remotion generan rótulos, gráficos y subtítulos animados que se componen encima del corte, pero no cortan el metraje. Si los usas en un equipo de más de tres personas, revisa la licencia de Remotion: es gratis para particulares, empresas de hasta 3 empleados y organizaciones sin ánimo de lucro; a partir de ahí pide licencia de empresa (25 $ al mes por puesto, o 0,01 $ por render con un mínimo de 100 $ al mes).
Para elegir:
- Solo quieres quitar silencios y no repites tomas: auto-editor. Es gratis, local y Claude Code puede ajustarle el margen y el umbral por ti.
- Hablas a cámara, repites frases y quieres un MP4 final con subtítulos: video-use si aceptas una clave de ElevenLabs, o el guion local con Whisper + ffmpeg si no quieres pagar transcripción y no te importa montar el entorno.
- Quieres acabar en tu editor de siempre: ButterCut (Mac) para un premontaje en XML, o auto-editor con
--export premiere,--export resolveo--export final-cut-pro. Los MCP de Resolve y Premiere sirven para automatizar el ensamblado y el render, no para decidir el corte. - No quieres tocar el terminal y no te importa subir el metraje ni pagar una suscripción aparte: ChatCut.
- Quieres rótulos y gráficos: HyperFrames o Remotion encima de un corte que ya tengas.
Ninguna de estas rutas controla CapCut. Lo que sí puedes hacer es abrir en CapCut el MP4 o el archivo .srt que salgan de cualquiera de ellas.
Prueba con Claude Code: un clip de 32 s con una toma fallida
Entorno: Claude Code con Opus 5.5 en un Apple M4 con macOS 26.1 y Homebrew. El clip es sintético: voz en inglés generada con say de macOS sobre una imagen de prueba de ffmpeg (testsrc2, 1920×1080 a 30 fps), con 3 s de silencio inicial, pausas largas y una toma fallida («…Um, wait, let me say that again.») seguida de la repetición correcta. No hay cámara real, cara, ruido de sala ni varias personas, y no se probó la transcripción en español: los resultados demuestran el flujo, no la precisión con tus grabaciones.
Paso 1: transcripción por palabras con faster-whisper
brew install ffmpeg
python3 -m venv venv
./venv/bin/pip install faster-whisper "av<19"
./venv/bin/python transcribe.py raw/talk.mp4 base.en
El "av<19" no es decorativo: es el arreglo del primer fallo (más abajo). transcribe.py:
"""Paso 1: transcripción por palabras del clip original (local, sin clave de API)."""
import json
import sys
import time

from faster_whisper import WhisperModel

src = sys.argv[1]
model_name = sys.argv[2] if len(sys.argv) > 2 else "base.en"

t0 = time.time()
model = WhisperModel(model_name, device="cpu", compute_type="int8")
segments, info = model.transcribe(src, word_timestamps=True, vad_filter=False)
words = []
for seg in segments:
    for w in seg.words:
        words.append({"start": round(w.start, 2), "end": round(w.end, 2), "word": w.word.strip()})
json.dump(words, open("words.json", "w"), indent=1)
print(f"model={model_name} words={len(words)} audio={info.duration:.1f}s elapsed={time.time()-t0:.1f}s")
Con el modelo base.en en CPU (int8) salieron 57 palabras con marca de tiempo en 3,0 s, carga del modelo incluida. La primera ejecución descarga el modelo, unos 141 MB. Los modelos terminados en .en solo sirven para inglés; para metraje en español necesitas un modelo multilingüe (el mismo nombre sin .en), y su precisión con tu voz es algo que tendrás que comprobar tú.
Paso 2: Claude decide qué tramos conservar
Claude leyó words.json, vio que la frase «First, we cut out the long pauses» aparecía dos veces, con la primera interrumpida por «Um, wait, let me say that again», y escribió una lista de cuatro tramos que quitaba el silencio inicial, la toma fallida entera y las pausas largas:
[{"start": 2.92, "end": 6.51}, {"start": 14.83, "end": 18.31}, {"start": 20.66, "end": 24.83}, {"start": 25.89, "end": 30.14}]Esa es la versión corregida; la primera cortaba el final de una palabra (tercer fallo). Para tu propio metraje, un encargo de ejemplo que ya incluye la corrección:
Lee words.json. Es una grabación a cámara con pausas y alguna toma repetida.
Escribe edl.json con los tramos que hay que conservar: quita el silencio inicial,
quita cualquier toma que se repita más adelante y deja solo la última, y acorta
las pausas largas. Antes de fijar cada borde, mide los silencios con
ffmpeg -i raw/talk.mp4 -af silencedetect=noise=-40dB:d=0.3 -f null -
y ajusta cada corte al silencio más cercano. Enséñame la lista antes de renderizar.
Paso 3: render con ffmpeg y subtítulos remapeados
render.py construye un único grafo de filtros de ffmpeg (trim/atrim por tramo, fundido de audio de 30 ms en cada borde y concat) y, a la vez, traslada las marcas de tiempo de cada palabra a la nueva línea de tiempo para generar el .srt:
"""Paso 3: convierte la lista de cortes (tramos a conservar) en final.mp4 + subtítulos.

edl.json: [{"start": s, "end": e}, ...] sobre la línea de tiempo original.
Genera final.mp4 (concat con fundidos de audio de 30 ms) y final.srt (palabras remapeadas).
"""
import json
import subprocess
import sys

src = sys.argv[1]
edl = json.load(open("edl.json"))
words = json.load(open("words.json"))
FADE = 0.03

# 1) cortar y unir en un solo grafo de filtros de ffmpeg
parts, labels = [], []
for i, k in enumerate(edl):
    d = k["end"] - k["start"]
    parts.append(f"[0:v]trim={k['start']}:{k['end']},setpts=PTS-STARTPTS[v{i}]")
    parts.append(
        f"[0:a]atrim={k['start']}:{k['end']},asetpts=PTS-STARTPTS,"
        f"afade=t=in:d={FADE},afade=t=out:st={d - FADE:.3f}:d={FADE}[a{i}]"
    )
    labels.append(f"[v{i}][a{i}]")
graph = ";".join(parts) + ";" + "".join(labels) + f"concat=n={len(edl)}:v=1:a=1[v][a]"
subprocess.run(
    ["ffmpeg", "-v", "error", "-y", "-i", src, "-filter_complex", graph, "-map", "[v]", "-map", "[a]",
     "-c:v", "libx264", "-crf", "20", "-preset", "veryfast", "-c:a", "aac", "-b:a", "160k", "final.mp4"],
    check=True,
)

# 2) remapear las palabras a la nueva línea de tiempo y agrupar 2-3 por subtítulo
# una palabra se conserva si se solapa con un tramo; sus tiempos se recortan a ese tramo
# (los bordes de Whisper se desplazan unos cientos de ms; exigir que quepa entera pierde palabras)
kept = []
for w in words:
    offset = 0.0
    for k in edl:
        overlap = min(w["end"], k["end"]) - max(w["start"], k["start"])
        if overlap > 0:
            s = max(w["start"], k["start"]) - k["start"] + offset
            e = min(w["end"], k["end"]) - k["start"] + offset
            kept.append({"start": s, "end": e, "word": w["word"]})
            break
        offset += k["end"] - k["start"]

def ts(t):
    h, rem = divmod(t, 3600)
    m, s = divmod(rem, 60)
    return f"{int(h):02d}:{int(m):02d}:{int(s):02d},{int(round((s % 1) * 1000)):03d}"

cues, chunk = [], []
for w in kept:
    chunk.append(w)
    if len(chunk) == 3 or w["word"].endswith((".", ",", "?", "!")):
        cues.append(chunk)
        chunk = []
if chunk:
    cues.append(chunk)
with open("final.srt", "w") as f:
    for n, c in enumerate(cues, 1):
        text = " ".join(x["word"] for x in c)
        f.write(f"{n}\n{ts(c[0]['start'])} --> {ts(c[-1]['end'])}\n{text}\n\n")
print(f"segments={len(edl)} kept_words={len(kept)}/{len(words)} cues={len(cues)}")
El render tardó entre 1,46 y 1,74 s y dejó un MP4 1080p de 15,53 s. El .srt salió con 18 subtítulos y 43 de las 57 palabras: las 14 que faltan son exactamente la toma fallida. Al volver a transcribir el resultado con base.en, el guion salió completo y sin la repetición.
La primera versión del guion tenía un error propio: solo conservaba las palabras cuyo inicio y final cabían dentro de un tramo, y tras ajustar los cortes a los silencios perdió palabras como «Hi,» (se quedaba en 40 de 57). La versión de arriba conserva cualquier palabra que se solape con un tramo y recorta sus tiempos.
Paso 4: subtítulos como pista, incrustados y versión vertical 9:16
Subtítulos como pista que el espectador puede activar o desactivar. Funcionan con el ffmpeg normal de Homebrew:
ffmpeg -i final.mp4 -i final.srt -map 0 -map 1 -c copy -c:s mov_text -metadata:s:s:0 language=eng final_softsubs.mp4Subtítulos incrustados (quemados en la imagen). Necesitan ffmpeg-full, que en Homebrew es keg-only y no queda en el PATH:
/opt/homebrew/opt/ffmpeg-full/bin/ffmpeg -i final.mp4 -vf "subtitles=final.srt:force_style='FontName=Helvetica,FontSize=22,Outline=2'" -c:v libx264 -crf 20 -preset veryfast -c:a copy final_burned.mp4Versión vertical 1080×1920 con subtítulos, con el mismo binario y las mismas opciones de salida:
-vf "crop=ih*9/16:ih,scale=1080:1920,subtitles=final.srt:force_style='FontName=Helvetica,FontSize=14,MarginV=60,Outline=2'"Los dos renders tardaron 1,67 s y 1,39 s. Un fotograma extraído en el segundo 1,2 de la salida mostraba el código de tiempo 00:00:03.800 de la imagen original y el subtítulo «this is a», lo que confirma que el corte y los subtítulos casaban. Dos límites: el recorte es centrado, así que solo sirve si estás en el centro del plano (el seguimiento de caras no se probó), y Helvetica es una fuente de macOS; en Windows o Linux cambia FontName.
Tres fallos al editar vídeo con Claude Code y cómo se arreglan
TypeError: open() got an unexpected keyword argument 'metadata_errors'
pip install faster-whisper a secas instaló faster-whisper 1.2.1 (la última versión en PyPI a 15 de octubre de 2026) junto con PyAV 19.0.1, publicado el 3 de octubre. Al transcribir, el proceso terminó con ese TypeError. Fijar PyAV por debajo de la 19 lo arregló:
./venv/bin/pip install faster-whisper "av<19"Se instaló PyAV 18.1.0 y la transcripción funcionó. La causa se deduce de la traza del error; una versión posterior de faster-whisper puede corregirlo, así que si pip te instala algo más nuevo que la 1.2.1, prueba primero sin fijar PyAV.
No such filter: 'subtitles' en el ffmpeg de Homebrew
El ffmpeg estándar de Homebrew (probado en 8.0.1_2 y en 9.0.2) no incluye los filtros subtitles, ass ni drawtext, porque se compila sin libass ni freetype. Los mensajes que verás:
- con
-vf subtitles=final.srt: «No option name near 'final.srt'» y «Error parsing filterchain»; - con
-vf subtitles=filename=final.srt: «No such filter: 'subtitles'».
Compruébalo con ffmpeg -filters | grep subtitles: si no devuelve nada, tu build no puede incrustar subtítulos. La fórmula ffmpeg-full sí trae libass, freetype, fontconfig y harfbuzz (además de whisper.cpp y tesseract). brew install ffmpeg-full tardó 2 min 05 s, y el binario queda en /opt/homebrew/opt/ffmpeg-full/bin/ffmpeg. Si solo necesitas subtítulos como pista (-c:s mov_text), el ffmpeg normal basta. Las builds de otras plataformas (distribuciones de Linux, builds «full» para Windows) son distintas y no se probaron.
Efecto secundario que conviene conocer: instalar ffmpeg-full actualizó la librería compartida libvpx (de 1.15.2 a 1.17.0), y el ffmpeg 8.0.1_2 que ya estaba instalado, desactualizado, dejó de arrancar con dyld: Library not loaded: /opt/homebrew/opt/libvpx/lib/libvpx.11.dylib. brew upgrade ffmpeg lo resolvió en 8 s, y brew linkage --test no encontró más librerías rotas. Si tienes un ffmpeg antiguo, actualízalo antes de instalar ffmpeg-full.
Los cortes según Whisper se comen el final de la palabra
Whisper marcó que «platforms.» terminaba en 29,50 s, pero silencedetect mostraba que la voz seguía hasta 30,04 s. Cortar con el tiempo de Whisper (más un pequeño margen) dejó la palabra a medias: al volver a transcribir se oía «platform.». En este clip los bordes de palabra se desviaron hasta unos 0,5 s.
Lo que funcionó fue medir los silencios reales y ajustar cada borde a ellos (±0,1 s):
ffmpeg -i raw/talk.mp4 -af silencedetect=noise=-40dB:d=0.3 -f null -Otros lo han visto también. Aducti (1 de septiembre de 2026) cuenta que Whisper mete el silencio previo en la primera palabra de un segmento, unos 0,5 s, y lo corrige contrastando con silencedetect. La documentación de video-use indica que las marcas de Scribe se desvían entre 50 y 100 ms y recomienda un margen de 30 a 200 ms y cortar en silencios de al menos 400 ms. Si le pides a Claude Code que corte por transcripción, pídele también que ajuste los bordes a los silencios medidos.
auto-editor frente a Claude Code: cortar silencios no elimina la toma fallida
Con el mismo clip, auto-editor 31.7.2 (Homebrew) quitó los silencios en 3,9 s, pero el resultado duró 21,31 s porque conservó la toma fallida:
auto-editor raw/talk.mp4 --margin 0.2s -o ae31_cut.mp4 --no-openCon la versión 29.3.1 de pip el comportamiento fue el mismo, y su línea de tiempo exportada lo confirma: un clip de 152 fotogramas que empieza en el segundo 8,8, justo donde está la frase interrumpida. auto-editor corta por volumen o movimiento y no sabe que una frase con voz es un error; esa decisión necesita la transcripción, que es lo que aporta Claude. Aun así, es un buen primer paso gratuito y exporta líneas de tiempo para seguir en otro editor: --export premiere, --export resolve, --export final-cut-pro, --export shotcut o --export kdenlive. En la prueba, --export resolve generó un FCPXML que apunta al archivo original.
Instálalo con brew install auto-editor o con el binario de GitHub. Según su README, ya no se publica en pip: PyPI sigue ofreciendo la 29.3.1, de noviembre de 2025.
Nombres propios en los subtítulos: revisa marcas y personas
En la prueba, el mismo audio dio resultados distintos según el modelo y la herramienta:
- faster-whisper con
small.enescribió «clog code» donde se decía «Claude Code»;base.enacertó. Es una sola muestra: no indica que un modelo sea mejor que otro, sino que los nombres propios hay que revisarlos. - El filtro
whisperde ffmpeg-full, sin prompt, partió «Claude.» y «code.» en dos subtítulos. Además numera el SRT desde 0; si una plataforma rechaza el archivo, renumera desde 1. - El subcomando
whisperde auto-editor 31.7.2 acepta un prompt y con él escribió bien «Claude Code»:
auto-editor whisper raw/talk.mp4 ggml-base.en.bin -f srt --prompt "Claude Code" -o out.srtEse comando necesita el modelo ggml-base.en.bin (148 MB, del repositorio whisper.cpp en Hugging Face). Tardó 12,2 s, pero cada subtítulo terminaba exactamente 4–5 s después de empezar, así que sus finales no sirven como puntos de corte. Para cortar, usa marcas por palabra o silencedetect.
Si tu canal repite nombres de marcas, personas o productos, pásalos como prompt a la transcripción y pídele a Claude Code que compare los subtítulos con una lista de términos antes de incrustarlos.
Cuánto cuesta editar vídeos con Claude Code y qué parte es gratis
- Claude Code: necesitas un plan de pago o crédito de API; con Pro o Max consumes límite de uso en lugar de pagar por token. Precios por plan: Precio de Claude Code 2026: Pro, Max, Team, API y extra usage. La parte de vídeo cuesta poco si Claude lee transcripciones (céntimos de dólar por cada 10 minutos según el cálculo de arriba) y mucho si le mandas fotogramas.
- Transcripción en local (Whisper, faster-whisper, WhisperX, whisper.cpp): no se cobra por hora de audio. Paga tu CPU o tu GPU y tu tiempo de instalación.
- ElevenLabs Scribe, obligatorio para video-use: 0,22 $ por hora de audio en cualquier plan según la página de precios de la API de ElevenLabs; el plan gratuito incluye unas 4,5 horas.
- ChatCut: de 25 a 160 $ al mes, además de tu uso de Claude.
- auto-editor, ffmpeg, HyperFrames: gratis. Remotion es gratis hasta 3 empleados.
Así que «editar vídeos gratis con Claude Code» solo es cierto a medias: las herramientas pueden ser gratuitas y locales, pero Claude Code no lo es. Con metraje largo, el límite de uso es el que suele acabarse primero; el informe de Heimdex (5 de agosto de 2026) avisa de que más metraje implica más tokens y puede agotar los límites, y que compilar la transcripción local puede pedir varios GB de herramientas. Si notas que la cuota se va más rápido de lo esperado, mira ¿Consumo anormal de cuota en Claude Code Max? Guía completa de diagnóstico (2026).
Como referencia de tiempo, Aducti cuenta que un reel le lleva unos 10–15 minutos con revisiones, con su skill ya montada.
Lista de comprobación antes de publicar el corte
- Escucha cada punto de corte. Busca palabras cortadas, respiraciones a medias y chasquidos. Si aparecen, ajusta los bordes a los silencios de
silencedetect. - Confirma que se quedó la toma buena. Ni auto-editor ni la autoevaluación de video-use detectan si la toma conservada es la equivocada. Lee el guion del resultado.
- Revisa nombres propios y cifras en los subtítulos antes de incrustarlos; corregir un .srt es trivial, corregir un vídeo ya renderizado no.
- Pon los subtítulos al final. La documentación de video-use avisa de que los rótulos tapan los subtítulos si se aplican después, y Heimdex señala que cambiar un corte desplaza los gráficos sincronizados. Si cambias la lista de cortes, regenera subtítulos y rótulos.
- Mira el encuadre vertical. Un recorte centrado corta a quien se mueve o no está en el centro.
- Comprueba la fuente. Si la
FontNameno existe en tu sistema, el subtítulo puede no salir como esperas y ffmpeg no siempre avisa; video-use lo resume como «Fonts fail silently». - Pista o incrustados. Si la plataforma no muestra la pista de subtítulos del MP4, sube el .srt por separado o incrústalos.
- HEVC para iPhone. Si exportas en HEVC, Aducti indica que el iPhone exige la etiqueta
hvc1(-tag:v hvc1en ffmpeg).
Cuando el flujo te funcione, conviértelo en una skill con tus reglas (dónde cortar, altura del subtítulo, cuántos zooms como máximo) para no repetirlas en cada sesión: Claude Code: hooks, comandos de barra y skills, ¿cuál usar?. Si aún no tienes Claude Code, empieza por Cómo instalar Claude Code: guía completa de configuración para todas las plataformas (2026).
Preguntas frecuentes sobre editar vídeos con Claude Code
¿Qué skill de Claude se usa para editar vídeos?
No hay una skill oficial de Anthropic. La más extendida es video-use (MIT, casi 29.000 estrellas en GitHub a 15 de octubre de 2026), que exige una clave de ElevenLabs para transcribir. ButterCut es la alternativa local para Mac que entrega un premontaje en XML para tu editor. También puedes pedirle a Claude Code que escriba su propio guion con Whisper y ffmpeg, como en la prueba de esta guía.
¿Cómo editar con Claude Code un vídeo ya hecho?
Pon el archivo en una carpeta, transcríbelo con marcas de tiempo por palabra, pídele a Claude Code una lista de tramos a conservar, revísala y renderízala con ffmpeg. Termina con subtítulos y, si hace falta, una versión 9:16. Los cuatro pasos de la prueba sirven de plantilla.
¿Puede Claude Code editar vídeos en CapCut o Premiere?
En CapCut, no: ninguna de las herramientas descritas aquí lo controla, aunque puedes abrir en CapCut el MP4 o el .srt resultante. En Premiere y DaVinci Resolve hay dos caminos: importar una línea de tiempo exportada (auto-editor, ButterCut) o dejar que Claude Code maneje el editor mediante un MCP de la comunidad, que sirve para ensamblar y renderizar, no para decidir el corte.
¿Se pueden editar vídeos con Claude Code gratis?
Las herramientas, sí: ffmpeg, Whisper en local y auto-editor no cuestan nada. Claude Code, no: necesita un plan de pago o crédito de API. Con video-use se añade ElevenLabs Scribe, a 0,22 $ por hora de audio pasadas las horas incluidas en el plan gratuito.
¿Funciona igual con vídeos en español?
El flujo es el mismo, pero hay que usar un modelo de Whisper multilingüe (sin .en) o un motor de transcripción con español. La prueba descrita aquí se hizo con voz sintética en inglés, así que no dice nada de la precisión en español; revisa los subtítulos con más cuidado las primeras veces, sobre todo nombres propios y términos técnicos.
Fuentes17
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 15 oct 2026.
Fuentes17
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 15 oct 2026.
- 1.documentación de visión de Claudeplatform.claude.com/docs/en/build-with-claude/vision
- 2.referencia de herramientas de Claude Codecode.claude.com/docs/en/tools-reference
- 3.reseña de video-use en Habrhabr.com/ru/articles/1032374
- 4.guía de Fyve sobre edición de vídeo con Claude Codefyve.co.jp/claude-code/articles/claude-code-video-editing-start
- 5.video-usegithub.com/browser-use/video-use
- 6.auto-editorgithub.com/WyattBlue/auto-editor
- 7.ButterCutgithub.com/barefootford/buttercut
- 8.DaVinci Resolvegithub.com/samuelgursky/davinci-resolve-mcp
- 9.Premiere Progithub.com/hetpatel-11/Adobe_Premiere_Pro_MCP
- 10.Palmier Progithub.com/palmier-io/palmier-pro
- 11.Plugin de ChatCut para Claude Codechatcut.io/claude-code-plugin
- 12.claude-code-video-toolkitgithub.com/digitalsamba/claude-code-video-toolkit
- 13.HyperFramesgithub.com/heygen-com/hyperframes
- 14.licencia de Remotionremotion.pro/license
- 15.Aductiaducti.com/recursos/editar-videos-claude-code-skill
- 16.página de precios de la API de ElevenLabselevenlabs.io/pricing/api
- 17.informe de Heimdexblog.heimdex.co/post/claude-code-video-editing-automation-guide-ko