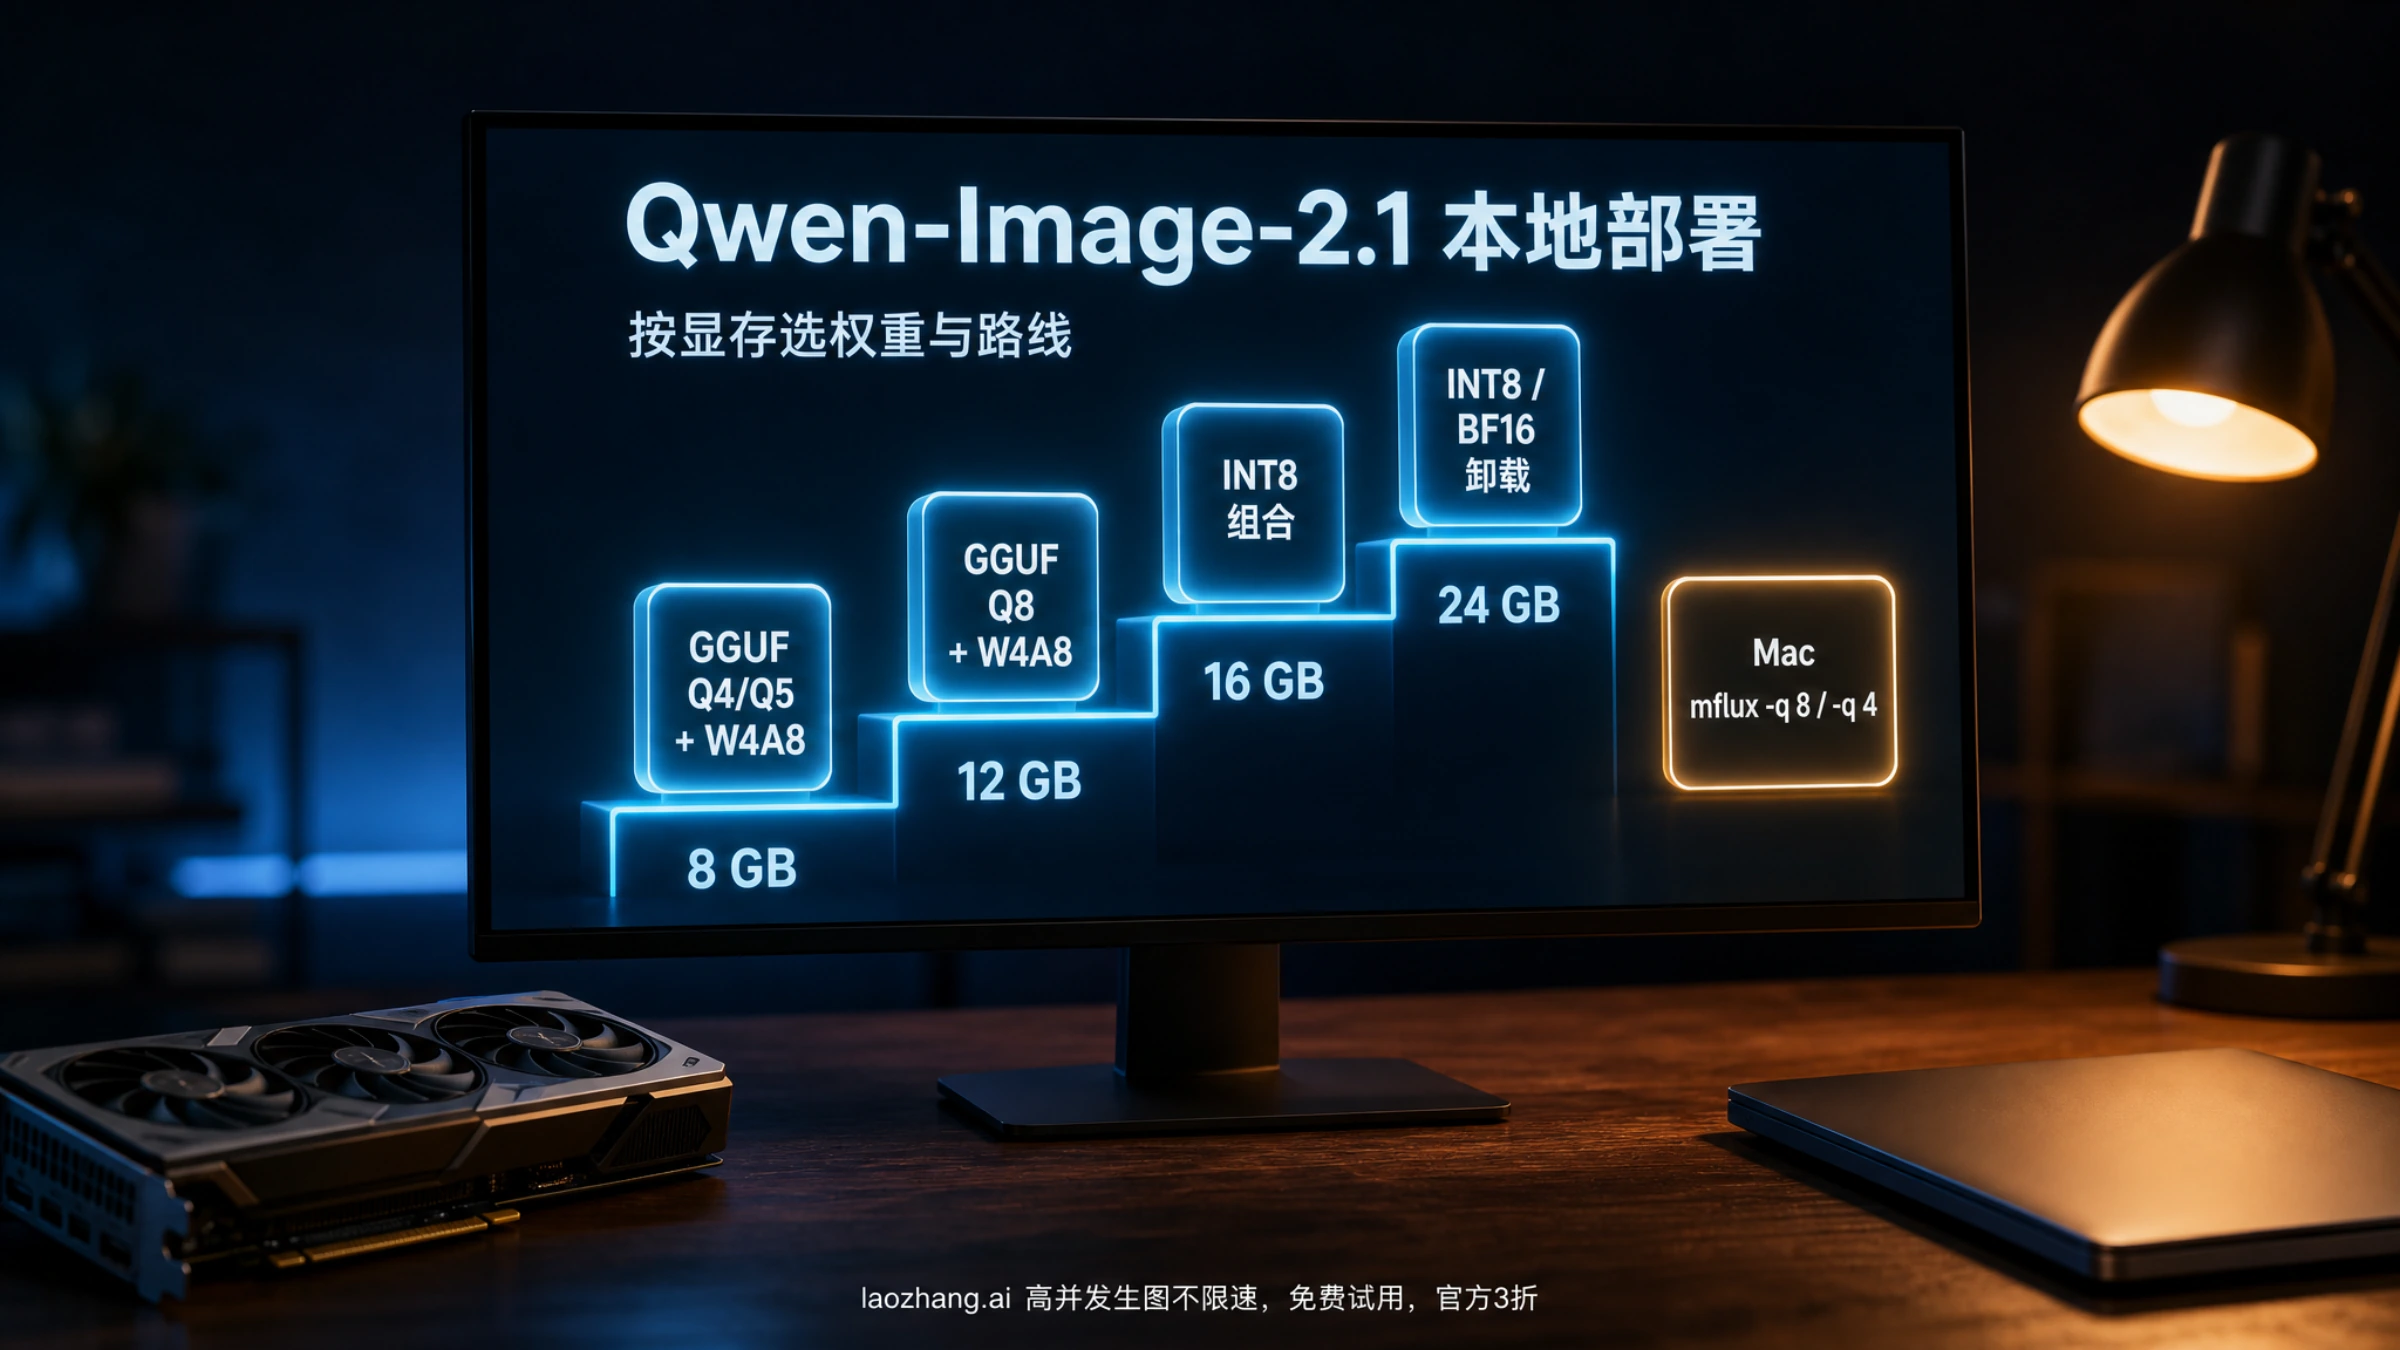
Qwen-Image-2.1 在 2026 年 9 月 20 日开源,一个模型同时做文生图、改图和透明背景图。它能不能在你的机器上跑,取决于三个文件加起来占多少显存:7B 参数的生成主干(DiT)、Qwen3-VL 8B 文本编码器和 RGBA VAE。官方 README 和 ComfyUI 教程都没有给出最低显存数字,所以下面的分档来自官方文件大小和第三方实测,每个数字都注明了来源和条件。GitHub README · ComfyUI 官方教程
先给结论,再展开每条路线:
| 你的硬件 | 建议路线 | 下载什么 | 磁盘占用(约) | 别人实测的显存/内存 |
|---|---|---|---|---|
| 24 GB 及以上(RTX 3090/4090/5090) | ComfyUI 原生,官方 INT8 组合;BF16 要靠卸载到内存 | qwen_image_2.1_int8_convrot + qwen3vl_8b_int8_convrot + VAE | 17.3 GB | INT8 组合折算约 16.1 GiB,RTX 4090 可常驻(ai.rs 计算);BF16 在 4090 上显存加系统内存合计约 30.2 GB,超出 24 GB(社区报告,见下文) |
| 16 GB(RTX 4060 Ti 16G、5070 Ti、4080) | ComfyUI 原生 INT8,或 W4A8 编码器 + INT8 主干 | 同上,或把编码器换成 qwen3vl_8b_w4a8 | 17.3 GB 或 14.3 GB | RTX 5070 Ti 16 GB,1024×1024、20 步,峰值约 13.9 GB(量化未注明,AIReiter 转述) |
| 12 GB(RTX 3060 12G、4070) | GGUF Q8_0 或 Q6_K 主干 + W4A8 编码器 | GGUF 文件 + qwen3vl_8b_w4a8 + VAE | 12.8–14.6 GB | 上传者建议 12 GB 以上用 Q8_0(建议,不是实测) |
| 8 GB(RTX 3060 8G、4060) | GGUF Q5_K_M/Q4_K_M + W4A8 编码器,先从 1024×1024 文生图试起 | GGUF 文件 + qwen3vl_8b_w4a8 + VAE | 11.6–11.9 GB | 三种说法冲突:4-bit 峰值约 7 GB(Diffusers nf4,Colab);上传者建议 Q5_K_M;日本作者用 Q4_K_M 输入图片时崩溃 |
| Mac(Apple Silicon) | mflux(MLX) | 官方权重按 -q 8 / -q 4 量化,或社区 MLX q4 包 | q4 包约 10.7 GB | M5 Max,1024×1024、40 步:bf16 峰值约 46 GB,-q 8 约 30.7 GB(PR 作者数据) |
磁盘数字来自 Hugging Face 与 ModelScope 接口返回的文件大小(十进制 GB),磁盘占用不等于显存占用。表中"实测"一列的每个数字在后文都有来源与条件;没有任何一行是官方要求。
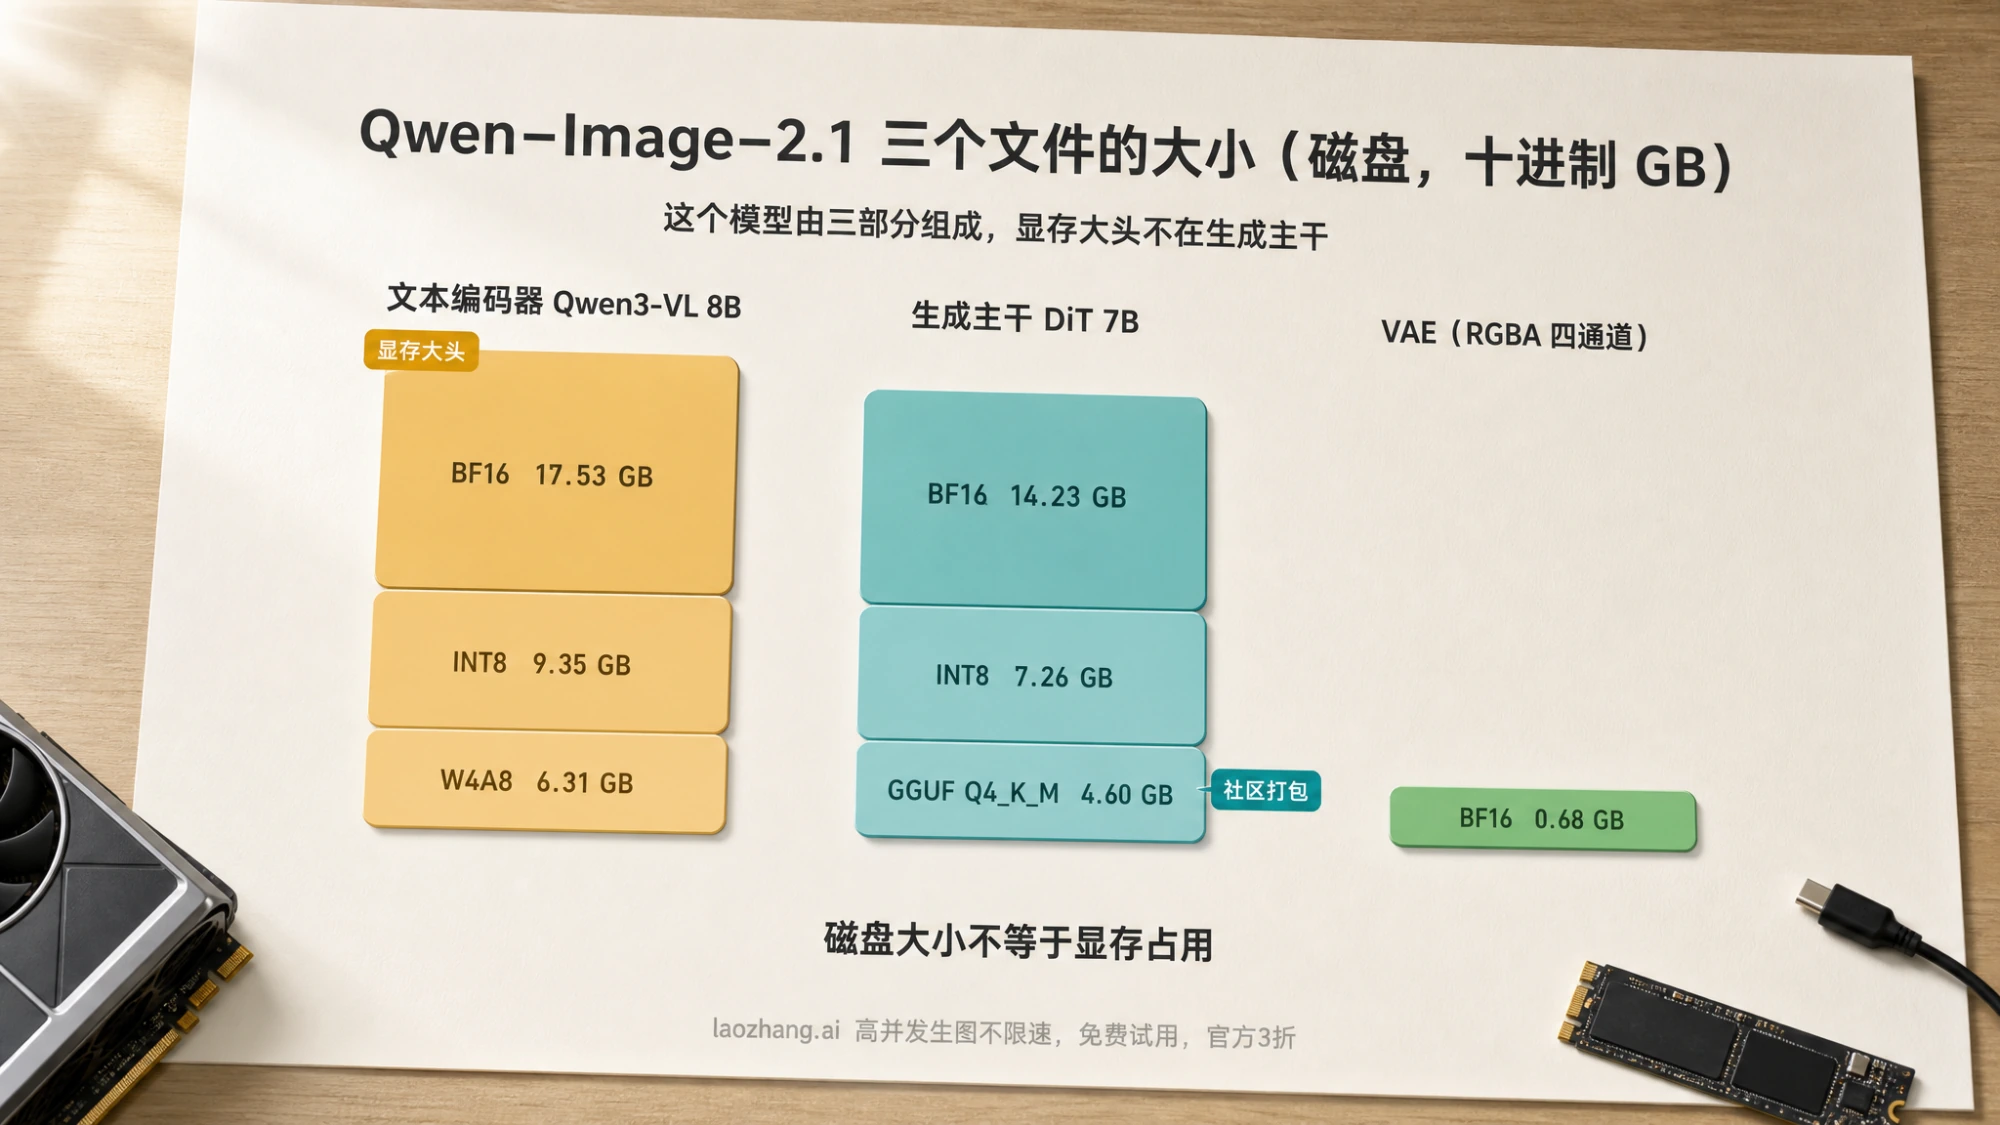
这个模型由三部分组成,显存大头不在生成主干
Qwen-Image-2.1 的视觉生成部分是 7B 参数、32 层单流 DiT;文本编码器是 Qwen3-VL 8B;VAE 是 64 通道的 RGBA 自编码器,16 倍空间压缩。它原生支持带透明通道的生成与编辑、从普通 RGB 照片里抠出主体、最多 10 张参考图、用圈选或涂抹指定局部编辑区域,也可以把原图和单独的蒙版作为两个输入。Qwen 官方博客
理解这个结构对选权重很重要:文本编码器(8B)比生成主干(7B)还大,官方 BF16 文件里编码器四个分片合计约 17.5 GB,主干两个分片约 14.2 GB。所以省显存的第一步通常是把编码器换成 INT8 或 W4A8 版本,而不是只盯着主干量化。vLLM-Omni 在数据中心卡上的测量也印证了这一点:把文本编码器量化到 FP8 节省约 6 GB,只量化 DiT 只省约 2 GB。vLLM-Omni recipe
另一个影响显存的机制是"混合粒度注意力 + 前缀 KV 缓存":参考图和指令在第一步编码一次,后续步骤复用(causal_condition: true 是默认值)。参考图越多、越大,第一步的编码与缓存占用就越高,8 GB 显卡上"文生图能跑、改图崩溃"的报告很可能与此有关。
国内下载:ModelScope 上有官方权重和 ComfyUI 权重
2026 年 9 月 22 日通过 ModelScope 接口核对,Qwen/Qwen-Image-2.1(Diffusers 完整仓库)和 Comfy-Org/Qwen-Image-2.1(ComfyUI 单文件权重)两个仓库都在 ModelScope 上,文件名和大小与 Hugging Face 一致。国内访问 Hugging Face 不稳定时,直接从 ModelScope 下载即可,不需要镜像站。ModelScope 模型页
ComfyUI 路线只需要三个文件,不要整仓库下载(Comfy-Org 仓库全部文件加起来超过 70 GB):
bashpip install -U modelscope
# 默认 INT8 组合:主干 7.26 GB + 编码器 9.35 GB + VAE 0.68 GB
# 语法按 modelscope 1.40.1 的 `modelscope download --help`:仓库 ID 与文件路径为位置参数
modelscope download Comfy-Org/Qwen-Image-2.1 \
  diffusion_models/qwen_image_2.1_int8_convrot.safetensors \
  text_encoders/qwen3vl_8b_int8_convrot.safetensors \
  vae/qwen_image_2.1_vae_bf16.safetensors \
  --local-dir ./ComfyUI/models
下载后的目录结构正好对应 ComfyUI 的 models/diffusion_models、models/text_encoders、models/vae。显存紧张的话把编码器换成 text_encoders/qwen3vl_8b_w4a8.safetensors(6.31 GB)。Diffusers 路线则下载整个 Qwen/Qwen-Image-2.1(约 33 GB),再把本地路径传给 from_pretrained。
Comfy-Org 仓库里的官方文件与大小(Hugging Face 接口,2026 年 9 月 22 日):
| 文件 | 大小 | 用途 |
|---|---|---|
diffusion_models/qwen_image_2.1_bf16.safetensors | 14.23 GB | 生成主干,BF16 |
diffusion_models/qwen_image_2.1_int8_convrot.safetensors | 7.26 GB | 生成主干,INT8(模板默认) |
text_encoders/qwen3vl_8b_bf16.safetensors | 17.53 GB | 文本编码器,BF16 |
text_encoders/qwen3vl_8b_int8_convrot.safetensors | 9.35 GB | 文本编码器,INT8(模板默认) |
text_encoders/qwen3vl_8b_w4a8.safetensors | 6.31 GB | 文本编码器,W4A8,最省显存的官方版本 |
text_encoders/qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors | 9.47 GB | 提示词改写模型(文生图),可选 |
text_encoders/qwen3.5_9b_qwen_image_2.1_pe_i2i.int8_convrot.safetensors | 9.47 GB | 提示词改写模型(改图),可选 |
vae/qwen_image_2.1_vae_bf16.safetensors | 0.68 GB | VAE,必需 |
两个 PE 文件从文件名看是提示词改写模型,ComfyUI 官方教程没有说明它们的接法;第一次跑通之前不用下。
ComfyUI 原生路线:三个文件、三个模板、25 步 cfg 1
这是大多数人的首选:官方 Day-0 支持,模板库里直接有工作流,不需要自定义节点。前提是 ComfyUI 必须更新到最新版,本地安装建议用 nightly(开发版),因为模板依赖的核心节点在稳定版里可能还没发布。ComfyUI 官方教程
步骤:
- 更新 ComfyUI,把上一节的三个文件放进对应目录。
- 打开模板库,搜索 Qwen Image 2.1,三个模板分别是 Qwen Image 2.1 Text to Image(文生图)、Qwen Image 2.1 Image Edit(改图)、Remove Background: Qwen Image 2.1(去背景)。
- 模板默认选中
qwen3vl_8b_int8_convrot+qwen_image_2.1_int8_convrot+qwen_image_2.1_vae_bf16。如果你下载的是 W4A8 编码器,在加载节点里手动换成它;BF16 版本教程明确说"需要更多显存"。 - 采样设置三个模板一致:steps 25、cfg 1、sampler euler、scheduler simple,默认目标约 4.0 MP(2048×2048)。8 GB 或 12 GB 显卡第一次跑先把分辨率降到 1024×1024,确认能出图再往上加。
- 点击运行。第一次运行会把编码器和主干都加载进显存,比后续生成慢得多;测速度要看第二张图开始的时间。
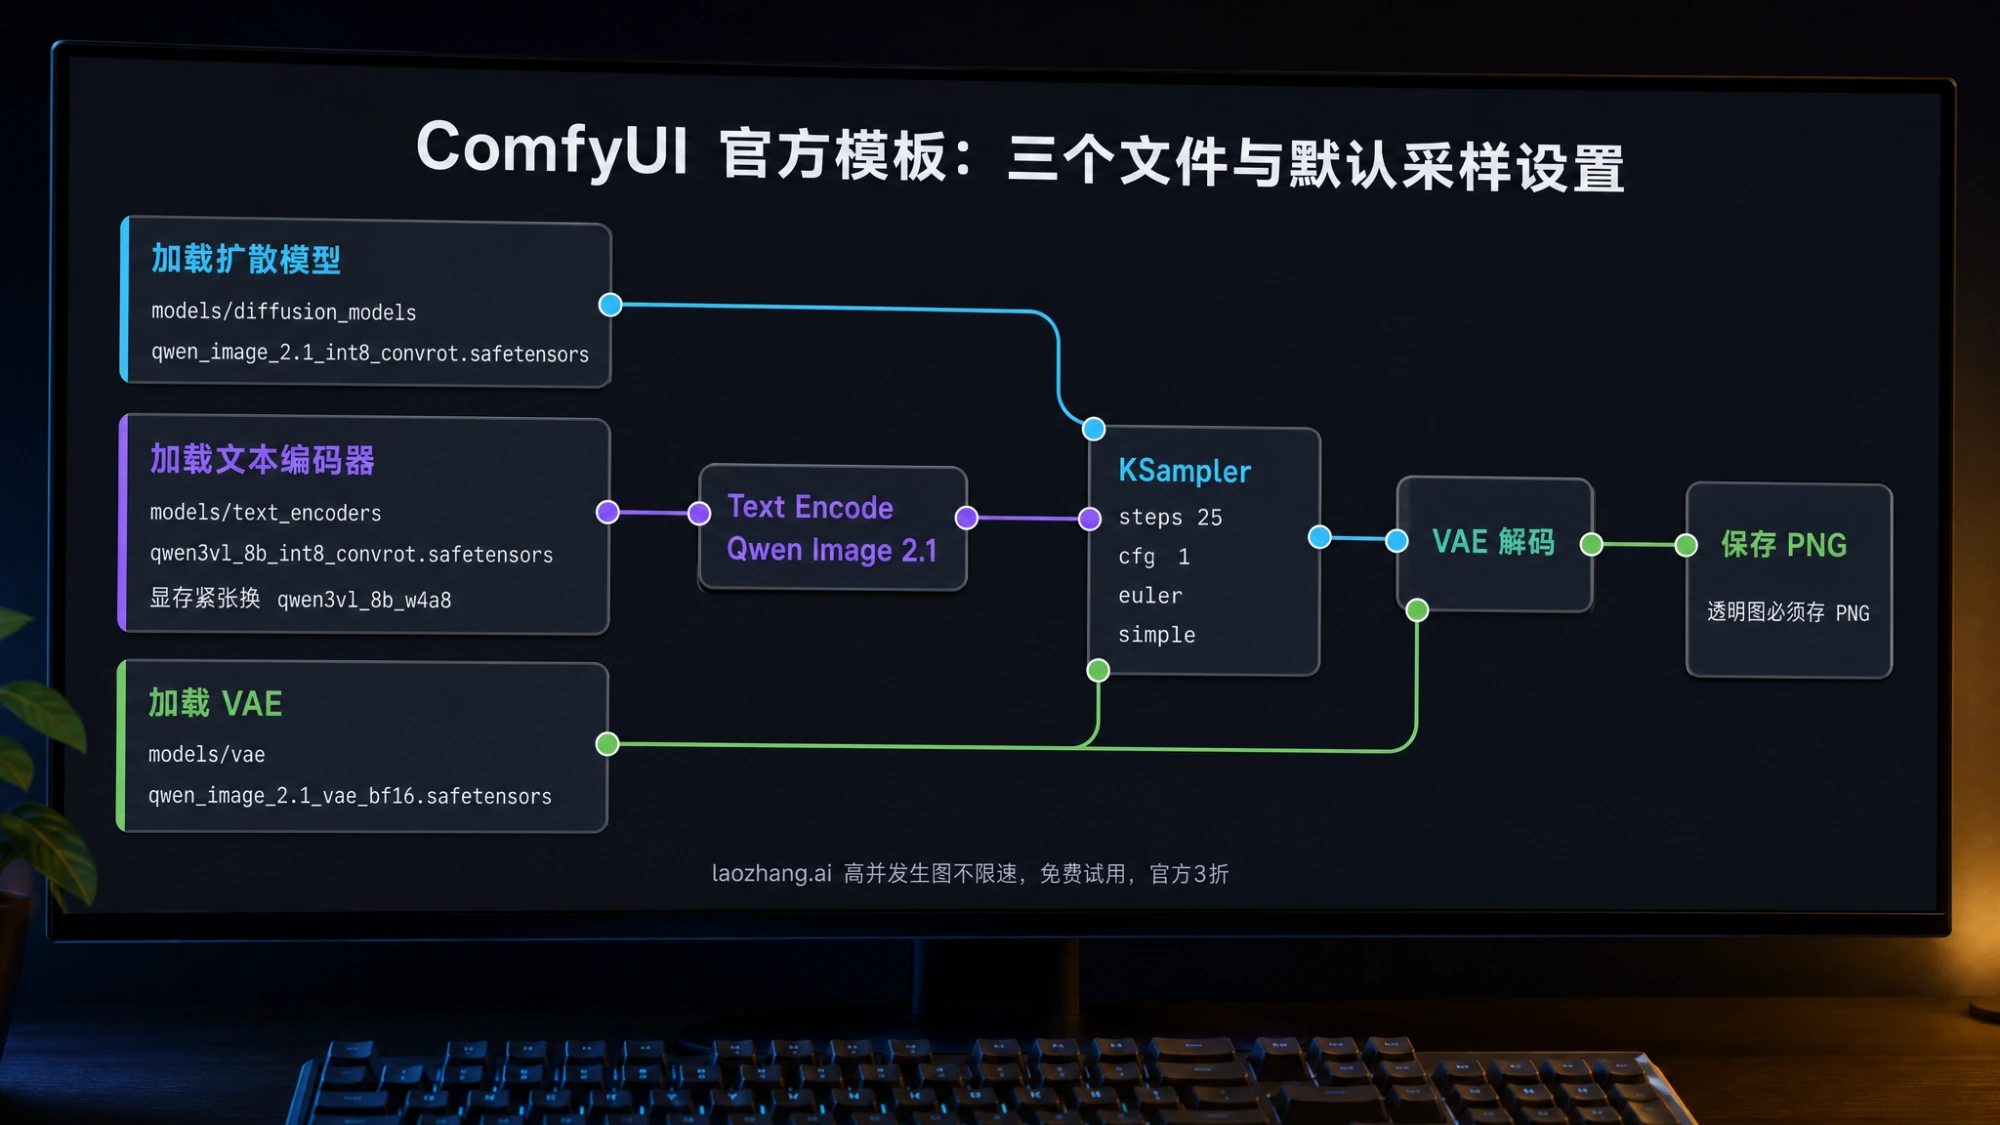
改图模板里,参考图按插槽顺序拼进文本编码器,提示词用编号引用,例如第一张图写作 <image1>。文本编码节点叫 Text Encode Qwen Image 2.1,在 model/conditioning/qwen image 分类下。
去背景模板本质上是改图工作流加一句固定提示词:Remove the background, and output a PNG image。因为 VAE 本身是四通道,输出直接带透明通道,不需要额外的抠图节点;保存时用 PNG,JPG 会丢掉透明信息。
GGUF 低显存路线:8 GB 显卡的三种说法要并列看
GGUF 是社区把生成主干重新打包的量化格式,只替换主干,文本编码器和 VAE 仍然用上一节的 safetensors 文件。截至 2026 年 9 月 22 日有两个仓库(都标注 quantized:Qwen/Qwen-Image-2.1,属于社区包,不是 Qwen 或 Comfy 官方):
| 仓库 | 量化 | 大小 |
|---|---|---|
| AlperKTS/Qwen-Image-2.1-GGUF(9 月 20 日) | Q5_K_M / Q6_K / Q8_0 | 4.89 / 5.84 / 7.62 GB |
| JohnsonHsu/Qwen-Image-2.1-GGUF(9 月 22 日) | Q4_0 / Q4_K_M / Q5_K_M / Q6_K / Q8_0 | 4.05 / 4.60 / 5.22 / 5.88 / 7.59 GB |
组合 Q4_K_M(4.60 GB)+ W4A8 编码器(6.31 GB)+ VAE(0.68 GB)约 11.6 GB 磁盘,是目前最小的 NVIDIA 路线。AlperKTS 模型卡
加载方式:
- 安装 ComfyUI-GGUF 自定义节点:进入
ComfyUI/custom_nodes,git clone https://github.com/city96/ComfyUI-GGUF,再 在 ComfyUI 的 Python 环境里pip install --upgrade gguf。 - 把 GGUF 文件放进
ComfyUI/models/unet(city96 README 指定的目录),编码器与 VAE 按上一节放置。 - 打开官方文生图模板,把加载主干的节点换成 Unet Loader (GGUF)(节点 ID
UnetLoaderGGUF,在 bootleg 分类下),其余不变。
如果报错 "Unknown model architecture!",说明你的 ComfyUI-GGUF 版本还不认识 Qwen-Image-2.1 的结构,先把节点更新到最新;一篇 9 月 21 日的记录称旧版会报这个错,并建议改用 leejet 分支。city96 的 README 在核对时还没有列出 Qwen-Image-2.1,兼容性取决于节点版本,不是模型文件坏了。ComfyUI-GGUF · 兼容性记录
关于 8 GB 显卡,三个来源的说法不一致,条件也不同,不能只信其中一个:
- 上传者建议(AlperKTS 模型卡):12 GB 以上用 Q8_0,8–12 GB 用 Q6_K,8 GB 用 Q5_K_M。这是建议,不是测量。
- Diffusers 4-bit 实测(Zenn 用户 kun432,Google Colab,9 月 21 日):对主干和编码器同时做 bitsandbytes nf4 量化,峰值约 7 GB。这是 Diffusers 路线的数字,不是 GGUF;也没有输入参考图。Zenn 记录
- 崩溃报告(negi-lab,作者自测):Q4_K_M 在 8 GB 上"理论上可行",但输入图片做改图时崩溃了。negi-lab 指南
把这三条放在一起,8 GB 显卡的合理预期是:1024×1024 的文生图大概率能跑(配 W4A8 编码器,主干 Q4/Q5),改图尤其是多张参考图或大图输入很可能超出显存。看到"8G 显存就能跑"的视频时,留意它演示的是文生图还是改图、分辨率多少、编码器用的哪个版本。Q4 级别有画质损失,上传者自己也这么说,具体先在哪类画面上露馅要自己试。
Diffusers 路线:40 步默认、offload 与 4-bit 的实测档位
Python 开发者或想接进自己脚本的人走 Diffusers。官方安装要求:torch>=2.4.0、transformers>=5.17、从 GitHub 安装最新 diffusers(支持来自 PR #14804,发布版可能还没包含),再加 accelerate 和 pillow。Hugging Face 模型卡
pythonimport torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1",          # 也可以填 ModelScope 下载后的本地目录
    torch_dtype=torch.bfloat16,
)
pipe.enable_model_cpu_offload()     # 显存不够时用这一行代替 .to("cuda")

image = pipe(
    prompt="一块霓虹灯招牌,写着“今晚营业”,雨夜街角,写实摄影",
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]
image.save("out.png")
改图只需要多传一个 image= 参数,可以是一张 PIL 图片,也可以是最多 10 张的列表。默认 40 步、默认分辨率 2048×2048;官方给的预设有 1:1 2048×2048、4:3 2400×1792、3:2 2528×1696、16:9 2752×1536 及对应竖版。注意 ComfyUI 模板默认 25 步,两条管线的默认值不同,不是谁写错了。
显存档位来自 Zenn 用户 kun432 在 Colab 上的一次测试(9 月 21 日,单人单次,数字是该次会话的峰值):
| 设置 | 峰值显存 | 备注 |
|---|---|---|
| BF16,不做任何优化(A100 80GB) | 约 31 GB | 与 vLLM-Omni 测的 34 GB 同一量级 |
enable_model_cpu_offload() | 约 17 GB | 16 GB 显卡仍然不够,需要再量化 |
| bitsandbytes nf4 4-bit(主干 + 编码器) | 约 7 GB | 8 GB 卡的希望所在,速度和画质有代价 |
同一测试的其他观察:A100 不做任何优化时跑 2048×2048、40 步约 1 分钟出头;L4(24 GB)即使开了 offload,不开 VAE 分块也会 OOM;而 vae.enable_tiling() 在 2048×2048 下出现了竖向条纹。所以 2048 大图在中端卡上要么降分辨率,要么接受分块的瑕疵。
提示词改写模型 Qwen/Qwen-Image-2.1-PE-T2I 和 -PE-I2I(后者约 18.8 GB)可以用 vLLM 或仓库里的 prompt_rewrite/ 本地跑;kun432 的记录说它明显改善了结果,包括非英语提示词。这是可选步骤,磁盘和显存都要另算。
Mac 路线:mflux 已合并支持,内存按 30–46 GB 准备
Apple Silicon 不走 CUDA,官方 README 也没提 MPS。目前可用的是 mflux(MLX 实现):PR #736 于 9 月 21 日合并,新增 mflux-generate-qwen-2.1 命令,支持文生图与图生图,-q 8 / -q 4 量化主干(文本编码器保持 bf16)。mflux PR #736
PR 作者在 M5 Max 上的数字:1024×1024、40 步、bf16 约 1.5 秒/步,整图约 78 秒,峰值统一内存约 46 GB;改用 -q 8 后约 30.7 GB。评审者在 M3 Ultra 上约 2.95 秒/步、整图约 2 分钟。这些是统一内存占用,不是显存;按这些数字,32 GB 机型至少要用 -q 4,而且目前没有可核验的成功记录,16 GB 机型更没有。negi-lab 的看法是 32 GB 机型可用内存只剩约 20 GB,建议 64 GB。
该 PR 明确推迟了改图指令版本、LoRA 和前缀 KV 缓存;后续 PR #741 的标题称加入了参考图编辑、RGBA 与前缀缓存,本文未核对其内容,装之前看一下 mflux 的当前发布说明。社区还有一个 MLX q4 打包(toxicdog/Qwen-Image-2.1-MLX):主干 4.00 GB + 编码器 6.02 GB + VAE 0.68 GB,约 10.7 GB。Draw Things 对 2.1 的支持没有核实到,它公开的说明只覆盖 Qwen Image 1.0。
速度预期:把冷启动和整图分开报
社区讨论里有人指出,本地生图速度要拆成冷启动(首次加载模型)、首步和整图三段,很多视频只报最好看的那一个。目前能查到的整图时间(都是第三方,条件已注明):
- RTX 5070 Ti 16 GB,1024×1024、20 步:约 25 秒(AIReiter 转述 X 用户报告,量化未注明)。
- RTX 4090,BF16:1024×1024 约 21 秒,1536×1536 约 56 秒,步数未注明;显存系统合计约 30.2 GB(同一来源转述)。AIReiter 汇总
- RTX 5090,SGLang-Diffusion,1024 px、40 步:14.12 秒(编码器流式卸载)对 19.95 秒(DiT 流式卸载),厂商 cookbook 单卡测量。SGLang cookbook
- A100 80 GB(Colab,无优化),2048×2048、40 步:约 1 分钟出头(kun432)。
- M5 Max,1024×1024、40 步:约 78 秒(mflux PR 作者)。
如果你要的是服务化、批量任务而不是单机出图,SGLang-Diffusion 给了 24 GB 和 32 GB 卡的参数:RTX 4090 用 --performance-mode manual --dit-layerwise-offload true --text-encoder-cpu-offload true,RTX 5090 用 --performance-mode manual --component-residency text_encoder=layerwise-offload;透明图通过 "background": "transparent" 参数,改图走 /v1/images/edits 上传 PNG。vLLM-Omni 只支持 NVIDIA,并且它公布的测量是在 GB200/GB300 上做的,不是消费级卡的参考。
透明图与改图:提示词和输出格式的两个细节
透明图(RGBA)在 ComfyUI、Diffusers、SGLang 上都能出(mflux 在 PR #736 时还没有),关键是提示词和格式。Diffusers 的官方模板是固定句式:
textThis is an RGBA image with transparency. <你的描述>. The image has alpha channel and the background is transparent.
保存必须用 PNG。ComfyUI 直接用去背景模板或在改图模板里写同样的意思;SGLang 用 "background": "transparent"。CSDN 上的中文部署指南也提到同样的要点:提示词里要出现 RGBA、alpha channel、transparent background 这些词,并存成 PNG。CSDN 部署指南
局部改图有三种指定区域的方式:在原图上圈出区域、涂抹区域,或者原图 + 单独的蒙版作为两个输入。参考图最多 10 张,但每多一张都会增加编码与缓存占用,8–12 GB 显卡建议从一张参考图、1024 分辨率开始。如果你在比较不同的改图工具,本站另有一篇图生图与改图工具路线概览。
许可证:研究许可、非商用,输出权只有社交媒体声明
这是本地部署前最容易被忽略、也最影响后果的一点。Qwen-Image-2.1 的权重采用 Qwen RESEARCH LICENSE AGREEMENT,授权范围是"仅限非商业目的"(研究或评估);条文写明"未取得单独的商业许可,不得将材料用于任何商业目的",联系邮箱是 model-business@notice.qwencloud.com。再分发或修改后的版本必须附带协议、标注修改、保留声明,并标示 "Built with Qwen" 或 "Improved using Qwen",且不能用 "Qwen" 作为衍生模型的主名称。LICENSE 原文
几个直接影响读者的推论:
- 上一代 Qwen-Image-2512 是 Apache-2.0,2.1 不是。看到"Qwen 开源可商用"的旧印象要更新。
- 社区 GGUF、MLX 打包属于衍生物,同样在这份许可证之下(它们的模型卡标注
license:other),不会因为换了格式就变成可商用。 - 许可证正文没有关于生成图片归属的条款。Qwen 开发者账号在 9 月 21 日的 X 帖子里表示生成结果不属于被许可的"材料",用户保留对生成图片的权利——这是社交媒体声明,本文只看到搜索摘要,未读到原帖;Hugging Face 讨论区有人回应"一条帖子不能覆盖 LICENSE 文件"。谨慎的做法是:个人研究和评估随便用,把模型跑成商业服务或用产出物做商业用途之前,先取得单独商业许可或书面确认。Hugging Face 讨论 #6
- 个人爱好者使用算不算"研究或评估",社区有争议,本文不能替你下法律结论。
搜索结果里常见的"整合包"和"越狱版/无审查版":整合包通常是把 ComfyUI、节点和上面这些官方或社区权重打在一起,方便但你要自己确认里面的文件来源和版本;"无审查版"是第三方改过的权重,本文不推荐,它同样受研究许可证约束,而且来源不透明。
跑不动或要商用时的下一步
硬件够不到或需要商用授权时,有三种代替方式,各自条件不同:
- 先试效果再决定下载:Hugging Face 上有官方 Space
Qwen/Qwen-Image-2.1,可以直接在线出图,国内访问可能需要耐心;ModelScope 的 DiffSynth-Studio 提供在线生成与 LoRA 训练入口。HF Space - 换一张显卡:从上面的分档看,16 GB 是"不折腾就能跑 INT8 组合"的起点,24 GB 才能舒服地跑 BF16 和多参考图改图。如果你在为本地 AI 选 16 GB 卡,可以参考本站的16 GB 显卡本地运行选购分析。
- 改用可商用的托管图像模型:截至 2026 年 9 月 22 日,laozhang.ai 的模型目录里没有 Qwen 图像模型,不要指望在那里调用 Qwen-Image-2.1;它列出的图像模型包括
gemini-3.1-flash-image(0.055 美元/次)、flux-2-pro(0.03 美元/次)、seedream-5-0-260128(0.035 美元/次)和按 token 计费的gpt-image-2.5-flare/gpt-image-2.5-sunburst(每百万输入 token 5 美元、每百万输出 token 30 美元),以上均为美元标价,随时可能变,以模型目录当日显示为准。Qwen-Image-3.0 有官方托管 API,但本文没有核实到其价格,不引用。ComfyUI 用户如果想在同一工作流里混用远程模型,可以看ComfyUI 使用 GPT Image 2.5 官方节点。
常见问题
8 GB 显存到底能不能跑 Qwen-Image-2.1?
文生图大概率能,改图不保证。可核验的依据是:Diffusers 4-bit(nf4)实测峰值约 7 GB(Colab,无参考图);GGUF 上传者建议 8 GB 用 Q5_K_M;一位作者用 Q4_K_M 在 8 GB 上做改图时崩溃。配置上用 W4A8 文本编码器 + Q4/Q5 主干,从 1024×1024 文生图开始,改图从一张小参考图试起。
ComfyUI 最少要下载哪几个文件?
三个:qwen_image_2.1_int8_convrot.safetensors(7.26 GB,放 models/diffusion_models)、qwen3vl_8b_int8_convrot.safetensors(9.35 GB,放 models/text_encoders)、qwen_image_2.1_vae_bf16.safetensors(0.68 GB,放 models/vae),合计约 17.3 GB。显存紧张时把编码器换成 6.31 GB 的 qwen3vl_8b_w4a8。国内从 ModelScope 的 Comfy-Org/Qwen-Image-2.1 仓库下载即可。
ComfyUI 和 Diffusers 该选哪个?
想直接出图、做改图和透明图、不写代码,选 ComfyUI,官方模板默认 25 步 cfg 1;要接进 Python 脚本、批处理或研究,选 Diffusers,默认 40 步,enable_model_cpu_offload() 后约 17 GB,再配 bitsandbytes 4-bit 可到约 7 GB;要做 API 服务,看 SGLang-Diffusion 或 vLLM-Omni(仅 NVIDIA)。
生成的图片能商用吗?
模型权重是研究许可证,非商用;商业使用需要向 Qwen 团队申请单独许可。生成图片的归属在许可证里没写,Qwen 团队在 X 上表示用户保留对生成图片的权利,但那不是许可证条款。商业项目在没有书面确认前不要把本地跑出的图当作已授权。
透明背景图怎么出?
提示词要写明这是带透明通道的 RGBA 图、背景透明(Diffusers 有固定句式),保存为 PNG。ComfyUI 直接用 "Remove Background: Qwen Image 2.1" 模板,VAE 是四通道,不需要额外抠图节点。
Mac 需要多少内存?
mflux 作者在 M5 Max 上的数据:1024×1024、40 步,bf16 峰值约 46 GB,-q 8 约 30.7 GB。32 GB 机型只能尝试 -q 4,64 GB 更稳妥;改图和参考图功能在核对时刚合并或尚未合并,先看 mflux 的最新发布说明。