MiniMax M3.1 Flash 参数量与显存:428B、252 GB,各量化版怎么选
MiniMax M3.1 Flash 约 428B 参数、官方权重 252.4 GB,不是小模型。多卡服务器跑官方版,Mac 用 MLX,单卡加大内存试 GGUF,否则用 API。
文章目录
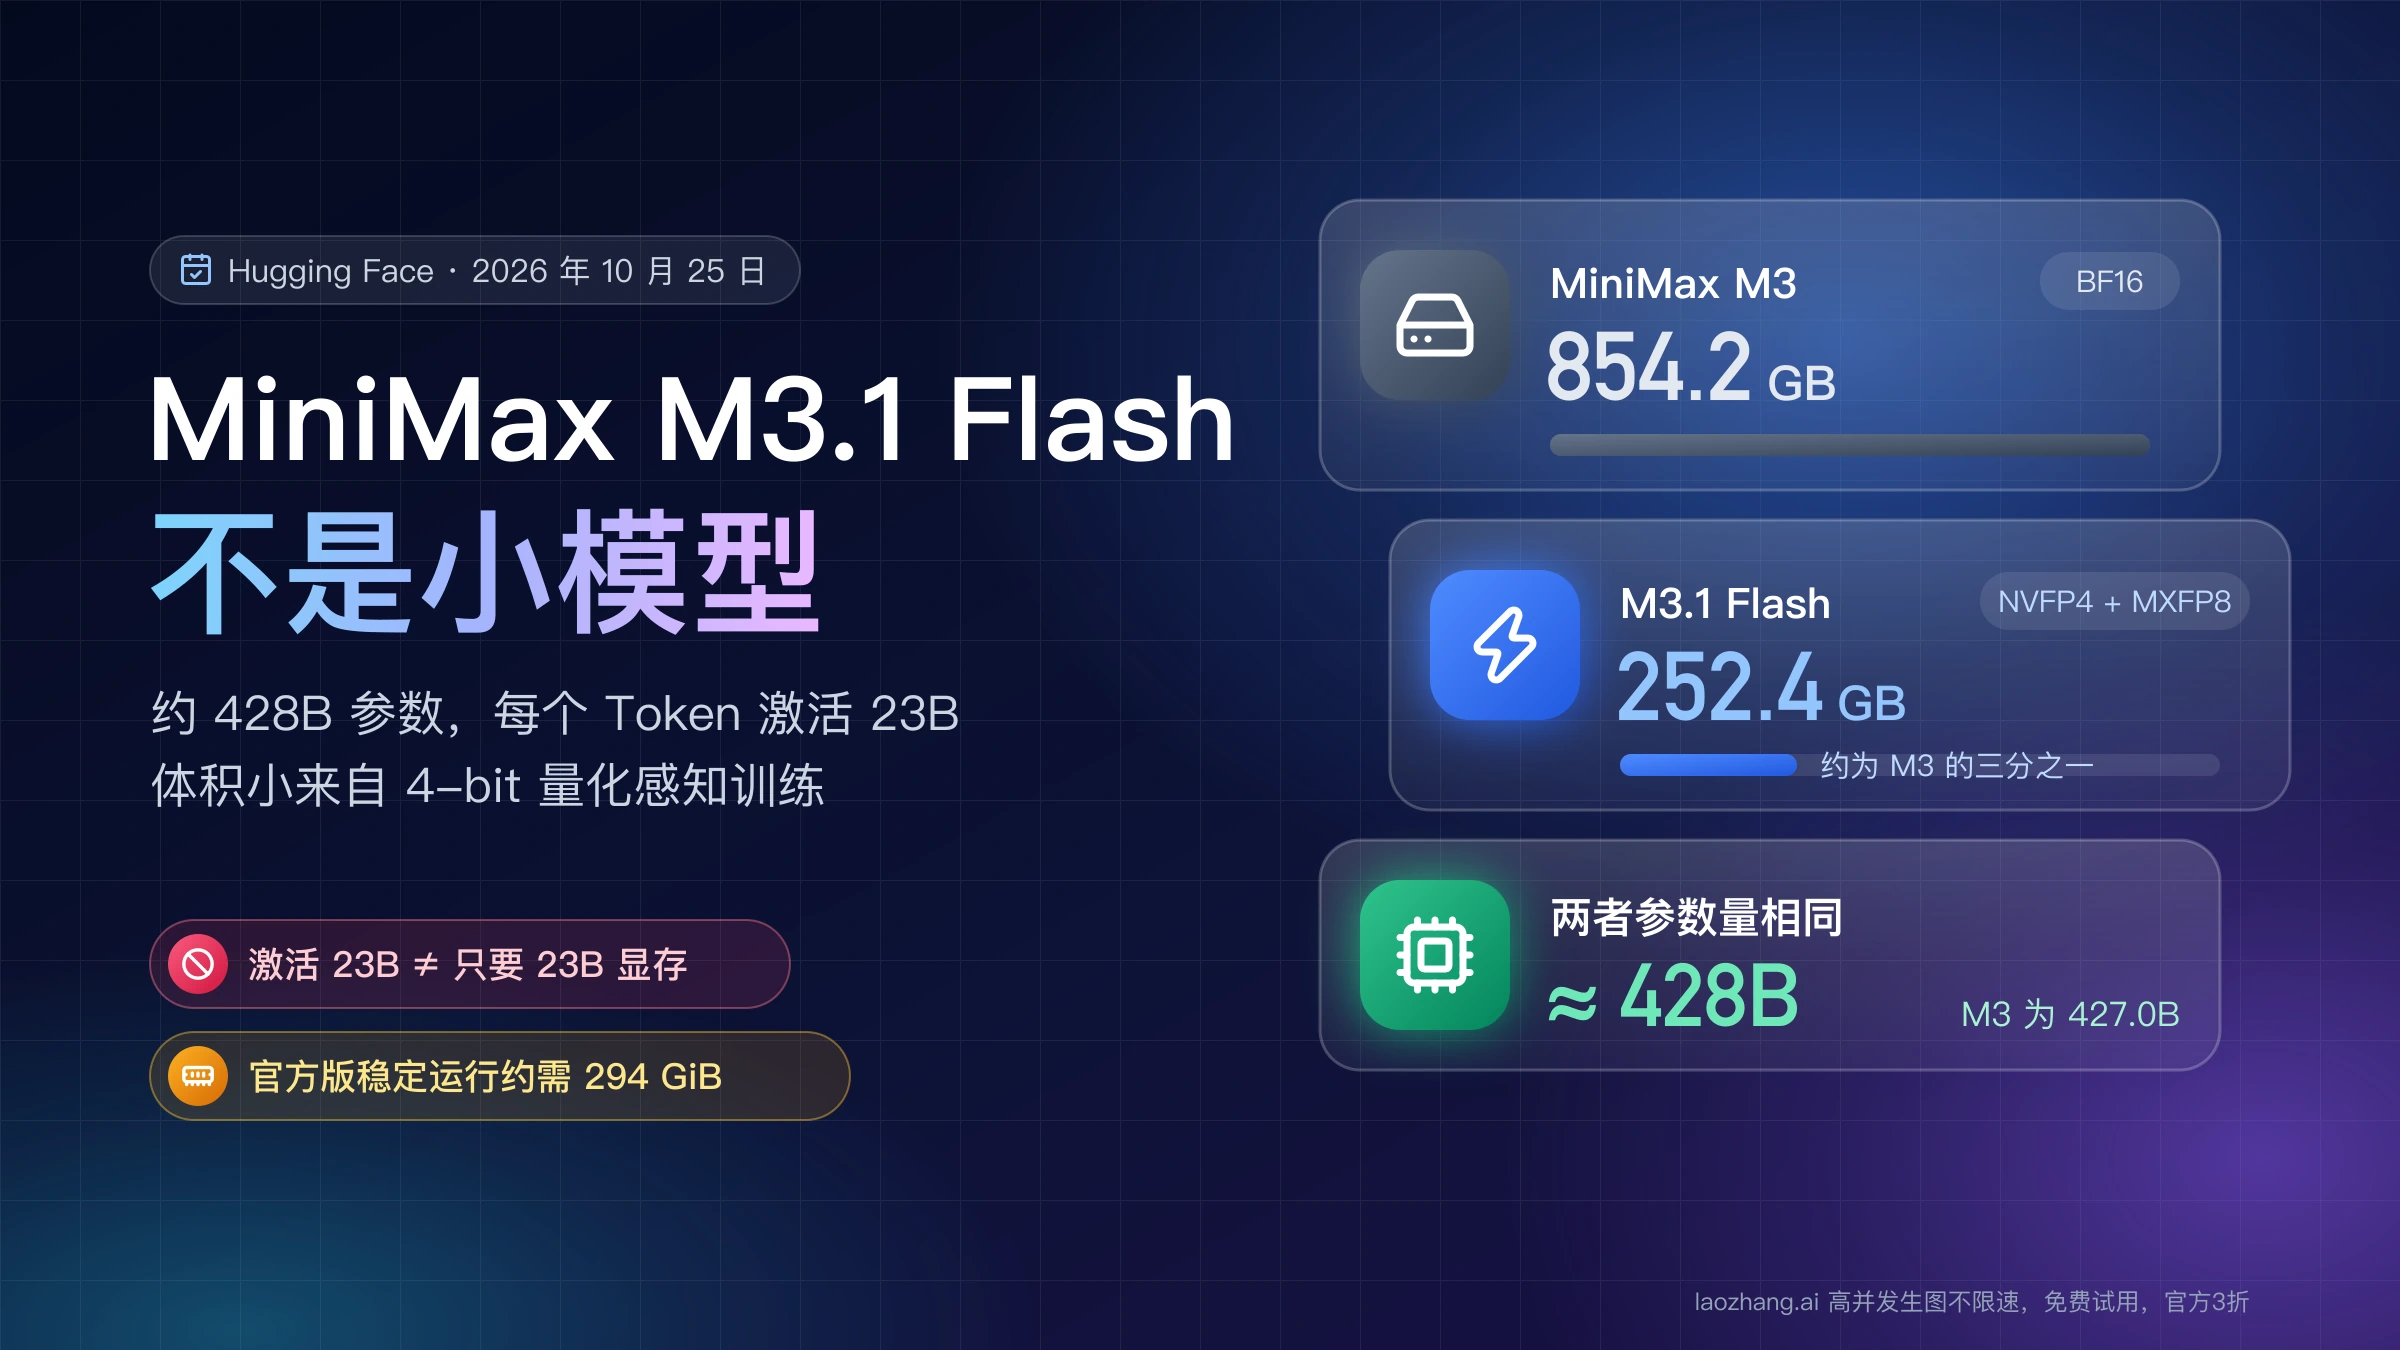
MiniMax M3.1 Flash 的规模和 MiniMax M3 一样:总参数约 428B,每个 Token 激活约 23B。Hugging Face 上的官方仓库 MiniMaxAI/MiniMax-M3.1-Flash 截至 2026 年 10 月 25 日合计 252.4 GB,其中主权重 250.1 GB、DSpark 草稿模型 2.3 GB。名字里的 Flash 指的是 4-bit 量化感知训练带来的更便宜、更快,不是参数更少;激活 23B 也不等于只要 23B 的显存,428B 参数都得放进显存或内存。
按手上的硬件选:4 卡 B200/B300 或 8 卡 H100/H200 的服务器,直接下载官方仓库,用 vLLM 0.33.0 以上运行;国产加速卡用 FlagOS 的 W8A8 版本(约 431 GB);512 GB 的 Mac Studio 用 mlx-community 的 4-bit 版,256 GB 的用 3-bit 版;一张 32 GB 显卡加 128 GB 以上内存,只能试 Unsloth 的低比特 GGUF,而且 llama.cpp 必须是 b11861 或更新的版本。连这一档都够不上,就别下载 120–260 GB 的文件了,直接用 MiniMax API 或阿里云百炼。
实际做过的检查只有计算类:2026 年 10 月 25 日用 Hugging Face 公开 API 读取了官方仓库、7 个衍生仓库和 MiniMax M3 仓库的文件清单并汇总体积,按官方 config.json 复算了参数量,再拿文件体积和常见硬件的显存、内存容量逐一对照。没有下载权重,也没有在本地跑推理,下文出现的速度数字都来自框架文档或社区报告,各自标明出处。
MiniMax M3.1 Flash 参数量:约 428B,Flash 不代表小模型
MiniMax 在 Hugging Face 官方模型卡里写的是"约 428B 总参数,每个 Token 激活 23B",原生多模态,输入支持文本、图片和视频,输出文本,上下文最长 1,000,000 Token。它是混合专家模型(MoE):每层 128 个路由专家,每个 Token 只走其中 4 个,再加 1 个共享专家,所以每步计算量接近一个 23B 的模型,但推理时 128 个专家都要常驻显存或内存,占地按 428B 算。
和 MiniMax M3 放在一起看最清楚。截至 2026 年 10 月 25 日,Hugging Face API 显示 MiniMaxAI/MiniMax-M3 的权重是 BF16,合计 427.0B 参数、854.2 GB;M3.1 Flash 参数量相同,下载体积却只有 252.4 GB,约为 M3 的三分之一。差别来自精度:模型卡说 M3.1 Flash 在训练阶段就对路由专家和注意力路径做了量化(量化感知训练,QAT),config.json 里路由专家存成 NVFP4(4-bit),注意力和稠密层是 MXFP8(8-bit),词嵌入、输出头和视觉编码器保持 BF16。所以 MiniMax 没有为 M3.1 Flash 发布 BF16 版本,按 BF16 推算出的约 856 GB 只是理论值,没有对应的下载文件。
仓库里的 dspark/ 目录是 2.3 GB 的 DSpark 草稿模型,用于投机解码,它取代了 M3 时期类似 EAGLE 的 MTP 方案。基本推理用不到它,但 vLLM 在 Blackwell 和 AMD 上的示例配置会自动从这个目录加载,整仓下载即可,不必单独处理。
Hugging Face 为什么显示 220B:两个 4-bit 参数挤在一个字节里
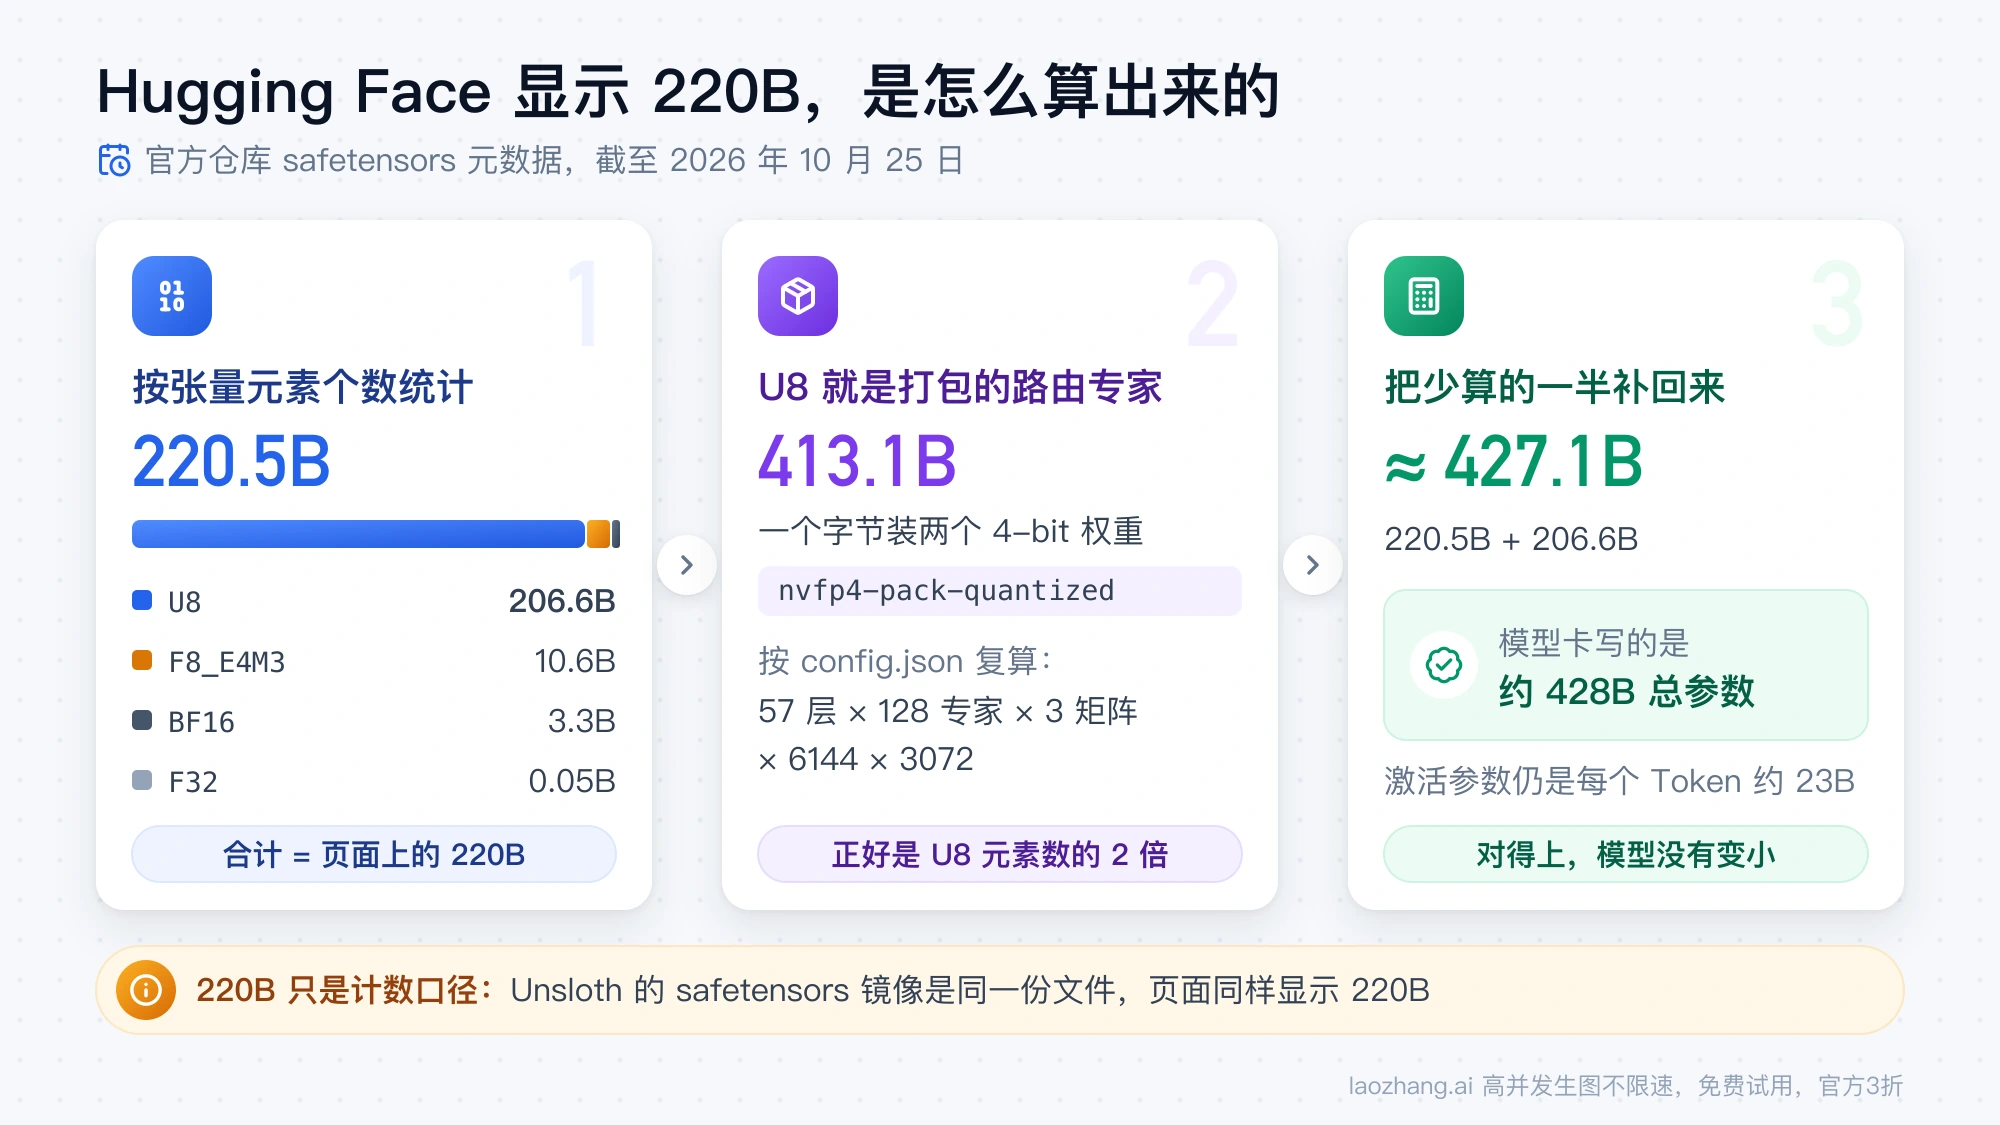
Hugging Face 页面上 MiniMax-M3.1-Flash 显示的"220B params"是按张量元素个数统计出来的,4-bit 专家被打包存储,所以少算了一半,模型本身并没有变小。截至 2026 年 10 月 25 日,官方仓库的 safetensors 元数据按数据类型列出:U8 206,561,083,392 个元素、F8_E4M3 10,560,208,896 个、BF16 3,323,222,528 个、F32 46,339,200 个,合计 220,490,854,016,也就是页面上的 220B。
其中 U8 张量就是路由专家:索引里的名字是 experts.N.w1/w2/w3.weight_packed,config.json 写的格式是 nvfp4-pack-quantized,每个字节装两个 4-bit 权重。按 config.json 复算,路由专家的参数量是 57 层 MoE × 128 个专家 × 3 个矩阵 × 6144 × 3072 = 413,122,166,784,正好等于 U8 元素数的 2 倍。把这部分按 2 倍计回去,总数是 220.5B + 206.6B ≈ 427.1B,和模型卡的 428B 对得上。Unsloth 的 safetensors 镜像 unsloth/MiniMax-M3.1-Flash 是同一份文件,页面上同样显示 220B。
如果在某些模型数据库里看到"MiniMax 未公开 M3.1 Flash 参数量",那是 10 月 23 日开放权重之前的信息,权重和 config.json 现在都能直接下载核对。
Hugging Face 上各版本多大:官方 252.4 GB,GGUF 最小 129.4 GB
截至 2026 年 10 月 25 日,在 Hugging Face 搜 MiniMax-M3.1-Flash 能找到 49 个仓库,真正值得看的是下表这几个。体积是用 Hugging Face API 把每个仓库(或每个量化文件夹)的 .safetensors、.gguf 文件大小加起来得到的,GB 是十进制,和 Hugging Face 页面的显示口径一致;括号里的 GiB 是二进制,和显存、内存的容量口径一致,比较"装不装得下"时看 GiB。
| 仓库 | 量化格式 | 体积 GB(GiB) | 运行平台与引擎 |
|---|---|---|---|
MiniMaxAI/MiniMax-M3.1-Flash(官方) | NVFP4 专家 + MXFP8 | 250.1(232.9),另加 DSpark 2.3 | NVIDIA Blackwell、Hopper,AMD MI355X;vLLM ≥ 0.33.0、SGLang |
amd/MiniMax-M3.1-Flash-Quark-MXFP4 | MXFP4 | 237.2(220.9),另加 DSpark 2.3 | AMD MI350X / MI355X;SGLang |
FlagRelease/MiniMax-M3.1-Flash-W8A8-nvidia-FlagOS-Express | W8A8 | 430.9(401.3),另加 DSpark 2.3 | FlagOS 的 vLLM-plugin-FL;其他 8 家芯片各有对应仓库 |
mlx-community/MiniMax-M3.1-Flash-Text-4bit | MLX 4-bit,仅文本 | 248.4(231.3) | Apple Silicon;MLX |
mlx-community/MiniMax-M3.1-Flash-Text-3bit | MLX 3-bit,仅文本 | 186.5(173.7) | Apple Silicon;MLX |
unsloth/MiniMax-M3.1-Flash-GGUF UD-Q8_K_XL | GGUF | 259.1(241.3) | llama.cpp ≥ b11861,CPU/GPU 混合 |
| 同上 UD-Q4_K_XL | GGUF | 249.4(232.3) | 同上 |
| 同上 UD-Q3_K_XL | GGUF | 194.0(180.6) | 同上 |
| 同上 UD-IQ3_S | GGUF | 175.5(163.4) | 同上 |
| 同上 UD-IQ3_XXS | GGUF | 160.0(149.1) | 同上 |
| 同上 UD-Q2_K_XL | GGUF | 143.9(134.0) | 同上 |
| 同上 UD-IQ2_XXS | GGUF | 134.9(125.7) | 同上 |
| 同上 UD-IQ1_M | GGUF | 129.4(120.5) | 同上 |
表里最容易误判的是 GGUF 的 4-bit 档:UD-Q4_K_XL 是 249.4 GB,几乎和官方检查点一样大,因为官方的路由专家本来就是 4-bit,转成 Q4 不会再省多少空间;从 Q4 到 Q8_K_XL 文件也只多 9.7 GB。所以想靠 GGUF 明显减小体积,要降到 3-bit 及以下,代价是精度。GGUF 版要读图片的话,还要另外下载 3.5 GB 的 mmproj-F32.gguf 视觉投影文件;MLX 的两个 Text 版本只有文本能力。
这些第三方量化的质量都没有公开评测,模型卡也提醒跑分只对应官方权重,第三方量化的结果可能不同。Unsloth 的 GGUF 仓库 README 第一行截至 10 月 25 日仍是"Work in progress",量化档位和文件还可能变动,下载前再看一眼文件列表。另有一个社区剪枝版 primitive-ai/MiniMax-M3.1-Flash-pruned-272B-NVFP4(162.9 GB),砍掉了部分专家,属于另一种模型,不能当作官方版的小号;名字里带 uncensored、abliterated 的仓库也不在推荐之列。
本地部署要多少显存:装下 235 GiB 权重之外还要留余量
只看权重,官方版加 DSpark 一共 235.0 GiB,要稳定运行至少需要约 294 GiB 的显存或统一内存。这个数是按"权重不超过总容量 80%"算的,剩下 20% 留给 KV cache、激活值、CUDA graph 和系统,这个 80% 是经验假设,不是 MiniMax 或 vLLM 给的数字;上下文开得越长、并发越多,需要的余量越大。2026 年 10 月 25 日按这个规则,把各版本体积和常见硬件的标称容量对照,结果如下:
| 硬件(标称总容量) | 能装下并留出余量的版本 | 推荐引擎 |
|---|---|---|
| 4 × B200(768 GB)、4 × B300(1,152 GB) | 官方版 | vLLM TP4 或 SGLang,原生 NVFP4,可开 DSpark |
| 8 × H100(640 GB)、8 × H200 | 官方版 | vLLM TP8,Marlin 内核,不开 DSpark |
| 4 × H200(564 GB) | 容量够放官方版 | vLLM 的 Hopper 示例要求整机 TP8,4 卡没有官方配方 |
| 国产加速卡 8 卡服务器 | FlagOS W8A8(403.4 GiB,需约 504 GiB 以上) | FlagOS 镜像或 vLLM-plugin-FL |
| Mac Studio 512 GB | MLX 4-bit,所有 GGUF 档位 | MLX 或 llama.cpp;官方版不能在 Mac 上跑 |
| Mac Studio 256 GB、2 台 DGX Spark(256 GB) | MLX 3-bit,GGUF UD-Q3_K_XL 及更小的档位 | Mac 用 MLX 或 llama.cpp;DGX Spark 要跨两台机器拆分模型;4-bit 版只够放权重,没有余量 |
| 4 × RTX 5090(128 GB)、1 台 DGX Spark(128 GB) | 只有 UD-IQ1_M(120.5 GiB)和 UD-IQ2_XXS(125.7 GiB)的权重勉强放下,分别只剩 7.5 GiB 和 2.3 GiB,没有余量 | 不推荐;4 × RTX 5090 的机器可借助系统内存卸载更大的档位 |
| 1 张 24–32 GB 显卡 | 任何版本都放不进显存 | 只能 GGUF 加大内存卸载,或用 API |
"装得下"不等于"引擎支持",这是下载前最该先确认的一点。官方检查点依赖 NVFP4 和 MXFP8 内核,只能在 vLLM、SGLang 这类 CUDA/ROCm 服务端引擎上跑,Mac 的统一内存再大也用不上它,必须换成 MLX 或 GGUF。上表也只算了权重,KV cache 和上下文占用都要另外加上。vLLM 配方里 KV cache 可以存成 FP8(Hopper)或 NVFP4(Blackwell、AMD),用来压低这部分占用;SGLang 文档给出的数字是 4 张 B300 在 TP4、显存占比 0.8 时 KV 池约能放 1,040 万个 Token,但那是一台服务器的总池子,不是单个请求的需求,单机小内存跑满 100 万上下文仍然不现实。
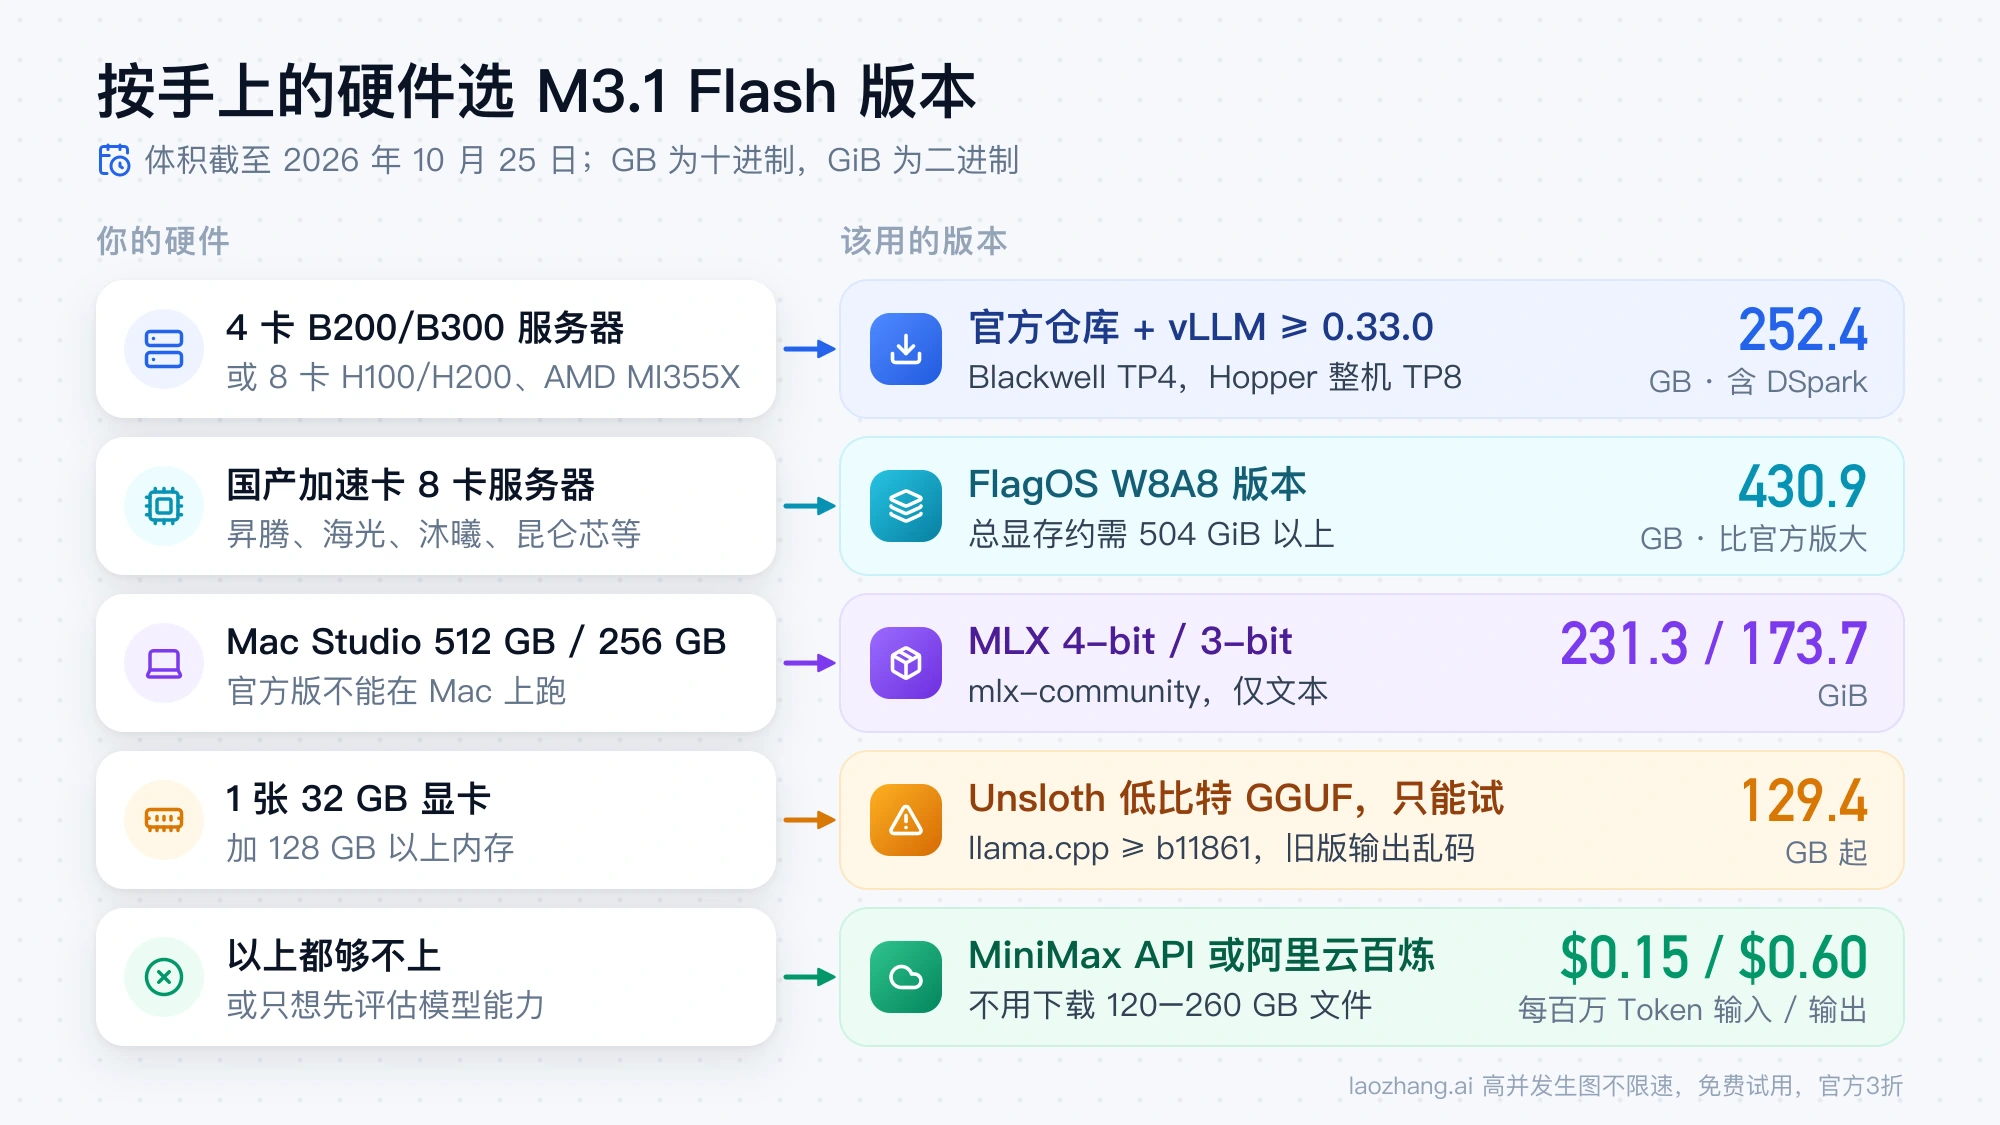
用 vLLM 或 SGLang 部署官方权重:Blackwell TP4,Hopper 要 TP8
GPU 服务器上的标准做法是下载官方仓库,用 vLLM 的 MiniMax-M3.1-Flash 部署配方启动,vLLM 版本要 0.33.0 或更新。截至 2026 年 10 月 25 日,这份配方列了三类硬件:NVIDIA Blackwell(GB200、GB300、B200、B300)用 TP4,NVFP4 专家直接跑在 FP4 Tensor Core 上;AMD MI355X(ROCm 7.2 以上)也是 TP4,加载时把 NVFP4 专家重新量化成 MXFP8;NVIDIA H100、H200 必须整机 8 卡 TP8。不管哪种硬件,--block-size 128 都是必填项,因为 MSA 的稀疏索引缓存依赖这个块大小。
下载命令来自官方模型卡,先确认磁盘至少有 260 GB 以上的空闲空间:
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-FlashH100、H200 上的启动命令照配方原样给出。Hopper 没有 FP4 Tensor Core,所以 KV cache 和索引缓存用 FP8,NVFP4 专家走 Marlin MoE 内核,DSpark 投机解码在 Hopper 上不开启;示例还把上下文限制在 262,144,并用 --limit-mm-per-prompt '{"video": 0}' 关掉了视频输入,图片仍然可用:
vllm serve MiniMaxAI/MiniMax-M3.1-Flash \
  --tensor-parallel-size 8 \
  --reasoning-parser minimax_m3 \
  --block-size 128 \
  --kv-cache-dtype fp8 \
  --attention-config '{"indexer_kv_dtype": "fp8"}' \
  --compilation-config '{"cudagraph_mode": "FULL_AND_PIECEWISE"}' \
  --max-model-len 262144 \
  --max-num-seqs 80 \
  --limit-mm-per-prompt '{"video": 0}' \
  --gpu-memory-utilization 0.9 \
  --no-enable-log-requests \
  --disable-hybrid-kv-cache-manager \
  --moe-backend marlin \
  --enable-auto-tool-choice \
  --tool-call-parser minimax_m3
Blackwell 的命令换成 -tp 4、--kv-cache-dtype nvfp4,并用 --speculative-config 打开 dspark 方法,草稿模型会自动从 dspark/ 目录读取,完整参数照配方复制。首次冷启动要编译内核、捕获 CUDA graph,配方提到可能超过 10 分钟,别把它当成卡死。客户端按模型卡建议设 temperature=1.0、top_p=0.95,推理强度通过 chat_template_kwargs 里的 reasoning_effort 选 low、medium、high、xhigh 或 max。
SGLang 也能跑,但截至 10 月 25 日,SGLang 的 MiniMax-M3.1 部署手册写明 M3.1 支持还没合并进主分支,要用 lmsysorg/sglang:dev-minimax-m31-flash 镜像(AMD 用 -mi35x 后缀的镜像)或从支持 PR 安装。手册只给了 B300、B200 和 AMD MI350X/MI355X 的配方,没有 Hopper 配方;Blackwell 上 MSA 内核需要 CUDA toolkit 13.4 以上,版本不够时不会报错,而是悄悄退回更慢的路径,启动日志要看清楚。手册里 4 张 B300 的解码速度是 1K 上下文 1,028 Token/秒、1M 上下文 723 Token/秒,那是 SGLang 自己的测试,用的是低延迟内核,投机解码接受长度固定为 5。
llama.cpp 和 Mac 能跑吗:GGUF 要 b11861 以上,Mac 用 MLX
能跑,但只能用社区量化版,而且 llama.cpp 的版本是硬门槛。10 月 23 日有人在 llama.cpp 提交 issue #31063,报告 M3.1 Flash 的 GGUF 加载正常、输出却全是乱码,原因是 MiniMax M3 架构的代码没有把每个专家的 NVFP4 缩放系数传进计算图。修复 PR #31097 在 2026 年 10 月 24 日合并,第一个包含它的发布版本是 b11861。用更旧的 llama.cpp,或者基于旧版 llama.cpp 打包的工具,加载任何 M3.1 Flash 的 GGUF 都会得到乱码,先升级再排查别的原因。
这个 issue 也给了消费级硬件目前唯一能参考的数字:报告者用 1 张 RTX 5090(32 GB)加 128 GB 内存,跑自己量化的 146 GiB Q2_K 文件,专家层放在 CPU 上(-cmoe),上下文 4,096;打上修复后回答正常,预填充约 3.59 Token/秒、解码约 5.12 Token/秒。这是单次请求的社区报告,只说明这一档能跑通,日常写代码或跑 Agent 会很慢。Unsloth 还没有 M3.1 Flash 的专门文档,它给 MiniMax M3 的 GGUF 建议可以参照:显存加内存的总量要比文件大出一截,最小的 UD-IQ1_M 至少配 133 GB,效果上推荐 UD-IQ3_XXS。1-bit、2-bit 这类低比特量化对 Agent 任务的影响,可以看本地 Coding Agent 失败?先区分量化、上下文还是 Harness。
Mac 用户的选择更简单:官方检查点不能在 Apple Silicon 上运行,512 GB 的 Mac Studio 选 mlx-community/MiniMax-M3.1-Flash-Text-4bit(231.3 GiB),256 GB 的选 -Text-3bit(173.7 GiB),也可以在 llama.cpp 里跑对应体积的 GGUF。另外,Ollama 模型库里的 minimax-m3.1-flash:cloud 是云端托管版本,请求发到 Ollama 的服务器,不占用本地显存,也不是本地部署。
昇腾、海光等国产卡:用 FlagOS 的 W8A8 版本,约 431 GB
国产加速卡不能直接用官方的 NVFP4 检查点,要换成 FlagOS 社区发布的 W8A8 版本。官方仓库附带的 FlagOS 多芯片部署文档列出 9 家芯片厂商的适配版本:平头哥(真武)、NVIDIA、沐曦、海光、华为昇腾、摩尔线程、天数智芯、昆仑芯和清微智能,权重同时放在 ModelScope 和 Hugging Face 的 FlagRelease 组织下,NVIDIA、昇腾、昆仑芯和平头哥是 Express 版本。W8A8 是由原始 NVFP4 权重重新量化到 8-bit,所以体积比官方版大:截至 10 月 25 日,NVIDIA 版仓库是 430.9 GB(401.3 GiB),按上面的余量规则需要约 504 GiB 以上的总显存,一般是 8 卡服务器。文档里的示例在平头哥平台上用 tensor_parallel_size=8,基础组件是 vLLM v0.24.0、vllm-plugin-FL v0.3.0 和 FlagGems v5.4.0,卡数、显存和启动参数以各平台模型卡为准,推荐直接用 FlagRelease 提供的容器镜像。
MiniMax M3.1 Flash 免费吗、能商用吗:看许可证的两个条件
权重可以免费下载,但许可证是 MiniMax Community License,不是 OSI 认可的开源协议,"开源"准确的说法是开放权重。按官方仓库的 LICENSE 文件,非商业用途免费;商用要做两件事:在网站、界面、博客、关于页或产品文档里显著标注"Built with MiniMax M3.1-Flash",并给 api@minimax.io 发邮件。年收入不超过 2,000 万美元的,发一次主题为"M3.1-Flash licensing — notice"的通知即可;超过的要事先取得 MiniMax 的书面授权。许可证里的商用范围包括收费产品和服务、商业化调用基于它的 API,以及把微调后的衍生模型用于商业目的;附录另列了军事用途、伤害未成年人等禁止用途。这里只是条款摘要,涉及具体业务时请找法务确认。
什么情况下直接用 API:每百万 Token 输入 $0.15、输出 $0.60
如果你的机器在上面的硬件表里落在最后两行,或者你只是想评估模型能力,直接用 API 更划算。截至 2026 年 10 月 25 日,MiniMax 开放平台价格页列出 MiniMax-M3.1-Flash 每百万 Token 输入 $0.15、输出 $0.60、缓存命中 $0.015,没有按上下文长度分档。国内用户也可以走阿里云百炼,MiniMax/MiniMax-M3.1-Flash 的模型信息页在华北2(北京)地域标的是每百万 Token 输入 1 元、输出 4 元、缓存命中 0.1 元,下单前以百炼控制台当日价格为准。另外,M3.1 Flash 是思考模型,kie.ai 和 DataLearner 的文章都报告思考无法关闭、reasoning_effort 不设时默认最高档 max,按 Token 计费时要为思考内容预留输出预算。
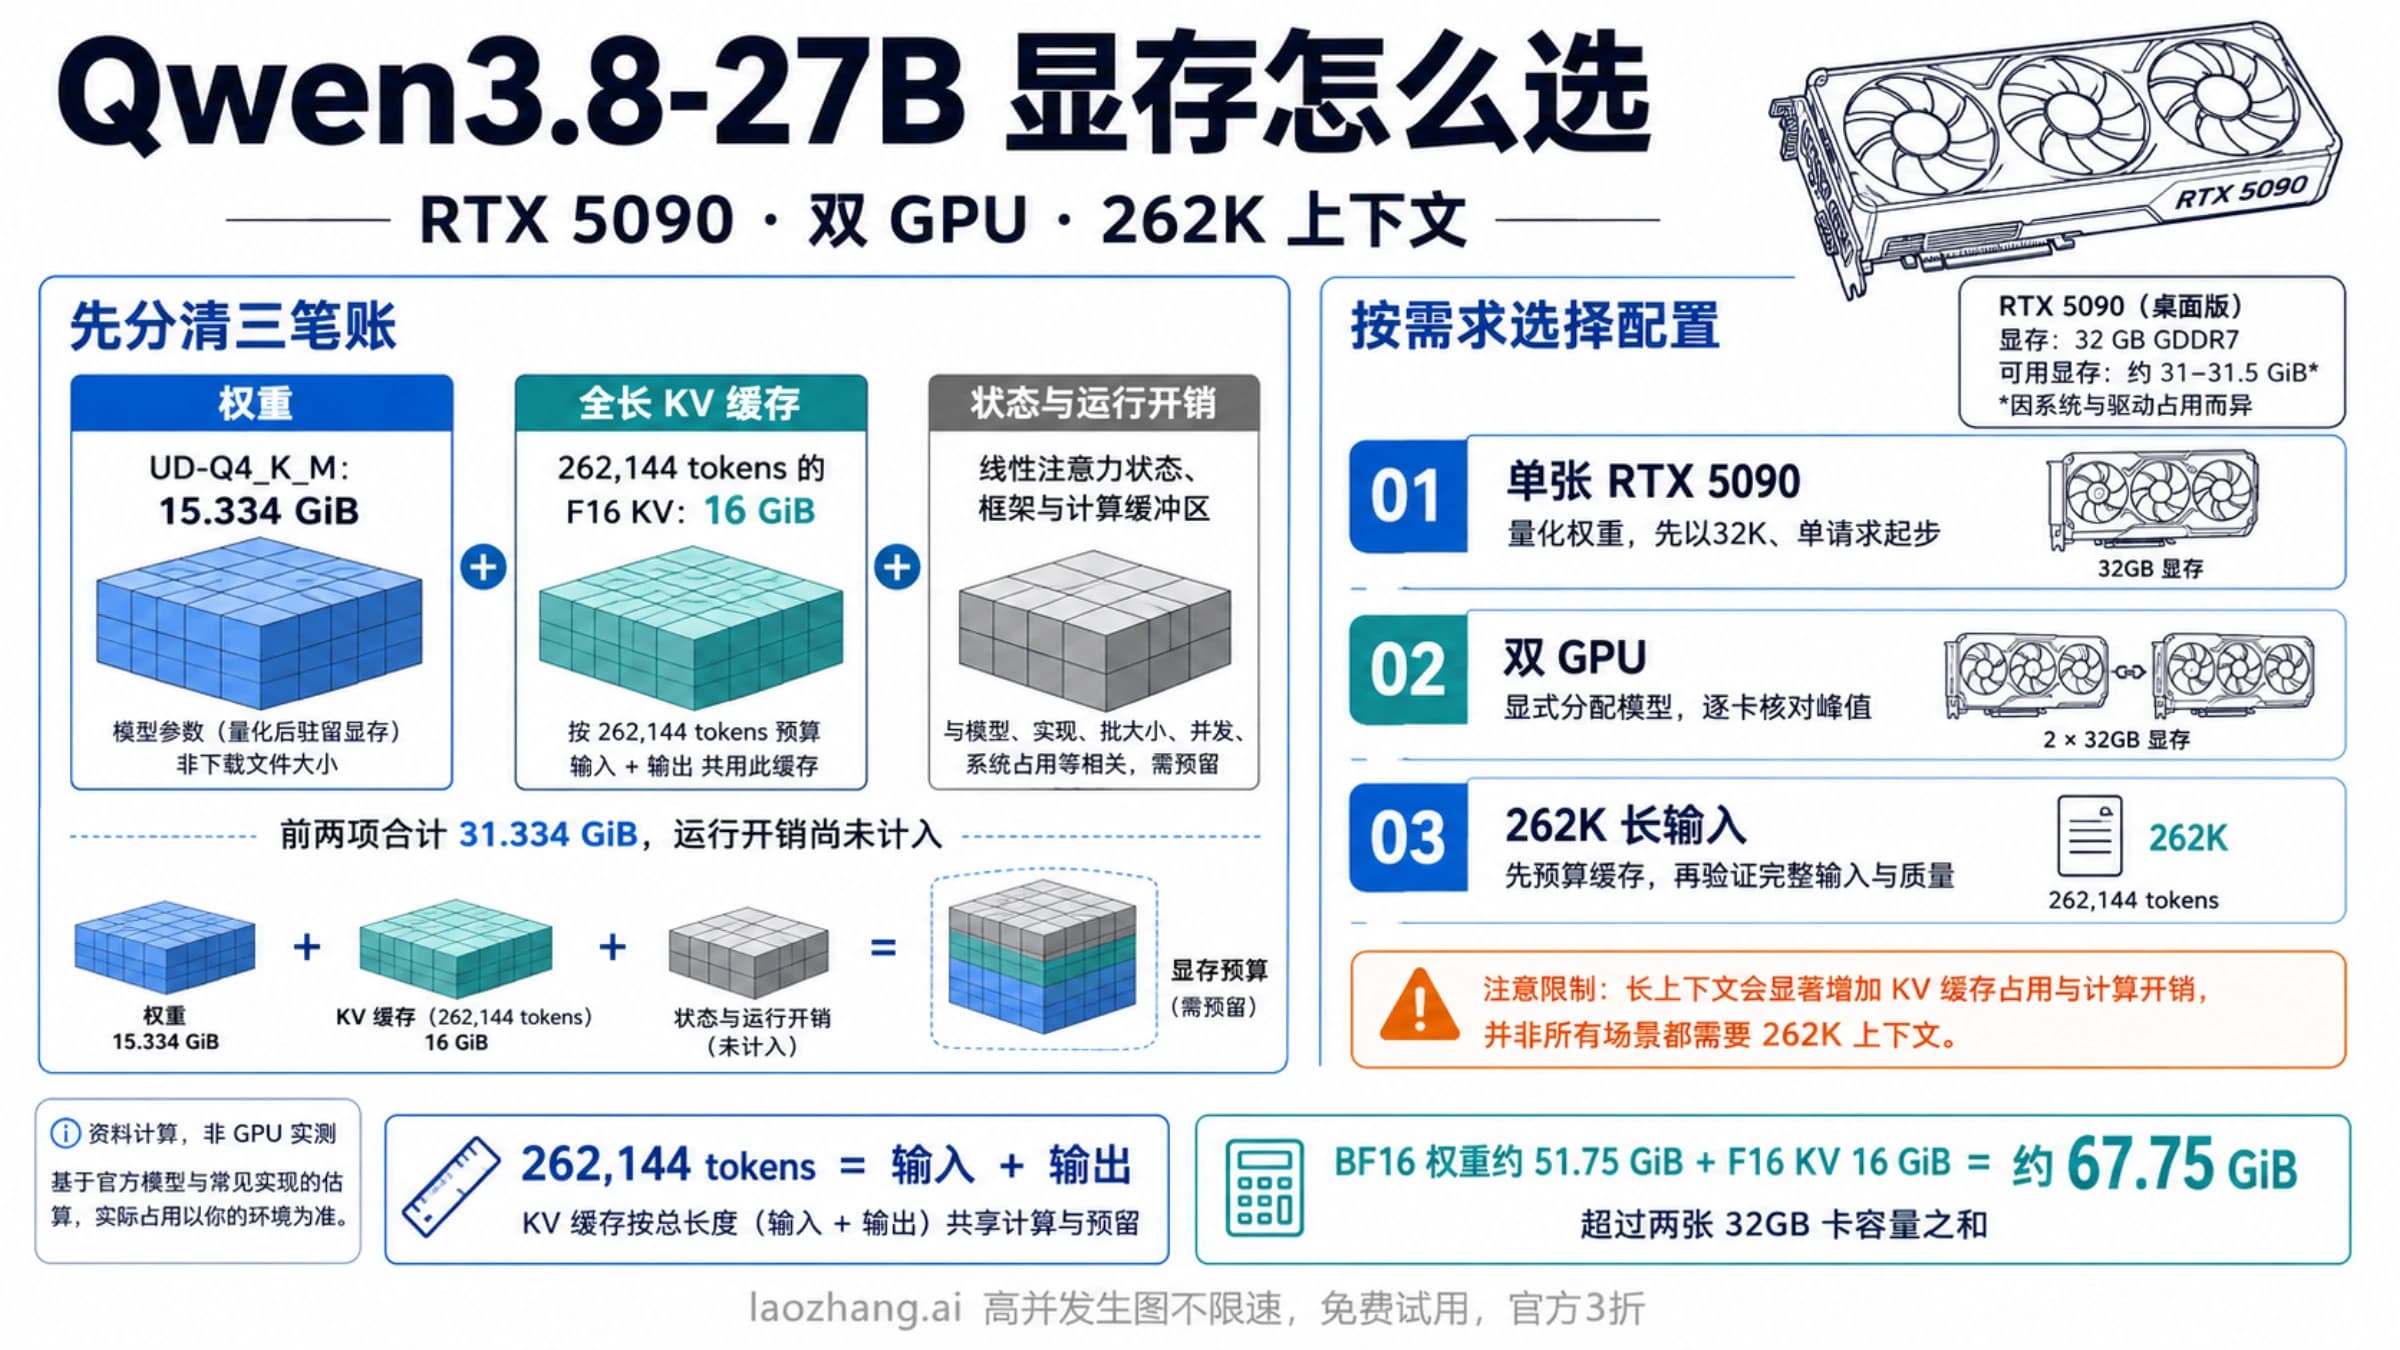
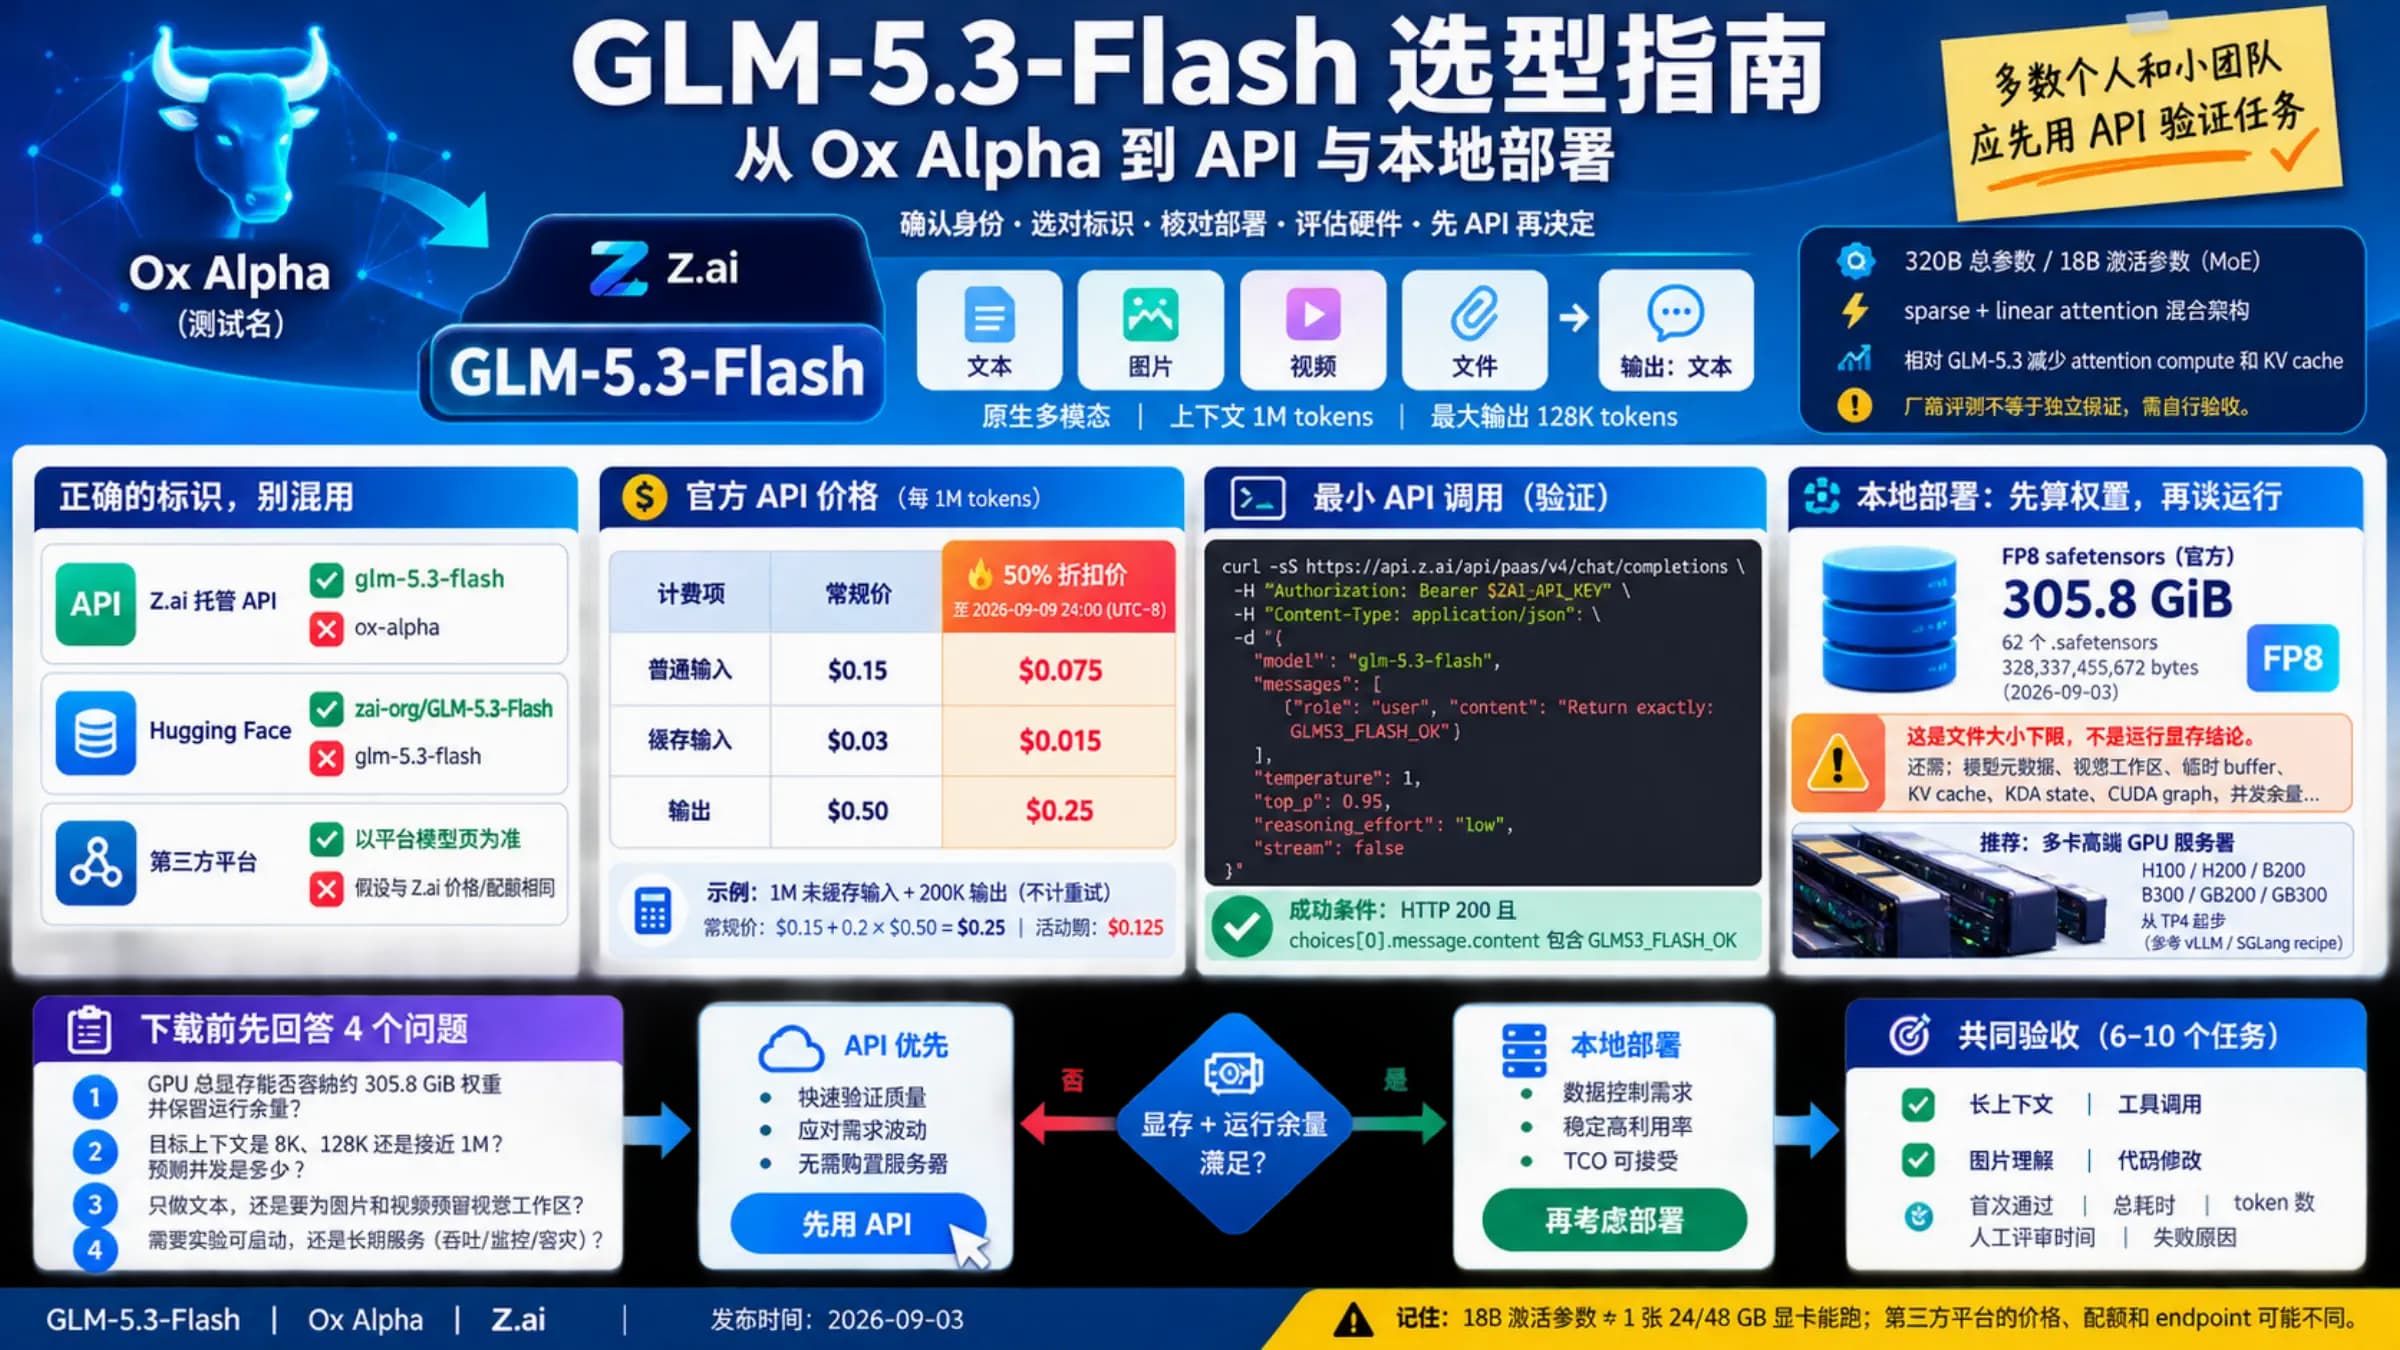
本地部署值得做的情况主要有三种:数据不能出内网、已经有闲置的 Blackwell 或 Hopper 整机、或者调用量大到 API 账单超过机器折旧。只有一张 32 GB 显卡的话,与其跑 1–2 bit 的 M3.1 Flash,不如换一个本身就装得下的模型,做法见 Qwen3.8-27B 显存指南:RTX 5090 如何选择量化、双卡与 262K 配置。本地和云端在编码场景下怎么分工,可以看本地 LLM 编码代理:什么时候比 Claude/Codex 更合适;如果你在几个开放权重的 Flash 模型之间比较,智谱的同类模型有一样的"检查点装不装得下"问题,见 GLM-5.3-Flash 选型指南:从 Ox Alpha 到 API 与本地部署。
参考来源8
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月25日。
参考来源8
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月25日。
- 1.Hugging Face 官方模型卡huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash
- 2.vLLM 的 MiniMax-M3.1-Flash 部署配方recipes.vllm.ai/MiniMaxAI/MiniMax-M3.1-Flash
- 3.SGLang 的 MiniMax-M3.1 部署手册docs.sglang.io/cookbook/autoregressive/MiniMax/MiniMax-M3.1
- 4.issue #31063github.com/ggml-org/llama.cpp/issues/31063
- 5.PR #31097github.com/ggml-org/llama.cpp/pull/31097
- 6.FlagOS 多芯片部署文档huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash/blob/main/docs/FlagOS-Multi-Chip-Support-and-Downloads.md
- 7.官方仓库的 LICENSE 文件huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash/blob/main/LICENSE
- 8.MiniMax 开放平台价格页platform.minimax.io/docs/guides/pricing