Claude Code MCP 上下文爆掉:排查占用、工具搜索与输出压缩
Claude Code 接入 MCP 后上下文吃紧,先查占用是在调用前、返回后还是长会话中增长。工具搜索缓解定义加载,大结果需要源头筛选和按需读取;整理之后还要确认同一任务的证据与访问能力仍在。
文章目录
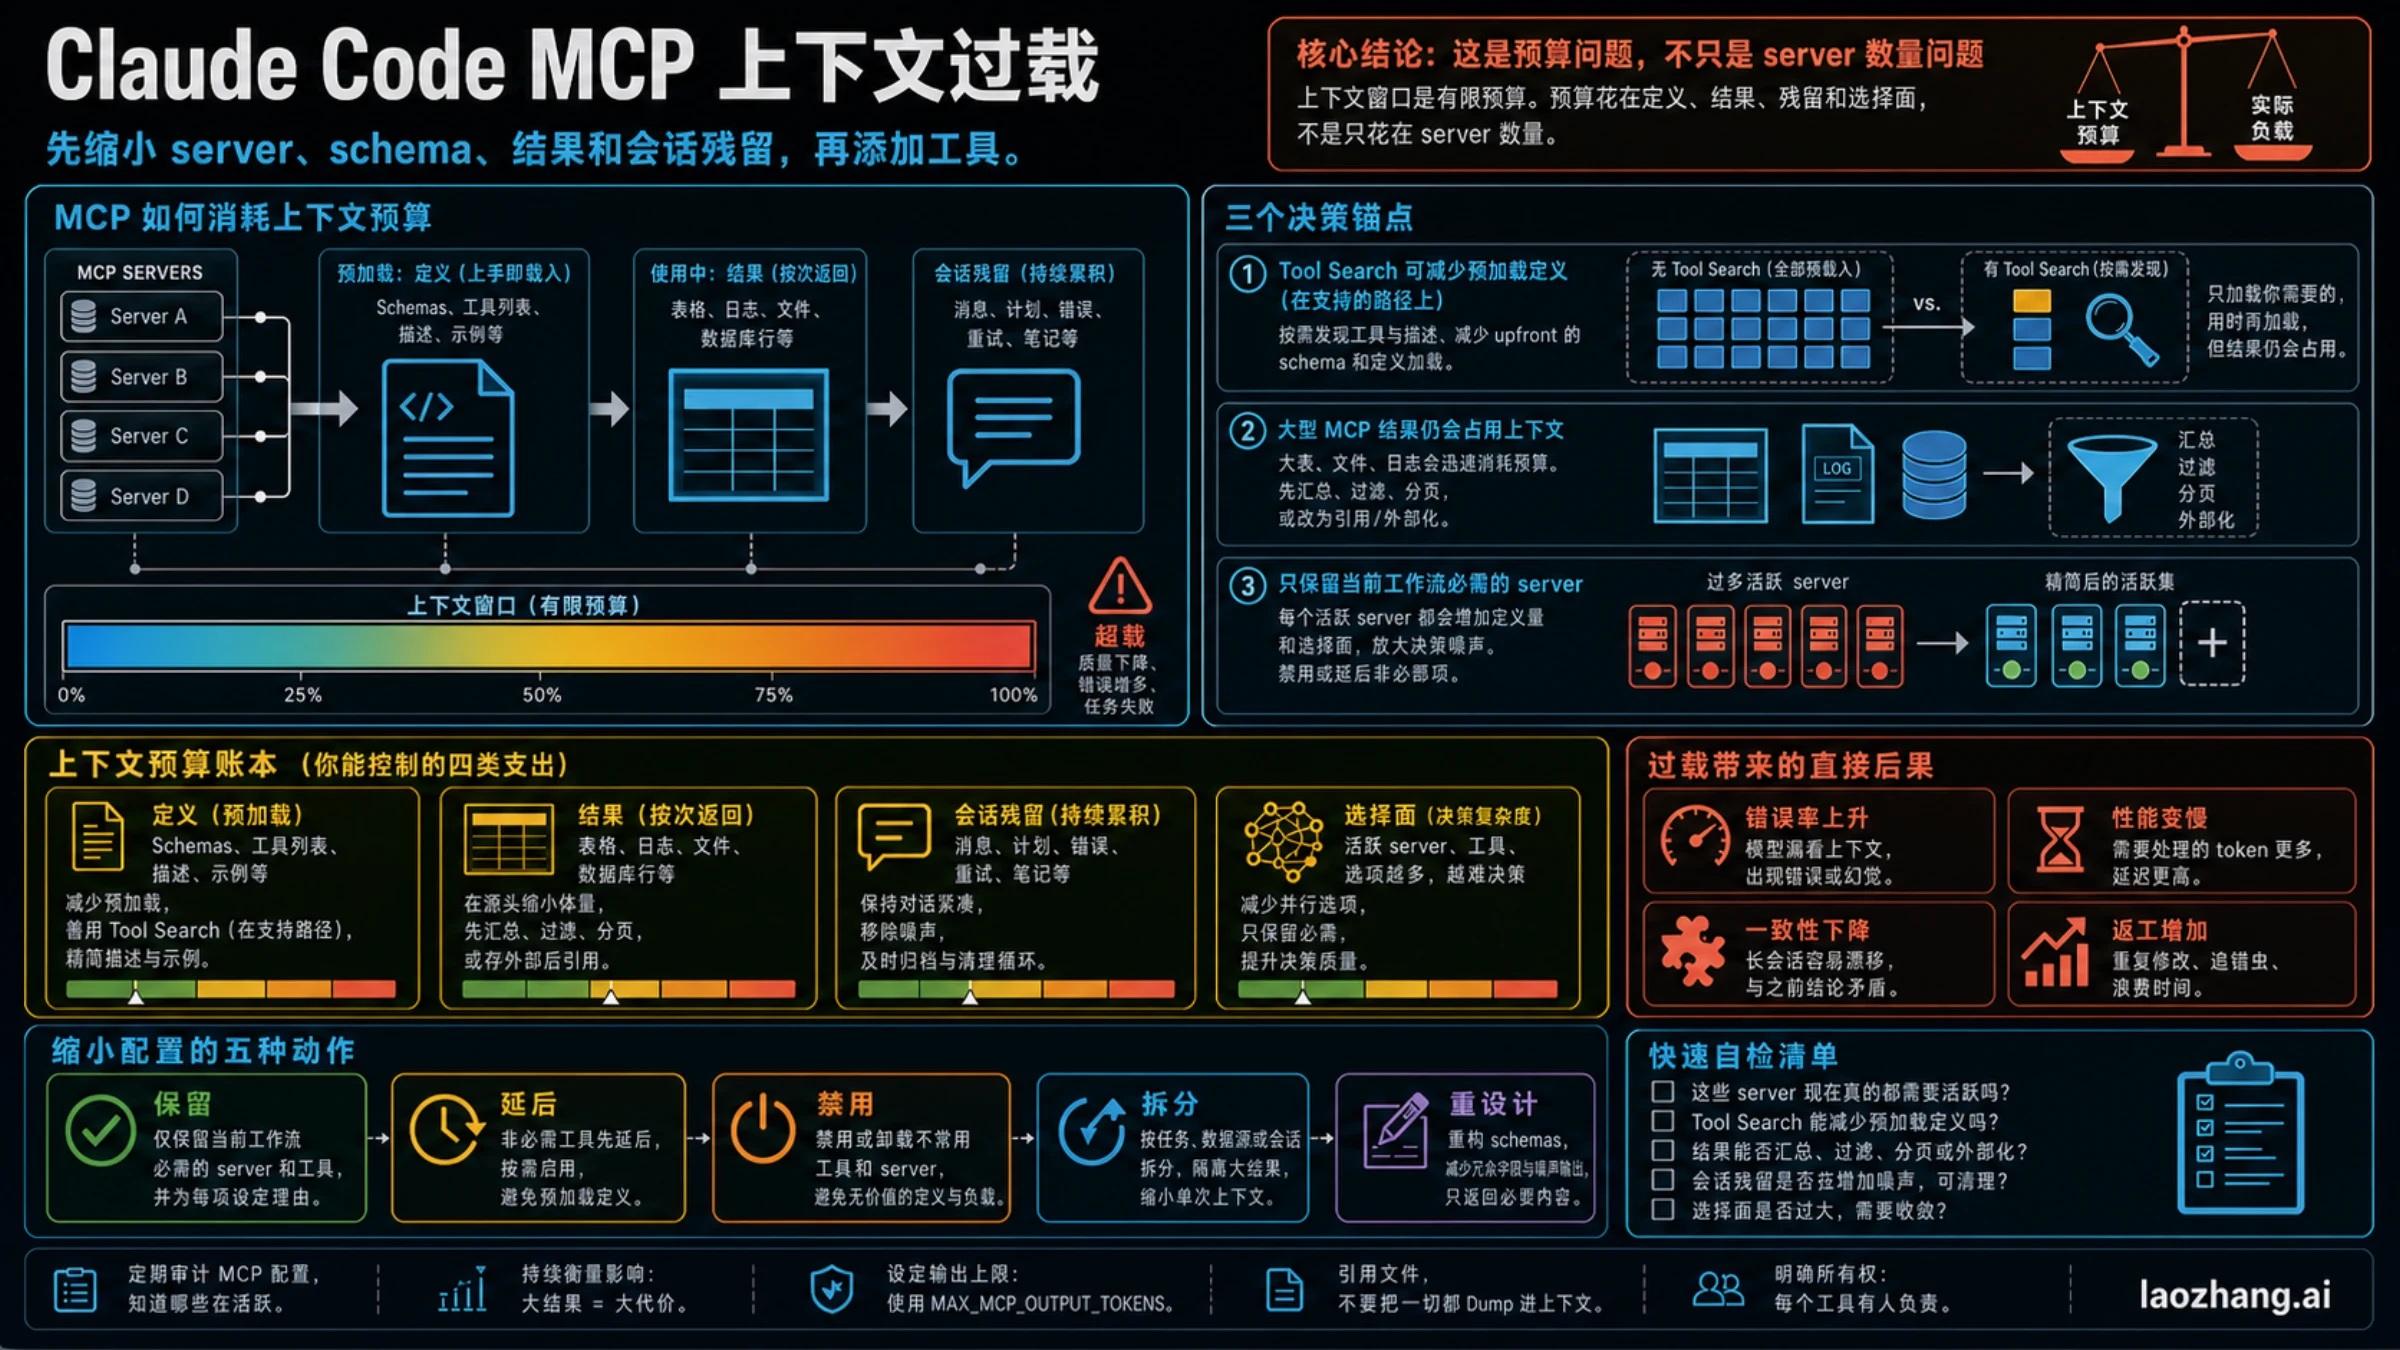
Claude Code 接入 MCP 后频繁压缩上下文、读完日志就忘了修复目标,先做两件事:用 /context 看当前占用,再回到刚才的工具调用,找出增加的内容。调用前就重,查工具定义与加载方式;某次调用后猛增,查返回数据;反复排查后才吃紧,查会话历史。 服务器数量只能提供线索,不能直接说明窗口为什么满了。
有效的整理应该留下当前任务需要的外部访问,缩小无关输出,让 Claude 还能找到决定结论的原始证据。只让占用数字下降、却把关键错误或数据入口关掉,并没有完成修复。
以下操作以 2026 年 10 月 6 日核对的 Claude Code 文档为依据。工具搜索的支持范围和返回结果的处理方式会随版本、模型及接入路径变化,判断时以自己会话中的状态和结果为准。
先确认占用在哪里增长
在 Claude Code 对话内输入 /context,查看工具、消息和已加载内容的分类。全屏界面折叠了细节时,用 /context all 展开。记录当前可用空间以及主要占用项,随后只做一次有明确用途的工具调用,再查看变化。这两个命令是当前命令参考提供的查看入口。
不需要先把全部服务器关闭。先按现象选择检查方向:
| 现象 | 先看什么 | 下一动作与判断依据 |
|---|---|---|
| 尚未调用外部工具,工具相关占用已经很大 | 工具定义是否提前加载,是否有必须常驻的例外 | 检查工具搜索设置及接入路径,再比较同一任务的启动占用 |
| 一次查询后,可用空间明显减少 | 该次返回的日志、记录、全文或图片 | 把查询收窄到任务所需范围;检查返回是否仍包含关键证据 |
| 多轮重试后,Claude 混淆已经否决的方案 | 重复结果、过期计划和旧判断 | 保存工作检查点,再压缩会话;避免立即重读同一批大结果 |
| 调用停在工具搜索或连接阶段 | 服务器是否连接、是否有工具、是否需要授权 | 先排查连接与访问状态;等待本身不能证明上下文过载 |
| 多个搜索工具反复选错 | 名称、描述和数据来源是否能区分 | 指定这次要查询的系统;自建工具应说明适用任务与返回结果 |
前三行是在找上下文压力,后两行是在排除容易混淆的故障。工具连接失败、权限不足和上下文空间不足,需要不同的处理。
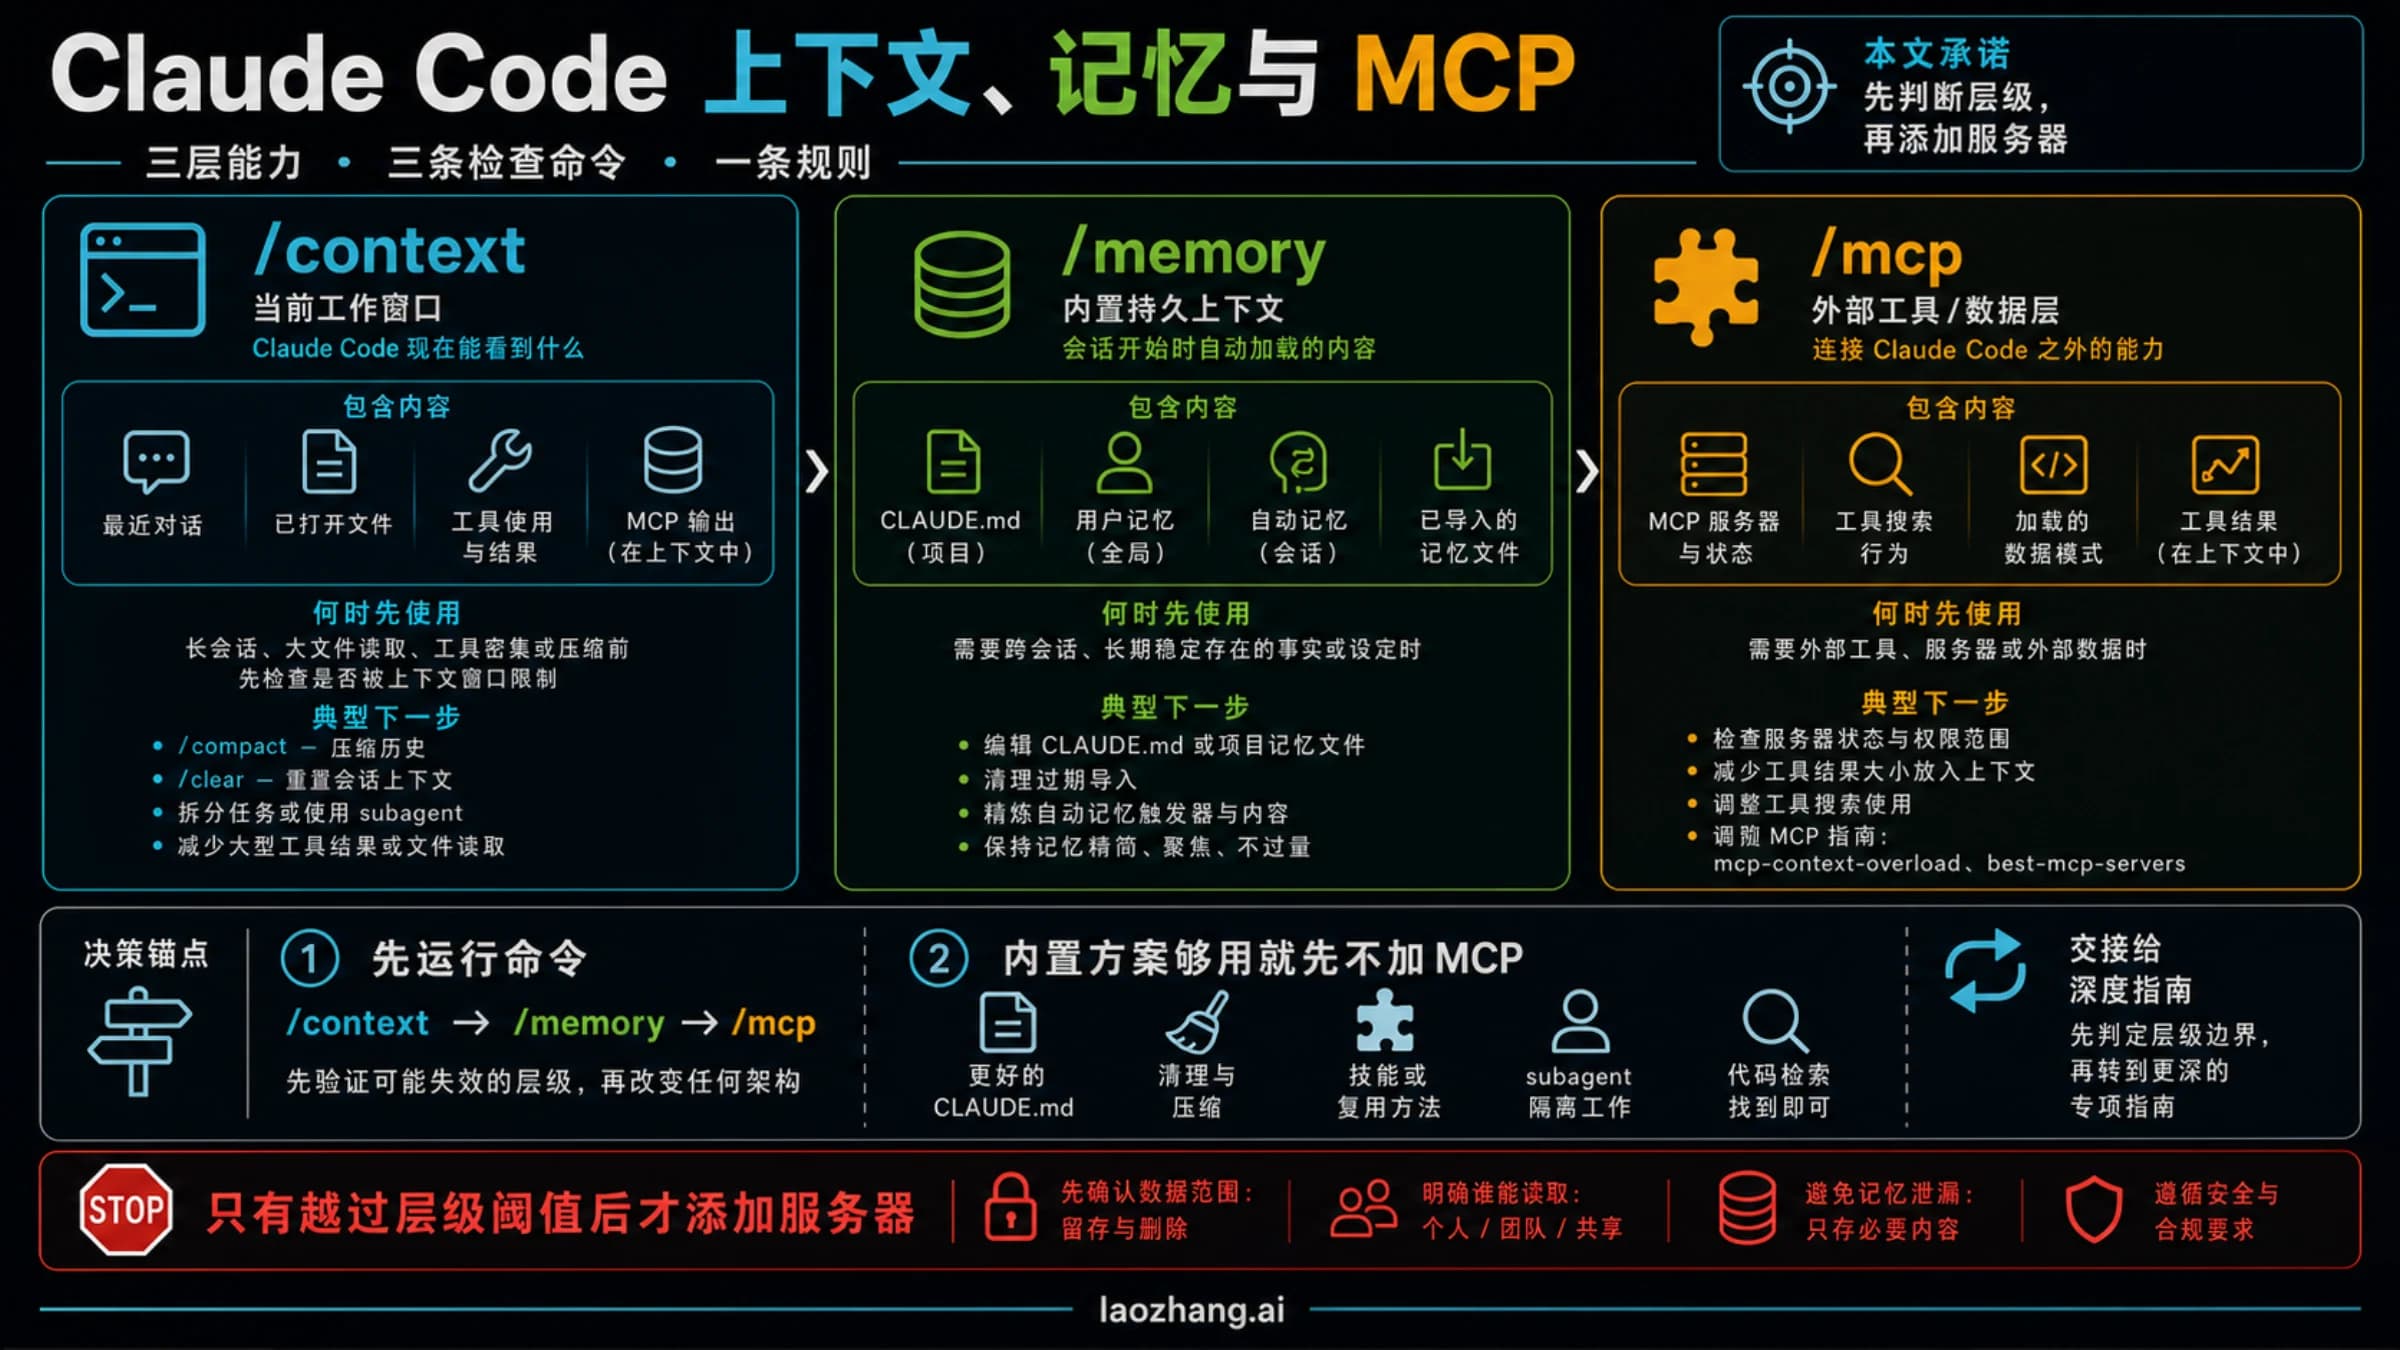
如果还分不清会话内容、长期项目指令与 Context7 连接问题,可以先看Claude Code 上下文、记忆、MCP 与 Context7 的层级排查。这里继续处理已经接入的 MCP 集合和工具返回。
Tool Search 为什么没有挡住大结果?
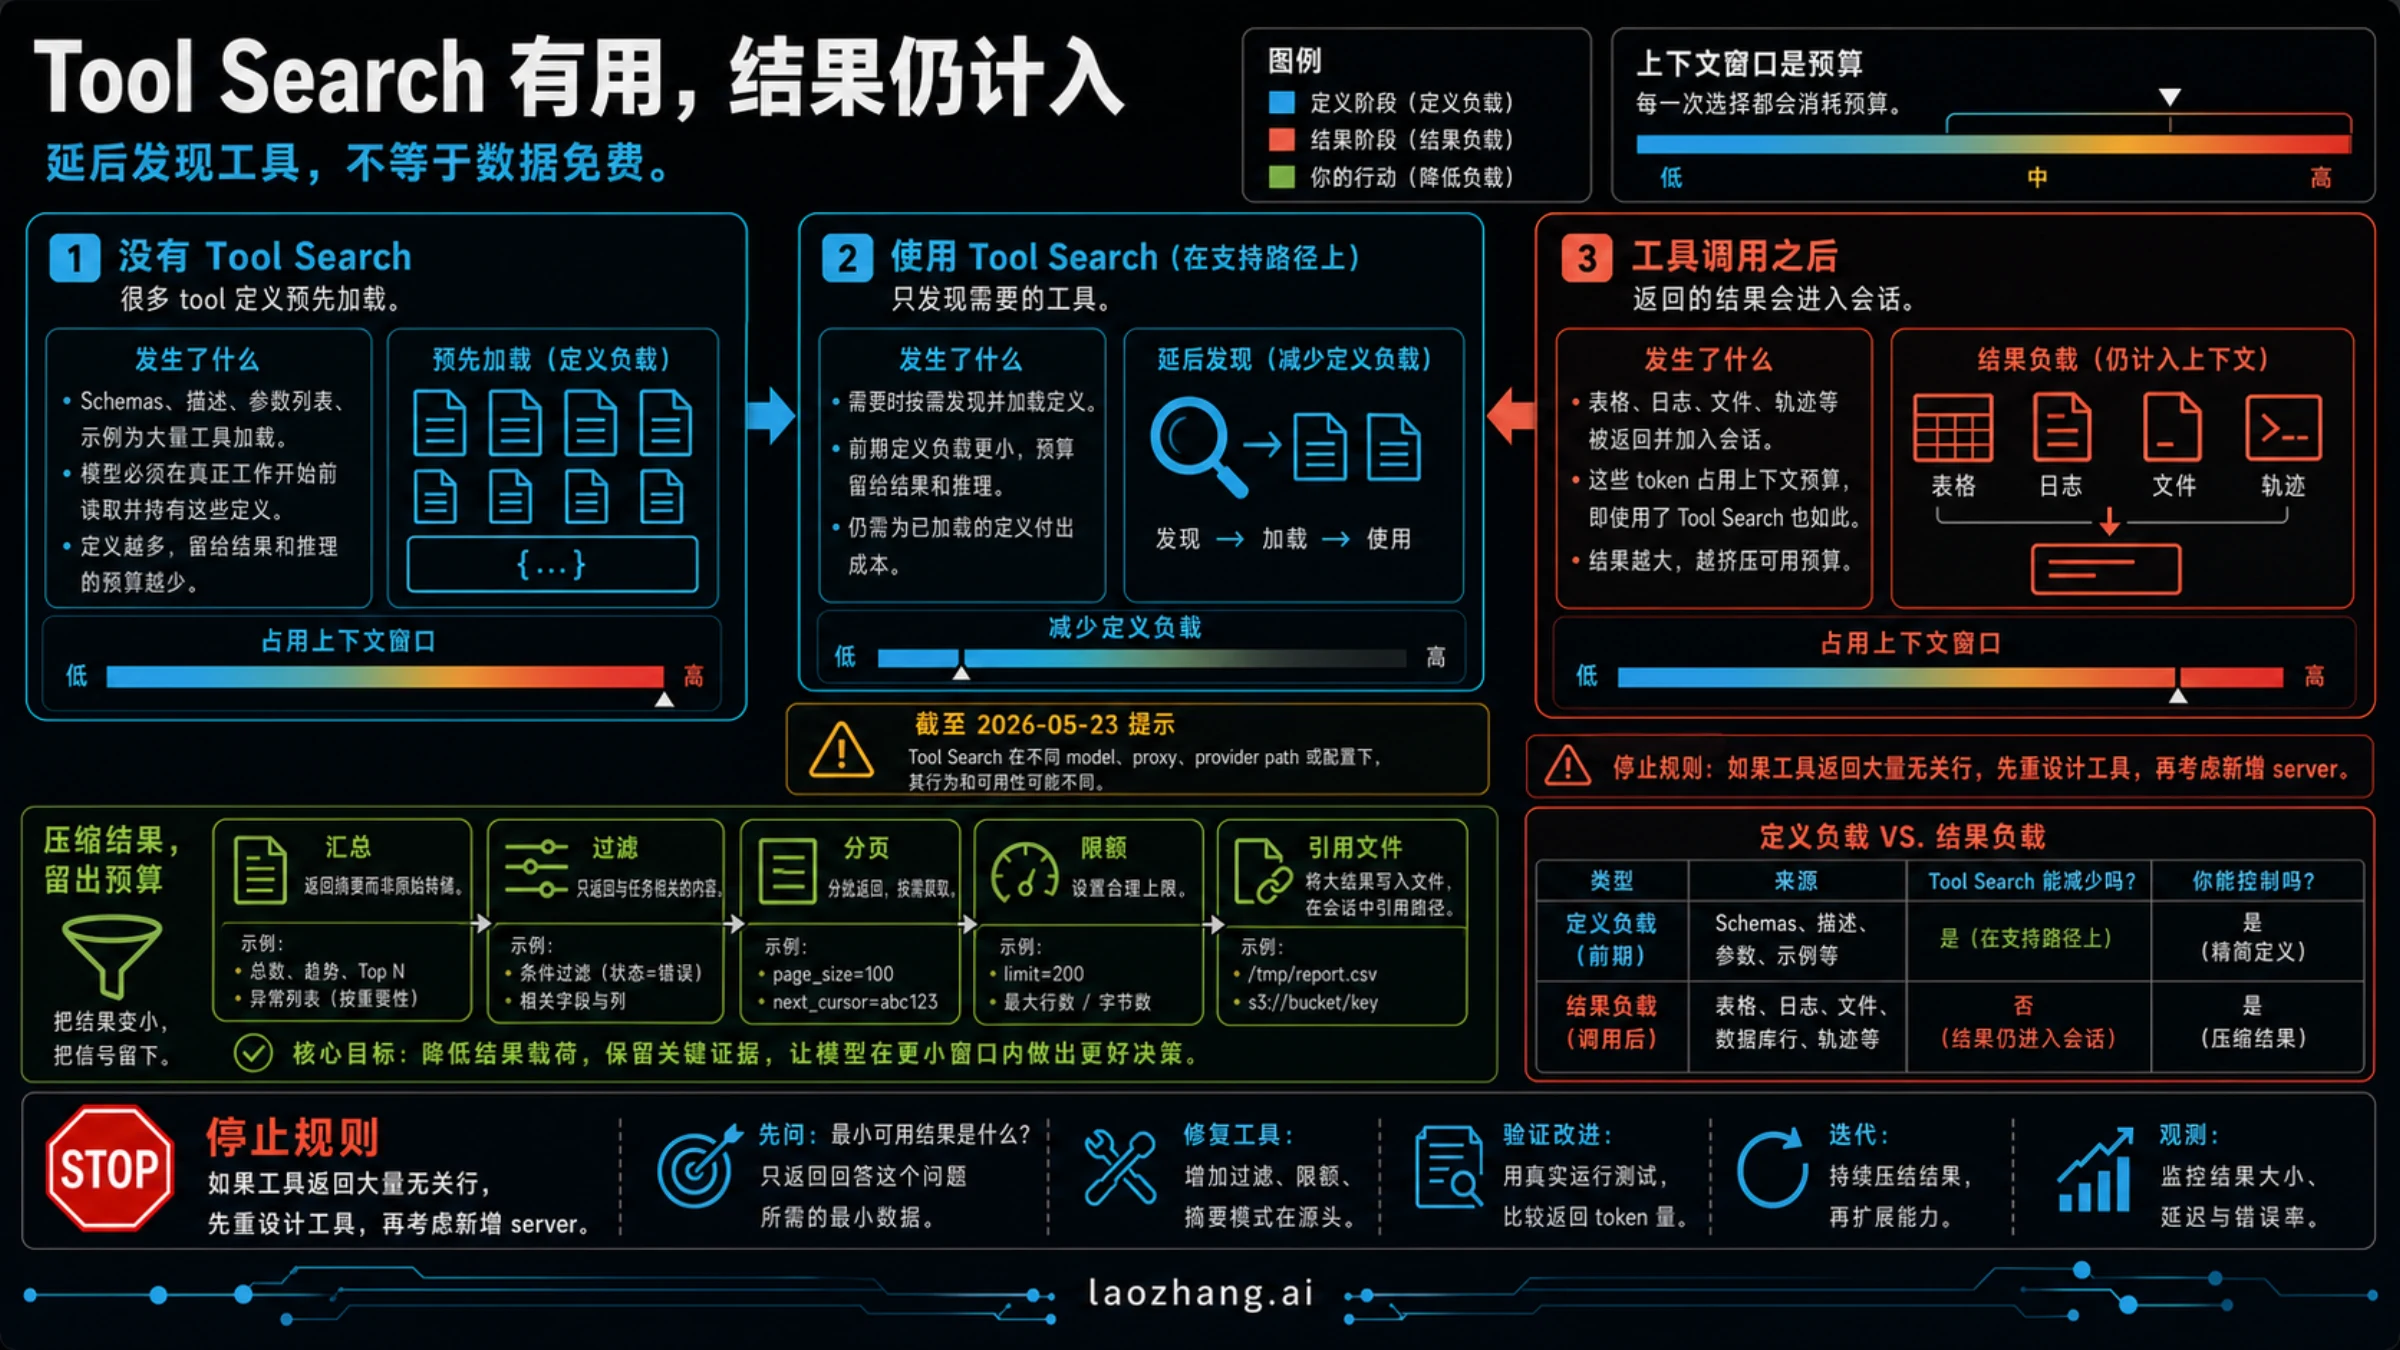
Tool Search 默认延后定义,启动仍加载工具名和服务器指令。它不筛选调用结果,也不清理历史。官方工具搜索说明
检查配置时,特别留意这几个不同含义:
- 未设置
ENABLE_TOOL_SEARCH:默认延后;显式auto才采用 10% 阈值。 - 非官方
ANTHROPIC_BASE_URL:默认关闭;显式true仍需代理和模型支持tool_reference。 - Google Cloud Agent Platform:v2.1.221 起,Claude 4.5 代及以后默认支持;更早代际或 Foundry 的 Azure 托管部署不能强开。
alwaysLoad、实验能力禁用与组织策略另有影响。
这些是配置说明中的条件,不是让所有读者照抄一个环境变量的建议。若当前路径不支持工具搜索,就通过减少无关的提前加载内容、缩小返回和整理历史来处理,不能把“设置了 true”当作已经生效。
判断是否走对方向也很直接:若工具定义占用已经较小,而增长紧跟某次结果,就转向输出设计。继续调整发现阈值不会让那份结果变短。
筛选服务器:保留任务所需,先用可逆开关
先把当前任务写成一句能验证的话。例如:“查清账单任务为何失败,给出失败记录数和各类代表错误,保留可以继续查看的记录编号。”这句话决定必须保留什么访问,而不是按安装日期或服务器数量做删减。
打开 /mcp,对每个服务器说明它在这次任务中负责什么。可以这样安排:
| 当前用途 | 合适处理 | 如何避免整理后无法工作 |
|---|---|---|
| 唯一能查询失败记录的日志系统 | 保留连接 | 确认能取到代表错误和详情 |
| 后续才会用到的浏览器验证 | 当前阶段暂时关闭,需要时恢复 | 在工作检查点记下后续验证入口 |
| 两个系统都能搜索同一份文档 | 本次选一个明确来源 | 用一次有意义的查询确认内容覆盖所需版本 |
| 自建服务器把日志读取与部署混在一起 | 按实际任务拆分或限制暴露范围 | 保留读日志所需工具,不借机扩大写入权限 |
| 任何查询都返回完整原始数据 | 修改默认输出 | 先返回范围、汇总和代表记录,再按编号取详情 |
/mcp 可按项目停用服务器并保留配置。服务器开关与可用性说明
做完一次停用,只验证受影响的任务。若关键数据无法取到,就恢复对应服务器;不要通过猜测补上缺失结果。停用也不会抹掉已经进入当前对话的历史输出,因此一次开关后占用没有立刻大降,并不说明开关无效。
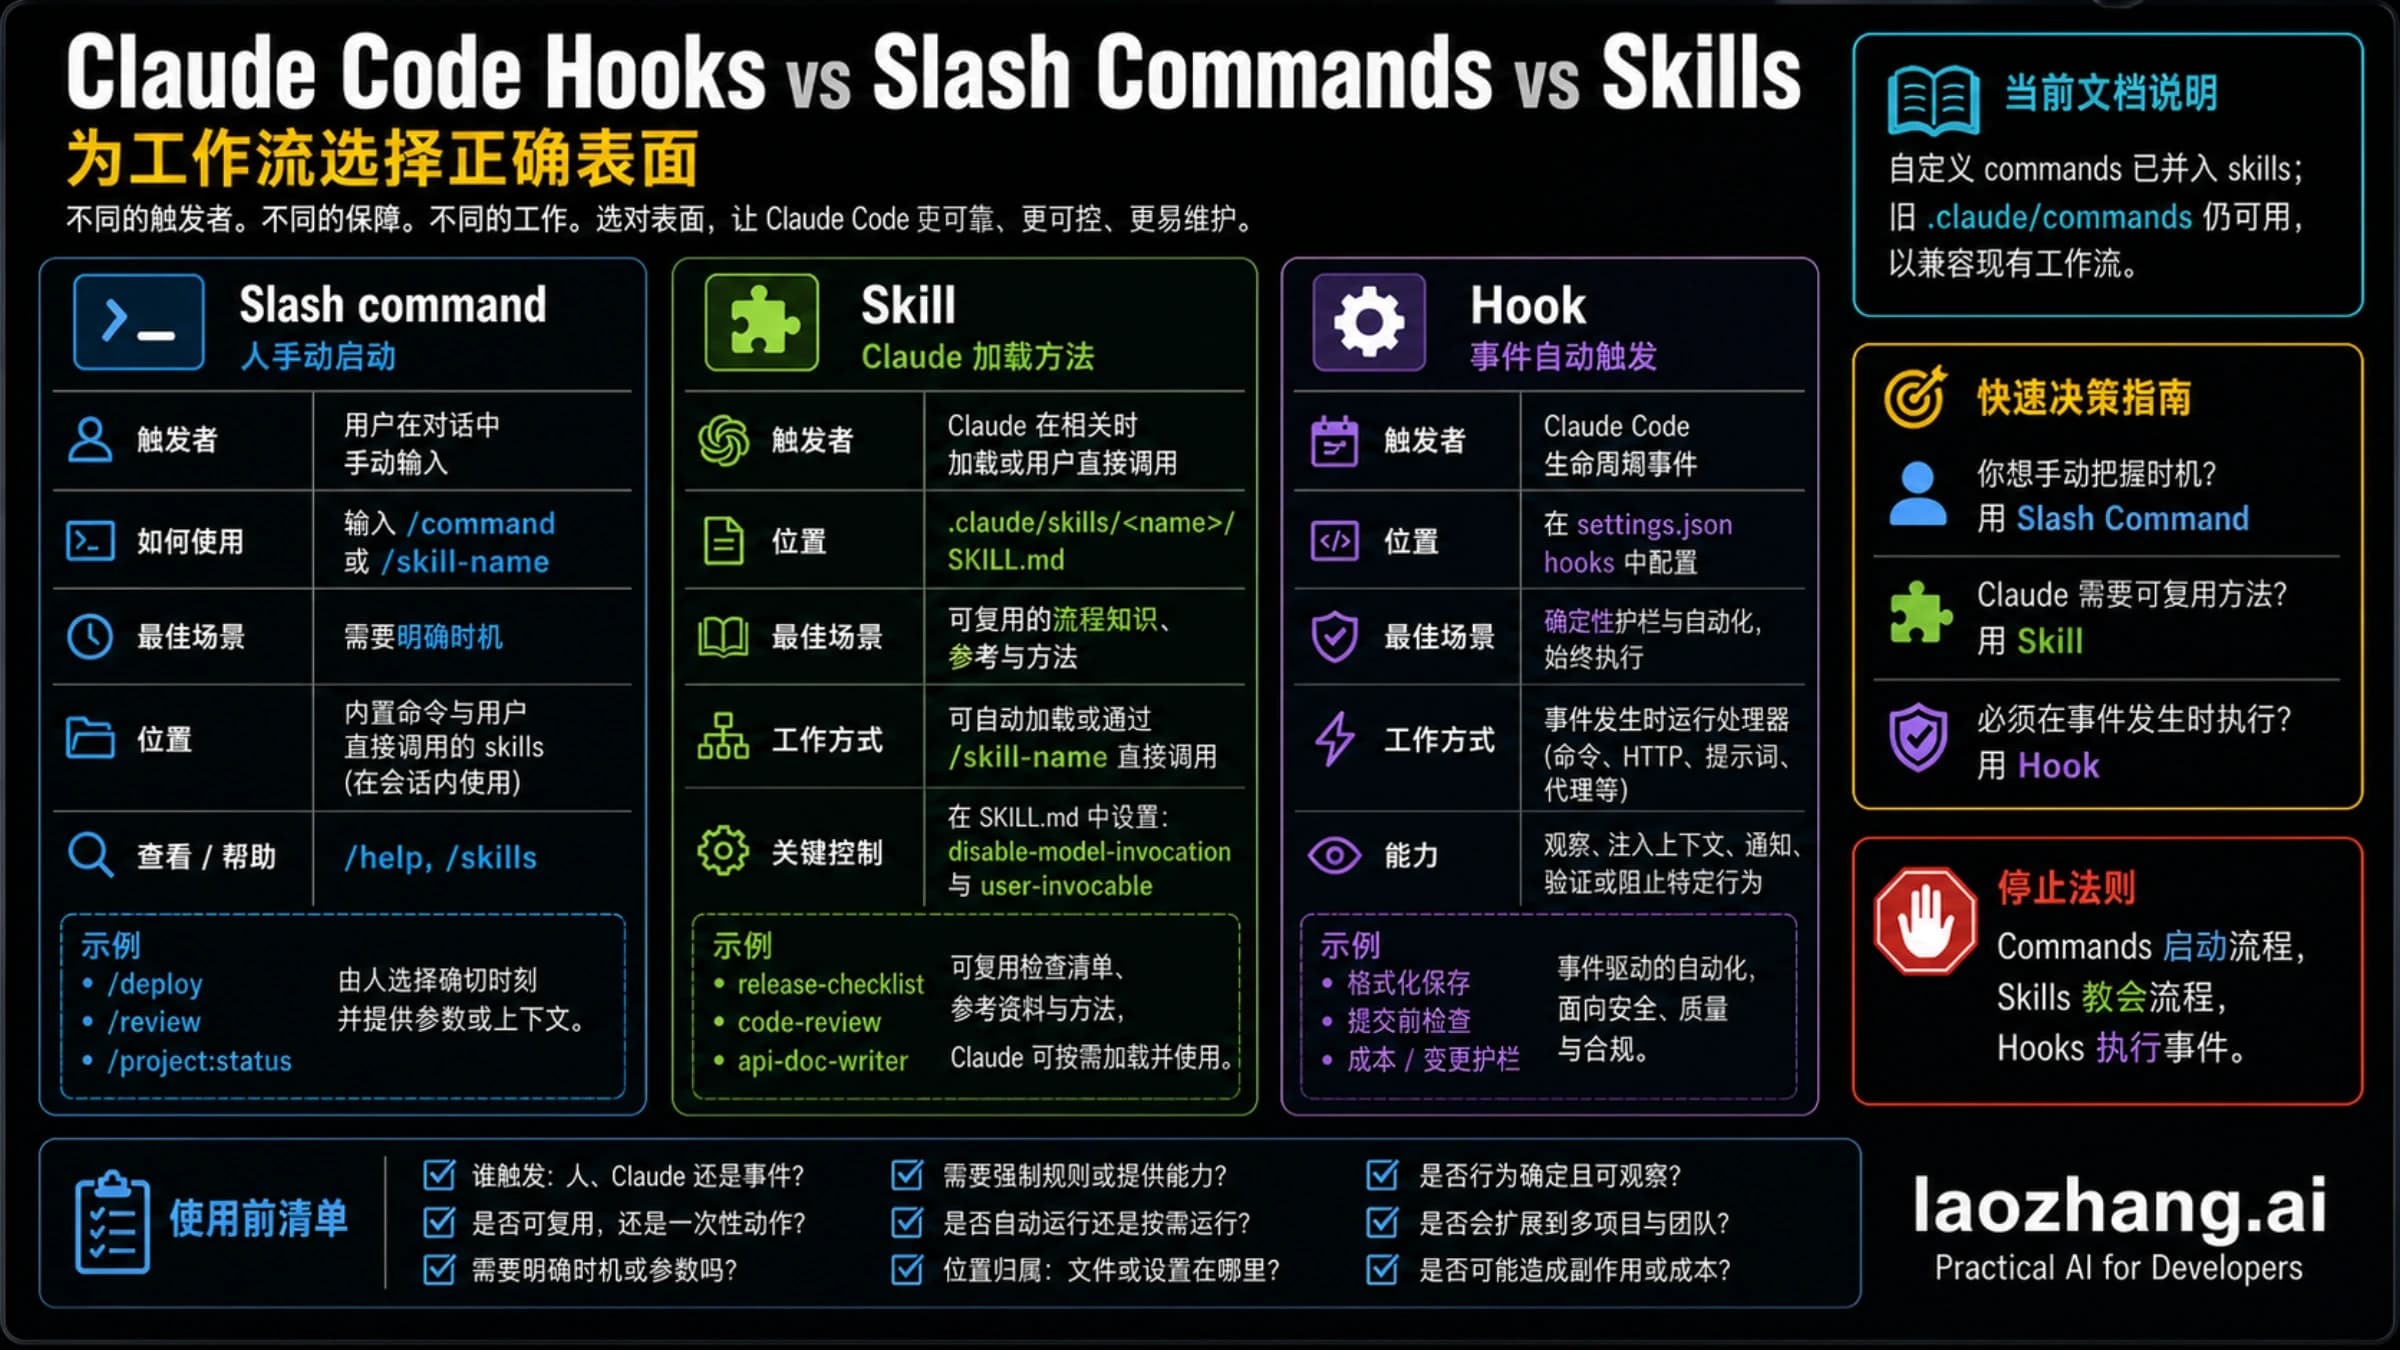
方法与访问也要分开:一套重复执行的检查步骤可以写成 skill,但查询外部日志仍需要真实的数据通道。换成脚本、CLI 或 skill 后,如果最后照样把整份数据打印回对话,压力仍然存在。Anthropic 的 MCP 代码执行分析支持在内容进入模型前筛选和处理的方向;它给出的性能案例不能直接视为你的 Claude Code 节省比例。
大输出落盘、报错截断和 token 上限分别意味着什么?
收到“大输出”提示时,先看结果是什么类型,再决定下一步。默认警告是 10,000 tokens,上限是 25,000。无专用限制的前台成功纯文本超限,或超过 50,000 字符,会落盘返回引用;isError 文本约超过 11,000 字符只留首尾各 5,000 字符。输出边界说明
实际处理可分三步:
- 先看文件引用或省略标记。 有文件引用时,按这次问题读取所需片段;有错误省略标记时,回到日志来源按时间或记录编号补取关键错误。
- 把下一次查询改小。 提供服务、时间段、错误类型、需要的字段和条数;别先把同一个完整结果再读一遍。
- 只有证据本身必须很大时,才考虑提高对应上限。 Claude 特有的
_meta["anthropic/maxResultSizeChars"]控制工具文本阈值;图片仍受MAX_MCP_OUTPUT_TOKENS限制。单工具限制说明
这些输出限制不等于整个上下文窗口容量。提高上限会允许更多内容进入对话,并不会减少内容。字符、UTF-8 字节和模型 token 是三种不同单位。不能把一个 JSON 的字节数当成 token,也不能把提高上限称为压缩。落盘只是把阅读推迟;如果下一步又把整个文件读进来,仍会增加上下文负担。
自建 MCP:让“查失败原因”只返回下一步需要的内容
假设你维护一个账单日志工具,原接口 read_billing_logs 总是返回整段日志。读者需要的结果其实是:失败有多少、主要是什么错误、哪条记录能证明它,以及如何继续查。
可以把工具设计成 find_billing_failures,接受时间范围、服务名和 limit;先做源头筛选与计数,再返回一页代表记录。get_failure_detail 只按记录编号取必要详情。两个工具的描述应说明用途、范围和输出,避免一个泛泛的 query 承担所有操作。
下面是自定义的业务返回示例,数据全部为演示,不是实际 Claude 调用或生产日志:
{
  "scope": {
    "service": "billing-worker",
    "from": "2026-10-06T09:00:00+08:00",
    "to": "2026-10-06T09:15:00+08:00"
  },
  "snapshot_id": "demo-billing-01",
  "total_failures": 5,
  "groups": [
    {"error_code": "DB_TIMEOUT", "count": 3, "sample_id": "err-101"},
    {"error_code": "INVALID_AMOUNT", "count": 2, "sample_id": "err-104"}
  ],
  "records": [
    {"id": "err-101", "job_id": "job-201", "error_code": "DB_TIMEOUT"},
    {"id": "err-104", "job_id": "job-204", "error_code": "INVALID_AMOUNT"}
  ],
  "returned": 2,
  "limit": 2,
  "next_cursor": "demo-page-2"
}
total_failures 表示整个筛选范围中的失败记录数,returned 只表示本页条数。不能把两个样例当作全部失败,也不能从样例比例推算类别总数;类别计数应在完整筛选结果上计算。这里故意返回两类代表错误,方便先形成调查方向,剩余记录仍可继续获取。同一任务若重复报错,应另按 job_id 去重统计受影响任务数,不能把日志行数直接当作任务数。
这里的 scope、计数、快照和游标都是应用设计,不是 MCP 必填字段。MCP 2025-11-25 规范允许 structuredContent、可选 outputSchema 等表达结果,但 JSON 本身并不会自动变小;规范中的 tools/list 分页用于工具目录,也不等于业务记录分页。MCP 工具规范
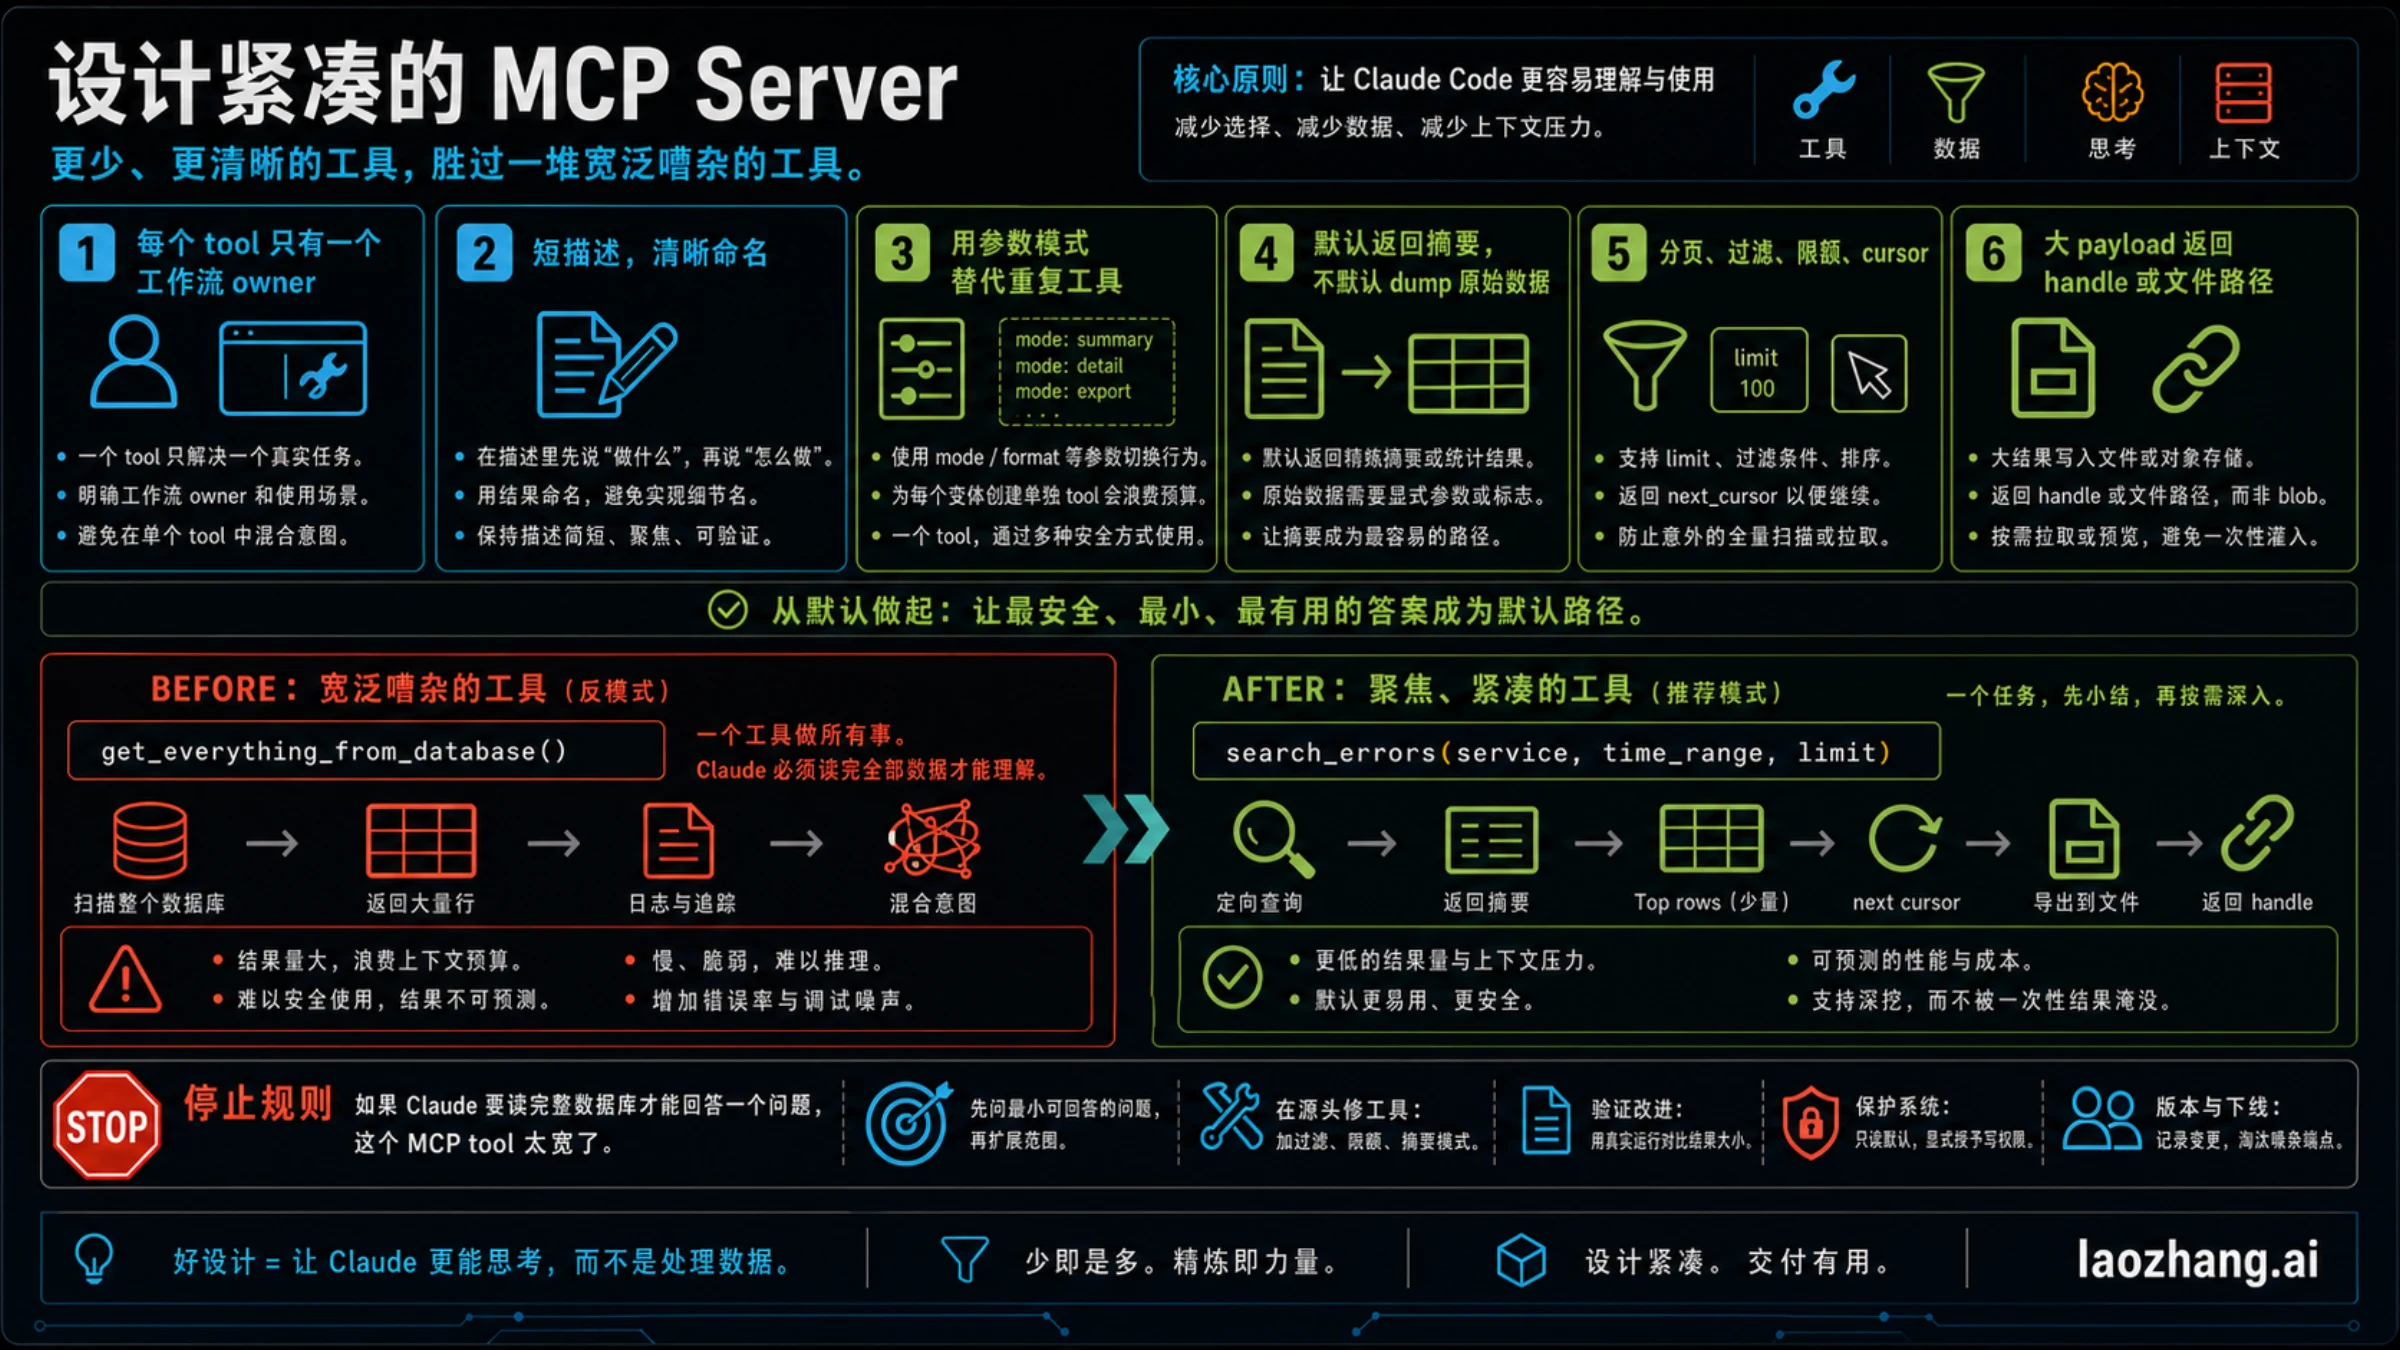
服务器端需要把以下关系实现完整,才不会变成“短但不可用”的结果:
- 范围固定。 首次查询确定时间段与筛选条件。分页游标对应同一快照或稳定排序,避免不断新增的日志造成漏项和重复。
- 详情可取。
sample_id和记录id应能交给详情工具,取到时间、任务编号、错误原因和必要堆栈。详情读取沿用原有授权检查。 - 截断可见。 如果某个字段只给了预览,就明确还有多少未显示以及如何取得完整内容,不把预览称为完整证据。
- 计数可信。 区分全部匹配数、当前页条数与类别统计的覆盖范围。若后端只统计当前页,字段和说明就应这样写。
- 大文件有可用入口。 返回资源 URI 或句柄前,确认目标客户端在现有权限下能读取;服务器本地的
file://路径不当然等于远程客户端可访问的文件。
对于上述演示,离线检查应能验证类别计数合计为 5、样例编号确实存在、所有分页合起来恰好覆盖那 5 条失败记录,而且两个错误类别都能取到详情。这些检查能证明返回逻辑,不能证明 Claude 的 token 用量、运行速度或排障成功率。
如果不能改第三方工具,就先改提问方式。例如:
查询 billing-worker 在 09:00–09:15 的失败记录。先返回失败总数、按错误码分组的数量和每类一条代表记录,保留记录编号。不要返回成功任务与完整日志;需要详情时再按编号取。
这是一份查询要求,是否能实现取决于工具是否提供对应筛选和汇总能力。工具不支持时,减少时间范围或分页取数;不能假装一句提示就给接口增加了新参数。
历史已经太重:先保存检查点,再 compact 或另开会话
把返回结果做小,主要改善后续调用。已经累积的旧日志、旧计划和文件内容,需要单独整理。Claude Code 的上下文包含指令、已加载内容、对话和工具结果,实际容量取决于模型及接入路径,不能统一按 200k 或某个固定缓冲区计算。上下文窗口说明
在整理前先留下一个可继续工作的检查点,例如:
当前任务:解释 billing-worker 的失败原因,尚未修改代码。
已确认:09:00–09:15 的演示数据有两类失败;真实结论需查真实记录。
需要保留:查询时间段、错误记录编号、已核对的文件位置。
已排除:列出有证据排除的原因,不能把猜测写成已排除。
下一步:按代表记录取详情,再检查对应代码路径。
访问要求:保留日志查询;浏览器验证留到修复后恢复。
真实工作中把演示内容替换成已有事实与路径。检查点不必保存每次失败尝试,但应保留结论依据、未决问题和下一动作,避免新会话重复走已经排除的分支。
/compact 在同一会话中压缩历史,可附带重点;/clear 开始空的对话上下文,项目记忆仍保留。两者行为不同,操作前确认要保留什么。命令参考
子代理可以把后续窄范围调查放到独立上下文,再返回结论、计数与证据位置,但它不会删除主会话里已有的大结果。任务复杂时可以用,不能把它当作已经累积内容的橡皮擦。压缩之后也别立刻要求“重新完整读取所有日志”,否则同一压力很快回来。
用同一个任务确认整理真的有效
不要把整理前的“读全部日志”与整理后的“只读一行”直接比较,然后宣称成功。固定一个本来就有价值的任务,例如找出某时间段的失败类别、数量和代表证据;两次都保留相同的服务、范围与成功条件。
记录这几项就足够做判断:
| 对比项 | 整理前后要确认什么 |
|---|---|
/context 中的主要占用与可用空间 | 增长发生在哪一步;工具定义、结果或历史谁变小了 |
| 返回的覆盖范围 | 时间、服务和筛选条件一致,没有悄悄少查数据 |
| 任务结果 | 仍能得到需要的类别、数量与代表错误 |
| 证据可访问性 | 记录编号或文件引用能继续读取,关键内容没有只剩无法打开的句柄 |
| 后续工作 | 能继续完成代码定位或验证,不需要恢复全部无关服务器 |
结果变短且上述任务仍能完成,才说明此次整理对这个任务有效。若只有数字下降,却无法解释失败原因,先恢复必需访问或补上详情;若占用仍高,按增长位置继续定位,别一次改变所有配置。
这里没有提供真实 Claude Code 会话的前后性能测试,也不承诺节省比例或固定适用的服务器数量。你自己的同任务结果比服务器清单长度更能说明问题。
几个容易误判的问题
“Server overloaded” 就是 MCP 吃满上下文吗?
不是。直接 Claude API 的 HTTP 529 与 overloaded_error 表示服务暂时过载,不能据此诊断 MCP 上下文窗口。先确认错误来自哪一层,保留 HTTP 状态、错误类型和请求编号;代理包装后的文字也可能不同。关闭 MCP 或 compact 不是这个错误的确定修复方法。Claude API 错误说明
Claude Code 很慢,是否应该先执行 /doctor?
如果没有明显的上下文增长线索,可以查看诊断,但要区分两个入口:当前交互式 /doctor 是会提出配置或上下文修复建议的 skill,修改需要确认;终端中的 claude doctor 则输出安装诊断。不能把前者一概称为只读。命令参考
若主要现象是 CPU、内存或持续卡顿,应按官方故障排查转向运行环境。安全模式会禁用多种自定义内容,不能仅凭它变快就认定是某个 MCP 的上下文问题。
一定要删掉 MCP 配置才能减少占用吗?
不必。先用项目内的停用开关做可逆比较,确认当前任务不依赖该访问再决定长期安排。工具搜索负责发现,输出筛选负责结果,压缩会话负责历史;三种动作针对的内容不同,不需要全靠删除服务器解决。
输出已经保存到文件,还需要服务器分页吗?
需要时仍然有价值。文件引用让你可以按需读取,服务器分页则让首次返回就围绕当前任务组织内容。若每次查询都生成巨大文件、下一步又完整读取,主会话仍会积累同一批内容。优先让查询范围和返回字段与下一步判断一致。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月6日。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月6日。
- 1.命令参考code.claude.com/docs/en/commands
- 2.官方工具搜索说明code.claude.com/docs/en/mcp
- 3.Anthropic 的 MCP 代码执行分析anthropic.com/engineering/code-execution-with-mcp
- 4.MCP 工具规范modelcontextprotocol.io/specification/2025-11-25/server/tools
- 5.上下文窗口说明code.claude.com/docs/en/context-window
- 6.Claude API 错误说明platform.claude.com/docs/en/api/errors
- 7.官方故障排查code.claude.com/docs/en/troubleshooting