Ошибка 429 в OpenAI API: как определить причину и восстановить запросы
Ошибка 429 в OpenAI API может означать временное ограничение запросов, исчерпанный баланс или месячный предел расходов. Разберитесь по коду ошибки, выберите действие и проверьте восстановление одним запросом перед запуском очереди.
Содержание
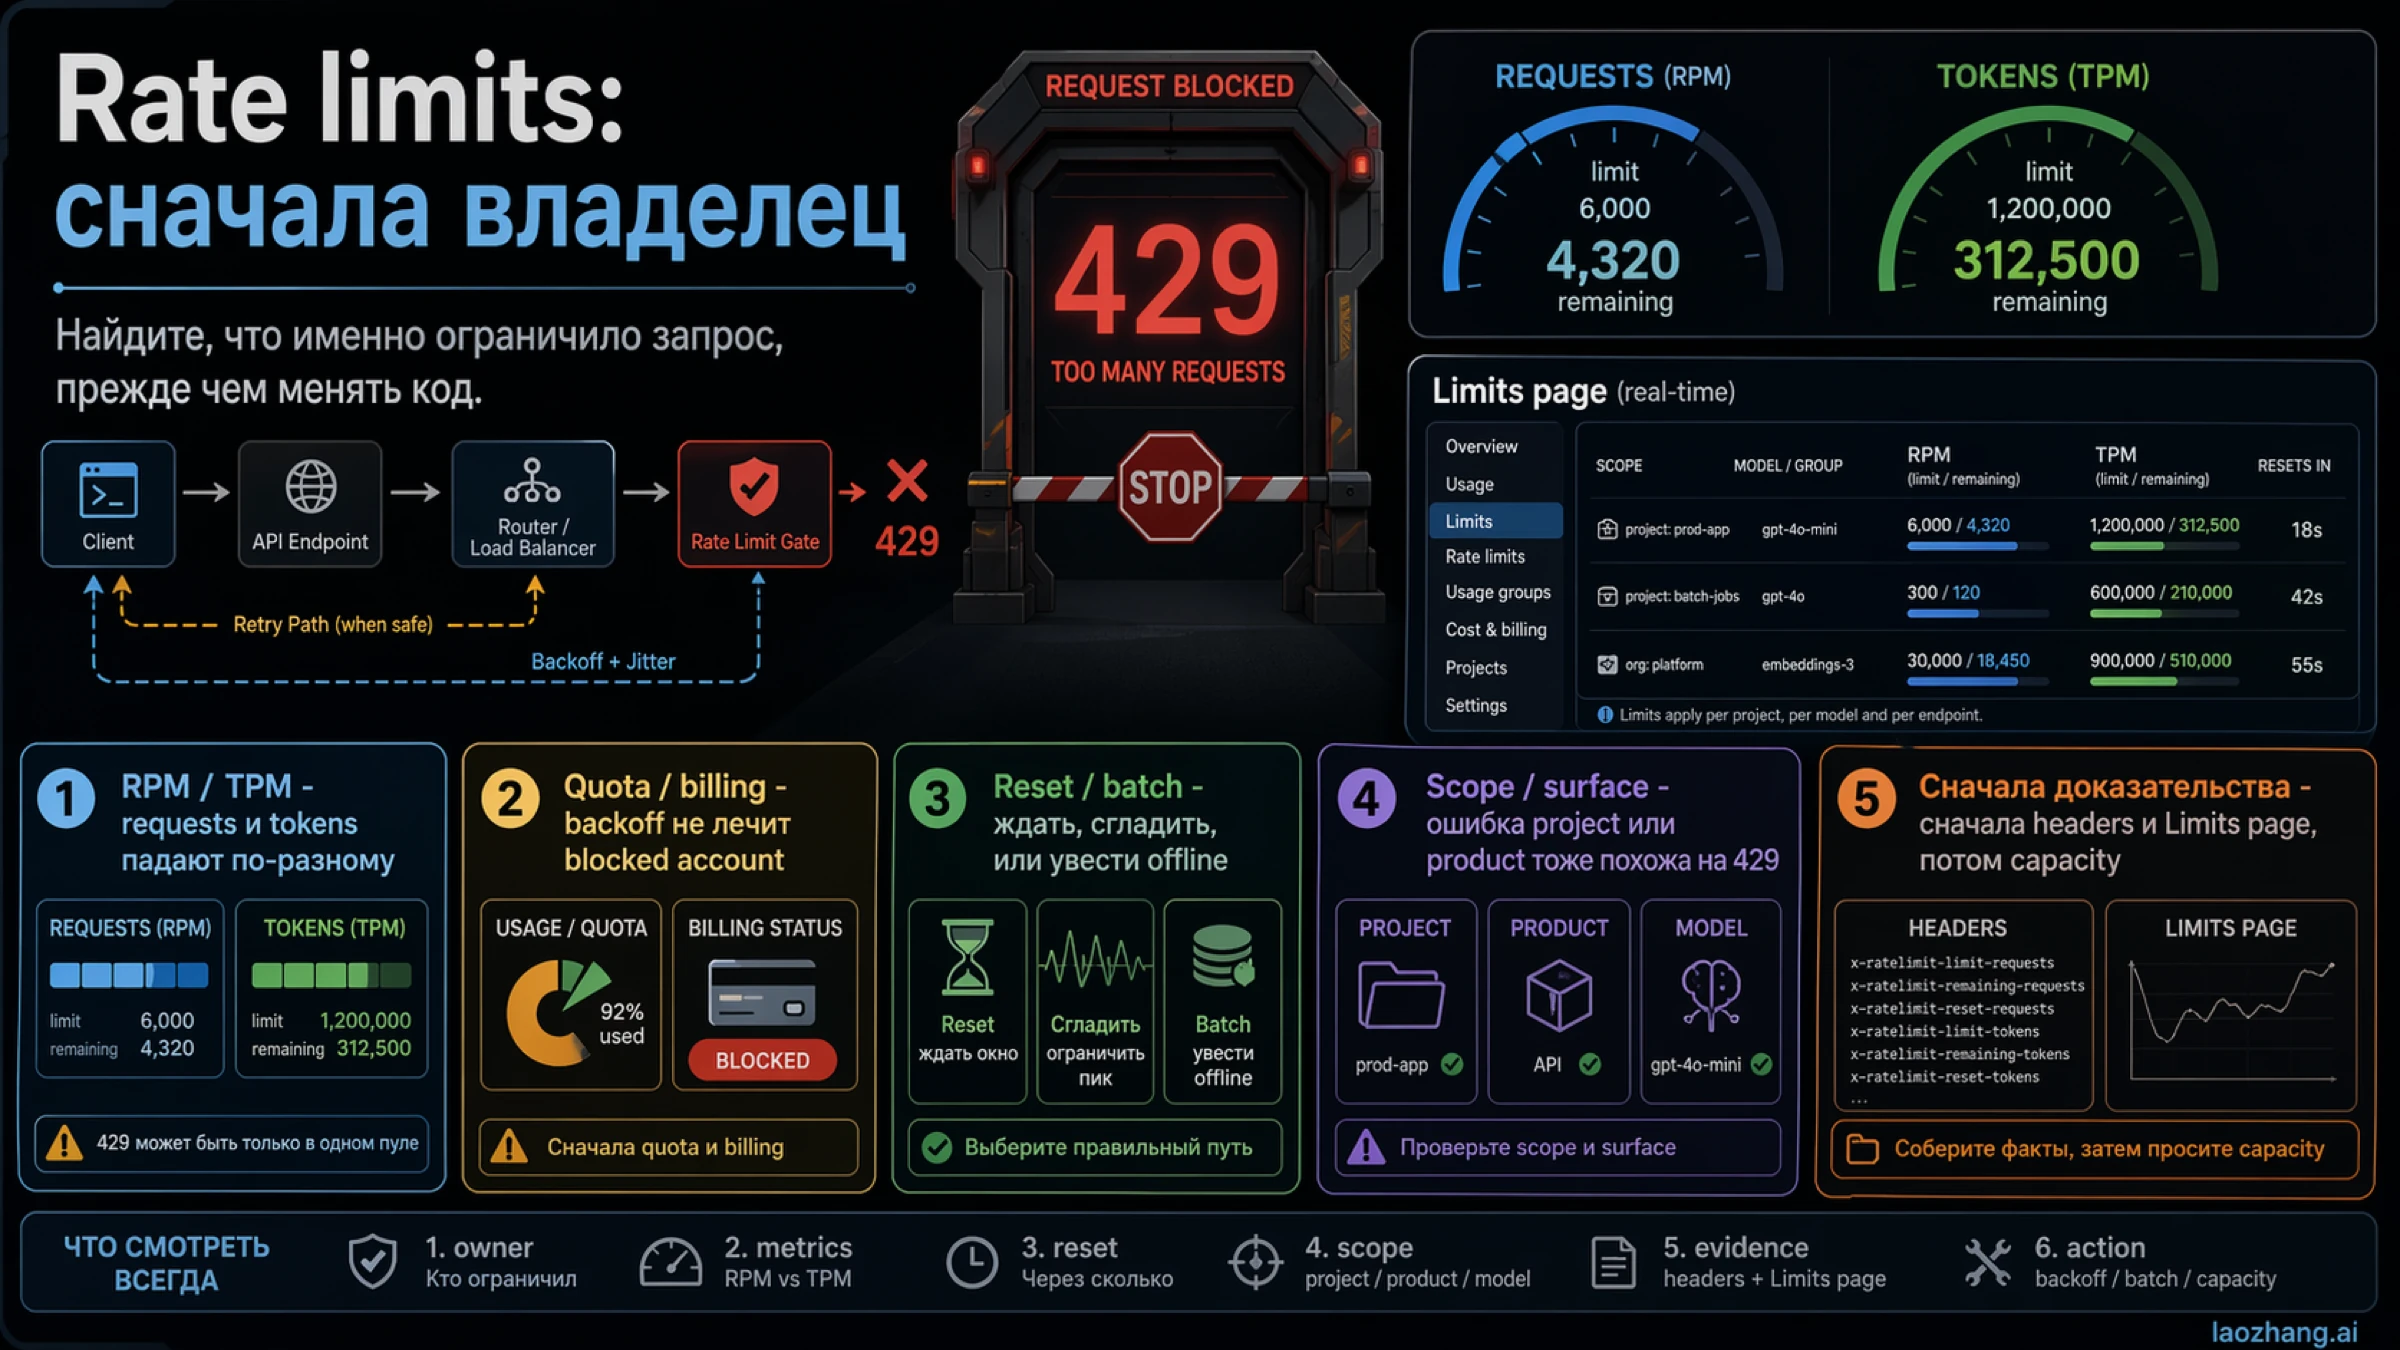
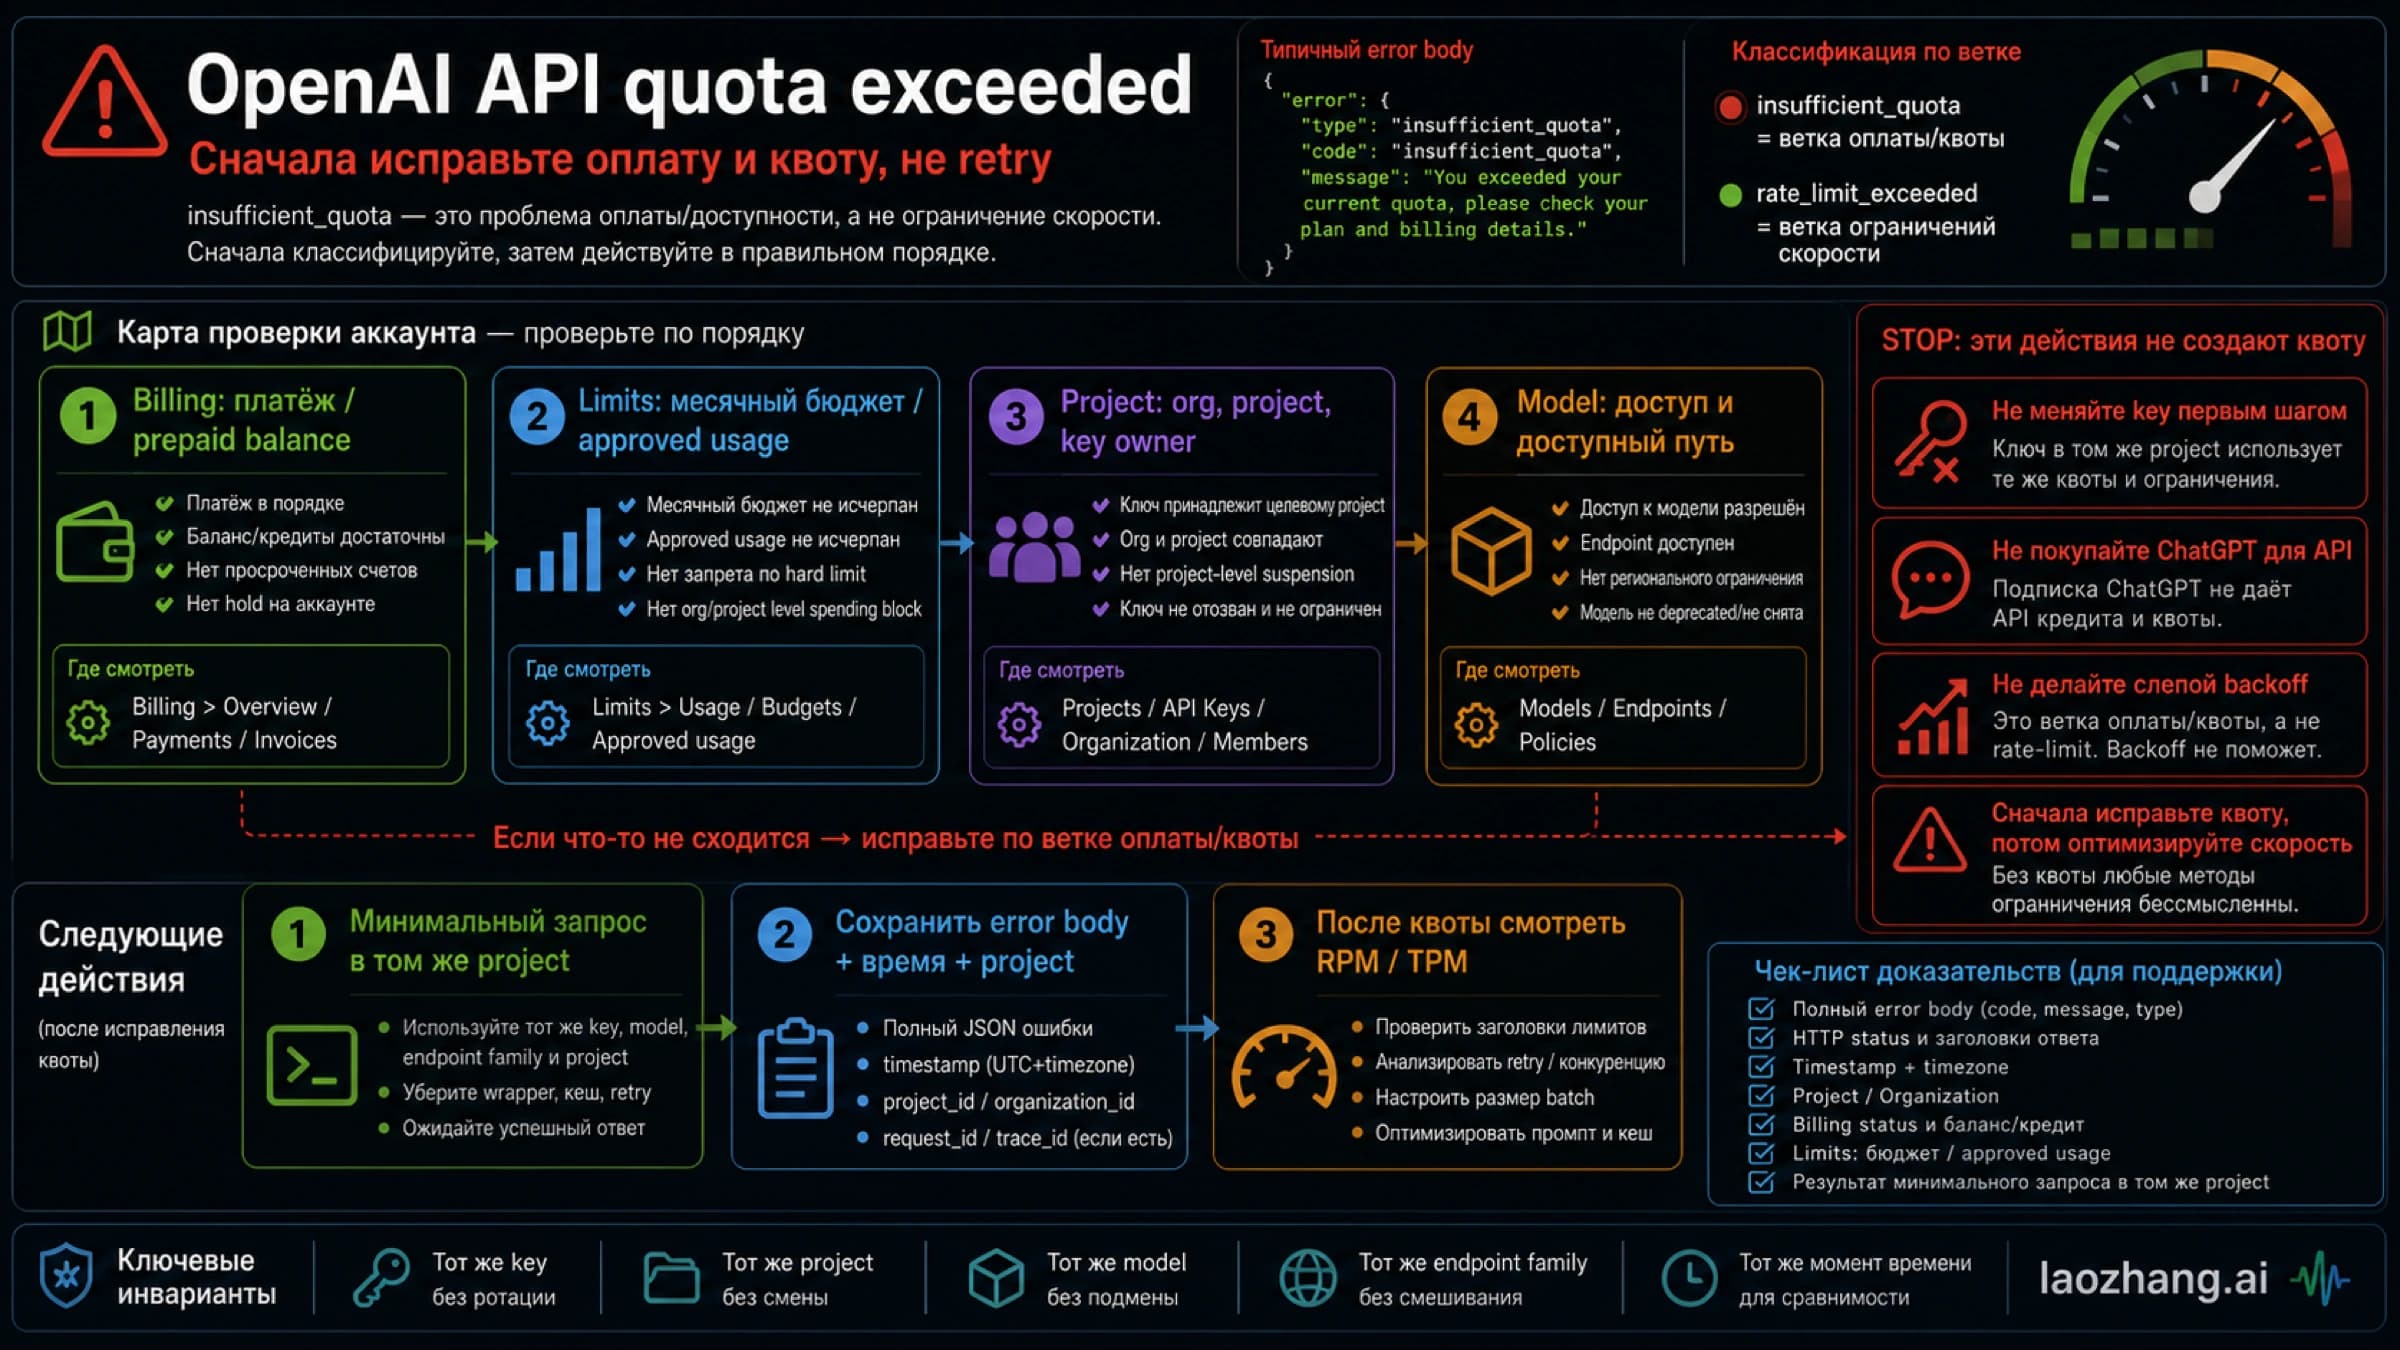
Ошибка 429 Too Many Requests в OpenAI API не всегда означает, что приложение отправляет слишком много запросов. Тот же статус возвращается при исчерпанном балансе или действующем месячном ограничении расходов. Сначала прочитайте error.code, error.type и сообщение в теле ответа: для временного ограничения нужна пауза, а для проблемы с оплатой — изменение состояния аккаунта. Бесконечный повтор не заменяет эту проверку.
Далее — порядок диагностики прямого OpenAI API по документации, проверенной 8 сентября 2026 года. Он подходит и для первого неудачного вызова, и для приложения, которое начало получать 429 под нагрузкой. Ограничения Azure OpenAI разбираются отдельно; ответ стороннего шлюза нужно дополнительно сверять с его правилами.
Найдите причину в теле ответа
Сохраните исходный ответ до того, как библиотека или интерфейс превратит его в короткое «превышен лимит». Важны HTTP-статус, поля error.code, error.type, error.message, идентификатор запроса и заголовки. Название исключения SDK — ещё не диагноз: в Python ответ 429 попадает в RateLimitError, в том числе когда причиной является квота. Это следует из справочника Python SDK.
Справочник ошибок и русская справка о 429 позволяют разделить основные случаи:
| Что видно в ответе | Что проверять | Что делать сначала |
|---|---|---|
| 429, сообщение о лимите запросов или токенов | RPM, TPM, остаток и время сброса соответствующего окна | Приостановить отправку и уменьшить нагрузку |
429, rate_limit_error, код slow_down | Резкий рост трафика, даже при запасе RPM и TPM | Соблюсти Retry-After, затем увеличивать частоту постепенно |
429, код credit_balance_exhausted | Предоплаченный баланс организации | Пополнить баланс и дождаться применения изменения |
429, код organization_usage_limit_exceeded | Назначенный организации месячный лимит использования API | Проверить Limits и возможность повышения лимита либо дождаться нового периода |
429, код organization_spend_limit_exceeded | Жёсткий месячный предел расходов организации | Проверить установленный предел и текущий расход |
429, код project_spend_limit_exceeded | Жёсткий месячный предел расходов конкретного проекта | Проверить настройки и расход именно этого проекта |
429, только общее insufficient_quota | Баланс, месячные ограничения, организация и проект ключа | Уточнить причину по сообщению и консоли; не запускать автоматический цикл |
503, service_unavailable_error, код server_is_overloaded | Временная нехватка мощности модели | Соблюсти паузу сервера; при продолжении сбоя проверить состояние сервиса |
Поле error.type у ошибок оплаты может оставаться insufficient_quota, тогда как конкретная причина указана в error.code. Поэтому проверка только типа теряет различие между пустым балансом, назначенной квотой и жёстким пределом расходов. Если код неизвестен, не считайте его временным только из-за числа 429: сопоставьте сообщение с документацией и настройками аккаунта.
Для журнала достаточно времени события, модели, endpoint, проекта, HTTP-статуса, типа и кода ошибки, x-request-id, номера попытки и доступных заголовков лимита. Не сохраняйте API-ключ или полный пользовательский ввод. В Python исключение APIStatusError предоставляет request_id и response, из которого можно прочитать заголовки. Такой журнал помогает установить, какой именно запрос и какое ограничение вызвали остановку.
Если причина в оплате: проверьте четыре разных ограничения
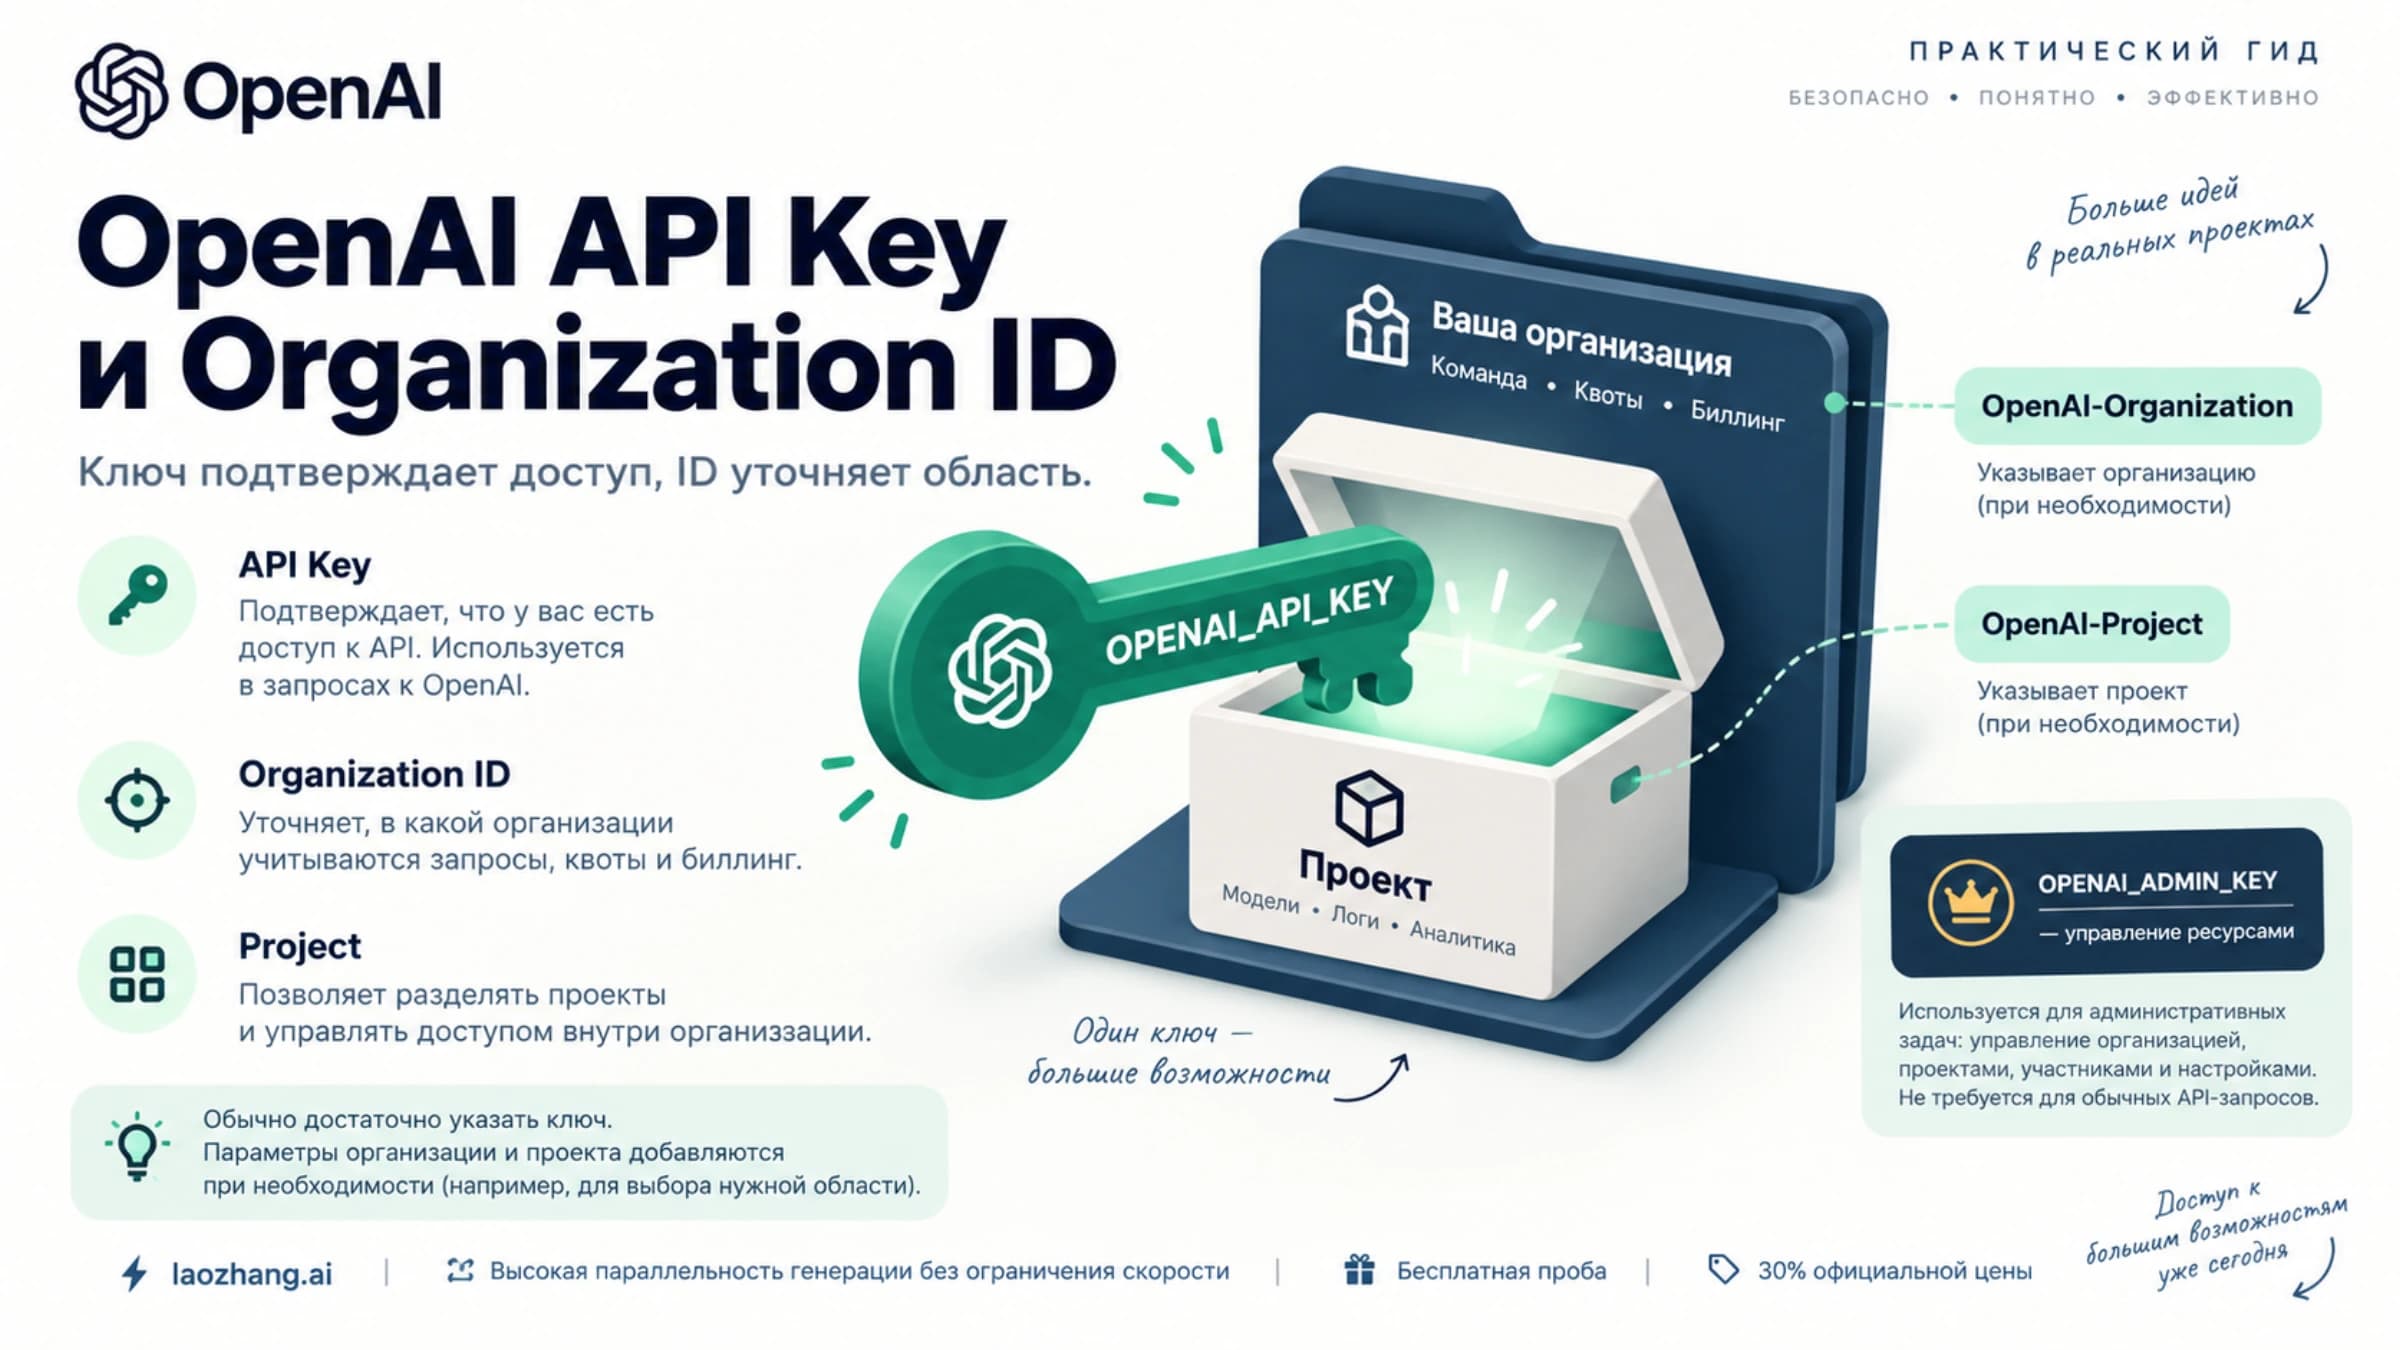
Начните с организации и проекта, которым принадлежит ключ приложения. Открытая в браузере консоль может показывать другую организацию; работающий ключ из одного проекта ничего не доказывает о втором. Сверьте конфигурацию приложения, выбранный проект, баланс и страницу Limits.
Затем проверяйте показатель, соответствующий коду ошибки:
- Предоплаченный баланс. При
credit_balance_exhaustedорганизации не хватает предоплаченных средств. Ожидание минутного окна RPM не пополнит баланс. После пополнения дайте изменению примениться и проверьте его в консоли. - Назначенный месячный лимит использования.
organization_usage_limit_exceededотносится к лимиту, разрешённому организации. Наличие денег не означает, что этот предел автоматически снят; проверьте возможность его повышения. - Жёсткий предел расходов организации.
organization_spend_limit_exceededблокирует трафик всех её проектов. Увеличение бюджета одного проекта не отменяет общий предел. - Жёсткий предел расходов проекта.
project_spend_limit_exceededдействует для затронутого проекта. Администратору нужно проверить именно его настройки, а не только общий расход организации.
Если кредиты закончились при включённом автопополнении, воспользуйтесь разбором сбоя автопополнения OpenAI API: там описано, как проверить настройки и оплату, пополнить баланс вручную и отдельно убедиться, что автоматические покупки возобновились.
Уведомление о достижении бюджета и жёсткий предел расходов выполняют разные функции. Согласно руководству OpenAI по ограничениям расходов, предупреждения уведомляют о расходе, а настроенный жёсткий предел прекращает запросы с конкретным кодом ошибки. Не делайте вывод «бюджет исчерпан — API заблокирован» по одному уведомлению. Смотрите, включено ли принудительное ограничение и на каком уровне.
Изменения применяются не обязательно мгновенно. Новый месячный период может снять исчерпание месячного предела расходов, но сам по себе не пополняет предоплаченный баланс. После исправления выполните один небольшой запрос с теми же ключом, проектом и моделью. Если код остался прежним, снова проверьте соответствующий показатель, а не увеличивайте число повторов. Подробный разбор общей ошибки квоты есть в статье OpenAI API: quota exceeded.
Если причина в частоте: читайте RPM и TPM раздельно
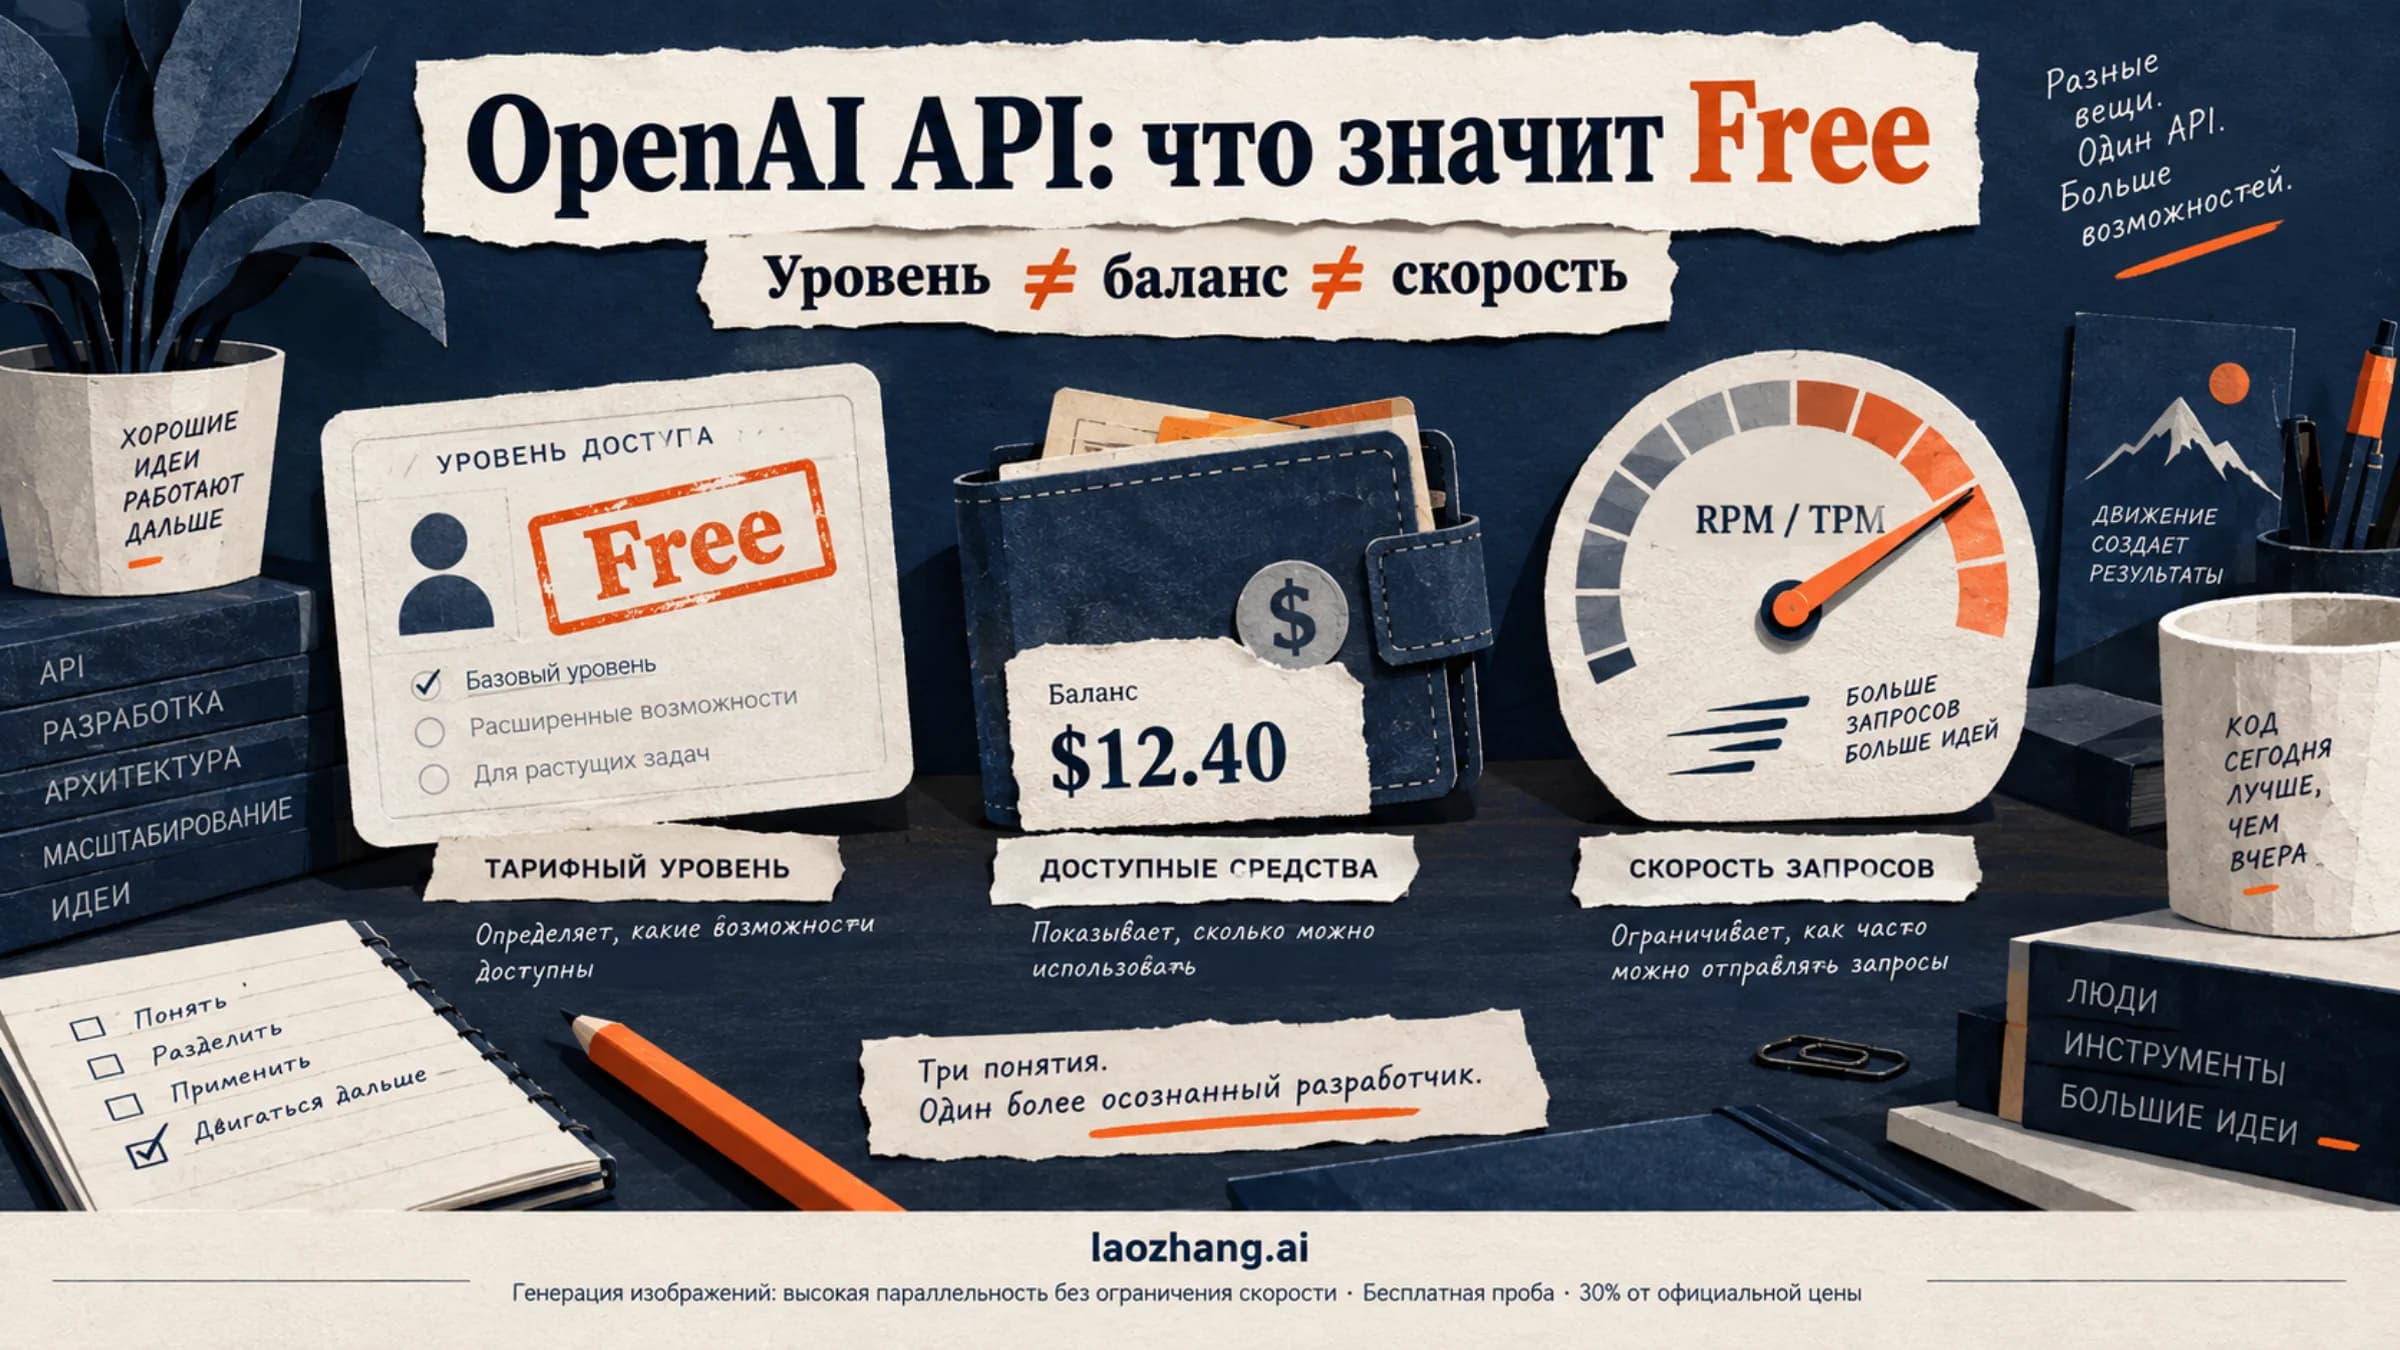
RPM — число запросов в минуту, TPM — число токенов в минуту. Эти ограничения действуют одновременно: свободные запросы не компенсируют закончившиеся токены. Лимиты могут применяться к организации и проекту, различаться между моделями или быть общими для нескольких моделей. Актуальные значения берите из Limits, а состояние окна — из ответа сервера. Область действия и заголовки описаны в руководстве по лимитам API.
| Заголовки ответа | Что они показывают | Как использовать |
|---|---|---|
x-ratelimit-limit-requests, x-ratelimit-remaining-requests | Предел и остаток запросов | При малом остатке ограничить подачу новых заданий |
x-ratelimit-reset-requests | Время до сброса ограничения запросов | Учитывать при выборе следующей попытки |
x-ratelimit-limit-tokens, x-ratelimit-remaining-tokens | Предел и остаток токенов | Проверить длину входа и допустимый размер ответа |
x-ratelimit-reset-tokens | Время до сброса ограничения токенов | Не ориентироваться только на окно запросов |
Retry-After | Минимальную паузу перед повтором, если она передана сервером | Не повторять раньше указанного срока |
Сохраняйте также доступные x-ratelimit-*, относящиеся к токенам проекта. Отсутствующий заголовок означает, что показатель не получен; это не нулевой и не бесконечный лимит. При одновременном исчерпании нескольких окон ориентируйтесь на более поздний допустимый срок отправки, соблюдая Retry-After.
Средняя нагрузка за минуту может выглядеть нормальной, а короткий всплеск — превышать ограничение. Например, лимит 60 RPM не следует понимать как разрешение отправлять все 60 запросов в первую секунду. Кроме того, неудачные запросы тоже учитываются в лимитах: быстрые повторы занимают ресурс, нужный для восстановления. Это отдельно поясняет справка OpenAI о 429.
При исчерпании RPM поставьте задания в общую очередь и дозируйте их отправку. Ограничение одновременных запросов полезно, но само по себе не задаёт частоту: если ответы приходят быстро, даже несколько рабочих процессов могут отправлять много запросов в секунду. Учитывайте суммарную нагрузку всех экземпляров приложения, использующих одну квоту.
При исчерпании TPM уберите лишнюю историю и повторяющиеся документы из входа, а размер ответа ограничьте под задачу. В Responses используется max_output_tokens, в Chat Completions — max_completion_tokens; предел охватывает и рассуждения, и видимый ответ. Слишком маленькое значение может оборвать полезный результат, поэтому сокращение надо проверять на характерных заданиях, а не только на коротком тесте.
Настройте повторы так, чтобы они не усиливали сбой
Автоматические повторы подходят для подтверждённого временного ограничения, включая slow_down, и для временной перегрузки server_is_overloaded. При ошибках баланса, расходов или доступа сначала исправляют причину. Не назначайте одну стратегию всему классу RateLimitError.
Ниже — практическая схема поведения приложения, а не готовый обработчик SDK:
- После неудачного запроса классифицировать статус и тело ошибки. При проблеме оплаты, доступа, неизвестной причине или отмене задания — остановиться.
- Проверить остаток общего времени и числа попыток. В число попыток включать первоначальный запрос.
- Если
Retry-Afterкорректен, выдержать как минимум указанную паузу. Если она не помещается в оставшееся время задания, отложить задание или завершить его с понятной ошибкой; не сокращать серверную паузу до своего максимума. - Если заголовка нет или его нельзя разобрать, использовать экспоненциальную задержку со случайным разбросом. Например, для первых повторов выбирать паузу из интервалов 1–2, 2–4 и 4–8 секунд. Это пример настройки приложения, а не обещание восстановления за восемь секунд.
- Перед каждой следующей попыткой снова проверять отмену и оставшийся срок. Ограничить также время самого HTTP-запроса, чтобы зависший вызов не обходил общий бюджет.
- После последней разрешённой попытки вернуть управляемую ошибку или перенести задание в отложенную очередь. Сохранить последнюю причину и идентификатор запроса.
Особенно проверьте повторы внутри SDK. Python SDK OpenAI по умолчанию дважды повторяет подходящие ошибки, включая 429 и 5xx. Если поверх него приложение делает до четырёх попыток, один пользовательский запрос при повторяемой ошибке может вызвать до 12 HTTP-запросов: четыре вызова SDK по три отправки каждый. Дополнительные повторы рабочего процесса увеличат это число ещё сильнее.
Если единым бюджетом и паузами управляет ваш код, отключите внутренние повторы Python SDK через max_retries=0. Если используете встроенные повторы, учитывайте их в общем времени и не добавляйте поверх них независимый бесконечный цикл. Для ограничения на уровне организации полезно координировать очередь между рабочими процессами: случайная задержка каждого клиента уменьшает синхронность, но не ограничивает суммарный поток сама по себе.
slow_down может возникать до исчерпания RPM и TPM, потому что трафик вырос слишком быстро. После паузы возобновляйте поток постепенно. server_is_overloaded относится к HTTP 503 и временной мощности модели; при повторении проверьте состояние OpenAI. Резервная модель пригодна только после проверки качества, совместимости и стоимости, причём она может использовать общий лимит с основной. Ни покупка кредитов, ни переключение модели не являются универсальным исправлением 429.
Планируйте пропускную способность: пример GPT-6 Astra
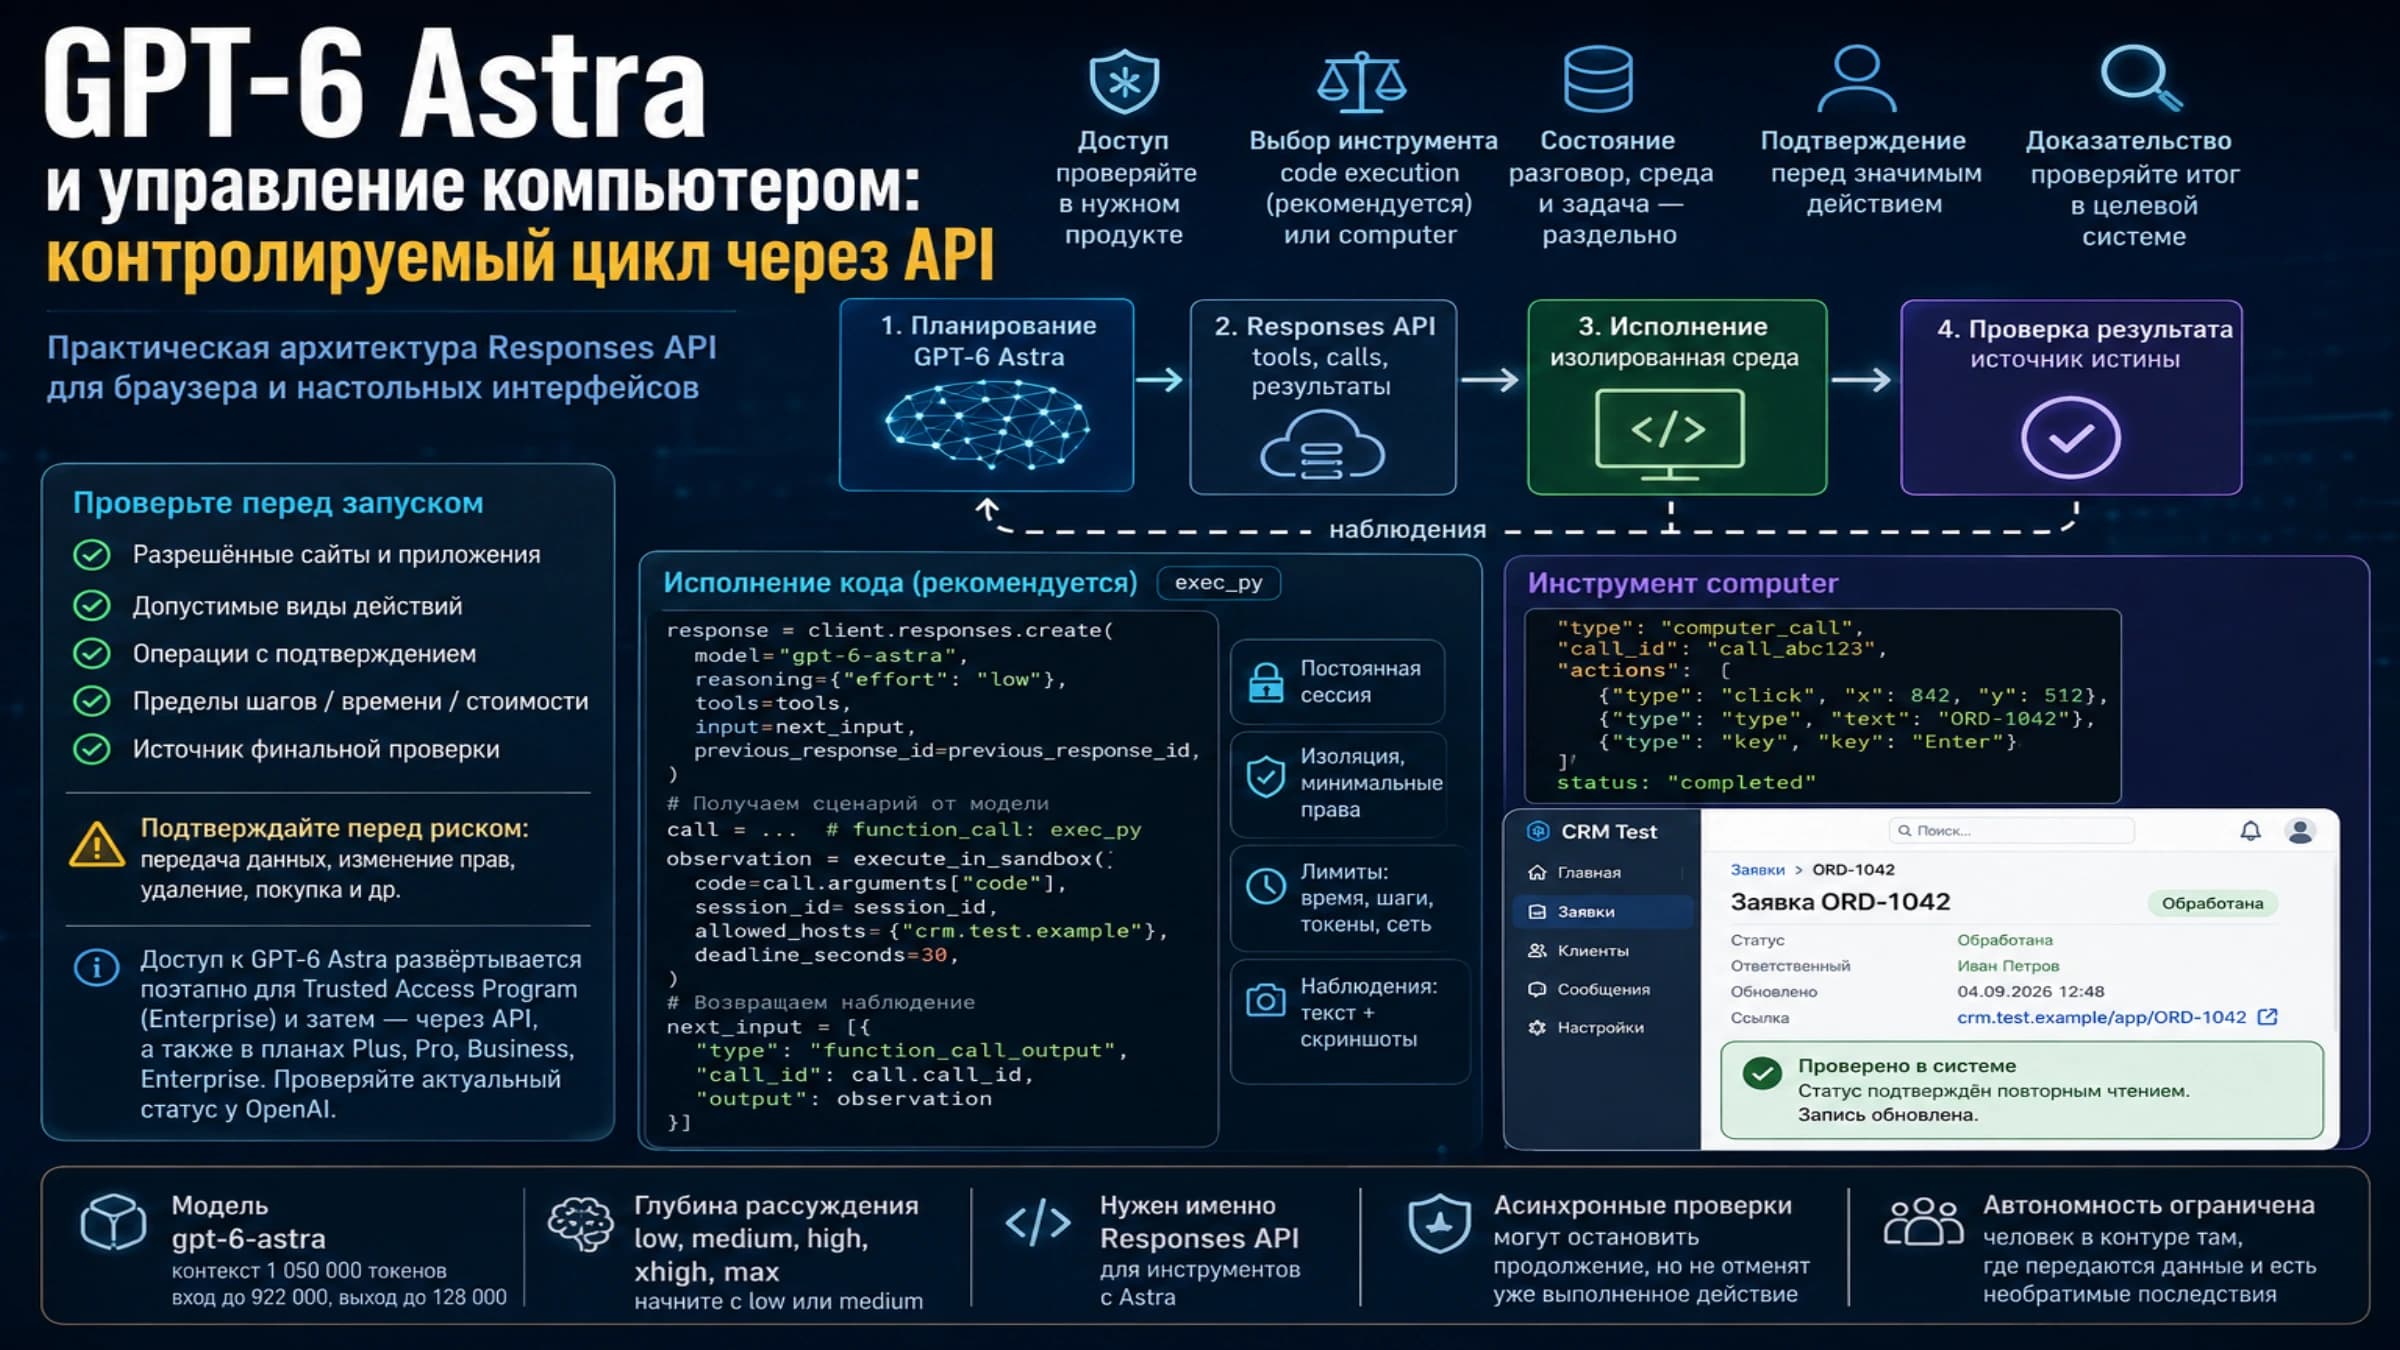
После устранения ошибки стоит проверить, помещается ли обычная нагрузка в назначенные ограничения. Для gpt-6-astra официальная карточка модели на 8 сентября 2026 года публикует следующие значения для Standard:
| Уровень использования API | RPM | TPM | Очередь Batch, входных токенов |
|---|---|---|---|
Free | не поддерживается | не поддерживается | не поддерживается |
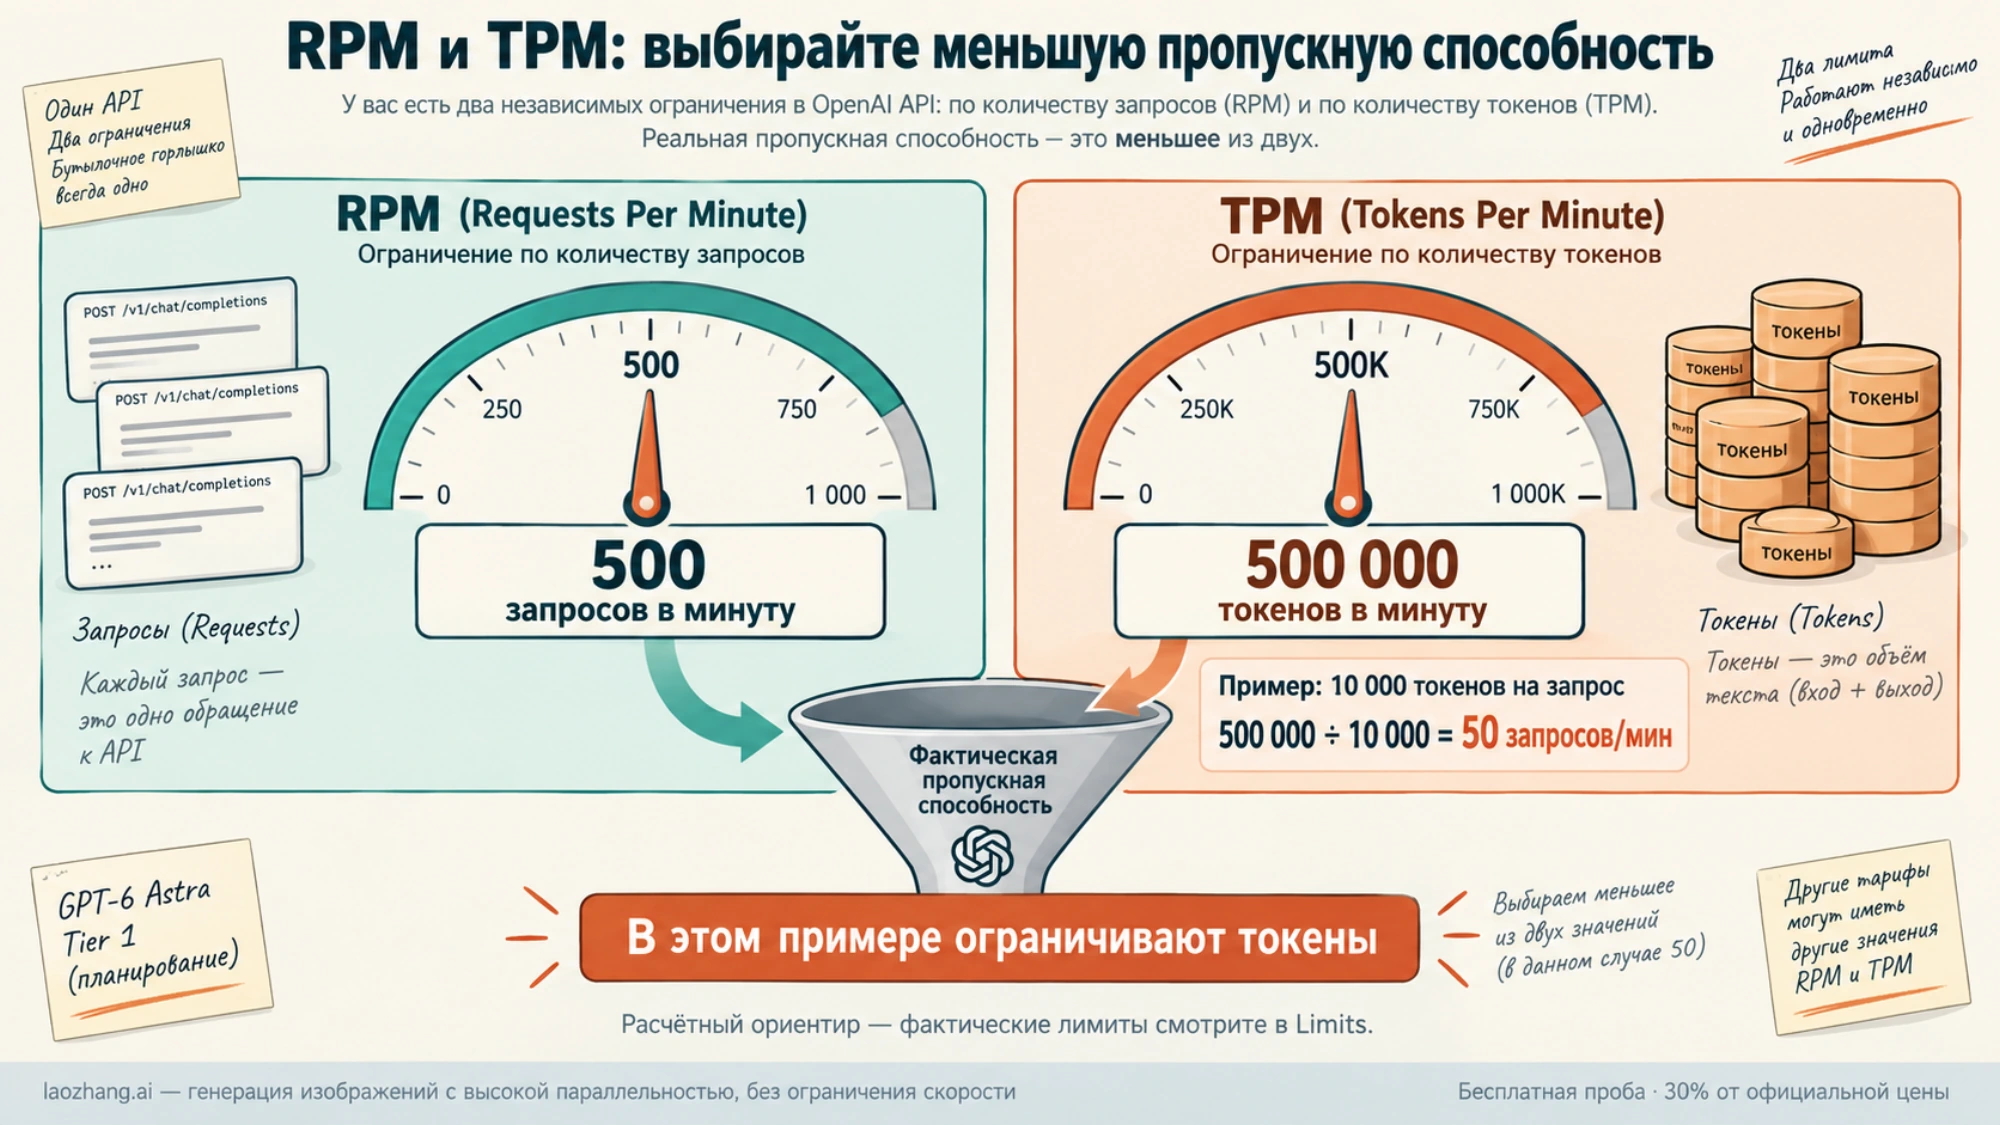
Tier 1 | 500 | 500 000 | 1 500 000 |
Tier 2 | 5 000 | 1 000 000 | 3 000 000 |
Tier 3 | 5 000 | 2 000 000 | 100 000 000 |
Tier 4 | 10 000 | 4 000 000 | 200 000 000 |
Tier 5 | 15 000 | 40 000 000 | 15 000 000 000 |
Это опубликованные ориентиры, а не подтверждение доступа и квоты конкретного ключа. Сначала проверьте доступ проекта к Astra, затем его текущие значения в Limits. Наличие модели в документации или в подписочном продукте не выдаёт разрешение API-проекту.
Для предварительной оценки устойчивой частоты используйте меньшую из двух величин: разрешённые RPM и TPM, разделённые на плановый расход токенов одного запроса. Допустим, при Tier 1 на запрос приходится условно 10 000 токенов для расчёта нагрузки. Тогда 500 000 / 10 000 даёт 50 запросов в минуту по токенам, хотя колонка RPM разрешает 500. Это расчётный пример, не измеренная производительность: оставляйте запас под разброс длины и сверяйте оценку с фактическими заголовками.
Очередь Batch API измеряется суммой входных токенов ожидающих заданий для модели. Значение 1 500 000 у Tier 1 не означает столько же заданий, одновременных вызовов или суточных запросов. Batch подходит для несрочной массовой обработки, но требует отдельного контроля вместимости очереди. Его назначение и расчёт описаны в руководстве по лимитам.
Режимы Standard и Fast одной модели используют общий лимит: Fast не добавляет отдельный запас RPM или TPM. Это уточняет документация Fast. Порог ввода свыше 272 000 токенов в карточке Astra относится к изменению цены длинного контекста, а не к универсальному порогу ошибки 429. Стоимость разобрана в статье о ценах GPT-6 Astra API.
Не выводите суточные лимиты, разрешённый параллелизм или отдельную квоту длинного контекста из этой таблицы. Когда конкретное ограничение не опубликовано, проверяйте назначенные параметры аккаунта. Для повышения лимита соберите профиль реальной нагрузки: частоту, размеры запросов, остатки токенов, длительность очереди и долю ошибок. Это позволяет отличить нехватку постоянной мощности от неудачной организации всплесков.
Как убедиться, что запросы восстановились
После исправления баланса, ограничения расходов или временной перегрузки начните с одного небольшого запроса. Сохраните прежние ключ, проект и модель: смена сразу нескольких параметров скроет, что именно помогло. Успешный ответ доказывает работоспособность этого вызова, но ещё не готовность выдержать всю очередь.
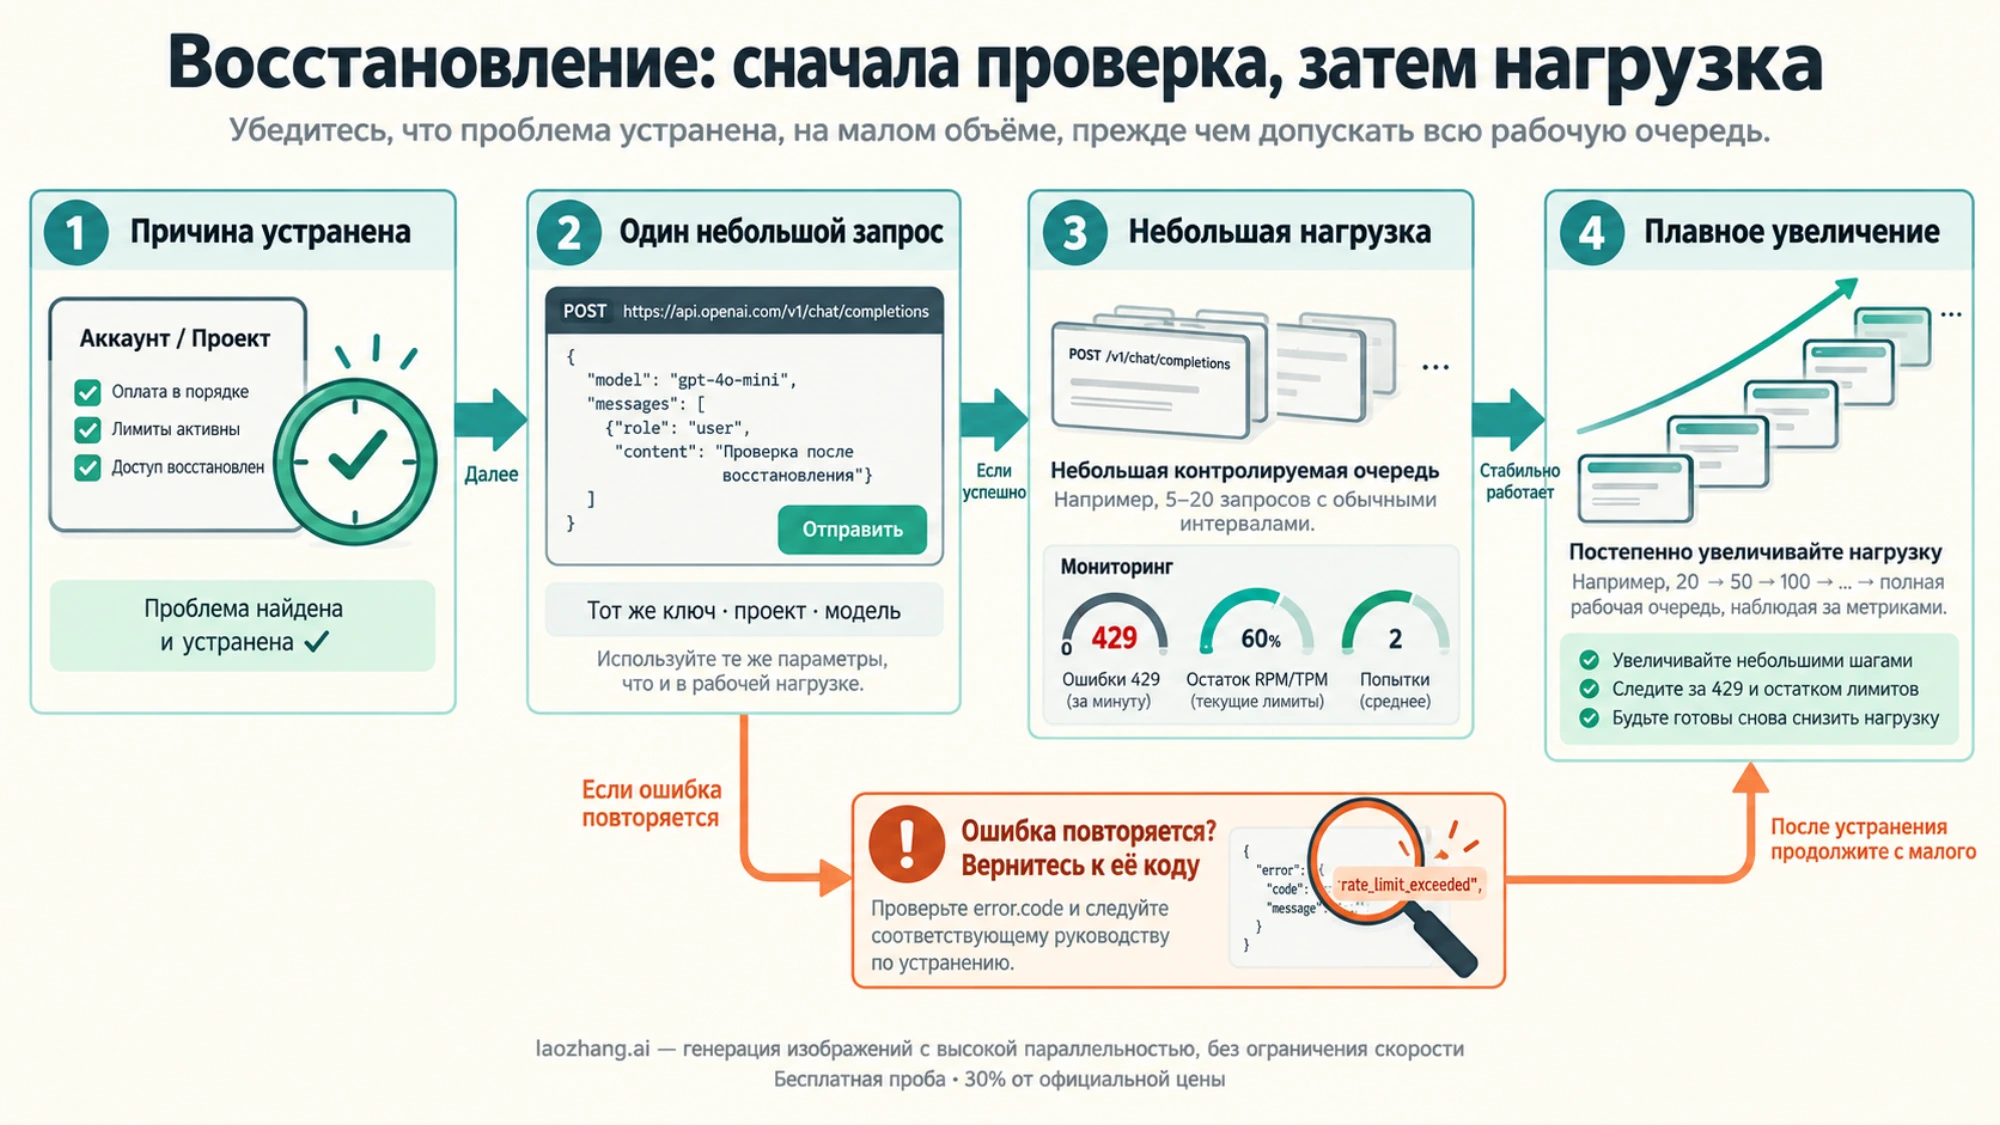
Верните небольшую долю обычного потока и наблюдайте за остатком запросов и токенов, повторными 429, временем ожидания и числом реальных HTTP-попыток. Затем плавно увеличивайте подачу заданий. Если короткий запрос проходит, а длинные снова вызывают 429, проверьте TPM и параметры ответа. Если ошибки появляются только при запуске всей очереди, проверьте всплеск частоты, число рабочих процессов и slow_down. Если сохраняется тот же код оплаты, вернитесь к соответствующему показателю аккаунта.
Когда причина остаётся неясной, передайте поддержке время события, идентификаторы запросов, модель, проект, коды и доступные заголовки без ключей и пользовательского содержимого. Не подменяйте эти данные одним скриншотом надписи «429».
Наконец, убедитесь, что ограничение действительно относится к API. Подписка ChatGPT и окна использования Codex не превращаются в RPM и TPM API-проекта. Для ошибки внутри Codex полезен разбор превышения числа повторов 429, а выбор системы оплаты объясняет статья API-ключ или подписка для Codex. Исправление должно относиться к той системе, которая отклонила запрос.
Источники9
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 8 сент. 2026 г..
Источники9
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 8 сент. 2026 г..
- 1.справочника Python SDKdevelopers.openai.com/api/reference/python
- 2.Справочник ошибокdevelopers.openai.com/api/docs/guides/error-codes
- 3.русская справка о 429help.openai.com/ru-ru/articles/5955604
- 4.Limitsplatform.openai.com/settings/organization/limits
- 5.руководству OpenAI по ограничениям расходовdevelopers.openai.com/api/docs/guides/spend-limits
- 6.руководстве по лимитам APIdevelopers.openai.com/api/docs/guides/rate-limits
- 7.состояние OpenAIstatus.openai.com
- 8.официальная карточка моделиdevelopers.openai.com/api/docs/models/gpt-6-astra
- 9.документация Fastdevelopers.openai.com/api/docs/guides/fast-mode