Claude Memory MCP в 2026: что это такое, что Claude Code уже помнит и когда действительно нужен внешний MCP
Практическое руководство по границе между встроенной памятью Claude Code и внешним memory MCP: что уже делают `CLAUDE.md` и auto memory, когда внешняя persistence реально добавляет ценность и какой setup surface оказывается самым легким и безопасным.
Содержание
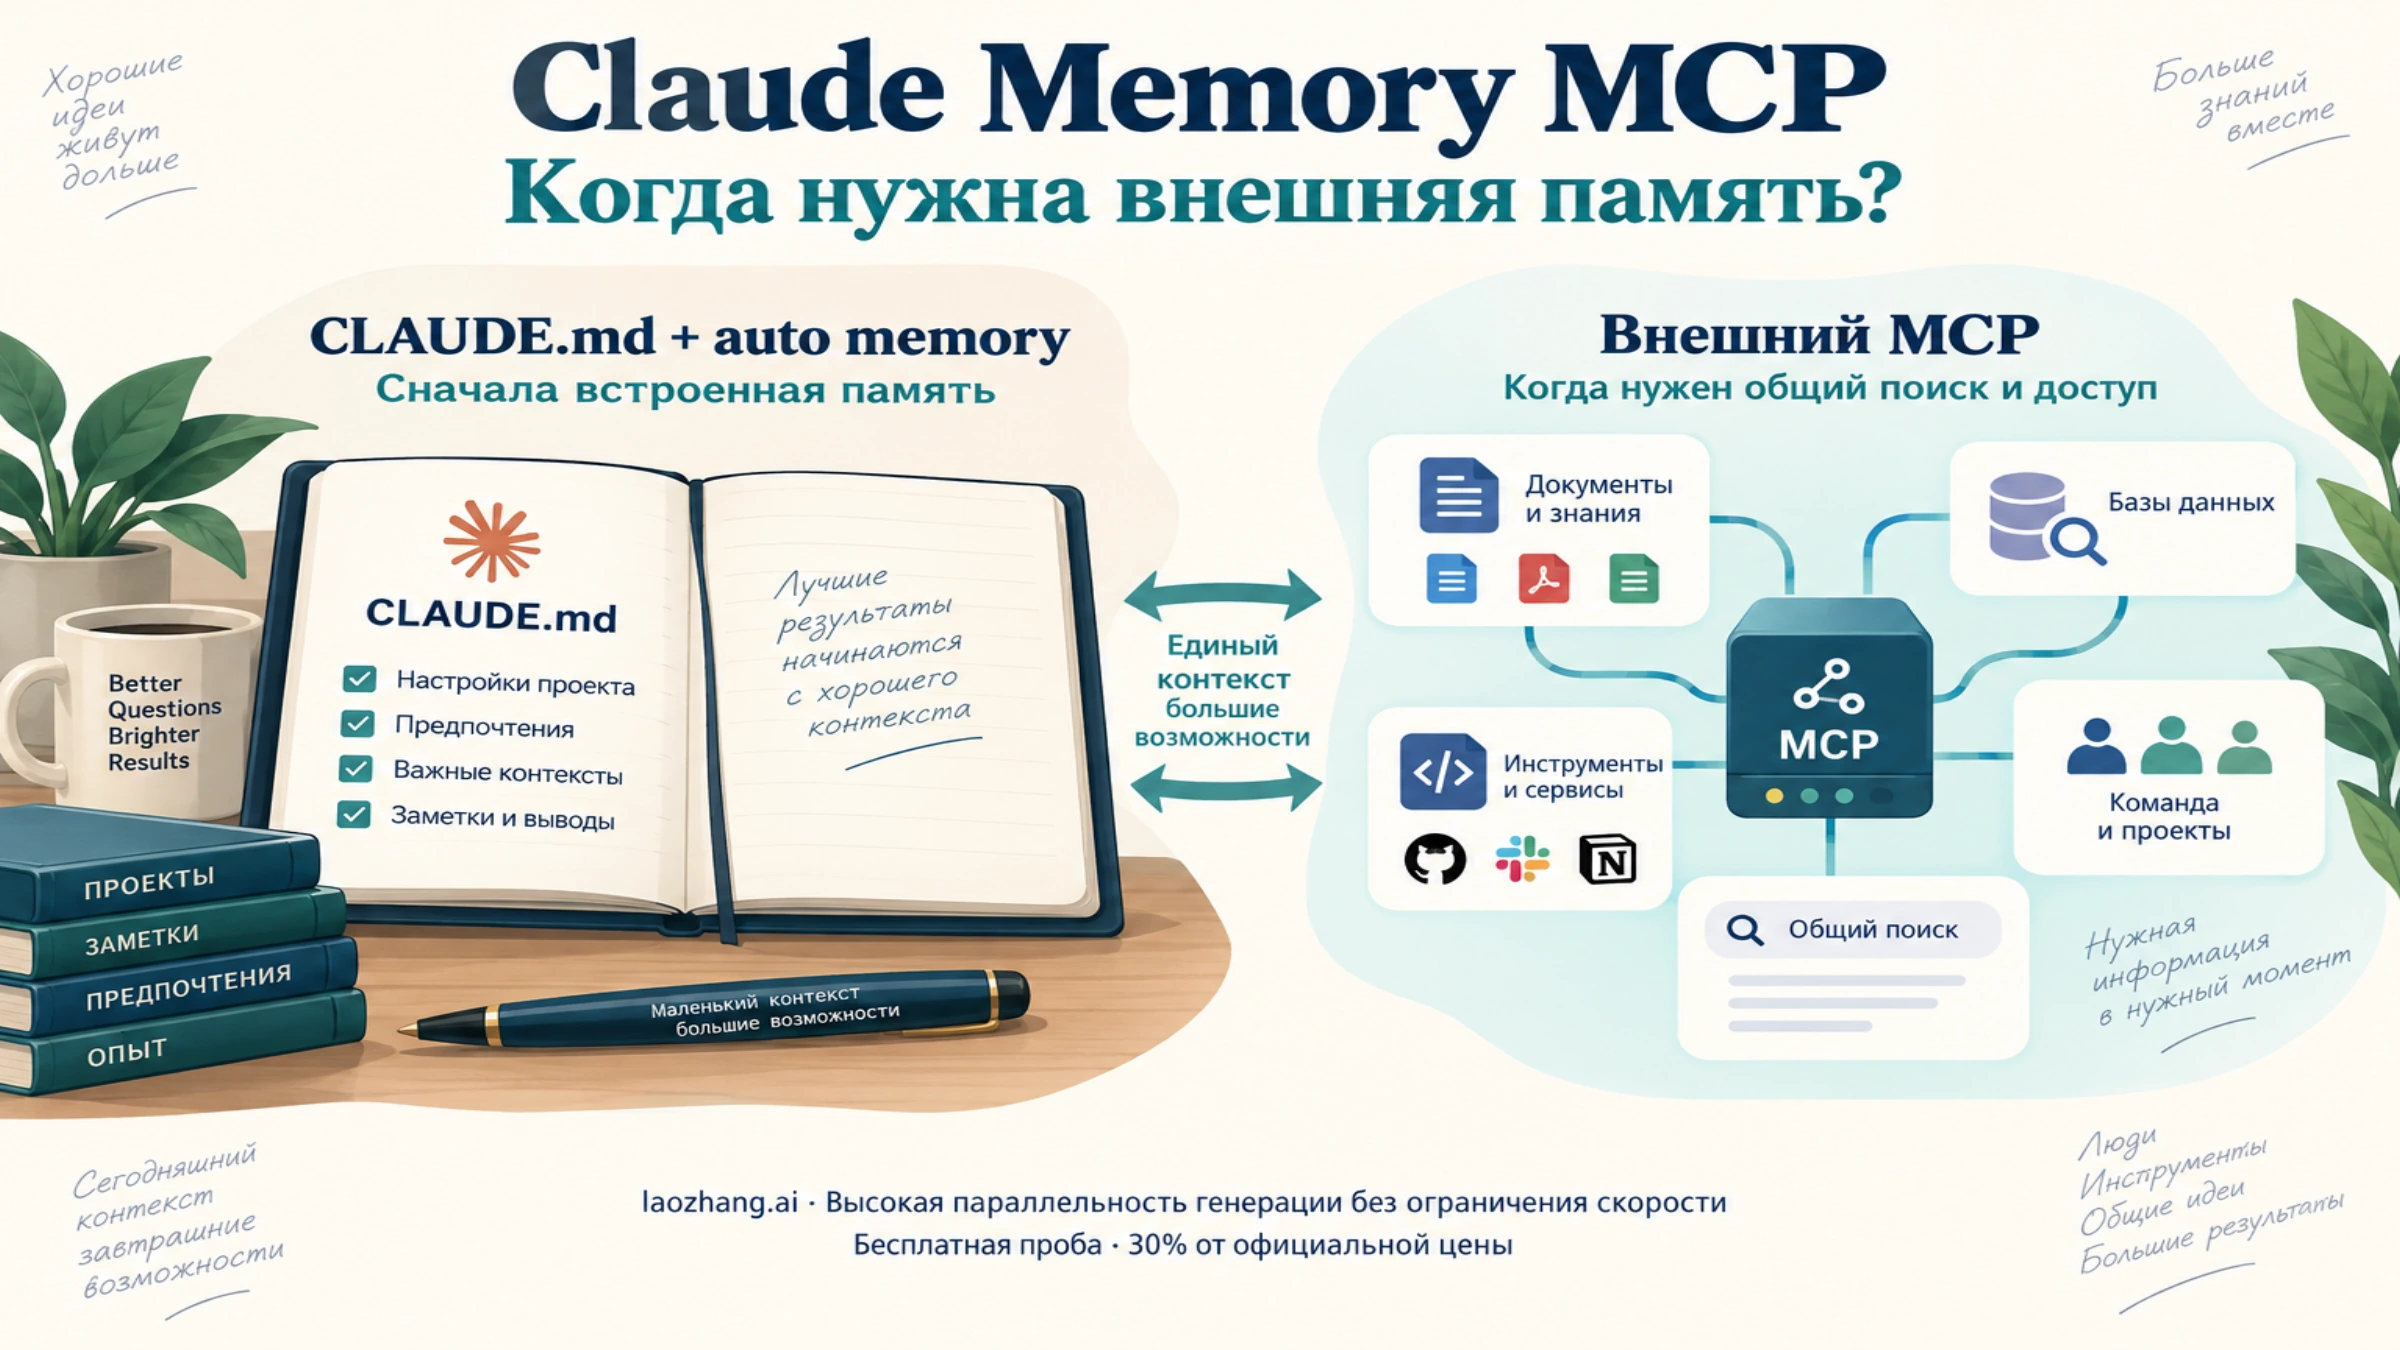
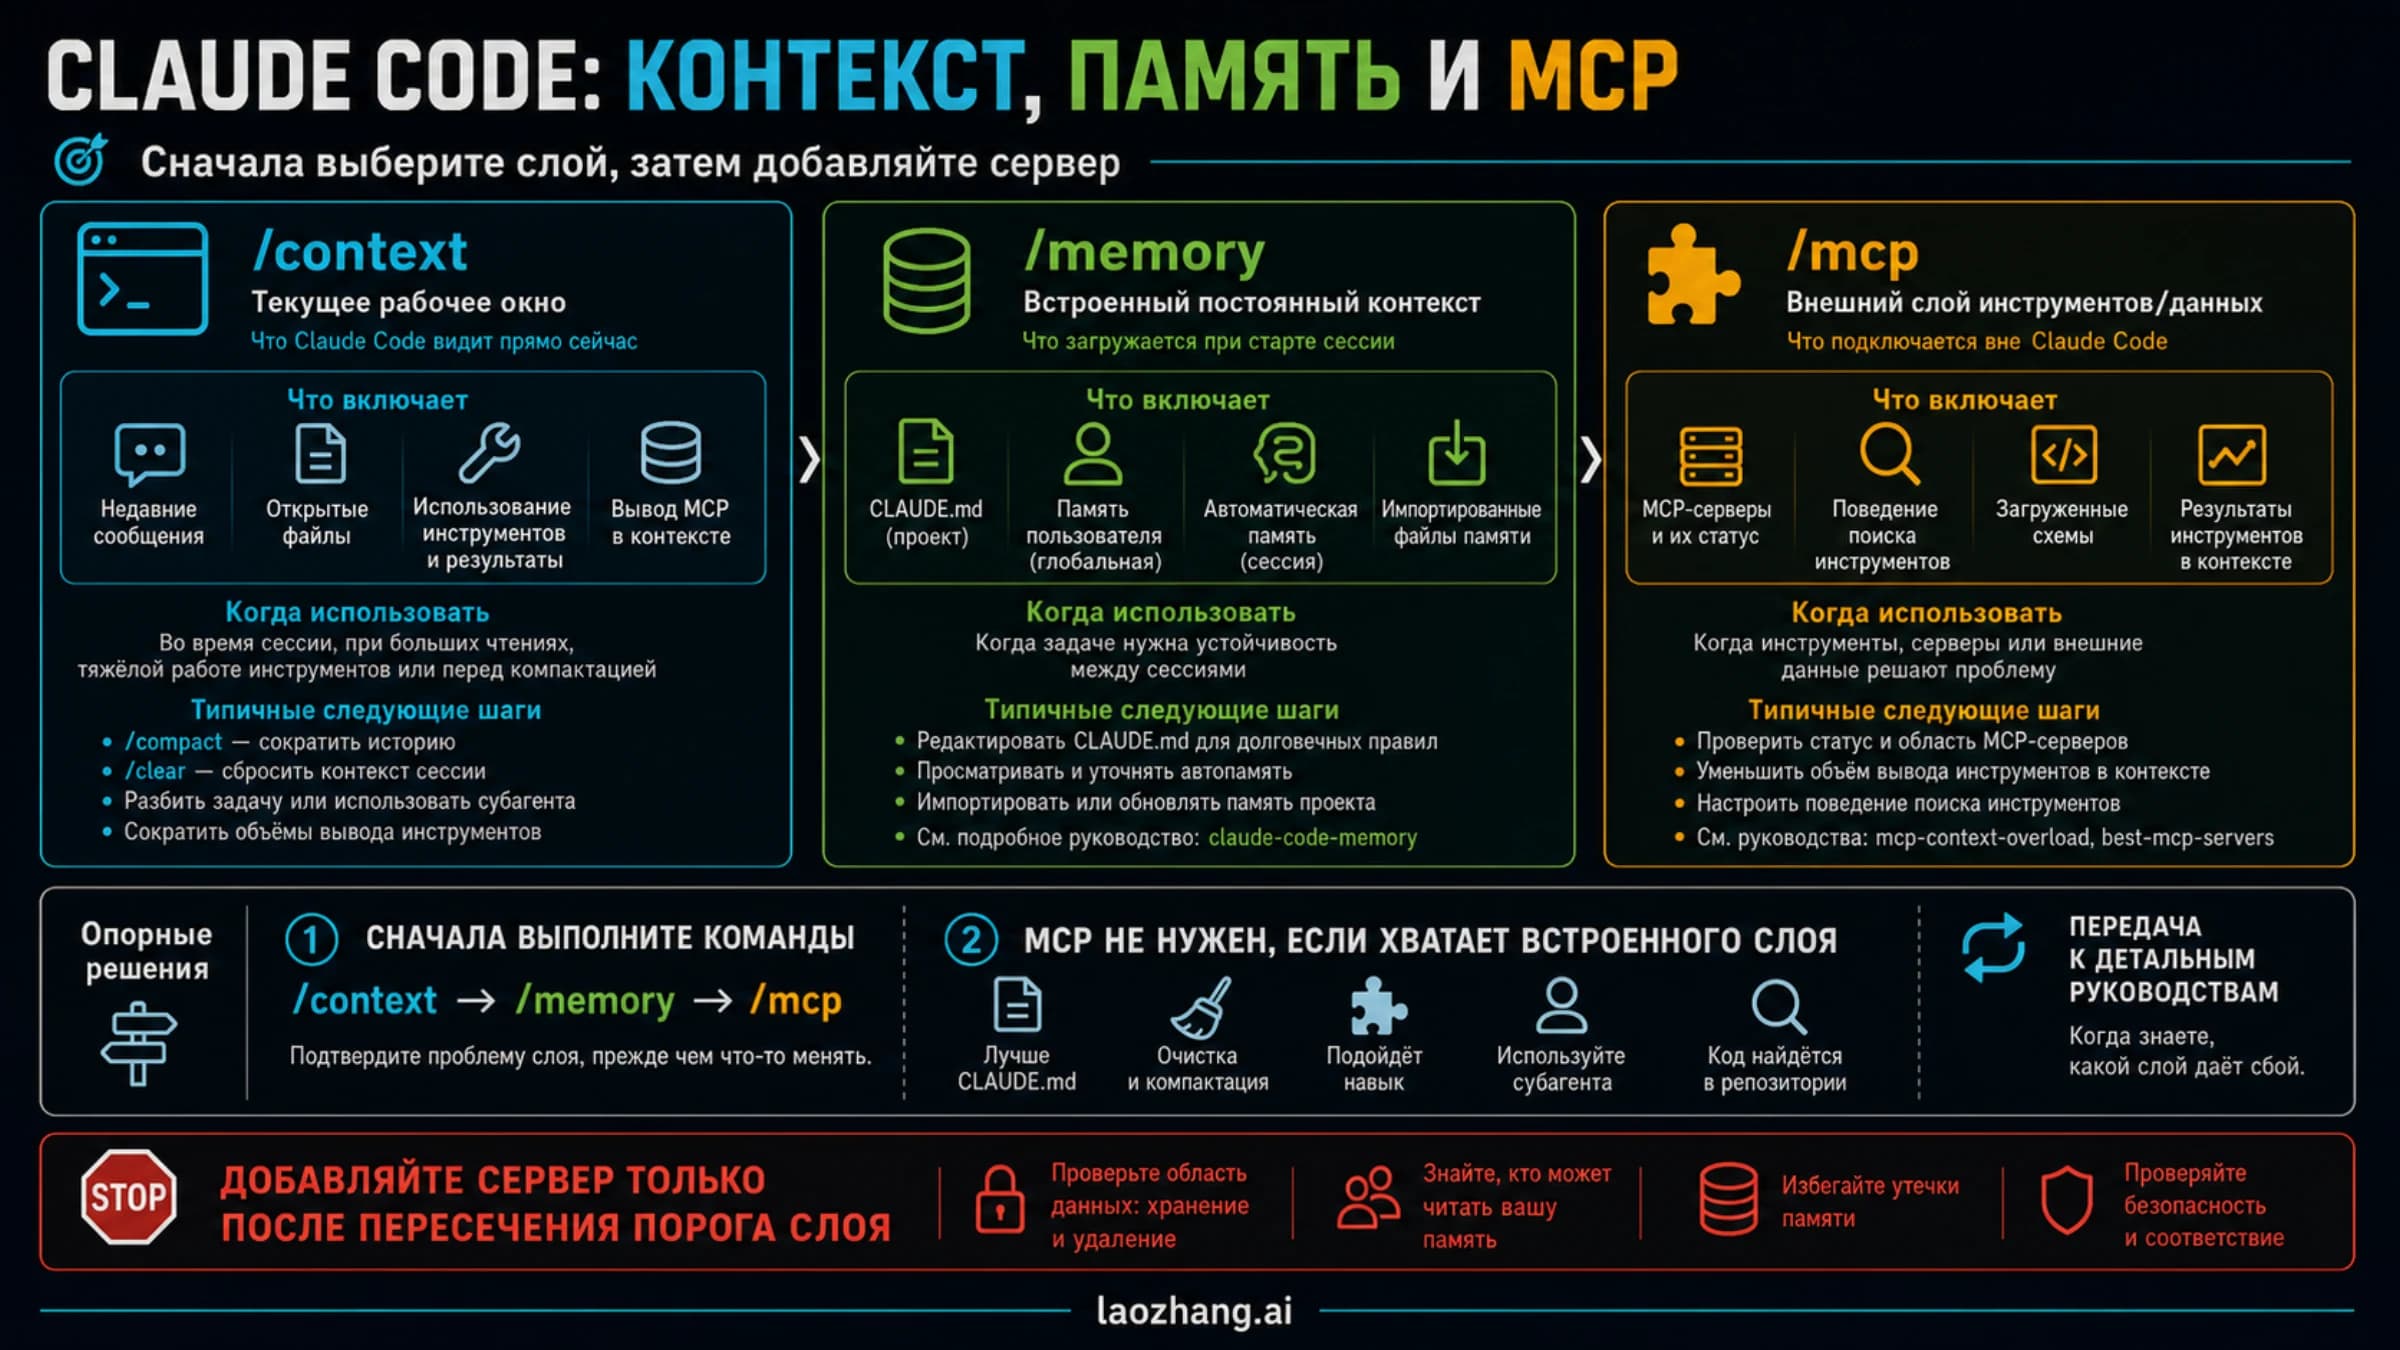
У Claude Code уже есть два встроенных memory surface: CLAUDE.md для явных правил и auto memory для изучаемых паттернов. Claude Memory MCP — это другое: внешний MCP server, который хранит или извлекает контекст за пределами встроенной machine-local memory boundary Claude Code.
Из этого разделения сразу следует и рекомендация. Если задача пока связана с repo rules, startup instructions, повторяющимися preference или one-machine habits, начинать нужно со встроенных layers. Если же нужен поиск между инструментами, доступ с разных машин или общая память команды, тогда внешний memory MCP становится реальным вариантом. Сам по себе /compact этого не требует.
Текущие Claude Code memory docs и MCP docs у Anthropic по-прежнему описывают это как разные surfaces. CLAUDE.md и auto memory относятся к built-in behavior Claude Code. MCP servers — это external integrations со своим approval flow, scope, operator trust и third-party risk. Поэтому главный вопрос здесь не только в том, какой инструмент звучит сильнее, а в том, какой layer должен владеть этим контекстом первым.
| Если ваш реальный вопрос про... | Сначала идите сюда | Почему именно этот слой первый |
|---|---|---|
| repo rules, стартовые инструкции, явные границы | CLAUDE.md | это встроенный явный слой, который Claude должен видеть с начала сессии |
| повторяющиеся правки и machine-local привычки | auto memory | это встроенный слой обучаемых паттернов, а не универсальное shared store |
| поиск между инструментами, работа на разных машинах, общая память команды | внешний memory MCP | проверьте, нужны ли отдельное хранилище, поиск и права доступа; /compact сам по себе не является таким порогом |
Если проблему уже описывают две первые строки, новый server пока не нужен. Внешняя memory-layer оправдана только тогда, когда третья строка стала реальной operational проблемой, а не просто красивым обещанием с landing page.
Что Claude Code уже помнит до всякого внешнего слоя
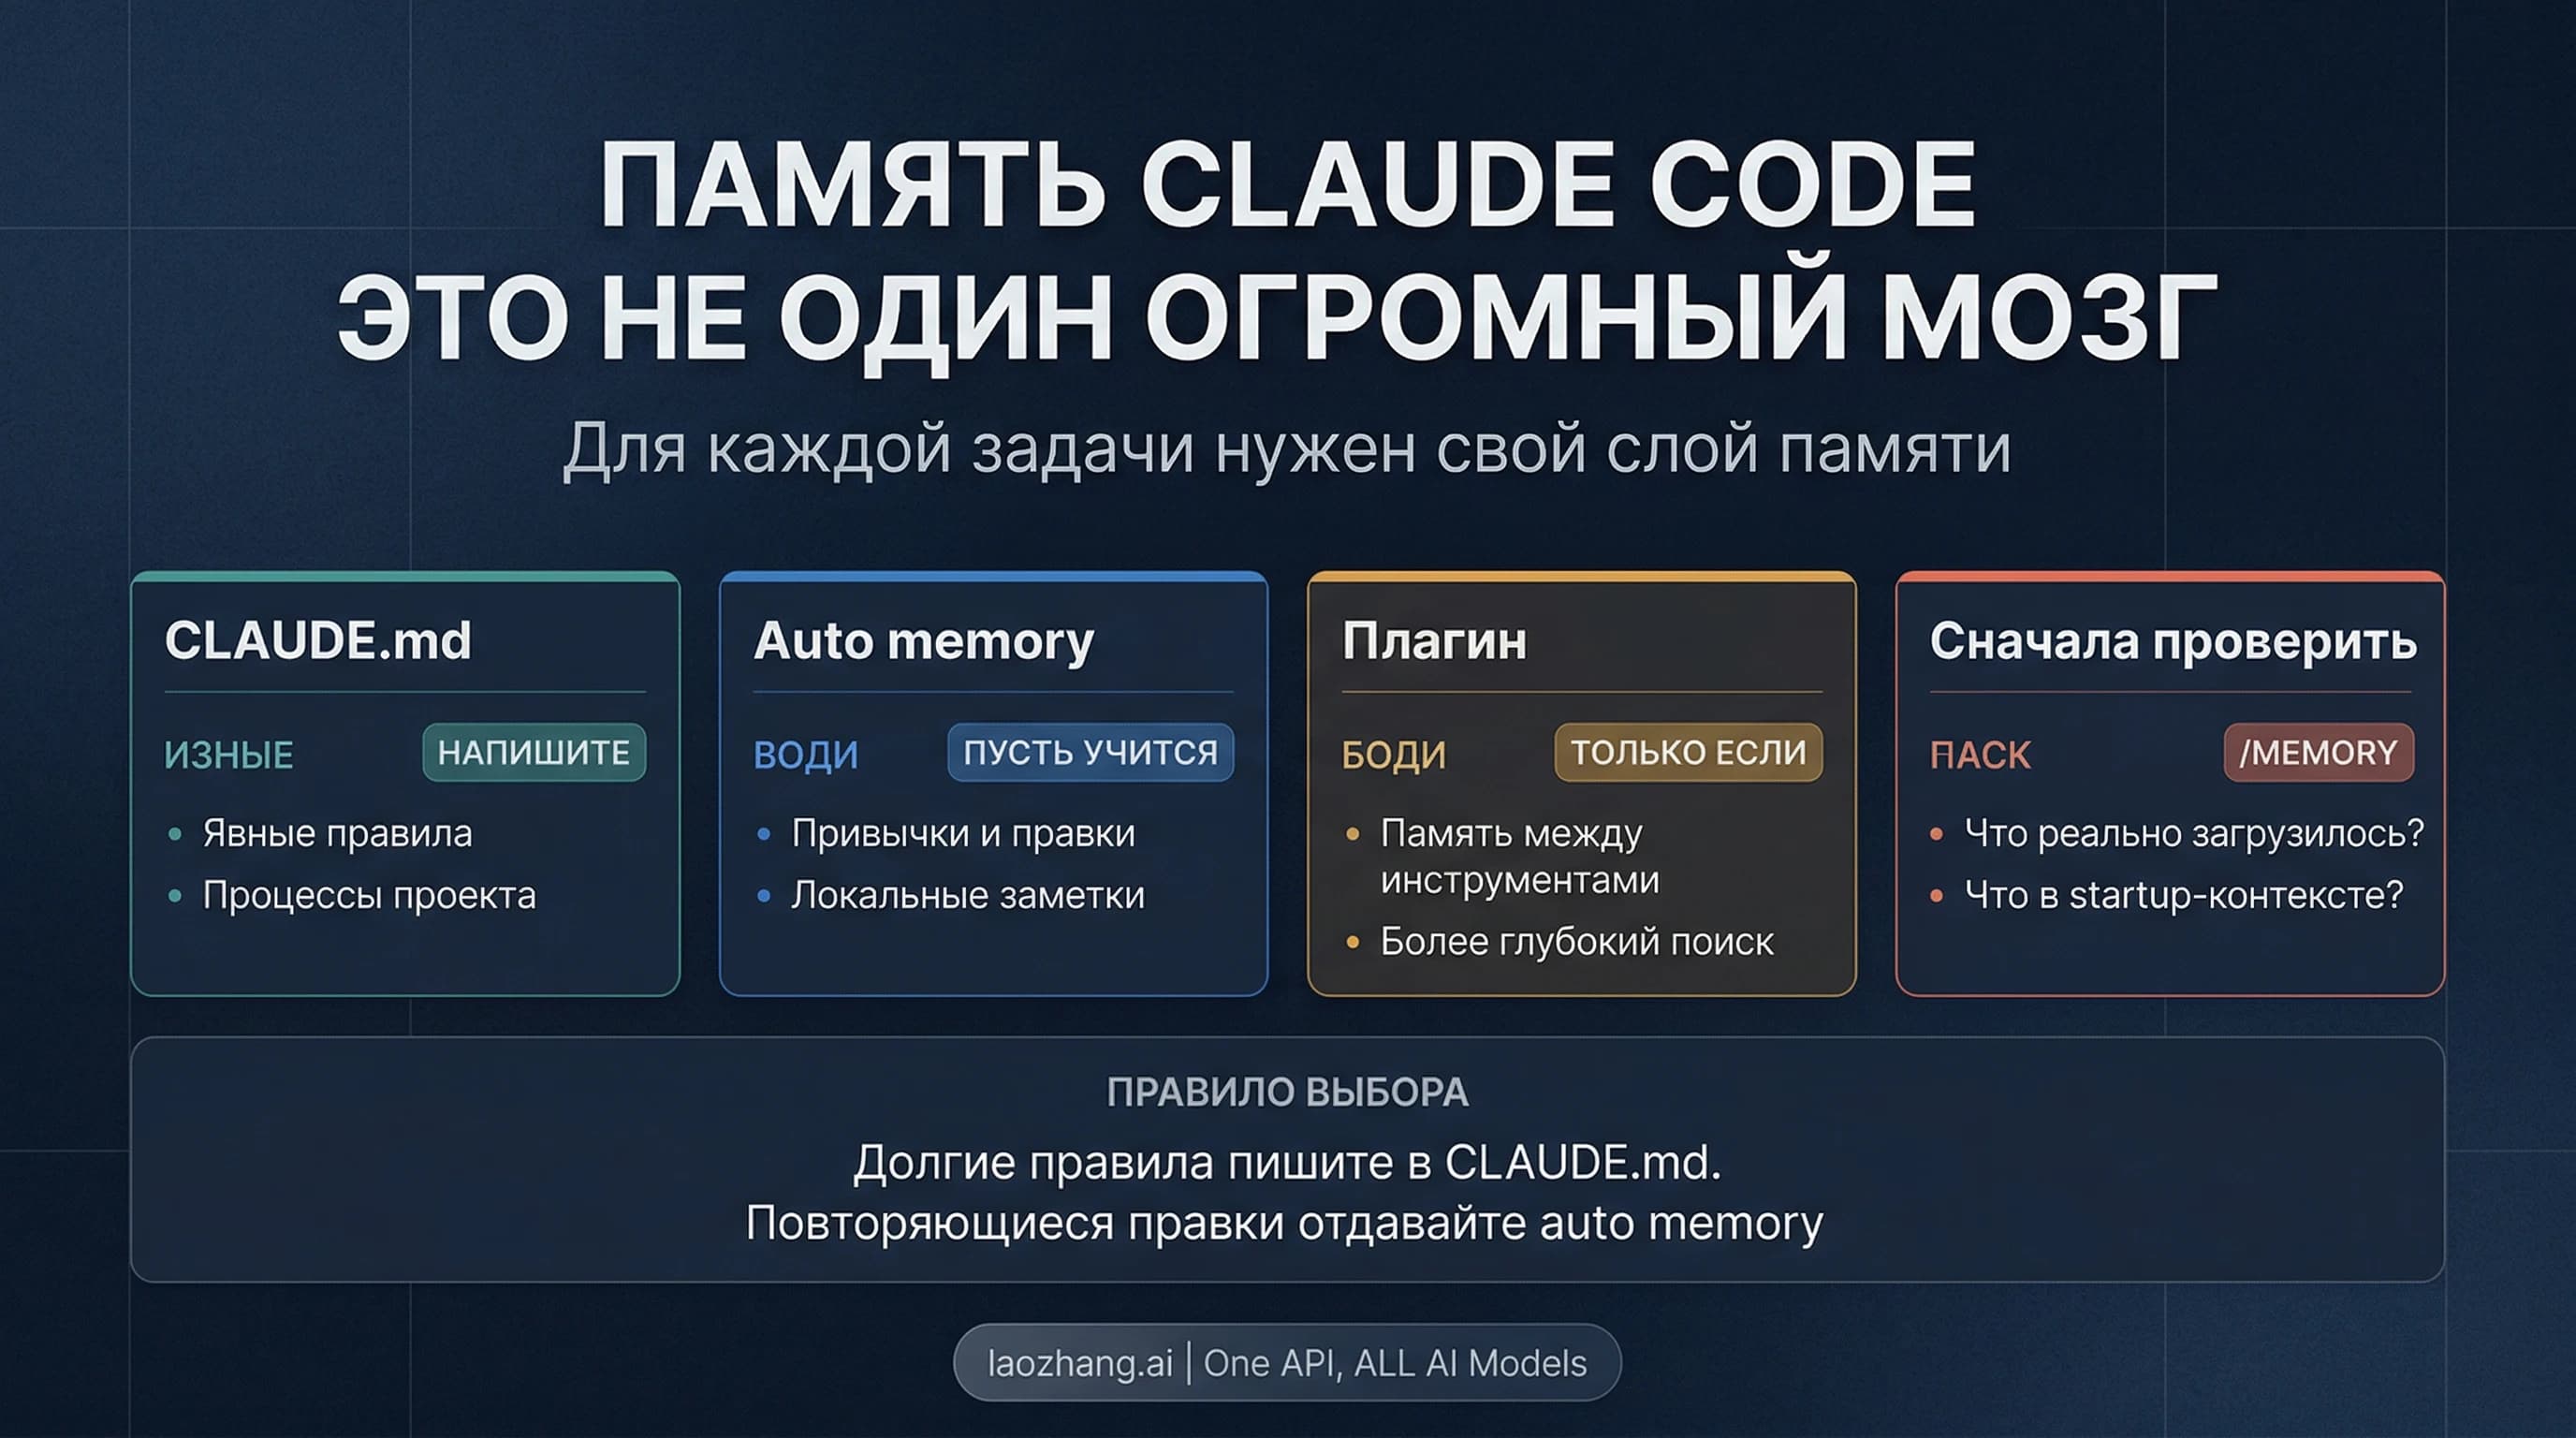
Главная ошибка здесь в том, что слово memory звучит как одна функция. На практике Claude Code уже разделяет явные правила и обучаемые паттерны.
CLAUDE.md — это durable rule layer. Именно сюда имеет смысл выносить тест-команды, review expectations, архитектурные ограничения, чувствительные директории и любые workflow-правила, потеря которых дорого обойдется. Сильная сторона CLAUDE.md не в магии, а в том, что этот слой виден уже с первого хода.
auto memory отвечает за другой тип continuity. Это место для повторяющихся правок, локальных привычек и устойчивых паттернов. Но официальный контракт при этом остается ограниченным: auto memory — machine-local layer, а не облачная память, которая автоматически поедет за вами куда угодно.
Поэтому полезнее спрашивать не “запоминает ли Claude”, а “какая поверхность должна помнить это знание”. Если речь о repo-policy и долговечных инструкциях, вернитесь в CLAUDE.md. Если речь о привычках и повторяющихся коррекциях — это кандидат для auto memory. Если же задача уже звучит как cross-tool retrieval, cross-machine continuity или team memory, только тогда появляется повод смотреть на внешний MCP.
Здесь важны и /memory, и /context. Очень много историй про “мне нужен persistent memory” заканчиваются не отсутствием внешнего хранилища, а тем, что встроенный контракт просто не был оформлен достаточно явно. Если вам нужен полный разбор built-in memory, startup loading и debugging через /compact, используйте нашу статью о памяти Claude Code. Эта страница нарочно уже: ее работа — решить, когда пора выходить наружу.
Какие проблемы внешний memory MCP решает на самом деле
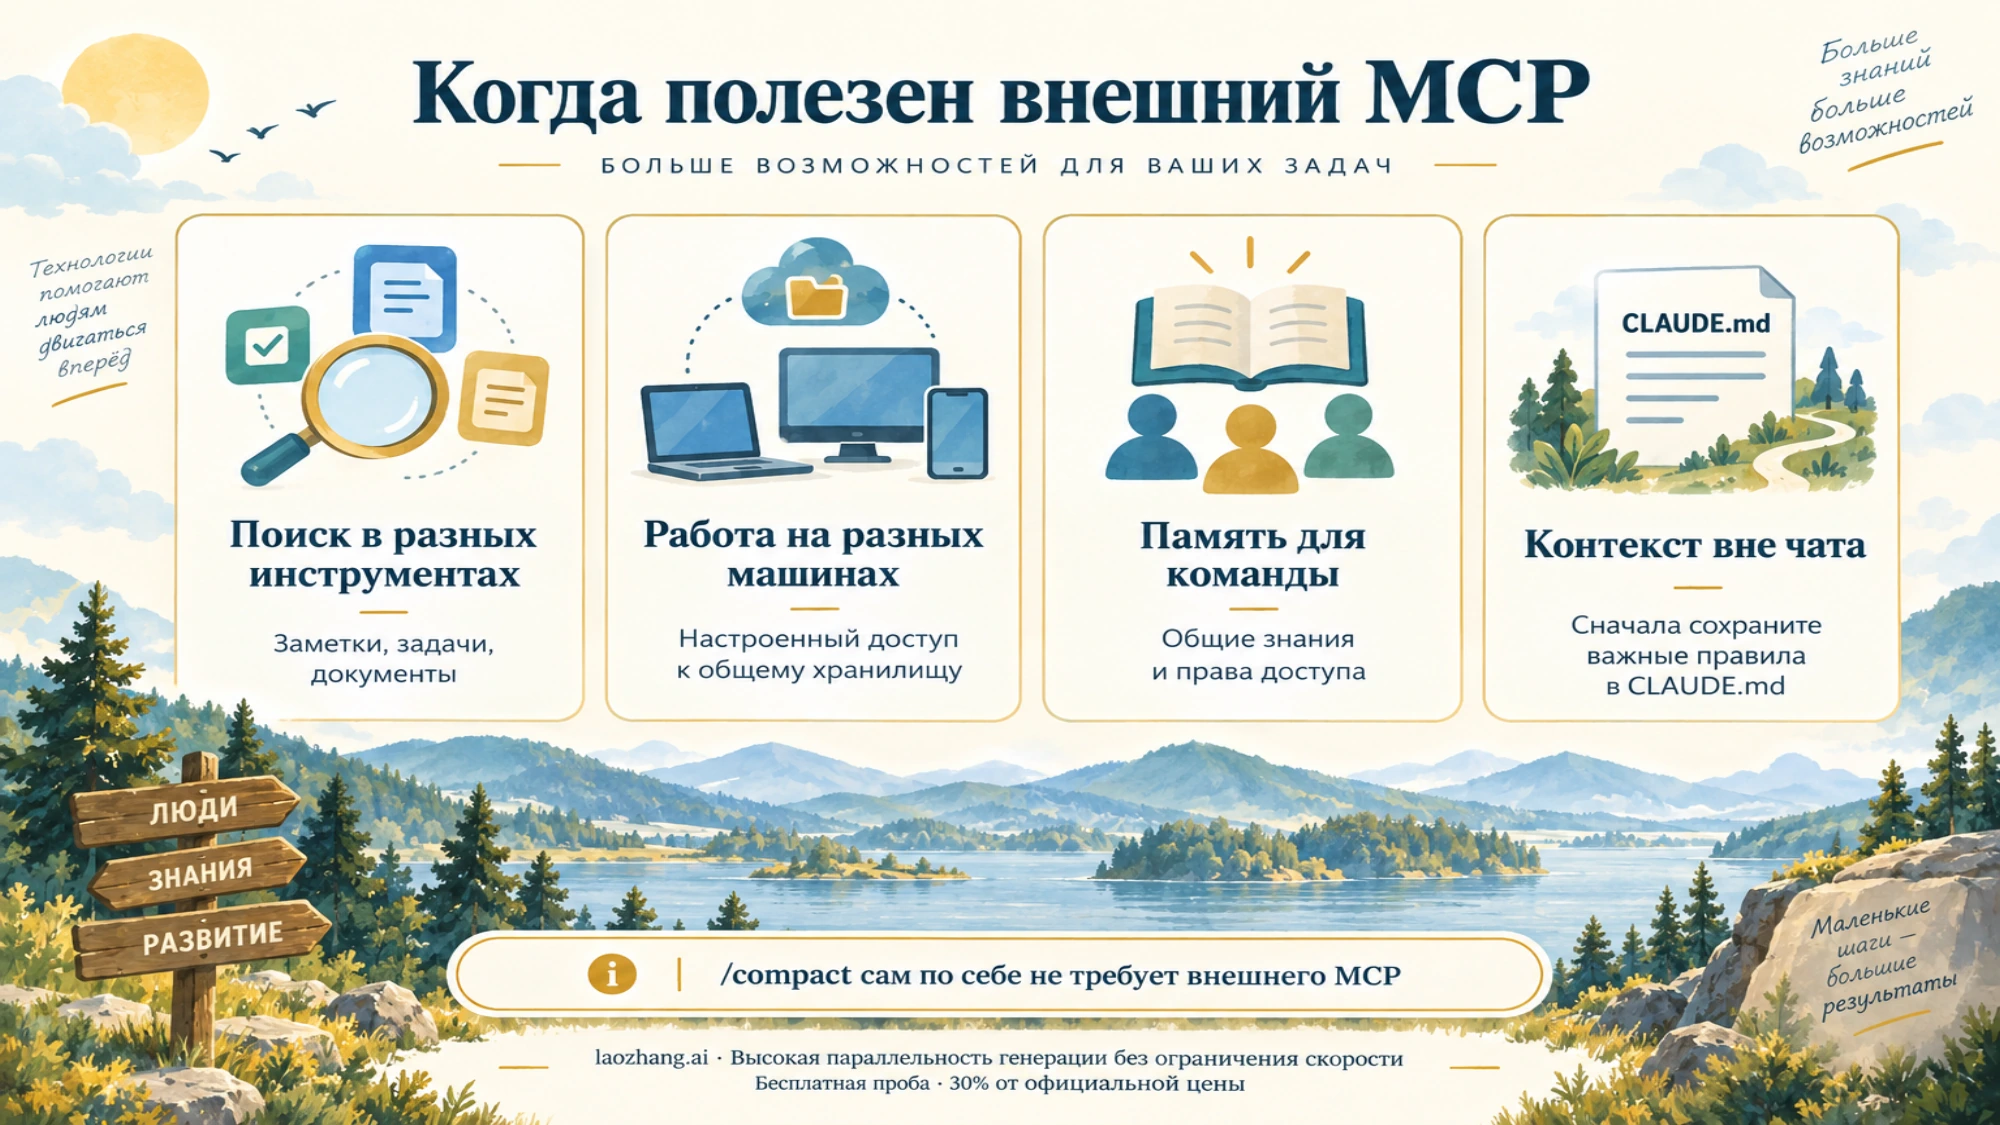
Внешний memory MCP полезен не как “более мощная память вообще”, а как ответ на конкретные continuity-провалы.
Первый порог — сохранение контекста вне чата. Сам по себе /compact не требует внешнего MCP: корневой CLAUDE.md перечитывается после сжатия. Сначала сохраните там устойчивые правила. Внешнее хранилище имеет смысл для знаний, которым нужны отдельный поиск или совместный доступ. Это следует из официального описания памяти.
Второй порог — cross-tool retrieval. Иногда знание вообще не относится к repo rules или local habits. Оно живет в заметках, issue history, внутренних docs или других инструментах. Тогда вы решаете retrieval-задачу, а не просто “усиливаете память” Claude Code.
Третий порог — cross-machine continuity. Встроенная память остается machine-local. Если вы регулярно перескакиваете между машинами, remote environments или несколькими runtime, а одна и та же memory-surface должна следовать за вами, это уже честный аргумент в пользу внешнего слоя.
Четвертый порог — team-shared memory. Это сильный аргумент, но и место, где чаще всего апгрейд делают слишком рано. Общая память нужна только там, где команде действительно нужен shared recall или общий retrieval layer, а не там, где “несколько человек тоже пользуются Claude Code”.
Vendor pages обычно продают ровно эти боли: persistence между сессиями, выживание после compaction, shared memory между tools и командами. Их полезно читать как surface signal. Их опасно читать как доказательство того, что у Claude Code по умолчанию “не хватает memory”.
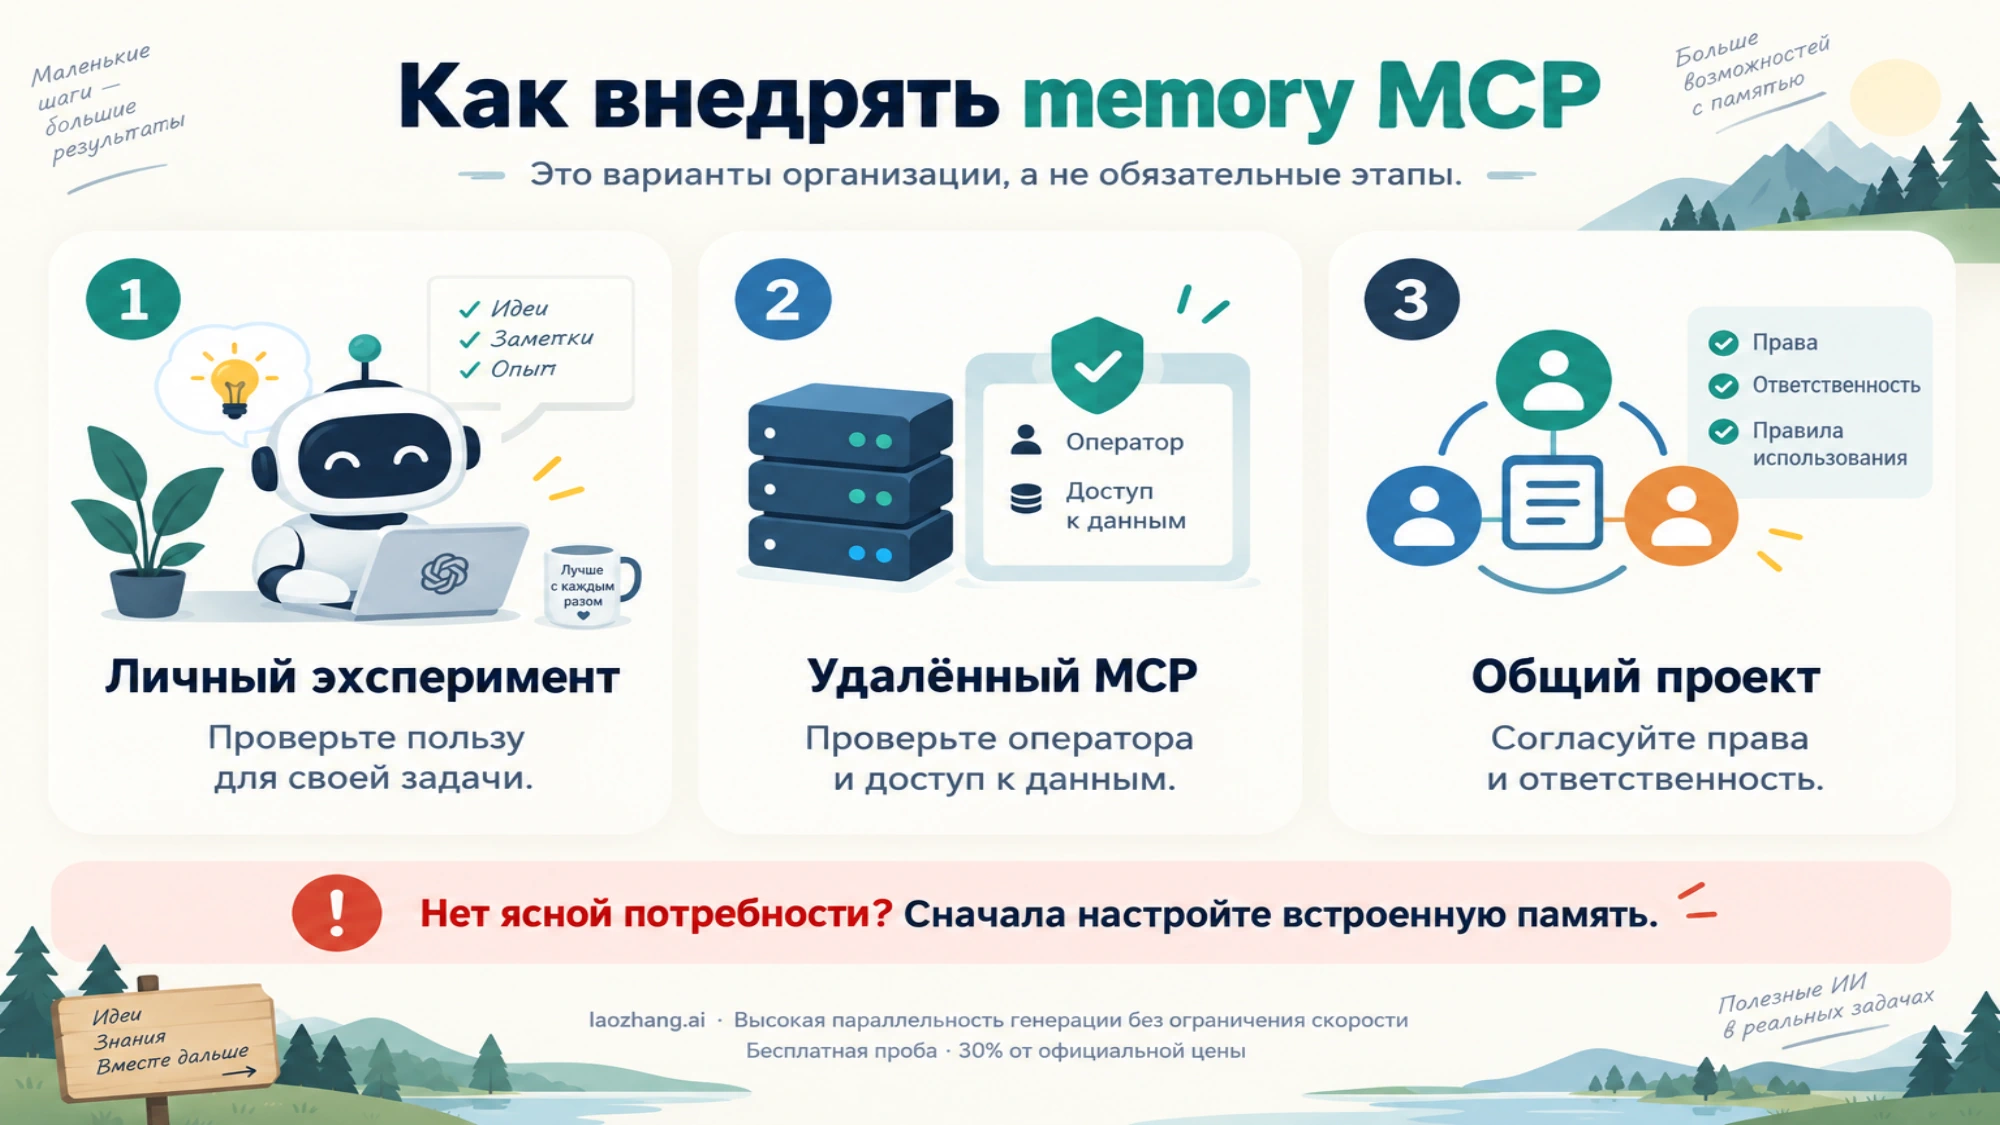
Plugin, remote MCP или project-shared setup?
Когда внешний порог действительно назван, следующий вопрос — уже не только какой tool выбрать, а кому должна принадлежать эта integration.
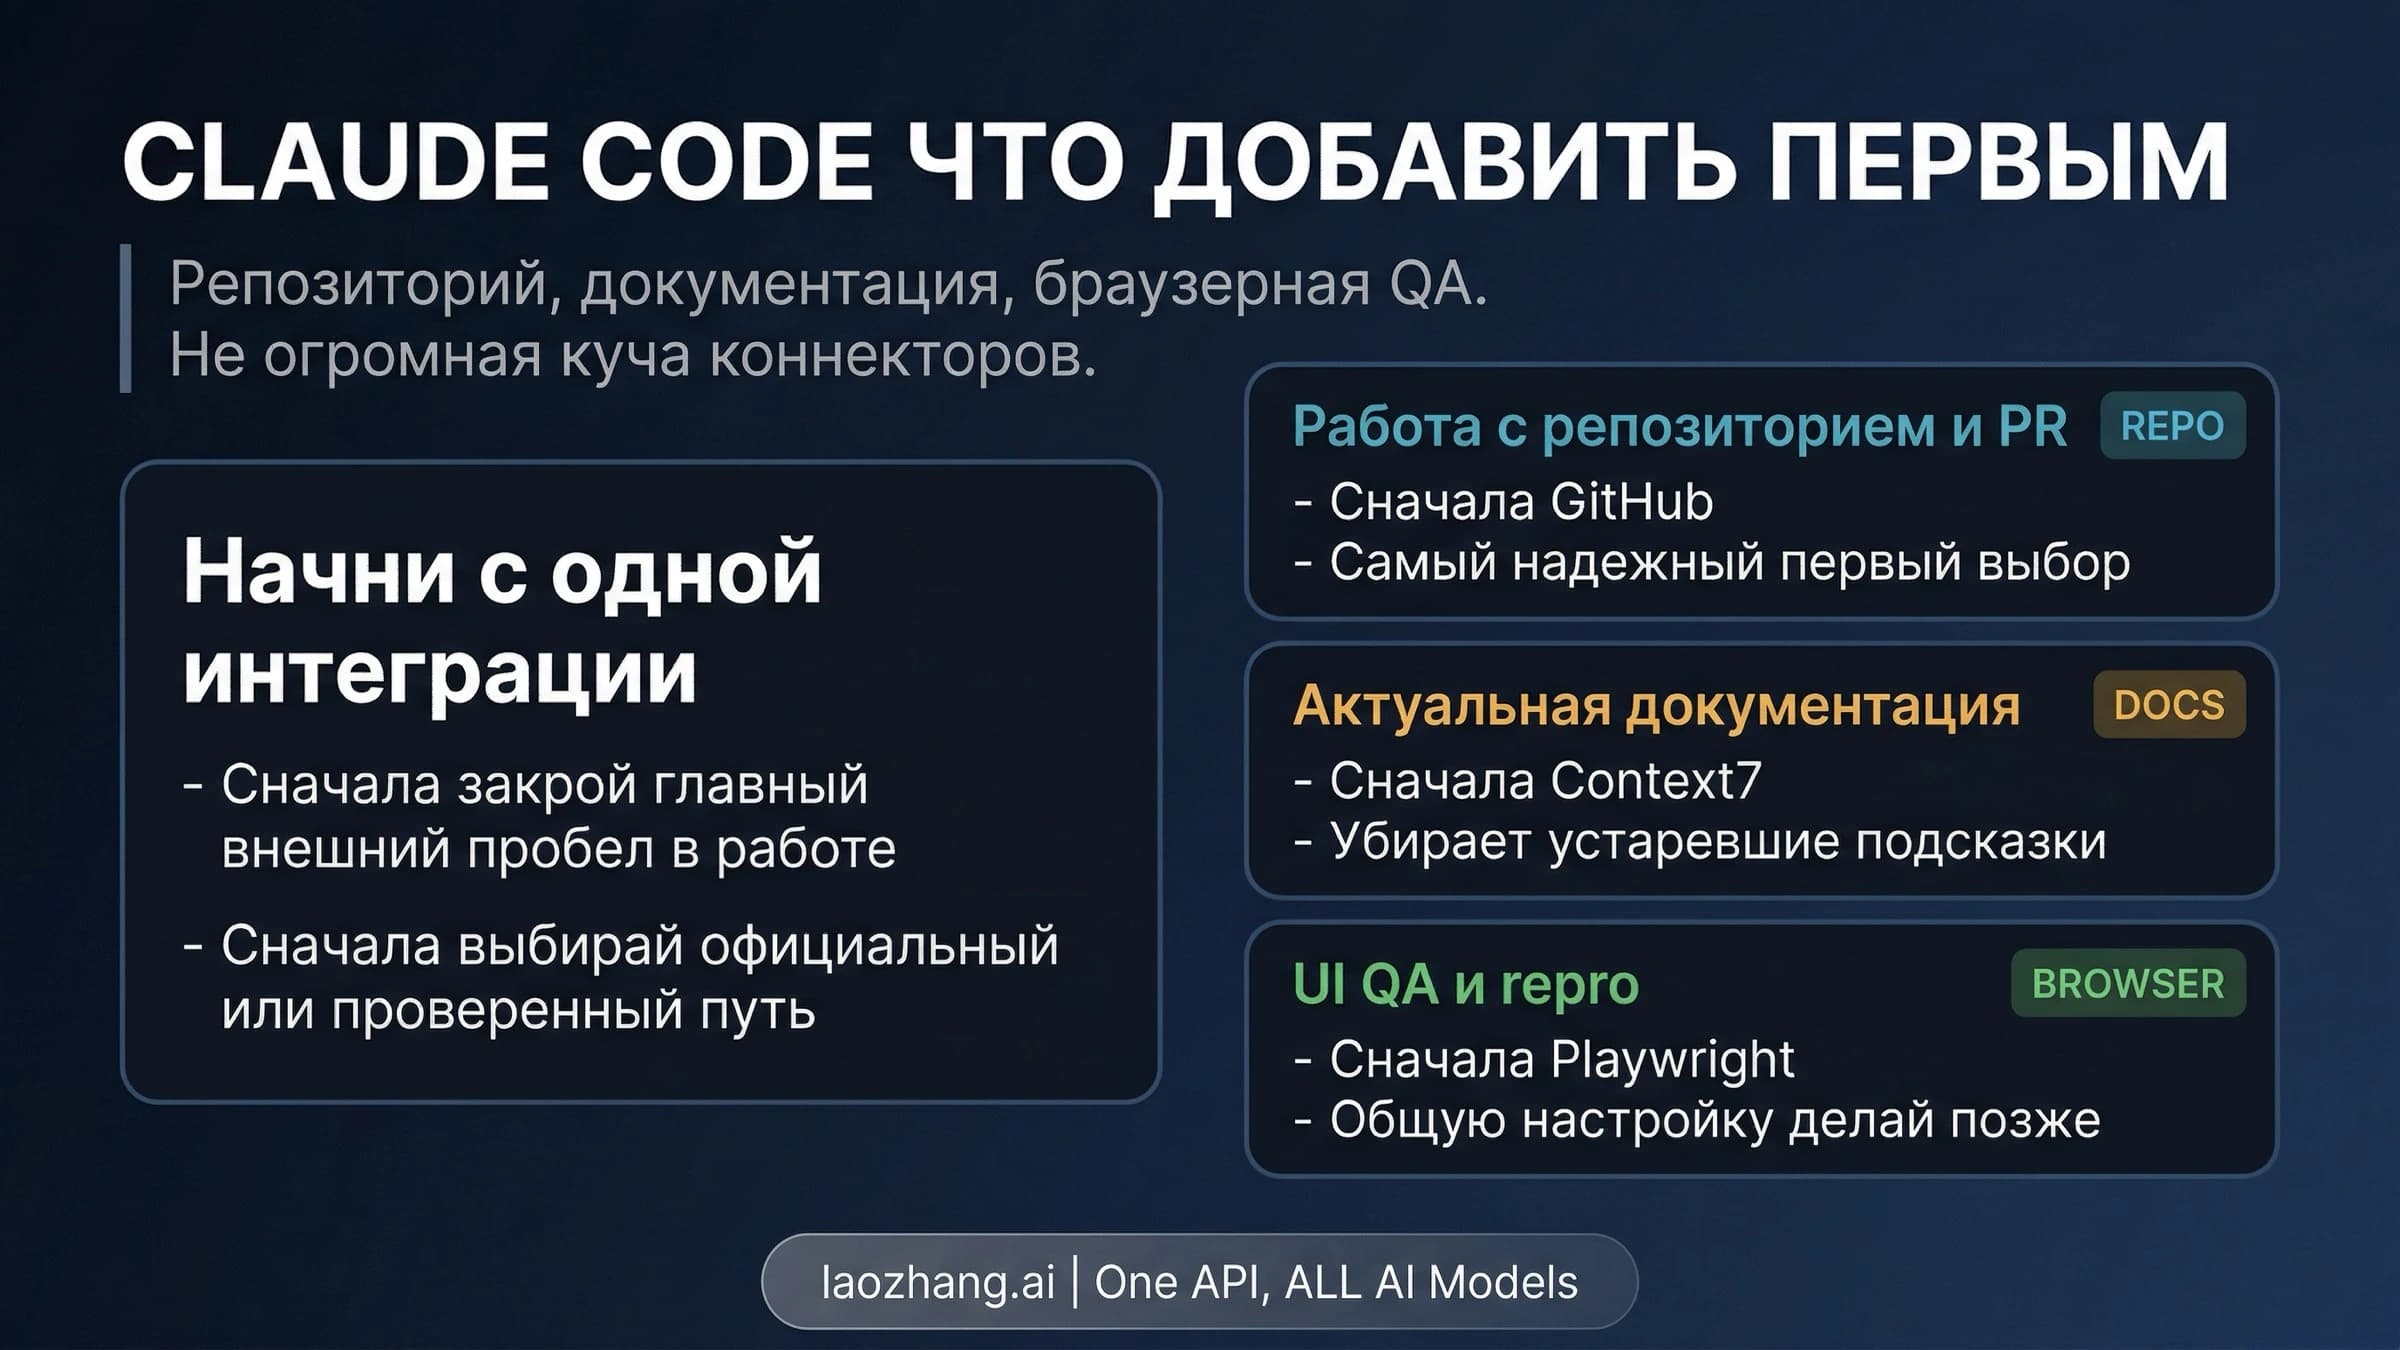
Самый безопасный default — personal first. Если workflow пока доказывает один человек, держите setup личным и легким. Это может быть plugin-like experience или remote MCP, включенный только в вашей среде. Сначала нужно доказать саму внешнюю потребность, а не превращать эксперимент в repo-wide infrastructure.
Remote MCP разумен тогда, когда external retrieval или persistence и есть главная цель. Но remote означает и operator trust, и service availability, и новую dependency boundary. Если вас привлекает лишь “магический” marketing language, рано. Если он закрывает точно названный continuity failure, тогда разговор имеет смысл.
Project-shared — это уже более поздний шаг. Anthropic не случайно разделяет local, project и user scopes: ownership влияет на рекомендацию. Если memory integration должен нести репозиторий, это должно быть следствием устойчивого shared workflow, а не желанием поскорее сделать setup “серьезнее”.
Именно поэтому эта статья должна оставаться уже, чем общий гид по Claude Code MCP. Там вопрос шире: какие integrations ставить первыми вообще. Здесь вопрос уже: стоит ли memory-specific внешний слой именно сейчас.
Как проверять обещания memory-MCP без лишней романтики
Рынок external memory реален, но baseline здесь все равно задают официальные документы Anthropic. Vendor pages — это свидетельство того, какие проблемы рынок считает важными, а не authority по встроенному memory-контракту Claude Code.
Проще всего переводить каждое обещание в operational вопрос:
Persistent memory: persistent где именно — после/compact, между tools, между машинами или для всей команды?Works with Claude: это реально MCP extension, или текст звучит так, будто функция встроена в Claude по умолчанию?Shared memory: кто владеет данными, кто может писать, кто отвечает за prompt-injection и плохой retrieved context?Easy setup: это легко для одного разработчика или безопасно и поддерживаемо для repo?
Неправильный апгрейд здесь хуже, чем никакой. Он не только не решает проблему, но и добавляет новый слой с потенциально stale или слишком широким контекстом. Поэтому честная последовательность такая: сначала фиксируйте официальную built-in baseline, потом сравнивайте внешний gain, ownership model и maintenance cost.
Когда правильное решение — пока ничего не добавлять
Для многих читателей лучший итог этой страницы — не установка memory MCP, а осознанный отказ от нее прямо сейчас.
Не добавляйте внешний слой, если:
- repo rules так и не собраны в понятный
CLAUDE.md - auto memory уже грязный, конфликтный или несет не свою работу
- вы еще не проверяли
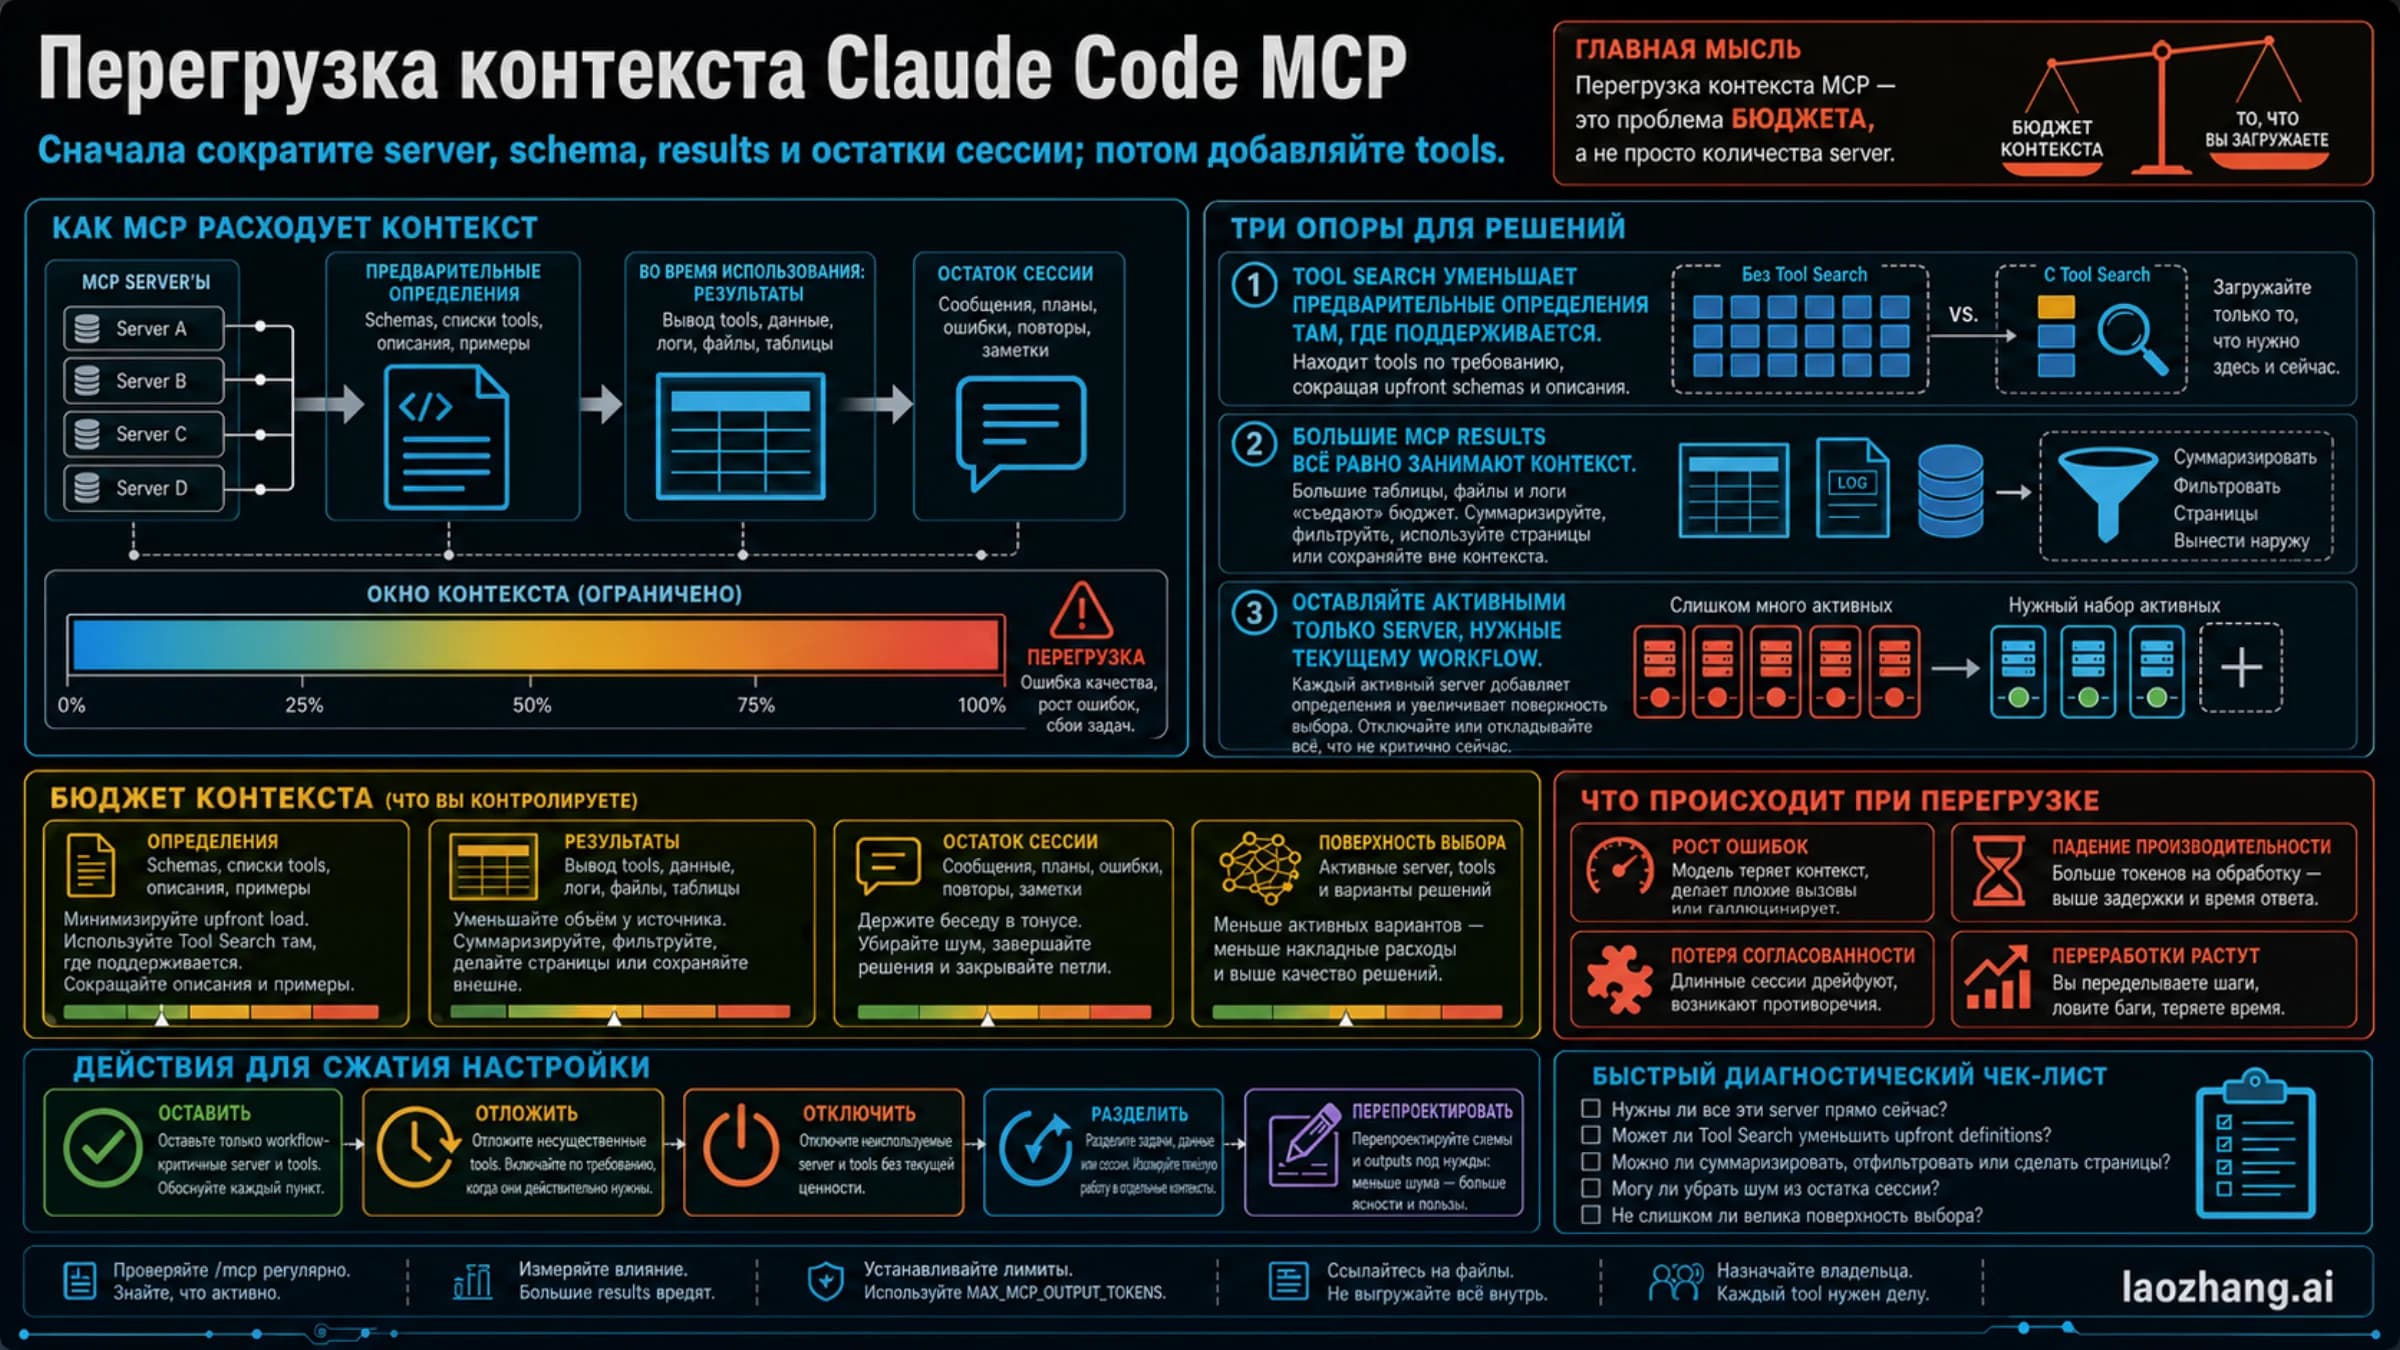
/memory, что реально загрузилось - боль похожа скорее на context bloat, чем на continuity gap
- вся работа по-прежнему живет на одной машине и в одном repo workflow
Во всех этих случаях новый server только скрывает неразобранность. Иногда проблема вообще не в memory, а в том, что вам нужен более сильный instruction layer внутри repo или более широкий MCP-выбор для внешних инструментов. Поэтому stop rule должен жить в теле статьи, а не прятаться в FAQ.
FAQ
Нужен ли memory MCP для Claude Code по умолчанию?
Обычно нет. Если проблема все еще про repo rules, local habits и one-machine continuity, сначала исправьте CLAUDE.md и auto memory.
Что Claude Code уже помнит по умолчанию?
Он уже дает явный слой через CLAUDE.md и обучаемый слой через auto memory. Но это не universal shared memory system.
Когда /compact действительно толкает к внешнему слою?
Сам по себе /compact не требует внешнего слоя: корневой CLAUDE.md перечитывается. Сначала сохраните устойчивые правила в нём; внешний MCP рассматривайте для отдельного поиска и совместного доступа.
Что выбирать сначала: plugin или remote MCP?
Сначала самый легкий personal setup, который решает реальную continuity-проблему. Remote нужен тогда, когда внешняя persistence или retrieval и есть цель. Project-shared — еще позже.
Когда особенно важно ничего не добавлять?
Когда вы еще не разобрали роли CLAUDE.md, auto memory и /memory, а весь workflow все еще machine-local. В такой точке built-in hygiene почти всегда полезнее, чем новый внешний dependency.
Источники1
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 16 апр. 2026 г..
Источники1
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 16 апр. 2026 г..