LLM 에이전트 API 비용 킬 스위치: 공급자 호출 전에 지출을 멈추는 법
LLM 에이전트의 비용 상한은 다음 유료 요청 앞에서 검사해야 합니다. 이미 쓴 금액과 진행 중인 요청의 예약액을 함께 계산하고, 재시도와 하위 에이전트에도 같은 예산을 적용하는 구현을 설명합니다.
목차
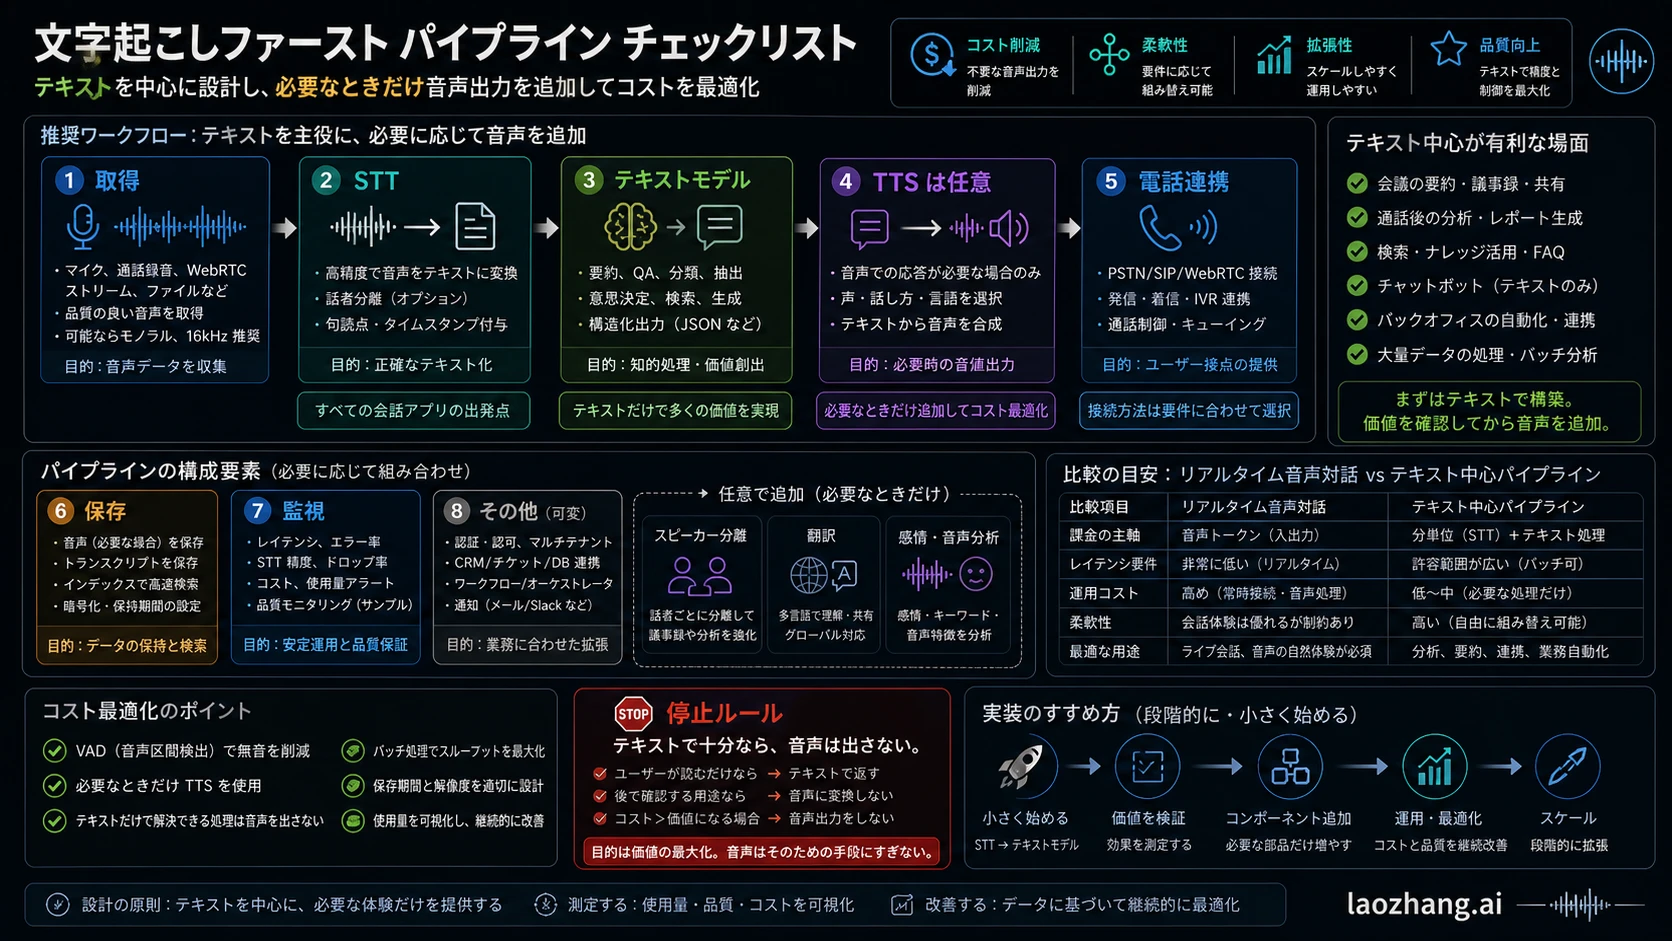
LLM 에이전트의 API 비용 폭증을 막으려면 다음 유료 요청을 보내기 전에, 이미 쓴 금액과 진행 중인 요청의 예약액을 더해 예산을 확인하고 필요한 금액을 함께 예약해야 합니다. 예약이 성공한 요청만 공급자에게 전달합니다. 응답이 오면 실제 사용량으로 정산하고, 비용을 확인할 수 없으면 예약을 유지한 채 새 유료 작업을 멈춥니다.
판단식은 실제 사용액 + 미정산 예약액 + 다음 요청의 최대 비용 ≤ 비용 상한입니다. 이 검사와 예약 갱신은 하나의 원자적 연산이어야 합니다. 여러 작업자가 잔액만 따로 읽으면 모두 같은 돈을 쓸 수 있다고 판단하기 때문입니다. 재시도, 하위 에이전트, 대체 모델, 도구 내부의 유료 호출도 같은 검사 경로를 지나야 합니다.
예산 알림은 여전히 유용합니다. 다만 알림을 받는 것과 요청을 차단하는 것은 다릅니다. 공급자의 강제 상한을 함께 쓰되, 요청별 상한과 작업 전체의 종료는 애플리케이션에서 제어하세요. 아래 예제는 Python 표준 라이브러리와 가짜 공급자만 사용하며, 실제 API 호출이나 청구서 검증은 포함하지 않습니다.
공급자 예산을 설정했는데도 내부 차단이 필요한 이유
현재 OpenAI는 조직과 프로젝트의 월간 지출에 강제 상한을 적용할 수 있습니다. Enforce a hard limit를 활성화하면 해당 상한 도달 시 요청이 429로 거절됩니다. 알림만 설정한 경우에는 트래픽이 계속됩니다. 조직 상한은 모든 프로젝트에, 프로젝트 상한은 그 프로젝트에 청구되는 요청에 적용됩니다. 다만 집행 상태가 즉시 전파되는 것은 아니어서 기록된 비용이 소폭 초과할 수 있습니다. “OpenAI 프로젝트 예산은 항상 알림뿐”이라는 설명은 현재 문서와 맞지 않습니다. OpenAI 지출 한도 문서
내부 예산 게이트는 여기에 다른 범위를 더합니다. 한 사용자 작업의 한도, 여러 공급자를 합친 비용, 아직 완료되지 않은 요청의 비용까지 다룹니다. 월간 공급자 상한이 남아 있어도 특정 작업의 예산이 끝났다면 해당 작업은 멈춰야 합니다.
| 제어 수단 | 확인할 동작 | 요청 전 금액 예약과의 차이 |
|---|---|---|
| OpenAI 조직·프로젝트 상한 | 강제 집행을 활성화했는지, 어느 청구 범위인지 | 현재 강제 차단을 지원하지만 전파 지연과 소폭 초과 가능성이 있음 |
| Cloudflare AI Gateway 지출 한도 | 적용되는 모든 규칙과 비용 산정 대상 | 비용은 요청 완료 후 반영되며, 동시 요청이 몰리면 한도를 넘을 수 있음 |
| LiteLLM 프록시 예산 | 팀·멤버·사용자·키의 범위와 초기화 주기 | 예산 기능의 존재만으로 병렬 요청의 엄격한 선예약을 입증할 수 없음 |
| 애플리케이션 예산 게이트 | 공유 원장에서 검사와 예약이 한 번에 일어나는지 | 아직 청구되지 않은 요청도 잔액에서 제외하고 다음 요청을 결정함 |
Cloudflare의 현재 베타 지출 한도는 요청 전에 적용 규칙을 검사하지만, 그때 비교하는 비용 기록은 완료 후 갱신됩니다. 비용 계산은 최선 노력 방식이며 최종 청구액과 완전히 같다는 보장이 없습니다. 따라서 이 기능을 병렬 작업의 정확한 사전 예약으로 해석하면 안 됩니다. Cloudflare 지출 한도와 동시성 안내
LiteLLM도 범위를 구분해야 합니다. 키 예산, 팀 예산, 팀 멤버 예산은 서로 다르며 예산 검사 대상이 null이면 해당 검사가 없습니다. 문서는 v1.95부터 팀 키에 내부 사용자의 개인 예산을 적용하지 않는 변경도 설명합니다. 실행 중인 버전에서 원하는 대상이 실제로 제한되는지 확인해야 합니다. LiteLLM 사용자·팀·키 예산 문서
얼마를 예약할지 먼저 확정합니다
예약액은 모델이 제안하는 숫자가 아니라 신뢰할 수 있는 실행기가 확정한 경로와 요금 조건에서 계산합니다. 요청이 사용할 모델, 입력 상한, 출력 상한, 추가 유료 기능을 확정한 뒤 그 조건을 실제 호출에도 그대로 적용해야 합니다. 예약 후 모델이나 출력 한도를 바꾸면 원래 예약은 더 이상 그 요청을 보호하지 못합니다.
텍스트만 처리하고 입력·출력 토큰만 청구되는 가상의 경로를 생각해 보겠습니다. 다음 값은 계산을 설명하기 위한 가정이며 실제 모델의 현재 요금이 아닙니다.
| 계산 입력 | 가정 |
|---|---|
| 입력 요금 | 100만 토큰당 2달러, USD |
| 출력 요금 | 100만 토큰당 8달러, USD |
| 입력 토큰 상한 | 5,000토큰 |
| 출력 토큰 상한 | 1,500토큰 |
| 기타 유료 기능 | 이 예제에는 없음 |
예약액은 5,000 × 2 / 1,000,000 + 1,500 × 8 / 1,000,000 = 0.022달러입니다. 부동소수점 오차를 피하려고 원장에서는 1달러를 1,000,000 micro-USD로 저장합니다. 따라서 예약액은 22,000입니다. 실제 사용액과 예약액은 같은 통화·단위로 기록하고, 더 작은 단위의 계산 결과는 예약액이 부족해지지 않도록 올림합니다.
입력 상한에는 시스템 지시, 대화 기록, 도구 결과와 첨부 자료까지 포함해야 합니다. 글자 수를 토큰 수로 그대로 쓰지 마세요. 캐시 읽기·쓰기, 추론 토큰, 이미지·음성, 검색 같은 별도 요금이 있는 경로라면 해당 항목의 상한도 합쳐야 합니다. 캐시 할인이 확실하지 않으면 할인 없이 예약하는 편이 보수적입니다. Anthropic은 입력 사용량에서 input_tokens, 캐시 읽기, 캐시 생성 필드를 구분하므로 한 필드만 보고 전체 입력 비용을 계산해서도 안 됩니다. Anthropic 한도와 사용량 필드 안내
경로의 요금이나 최대 사용량을 확정할 수 없다면 0으로 추정해 통과시키지 않습니다. 해당 경로를 거절하거나, 별도로 승인된 보수적 상한을 적용할 수 있는 요청으로 제한합니다. SDK가 내부에서 재시도한다면 그 각각의 실제 전송을 예약하도록 연결해야 합니다. 연결할 수 없으면 재시도 전체의 확실한 최대 비용을 먼저 확보해야 하며, 확인되지 않은 재시도 횟수를 가정해서는 안 됩니다.
예산 소유자와 요청 내용을 모델 밖에서 고정합니다
원장의 예산 ID는 사용자 인증과 서버의 작업 기록으로 결정합니다. 모델이 출력한 budget_id, 가격, 새 작업 ID를 그대로 사용하면 예산 소진 후 다른 이름으로 계속 호출할 수 있습니다. 하위 에이전트는 부모 작업의 예산을 상속하고, 더 작은 자체 상한이 필요하면 부모 상한과 함께 검사합니다.
예약에는 요청 ID뿐 아니라 기간, 유료 경로, 확정된 요청 내용의 해시와 예약액을 묶습니다. 같은 요청 ID에 다른 내용을 보내려 하면 충돌로 처리합니다. 동일 ID가 다시 들어와도 공급자에게 두 번 보내지 않도록 별도의 실행 상태가 필요합니다. 정산 ID의 중복 방지와 공급자 전송의 중복 방지는 같은 문제가 아닙니다.
운영 원장에는 최소한 다음 정보가 있어야 합니다.
- 예산 소유자와 적용 기간, 통화·단위, 승인된 상한과 정책 버전
- 요청 ID와 부모 작업 ID, 확정 경로, 요청 내용 식별값, 예약액
- 예약됨·전송됨·비용 불명·정산됨·전송 전 취소됨 상태
- 확인된 실제 금액, 사용량 근거, 공급자 요청 식별값, 정산 시각
- 종료 사유와 재개 승인 기록
요청 본문이나 비밀 키를 그대로 감사 로그에 넣을 필요는 없습니다. 어떤 승인으로 어떤 비용이 예약·정산됐는지 재구성할 수 있는 정보만 접근을 제한해 보관합니다.
실행 가능한 원형: 검사·예약·전송·정산
다음 코드를 spend_guard.py로 저장하고 python3 spend_guard.py로 실행할 수 있습니다. ApprovedCall은 모델의 출력을 직접 담는 객체가 아닙니다. 신뢰할 수 있는 서버 코드가 요청을 검증하고 경로와 비용 상한을 확정한 뒤 생성합니다. payload_hash에는 실제로 전송할 확정 요청의 식별값을 넣어야 합니다.
이 원형은 하나의 Python 프로세스 안에서 같은 SpendGuard 인스턴스를 공유하는 스레드를 대상으로 합니다. 잠금 안에서 잔액 검사와 예약을 함께 처리합니다. 가짜 공급자는 결과와 확인된 비용을 반환합니다. 실제 SDK 연결, 요금 계산기, 재시작 후 복구를 갖춘 제품 코드가 아닙니다.
from dataclasses import dataclass
from threading import Lock
from concurrent.futures import ThreadPoolExecutor

@dataclass(frozen=True)
class ApprovedCall:
    scope: str
    period: str
    route: str
    payload_hash: str
    bound: int                 # 정수 micro-USD: 1달러 = 1,000,000

class SpendGuard:
    def __init__(self, scope, period, cap):
        if type(cap) is not int or cap <= 0:
            raise ValueError('invalid cap')
        self.scope, self.period, self.cap = scope, period, cap
        self.actual = self.held = 0
        self.records = {}
        self.terminal = None
        self.lock = Lock()

    def reserve(self, request_id, call):
        with self.lock:
            if (not request_id or call.scope != self.scope
                    or call.period != self.period or not call.route
                    or not call.payload_hash or type(call.bound) is not int
                    or call.bound <= 0):
                self.terminal = 'invalid_policy_input'
                return False
            old = self.records.get(request_id)
            if old is not None:
                if old['call'] != call:
                    self.terminal = 'request_id_conflict'
                    return False
                return old['state'] == 'reserved' and self.terminal is None
            if self.terminal:
                return False
            if self.actual + self.held + call.bound > self.cap:
                self.terminal = 'over_budget'
                return False
            self.records[request_id] = {
                'call': call, 'state': 'reserved', 'charge': None}
            self.held += call.bound
            return True

    def claim(self, request_id, call):
        # 호출자는 이 반환값이 True일 때 한 번만 실행합니다.
        with self.lock:
            rec = self.records.get(request_id)
            if (self.terminal or rec is None or rec['call'] != call
                    or rec['state'] != 'reserved'):
                return False
            rec['state'] = 'sent'
            return True

    def cancel_unclaimed(self, request_id):
        # 이 원형에서는 claim 전이면 실행기가 아직 호출하지 않았습니다.
        with self.lock:
            rec = self.records[request_id]
            if rec['state'] != 'reserved':
                return False
            self.held -= rec['call'].bound
            rec['state'] = 'cancelled'
            return True

    def unknown(self, request_id):
        with self.lock:
            rec = self.records[request_id]
            if rec['state'] == 'sent':
                rec['state'] = 'unknown'
                self.terminal = 'needs_reconciliation'
            # 이미 정산된 요청을 늦은 timeout이 다시 미정산으로 바꾸지 않습니다.

    def settle(self, request_id, charge):
        with self.lock:
            rec = self.records[request_id]
            if type(charge) is not int or charge < 0:
                raise ValueError('trusted charge required')
            if rec['state'] == 'settled':
                if rec['charge'] != charge:
                    self.terminal = 'settlement_conflict'
                    raise ValueError('conflicting settlement')
                return
            if rec['state'] not in ('sent', 'unknown'):
                raise ValueError('not dispatched')
            self.held -= rec['call'].bound
            self.actual += charge
            rec.update(state='settled', charge=charge)
            if charge > rec['call'].bound:
                self.terminal = 'estimate_breached'
            # 정산돼도 종료 상태는 자동으로 해제하지 않습니다.

    def invoke(self, request_id, call, fake_provider):
        if not self.reserve(request_id, call) or not self.claim(request_id, call):
            return {'status': 'blocked', 'retryable': False,
                    'reason': self.terminal or 'already_claimed'}
        try:
            result, charge = fake_provider(call)
            self.settle(request_id, charge)
            with self.lock:
                reason = self.terminal
            return {'status': 'stopped' if reason else 'completed',
                    'result': result, 'reason': reason}
        except Exception:
            self.unknown(request_id)
            return {'status': 'needs_reconciliation', 'retryable': False}

def verify():
    call = ApprovedCall('job-17', 'run-17', 'text-A', 'payload-A', 22_000)
    hits = []
    def fake(c):
        hits.append(c.route)
        return 'saved answer', 15_000
    g = SpendGuard('job-17', 'run-17', 50_000)
    assert g.invoke('one', call, fake)['status'] == 'completed'
    assert g.invoke('one', call, fake)['status'] == 'blocked'
    assert len(hits) == 1 and (g.actual, g.held) == (15_000, 0)
    g.settle('one', 15_000)
    assert g.actual == 15_000
    assert g.invoke('two', call, fake)['status'] == 'completed'
    assert g.invoke('three', call, fake)['status'] == 'blocked'
    assert len(hits) == 2 and g.terminal == 'over_budget'
    assert g.invoke('four', call, fake)['status'] == 'blocked'
    assert len(hits) == 2

    race = SpendGuard('job-17', 'run-17', 50_000)
    with ThreadPoolExecutor(max_workers=8) as pool:
        admitted = list(pool.map(lambda n: race.reserve(str(n), call), range(8)))
    assert sum(admitted) == 2 and race.held == 44_000
    assert race.actual + race.held <= race.cap
    for n, ok in enumerate(admitted):
        if ok:
            assert not race.claim(str(n), call)  # 작업 전체가 종료됐습니다.
            assert race.cancel_unclaimed(str(n))
    assert race.held == 0

    u = SpendGuard('job-17', 'run-17', 50_000)
    def timeout(c):
        raise TimeoutError('fake disconnected stream')
    assert u.invoke('unknown', call, timeout)['status'] == 'needs_reconciliation'
    assert u.held == 22_000 and not u.cancel_unclaimed('unknown')
    assert u.invoke('new', call, fake)['status'] == 'blocked'
    u.settle('unknown', 18_000)
    u.settle('unknown', 18_000)
    assert (u.actual, u.held) == (18_000, 0) and u.terminal

    breach = SpendGuard('job-17', 'run-17', 22_000)
    assert breach.reserve('b', call) and breach.claim('b', call)
    breach.settle('b', 25_000)
    assert breach.actual == 25_000 and breach.terminal == 'estimate_breached'
    assert not breach.reserve('c', call)
    reported = SpendGuard('job-17', 'run-17', 22_000)
    answer = reported.invoke('r', call, lambda c: ('saved result', 25_000))
    assert answer == {'status': 'stopped', 'result': 'saved result',
                      'reason': 'estimate_breached'}
    print('offline assertions passed')

if __name__ == '__main__':
verify()reserve()는 이미 사용한 금액과 남아 있는 예약을 모두 확인합니다. claim()은 승인된 요청을 한 번만 전송 상태로 바꿉니다. 둘 사이에 작업 전체가 종료되면 아직 전송하지 않은 요청도 실행하지 않습니다. 이 경우에만 cancel_unclaimed()로 예약을 해제합니다. 전송 상태가 된 요청의 예약은 이 함수로 해제할 수 없습니다.
settle()은 같은 요청을 같은 금액으로 다시 정산해도 실제 금액을 중복 가산하지 않습니다. 금액이 서로 다른 중복 정산은 충돌로 남기며 새 호출을 막습니다. 실제 비용이 예약액보다 크면 원장에 실제 금액을 그대로 기록한 후 차단합니다. 예약액에 맞춰 비용을 줄여 기록하면 청구 불일치를 숨기게 됩니다. 이미 발생한 초과액을 코드가 소급해서 없앨 수는 없습니다. 이때 invoke()는 완료된 응답을 보존하면서 stopped와 종료 사유를 반환합니다. 호출자는 결과가 있다는 이유로 작업을 계속하지 않습니다.
완료된 요청 ID를 다시 호출하면 이 원형은 재전송 없이 blocked를 반환합니다. 결과를 재사용하려면 별도 결과 저장소에서 기존 결과를 반환하도록 연결합니다. 새 요청 ID를 발급하는 것은 새 유료 시도이므로 다시 예약해야 합니다.
오프라인 확인 결과를 읽는 법
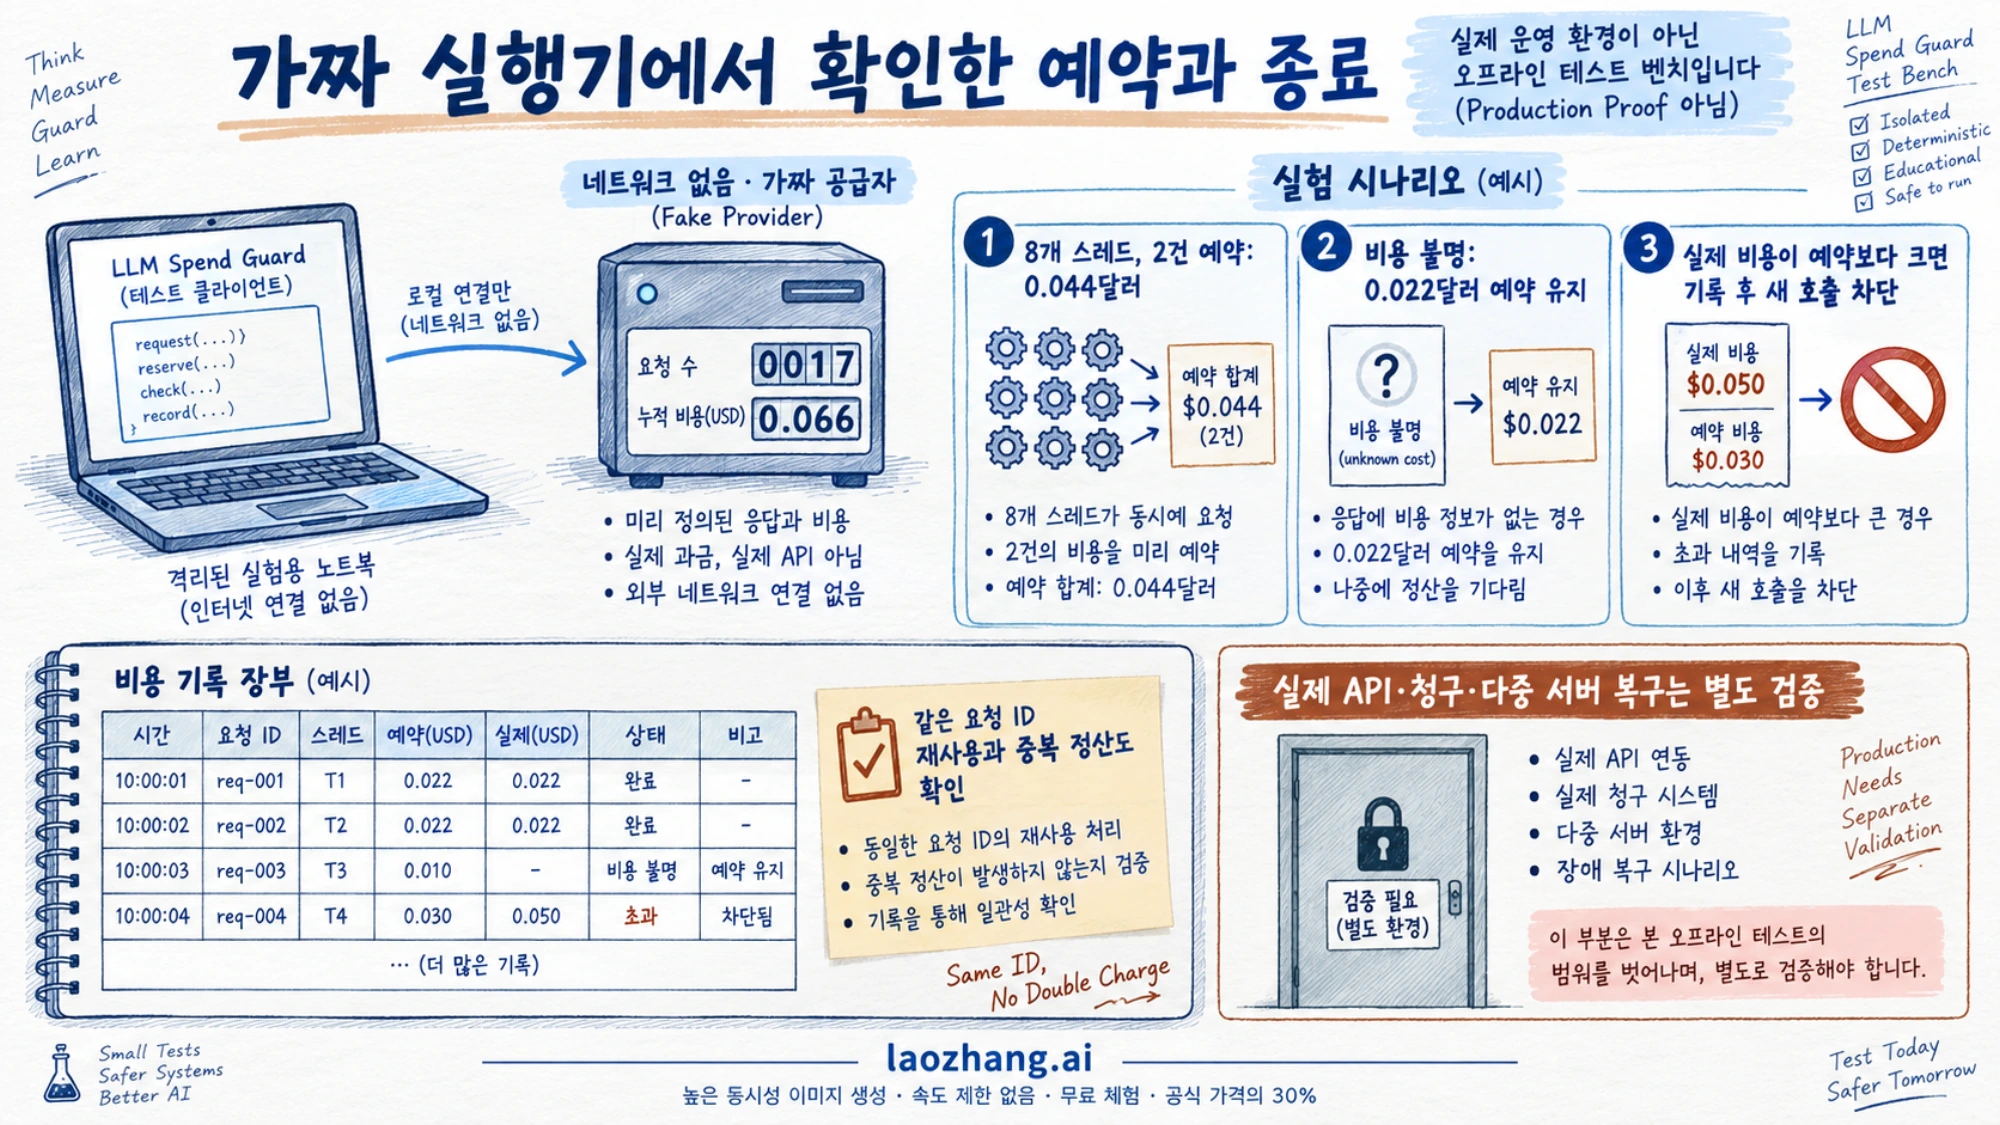
위 최종 코드를 로컬에서 실행해 offline assertions passed를 확인했습니다. 확인한 범위는 다음과 같습니다.
| 확인한 상황 | 결과 |
|---|---|
| 0.05달러 한도에서 두 요청의 실제 비용이 각각 0.015달러 | 두 건 완료 후 실제 사용액은 0.03달러. 다음 0.022달러 예약은 거절됨 |
| 완료된 요청 ID 재사용과 동일 금액 재정산 | 가짜 공급자 호출과 실제 금액이 중복 증가하지 않음 |
| 8개 스레드가 각각 0.022달러를 동시에 예약 | 두 건만 예약, 총예약 0.044달러. 이후 한도 거절로 작업을 닫고 아직 전송하지 않은 예약은 취소함 |
| 가짜 스트림 단절로 비용을 확인할 수 없음 | 0.022달러 예약 유지. 새 호출 차단 후 확인된 0.018달러를 한 번만 정산함 |
| 예약 0.022달러보다 실제 비용 0.025달러가 큼 | 실제 금액 기록, estimate_breached로 새 요청 차단 |
이는 가짜 실행기의 호출 수와 메모리 원장 상태를 확인한 결과입니다. 실제 공급자의 병렬 청구, 스트리밍 비용, SDK 내부 재시도, Redis나 데이터베이스 장애 복구를 시험한 결과로 확대해서는 안 됩니다. 스레드 시험도 병렬 예약의 시험이며, 여러 서버가 실제 API를 동시에 호출한 실험은 아닙니다.
여러 서버에 배포할 때 달라지는 부분
메모리 잠금은 다른 프로세스를 보호하지 않고 재시작하면 기록도 사라집니다. 배포할 때는 공유 저장소에서 같은 예산 범위의 검사·예약·요청 상태 기록을 하나의 트랜잭션으로 바꿔야 합니다. 팀·사용자·작업·기간별 한도를 함께 적용한다면 모든 대상의 여유 금액을 확인하고 모두 예약하거나, 하나도 변경하지 않아야 합니다. 각 한도를 따로 갱신하면 일부만 예약되는 실패가 생깁니다.
Redis Lua는 서버에서 스크립트가 원자적으로 실행되는 기능을 제공하므로 검사와 갱신을 묶는 수단이 될 수 있습니다. 그러나 그 보장은 공급자 HTTP 호출까지 포함하는 트랜잭션, 영구 보존, 장애 시 자동 복구를 뜻하지 않습니다. 스크립트 실행 오류가 모든 이전 변경을 되돌린다고 가정해서도 안 됩니다. 입력을 먼저 검증하고, 키 접근·지속성·장애 복구는 실제 배포 구성에서 별도로 설계해야 합니다. Redis Lua 실행 범위
원장 갱신 실패나 상태 조회 실패 시에는 새 요청을 보내지 않습니다. 전송 직전에 기록이 저장됐지만 실제 전송 여부를 확인할 수 없는 장애도 보수적으로 보류합니다. “보내지 않았다는 기록이 없다”는 사실과 “확실히 보내지 않았다”는 증거는 다릅니다.
타임아웃과 스트림 중단은 환불 신호가 아닙니다
클라이언트가 연결을 끊어도 공급자가 이미 작업을 처리했을 수 있습니다. 따라서 스트림 중단, 타임아웃, 취소 요청, 오류 응답만으로 예약액을 전부 풀면 안 됩니다. 비용 근거를 받지 못한 요청은 unknown으로 남기고 원래 기간의 예약을 유지합니다.
복구 작업은 공급자 요청 식별값과 신뢰할 수 있는 사용량 기록을 대조해 금액을 확정합니다. 사용량을 알게 되면 해당 요청을 한 번만 정산합니다. 아직 전송되지 않았다는 확실한 증거가 있는 경우에만 미사용 예약을 해제할 수 있습니다. 비용을 계속 확인할 수 없으면 새 돈처럼 쓰지 말고 미정산 항목으로 남겨 운영자가 판단하게 합니다.
기간이 바뀌어도 이전 요청의 예약을 새 기간으로 슬쩍 옮기거나 삭제하지 않습니다. 원래 예약된 기간에 정산하고, 새 기간에서 실행을 허용할지는 별도 정책으로 결정합니다. 타임아웃 후 새 세션·새 작업 ID를 만드는 방식으로 원래 작업의 상한을 초기화해서도 안 됩니다.
LiteLLM의 에이전트 세션 예산은 성공 응답 후 비용을 누적하고 다음 호출 전에 확인하는 방식이며 기본 카운터 TTL은 1시간입니다. TTL이 끝나거나 trace ID가 달라지는 것을 부모 작업의 전체 예산 복구로 해석할 수 없습니다. 문서의 설정 위치 설명에도 키 metadata와 에이전트 매개변수의 차이가 있으므로, 확인하지 않은 복사 설정을 배포용 정답으로 제공하지 않습니다. 사용 중인 버전에서 적용 범위를 검증해야 합니다. LiteLLM 에이전트 반복·세션 예산 문서
예산 종료를 재시도 오류로 처리하지 않습니다
예산이 끝나면 호출자는 작업의 종료 결과를 받아야 합니다. over_budget이면 새 모델 요청, 유료 도구, 하위 에이전트 생성과 대기 중인 재시도를 멈춥니다. needs_reconciliation이면 결과와 원장 기록을 보존하고 정산을 기다립니다. 더 싼 모델이나 다른 키로 자동 전환하는 것도 새 유료 요청이므로 같은 상한을 통과해야 합니다.
예를 들어 내부 실행 결과는 status: blocked, reason: over_budget, retryable: false와 부모 작업 ID를 함께 반환할 수 있습니다. 이 값을 모델에게만 보여 주고 실행기는 재시도하는 구조로 만들지 마세요. 실행기와 대기열의 종료 상태가 실제 차단을 책임져야 합니다.
공급자 오류도 HTTP 상태 하나로 분류하면 안 됩니다.
| 오류 | 해석과 처리 |
|---|---|
OpenAI 429 + organization_spend_limit_exceeded 또는 project_spend_limit_exceeded | 해당 지출 상한 도달. 같은 조건에서 자동 재시도하지 않음 |
Anthropic 429 + rate_limit_error, 세부 코드 enforced_spend_limit_reached | 서비스 티어의 지출 상한 도달. 이 경우 retry-after가 없으며 시간 간격만 늘려도 복구되지 않음 |
Anthropic 400 + invalid_request_error, 사용자가 지정한 API·워크스페이스 사용 한도 메시지 | 사용자 지정 지출 한도. 입력 오타나 일반 처리량 제한과 구분 |
| 처리량 제한, 일시적 오류, 연결 단절 | 원인별 정책 적용. 재시도가 허용돼도 각 전송의 예산을 확보하며 이전 비용 불명 요청은 유지 |
Anthropic의 Claude Code 워크스페이스 한도에는 별도 429 동작이 있으므로 위 두 API 분류를 모든 워크스페이스 오류에 그대로 적용하지 않습니다. 계정·경로·오류 세부 정보를 함께 확인해야 합니다. OpenAI 상한 오류, Anthropic 지출·요청 한도
재개는 모델의 결정이 아니라 승인된 정책의 결정입니다. 운영자는 미정산 비용, 진행 중 요청, 상한 변경의 이유와 유효 기간을 확인한 뒤 작업을 계속할지 결정합니다. 예제는 정산만으로 종료 상태를 해제하지 않습니다. 실제 시스템도 재개 승인 기록을 남기고, 기존 사용액과 예약액을 유지한 상태에서 새 정책으로 다음 요청을 검사해야 합니다.
반복 자체를 해결해야 한다면 AI 에이전트 도구 호출 무한 루프를 멈추는 방법에서 진행 확인과 중복 작업 복구를 따로 다룰 수 있습니다. 비용 게이트는 반복이 정당한지까지 판단하지 않으며, 반복 제한도 금액 예약을 대신하지 않습니다.
자주 묻는 질문
OpenAI의 강제 상한만 쓰면 되는 것 아닌가요?
조직이나 프로젝트의 월간 API 지출을 막는 데 유용합니다. 현재는 강제 집행을 활성화할 수 있지만 반영 지연으로 소폭 초과할 수 있습니다. 여러 공급자를 쓰는 한 작업의 예산과 진행 중 요청의 선예약이 필요하다면 내부 게이트도 적용합니다. OpenAI 공식 설명
429 응답을 받았으면 자동 재시도해도 되나요?
아니요. 지출 상한에 걸린 429와 처리량 제한에 걸린 429를 구분해야 합니다. 같은 지출 정책이 유지되는 동안의 재시도는 작업을 계속 돌릴 뿐입니다. 오류 코드와 세부 정보로 분류하고, 허용된 재시도라도 새 유료 전송 전에 예약합니다. OpenAI 오류 코드, Anthropic 오류 구분
실제 비용이 적었는데도 작업이 멈추면 바로 다시 실행해도 되나요?
자동으로 다시 실행하지 않습니다. 이미 종료된 작업이라면 정산 완료 여부와 대기 중인 호출을 확인하고 승인된 재개 절차를 거칩니다. 이 예제에서 예약 부족으로 종료된 상태는 나중에 잔액이 생겨도 유지됩니다. 새 인스턴스를 만들어 카운터를 지우는 것은 복구가 아닙니다.
하위 에이전트마다 예산을 따로 주면 충분한가요?
부모 작업의 총상한도 함께 적용해야 합니다. 하위 에이전트마다 새 잔액을 주기만 하면 전체 비용은 하위 에이전트 수만큼 늘어납니다. 공유 부모 예산과 필요하다면 더 작은 하위 예산을 함께 원자적으로 예약합니다. 도구에 숨은 모델 호출과 대체 경로도 포함합니다.
이 구현이 실제 청구액을 절대 넘지 않게 보장하나요?
아니요. 제시한 검증은 한 프로세스의 가짜 실행기와 공유 메모리 원장에 대한 것입니다. 실제 청구 상한을 주장하려면 모든 유료 경로의 통제, 보수적인 요금 상한, 내구성 있는 공유 원장, 장애와 재시도 처리까지 검증해야 합니다. 예약보다 실제 비용이 컸다면 그 비용을 기록하고 동결해야 하며, 이미 발생한 초과를 없었다고 처리할 수는 없습니다.
참고 자료6
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 7일.
참고 자료6
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 7일.
- 1.OpenAI 지출 한도 문서developers.openai.com/api/docs/guides/spend-limits
- 2.Cloudflare 지출 한도와 동시성 안내developers.cloudflare.com/ai-gateway/features/spend-limits
- 3.LiteLLM 사용자·팀·키 예산 문서docs.litellm.ai/docs/proxy/users
- 4.Anthropic 한도와 사용량 필드 안내platform.claude.com/docs/en/api/rate-limits
- 5.Redis Lua 실행 범위redis.io/docs/latest/develop/programmability/eval-intro
- 6.LiteLLM 에이전트 반복·세션 예산 문서docs.litellm.ai/docs/a2a_iteration_budgets