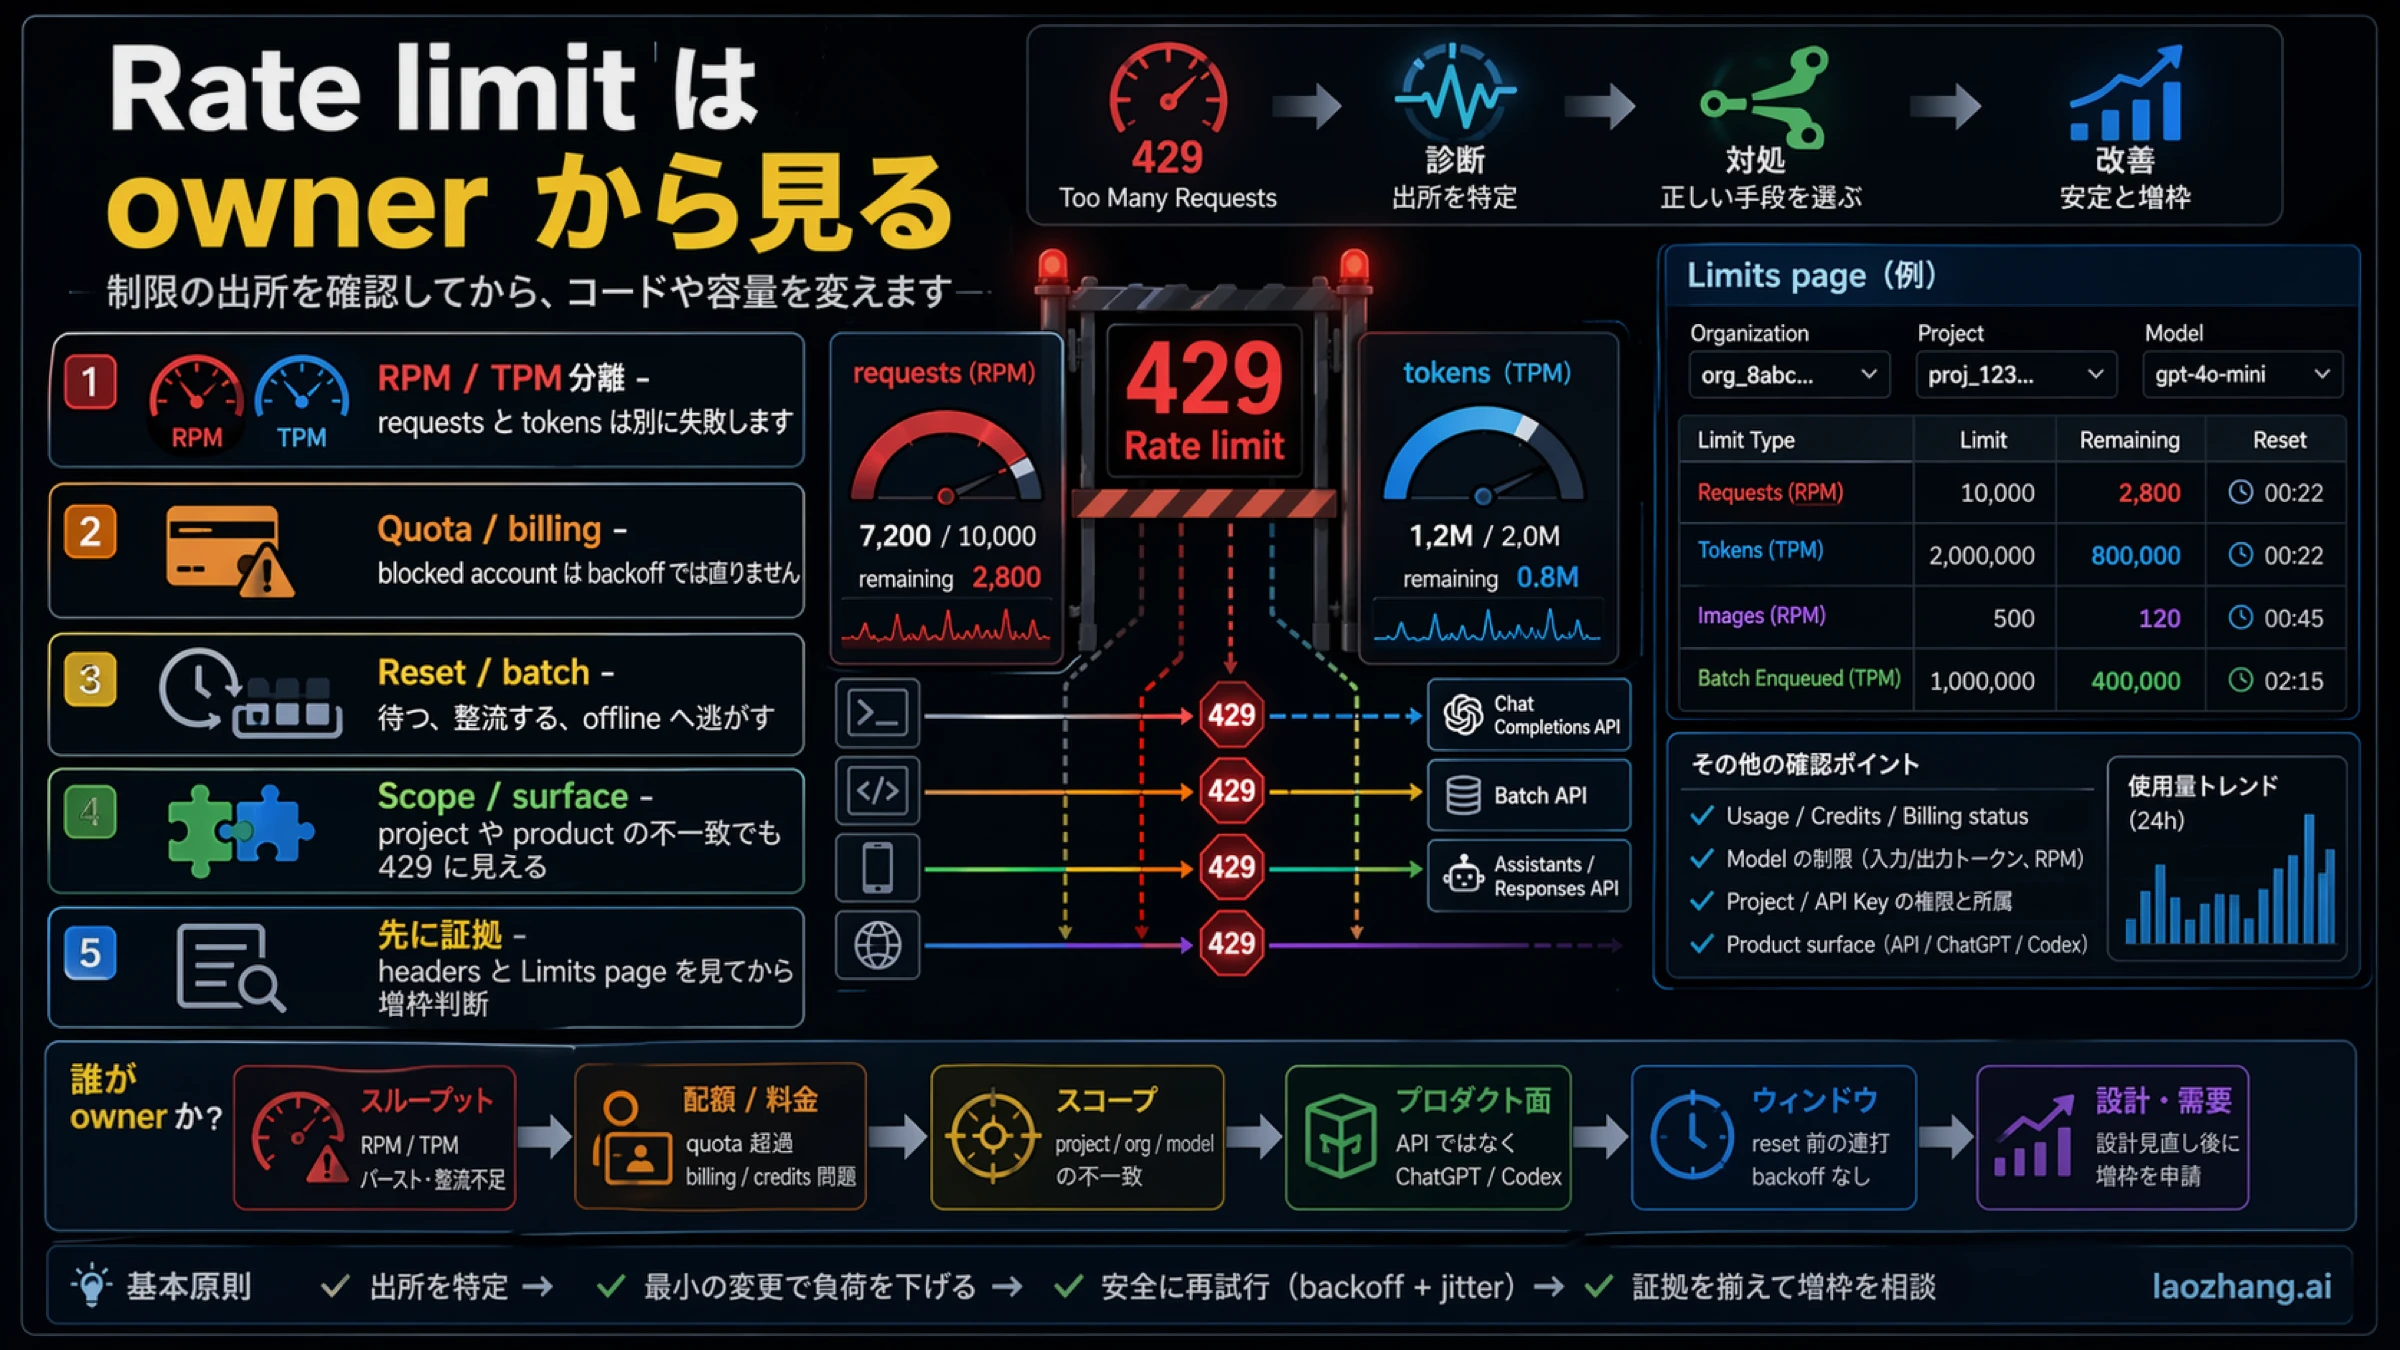
OpenAI APIで 429 Too Many Requests が返ったら、まずエラー本文の error.code と error.type を確認してください。レート制限なら送信量と待機時間を調整し、残高や支出上限が原因なら再試行を止めて該当する設定を確認します。 429という数字だけを見て、再送や入金を繰り返すと原因を取り違えます。
OpenAIの日本語ヘルプでは、通常のレート制限と、クレジット・利用上限・支出上限に関する429を区別しています。本記事は2026年9月8日に確認したOpenAI Platformへ直接送るAPIリクエストを対象に、エラーを分類してから安全に処理を戻すまでを説明します。Azure OpenAIや他社のAPIゲートウェイを使っている場合は、その提供元のエラー定義と課金設定を確認してください。
最初に見るのはステータスより詳細コード
ログに「429」としか残っていない場合は、再試行を増やす前にレスポンス本文を取得します。error.type が insufficient_quota でも、残高不足とは限りません。より具体的な error.code と error.message を合わせて読みます。
| 本文にあるコード・状態 | 主な原因 | 最初に行う操作 |
|---|---|---|
| リクエスト数またはトークン量の上限超過 | RPM・TPMなどの枠を消費 | 送信を減らし、ヘッダーの待機時間を確認する |
slow_down | トラフィックの増加が急すぎる | ワーカーや処理件数の増やし方を緩やかにする |
credit_balance_exhausted | 組織のプリペイドクレジットが尽きた | 対象組織の残高と課金設定を確認する |
organization_usage_limit_exceeded | 組織に割り当てられた月間利用上限に到達 | 組織の利用上限と引き上げ手続きを確認する |
organization_spend_limit_exceeded | 組織の月間支出のハード上限に到達 | 組織の支出上限と当月の支出を確認する |
project_spend_limit_exceeded | プロジェクトの月間支出のハード上限に到達 | キーが属するプロジェクトの支出上限を確認する |
insufficient_quota だけで詳細が不明 | 残高・利用枠などのいずれか | メッセージ、組織、プロジェクト、課金画面を照合する |
コードの定義は公式の429トラブルシューティングに基づきます。表にないコードや情報の欠けた応答を、自動的に「一時的なレート制限」と扱わないでください。
調査用には発生時刻とタイムゾーン、モデル、エンドポイント、組織・プロジェクト、HTTPステータス、コード、メッセージ、リクエストIDを残します。取得できる場合は Retry-After と x-ratelimit-* も保存します。APIキーやプロンプト全文をログに出す必要はありません。
残高があるのに429になる場合の確認順
残高を追加しても直らないときは、「いくら残っているか」と「どの上限で止められているか」を分けて確認します。組織の残高が十分でも、特定プロジェクトの支出上限に達していれば、そのプロジェクトの処理は止まります。別の組織の課金画面を見ている場合も、使用中のキーの状態は判断できません。
まず失敗したキーが属する組織とプロジェクトを特定します。複数の環境を使っているなら、本番・開発環境で同じ設定を参照していると思い込まないでください。確認方法はAPIキーとOrganization IDの整理でも説明しています。
次に、詳細コードが示す項目だけを確認します。
credit_balance_exhaustedなら、対象組織のプリペイド残高を確認します。必要なクレジット追加や課金設定の修正が完了するまで、同じ要求を連続送信しません。organization_usage_limit_exceededなら、割り当てられた月間利用上限を確認します。残高追加やプロジェクト予算の変更だけで、その利用上限も上がるとは限りません。organization_spend_limit_exceededなら、組織全体のハード上限を確認します。影響はその組織の全プロジェクトに及びます。project_spend_limit_exceededなら、対象プロジェクトのハード上限を確認します。同じプロジェクトでキーだけ作り直しても、上限そのものは変わりません。
ここで混同しやすいのが、支出アラートとハード上限です。OpenAIの支出上限ガイドによると、アラートは通知を出す設定であり、ハード上限はAPIトラフィックを停止する設定です。 「予算」という表示や通知を見ただけでは、APIを止めた原因と断定できません。停止コードと実際に設定されたハード上限を照合します。
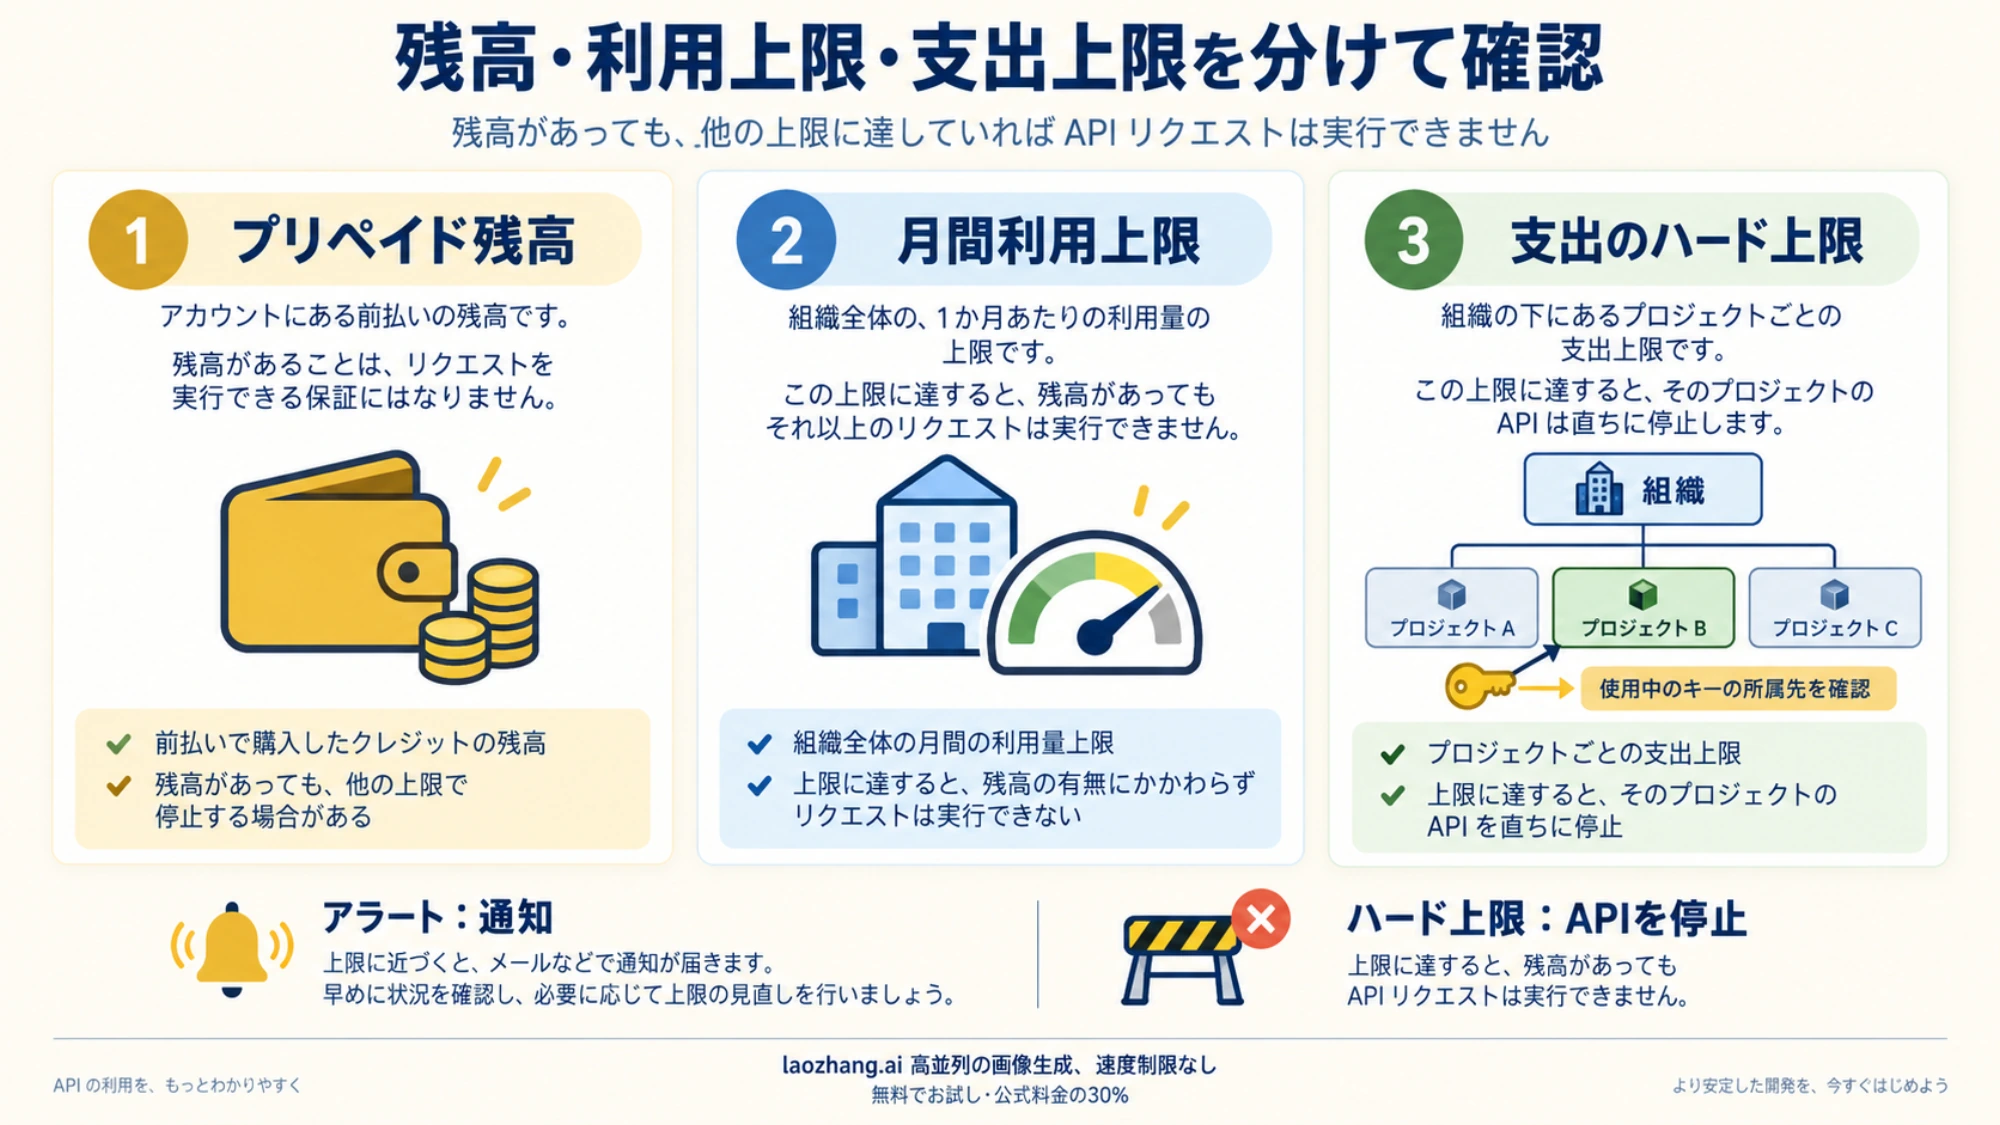
権限のある担当者が上限を変更した場合も、設定の反映に時間がかかることがあります。月間支出上限は月次リセットで回復する場合がありますが、どの課金エラーも一定の秒数で直るわけではありません。詳細な課金確認はOpenAI APIのquota exceededエラー対処法を参照してください。
設定を修正したら、失敗していたものと同じキー・プロジェクト・モデルで、小さいリクエストを1件だけ送り、成功と新しいレスポンスを確認する方法を勧めます。いきなり全ワーカーを再開すると、課金問題が解消した直後に別のレート制限を起こすことがあります。
RPMとTPMのどちらを使い切っているか
課金関連のコードがなく、リクエスト数やトークン数の超過が示されているなら、OpenAI Platformの Limits とレスポンスヘッダーを確認します。公式レート制限ガイドでは、組織とプロジェクトに上限が適用され、モデルごとの上限や複数モデルで共有する枠があると説明されています。キーを増やしても、同じ共有枠から抜けられるとは限りません。
RPMは1分あたりのリクエスト数、TPMは1分あたりのトークン量です。件数が少なくても、長い入力や大きな出力上限でTPMを圧迫します。反対に、短い質問でも一斉に送ればリクエスト数の制限に達します。1分の平均が低くても、より短い時間幅のバーストで429になる場合があります。
| 調べる対象 | 上限 | 残り枠 | リセットまで |
|---|---|---|---|
| リクエスト数 | x-ratelimit-limit-requests | x-ratelimit-remaining-requests | x-ratelimit-reset-requests |
| トークン量 | x-ratelimit-limit-tokens | x-ratelimit-remaining-tokens | x-ratelimit-reset-tokens |
プロジェクトのトークン枠に関するヘッダーが返る場合は、それも併せて確認します。ヘッダーのない応答は「残り枠がゼロ」ではなく「この応答からは取得できない」と記録してください。Limits の現在値、本文、前後のレスポンスを使って判断します。
リクエスト数が先に尽きるなら、キューからの送信間隔を広げ、同時実行数を下げます。複数ワーカーが同じ上限を使っている場合、各ワーカーの待機だけでは全体の流量を管理できません。共通キューや共有の流量制御で、同時に送る件数を調整します。
トークン枠が先に尽きるなら、不要な会話履歴や重複した資料を減らし、出力上限を必要量に合わせます。Responses APIでは max_output_tokens、Chat Completions APIでは max_completion_tokens を使います。これらは推論トークンと表示される出力の両方に関わるため、極端に小さくすると回答が完了しない場合もあります。パラメーターと制限の説明は公式ヘルプを確認してください。
たとえば毎分80件、1件あたり入力と出力の合計を18,000トークンと見積もるなら、単純計算で毎分144万トークンです。5000 RPMには余裕があっても、100万TPMの枠には収まりません。これは容量計画用の例であり、実際の制限計算や実測値を再現するものではありません。出力上限や入力長のばらつきも見て、ヘッダーで予測を確かめます。
Retry-Afterを守り、再試行の担当を一つにする
一時的なレート制限には、間隔を延ばしながら再試行する指数バックオフと、送信時刻を分散させるジッターが使えます。ただし、失敗したリクエストも制限に数えられるため、ただ再試行を増やすと回復を遅らせます。OpenAIのレート制限ガイドも、待機を入れた再試行を案内しています。
Retry-After が有効なら、指定された時間より前に再送しないことが基本です。秒数とHTTP日時の両形式を扱い、ヘッダーがない場合や解析できない場合にだけ、自前のバックオフを使います。たとえばサーバーが120秒の待機を指定したのに、アプリの最大待機が15秒だからと15秒後に再送するのは逆効果です。残りの処理期限に収まらないなら、その場での再試行をやめ、後で処理するキューへ戻すか、呼び出し元に失敗を返します。
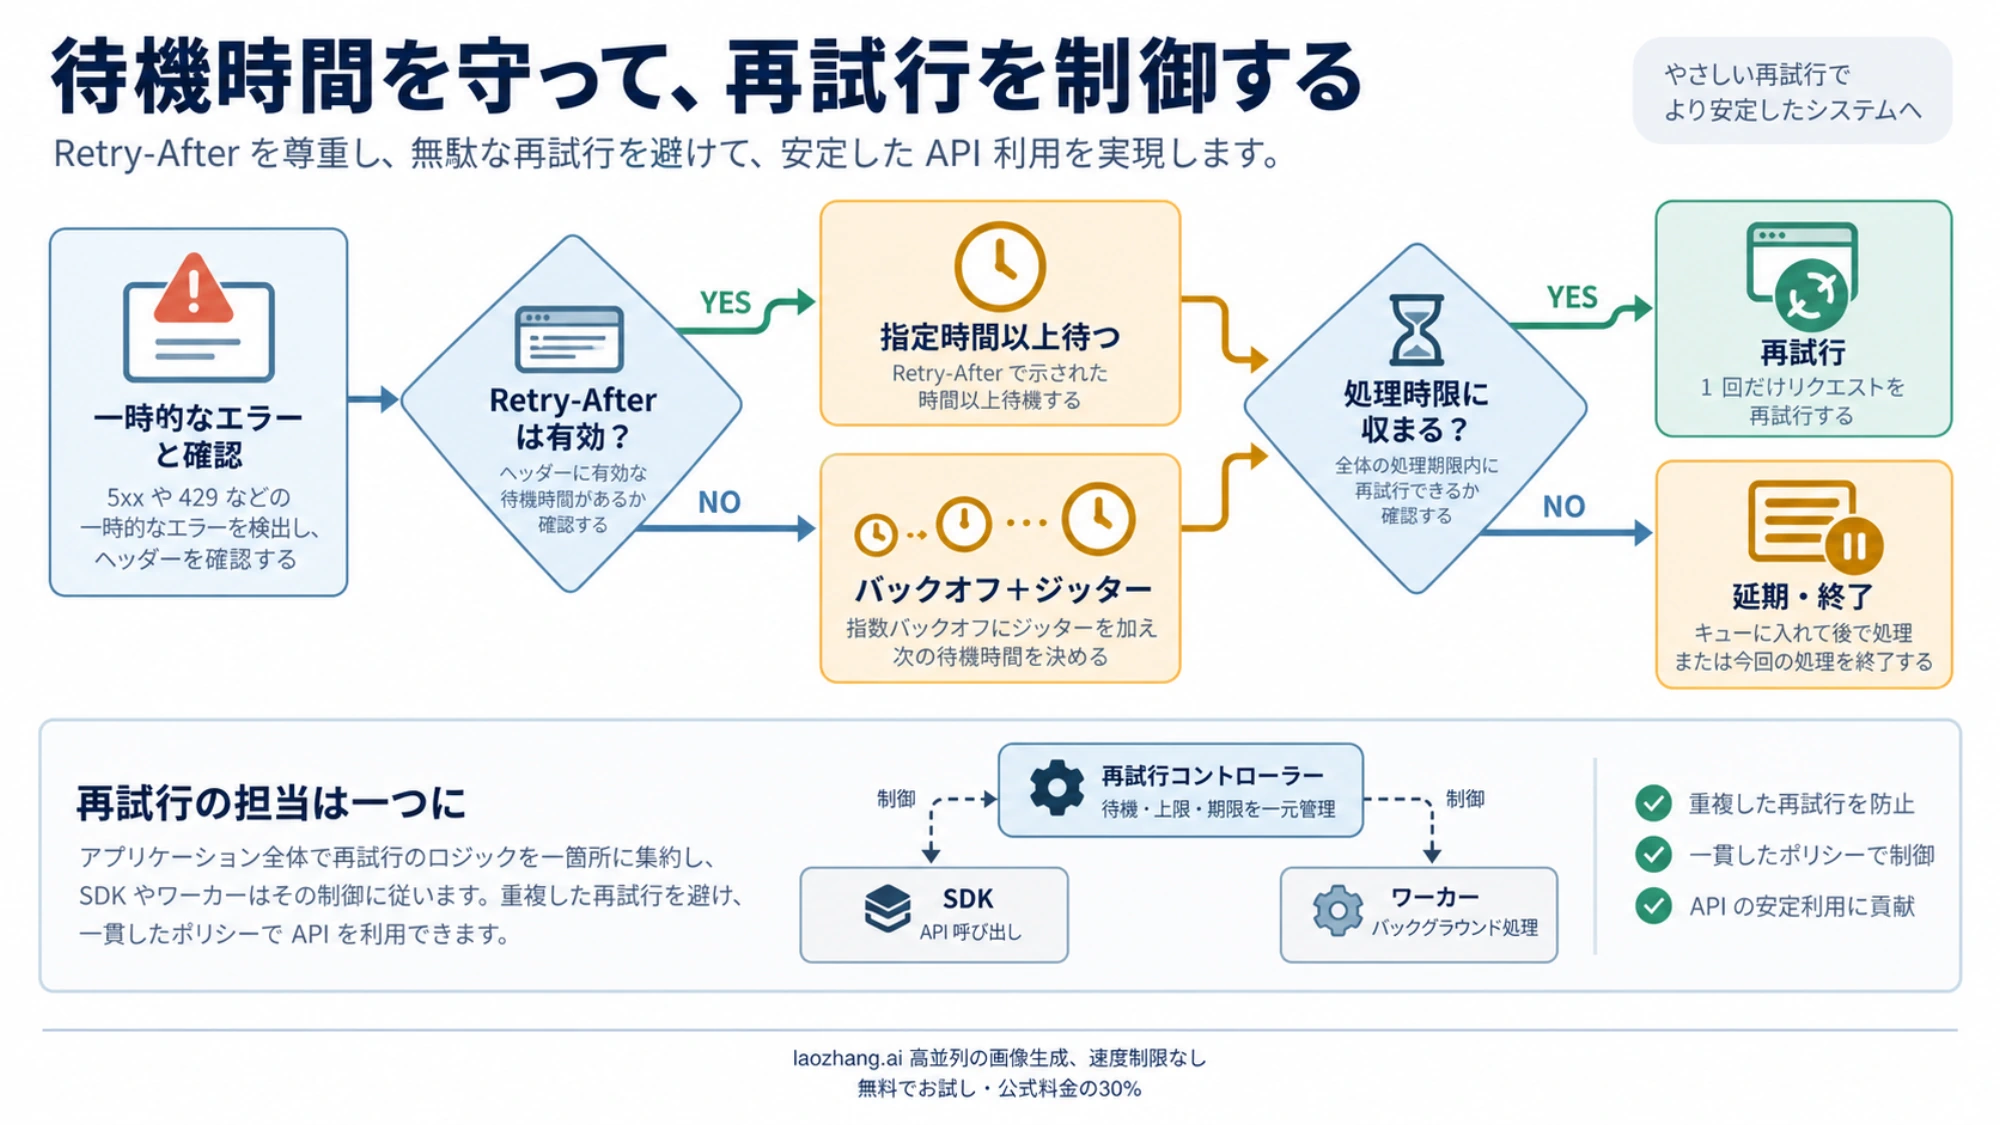
次のPython関数は、待機時間を決める部分だけを切り出した例です。APIへの送信は行いません。呼び出し側が一時的なエラーだと分類した後に使い、None が返ったら現在の処理期限内では再試行しません。
pythonimport random
import re
from datetime import datetime, timezone
from email.utils import parsedate_to_datetime


def retry_delay(retry_after, retry_index, remaining_seconds, *, now=None):
    # retry_indexは0から。remaining_secondsは処理期限までの残り秒数。
    if remaining_seconds <= 0:
        return None
    delay = None
    value = retry_after.strip() if isinstance(retry_after, str) else ""

    if re.fullmatch(r"[0-9]+", value):
        delay = float(value)
    elif value:
        try:
            target = parsedate_to_datetime(value)
            if target.tzinfo is not None:
                current = now or datetime.now(timezone.utc)
                delay = max(0.0, (target - current).total_seconds())
        except (TypeError, ValueError, OverflowError):
            pass

    if delay is None:
        # ヘッダーなし・不正値の場合のみ、自前の上限付きバックオフ。
        upper = min(30.0, 2.0 ** min(max(retry_index, 0), 5))
        delay = random.uniform(upper / 2, upper)

    # 有効なサーバー指定を短く切り詰めない。
    return delay if delay < remaining_seconds else None
この関数とは別に、呼び出し回数の上限、API呼び出し自体のタイムアウト、キャンセルを管理します。待機後に残り時間を再計算し、送信を含めた全体の期限を超えないようにします。これは待機計算の例であり、そのまま運用に入れられる再試行クライアントではありません。
もう一つの落とし穴はSDKとの重複です。OpenAI Python SDKのリファレンスでは、対象エラーをデフォルトで2回再試行すると説明されています。SDKの1回の呼び出しが最大3回の送信になり、外側のジョブ処理がさらに3回呼び直すなら、1ジョブから最大9回の送信が発生し得ます。実際の回数は、エラーの種類や途中の成功で変わります。
アプリ側でエラー分類と待機を制御するなら、OpenAI(max_retries=0) でSDKの自動再試行を無効にし、再試行の責任を一つに集めます。SDKに任せる場合も、ワーカー、キュー、ゲートウェイで追加される再試行を確認してください。Pythonでは429が RateLimitError に対応しますが、例外名だけでは課金原因かどうかは分かりません。APIStatusError の response と request_id を使い、本文を読んでから再試行対象を判断します。
slow_downと503は何が違うか
RPM・TPMにまだ余裕があっても、送信量の増やし方が急すぎると 429 の slow_down が返る場合があります。一方、503 の server_is_overloaded はモデルの処理容量が一時的に不足している状態です。公式エラーコードガイドでは、前者の型は rate_limit_error、後者は service_unavailable_error とされています。
slow_down が出たら、デプロイ直後やバッチ開始時に全ワーカーを同時起動していないか確認します。待機後に同じ集中を繰り返さないよう、稼働数を少しずつ戻し、キューへの投入・取り出しを分散させます。
server_is_overloaded では Retry-After を尊重し、長引く場合はOpenAI Statusと発生時間帯を照合します。これは残高不足を示すコードではないため、最初の対応を入金にする根拠はありません。別モデルへ切り替える場合も、共有レート枠、料金、機能、出力品質が変わる可能性を確認します。再試行とモデルのフォールバックの使い分けは、切り替え条件を設計するときに役立ちます。
GPT-6 Astraの公開上限を容量計画に使う
個々の429を解消したら、ピーク時の必要量が継続的に上限を超えていないかを調べます。GPT-6 Astraの公式モデルページで2026年9月8日に確認したStandardの公開値は次のとおりです。利用モデルの例として掲載しており、この表が自分のキーに同じ値を保証するわけではありません。
| Usage Tier | RPM | TPM | Batch queueの入力トークン上限 |
|---|---|---|---|
| Tier 1 | 500 | 500,000 | 1,500,000 |
| Tier 2 | 5,000 | 1,000,000 | 3,000,000 |
| Tier 3 | 5,000 | 2,000,000 | 100,000,000 |
| Tier 4 | 10,000 | 4,000,000 | 200,000,000 |
| Tier 5 | 15,000 | 40,000,000 | 15,000,000,000 |
Freeでは対応していません。有料であることやTierの番号だけでモデルへのアクセスを判断せず、対象プロジェクトでの利用可否と Limits の現在値を確認します。モデルへのアクセス不可とレート制限も、同じ原因として扱わないでください。
Batch queueは、同じモデルで処理待ちになっているBatchジョブの入力トークン合計です。リクエスト件数や1日あたりの利用枠ではありません。入力5,000トークンの要求を300件待機させると150万トークンになります。完了したジョブの入力トークンは待機枠を占有しなくなるため、非同期処理では投入量と完了速度の両方を監視します。定義は公式のBatch関連レート制限を参照してください。
Fast modeの公式ガイドでは、同一モデルのStandardとFastはレート制限を共有すると説明されています。Fastに切り替えても、RPM・TPMの枠が追加されるわけではありません。
容量計画では、ピーク1分の件数、入力・出力の見積もり、再試行分、Batchの待機入力を別々に数えます。平均値だけでなく、長い要求が集中する時間帯と他のワーカーによる消費も含めます。上限ぎりぎりまで送る設計ではなく、実際のばらつきと許容遅延に合わせて余裕を設けます。余裕率に公式の一律な正解はありません。
また、Astraで入力が272Kトークンを超える場合の条件は長い入力に対する料金の境界であり、429が発生する一律の境界ではありません。公開表から同時実行数、日次枠、長文専用TPMを逆算することもできません。料金条件はGPT-6 Astra APIの料金解説、実効上限は対象アカウントの Limits で確認してください。
復旧確認は小さく始める
原因に合った変更を行ったら、同じ条件で小さい要求を送り、結果を比較します。課金設定を修正したのに project_spend_limit_exceeded が残るなら、対象プロジェクトや反映状況を再確認します。成功後に負荷を増やしてRPM・TPMの429へ変わったなら、課金問題から処理量の問題へ切り分けを進めます。
再開は1件、少数のワーカー、通常負荷の順に進め、エラー率、待機時間、キュー滞留、残り枠を見ます。制限を超える需要が続く場合に、入力削減、非同期化、上限の引き上げを検討します。サポートへ相談するときは、リクエストID、発生時刻、モデル、該当コード、ピークRPM・TPM、実施した変更を整理すると、再現条件を伝えやすくなります。
ChatGPTの有料プランやCodexのアカウント利用枠は、OpenAI Platform APIの残高・RPM・TPMとは別です。Codex経由の問題ならCodexのAPIキー利用とサブスクリプションの違い、Azure側の問題ならAzure OpenAIのTPM制限を確認し、失敗した接続先の設定を直してください。