Nano Banana APIで画像が生成されない原因と対処
HTTP 200でも画像が返らない形はテキストだけ、candidatesが空、NO_IMAGEなどに分かれ、対処も違います。ポリシーのブロックと停止済みIDは再送しても直りません。
目次
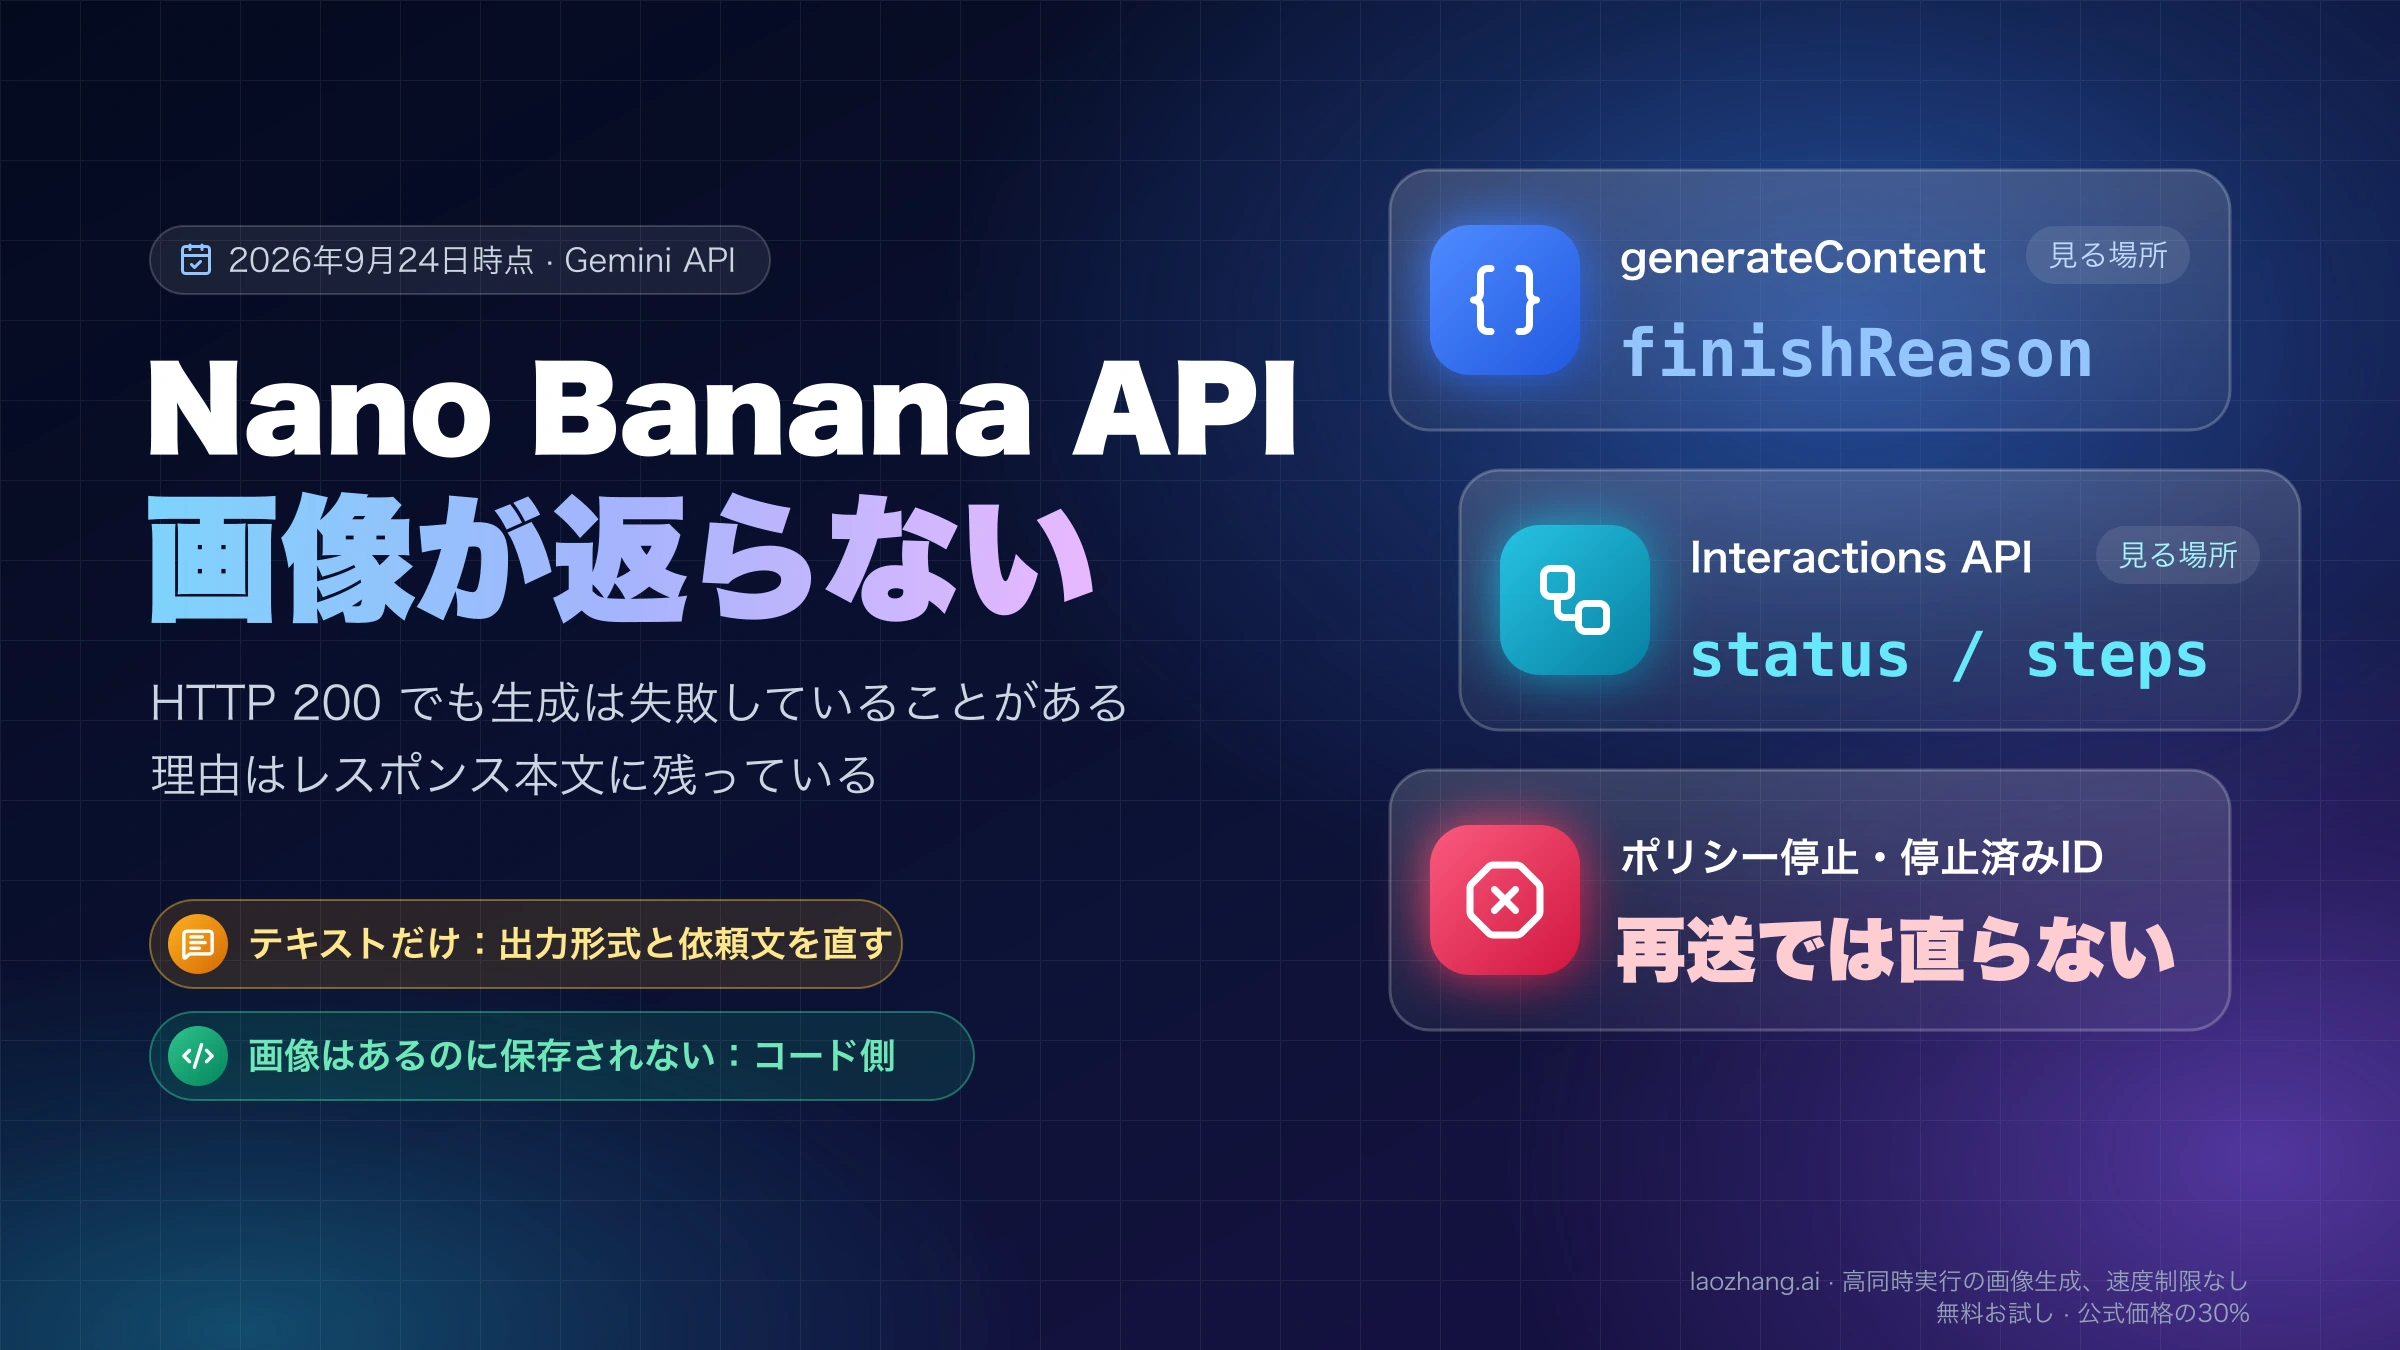
Nano BananaをAPIで呼んで画像が返ってこないとき、HTTPステータスが成功でも生成は失敗していることがあります。理由はレスポンス本文に残っていて、generateContentならpromptFeedback.blockReasonとcandidates[].finishReason、Interactions APIならstatusとstepsの中身を見れば、どの形の失敗かが分かります。テキストだけ返ったなら依頼と出力形式を直せば通る余地がありますが、ポリシーによるブロックと停止済みのモデルIDは、同じリクエストを何度送っても結果は変わりません。
2026年9月24日時点で使えるモデルIDは、Nano Banana 2のgemini-3.1-flash-image、Nano Banana 2 Liteのgemini-3.1-flash-lite-image、Nano Banana Proのgemini-3-pro-imageです。初代Nano Bananaのgemini-2.5-flash-imageは2026年10月2日に停止し、-preview付きのIDは2026年6月25日までにすべて停止しています。Google:Nano Banana image generation
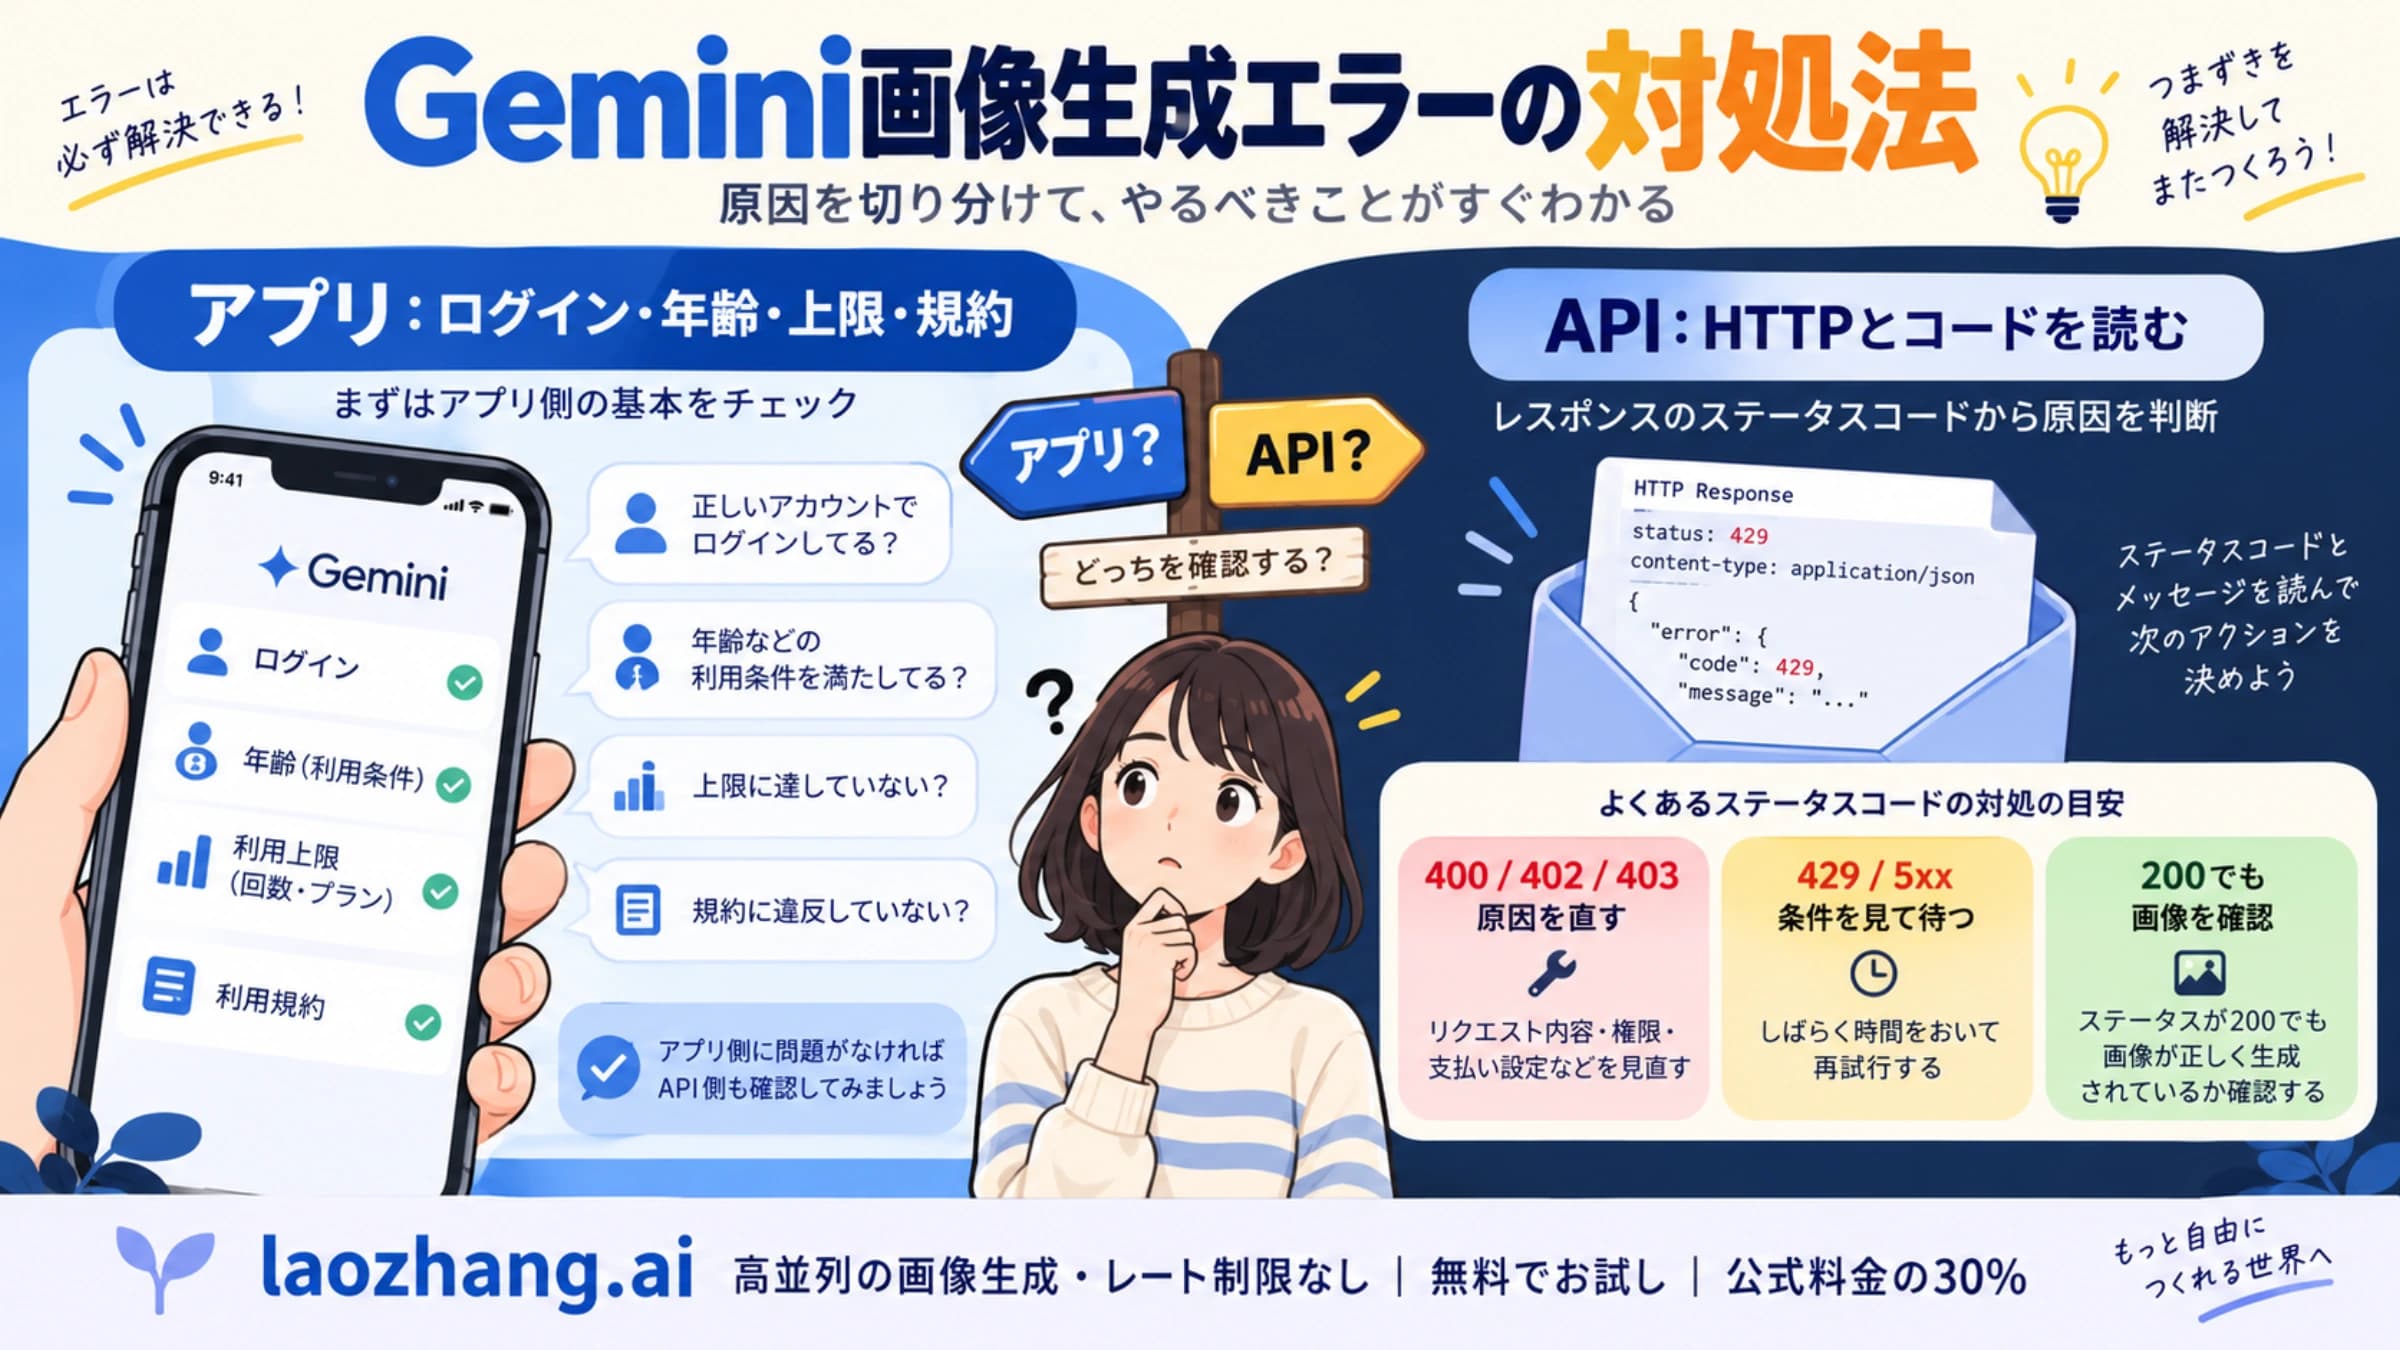
コードを書かずにGeminiアプリやウェブ版で使っていて画像が出ない場合は、Nano Banana が Gemini で動かない時の 12 個の直し方を先に確認してください。ここから先は、Gemini API、AI Studio、公式SDK、APIを使うツール経由で呼んでいる場合の話です。
最初にレスポンスを丸ごと保存する
SDKの便利なプロパティは、判断に必要な情報を落とします。Interactions APIのinteraction.output_imageが返すのは最後の画像ブロック1つだけで、テキストと画像が交互に並ぶ出力では全体を取れません。generateContentのresponse.partsからはfinishReasonもpromptFeedbackも見えません。「画像がない」と判断する前に、レスポンス本文をそのままJSONで保存します。
REST(generateContent)なら、curlの出力をファイルに書き出すだけです。
curl -s -o response.json -X POST \
  "https://generativelanguage.googleapis.com/v1/models/gemini-3.1-flash-image:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"contents":[{"parts":[{"text":"夕暮れの港町を描いた横長のイラストを1枚生成してください"}]}]}'Pythonの公式SDK(google-genai)では、レスポンスオブジェクトをJSONに書き出します。
with open("response.json", "w", encoding="utf-8") as f:
    f.write(response.model_dump_json(exclude_none=True))      # generateContent
# f.write(interaction.model_dump_json(exclude_none=True)) # Interactions APISDKのダンプはキーがfinish_reasonのようなsnake_case、RESTの本文はfinishReasonのようなcamelCaseになります。後半の確認スクリプトはどちらも読めます。
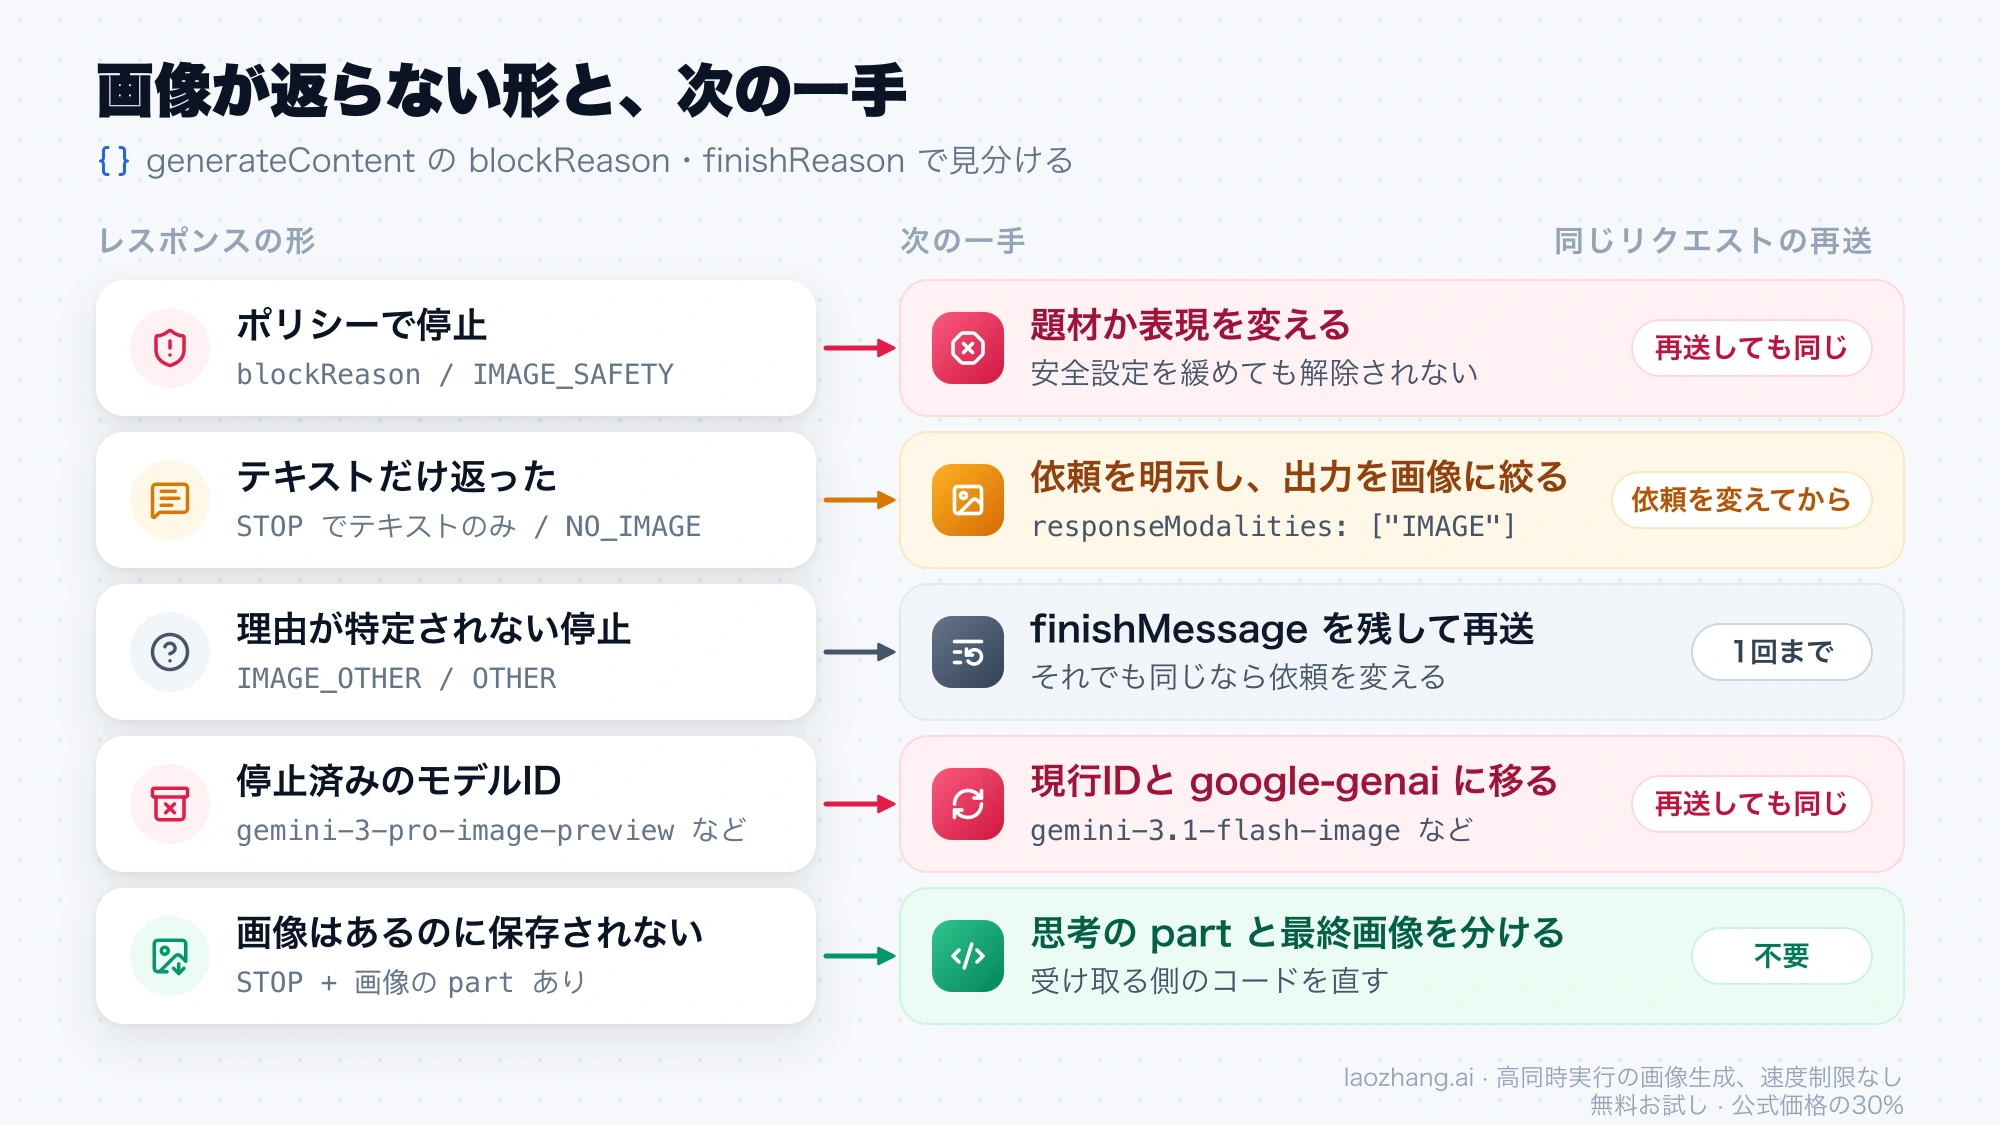
レスポンスの形と次の一手
generateContentとInteractions APIはレスポンスの構造が別物なので、分けて見ます。Googleは2026年6月にInteractions APIを一般提供とし新規プロジェクトに推奨していますが、generateContentもレガシー扱いながら引き続き完全にサポートされています。Google:Interactions API overview
generateContentの場合
| レスポンスの形 | 意味 | 次の一手 | 同じリクエストの再送 |
|---|---|---|---|
candidatesが空でpromptFeedback.blockReasonあり | 入力(プロンプトや参照画像)の段階でブロック | 題材か表現を変える | 効果なし |
finishReason: STOPでpartsはテキストだけ | モデルが文章で応じた | 画像の依頼を明示し、出力形式を画像に絞る | 依頼を変えてから |
NO_IMAGE | 画像を出すはずだったが出なかった | 依頼を短く具体的にする | 依頼を変えてから |
IMAGE_SAFETY、IMAGE_PROHIBITED_CONTENT、SAFETY、PROHIBITED_CONTENT、BLOCKLIST、SPII | 生成の途中または生成物がポリシーで停止 | 題材を変える | 効果なし |
IMAGE_RECITATION、RECITATION | 既存の素材に似すぎて停止 | 依頼を独自の内容にし、特定の作品の再現を外す | 依頼を変えてから |
IMAGE_OTHER、OTHER | 理由が特定されない停止 | finishMessageを記録して1回だけ再送 | 1回まで |
MAX_TOKENS | 出力上限で打ち切り | maxOutputTokensを外すか増やす | 設定を変えてから |
MISSING_THOUGHT_SIGNATURE | 複数ターンの編集で署名が欠けた | 前のターンの署名を履歴に戻す | 履歴を直してから |
STOPで画像のpartがあるのに保存されない | 受け取る側のコードの問題 | 思考中のpartと最終画像を分けて読む | 不要 |
値の意味はGoogleのFinishReasonリファレンスとBlockReasonリファレンスにあります。NO_IMAGEは「画像が生成されるはずだったが生成されなかった」、IMAGE_SAFETYは「生成された画像に安全上の違反がある」と定義されています。どちらの説明も、プロンプトのどの部分が原因かまでは教えてくれません。finishMessageが入っていれば補足の説明なので、必ずログに残します。
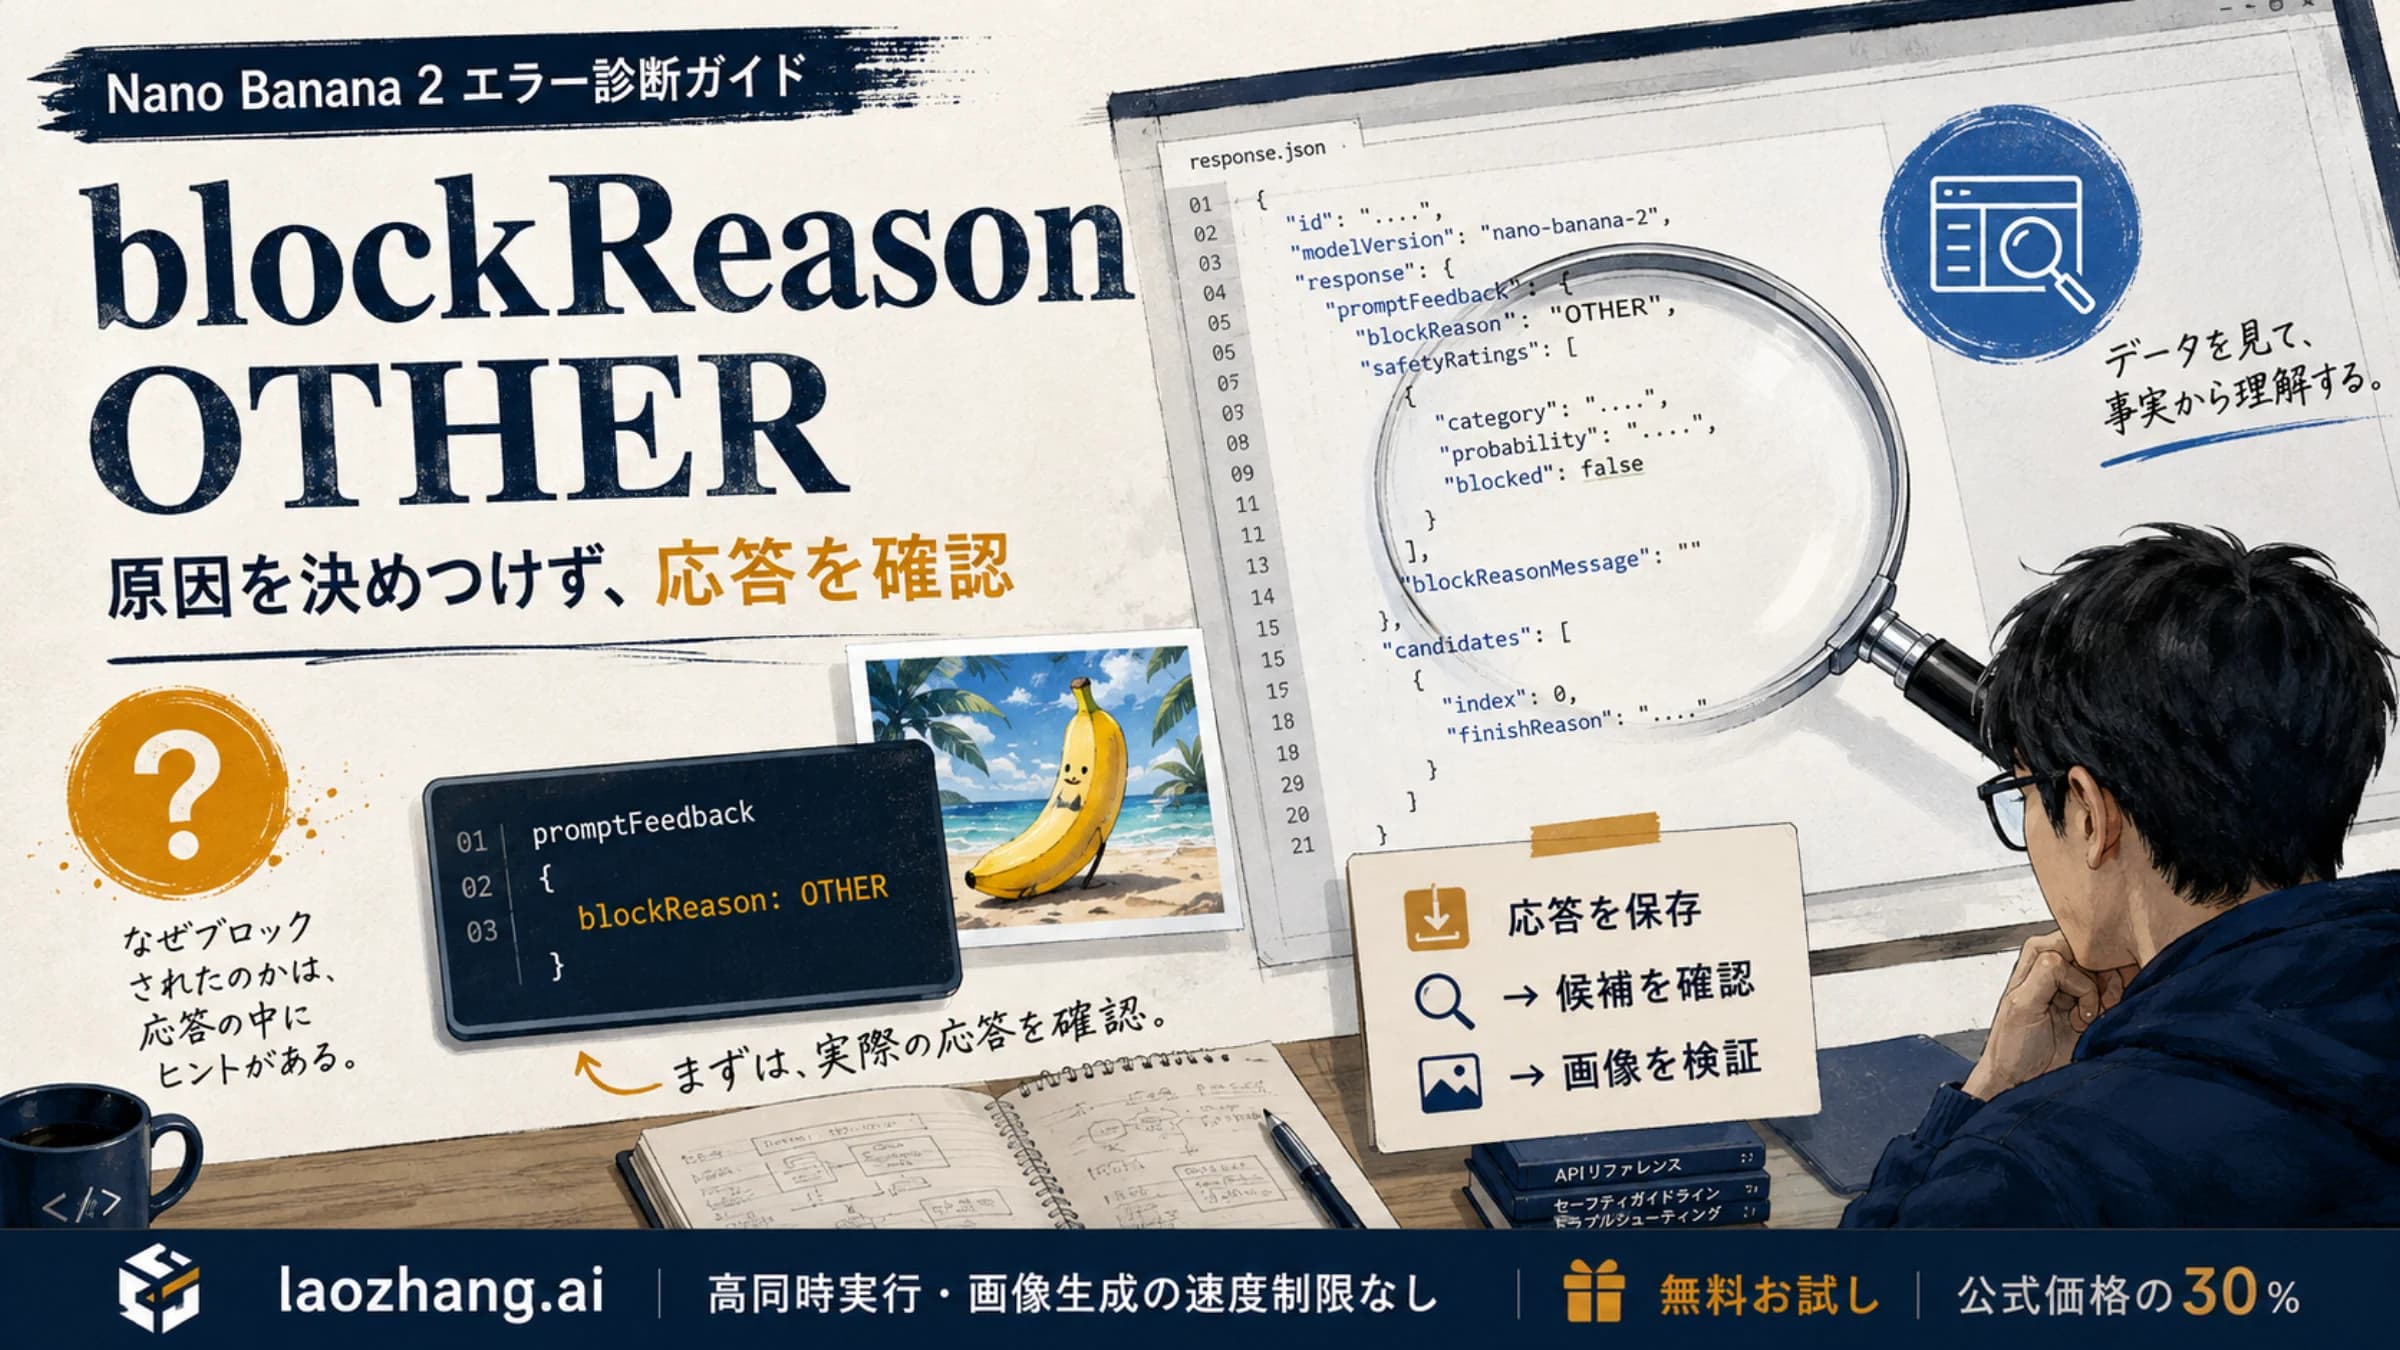
入力段階のブロックでblockReasonがOTHERのときの意味と処理は、Nano Banana 2のblockReason OTHER:意味と空応答の処理方法を参照してください。MISSING_THOUGHT_SIGNATUREは、Nano Banana 2 Thought Signatureエラー:全シナリオ完全修正ガイド(2026年)を参照してください。
Interactions APIの場合
Interactions APIにはfinishReasonがありません。見るのはstatusと、stepsのうちtypeがmodel_outputのステップに画像ブロック(type: "image")があるかどうかです。
status | 意味 | 次の一手 |
|---|---|---|
completedでmodel_outputに画像ブロックなし | テキストだけ返った | response_formatで画像を指定し、依頼を明示する |
failed | interactionが失敗 | errorsのcodeとmessageを保存する |
incomplete | 完了したが結果が不完全(max_tokens到達など) | 出力上限の設定を見直す |
in_progress、queued | まだ終わっていない | background=trueで実行したなら、完了後に取得し直す |
cancelled | キャンセルされた | 呼び出し側の処理を確認する |
画像の安全性でブロックされたときにInteractions APIがどう表現するかは、2026年9月24日時点の公開ドキュメントに記載がありません。failedや画像なしのcompletedが続く場合は、推測でフィールドを作らず、status、steps、errorsを丸ごと保存して比べてください。Google:Interactions API reference
再送してよい場面、してはいけない場面
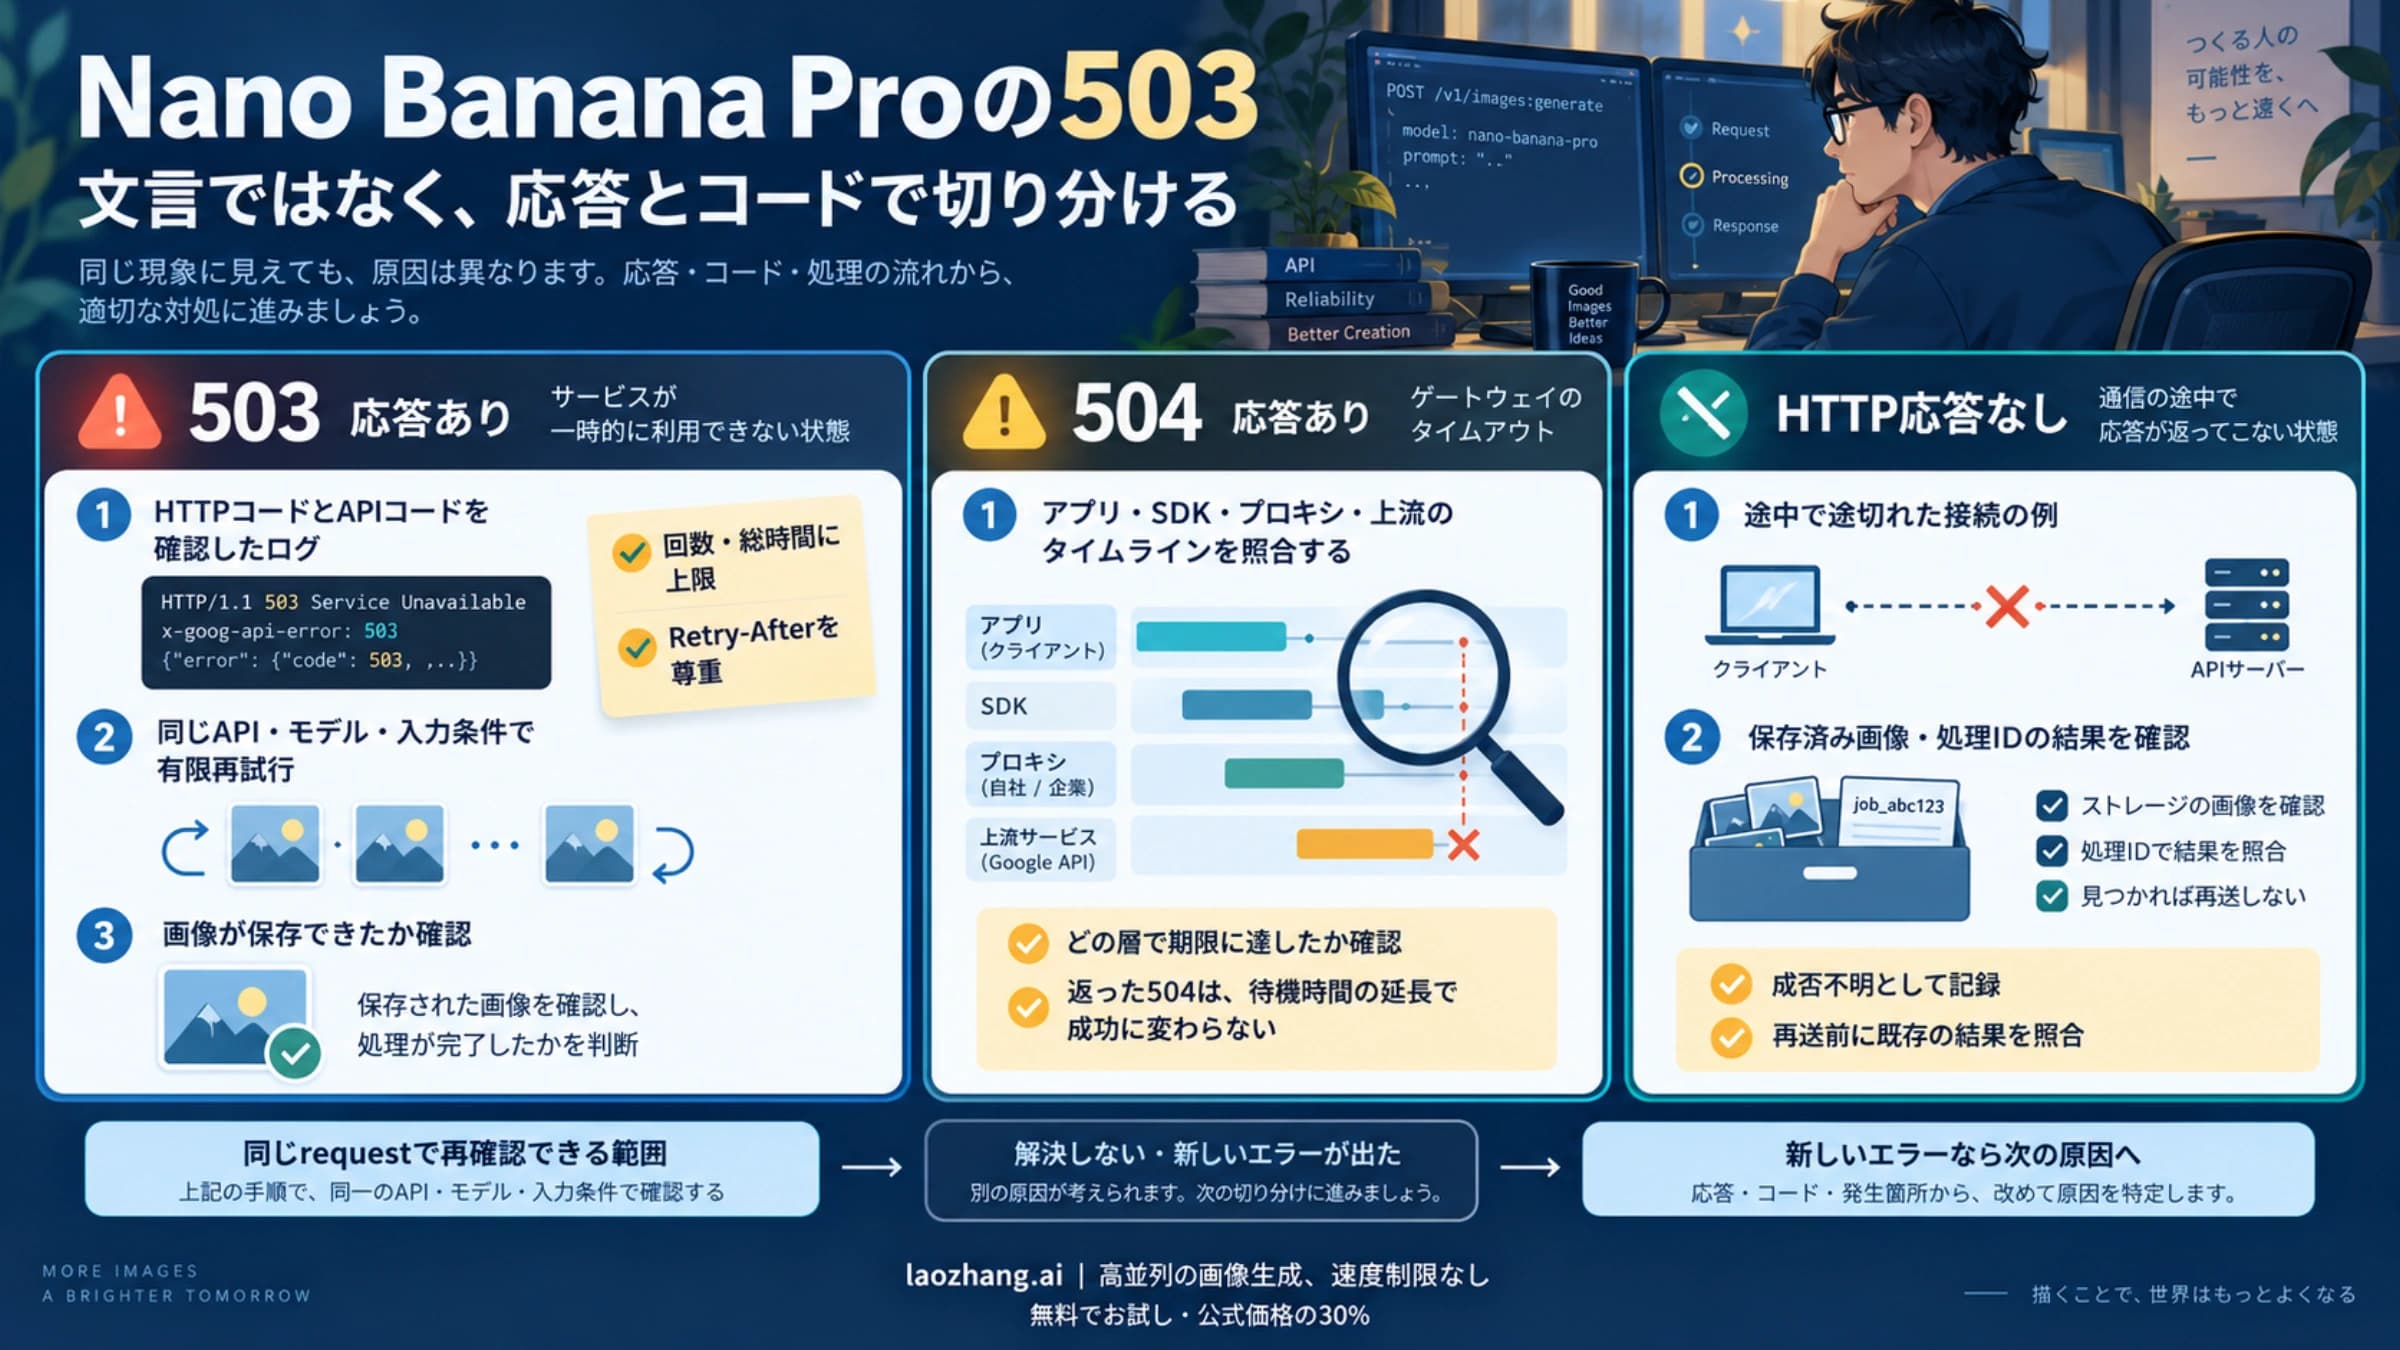
再送に意味があるのは、失敗が一時的な場合だけです。Googleのトラブルシューティングガイドは、429 RESOURCE_EXHAUSTEDや503 UNAVAILABLEには指数バックオフでの再試行を勧め、400や403のようなクライアントエラーは再試行しないよう書いています。公式SDKは429と5xxを既定で自動再試行します。Google:Troubleshooting guide
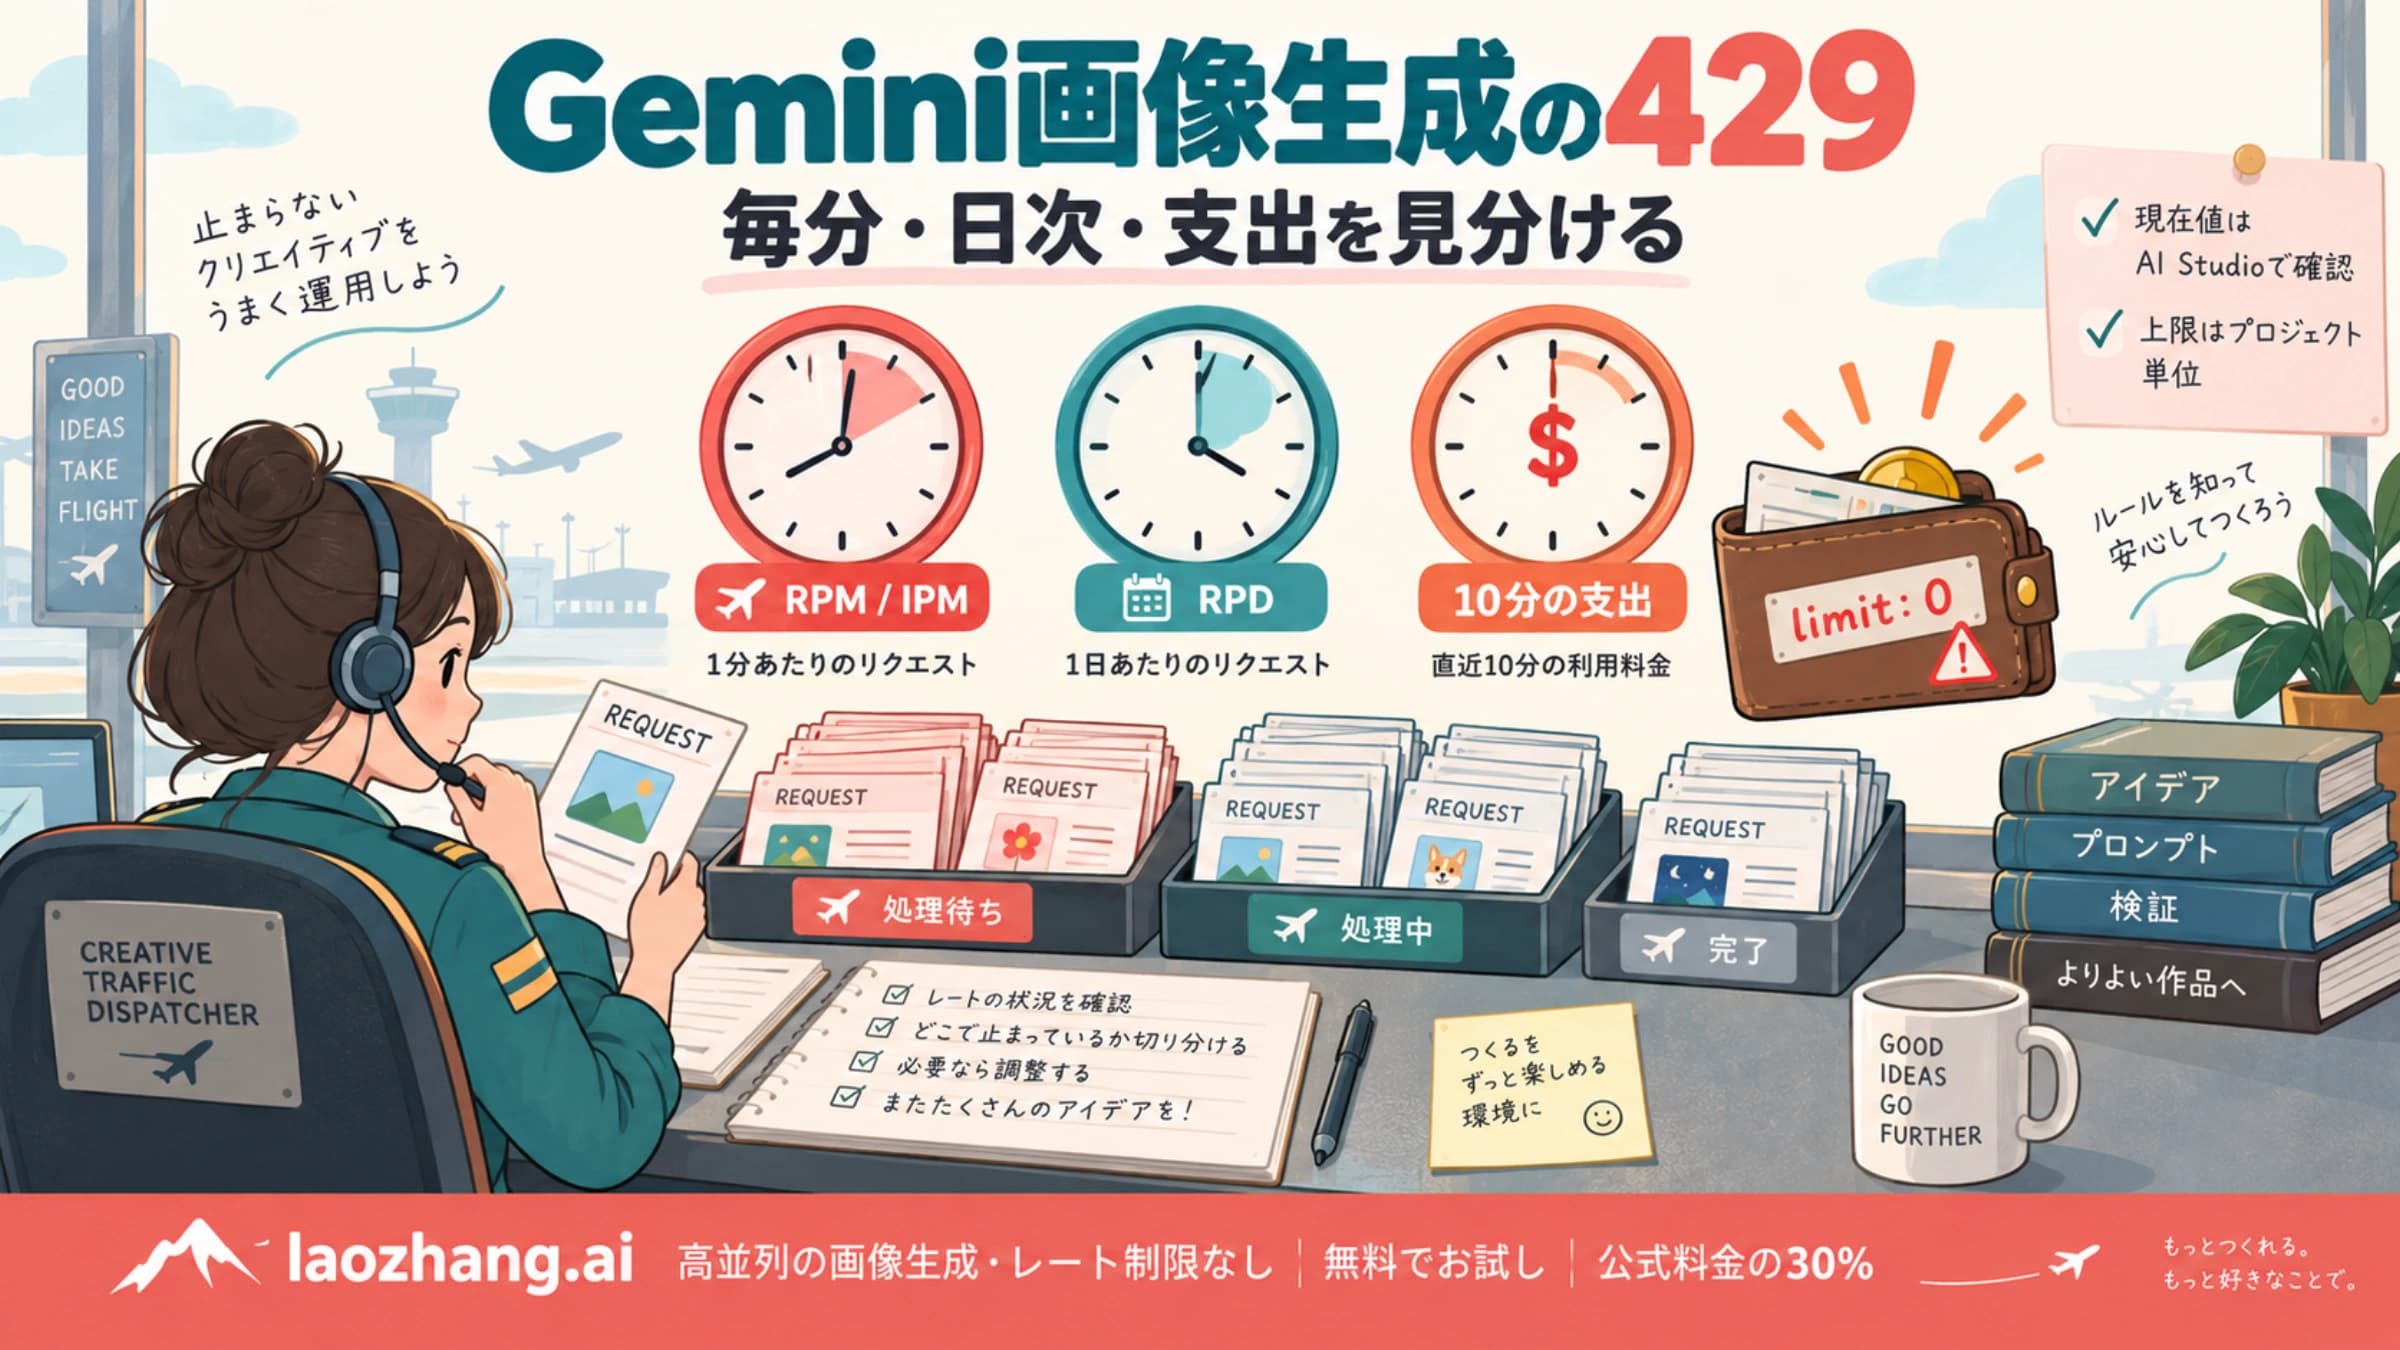
ポリシーによる停止は、同じ入力なら同じ判定になると考えて扱います。再送は料金と時間を使うだけです。IMAGE_OTHERやOTHERは理由が分からないので1回だけ再送し、それでも同じなら依頼を変える、という上限を決めておくと無限ループを防げます。429でそもそも呼び出しが受け付けられていない場合は、Nano Banana 2 の制限は1日何回?回復の仕組みのほうが当てはまります。
テキストだけ返るときは出力形式と依頼文を直す
Nano Bananaは既定でテキストと画像の両方を返すモデルで、依頼の内容によっては画像なしの文章だけで応じます。質問に答えただけ、画像の構想を説明しただけ、という返答がこの形です。
まず出力形式を確認します。generateContentのresponseModalitiesは、レスポンスに含まれるモダリティと完全に一致する指定で、空のリストはテキストのみの指定と同じ扱いです。ラッパーやツールが["TEXT"]や空リストを送っていれば、画像は最初から返りません。画像だけが欲しいなら["IMAGE"]を指定します。Google:GenerationConfig
from google import genai
from google.genai import types

client = genai.Client()
response = client.models.generate_content(
    model="gemini-3.1-flash-image",
    contents="夕暮れの港町を描いた横長のイラストを1枚生成してください",
    config=types.GenerateContentConfig(response_modalities=["IMAGE"]),
)
Interactions APIではresponse_formatに画像の形式を指定すると、会話的なテキストを省いて画像だけを返すよう設定できます。
curl -s -o interaction.json -X POST \
  "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.1-flash-image",
    "input": "夕暮れの港町を描いた横長のイラストを1枚生成してください",
    "response_format": {"type": "image", "aspect_ratio": "16:9"}
}'どちらも出力できるモダリティを絞る設定で、毎回必ず画像が出る保証ではありません。画像に絞ってもNO_IMAGEやポリシーによる停止は起こりえます。
依頼文は、何を作るかを最初に書きます。「〜の画像を1枚生成してください」のように画像を作る指示を先頭に置き、説明や質問と混ぜないようにします。Googleの推奨言語には日本語(ja-JP)が含まれているので、日本語で書くこと自体は問題ありません。X上には「日本語のプロンプトだと画像を作ってくれないことが多く、冒頭に"Generate an image"と入れると成功しやすい」という体験談がありますが、Googleが認めた挙動ではありません。試すなら費用のかからない切り分けとして、画像の指示だけを英語で先頭に置いた版と比べてください。
枚数にも注意が必要です。Googleは制限事項として「ユーザーが明示した画像の枚数に、モデルが常に従うとは限らない」と書いています。複数枚が必要なら1枚ずつ呼ぶほうが確実です。Google:Limitations
ポリシーで止まったら題材を変える
IMAGE_SAFETYやPROHIBITED_CONTENTで止まった場合、安全設定を緩めても解決しません。Gemini APIで調整できる安全フィルタは、ハラスメント、ヘイトスピーチ、性的描写、危険なコンテンツの4カテゴリのしきい値です。子どもの安全を脅かすコンテンツのような中核的な危害への保護は常に有効で、調整できません。Google:Safety settings
さらに、Gemini 2.5と3系のモデルでは、しきい値を指定しない場合の既定値がすでにOFFです。自分でしきい値を厳しくしていないなら、BLOCK_NONEやOFFに変えても緩む余地はありません。4カテゴリの設定項目にはIMAGE_SAFETYやPROHIBITED_CONTENTを解除するものもありません。Interactions APIはカスタムの安全設定自体に対応していません。
何が引っかかったのかは、レスポンスのフィールドからは分かりません。切り分けるには、プロンプトを要素ごとに分け、1つずつ外して送ります。参照画像を付けている場合は、画像なしで同じ文だけを送ると、入力画像が原因かどうかを判断できます。題材そのものが規約に触れているなら、表現を言い換えても通るとは考えないほうが安全です。Googleの生成AIの使用禁止に関するポリシーが基準になります。
同じGoogleのモデルを別のサービスやツール経由で呼んでも、判定しているのはGoogle側のモデルなので、ポリシーによる停止の回避策にはなりません。なお、finishReasonがPUP_LIMITED_DISABLEDの場合は、プロンプトではなくアカウントが使用禁止ポリシー違反で制限または無効化されていることを示します。
停止済みのモデルIDと古いSDKを疑う
「3月までは動いていたコードが、今は画像を返さない」なら、モデルIDを最初に確認します。停止したIDを呼ぶと、画像ではなくエラーが返ります。これもリクエストを再送しても直らないケースです。
| モデルID | 名称 | 2026年9月24日時点の状態 |
|---|---|---|
gemini-3.1-flash-image | Nano Banana 2 | 2026年5月28日に一般提供、停止日は未発表 |
gemini-3-pro-image | Nano Banana Pro | 2026年5月28日に一般提供、停止日は未発表 |
gemini-3.1-flash-lite-image | Nano Banana 2 Lite | 2026年6月30日に一般提供 |
gemini-2.5-flash-image | Nano Banana(初代) | 2026年10月2日に停止 |
gemini-3.1-flash-image-preview | Nano Banana 2のプレビュー版 | 2026年6月25日に停止(後継はgemini-3.1-flash-image) |
gemini-3-pro-image-preview | Nano Banana Proのプレビュー版 | 2026年6月25日に停止(後継はgemini-3-pro-image) |
gemini-2.5-flash-image-preview | 初代のプレビュー版 | 2026年1月15日に停止 |
gemini-2.0-flash-preview-image-generation | Gemini 2.0の画像生成プレビュー | 2025年11月14日に停止 |
出典はGoogleのモデル廃止スケジュールと変更履歴です。generateContentのレスポンスにはmodelStatusが付くことがあり、modelStageがLEGACYなら廃止に向かっている段階、retirementTimeは提供終了の予定時刻です。初代から移る先として、Googleは画像生成ガイドでNano Banana 2 Liteを勧め、料金ページではNano Banana 2とNano Banana 2 Liteを挙げています。移行先を用途で選ぶなら、Nano Banana 2・Pro・2.1・Liteの違いと選び方:新規は2.1が参考になります。
SDKも確認が必要です。Googleの現在のサンプルはgoogle-genaiパッケージ(from google import genaiとgenai.Client())を使います。google.generativeaiのGenerativeModelを使う書き方は旧SDKのもので、現行のサンプルとは別物です。Interactions APIはSDKのバージョンによって型の形が違い、たとえばgoogle-genai 1.65.0のInteraction型にはstepsがなくoutputsを持っています。ドキュメントどおりにinteraction.stepsを読むコードが古いSDKで動かない場合は、SDKを更新してください。
画像はあるのにコードが保存していない
finishReasonがSTOPでレスポンスのサイズも大きいのに、ファイルが保存されない場合は、受け取る側の問題を疑います。
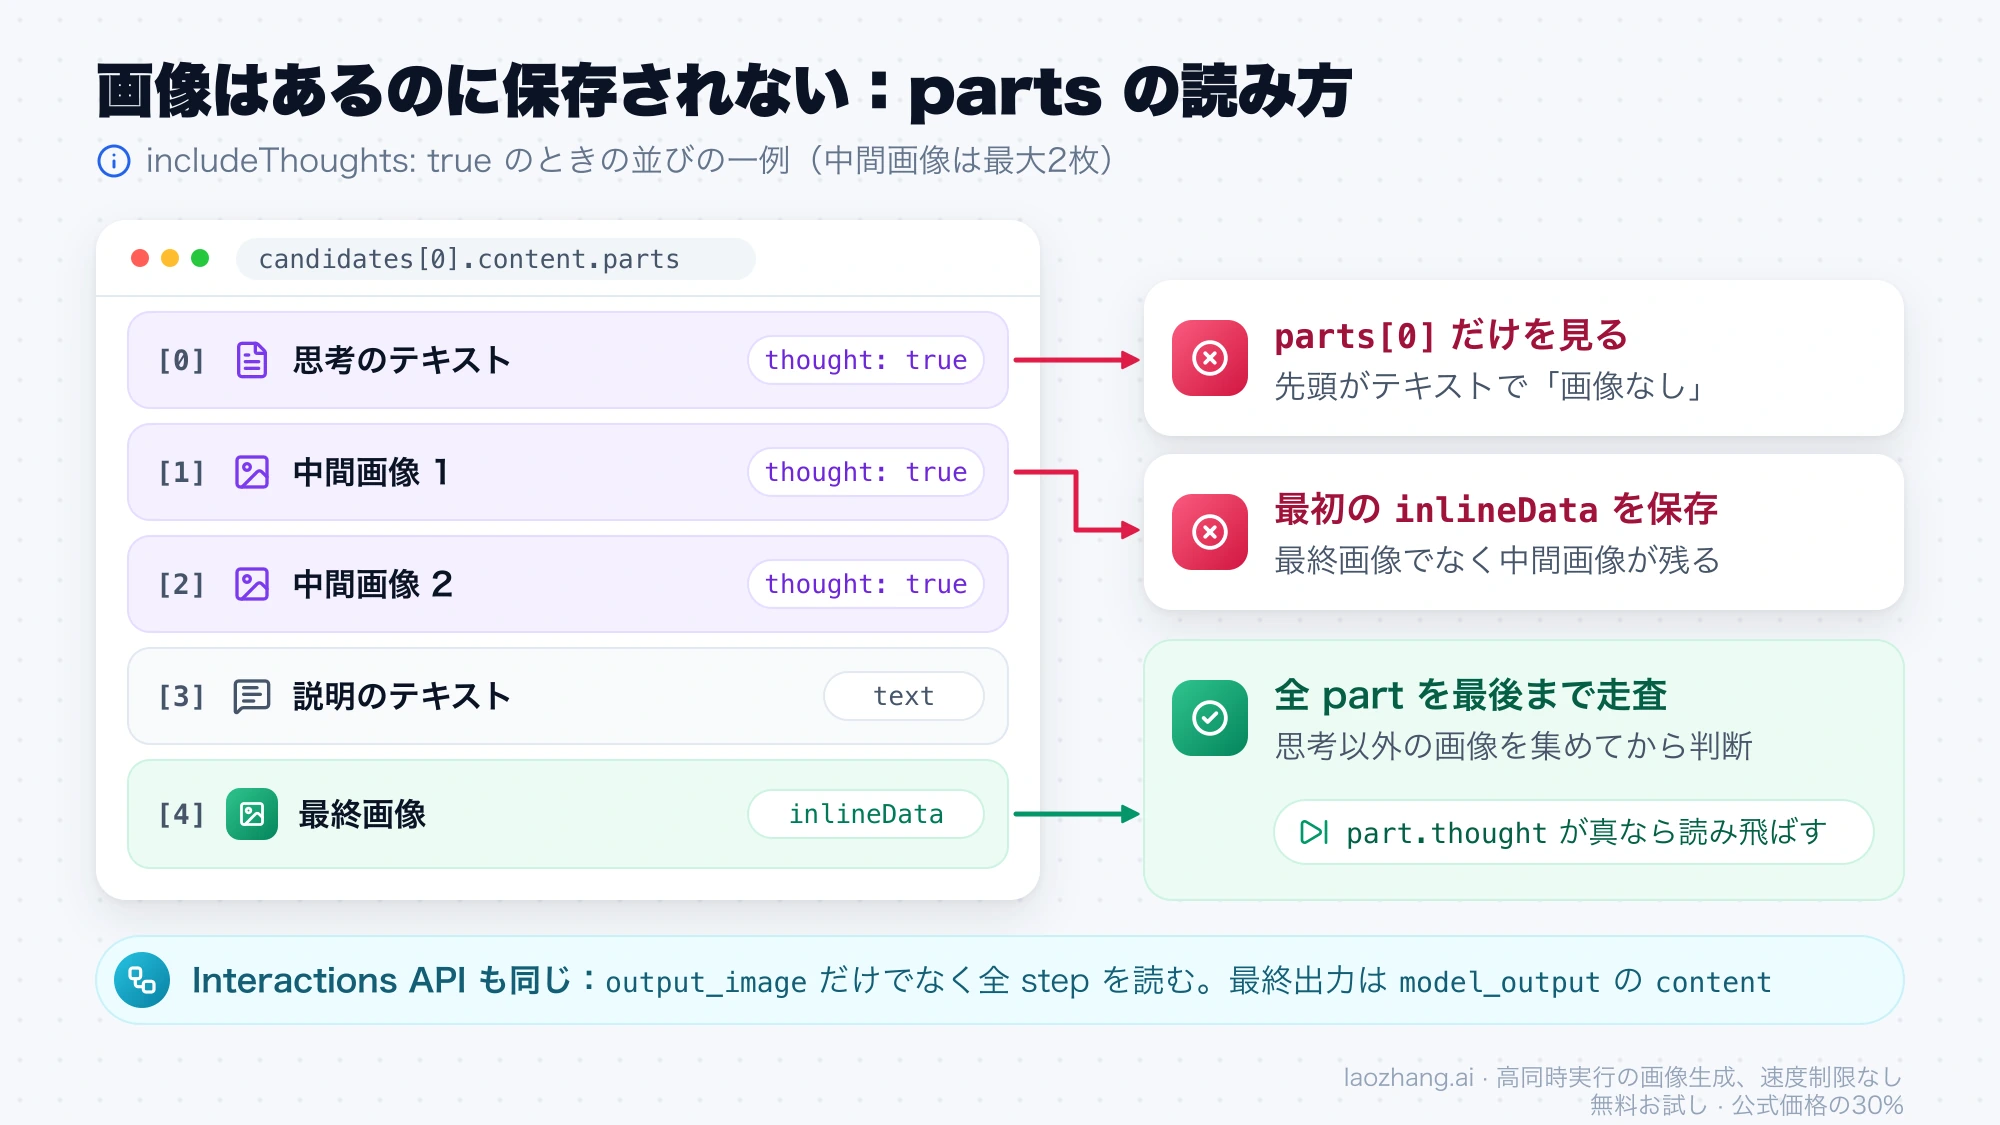
Gemini 3系の画像モデルは思考(Thinking)が常に有効で、APIからは無効にできません。モデルは構図を試すために最大2枚の中間画像を作り、思考の中の最後の画像がそのまま最終画像になります。generateContentでincludeThoughtsをtrueにすると、思考のpartがthought: true付きでレスポンスに入り、その中に中間画像が含まれることがあります。Googleのサンプルはpart.thoughtが真のpartを読み飛ばしてから画像を取り出しています。Google:Thinking process
ドキュメントから推測できる失敗の仕方は3つあります。
- 最初の
inlineDataだけを保存するコードは、最終画像ではなく中間画像を保存する可能性がある parts[0]だけを見るコードは、先頭がテキストのpartだと「画像なし」と判断する- Interactions APIで
output_imageだけを読むコードは、テキストと画像が交互に並ぶ出力(gemini-3-pro-imageのイラスト入りの物語など)の途中の画像を取りこぼす
対策は、全partまたは全stepを最後まで走査し、思考以外の画像をすべて集めてから「画像なし」を判断することです。Interactions APIでは、思考はtype: "thought"のステップのsummaryに、最終的な出力はmodel_outputのステップのcontentに入ります。
保存したJSONを判定する確認スクリプト
ここまでの判定を1つにまとめたのが次のスクリプトです。Python 3の標準ライブラリだけで動き、保存したレスポンスJSON(RESTのcamelCase、SDKダンプのsnake_caseのどちらでも可)を読んで、形、次の一手、usageを表示します。最終画像があれば終了コード0、画像がなければ1、判定できない入力なら2を返すので、バッチ処理やCIのチェックにも組み込めます。
#!/usr/bin/env python3
"""Nano Banana の応答 JSON から「画像が返らない形」を判定する。
使い方: python3 check_nb_response.py response.json
終了コード: 0=最終画像あり / 1=画像なし / 2=読めない入力
"""
import json
import sys

POLICY = {"SAFETY", "PROHIBITED_CONTENT", "BLOCKLIST", "SPII",
          "IMAGE_SAFETY", "IMAGE_PROHIBITED_CONTENT"}
ACTIONS = {
    "IMAGE": "最終画像あり。保存処理を確認する",
    "PROMPT_BLOCKED": "入力の段階でブロック。同じ入力の再送は不可。題材か表現を変える",
    "POLICY": "生成物がポリシーで停止。同じ入力の再送は不可。題材を変える",
    "TEXT_ONLY": "テキストだけ返った。画像を明示的に依頼し、出力形式を画像に絞る",
    "NO_IMAGE": "画像が生成されなかった。依頼を短く明確にしてから再送する",
    "RECITATION": "既存の素材に似すぎて停止。特定作品の再現を依頼から外す",
    "MAX_TOKENS": "出力上限で打ち切り。maxOutputTokensを外すか増やす",
    "MISSING_THOUGHT_SIGNATURE": "複数ターン編集で署名が欠落。履歴に署名を戻す",
    "FAILED": "interactionが失敗。errorsを記録する",
    "NOT_FINISHED": "まだ完了していない。完了後に取得し直す",
    "HTTP_ERROR": "HTTPエラー。429/5xxは待って再試行、4xxはモデルIDと引数を確認",
    "OTHER": "理由が特定されない停止。finishMessageを記録し、1回だけ再試行",
}


def get(d, *keys):
    """camelCase(REST)とsnake_case(SDKのダンプ)の両方を読む"""
    if isinstance(d, dict):
        for k in keys:
            if k in d:
                return d[k]
    return None


def is_image_block(p):
    blob = get(p, "inlineData", "inline_data")
    if blob is not None:
        return str(get(blob, "mimeType", "mime_type") or "").startswith("image/")
    return get(p, "type") == "image"


def check_generate_content(r):
    feedback = get(r, "promptFeedback", "prompt_feedback") or {}
    cands = get(r, "candidates") or []
    info = {"api": "generateContent",
            "usage": get(r, "usageMetadata", "usage_metadata"),
            "modelStatus": get(r, "modelStatus", "model_status")}
    if not cands:
        reason = get(feedback, "blockReason", "block_reason")
        info["detail"] = f"candidatesが空 / blockReason={reason}"
        return ("PROMPT_BLOCKED" if reason else "OTHER"), info
    finals, thoughts, texts, reasons = 0, 0, 0, []
    for c in cands:
        reasons.append(get(c, "finishReason", "finish_reason"))
        for p in get(get(c, "content") or {}, "parts") or []:
            if is_image_block(p):
                if get(p, "thought"):
                    thoughts += 1
                else:
                    finals += 1
            elif get(p, "text"):
                texts += 1
        if get(c, "finishMessage", "finish_message"):
            info["finishMessage"] = get(c, "finishMessage", "finish_message")
    info["detail"] = (f"finishReason={reasons} 最終画像={finals} "
                      f"思考中の画像={thoughts} テキスト={texts}")
    if thoughts and not finals:
        info["note"] = "思考中の画像だけで、最終画像ではない"
    if finals:
        return "IMAGE", info
    fr = str(reasons[0])
    if fr in POLICY:
        return "POLICY", info
    if fr in ("RECITATION", "IMAGE_RECITATION"):
        return "RECITATION", info
    if fr in ("STOP", "NO_IMAGE", "MAX_TOKENS", "MISSING_THOUGHT_SIGNATURE"):
        return ("TEXT_ONLY" if fr == "STOP" else fr), info
    return "OTHER", info


def check_interaction(r):
    status = get(r, "status")
    info = {"api": "Interactions", "usage": get(r, "usage"),
            "errors": get(r, "errors")}
    finals, thoughts, texts = 0, 0, 0
    for step in get(r, "steps") or []:
        if get(step, "type") == "model_output":
            for block in get(step, "content") or []:
                if is_image_block(block):
                    finals += 1
                elif get(block, "type") == "text":
                    texts += 1
        elif get(step, "type") == "thought":
            thoughts += sum(is_image_block(b) for b in get(step, "summary") or [])
    for block in get(r, "outputs") or []:  # 古いSDKの型は steps でなく outputs
        if is_image_block(block):
            finals += 1
        elif get(block, "type") == "text":
            texts += 1
    info["detail"] = (f"status={status} 最終画像={finals} "
                      f"思考中の画像={thoughts} テキスト={texts}")
    if thoughts and not finals:
        info["note"] = "思考中の画像だけで、最終画像ではない"
    if status in ("in_progress", "queued", "requires_action"):
        return "NOT_FINISHED", info
    if finals:
        return "IMAGE", info
    if status in ("failed", "cancelled"):
        return "FAILED", info
    if status == "incomplete":
        return "MAX_TOKENS", info
    return "TEXT_ONLY", info


def check(r):
    if not isinstance(r, dict):
        return None, {}
    if "error" in r:
        e = r["error"]
        return "HTTP_ERROR", {"api": "?", "detail": f"{get(e, 'code')} {get(e, 'status')}"}
    if "candidates" in r or get(r, "promptFeedback", "prompt_feedback") is not None:
        return check_generate_content(r)
    if "status" in r:
        return check_interaction(r)
    return None, {}


def main(path):
    with open(path, encoding="utf-8") as f:
        verdict, info = check(json.load(f))
    if verdict is None:
        print("判定できない形式です。生のレスポンス本文を保存してください")
        return 2
    print(f"[{verdict}] {info.pop('api')}: {info.pop('detail')}")
    print(f"  次の対処: {ACTIONS[verdict]}")
    for key, value in info.items():
        if value:
            print(f"  {key}: {json.dumps(value, ensure_ascii=False)}")
    return 0 if verdict == "IMAGE" else 1


if __name__ == "__main__":
sys.exit(main(sys.argv[1]))IMAGE_SAFETYで止まった応答を模したJSONを渡すと、次のように表示されます(usageの数字はテスト用に作った値で、実際の応答ではありません)。
$ python3 check_nb_response.py gc_image_safety.json
[POLICY] generateContent: finishReason=['IMAGE_SAFETY'] 最終画像=0 思考中の画像=0 テキスト=0
  次の対処: 生成物がポリシーで停止。同じ入力の再送は不可。題材を変える
  usage: {"promptTokenCount": 15, "thoughtsTokenCount": 310, "totalTokenCount": 325}
  finishMessage: "(fixture)"
動作確認は、APIリファレンスのフィールド名に合わせて手作りしたJSON 24件によるオフラインテストです。内訳はgenerateContentの各形12件、Interactions APIの各形7件、google-genai 1.65.0のmodel_dump_jsonで書き出したsnake_case版3件、HTTPエラー1件、無関係なJSON 1件で、Python 3.12で24件すべてが期待どおりの判定と終了コードになりました。実際のGoogleのレスポンスによる確認はまだないため、実環境では自分のresponse.jsonを1件通し、表示と中身が合っているかを最初に見てください。
失敗した呼び出しの料金はusageで確かめる
画像が返らなかった呼び出しがいくら課金されるのか、Googleは規則を公表していません。公表されているのはモダリティ別のトークン単価で、2026年9月24日時点の有料ティア(Standard)は次のとおりです。どちらのモデルも、無料ティアでは使えません。Google:Gemini API pricing
| 100万トークンあたり | Nano Banana 2(gemini-3.1-flash-image) | Nano Banana Pro(gemini-3-pro-image) |
|---|---|---|
| 入力(テキスト・画像) | $0.50 | $2.00 |
| 出力(テキスト・思考) | $3 | $12 |
| 出力(画像) | $60 | $120 |
| 画像1枚の目安 | 0.5K $0.045、1K $0.067、2K $0.101、4K $0.151 | 1K・2K $0.134、4K $0.24 |
思考のトークンはincludeThoughtsの設定に関係なく課金され、思考中の中間画像は課金されないとGoogleは説明しています。失敗した呼び出しの費用を見積もるときは、推測ではなくその呼び出しのusageを読みます。
- generateContent:
usageMetadataのpromptTokenCount(入力)、thoughtsTokenCount(思考)、candidatesTokenCount(出力)、candidatesTokensDetails(出力のモダリティ別内訳) - Interactions API:
usageのtotal_input_tokens、total_thought_tokens、total_output_tokens、output_tokens_by_modality
Nano Banana 2の場合、目安は「入力トークン×$0.50+テキストと思考のトークン×$3+画像トークン×$60」を100万で割った額です。1Kの画像は1,120トークンを消費するとされているので、1,120×$60÷1,000,000=約$0.067となり、単価表の値と一致します。出力のモダリティ別内訳に画像のトークンがなければ、画像の出力単価はかかっていないと読めます。ただし、ブロックされた応答にこの計算がそのまま当てはまるという公式の説明はないので、確定額は請求画面で確かめてください。失敗が多いなら、まず前半の表で形を分け、再送しても変わらない失敗への再送を止めるのが、無駄を減らす近道です。
よくある質問
AI Studioで画像が表示されないときも同じ考え方でよいですか
はい。AI Studioで選べるNano Bananaのモデルも、上の表と同じIDです。選択中のモデルが停止済みのプレビュー版でないかを確認し、同じプロンプトをAPIで送ってレスポンスを保存すると、どの形で止まっているかが分かります。安全設定はRun settingsの「Advanced settings」内にありますが、ポリシーによる停止を解除するものではありません。
日本語のプロンプトだと画像が出にくいのですか
Googleの推奨言語には日本語(ja-JP)が含まれています。日本語だとテキストで返されやすいという体験談はありますが、公式に確認された挙動ではありません。テキストだけ返る場合は、画像を作る指示を文頭に置き、出力形式を画像に絞ってから、英語の指示と比べてみるのが手軽な切り分けです。
以前は動いていたコードが画像を返さなくなりました
モデルIDの末尾に-previewが付いていれば、2026年6月25日までに停止しています。gemini-3.1-flash-imageやgemini-3-pro-imageに変え、SDKをgoogle-genaiの新しい版に更新してください。gemini-2.5-flash-imageを使っている場合は、2026年10月2日の停止前に移行が必要です。
公式ドキュメント
リクエストパラメータ、料金、課金ルールは LaoZhang API の開発者ドキュメントを参照してください:画像生成の課金と失敗処理。
注記:laozhang.ai は当ブログ運営チームの自社サービスです。その料金は中立的な比較ではなく、自社の提示価格です。
参考資料11
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年9月24日。
参考資料11
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年9月24日。
- 1.Google:Nano Banana image generationai.google.dev/gemini-api/docs/image-generation
- 2.Google:Interactions API overviewai.google.dev/gemini-api/docs/interactions-overview
- 3.FinishReasonリファレンスai.google.dev/api/generate-content
- 4.Google:Interactions API referenceai.google.dev/api/interactions
- 5.Google:Troubleshooting guideai.google.dev/gemini-api/docs/troubleshooting
- 6.Google:Safety settingsai.google.dev/gemini-api/docs/safety-settings
- 7.生成AIの使用禁止に関するポリシーpolicies.google.com/terms/generative-ai/use-policy
- 8.Googleのモデル廃止スケジュールai.google.dev/gemini-api/docs/deprecations
- 9.変更履歴ai.google.dev/gemini-api/docs/changelog
- 10.Google:Thinking processai.google.dev/gemini-api/docs/generate-content/image-generation
- 11.Google:Gemini API pricingai.google.dev/gemini-api/docs/pricing