KiroでGPT-5.6を使う:クレジット倍率とモデルの比較手順
KiroのGPT-5.6は、有料プランから選べる内蔵モデルです。2026年8月30日時点のクレジット倍率と処理地域を確認し、実際の仕事を完了するまでの費用と修正時間で選びます。
目次
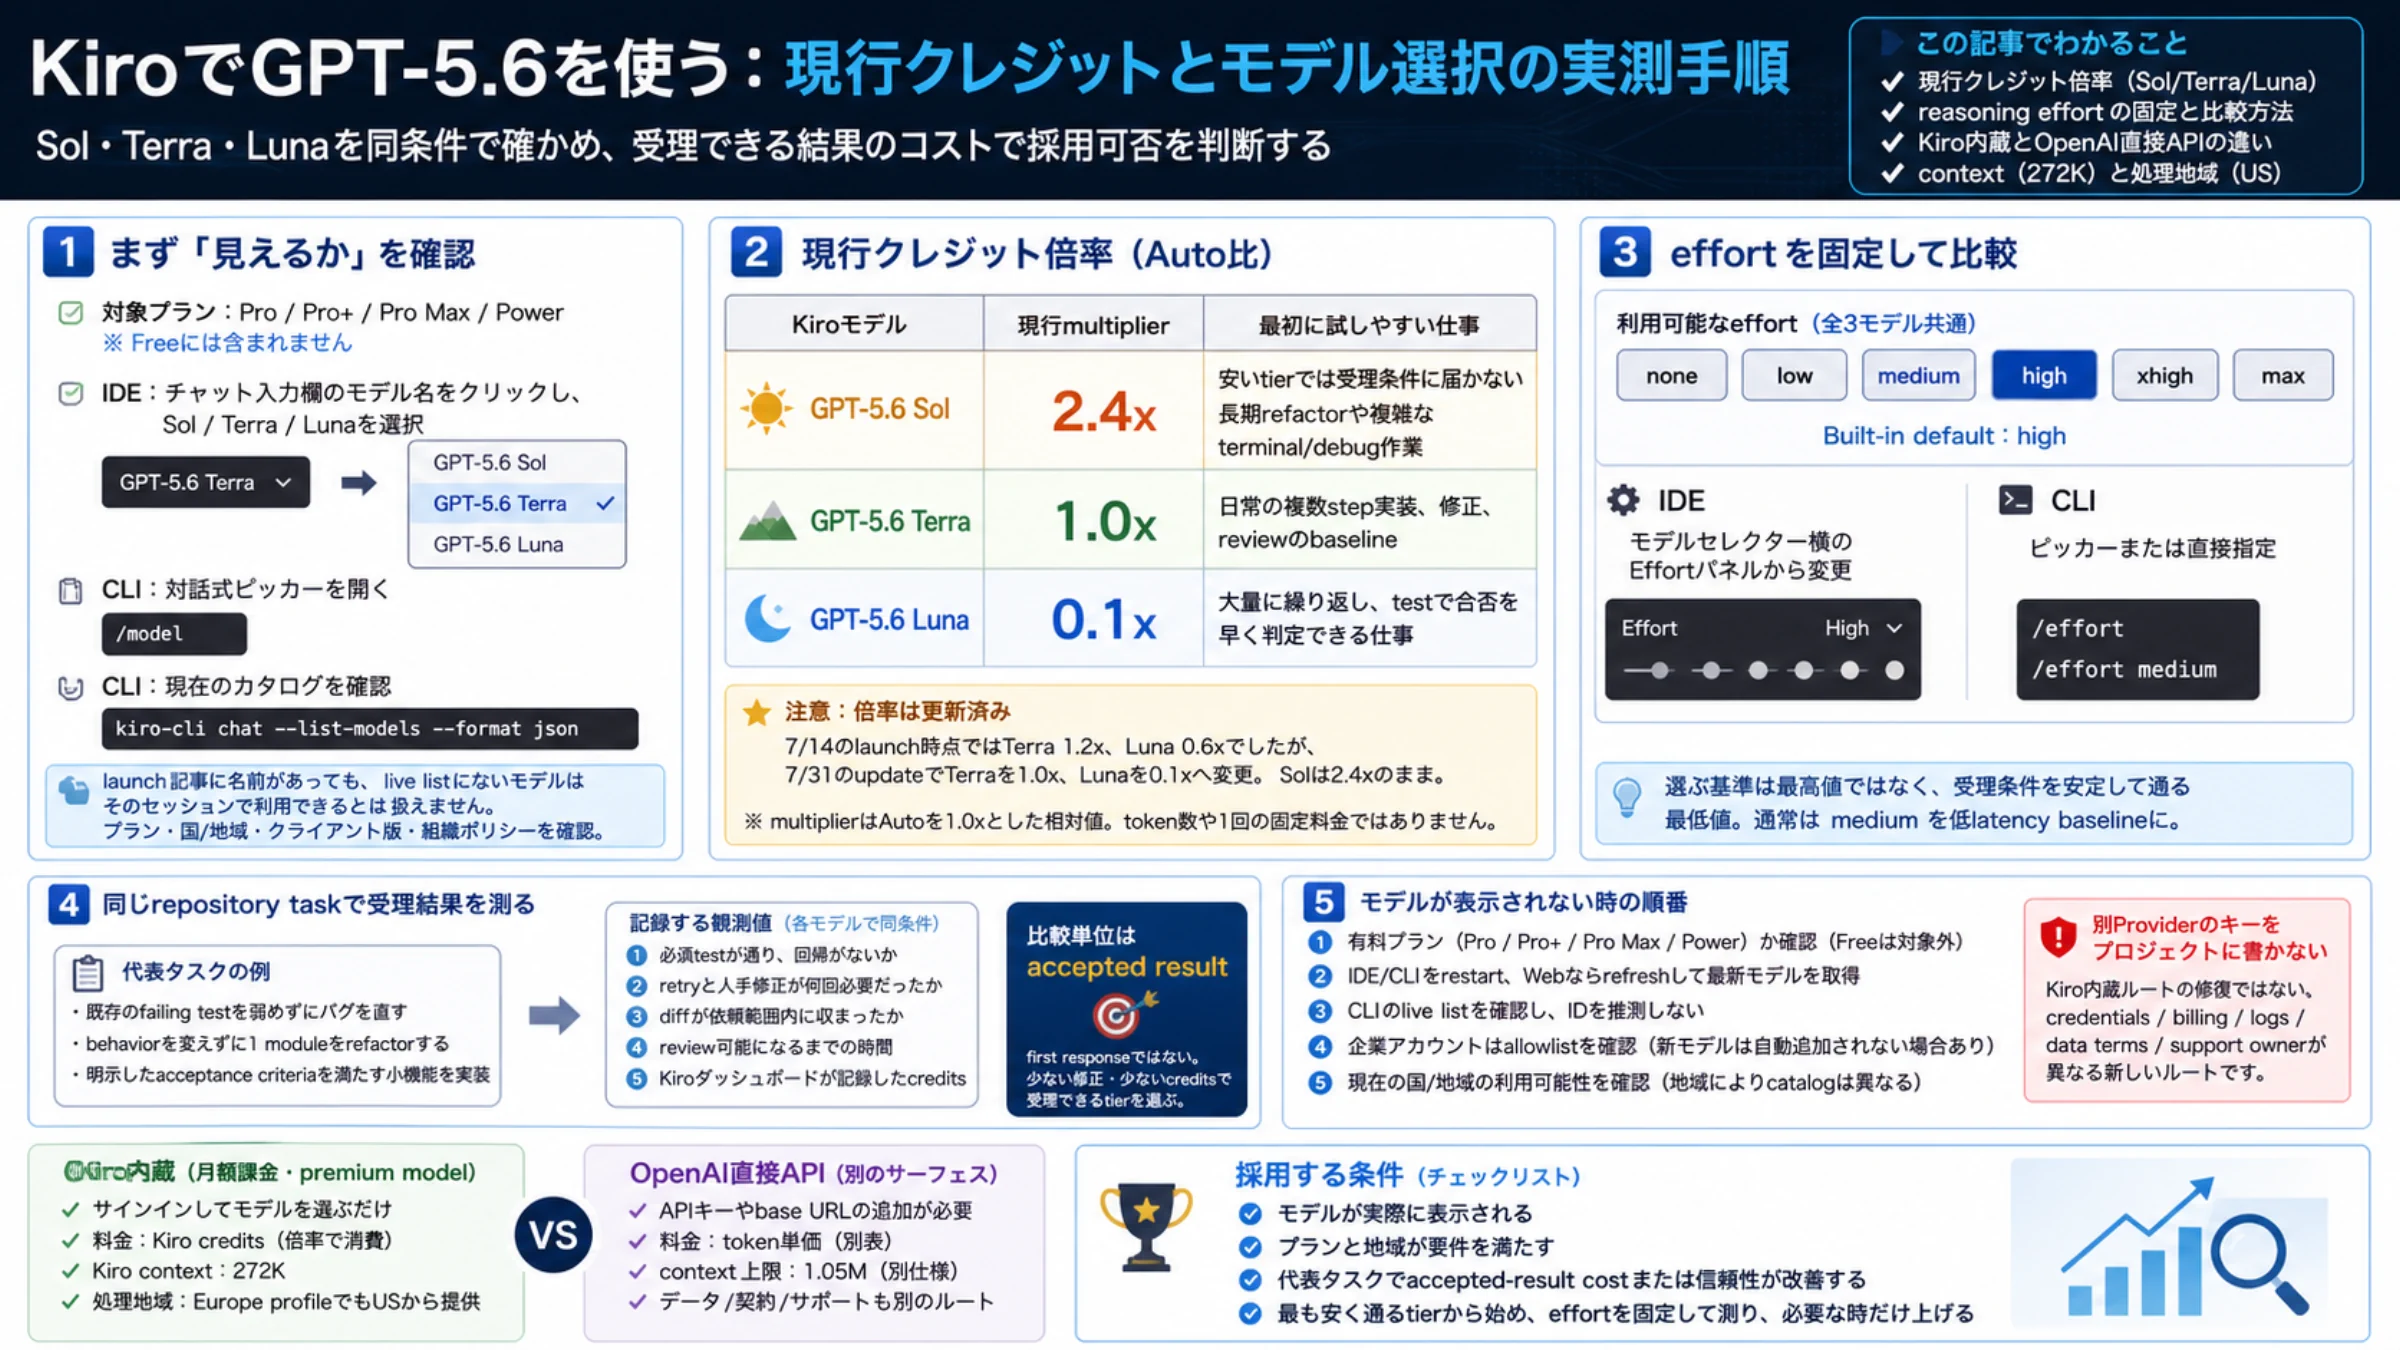
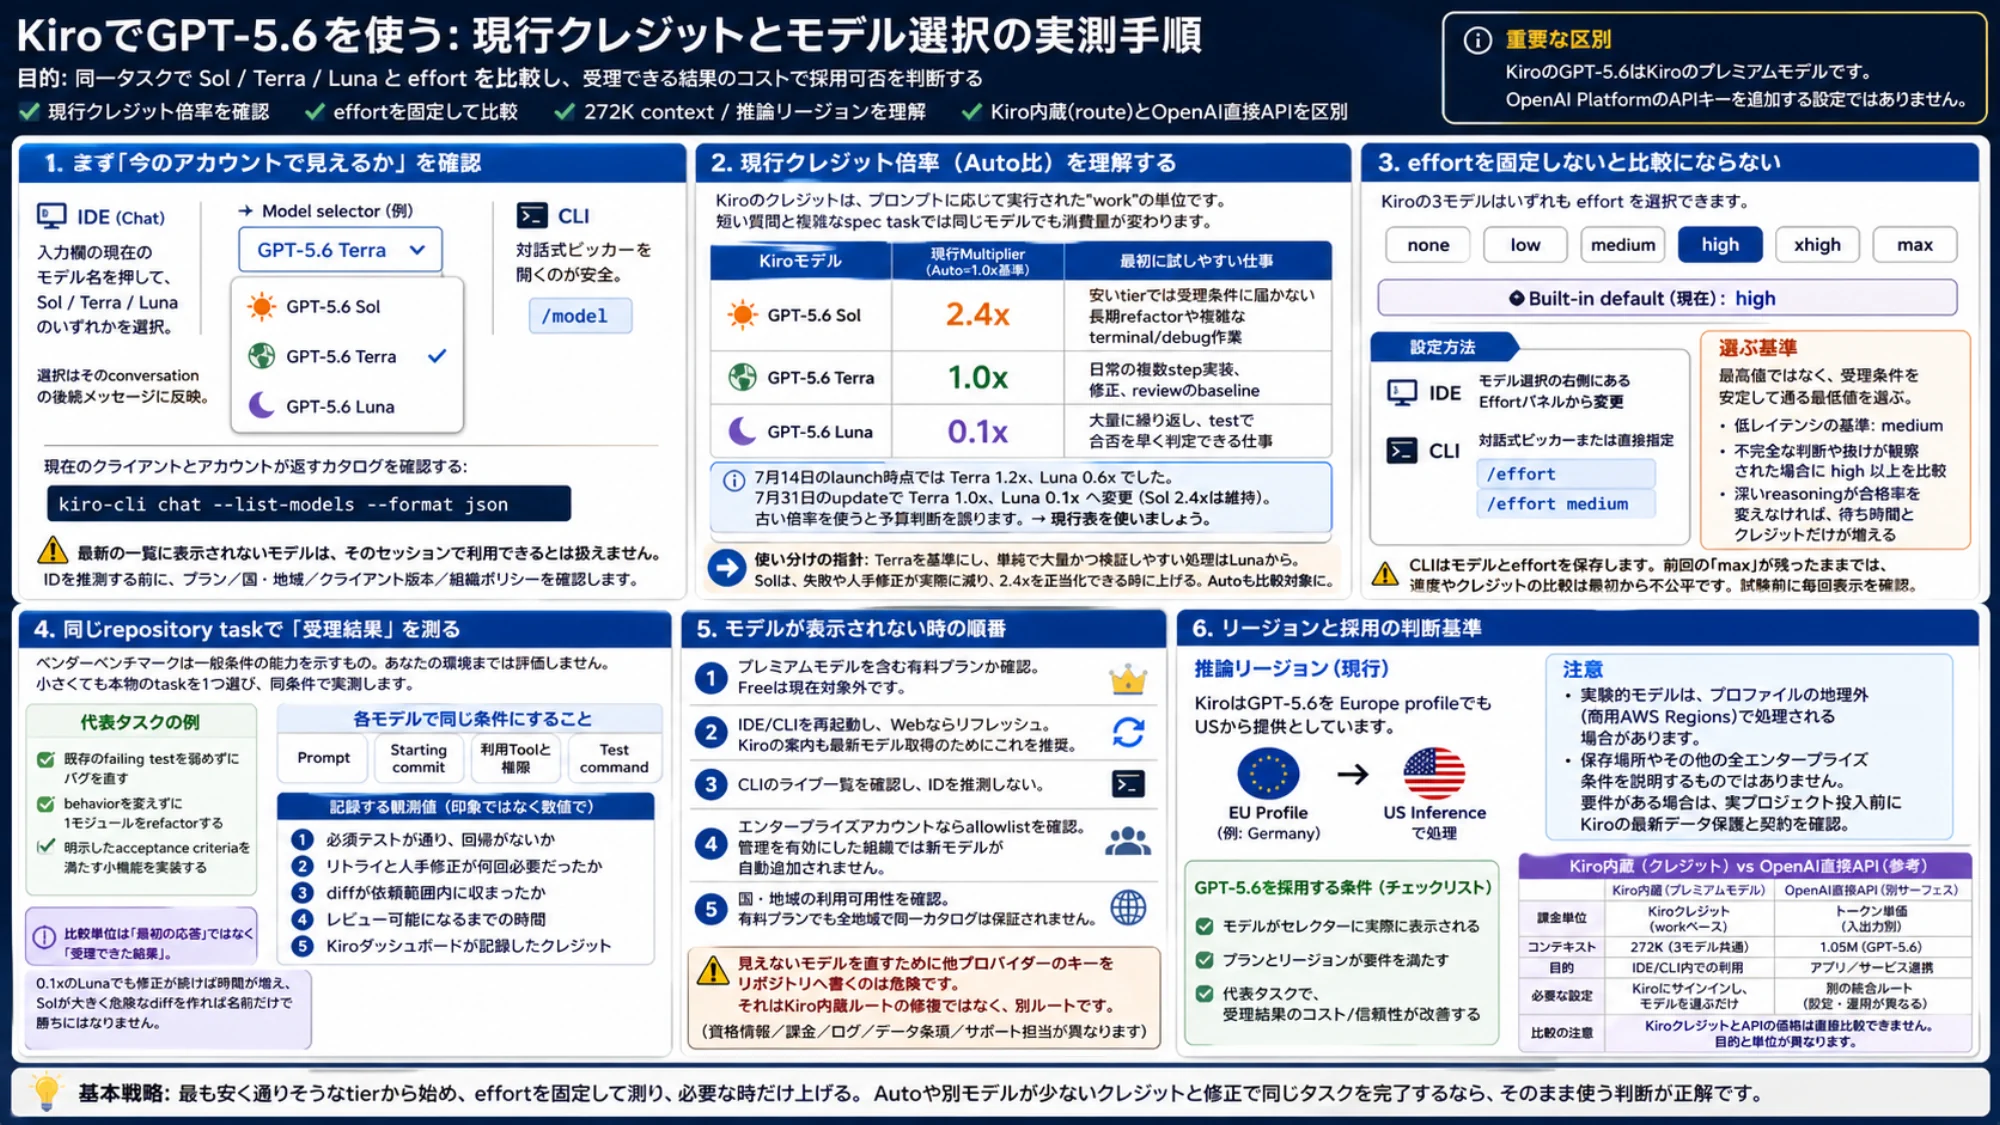
KiroではGPT-5.6 Sol、Terra、Lunaを内蔵モデルとして選べます。利用するにはKiroにサインインし、プレミアムモデルに対応したプランでモデル選択欄を切り替えます。OpenAI PlatformのAPIキーやベースURLをプロジェクトに追加する必要はありません。
KiroとOpenAIの直接APIでは、料金や扱える文脈の長さが異なります。Kiroはクレジットで利用量を測り、3モデルのコンテキスト長を272Kとしています。OpenAIの直接APIに記載されたトークン単価や1.05Mのコンテキスト長を、そのままKiroへ当てはめることはできません。
最初に「今のアカウントで見えるか」を確認する
Kiroの現行モデル一覧では、GPT-5.6はPro、Pro+、Pro Max、Powerで利用でき、Freeには含まれていません。
IDEではチャット入力欄にある現在のモデル名を押し、Sol、Terra、Lunaのいずれかを選びます。選択はその会話の後続メッセージへ反映されます。CLIではまず対話式の選択画面を開くのが安全です。
/model現在のクライアントとアカウントが返すモデル一覧を確認するなら、次のコマンドを使えます。
kiro-cli chat --list-models --format json発表記事に名前があっても、現在の一覧にないモデルをそのセッションで使えるとは判断できません。IDを推測せず、プラン、国・地域、クライアントのバージョン、組織の利用方針を確認します。
7月の記事に残る倍率は現在値ではない
Kiroのクレジットは、依頼に応じて実行した処理量を表します。同じモデルでも、短い質問と複雑な仕様に沿った実装では消費量が異なります。倍率はAutoを1.0xとした相対値で、トークン数や1回の固定料金ではありません。
| Kiroのモデル | 確認時点の倍率 | 最初に試しやすい仕事 |
|---|---|---|
| GPT-5.6 Luna | 0.1x | 大量に繰り返し、テストで合否を早く判定できる仕事 |
| GPT-5.6 Terra | 1.0x | 複数の手順を伴う日常の実装、修正、レビュー |
| GPT-5.6 Sol | 2.4x | 低価格なモデルでは要求を満たせない大規模リファクタリングや複雑なデバッグ |
7月14日の公開時点ではTerra 1.2x、Luna 0.6xでした。しかしKiroは7月31日の更新でTerraを1.0x、Lunaを0.1xへ変更し、Solは2.4xのままとしています。日本語の初期検証記事に旧値が残っていても、予算には現行表を使います。
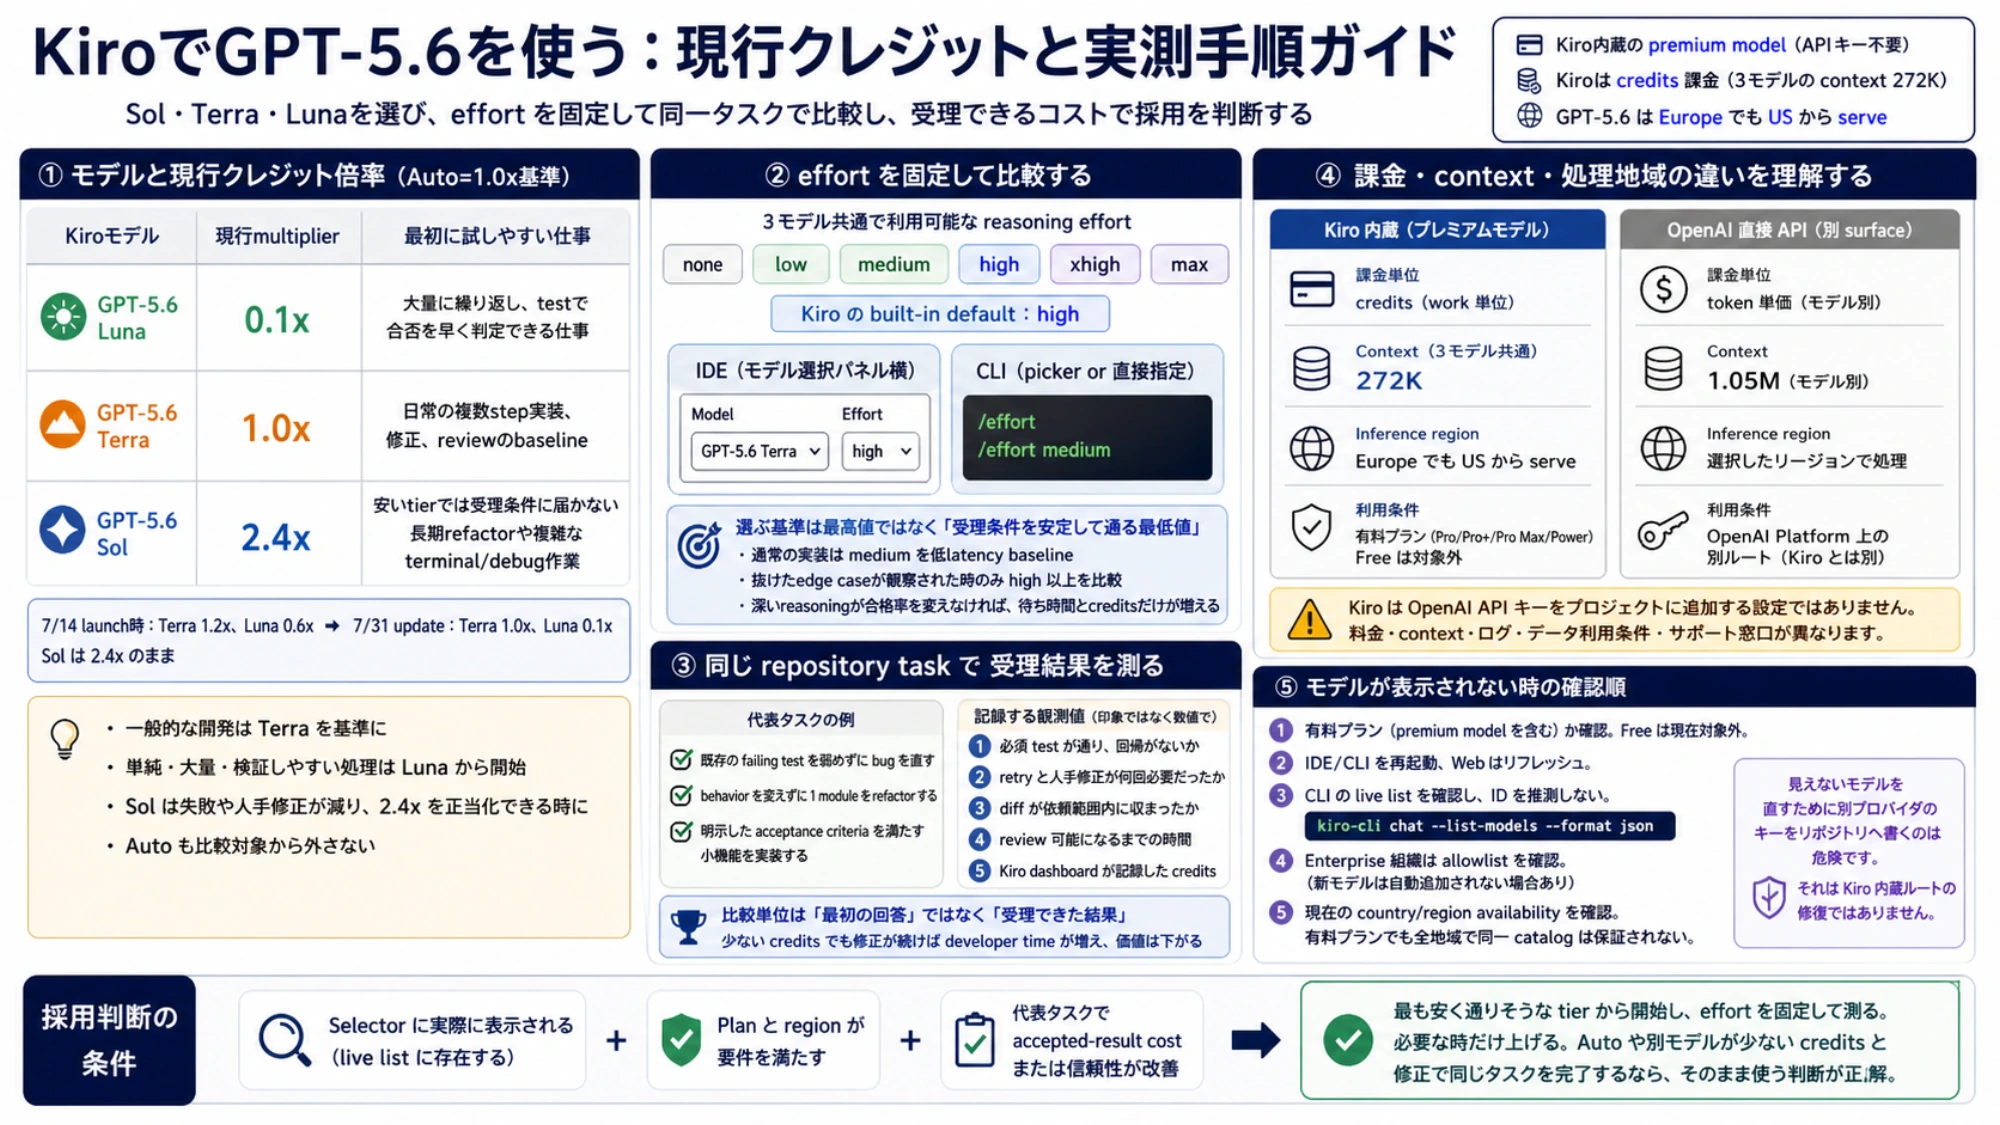
一般的な開発ならTerraを基準にし、単純で大量かつ検証しやすい処理はLunaから始められます。Solへ上げるのは、失敗や手作業による修正が実際に減り、2.4xを正当化できる時です。Autoも比較対象から外しません。
OpenAI直接APIのトークン単価を比較したい場合は、別の GPT-5.6 Sol・Terra・Luna API選択ガイド を使ってください。その価格表でKiroのクレジットを計算することはできません。
推論の強度を固定しないと比較にならない
Kiroの推論の強度に関する文書によると、3モデルはいずれも none、low、medium、high、xhigh、max を受け付けます。Kiroが示す既定値は現在 high です。
IDEではモデル選択欄横のEffortパネルから変更します。CLIでは選択画面か直接指定を使います。
/effort
/effort mediumCLIはモデルと推論の強度を保存します。前回のmaxが残っていると、他のモデルとの比較条件がそろいません。試験前に毎回表示を確認します。
選ぶ基準は最高値ではなく、完了条件を安定して満たせる最も低い値です。通常の実装では、まずmediumを待ち時間を抑えた比較の基準にできます。例外ケースの見落としや不十分な判断があれば、high以上で改善するかを試します。推論の強度を上げても要求を満たす割合が変わらないなら、追加の待ち時間やクレジット消費に見合うかを見直します。
同じ開発課題で結果を比べる
提供元のベンチマークは、公開された条件での能力を示します。自社コードの開始状態、ツール権限、既存テスト、完了条件は含まれないため、小さくても実際の開発課題で試してください。
- 既存の失敗しているテストを弱めずに不具合を直す
- 動作を変えずに一つのモジュールをリファクタリングする
- 明示した完了条件を満たす小機能を実装する
各モデルで指示、コミット、利用ツール、テストコマンドを同じにします。記録するのは印象ではなく、次の観測値です。
- 必須テストが通り、回帰がないか
- 再試行と手作業による修正が何回必要だったか
- 差分が依頼範囲内に収まったか
- レビュー可能になるまでの時間
- Kiroの管理画面が記録したクレジット
比べるのは最初の返答ではなく、使える結果を得るまでの全体です。倍率0.1xのLunaでも修正が続けば開発者の時間が増えます。Solで変更範囲が広がりすぎたり危険な差分が生じたりするなら、上位モデルというだけでは採用理由になりません。
モデルが表示されない時の順番
- プレミアムモデルを含む有料プランか確認する。Freeは現在対象外です。
- IDE/CLIを再起動し、Webなら再読み込みする。Kiroの公開案内も最新モデル取得のためにこの操作を勧めています。
- CLIの現在のモデル一覧を確認し、IDを推測しない。
- 企業アカウントなら許可リストを確認する。Kiroのモデル管理では、管理を有効にした組織に新モデルが自動追加されないと説明されています。
- 現在の国・地域ごとの提供状況を確認する。有料プランでも、地域が違えば同じモデル一覧になるとは限りません。
モデルが表示されない原因を調べるために、別の提供元のキーをリポジトリへ書き込まないでください。外部APIの導入は、Kiro内蔵モデルとは認証、請求、ログ、データの扱い、問い合わせ先が変わる別の構成です。
Europeプロファイルでも推論は米国で処理される
Kiroの推論処理地域の一覧では、GPT-5.6はEuropeプロファイルでも米国から提供すると記載されています。また、実験的モデルは、プロファイルで選んだ地域外の商用AWSリージョンで処理される場合があると案内されています。
この表だけではデータの保存場所や企業向け契約の全条件は分かりませんが、Europeプロファイルなら必ず欧州で推論されるとは言えません。コード、指示、ログに地域要件がある場合は、実際のプロジェクトを渡す前に、Kiroのデータ保護に関する案内と契約を確認してください。
GPT-5.6は、選択欄に表示され、プランと処理地域が要件を満たし、代表的な仕事で費用や信頼性が改善する場合に採用します。まず低価格な候補を同じ推論設定で比べ、要求を満たさない場合に上位モデルを試してください。Autoや別モデルで同じ仕事を少ないクレジットと手直しで完了できるなら、切り替える必要はありません。