Seedream 5.0 Pro API: separar una imagen en capas y sacar un PSD
Con layer_decomposition: true el endpoint de imágenes devuelve una imagen base y hasta 16 capas PNG; pagas por cada imagen devuelta, base incluida.
En esta página
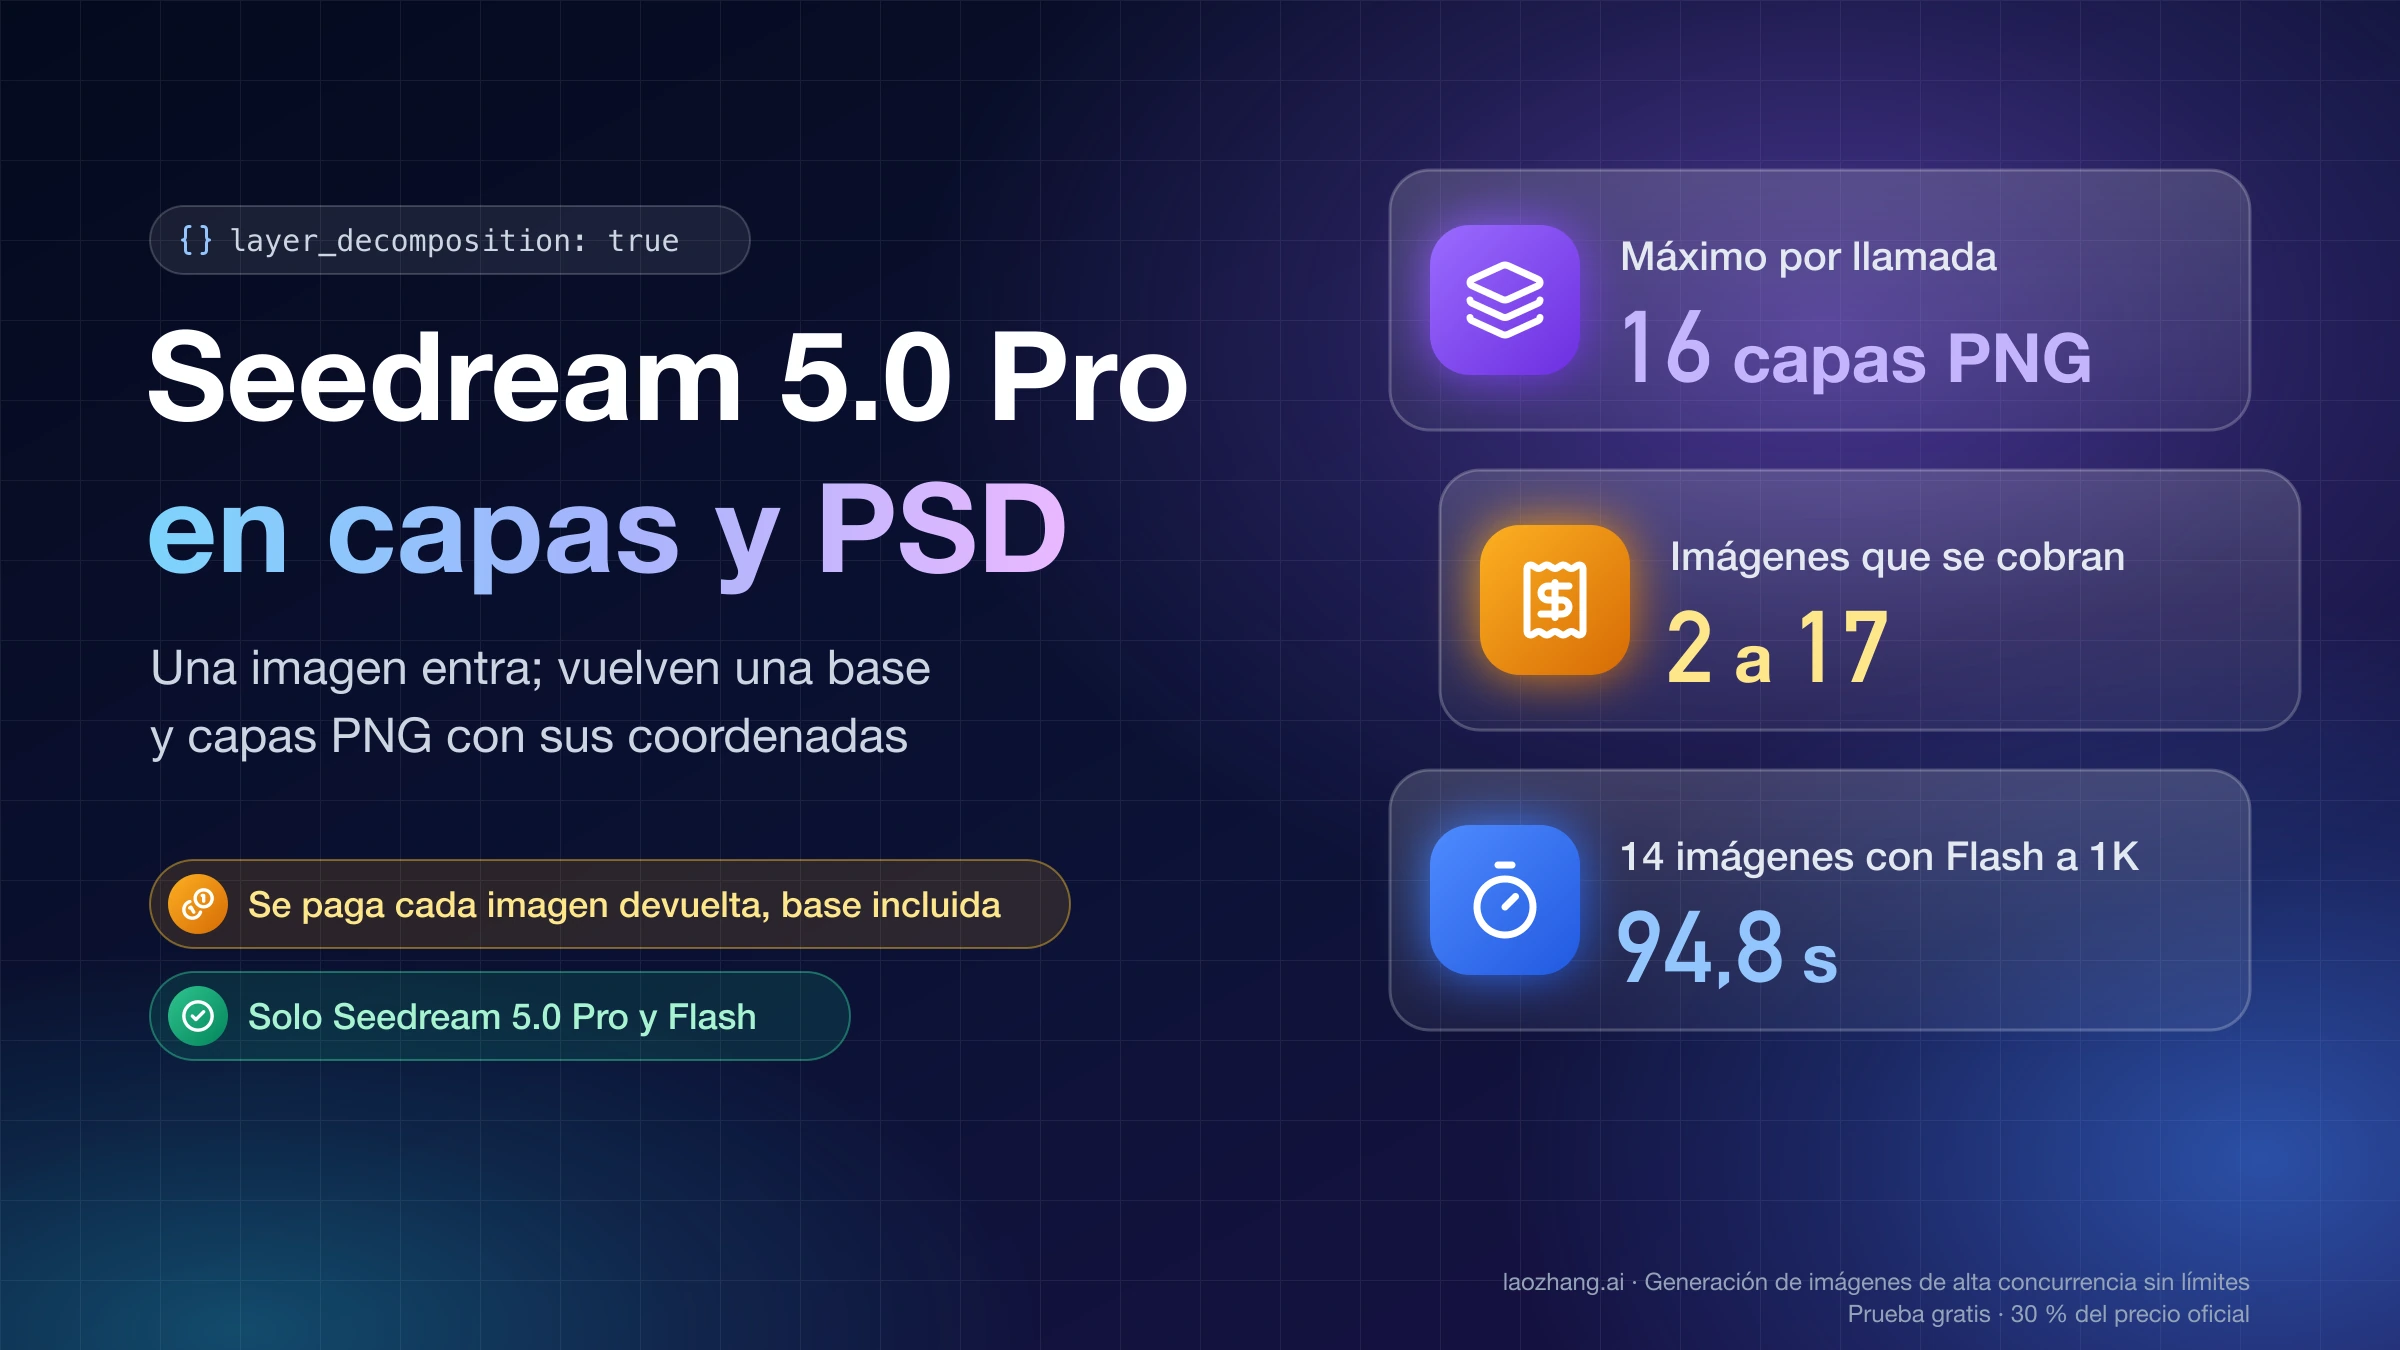
La separación en capas (layer decomposition) de Seedream 5.0 no es un modelo aparte: es el endpoint de generación de imágenes de siempre con "layer_decomposition": true. Le envías una sola imagen PNG o JPEG y devuelve una imagen base (el fondo, con los huecos repintados) más un máximo de 16 capas PNG con canal alfa, cada una con su nombre, su orden de apilado y sus coordenadas. Solo lo admiten Seedream 5.0 Pro y Seedream 5.0 Flash, y se paga por cada imagen devuelta, base incluida, así que la factura depende de un número que tú no fijas.
Lo que sigue se apoya en tres llamadas reales del 2 de octubre de 2026, todas a 1K y a través de api.laozhang.ai, con la imagen de ejemplo de la documentación de BytePlus: Flash devolvió 14 imágenes en 94,8 s, Pro devolvió 14 en 110,6 s y Flash con un prompt que nombraba dos elementos devolvió 3 en 34,8 s. El script de Python que convierte la respuesta en un PSD también se ejecutó sobre esas tres respuestas. No se llamó a BytePlus directamente ni se probaron 1.5K, 2K o auto, las etiquetas bbox, carteles con mucho texto o las respuestas de error, y el PSD no se abrió en Photoshop: en esos puntos lo que leerás es lo que dice la documentación, citada del original en inglés porque BytePlus no la publica en español.
Qué se ejecutó y qué no: tres llamadas a 1K y un script de PSD
La imagen de entrada fue la misma en las tres llamadas: layer_auto.png, el ejemplo público del tutorial de BytePlus, una ilustración 3D sin texto de 2784 × 3441 px y 9,9 MB. Es una sola muestra por configuración, de modo que las cifras describen esta imagen y no una tasa general.
| Llamada | Modelo | Prompt | HTTP | Tiempo | Imágenes devueltas | Coste según tarifa publicada |
|---|---|---|---|---|---|---|
| 1 | seedream-5-0-flash-260915 | ninguno | 200 | 94,8 s | 14 (base + 13 capas) | 14 × 0,018 $ = 0,252 $ |
| 2 | seedream-5-0-pro-260628 | ninguno | 200 | 110,6 s | 14 (base + 13 capas) | 14 × 0,12 $ = 1,68 $ |
| 3 | seedream-5-0-flash-260915 | dos elementos nombrados | 200 | 34,8 s | 3 (base + 2 capas) | 3 × 0,018 $ = 0,054 $ |
El coste es el precio por imagen publicado por LaoZhang multiplicado por usage.generated_images; el registro de consumo de la consola no se consultó. En las tres respuestas la imagen base midió 880 × 1088 px en JPEG y las capas llegaron en PNG.
Quedó sin ejecutar: la ruta directa de BytePlus ModelArk, los tamaños 1.5K, 2K y auto, la selección por etiquetas bbox, la entrada en Base64, la salida b64_json, una imagen con texto, los casos de error (un WebP, dos imágenes, una imagen demasiado pequeña) y los límites de frecuencia. El PSD se reabrió con la biblioteca psd-tools, no con Photoshop, Photopea ni GIMP.
La petición: layer_decomposition en true y una sola imagen
Basta un POST al endpoint de imágenes con el modelo, la imagen y layer_decomposition en true. Este es el cuerpo que se envió en la primera llamada:
{
  "model": "seedream-5-0-flash-260915",
  "image": "https://arkdocs-en.tos-ap-southeast-1.volces.com/images/image-generation/layer_auto.png",
  "layer_decomposition": true,
  "size": "1K",
  "response_format": "url",
  "watermark": false
}
La llamada se hizo con requests y un tiempo de espera de 420 s. El fragmento siguiente es esa misma llamada, con dos cambios respecto a lo ejecutado: lee la clave de una variable de entorno en lugar de un archivo local y guarda la respuesta sin envolver en response.json, que es lo que espera el script de PSD de más abajo.
import json
import os
import time

import requests

body = {
    "model": "seedream-5-0-flash-260915",
    "image": "https://arkdocs-en.tos-ap-southeast-1.volces.com/images/image-generation/layer_auto.png",
    "layer_decomposition": True,
    "size": "1K",
    "response_format": "url",
    "watermark": False,
}

start = time.time()
resp = requests.post(
    "https://api.laozhang.ai/v1/images/generations",
    headers={"Authorization": f"Bearer {os.environ['LAOZHANG_API_KEY']}"},
    json=body,
    timeout=420,
)
print("HTTP", resp.status_code, round(time.time() - start, 1), "s")
data = resp.json()
print(data.get("usage"))
with open("response.json", "w") as f:
    json.dump(data, f, indent=2, ensure_ascii=False)
En BytePlus ModelArk cambian la URL, la clave y el identificador del modelo, que lleva el prefijo dola-. Este es el cURL del tutorial oficial de Seedream 5.0 Pro, que no se ejecutó en la prueba:
curl https://ark.ap-southeast.bytepluses.com/api/v3/images/generations \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $ARK_API_KEY" \
  -d '{
    "model": "dola-seedream-5-0-pro-260628",
    "image": "https://arkdocs-en.tos-ap-southeast-1.volces.com/images/image-generation/layer_auto.png",
    "size": "2K",
    "layer_decomposition": true,
    "watermark": false
  }'
Los parámetros que cambian el resultado, según la referencia de la API de BytePlus a 2 de octubre de 2026:
| Parámetro | Valores en modo capas | Qué conviene saber |
|---|---|---|
model | Seedream 5.0 Pro o 5.0 Flash | BytePlus: dola-seedream-5-0-pro-260628, dola-seedream-5-0-flash-260915. LaoZhang: los mismos sin dola-. |
image | una URL accesible o un Base64 | Exactamente una imagen; con varias la petición da error. El Base64 va como data:image/png;base64,... con el formato en minúsculas. |
prompt | opcional | Sin él, el modelo decide qué elementos separar. |
size | 1K, 1.5K, 2K, auto | Por defecto auto. No admite ancho × alto explícito; la base conserva la proporción de la entrada. |
output_format | jpeg (por defecto) o png | Solo afecta a la imagen base; las capas son siempre PNG. |
response_format | url (por defecto) o b64_json | Las URL caducan a las 24 horas. |
watermark | true por defecto | Añade la marca «AI-generated» en la esquina inferior derecha; para recursos de diseño, envía false. |
Con auto, una entrada de entre 921.600 y 4.624.220 píxeles sale a su mismo tamaño; una menor sale a 1K y una mayor, a 2K. En la prueba, 1K sobre una entrada de 2784 × 3441 px dio una base de 880 × 1088 px, con la proporción intacta.
La imagen de entrada tiene que ser PNG o JPEG (la generación normal acepta también WebP, BMP, TIFF, GIF y HEIC, pero el modo capas no), tener entre 262.144 píxeles (512 × 512) y 36.000.000 (6000 × 6000), una proporción entre 1:16 y 16:1 y pesar 30 MB como máximo.
Pedir solo algunos elementos: el prompt bajó de 14 imágenes a 3
El prompt es la única palanca que tienes sobre el número de capas y, por tanto, sobre el tiempo y la factura. La tercera llamada añadió una sola clave al cuerpo anterior:
"prompt": "Separate only the central toast lead singer with sunglasses and the toast-shaped electric guitar."El resultado fueron 3 imágenes en lugar de 14, 34,8 s en lugar de 94,8 s y 0,054 $ en lugar de 0,252 $, con dos capas llamadas «toast-shaped electric guitar» y «central toast lead singer with sunglasses». La base conservó todo lo demás y redibujó el parabrisas y la parrilla de la furgoneta donde antes estaba el cantante.
La documentación de BytePlus describe tres formas de usar el prompt:
- Automático. Con cURL, Java o Go se omite
prompty el modelo identifica sujetos, textos, fondo y elementos decorativos. El SDK de Python y el de OpenAI exigen el parámetro; en ese caso se envía una instrucción general que pida separar los elementos visuales principales. - Elementos nombrados. Los describes en lenguaje natural, como en el ejemplo oficial «Decompose the person, title text, and decorative icon in the lower-right corner». También puedes marcar los elementos sobre la propia imagen con trazos o selecciones.
- Regiones exactas. Etiquetas bbox dentro del prompt, con coordenadas normalizadas de 0 a 1000 en el orden izquierda, arriba, derecha, abajo. Este modo no se probó; el ejemplo oficial, abreviado aquí a tres regiones, tiene esta forma:
Perform precise layer separation on the image. The text regions to separate are at <bbox>180 64 812 198</bbox> and <bbox>757 210 939 280</bbox>; the parrot is at <bbox>347 305 642 997</bbox>.Como la respuesta devuelve cada capa con sus coordenadas normalizadas, una primera pasada automática te da las cajas que luego puedes reutilizar en una segunda petición más acotada.
Dos avisos. Si pides más capas de las 16 que caben, BytePlus advierte de que «some layer information may be lost». Y sobre el prompt vacío hay versiones opuestas: la documentación de LaoZhang dice que puedes omitirlo «or send an empty string», mientras que el tutorial de la pasarela EvoLink sostiene que la cadena vacía hace perder la detección automática. La cadena vacía no se probó; lo seguro es no enviar la clave prompt cuando quieres el modo automático.
Leer la respuesta: z_index, bounding_box y capas mayores que su caja
Todo llega en data[]: la imagen base tiene z_index 0 y solo url, size y output_format; cada capa añade bounding_box, name y description. Así empezaba la respuesta de la primera llamada, con las URL acortadas:
{
  "model": "dola-seedream-5-0-flash-260915",
  "data": [
    { "url": "https://...", "size": "880x1088", "output_format": "jpeg", "z_index": 0 },
    {
      "url": "https://...",
      "size": "759x627",
      "output_format": "png",
      "z_index": 10,
      "bounding_box": {
        "absolute": [305, 528, 695, 851],
        "normalized": [347, 485, 789, 781]
      },
      "name": "Light green minivan",
      "description": "The main body of the light green minivan, which acts as the base supporting the central toast, excluding the toast above and the guitar in front."
    }
  ],
  "usage": {
    "input_images": 1,
    "generated_images": 14,
    "output_tokens": 53663,
    "total_tokens": 53663
  }
}
Cómo se lee cada campo:
z_indexes el orden de apilado: 0 para la base y de 1 en adelante para las capas, de abajo arriba. En las tres respuestas fue correlativo, sin saltos.bounding_box.absolutees[left, top, right, bottom]en píxeles de la imagen base devuelta.bounding_box.normalizedes la misma caja en una escala de 0 a 1000 sobre el ancho y el alto de la base.nameydescriptionson textos en inglés que escribe el modelo, y cambian entre ejecuciones: la misma furgoneta fue «Light green minivan» con Flash y «Light green minibus» con Pro. No los uses como identificadores estables.usage.generated_imagescuenta la base: 14 significa una base y 13 capas.output_tokenses la suma de ancho × alto de todas las imágenes dividida entre 256.
El detalle que rompe una recomposición ingenua es que el archivo de cada capa es más grande que su caja. La furgoneta llegó como PNG de 759 × 627 px para una caja de 390 × 323 px; el pie de micrófono, 271 × 1037 px para una caja de 103 × 394 px; la tumbona, 660 × 940 px para una caja de 118 × 169 px. Si pegas el PNG tal cual en (left, top), cada elemento invade a los vecinos. La regla del tutorial de BytePlus es:
x = left      y = top
w = right - left
h = bottom - top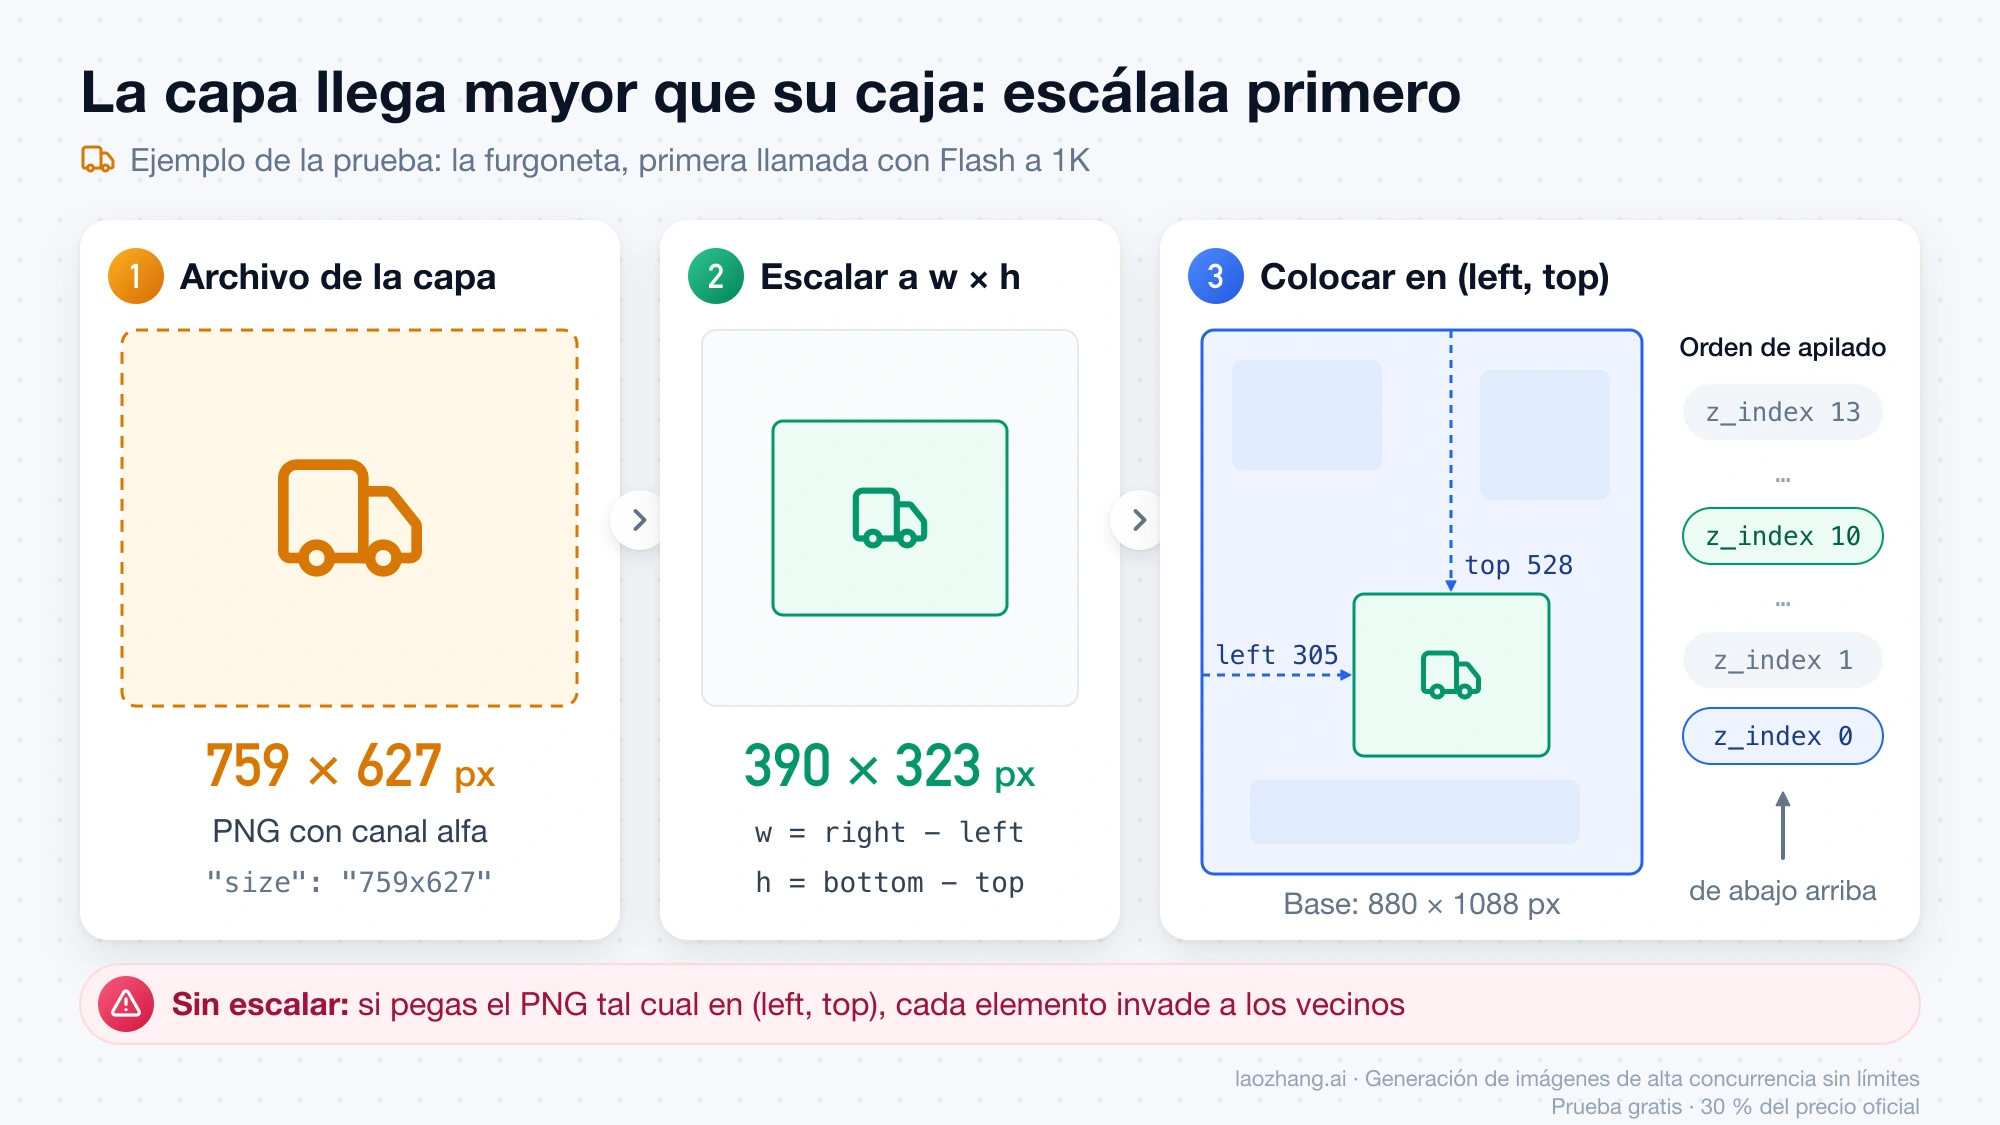
Usa la base como fondo, ordena las capas por z_index ascendente, escala cada una a w × h y colócala en (x, y). Para un lienzo propio de W × H se usan las coordenadas normalizadas:
x = left / 1000 × W          y = top / 1000 × H
w = (right - left) / 1000 × W
h = (bottom - top) / 1000 × H
BytePlus avisa de que, al ser enteros, las coordenadas normalizadas pueden introducir errores de redondeo. Que los archivos traigan más píxeles que su caja a 1K deja margen para montar las capas en un lienzo mayor sin ampliarlas (el pie de micrófono tiene unas 2,6 veces más píxeles por lado que su caja), aunque ese montaje no se comprobó visualmente.
En la respuesta que pasa por LaoZhang, el campo model vuelve con el identificador de BytePlus (dola-seedream-5-0-flash-260915) aunque la petición se envíe sin el prefijo.
Pasar la respuesta a capas PNG, vista recompuesta y PSD con Python
La API no devuelve un PSD: devuelve PNG sueltos y un JSON, y el archivo por capas hay que montarlo. El script siguiente lo hace y es el que se ejecutó sobre las tres respuestas con Python 3.12, Pillow 12.3.0 y psd-tools 1.23.0. Descarga todas las imágenes (o las decodifica si pediste b64_json), guarda cada capa con su nombre, compone una vista plana y escribe el PSD.
python3 -m pip install pillow psd-tools
python3 layers_to_psd.py response.json out_dir"""Guarda todas las imágenes de una respuesta de separación en capas de
Seedream, recompone una vista plana y escribe un PSD por capas.
Uso: python3 layers_to_psd.py response.json out_dir
Requiere: python3 -m pip install pillow psd-tools
"""
import base64
import json
import re
import sys
import urllib.request
from io import BytesIO
from pathlib import Path
from PIL import Image
from psd_tools import PSDImage
response = json.loads(Path(sys.argv[1]).read_text())
out = Path(sys.argv[2])
out.mkdir(parents=True, exist_ok=True)
def load(item):
if item.get("b64_json"):
value = item["b64_json"].split(",", 1)[-1]
return base64.b64decode(value + "=" * (-len(value) % 4))
with urllib.request.urlopen(item["url"], timeout=120) as download:
return download.read()
items = sorted(response["data"], key=lambda item: item["z_index"])
base_item, layer_items = items[0], items[1:]
assert base_item["z_index"] == 0 and "bounding_box" not in base_item
content = load(base_item)
ext = "png" if base_item.get("output_format") == "png" else "jpg"
(out / f"layer-00-base.{ext}").write_bytes(content)
base = Image.open(BytesIO(content)).convert("RGBA")
canvas = base.copy()
psd = PSDImage.new("RGBA", base.size)
psd.append(psd.create_pixel_layer(base, name="base", top=0, left=0))
for item in layer_items:
content = load(item)
slug = re.sub(r"[^a-z0-9]+", "-", item.get("name", "layer").lower()).strip("-") or "layer"
(out / f"layer-{item['z_index']:02d}-{slug}.png").write_bytes(content)
left, top, right, bottom = item["bounding_box"]["absolute"]
# El PNG suele ser mayor que su caja: primero se escala a la caja.
layer = Image.open(BytesIO(content)).convert("RGBA").resize((right - left, bottom - top), Image.LANCZOS)
canvas.alpha_composite(layer, (left, top))
psd.append(psd.create_pixel_layer(layer, name=item.get("name", slug), top=top, left=left))
print(f"z={item['z_index']:>2} file={item['size']:>9} box={right - left}x{bottom - top} at ({left},{top}) {item.get('name')}")
canvas.save(out / "recomposed.png")
psd.save(out / "layers.psd")
print(f"Saved {len(layer_items)} layers + base, recomposed.png and layers.psd in {out}")En la carpeta de salida quedan layer-00-base.jpg, un layer-NN-nombre.png por capa a su tamaño original, recomposed.png y layers.psd. En la prueba, el PSD salió de 880 × 1088 px con 14 capas de píxeles con nombre para las dos llamadas automáticas y 3 para la acotada, cada una en su posición absolute. Al reabrirlo con psd-tools y componerlo, el resultado coincidió con recomposed.png (diferencia absoluta media de 0,001 o menos). Lo que no se observó es cómo lo abre Photoshop, Photopea o GIMP.
Tres cosas que conviene tener presentes:
- Ejecuta el script el mismo día: las URL de la respuesta caducan a las 24 horas.
- Las capas del PSD están a la resolución de la caja. Los PNG guardados aparte conservan todos sus píxeles; son los que te interesan para montar en un lienzo mayor.
- Todas las capas son de píxeles. Nada de lo que devuelve la API es un objeto de texto editable.
Para retocar después una capa suelta, la documentación de BytePlus indica enviarla como única imagen de entrada de una petición normal de Seedream con "background": "transparent" y salida PNG, lo que permite recolorearla o cambiarle el estilo sin perder la transparencia. Ese modo exige una entrada con canal alfa y devuelve error con output_format: jpeg. No se ejecutó en la prueba.
¿Al recomponer sale la imagen original? No: cambia del 4 % al 30 %
No sale la misma imagen, y cuantos más elementos se separan, más se aleja. La medida fue esta: se recompusieron las capas en sus cajas absolute por orden de z_index, se redujo la entrada al tamaño de la base y se contó qué parte de los píxeles difería en más de 32 sobre 255 en algún canal.
| Llamada | Capas separadas | Píxeles que difieren de la entrada |
|---|---|---|
| Flash, automático | 13 | 30,2 % |
| Pro, automático | 13 | 12,6 % |
| Flash, dos elementos nombrados | 2 | 4,0 % |
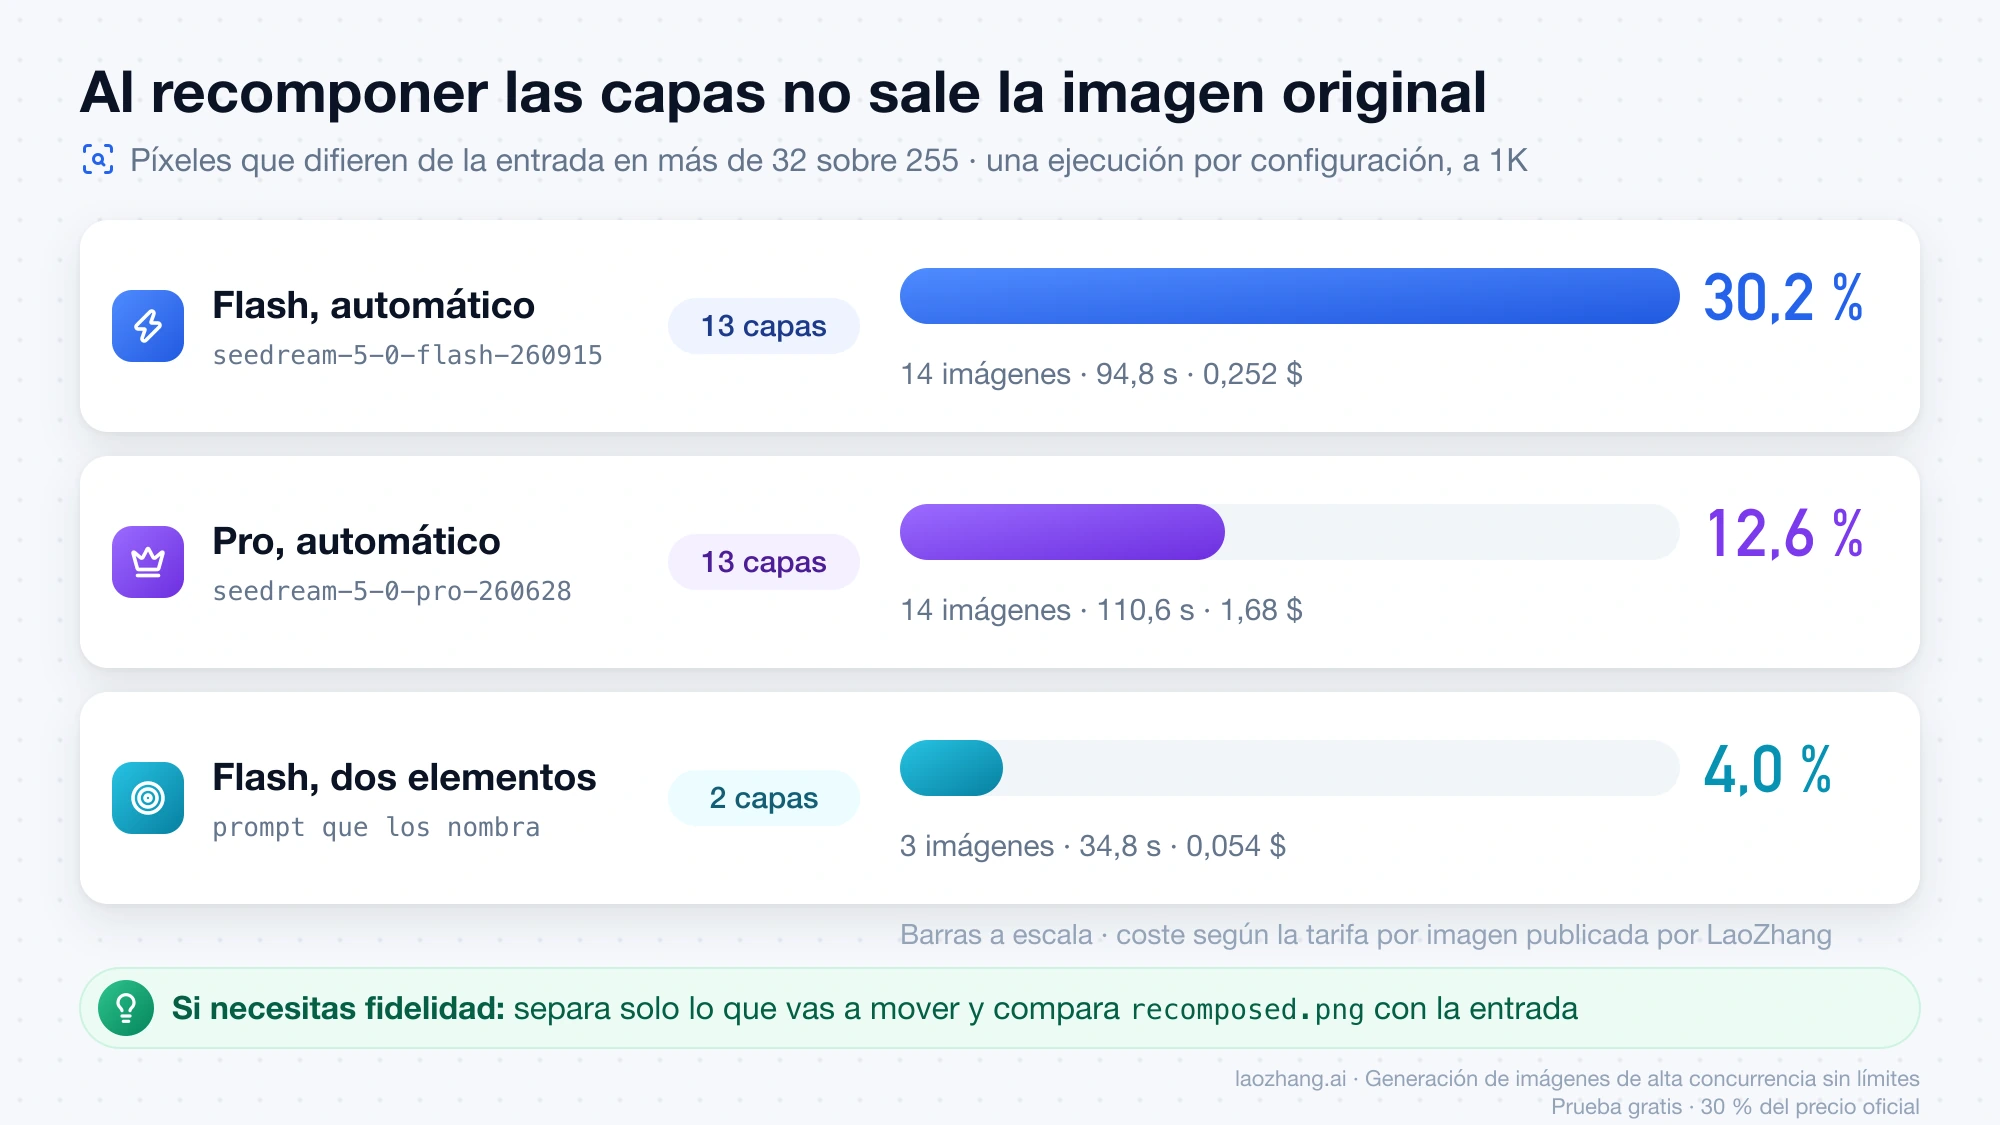
La causa se ve en los archivos. Cada capa es un objeto completo: el modelo pinta las partes que en la imagen original quedaban tapadas, y repinta la base detrás de lo que quita. Eso es lo que permite mover una capa sin dejar un agujero, y también lo que impide que la pila sea una copia exacta.
En el resultado automático de Flash, los dos personajes desenfocados del primer plano volvieron nítidos y con otra forma, el músico de la izquierda se redibujó como un personaje entero y más grande, el escenario pasó a ser un disco completo que tapa césped visible en la original, y las burbujas flotantes desaparecieron tanto de la base como de las capas. Pro mantuvo el desenfoque del primer plano y dejó las burbujas y el escenario en la base; a simple vista queda cerca de la entrada, con diferencias pequeñas en los bordes. Los dos modelos encontraron 13 capas, pero no las mismas: Flash convirtió el escenario en capa y Pro separó el ukelele.
Es una ilustración 3D estilizada y una ejecución por modelo, así que los porcentajes no predicen tu imagen. Sí bastan para no dar por buena la afirmación del tutorial de EvoLink de que ordenar por z_index y componer cada capa en su caja «reproduces the original image exactly». Si necesitas fidelidad, separa solo lo que vas a mover y compara siempre recomposed.png con la entrada antes de dar el resultado por bueno.
Cuánto cuesta una llamada: precio por imagen × imágenes devueltas
El coste es precio por imagen × usage.generated_images, y ese número va de 2 (base y una capa) a 17 (base y 16 capas). Las tarifas por imagen, a 2 de octubre de 2026:
- BytePlus, Flash: 0,018 $ por imagen de salida; la imagen de entrada es gratis (precios de ModelArk).
- BytePlus, Pro en modo capas: 0,0225 $ por imagen de hasta 2,61 millones de píxeles (1.5K o menos) y 0,045 $ por encima; la primera imagen de entrada es gratis. Es la mitad de lo que cuesta una generación normal con Pro (0,045 $ y 0,09 $). Cada capa se factura según su propio tramo de píxeles.
- LaoZhang, Flash: 0,018 $ por imagen devuelta.
- LaoZhang, Pro: 0,12 $ por imagen devuelta, tarifa plana sin tramos (documentación de Seedream en LaoZhang).
Aplicadas a los tres tamaños de resultado que importan:
| Imágenes devueltas | Flash (BytePlus o LaoZhang) | Pro en BytePlus, tramo bajo | Pro en LaoZhang |
|---|---|---|---|
| 3 (llamada acotada) | 3 × 0,018 = 0,054 $ | 3 × 0,0225 = 0,0675 $ | 3 × 0,12 = 0,36 $ |
| 14 (llamadas automáticas) | 14 × 0,018 = 0,252 $ | 14 × 0,0225 = 0,315 $ | 14 × 0,12 = 1,68 $ |
| 17 (máximo posible) | 17 × 0,018 = 0,306 $ | 17 × 0,0225 = 0,3825 $ | 17 × 0,12 = 2,04 $ |
Dos supuestos en la columna de BytePlus. La página de precios no dice de forma expresa que la imagen base se cobre a la tarifa de capa; como generated_images la cuenta y la facturación se basa en las imágenes generadas con éxito, el cálculo la incluye. Y todas las imágenes se suponen en el tramo bajo, que es lo que ocurre a 1K; una base 2K de 2048 × 2048 px tiene 4,19 millones de píxeles y pasa al tramo de 0,045 $. Con todas las imágenes en el tramo alto, el máximo de Pro en BytePlus sería 17 × 0,045 = 0,765 $. Impuestos y descuentos quedan fuera.
Para presupuestar un lote antes de lanzarlo, multiplica el número de imágenes por 17 y por el precio unitario: ese es el techo. Mil imágenes con Flash cuestan como mucho 1000 × 0,306 = 306 $; si un prompt acotado las deja en 3 imágenes por llamada, 1000 × 0,054 = 54 $. BytePlus no cobra las salidas bloqueadas por moderación, y LaoZhang indica que una imagen que no se puede separar devuelve HTTP 400 y no se cobra.
Flash o Pro y por qué vía: Flash primero, Pro directo en BytePlus
Empieza con Flash y pasa a Pro solo cuando la fidelidad lo justifique. Flash cuesta 0,018 $ por imagen en las dos rutas y fue algo más rápido en la prueba (94,8 s frente a 110,6 s con el mismo número de capas). Pro alteró menos la imagen al recomponer (12,6 % frente a 30,2 % de píxeles distintos) y respetó el desenfoque del primer plano, que es justo lo que se echa de menos cuando las capas van a volver a montarse sobre la misma composición.
La vía cambia según el modelo:
- Flash: el precio de LaoZhang es igual a la tarifa de BytePlus, así que la pasarela no te cuesta nada adicional y te ahorra abrir una cuenta en BytePlus. Es la ruta que se probó.
- Pro: en modo capas, BytePlus directo cuesta 0,0225 $ por imagen frente a 0,12 $ en LaoZhang, unas 5,3 veces menos en el tramo bajo (0,12 ÷ 0,0225) y 2,7 veces menos en el alto (0,12 ÷ 0,045). Para un volumen serio con Pro, la cuenta directa compensa; la pasarela solo tiene sentido para unas pocas llamadas de evaluación con una clave que ya tengas.
Si trabajas desde la UE, ten en cuenta que BytePlus ofrece estos dos modelos solo en la región ap-southeast-1; en eu-west-1 está Seedream 5.0 lite, que no admite la separación en capas (lista de modelos de ModelArk). Si la residencia de datos en la UE es un requisito, esta función no lo cumple hoy en BytePlus.
Sobre los tamaños: BytePlus documenta 1K, 1.5K, 2K y auto para ambos modelos y afirma que 1.5K cuesta lo mismo que 1K con mejor calidad; la documentación de LaoZhang lista solo 1K y 2K para Pro. Ningún tamaño distinto de 1K se probó. En LaoZhang hace falta además una clave con modo de facturación «Usage first» o «Per-call», porque Seedream se cobra por llamada.
Si todavía dudas entre Seedream y el modelo de Google para el resto del trabajo de imagen, la comparativa Nano Banana Pro vs Seedream 5.0 Pro: cuál elegir y cuánto cuesta recorre precios oficiales y límites de ambos.
Por qué tarda y qué hace fallar la petición: tiempos, cuota y HTTP 400
Tarda porque una llamada genera hasta 17 imágenes y la respuesta es síncrona: no llega nada hasta que están todas. Estos dos modelos no admiten stream. En la prueba, 3 imágenes tardaron 34,8 s y 14 imágenes entre 94,8 y 110,6 s.
- Tiempo de espera del cliente. LaoZhang recomienda 300 s como mínimo a 1K y advierte de que una petición a 2K puede alargarse y se cobra aunque tu cliente se desconecte. Un
timeoutcorto no cancela el gasto: solo te deja sin la respuesta. - Todo o nada. BytePlus lo dice así: «If any layer fails to generate, the entire request fails. Partial success is not supported.» No existe una respuesta con la mitad de las capas.
- Campos que provocan HTTP 400 en LaoZhang.
sequential_image_generationystreamno pueden aparecer en el cuerpo, ni siquiera desactivados. Los modelos anteriores (seedream-5-0-260128,seedream-4-5-251128) devuelven HTTP 400 con el códigoInvalidParametersi recibenlayer_decomposition. - Entrada fuera de límites. Más de una imagen da error según BytePlus, y el modo capas solo admite PNG y JPEG. Qué mensaje exacto devuelve un WebP o una segunda imagen no se comprobó.
- Navegador. Las URL de resultado no envían cabeceras CORS, según LaoZhang; si descargas las capas desde código que corre en el navegador, pide
b64_json. - Cuota en BytePlus. El límite es de 500 imágenes por minuto por modelo y cuenta, y cada petición de capas reserva 17 al empezar; lo que sobra se devuelve al terminar. Con la cuota intacta caben 500 ÷ 17 = 29 peticiones lanzadas en el mismo minuto (29 × 17 = 493), no 500, y la devolución llega cuando cada petición acaba, entre medio minuto y dos minutos después a juzgar por los tiempos de la prueba. Una pasarela puede aplicar sus propios límites.
Cuándo la separación en capas de Seedream no es la herramienta
No es la herramienta adecuada cuando necesitas una de estas cuatro cosas:
- Un solo recorte con transparencia. Pagar una base y varias capas para quedarte con un objeto es mala cuenta, y lo que obtienes no es una máscara del original sino un objeto redibujado. Para ese caso sirve cómo hacer un PNG con fondo transparente y comprobar que lo es.
- Los píxeles originales intactos. La base y las capas son imágenes generadas. En la prueba cambió entre el 4 % y el 30 % de los píxeles; para retoque que deba conservar el original, esto no vale como segmentación.
- Texto editable o más de 2K. Las capas son de píxeles, también las de texto, y los tamaños documentados por BytePlus acaban en 2K. Un archivo con capas de texto vivas o una salida 4K quedan fuera de lo que ofrece esta API.
- Un PSD sin escribir código. layerpsd.com, del mismo equipo que este blog, es una herramienta de navegador que según su propia página divide un JPG, PNG o WebP en un PSD por capas desde 0,018 $ por capa, sin suscripción, con Seedream 5.0 Flash. No se probó en esta ocasión.
Para todo lo demás, el camino corto es: una llamada automática con Flash a 1K para ver cuántas capas salen y cómo se llaman, una segunda llamada que nombre solo los elementos que vas a mover, el script para obtener los PNG y el PSD, y una comparación de recomposed.png con la entrada antes de pasar a Pro o a un tamaño mayor.