Nano Banana no genera imagen en la API: diagnóstico y arreglo
Si la API de Nano Banana responde sin imagen, el JSON explica el motivo: solo texto, un bloqueo, candidates vacío o un ID retirado. Cada caso tiene su arreglo.
En esta página
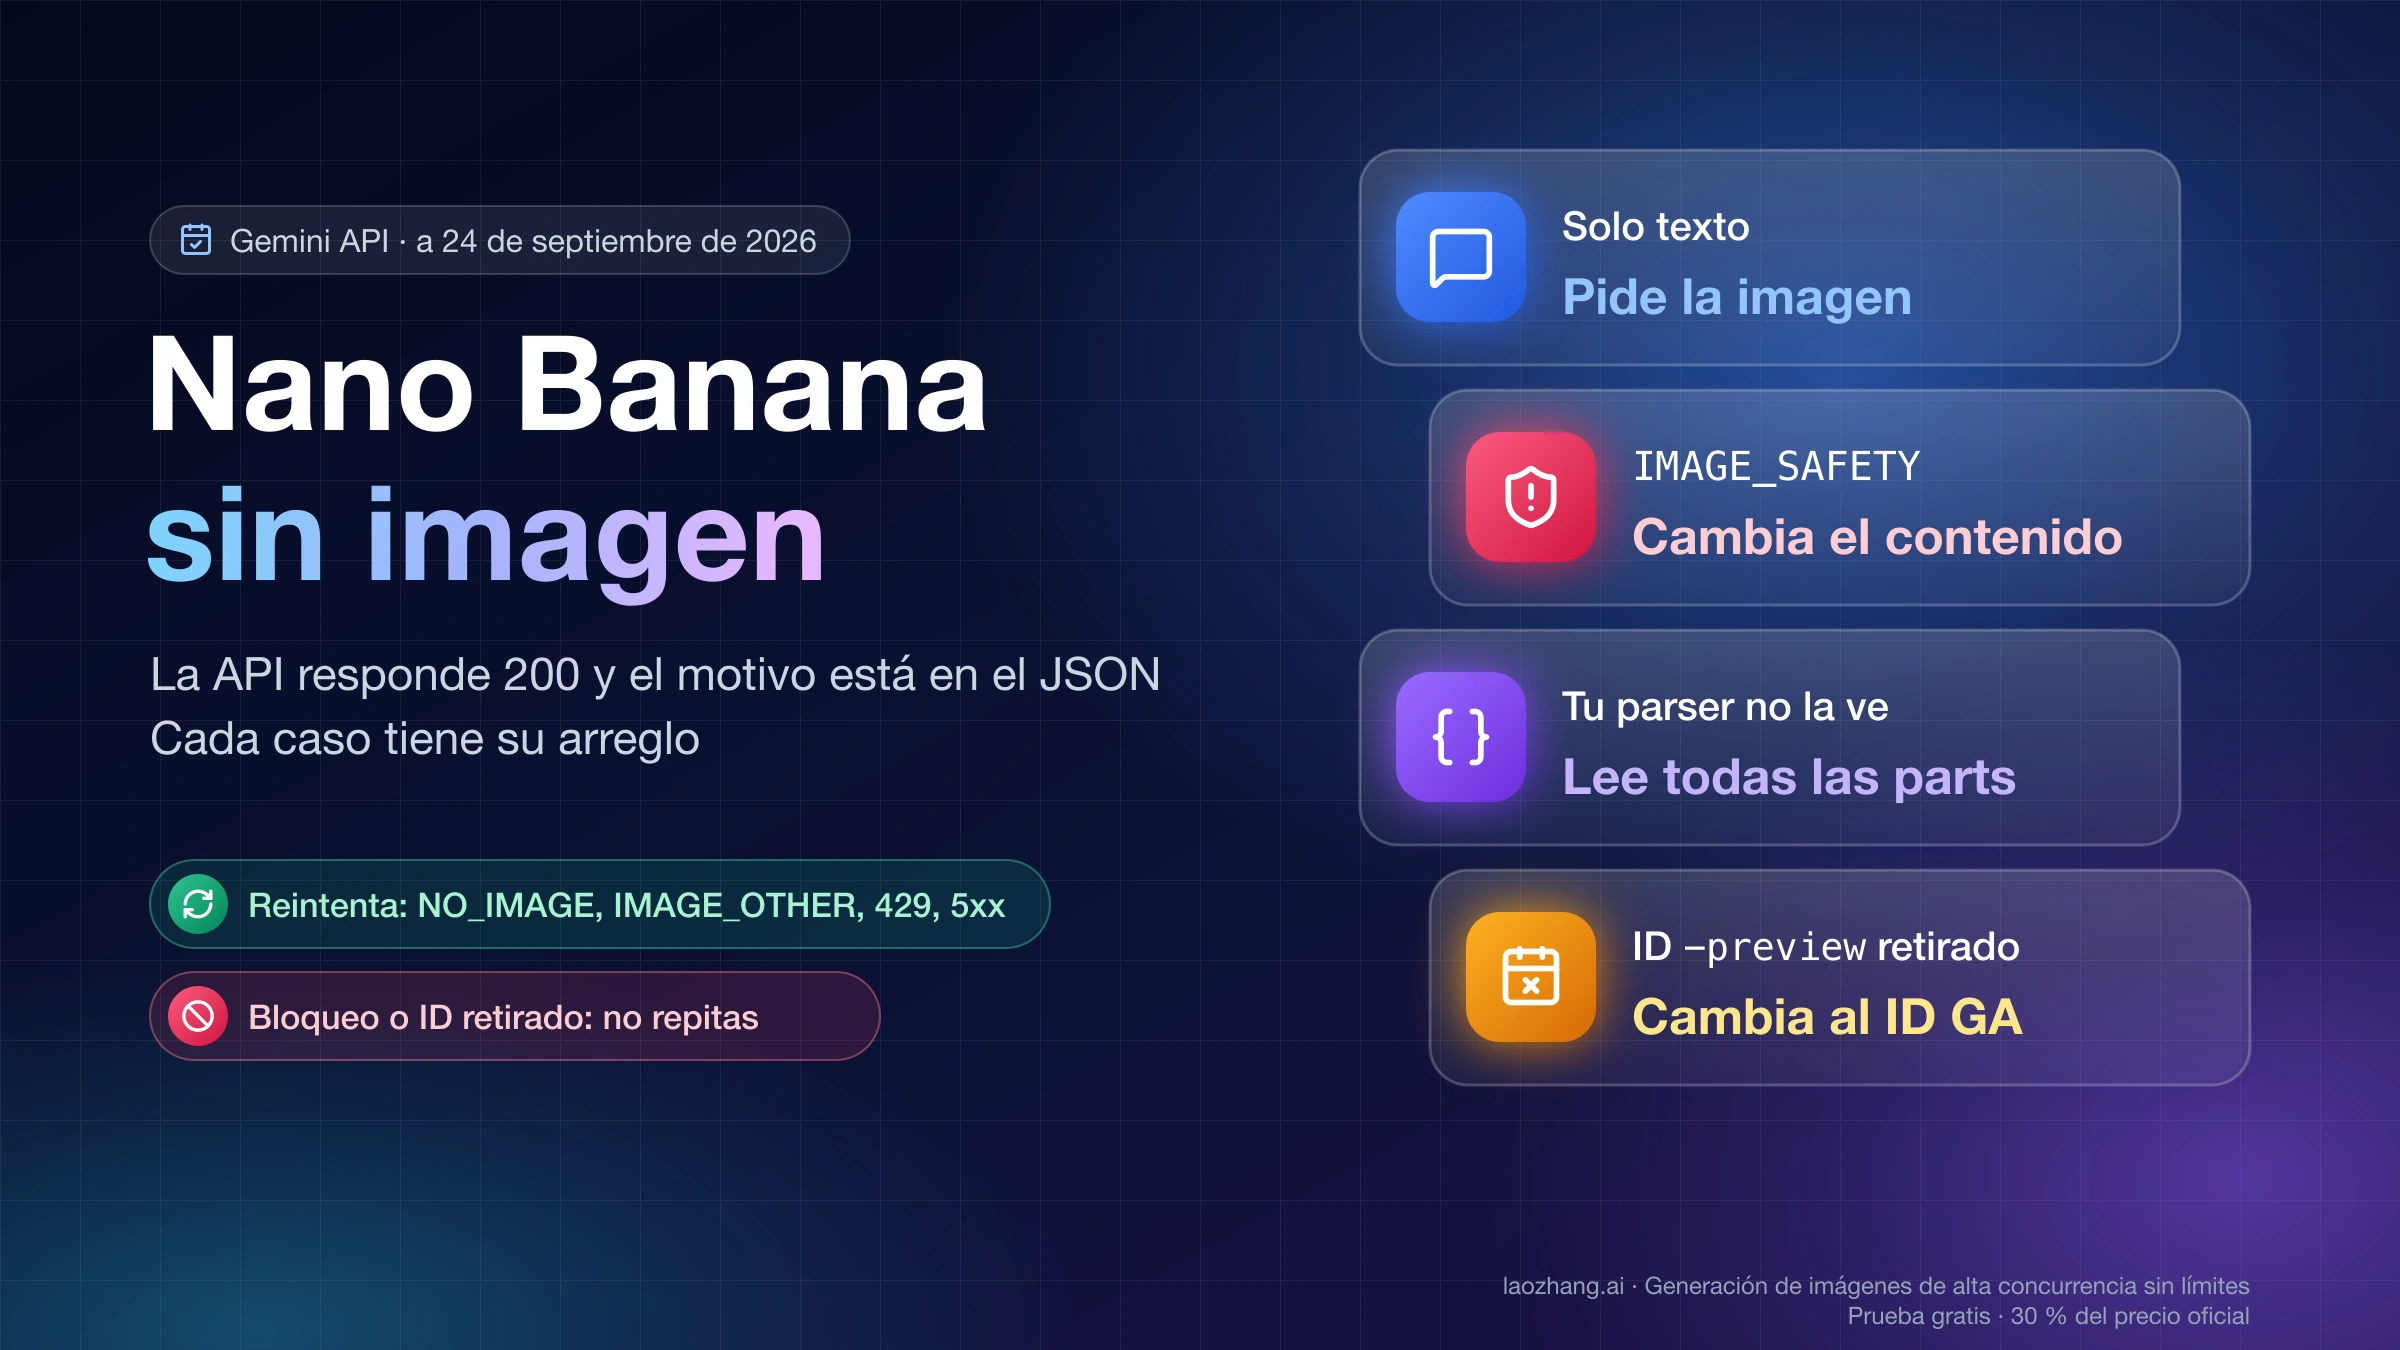
Cuando la API de Nano Banana contesta con HTTP 200 y no trae ninguna imagen, la llamada no ha fallado por red: la respuesta llegó y el motivo está dentro del JSON. Hay cuatro explicaciones posibles: el modelo respondió solo con texto, un filtro detuvo la imagen (finishReason como IMAGE_SAFETY, o candidates vacío con promptFeedback.blockReason), la salida se cortó antes de tiempo, o tu código no encontró una imagen que sí venía. Aparte están los ID de modelo retirados, que ya no generan nada: gemini-3.1-flash-image-preview y gemini-3-pro-image-preview se apagaron el 25 de junio de 2026, y gemini-2.5-flash-image se apaga el 2 de octubre de 2026.
Reintentar la misma petición solo tiene sentido con NO_IMAGE, IMAGE_OTHER, un 429 o errores 5xx, y en los dos últimos casos tras una espera. Ante un bloqueo por políticas o un ID retirado, repetirla da el mismo resultado: hay que cambiar el contenido o el modelo.
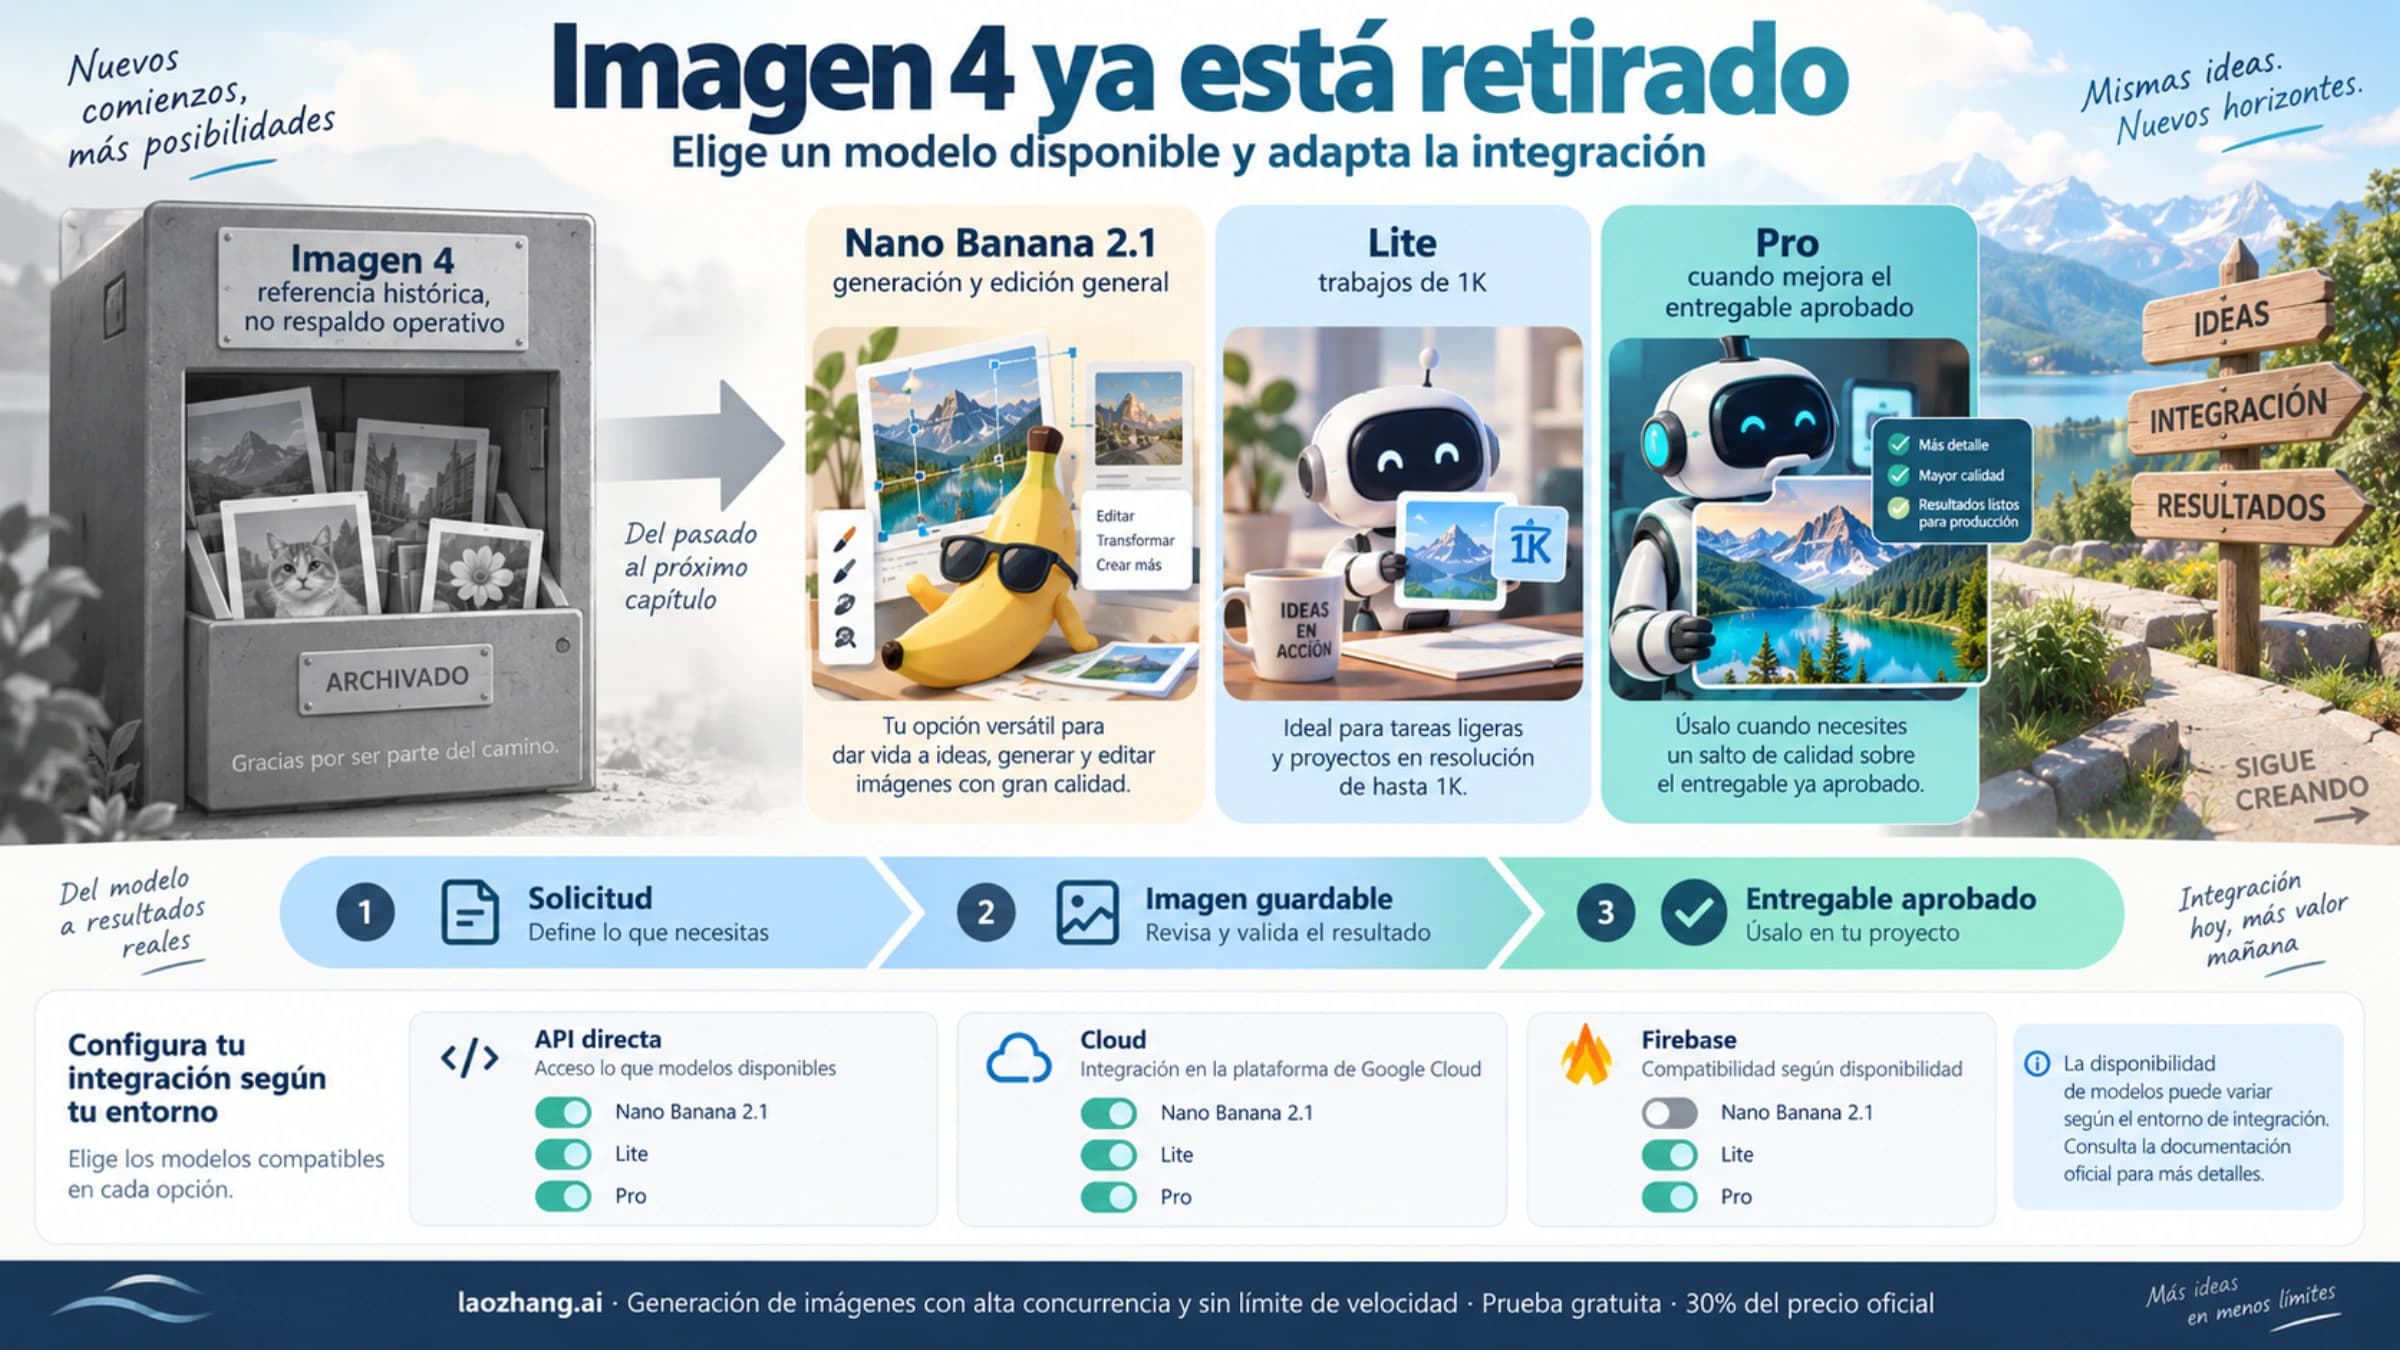
Si usas la app o la web de Gemini sin escribir código, tu caso está en Nano Banana no funciona en Gemini: 12 arreglos para errores de imagen. Lo que sigue es para quien llama a la Gemini API directamente, desde AI Studio, con un SDK oficial o con una herramienta montada sobre la API. A 24 de septiembre de 2026, los ID vigentes son gemini-3.1-flash-image (Nano Banana 2), gemini-3.1-flash-lite-image (Nano Banana 2 Lite), gemini-3-pro-image (Nano Banana Pro) y gemini-2.5-flash-image (el Nano Banana original, hasta su retirada).
Guarda la respuesta cruda antes de cambiar nada
El diagnóstico sale de la respuesta completa, no del mensaje que muestre tu aplicación. Hay dos API con estructuras distintas y conviene no mezclarlas. La Interactions API está disponible de forma general (GA) desde junio de 2026 y Google la recomienda para proyectos nuevos; generateContent pasa a considerarse heredada, pero sigue plenamente admitida.
| Qué buscas | generateContent | Interactions API |
|---|---|---|
| ¿Terminó bien? | candidates[0].finishReason y, si existe, finishMessage | status |
| ¿Se bloqueó el prompt? | candidates vacío y promptFeedback.blockReason | status: "failed" y la lista errors |
| La imagen final | parts con inlineData y mimeType de imagen, sin thought: true | bloques type: "image" dentro de pasos model_output |
| Imágenes de razonamiento | parts con thought: true | pasos type: "thought", dentro de summary |
| Consumo de tokens | usageMetadata | usage |
Con REST basta con escribir el cuerpo en un archivo:
curl -s -X POST \
  "https://generativelanguage.googleapis.com/v1/models/gemini-3.1-flash-image:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"contents": [{"parts": [{"text": "Genera una imagen de un faro en la costa cantábrica al amanecer"}]}]}' \
  -o respuesta.json
Con el SDK de Python (google-genai), los objetos de respuesta se pueden volcar a JSON:
with open("respuesta.json", "w", encoding="utf-8") as f:
    f.write(response.model_dump_json(exclude_none=True))      # generateContent
    # f.write(interaction.model_dump_json(exclude_none=True)) # Interactions API
El volcado del SDK usa nombres en snake_case (finish_reason, inline_data, mime_type), mientras que REST devuelve camelCase (finishReason, inlineData, mimeType). Un parser que busque inlineData en un volcado del SDK no encontrará ninguna imagen aunque la haya; el script del final acepta las dos formas.
De la forma de la respuesta a la acción
Cada fila de esta tabla corresponde a un caso distinto. La última columna es la que más dinero ahorra: indica si merece la pena repetir exactamente la misma petición.
| Lo que ves | Qué significa | Qué hacer | ¿Repetir igual? |
|---|---|---|---|
finishReason: "STOP" con solo texto, o status: "completed" sin bloque image | El modelo decidió contestar con texto | Pide la imagen de forma explícita y limita la salida a imagen | No; cambia la petición |
NO_IMAGE | Se esperaba una imagen y no se generó | Pide la imagen explícitamente, simplifica el prompt | Una vez |
IMAGE_SAFETY, IMAGE_PROHIBITED_CONTENT, PROHIBITED_CONTENT, BLOCKLIST, SPII | El contenido chocó con las políticas | Cambia lo que pides o las imágenes que envías | No |
SAFETY | Lo cortó uno de los filtros ajustables | Revisa safetyRatings y tus safetySettings | Solo si habías endurecido el umbral |
candidates vacío y promptFeedback.blockReason | Se bloqueó el prompt antes de generar | Actúa según blockReason | No |
IMAGE_RECITATION o RECITATION | La salida se parecía a material existente | Haz el prompt más original | No |
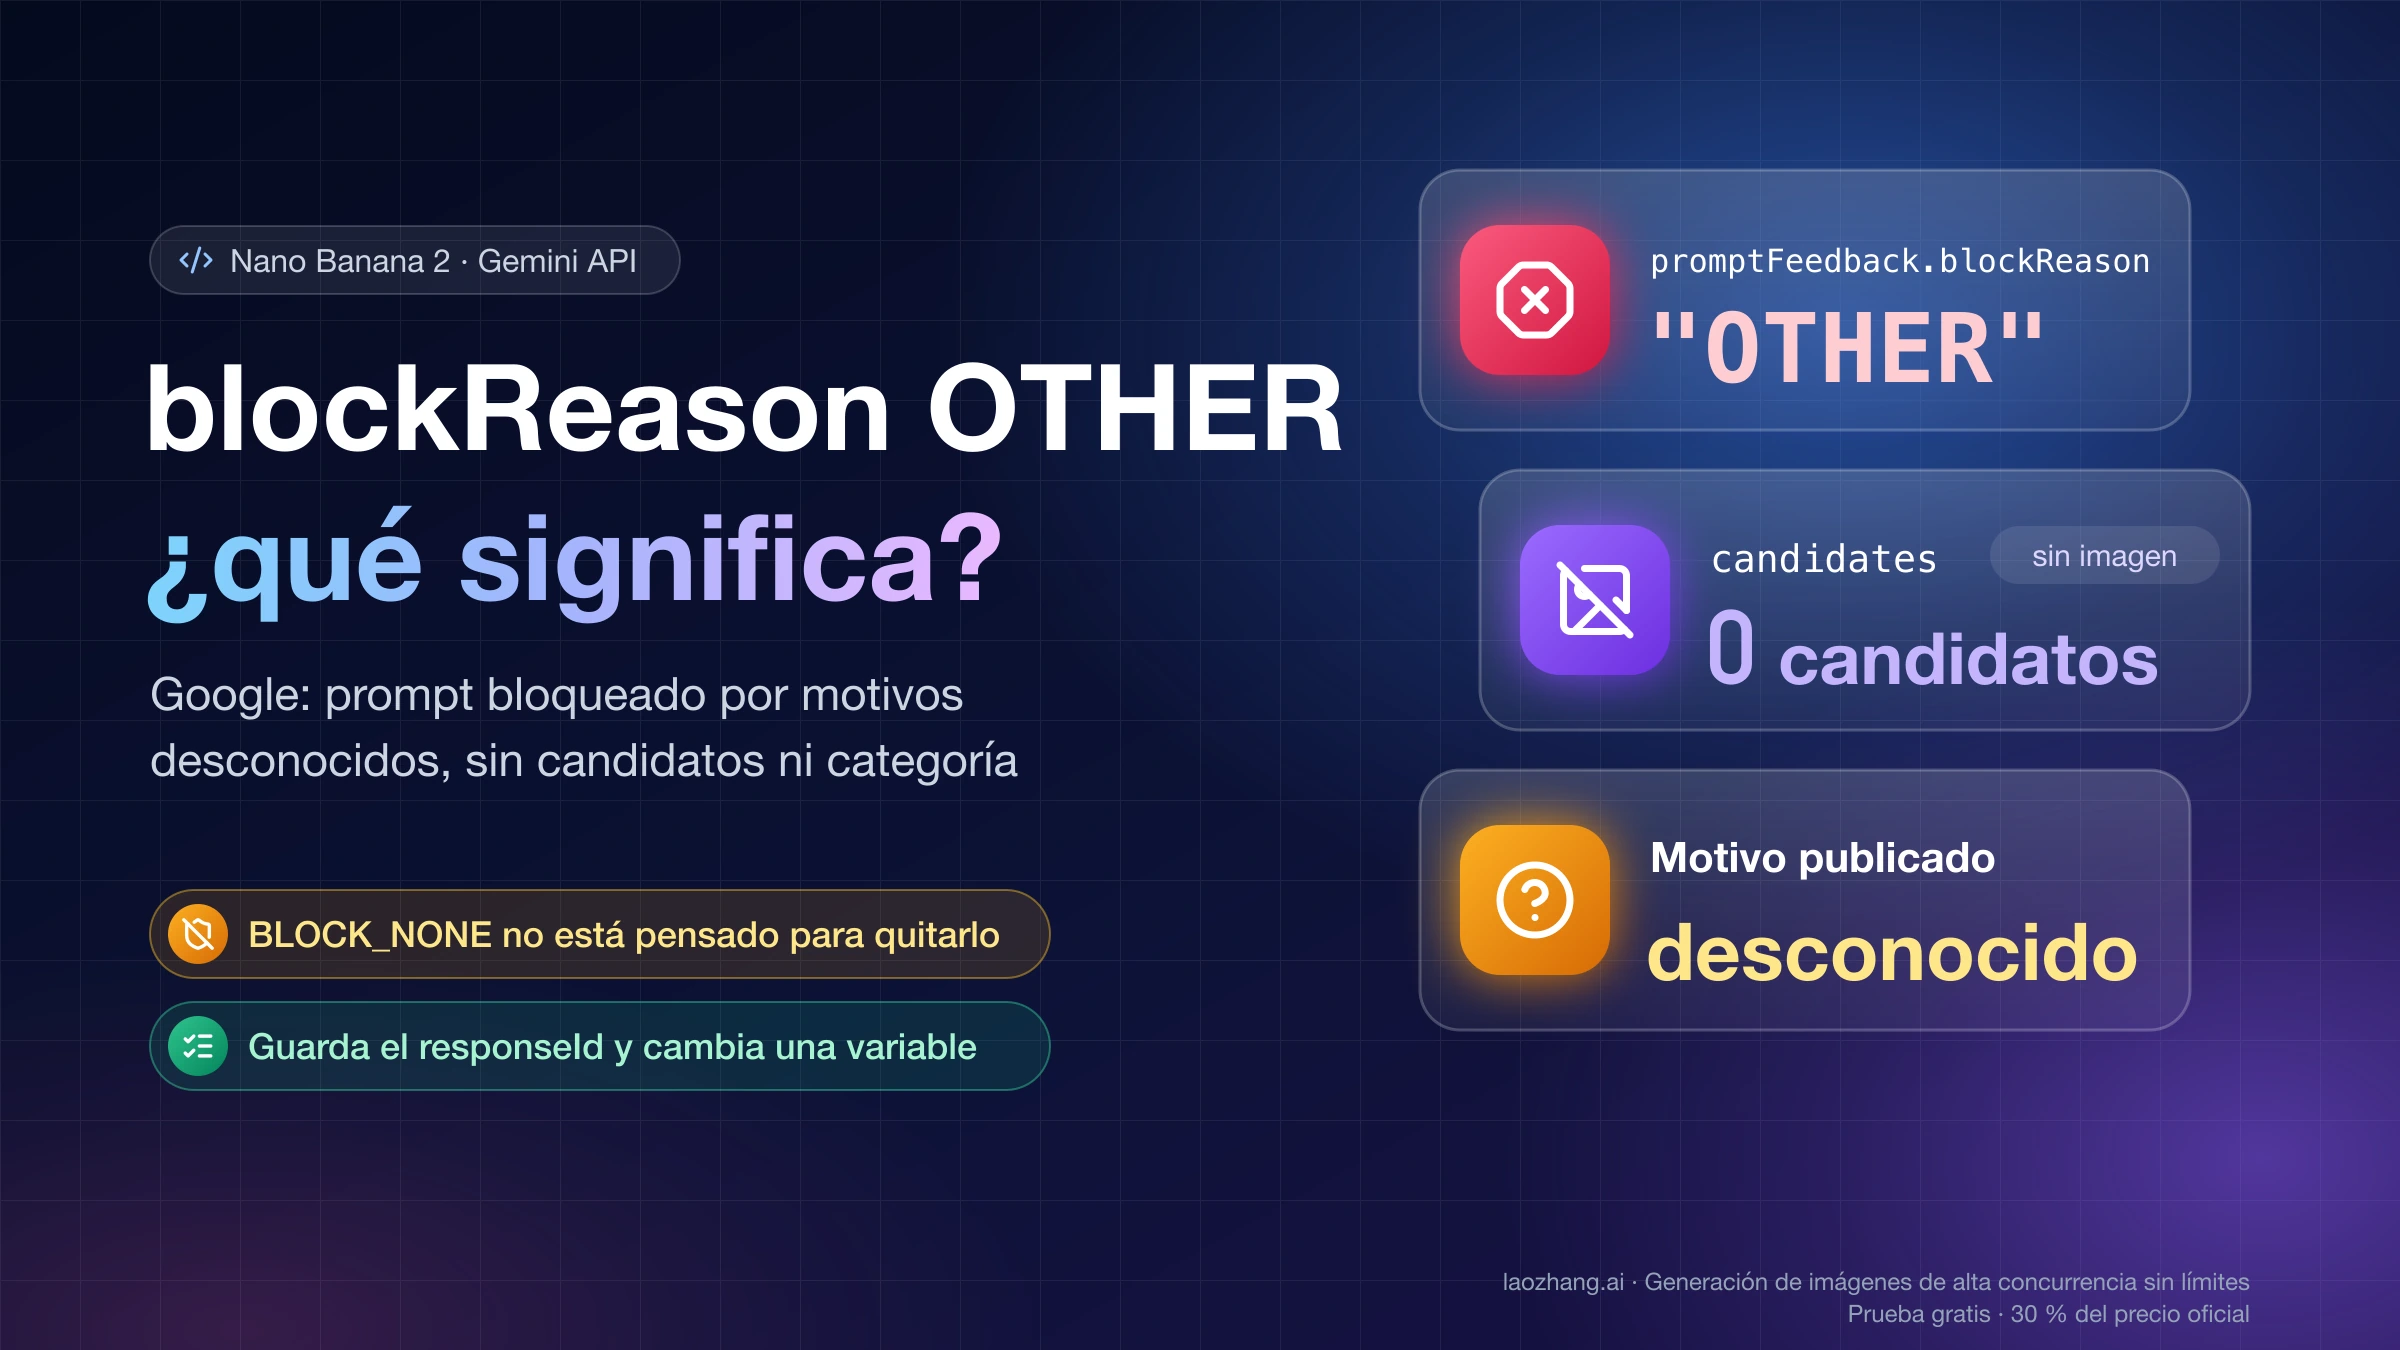
IMAGE_OTHER u OTHER | Causa no especificada | Reintenta una vez; si se repite, simplifica | Una vez |
MAX_TOKENS o status: "incomplete" | Se alcanzó el límite de salida | Sube o quita maxOutputTokens / max_output_tokens | Tras cambiarlo |
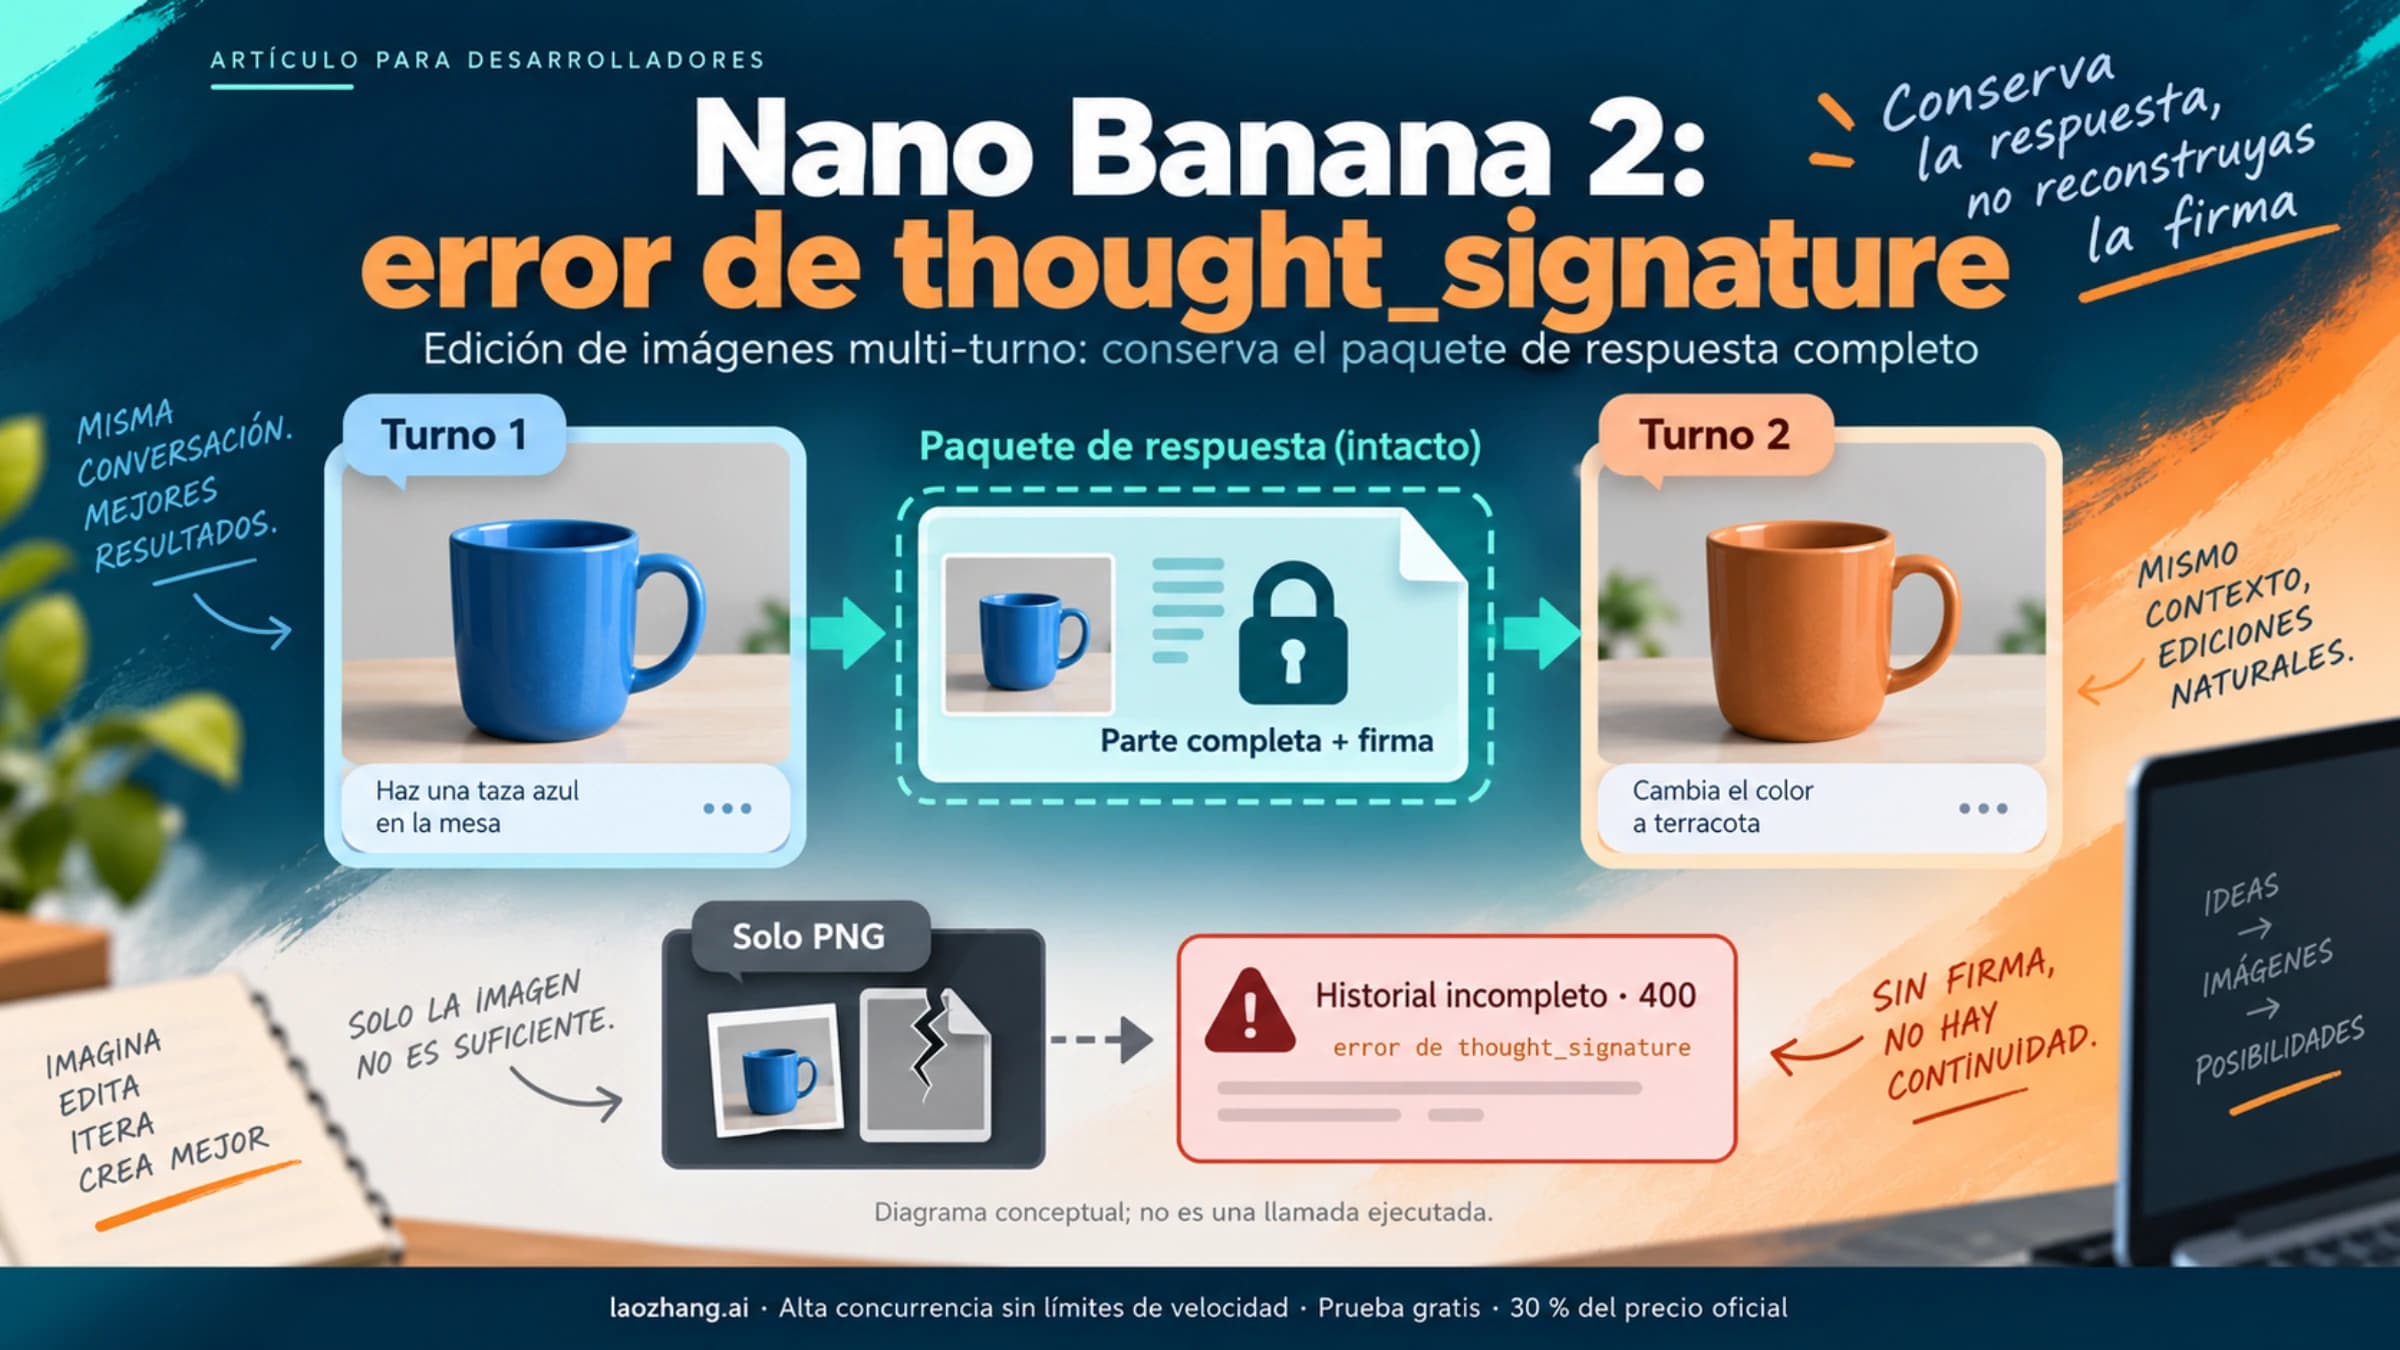
MISSING_THOUGHT_SIGNATURE | Falta una firma de razonamiento en una edición multiturno | Devuelve las firmas tal como llegaron | Tras corregirlo |
status: "failed" | La interaction falló | Lee errors[].message | Depende del mensaje |
PUP_LIMITED_DISABLED | Cuenta limitada por la Política de uso prohibido | Se resuelve en la cuenta, no en el código | No |
Error HTTP con un ID -preview de imagen | El modelo ya no existe | Cambia al ID GA | No |
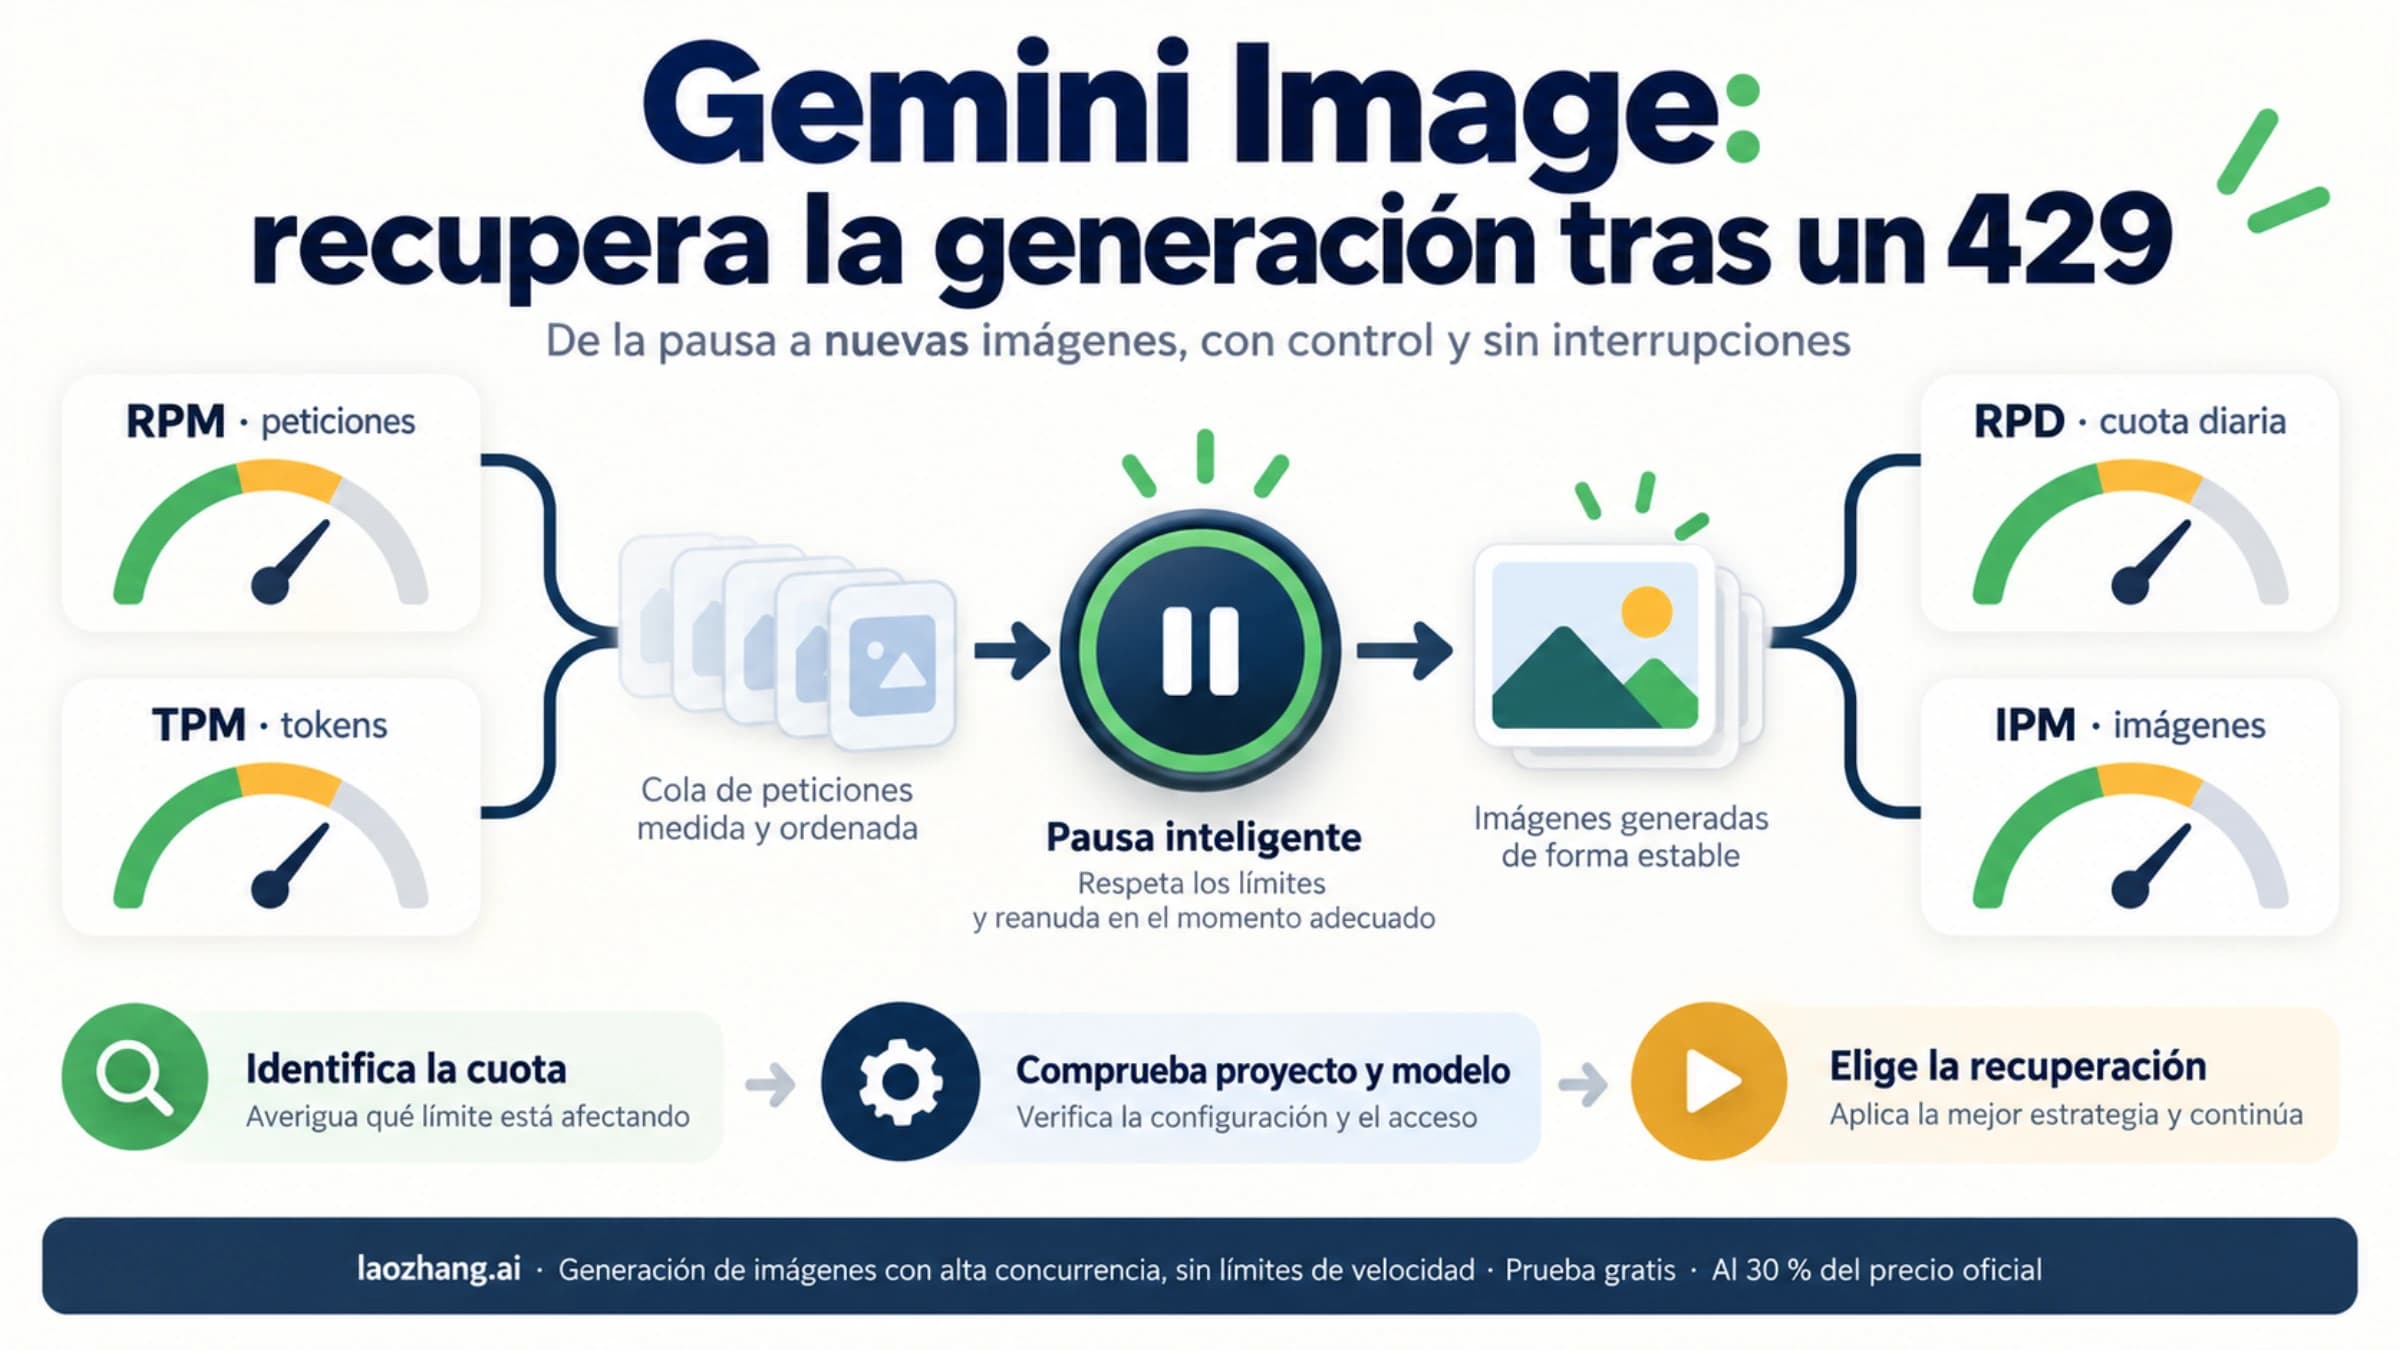
| HTTP 429, 408 o 5xx | Cuota o fallo transitorio | Espera con backoff exponencial | Sí, con espera |
Los valores de finishReason salen de la referencia de generateContent. Ninguna de sus descripciones dice qué parte concreta del prompt provocó un bloqueo; finishMessage, cuando viene, puede añadir algo de detalle.
Solo texto: pide la imagen y limita la salida
La documentación de Google lo dice sin rodeos: el modelo devuelve por defecto texto e imagen. Si nada en la petición deja claro que quieres una imagen, la respuesta puede quedarse en texto. El arreglo tiene dos partes: que el prompt diga claramente que quieres una imagen y que la petición restrinja la salida.
from google import genai
from google.genai import types

client = genai.Client()
prompt = "Genera una imagen: un faro en la costa cantábrica al amanecer, estilo acuarela."

# generateContent
response = client.models.generate_content(
    model="gemini-3.1-flash-image",
    contents=prompt,
    config=types.GenerateContentConfig(response_modalities=["IMAGE"]),
)

# Interactions API
interaction = client.interactions.create(
    model="gemini-3.1-flash-image",
    input=prompt,
    response_format={"type": "image"},
)
responseModalities exige que la respuesta coincida exactamente con las modalidades pedidas, y si pides una combinación que el modelo no admite, la API devuelve un error en lugar de una respuesta vacía. Restringir la salida no garantiza la imagen: la llamada puede seguir terminando en NO_IMAGE o en un bloqueo, y entonces toca la fila correspondiente de la tabla. Tampoco cuentes con el número exacto de imágenes: según las limitaciones publicadas, el modelo no siempre respeta cuántas pides.
Sobre el idioma: la lista de idiomas con mejor rendimiento incluye es-MX y no menciona es-ES, lo que no indica ningún problema con el español de España. Si un prompt en español vuelve una y otra vez solo con texto, la prueba barata es dejar muy explícita la petición de imagen al principio y, si sigue igual, comparar con la misma petición en inglés.
Bloqueos: qué cambiar y qué no sirve
Los bloqueos por políticas (IMAGE_SAFETY, IMAGE_PROHIBITED_CONTENT, PROHIBITED_CONTENT, BLOCKLIST, SPII) no se arreglan repitiendo la llamada. Como el enum no señala el elemento que lo disparó, lo práctico es quitar de uno en uno lo que tenga más papeletas: personas reales identificables, contenido sexual o violento, marcas, obras ajenas o datos personales. Con imágenes de referencia pasa lo mismo; en r/Bard hay usuarios que cuentan que Gemini deja de generar en cuanto una de las fotos de entrada es de un famoso.
Los ajustes de seguridad no son una vía para saltarse estos bloqueos. Según la guía de ajustes de seguridad:
- Los umbrales ajustables cubren cuatro categorías: acoso (
HARASSMENT), incitación al odio (HATE_SPEECH), contenido sexual explícito (SEXUALLY_EXPLICIT) y contenido peligroso (DANGEROUS_CONTENT).IMAGE_SAFETY,PROHIBITED_CONTENTy el resto no están entre ellas, así que no hay ningún ajuste documentado que los desactive. - Las protecciones frente a daños graves, como los que ponen en peligro a menores, bloquean siempre y no se pueden ajustar.
- Si no fijas ningún umbral, en los modelos Gemini 2.5 y 3 el valor por defecto es
OFF. De ahí se deduce que ponerBLOCK_NONEno afloja nada si nunca tocaste esos ajustes, y quefinishReason: "SAFETY"solo se corrige desdesafetySettingscuando antes los habías endurecido tú; en ese caso,safetyRatingsindica qué categoría saltó. En AI Studio están en Run settings, dentro de Advanced settings. - La Interactions API no admite ajustes de seguridad personalizados.
- Google avisa de que las aplicaciones con ajustes menos restrictivos pueden someterse a revisión.
Si el prompt se bloquea entero, candidates llega vacío y promptFeedback.blockReason trae SAFETY, OTHER, BLOCKLIST, PROHIBITED_CONTENT o IMAGE_SAFETY. El caso OTHER tiene su propia guía: Nano Banana 2 blockReason OTHER: qué significa y qué revisar.
Con RECITATION o IMAGE_RECITATION, la guía de solución de problemas recomienda que el prompt y el contexto sean lo más originales posible: fuera títulos de obras, personajes con nombre y peticiones de «igual que».
Cambiar de plataforma tampoco resuelve un bloqueo: si otra herramienta o proveedor acaba llamando al mismo modelo de Google, la decisión sobre el contenido la vuelve a tomar ese modelo.
Cuando la imagen está ahí y tu código no la ve
Los modelos de imagen de Gemini 3 razonan siempre, sin opción de desactivarlo, y durante ese proceso generan hasta dos imágenes provisionales para probar la composición. Según la documentación del proceso de razonamiento, la última imagen del razonamiento coincide con la imagen final. En generateContent, esas partes llevan thought: true y aparecen cuando activas includeThoughts; en la Interactions API van en pasos type: "thought". Los ejemplos oficiales se saltan esas partes antes de guardar la imagen.
De ahí salen dos fallos típicos del parser (la documentación no los describe así; se deducen de la estructura de la respuesta):
- Con
includeThoughtsactivado, guardar la primera parte coninlineDatapuede darte un borrador de razonamiento en lugar de la imagen final. - Un filtro mal escrito puede informar de «sin imagen» con la imagen dentro de la respuesta: por ejemplo, quedarse solo con
parts[0]o descartar toda parte que llevethoughtSignature, cuando la documentación indica que las partes de imagen de la respuesta final también llevan esa firma.
La salida intercalada de texto e imagen tiene su propia trampa. En la Interactions API, interaction.output_image devuelve solo el último bloque de imagen; si pides, por ejemplo, una historia ilustrada, hay que recorrer steps y guardar cada bloque image de los pasos model_output. En generateContent hay que recorrer todas las parts, no solo la primera. Antes de concluir que no hay imagen, guarda todas las partes.
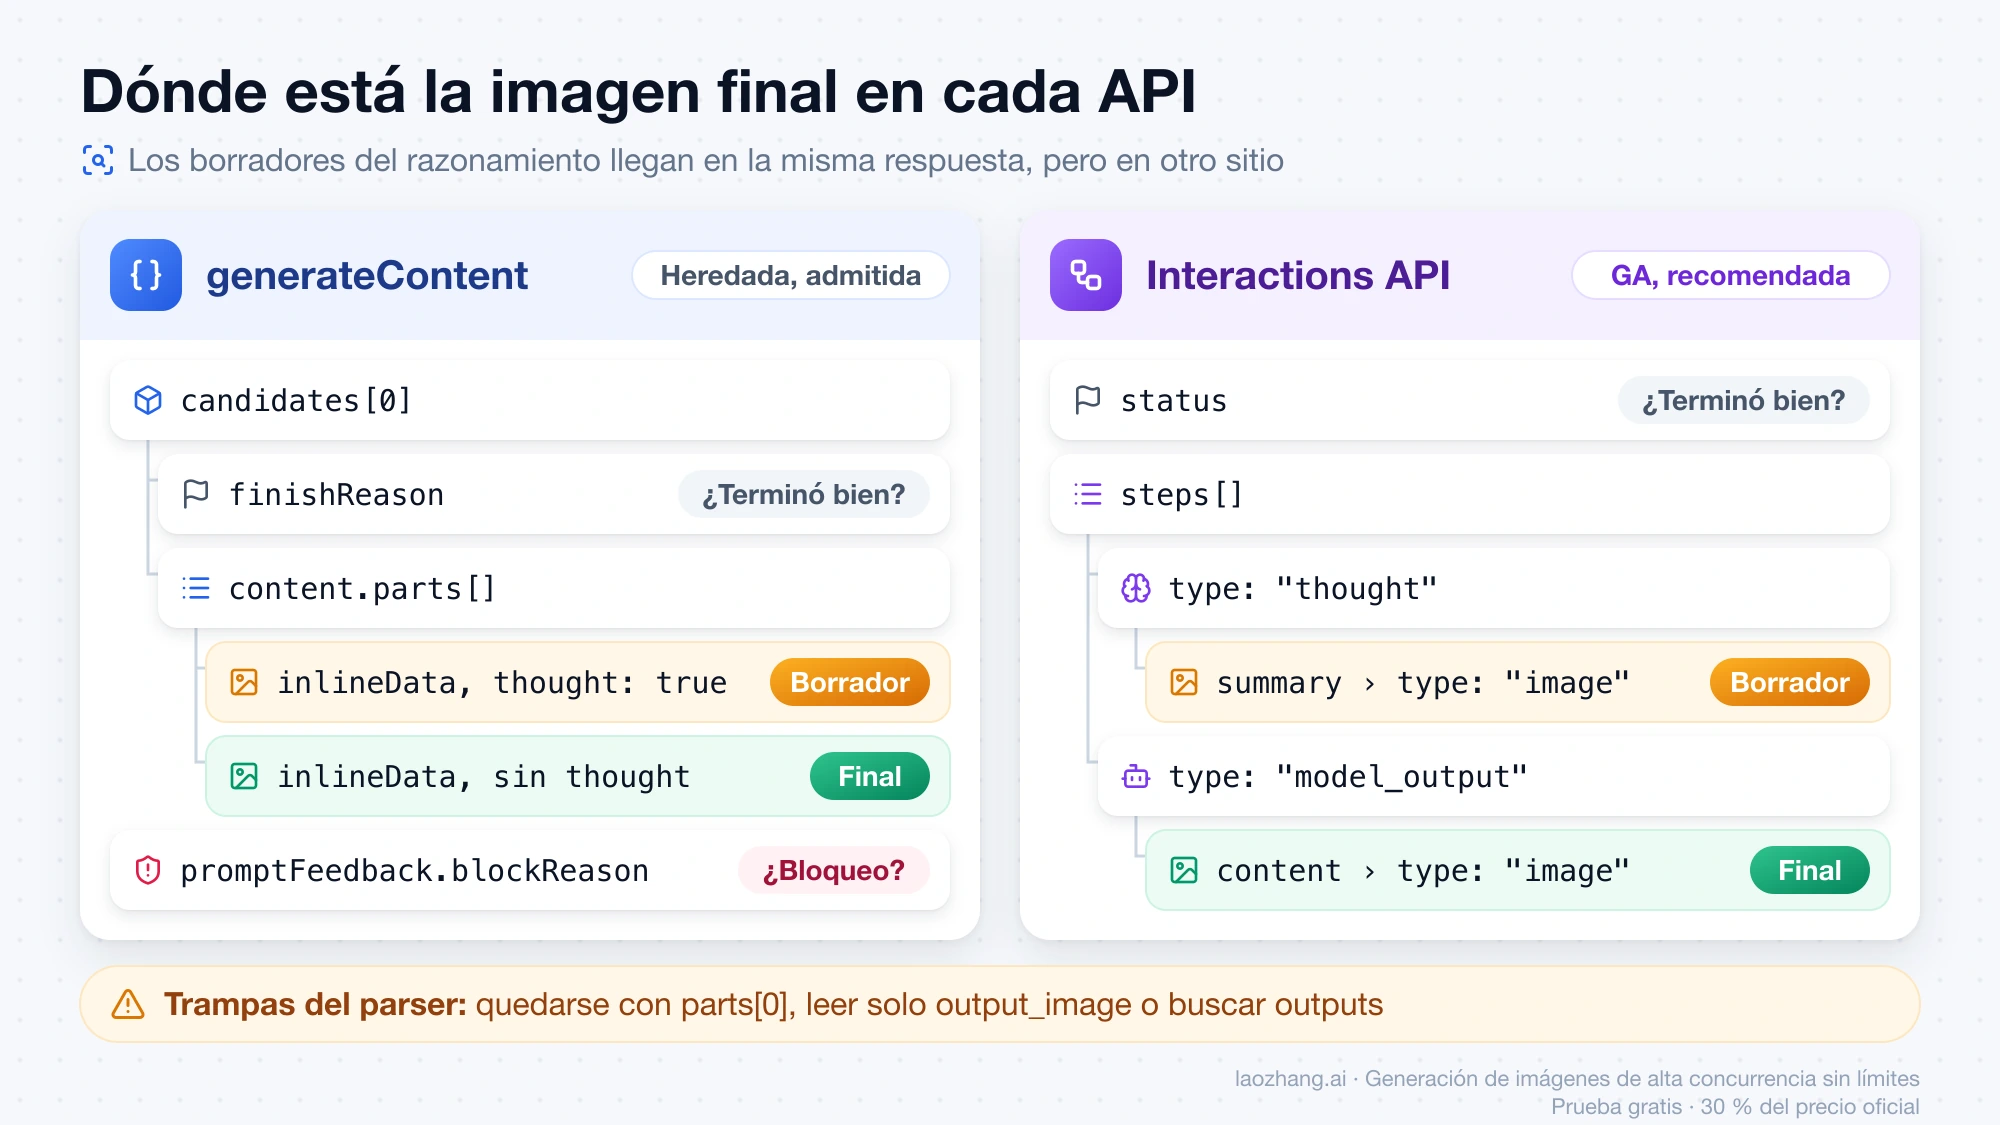
Si tu código de la Interactions API lee interaction.outputs, está escrito para el esquema anterior. Según el registro de cambios, la respuesta pasó de outputs a steps: el esquema nuevo es el predeterminado desde el 26 de mayo de 2026 y el antiguo se retiró el 8 de junio. Con google-genai 1.65.0, por ejemplo, el objeto Interaction solo define outputs; ante una respuesta con steps, ese campo queda en None y tu código informa de que no hay imagen aunque la haya. Actualiza el SDK y recorre steps. El script de más abajo lee los dos esquemas y avisa cuando encuentra el antiguo.
Si el problema aparece en la segunda vuelta de una edición conversacional y la respuesta termina en MISSING_THOUGHT_SIGNATURE, falta devolver las firmas de razonamiento. El chat de los SDK oficiales lo hace solo; si montas el historial a mano, consulta Error de Thought Signature en Nano Banana 2: Guía completa de solución (2026).
ID retirados y código que funcionaba hace unos meses
Si tu código funcionaba en primavera y ahora falla, mira primero el ID del modelo. Estas son las fechas de la página de retiradas de Google:
| ID antiguo | Estado a 24 de septiembre de 2026 | Qué usar |
|---|---|---|
gemini-3.1-flash-image-preview | Apagado el 25 de junio de 2026 | gemini-3.1-flash-image |
gemini-3-pro-image-preview | Apagado el 25 de junio de 2026 | gemini-3-pro-image |
gemini-2.5-flash-image-preview | Apagado el 15 de enero de 2026 | gemini-3.1-flash-image o gemini-3.1-flash-lite-image |
gemini-2.0-flash-preview-image-generation | Apagado el 14 de noviembre de 2025 | gemini-3.1-flash-image o gemini-3.1-flash-lite-image |
gemini-2.5-flash-image | Se apaga el 2 de octubre de 2026 | gemini-3.1-flash-image o gemini-3.1-flash-lite-image |
gemini-3.1-flash-image y gemini-3-pro-image son GA desde el 28 de mayo de 2026 y no tienen fecha de retirada anunciada. Ojo con la columna de reemplazo de esa misma página: para gemini-2.5-flash-image todavía señala gemini-3.1-flash-image-preview, que ya está apagado. La advertencia de la página de precios indica migrar a Gemini 3.1 Flash Image o a Gemini 3.1 Flash Lite Image, y la guía de imagen recomienda Nano Banana 2 Lite a quien viene del modelo original. Para elegir entre ellos por calidad y precio, tienes Nano Banana 2 Lite vs 2 vs 2.1 vs Pro: elige por tarea.
Una llamada con un ID apagado devuelve un error en lugar de una respuesta. Reintentar no cambia nada: hay que cambiar el ID. Si además tu código importa google.generativeai o @google/generative-ai, aprovecha la migración: los ejemplos oficiales actuales usan from google import genai en Python y @google/genai en JavaScript.
Los 429 no son respuestas sin imagen, sino límites de cuota o de tasa; se tratan en Límites de Nano Banana 2: cuota en Gemini, AI Mode y la API. Para 429, 408 y 5xx, la guía de Google recomienda backoff exponencial con jitter y un tope de reintentos. Los errores 400 y 403 no se reintentan.
Script para diagnosticar una respuesta guardada
nb_inspect.py lee el JSON guardado (de REST o volcado desde el SDK de Python), detecta de qué API es, clasifica el caso con la tabla anterior e imprime la acción. También cuenta imágenes finales y de razonamiento, avisa si el ID está retirado, resume los tokens por modalidad y, para los tres modelos GA, estima el coste con la tarifa Standard publicada. Solo usa la biblioteca estándar de Python 3.9 o posterior.
- Entrada: un archivo JSON; opcionalmente
--model IDsi la respuesta no trae el modelo (en los errores HTTP no viene) y--save carpetapara escribir las imágenes finales. - Salida: líneas
CASO,ACCIÓN,IMÁGENES,TOKENSy, si procede,ESTIMACIÓNyMODELO RETIRADO. - Código de salida:
0si hay imagen final,1si no la hay y2si el archivo no es válido. Sirve para cortar un pipeline antes de guardar un resultado vacío.
#!/usr/bin/env python3
"""Diagnostica una respuesta de Nano Banana guardada en JSON (generateContent o Interactions API).

Uso: python3 nb_inspect.py respuesta.json [--model ID] [--save carpeta]
Salida: una línea CASO, la acción, recuento de imágenes y tokens por modalidad.
Código de salida: 0 = hay imagen final, 1 = no hay imagen, 2 = entrada no válida.
Solo biblioteca estándar. Acepta camelCase (REST) y snake_case (volcado de SDK).
"""
import argparse, base64, json, pathlib, sys

RETIRED = {  # ID -> (fecha de retirada, sustituto recomendado)
    "gemini-3.1-flash-image-preview": ("2026-06-25", "gemini-3.1-flash-image"),
    "gemini-3-pro-image-preview": ("2026-06-25", "gemini-3-pro-image"),
    "gemini-2.5-flash-image-preview": ("2026-01-15", "gemini-3.1-flash-lite-image"),
    "gemini-2.0-flash-preview-image-generation": ("2025-11-14", "gemini-3.1-flash-lite-image"),
}
SUNSET = {"gemini-2.5-flash-image": "2026-10-02"}
# Tarifa Standard USD por 1M tokens: (entrada, salida texto+razonamiento, salida imagen)
RATES = {
    "gemini-3.1-flash-image": (0.50, 3.00, 60.00),
    "gemini-3-pro-image": (2.00, 12.00, 120.00),
    "gemini-3.1-flash-lite-image": (0.25, 1.50, 30.00),
}
POLICY = {"IMAGE_SAFETY", "PROHIBITED_CONTENT", "IMAGE_PROHIBITED_CONTENT", "BLOCKLIST", "SPII"}
ACTIONS = {
    "TEXT_ONLY": "Pide la imagen de forma explícita y limita la salida a imagen "
                 "(responseModalities ['IMAGE'] o response_format {'type': 'image'}).",
    "NO_IMAGE": "El modelo debía generar una imagen y no lo hizo: pide la imagen explícitamente, "
                "simplifica el prompt y reintenta una vez.",
    "POLICY": "Bloqueo por políticas: no repitas la misma petición. Cambia el contenido "
              "(p. ej., personas reales, contenido sexual o violento, marcas u obras ajenas); "
              "los ajustes de seguridad no lo desbloquean.",
    "SAFETY": "Lo cortó un filtro ajustable: si configuraste safetySettings, mira safetyRatings y tu umbral "
              "(sin configurar están en OFF en Gemini 2.5 y 3); si no los tocaste, cambia el contenido.",
    "PROMPT_OTHER": "Prompt bloqueado sin categoría (blockReason OTHER): puede infringir los términos o no estar admitido; "
                    "cambia el contenido en vez de reintentar.",
    "RECITATION": "Salida parecida a material existente: haz el prompt más original y quita referencias a obras concretas.",
    "OTHER": "Causa no especificada: reintenta una vez; si se repite, simplifica el prompt o las imágenes de entrada.",
    "MAX_TOKENS": "Se alcanzó el límite de salida: sube o quita maxOutputTokens / max_output_tokens.",
    "MISSING_THOUGHT_SIGNATURE": "En edición multiturno devuelve las thought signatures tal cual (o usa el chat del SDK).",
    "FAILED": "Lee errors[]: si el mensaje habla de contenido o políticas, trátalo como bloqueo; "
              "si es un fallo de plataforma, reintenta con backoff.",
    "NOT_DONE": "La interaction no ha terminado o se canceló: vuelve a consultarla con su id o atiende la acción pendiente.",
    "PUP_LIMITED_DISABLED": "Cuenta limitada por la Política de uso prohibido: no se arregla desde el código.",
}


def g(d, *names, default=None):
    """Lee un campo aceptando camelCase o snake_case."""
    for n in names:
        if isinstance(d, dict) and n in d:
            return d[n]
    return default


def check_model(model):
    notes = []
    m = (model or "").removeprefix("models/")
    if m in RETIRED:
        day, new = RETIRED[m]
        notes.append(f"MODELO RETIRADO: {m} se apagó el {day}; cambia a {new}. Reintentar no sirve.")
    elif m in SUNSET:
        notes.append(f"AVISO: {m} se apaga el {SUNSET[m]}; migra a gemini-3.1-flash-image o gemini-3.1-flash-lite-image.")
    return notes


def estimate(model, tin, ttext, timg):
    r = RATES.get((model or "").removeprefix("models/"))
    if not r:
        return None
    return (tin * r[0] + ttext * r[1] + timg * r[2]) / 1_000_000


def inspect_generate_content(d):
    cands = g(d, "candidates", default=[]) or []
    fb = g(d, "promptFeedback", "prompt_feedback", default={}) or {}
    um = g(d, "usageMetadata", "usage_metadata", default={}) or {}
    img_tok = sum(g(x, "tokenCount", "token_count", default=0) for x in
                  g(um, "candidatesTokensDetails", "candidates_tokens_details", default=[]) or []
                  if str(g(x, "modality")).upper() == "IMAGE")
    cand_tok = g(um, "candidatesTokenCount", "candidates_token_count", default=0) or 0
    usage = {"entrada": g(um, "promptTokenCount", "prompt_token_count", default=0) or 0,
             "razonamiento": g(um, "thoughtsTokenCount", "thoughts_token_count", default=0) or 0,
             "salida_texto": cand_tok - img_tok, "salida_imagen": img_tok}
    finals, thoughts, texts = [], [], []
    if not cands:
        reason = g(fb, "blockReason", "block_reason", default="SIN_CANDIDATOS")
        case = {"OTHER": "PROMPT_OTHER", "SAFETY": "SAFETY", "SIN_CANDIDATOS": "OTHER"}.get(reason, "POLICY")
        return f"PROMPT_BLOQUEADO:{reason}", case, finals, thoughts, texts, usage, None
    c = cands[0]
    for p in g(g(c, "content", default={}), "parts", default=[]) or []:
        blob = g(p, "inlineData", "inline_data")
        if blob and str(g(blob, "mimeType", "mime_type", default="")).startswith("image/"):
            (thoughts if p.get("thought") else finals).append(blob)
        elif p.get("text") and not p.get("thought"):
            texts.append(p["text"])
    fr = str(g(c, "finishReason", "finish_reason", default="SIN_FINISHREASON")).removeprefix("FinishReason.")
    msg = g(c, "finishMessage", "finish_message")
    if finals:
        return f"IMAGEN_OK:{fr}", None, finals, thoughts, texts, usage, msg
    if fr in POLICY:
        case = "POLICY"
    elif fr == "SAFETY":
        case = "SAFETY"
    elif fr in ("RECITATION", "IMAGE_RECITATION"):
        case = "RECITATION"
    elif fr in ("OTHER", "IMAGE_OTHER"):
        case = "OTHER"
    elif fr == "STOP":
        case = "TEXT_ONLY"
    else:
        case = fr if fr in ACTIONS else None
    return f"SIN_IMAGEN:{fr}", case, finals, thoughts, texts, usage, msg


def inspect_interaction(d):
    status = d.get("status")
    finals, thoughts, texts = [], [], []
    steps = d.get("steps")
    if steps is None and isinstance(d.get("outputs"), list):  # esquema antiguo (antes de mayo de 2026)
        steps = [{"type": "model_output", "content": [b for b in d["outputs"] if b.get("type") != "thought"]}]
    for step in steps or []:
        blocks = step.get("content") or [] if step.get("type") == "model_output" else step.get("summary") or []
        for b in blocks:
            if b.get("type") == "image" and b.get("data"):
                (finals if step.get("type") == "model_output" else thoughts).append(b)
            elif b.get("type") == "text" and step.get("type") == "model_output":
                texts.append(b.get("text", ""))
    u = d.get("usage") or {}
    img_tok = sum(x.get("tokens", 0) for x in u.get("output_tokens_by_modality") or [] if x.get("modality") == "image")
    usage = {"entrada": u.get("total_input_tokens", 0), "razonamiento": u.get("total_thought_tokens", 0),
             "salida_texto": u.get("total_output_tokens", 0) - img_tok, "salida_imagen": img_tok}
    msg = "; ".join(f"{e.get('code')}: {e.get('message')}" for e in d.get("errors") or []) or None
    if finals and status == "completed":
        return "IMAGEN_OK:completed", None, finals, thoughts, texts, usage, msg
    case = {"completed": "TEXT_ONLY", "incomplete": "MAX_TOKENS", "failed": "FAILED"}.get(status, "NOT_DONE")
    return f"SIN_IMAGEN:{status}", case, finals, thoughts, texts, usage, msg


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("file")
    ap.add_argument("--model", help="ID usado en la petición (si la respuesta no lo trae)")
    ap.add_argument("--save", help="carpeta donde guardar las imágenes finales")
    a = ap.parse_args()
    try:
        d = json.loads(pathlib.Path(a.file).read_text(encoding="utf-8"))
    except (OSError, json.JSONDecodeError) as e:
        print(f"ENTRADA_NO_VALIDA: {e}")
        return 2
    model = a.model or g(d, "modelVersion", "model_version") or d.get("model")
    notes = check_model(model)
    if "error" in d and isinstance(d["error"], dict):  # error HTTP: la petición ni siquiera generó
        code = d["error"].get("code")
        print(f"CASO: ERROR_HTTP:{code}  {d['error'].get('message', '')}")
        if code == 429:
            print("ACCIÓN: cuota o límite de tasa; espera con backoff exponencial o revisa tu nivel.")
        elif isinstance(code, int) and (code >= 500 or code == 408):
            print("ACCIÓN: fallo transitorio; reintenta con backoff exponencial y jitter.")
        else:
            print("ACCIÓN: error de la petición (clave, parámetros o ID de modelo); no reintentes sin cambiarla.")
        for n in notes:
            print(n)
        return 1
    if "candidates" in d or g(d, "promptFeedback", "prompt_feedback") is not None:
        api, res = "generateContent", inspect_generate_content(d)
    elif "status" in d:
        api, res = "Interactions", inspect_interaction(d)
    else:
        print("ENTRADA_NO_VALIDA: no parece generateContent (candidates) ni Interactions (status/steps)")
        return 2
    label, case, finals, thoughts, texts, usage, msg = res
    print(f"API: {api}   MODELO: {model or 'desconocido'}")
    print(f"CASO: {label}")
    if msg:
        print(f"DETALLE: {msg}")
    print(f"IMÁGENES: finales={len(finals)} razonamiento={len(thoughts)}   TEXTO: {len(texts)} bloque(s)")
    if case:
        print(f"ACCIÓN: {ACTIONS[case]}")
    elif not finals:
        print("ACCIÓN: valor no reconocido; guarda el JSON completo y revisa status/errors o finishReason.")
    if thoughts and not finals:
        print("NOTA: solo hay imágenes de razonamiento (thought) y ninguna final; revisa el caso antes de usarlas.")
    if api == "Interactions" and "outputs" in d and "steps" not in d:
        print("NOTA: esquema antiguo 'outputs'; la API actual devuelve 'steps'. Actualiza el SDK y recorre steps.")
    if len(finals) > 1:
        print("NOTA: hay varias imágenes finales; output_image o parts[0] no las recogen todas.")
    for n in notes:
        print(n)
    if not any(usage.values()):
        print("TOKENS: la respuesta no trae campos de uso; consulta el consumo en tu panel de facturación.")
        cost = None
    else:
        print("TOKENS: " + "  ".join(f"{k}={v}" for k, v in usage.items()))
        cost = estimate(model, usage["entrada"], usage["razonamiento"] + usage["salida_texto"], usage["salida_imagen"])
    if cost is not None:
        print(f"ESTIMACIÓN (tarifa Standard publicada, no es la factura): {cost:.6f} USD")
    if a.save and finals:
        out = pathlib.Path(a.save)
        out.mkdir(parents=True, exist_ok=True)
        for i, b in enumerate(finals, 1):
            ext = str(g(b, "mimeType", "mime_type", default="image/png")).split("/")[-1]
            (out / f"imagen_{i}.{ext}").write_bytes(base64.b64decode(b["data"]))
        print(f"GUARDADAS: {len(finals)} en {out}")
    return 0 if finals else 1


if __name__ == "__main__":
    sys.exit(main())
Esta es la salida con una respuesta de ejemplo de Nano Banana Pro bloqueada por IMAGE_SAFETY:
$ python3 nb_inspect.py gc_image_safety.json
API: generateContent   MODELO: gemini-3-pro-image
CASO: SIN_IMAGEN:IMAGE_SAFETY
DETALLE: (texto de ejemplo)
IMÁGENES: finales=0 razonamiento=0   TEXTO: 0 bloque(s)
ACCIÓN: Bloqueo por políticas: no repitas la misma petición. Cambia el contenido (p. ej., personas reales, contenido sexual o violento, marcas u obras ajenas); los ajustes de seguridad no lo desbloquean.
TOKENS: entrada=20  razonamiento=210  salida_texto=0  salida_imagen=0
ESTIMACIÓN (tarifa Standard publicada, no es la factura): 0.002560 USD
Y esta, con una historia ilustrada de la Interactions API con dos imágenes intercaladas y una imagen de razonamiento:
$ python3 nb_inspect.py int_interleaved.json --save out
API: Interactions   MODELO: gemini-3-pro-image
CASO: IMAGEN_OK:completed
IMÁGENES: finales=2 razonamiento=1   TEXTO: 2 bloque(s)
NOTA: hay varias imágenes finales; output_image o parts[0] no las recogen todas.
TOKENS: entrada=20  razonamiento=300  salida_texto=60  salida_imagen=2240
ESTIMACIÓN (tarifa Standard publicada, no es la factura): 0.273160 USD
GUARDADAS: 2 en out
El script se probó sin conexión el 24 de septiembre de 2026 con Python 3.12 sobre 25 archivos: 18 JSON de ejemplo escritos a mano (los casos de la tabla, el esquema antiguo outputs y dos entradas no válidas) y 7 volcados generados al pasar varios de esos ejemplos por los tipos del SDK google-genai en sus versiones 1.65.0 y 2.25.0. Todos dieron el caso y el código de salida esperados. No se ha ejecutado contra llamadas reales a Google, así que los tokens y los textos de error de los ejemplos son inventados. En la Interactions API, la documentación no muestra cómo se representa un bloqueo de imagen: con status: "failed", el script se limita a enseñarte errors[] sin inventar campos.
Cuánto te costó la llamada que no trajo imagen
Google cobra la Gemini API por tokens y por modalidad, y no publica ninguna regla sobre si una respuesta bloqueada se factura entera o sale gratis. La forma de saberlo es leer el consumo de esa llamada: usageMetadata en generateContent (promptTokenCount, thoughtsTokenCount, candidatesTokenCount y su desglose candidatesTokensDetails por modalidad) y usage en la Interactions API (total_input_tokens, total_thought_tokens, total_output_tokens y output_tokens_by_modality).
Tarifas Standard de pago publicadas a 24 de septiembre de 2026, en USD por millón de tokens. Ninguno de estos modelos tiene nivel gratuito para salida de imagen:
| Modelo | Entrada | Salida de texto y razonamiento | Salida de imagen | Equivalencia por imagen |
|---|---|---|---|---|
Nano Banana 2 (gemini-3.1-flash-image) | USD 0,50 | USD 3 | USD 60 | 1K = 1.120 tokens ≈ USD 0,067; 4K ≈ USD 0,151 |
Nano Banana Pro (gemini-3-pro-image) | USD 2 | USD 12 | USD 120 | 1K/2K ≈ USD 0,134; 4K ≈ USD 0,24 |
Nano Banana 2 Lite (gemini-3.1-flash-lite-image) | USD 0,25 | USD 1,50 | USD 30 | Solo 1K: 1.120 tokens ≈ USD 0,0336 |
Dos detalles de la documentación afectan a las llamadas fallidas: los tokens de razonamiento se facturan los veas o no, y las imágenes provisionales del razonamiento no se cobran. Con eso, la estimación es:
coste ≈ (entrada × tarifa de entrada + (razonamiento + texto) × tarifa de texto + tokens de imagen × tarifa de imagen) ÷ 1.000.000
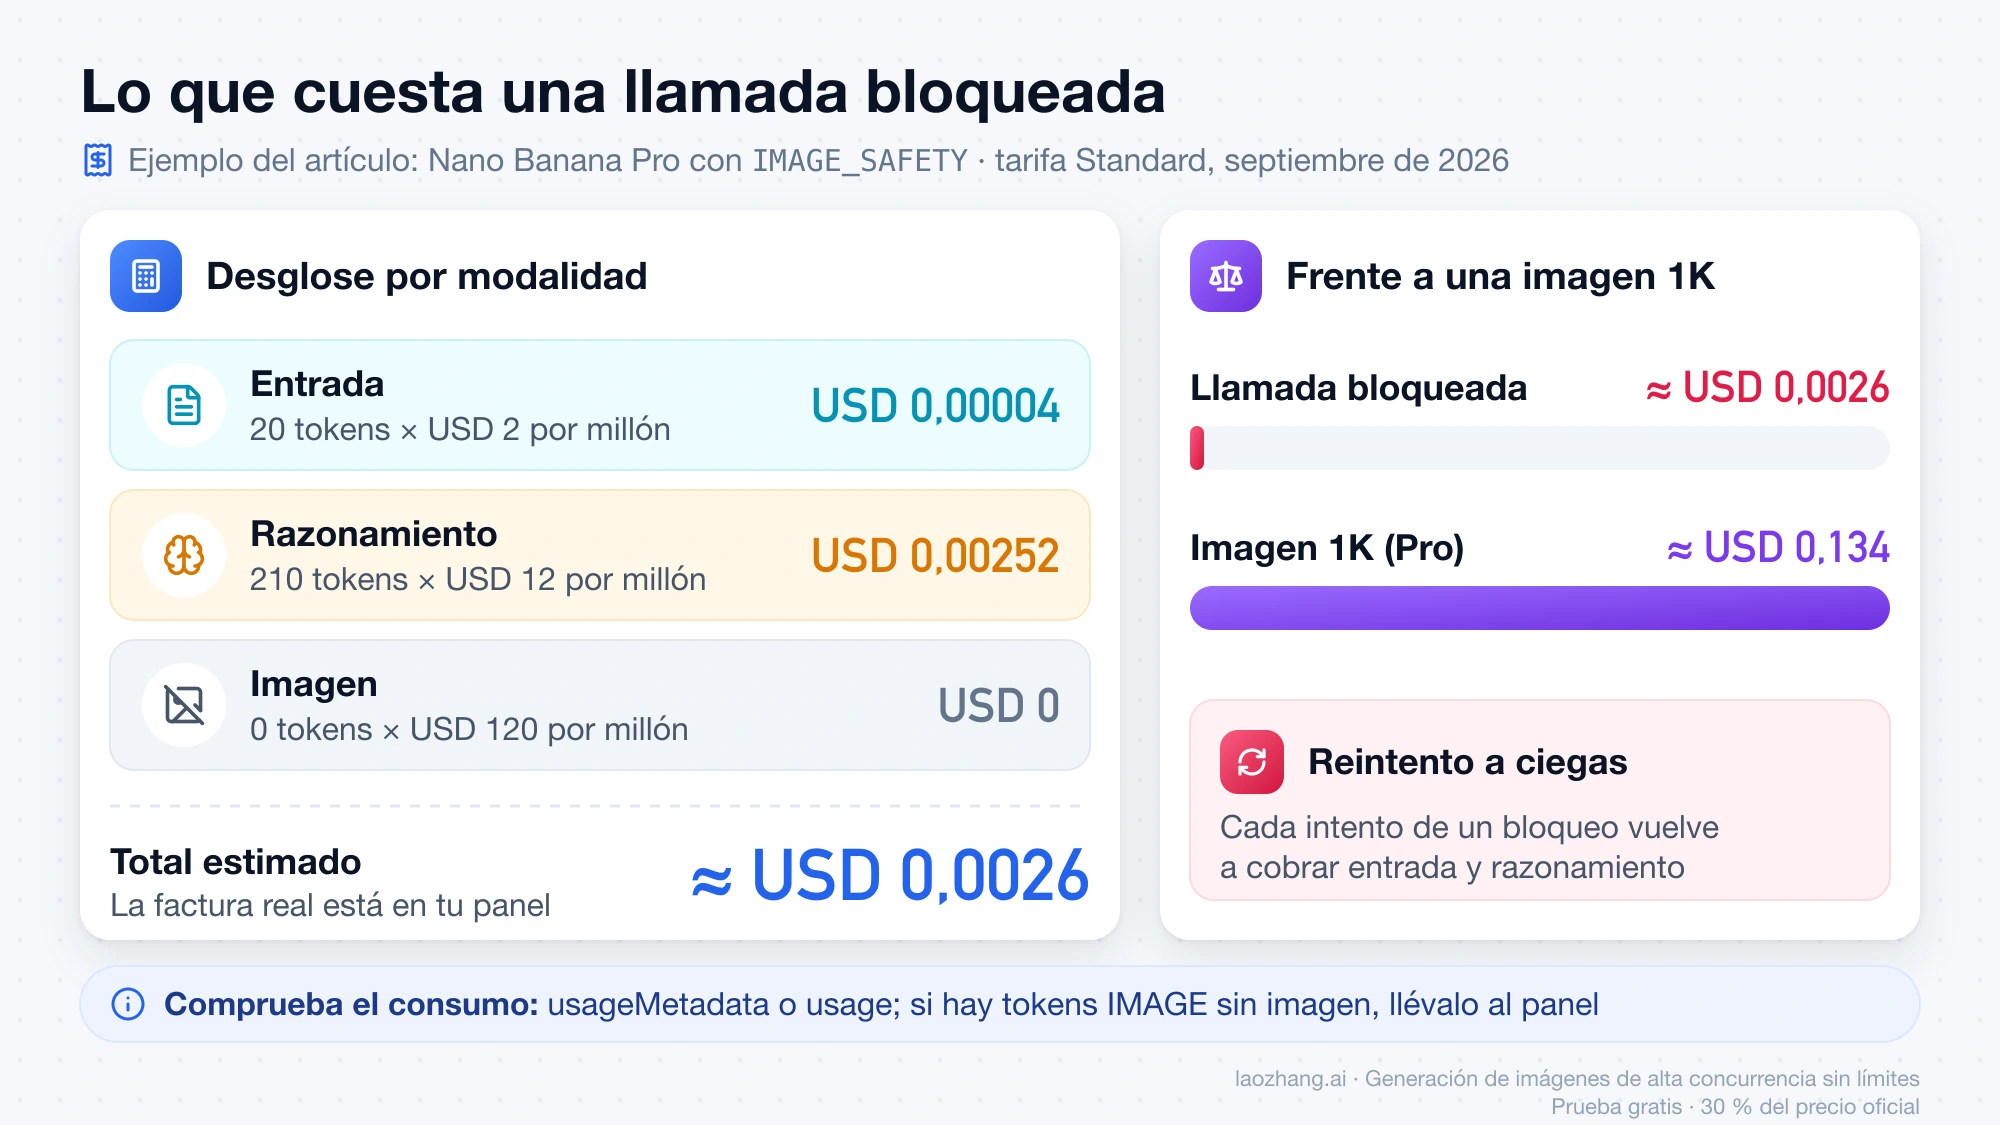
En el ejemplo inventado de Nano Banana Pro bloqueado por IMAGE_SAFETY (20 tokens de entrada, 210 de razonamiento, 0 de imagen), el resultado es (20 × 2 + 210 × 12) ÷ 1.000.000 ≈ USD 0,0026, frente a unos USD 0,134 de una imagen 1K. Si en tu respuesta real el desglose trae tokens IMAGE aunque no haya imagen, ese es el dato que conviene llevar al panel de facturación, que es el que manda. Al reintentar a ciegas un bloqueo por políticas, en cambio, cada intento vuelve a consumir entrada y razonamiento para el mismo resultado.
Preguntas frecuentes
¿Por qué la API devuelve 200 si no hay imagen?
Porque la petición se procesó: el servidor recibió el prompt, lo evaluó y contestó. Que no haya imagen es un resultado de la generación y se indica dentro del cuerpo (finishReason, promptFeedback.blockReason o status), no con el código HTTP. Comprueba siempre el cuerpo antes de dar la llamada por buena.
¿Poner BLOCK_NONE o OFF en todas las categorías arregla IMAGE_SAFETY?
No. Los umbrales ajustables solo cubren acoso, incitación al odio, contenido sexual explícito y contenido peligroso, y en Gemini 2.5 y 3 ya están en OFF si no los tocas. IMAGE_SAFETY y PROHIBITED_CONTENT no forman parte de esos ajustes: toca cambiar el contenido.
Uso AI Studio y solo recibo texto, ¿es otro problema?
Son los mismos modelos y los mismos casos. Pide la imagen de forma explícita, revisa en Run settings si has endurecido los ajustes de seguridad y, si necesitas ver finishReason, repite la petición por la API y guarda el JSON.
¿Me cobran igual una respuesta bloqueada que una imagen?
Google no publica una regla específica para ese caso. Mira usageMetadata o usage de esa llamada: si el desglose por modalidad no trae tokens de imagen, la parte cara (USD 60 o USD 120 por millón de tokens de imagen) no aparece en el consumo, aunque la entrada y el razonamiento sí cuentan.
Documentación oficial
Los parámetros de la solicitud, los precios y las reglas de cobro están en la documentación para desarrolladores de LaoZhang API: facturación y fallos en la generación de imágenes.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 24 sept 2026.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 24 sept 2026.
- 1.Interactions APIai.google.dev/gemini-api/docs/interactions-overview
- 2.referencia de generateContentai.google.dev/api/generate-content
- 3.el modelo devuelve por defecto texto e imagenai.google.dev/gemini-api/docs/image-generation
- 4.guía de ajustes de seguridadai.google.dev/gemini-api/docs/safety-settings
- 5.guía de solución de problemasai.google.dev/gemini-api/docs/troubleshooting
- 6.registro de cambiosai.google.dev/gemini-api/docs/changelog
- 7.página de retiradas de Googleai.google.dev/gemini-api/docs/deprecations
- 8.página de preciosai.google.dev/gemini-api/docs/pricing