Gemini 3 Pro Image Batch API: imágenes con un 50% de descuento
Genera imágenes por lotes con el descuento oficial del 50%, incluyendo entrada y razonamiento en el presupuesto. Un ejemplo con JSONL te permite conservar el trabajo y recuperar sus resultados sin reenviarlo a ciegas.
En esta página
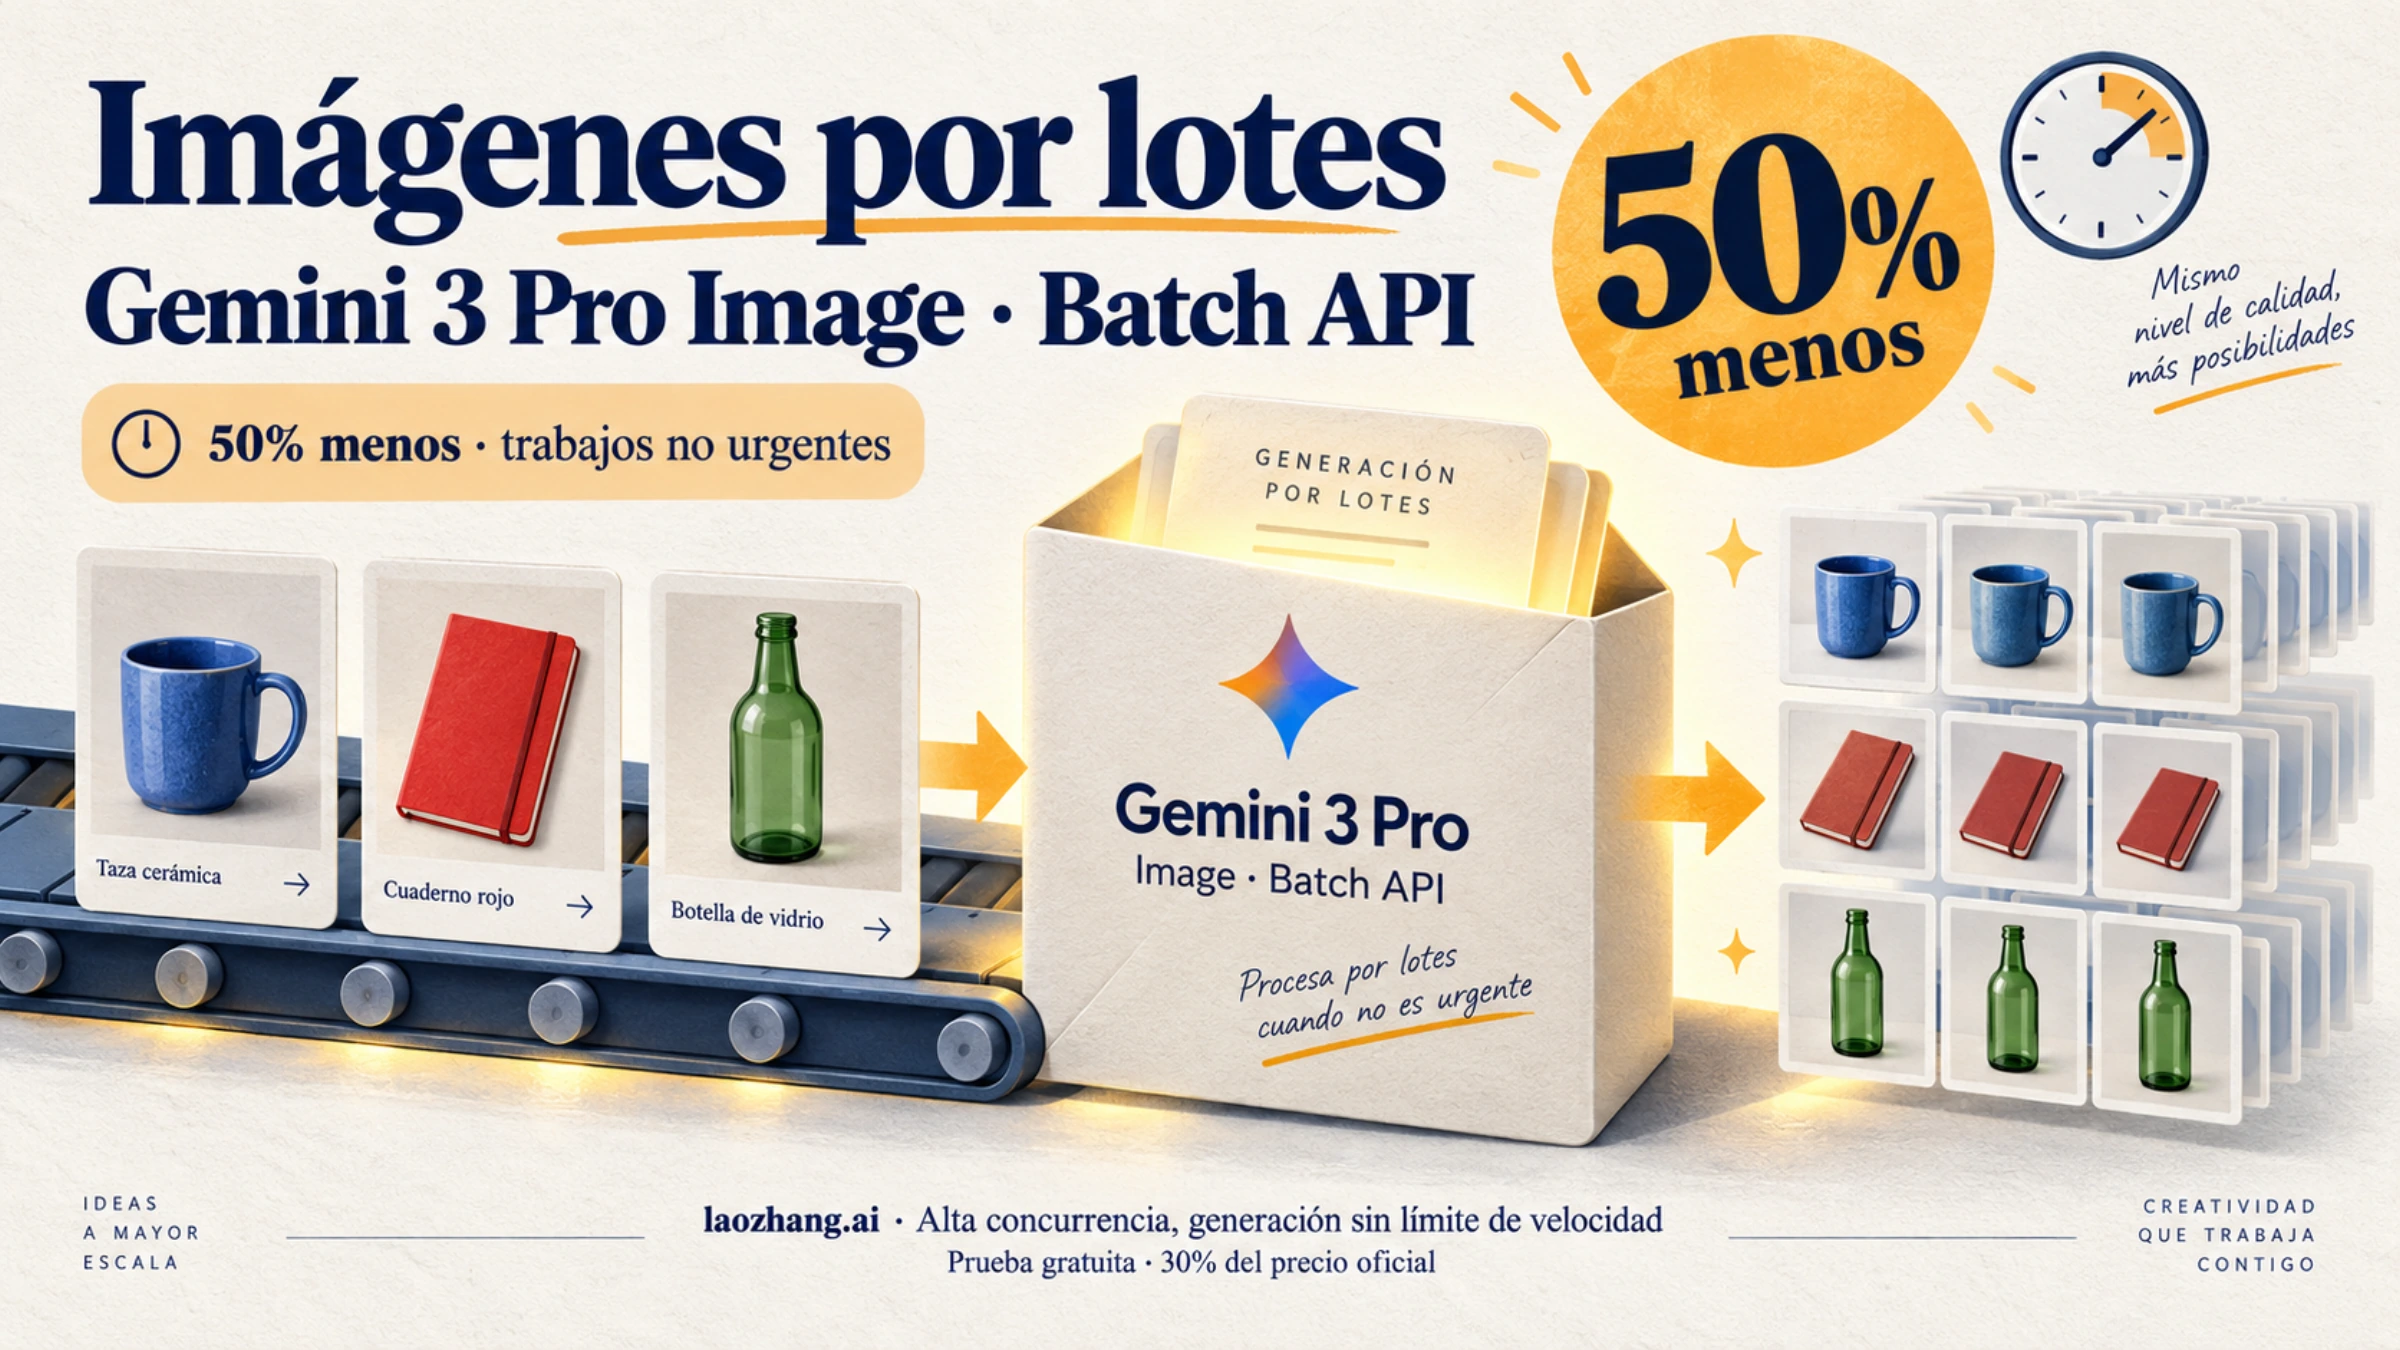
La Batch API oficial de Gemini 3 Pro Image cuesta un 50% menos que la modalidad Standard para solicitudes equivalentes. Es una opción útil para preparar imágenes de un catálogo, variantes de una campaña o ilustraciones que no necesitas recibir al instante. Google fija un objetivo de procesamiento de 24 horas; úsalo para planificar, sin convertirlo en una hora de entrega garantizada. El descuento corresponde a la API para desarrolladores, no a una suscripción de la aplicación Gemini. Fuente: Batch API de Google.
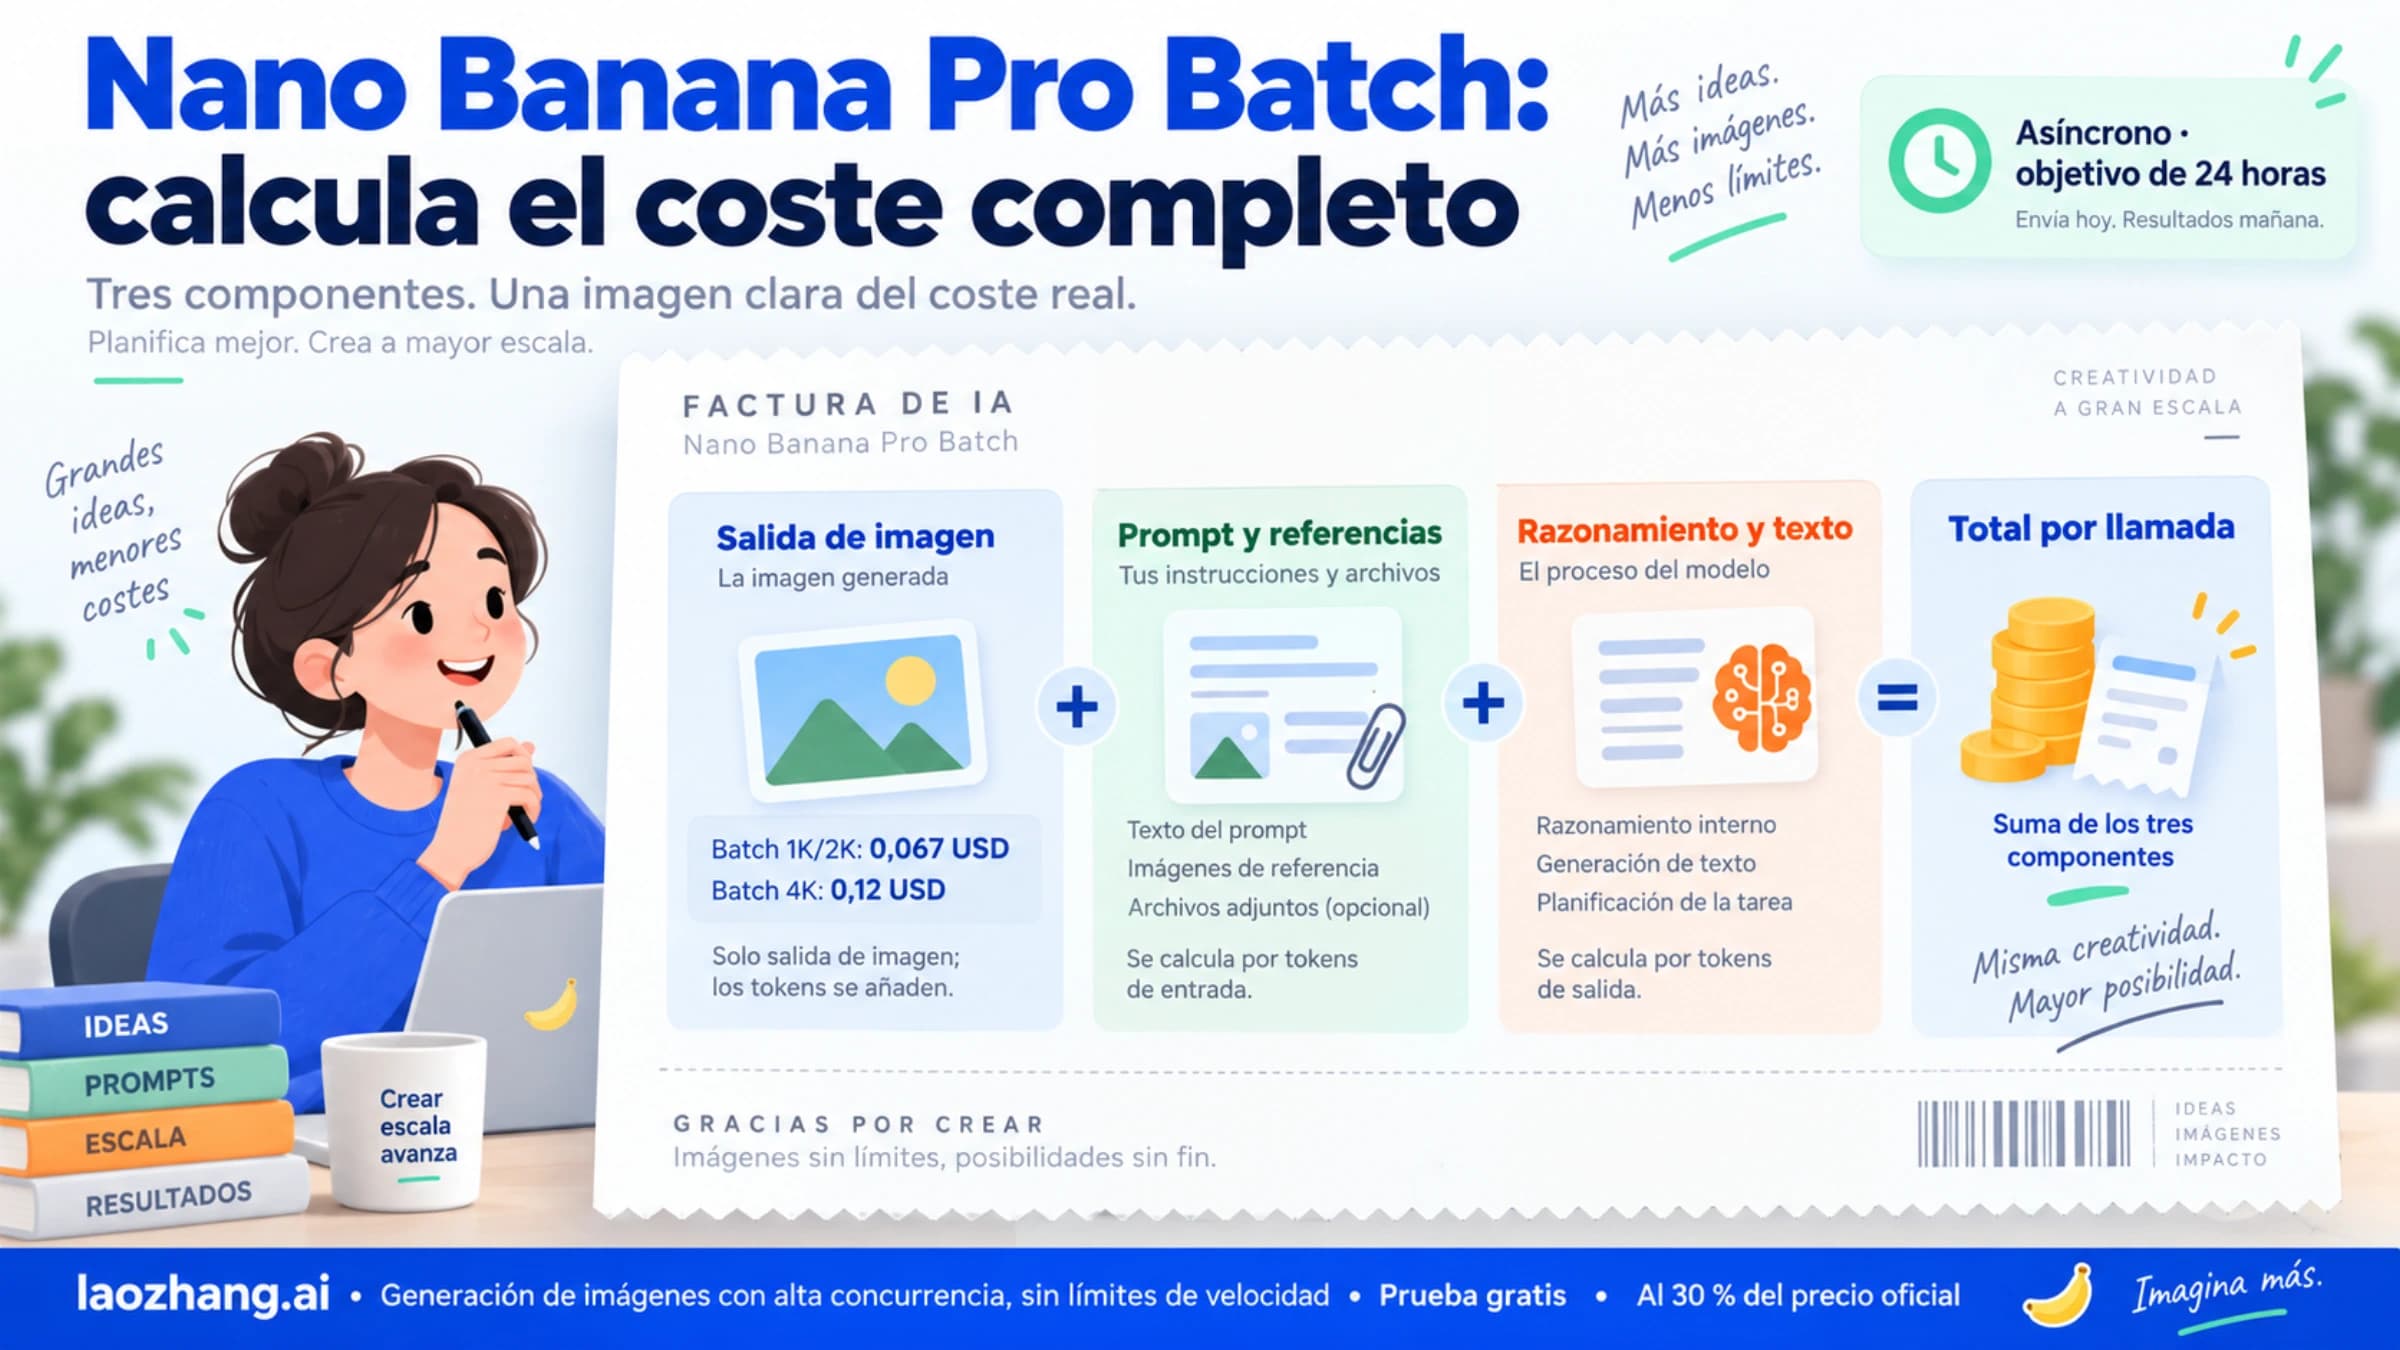
Para una imagen de salida de 1K o 2K, la tabla oficial muestra 0,067 USD en Batch; para 4K, 0,12 USD. A ese importe debes añadir la entrada y la salida de texto y razonamiento. Más adelante calculamos un lote completo y seguimos un recorrido con archivos JSONL: preparar solicitudes, enviar una sola vez, guardar el nombre del trabajo y recuperar las imágenes mediante su key. Fuente: precios de Gemini 3 Pro Image.
Cuánto cuesta el lote y cuánto cuesta una imagen que puedes usar
Estas son las tarifas consultadas el 6 de octubre de 2026, en USD y para gemini-3-pro-image en la Gemini Developer API. Las filas de imágenes representan generación o entrada de imagen; no son una tarifa total por pedido.
| Concepto | Standard | Batch |
|---|---|---|
| Texto de entrada, por millón de tokens | 2 USD | 1 USD |
| Una imagen de referencia de entrada | Aproximadamente 0,0011 USD | Aproximadamente 0,0006 USD |
| Texto de salida y razonamiento, por millón de tokens | 12 USD | 6 USD |
| Imagen de salida de 1K o 2K | 0,134 USD | 0,067 USD |
| Imagen de salida de 4K | 0,24 USD | 0,12 USD |
Tabla y notas de precios de Google. La imagen de entrada se contabiliza con 560 tokens. Para 1K/2K, Google indica 1.120 tokens de salida de imagen: el cálculo sin redondear da 0,1344 USD en Standard y 0,0672 USD en Batch. Para 4K son 2.000 tokens: 0,24 y 0,12 USD. En los cálculos siguientes usamos esos valores sin redondear, evitando acumular el redondeo de la tabla en cada imagen.
Ejemplo: 600 imágenes de producto en 2K
Supongamos que encargas 600 imágenes, cada solicitud con una referencia y 180 tokens de texto de entrada. Para presupuestar, reservas además 900 tokens de texto y razonamiento de salida por solicitud. Son supuestos de cálculo, no mediciones del modelo ni una previsión de cuántos tokens consumirá tu catálogo.
| Parte del presupuesto Batch | Operación | Coste |
|---|---|---|
| Salida de 600 imágenes 2K | 600 × 0,0672 | 40,32 USD |
| 600 referencias | 600 × 560 / 1.000.000 × 1 | 0,336 USD |
| Texto de entrada | 600 × 180 / 1.000.000 × 1 | 0,108 USD |
| Texto y razonamiento de salida | 600 × 900 / 1.000.000 × 6 | 3,24 USD |
| Total bajo estos supuestos | Suma de las cuatro filas | 44,004 USD |
El mismo consumo en Standard sería 88,008 USD. El descuento del 50% se conserva al comparar los mismos consumos; no significa que cualquier dos ejecuciones vayan a producir el mismo consumo o resultado. Gemini 3 Pro Image utiliza razonamiento y sus tokens se facturan aunque no los veas en la respuesta. Proceso de razonamiento en la generación de imágenes.
Ahora cambia el denominador. Si se generan 570 imágenes finales y apruebas 540 para publicar, el gasto hipotético de 44,004 USD representa:
- 0,07334 USD por solicitud enviada: 44,004 / 600.
- 0,0772 USD por imagen final recibida: 44,004 / 570.
- 0,081489 USD por imagen aprobada: 44,004 / 540, aproximadamente.
Este segundo cálculo presupone un gasto total observado de 44,004 USD; no afirma que los fallos o respuestas sin imagen cuesten lo mismo que una generación completa. Para tus cifras reales, utiliza el consumo facturado y cuenta las imágenes finales que realmente has recibido y aceptado. Si regeneras, incorpora el gasto de esos nuevos intentos al numerador y las nuevas imágenes aceptadas al denominador.
Los importes tampoco incluyen impuestos, cambio de moneda, almacenamiento propio ni herramientas adicionales. La tabla Batch consultada no detalla una tarifa de Google Search: no deduzcas que toda búsqueda u otra herramienta sea gratuita por usar un lote.
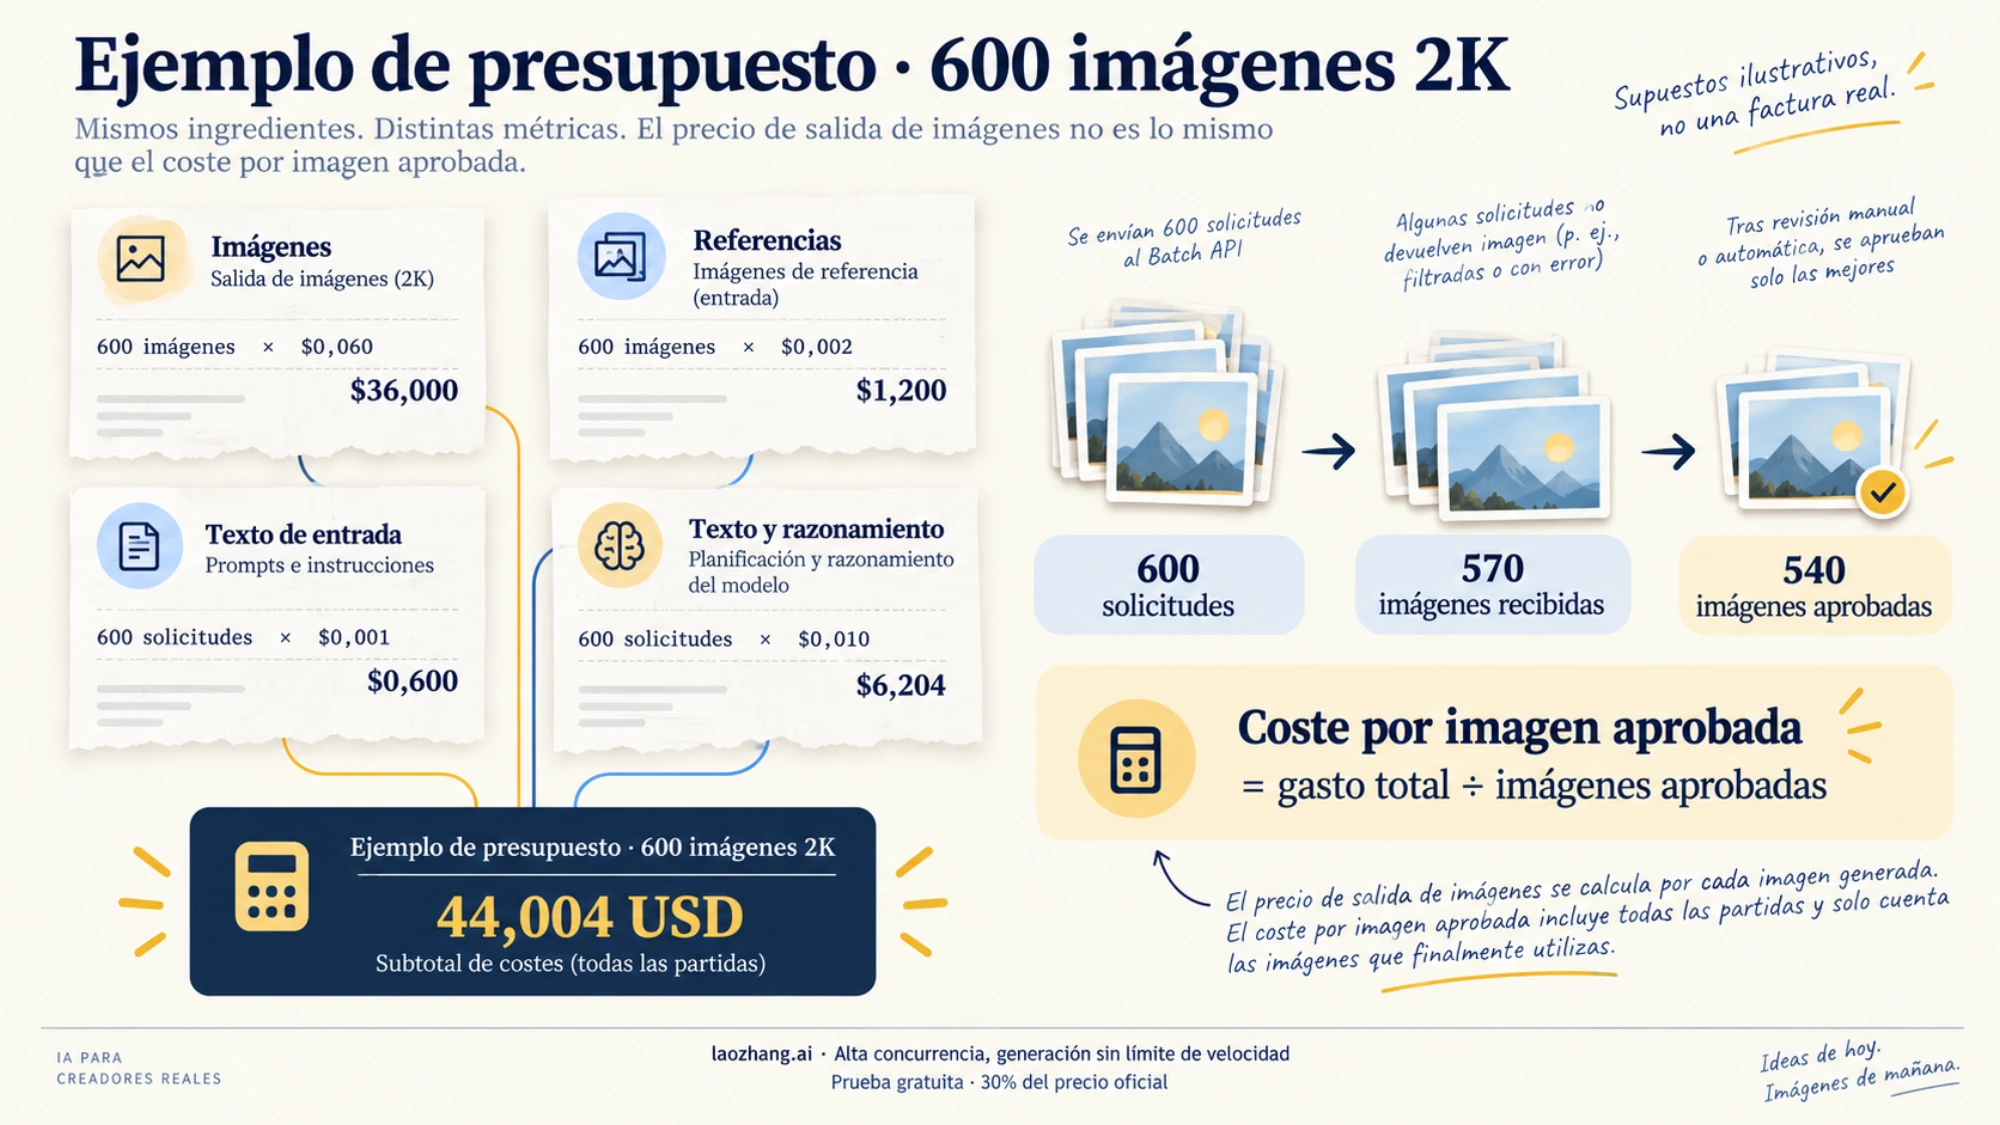
Ilustración del presupuesto hipotético y sus distintos denominadores; no representa una factura ni resultados medidos.
Qué preparar antes de enviar solicitudes
Usa gemini-3-pro-image, el identificador estable que figura en la ficha actual. Algunos ejemplos de Batch todavía muestran el alias gemini-3-pro-image-preview; conviene distinguir el ejemplo histórico del modelo que vas a solicitar. La ficha confirma compatibilidad con Batch y con entrada y salida de imagen y texto. Ficha del modelo.
Necesitas un proyecto con acceso y facturación para este modelo, una clave de la Gemini Developer API y el SDK Python actual google-genai disponible en tu entorno. La fila de precios de este modelo no ofrece un nivel gratuito de API. Las posibles imágenes gratuitas de la aplicación Gemini pertenecen a otro producto y no pagan tus llamadas a Batch.
El ejemplo utiliza dos solicitudes de texto a imagen, sin referencias ni búsqueda, para que puedas seguir el recorrido con pocos elementos. Primero comprueba que las instrucciones representan lo que quieres producir; después amplía el archivo. Google admite solicitudes insertadas directamente para lotes de menos de 20 MB y archivos de entrada de hasta 2 GB; para generar muchas imágenes recomienda el archivo JSONL. Formatos de entrada de Batch.
En el JSON de cada solicitud necesitas estas opciones:
"generationConfig": {
  "responseModalities": ["TEXT", "IMAGE"],
  "imageConfig": {
    "aspectRatio": "1:1",
    "imageSize": "2K"
  }
}
responseModalities solicita imagen además de texto. imageSize admite 1K, 2K y 4K en Pro; que el esquema genérico mencione 512 no habilita ese tamaño en este modelo. 1:1 evita depender de formatos que el esquema general admite pero Pro no necesariamente soporta. Referencia de configuración de imagen.
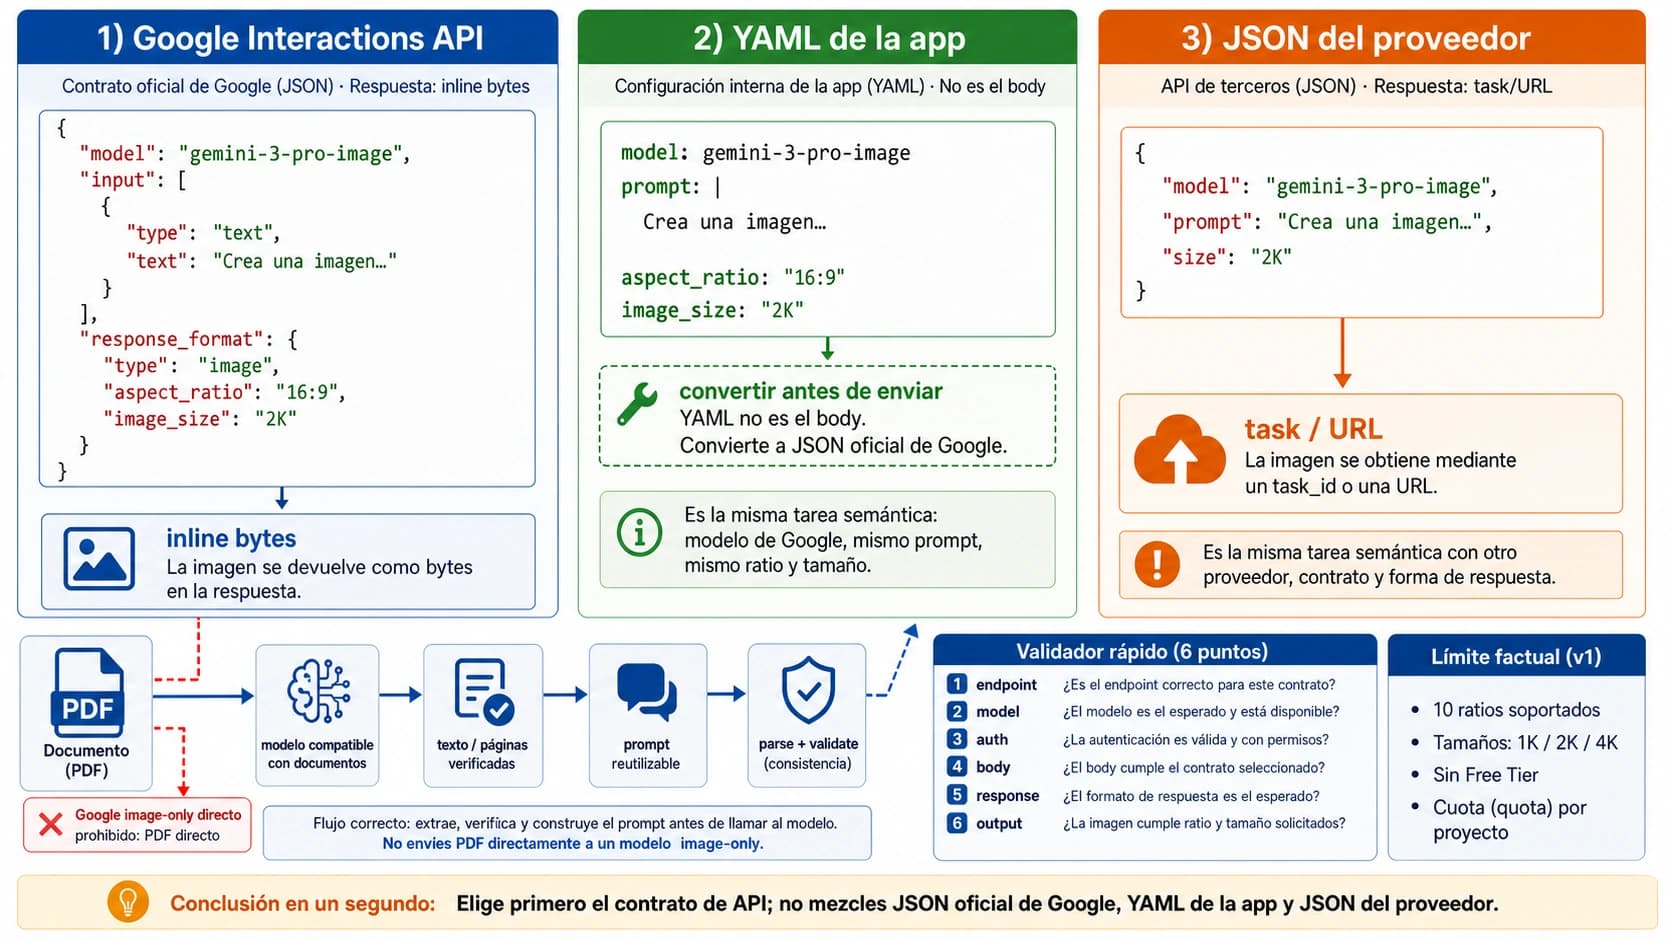
Mantén separados los nombres: el archivo contiene JSON de GenerateContent, con generationConfig, responseModalities e imageConfig; los objetos de configuración del SDK Python usan nombres como display_name y mime_type. El campo de instrucciones response_format de otros ejemplos de generación no sustituye la configuración de este Batch.
Envía el archivo una vez y guarda el nombre del trabajo
Guarda lo siguiente como enviar_lote.py. Prepara previamente GEMINI_API_KEY en tu entorno, sin escribir la clave en el archivo. Al ejecutarlo, subes un archivo y creas un trabajo de pago. El ejemplo impide volver a enviarlo mientras exista envio.json; conserva ese registro junto a solicitudes.jsonl.
import json
import os
import uuid
from pathlib import Path
from google import genai
from google.genai import types

registro = Path("envio.json")
if registro.exists():
    raise SystemExit("Ya hay un envío registrado. Revísalo antes de crear otro.")

instrucciones = {
    "taza-azul": "Una taza azul de cerámica sobre fondo blanco, fotografía de producto, sin texto.",
    "cuaderno-rojo": "Un cuaderno rojo cerrado sobre fondo blanco, fotografía de producto, sin texto.",
}
archivo = Path("solicitudes.jsonl")
with archivo.open("w", encoding="utf-8") as salida:
    for clave, texto in instrucciones.items():
        linea = {
            "key": clave,
            "request": {
                "contents": [{"role": "user", "parts": [{"text": texto}]}],
                "generationConfig": {
                    "responseModalities": ["TEXT", "IMAGE"],
                    "imageConfig": {"aspectRatio": "1:1", "imageSize": "2K"},
                },
            },
        }
        salida.write(json.dumps(linea, ensure_ascii=False) + "\n")

cliente = genai.Client(
    vertexai=False,
    api_key=os.environ["GEMINI_API_KEY"],
    http_options=types.HttpOptions(
        timeout=60_000, retry_options=types.HttpRetryOptions(attempts=1)
    ),
)
subido = cliente.files.upload(
    file=str(archivo),
    config=types.UploadFileConfig(mime_type="jsonl", display_name="catalogo-entrada"),
)
datos = {
    "estado_local": "envio_por_confirmar",
    "display_name": "catalogo-" + uuid.uuid4().hex,
    "archivo_subido": subido.name,
    "claves": list(instrucciones),
}

def guardar(modo):
    with registro.open(modo, encoding="utf-8") as f:
        json.dump(datos, f, ensure_ascii=False, indent=2)
        f.flush()
        os.fsync(f.fileno())

guardar("x")  # Deja constancia antes de crear el trabajo.
trabajo = cliente.batches.create(
    model="gemini-3-pro-image",
    src=subido.name,
    config={"display_name": datos["display_name"]},
)
datos.update(estado_local="creado", nombre=trabajo.name)
guardar("w")
print("Nombre que debes conservar:", trabajo.name)
El cliente selecciona explícitamente la Developer API con vertexai=False y configura un único intento por llamada, sin reintentos automáticos. El timeout se expresa en milisegundos en el SDK. Implementación oficial de la configuración de red.
Cada línea conserva una key propia. No asocies la primera respuesta con el primer producto por su posición: utiliza el identificador. La fuente del SDK es subido.name, una cadena con el nombre del archivo, no el objeto subido. Ejemplo oficial de imágenes mediante archivo.
La creación de un trabajo no es idempotente: repetir la misma llamada puede crear otro lote. Si el script se interrumpe después de enviar la petición y antes de guardar nombre, el registro queda en envio_por_confirmar. Busca el trabajo usando el display_name único y el archivo conservado, y confirma qué se creó antes de volver a enviar. El registro reduce el riesgo; no hace atómica la operación entre tu disco y Google. No borres el registro para resolver automáticamente un error de red. Condiciones de creación y reintento.
Consulta el mismo trabajo y descarga los resultados
Guarda este segundo archivo como descargar_lote.py. Lee el nombre ya persistido; no crea otro trabajo. Consulta durante 30 minutos por ejecución, con un timeout de red de 60 segundos, y puedes volver a ejecutarlo después para continuar esperando. Una llamada ya iniciada puede terminar después del límite local.
import json
import os
import time
from pathlib import Path
from google import genai
from google.genai import types

registro = json.loads(Path("envio.json").read_text(encoding="utf-8"))
nombre = registro.get("nombre")
if not nombre:
    raise SystemExit("Falta el nombre del trabajo: confirma primero el envío.")
cliente = genai.Client(
    vertexai=False,
    api_key=os.environ["GEMINI_API_KEY"],
    http_options=types.HttpOptions(
        timeout=60_000, retry_options=types.HttpRetryOptions(attempts=1)
    ),
)
terminales = {
    "JOB_STATE_SUCCEEDED", "JOB_STATE_FAILED",
    "JOB_STATE_CANCELLED", "JOB_STATE_EXPIRED",
}
limite = time.monotonic() + 30 * 60
while True:
    if time.monotonic() >= limite:
        raise SystemExit("Termina la espera local. El trabajo sigue en Google.")
    trabajo = cliente.batches.get(name=nombre)
    estado = trabajo.state.name
    print(nombre, estado)
    if estado in terminales:
        break
    restante = limite - time.monotonic()
    if restante <= 0:
        raise SystemExit("Termina la espera local. El trabajo sigue en Google.")
    time.sleep(min(60, restante))

if estado != "JOB_STATE_SUCCEEDED":
    raise SystemExit(f"Estado final {estado}; detalle: {trabajo.error}")
if not trabajo.dest or not trabajo.dest.file_name:
    raise SystemExit("No hay archivo de resultados. Conserva el trabajo y revisa su destino.")
contenido = cliente.files.download(file=trabajo.dest.file_name)
Path("resultados.jsonl").write_bytes(contenido)
print("Archivo descargado: resultados.jsonl")
Los estados PENDING y RUNNING indican que aún debes esperar; los cuatro estados finales aparecen en el código con su nombre completo. El plazo local de 30 minutos solo termina la espera del script. No cancela el trabajo ni demuestra que no haya gasto. Google indica que un lote que permanece pendiente o en ejecución durante 48 horas pasa a EXPIRED sin resultados. Los resultados de trabajos completados se conservan para descarga durante seis semanas: descárgalos y archívalos antes. Estados y recuperación de resultados.
Extrae las imágenes por identificador y separa los fallos
Que el lote termine en SUCCEEDED no implica que cada elemento haya entregado una imagen válida. El archivo descargado contiene JSONL en bytes UTF-8: cada fila puede tener response, error o un estado. En este JSON bruto, las imágenes llegan en inlineData.data como Base64. En cambio, cuando trabajas directamente con partes del SDK, part.as_image() convierte la parte a imagen; no vuelvas a descodificar unos bytes que el SDK ya haya descodificado. Formato oficial de resultados de imagen.
Guarda el siguiente archivo como extraer_imagenes.py. Se ejecuta localmente sobre los dos JSONL y no llama a Google. Conserva todos los archivos descargados; el informe te permite revisar únicamente los productos sin una imagen final recuperada.
import base64
import binascii
import json
import re
from pathlib import Path

def extraer(entrada, resultados, carpeta):
    solicitudes = [json.loads(x) for x in entrada.splitlines() if x.strip()]
    claves = [x["key"] for x in solicitudes]
    if len(claves) != len(set(claves)):
        raise ValueError("Hay identificadores repetidos en la entrada")
    if any(not re.fullmatch(r"[a-z0-9-]+", x) for x in claves):
        raise ValueError("Usa identificadores seguros: letras minúsculas, cifras y guiones")
    informe = {k: {"estado": "sin_resultado", "archivos": []} for k in claves}
    vistos, incidencias = set(), []
    carpeta.mkdir(parents=True, exist_ok=True)
    extensiones = {"image/png": ".png", "image/jpeg": ".jpg", "image/webp": ".webp"}

    for numero, linea in enumerate(resultados.splitlines(), 1):
        if not linea.strip():
            continue
        try:
            fila = json.loads(linea)
        except json.JSONDecodeError:
            incidencias.append({"linea": numero, "motivo": "json_invalido"})
            continue
        clave = fila.get("key")
        if clave not in informe or clave in vistos:
            incidencias.append({"linea": numero, "motivo": "clave_desconocida_o_repetida"})
            continue
        vistos.add(clave)
        item = informe[clave]
        estado = fila.get("status") or {}
        if fila.get("error") or estado.get("code", 0) != 0:
            item.update(estado="error_o_estado", detalle=fila.get("error") or estado)
            continue
        respuesta = fila.get("response") or {}
        problemas = []
        for candidato in respuesta.get("candidates") or []:
            partes = (candidato.get("content") or {}).get("parts") or []
            for parte in partes:
                if parte.get("thought"):
                    continue  # No cuenta como imagen final.
                imagen = parte.get("inlineData") or {}
                extension = extensiones.get(imagen.get("mimeType"))
                if not extension or not imagen.get("data"):
                    continue
                try:
                    datos = base64.b64decode(imagen["data"], validate=True)
                    if not datos:
                        raise ValueError("Imagen vacía")
                except (binascii.Error, ValueError):
                    problemas.append("base64_invalido_o_vacio")
                    continue
                ruta = carpeta / f"{clave}-{len(item['archivos']) + 1}{extension}"
                ruta.write_bytes(datos)
                item["archivos"].append(str(ruta))
        item["estado"] = "recuperada" if item["archivos"] else "sin_imagen_final"
        if problemas:
            item["avisos"] = problemas
    return {"solicitudes": informe, "incidencias": incidencias}

if __name__ == "__main__":
    informe = extraer(
        Path("solicitudes.jsonl").read_text(encoding="utf-8"),
        Path("resultados.jsonl").read_bytes().decode("utf-8"),
        Path("imagenes"),
    )
    Path("informe.json").write_text(
        json.dumps(informe, ensure_ascii=False, indent=2), encoding="utf-8"
    )
    print("Consulta informe.json y abre los archivos de imagen recuperados.")
Aquí recuperada significa que había datos no vacíos, con MIME reconocido y Base64 descodificable. Abre después cada archivo para comprobar que es una imagen y que sirve para el producto: el parser no valida su calidad visual, sus dimensiones ni el cumplimiento de las instrucciones. Conserva también usageMetadata, si aparece en la respuesta original, para contrastar consumo, resultados y gasto.
El código de los tres archivos se ha comprobado sintácticamente; el extractor se ha verificado con respuestas sintéticas locales, incluyendo orden alterado, errores, texto sin imagen y partes de razonamiento. No se han ejecutado llamadas reales, ni se ha medido generación, latencia o facturación. Antes de ampliar el volumen, valida el recorrido con un lote pequeño en tu propio proyecto.
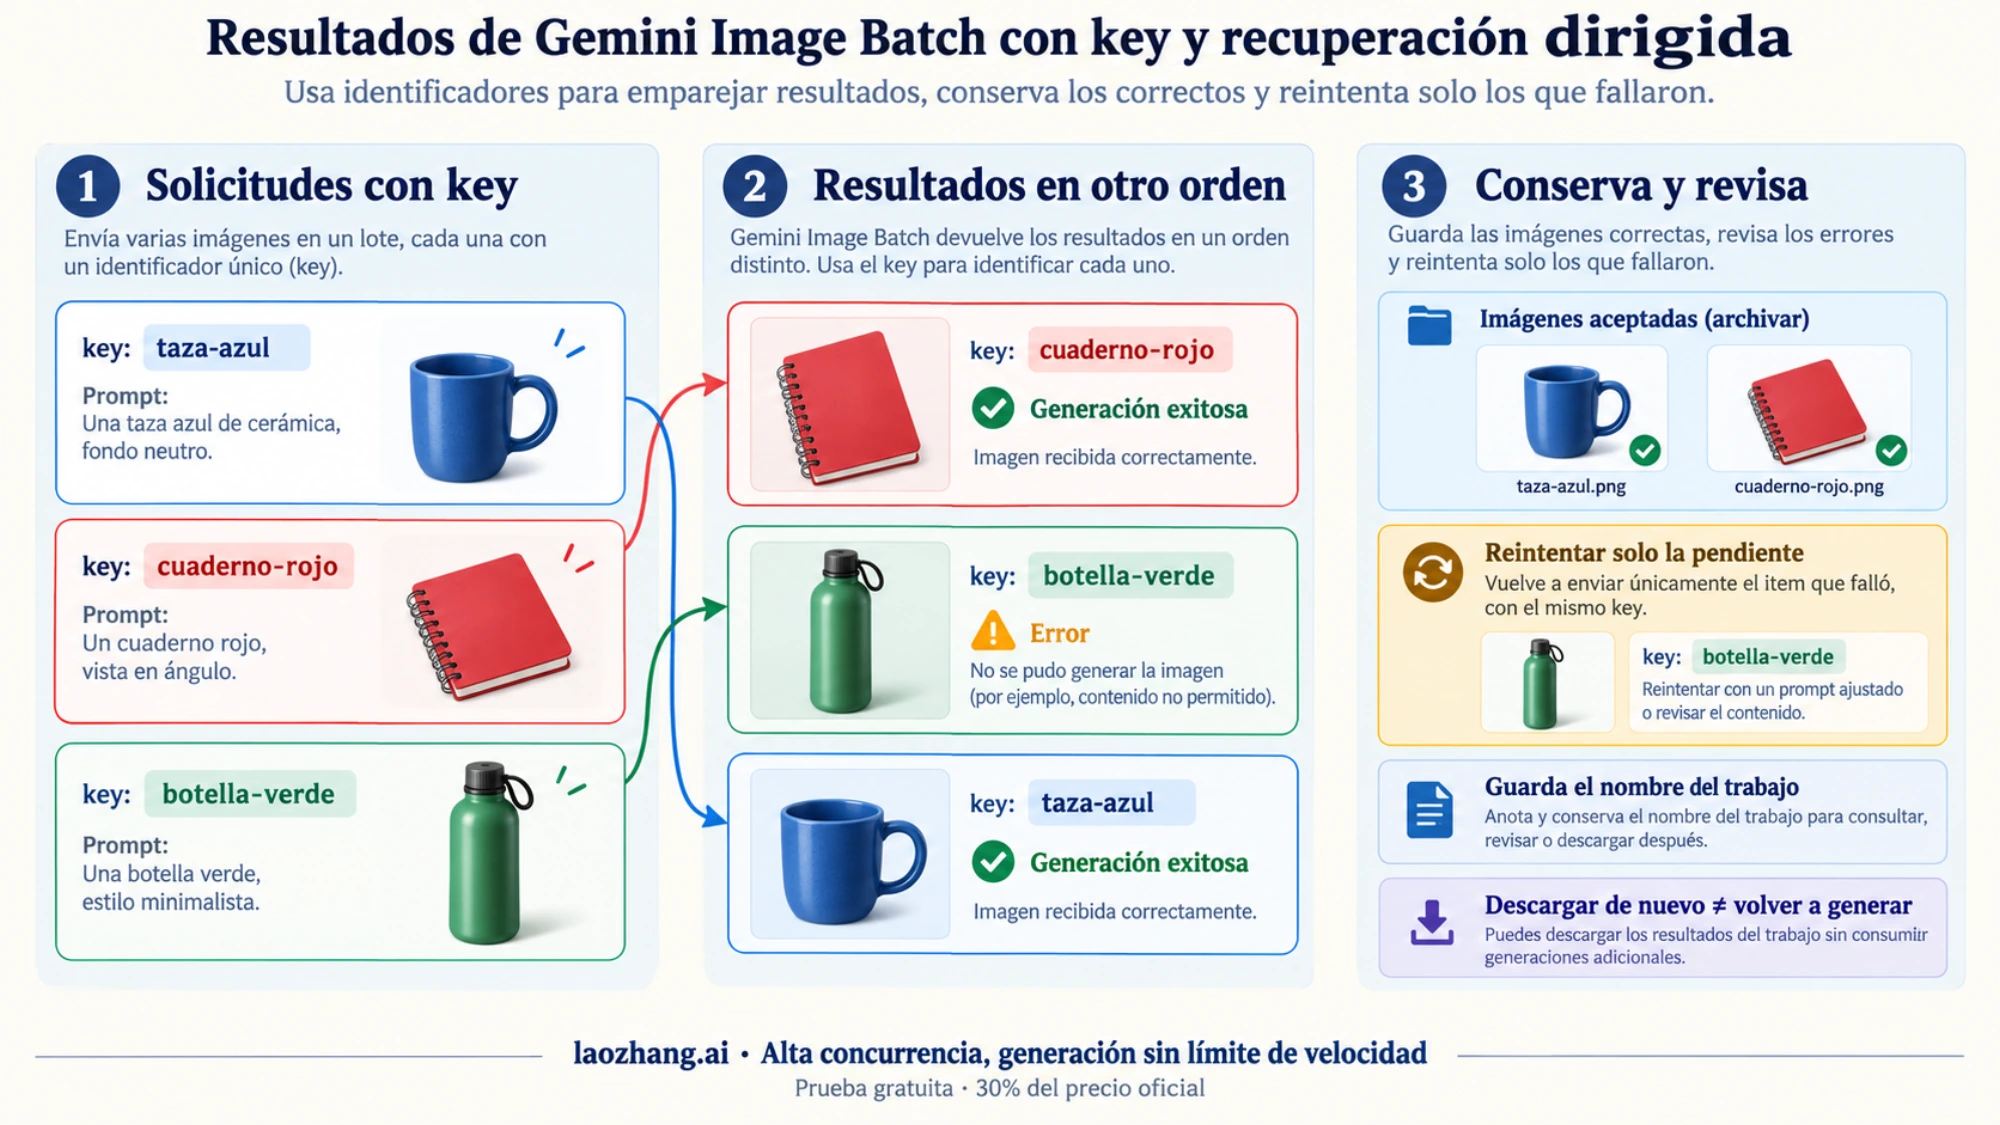
Ilustración de la recuperación por identificador. Las solicitudes y respuestas dibujadas no son una ejecución real del modelo.
Si falta una imagen, reintenta solo lo necesario
Trabaja con tres listas: imágenes recuperadas, imágenes aprobadas y elementos pendientes. Una respuesta con texto puede ser una ejecución completada que no produjo la imagen que necesitas. Un archivo técnicamente recuperable también puede requerir otra versión por criterios editoriales. Conserva los éxitos y el motivo de cada rechazo antes de preparar otro JSONL.
Para un reintento, asigna una nueva clave que permita relacionarlo con el original, por ejemplo taza-azul-r1, y fija de antemano cuántos intentos y cuánto gasto adicional aceptas. No reenvíes automáticamente las 600 solicitudes porque fallaron 12. Un error durante la descarga se resuelve descargando de nuevo el mismo resultado, sin volver a generar las imágenes.
Si te planteas cancelar, la documentación indica que se detiene el procesamiento de nuevas solicitudes. No establece en los apartados consultados una regla universal de devolución para errores, ausencia de imagen o cancelación. Mantén el coste pendiente hasta tener consumo o liquidación fiables. Si este lote forma parte de un agente que genera por su cuenta, puedes ampliar ese control con un límite de gasto que impida nuevas llamadas.
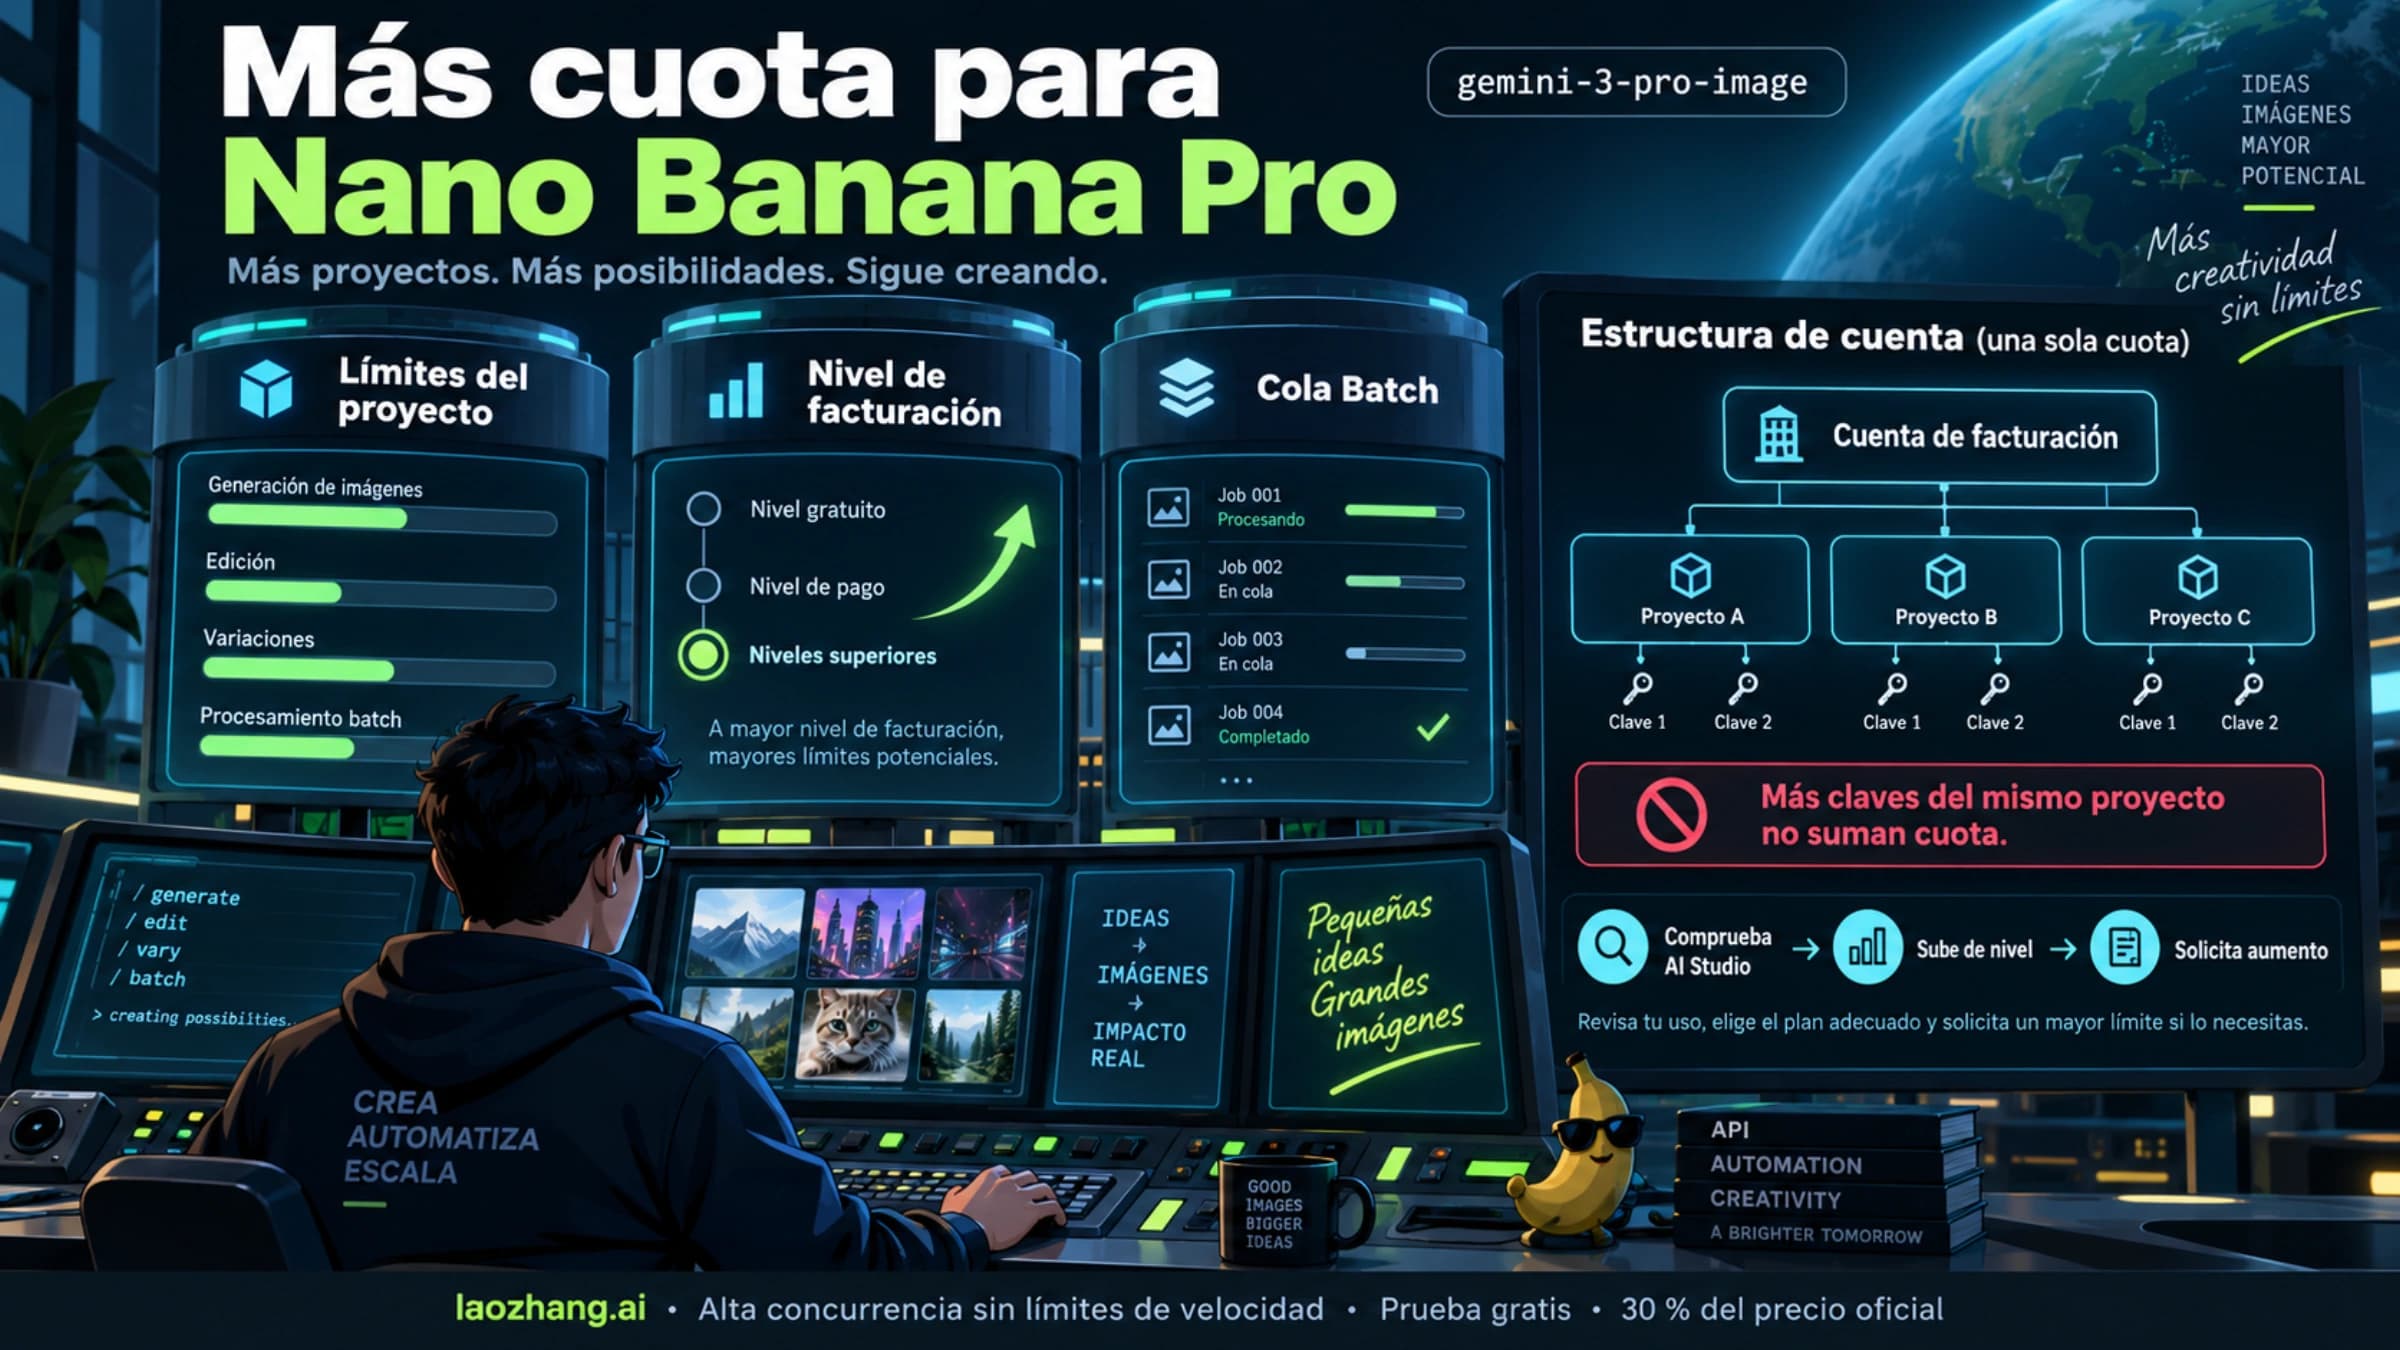
Batch tiene sus propios límites por proyecto: la documentación general incluye hasta 100 trabajos simultáneos, 2 GB por archivo de entrada y 20 GB de almacenamiento, además de tokens en cola por modelo. La capacidad disponible en tu proyecto debe verificarse; abrir más claves del mismo proyecto no multiplica esas cuotas. Límites de Batch API.
Preguntas frecuentes
¿Puedo sumar caché o Flex al descuento de Batch?
No lo presupuestes para Gemini 3 Pro Image. Su ficha actual indica que no admite caché, Flex ni Priority, aunque la página general de precios muestre filas Flex y Priority para este modelo. Batch sí figura como compatible. Ante esa discrepancia, esta guía no ofrece esas modalidades como una opción de ahorro disponible. Capacidades del modelo.
¿1K cuesta menos que 2K en el Batch oficial?
No según la tarifa publicada: ambas salidas aparecen a 0,067 USD por imagen en Batch, frente a 0,12 USD para 4K. Son importes de salida de imagen; la entrada y el texto y razonamiento se añaden. Una imagen más pequeña puede ayudarte en tu entrega o almacenamiento, pero aquí no obtiene una tarifa de generación inferior a 2K. Precios oficiales.
¿El descuento asegura la misma imagen que una llamada Standard?
No. La documentación describe un descuento para procesamiento asíncrono y compatibilidad con la configuración de solicitudes, pero no garantiza que dos ejecuciones produzcan imágenes idénticas píxel a píxel. Compara resultados con tus criterios de aceptación, no con una promesa de identidad visual. Configuración y funcionamiento de Batch.
¿Puedo generar imágenes gratis con este modelo por API?
La tabla de Gemini 3 Pro Image marca el nivel gratuito como no disponible, tanto en Standard como en Batch. El uso gratuito que puedas encontrar en la aplicación Gemini o en una interfaz de prueba no equivale a una cuota gratuita de este endpoint. Nivel gratuito y tarifas del modelo.
¿Me conviene Batch si tengo que entregar esta tarde?
Solo si tu margen admite el riesgo de que el trabajo siga pendiente. El objetivo de Google es de 24 horas y no constituye una garantía para tu lote. Para una entrega inmediata, evalúa la ruta Standard y su coste; para producción planificada, prepara el lote con antelación y conserva tiempo y presupuesto para revisar y regenerar los elementos rechazados. Plazo objetivo de Batch.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 6 oct 2026.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 6 oct 2026.
- 1.Fuente: Batch API de Googleai.google.dev/gemini-api/docs/batch-api
- 2.Fuente: precios de Gemini 3 Pro Imageai.google.dev/gemini-api/docs/pricing
- 3.Proceso de razonamiento en la generación de imágenesai.google.dev/gemini-api/docs/image-generation
- 4.Ficha del modeloai.google.dev/gemini-api/docs/models/gemini-3-pro-image
- 5.Referencia de configuración de imagenai.google.dev/api/generate-content
- 6.Implementación oficial de la configuración de redgithub.com/googleapis/python-genai/blob/main/google/genai/_api_client.py
- 7.Límites de Batch APIai.google.dev/gemini-api/docs/rate-limits