Structured Outputs 与 Function Calling:怎么选、怎么验收
只整理已有信息,选 Structured Outputs;需要应用查数据或执行操作,选 Function Calling;查完还要交给 UI 固定对象,再组合两者。严格 schema 管住结构,业务值和实际结果仍由应用验收。
文章目录
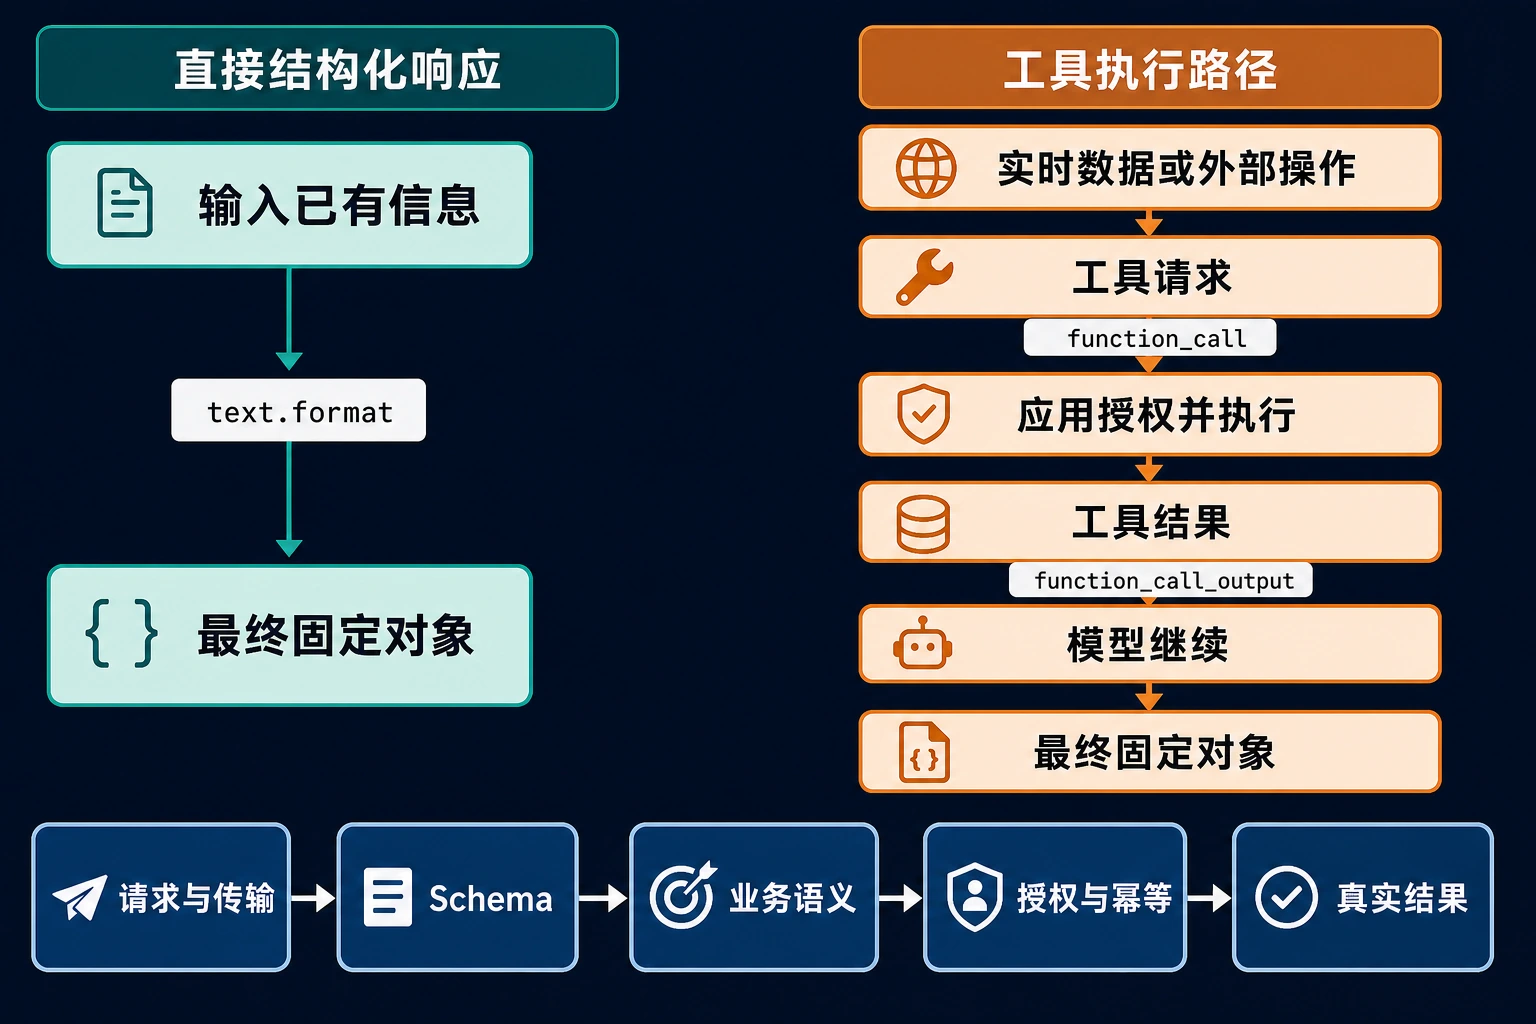
最终回答需要固定字段,选 Structured Outputs;任务需要应用查询系统或执行操作,选 Function Calling;查询完成后还需要固定的 UI 对象,再组合两者。 判断时看“谁消费这一步的输出”:前端或下游程序消费最终答案,用 text.format;应用执行器消费函数参数,用函数工具定义。
| 当前要完成的事 | 先用什么 | 教室预约场景中的结果 |
|---|---|---|
| 从用户文字提取日期、人数 | Structured Outputs | 一份预约需求对象,不表示已查询或预订 |
| 查询教室当天是否空闲 | Function Calling | 应用查到教室数据,并回传对应调用结果 |
| 查完后展示固定的教室卡片 | Function Calling + Structured Outputs | 查询有结果,卡片也符合约定字段 |
两者都能使用 JSON Schema,函数的严格参数约束本身也利用 Structured Outputs。但函数参数与最终答案是两个消费位置,并非两个相互排斥的产品功能。OpenAI 的结构化输出指南按连接应用功能、约束最终回答来区分用途。
本文示例使用 Responses API。接口字段依据 2026 年 10 月 7 日核对的官方文档;程序采用虚构的教室数据,只做了离线语法、schema 和合成响应检查,没有实际请求模型、验证 SDK 加载或接入预约系统。
只整理已有信息:先把最终对象设计好
假设用户说:“10 月 12 日下午,需要容纳 18 人的教室。”这一步只提取需求,不查询课表。先决定程序如何表示信息缺失:未提供年份时,日期可以为 null,而不是自动补一个年份;未提供人数时也保留 null。
下面的 JSON 是最终回答的 schema。字段都必须出现,值允许为空的字段明确包含 null;state 让调用方区分“信息齐全”和“还需要问用户”。
{
  "type": "object",
  "properties": {
    "state": { "type": "string", "enum": ["ready", "needs_input"] },
    "visit_date": { "type": ["string", "null"] },
    "headcount": { "type": ["integer", "null"] },
    "question": { "type": ["string", "null"] }
  },
  "required": ["state", "visit_date", "headcount", "question"],
  "additionalProperties": false
}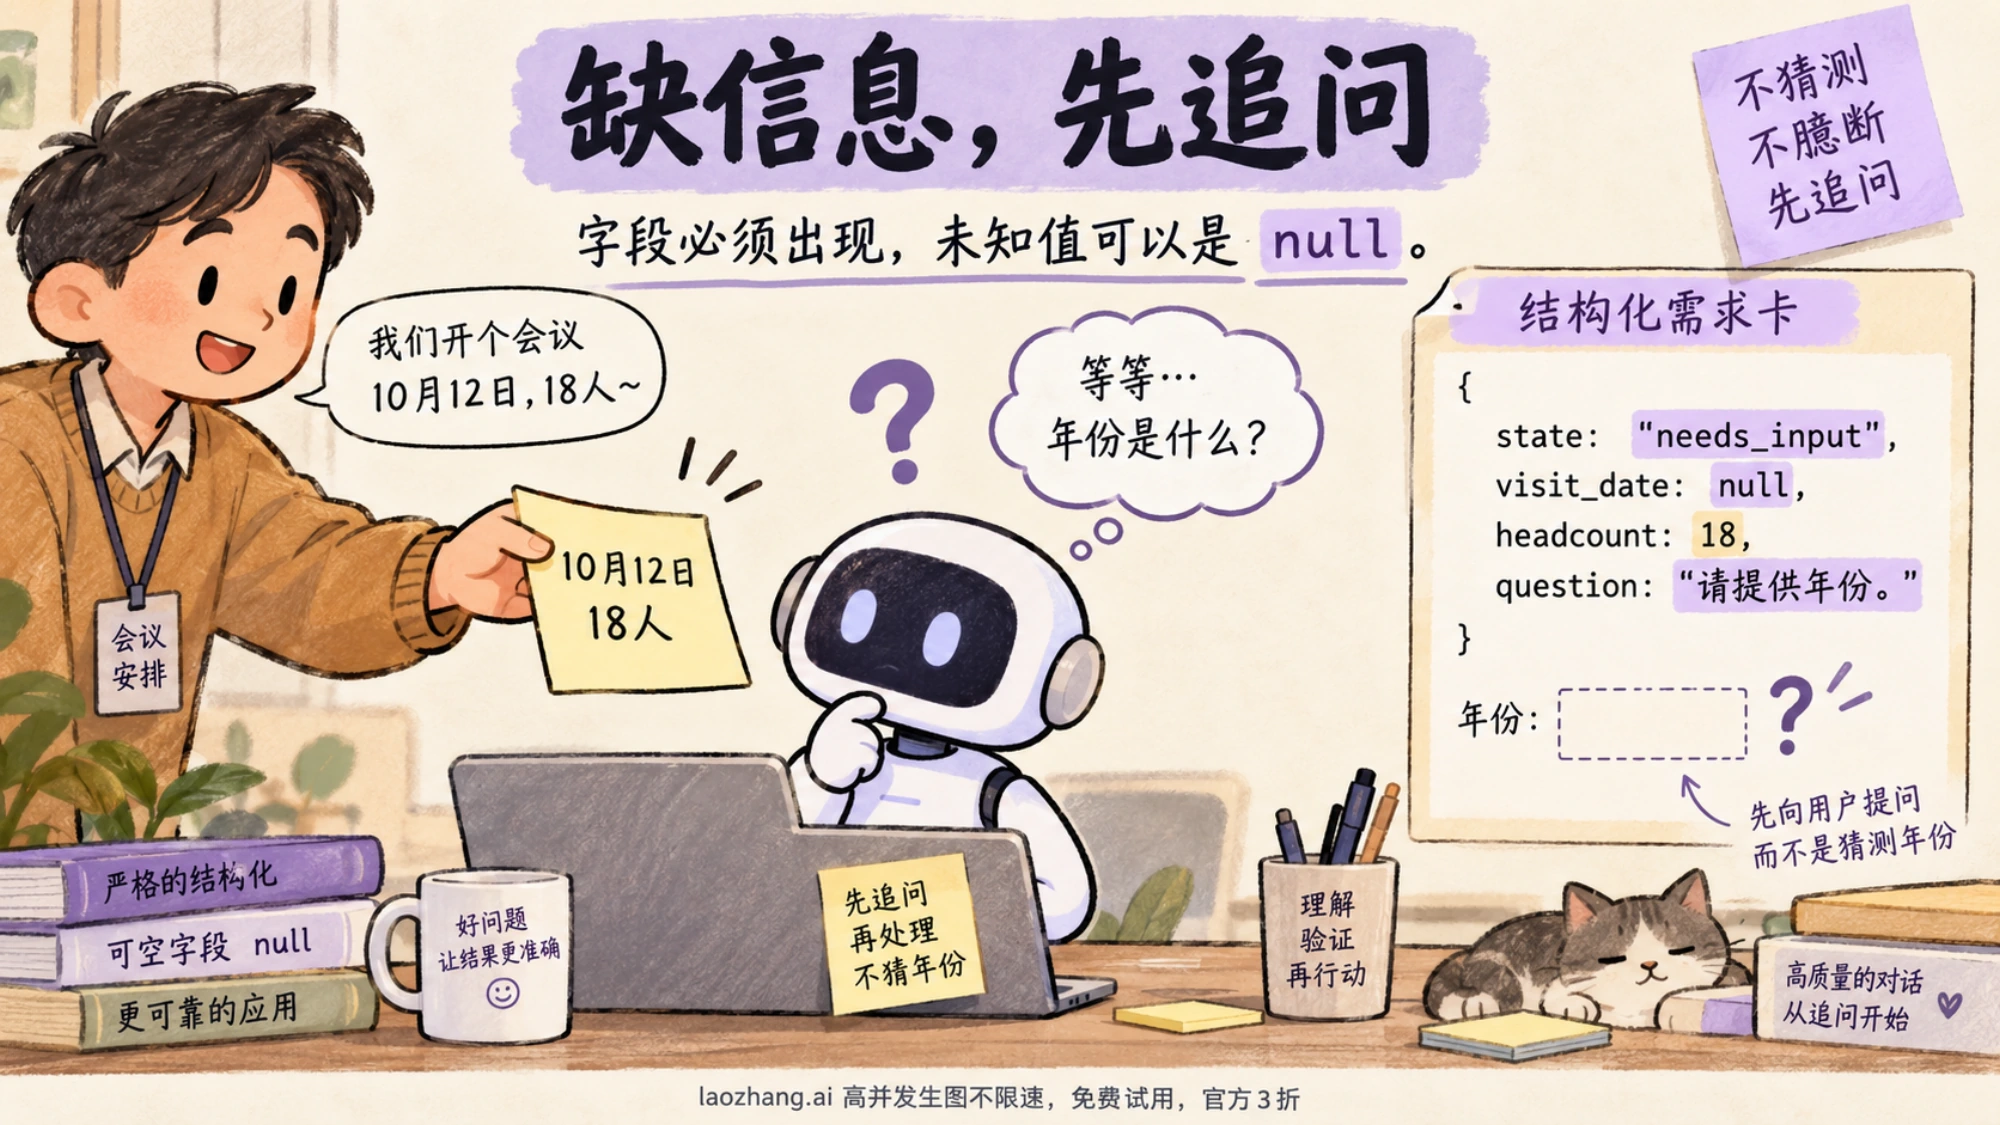
这是结构规则,字段之间的业务关系还要单独验收:ready 时日期和人数应有效、question 应为 null;needs_input 时至少缺少一项,并应给出明确追问。JSON Schema 合法,不代表状态与内容必然一致。
Python SDK 的 responses.parse 可以用 Pydantic 类型生成 schema 并解析结果。下面是独立的接入示例,需安装 openai、pydantic,并在符合服务资格的后端配置项目密钥后才能实际运行。这里不做教室查询。
from datetime import date
from typing import Literal
from openai import OpenAI
from pydantic import BaseModel

class RoomRequest(BaseModel):
    state: Literal["ready", "needs_input"]
    visit_date: str | None
    headcount: int | None
    question: str | None

def validate_request(value):
    if value.visit_date is not None:
        date.fromisoformat(value.visit_date)
    if value.headcount is not None and value.headcount < 1:
        raise ValueError("人数必须为正整数")
    complete = value.visit_date is not None and value.headcount is not None
    if value.state == "ready":
        if not complete or value.question is not None:
            raise ValueError("ready 与字段内容不一致")
    elif complete or not value.question or not value.question.strip():
        raise ValueError("needs_input 必须对应缺失信息和明确追问")
    return value

client = OpenAI()
response = client.responses.parse(
    model="gpt-6-astra",
    input=[
        {"role": "system", "content":
         "提取教室需求。日期必须包含年、月、日;未给年份不要猜。"
         "缺日期或人数时使用 needs_input,缺失值设 null 并追问;"
         "都齐全时使用 ready,question 设 null。不要声称已查课表。"},
        {"role": "user", "content": "10 月 12 日需要容纳 18 人的教室。"}
    ],
    text_format=RoomRequest,
)
if response.status != "completed":
    raise RuntimeError(f"回答未完成:{response.incomplete_details}")
for item in response.output:
    if item.type == "message":
        for part in item.content:
            if part.type == "refusal":
                raise RuntimeError(f"请求被拒绝:{part.refusal}")
if response.output_parsed is None:
    raise RuntimeError("没有可消费的结构化回答")
value = validate_request(response.output_parsed)
print(value.model_dump())
Python 的入口是 text_format=RoomRequest;JavaScript 的解析辅助函数使用 text.format=zodTextFormat(...)。直接传 JSON Schema 时,Responses 的入口是 text.format,其中包含 type: "json_schema"、name、strict 和 schema。Chat Completions 使用的是 response_format,不能把两个接口的嵌套结构混用。官方 SDK 示例分别给出了这些形式。
需要查询系统:模型提出调用,应用完成执行
用户改问:“查一下 2026-10-12,A201 和 A202 有没有空。”答案依赖课表,此时给模型 lookup_room_day 工具。它返回的 function_call 是请求,应用需要解析参数、校验访问范围、查询数据,然后回传结果。
Responses 的函数定义直接使用 name、parameters、strict,不套 Chat Completions 的 function 对象。返回项里有两个容易混淆的标识:
id标识输出项,例如fc_...。call_id关联函数调用与结果;function_call_output必须带回这个值。
它们都不等于用户授权,也不等于预约系统生成的预订回执。一次响应可以有零个、一个或多个函数调用,不能只处理 output[0]。接续请求还应保留完整输出,包含随工具调用返回的 reasoning 项;官方函数调用处理说明展示了这一点。JavaScript 当前文档通过 toResponseInputItems(response.output) 转成输入项,Python 示例保留完整 response.output。
完整示例:查询两个教室,再返回固定卡片
下面是独立 Python 程序。它定义了实际执行的函数、工具参数、结果回传、最终 schema 和业务校验,不依赖上一个代码块。数据表是程序内的虚构演示数据,allowed_rooms 是应用预先决定的访问范围,不能让模型传入一个用户 ID 来替代服务端身份。
这里展示组合流程:查询阶段继续提供工具;所有所需教室都有成功结果后,进入不再提供工具的最终结构化阶段。如果只需要自然语言答复,可以在查询完成后改用普通最终回答,省去最终 schema;如果根本不需要查询,就采用上一节的直接提取。
import json
from datetime import date
from openai import OpenAI

TOOLS = [{
    "type": "function",
    "name": "lookup_room_day",
    "description": "查询当前用户可访问教室在指定日期的课表状态。",
    "strict": True,
    "parameters": {
        "type": "object",
        "properties": {
            "room_code": {"type": "string"},
            "visit_date": {"type": "string"}
        },
        "required": ["room_code", "visit_date"],
        "additionalProperties": False
    }
}]
CARD_SCHEMA = {
    "type": "object",
    "properties": {
        "visit_date": {"type": "string"},
        "rooms": {
            "type": "array",
            "items": {
                "type": "object",
                "properties": {
                    "room_code": {"type": "string"},
                    "available": {"type": "boolean"},
                    "seats": {"type": "integer"},
                    "checked_at": {"type": "string"}
                },
                "required": ["room_code", "available", "seats", "checked_at"],
                "additionalProperties": False
            }
        }
    },
    "required": ["visit_date", "rooms"],
    "additionalProperties": False
}
DEMO_SCHEDULE = {
    ("A201", "2026-10-12"): {
        "available": True, "seats": 24,
        "checked_at": "2026-10-07T09:00:00+08:00"},
    ("A202", "2026-10-12"): {
        "available": False, "seats": 32,
        "checked_at": "2026-10-07T09:00:00+08:00"}
}

def require_completed(response):
    if response.status != "completed":
        raise RuntimeError(f"未完成:{response.incomplete_details}")
    for item in response.output:
        if item.type == "message":
            for part in item.content:
                if part.type == "refusal":
                    raise RuntimeError(f"拒绝:{part.refusal}")

def lookup_room_day(args, allowed_rooms, target_date):
    if not isinstance(args, dict) or set(args) != {"room_code", "visit_date"}:
        return {"ok": False, "error": "invalid_arguments"}
    room, day = args["room_code"], args["visit_date"]
    if not isinstance(room, str) or not isinstance(day, str):
        return {"ok": False, "error": "invalid_arguments"}
    try:
        date.fromisoformat(day)
    except ValueError:
        return {"ok": False, "error": "invalid_date"}
    if day != target_date:
        return {"ok": False, "error": "unexpected_date"}
    if room not in allowed_rooms:
        return {"ok": False, "error": "not_allowed"}
    row = DEMO_SCHEDULE.get((room, day))
    if row is None:
        return {"ok": False, "error": "not_found"}
    return {"ok": True, "room_code": room, "visit_date": day, **row}

def validate_card(card, evidence, target_rooms, target_date):
    if not isinstance(card, dict) or set(card) != {"visit_date", "rooms"}:
        raise ValueError("卡片字段错误")
    if card["visit_date"] != target_date or not isinstance(card["rooms"], list):
        raise ValueError("卡片日期或列表错误")
    by_room = {}
    for row in card["rooms"]:
        if not isinstance(row, dict) or set(row) != {
            "room_code", "available", "seats", "checked_at"
        }:
            raise ValueError("教室字段错误")
        room = row["room_code"]
        if not isinstance(room, str) or room in by_room or room not in evidence:
            raise ValueError("重复或没有查询依据的教室")
        if type(row["available"]) is not bool or type(row["seats"]) is not int:
            raise ValueError("教室字段类型错误")
        expected = {key: evidence[room][key] for key in row}
        if row != expected:
            raise ValueError("卡片与查询结果不一致")
        by_room[room] = row
    if set(by_room) != set(target_rooms):
        raise ValueError("查询卡片有遗漏或多余教室")
    return card

def query_then_card(client, target_rooms, target_date, allowed_rooms):
    date.fromisoformat(target_date)
    if not target_rooms or not set(target_rooms) <= set(allowed_rooms):
        raise ValueError("请求教室超出访问范围")
    history = [{"role": "user", "content":
                f"查询 {target_date} 的这些教室:{', '.join(target_rooms)}。"}]
    evidence, seen = {}, {}
    for _ in range(4):
        response = client.responses.create(
            model="gpt-6-astra", input=history, tools=TOOLS,
            instructions="使用工具逐一查询请求的教室,不猜课表。",
            tool_choice="auto"
        )
        require_completed(response)
        history.extend(response.output)
        calls = [item for item in response.output if item.type == "function_call"]
        if not calls:
            raise RuntimeError("尚无完整查询结果,模型已停止调用")
        for call in calls:
            fingerprint = (call.name, call.arguments)
            if call.call_id in seen:
                old_fingerprint, result = seen[call.call_id]
                if old_fingerprint != fingerprint:
                    raise RuntimeError("同一 call_id 对应了不同调用")
            else:
                if call.name != "lookup_room_day":
                    result = {"ok": False, "error": "unknown_tool"}
                else:
                    try:
                        args = json.loads(call.arguments)
                    except (TypeError, ValueError):
                        result = {"ok": False, "error": "invalid_json"}
                    else:
                        result = lookup_room_day(args, allowed_rooms, target_date)
                seen[call.call_id] = (fingerprint, result)
            if result.get("ok") is True:
                evidence[result["room_code"]] = result
            history.append({
                "type": "function_call_output", "call_id": call.call_id,
                "output": json.dumps(result, ensure_ascii=False)
            })
        if set(target_rooms) <= set(evidence):
            break
    else:
        raise RuntimeError("查询轮次耗尽,不能生成成功卡片")
    final = client.responses.create(
        model="gpt-6-astra", input=history,
        instructions="只根据成功的工具结果生成所请求教室的卡片,不添加教室。",
        text={"format": {
            "type": "json_schema", "name": "room_day_card",
            "strict": True, "schema": CARD_SCHEMA
        }}
    )
    require_completed(final)
    card = json.loads(final.output_text)
    return validate_card(card, evidence, target_rooms, target_date)

if __name__ == "__main__":
    client = OpenAI()
    card = query_then_card(
        client, ["A201", "A202"], "2026-10-12", {"A201", "A202"}
    )
    print(json.dumps(card, ensure_ascii=False, indent=2))
程序中的四轮上限是演示的停止策略,不是 OpenAI 规定的最佳重试次数。生产查询函数需要改接自己的数据源,明确超时、数据更新时间和错误结果;在本例中,not_found 会作为工具结果回传,最终仍缺少查询证据时停止,不拿“没查到”冒充“空闲”。
seen 缓存只按当前流程的 call_id 避免重复执行同一请求,并检查参数是否被替换。它不是持久化业务幂等机制:模型可能用新的 call_id 请求同一操作,进程也可能重启。示例的只读查询允许重复查询;预订、取消、付款等写操作还需要业务幂等键和系统回执。
strict: true:字段齐全不等于信息齐全
函数严格模式要求每个对象都有 additionalProperties: false,并把所有属性列入 required。业务可选字段通过 nullable 表示;它仍然是必须出现的字段。明确发送 strict: true 而 schema 不符合支持范围时,请求会被拒绝。官方严格模式说明也区分了不同接口的默认行为:
| 函数定义中的设置 | 当前文档规定的行为 |
|---|---|
strict: true | 按支持的严格 schema 约束参数;不兼容 schema 报错 |
Responses 中省略 strict | 尝试规范化为严格模式;不能兼容时退回尽力生成,响应工具显示 strict: false |
Chat Completions 中省略 strict | 默认非严格模式 |
strict: false | 明确使用非严格、尽力生成的参数 |
因此,把报错的 strict: true 删除,不是修好了消费者要求。应先修 schema;如果有意采用非严格模式,应用必须承担相应的验证和失败处理。
可空枚举还要注意两个规则同时生效。下面左边允许类型为 null,枚举却不包含 null,所以一般 JSON Schema 校验仍会拒绝空值;右边才表达真正的可空选择。
{
  "wrong_nullable_enum": {
    "type": ["string", "null"],
    "enum": ["morning", "afternoon"]
  },
  "nullable_enum": {
    "type": ["string", "null"],
    "enum": ["morning", "afternoon", null]
  }
}
这说明的是 JSON Schema 的类型与枚举交集,不是一次 OpenAI 服务端接受测试。人数缺失也不能靠 required 变成已知信息:要么返回 null 和追问,要么让应用在发起查询前补齐必要输入。
Structured Outputs 只支持 JSON Schema 子集:根节点应为 object,不能是根级 anyOf;对象要封闭、字段要 required,if/then/else、allOf 等组合不在当前支持范围。字段间的关系通常留给业务校验。当前文档支持普通模型的部分 pattern、format、数值边界和数组长度约束,微调模型另有限制;不能把微调例外套到全部模型,也不能以本地通用校验器通过推断 API 接受。复杂 schema 应逐项对照支持范围。
拒绝、未完成、没有工具调用:分别处理
拿到 HTTP 200 或 status: "completed" 仍不能直接消费业务对象。完成的消息也可能包含 refusal;status: "incomplete" 则可能带有 max_output_tokens 或 content_filter 原因。官方边界处理示例要求应用识别这些分支。
| 实际响应 | 应用下一步 |
|---|---|
消息包含 refusal | 进入拒绝处理,不把它解析成业务 schema,不盲目重试 |
incomplete,原因是 max_output_tokens | 不使用部分 JSON;评估减少输出或增加预算后再发起有上限的尝试 |
incomplete,原因是 content_filter | 停止消费该结果,按过滤状态处理 |
完成但解析对象为 None | 视为没有结构化结果;记录原因,不补默认值假装成功 |
auto 下没有函数调用 | 若任务只需已有信息可以直接回答;若仍缺实时数据则不能宣布已查到 |
| 工具返回错误或超时 | 区分可重试故障与参数、权限错误;写操作先查实际状态再决定重试 |
tool_choice: "required" 要求产生一个或多个工具调用,指定函数可以限制为特定函数;parallel_tool_calls: false 把调用数限制为零或一个,单独使用不保证必有一次调用。这些参数控制调用选择,不保证参数表达了真实需求、权限通过或业务执行成功。微调模型一次并行多函数调用时,当前文档另有 strict 被禁用的例外,见工具选择与并行说明。缺少日期时应先追问,而不是用 required 强迫模型猜一个日期。
JSON mode 是另一个选择:Responses 使用 text.format: {"type": "json_object"},通常保障 JSON 格式,不保障你的 schema,也有未完成等边界。上下文还须明确要求生成 JSON,并包含 JSON 字样,否则可能出现持续空白或请求报错。能使用 Structured Outputs 的固定对象任务,优先采用 schema;采用 JSON mode 时自己校验字段与业务值。JSON mode 文档说明了这些条件。
怎么验收:结构、含义和执行结果分开看
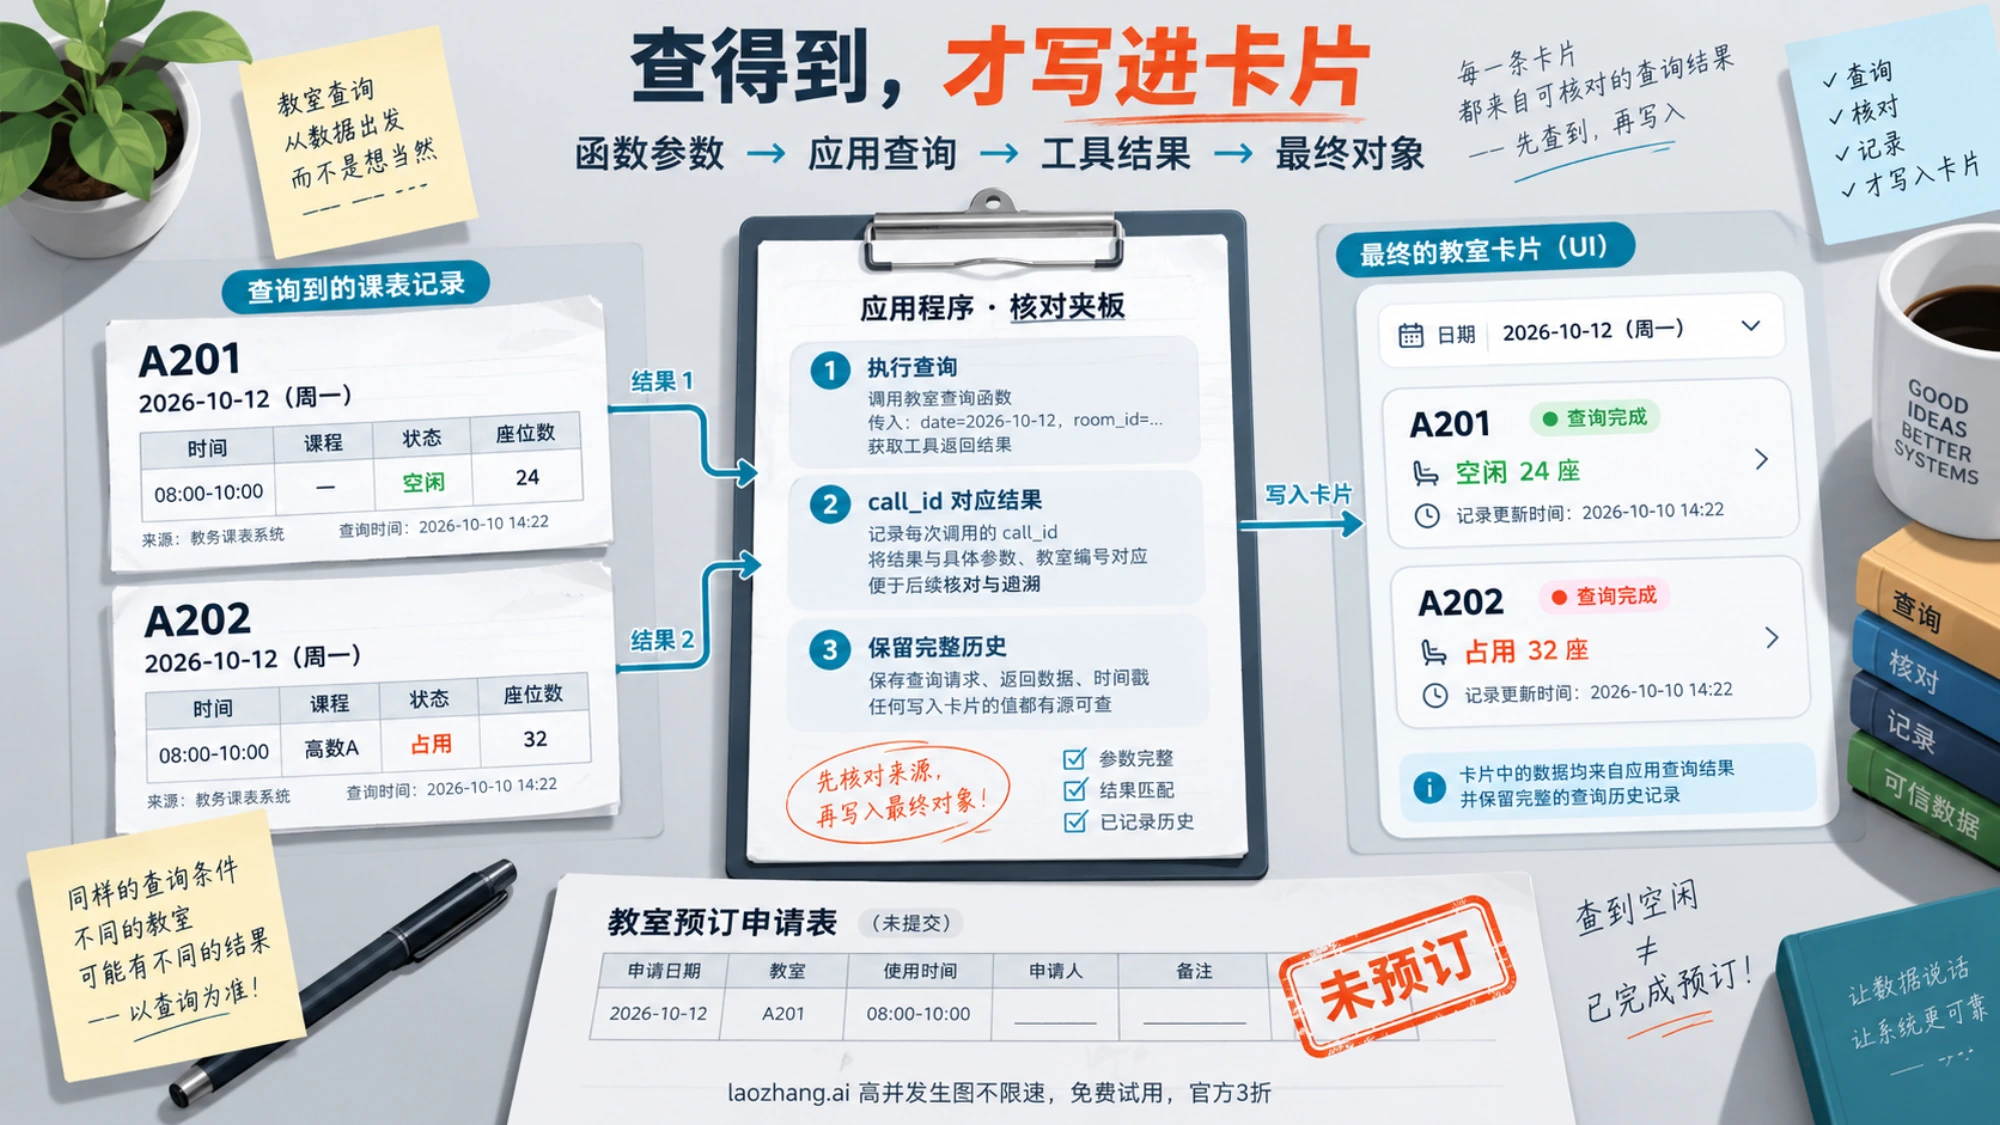
在教室例子里,available: true 符合 boolean 类型,只说明结构正确。它与查询返回的 false 不一致,就不能进入预约 UI;即使二者一致,也只证明查询结果被忠实展示,不能宣称教室已经预订。
| 验收对象 | 成功依据 | 不能据此推出什么 |
|---|---|---|
| 最终对象的结构 | 字段、类型、枚举、额外字段校验通过 | 事实真实、字段间关系正确 |
| 业务含义 | 日期、人数、状态关系有效,卡片与源结果一致 | 当前用户有执行权限 |
| 函数调用 | 工具名和参数有效,原 call_id 对应结果 | 函数已执行成功或恰好执行一次 |
| 查询结果 | 应用实际读到源记录,保留来源与更新时间 | 已经完成写入操作 |
| 预订等写入效果 | 业务系统的预订 ID、状态和必要复查一致 | 模型的成功措辞可以替代系统回执 |
最小有用验收不只是给合法 JSON 一个绿灯。对上述代码,离线检查应包含:缺年份的 needs_input、空值枚举、拒绝和截断、零个或两个调用、id 与 call_id 不同、重复调用、工具未知、访问范围失败,以及最终卡片漏项或篡改课表值。本文对自己的示例做了这些合成检查;它们验证应用分支,不能证明模型会稳定选对工具、SDK 实际可加载或真实系统执行成功。
真实接入时,把一次业务流程的请求、工具参数、执行日志、工具结果和最终对象关联起来。对写入另保存业务操作 ID;超时后先按该 ID 或幂等键核对状态,确认没执行再决定重试。call_id 的关联关系帮助你追踪模型协议,业务系统回执帮助你验证实际效果。
常见问题
Structured Outputs 能不能直接执行函数?
不能自己执行。你可以设计一个最终 JSON,然后用应用代码据此分派操作,但工具名称校验、身份绑定、授权、执行、结果关联和重试仍要自己实现。需要模型请求应用执行时,Function Calling 已提供调用与结果回传的协议;最终 JSON 不会自动获得这些能力。
required 和 strict 都开了,是否就一定成功?
不是。required 要求产生调用,strict 约束支持范围内的参数结构,应用仍可能拒绝访问、查询失败或发现语义错误。拒绝、未完成与微调并行例外也需按当前函数调用文档处理。
可以一次请求同时传工具和最终 schema 吗?
它们约束不同输出位置,组合配置本身不等于执行流程已经完成。仍要处理模型提出的调用、执行并回传结果。示例把查询与最终卡片分阶段,是为了让应用先确认所需证据齐全;最后一次不提供工具,明确进入最终回答阶段。只需要自然语言答案时不必再加最终 schema。
从 Chat Completions 迁过来,只改 response_format 就够了吗?
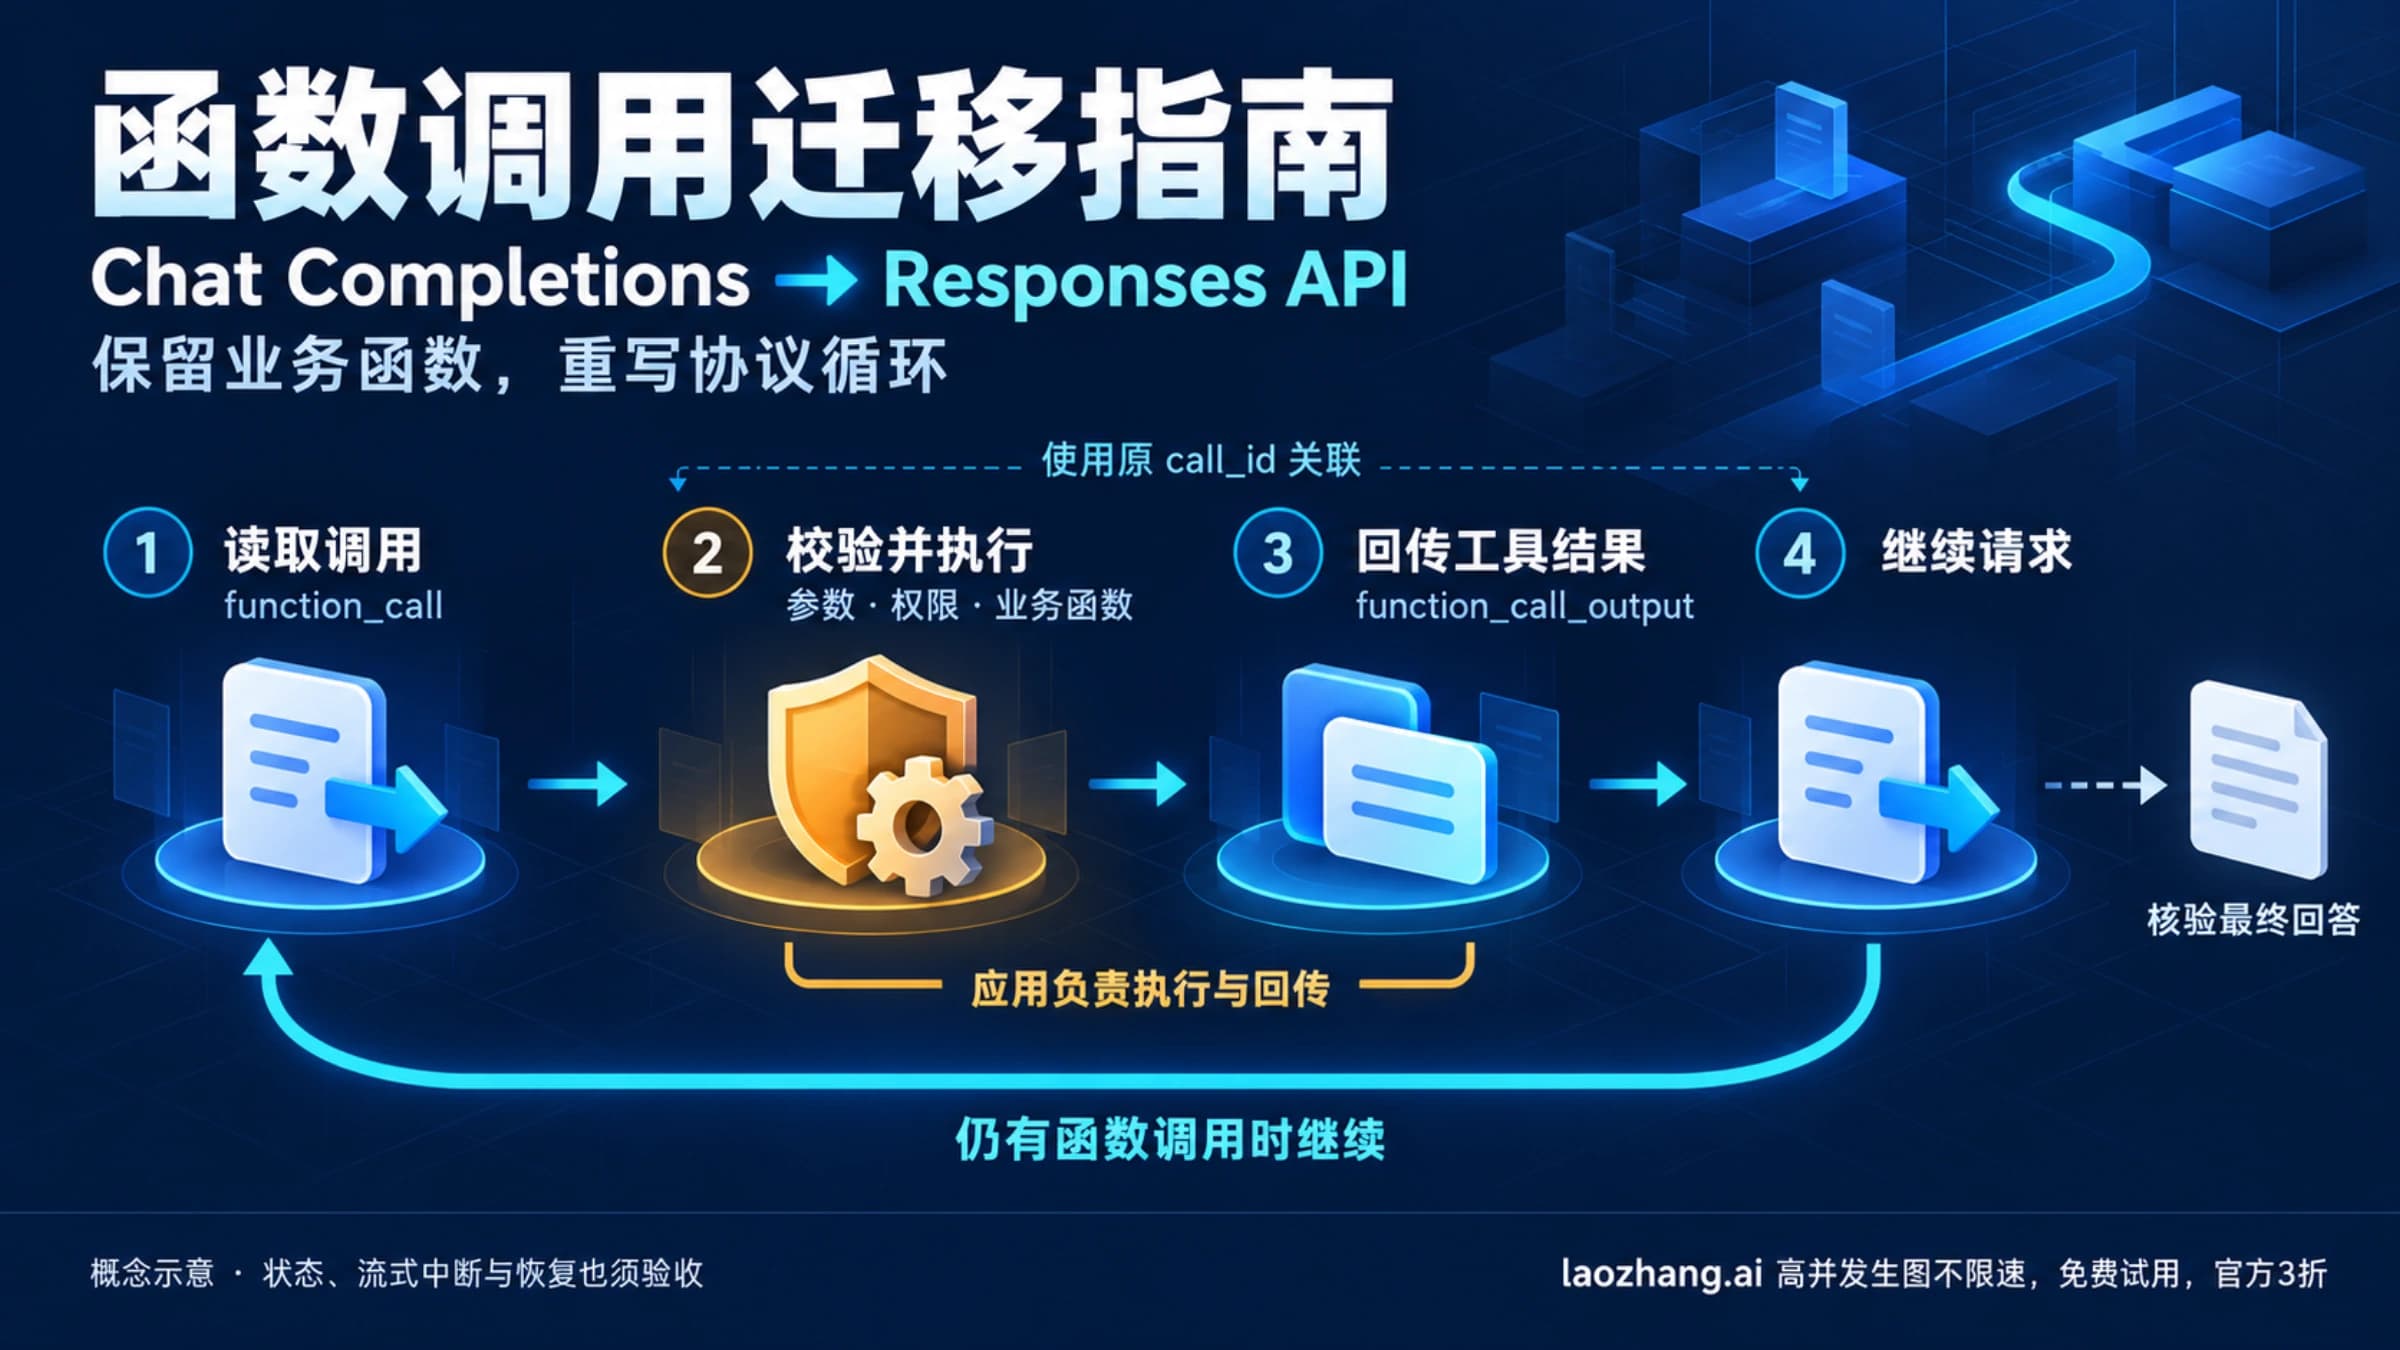
不够。最终格式入口改为 text.format,工具定义、输出项和 call_id 结果关联也要一起适配;当前 GPT-6 Astra、GPT-6.1 Sol 的工具调用要求 Responses API,这不代表所有文本请求都已停止支持 Chat Completions。完整迁移与 streaming 流程见函数调用迁移指南,接口范围见官方函数调用指南。
如果还没有完成后端接入,下一步先阅读 OpenAI API Key 创建、计费与首次调用,按自己的所在地和账户条件核对当前规则。已有项目则先选消费位置,再落实相应的 schema、执行器和验收依据。
参考来源2
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月7日。
参考来源2
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月7日。