OpenAI Assistants API 迁移到 Responses API:停用后的生产切换
Assistants API 已于 2026 年 8 月 26 日停用。现在要从应用保存的配置和记录迁出:恢复可用历史,重新管理状态与工具调用,再把流量切到经过验证的 Responses 实现。故障退路也必须在新系统中成立。
文章目录

OpenAI Assistants API 已于 2026 年 8 月 26 日停用,现在不能再靠旧接口导出 Thread、运行 Assistant,或把流量切回旧 Run。官方迁移指南明确要求使用应用已经保存的消息。可执行的迁移起点是:取回自己的指令、工具定义和历史记录,先恢复一条完整的 Responses 工作流,再验证检索、事件和生产切换。
如果手上只有 asst_、thread_ 或 run_ ID,没有配置、消息或备份,它们不足以恢复原对话。此时仍可根据业务规则建立新会话;旧历史只能标为不可用,不能让模型补写成“恢复记录”。
本文针对官方 OpenAI 的 Assistants → Responses 迁移。Azure、第三方兼容接口的对象、工具和保存规则须分别核对。示例依据当前官方文档编写,做了纯离线语法和合成数据检查,没有实际调用 OpenAI、运行 SDK 或证明生产行为等价。
先恢复配置,让新请求不再依赖 Assistant ID
把原 Assistant 的 instructions、模型选择、函数 schema、检索范围和输出格式收回应用配置,给它一个可固定、可部署的版本。来源可以是停用前的导出、应用数据库、配置仓库或已有备份;缺失的规则由业务负责人重新确认,不从 Assistant ID 推算。
官方迁移页还保留 Assistant → Prompt 的映射,但 reusable Prompt objects 与 v1/prompts 也计划于 2026 年 11 月 30 日停用。长期实现应直接发送指令与工具定义,避免迁一次又依赖下一项即将退役的服务。Prompt 对象迁出指南给出的方向就是把内容移入应用代码。
| 原来的依赖 | 现在放在哪里 | 实际恢复动作 |
|---|---|---|
| Assistant 指令、模型与工具 | 版本化应用配置 | 从保存的定义重建,审查缺失字段,固定配置版本 |
| Thread 与用户的关系 | 应用会话表 | 保留租户、用户、业务会话与旧 ID 的关系,另建新状态 |
| Message 历史 | 本地归档,再转换为受支持的输入 | 恢复顺序和角色;附件、引用及工具记录单独处理 |
Run 与 requires_action | Response 与应用工具循环 | 识别 typed Items,执行函数,回传对应 call_id |
| Assistant/Thread 绑定的文件 | 明确的检索配置 | 核对 vector store 和文件的现存状态,再指定搜索范围 |
例如订单客服配置可以保留“必须查到记录再回答物流状态”的规则。下面完整函数示例把配置写在代码里;生产中可将同样的定义存入受版本控制的 JSON 或配置系统。不要把用户输入直接写进系统指令,也不要让模型决定当前登录用户或租户身份。
把已保存的 Thread 记录转成可继续的历史
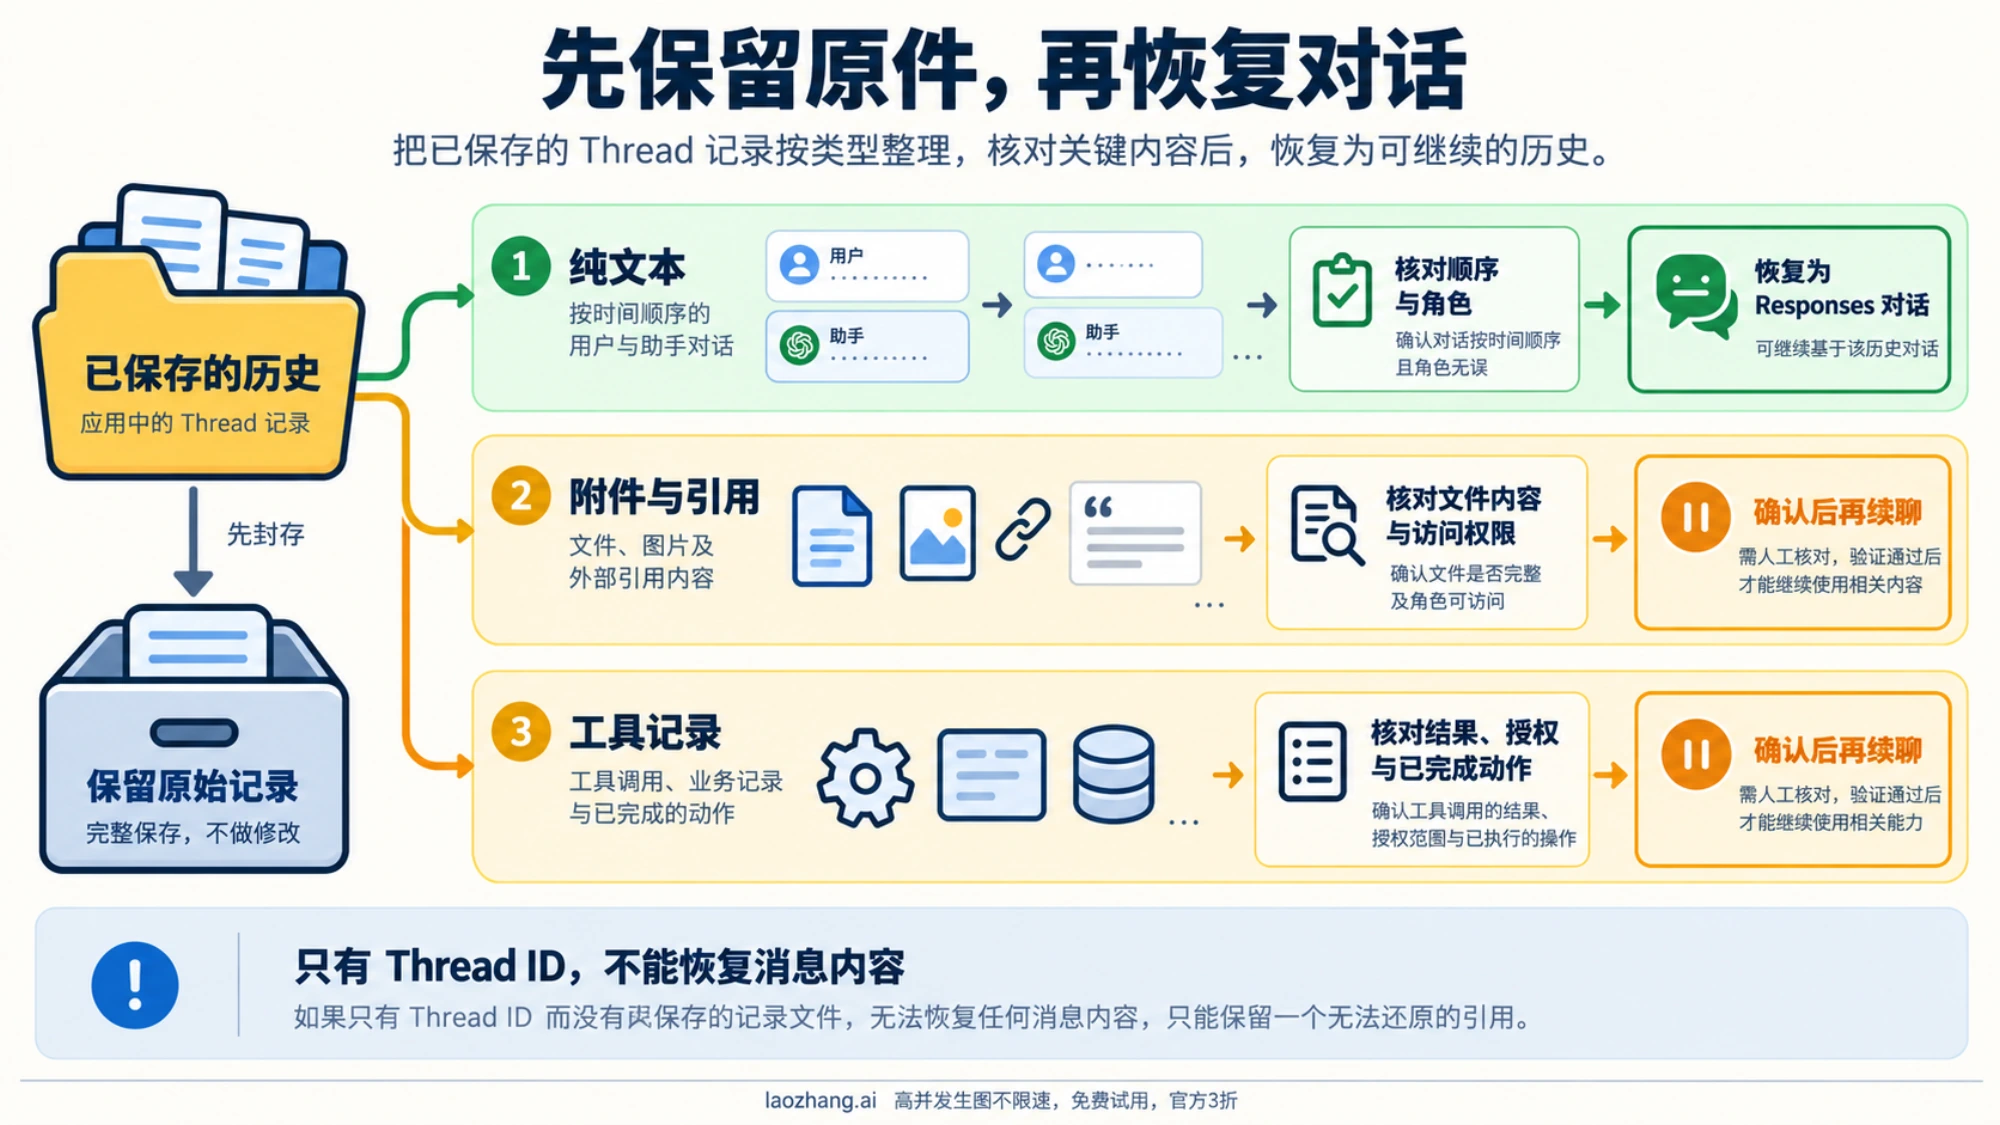
先保留原始导出,再产生新输入。转换成功不等于所有历史都能继续执行:旧消息里可能只有显示文字,没有原附件、检索证据或完整工具结果。已经完成的业务动作应从业务数据库确认;未完成的旧 Run 不能继续轮询,需在新系统中重新安排任务并核对是否已经产生副作用。
下面是最小的已保存记录格式,保存为 archive.json。messages 必须按时间升序,内容是原始存档,不是重新向旧接口取回的结果。若备份另有 Run steps 或工具日志,先将它们归入 tool_events;没有完整记录时先按只读历史处理,不能因为这个数组为空就推断工具没有执行过。
{
  "thread_id": "thread_archived_example",
  "messages": [
    {
      "id": "msg_saved_1",
      "role": "user",
      "created_at": 1780000000,
      "attachments": [],
      "content": [
        {"type": "text", "text": {"value": "订单是 DEMO-7", "annotations": []}}
      ]
    },
    {
      "id": "msg_saved_2",
      "role": "assistant",
      "created_at": 1780000001,
      "attachments": [],
      "content": [
        {"type": "text", "text": {"value": "请问要查询配送状态吗?", "annotations": []}}
      ]
    }
  ],
  "tool_events": []
}
这个转换器只接受纯文本历史。它把完整原件保留在转换文件的 original 中,把可继续的部分放到 input;遇到附件、引用、非文本内容或工具事件就阻止自动续聊,并指出需要处理的消息。保存为 convert_archive.py:
import json
import sys
from pathlib import Path


def convert(archive):
    items, blockers = [], []
    messages = archive.get("messages")
    if not isinstance(messages, list) or not messages:
        raise ValueError("需要完整消息记录,只有 Thread ID 不够")
    previous_time = None
    for index, message in enumerate(messages):
        label = message.get("id", f"message-{index}")
        timestamp = message.get("created_at")
        if type(timestamp) is not int:
            raise ValueError(f"{label}: 缺少有效时间")
        if previous_time is not None and timestamp < previous_time:
            raise ValueError("消息不是时间升序,请先核对原始顺序")
        previous_time = timestamp
        role = message.get("role")
        if role not in ("user", "assistant"):
            blockers.append(f"{label}: 不支持的角色")
            continue
        parts = message.get("content")
        if not isinstance(parts, list) or not parts:
            blockers.append(f"{label}: 缺少内容")
            continue
        content = []
        if message.get("attachments"):
            blockers.append(f"{label}: 附件需要重新确认访问与内容")
        for part in parts:
            if part.get("type") != "text":
                blockers.append(f"{label}: 非文本内容需要单独转换")
                continue
            text = part.get("text", {})
            if not isinstance(text.get("value"), str):
                blockers.append(f"{label}: 文本内容无效")
                continue
            if text.get("annotations"):
                blockers.append(f"{label}: 引用需要核对原文件")
            content.append({
                "type": "input_text" if role == "user" else "output_text",
                "text": text["value"],
            })
        if content:
            items.append({"role": role, "content": content})
    if archive.get("tool_events"):
        blockers.append("工具事件需确认结果、授权和业务动作是否已完成")
    return {
        "legacy_thread_id": archive.get("thread_id"),
        "ready_to_resume": not blockers,
        "input": items,
        "blockers": blockers,
        "original": archive,
    }


if __name__ == "__main__":
    source, destination = map(Path, sys.argv[1:3])
    if destination.exists():
        raise FileExistsError("不覆盖已有转换结果")
    result = convert(json.loads(source.read_text(encoding="utf-8")))
    destination.write_text(
        json.dumps(result, ensure_ascii=False, indent=2), encoding="utf-8"
    )
    print(json.dumps({
        "ready_to_resume": result["ready_to_resume"],
        "blockers": result["blockers"],
    }, ensure_ascii=False))
运行 python convert_archive.py archive.json converted.json,先看 ready_to_resume。为 false 时,转换结果仅供整理与展示,不应直接交给下面的续聊程序。附件可以在授权范围内重新接入;旧引用应保留原始位置,并重新核对文件是否可读。只有文字但缺少证据的历史,可作为只读记录展示;需要继续处理的业务事实应从当前业务系统重新获取。
官方历史示例同样区分用户的 input_text 与助手的 output_text,但其中调用旧 Thread messages API 的部分已经失效。当前迁移说明不能被理解为现在还能在线补导出历史。
Thread 迁到哪里:选一种状态策略,避免重复回放
恢复文本后,再决定后续状态由谁保存。会话状态文档提供手动回放、previous_response_id 和 Conversations 三种方式。
| 方式 | 每轮实际发送什么 | 适用场景与必要条件 |
|---|---|---|
| 应用自管 Items | 已转换历史、新输入,以及完整的新 response.output | 要自己保存、裁剪和删除历史;store:false 仅控制 Response 对象保存 |
previous_response_id | 可用的上一条 Response ID,加本轮新增输入 | 短期续接;每轮重发所需指令,不能把 ID 当永久归档 |
| Conversation | 同一个新 Conversation ID,加本轮新增输入 | 跨设备或任务持久会话;应用仍负责用户权限、映射和删除 |
Conversation 会把已有 Items 加到上下文,并在请求完成后保存本轮输入与输出。因此,一旦用转换历史初始化新 Conversation,后续只发送增量,不要再重复整段历史。conversation 和 previous_response_id 不能同时使用;通过 previous_response_id 续接时,上轮 instructions 不会自动继承。Responses 创建参数规定了这两项边界。
选择 Conversation 时,可以在读者自己的授权环境执行 client.conversations.create(items=converted["input"]),再把返回的新 ID 与业务会话关联。应用端映射至少包含租户、用户、业务会话、旧 Thread ID、新状态标识与配置版本;授权检查要先于任何会话读取。把 ID 的前缀替换成 conv_ 不会创建对象,也不会迁移数据。
手动回放尤其要保留新 Response 的全部输出 Items,包括函数调用、工具结果、不透明 reasoning 和助手 phase,不能把 output_text 当完整历史。Python 官方示例追加完整 response.output;JavaScript 当前示例用 toResponseInputItems 转成可回放输入。推理上下文说明也要求工具往返时保留相关 Items。旧归档没有这些内容时,不要生成一份“推理历史”补上。
长对话还要设上下文预算、摘要或裁剪规则,并验证订单编号、已确认事实和未完成任务仍然保留。历史通过 ID 续接也不是免费上下文:官方说明链中的先前输入 token 仍按输入计费。
用完整工具循环恢复订单查询,而不是只替换 endpoint
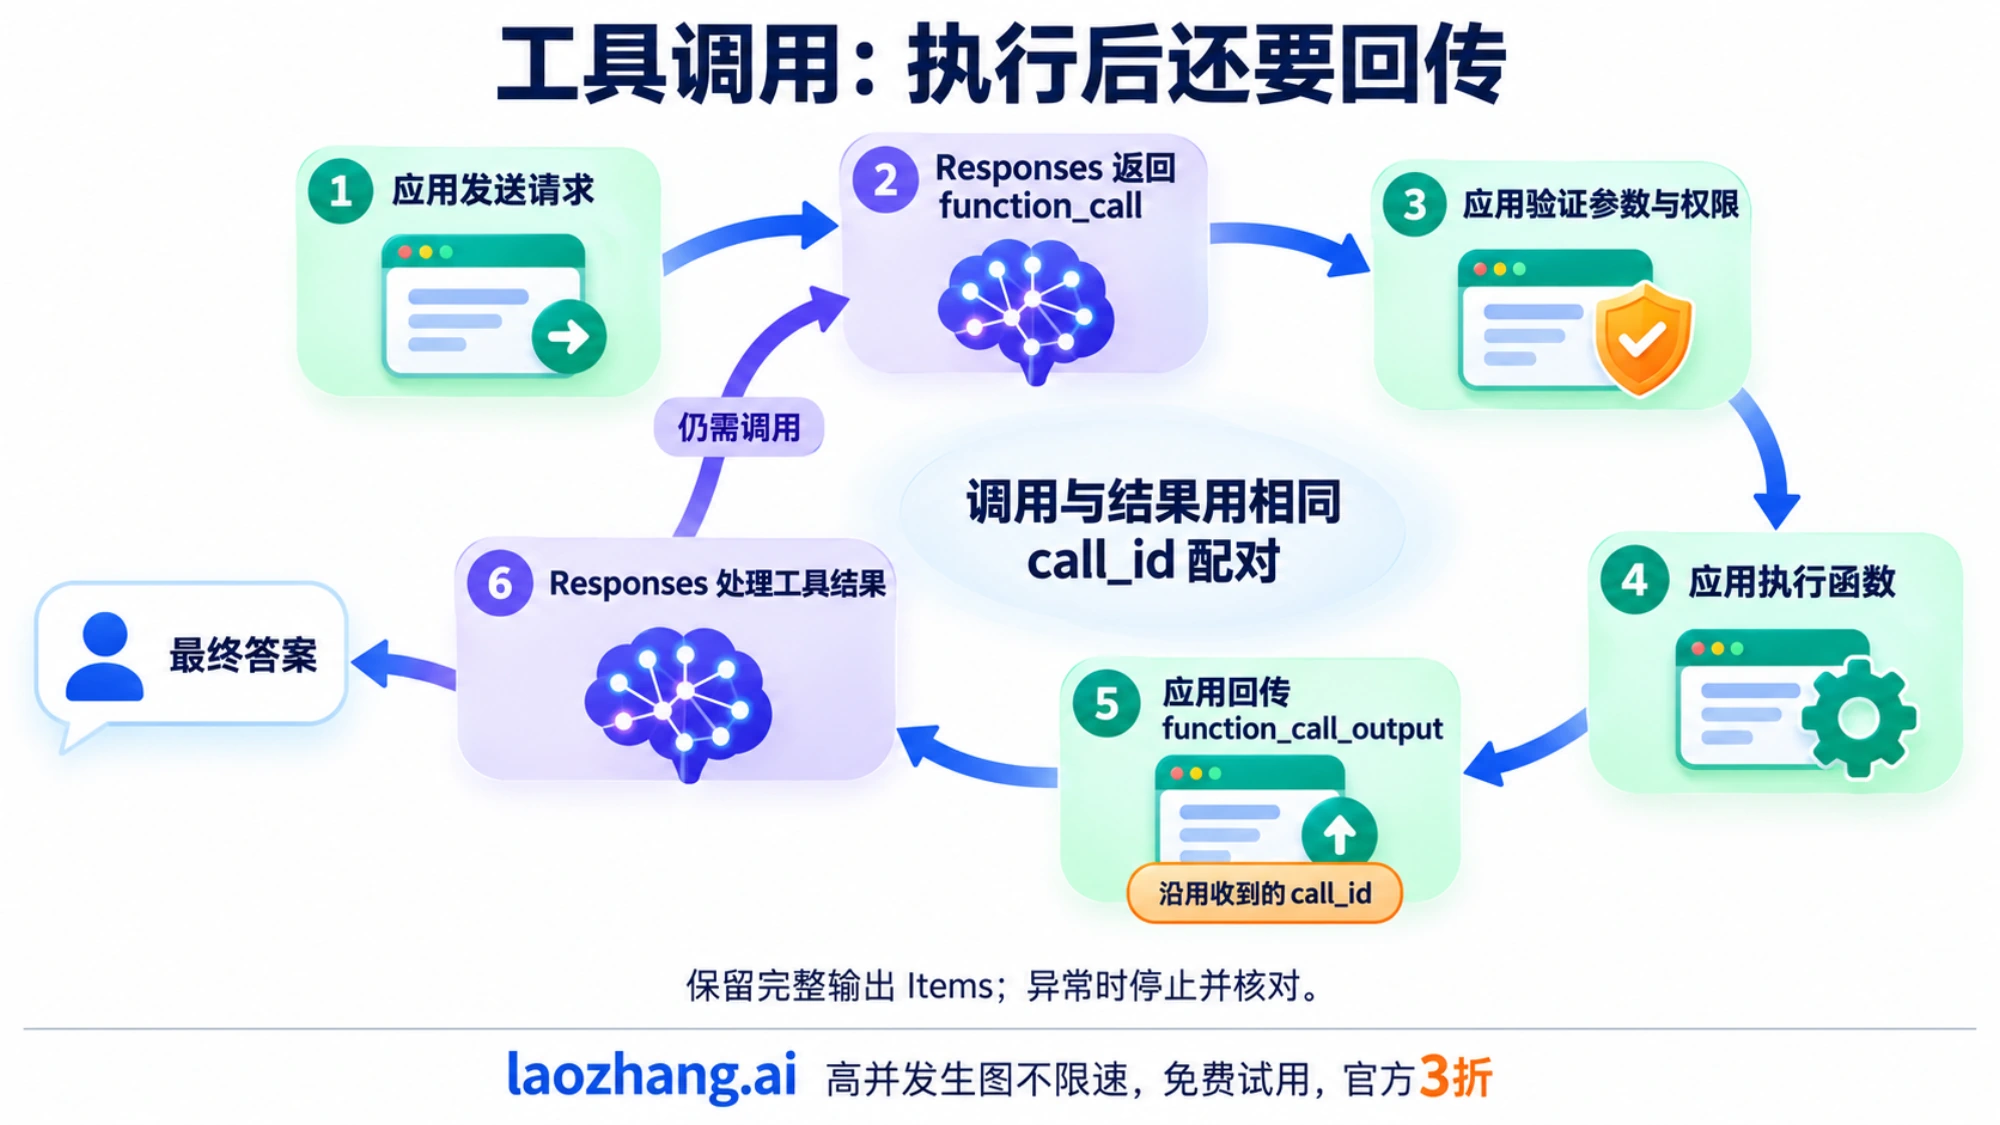
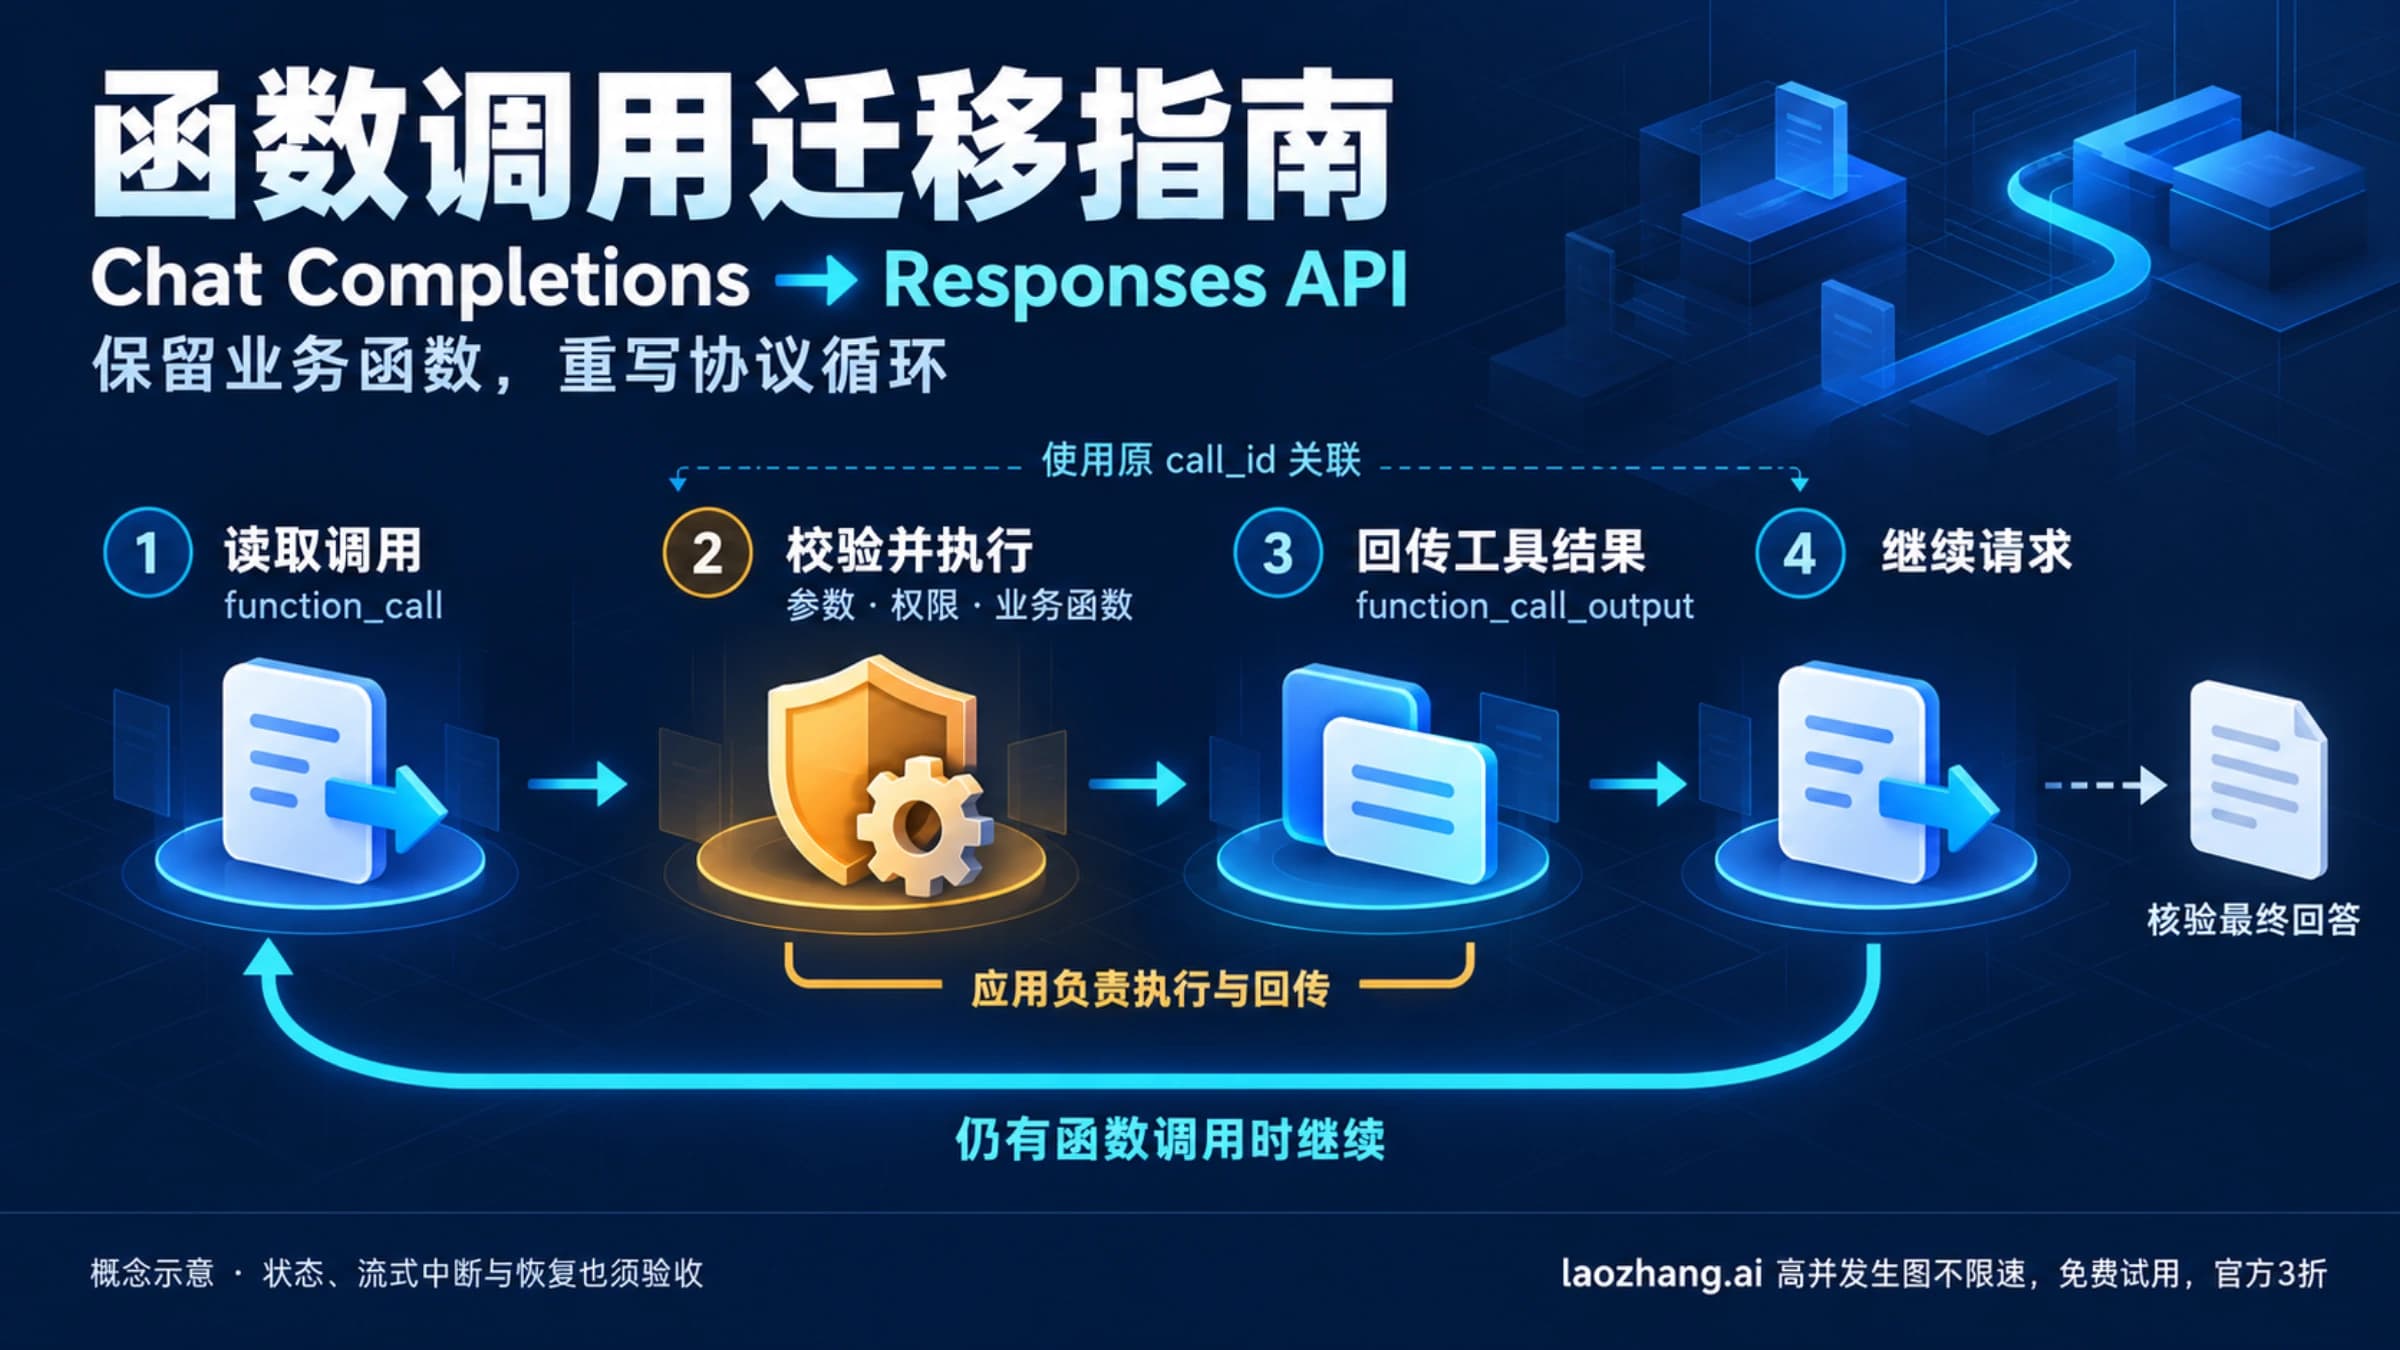
自定义函数由应用执行。模型输出 function_call 后,应用校验参数与用户权限,运行函数,再发送 function_call_output。两者用原始 call_id 关联,不能改用 Item 的 fc_ ID。函数调用指南明确允许一次返回零个、一个或多个函数调用;得到工具输出后,模型还可能继续调用。
下面的 resume_orders.py 可接上 converted.json。前提是读者环境中已有兼容的 OpenAI Python SDK、官方项目凭据,以及获准使用的 Responses 模型 ID;这些前提不由本地语法检查证明。代码中的订单是只读合成数据,不访问真实订单系统。
程序采用应用自管历史。每次对话成功后将完整 Items 保存到 session.json,新一轮前保留 last-ready.json 检查点;异常时保留未完成状态并停止自动续接,避免把半段工具往返当成正常历史。恢复前先核对本轮工具动作,再决定是否采用检查点。示例限单进程、单会话运行;部署为多用户服务时,须改成受认证保护的会话存储、会话锁和原子提交。
import json
import sys
from pathlib import Path
from openai import OpenAI

MODEL, QUESTION = sys.argv[1:3]
STATE_PATH = Path("session.json")
INSTRUCTIONS = (
    "你是订单客服。订单状态必须来自 get_order_status,不能猜测。"
    "只查询当前用户已获授权的订单;工具返回错误时直接说明无法查询。"
)
TOOLS = [{
    "type": "function",
    "name": "get_order_status",
    "description": "查询当前用户有权限访问的订单配送状态。",
    "strict": True,
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False,
    },
}]

# 合成的当前用户权限;生产中由已认证身份及业务数据库提供。
ALLOWED_ORDERS = {"DEMO-7"}
ORDERS = {"DEMO-7": {"status": "shipped", "carrier": "演示快递"}}


def save_state(history, ready):
    temporary = STATE_PATH.with_suffix(".tmp")
    temporary.write_text(json.dumps({
        "ready": ready, "config_version": "orders-v1", "history": history,
    }, ensure_ascii=False, indent=2), encoding="utf-8")
    temporary.replace(STATE_PATH)


def execute(call):
    if call.name != "get_order_status":
        raise ValueError("未知工具,停止执行")
    args = json.loads(call.arguments)
    if (not isinstance(args, dict) or set(args) != {"order_id"}
            or not isinstance(args["order_id"], str)):
        raise ValueError("工具参数无效")
    order_id = args["order_id"]
    if order_id not in ALLOWED_ORDERS:
        return {"error": "not_authorized"}
    return ORDERS.get(order_id, {"error": "not_found"})


if STATE_PATH.exists():
    state = json.loads(STATE_PATH.read_text(encoding="utf-8"))
    if not state["ready"] or state["config_version"] != "orders-v1":
        raise RuntimeError("会话未完成或配置不匹配,请先人工核对")
    history = state["history"]
else:
    converted = json.loads(Path("converted.json").read_text(encoding="utf-8"))
    if not converted["ready_to_resume"]:
        raise RuntimeError("历史存在未处理内容,不能自动续聊")
    history = converted["input"]

save_state(history, True)
Path("last-ready.json").write_text(
    STATE_PATH.read_text(encoding="utf-8"), encoding="utf-8"
)
history.append({"role": "user", "content": QUESTION})
save_state(history, False)
client = OpenAI()
seen_calls = set()

for _ in range(6):
    response = client.responses.create(
        model=MODEL,
        instructions=INSTRUCTIONS,
        tools=TOOLS,
        input=history,
        store=False,
        parallel_tool_calls=False,
        include=["reasoning.encrypted_content"],
    )
    if response.status != "completed":
        raise RuntimeError(f"Response 未成功完成:{response.status}")
    history.extend(item.model_dump(exclude_none=True) for item in response.output)
    save_state(history, False)
    calls = [item for item in response.output if item.type == "function_call"]
    if calls:
        for call in calls:
            if not call.call_id or call.call_id in seen_calls:
                raise RuntimeError("调用标识缺失或重复")
            seen_calls.add(call.call_id)
            result = execute(call)
            history.append({
                "type": "function_call_output",
                "call_id": call.call_id,
                "output": json.dumps(result, ensure_ascii=False),
            })
        save_state(history, False)
        continue
    if any(item.type != "message" and item.type != "reasoning"
           for item in response.output):
        raise RuntimeError("出现本示例未处理的输出类型")
    texts = [part.text for item in response.output
             if item.type == "message"
             and getattr(item, "phase", None) in (None, "final_answer")
             for part in item.content if part.type == "output_text"]
    if not texts or not "".join(texts).strip():
        raise RuntimeError("没有可显示的最终文本,请检查拒绝或中间输出")
    save_state(history, True)
    print("".join(texts))
    break
else:
    raise RuntimeError("超过工具循环上限,保留现场并停止")
在读者的测试环境运行 python resume_orders.py YOUR_APPROVED_MODEL "这个订单发货了吗?",其中模型占位符要换成项目实际支持的 ID。成功判断包括:模型调用获准的订单查询,应用回传同一个 call_id,最后答案与合成记录中的 shipped 一致,并且 session.json 的 ready 为 true。只看到 HTTP 200、调用请求或本地函数执行,都不足以判定业务完成。后续输入可以沿用同一个本地状态文件;更换用户时必须使用独立且经过授权的会话。
strict:true 也不是权限检查。每个 schema 对象必须设 additionalProperties:false,所有属性列入 required;可选值用可空类型表达。不写 strict 时,当前 Responses 会尝试规范化,不兼容则退回 best-effort,并显示 strict:false。因此迁移时应明确写出 strict 并保留应用验证。parallel_tool_calls:false 只限制为零个或一个调用,并不强制模型一定查订单。strict 与并行调用规则解释了这些区别。
若工具将来涉及退款、发邮件或修改订单,不能直接换掉这个只读函数就上线。应先由应用验证权限与确认要求,再用持久的业务动作键实现幂等,并记录动作结果。call_id 只解决模型调用和输出的配对,不能阻止另一次请求产生相同业务动作。超时后先查动作是否已经提交,再决定重试;取消模型也不会撤回已经发生的退款。
File Search:找回正确文件,并验证答案的依据
Responses 的 file_search 由 OpenAI 执行,不能套用自定义函数的结果回传循环。先核对原 vector store 是否仍存在、属于正确项目、允许当前用户访问;文件在 store 内的处理状态须为 completed。旧 Assistant 或 Thread 的绑定关系不会自动决定新请求的搜索范围。File Search 指南说明了文件就绪与显式指定 store 的要求。
下面片段接在已初始化的 Python client 后,MODEL 使用获准模型,VECTOR_STORE_ID 换成已经核对过的真实 store ID。它不创建 store 或上传文件:
VECTOR_STORE_ID = "YOUR_VERIFIED_VECTOR_STORE_ID"
response = client.responses.create(
    model=MODEL,
    store=False,
    input="退款审批额度在什么文件的哪一节?请依据检索内容回答。",
    tools=[{
        "type": "file_search",
        "vector_store_ids": [VECTOR_STORE_ID],
    }],
    include=["file_search_call.results"],
)
if response.status != "completed":
    raise RuntimeError(f"检索请求未成功:{response.status}")
searches = [item for item in response.output if item.type == "file_search_call"]
if not searches or not any(getattr(item, "results", None) for item in searches):
    raise RuntimeError("没有可核对的检索结果,不能判为迁移成功")
print(response.output_text)
print(response.model_dump_json(indent=2))检索结果默认不返回,include=["file_search_call.results"] 是为了核对实际证据。对测试问题,应先知道正确文件和段落,再比对结果、最终答案与 message 的 file citations。还要用无结果、过期文件、相互冲突的文件和无权访问的文件检验行为;资料不足时应回答无法确认,而不是编一个审批额度。
多租户场景先由应用选择允许的 store,再在需要时使用文件 metadata filters 缩小范围。过滤条件必须由可信身份与权限生成,不能让用户或模型随意指定另一租户。原始文件确实还在且有权重新使用时,可以在自己的环境重新建立索引;只有旧 file ID 的情况下,不能保证还能取回文件内容。
检索回退可以是已经验证的独立搜索实现、只读资料页面或人工查证。它必须实际能访问同一套获准资料;“继续用旧 Assistants File Search”已经不是退路。
改写事件与长任务,让结束、失败和取消各有处理
旧 Run 轮询应按新用途拆开:普通请求等 Response;需要逐字显示时消费 typed SSE;真正长任务再用 background:true。不要把每一次旧 Run 都机械变成后台任务。
| 输入或事件 | 新实现的处理方式 |
|---|---|
response.created | 建立请求关联,记录 Response ID |
response.output_text.delta | 追加显示文字,尚不宣告任务完成 |
| 函数 arguments delta/done | 按 Item 聚合参数;完整调用到齐并验证后才执行 |
response.completed | 检查终态、输出类型和业务结果,再提交会话状态 |
| error、失败或不完整输出 | 保留错误与未完成状态,向用户提供可重试或人工处理入口 |
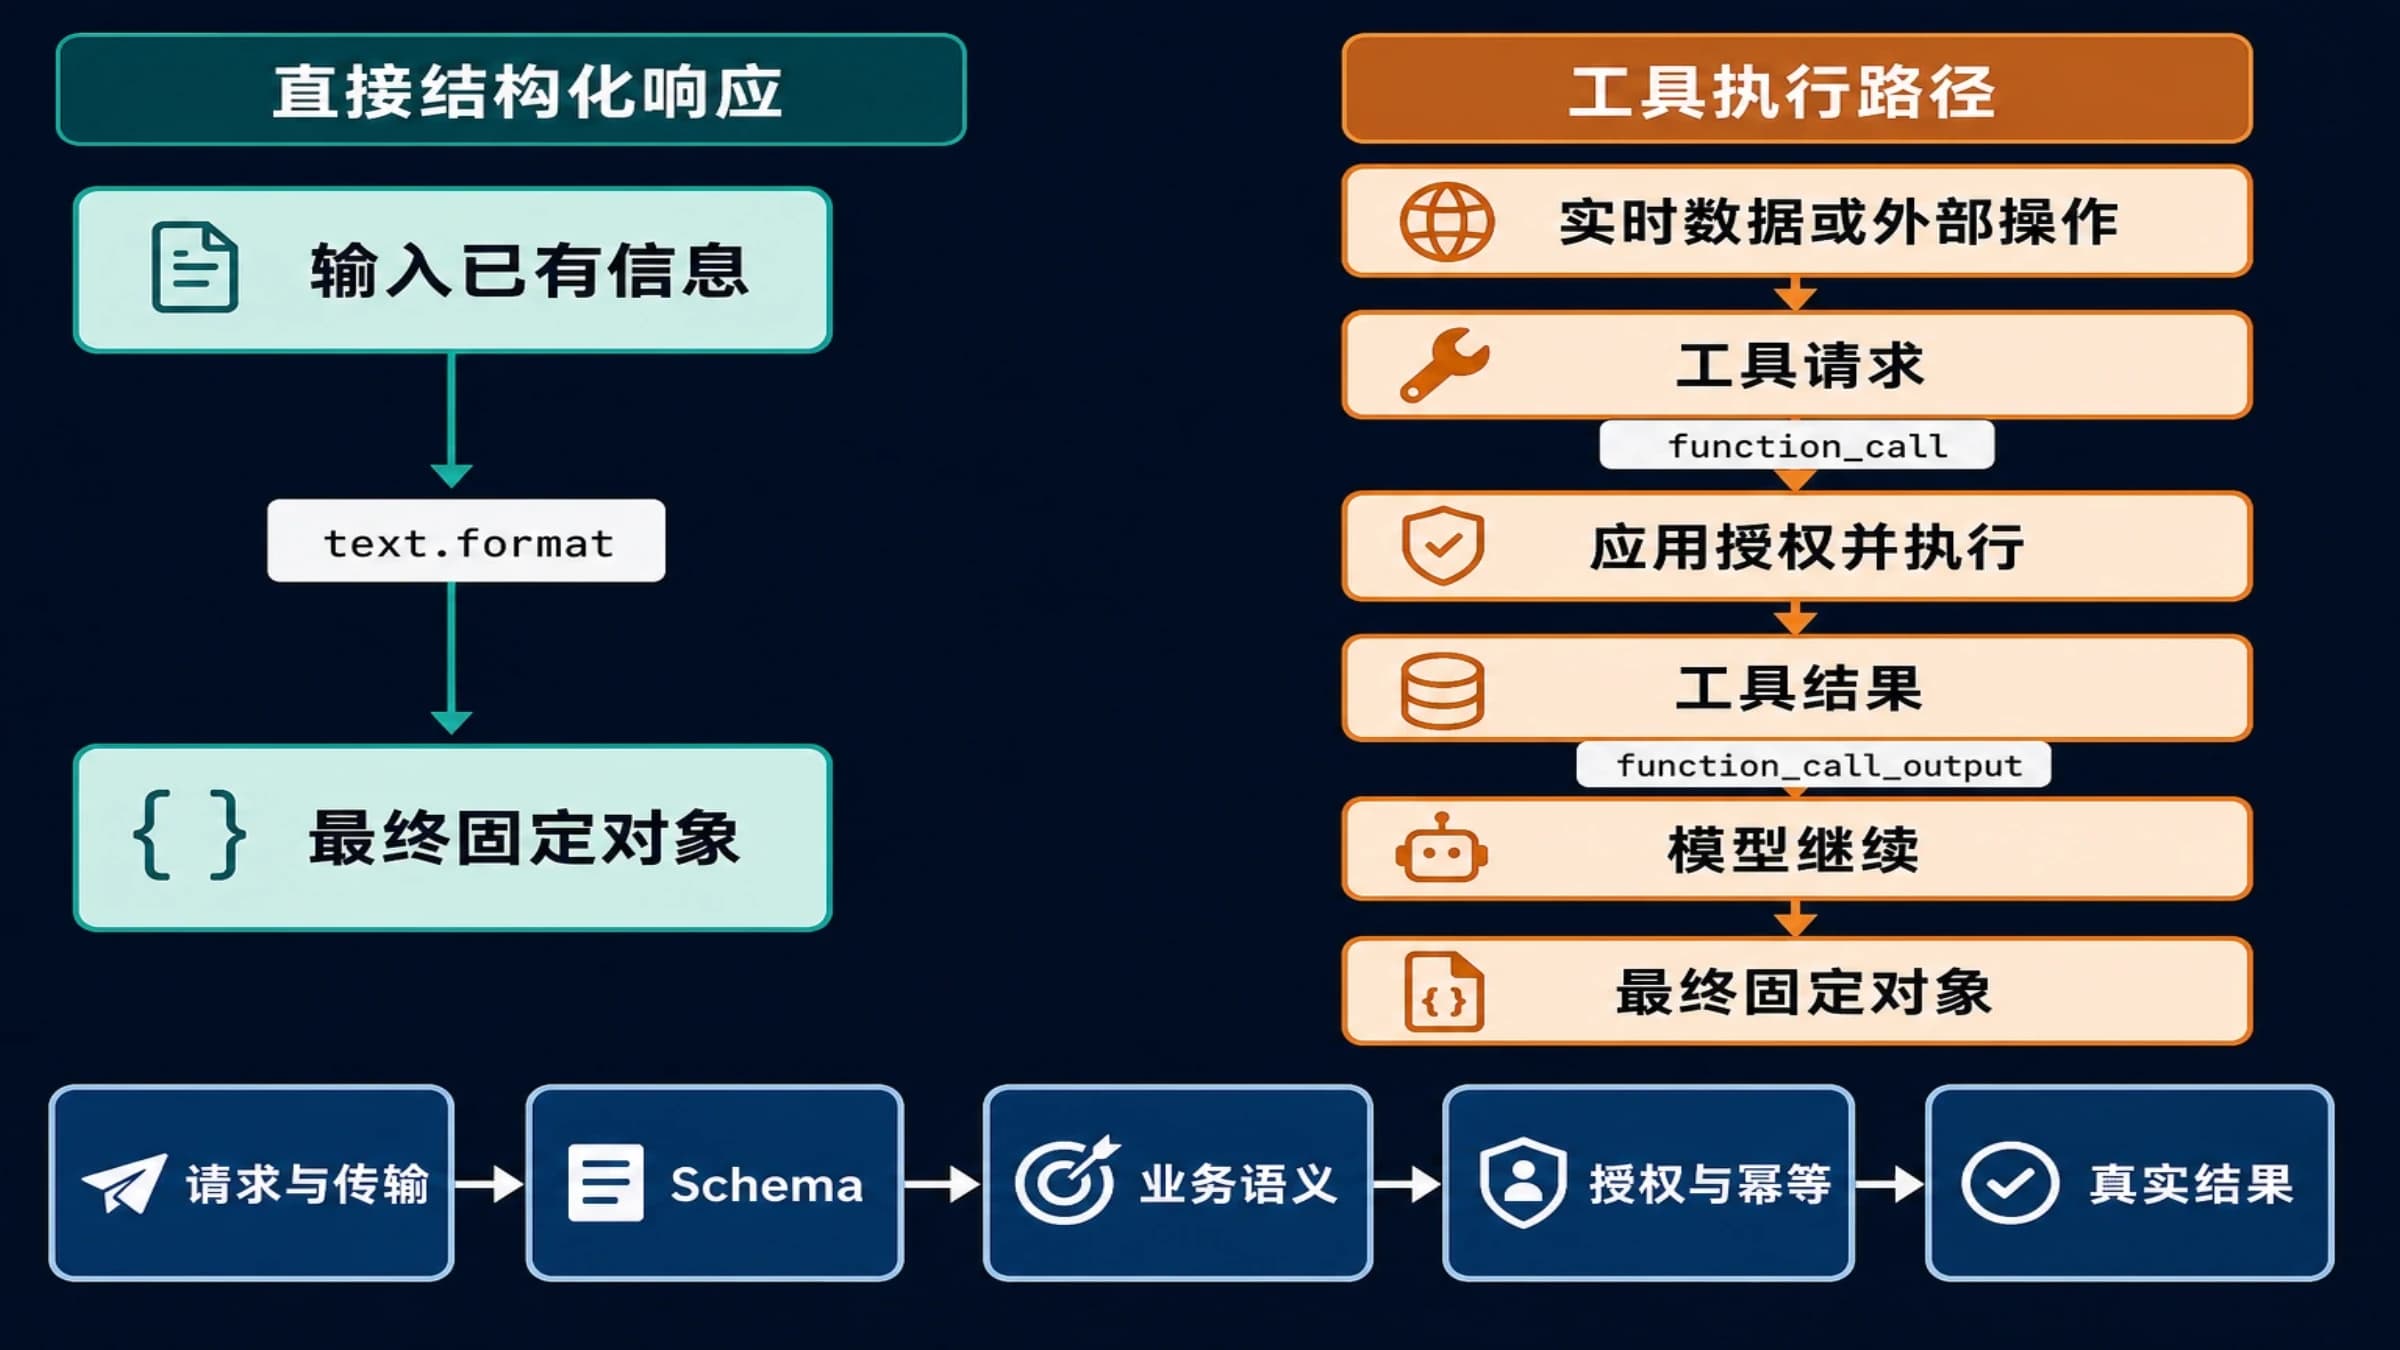
结构化输出要把旧 response_format 改为 text.format,如 {"type":"json_schema","name":"order_result","schema":...,"strict":true};其中 schema 仍要提供完整定义。前端不能把函数参数、reasoning 或工具 Item 拼进普通回复文本。官方的Responses 迁移指南分别给出了输出格式与 typed events 的变更。
后台模式下,保存 Response ID,在 queued 或 in_progress 时调用 responses.retrieve 轮询,退出这两个状态只表示进入终态,不一定成功。取消在运行的后台任务用 responses.cancel;同步任务取消通过结束连接。后台断线后想恢复流,创建时就要同时设 stream:true,保存 sequence_number,恢复时传 starting_after。后台模式文档还指出当前后台首 token 延迟更高,不能仅因异步就承诺更快。
应用端同时保存任务 ID、状态、最后事件位置和已经完成的工具动作。重连后先恢复状态,不能把“前端没收到完成事件”当成“后台没有执行过”。
数据保存:store:false 不能代替完整的保留策略
store:false 关闭的是普通 Response 对象保存,不代表所有内容都零留存。当前数据控制文档区分应用状态与滥用监控日志:普通 Response 默认保存 30 天,store:true 的相关数据至少保存 30 天,存在文档列出的例外;默认滥用监控日志可能包含内容,通常最多保存 30 天,也有延长例外。
Conversation 与其 Items 没有普通 Response 的 30 天到期机制,保存到删除,而且不符合 ZDR 资格。向 Conversation 附加请求时写 store:false,也不能据此声称没有提供商会话历史。文件、vector store、托管容器与第三方服务还有各自的保存规则。
后台模式的当前规则需要单独核对:官方说明 ZDR 项目的后台请求使用 store:false,但仍会为异步执行和轮询把数据临时保存到磁盘约 10 分钟。MAM 项目的后台请求只有显式 store:true 才在轮询期后继续按标准期限保存;省略或设为 false 时约 10 分钟后删除。不要沿用“后台必须 store:true”或“ZDR 一律不能用后台”的旧结论;客户合同若连临时保存也不允许,就应选择合适的前台流程。后台说明与Responses 数据条款提供当前适用范围。
上面的手动回放示例仍会在应用机器保存原归档和 session.json。这些文件也需要访问控制、删除期限和备份规则;把历史从提供商移回应用,不会自动完成数据最小化。
用保存的业务结果验收,再逐步切到新实现
现在的对照基线应是已保存的真实任务输入、可信业务结果和配置,或已经正常运行的 Responses 版本。旧 Assistants 已不能作为在线双跑基线。没有旧输出时,仍可按业务规则建立验收答案,例如授权用户查询正确订单、无权限用户拿不到订单、检索引用能回到指定文件。
先在隔离的测试环境跑完整流程,保留配置版本、使用的 SDK 版本、新输出 Items、工具调用与结果,以及失败分支。工具测试还应覆盖未知工具、无效 JSON、越权参数、零调用、多调用、无最终答案和轮数上限。比较任务是否完成,再看总延迟、token、工具用量与存储开销;换 endpoint 本身不能证明更便宜或质量更高。
切流可以从内部用户和低风险会话开始,按自己业务设定批次。每个会话固定状态策略与配置版本,避免请求一会儿读本地历史、一会儿读另一套 Conversation。需要影子比较时,只让其中一侧提交业务动作,另一侧使用只读数据或合成工具结果;不能让两套实现各退款一次。
| 切换时出现的问题 | 可执行的停止与恢复动作 |
|---|---|
| 新配置回答错误 | 停止增加流量,恢复已验收的 Responses 配置版本 |
| 会话遗漏或串话 | 暂停相关会话,核对用户映射和状态;从最后完整检查点恢复 |
| 工具结果不明 | 查询业务动作记录,确认是否提交,再决定重试或人工处理 |
| 检索无证据或越权 | 停用该搜索路径,转获准的只读资料或人工查证 |
| 新运行环境不可用 | 切到已验证的新运行环境;否则排队、暂停自动处理或人工接管 |
所谓“回滚”,现在是恢复仍可运行且已验收的新版本,不是恢复旧 Assistant。若切换前后用了不同状态存储,需先有明确的历史转换和恢复流程;不能仅切 feature flag 就假定对话随之恢复。
最终完成的标志是:新请求只走可用接口,保存的配置与历史能进入新流程,权限和工具结果正确,文件答案可追溯,前端知道成功与失败,异常时有实际可执行的恢复方式。第三方服务接入若出现 URL 或接口兼容问题,可另看OpenAI base_url 的优先级与实际请求路径,但改地址不会自动迁移旧对象或工具合同。
常见问题
只有 Thread ID,还能恢复旧聊天吗?
仅凭 ID 不能恢复。当前官方迁移指南明确指出旧消息列表接口已失效,须使用应用保存的消息。可以查自己数据库、备份或历史导出;找不到内容时就新建会话,并如实保留历史不可用的状态。
必须先创建 Prompt object 才能迁到 Responses 吗?
不必。直接通过应用配置发送 model、instructions、tools 和输出定义即可。Prompt objects 与 v1/prompts 计划于 2026 年 11 月 30 日停用,官方迁出方案推荐将内容移入应用代码。
函数调用成功,为什么用户仍没有答案?
因为收到 function_call 只是模型请求执行。应用还要执行函数,用同一个 call_id 回传 function_call_output,继续请求,直到拿到可用的最终输出。结果可能还需要更多调用;失败、不完整或只有中间消息时,应按未完成任务处理。函数调用流程定义了完整往返。
迁移失败后,能重新打开 Assistants 作为回退吗?
不能把已停用的 Assistants 当可用回退。应恢复经过验收的 Responses 版本、切换已验证的新运行环境,或暂停自动处理并由人工接管。未确认的工具动作先查业务结果,避免重复执行。
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月6日。
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月6日。
- 1.官方迁移指南developers.openai.com/api/docs/assistants/migration
- 2.Prompt 对象迁出指南developers.openai.com/api/docs/guides/prompting/migrate-from-prompt-object
- 3.会话状态文档developers.openai.com/api/docs/guides/conversation-state
- 4.Responses 创建参数developers.openai.com/api/reference/resources/responses/methods/create
- 5.推理上下文说明developers.openai.com/api/docs/guides/reasoning
- 6.函数调用指南developers.openai.com/api/docs/guides/function-calling
- 7.File Search 指南developers.openai.com/api/docs/guides/tools-file-search
- 8.Responses 迁移指南developers.openai.com/api/docs/guides/migrate-to-responses
- 9.后台模式文档developers.openai.com/api/docs/guides/background
- 10.数据控制文档developers.openai.com/api/docs/guides/your-data