Nano Banana Pro Seed 参数怎么用?接口核对与图片一致性方案
想再次得到同一张图,先保存满意的原文件;想让角色换场景仍保持一致,使用批准的参考图和明确的保持条件。Nano Banana Pro 的 seed 要按具体接口核对,文档有字段也不代表每次输出完全相同。
文章目录
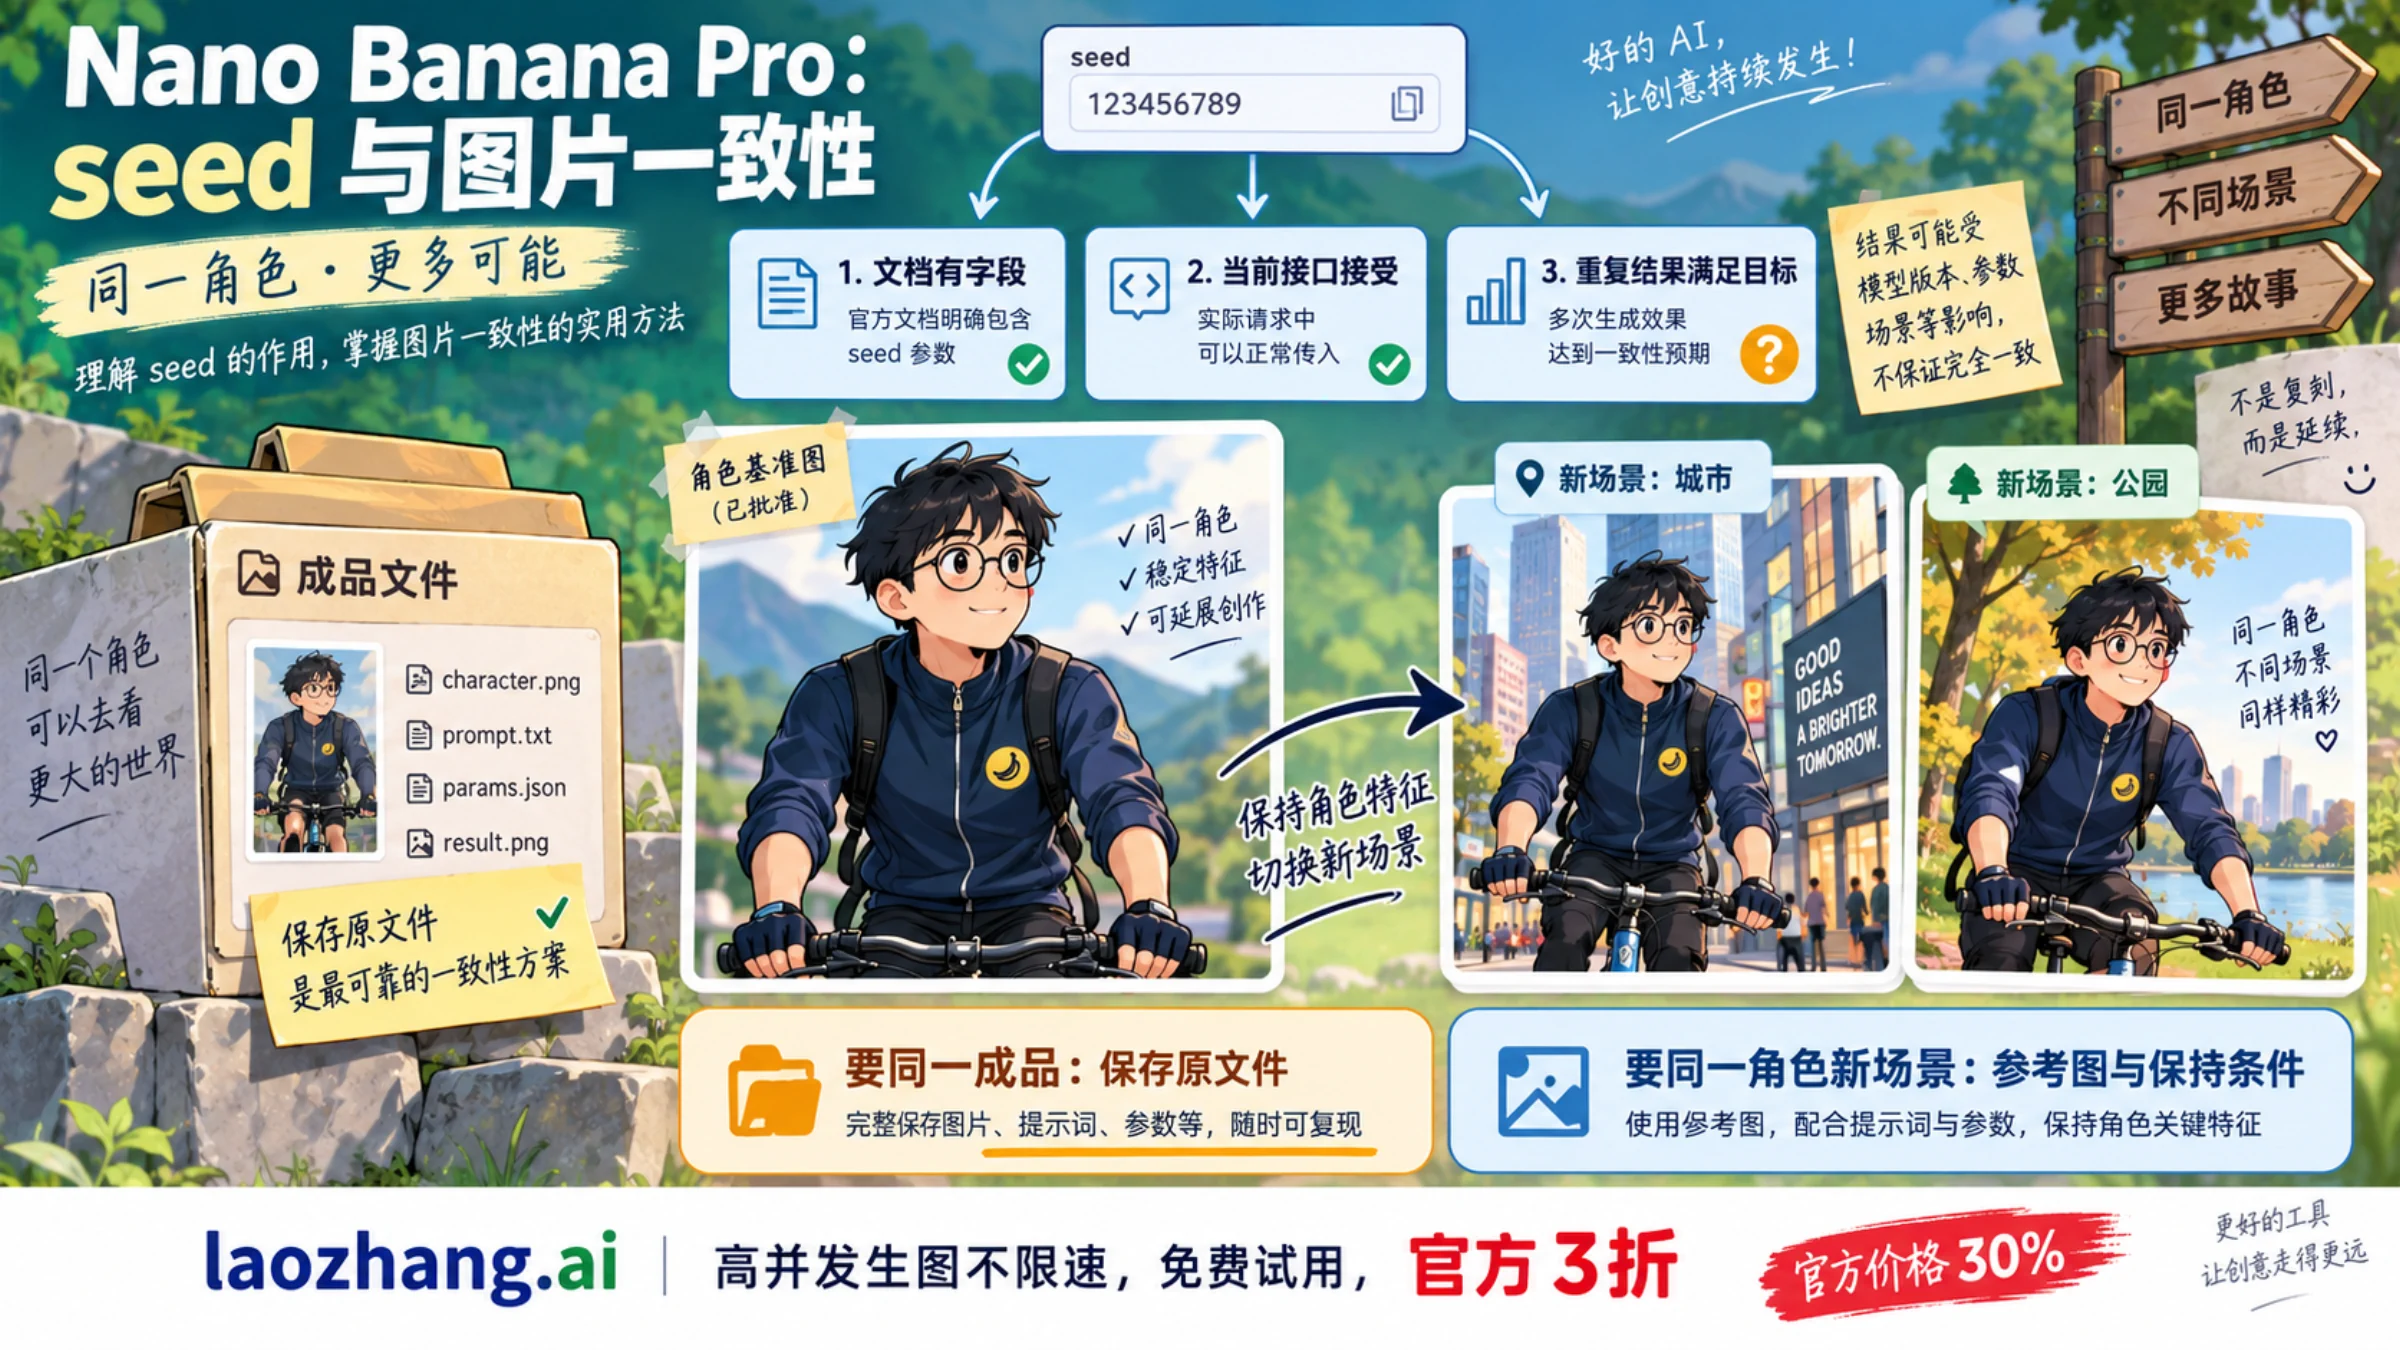
Nano Banana Pro 的 seed 不能再简单回答为“完全不支持”。 截至 2026 年 10 月 7 日,Google 的通用 GenerationConfig 已列出 seed,Ideogram 和 Runware 的 Nano Banana Pro 文档也有相应字段。不过,字段存在、具体模型接受字段、重复请求得到相同像素,是三个不同的问题。Google 通用配置明确提醒:并非所有参数都适用于每个模型;Vertex 的通用 seed 说明也只承诺尽力重复响应,不保证确定性。Google 配置文档、Vertex 参数说明
如果你已经生成了一张满意的图片,最稳妥的下一步是保存原文件,而不是靠 seed 重新生成。如果你要让同一角色出现在新场景里,重点是固定参考图、写清哪些元素必须保留,再挑选符合要求的候选图。下面按这两类需求给出操作方法和完整的请求、保存示例。
先看你用的接口:seed 应该放在哪里?
先确认服务商、接口路径和模型 ID,再查该接口的参数。别把某个平台的字段直接复制到另一个平台。
| 调用入口 | 当前文档能确认的内容 | 使用时怎么判断 |
|---|---|---|
Google Gemini API 的 generateContent | 通用 generationConfig.seed 是整数;未设置时随机生成种子 | 通用字段不代表每个 Pro 调用入口都支持;按模型和接口核对兼容性 |
| Vertex 的通用生成参数 | 固定 seed 时尽力重复响应,仍可能变化 | 模型或温度等设置变化后,不能只凭 seed 判断结果会相同 |
| Ideogram 的 Nano Banana Pro 接口 | 请求体列出整数 seed,范围为 0–2147483647,响应也返回 seed | 这是 Ideogram 自己的接口约定;应保存返回值及生成记录 |
| Runware 的 Nano Banana Pro 文档 | 列出整数 seed 与可复现生成用途,显式传入范围为 0–2147483647 | 按 Runware 的请求格式使用,不能套用 Google 的嵌套字段 |
表中提供方字段分别见 Ideogram Nano Banana Pro API与 Runware 模型文档。它们证明相应服务有公开的 seed 约定,不能据此推断 Google 后端如何映射参数,也不能声称已验证像素级复现。
在 Google generateContent 的通用格式中,seed 与图片配置是并列关系。下面只是字段位置示意,不是已验证的 Pro seed 兼容性请求:
{
  "generationConfig": {
    "seed": 27182,
    "responseModalities": ["TEXT", "IMAGE"],
    "imageConfig": {
      "aspectRatio": "4:3",
      "imageSize": "2K"
    }
  }
}
imageConfig 里没有 seed,不代表整个 API 没有 seed。反过来,请求成功也不代表参数一定产生了你预期的效果。若服务返回“不支持参数”或类似错误,先核对模型、接口和参数层级;不要反复提交同一个失败请求,也不要把 seed 改名为 random_seed 就当作解决了问题。
当前 Pro 正式模型 ID 是 gemini-3-pro-image。旧代码中的 gemini-3-pro-image-preview 已于 2026 年 6 月 25 日停用,应按 模型说明与 停用表迁移。不要将文本模型 Gemini Pro 的 ID 当作图片模型使用。
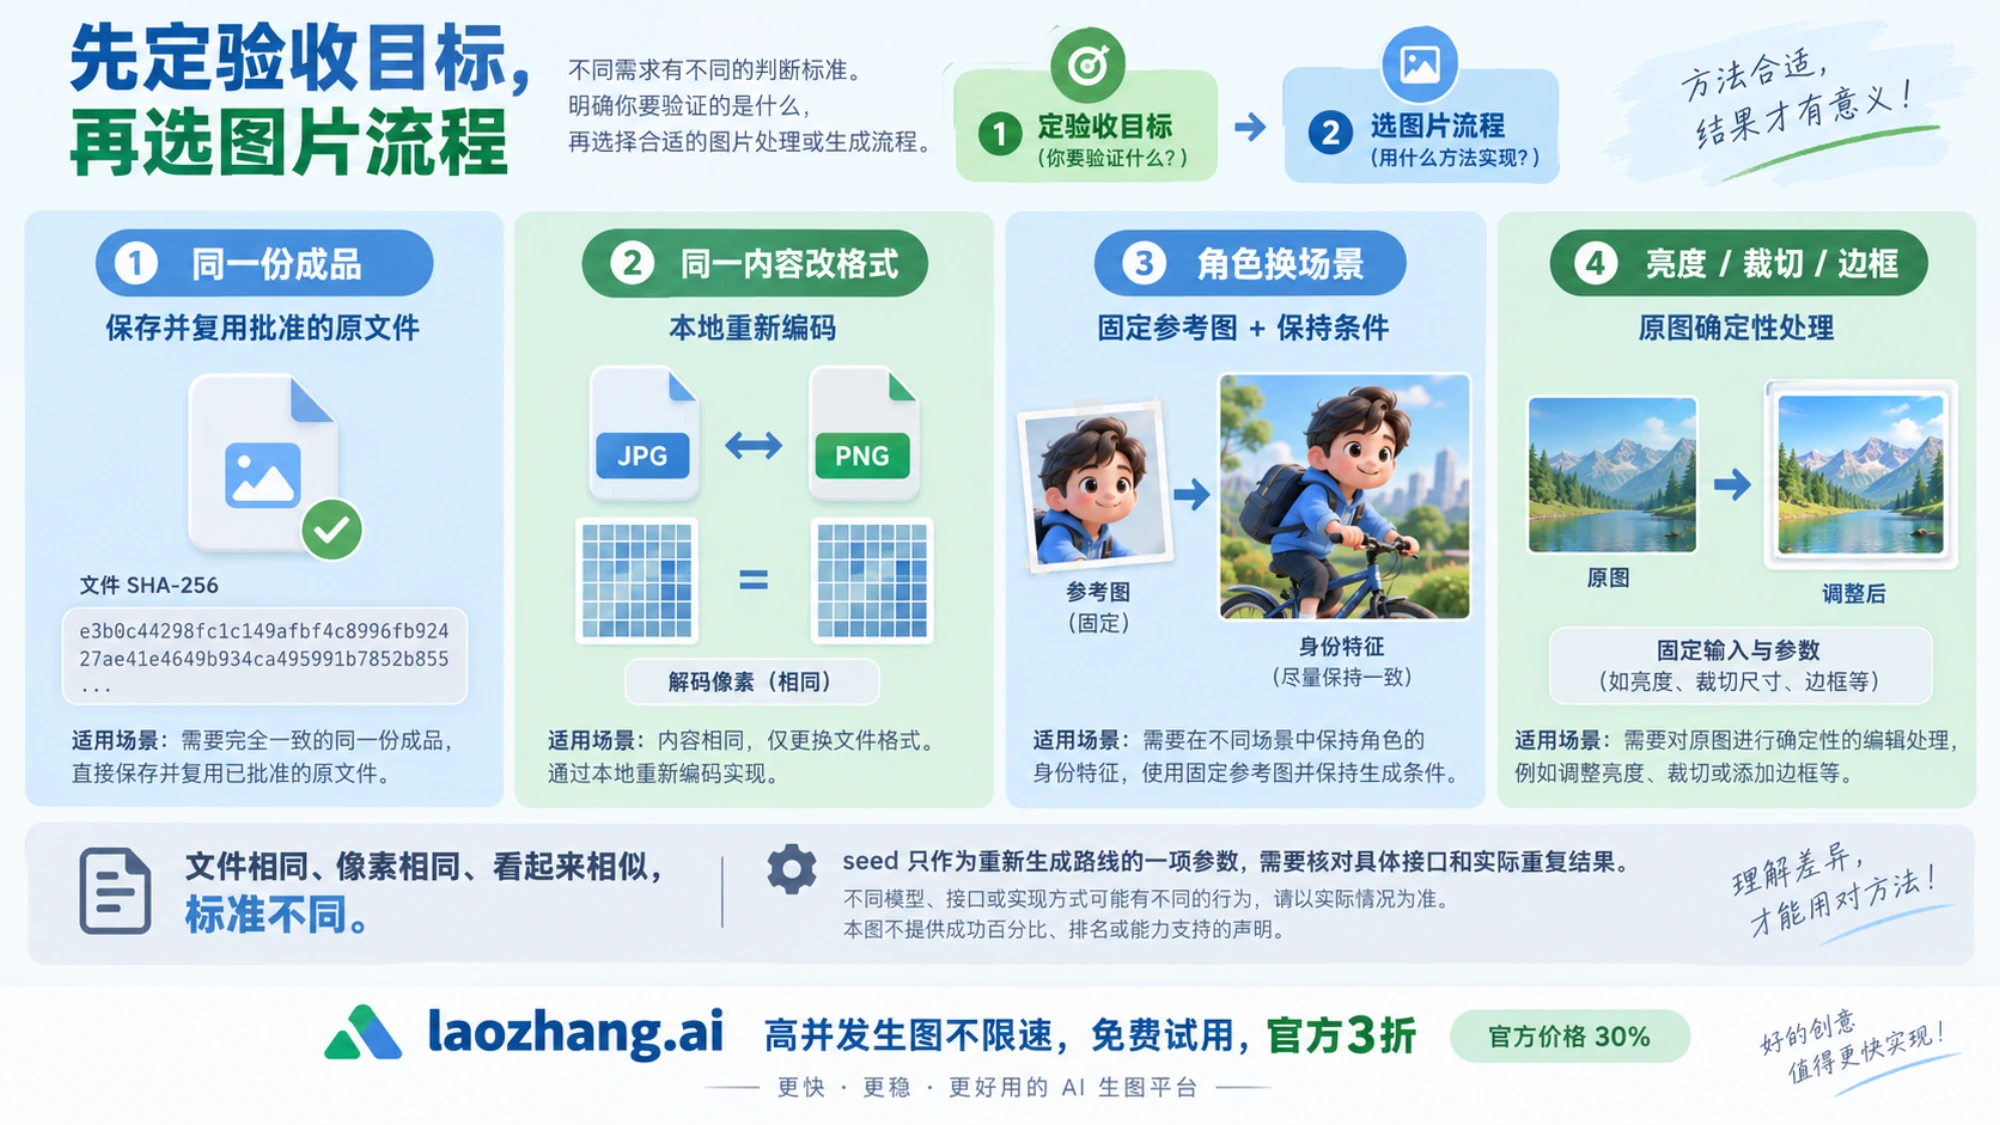
你要同一张成品,还是同一角色的新图片?
先把验收目标写成一句话,再选工具。这能避免为了“固定 seed”花费时间,却没有解决实际交付问题。
| 你真正需要的结果 | 优先采用的办法 | 怎么验收 |
|---|---|---|
| 网站、客户或测试再次拿到同一份图片 | 保存批准的原文件,直接复用 | 文件 SHA-256 相同 |
| 同一图片重新编码、改格式后内容相同 | 比较解码后的尺寸、色彩模式与像素 | 文件哈希可能不同,像素仍可能相同 |
| 同一角色换背景、换动作 | 固定角色参考图,明确保持和改变条件 | 核对五官、发型、服装、配饰等身份特征 |
| 一组营销图具有统一品牌风格 | 风格参考图加构图、配色约束,再筛选候选 | 按品牌要求验收,不以单一相似度分数代替 |
| 只改亮度、裁切或加固定边框 | 在原图上做本地处理 | 固定输入、处理参数和软件环境 |
| 必须从输入重新计算并尽量复现 | 选择有明确 seed 约定的接口,或可固定环境的自托管流程 | 保存完整设置并验证实际重复结果 |
文件相同、像素相同和看起来相似,不是同一个标准。 PNG 的元数据或压缩方式变化会改变文件哈希;两张图片的整体构图很像,也可能有不同的耳环、鞋带或文字。先确定哪些差异能接受,才有办法判断 seed 或参考图是否满足需求。
参考图片锚定:让固定 IP 角色换场景
对于“保留角色、生成新内容”,参考图能直接告诉模型要保留什么。Google 的图片指南支持 Pro 使用最多 14 张参考图;表中分别列出最多 6 张物体参考、5 张角色参考和 3 张风格参考。这些是输入用途和数量上限,不是画面中人物数量或身份一致性的保证。参考图说明
实际开始时,用一张已经批准的角色图即可;需要补充侧脸、背面或服装细节时再增加参考。让每张图承担清楚的作用,避免同时提供互相矛盾的发色、服装和画风。不要把“参考图越多越好”当作通用规则。
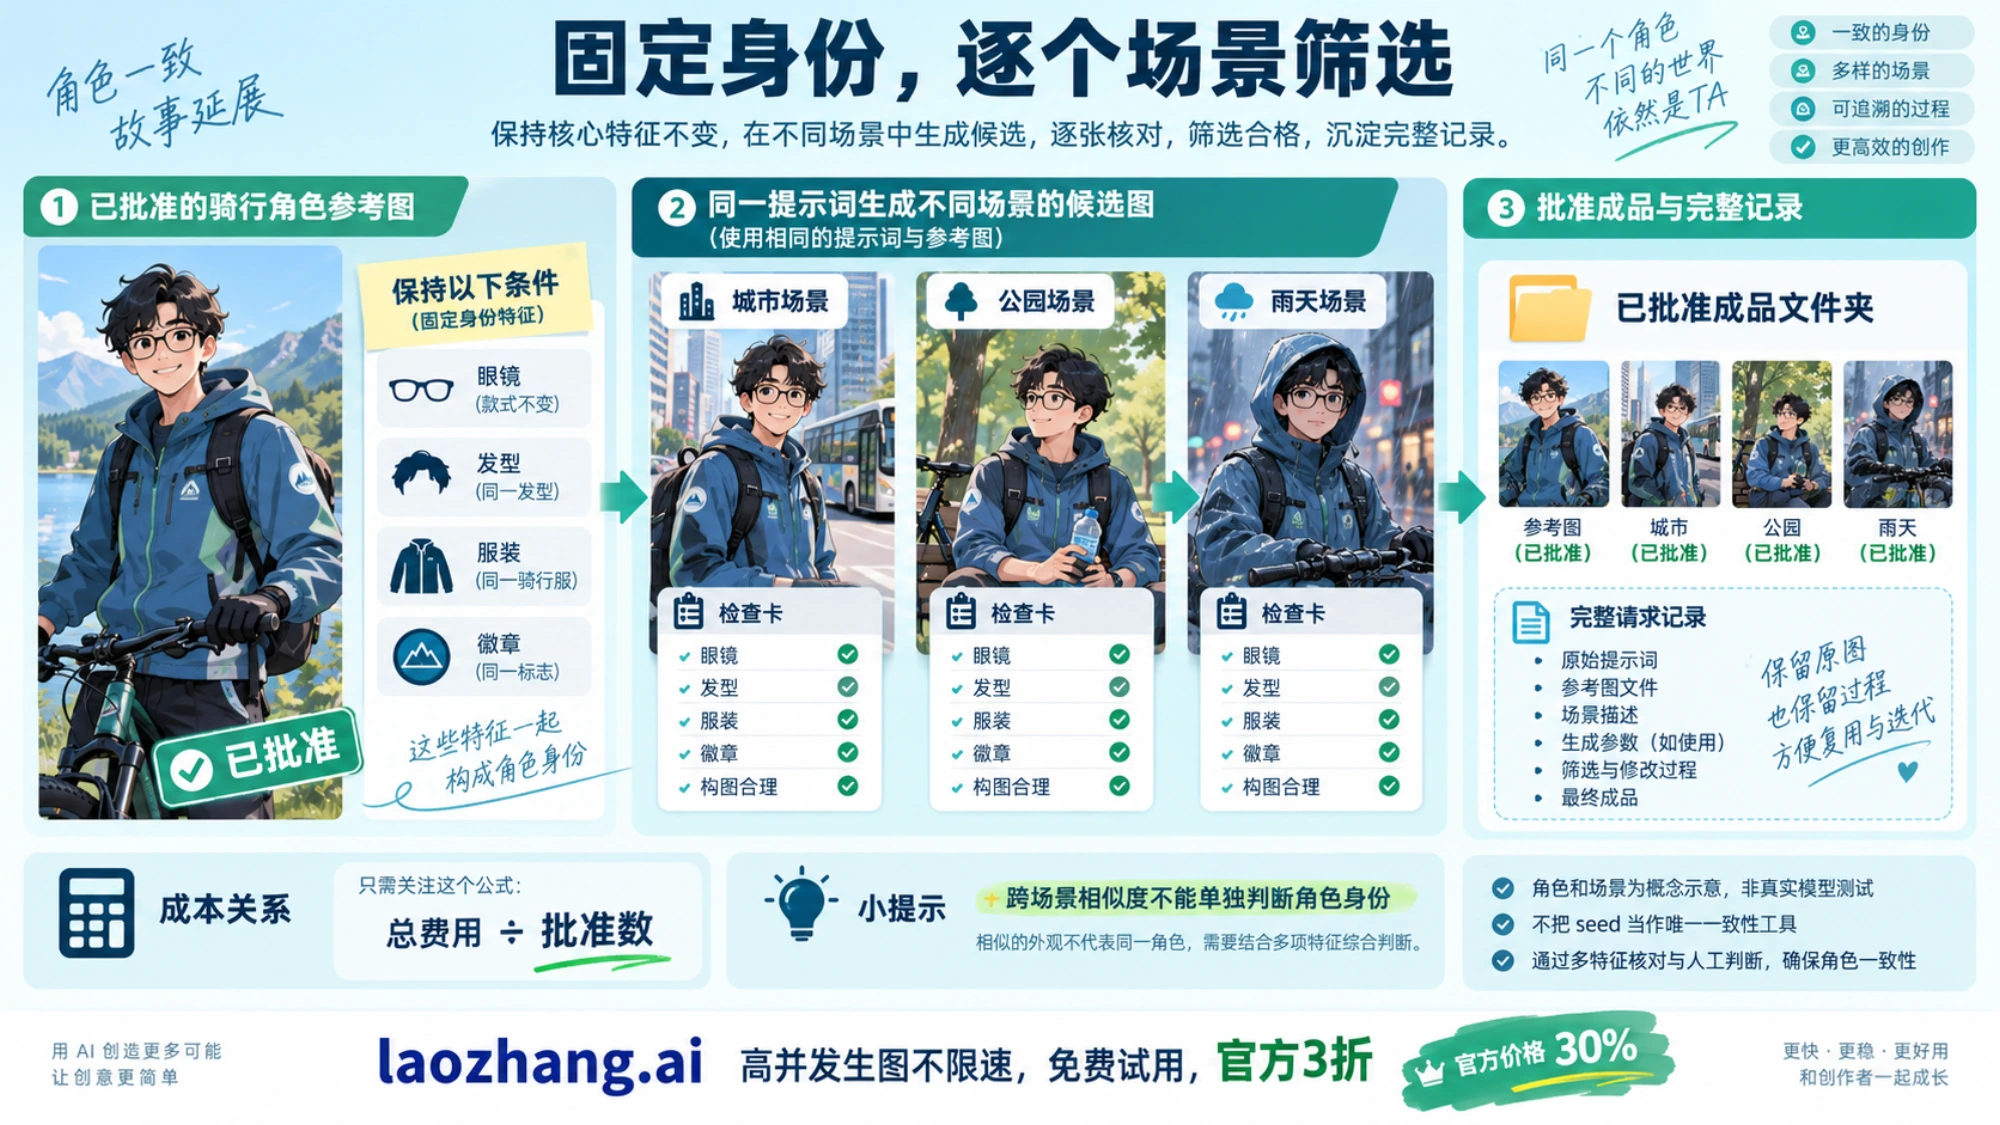
例如,你要为同一位虚构骑行角色做城市、公园和雨天三张宣传图,可以将要求分为两部分:
角色以附件为准:保留短黑发、圆形眼镜、左眉的小缺口、
深蓝骑行外套和胸前黄色圆形徽章。不要增加新的配饰。
保留参考图的二维插画风格、线条粗细和角色身材比例。

这次只改变:场景改为雨后的城市路口,人物站在自行车旁,
右手扶车把,左手向观众挥手。背景留出右上方的标题空间。
画面比例 4:3,输出 2K。不要把参考图里的背景复制过来。
“左眉缺口、黄色徽章”比“长得一样”更容易验收。数值和颜色代码可以减少描述歧义,但生成模型不会因此变成精密图像处理器。如果必须将所有像素的亮度乘以 0.85,应使用后面的本地处理方法。
多轮编辑适合围绕同一张图逐步调整。每轮最好只改一组相关内容,确认结果后再继续。如果发现脸型或服装已经偏离,回到批准的角色图重新编辑,别把偏离后的最新图继续当成唯一依据。需要延续对话时,按当前接口保存完整的请求与响应内容,包括其要求保留的签名;下面的单轮示例则每次明确附上参考图,不依赖隐藏的会话状态。
完整示例:附参考图、保存所有最终图片和请求记录
下面使用 Google generateContent REST 格式和 Python 标准库。它读取一张本地 PNG/JPEG/WebP 参考图,提交一次请求,保存原始响应、最终图片和文件哈希。代码默认不带 seed,先把参考图流程接完整;只有确认当前入口支持时,再自行加入对应字段。
保存为 reference_job.py。你需要具有该模型调用权限的 Gemini API 密钥;实际执行会提交图片并产生适用费用。本文只对代码语法、请求 JSON 和模拟响应处理做了离线检查,没有真实生成、账单或一致性测试。字段依据见 生成接口及其 Part、ImageConfig 定义。
import argparse
import base64
import hashlib
import json
import os
from pathlib import Path
from urllib.error import HTTPError
from urllib.request import Request, urlopen

MODEL = "gemini-3-pro-image"
ENDPOINT = (
    "https://generativelanguage.googleapis.com/v1beta/models/"
    + MODEL + ":generateContent"
)
MIME_TYPES = {".png": "image/png", ".jpg": "image/jpeg",
              ".jpeg": "image/jpeg", ".webp": "image/webp"}
EXTENSIONS = {"image/png": ".png", "image/jpeg": ".jpg",
              "image/webp": ".webp"}

def build_request(reference, prompt):
    mime = MIME_TYPES.get(reference.suffix.lower())
    if mime is None:
        raise ValueError("参考图必须是 PNG、JPEG 或 WebP")
    raw = reference.read_bytes()
    if not raw:
        raise ValueError("参考图为空")
    return {
        "contents": [{"role": "user", "parts": [
            {"inlineData": {"mimeType": mime,
                            "data": base64.b64encode(raw).decode("ascii")}},
            {"text": prompt}
        ]}],
        "generationConfig": {
            "responseModalities": ["TEXT", "IMAGE"],
            "imageConfig": {"aspectRatio": "4:3", "imageSize": "2K"}
        }
    }

def save_outputs(response, folder):
    records = []
    for candidate_index, candidate in enumerate(response.get("candidates", [])):
        parts = candidate.get("content", {}).get("parts", [])
        for part_index, part in enumerate(parts):
            if part.get("thought"):
                continue
            blob = part.get("inlineData", {})
            mime = blob.get("mimeType")
            if mime not in EXTENSIONS or not blob.get("data"):
                continue
            raw = base64.b64decode(blob["data"], validate=True)
            if not raw:
                raise ValueError("响应中的图片数据为空")
            name = f"candidate-{candidate_index}-part-{part_index}" + EXTENSIONS[mime]
            (folder / name).write_bytes(raw)
            records.append({"file": name, "mime_type": mime,
                            "sha256": hashlib.sha256(raw).hexdigest()})
    if not records:
        raise ValueError("没有最终图片;请检查 response.json 中的反馈与结束原因")
    return records

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("reference", type=Path)
    parser.add_argument("prompt_file", type=Path)
    parser.add_argument("output_dir", type=Path)
    args = parser.parse_args()
    prompt = args.prompt_file.read_text(encoding="utf-8").strip()
    if not prompt:
        raise ValueError("提示词为空")
    payload = build_request(args.reference, prompt)
    key = os.environ.get("GEMINI_API_KEY")
    if not key:
        raise ValueError("请在自己的运行环境中设置 GEMINI_API_KEY")
    args.output_dir.mkdir(parents=True, exist_ok=False)
    (args.output_dir / "request.json").write_text(
        json.dumps(payload, ensure_ascii=False, indent=2), encoding="utf-8")
    request = Request(ENDPOINT, method="POST",
                      data=json.dumps(payload).encode("utf-8"),
                      headers={"Content-Type": "application/json",
                               "x-goog-api-key": key})
    try:
        with urlopen(request, timeout=180) as result:
            response_text = result.read().decode("utf-8")
    except HTTPError as error:
        (args.output_dir / "error.txt").write_bytes(error.read())
        raise RuntimeError(f"HTTP {error.code},已保存 error.txt;没有自动重试") from None
    (args.output_dir / "response.json").write_text(response_text, encoding="utf-8")
    response = json.loads(response_text)
    images = save_outputs(response, args.output_dir)
    sent_reference = base64.b64decode(
        payload["contents"][0]["parts"][0]["inlineData"]["data"])
    manifest = {"model": MODEL, "reference_sha256": hashlib.sha256(
        sent_reference).hexdigest(), "images": images,
        "usageMetadata": response.get("usageMetadata", {})}
    (args.output_dir / "manifest.json").write_text(
        json.dumps(manifest, ensure_ascii=False, indent=2), encoding="utf-8")
    print(f"已保存 {len(images)} 张最终图片到 {args.output_dir}")

if __name__ == "__main__":
    main()
把上面的角色要求保存为 UTF-8 文本文件 scene.txt,把参考图命名为 approved-character.png。在自己的环境中配置密钥后执行:
python reference_job.py approved-character.png scene.txt outputs/city-01成功信号是输出目录中有最终图片、response.json 和 manifest.json。一次响应可能含文字与多张图片,代码不会假定第一段就是图片,也会跳过标记为 thought 的内容。图片指南提醒,模型并不总能遵循要求的确切出图数量;因此应按实际保存的最终图片计数。输出限制
这个程序保存的请求和响应包含你的图片与提示词,适合留在自己的受控存储中;分享示例前应另做脱敏。密钥只用于请求头,不写进请求记录。
多样本筛选:先设验收条件,再算可用图片成本
参考图不能替你完成验收。需要交付时,可以用同一参考图和同一份提示词生成几个候选,分别存入不同目录,然后按事先确定的要求挑选。上面的程序一次只发一个请求,不自动批量调用或重试;例如 city-01、city-02、city-03 是三次独立任务记录。
对骑行角色,验收可以检查眼镜形状、眉毛缺口、徽章、服装颜色、手部与车把关系,以及预留标题空间。将“身份必须一致”和“构图可以变化”分开,才不会因为一张图整体很像,就漏掉身份特征错误。
SSIM 等像素结构指标适合辅助比较同构图图片,却不能单独判断是不是同一个角色。背景改变会降低相似度,相近背景又可能掩盖脸部变化。跨姿势、跨场景任务应保留人工核对,不把相似度 0.9 解释成“90% 的身份一致性”。
成本也要按最终批准的图片计算。以 Google Gemini API 的 Pro 标准费率为例,1K/2K 图片输出按 1,120 tokens、每百万 tokens 120 美元计,精确计算为:
单张 1K/2K 图片输出:1,120 ÷ 1,000,000 × 120 = 0.1344 美元
3 张候选的图片输出:3 × 0.1344 = 0.4032 美元这是图片输出部分,不是总账单。输入文本、参考图和文字/思考输出分别计费;标准输入每百万 tokens 2 美元,一张输入图按 560 tokens 约为 0.0011 美元,文字与思考输出每百万 tokens 12 美元。4K 图片输出为 0.24 美元。Pro API 没有免费层,AI Studio 的测试入口不等于固定免费图片额度。Google Pro 定价
假设三张候选最终批准一张,图片输出部分分摊到该成品就是 0.4032 美元;批准两张则是每张 0.2016 美元。两者只是同一组假设的算术,不是实际通过率或账单。实际项目应记录请求数、最终图片数、批准数和费用,用“总费用 ÷ 批准数”观察成本;批准数为零时,不应报告一个虚假的单张可用成本。
只改亮度或裁切时,直接处理原图
如果原图已经合格,只需要统一变暗、裁切、缩放或添加固定边框,就不必重新生成。确定性图像处理能避免模型重新解释角色和背景。
下面的本地示例需要 Pillow。它读取指定原图,把 RGB 亮度乘以 0.85,保留原有透明度,保存 PNG,并同时记录文件哈希与解码像素哈希。保存为 darken.py:
import hashlib
import json
import sys
from pathlib import Path
from PIL import Image, ImageEnhance

source, target = map(Path, sys.argv[1:3])
with Image.open(source) as image:
    rgba = image.convert("RGBA")
alpha = rgba.getchannel("A")
adjusted = ImageEnhance.Brightness(rgba.convert("RGB")).enhance(0.85)
adjusted.putalpha(alpha)
adjusted.save(target, format="PNG")
record = {
    "source_sha256": hashlib.sha256(source.read_bytes()).hexdigest(),
    "factor": 0.85,
    "size": list(adjusted.size),
    "mode": adjusted.mode,
    "pixel_sha256": hashlib.sha256(adjusted.tobytes()).hexdigest(),
    "file_sha256": hashlib.sha256(target.read_bytes()).hexdigest()
}
target.with_suffix(".json").write_text(
json.dumps(record, indent=2), encoding="utf-8")python darken.py approved.png approved-dark.png要再次分发同一份成品,直接使用保存的 approved-dark.png。要重新计算并核对结果,还应记录 Pillow 版本和处理环境。相同参数本身不涵盖输入、软件版本与编码器变化,文件哈希和像素哈希也应分别比较。
必须固定 seed 时,如何选择下一条路线?
如果工作流程必须保存 seed 并重放请求,可以先评估上文有明确 seed 字段的 Ideogram 或 Runware Pro 接口。保存 seed、服务商、模型版本、完整请求、参考图哈希和输出原件,再按你自己的验收标准验证重复结果。不要根据字段名称猜测其内部实现,也不要把提供方的“可复现”说明直接升级为像素完全相同的承诺。
如果你需要控制整个生成环境,可以评估自托管的图像生成流程,固定模型权重、随机数、采样设置、依赖和设备条件。它增加了部署与维护工作,但能让你检查更多影响结果的环节。即使如此,PyTorch 的可复现性说明仍明确指出,相同 seed 不保证跨版本、跨平台或 CPU/GPU 结果相同;自己的固定环境也应实际验证。
旧教程中建议改用 Google Imagen 3/4 的做法需要重新判断可用性。Gemini API 的 Imagen 4 模型已于 2026 年 8 月 17 日停用;Vertex 的 Imagen 4 模型页列出的停用日期是 2026 年 6 月 30 日。它们是不同服务的生命周期,不能混成一个日期,也不宜继续当作当前 seed 备用方案。Gemini API 停用表、Vertex Imagen 4 模型页
对于电商主图,通常先批准一张产品图,再用它生成新背景;对于固定 IP 宣传素材,先固定角色特征,再逐场景筛选;对于游戏帧、可平铺纹理或自动化回归测试,应先明确需要的是连续性、无缝边界还是逐像素相同。seed 只涉及其中一部分,不能替代相应验收。
常见问题
Nano Banana Pro 到底有没有 seed 参数?
有公开字段,但要按具体接口回答。Google 通用 GenerationConfig 列有 seed,同时注明并非所有参数适用于每个模型;Ideogram 和 Runware 的 Pro 文档也列有自己的 seed 字段。通用定义不能单独证明你的 Pro 入口接受它,更不能证明像素级复现。Google 参数、Ideogram、Runware
固定 seed 和提示词,为什么还是生成不同图片?
seed 不是完整请求。参考图、模型版本、参数和服务路线变化都需要核对;即使保持同请求,Vertex 的通用说明也只给出尽力重复响应的边界。如果必须再次得到同一张已批准图片,保存并复用原文件更直接。Vertex seed 说明
第三方 API 的 seed 只是装饰吗?
不能这样断言。Ideogram 和 Runware 已在各自 Pro 文档中定义 seed 的用途。没有对应调用与结果证据,就无法判断某个平台如何映射这个字段,也不能声称它只影响路由。选择时核对该平台自己的接口约定,并验证你需要的结果。Ideogram 参数、Runware 参数
要保持角色一致,必须上传 14 张参考图吗?
不必。14 张是总输入上限,不是推荐用量或成功条件。先用一张清楚、已批准的角色图,需要补充角度或细节时再增加;Pro 指南中的角色参考上限为 5 张。避免把互相矛盾的图片一起当作身份依据。参考图限制
把温度设为 0,或者关闭思考,就能完全复现吗?
不能从这些设置推出完全复现。Pro 的思考功能默认开启且不能关闭;它是生成过程的一部分,不能当作固定输出的开关。温度也不是 seed 或完整环境的替代品。图片思考说明、Vertex 参数边界
怎么确认已经保存的是最终图片?
对 generateContent,遍历候选内容中的图片部分,跳过标记为 thought 的部分,并保存实际返回的所有最终图片;不要只读第一段。本文代码适用于这一响应格式。如果使用 Interactions API,需要按该接口的 model_output 步骤读取图片,不能混用两套响应解析。图片输出说明
官方文档
接入参数、价格与扣费规则以老张API开发文档为准:Nano Banana Pro API 文档。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月8日。
参考来源10
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月8日。
- 1.Google 配置文档ai.google.dev/api/generate-content
- 2.Vertex 参数说明docs.cloud.google.com/gemini-enterprise-agent-platform/models/capabilities/content-generation-parameters
- 3.Ideogram Nano Banana Pro APIdeveloper.ideogram.ai/api-reference/images/generate/nano-banana-pro
- 4.Runware 模型文档runware.ai/docs/models/google-nano-banana-pro
- 5.模型说明ai.google.dev/gemini-api/docs/models/gemini-3-pro-image
- 6.停用表ai.google.dev/gemini-api/docs/deprecations
- 7.参考图说明ai.google.dev/gemini-api/docs/image-generation
- 8.Google Pro 定价ai.google.dev/gemini-api/docs/pricing
- 9.PyTorch 的可复现性说明docs.pytorch.org/docs/2.14/notes/randomness.html
- 10.Vertex Imagen 4 模型页docs.cloud.google.com/vertex-ai/generative-ai/docs/models/imagen/4-0-generate