AI 视频多角色对话:同框生成还是分镜剪辑,按 5 个条件选
两人、短台词、要看到互动,用同框一次生成;台词长、三人以上或要反复改词,按镜头拆开再剪。附 Veo、Seedance、Kling 等官方文档写明的能力和失败修法。
文章目录
多角色对话用同框还是分镜:先看这 5 个条件
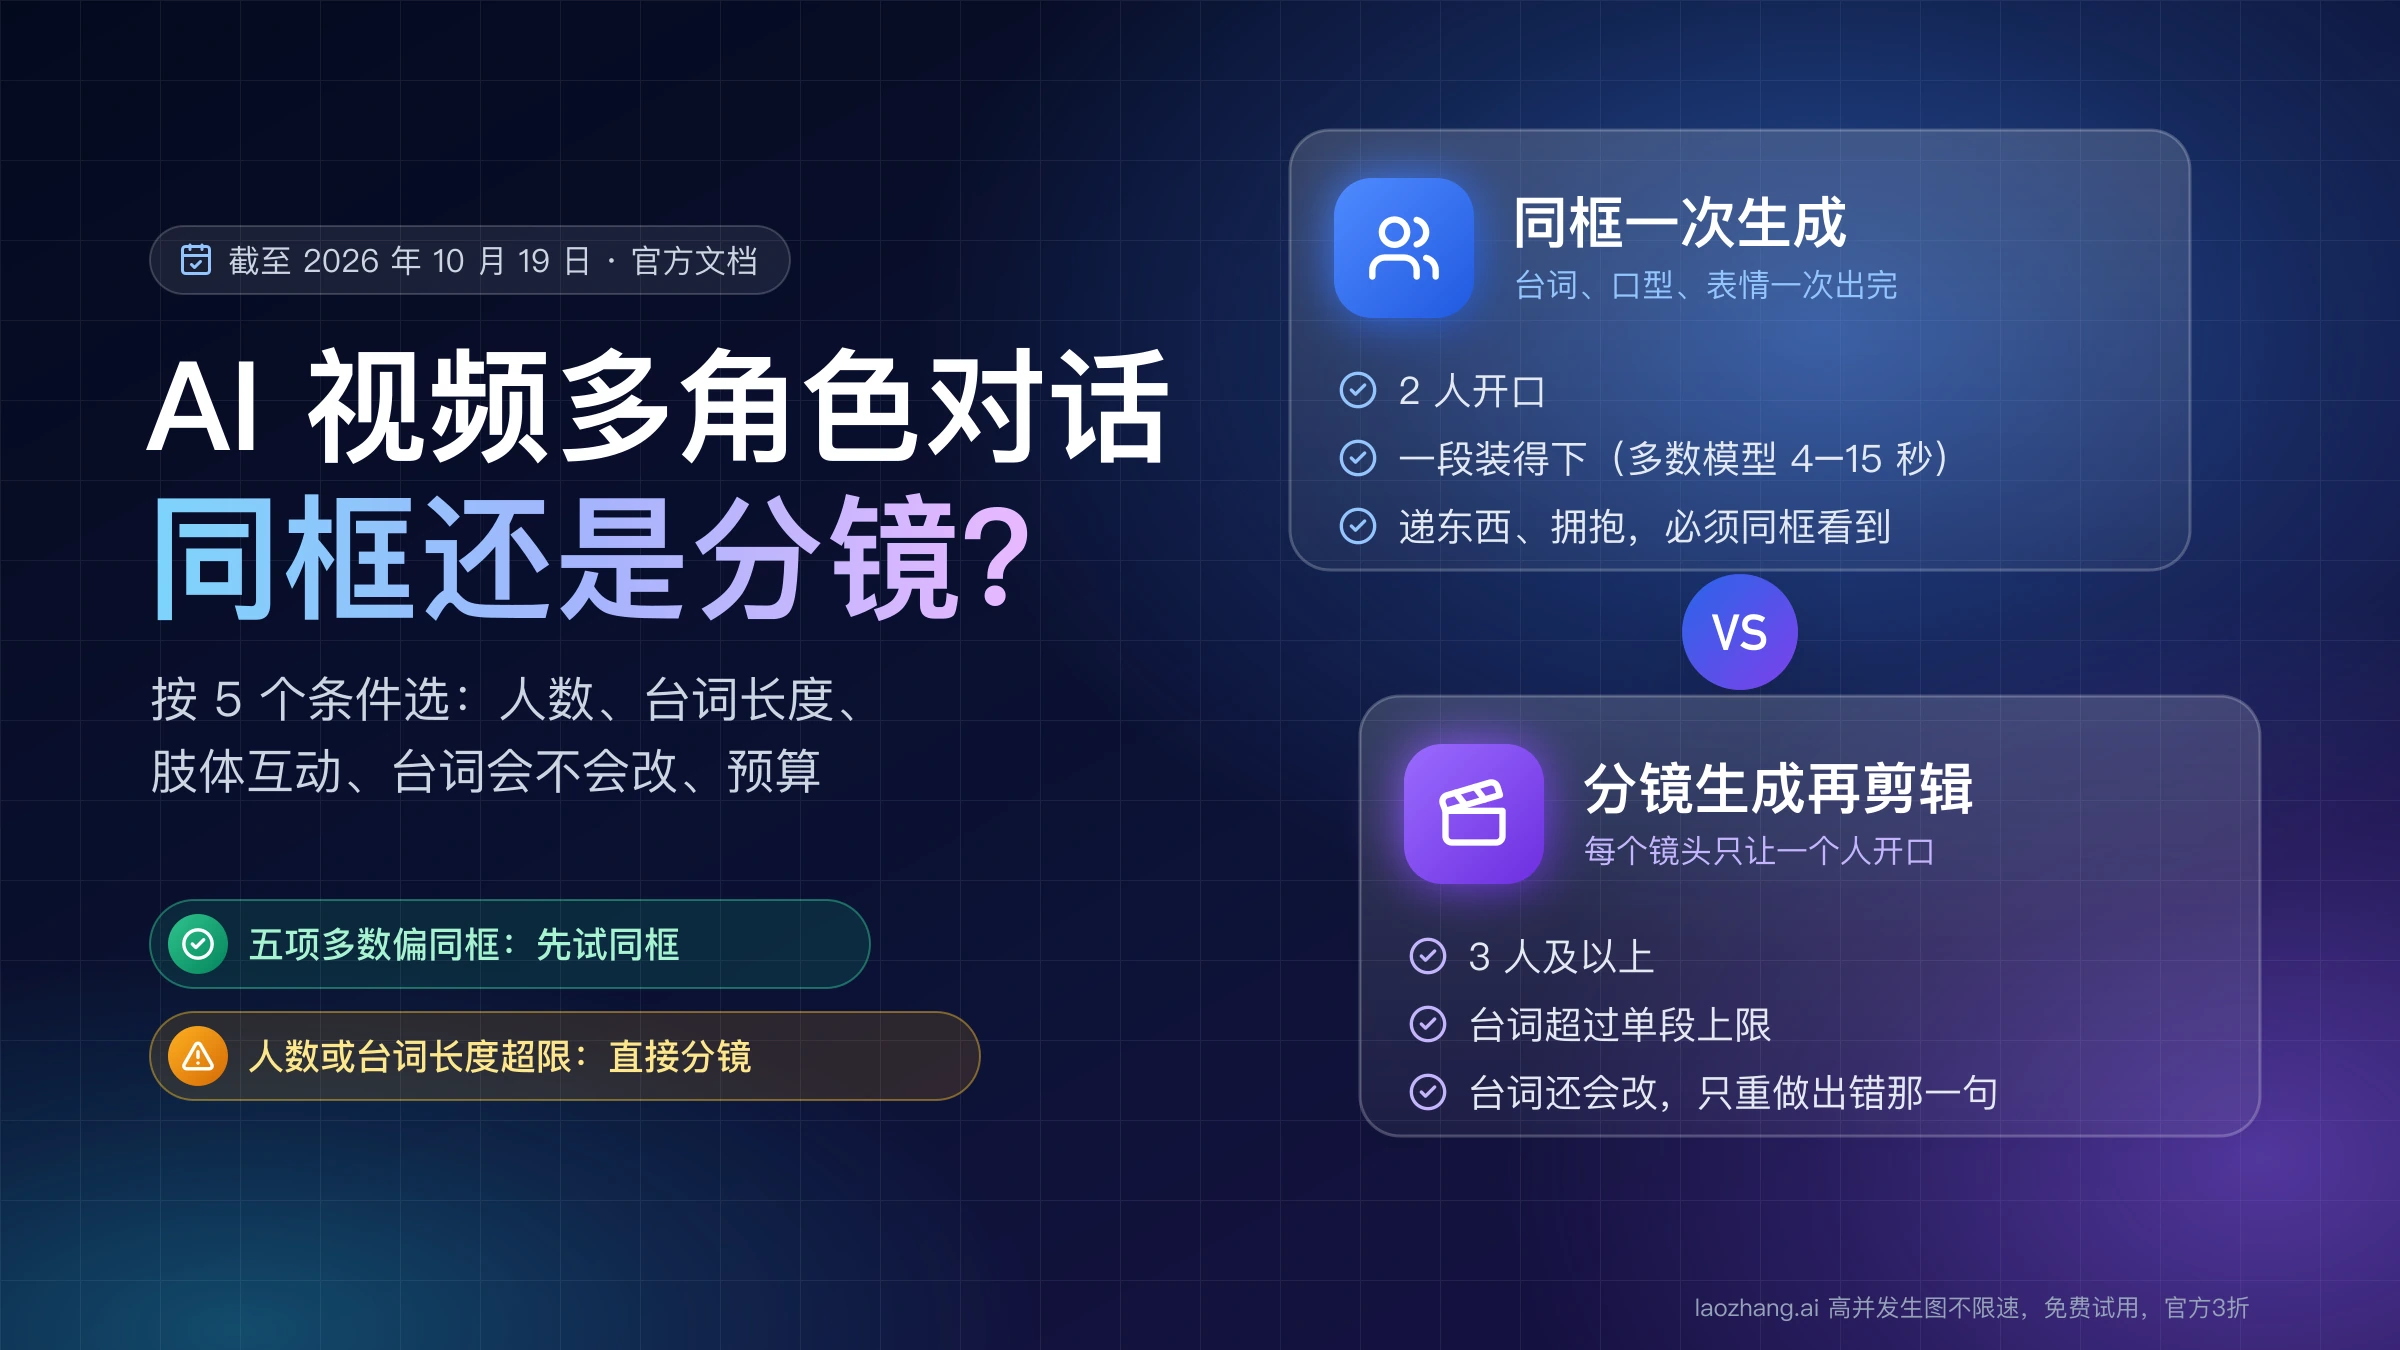
一场两人以上的对白,有两种生产方式。同框一次生成:两个角色同在画面里,台词、口型、表情由模型一次出完。分镜生成再剪辑:拆成单人近景、正反打、过肩镜头,每个镜头只让一个人开口,各自生成后在剪辑软件里接起来。
判断用哪种,看这场戏的 5 个条件:
| 条件 | 偏向同框一次生成 | 偏向分镜生成再剪辑 |
|---|---|---|
| 开口的人数 | 2 人 | 3 人及以上 |
| 台词总长 | 一段能装下(多数模型单段 4–15 秒,Seedance 2.5 最长 30 秒) | 超过单段上限,或每人台词都很长 |
| 肢体互动 | 有递东西、拥抱、抢话、同时反应,必须在一个画面里看到 | 基本是你一句我一句,互动靠视线和剪辑交代 |
| 台词会不会改 | 定稿了,不会再动 | 客户或导演还会改某一句 |
| 每条合格镜头的预算 | 能接受整段重抽 | 只想重做出错的那一句 |
五项里多数落在左边,先试同框;有一项明确落在右边(尤其是人数和台词长度),直接分镜,不要在同框上反复重抽。介于两者之间时,有两种折中:一是用模型自带的多镜头功能,让模型在一次生成里自己切正反打;二是 Runway 官方帮助文档里写的流程,两人同框,但每个角色的口型分开驱动,再合成。
下面的判断都来自各厂商截至 2026 年 10 月 19 日的公开文档和署名第三方文章,没有附带生成测试,所以不写成功率。
同框一次生成:两个人、短对白、要看到互动时用
同框的好处是互动真实:一个人说话时另一个人的反应、两人之间的距离和动作都在同一画面里,剪辑工作量也最小。代价是模型要在一次生成里同时管好两张脸、两种音色和"谁在哪一秒开口"。
这个代价在官方文档里有直接记载。字节跳动 BytePlus 的 Seedance 2.5 提示词指南把"多主体视频里角色与参考图、音色或出场顺序错配"列为典型问题,例子是第一个出场的角色被替换成另一个参考角色。它给的修法是:按角色首次出场的顺序上传参考素材,并在提示词里按这个顺序重新编号,让每个角色和自己的图片、音频一一对应。它还提醒,单个任务同时叠加多种参考和编辑要求时结果可能不稳定,建议拆成几个更简单的任务。
在其他模型的文档里,这类失败没有被写成明确条目,但从功能边界看得出同框的难点:
- Veo 3.1:Gemini API 的 Veo 文档让你用引号写台词,官方示例就把两个人的台词放进同一段:先写"Man:"加动作和一句台词,再写"Woman:"加动作和回答。文档没有写一段最多几人说话,这不等于不支持。单段只有 4、6、8 秒,两句短对白基本就是上限。
- Gemini Omni 1.1 Flash:Omni 文档说明,默认会把一段视频生成成几个不同镜头;要两人一镜到底,必须在提示词里写明 "No scene cuts" 或 "In a single continuous shot"。Omni 不支持上传音频参考,也不支持修改人声,所以没有办法把某个声音绑定到某个角色。
- Kling 3.0:可灵的 3.0 发布说明称原生音频在多角色场景里可以"精准指定说话的角色",这是厂商的说法,没有独立测试佐证。
同框想提高一次就对的概率,提示词里要做三件事。第一,每个角色一个固定称呼和一组固定外观描述(发型、衣服颜色、一件道具),每一段都原样重复,不改成"她""那个男人"。第二,每一段同时写谁说、谁听、听的人在画面哪一侧。第三,台词短,两人轮流说,不写抢话和同时说话。第三方站点 Seedance TV 2026 年 8 月的一篇文章也是这个思路:它认为两个角色最可控,三个角色要靠外观差异明显才行,人更多就拆成双人镜头和反应镜头再剪。
分镜生成再剪辑:台词长、三人以上、要反复改时用
分镜的核心是每个镜头只有一个人开口。单人近景不存在"嘴动的人不对"这个问题,音色也只有一种;某一句台词要改,只重做那一个镜头。代价是生成次数变多,以及要把人物在不同镜头里保持一致,剪起来视线、轴线、光线都接得上。
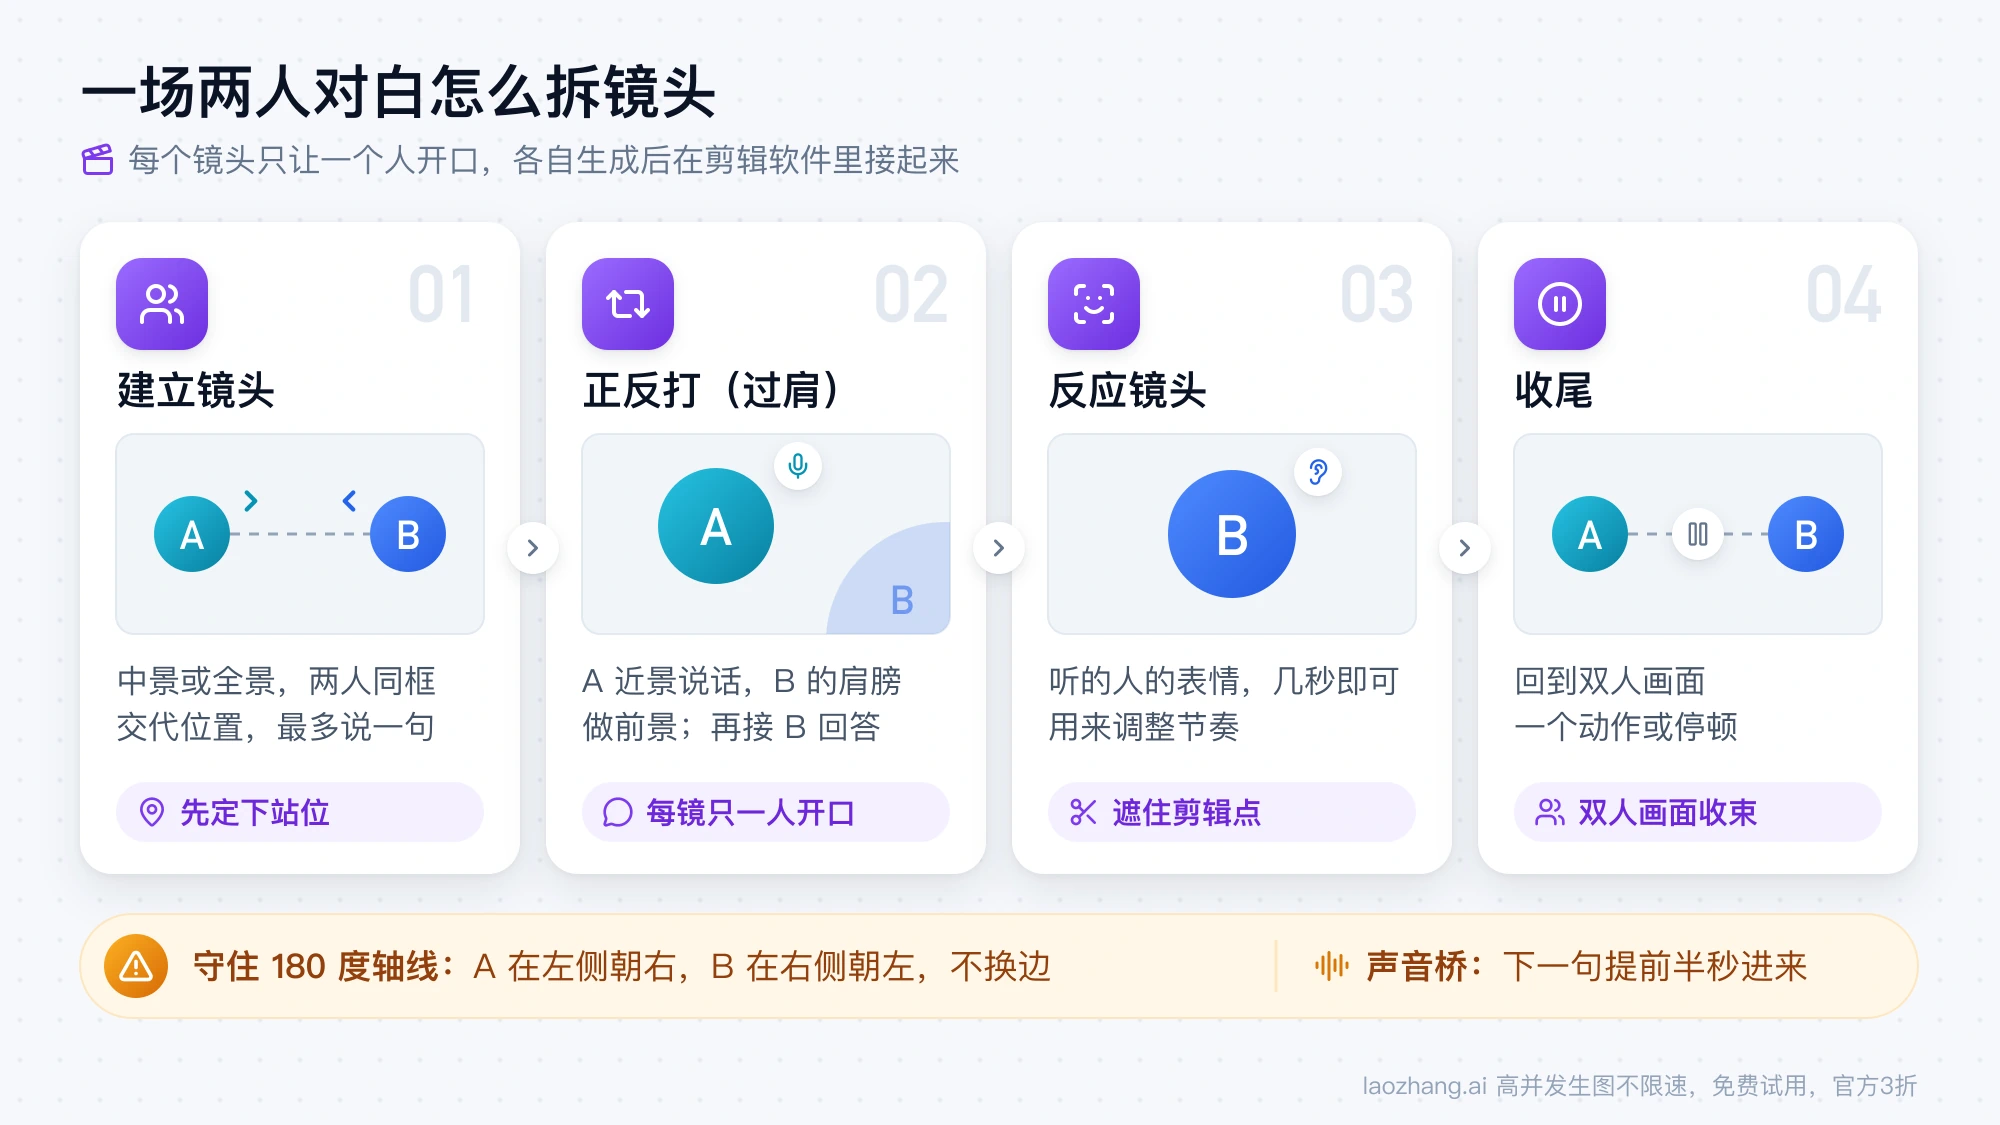
一场两人对白的常见拆法:
- 建立镜头:两人同框的中景或全景,交代位置关系,不说话或只说一句。
- 正反打:A 的近景说话(可带 B 的肩膀做前景,即过肩镜头),再接 B 的近景回答,交替推进。
- 反应镜头:听的人的表情,几秒即可,用来遮住剪辑点、调整节奏。
- 收尾:回到双人画面,一个动作或停顿。
Google 的 Vertex AI Veo 提示词指南也把"两人交谈的中景"和"对话里常用的过肩镜头"当作基本写法,这套镜头语言模型是认识的。
分镜最难的是人物一致。具体做法:
- 每个角色准备单人参考图,不用合照。Seedance 2.5 文档建议在文字里写明"图片 1-2 是角色 1,对应音频 1;图片 3-4 是角色 2,对应音频 2",不要只把名字写在图片上,否则容易混淆或复制角色。
- 声音单独固定。Seedance 2.5 可以用音频做参考;Kling 3.0 Omni 的发布说明写到可以给角色元素加一段至少 3 秒的说话音频来提取音色。Omni 和 Veo 的文档都没有音频参考,同一个人在不同镜头里的声音可能对不上,可以考虑先出画面,配音和口型另外处理。
- 剪辑守住 180 度轴线:A 一直在画面左侧朝右,B 在右侧朝左,正反打时不要让两人换边。提示词里每个镜头都重复站位。
- 用声音桥藏剪辑点:下一句台词提前半秒进来(J-cut),或上一句的尾音拖进下一个镜头,比硬切自然。环境声和音乐最后统一铺一条。
台词常改的场景,分镜的优势最明显:Seedance 2.5 文档里的编辑示例可以"只修改视频 1 里男人的台词",并保持其余内容不变;而 Omni 明确不支持修改人声,也不能给上传的说话视频续写新台词。
Seedance 的提示词写法、参考素材编号和局部修改,详见 Seedance 2 提示词指南:分镜、参考素材与 2.5 编辑示例。
如果你用 API 批量出分镜,laozhang.ai 提供 Seedance 2.5 接口和 Seedance 虚拟人素材接口:用一张公开的 HTTPS 图片建一个虚拟人素材,在每个镜头里以 asset 地址作为参考图引用,让同一个角色跨镜头保持一致。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
折中做法:模型自带多镜头,或逐角色驱动后合成
模型自带多镜头:一次生成里由模型自己切出正反打。可灵 3.0 发布说明写到多镜头功能能理解"经典的正反打对话"并自动调整机位;API 文档写明每次 1–6 个镜头,每个镜头至少 1 秒,各镜头时长之和等于总时长,每个镜头的描述最多 512 字符。Omni 默认就会切几个镜头;Seedance 2.5 支持用 Shot 1、Shot 2 加整数秒时间戳分段;MiniMax H3 宣称"原生多镜头建模";Wan 2.7 文档里也有"Shot 1 [0–3 seconds]"这样的分镜写法。
它的好处是一次出片、风格和光线天然一致;局限是整段仍是一次生成,某一句错了要整段重抽,总长也受单段上限约束(Kling 3.0 为 3–15 秒)。适合台词不长、又不想同框一镜到底的场景。
逐角色驱动后合成:Runway 帮助中心有一篇 用 Act-Two 制作多角色对话的教程(2025 年 12 月 17 日更新),因为 Act-Two 只支持单个角色输入,流程是:
- 分别录下每个角色的表演和台词,总长不超过 30 秒(Act-Two 上限)。
- 用 Gen-4 Image 的参考功能生成一张两人同框的图。
- 用这张图生成 10 秒的底片视频,台词更长就用最后一帧接着生成。
- 把底片裁成只剩一个角色,用 Act-Two 套上该角色的表演;另一个角色同样做一遍。
- 在剪辑软件里把两个 Act-Two 输出叠回底片上对齐合成。
结果画面上是同框,但每个人的口型是分开驱动的,嘴动的人不会错。代价是要录表演、要会基础合成,Act-Two 按每秒 5 credits 计费。Runway 的独立 Lip Sync 工具已在 2026 年 5 月 27 日下线,官方给的替代就是 Act-Two。
哪些模型能让几个人说话:官方文档写明的能力对照
下表只收截至 2026 年 10 月 19 日第一方文档写明的内容;"未写明"表示文档里没有,不代表一定不支持。Sora 的 API 已在 2026 年 9 月 24 日关闭,不在选项里。各平台的可用地区以平台说明为准,Veo、Omni、可灵海外版等在中国大陆使用受地区限制。
| 模型或工具 | 单段时长 | 多镜头 | 台词写法 | 角色与声音绑定 | 真人脸 |
|---|---|---|---|---|---|
| Veo 3.1 | 4/6/8 秒;每次延长 7 秒,最长输出 148 秒 | 未写明专门功能 | 引号写台词,可多人标注 | 最多 3 张参考图,原文为"单个人物、角色或产品"的素材图,两人场景怎么用没有说明 | 未写明 |
| Gemini Omni 1.1 Flash | 每次延长 10 秒,总长最多 40 秒 | 默认多镜头,一镜到底须写 "No scene cuts" | 提示词描述 | 不支持音频参考和修改人声 | 不支持部分可识别人物 |
| Seedance 2.5 | 4–30 秒 | Shot N 加整数秒时间戳 | 花括号包台词;非中文台词先写语种 | 图片、音频按上传顺序编号后在文字里绑定;最多 10 段音频,合计 30 秒 | 不能直接上传真人脸,需用平台生成素材、预设数字人或认证的真人素材 |
| Kling 3.0 / 3.0 Omni | 3–15 秒 | 1–6 个镜头,支持正反打 | 提示词里给每个角色写台词 | 厂商称可精准指定说话角色;3.0 Omni 可给元素加音色 | 未写明 |
| MiniMax H3 | 4–15 秒 | 原生多镜头 | 11 种语言对白 | 最多 3 段音频参考,未写明多人绑定 | 未写明 |
| Wan 2.7 | 2–15 秒 | 提示词分镜 | 提示词描述 | 可传一段 2–30 秒音频,未写明多人绑定 | 未写明 |
| Runway Act-Two | 表演最长 30 秒 | 无,逐角色合成 | 用录好的表演驱动 | 每次只驱动一个角色 | 未写明 |
| MultiTalk / InfiniteTalk(开源) | MultiTalk 最长 15 秒;InfiniteTalk 默认 40 秒 | 无 | 音频驱动 | 每段音频绑定到 person1、person2 | 自部署,需自备 GPU |
可灵 4.0 于 2026 年 10 月 15 日全量开放,发布说明写到 3–30 秒、参考音频(仅限音色)、口型同步更准,但没有重述多镜头数量和多人说话的能力,API 文档也还停留在 3.0,所以表里按 3.0 写。
开源的 MultiTalk 在仓库里把自己定位为"音频驱动的多人对话视频生成",用配置里的 person1、person2 把每段音频绑到对应的人;它的论文也承认存在"音频和人物绑定错误"的问题。
只在 Seedance 和 Veo 之间二选一时,按时长、参考和价格怎么比,见 Seedance 和 Veo 哪个好:时长、参考与每秒价格;想先确定 Wan、MiniMax 和 Seedance 先测哪个,见 Wan 3.0、MiniMax H3、Seedance 2.5 怎么选:先看交付约束;Omni 的入口和模型名见 Gemini Omni 1.1 Flash 怎么用:先分清应用、Flow 与 API。
分镜比同框贵多少:看重抽粒度,Veo 的 8 秒规则例外
每秒单价对两种方式是一样的,差别在于生成了多少秒、出错时重抽多少秒。下面用一场 16 秒、两人共 4 句台词的对白演算,价格都是 API 标价,会变动。
Seedance 2.5(BytePlus,720p 约 $0.231/秒,截至 2026 年 10 月 15 日的标价)
- 同框一次生成 16 秒:16 × $0.231 ≈ $3.70。如果需要重抽 2 次才对,总共生成 3 次:$3.70 × 3 ≈ $11.09。
- 分镜 4 个 4 秒镜头:第一轮同样 16 秒、$3.70。假设其中一个镜头重抽 2 次,多出 8 秒:8 × $0.231 ≈ $1.85,合计 $5.54。再加一个 4 秒建立镜头和一个 4 秒反应镜头,多 $1.85,合计 $7.39。
也就是说,在 Seedance 这类按秒计费、单段最短 4 秒的模型上,分镜多出的钱主要是补拍的镜头;一旦同框需要整段重抽,分镜往往更省。国内火山方舟上 Seedance 2.5 按 token 计费,480p/720p、不含输入视频为每百万 token ¥70(截至 2026 年 10 月 15 日),换算到每秒取决于分辨率和时长,可以用同样的方法按"生成秒数 × 次数"估算。
Veo 3.1(截至 2026 年 10 月 1 日的标价:Standard $0.40/秒,Fast 1080p $0.12/秒)
Veo 的规则不一样:用参考图、1080p 或 4K 时,单段必须是 8 秒。为了保持人物一致而给每个分镜都挂参考图,4 个镜头就要按 4 × 8 = 32 秒计费,哪怕每个镜头你只剪用 4 秒:
- Standard:32 × $0.40 = $12.80;Fast 1080p:32 × $0.12 = $3.84。
- 对比同框:拆成两段 8 秒的双人同框片段(各含两句台词),共 16 秒,Standard 为 16 × $0.40 = $6.40,Fast 1080p 为 16 × $0.12 = $1.92。
所以在 Veo 上分镜的第一轮成本大约是同框的 2 倍,只有当同框需要重抽 1 次以上时,分镜才可能更划算。算自己的预算时,把"每条合格镜头的平均生成次数"代进去,比只看单价更接近真实花费。
嘴动的人不对、音色互换:常见失败与下一步
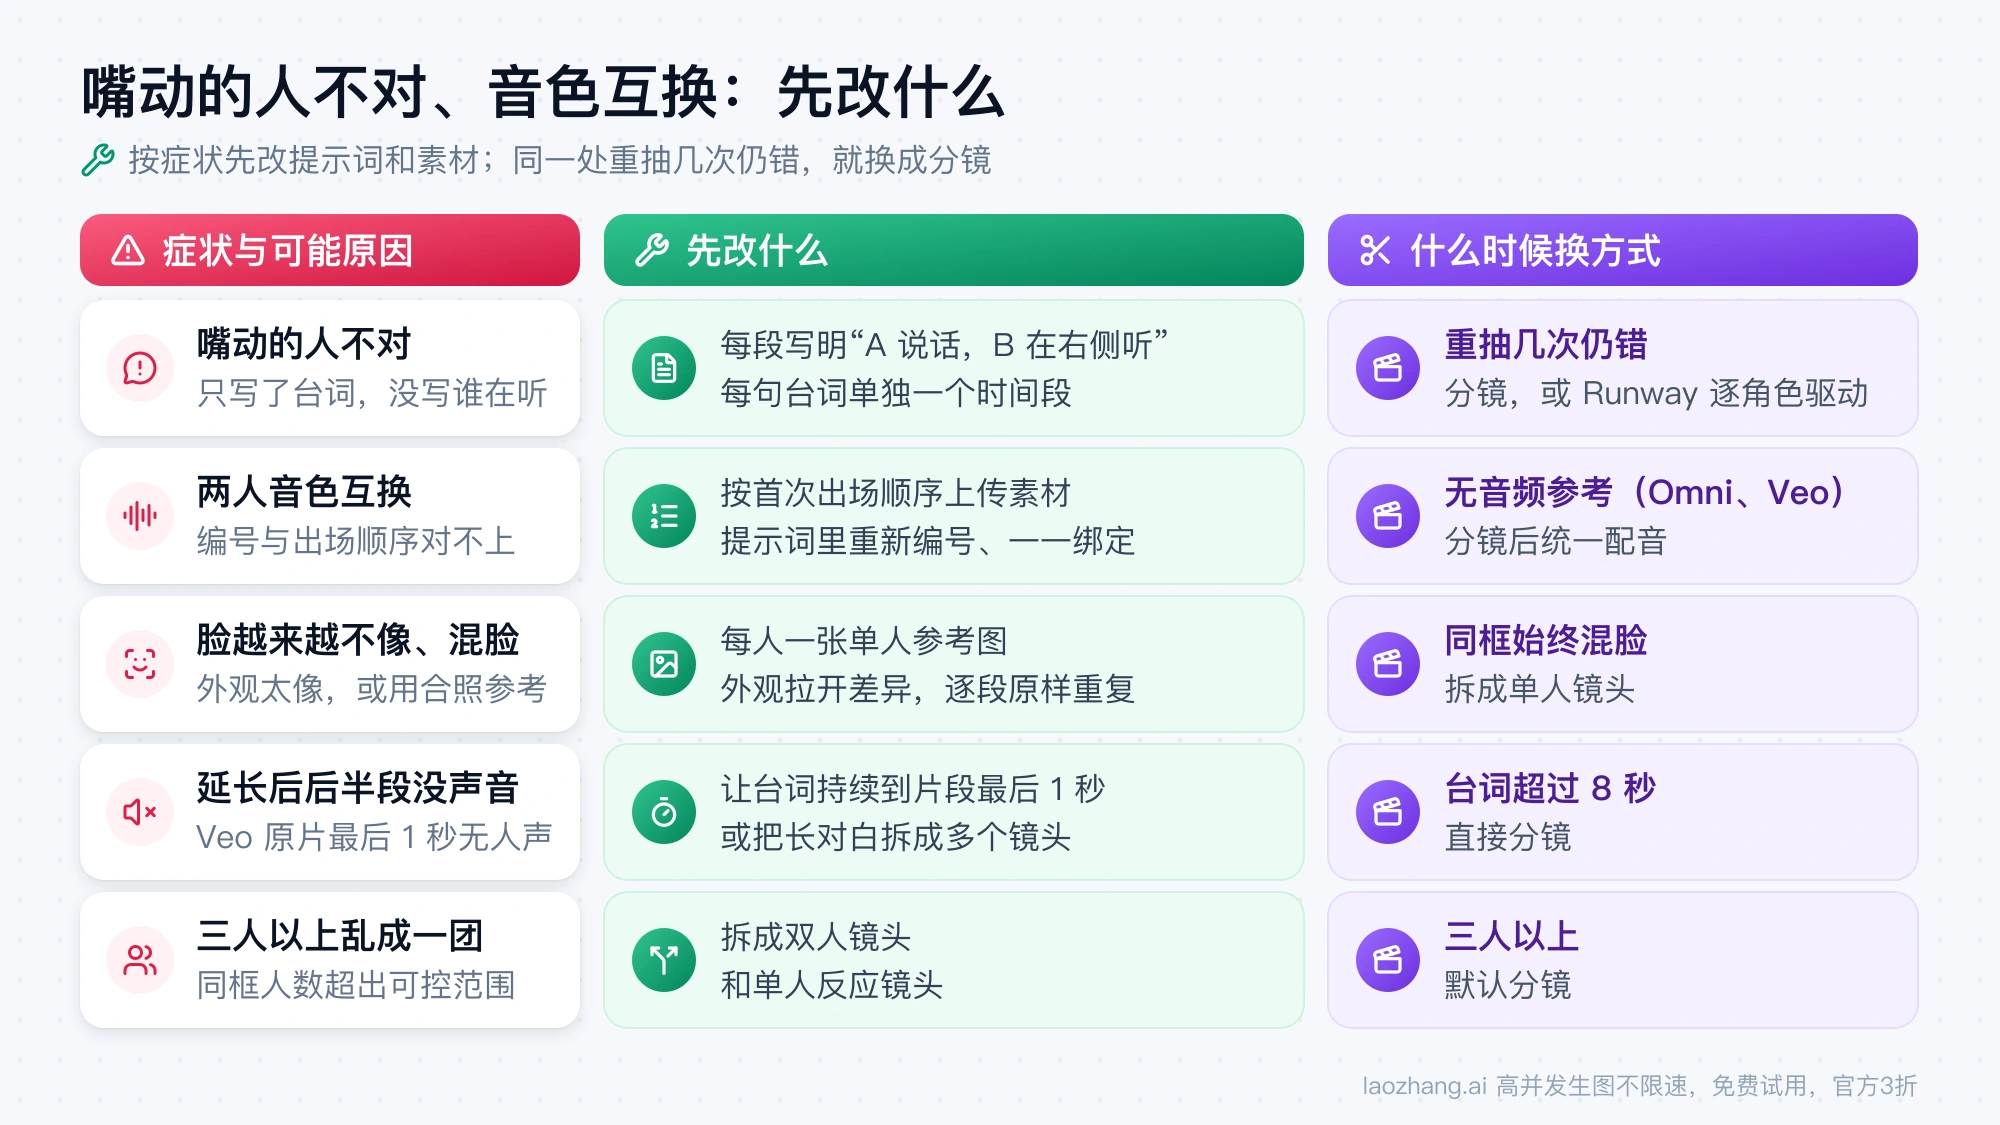
| 症状 | 可能原因 | 先改什么 | 什么时候换方式 |
|---|---|---|---|
| 嘴在动的不是说台词的那个人 | 提示词只写了台词,没写谁在听;两人轮流说的边界不清 | 每段写明"A 说话,B 在画面右侧听、不说话",给每句话单独一个时间段 | 同一段重抽几次仍错,改成分镜,或用 Runway 逐角色驱动 |
| 两个角色的音色互换 | 参考图和音频的编号与出场顺序对不上 | 按角色首次出场的顺序上传素材,提示词里重新编号、一一绑定(Seedance 文档的修法) | 模型不支持音频参考时(Omni、Veo),改为分镜后统一配音 |
| 第一个出场的人变成了另一个参考角色 | 同上,Seedance 文档点名的错配 | 同上 | — |
| 脸越来越不像,两人特征混在一起 | 外观描述太像或每段写法不同;用了合照做参考 | 每人一张单人参考图,外观描述拉开差异并逐段原样重复 | 同框始终混脸,拆成单人镜头 |
| 两人在正反打之间换了边 | 没有交代站位 | 第一段定好"A 在左朝右,B 在右朝左",之后每个镜头重复 | — |
| 想一镜到底,Omni 却切了好几个镜头 | Omni 默认多镜头 | 提示词加 "No scene cuts" 或 "In a single continuous shot" | — |
| 画面里冒出字幕 | Seedance 里台词词语重复可能触发字幕 | 避免重复台词词语,加"无字幕" | — |
| 延长后后半段没有声音 | Veo 延长时,原视频最后 1 秒没有人声,声音就接不上 | 让台词持续到片段最后 1 秒,或把长对白拆成多个镜头 | 台词超过 8 秒,直接分镜 |
| 三人以上的戏乱成一团 | 同框人数超出可控范围 | 拆成双人镜头和单人反应镜头 | 三人以上默认分镜 |
两套未实测的提示词模板:同框版与分镜版
下面两套模板按 Seedance 2.5 文档写明的语法拼成,没有经过生成测试,只作为起点。Seedance 用花括号包台词,素材按上传顺序编号;换成 Veo 时,台词改用英文引号,素材绑定那一行删掉。
同框版(两人、8 秒、一镜到底):
图片1是角色A:齐耳黑色短发,铁锈红雨衣,米色毛衣,对应音频1。
图片2是角色B:黑色短卷发,藏青色工装夹克,灰色T恤,对应音频2。
白天的车站咖啡馆,固定机位中景双人镜头,不切镜头。
角色A坐在画面左侧朝右,角色B坐在画面右侧朝左,两人始终坐在同一张木桌旁。
0-4秒:角色A说话,角色B看着A、不说话。角色A(压低声音):{票改到明天了?}
4-8秒:角色B回答,角色A听、不说话。角色B(平静):{只改了我那张。}
无字幕,无背景音乐。分镜版(同一段对白拆成 4 个镜头,每个镜头单独生成,每次都上传同样的两张参考图):
镜头1(4秒):图片1是角色A,图片2是角色B(外观描述同上)。车站咖啡馆全景双人镜头,A 在左朝右,B 在右朝左,两人坐下,不说话。

镜头2(4秒):过肩镜头,B 的右肩在画面右侧前景,焦点在角色A。角色A(压低声音):{票改到明天了?} 只有角色A说话。

镜头3(4秒):过肩镜头,A 的左肩在画面左侧前景,焦点在角色B。角色B(平静):{只改了我那张。} 只有角色B说话。

镜头4(4秒):角色A的近景反应,沉默,低头看杯子。不说话。
剪辑时,镜头 3 的台词可以提前半秒压在镜头 2 的结尾上;4 个镜头出完后统一铺环境声。
常见问题
多个角色的台词怎么写进 AI 视频提示词?
每句台词前写清是谁说的,用固定称呼(角色A、角色B),并写出说话时另一个人在做什么。格式按模型来:Veo 用引号,官方示例是"Man: …"加引号台词;Seedance 2.5 用花括号包台词,素材在文字里按编号绑定到角色;Kling 3.0 的示例是在描述里直接写"某某说:……"。
有没有能免费做多人对话视频的工具?
开源的 MultiTalk 和 InfiniteTalk 本身免费,用音频驱动多人说话,并能把每段音频绑定到指定的人,但需要自己有 GPU 部署。各家商业模型的免费额度经常变动,以平台当前页面为准;宣称免费的第三方网站,背后用的是哪个模型、生成的视频能不能商用,要先看清楚。
三个人以上的对话能同框一次生成吗?
可灵 3.0 的发布说明列出了"多角色指代(3 人及以上)",官方示例里有一家四口轮流说话。但人越多,错配的机会越多,第三方 Seedance TV 的文章也认为两人最可控。三人以上建议默认分镜,只把需要同框互动的那一两个镜头做成双人画面。
可以用真人照片做多角色对话吗?
主流平台都有限制。Seedance 2.5 不能直接上传真人脸,要用同账号 30 天内的平台生成内容、预设数字人,或通过认证的真人素材;Gemini Omni 不支持上传和编辑含有部分可识别人物的图片。需要用真人形象时,走平台自己的真人素材认证流程,不要用普通照片硬传。
同框生成的对白口型不准,可以只修一句吗?
看模型。Seedance 2.5 文档里有只修改视频中某个人台词的编辑示例;Gemini Omni 明确不支持修改人声,也不能给上传的说话视频续写台词。如果你的台词经常要改,从一开始就按分镜做,改一句只重做一个镜头。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月19日。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月19日。
- 1.Seedance 2.5 提示词指南docs.byteplus.com/en/docs/modelark/seedance-2-5-prompt-guide
- 2.Gemini API 的 Veo 文档ai.google.dev/gemini-api/docs/veo
- 3.Omni 文档ai.google.dev/gemini-api/docs/omni
- 4.3.0 发布说明kling.ai/release-note/release-notes/whbvu8hsip
- 5.Vertex AI Veo 提示词指南cloud.google.com/vertex-ai/generative-ai/docs/video/video-gen-prompt-guide
- 6.用 Act-Two 制作多角色对话的教程help.runwayml.com/hc/en-us/articles/41748090660499