LLM Agent API 花费熔断开关:在供应商调用前截住失控账单
在每次付费调用前,将已结算费用、在途预留和本次费用上界一起检查;额度不足立即停,账单未知继续占用额度。附不连接供应商的可运行预算闸门示例。
文章目录
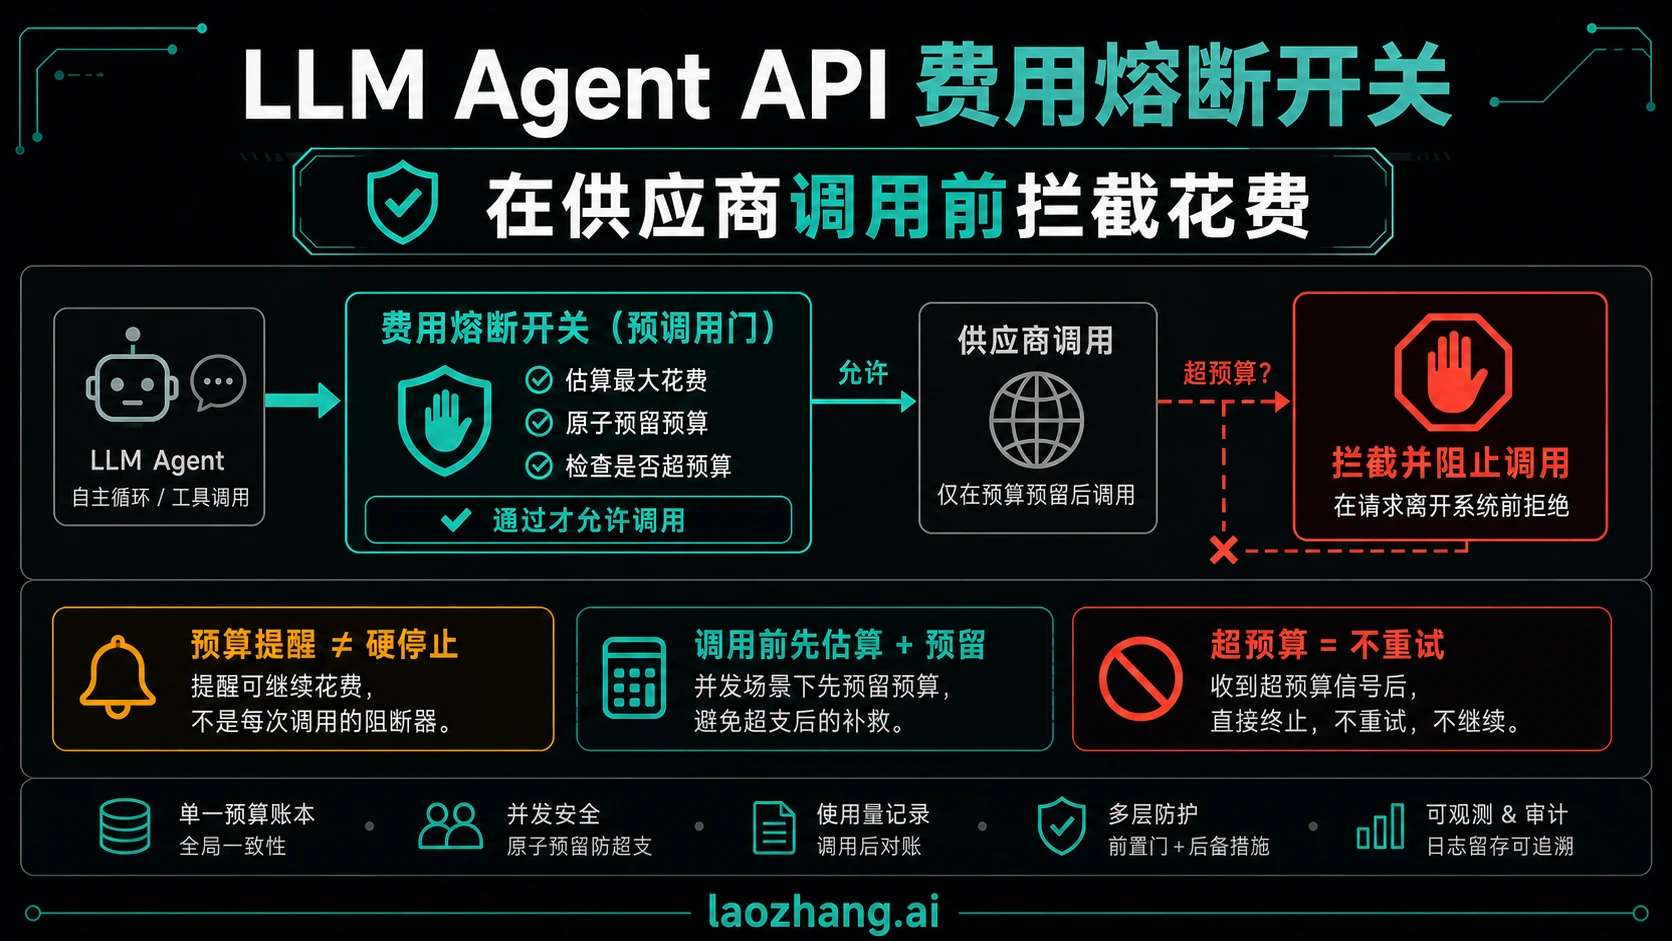
要阻止 LLM Agent 把 API 账单跑失控,预算检查必须发生在下一次付费请求出站之前:先为这次调用原子预留额度,预留成功才调用供应商,结束后按实际用量结算。额度不足时,停止当前任务的付费派发、重试和子 Agent;响应丢失时,保留预留并等待对账。
核心条件是:已结算费用 + 在途预留 + 本次费用上界 ≤ 预算上限。检查与增加预留必须是同一个不可交错的操作。否则多个 worker 都读到“还剩 1 美元”,仍可能一起发出合计超过 1 美元的请求。
供应商的硬上限也值得启用。当前 OpenAI 官方文档已支持组织、项目层面的硬花费限制,需要启用 Enforce a hard limit;只有花费提醒时,请求仍会继续。硬限制有传播延迟,已记录花费可能略超设定金额。因此,账户级限制负责后备保护,调用前闸门负责自己的任务预算,两者可以同时使用。
先确认哪一个组件能拒绝下一次付费调用
能看见花费,不等于能拦住花费。先沿真实调用链找出出站入口:主模型、子 Agent、摘要器、评估器、付费检索、图片工具、SDK 内部重试和备用路由,都应在开始计费前接受预算决策。只管住主 planner,工具里的一次隐藏模型调用仍能继续花钱。
| 控制方式 | 能解决什么 | 不能单独保证什么 |
|---|---|---|
| 邮件提醒、花费看板 | 让操作者发现异常 | 下一次请求被拒绝 |
| 最大轮次、执行时限 | 缩短循环、控制任务规模 | 金额不超限;不同调用的单价与用量不同 |
| 单次输入、输出上限 | 缩小单次费用上界 | 大量小请求累计不超预算 |
| 供应商硬花费限制 | 在其组织、项目或账户范围阻断后续流量 | 单个 Agent 的预算,以及零传播延迟 |
| 网关预算 | 集中管理经过网关的流量 | 绕行流量受控,或并发下发票金额绝不超限 |
| 调用前原子预留 | 在已知费用上界和共享账本范围内做金额准入 | 已发出的调用被撤销,或估价错误自动消失 |
预算闸门放在内部代理、网关或执行器都可以,关键是它拥有实际出站控制权。用一句提示词要求模型“不要超过预算”,只改变模型行为,不能替代执行器拒绝请求。
预算身份也应由应用确定。可信的登录上下文、队列任务记录或服务端任务映射决定租户、父任务和预算周期;模型不能自己填一个新的 budget_id,更不能通过新会话获得新的总额度。子 Agent 可以有更小的子预算,但放行时还要满足父任务、租户和账户的共同限制,不能只扣其中一个。
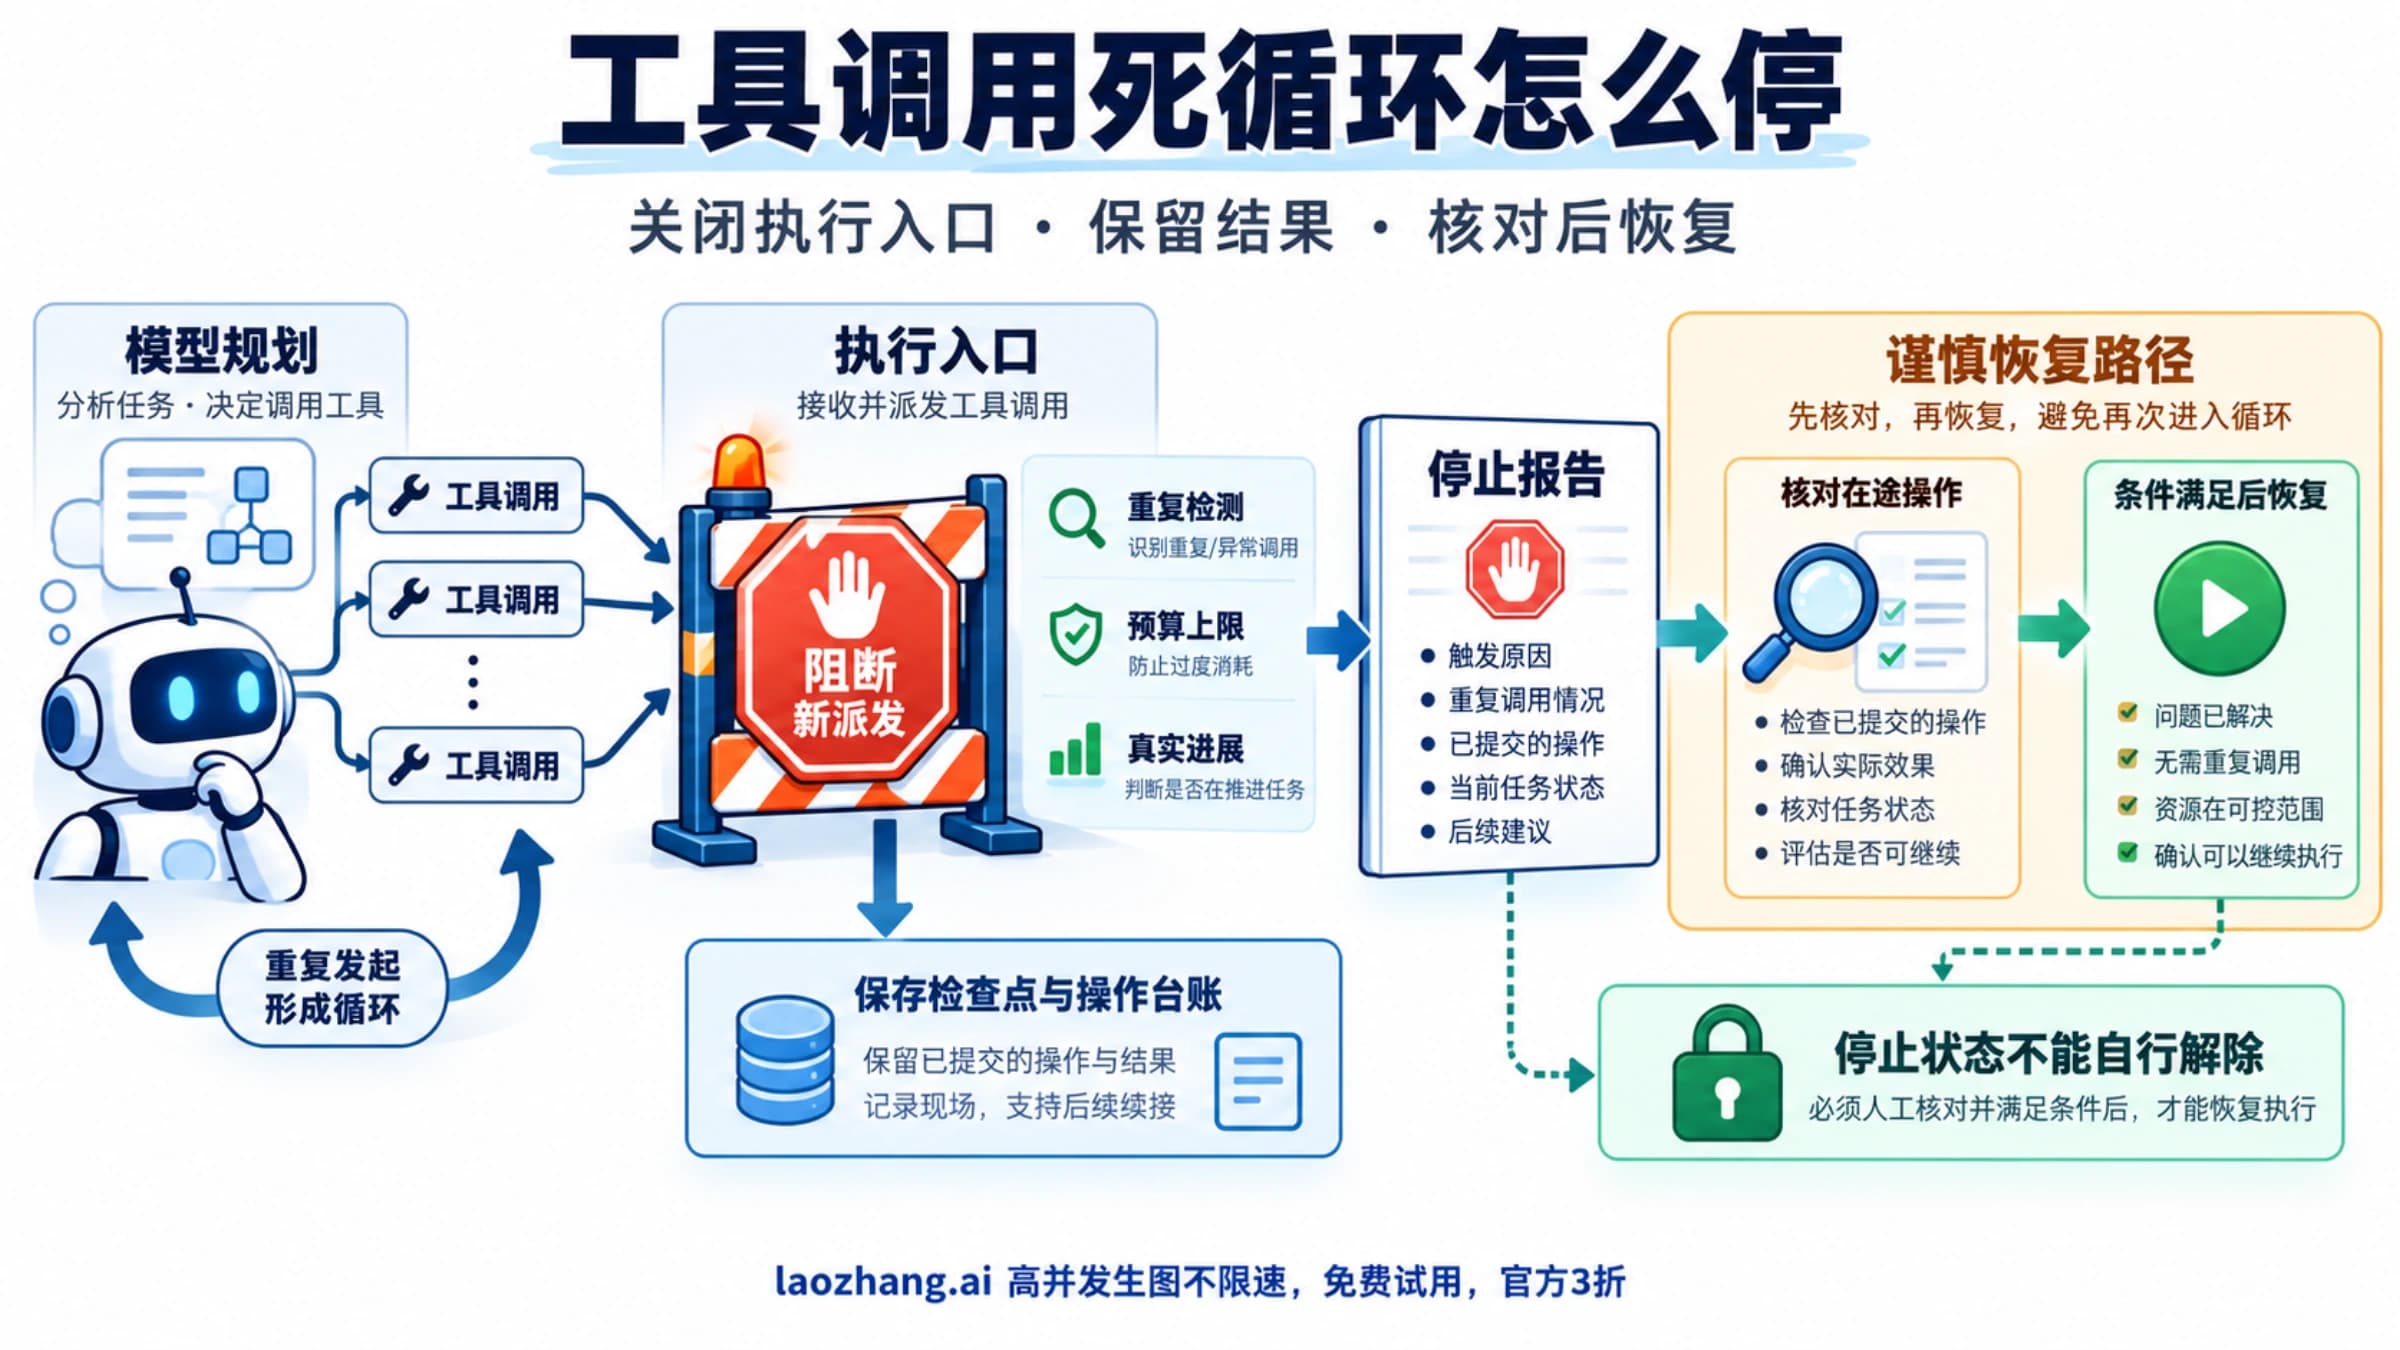
若问题首先是“相同工具为什么一直调用”,可继续看 AI Agent 工具调用死循环怎么停。重复检测和业务进展检查负责终止无效行为;本页的金额闸门负责阻止下一次付费调用,两种控制应共同生效。
怎样在调用前算出值得预留的金额
预留金额应来自应用已经确定的路线、价格与调用上限,不能由 Agent 自报“这次大概很便宜”。至少把以下输入固定下来:
- 实际供应商、模型、服务类型和价格版本,包含可能发生的备用路线。
- 完整输入的保守计量,包括系统提示、历史消息、工具结果和附件;字符数不能直接当作 token 数。
- 执行器真正会传给供应商的输出上限,以及适用的图像、音频、缓存写入、工具或其他计费项。
- 币种、计量单位和舍入方式。账本可以使用整数微美元,避免浮点数累计误差。
对于只包含文本输入与输出的假设调用,若输入最多 8,000 token、输出最多 2,000 token,假设输入单价为每百万 token 2 美元、输出单价为每百万 token 10 美元,则预留为:
8,000 × 2 ÷ 1,000,000 + 2,000 × 10 ÷ 1,000,000 = 0.036 美元
这里的价格和用量仅用于演算,不是某个模型的现行报价。若此路线还收取每次 0.005 美元的工具费,预留应变为 0.041 美元;重试再次调用供应商时,需要再次预留。首次预留 0.036 美元,不自动覆盖三次尝试。
有缓存也不能随意把输入成本算成零。Anthropic 的用量说明区分普通输入、缓存读取与缓存写入字段;某些缓存 token 不计入输入速率限制,并不意味着不计费。若调用前无法确定缓存命中,应使用适用于该请求的保守费用上界,再按实际分类结算。
拿不到可信价格、无法限定付费工具次数,或者备用路线的成本尚未纳入,就拒绝开始这次付费工作,返回 cost_bound_unknown。可以先缩小输入、降低允许的输出、改用已核定路线,之后重新做预算决策;不能用零元估算让请求先出去。
原子预留、出站调用和结算分别做什么
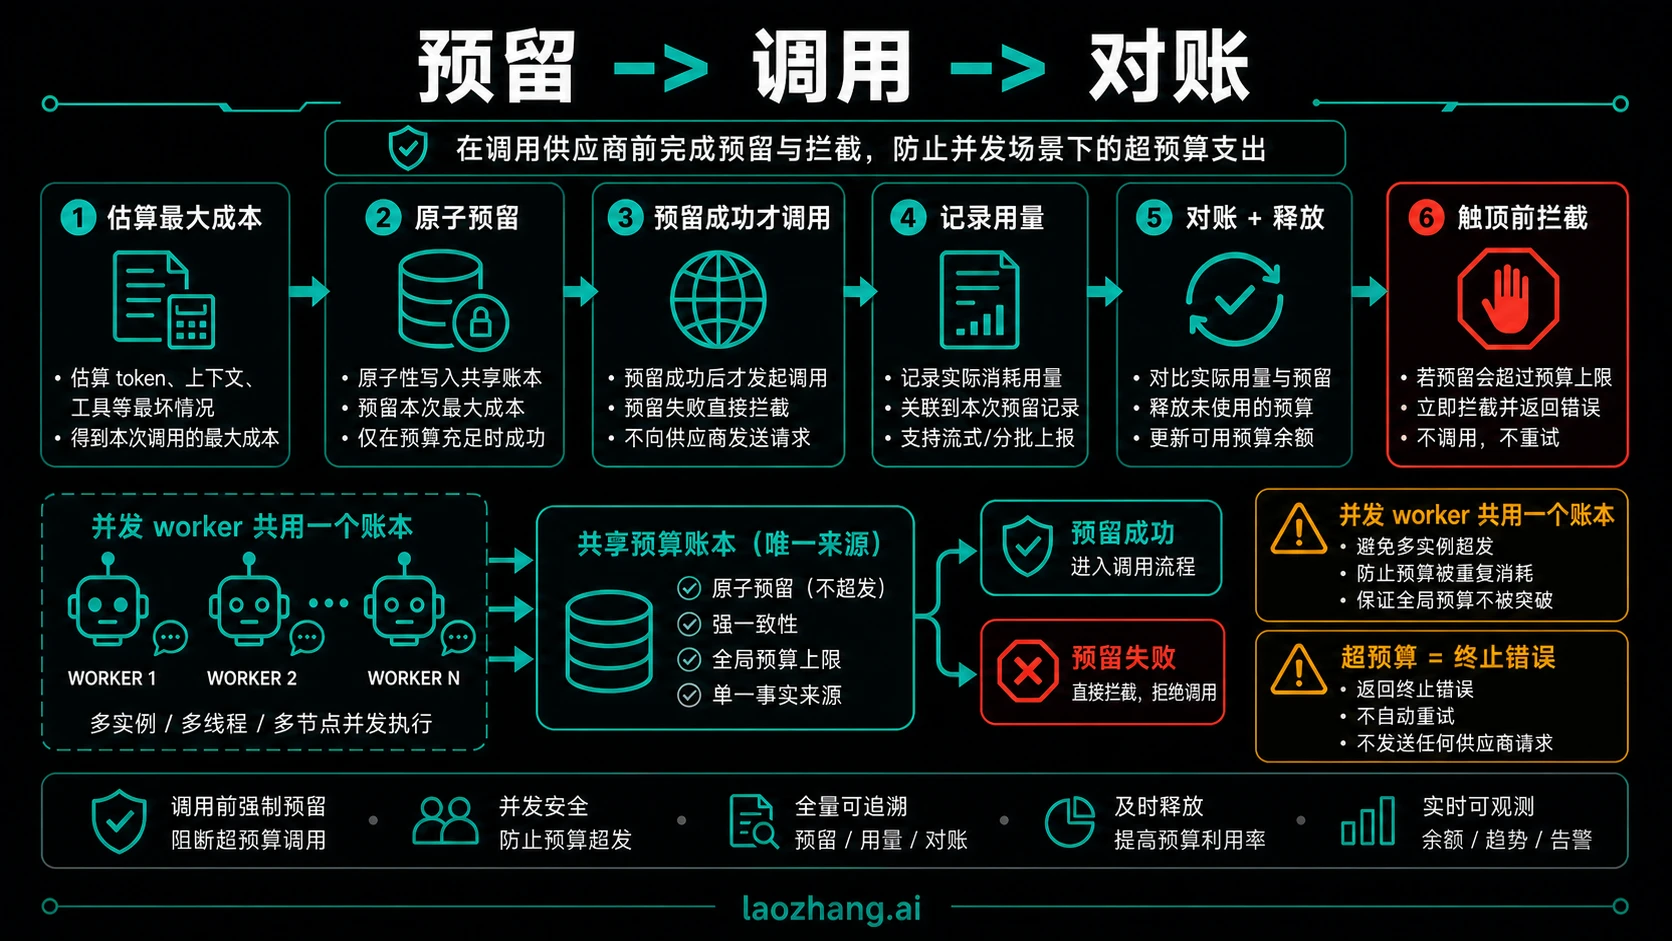
三个阶段要通过稳定的请求标识连接起来。账本至少保存预算身份、周期、上限、已结算金额、未结算预留,以及每次请求的内容绑定、状态、预留金额和最终费用。
放行前同时检查余额并占用额度
原子操作先读取当前账本,确认任务未停止,再检查 spent + held + reserve,最后写入预留记录。只有写入成功,调用器才能出站。不能把“读余额”和“扣预留”分成两个独立请求。
例如总预算为 0.10 美元,两次并发调用各预留 0.06 美元:第一笔成功后,在途预留变为 0.06 美元;第二笔检查到需要 0.12 美元,必须被拒绝。等第一笔按 0.04 美元结算,剩余 0.06 美元才是已确认可用的额度。不过,若任务已因预算不足进入停止状态,结算释放额度也不能由模型自行解除停止。
生产实现可用支持正确隔离的数据库事务,或存储系统提供的原子操作。Redis 的 Lua 脚本具有原子执行能力,可以把条件检查和预留更新放在一起;这不意味着供应商 HTTP 调用也在同一个事务内,更不自动提供持久化、故障切换或脚本报错回滚的完整保证。应在修改前验证输入,并另行设计恢复与审计。
若多个预算同时约束一次调用,例如租户月预算和父任务预算,都要共同通过并预留。扣了租户预算却没扣父任务预算,或者第二个扣款失败后留下第一笔孤立预留,都不算完成准入。
正常结束按实际金额结算,重复通知不能重复扣费
最终费用应来自可信用量与对应计费规则,必要时结合供应商的请求日志或账单对账。结算原子地将预留移出 held,将实际费用加入 spent,并记录请求结果。重复收到相同结算结果,只返回已有结果;同一请求标识出现不同路线、载荷或最终金额,应冻结并核查,不能覆盖旧记录。
请求标识的幂等性只保护账本,不自动保护供应商调用。两个 worker 拿到同一请求标识,必须由唯一执行权或持久化任务状态决定谁能出站;“已有预留,所以再调用一次”会造成重复计费。
超时、断流和进程崩溃先保留预留
请求可能已经被供应商接受,只是客户端没有得到响应。此时将记录改为 unknown,继续占用原预留,暂停该任务的自动付费续跑,再按供应商请求标识核对。TTL 到期不能作为释放费用的依据,否则旧调用尚未确认,新调用又占用了同一笔额度。
只有能证明请求没有发出、没有被接受,或已经取得明确的最终费用,才相应释放或结算。供应商返回错误本身并不能普遍证明费用为零。取消正在等待的流也不等于已经撤销计费。
如果实际费用高于预留,账本要记录真实金额、冻结后续派发并报警。此时应承认费用上界失效,排查价格、计量、路由或额外收费;不能只扣预留金额,让报表看上去没有超支。
一个可以离线运行的预算闸门
下面的 Python 示例只使用标准库,不读取密钥、不联网、不调用 SDK。它验证单进程、多线程共享同一个对象时的检查与预留、唯一调用权、未知费用保留及幂等结算。内存与线程锁不提供多进程共享、重启恢复或真实账单保证,生产系统应把同样的状态转移放进可靠的共享账本。
这里的 Policy 是应用创建的可信配置,max_cost 是假路线的费用上界,单位为微美元:40_000 表示 0.04 美元。示例不负责估算真实模型费用;接入真实调用前,必须完成上一节的路线计量与上界约束。模型输入只进入 payload,不能决定上限、身份或价格。
将代码保存为 spend_gate.py,执行 python3 spend_gate.py:
from dataclasses import dataclass
from hashlib import sha256
from threading import Lock
from concurrent.futures import ThreadPoolExecutor
import json


@dataclass(frozen=True)
class Policy:
    budget: str
    period: str
    route_revision: str
    cap: int
    max_cost: int


def money(value):
    if type(value) is not int or value < 0:
        raise ValueError("金额必须是非负整数微美元")
    return value


class Gate:
    def __init__(self, policy):
        money(policy.cap)
        if money(policy.max_cost) == 0:
            raise ValueError("此示例只接受已知的正费用上界")
        self.policy = policy
        self.lock = Lock()
        self.spent = self.held = 0
        self.stop = None
        self.records = {}

    def admit(self, request_id, payload):
        if not isinstance(request_id, str) or not request_id:
            raise ValueError("缺少稳定请求标识")
        fingerprint = sha256(json.dumps(
            payload, sort_keys=True, ensure_ascii=False
        ).encode()).hexdigest()
        p = self.policy
        binding = (p.budget, p.period, p.route_revision, fingerprint)
        with self.lock:
            old = self.records.get(request_id)
            if old:
                if old["binding"] != binding:
                    self.stop = "request_conflict"
                return False  # 已有记录不能再次取得调用权
            if self.stop:
                return False
            if self.spent + self.held + p.max_cost > p.cap:
                self.stop = "over_budget"
                return False
            self.records[request_id] = {
                "binding": binding, "reserve": p.max_cost,
                "state": "in_flight", "actual": None
            }
            self.held += p.max_cost
            return True

    def unknown(self, request_id):
        with self.lock:
            row = self.records[request_id]
            if row["state"] != "settled":
                row["state"] = "unknown"
                self.stop = "usage_unknown"  # 不释放 held

    def settle(self, request_id, actual):
        actual = money(actual)
        with self.lock:
            row = self.records[request_id]
            if row["state"] == "settled":
                if row["actual"] != actual:
                    self.stop = "settlement_conflict"
                    raise ValueError("同一请求出现不同结算金额")
                return
            self.held -= row["reserve"]
            self.spent += actual
            row.update(state="settled", actual=actual)
            if actual > row["reserve"]:
                self.stop = "bound_broken"
            # 对账不自动解除已有停止状态


def guarded_call(gate, request_id, payload, provider):
    if not gate.admit(request_id, payload):
        return "blocked"
    try:
        actual = provider(payload)  # 假供应商返回最终费用
        gate.settle(request_id, actual)
    except Exception:
        gate.unknown(request_id)
        raise
    return "done"


def tests():
    p = Policy("tenant-a/run-1", "run-1", "fake-v1", 100_000, 40_000)
    gate = Gate(p)
    calls = []

    def fake(payload):
        calls.append(payload)
        return 40_000

    assert guarded_call(gate, "a", {"q": "one"}, fake) == "done"
    assert guarded_call(gate, "b", {"q": "two"}, fake) == "done"
    assert guarded_call(gate, "c", {"q": "three"}, fake) == "blocked"
    assert guarded_call(gate, "d", {"q": "retry"}, fake) == "blocked"
    assert len(calls) == 2 and gate.spent == 80_000
    gate.settle("a", 40_000)
    assert gate.spent == 80_000  # 重复结算不增加费用

    parallel = Gate(p)
    with ThreadPoolExecutor(max_workers=8) as pool:
        accepted = list(pool.map(
            lambda i: parallel.admit(str(i), {"q": i}), range(8)
        ))
    assert sum(accepted) == 2 and parallel.held == 80_000

    lost = Gate(p)
    assert lost.admit("lost", {"q": "x"})
    assert not lost.admit("lost", {"q": "x"})
    lost.unknown("lost")
    assert lost.held == 40_000 and not lost.admit("next", {"q": "y"})
    lost.settle("lost", 30_000)
    assert lost.spent == 30_000 and lost.held == 0
    assert lost.stop == "usage_unknown"

    overflow = Gate(p)
    assert overflow.admit("high", {})
    overflow.settle("high", 120_000)
    assert overflow.spent == 120_000 and overflow.stop == "bound_broken"
    assert not overflow.admit("later", {})
    print("offline checks passed")


if __name__ == "__main__":
    tests()
这份示例的通过输出为 offline checks passed。我们运行了上述离线代码:正常预算内的两次假调用完成,第三次和后续重试被拒绝,假供应商总调用次数保持为 2;8 个线程竞争未结算额度时只放行 2 个。重复结算没有再次扣费,未知费用没有释放额度,实际费用超过预留时如实入账并停止。
这个结果证明的是代码中锁保护下的状态转移。它没有测试真实供应商、流式 token 计量、外部 Redis、数据库故障或多节点账本。示例也没有管理 SDK 内部重试:真实适配器应确保每一次计费尝试都有独立准入;若 SDK 把重试藏在一次 provider() 调用里,就不能直接套用上述保证。
预算错误怎样传到 Agent,才不会换条路继续花钱
控制器应把预算拒绝当成任务停止结果,直接交付已有结果与停止原因,不把它当作普通工具失败重新交回模型规划。返回给调用方的结构可以是:
{
  "error": "over_budget",
  "retryable": false,
  "budget_id": "tenant-a/run-1",
  "next_action": "stop_paid_dispatch"
}
随后停止主任务的付费调度、取消尚未出站的队列项,并把停止状态传播到子 Agent 与工具执行器。正在供应商侧执行的调用仍要保留预留并结算,停止新请求不会撤销它们。
over_budget、cost_bound_unknown、缺失预算身份及账本不可用都应阻止付费出站。若网络错误被判定可重试,也必须先处理前次未知费用,再为新尝试重新预留。供应商账户花费上限拒绝则按其明确错误码停止,不能笼统地遇到 HTTP 429 就自动重试。
备用模型、另一把 key、另一个网关仍然是付费路线。应用可以批准更便宜的路线,但必须保留原父任务预算与停止策略,以新路线的可信上界重新检查;模型自行改路线、生成新 trace ID 或重启会话不能解除熔断。
恢复应由有权限的操作者在对账后决定。记录新上限或缩小后的任务、批准人、策略版本、有效期与原因,再恢复受控派发。单纯清零内部 spent 只会改变计数,不会减少供应商已经产生的账单。
OpenAI、Anthropic 和网关的预算各有什么边界
下表按 2026 年 10 月 6 日核对到的官方规则区分。它用于判断机制,不表示每个账户已启用相应选项,也不代表我们修改过这些平台的设置。
| 服务 | 预算阻断行为 | 对 Agent 的直接影响 |
|---|---|---|
| OpenAI | 组织或项目启用硬限制后,触顶分别返回 organization_spend_limit_exceeded、project_spend_limit_exceeded,HTTP 429;提醒本身不停止流量 | 按具体错误码停止,不按普通吞吐限流反复重试;组织限额覆盖所有项目,项目限额只覆盖计入该项目的流量。执行传播期间可能略超限 |
| Anthropic | 服务配置的组织月度花费上限触顶:429 rate_limit_error,Messages 的详情码为 enforced_spend_limit_reached,没有 retry-after;用户设定、低于该上限的花费限制:400 invalid_request_error | 不把这两种花费拒绝当成短暂限流;Claude Code 的工作区检查存在单独的 429 行为,不能仅凭状态码归因。AWS 计费路线也不能直接套用平台余额规则 |
| Cloudflare AI Gateway | 适用规则超限时在供应商调用前返回 429;成本在请求完成后记录,具有最终一致性,并发突刺可能超限 | 适合集中控制,但已放行的并发费用尚未进入累计值;成本为尽力估算,不能据此承诺发票精确上限 |
| LiteLLM Proxy | 支持代理、团队、成员、用户、虚拟 key 以及多时间窗口的预算;没有设置预算的 key 不等于有默认保护 | 应核对部署版本和实际作用范围,不能从字段名推断原子预留。团队 key 从 v1.95 起不再执行所属用户的个人预算,团队内成员预算是另一个控制项 |
OpenAI 自行配置的硬花费上限,与 OpenAI 根据使用层级批准的月度 usage limit 是两类限制。遇到组织或项目花费码,核对相应范围;遇到 organization_usage_limit_exceeded,应核对批准的使用额度。提高每分钟 token 限制并不会自动解除月度金额限制。官方花费限制说明给出了对应区别与恢复条件。
Cloudflare 的身份维度也需要可信来源:cf.user_id 适用于 Access 保护的自定义域名与有效用户身份,服务令牌没有该用户字段;其他场景需由应用提供可信用户元数据。按用户拆桶与只过滤某个用户不是同一回事,不能让模型选择用户标识来获得新预算。规则与身份条件见官方文档。
如果使用 LiteLLM Agent 会话预算,还要区分会话计数与持久化总预算。其说明中的费用在成功响应后累计,下一次调用前检查,会话计数默认 TTL 为 1 小时。这有助于限制轮次和会话花费,却不能单独证明并发在途费用不会超限;TTL 过期或更换 trace ID 也不应让父任务总预算归零。配置位置须按实际部署版本确认,不能把文档里的示例当成已经验证的生产配置。
上线前要证明的是“被拒绝的调用没有出站”
先接假供应商计数器,再验证真实运行环境的入口与账本。看日志里有 blocked 不够,拒绝发生后出站调用次数必须不增加。
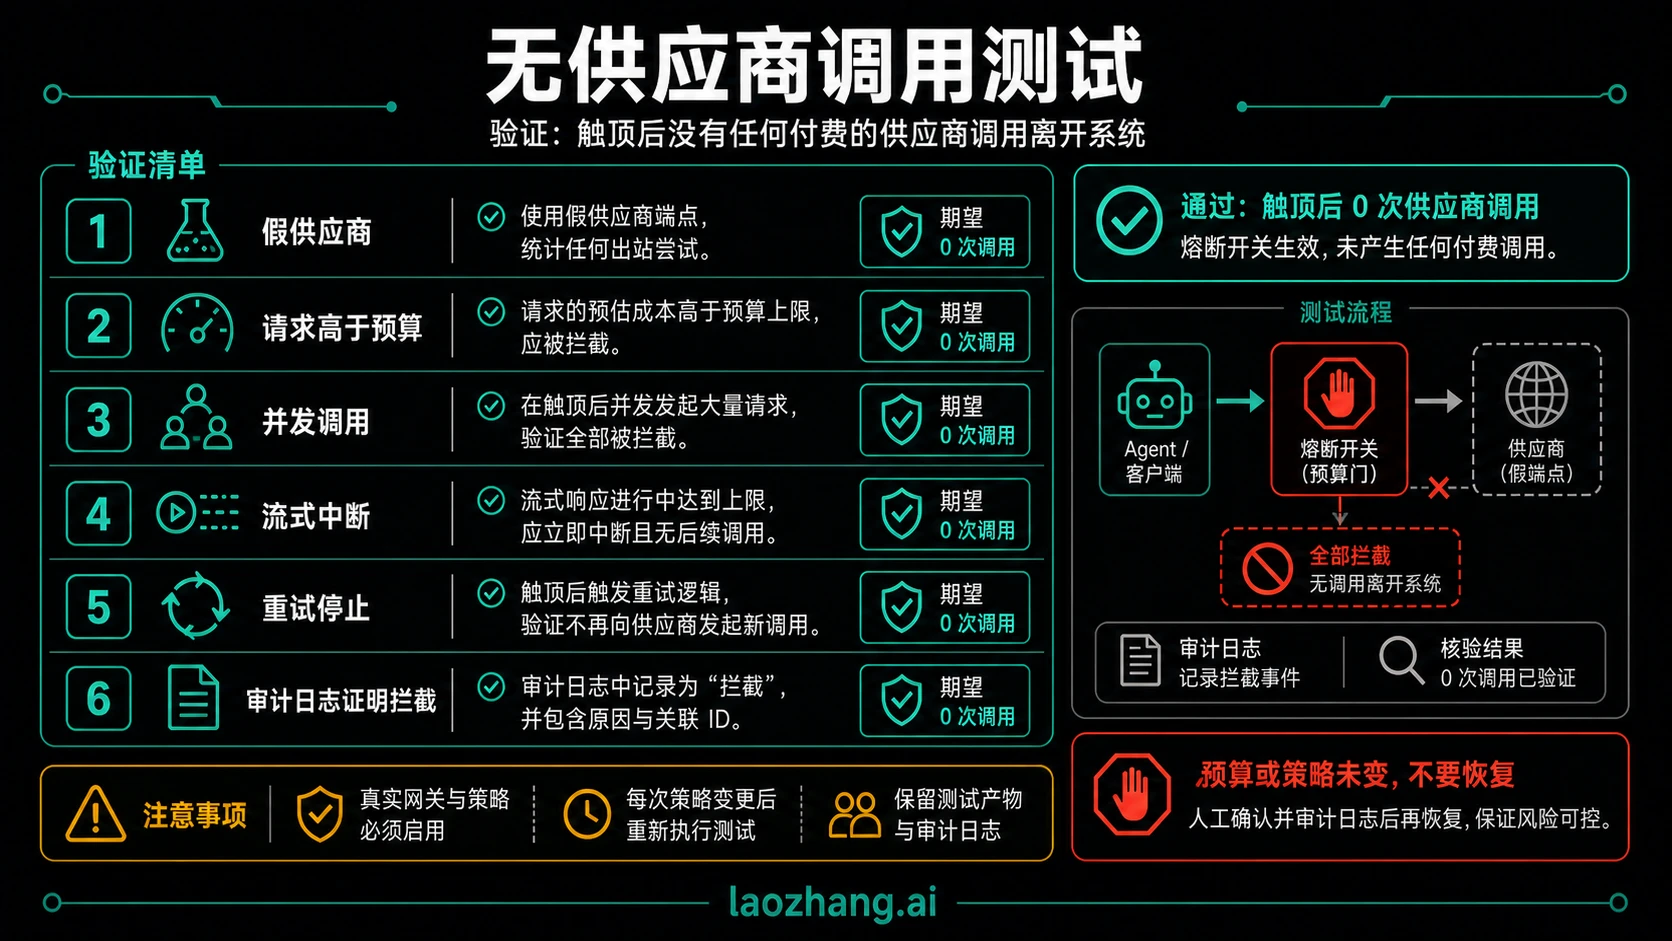
| 场景 | 应观察到的结果 |
|---|---|
| 正常费用低于预留 | 结算真实费用,释放差额,任务在预算内可继续 |
| 下一次费用上界超过余额 | 预留失败,供应商调用计数不增加 |
| 多 worker 同时竞争余额 | 所有成功预留总额受同一上限约束;失败者不能出站 |
| 重复派发同一请求、重复结算 | 不重复调用、不重复扣费;内容或金额冲突停下核查 |
| 流式断开、响应丢失、发送后崩溃 | 保留在途预留,重启后仍能找到未知记录 |
| 账本写入失败或状态无法读取 | 拒绝新的付费调用,而非临时绕过账本 |
| SDK 重试、子 Agent、付费工具或备用路线 | 每个计费尝试进入同一父预算;停止状态不能被重新规划解除 |
| 实际费用超过预留 | 记录真实费用并冻结,不掩盖超支 |
离线示例覆盖其中的金额状态与单进程竞争。生产验收还要用自己的共享存储、队列与适配器验证持久化、故障恢复和所有付费路径;这些结果不能由离线锁测试代替。
发生费用事故时,先在可控的出站入口暂停新付费派发,再查看已结算、在途和未知三类金额。保存请求标识与脱敏日志,核对供应商费用后决定停止、缩小任务或批准恢复。不要先删记录、重置预算或换凭证续跑,那会让旧费用失去归属。
常见问题
OpenAI 项目预算现在能硬停吗?
可以,但需要启用 Enforce a hard limit。当前组织和项目硬限制触顶后返回相应花费错误码;只设置提醒不会停止 API 流量。执行有传播延迟,记录花费可能略超,因此它是有价值的账户保护,不能替代每个 Agent 的调用前预留。OpenAI 官方说明
返回 429 后,Agent 应该重试吗?
先看具体错误。请求或 token 吞吐限制可能按服务要求等待后重试;组织、项目或服务花费上限触顶,不会因为短暂等待自动恢复。OpenAI 的花费码、Anthropic 的 enforced_spend_limit_reached 应进入停止处理;用户设定的 Anthropic 花费限制还可能返回 400。不要让统一重试器只按 429 分类。OpenAI、Anthropic
超时后没拿到 usage,能把预留退回来吗?
不能仅凭超时释放。请求可能已产生费用,应保留未知预留并核对。能证明未发出,或者已取得明确最终用量,才相应释放或结算;超时、取消与错误响应都不是通用的零费用证明。
已经用了 AI 网关,还需要自建账本吗?
先看你的目标。如果只需要集中花费提醒与后续阻断,网关预算可能足够;若要让多个并发任务在固定金额内准入,就要核对网关是否把在途费用原子预留在同一预算里。Cloudflare 当前文档明确费用完成后入账、最终一致性与并发超限边界,不能把它直接当成严格预留账本。官方限制说明
更便宜的模型可以在熔断后自动接着跑吗?
只有应用策略明确允许恢复,并以同一父预算完成新的费用检查时才可以。换模型不应改变预算身份;已经因未知用量或账本异常停止的任务,要先处理停止原因,不能仅因新模型便宜就继续出站。
调用前预留能保证真实账单永远不超预算吗?
需要费用上界正确、全部付费路径受控、共享账本可靠并且结算完整。任何额外收费、错误价格、未受控重试或绕行都可能破坏保证。预留上界被实际费用突破时,应如实入账并停止;本页离线代码证明自己的状态转移,没有证明真实供应商账单或多节点系统具备这些条件。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月7日。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月7日。
- 1.OpenAI 官方文档developers.openai.com/api/docs/guides/spend-limits
- 2.Anthropic 的用量说明platform.claude.com/docs/en/api/rate-limits
- 3.Redis 的 Lua 脚本redis.io/docs/latest/develop/programmability/eval-intro
- 4.Cloudflare AI Gatewaydevelopers.cloudflare.com/ai-gateway/features/spend-limits
- 5.LiteLLM Proxydocs.litellm.ai/docs/proxy/users
- 6.LiteLLM Agent 会话预算docs.litellm.ai/docs/a2a_iteration_budgets