OpenAI Assistants API를 Responses API로 마이그레이션하는 방법
Assistants API는 이미 종료됐습니다. 앱에 남아 있는 설정과 대화 기록을 기준으로 Responses 요청을 구성하고, 도구 결과와 검색 근거를 확인한 뒤 트래픽을 전환해야 합니다. 장애 시 돌아갈 대상도 동작하는 Responses 버전으로 준비합니다.
목차
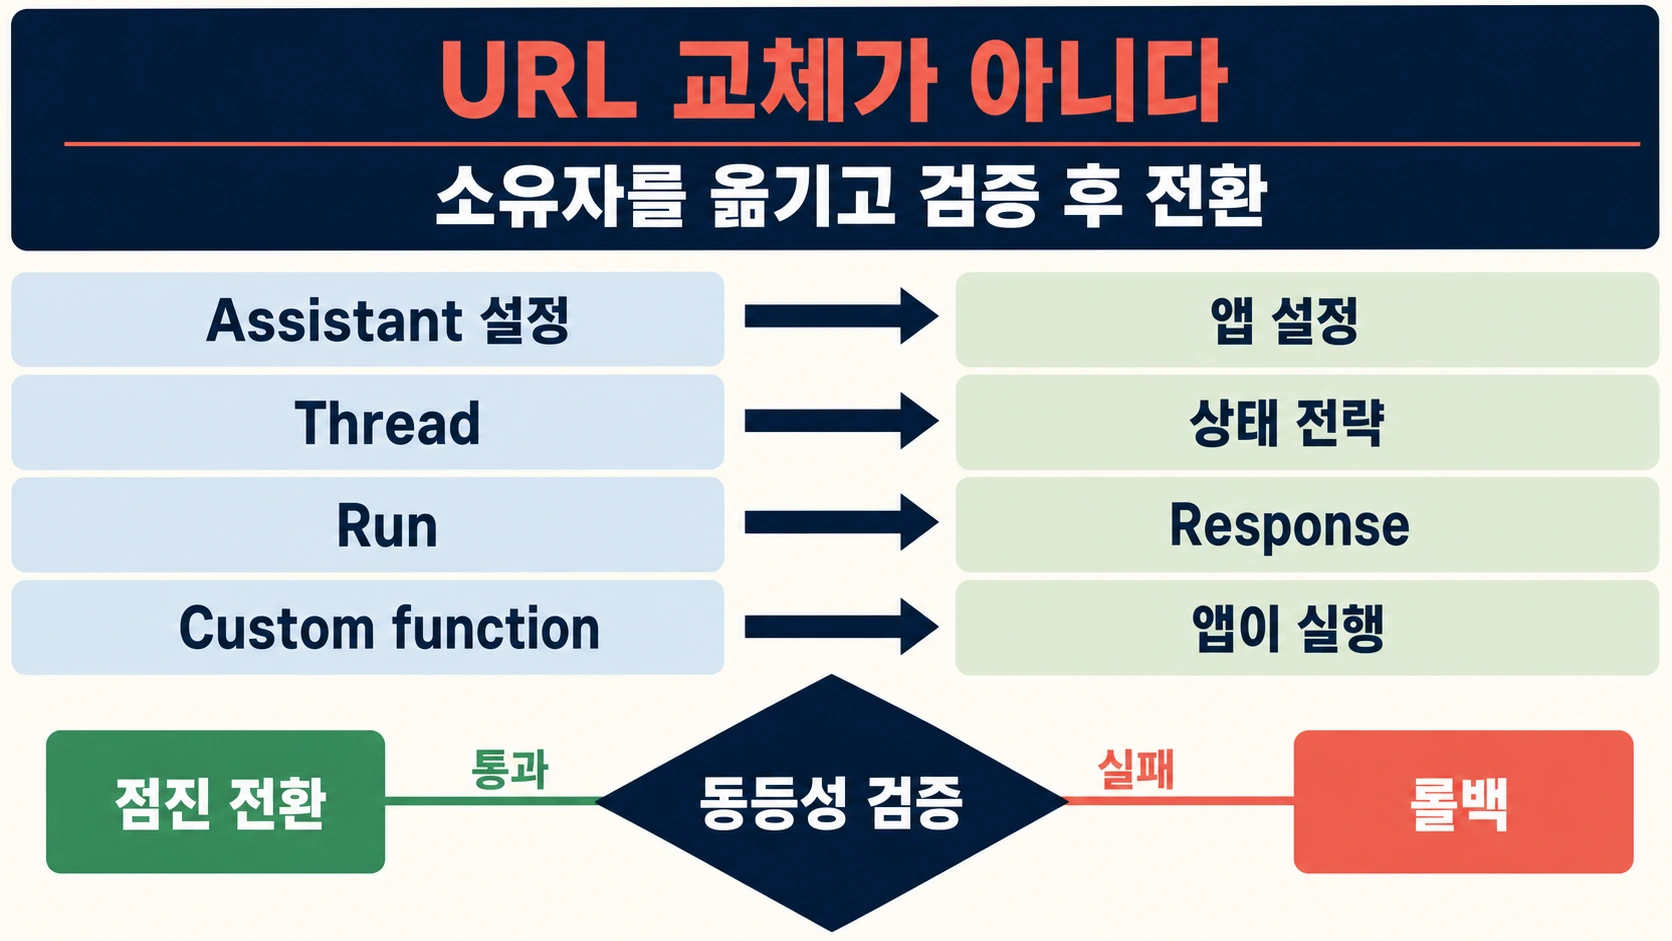
OpenAI Assistants API는 2026년 8월 26일 종료됐으며 현재 사용할 수 없습니다. 지금 마이그레이션하려면 애플리케이션이 보관한 Assistant 설정과 대화 기록에서 출발해야 합니다. thread_id만 가지고 기존 메시지를 다시 조회하거나, 옛 Run을 이어서 실행하는 방식은 사용할 수 없습니다. 현재 공식 이전 문서도 과거 Thread 조회 예제가 더 이상 동작하지 않는다고 명시합니다.
복구 순서는 설정을 코드로 옮기기 → 저장된 기록에서 이어갈 맥락 만들기 → Responses의 함수 호출과 검색 연결하기 → 저장된 업무 결과로 검증하기 → 새 경로로 트래픽 전환하기입니다. 설정과 기록이 충분한 기능부터 살리고, 자료가 없는 대화는 새로 시작하거나 담당자에게 넘깁니다. 없는 기록을 모델이 추정해 채우게 하지 않습니다.
이 글은 OpenAI의 Assistants를 OpenAI Responses로 이전하는 경우를 다룹니다. 예시는 고객 지원 서비스에서 배송 문의를 이어가는 상황이며, 코드의 도구는 합성 데이터만 조회합니다. 로컬 문법과 합성 사례를 확인했으며, 실제 OpenAI SDK 요청이나 운영 환경에서의 기능 동등성을 시험한 결과는 아닙니다.
먼저 확보할 것은 API 객체가 아니라 앱에 남은 자료입니다
예전 asst_, thread_, run_ ID는 출처를 추적하는 값으로 남겨 둡니다. 접두사를 바꿔 새 API의 ID로 사용할 수는 없습니다. 지금 쓸 수 있는 설정·기록·업무 데이터가 무엇인지 다음과 같이 확인합니다.
| 앱에 남은 자료 | 이전에 사용하는 방법 | 자료가 없으면 |
|---|---|---|
| instructions, 모델 설정, 도구 스키마의 코드·내보내기 파일 | 버전 관리되는 Responses 설정으로 복원 | 확인된 업무 규칙부터 새로 정의하고 담당자가 승인 |
| 시간순 메시지와 콘텐츠를 포함한 대화 내보내기 | 지원되는 콘텐츠를 input item으로 변환 | 새 대화로 시작하고 필요한 정보를 사용자에게 다시 확인 |
| 티켓·주문 DB의 처리 결과 | 최신 사실 조회와 이전 결과 비교의 기준 | 처리 완료 여부를 확인할 때까지 변경 작업 중단 |
| 원본 문서, 파일 ID, vector store 목록 | 현재 접근 권한과 처리 상태를 확인해 검색 연결 | 허가된 원본으로 다시 색인하거나 문서 검색 기능 보류 |
| 함수 호출 기록과 업무 작업 키 | 이미 수행한 작업의 중복 방지 | 재실행 전 업무 DB와 대조하거나 담당자에게 이관 |
운영 로그에 “환불 요청을 받았다”는 문장만 있다고 환불이 완료됐다고 판단하면 안 됩니다. 대화 복구와 업무 상태 복구를 분리하고, 주문 DB처럼 실제 결과를 가진 시스템을 우선합니다. 읽기 전용 보관본은 그대로 유지하며 변환 결과를 별도 파일에 저장합니다.
Assistant 설정의 목적지를 Prompt object로만 정하면 또 한 번 이전해야 합니다. reusable Prompt objects와 v1/prompts는 2026년 11월 30일 종료 예정입니다. 현재 Prompt 이전 안내는 내용을 애플리케이션 코드로 옮기도록 안내합니다. 지침, 도구, 출력 스키마와 모델 선택을 하나의 설정 버전으로 묶으면 배포와 복구 때 같은 조합을 다시 적용할 수 있습니다.
기존 대화 기록을 Responses 입력으로 변환하기
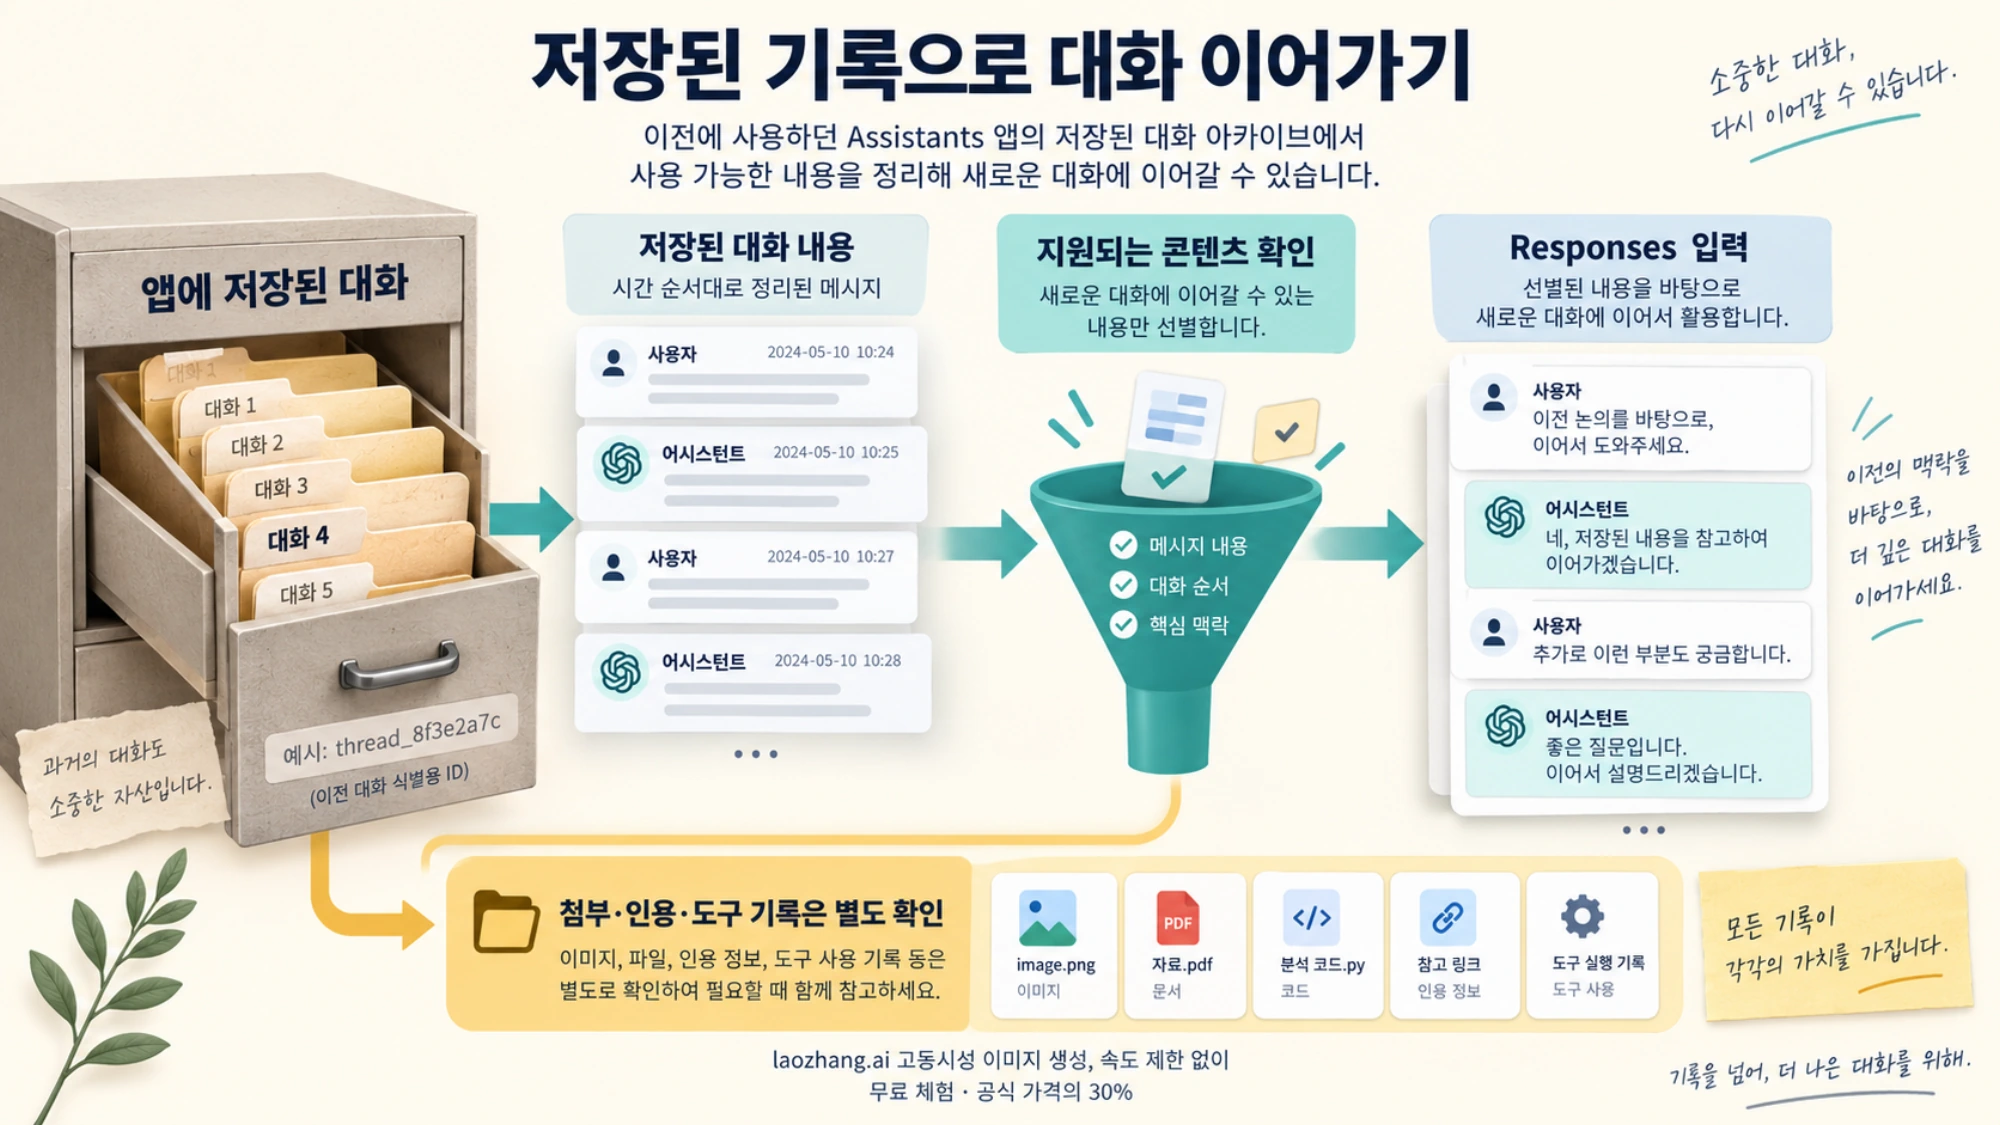
기록 이전의 첫 단계는 API 호출이 아닙니다. 보관 파일의 순서와 콘텐츠를 확인하고, 다시 사용할 수 있는 메시지만 입력으로 만드는 작업입니다. 아래는 앱이 이미 저장한 내보내기를 다루는 예시입니다. OpenAI 내보내기의 고정 형식이 아니라 이 예제에서 정한 파일 형식입니다.
ticket-history.json을 다음처럼 준비합니다. seq는 원래 저장 순서를 나타내며, 배열의 현재 정렬이나 메시지 ID로 순서를 추정하지 않습니다.
{
  "archive_version": 1,
  "messages": [
    {"seq": 1, "role": "user", "content": [{"type": "text", "text": {"value": "주문 K-207의 배송이 늦어지고 있어요.", "annotations": []}}]},
    {"seq": 2, "role": "assistant", "status": "completed", "content": [{"type": "text", "text": {"value": "현재 배송 상황을 확인해 드리겠습니다.", "annotations": []}}]}
  ],
  "tool_events": []
}
다음 변환기는 텍스트만 있는 완료된 대화를 대상으로 합니다. 첨부, 인용, 이미지, 미완료 응답이나 도구 이벤트가 있으면 실행을 멈춥니다. 지원하지 않는 데이터를 조용히 버려서 “이전 완료”로 표시하지 않는 것이 목적입니다.
import json
from pathlib import Path

def archive_to_items(archive):
    if archive.get("archive_version") != 1:
        raise ValueError("지원하지 않는 보관 파일 버전")
    if archive.get("tool_events"):
        raise ValueError("도구 이벤트는 별도로 대조해야 합니다")
    messages = archive.get("messages")
    if not isinstance(messages, list):
        raise ValueError("messages 배열이 필요합니다")
    sequence = [m.get("seq") for m in messages]
    if any(type(n) is not int for n in sequence):
        raise ValueError("각 메시지에 정수 seq가 필요합니다")
    if len(sequence) != len(set(sequence)):
        raise ValueError("중복 seq를 먼저 해결하세요")
    items = []
    for message in sorted(messages, key=lambda m: m["seq"]):
        role = message.get("role")
        if role not in ("user", "assistant"):
            raise ValueError("지원하지 않는 메시지 역할")
        if message.get("attachments"):
            raise ValueError("첨부가 있는 대화는 개별 이전이 필요합니다")
        if role == "assistant" and message.get("status") != "completed":
            raise ValueError("완료되지 않은 assistant 메시지")
        parts = message.get("content")
        if not isinstance(parts, list) or not parts:
            raise ValueError("콘텐츠가 없는 메시지")
        content = []
        for part in parts:
            text = part.get("text", {})
            if part.get("type") != "text" or text.get("annotations"):
                raise ValueError("텍스트 외 콘텐츠 또는 인용은 별도 검토 필요")
            value = text.get("value")
            if not isinstance(value, str) or not value.strip():
                raise ValueError("비어 있거나 잘못된 텍스트")
            content.append({
                "type": "input_text" if role == "user" else "output_text",
                "text": value,
            })
        item = {"type": "message", "role": role, "content": content}
        # 이미 저장된 phase가 있을 때만 유지하며, 없는 값을 추정하지 않습니다.
        if "phase" in message:
            if role != "assistant" or message["phase"] not in (
                "commentary", "final_answer"
            ):
                raise ValueError("지원하지 않는 phase")
            item["phase"] = message["phase"]
        items.append(item)
    return items

if __name__ == "__main__":
    archive = json.loads(Path("ticket-history.json").read_text(encoding="utf-8"))
    items = archive_to_items(archive)
    Path("responses-history.json").write_text(
        json.dumps(items, ensure_ascii=False, indent=2), encoding="utf-8"
    )
    print(f"메시지 {len(items)}개 변환")
실제 앱의 내보내기 형식이 다르면 위의 입력 어댑터를 먼저 고칩니다. 첨부와 인용이 있는 대화는 원본 파일의 현재 접근 가능 여부, 지원되는 입력 형식, 출처 연결을 따로 확인합니다. 다시 사용할 수 없는 부분은 보관본에서 열람할 수 있게 남기고, 이어가는 대화에 어떤 맥락이 빠졌는지 표시합니다.
변환 성공만으로 맥락이 복구됐다고 볼 수는 없습니다. 위 기록 뒤에 “그 주문은 언제 도착하나요?”를 붙여 K-207을 정확히 참조하는지 확인해야 합니다. 이전 메시지의 답변을 현재 배송 상태로 믿게 하지 말고, 새 조회 도구에서 최신 결과를 받게 합니다. 공식 기록 이전 설명도 앱에 저장된 메시지를 출발점으로 삼습니다.
대화 상태는 운영 방식에 맞춰 선택합니다
텍스트 기록을 입력으로 만들었다면 다음 턴부터 누가 상태를 보관할지 정합니다. Responses에서 Thread에 해당하는 방식이 하나로 고정된 것은 아닙니다.
| 방식 | 요청에 넣는 것 | 적합한 상황 | 함께 결정할 사항 |
|---|---|---|---|
| 앱 관리 기록 | 필요한 메시지와 전체 출력 item | 자체 보관·삭제 정책, 명시적 복구가 필요한 서비스 | 순서, item 보존, 길이 제한, 저장소 접근 권한 |
previous_response_id | 사용 가능한 직전 Response ID와 새 입력 | 짧고 선형인 연속 대화 | ID가 조회 불가능할 때 앱 기록으로 새 요청 시작 |
| Conversation | 앱 세션에 연결한 conversation ID와 새 입력 | 여러 기기·작업자가 이어가는 지속 대화 | 사용자·조직별 연결, 삭제 정책, 장기 보관 |
요청 명세에 따르면 conversation과 previous_response_id는 함께 사용할 수 없습니다. previous_response_id를 사용해도 이전 요청의 instructions는 다음 요청에 전달되지 않습니다. 지침과 필요한 도구 설정은 다음 요청에도 명시합니다.
Conversation을 선택하면 기존 item이 입력 앞에 붙고, 새 입력과 출력은 완료 후 자동으로 추가됩니다. 따라서 매번 전체 보관 기록까지 다시 보내면 중복됩니다. 변환 기록을 처음 한 번 등록한 뒤 앱 DB에 다음 연결을 저장하는 흐름이 필요합니다.
# 아래 변수 client와 model은 뒤의 실행 예제처럼 구성합니다.
conversation = client.conversations.create(items=converted_items)
# 앱 DB: 인증된 tenant_id + app_session_id -> conversation.id
response = client.responses.create(
    model=model,
    instructions="배송 상태는 조회 결과로만 답하세요.",
    conversation=conversation.id,
    input="그 주문은 언제 도착하나요?",
)
이 코드는 연결 관계를 보여 주는 조각입니다. converted_items는 위 변환 결과이며, 실제 DB 저장은 서비스 구현에 맞게 추가합니다. 연결 생성은 세션별로 잠그고 이미 등록한 Conversation이 있는지 확인합니다. 재시도 때문에 같은 기록을 두 번 등록하지 않도록 이전 상태와 대상 ID를 함께 저장합니다. 모델 입력이나 클라이언트가 보낸 ID만으로 다른 사용자의 Conversation을 선택하지 않습니다.
앱 관리 방식에서는 output_text만 저장하면 안 됩니다. 함수 호출, 결과, reasoning item과 assistant의 phase까지 이어가기 위한 상태가 손실될 수 있습니다. reasoning 문서는 도구 결과와 함께 관련 reasoning item을 그대로 전달하도록 안내합니다. 암호화된 reasoning 콘텐츠는 원형을 보존하고, 텍스트 대화에서 숨겨진 추론을 새로 만들어 복원하지 않습니다.
함수 호출부터 최종 답변까지 한 루프로 연결하기
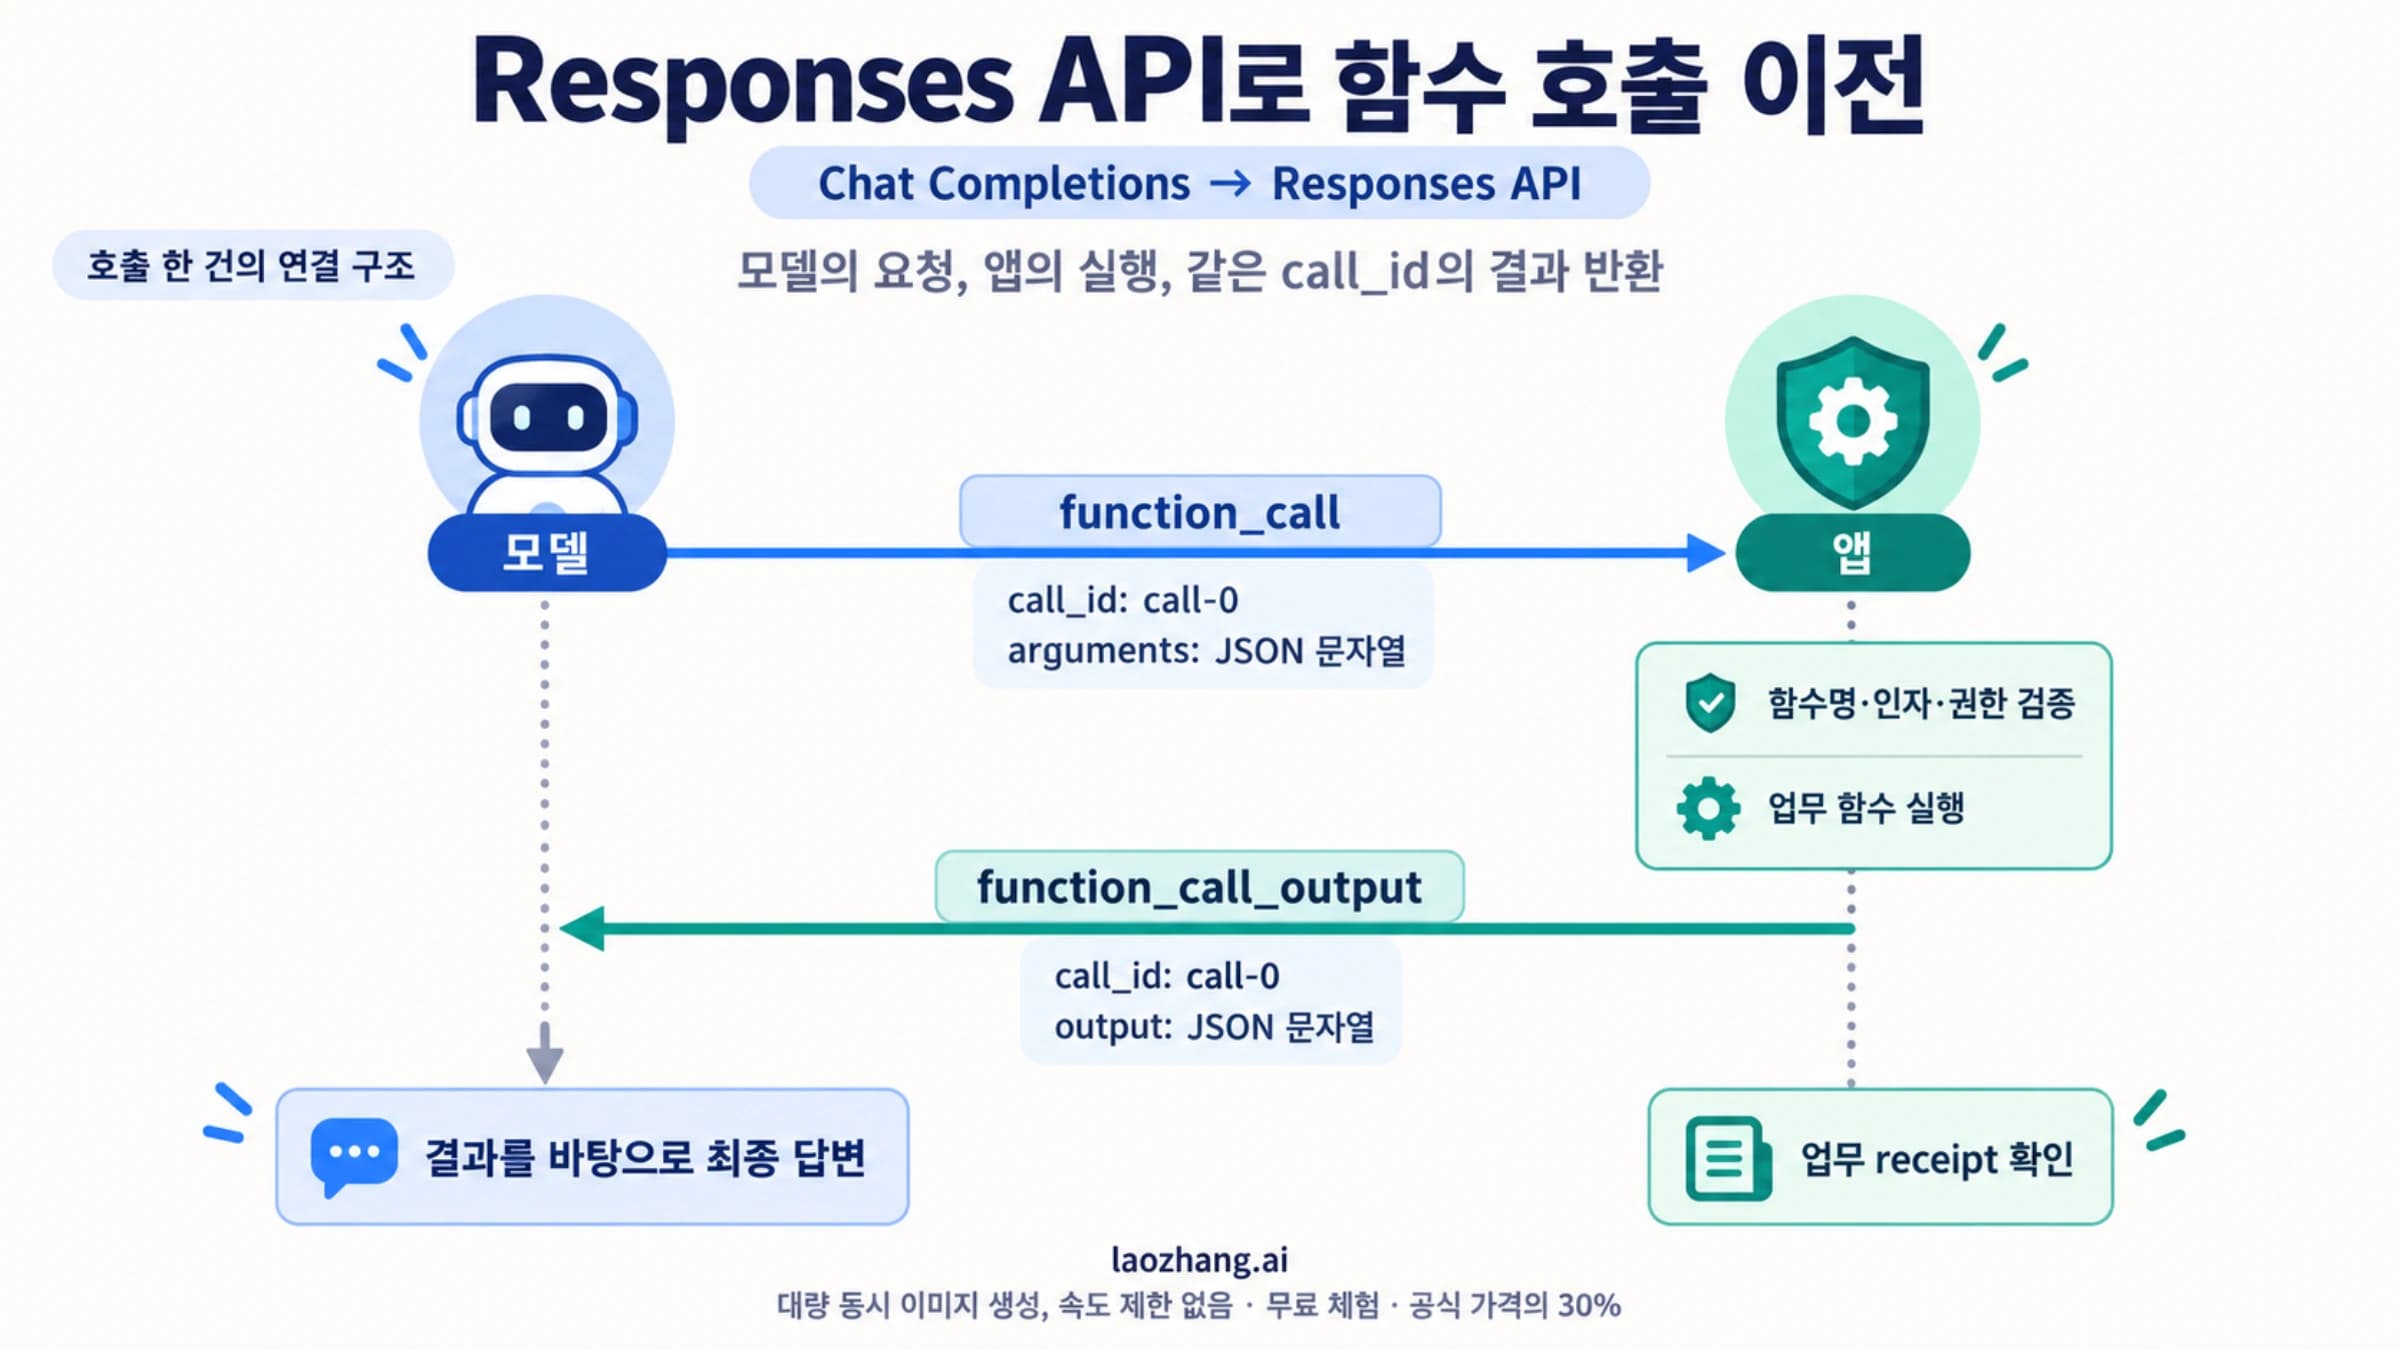
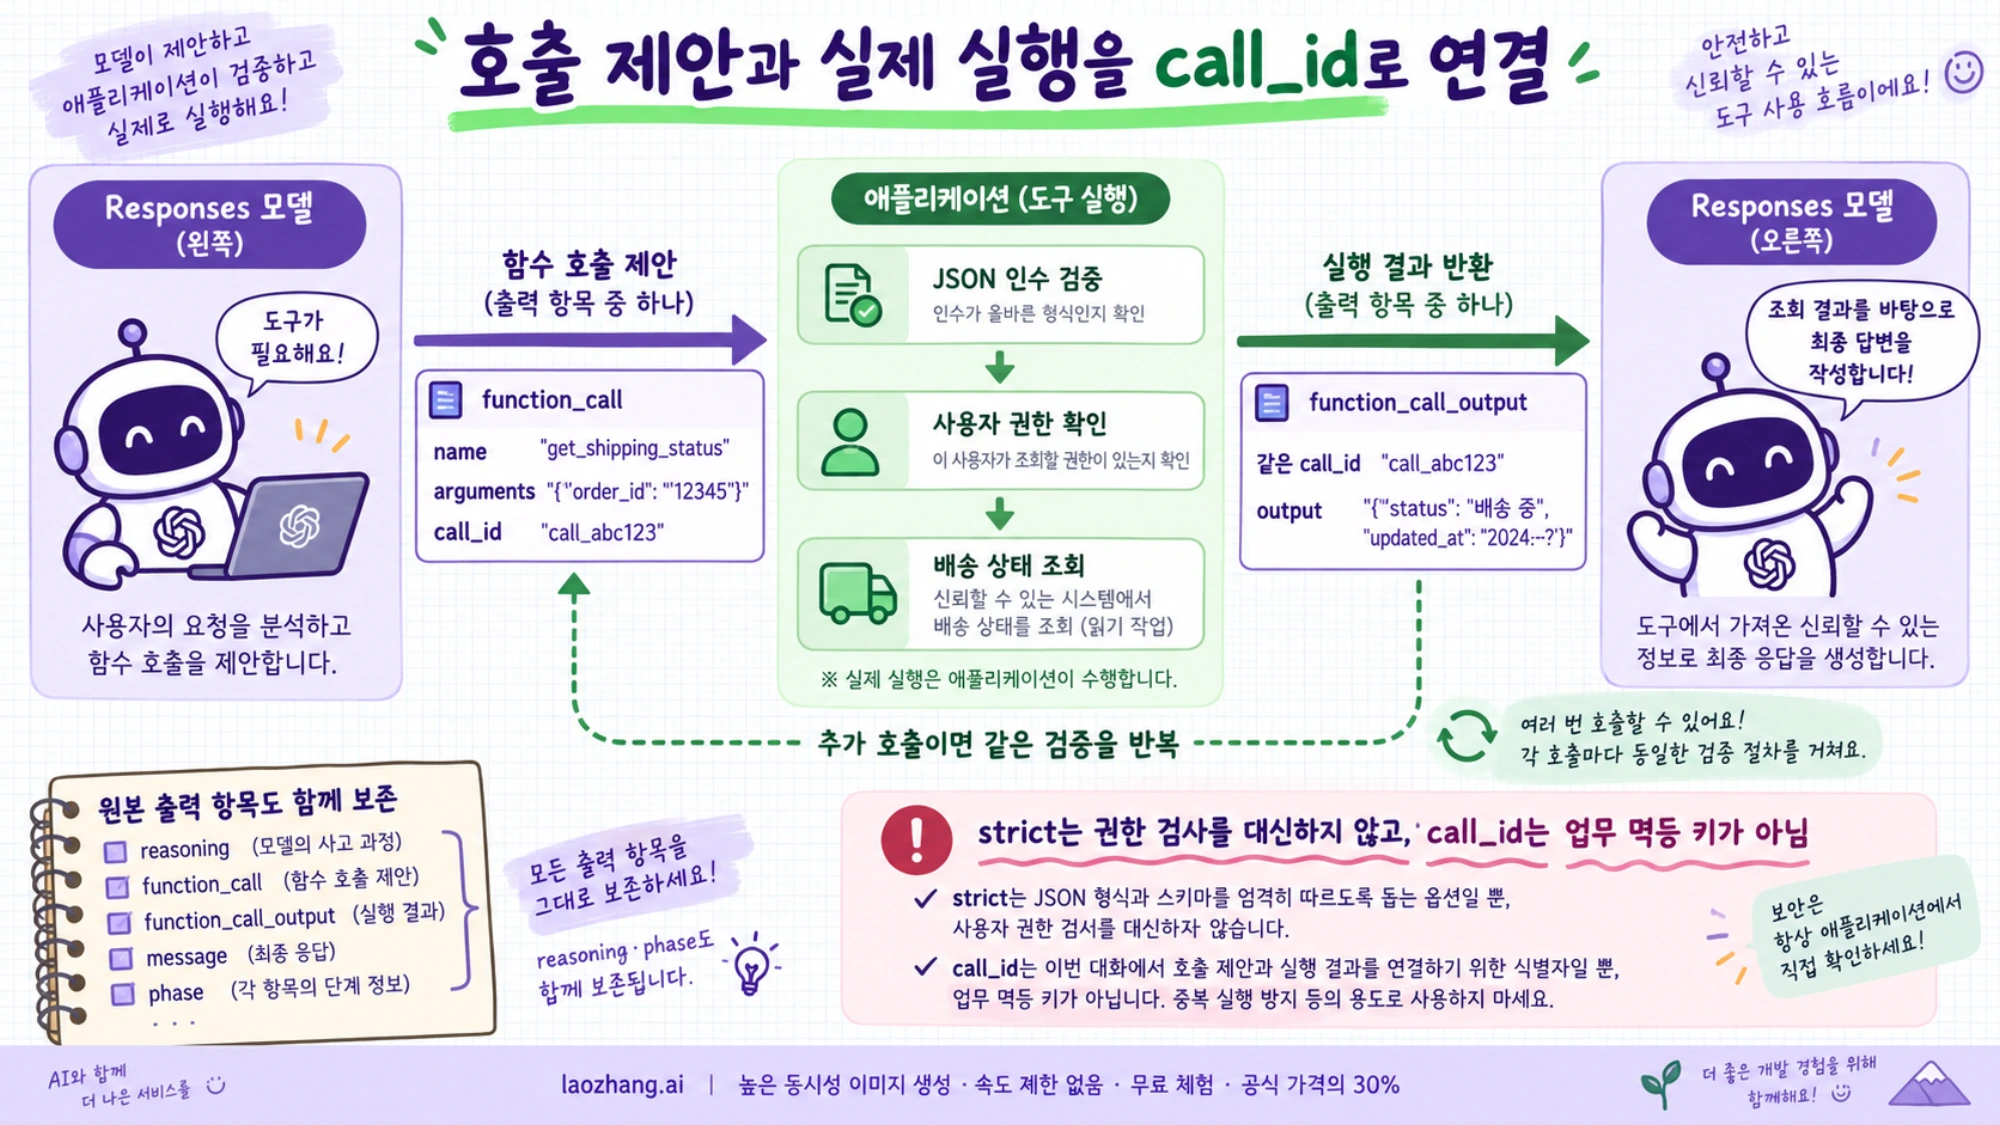
Assistants의 requires_action을 처리하던 코드는 Responses의 function_call과 function_call_output 흐름으로 바뀝니다. 모델이 함수 이름과 인수를 제안하고, 앱이 검증·권한 확인·실행을 맡습니다. 결과를 반환할 때 연결 키는 item의 id가 아니라 원래 call_id입니다. 공식 함수 호출 안내는 한 응답에 0개, 1개 또는 여러 호출이 있을 수 있다고 설명합니다.
아래를 support_responses.py로 저장하면 위에서 만든 responses-history.json을 읽어 새 질문을 이어가는 예제로 사용할 수 있습니다. 독자의 환경에는 현재 OpenAI Python SDK와 사용할 모델의 접근 권한이 필요합니다. create를 주입받는 함수로 분리해 모델을 호출하지 않고도 앱 로직을 시험할 수 있게 했습니다. 예제의 lookup_delivery는 합성 배송 자료만 읽으며 주문이나 환불을 변경하지 않습니다.
import json
import os
from pathlib import Path

INSTRUCTIONS = """
배송 현황은 lookup_delivery 결과로만 답합니다.
조회 권한이 없거나 결과가 없으면 확인할 수 없다고 설명합니다.
과거 대화의 배송 상태를 최신 사실로 사용하지 않습니다.
""".strip()

TOOLS = [{
    "type": "function",
    "name": "lookup_delivery",
    "description": "인증된 사용자가 볼 수 있는 주문의 배송 현황을 조회합니다.",
    "strict": True,
    "parameters": {
        "type": "object",
        "properties": {"order_id": {"type": "string"}},
        "required": ["order_id"],
        "additionalProperties": False,
    },
}]

def dispatch(call, allowed_orders, deliveries):
    if call.name != "lookup_delivery":
        raise ValueError("허용하지 않은 함수")
    args = json.loads(call.arguments)
    if not isinstance(args, dict) or set(args) != {"order_id"}:
        raise ValueError("잘못된 인수 필드")
    order_id = args["order_id"]
    if not isinstance(order_id, str) or not order_id.strip():
        raise ValueError("잘못된 주문 번호")
    if order_id not in allowed_orders:
        return {"error": "not_authorized"}
    return deliveries.get(order_id, {"error": "not_found"})

def answer(create, model, history, question, allowed_orders, deliveries):
    items = list(history) + [{"role": "user", "content": question}]
    completed_calls = {}
    for _ in range(6):
        response = create(
            model=model,
            instructions=INSTRUCTIONS,
            tools=TOOLS,
            input=items,
            store=False,
            include=["reasoning.encrypted_content"],
        )
        if response.status != "completed":
            raise RuntimeError(f"응답 미완료: {response.id} / {response.status}")
        # message뿐 아니라 reasoning과 호출 item도 그대로 이어갑니다.
        items.extend(response.output)
        calls = [x for x in response.output if x.type == "function_call"]
        if not calls:
            messages = [x for x in response.output if x.type == "message"]
            if messages and all(getattr(x, "phase", None) == "commentary"
                                for x in messages):
                raise RuntimeError("중간 설명만 반환되어 최종 답변 확인 필요")
            if not response.output_text.strip():
                raise RuntimeError("호출도 최종 텍스트도 없는 응답")
            return response.output_text, items
        for call in calls:
            if not call.call_id:
                raise ValueError("call_id가 없는 호출")
            signature = (call.name, call.arguments)
            if call.call_id in completed_calls:
                saved_signature, output = completed_calls[call.call_id]
                if saved_signature != signature:
                    raise ValueError("같은 call_id의 내용이 달라졌습니다")
            else:
                result = dispatch(call, allowed_orders, deliveries)
                output = json.dumps(result, ensure_ascii=False)
                completed_calls[call.call_id] = (signature, output)
            items.append({
                "type": "function_call_output",
                "call_id": call.call_id,
                "output": output,
            })
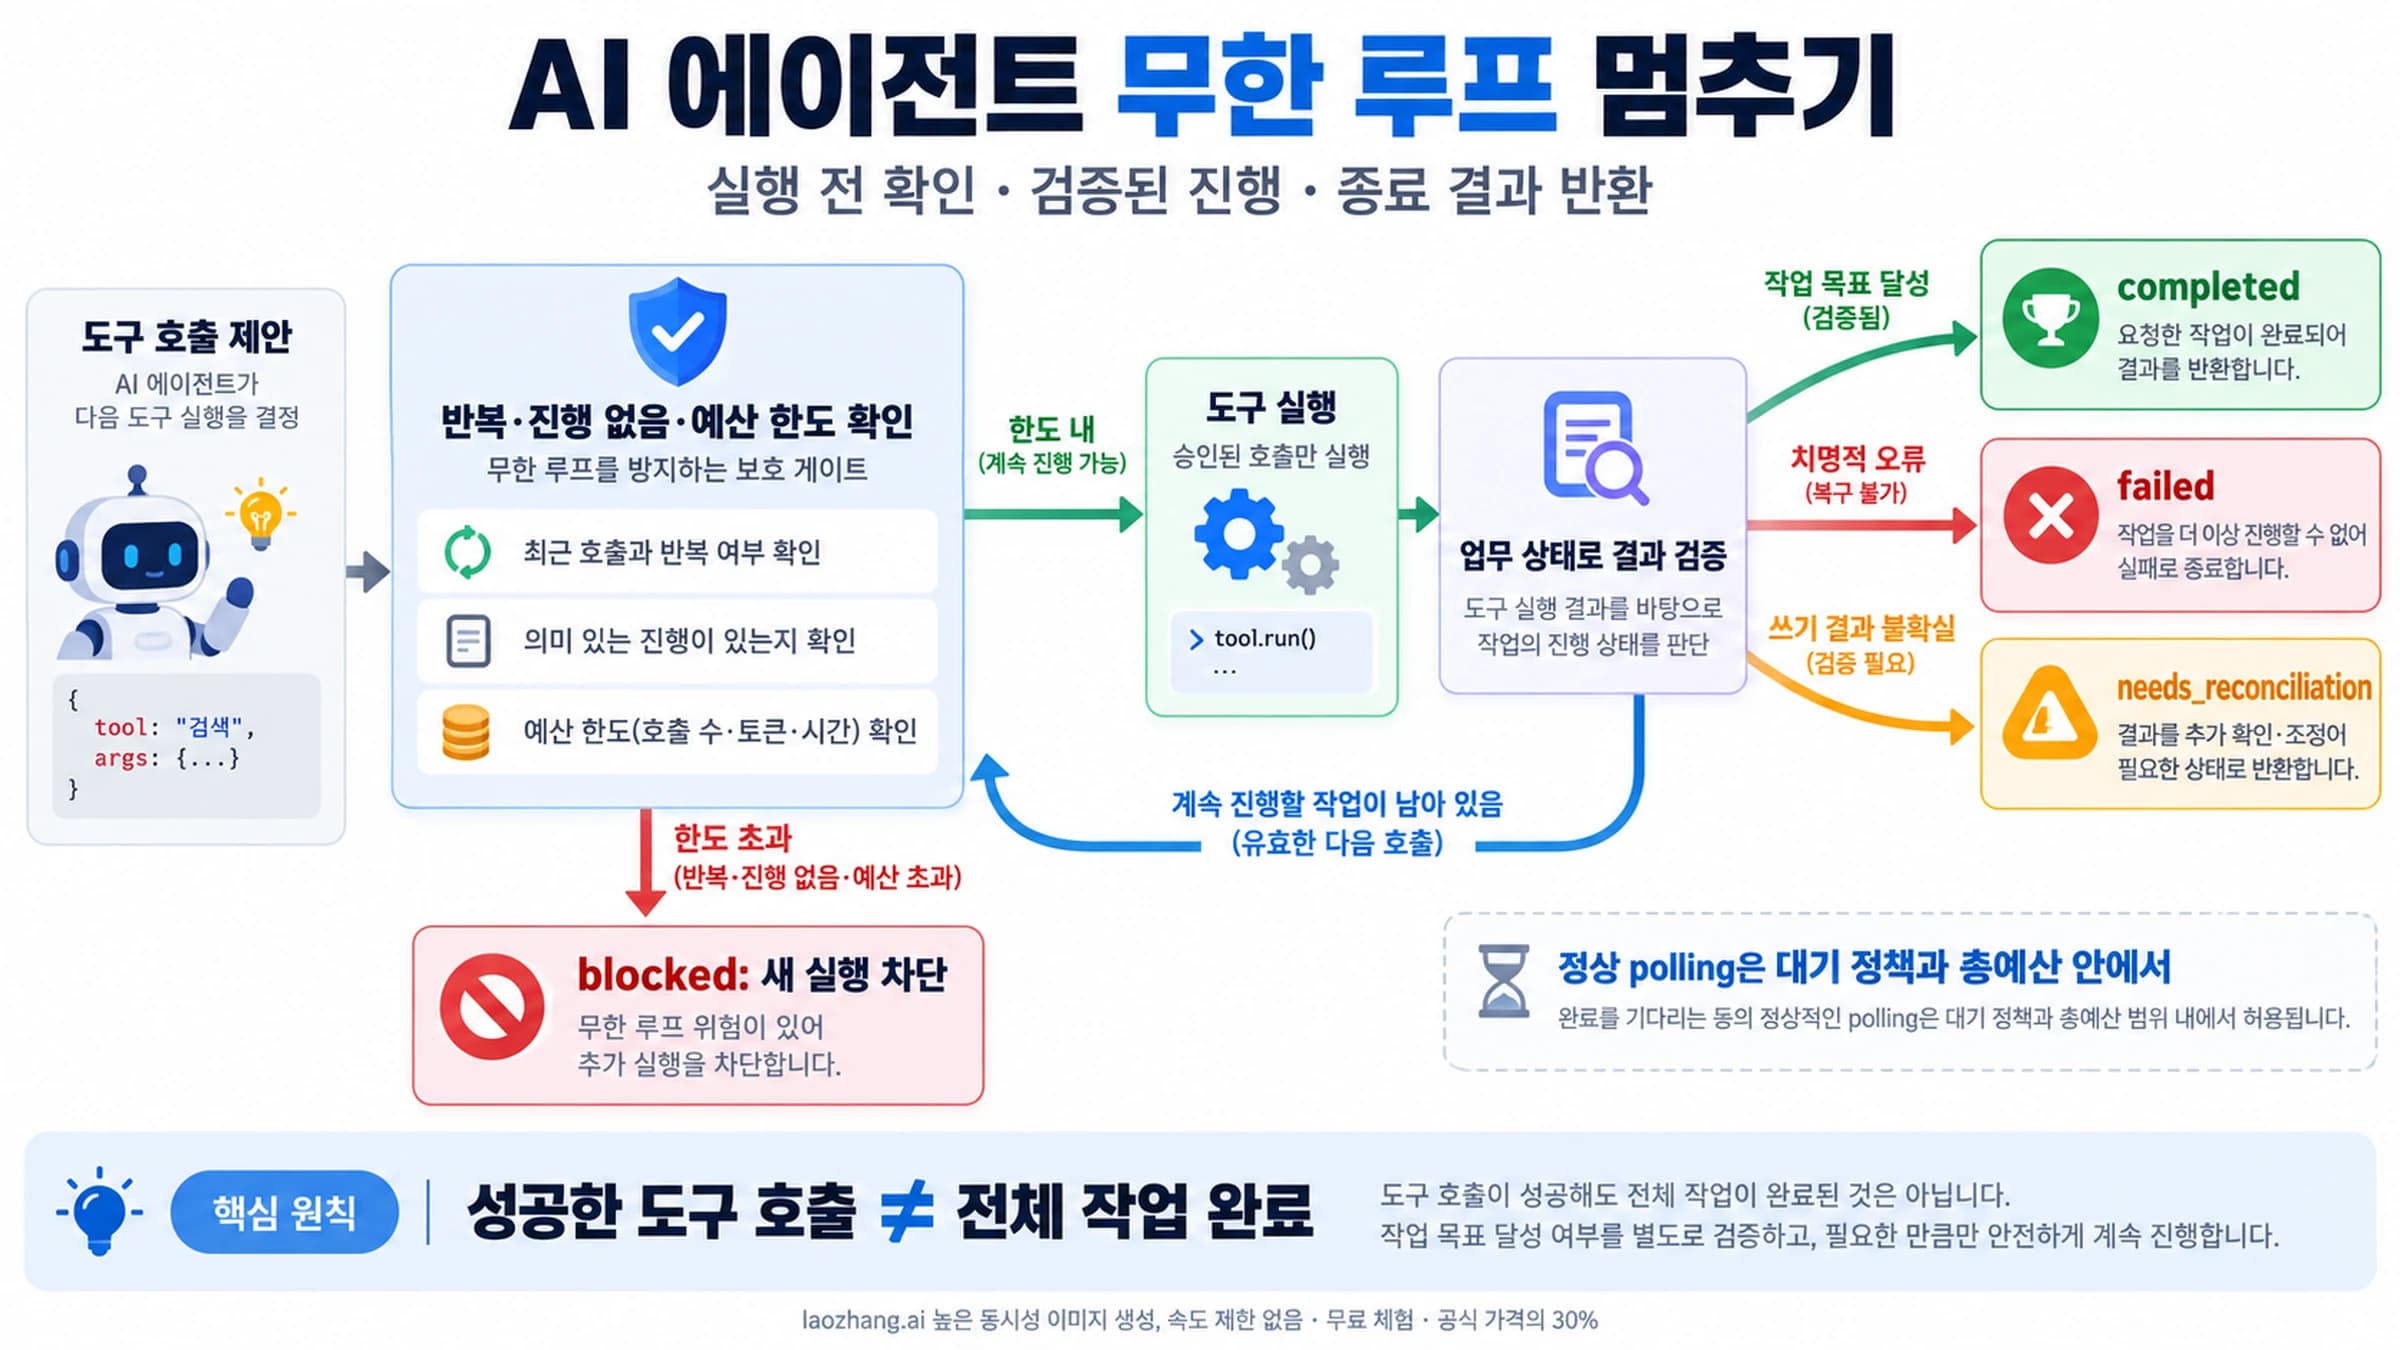
    raise RuntimeError("함수 호출 횟수 제한: 담당자 확인 필요")

if __name__ == "__main__":
    from openai import OpenAI

    client = OpenAI()  # 독자 환경의 OPENAI_API_KEY 사용
    model = os.environ["OPENAI_MODEL"]
    history = json.loads(
        Path("responses-history.json").read_text(encoding="utf-8")
    )
    # 예제의 사용자와 조회 데이터는 모두 합성 자료입니다.
    allowed_orders = {"K-207"}
    deliveries = {"K-207": {"status": "배송 중", "estimated_arrival": "내일"}}
    text, items = answer(
        client.responses.create, model, history,
        "그 주문은 언제 도착하나요?", allowed_orders, deliveries,
    )
    saved = [x.model_dump(mode="json") if hasattr(x, "model_dump") else x
             for x in items]
    Path("responses-history-next.json").write_text(
        json.dumps(saved, ensure_ascii=False, indent=2), encoding="utf-8"
    )
    print(text)
이 예제는 잘못된 함수 이름·JSON·인수나 미완료 응답에서 중단합니다. 권한이 없거나 주문이 없으면 그 결과를 도구 출력으로 돌려주어 모델이 확인 불가를 설명할 수 있게 합니다. 호출이 없는 응답은 최종 텍스트가 있을 때만 완료로 취급합니다. 합성 검증에서는 호출 없음, 여러 호출, 인수 오류, 권한 밖 주문, 미완료 응답과 횟수 제한을 확인했습니다. 이는 앱의 분기 처리 검증이며 SDK의 입력 수용이나 실제 모델 동작을 보장하지 않습니다.
실제 서비스에서는 한 세션의 요청을 직렬화하고, 전체 item을 권한이 분리된 저장소에 보관합니다. 저장된 item을 다음 입력으로 재생할 때도 assistant의 phase와 reasoning 콘텐츠를 포함한 필드를 보존해야 합니다. 네트워크 시간 제한과 재시도 정책도 별도로 둡니다.
strict와 call_id가 대신해 주지 않는 일
strict: true를 명시한 스키마는 모든 객체에 additionalProperties: false를 넣고, 각 속성을 required에 포함해야 합니다. 선택값은 필요하면 null을 허용하는 타입으로 표현합니다. 현재 strict 모드 문서에 따르면 strict를 생략하면 Responses가 스키마를 strict 모드로 정규화하려고 시도하지만, 호환되지 않으면 비엄격 방식으로 돌아갈 수 있습니다. 생략을 검증 보장으로 해석하지 않습니다.
스키마를 통과한 주문 번호도 다른 사용자의 주문일 수 있습니다. 권한은 인증된 사용자 정보와 업무 DB에서 확인합니다. parallel_tool_calls: false는 함수 호출을 0개 또는 1개로 제한하며, 반드시 한 번 실행하도록 강제하는 옵션은 아닙니다.
call_id는 모델 호출과 결과를 연결할 뿐 업무의 중복 실행을 막지 않습니다. 환불·취소 같은 변경 함수에는 앱이 만든 지속적인 작업 키가 필요합니다. 예를 들어 tenant + ticket + refund_request_id에 고유 제약을 두고 처리 결과를 기록한 뒤, 재시도 시 기존 결과를 반환합니다. 위 코드의 메모리 캐시는 같은 실행 안에서만 유지되므로 이러한 변경 작업의 중복 방지 장치로 사용할 수 없습니다.
File Search는 문서 준비와 인용까지 확인합니다
file_search는 OpenAI가 실행하는 도구입니다. 앱의 조회 함수처럼 직접 실행한 뒤 function_call_output을 보낼 필요가 없습니다. 기존 Assistant나 Thread에 붙어 있던 파일 관계만으로 새 요청의 검색 대상이 결정되지는 않습니다.
이전할 문서마다 현재 프로젝트에서 접근할 수 있는 파일과 vector store인지 확인하고, 필요한 파일 처리가 completed인지 확인합니다. 기존 자료를 사용할 수 없다면 허가된 원본을 새로 색인하는 절차가 필요합니다. 사용자별 문서를 함께 저장했다면 먼저 앱에서 대상 저장소 접근을 확인하고, 필요한 메타데이터 필터를 요청에 적용합니다. 필터만으로 앱의 접근 권한 검사를 대체하지 않습니다.
앞 예제의 client와 model을 사용하는 별도 검색 요청은 다음 형태입니다. verified_store_id는 독자의 앱이 확인한 실제 저장소 ID이며 그대로 실행할 수 있는 예시 값은 아닙니다.
search_response = client.responses.create(
    model=model,
    instructions="검색된 반품 정책을 근거로 답하고 출처를 표시하세요.",
    input="배송 지연으로 반품할 때 배송비는 누가 부담하나요?",
    tools=[{"type": "file_search", "vector_store_ids": [verified_store_id]}],
    include=["file_search_call.results"],
)
File Search 문서에 따르면 검색 결과는 기본 응답에 포함되지 않습니다. 위의 include로 결과를 요청하고, file_search_call 결과와 최종 메시지의 인용 annotation을 함께 확인합니다. “답변이 왔다”보다 올바른 정책 문서가 검색됐고 답변의 인용이 그 문서에 연결됐는가가 검증 기준입니다.
문서가 없는 질문, 폐기된 정책, 다른 고객사의 문서에 대한 질문도 넣습니다. 빈 검색 결과에서 규정을 지어내거나 권한 밖 문서를 인용하면 트래픽 전환을 멈추고 검색 대상·필터·지침을 수정합니다.
Run 상태 처리와 스트리밍 화면도 바꿔야 합니다
일반 채팅은 동기 요청이나 스트리밍으로 시작합니다. 오래 걸리는 작업에만 background: true를 검토합니다. 기존 Run에서 polling을 썼다는 이유만으로 모든 요청을 background로 바꾸지는 않습니다.
텍스트 스트림은 response.created, response.output_text.delta, response.completed, error처럼 이벤트의 type을 구분합니다. 함수 인수는 response.function_call_arguments.delta와 done 이벤트로 전달됩니다. 현재 이전 문서의 설명처럼 기존 이벤트 소비 코드를 교체해야 합니다. 인수의 일부 조각을 받자마자 실행하지 말고, 완성된 호출을 위 검증 함수에 넘깁니다. UI에 텍스트를 표시한 것과 업무 처리가 완료된 것은 별개 상태로 기록합니다.
background 작업은 응답 ID를 앱의 작업 ID에 연결하고 queued나 in_progress인 동안 조회합니다. 그 상태를 벗어났다고 바로 성공 표시를 하지 않고, completed인지와 결과를 확인합니다. 진행 중 취소는 responses.cancel로 요청하며, 취소 결과도 작업 기록에 남깁니다. 동기 요청은 연결 종료 방식으로 취소합니다. 이 동작은 background 문서에 설명되어 있습니다.
background 스트림을 재연결하려면 처음 생성할 때 stream: true도 넣어야 합니다. 마지막 sequence_number를 저장하고 재연결 시 starting_after로 이어갑니다. 이미 화면에 적용한 이벤트는 다시 적용하지 않습니다. 모델 생성을 취소해도 앱이 이미 완료한 환불이나 외부 변경은 취소되지 않으므로, 업무 취소는 별도 절차가 필요합니다.
기존 JSON 출력 계약은 response_format을 그대로 보내는 대신 Responses의 text.format으로 옮깁니다. json_schema를 쓰는 경우 이름, schema, strict를 그 안에 둡니다. 공식 출력 형식 이전 설명을 기준으로 파서도 바꿉니다. 모든 출력 item을 메시지라고 가정하는 파서는 함수·reasoning·검색 결과를 따로 처리하도록 수정합니다.
저장과 비용은 상태 선택과 함께 결정합니다
위 함수 루프의 store=False는 Response 객체 저장을 끄기 위한 설정입니다. 공급자와 앱의 모든 데이터 보관을 없애는 뜻은 아닙니다.
| 저장 대상 | 현재 문서의 기본 동작 | 이전 시 확인할 것 |
|---|---|---|
| Response 객체 | 기본 30일 보관, 일반적으로 store=true일 때 최소 30일 | 조회 의존 여부와 store 설정 |
| Conversation과 그 item | 30일 TTL이 적용되지 않으며 삭제할 때까지 보관 | 삭제 흐름과 사용자별 접근, ZDR 대상이 아니라는 점 |
| 기본 abuse monitoring 로그 | 고객 콘텐츠를 포함할 수 있으며 최대 30일, 예외 있음 | 승인된 ZDR/MAM 조건과 실제 조직 설정 |
| 파일·vector store·앱 보관본 | 각 저장소의 수명과 삭제 정책에 따름 | 대화 삭제가 연관 자료까지 어떻게 처리하는지 |
이 구분은 대화 상태 문서와 데이터 제어 문서를 기준으로 합니다. store=false인 요청을 Conversation에 붙여 놓고 공급자에게 기록이 남지 않는다고 설명하면 안 됩니다.
background의 임시 저장도 별도로 봐야 합니다. 2026년 10월 6일 확인한 현재 안내는 ZDR 프로젝트의 background 요청이 store=false로 실행되지만 polling을 위해 응답을 디스크에 약 10분간 임시 저장한다고 설명합니다. MAM 프로젝트는 foreground에서 store 생략 또는 true일 때 표준 보관을 따르며, background는 명시적으로 store=true인 경우에만 임시 polling 기간 이후 표준 보관을 적용합니다. background에서 생략하거나 false이면 약 10분 후 삭제됩니다. 임시 저장까지 금지하는 서비스 정책이라면 이 방식을 선택할 수 없습니다. 이 문서 설명만으로 특정 조직의 계약 적합성을 판단하지 않습니다.
비용도 상태를 서버에 맡긴다고 사라지지 않습니다. previous_response_id로 이어간 체인의 이전 입력 토큰도 입력으로 과금됩니다. 긴 대화는 필요한 기록의 범위와 요약 정책을 정하고, 요약 후에도 주문 번호·승인 여부·미완료 작업 같은 핵심 정보가 유지되는지 확인합니다. 비용 비교에는 모델뿐 아니라 도구와 저장소 사용도 포함합니다. 이 글에서 실제 청구액이나 지연 시간의 개선을 측정하지는 않았습니다.
트래픽 전환과 복구 대상은 모두 동작하는 새 경로여야 합니다
Assistants가 종료된 지금은 old/new API를 동시에 호출하는 비교를 할 수 없습니다. 대신 보관된 요청과 당시의 확인 가능한 업무 결과, 또는 이미 운영 중인 Responses 버전을 기준으로 비교합니다. 환불 같은 변경 함수는 비교 실행에서 한쪽만 실제 실행하게 하고, 나머지는 저장된 결과를 재생합니다.
배송 문의라면 다음과 같은 사례로 전환을 판단할 수 있습니다.
| 사례 | 확인할 결과 | 실패하면 먼저 고칠 곳 |
|---|---|---|
| 과거 대화 뒤 “그 주문”으로 질문 | 같은 주문을 조회하고 최신 상태로 답변 | 보관 기록 순서와 상태 연결 |
| 한 응답에 여러 조회 함수 | 각각 원래 call_id로 결과 반환 후 최종 답변 | 함수 결과 연결과 루프 |
| 다른 사용자의 주문 번호 | 권한 오류 반환, 배송 정보 미노출 | 인증 정보와 조회 권한 |
| 정책 문서 질문과 근거 없는 질문 | 정확한 인용 또는 확인 불가 | 파일 준비와 검색 대상 |
| 연결 끊김·작업 실패·취소 | 완료와 실패를 구분하고 중복 변경 방지 | 작업 저장, 이벤트 처리와 작업 키 |
| 길어진 대화·반복 도구 호출 | 정한 비용·시간·호출 한도에서 종료 | 기록 관리와 횟수 제한 |
확인이 끝나면 내부 사용자, 조회만 하는 신규 세션, 작은 트래픽 구간 순서로 넓힙니다. 이어가야 하는 기존 대화의 기록 변환은 세션별로 처리하고, 정상인 신규 요청까지 대량 이전에 묶어 기다리게 하지 않습니다. 비교 결과와 앱의 작업 ID, 설정 버전, Response ID, 도구 결과를 연결해 장애 원인을 추적할 수 있게 합니다. HTTP 성공이나 자연스러운 답변만으로 전환을 승인하지 않습니다.
복구 버튼이 가리킬 곳도 미리 만들어 둡니다. 새 설정 버전이 문제라면 검증된 Responses 모델·지침·도구 조합으로 되돌립니다. 그 경로도 사용할 수 없으면 조회 전용 응답, 작업 대기열, 담당자 처리로 낮춥니다. 복구 과정에서 진행 중 작업의 상태와 이미 끝난 변경을 확인하고, 전체 사용자 입력을 무조건 재전송하지 않습니다. “Assistants로 돌아가기”는 현재 복구 수단이 아닙니다.
API 호스트나 공급자도 함께 바꾸는 작업이라면 OpenAI API의 base_url 적용 순서와 경로 확인 방법을 별도로 확인하세요. 여기서 다룬 OpenAI의 상태·도구 계약이 다른 공급자에서도 동일하게 제공된다고 가정하지 않습니다.
자주 묻는 질문
Thread ID만 있으면 대화를 가져올 수 있나요?
현재 Assistants API의 Thread 메시지 조회는 사용할 수 없습니다. 공식 이전 안내는 앱이 저장한 메시지를 사용하도록 명시합니다. ID만 있고 내용이 없다면 이 절차로 복원할 수 없습니다. 자체 백업·업무 기록에서 확인하거나 새 대화로 시작해야 합니다.
Assistant를 Prompt로 바꾸면 이전이 끝나나요?
아닙니다. 설정 외에도 대화 기록, 도구 결과, 검색과 실행 상태를 옮겨야 합니다. Prompt objects도 2026년 11월 30일 종료 예정이므로 장기 운영은 지침과 도구 설정을 코드에서 관리하는 편이 현재 공식 이전 방향에 맞습니다.
함수 호출을 받았는데 배송 조회가 실행되지 않는 이유는 무엇인가요?
사용자 정의 함수는 앱이 실행해야 합니다. function_call에서 이름과 인수를 검증한 뒤 조회하고, 같은 call_id의 function_call_output을 다음 요청에 넣습니다. 이후 추가 호출이나 최종 답변까지 이어가야 합니다. OpenAI가 실행하는 file_search와 실행 주체가 다릅니다. 함수 호출 절차에서 두 책임을 확인할 수 있습니다.
store=false와 background를 같이 쓰면 기록이 전혀 남지 않나요?
그렇지 않습니다. 현재 background 안내는 polling을 위해 응답을 디스크에 약 10분간 임시 저장한다고 설명합니다. 기본 abuse monitoring, Conversation, 파일과 앱 자체 저장도 각각의 정책을 따릅니다. 실제 조직의 데이터 제어와 사용하는 기능을 함께 확인해야 합니다.
이전 후 문제가 생기면 무엇으로 되돌려야 하나요?
검증해 둔 Responses 버전이나 조회 전용·대기열·담당자 처리 경로로 되돌립니다. 이미 수행한 업무 변경은 작업 키와 DB 결과로 대조한 뒤 처리합니다. 이미 종료된 Assistants는 복구 대상이 될 수 없습니다.
참고 자료11
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 7일.
참고 자료11
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 7일.
- 1.현재 공식 이전 문서developers.openai.com/api/docs/assistants/migration
- 2.Prompt 이전 안내developers.openai.com/api/docs/guides/prompting/migrate-from-prompt-object
- 3.요청 명세developers.openai.com/api/reference/resources/responses/methods/create
- 4.reasoning 문서developers.openai.com/api/docs/guides/reasoning
- 5.공식 함수 호출 안내developers.openai.com/api/docs/guides/function-calling
- 6.File Search 문서developers.openai.com/api/docs/guides/tools-file-search
- 7.현재 이전 문서developers.openai.com/api/docs/guides/migrate-to-responses
- 8.background 문서developers.openai.com/api/docs/guides/background
- 9.대화 상태 문서developers.openai.com/api/docs/guides/conversation-state
- 10.데이터 제어 문서developers.openai.com/api/docs/guides/your-data
- 11.2026년 11월 30일 종료 예정developers.openai.com/api/docs/deprecations