Muse Wonder API: cómo usarla y precio de cada petición
Por API solo está muse-wonder-1.0, no Full: 4 $ y 20 $ por millón en api.meta.ai u OpenRouter. Una respuesta corta, 0,038 $; un turno de agente, 0,36 $.
En esta página
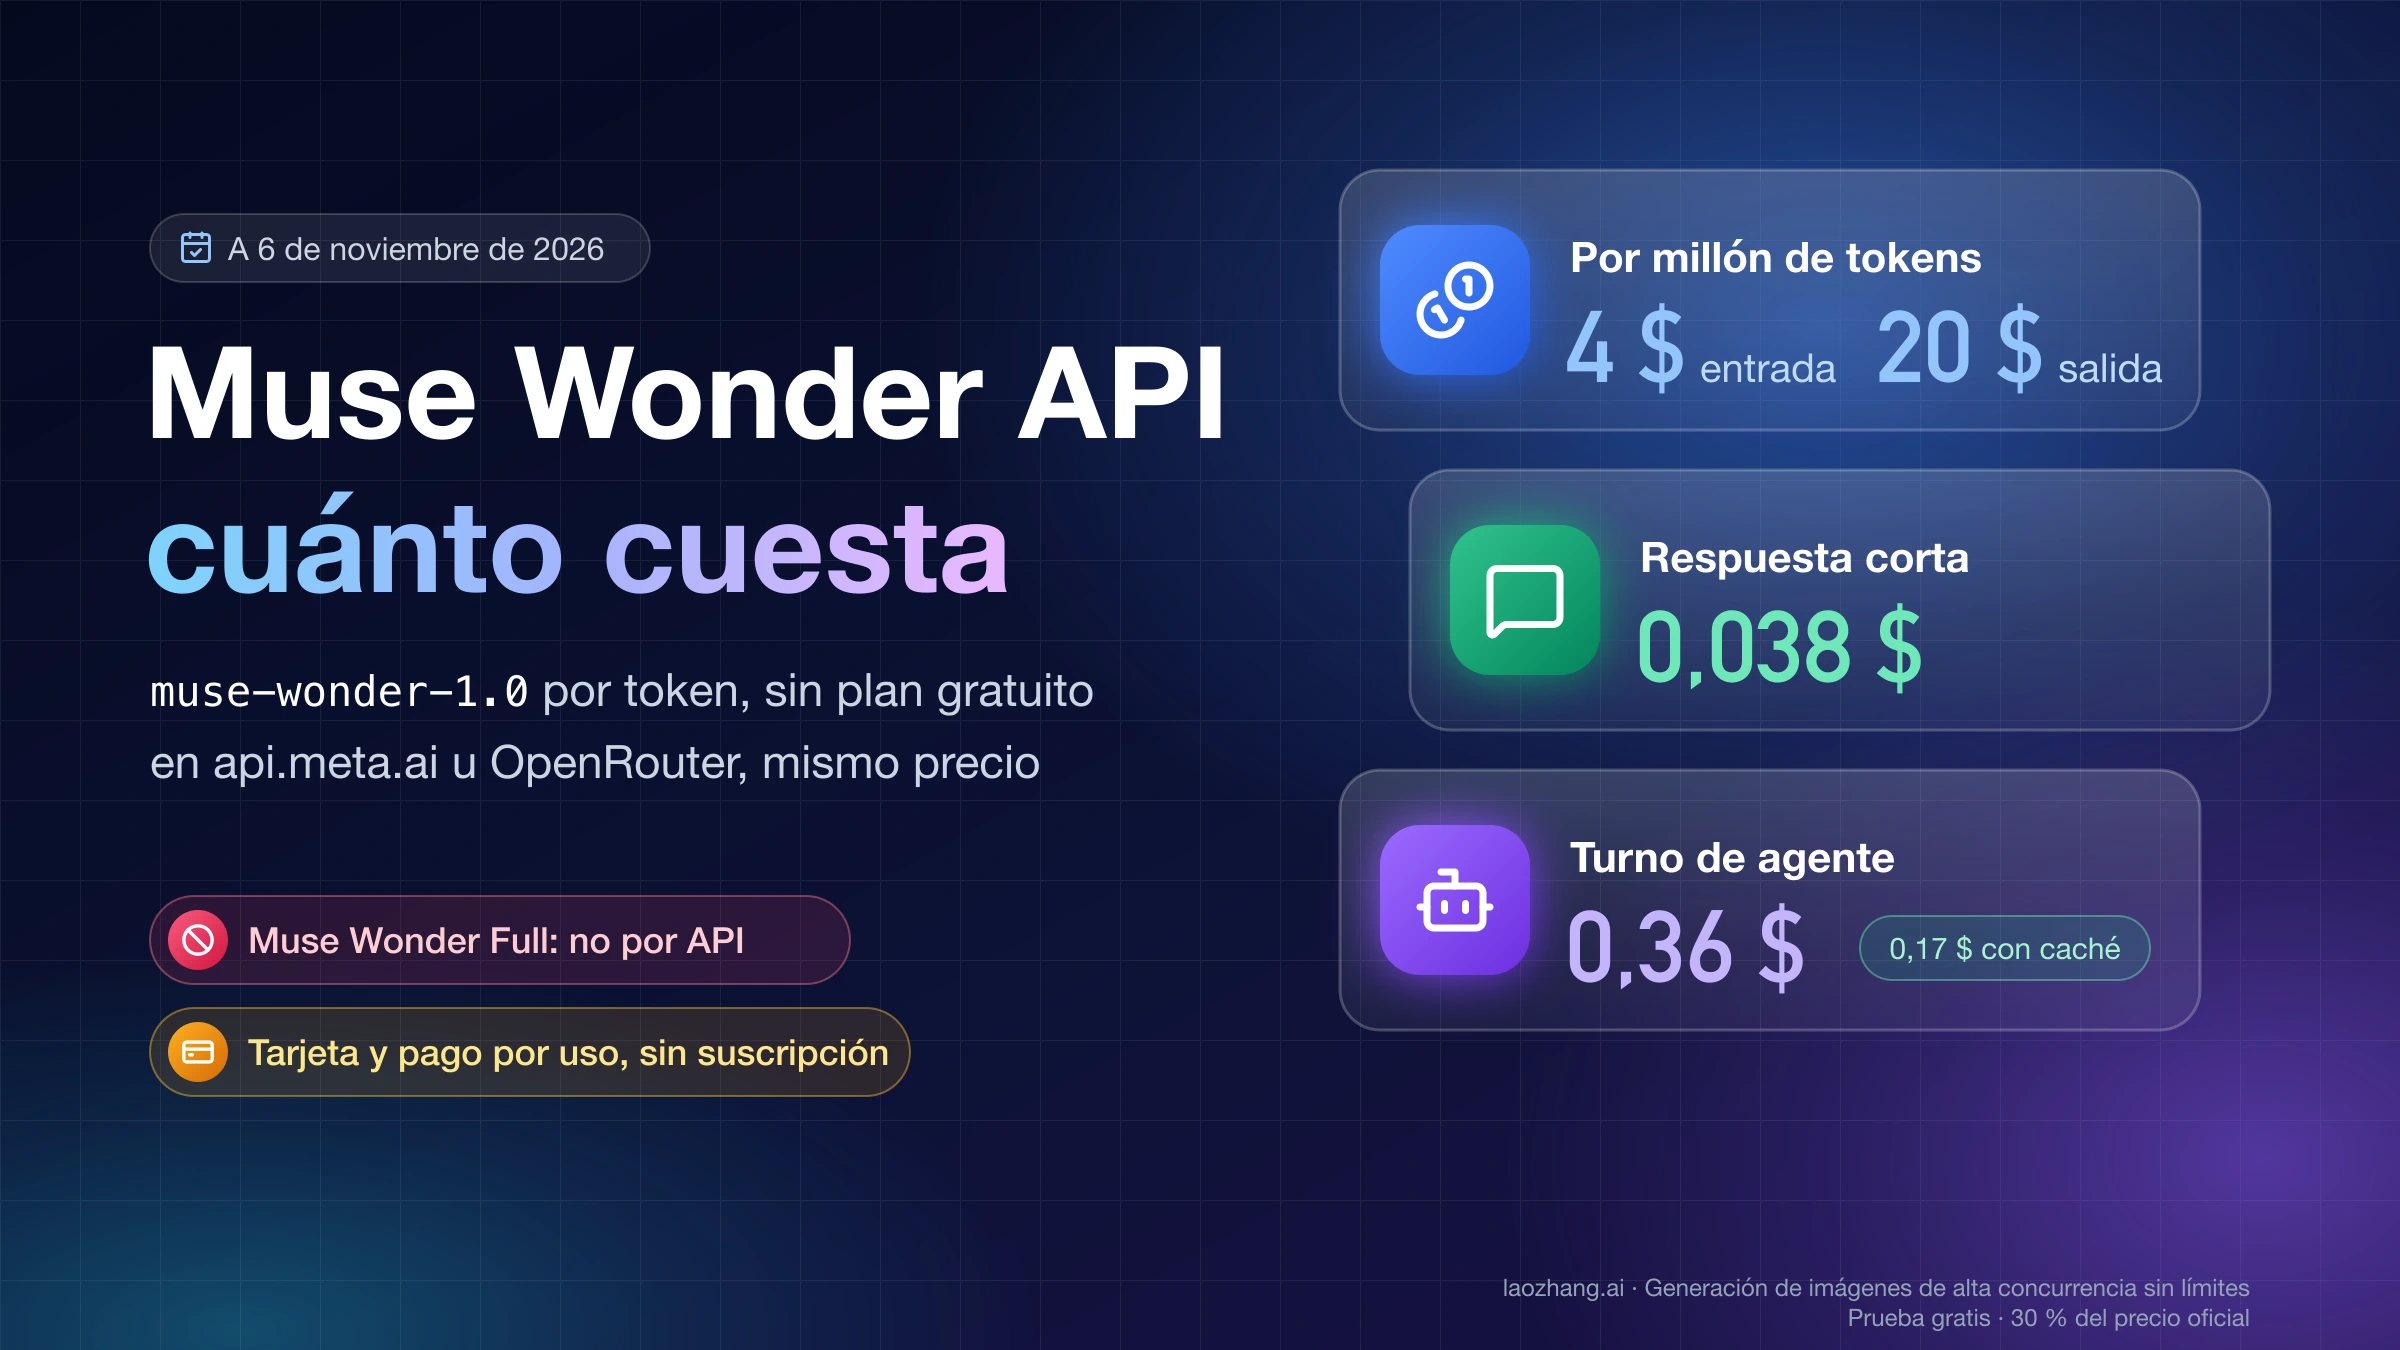
A 6 de noviembre de 2026, la API de Muse Wonder es un solo modelo, muse-wonder-1.0, que Meta sirve en la Meta Model API (https://api.meta.ai/v1) con una clave de API en la cabecera Authorization: Bearer. Cuesta 4 $ por millón de tokens de entrada, 0,20 $ por millón de entrada en caché y 20 $ por millón de salida. No hay plan gratuito ni suscripción de API: añades una tarjeta y Meta cobra lo que consumes. Muse Wonder Full, la variante que Meta reserva para su agente Muse Code, no se puede llamar por API, y poner el razonamiento en max no la activa.
Para empezar, crea una clave en el panel de Model API y envía tu primera petición a POST /v1/responses con el modelo muse-wonder-1.0 y el razonamiento en high, el nivel que Meta recomienda como punto de partida para agentes. Si ya trabajas con OpenRouter, el mismo modelo está allí como meta/muse-wonder, con Meta como único proveedor y los mismos precios por token; lo que cambia es una comisión del 5,5 % al recargar crédito. Con estas tarifas, una respuesta corta sale por unos 0,038 $, y un turno de agente con 60.000 tokens de contexto, por 0,36 $, o 0,17 $ si 50.000 de esos tokens entran en caché.
La excepción es el país. Cuba, Venezuela, Nicaragua y Haití están en la lista de territorios restringidos de Meta, que prohíbe acceder a la API desde ellos y eludir ese control por cualquier medio técnico.
Qué ofrece la API: muse-wonder-1.0, sin Muse Wonder Full
muse-wonder-1.0 acepta texto, imagen, vídeo, audio y PDF, devuelve solo texto y tiene una ventana de contexto de 1.048.576 tokens. Meta lo lanzó el 12 de octubre de 2026 y lo mantiene en vista previa (preview), así que su comportamiento y sus límites pueden cambiar. En la API funciona solo en modo Standard, en el que tu contenido no se usa para entrenar los modelos de Meta; el Contributor mode, la modalidad en la que sí se usa, no existe para Wonder en la API. Todo lo anterior sale de la página de modelos de la Meta Model API.
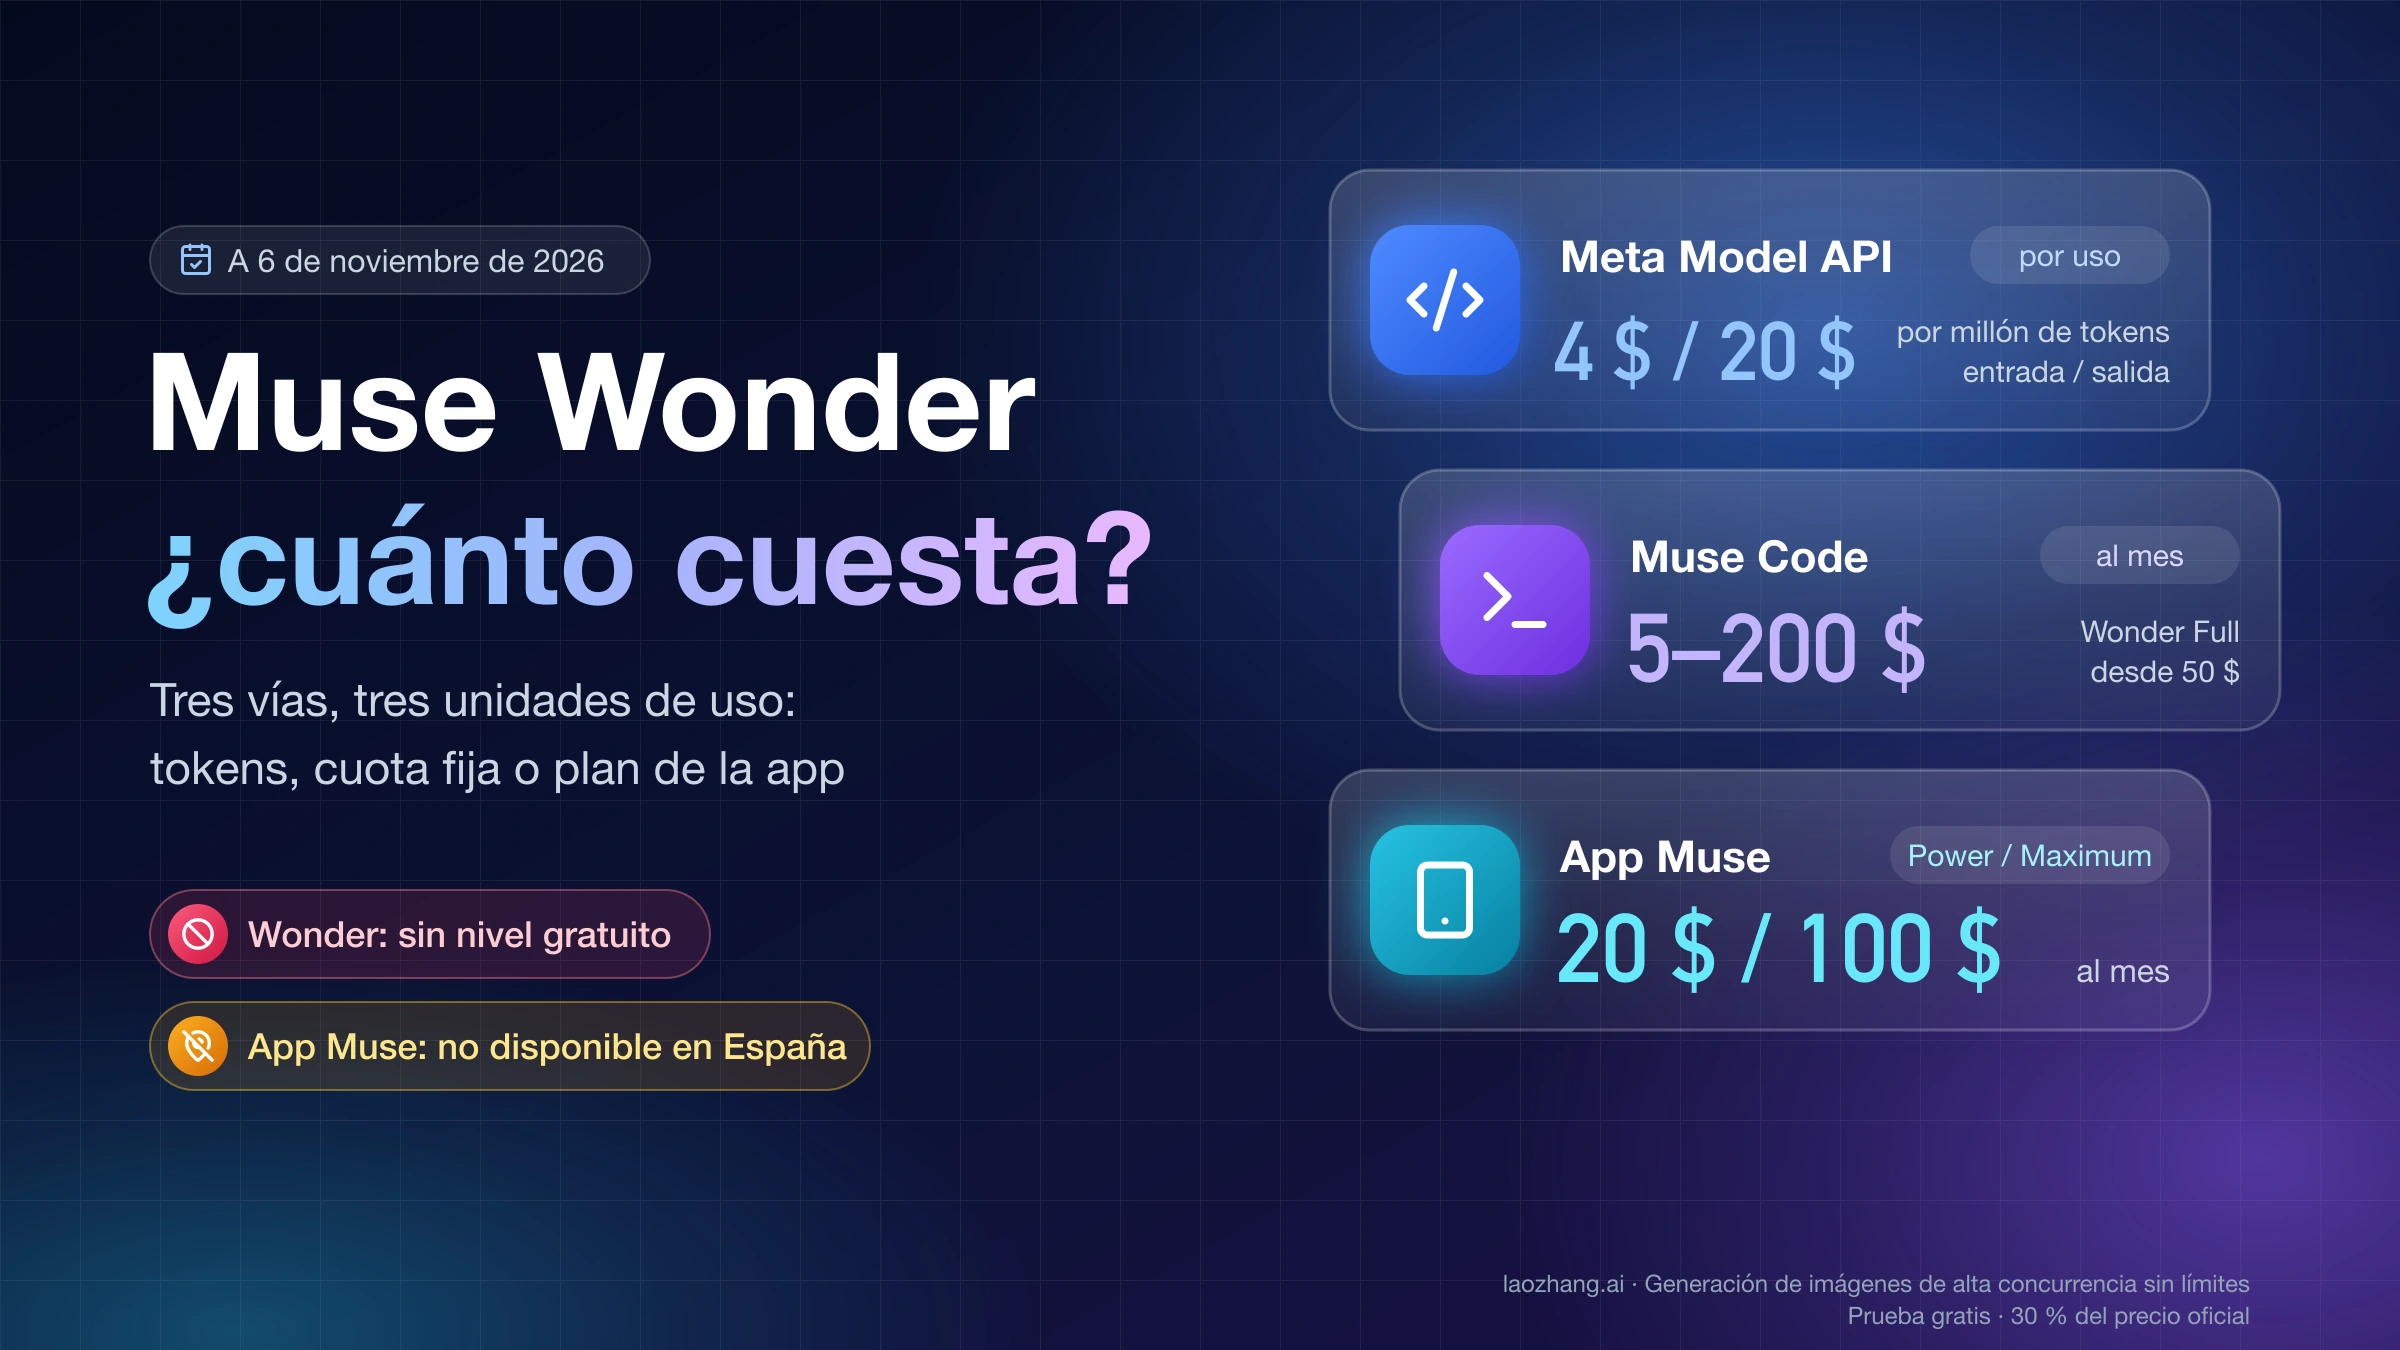
Muse Wonder Full no está disponible en la Model API ni aparece en OpenRouter. Solo existe dentro de Muse Code, el agente de terminal de Meta, y únicamente en los planes Power Usage (50 $ al mes) y Maximum Usage (200 $ al mes). Esa suscripción no es un plan de API: su credencial solo funciona en la CLI de Muse Code, y cualquier clave de API que crees aparte se factura por uso. La comparación de precios entre la app, Muse Code y la API está en Muse Wonder precio: API, Muse Code o app Muse desde España.
Muse Spark sí tiene API, en el mismo endpoint y con el mismo formato de petición: cambias el ID por muse-spark-1.3 y pagas 1,25 $ por millón de tokens de entrada, 0,15 $ en caché y 4,25 $ de salida. Meta recomienda Wonder para tareas largas y complejas, donde la capacidad pesa más que el coste, y Spark para trabajo de alto volumen, sensible a la latencia o al precio, y para subagentes. Pasar una carga de uno a otro es solo cambiar el ID del modelo.
Wonder no genera vídeo, y Meta tampoco vende una API de vídeo; las alternativas están en Muse Video API: cómo generar vídeos de hasta 60 s sin API de Meta. La app de consumo Muse es otro producto, con su propia disponibilidad; la tienes comparada en ChatGPT Dots vs Meta Muse vs Grok Bot vs Claude Duet desde España.
Clave de API y primera petición a muse-wonder-1.0
Para llamar a Muse Wonder directamente necesitas una cuenta de Model API con la facturación configurada, una clave y curl, Python 3.9 o posterior, o Node.js 18 o posterior. El orden importa: si la cuenta no tiene facturación, la API responde con un 402 billing_not_configured aunque la clave sea correcta.
- Entra en el panel de Model API en dev.meta.ai y, como administrador del equipo, añade una tarjeta y los datos de facturación: razón social y dirección de la empresa o, si no eres empresa, tu nombre legal y tu dirección postal.
- En API keys, pulsa Create API key. La clave tiene el formato
LLM_{id}_{secreto}y solo se muestra una vez, así que cópiala en ese momento. Las claves de un mismo equipo comparten los límites de uso. - Guárdala como variable de entorno, por ejemplo con
export MODEL_API_KEY="LLM_..."en macOS o Linux, para que no quede escrita en el código. - Envía la primera petición a la Responses API:
curl -X POST "https://api.meta.ai/v1/responses" \
  -H "Authorization: Bearer $MODEL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "muse-wonder-1.0",
    "reasoning": {"effort": "high"},
    "input": "Resume en tres puntos qué cambia entre HTTP/2 y HTTP/3."
  }'
Con el SDK de OpenAI para Python, la misma petición queda así. Ni este SDK ni el de Anthropic leen MODEL_API_KEY por su cuenta, de modo que tienes que pasarla al crear el cliente:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.responses.create(
    model="muse-wonder-1.0",
    reasoning={"effort": "high"},
    input="Resume en tres puntos qué cambia entre HTTP/2 y HTTP/3.",
)

print(response.model_dump_json(indent=2))
En el bloque usage de la respuesta, los tokens de razonamiento aparecen en output_tokens_details.reasoning_tokens y se cobran como salida, mientras que la entrada servida desde caché aparece en input_tokens_details.cached_tokens. El contexto que Meta inyecta por su cuenta (instrucciones internas del sistema) no se cobra ni figura en usage.
Antes de tener clave puedes comprobar que llegas al servicio. El 6 de noviembre de 2026, a las 00:37 UTC, una petición GET https://api.meta.ai/v1/status sin ninguna clave devolvió HTTP 200 con "service_status":"operational", aunque la lista de estado por modelo, model_statuses, venía vacía; por eso confirma que la API responde, no que Muse Wonder en concreto esté disponible. En la misma prueba, hecha con curl desde un solo equipo, /v1/models, /v1/responses y /v1/chat/completions devolvieron 401 sin clave. No se envió ninguna petición de generación con una clave válida, así que los dos ejemplos de arriba siguen la guía de inicio rápido de la Meta Model API y su guía de razonamiento, no una respuesta capturada.
¿Responses, Chat Completions o Messages? Responses salvo que migres
Los tres formatos llegan a los mismos modelos, con la misma clave y el mismo precio por token; lo que cambia son las funciones disponibles. Para código nuevo, Meta recomienda Responses porque es el único que lo tiene todo: razonamiento que se conserva entre turnos, búsqueda web, ejecución en segundo plano y archivos de entrada. Chat Completions sirve para no tocar código que ya llama a /v1/chat/completions, y Messages, para herramientas con formato Anthropic como Claude Code.
| Formato | Ruta | Para qué | Razonamiento entre turnos | Búsqueda web |
|---|---|---|---|---|
| Responses | POST /v1/responses | Código nuevo, agentes y bucles con herramientas | Sí, con elementos cifrados o previous_response_id | Sí |
| Chat Completions | POST /v1/chat/completions | Código OpenAI que ya usa messages | No, con claves externas | No |
| Messages | POST /v1/messages | SDK de Anthropic y Claude Code | Sí, reenviando thinking desde tu cliente | Sí |
El nivel de razonamiento se escribe distinto en cada formato: en Chat Completions va como reasoning_effort en la raíz de la petición, y en Responses, anidado en reasoning.effort. Messages tiene dos trampas. La URL base es el host sin /v1 (https://api.meta.ai), porque el SDK de Anthropic añade /v1/messages por su cuenta. Y el adaptador acepta thinking.budget_tokens pero no lo traduce a nivel de razonamiento, así que para fijarlo hay que usar output_config.effort. Los detalles de cada uno están en la guía de formatos de la Meta Model API.
Qué nivel de razonamiento elegir: high por defecto, max para lo difícil
Empieza en high. La guía de Meta para agentes de programación lo describe como un buen valor por defecto (strong default) y deja xhigh y max para cuando hace falta razonar más. El nivel de razonamiento (reasoning_effort) admite minimal, low, medium, high, xhigh y max. El valor none devuelve HTTP 400 en Muse Wonder, y si omites el parámetro el modelo razona a un nivel que decide él, sin que Meta publique cuál.
Subir de high a max se nota más en la factura y en la espera que en el resultado. En el Intelligence Index v5.0.1 de Artificial Analysis, a 6 de noviembre de 2026, Muse Wonder en max obtiene 44 puntos, cuesta 6,95 $ por tarea del índice y tarda 21,19 s hasta el primer token de respuesta; en high obtiene 41, cuesta 4,56 $ y tarda 9,83 s. Es decir, high cuesta un 34,4 % menos por tarea y empieza a responder 2,16 veces antes, a cambio de 3 puntos. Artificial Analysis no publica cifras de Wonder por debajo de high, así que para low o medium no hay comparación independiente.
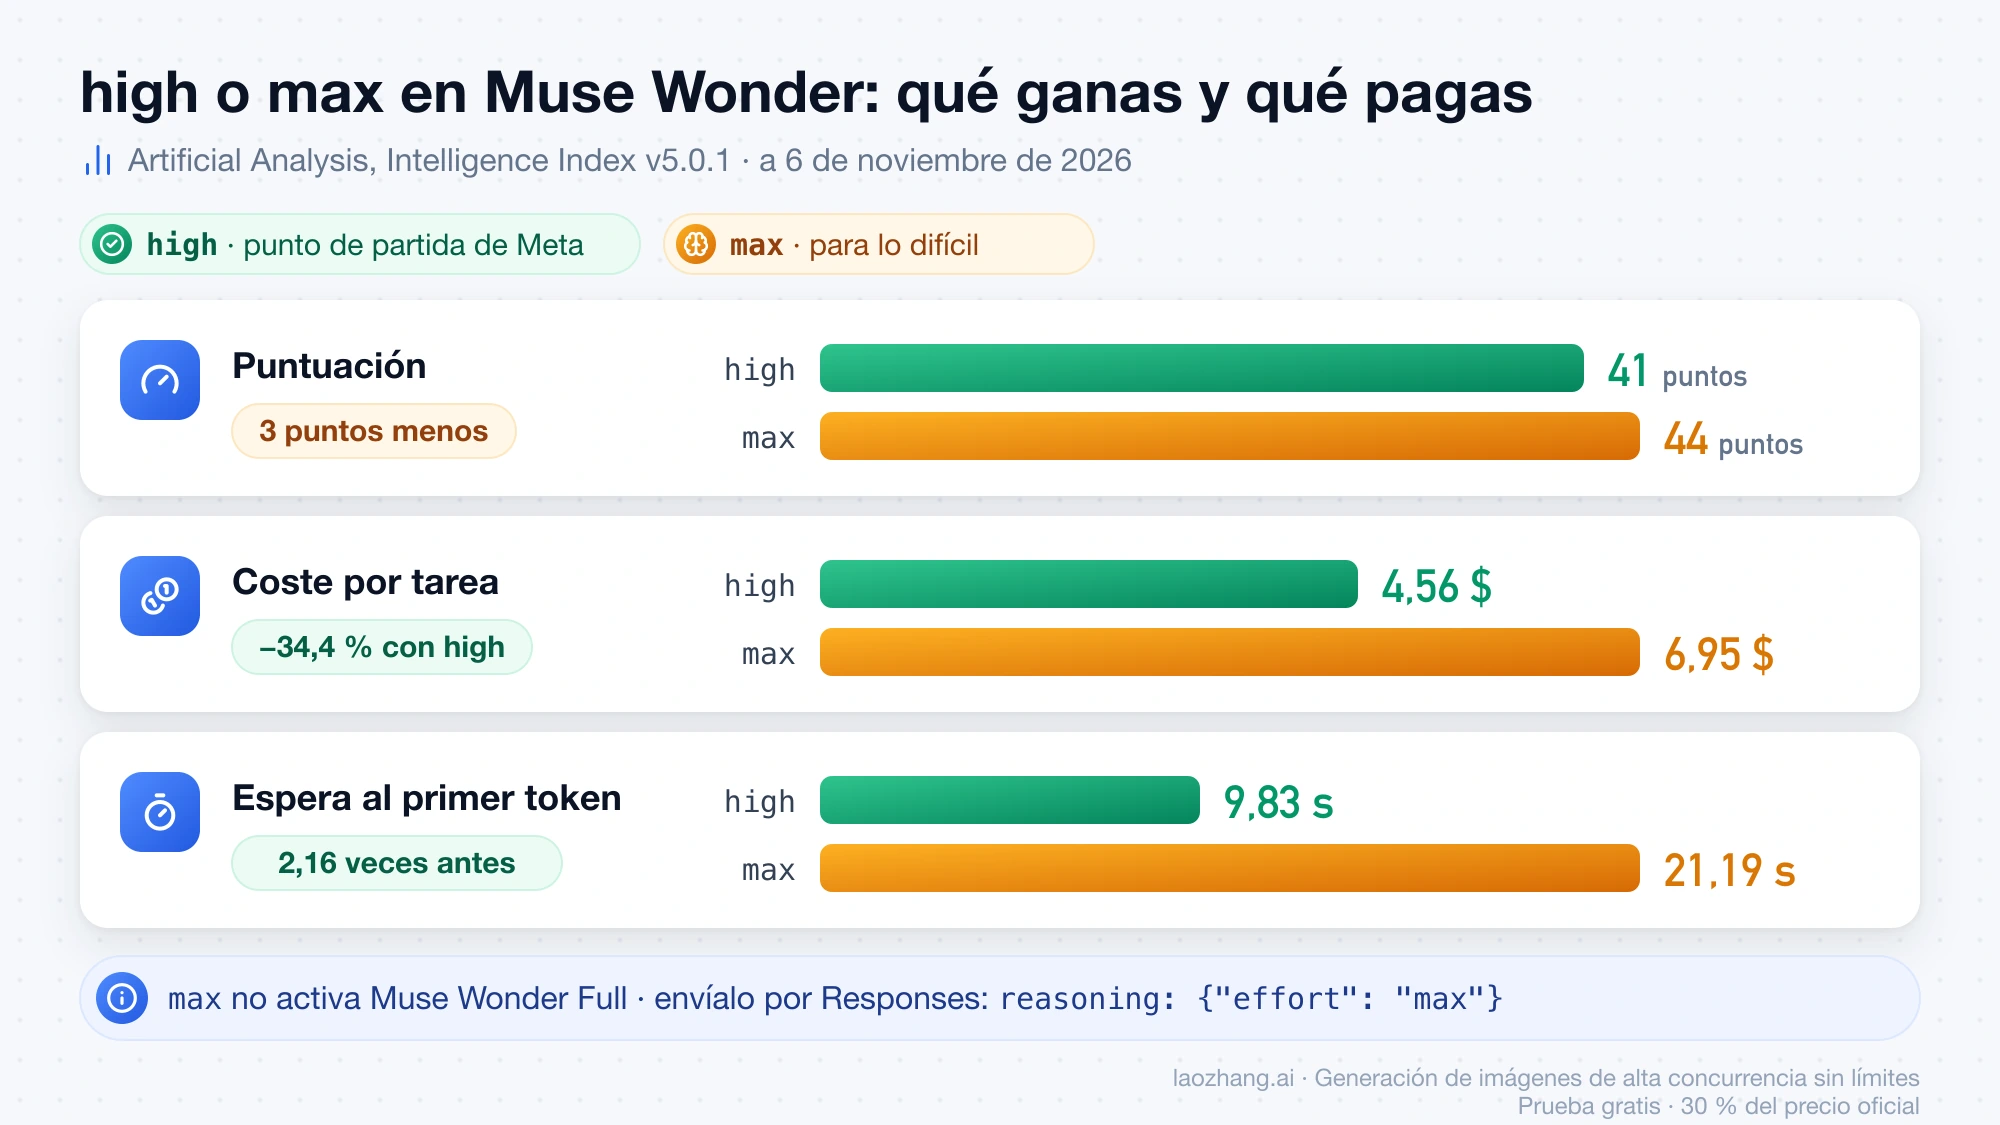
La diferencia de coste viene de que los tokens de razonamiento se facturan como salida y cuentan dentro del límite de salida. Reserva max para problemas en los que acertar importa más que la rapidez, como rastrear un fallo de concurrencia o planificar una migración grande, que son los dos ejemplos que pone Meta. Y envíalo por Responses: todos los ejemplos de max en la guía de razonamiento de Meta usan reasoning: {"effort": "max"} en esa API, mientras que la referencia de Chat Completions solo enumera valores hasta xhigh. Si lo que buscas es abaratar subtareas sencillas, suele compensar más enviarlas a muse-spark-1.3 que bajar el nivel de Wonder.
Cuánto cuesta una petición a la API de Muse Wonder
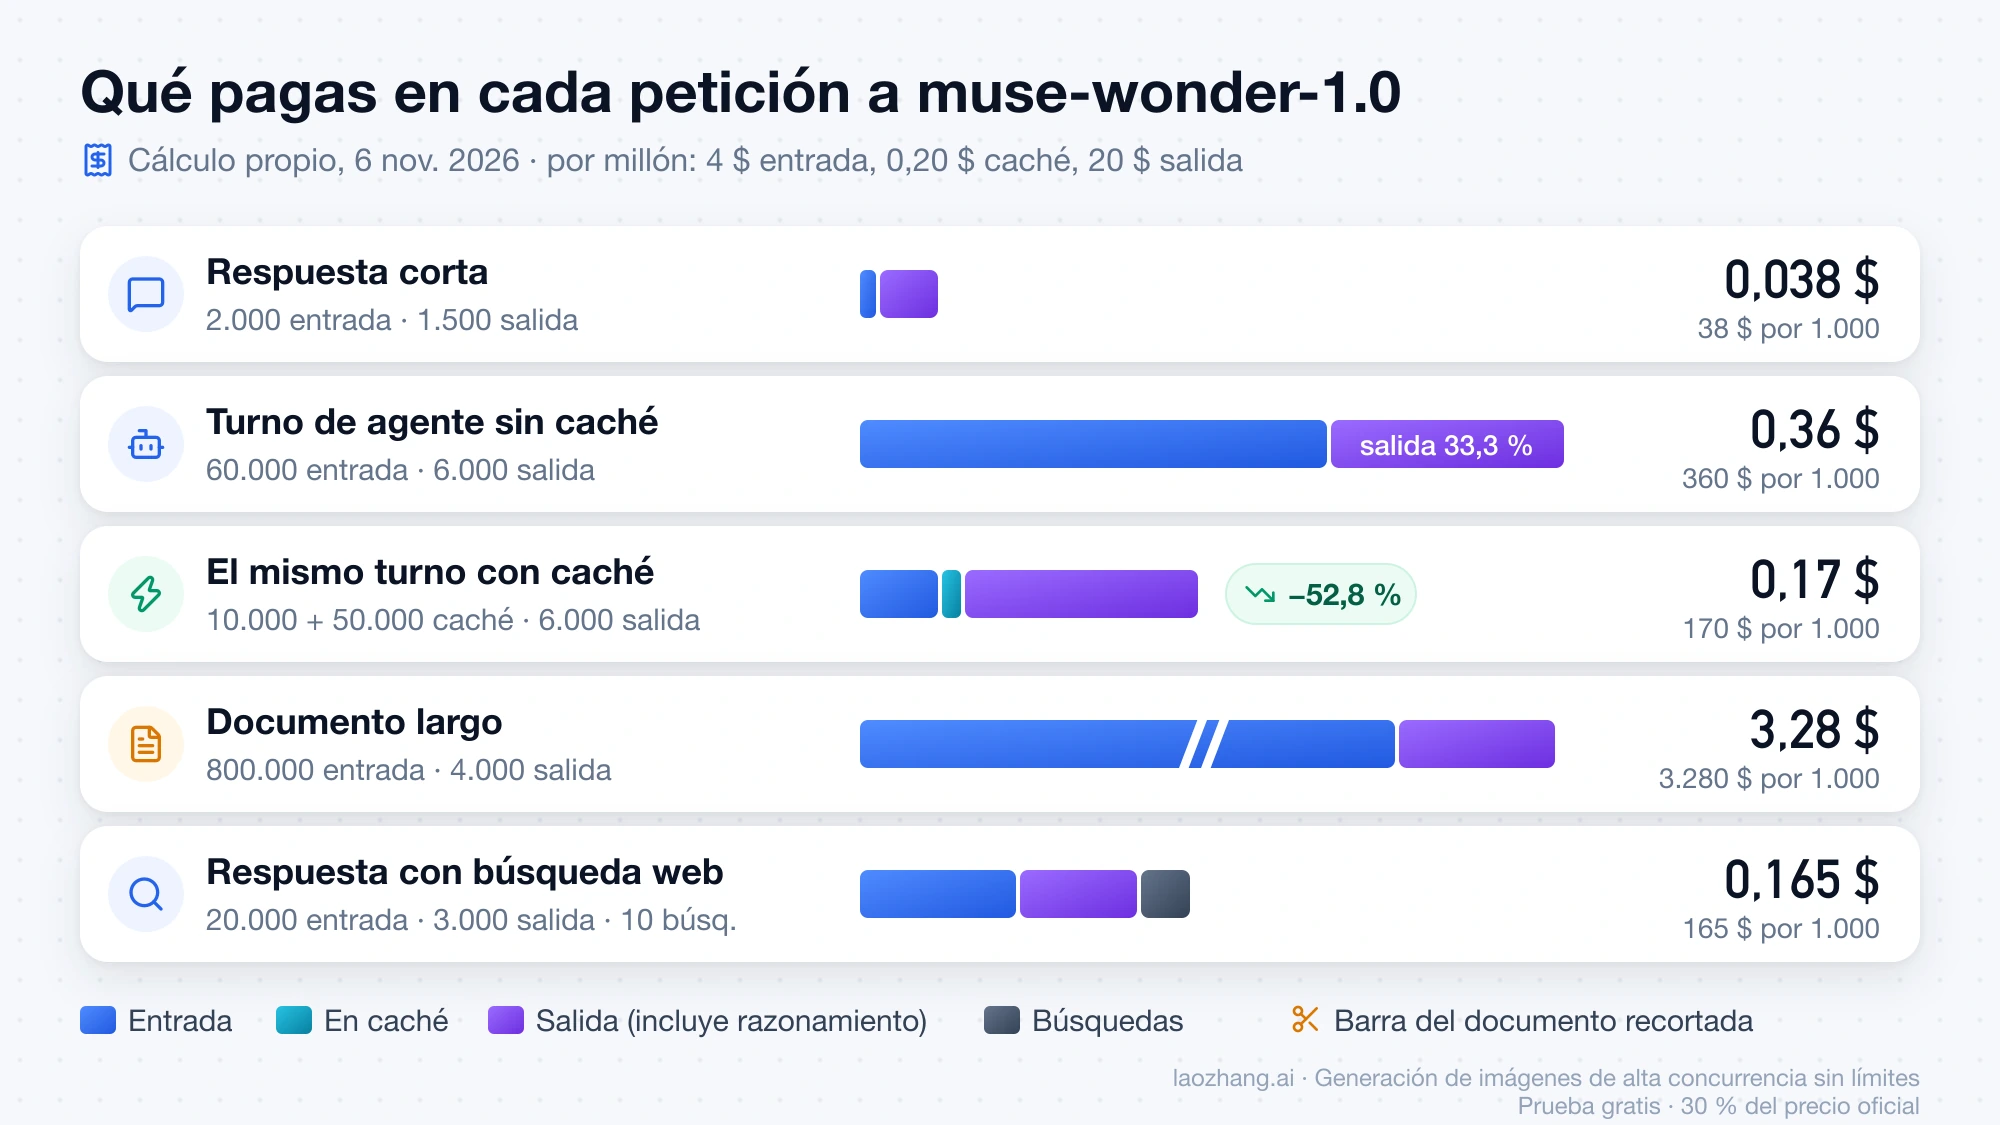
Con la Meta Model API pagas por token: 4 $ por millón de entrada, 0,20 $ por millón de entrada en caché y 20 $ por millón de salida, más 2,50 $ por cada 1.000 búsquedas web, y no hay recargo por contexto largo: un documento de 800.000 tokens se cobra al mismo precio por token que uno de 2.000. La tabla es un cálculo propio, hecho el 6 de noviembre de 2026 con esas tarifas de lista de Meta, para cinco cargas típicas. Los recuentos de tokens son ejemplos elegidos para el cálculo, no mediciones de Muse Wonder, así que sustitúyelos por los que veas en tu usage; la parte de razonamiento dentro de la salida cambia mucho con el nivel elegido.
| Carga | Tokens por petición | Coste por petición | Por 1.000 peticiones |
|---|---|---|---|
| Respuesta corta | 2.000 de entrada + 1.500 de salida | 0,038 $ | 38 $ |
| Turno de agente sin caché | 60.000 de entrada + 6.000 de salida | 0,36 $ | 360 $ |
| El mismo turno con caché | 10.000 de entrada + 50.000 en caché + 6.000 de salida | 0,17 $ | 170 $ |
| Documento largo | 800.000 de entrada + 4.000 de salida | 3,28 $ | 3.280 $ |
| Respuesta con búsqueda web | 20.000 de entrada + 3.000 de salida + 10 búsquedas | 0,165 $ | 165 $ |
La cuenta es (entrada × 4 + entrada en caché × 0,20 + salida × 20) / 1.000.000, más 0,0025 $ por búsqueda. Con ese mismo cálculo, en el turno de agente la salida supone un 33,3 % del coste, y la caché lo rebaja un 52,8 %. No hace falta activarla: Meta la aplica sola comparando el principio de cada petición con las recientes, así que conviene dejar fijo lo que se repite (instrucciones del sistema, herramientas, ejemplos, historial) al principio y poner lo nuevo al final.
Muse Wonder no es gratis por API: ni la página de precios y límites de la Meta Model API ni las de facturación mencionan crédito de prueba o un nivel gratuito, aunque tampoco piden mínimo ni compromiso previo. El cargo va a la tarjeta cada vez que el saldo pendiente llega al umbral de pago, que puede subir a medida que se cobran pagos, y lo que quede se cobra el día 1 de cada mes; también puedes pagar antes.
Los límites de uso son por equipo, no por clave: 3.000 peticiones por minuto (RPM) y 4.000.000 de tokens por minuto (TPM) para muse-wonder-1.0, compartidos también con el Playground. Aplicando ese límite a las cargas de la tabla (cálculo propio del 6 de noviembre de 2026, que cuenta entrada y salida), el TPM llega antes que el RPM: caben unas 1.142 respuestas cortas por minuto, unos 60 turnos de agente de 66.000 tokens o unos 4 documentos de 804.000 tokens. Meta no aclara si la entrada en caché cuenta para el TPM, de modo que con caché el margen real puede ser mayor.
¿Meta Model API u OpenRouter? Mismo modelo, distinta factura
OpenRouter no es un canal de Meta, pero reenvía a Meta. El 6 de noviembre de 2026, su API pública (/api/v1/models/meta/muse-wonder/endpoints) mostraba un único endpoint, Meta | meta/muse-wonder-20261012, con los mismos precios por token que Meta y una disponibilidad del 100 % en el último día. Elige Meta si quieres pagar a posteriori con tarjeta, sin comisiones, o necesitas retención cero de datos; elige OpenRouter si ya tienes saldo allí o prefieres una sola clave para modelos de varios proveedores.
| Meta Model API | OpenRouter | |
|---|---|---|
| Clave | LLM_…, creada en el panel de Model API | sk-or-v1-…, creada en OpenRouter |
| URL base y modelo | https://api.meta.ai/v1, muse-wonder-1.0 | https://openrouter.ai/api/v1, meta/muse-wonder |
| Precio por token | Tarifa de Meta | La misma, sin margen |
| Comisión | Ninguna | 5,5 % al comprar crédito con tarjeta (mínimo 0,80 $); 5 % con cripto |
| Forma de pago | Tarjeta: al llegar al umbral y el día 1 de cada mes | Crédito comprado por adelantado |
| Retención cero de datos (ZDR) | Bajo solicitud, para cuentas que cumplan requisitos | No la cubre la ZDR de Meta; rige la política de OpenRouter |
| Muse Wonder Full | No | No |
El mínimo de 0,80 $ pesa en recargas pequeñas. Según un cálculo propio del 6 de noviembre de 2026 con la comisión de OpenRouter que recoge la tabla, con 10 $ de crédito la comisión es un 8 %, y solo a partir de 14,55 $ baja al porcentaje estándar que anuncian las tarifas de OpenRouter. La retención cero de datos de Meta se pide a ventas, se aplica a toda la organización y, según su página de Zero Data Retention, solo cubre las llamadas hechas directamente a la Model API.
Las claves no son intercambiables. En la prueba del 6 de noviembre, una clave con formato de OpenRouter enviada a api.meta.ai recibió el mismo 401 que una petición sin clave. La ficha de OpenRouter también da un dato que Meta no publica: un max_completion_tokens de 943.718 para Wonder. Es la cifra de OpenRouter, no un límite documentado por Meta; en ambos casos, la entrada más la salida solicitada tienen que caber en 1.048.576 tokens. Entre los parámetros que esa ficha admite están reasoning_effort, tools, tool_choice, response_format y salidas estructuradas.
Errores 401, 402, 403, 404 y 429 de la API de Muse Wonder
Los errores de la Meta Model API llegan en el formato de OpenAI, {"error": {"message", "type", "param", "code"}}, y el code indica qué hay que arreglar. Estos son los cuerpos que devolvió la API el 6 de noviembre de 2026 a peticiones sin clave válida, enviadas con curl desde un solo equipo. El primero sale en Responses, Chat Completions y /v1/models; el segundo, con forma de Anthropic, en Messages:
{"error":{"code":"invalid_api_key","message":"Unauthorized","param":null,"type":"authentication_error"}}

{"error":{"message":"Unauthorized","type":"authentication_error"},"type":"error"}
Una ruta mal escrita, como /v1/chat/completion sin la «s», también devolvió 401 sin clave, porque la API comprueba la clave antes que la ruta. La documentación dice que una ruta desconocida da 404 con el cuerpo vacío, pero ese 404 solo aparece cuando la clave ya es válida; si ves 401, arregla primero la clave.
| Código | Qué significa | Qué hacer |
|---|---|---|
| 400 | Valor no admitido, como reasoning_effort en none o un límite de salida por encima del máximo del modelo | Usa minimal o superior y baja max_output_tokens o max_completion_tokens |
401 invalid_api_key | Clave ausente, mal copiada, revocada o sin el formato LLM_… (una clave de OpenRouter incluida) | Revisa la variable de entorno y que el cliente envíe Authorization: Bearer |
402 billing_not_configured | «Billing account issue. Please check your account status.»: sin saldo, tarjeta caducada o facturación sin configurar | Corrige la facturación en el panel; reintentar no sirve |
| 403 | La clave no tiene permiso para ese modelo o esa función | Comprueba en el panel a qué tiene acceso la clave |
| 404 | «The model {model_id} does not exist or is not available»: ID mal escrito, sin acceso o barra final en la URL base | Usa muse-wonder-1.0 y https://api.meta.ai/v1, sin barra al final |
429 rate_limit_error | Superaste el RPM o el TPM del equipo, o los 600 envíos por minuto en segundo plano | Espera lo que indique Retry-After; si no viene, reintenta con espera exponencial desde unos 500 ms |
La guía de errores de la Meta Model API pide no reintentar 400, 401, 402, 403 ni 404, porque exigen corregir la petición; solo merece la pena reintentar 429 y los 5xx. Las respuestas correctas traen las cabeceras x-ratelimit-remaining-tokens y x-ratelimit-remaining-requests, que te dejan frenar antes de llegar al 429.
Conectar Muse Wonder a Claude Code, Codex u OpenCode
Claude Code se conecta por la Messages API, y Codex y OpenCode, por Responses; en los tres casos la clave es la misma MODEL_API_KEY. En Claude Code, lo que más falla es dejar sin asignar los alias opus, sonnet y haiku: el modo plan, los subagentes y las tareas de fondo pasan por esos alias y, si no apuntan a un modelo de Meta, intentan llamar a un modelo Claude que la Model API no sirve. La configuración que da la guía de agentes de programación de Meta es esta, en este orden:
# 1. La clave de Model API
export MODEL_API_KEY="LLM_..."

# 2. Proveedor y modelos (Claude Code añade /v1/messages a la URL)
export ANTHROPIC_BASE_URL="https://api.meta.ai"
export ANTHROPIC_AUTH_TOKEN="$MODEL_API_KEY"
export ANTHROPIC_MODEL="muse-wonder-1.0"
export ANTHROPIC_DEFAULT_OPUS_MODEL="muse-wonder-1.0"
export ANTHROPIC_DEFAULT_SONNET_MODEL="muse-spark-1.3"
export ANTHROPIC_DEFAULT_HAIKU_MODEL="muse-spark-1.3"
export CLAUDE_CODE_SUBAGENT_MODEL="muse-spark-1.3"
export ENABLE_TOOL_SEARCH="true"

# 3. Arranca Claude Code
claude
Usa ANTHROPIC_AUTH_TOKEN y no ANTHROPIC_API_KEY: la primera envía Authorization: Bearer, que es lo que espera la API, y la segunda envía x-api-key. Así, Wonder lleva el bucle principal y Spark, más barato, se encarga de sonnet, haiku y los subagentes; si prefieres todo en Wonder, pon muse-wonder-1.0 en las cinco variables de modelo. ENABLE_TOOL_SEARCH mantiene activa la búsqueda de herramientas MCP, que Claude Code desactiva por defecto con proveedores que no son Anthropic.
En Codex, la configuración va en ~/.codex/config.toml: model = "muse-wonder-1.0", model_provider = "meta", model_reasoning_effort = "high" y un bloque [model_providers.meta] con base_url = "https://api.meta.ai/v1", env_key = "MODEL_API_KEY" y wire_api = "responses". En OpenCode, el proveedor usa el adaptador @ai-sdk/openai con la misma URL base y include: ["reasoning.encrypted_content"], que es lo que conserva el razonamiento entre turnos. Si el agente te muestra un coste de 0 $, no es un error: le faltan los precios del proveedor personalizado, y el consumo real lo ves en el panel de Model API.
En qué países no se puede usar la API de Muse Wonder
La Meta Model API está disponible en la mayoría de países donde funcionan Meta AI y la facturación, y la referencia que manda es la política de uso geográfico de Meta, actualizada el 12 de octubre de 2026. En América Latina, su lista de territorios restringidos incluye Cuba, Venezuela, Nicaragua y Haití; fuera de la región figuran, entre otros, Rusia, China (con Hong Kong y Macao), Irán, Siria y Corea del Norte. Desde esos territorios no se puede acceder a la API, un producto que la integre no puede ofrecerse a sabiendas a usuarios situados allí, y la política prohíbe expresamente usar medios técnicos para eludir los controles geográficos.
Si viajas a un país no admitido, Meta avisa de que no podrás iniciar sesión mientras estés allí. España y el resto de Latinoamérica no aparecen en la lista de territorios restringidos, y la única restricción por modelo que añade la política es la de Muse Image en la India, que no afecta a Wonder.
Fuentes12
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 6 nov 2026.
Fuentes12
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 6 nov 2026.
- 1.página de modelos de la Meta Model APIdev.meta.ai/docs/models
- 2.dev.meta.aidev.meta.ai
- 3.guía de inicio rápido de la Meta Model APIdev.meta.ai/docs/quickstart
- 4.guía de formatos de la Meta Model APIdev.meta.ai/docs/protocols
- 5.Intelligence Index v5.0.1 de Artificial Analysisartificialanalysis.ai/models/muse-wonder
- 6.guía de razonamiento de Metadev.meta.ai/docs/reasoning
- 7.página de precios y límites de la Meta Model APIdev.meta.ai/docs/pricing-rate-limits
- 8.tarifas de OpenRouteropenrouter.ai/pricing
- 9.página de Zero Data Retentiondev.meta.ai/help/policies-and-privacy/zero-data-retention
- 10.guía de errores de la Meta Model APIdev.meta.ai/docs/error-handling
- 11.guía de agentes de programación de Metadev.meta.ai/docs/coding-agents
- 12.política de uso geográfico de Metadev.meta.ai/legal/geographic-use-policy