Retención de datos en API LLM vs ZDR: cómo elegir y verificar una ruta
La retención limitada puede ser válida si cumple tu política. Si necesitas ZDR, verifica la ruta completa y rechaza cambios de modelo, funciones o proveedor sin evidencia.
En esta página
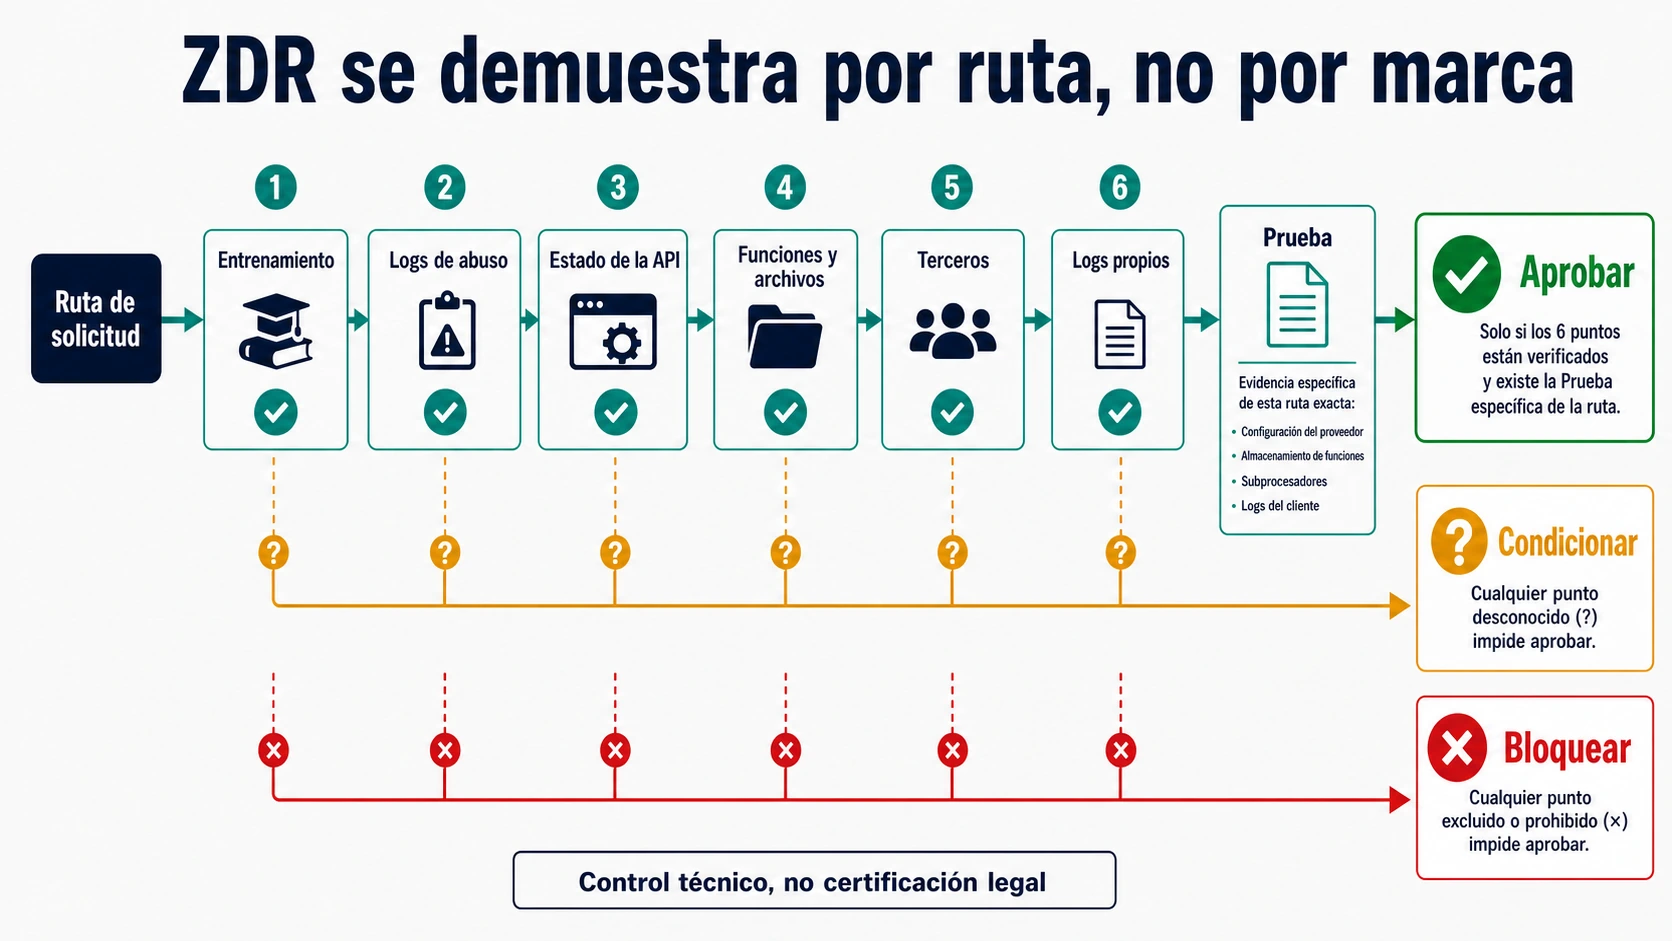
Elige retención limitada cuando tu política permita conservar ese contenido durante un plazo documentado; exige Zero Data Retention (ZDR) cuando prohíba su almacenamiento por el proveedor. En ambos casos, aprueba una ruta concreta: contrato, organización o proyecto, modelo, endpoint, funciones, intermediarios y registros propios. La marca y un store=false no bastan.
Para decidir, necesitas dos cosas distintas: definir dónde y durante cuánto tiempo permites guardar contenido, y acreditar que el recorrido real de la solicitud respeta esos límites. Más abajo encontrarás una ficha JSON y un comprobador local que rechaza una ruta alternativa sin aprobar. Los ejemplos son ficticios y se ejecutan sin llamar a ninguna API; no acreditan la configuración de una cuenta ni el borrado de datos de un proveedor.
Qué es ZDR y qué significa «cero» en tu aplicación
ZDR significa Zero Data Retention, o retención cero de datos. Es una condición de tratamiento del contenido dentro de un servicio y un ámbito definidos. Debes leer qué excluye del almacenamiento, cuándo termina el procesamiento y qué excepciones admite el acuerdo. No presupone que desaparezcan todos los identificadores, métricas o datos en memoria.
«No se usa para entrenar» responde a otra pregunta. Por ejemplo, OpenAI excluye por defecto el contenido de la API del entrenamiento, salvo consentimiento expreso, pero sus registros habituales de prevención de abuso pueden contener entradas y respuestas durante un máximo de 30 días, con excepciones. Desactivar el historial de una respuesta tampoco desactiva automáticamente esos registros.
Antes de comparar proveedores, escoge una política para la clase de datos que quieres enviar:
| Política de tu aplicación | Cuándo permite una ruta | Qué debes resolver |
|---|---|---|
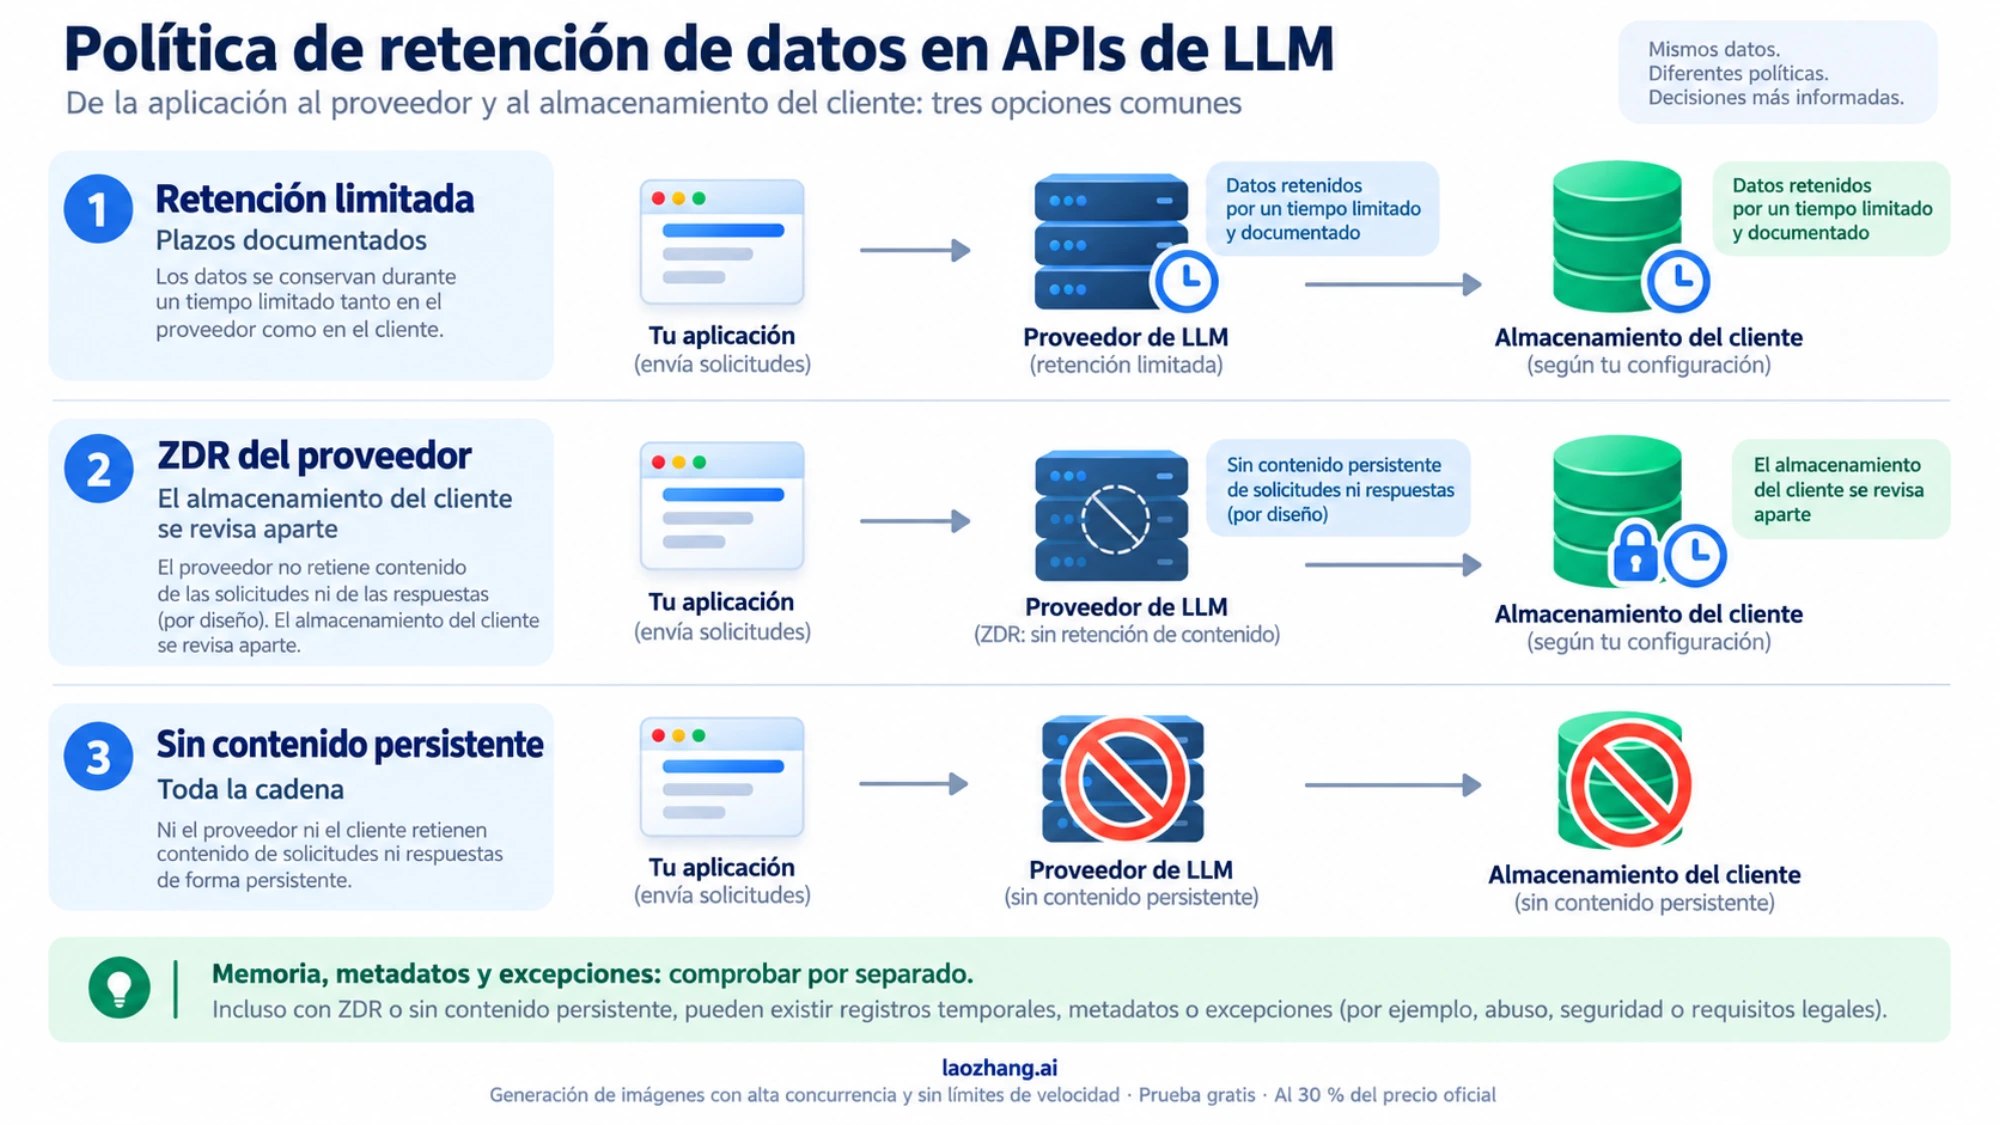
| Retención limitada | Todos los lugares que guardan contenido tienen un plazo aceptable y una finalidad autorizada | Plazo por sistema, excepciones, acceso y eliminación, incluidas copias de seguridad |
| Sin contenido persistente en proveedores | Cada proveedor del recorrido tiene cobertura ZDR para el uso concreto | Los almacenes controlados por ti siguen necesitando su propia política |
| Sin contenido persistente en toda la cadena | Ni proveedores ni sistemas del cliente escriben ese contenido de forma persistente | Historial, archivos, herramientas, registros, colas y copias propias también deben quedar cubiertos |
Estas son políticas de ejemplo, no categorías oficiales ni conclusiones sobre el RGPD. Si tu requisito incluye prohibir también cachés en memoria o determinados metadatos, añádelo expresamente: las dos últimas filas, por sí solas, no lo hacen.
Un bucket del cliente puede cambiar la decisión
ZDR con Private Safety Processing de OpenAI puede guardar interacciones seleccionadas y resultados de seguridad cifrados en almacenamiento regional controlado por el cliente, con un TTL de 30 días. OpenAI conserva referencias e información operativa, y el procesamiento de seguridad se realiza automáticamente dentro del entorno protegido descrito.
Por tanto, esta modalidad puede encajar en una política que prohíba conservar contenido en infraestructura del proveedor y admita un almacén de seguridad del cliente. No encaja en una prohibición de cualquier contenido persistente en toda la cadena. El cifrado no convierte un archivo guardado en un archivo inexistente; revocar una clave tampoco equivale a borrar el registro.
No confundas esa arquitectura con Private Retention with PSP: OpenAI la describe como una modalidad distinta, con almacenamiento gestionado por OpenAI. El nombre «private» no acredita ZDR.
Cuándo la retención limitada es una elección válida
La retención habitual puede ser suficiente para una aplicación que envía material público o datos cuya política permite un plazo finito. La decisión debe incluir el contenido real del mensaje: un texto público acompañado por un identificador personal ya plantea otra revisión.
Imagina un servicio que resume fichas de productos publicadas. Su política ficticia permite hasta 30 días de contenido para prevención de abuso, siete días en registros internos y ningún uso para entrenamiento. Puede aprobar una ruta de retención limitada si confirma esos límites, la ausencia de un historial adicional sin caducidad y las excepciones aplicables. No necesita etiquetarla como ZDR para utilizarla.
Si el mismo servicio empieza a resumir expedientes que su política prohíbe almacenar en terceros, necesita una ruta con cobertura ZDR verificada, o transformar los datos de forma que el contenido enviado quede permitido. No basta con cambiar el nombre de la política en una ficha. Y si exige cero persistencia también en sistemas propios, debe retirar las copias que cree su aplicación.
El plazo máximo tampoco describe cuánto tiempo se guarda cada solicitud. La ayuda comercial de Claude sitúa el borrado habitual de entradas y salidas de API dentro de 30 días, con condiciones y excepciones; su documentación técnica distingue modelos y funciones que necesitan almacenamiento de los que no lo necesitan. Pide el plazo aplicable a tu uso concreto, sin convertir esas descripciones en un único «Claude guarda todo 30 días» o «Claude no guarda nada».
Qué comprobar en las rutas actuales
Las condiciones siguientes corresponden a documentación consultada el 6 de octubre de 2026. Sirven para formular la comprobación, no para declarar aprobada tu cuenta.
| Ruta | Comprobación que cambia la elección |
|---|---|
| OpenAI API | ZDR requiere aprobación y controles de organización/proyecto. En Responses y Chat Completions fuerza store=false, pero no convierte en elegibles todos los endpoints con estado. Comprueba también el modelo, la caché y las herramientas; el procesamiento en segundo plano no es compatible con ZDR estricto. Controles y excepciones. |
| Claude API | La cobertura depende de la organización, modelo y funciones. Una función incompatible puede responder y conservar datos: bloquéala en tu aplicación. Algunos modelos requieren 30 días salvo autorización expresa. Ámbito de ZDR. |
| Gemini Developer API | La documentación actual remite a Vertex AI si necesitas ZDR garantizado o un DPA empresarial. No presupongas que una cuenta de pago de Developer satisface ese requisito. Search y Maps grounding conservan datos durante 30 días. Condiciones de Developer. |
| Google Cloud / Vertex | Es otra ruta contractual. Debes confirmar las excepciones de supervisión de abuso y las condiciones de modelos o funciones Advanced AI. En esta ruta, Google Search grounding puede guardar consultas derivadas y contexto hasta tres días; Maps, 30 días. No traslades los plazos de Developer. Condiciones de Cloud. |
| Modelos vendidos por Azure en Foundry | Identifica quién vende y trata el modelo. La aprobación de supervisión de abuso modificada no elimina el estado de funciones ni los registros de tu aplicación. ContentLogging=false acredita ese control concreto; si la propiedad no aparece, no infieras que está desactivado. Privacidad y almacenamiento. |
| Amazon Bedrock | Comprueba la región, el modo efectivo y los allowed_modes del modelo. none evita almacenamiento duradero dentro de su ámbito; la política predeterminada puede permitir retención de seguridad. Cambiar a aws_review para acceder a un modelo sale de una exigencia ZDR. Modos y disponibilidad. |
| OpenRouter | provider.zdr restringe rutas de inferencia, pero no extiende automáticamente la cobertura a plugins o herramientas. Una declaración BYOK del cliente es una declaración propia, no una verificación independiente del intermediario. Incluye sus condiciones y el destino efectivo en la ficha. Restricción de rutas ZDR. |
En Claude, los esquemas de salidas estructuradas pueden conservarse hasta 24 horas desde su último uso: evita datos sensibles en nombres, enumeraciones, constantes o patrones. Las excepciones legales y de seguridad, incluso con ZDR, necesitan una decisión expresa en tu política. Condiciones de funciones y excepciones.
En Gemini Developer, comprueba además los registros y conjuntos de datos del proyecto. Los registros de producto habilitados tienen 55 días por defecto, configurables a 7, 14, 28 o 55; los guardados como conjuntos de datos no caducan automáticamente. Esa ventana no es la regla de todos los mensajes ni el plazo de prevención de abuso. Distingue el store efectivo, el registro del proyecto y las exportaciones.
Una ficha que vincula contrato, configuración y recorrido real
Rellena una ficha por cada combinación aprobada. Mantén separados lo autorizado y lo observado: si ambos son siempre una copia de la configuración prevista, no detectarás un cambio del destino real.
La ficha siguiente es una simulación completa, con nombres y referencias inventados. Guárdala como ficha.json para ejecutar el ejemplo. En una aprobación real, sustituye las referencias fixture: por documentos identificables y añade el responsable, la fecha de revisión, el acuerdo aplicable y el procedimiento de eliminación. No guardes claves ni mensajes de usuarios en este archivo.
{
  "clase_datos": "fichas_publicas_sinteticas",
  "politica": "retencion_limitada",
  "max_dias": 30,
  "excepciones_aceptadas": true,
  "ambito_aprobado": {
    "contrato": "fixture:contrato-A",
    "organizacion": "org-ejemplo",
    "proyecto": "proyecto-publico",
    "region": "region-A",
    "gateway": "ninguno",
    "proveedor": "proveedor-A",
    "modelo": "modelo-A",
    "endpoint": "/respuesta",
    "funciones": [],
    "store": false,
    "logging": "solo-registros-internos-limitados"
  },
  "ambito_observado": {
    "contrato": "fixture:contrato-A",
    "organizacion": "org-ejemplo",
    "proyecto": "proyecto-publico",
    "region": "region-A",
    "gateway": "ninguno",
    "proveedor": "proveedor-A",
    "modelo": "modelo-A",
    "endpoint": "/respuesta",
    "funciones": [],
    "store": false,
    "logging": "solo-registros-internos-limitados"
  },
  "inventario_completo": true,
  "sistemas": [
    {
      "id": "prevencion-abuso",
      "control": "proveedor",
      "contenido_persistente": true,
      "dias": 30,
      "sin_entrenamiento": true,
      "cobertura_zdr": false,
      "evidencia": ["fixture:politica-A", "fixture:config-A"]
    },
    {
      "id": "registros-aplicacion",
      "control": "cliente",
      "contenido_persistente": true,
      "dias": 7,
      "sin_entrenamiento": true,
      "cobertura_zdr": false,
      "evidencia": ["fixture:registros-A", "fixture:borrado-A"]
    }
  ]
}
Para convertirla en evidencia útil, vincula cada sistema a tres comprobaciones:
- Ámbito documental. Contrato o autorización vigente para esa organización, proyecto, modelo, endpoint y funciones. Una página pública explica condiciones; no prueba que tu organización tenga la aprobación necesaria.
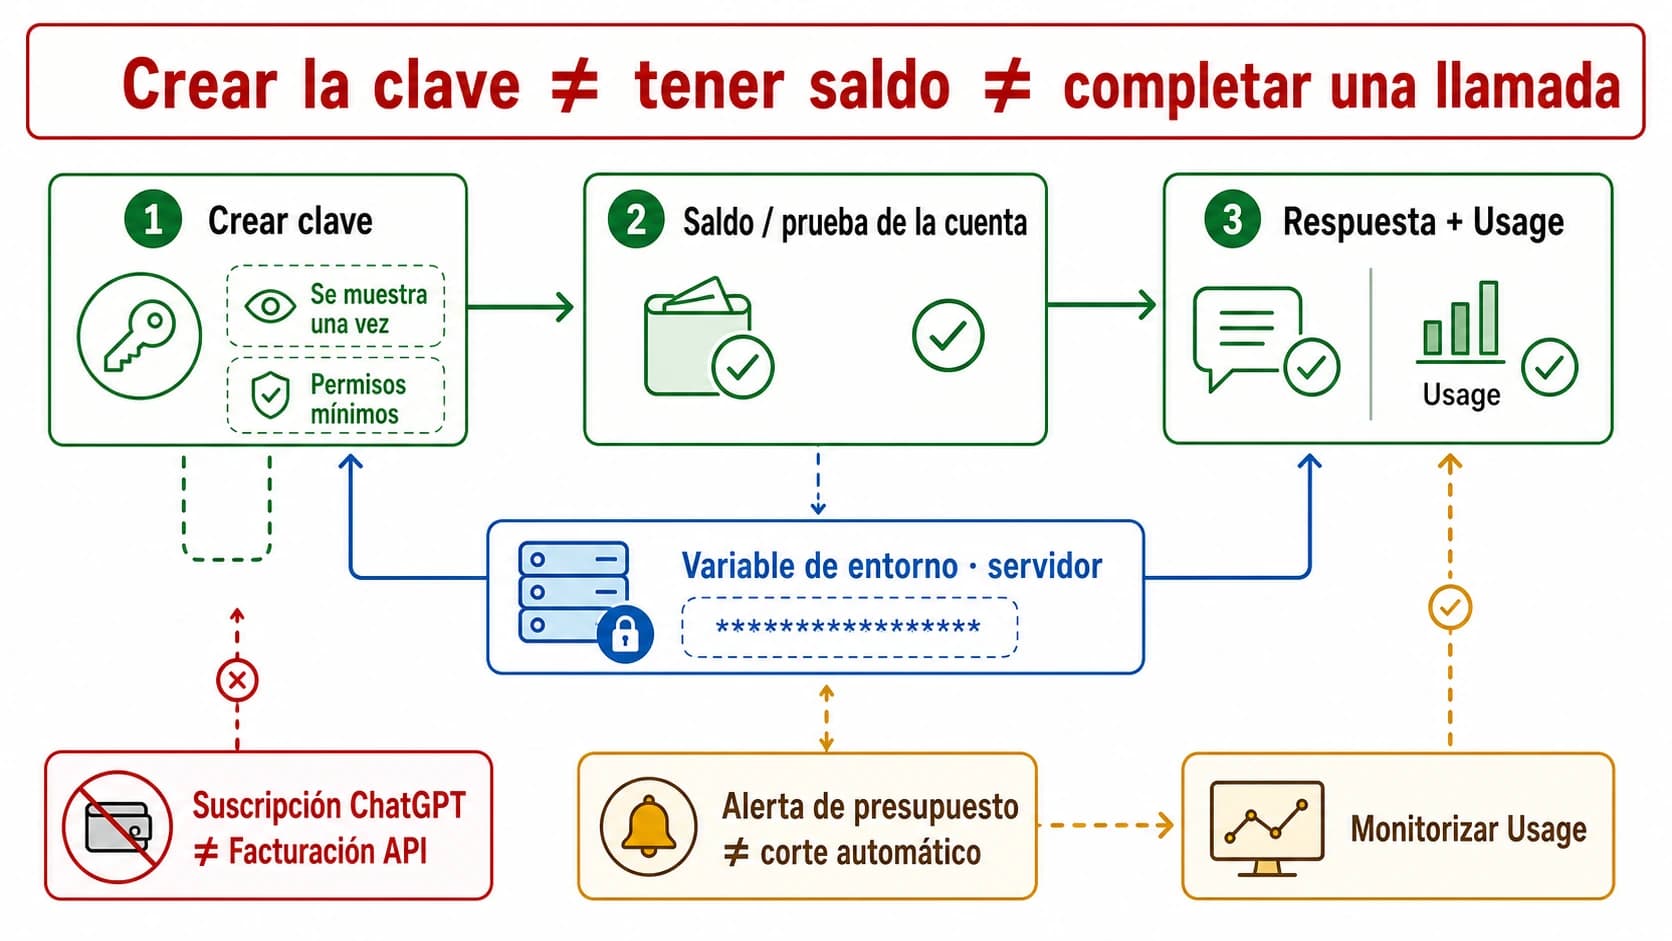
- Configuración efectiva. Exportación o lectura administrativa autorizada del recurso concreto, con los controles realmente activos. No interpretes un campo ausente como un
false. - Recorrido observado. Registro mínimo del destino y las funciones que usa la aplicación, sin copiar el contenido sensible. Incluye gateways, herramientas, destinos alternativos y sistemas de registro. Todo almacén de contenido necesita su plazo y la evidencia de su eliminación; incluye el bucket de seguridad del cliente cuando exista.
inventario_completo es una afirmación del responsable sobre ese inventario, no un descubrimiento automático. Un comprobador no detecta un sistema que nadie haya declarado. Revisa también colas, informes de errores, copias de seguridad, soporte y observabilidad antes de darlo por completo.
Comprobar la decisión y rechazar un fallback incorrecto
Este programa para Python 3 lee únicamente la ficha local. Valida campos necesarios y compara el ámbito aprobado con el observado. No accede a documentos, cuentas, redes ni APIs; tampoco verifica por sí mismo que las referencias aportadas sean verdaderas.
Guárdalo como comprobar.py, junto a ficha.json, y ejecuta python3 comprobar.py. La lista de funciones se compara exactamente: usa un orden consistente.
import copy
import json
from pathlib import Path

CAMPOS = {
    "contrato", "organizacion", "proyecto", "region", "gateway",
    "proveedor", "modelo", "endpoint", "funciones", "store", "logging"
}
POLITICAS = {
    "retencion_limitada", "zdr_proveedor", "sin_contenido_persistente"
}


def evaluar(ficha):
    errores = []
    politica = ficha.get("politica")
    if politica not in POLITICAS:
        errores.append("Politica desconocida")
    if not ficha.get("clase_datos"):
        errores.append("Falta la clase de datos")
    if ficha.get("inventario_completo") is not True:
        errores.append("Inventario incompleto")
    if ficha.get("excepciones_aceptadas") is not True:
        errores.append("Excepciones sin resolver")

    aprobado = ficha.get("ambito_aprobado", {})
    observado = ficha.get("ambito_observado", {})
    for nombre, ambito in (("aprobado", aprobado), ("observado", observado)):
        if not isinstance(ambito, dict) or not CAMPOS <= ambito.keys():
            errores.append("Ambito " + nombre + " incompleto")
        else:
            cadenas = CAMPOS - {"funciones", "store"}
            if any(not isinstance(ambito[c], str) or not ambito[c].strip()
                   for c in cadenas):
                errores.append("Ambito " + nombre + " contiene desconocidos")
            funciones = ambito["funciones"]
            if not isinstance(funciones, list) or not all(
                isinstance(f, str) and f.strip() for f in funciones
            ) or type(ambito["store"]) is not bool:
                errores.append("Ambito " + nombre + " mal formado")
    if aprobado != observado:
        errores.append("La ruta efectiva no coincide con la aprobada")

    limite = ficha.get("max_dias")
    if type(limite) is not int or limite < 0:
        errores.append("Limite de retencion sin definir")
        limite = -1
    sistemas = ficha.get("sistemas", [])
    if not isinstance(sistemas, list) or not sistemas:
        return errores + ["No hay inventario de sistemas"]
    for s in sistemas:
        if not isinstance(s, dict):
            errores.append("Sistema mal formado")
            continue
        nombre = s.get("id", "sistema sin nombre")
        control = s.get("control")
        persiste = s.get("contenido_persistente")
        dias = s.get("dias")
        if control not in {"cliente", "proveedor"}:
            errores.append(nombre + ": responsable desconocido")
        evidencia = s.get("evidencia")
        if not isinstance(evidencia, list) or not evidencia or not all(
            isinstance(e, str) and e.strip() for e in evidencia
        ):
            errores.append(nombre + ": falta evidencia")
        if s.get("sin_entrenamiento") is not True:
            errores.append(nombre + ": uso para entrenamiento sin resolver")
        if type(persiste) is not bool or type(dias) is not int or dias < 0:
            errores.append(nombre + ": retencion desconocida")
        elif (persiste and dias == 0) or (not persiste and dias != 0):
            errores.append(nombre + ": contenido y plazo incompatibles")
        elif dias > limite:
            errores.append(nombre + ": supera el plazo permitido")
        if politica in {"zdr_proveedor", "sin_contenido_persistente"}:
            if control == "proveedor" and (
                persiste is not False or s.get("cobertura_zdr") is not True
            ):
                errores.append(nombre + ": no acredita ZDR del proveedor")
        if politica == "sin_contenido_persistente" and persiste is not False:
            errores.append(nombre + ": conserva contenido")
    return errores


ficha = json.loads(Path("ficha.json").read_text(encoding="utf-8"))
resultado = evaluar(ficha)
print("RECHAZAR: " + "; ".join(resultado) if resultado else "ADMISIBLE")

# Casos sinteticos: solo comprueban la logica del programa.
assert evaluar(ficha) == []
fallback = copy.deepcopy(ficha)
fallback["ambito_observado"]["proveedor"] = "proveedor-B"
assert evaluar(fallback)
desconocido = copy.deepcopy(ficha)
desconocido["sistemas"][0]["dias"] = None
assert evaluar(desconocido)
zdr = copy.deepcopy(ficha)
zdr["politica"] = "zdr_proveedor"
assert evaluar(zdr)  # La ruta habitual no adquiere ZDR por renombrarla.
zdr["sistemas"][0].update(
    contenido_persistente=False, dias=0, cobertura_zdr=True
)
assert evaluar(zdr) == []  # El cliente puede conservar contenido limitado.
zdr["politica"] = "sin_contenido_persistente"
assert evaluar(zdr)  # Sus registros propios siguen guardando contenido.
print("Seis casos sinteticos comprobados")
La salida de la ficha ficticia es ADMISIBLE, seguida del resultado de los seis casos. Significa que sus campos satisfacen la política del ejemplo. No significa «ZDR activado» ni «datos borrados». Las afirmaciones sobre cobertura y plazos deben proceder de las comprobaciones anteriores. Las pruebas con assert están pensadas para esta ficha de ejemplo; sepáralas del comprobador si introduces una ficha real con otra decisión esperada.
En producción, aplica la decisión antes de enviar el contenido. El enrutador debe evaluar la ficha del destino alternativo con el ámbito de esa solicitud y pasar todos los controles; no puede reutilizar la aprobación del destino principal. Al cambiar modelo, región, endpoint, funciones o registros, compara de nuevo la configuración y actualiza la evidencia. Si la alternativa no está aprobada, devuelve un error controlado o usa otra ruta ya aprobada para esa clase de datos.
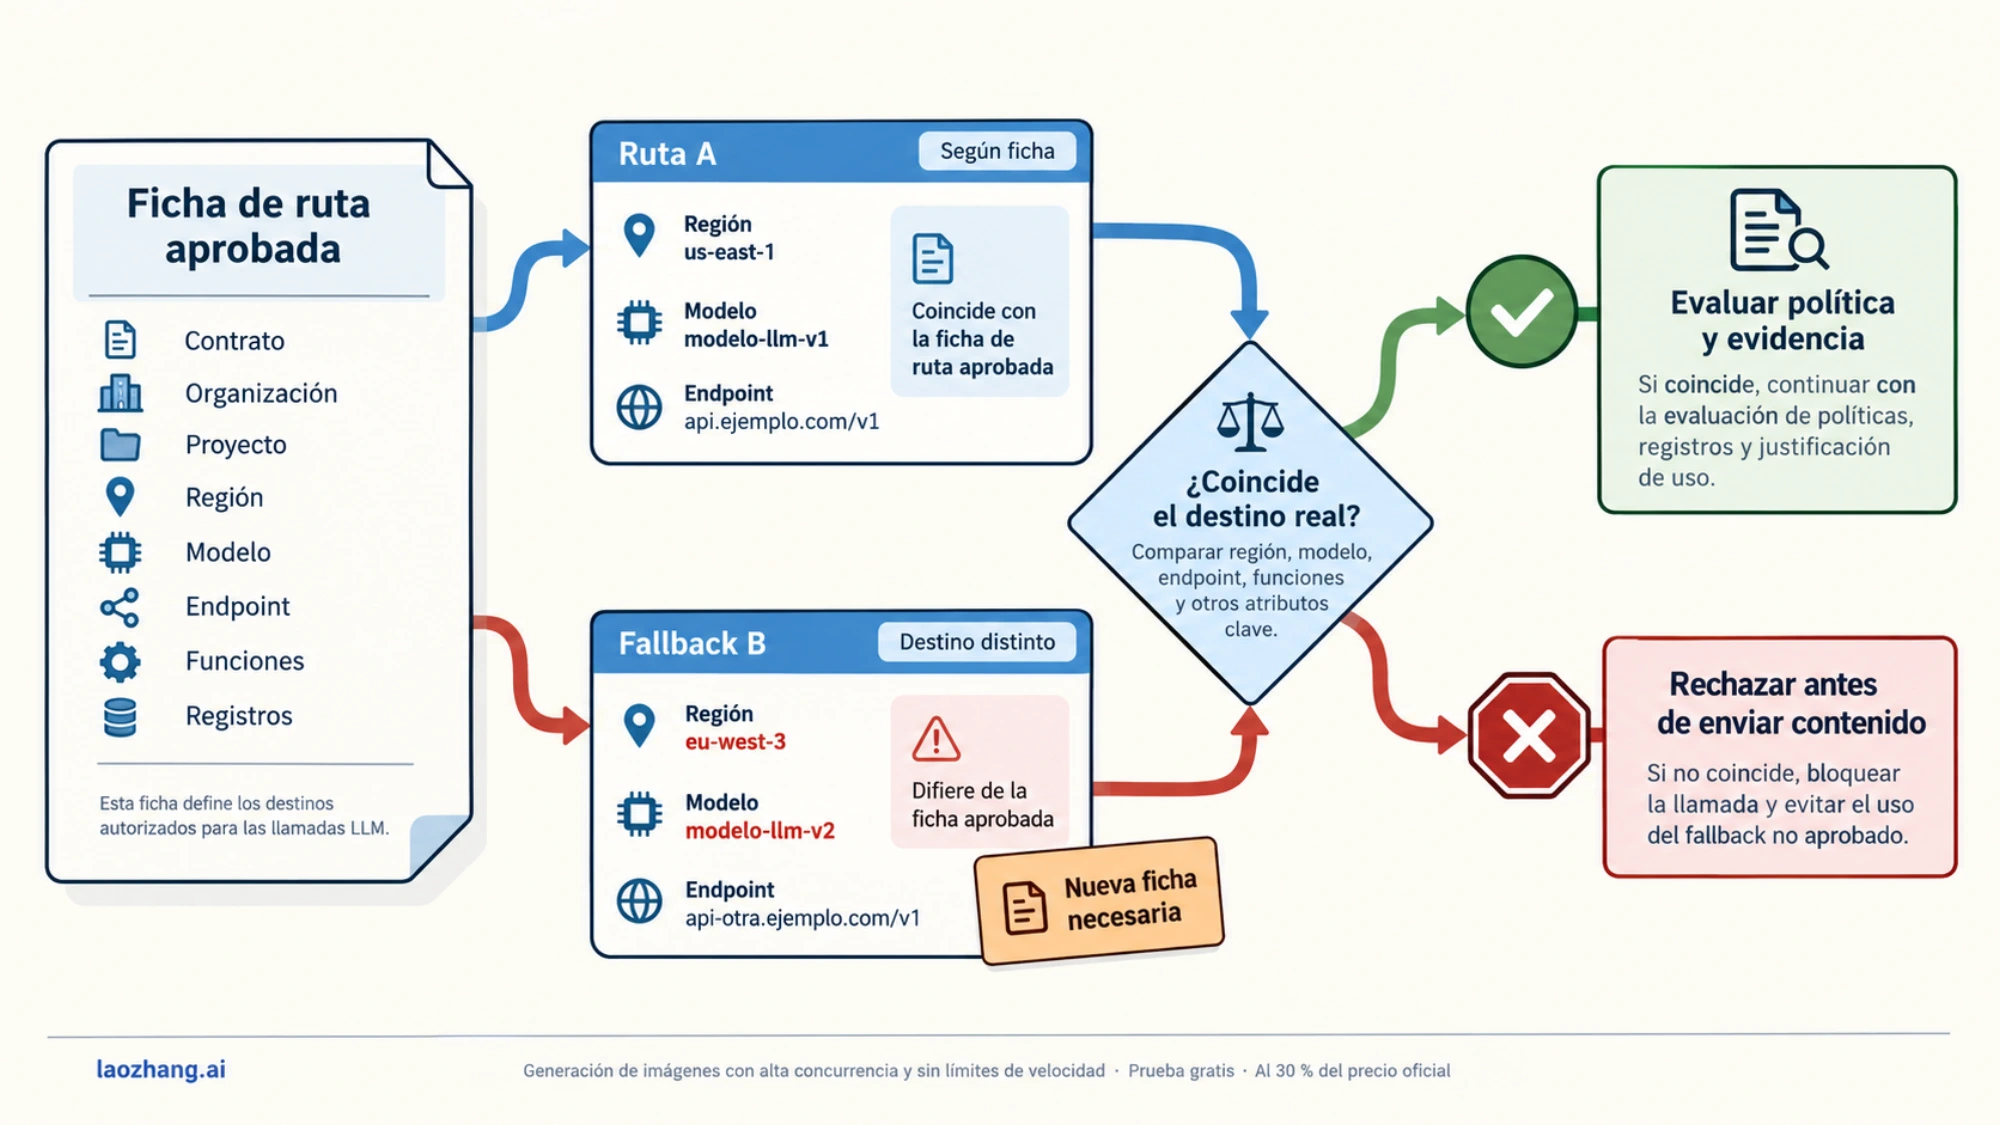
Un ejemplo concreto es Bedrock: si el modelo nuevo no admite none, habilitar aws_review puede resolver su disponibilidad y, al mismo tiempo, incumplir tu política ZDR. Las opciones coherentes son un modelo aprobado compatible, una autorización expresa que habilite el modo requerido o detener ese envío. Disponibilidad según el modo de retención.
Preguntas frecuentes
¿Una respuesta correcta demuestra que ZDR está activado?
No. Demuestra que la solicitud se procesó. En Claude, funciones excluidas del acuerdo ZDR pueden ejecutarse sin que la API las rechace. Debes verificar la cobertura y bloquearlas tú cuando la política las prohíba.
¿Puedo usar store=false como prueba de retención cero?
No. Ese campo controla determinados estados del producto. En Gemini Developer, por ejemplo, no convierte la ruta en ZDR garantizado ni elimina las condiciones de grounding. En OpenAI tampoco sustituye la aprobación de organización/proyecto y la elegibilidad de funciones.
¿ZDR con un gateway cubre también mis registros?
No automáticamente. Un intermediario añade sus propios controles y posibles herramientas; tus registros, copias y proveedores de observabilidad necesitan su propia revisión. La restricción ZDR de OpenRouter se refiere a rutas de inferencia y no acredita por sí sola toda esa cadena. Una etiqueta de cualquier gateway, incluida laozhang.ai, no aporta la evidencia necesaria para aprobar contenido que exige ZDR.
¿ZDR basta para cumplir el RGPD?
No se puede concluir el cumplimiento a partir de esa etiqueta técnica. La ficha de retención permite revisar una parte de la arquitectura; la evaluación correspondiente debe resolver por separado finalidad, base jurídica, contrato, transferencias y demás obligaciones aplicables. Tampoco este ejemplo exige ZDR para cualquier uso: acepta retención limitada cuando la política definida y la evidencia la permiten.
Fuentes10
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 6 oct 2026.
Fuentes10
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 6 oct 2026.
- 1.OpenAI excluye por defecto el contenido de la API del entrenamiento, salvo consentimiento expresodevelopers.openai.com/api/docs/guides/your-data
- 2.ZDR con Private Safety Processing de OpenAIdevelopers.openai.com/api/docs/guides/private-safety-processing
- 3.La ayuda comercial de Claude sitúa el borrado habitual de entradas y salidas de API dentro de 30 díasprivacy.claude.com/en/articles/7996866-how-long-do-you-store-my-organization-s-data
- 4.su documentación técnica distingue modelos y funciones que necesitan almacenamiento de los que no lo necesitanplatform.claude.com/docs/en/manage-claude/api-and-data-retention
- 5.Condiciones de Developerai.google.dev/gemini-api/docs/zdr
- 6.Condiciones de Clouddocs.cloud.google.com/gemini-enterprise-agent-platform/resources/zero-data-retention
- 7.Privacidad y almacenamientolearn.microsoft.com/en-us/azure/foundry/responsible-ai/openai/data-privacy
- 8.Modos y disponibilidaddocs.aws.amazon.com/bedrock/latest/userguide/data-retention.html
- 9.Restricción de rutas ZDRopenrouter.ai/docs/guides/features/zdr
- 10.registros y conjuntos de datos del proyectoai.google.dev/gemini-api/docs/logs-datasets