Claude Code 报 529 过载怎么办:换模型还是等待
Claude Code 报 529 过载时已自动重试过,也不扣额度。容量按模型计算:急用就 /model 换模型,常遇到就配备用模型链,无人值守时让它一直等。
文章目录
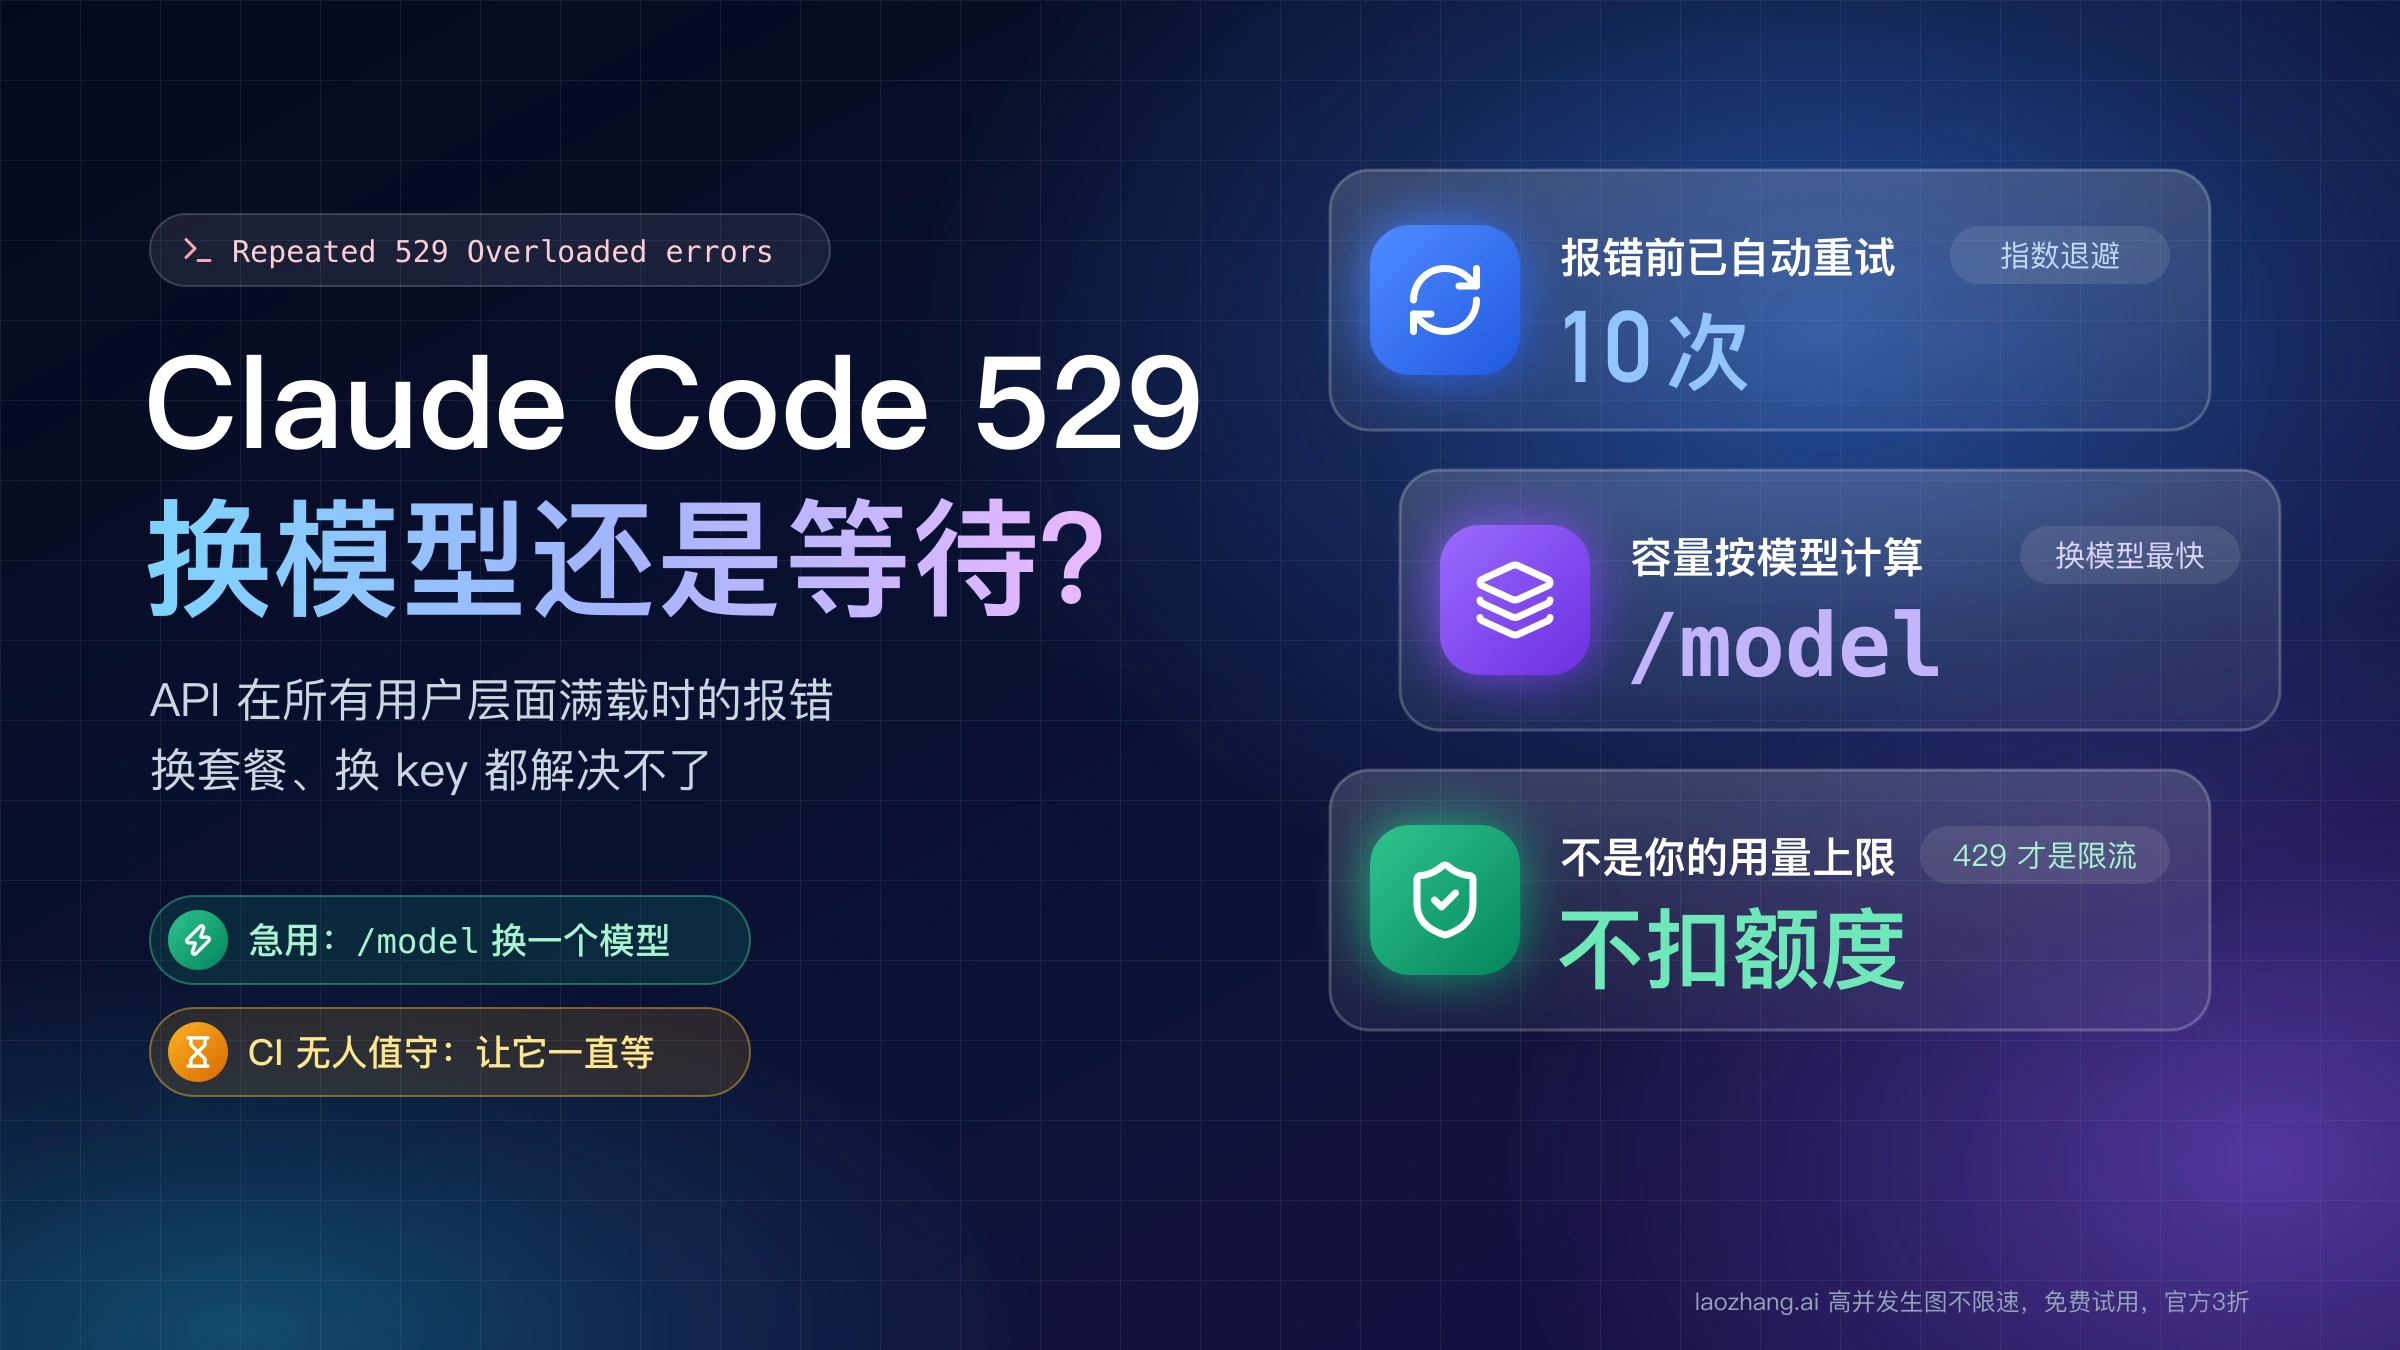
Claude Code 弹出下面这句时,它已经在后台按指数退避重试过最多 10 次,重试全部失败才把错误交给你:
API Error: Repeated 529 Overloaded errors. The API is at capacity — this is usually temporary. Try again in a moment. If it persists, check https://status.claude.com.529 的意思是 API 在所有用户层面暂时满载。它不是你的用量上限,也不计入额度,换套餐、换 key 都解决不了。截至 2026 年 9 月 28 日,Claude Code 官方文档写明容量是按模型分别计算的,所以想马上接着干活,最直接的办法是换一个模型。
下一步按你的处境选:
- 任务正急:运行
/model切到另一个模型;桌面端 Code 标签页用应用里的模型选择器。原消息还在对话里,切完直接重发。 - 不急,或状态页事故写的是多个模型一起出错:过几分钟再发,换模型未必有用。
- 一周碰上好几次:配置备用模型链(
fallbackModel),下次主模型过载时,这一轮自动换到备用模型。 - CI、脚本、远程任务没人盯着:设置
CLAUDE_CODE_RETRY_WATCHDOG=1,让它对 429 和 529 一直等下去,而不是重试 10 次就失败退出。
先认准屏幕上是哪一句
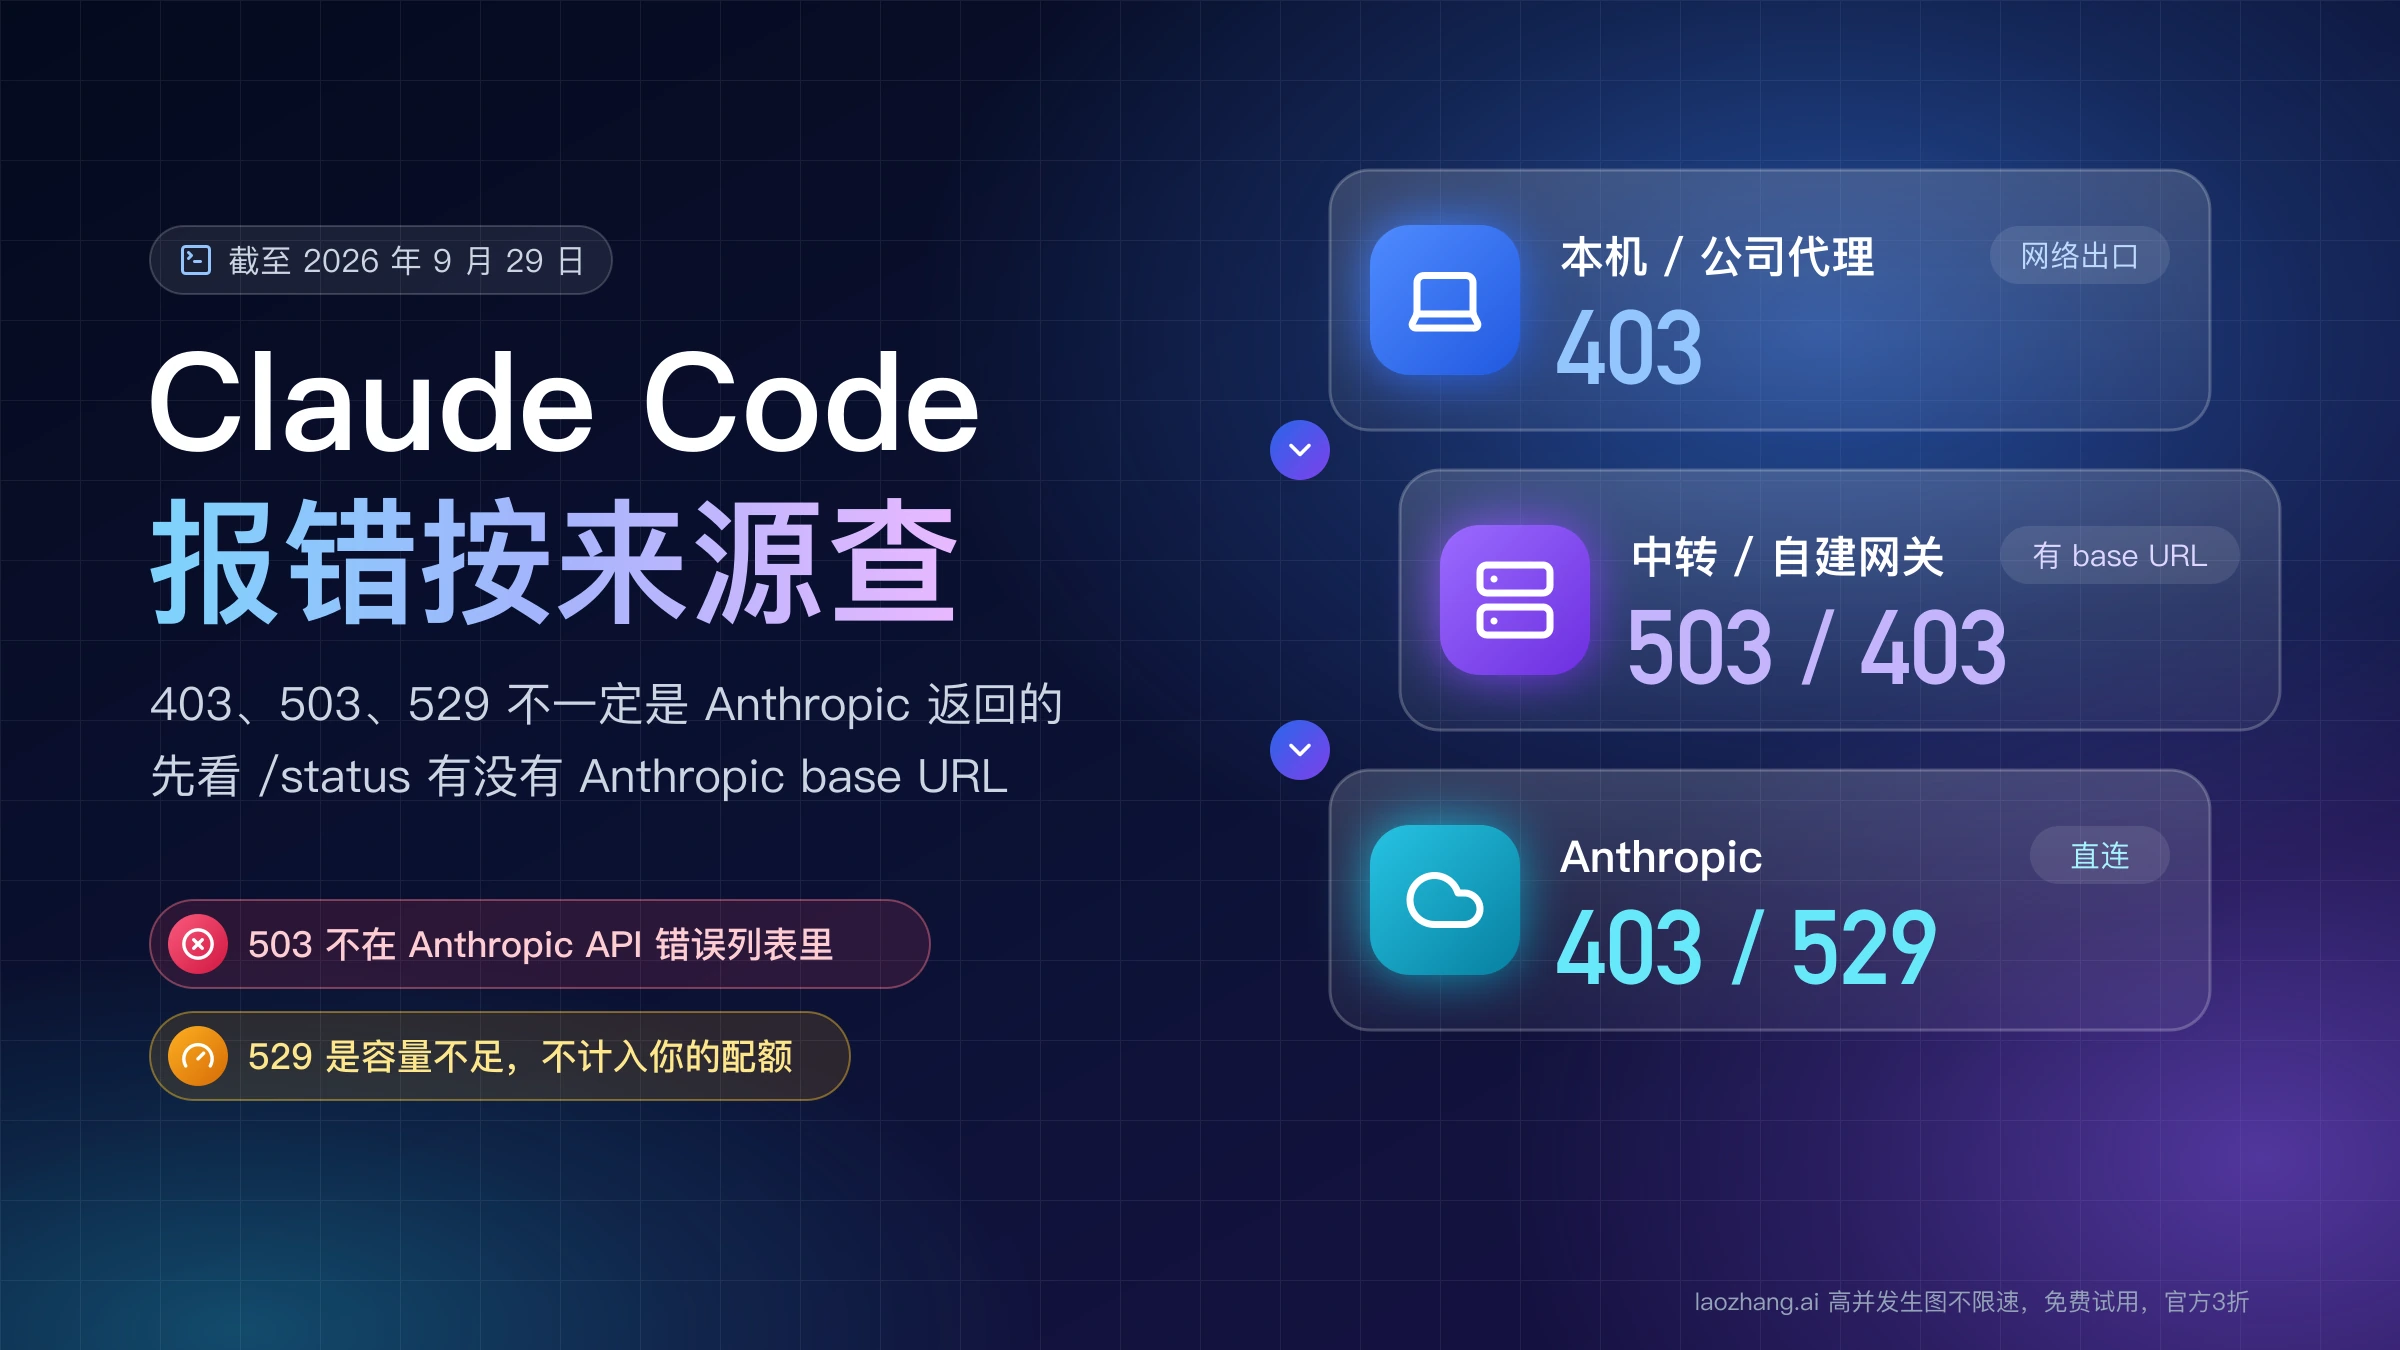
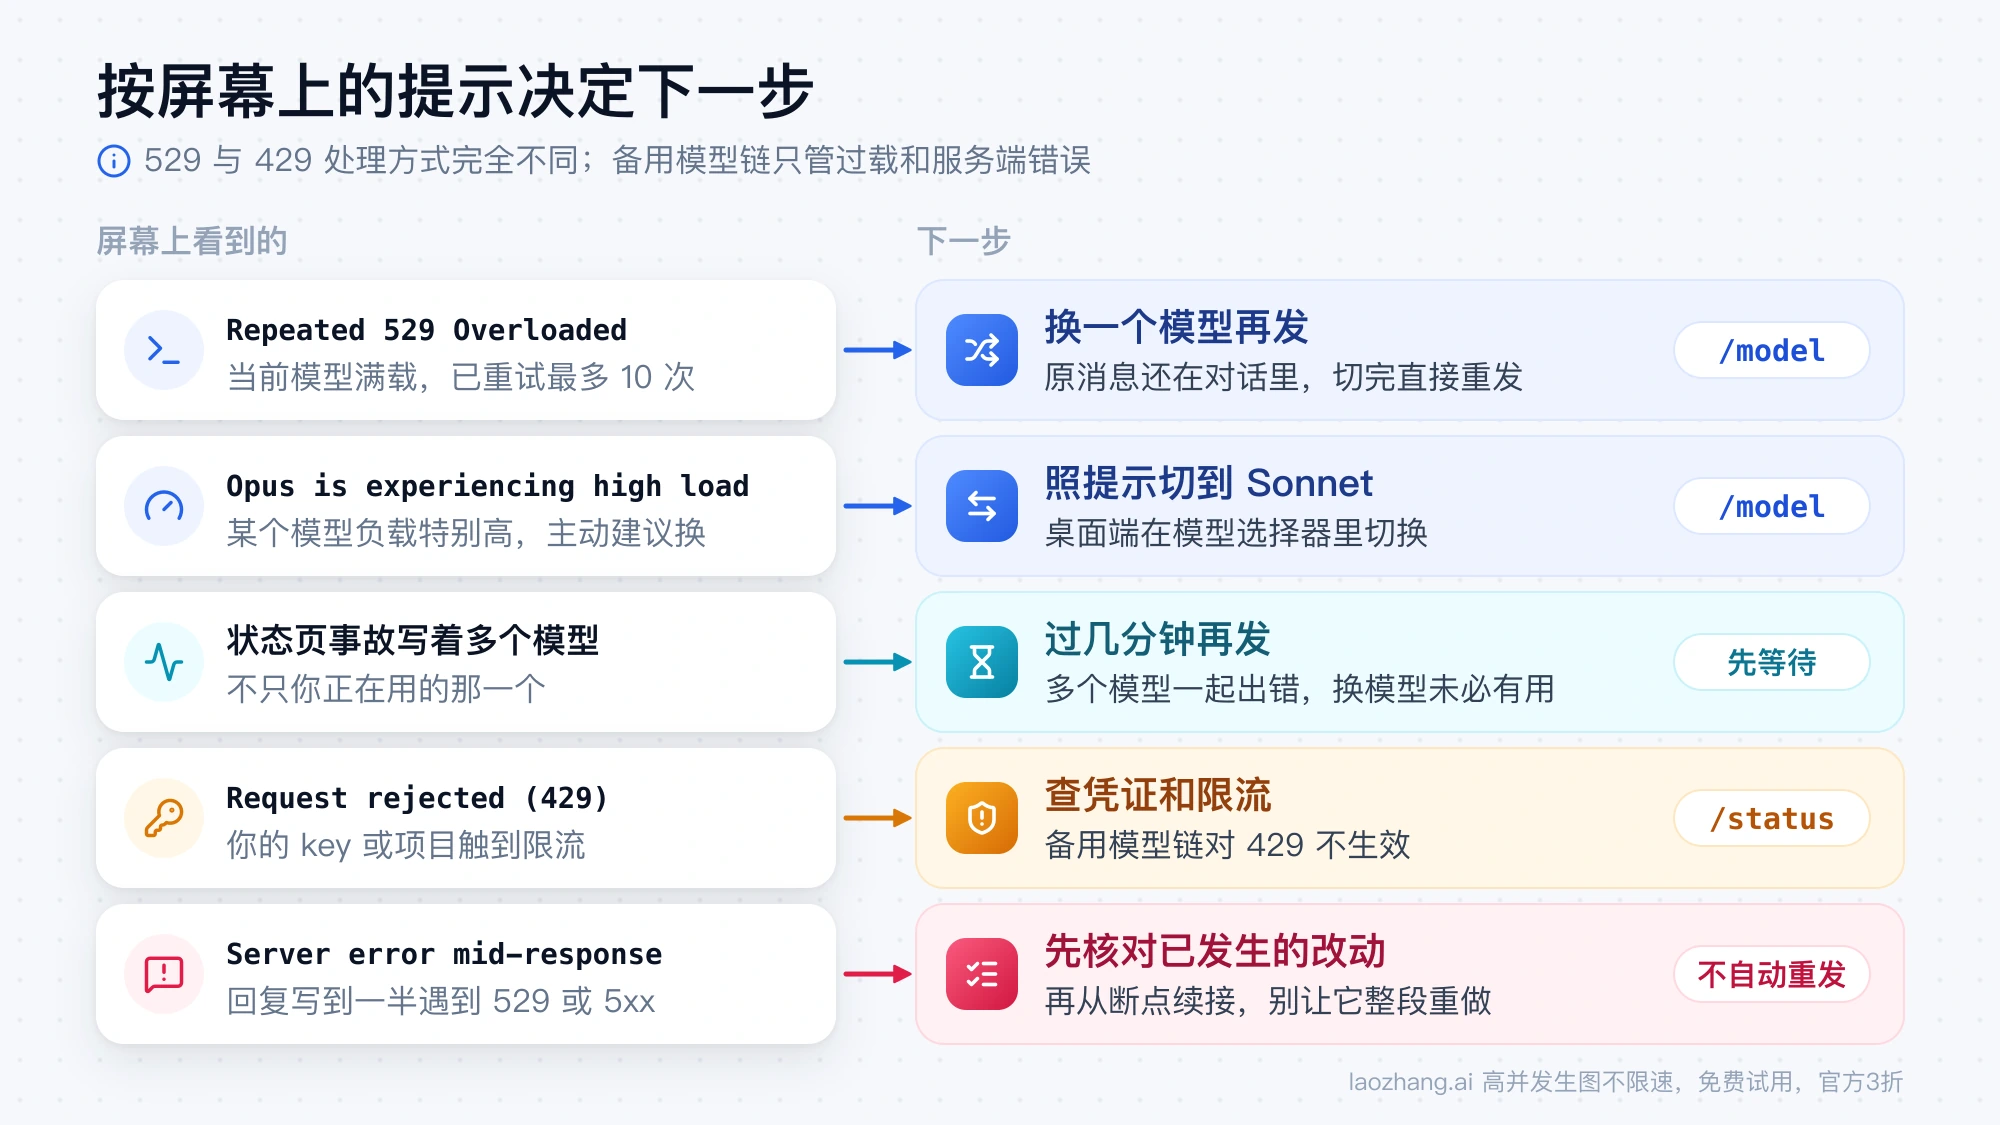
同样是"用不了",提示不同,处理方式完全不同。备用模型链只对过载和服务端错误生效,对 429 限流不起作用;把 429 当成 529 处理,等多久都不会好。
| 屏幕上的提示 | 含义 | 已经自动重试过吗 | 下一步 |
|---|---|---|---|
Retrying in Ns · attempt x/y | 正在重试,还没失败 | 进行中 | 让它跑完;从第 3 次起标签会写出具体原因 |
API Error: Repeated 529 Overloaded errors | 当前模型容量满载,所有用户都受影响 | 是,默认最多 10 次 | 换模型,或几分钟后重发;看提示末尾点名的状态页 |
Opus is experiencing high load, please use /model to switch to Sonnet | 某个模型负载特别高,Claude Code 主动建议换 | 是 | 照提示用 /model 切换;桌面端显示 Switch to Sonnet.,用模型选择器 |
API Error: Request rejected (429) | 你的 API key、Bedrock 项目或 Google Cloud 项目触到限流 | 通常是 | /status 核对当前凭证,再看 Claude Code Rate Limit Reached 修复指南 |
Server is temporarily limiting requests (not your usage limit) | 服务端短时节流,与套餐额度无关 | 是(v2.1.199 起) | 稍等再发;持续出现再看状态页 |
API Error: 500 Internal server error | API 内部的意外故障 | 是 | 按 Claude Code API Error 500 排查 处理 |
Server error mid-response. The response above may be incomplete. | 回复写到一半遇到 529 或 5xx | 否,故意不重发 | 见下文"回复做到一半断了"一节 |
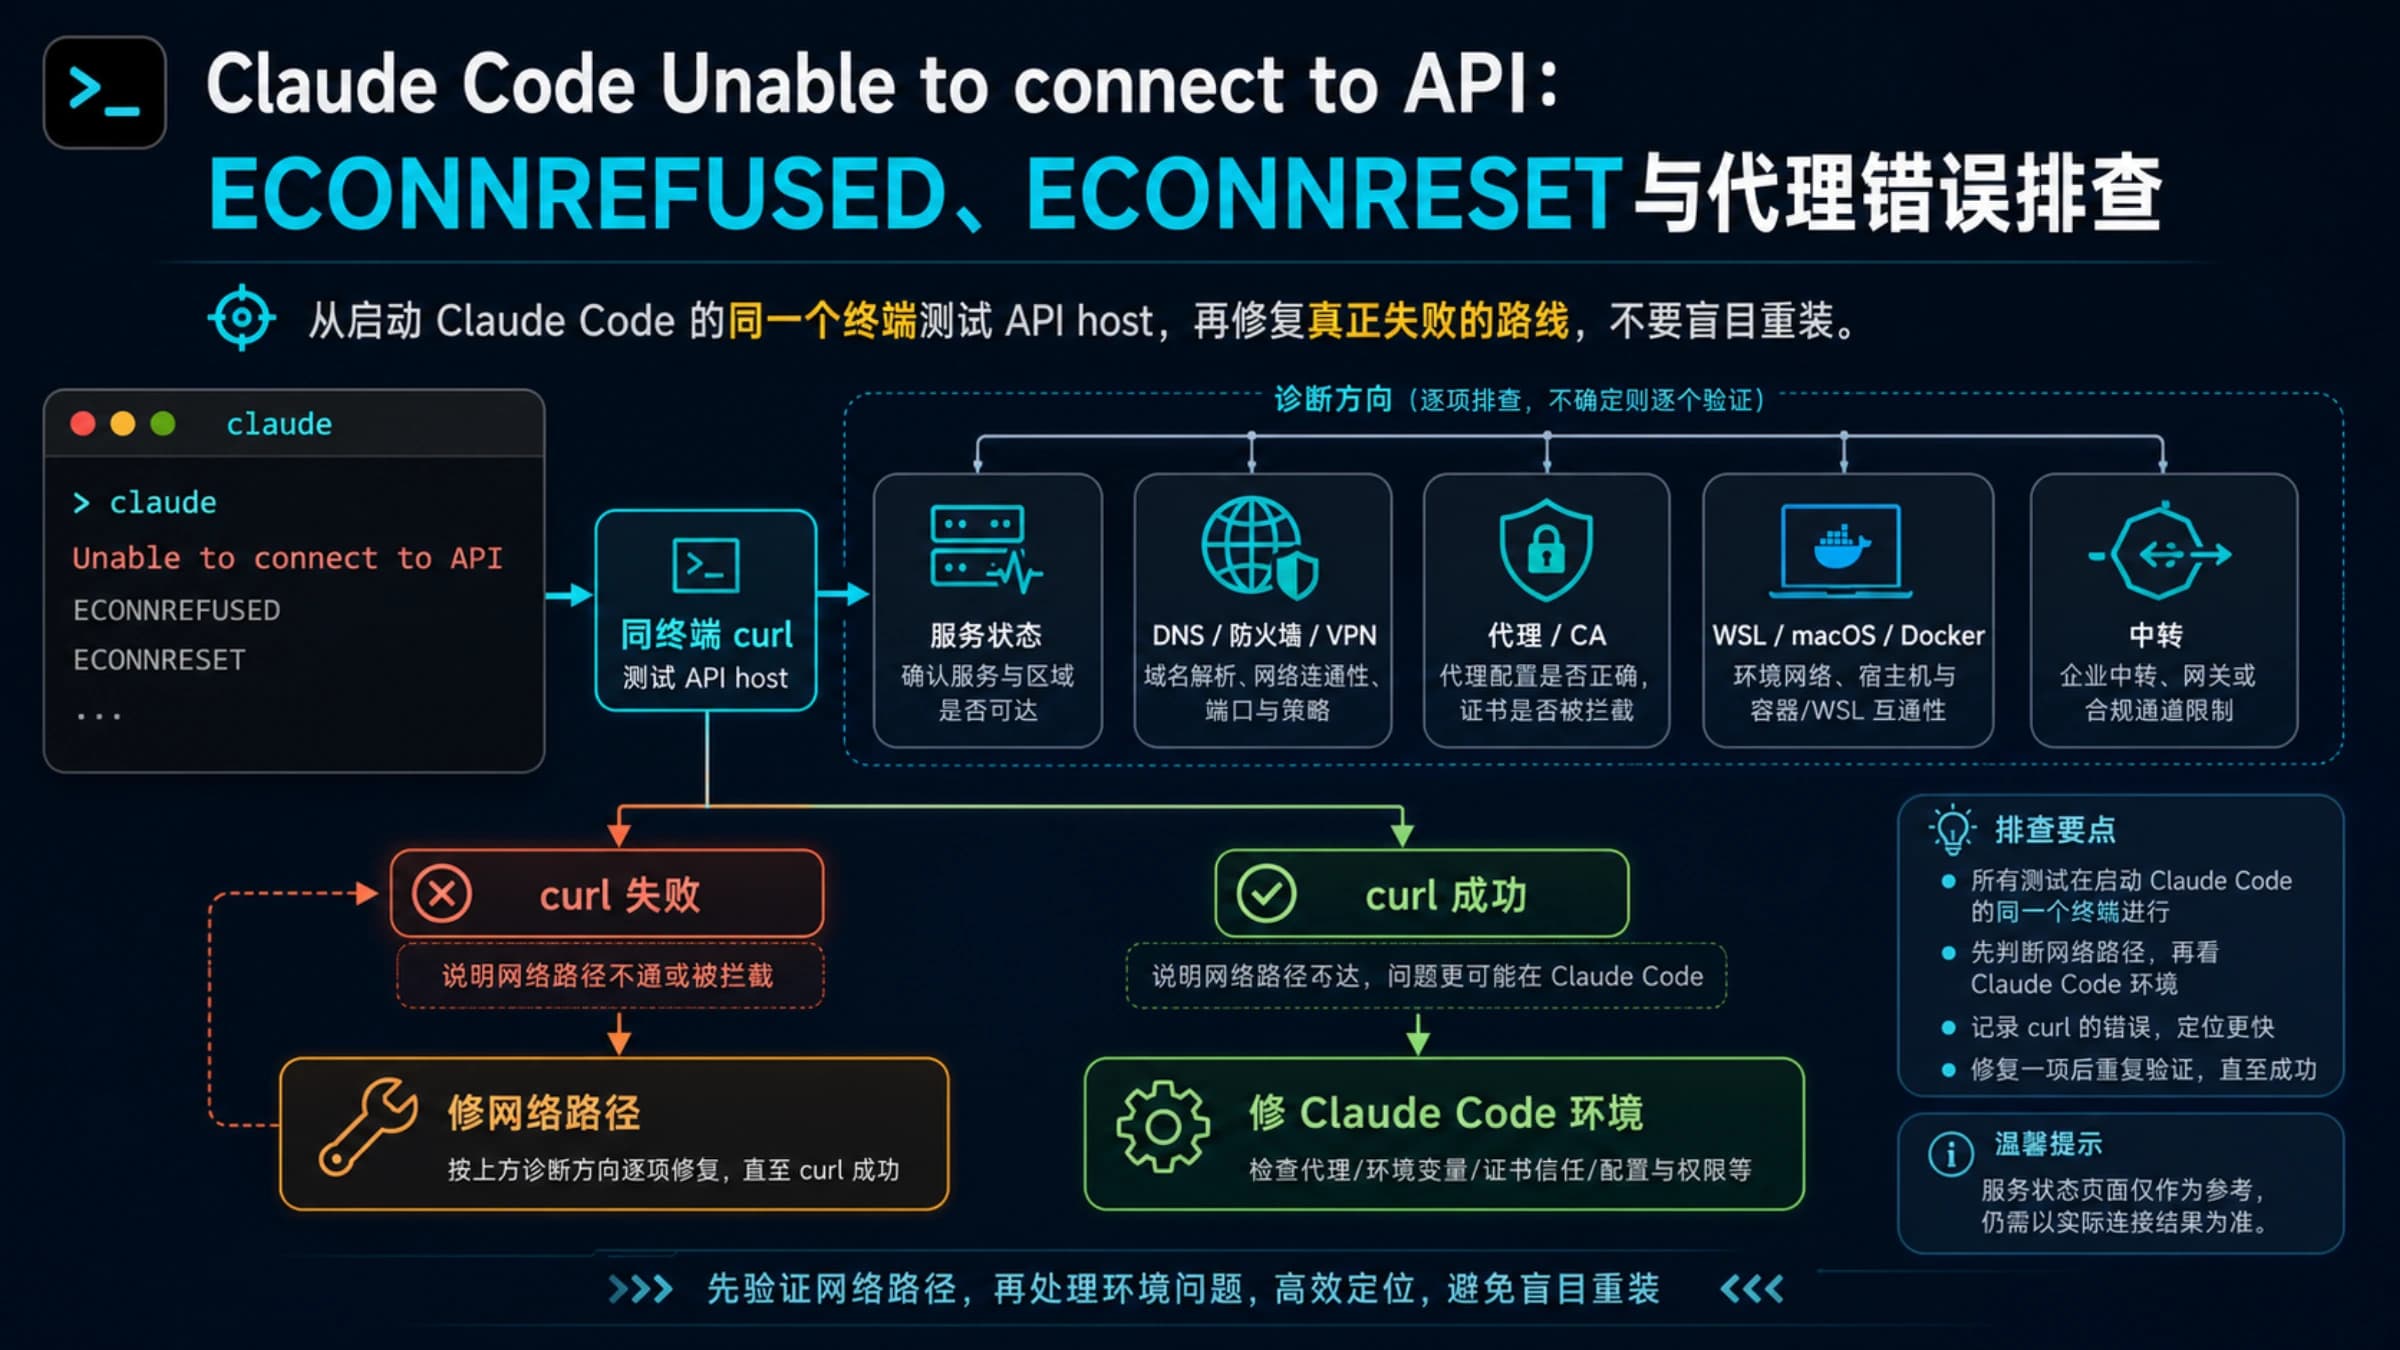
Unable to connect to API、ECONNRESET 等 | 网络或代理连不上 | 视情况 | 按 Unable to connect to API 排查 处理 |
重试时,转圈提示一开始只写 API error。v2.1.198 及以后,从第 3 次尝试起它会换成具体原因;如果是 529,倒计时下方还会写出该去哪里看服务状态。所以最终报错之前,你通常已经能看出这是过载。
529 说明了什么,不说明什么
Claude API 的错误文档把 HTTP 529 定义为 overloaded_error,原因是 API 在所有用户层面流量过高。定义里没有提到账号等级、免费档或 key 的优先级,把 529 归咎于"自己的 key 档位太低",没有官方依据。
与它相邻的 429 才和你自己有关:同一份文档提醒,组织用量突然暴涨时,触发的是 429(加速限制),而不是 529。也就是说:
- 529:大家都挤,跟你用了多少无关,不扣额度;
- 429:你的 key、项目或组织触到了上限,要去看用量和凭证。
"已经重试过"这一点也改变了你该做的事。Claude Code 会对服务端错误、过载响应,以及在回复开始输出之前发生的超时自动重试,默认最多 10 次、间隔逐次拉长。看到最终报错时,短时间内反复按回车重发,等于把刚才的重试再做一遍,而容量问题是按模型算的,换模型往往比原地重发更快。
如果你不是在用 Claude Code,而是自己写代码直接调 API:官方 SDK 默认只重试 2 次,可以通过 max_retries 调整。生产环境的重试预算和退避写法,见 Claude API 529 overloaded_error 怎么处理。
马上继续:换模型,而不是原地重发
官方给 529 的处理建议有三条:看状态页、几分钟后再试、用 /model 换一个模型。第三条之所以有效,是因为容量按模型分别计算,一个模型满载时,另一个模型可能照常可用。
- 终端 CLI:输入
/model,选另一个模型。某个模型负载特别高时,Claude Code 会主动提示,例如Opus is experiencing high load, please use /model to switch to Sonnet;用 Fable 模型时提示里写的是 Fable。 - Claude 桌面端(Code 标签页或 Cowork):提示变成
Opus is experiencing high load. Switch to Sonnet.,在应用的模型选择器里切换。
换哪一个,由当时哪个模型出问题决定,没有固定答案。可以参考 status.claude.com 上的事故标题,它们经常直接写出模型名。以 2026 年 9 月为例:9 月 2 日至 3 日是 "Elevated errors for Claude Sonnet 5",9 月 15 日是 "Intermittent error spikes for Claude Mythos 5.1 and Claude Fable 5.1",9 月 22 日则是 "Elevated errors for multiple models"。事故标题只点了你正在用的模型,换一个模型就很值得试;标题写的是多个模型,那就先等一等。
换模型之前还要留意计费:按你的套餐和席位,Fable 的用量可能从 usage credits(付费计划的额外用量)里扣,而不是套餐内额度,/model 里对应一行会标 "Requires usage credits"。走 API key 时,则按所选模型的单价计费。
让下次过载不打断你:配置备用模型链
如果过载经常打断你,与其每次手动 /model,不如配置备用模型链(fallback model chain)。主模型过载、不可用或返回其他不可重试的服务端错误时,Claude Code 会按顺序换到备用模型,并在屏幕上提示一次。
只对当前会话生效,用命令行参数,逗号分隔:
claude --fallback-model sonnet,haiku想长期生效,写进 settings 文件(用户级 ~/.claude/settings.json 或项目里的 .claude/settings.json):
{
  "fallbackModel": ["claude-sonnet-5", "claude-haiku-4-5"]
}
上面的模型 ID 取自截至 2026 年 9 月 28 日的官方示例;条目也可以写别名(如 sonnet),写 "default" 表示默认模型。命令行参数优先于 settings。
配置之前要知道它的边界,以下几条都来自官方文档:
- 只管当前这一轮:本轮换到备用模型后,你发下一条消息时,Claude Code 仍会先试主模型。
- 最多 3 个模型:去重后超出的条目会被忽略。
- 429 不触发切换:认证、计费、限流、请求过大、网络传输错误和组织策略拒绝都不会换模型,按原来的重试和报错流程走。
- 启动时没有确认:
/status也不显示备用链。第一次真正切换时出现的提示,是你唯一能看到它已生效的信号。 - 不在
availableModels允许范围内的条目会被丢弃;压缩上下文时,也不会退到上下文窗口比主模型小的模型上。 - 子代理同样适用(v2.1.247 起):子代理的请求会按备用链切换,你的会话模型不变。
备用链里放哪个模型,决定了过载时花谁的钱。在 -p 非交互模式下,Fable 请求需要扣 usage credits 时,Claude Code 不会弹确认,直接扣费;不想在脚本里产生这类费用,就不要把 Fable 放进备用链。
无人值守:让 CI 等下去,而不是直接失败
交互使用时,重试 10 次后报错,你再手动处理,问题不大。CI、评测脚本、远程 worker 就不一样了:一次 529 让整个任务失败,重跑的代价往往更高。官方为这种场景准备了一个环境变量:
export CLAUDE_CODE_RETRY_WATCHDOG=1
claude -p "运行测试并修复失败用例"
它的行为,以及与之相关的其他变量:
| 变量 | 默认 | 作用 |
|---|---|---|
CLAUDE_CODE_RETRY_WATCHDOG | 未设置 | 设为 1 后,对 429、529 容量错误无限重试,退避间隔最长 5 分钟;需要 v2.1.186 及以上 |
CLAUDE_CODE_MAX_RETRIES | 10 | 重试次数;v2.1.186 起上限为 15。在脚本里调小,可以更快暴露失败 |
API_TIMEOUT_MS | 600000 | 单次请求超时,单位毫秒,即 10 分钟 |
几个细节决定它适不适合你的流水线:
- 有些 429 仍会立刻失败:v2.1.239 起,429 如果报告的是消费上限或 usage credits 已用完,即便是网关按周期重置的消费上限,Claude Code 也会直接失败,不会空等。
- 其他临时错误的重试次数也会放宽:v2.1.199 起,服务端错误、超时、断线的默认重试次数提高到 300 次,约 3 小时的退避,
CLAUDE_CODE_MAX_RETRIES的 15 次上限也随之取消。给 CI 任务设置总超时时要把这段时间算进去。 -p模式下凭证怎么选:只要环境里有ANTHROPIC_API_KEY,-p就一定用它,而不是订阅登录。这决定了过载时该看哪个状态页,也决定了费用算在谁头上。
人坐在终端前时通常用不上这个变量:无限等待会把一个本可以换模型解决的问题拖成长时间卡住。
你该看哪个状态页
529 提示的最后一句会写出该去哪里看状态,而且随你的连接方式变化。先用 /status 确认 Claude Code 当前实际用的是哪种凭证,再对照下表:
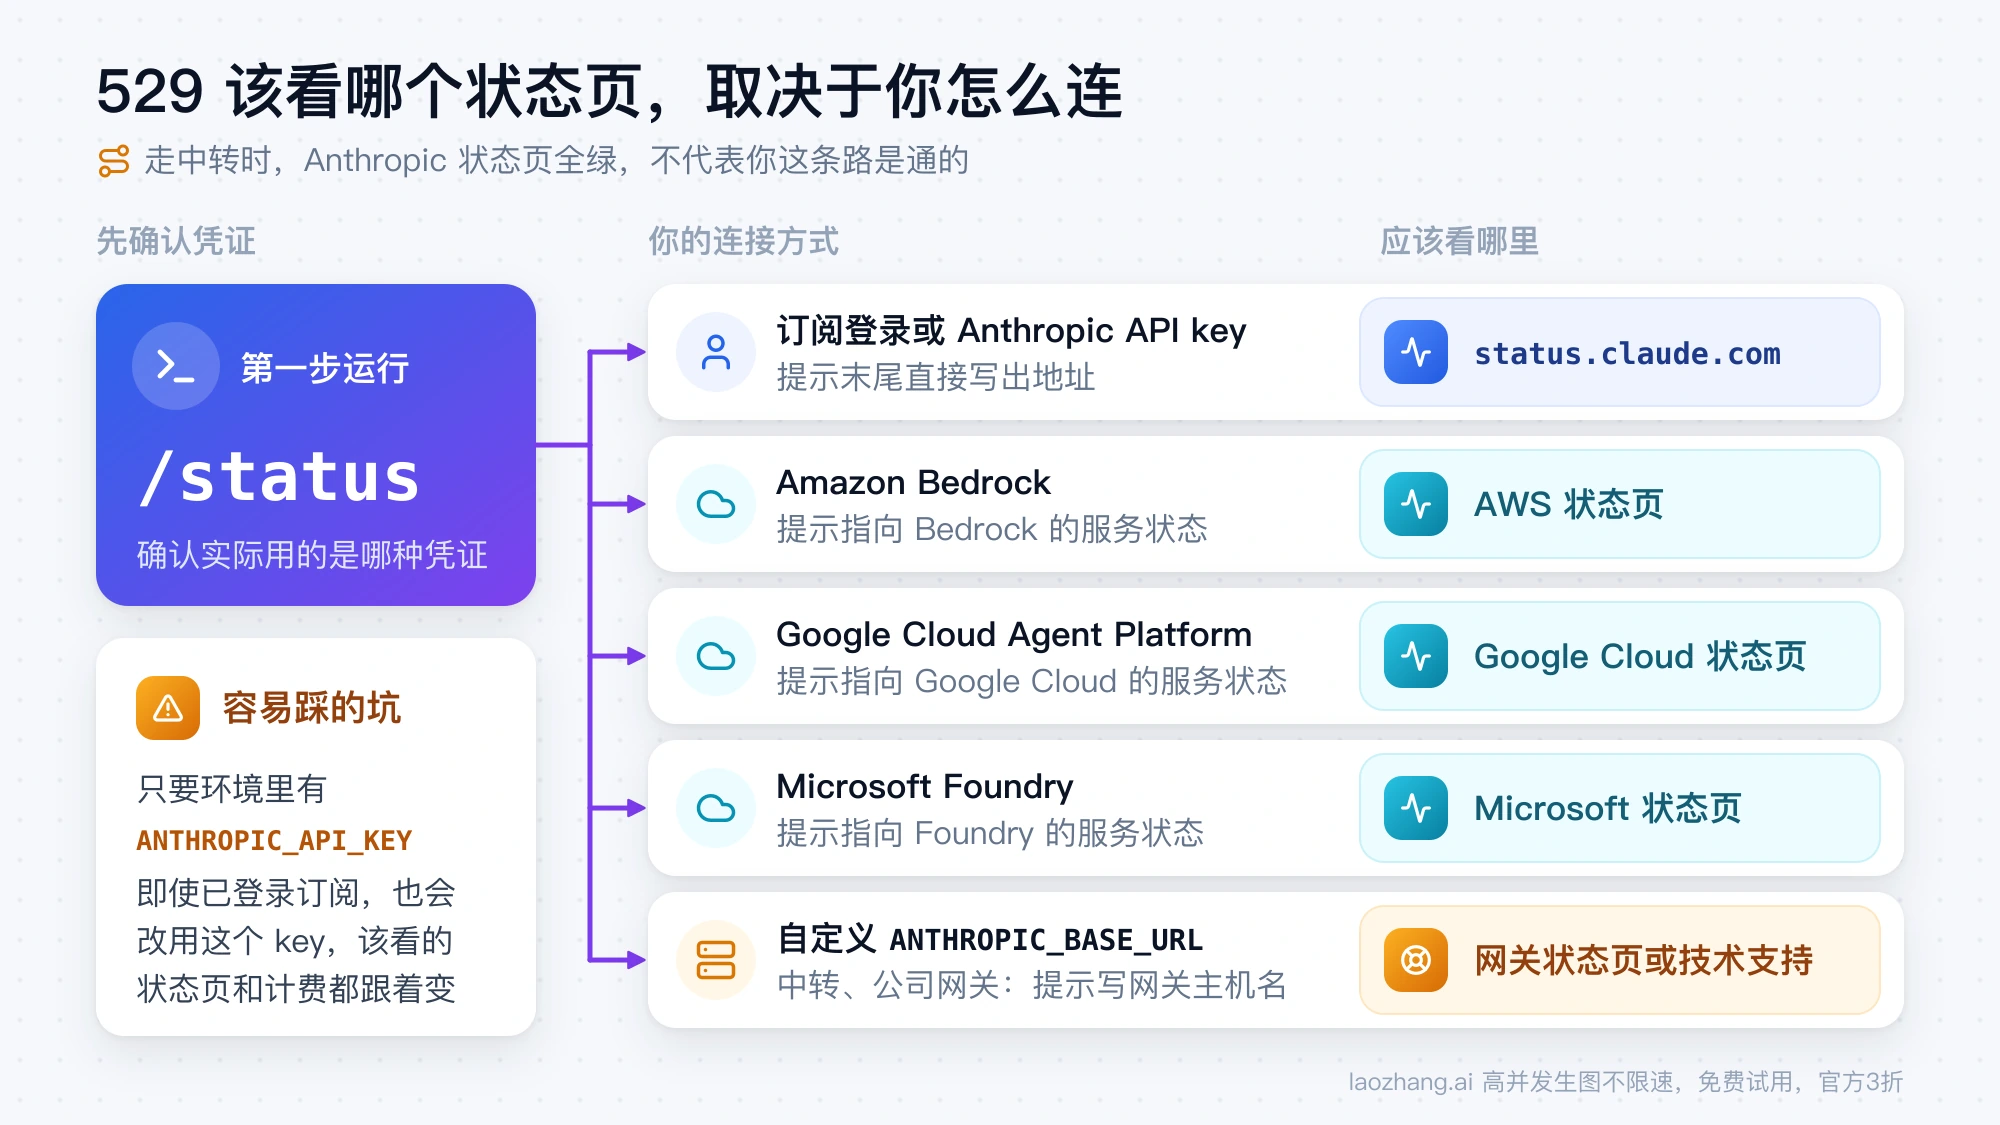
| 你的连接方式 | 提示末尾指向 | 应该看哪里 |
|---|---|---|
| Claude 订阅登录,或 Anthropic API key | https://status.claude.com | status.claude.com |
| Amazon Bedrock | Bedrock 的服务状态 | AWS 的服务状态页 |
| Google Cloud Agent Platform | Google Cloud 的服务状态 | Google Cloud 的服务状态页 |
| Microsoft Foundry | Foundry 的服务状态 | Microsoft 的服务状态页 |
自定义 ANTHROPIC_BASE_URL(中转、公司网关) | 网关的主机名 | 网关自己的状态页或技术支持 |
两个容易踩的坑:
以为在用订阅,其实在用 API key。 只要设置了 ANTHROPIC_API_KEY,即使已经登录订阅,Claude Code 也会改用这个 key(交互模式下会先请你确认一次)。想回到订阅,执行 unset ANTHROPIC_API_KEY。这不会让 529 消失,却会改变你该看的状态页和计费对象;如果屏幕上其实是 429,残留的 key 还可能让请求走到一个限额很低的档位。
走中转却只盯着 status.claude.com。 通过中转或网关连接时,提示里写的是网关主机名。这个 529 可能是网关自己返回的,也可能是它转发的上游过载,Anthropic 状态页一片绿色并不能说明你这条路是通的。先看网关的公告或问它的支持;改走另一家中转,也不代表上游模型的容量变多了。
另外,status.claude.com 的组件是按产品划分的(claude.ai、Claude API、Claude Code 等),没有按模型拆分。某个模型容量吃紧,要看事故标题里有没有它的名字;页面显示全部正常时,按模型切换仍然是官方给出的做法。
回复做到一半断了
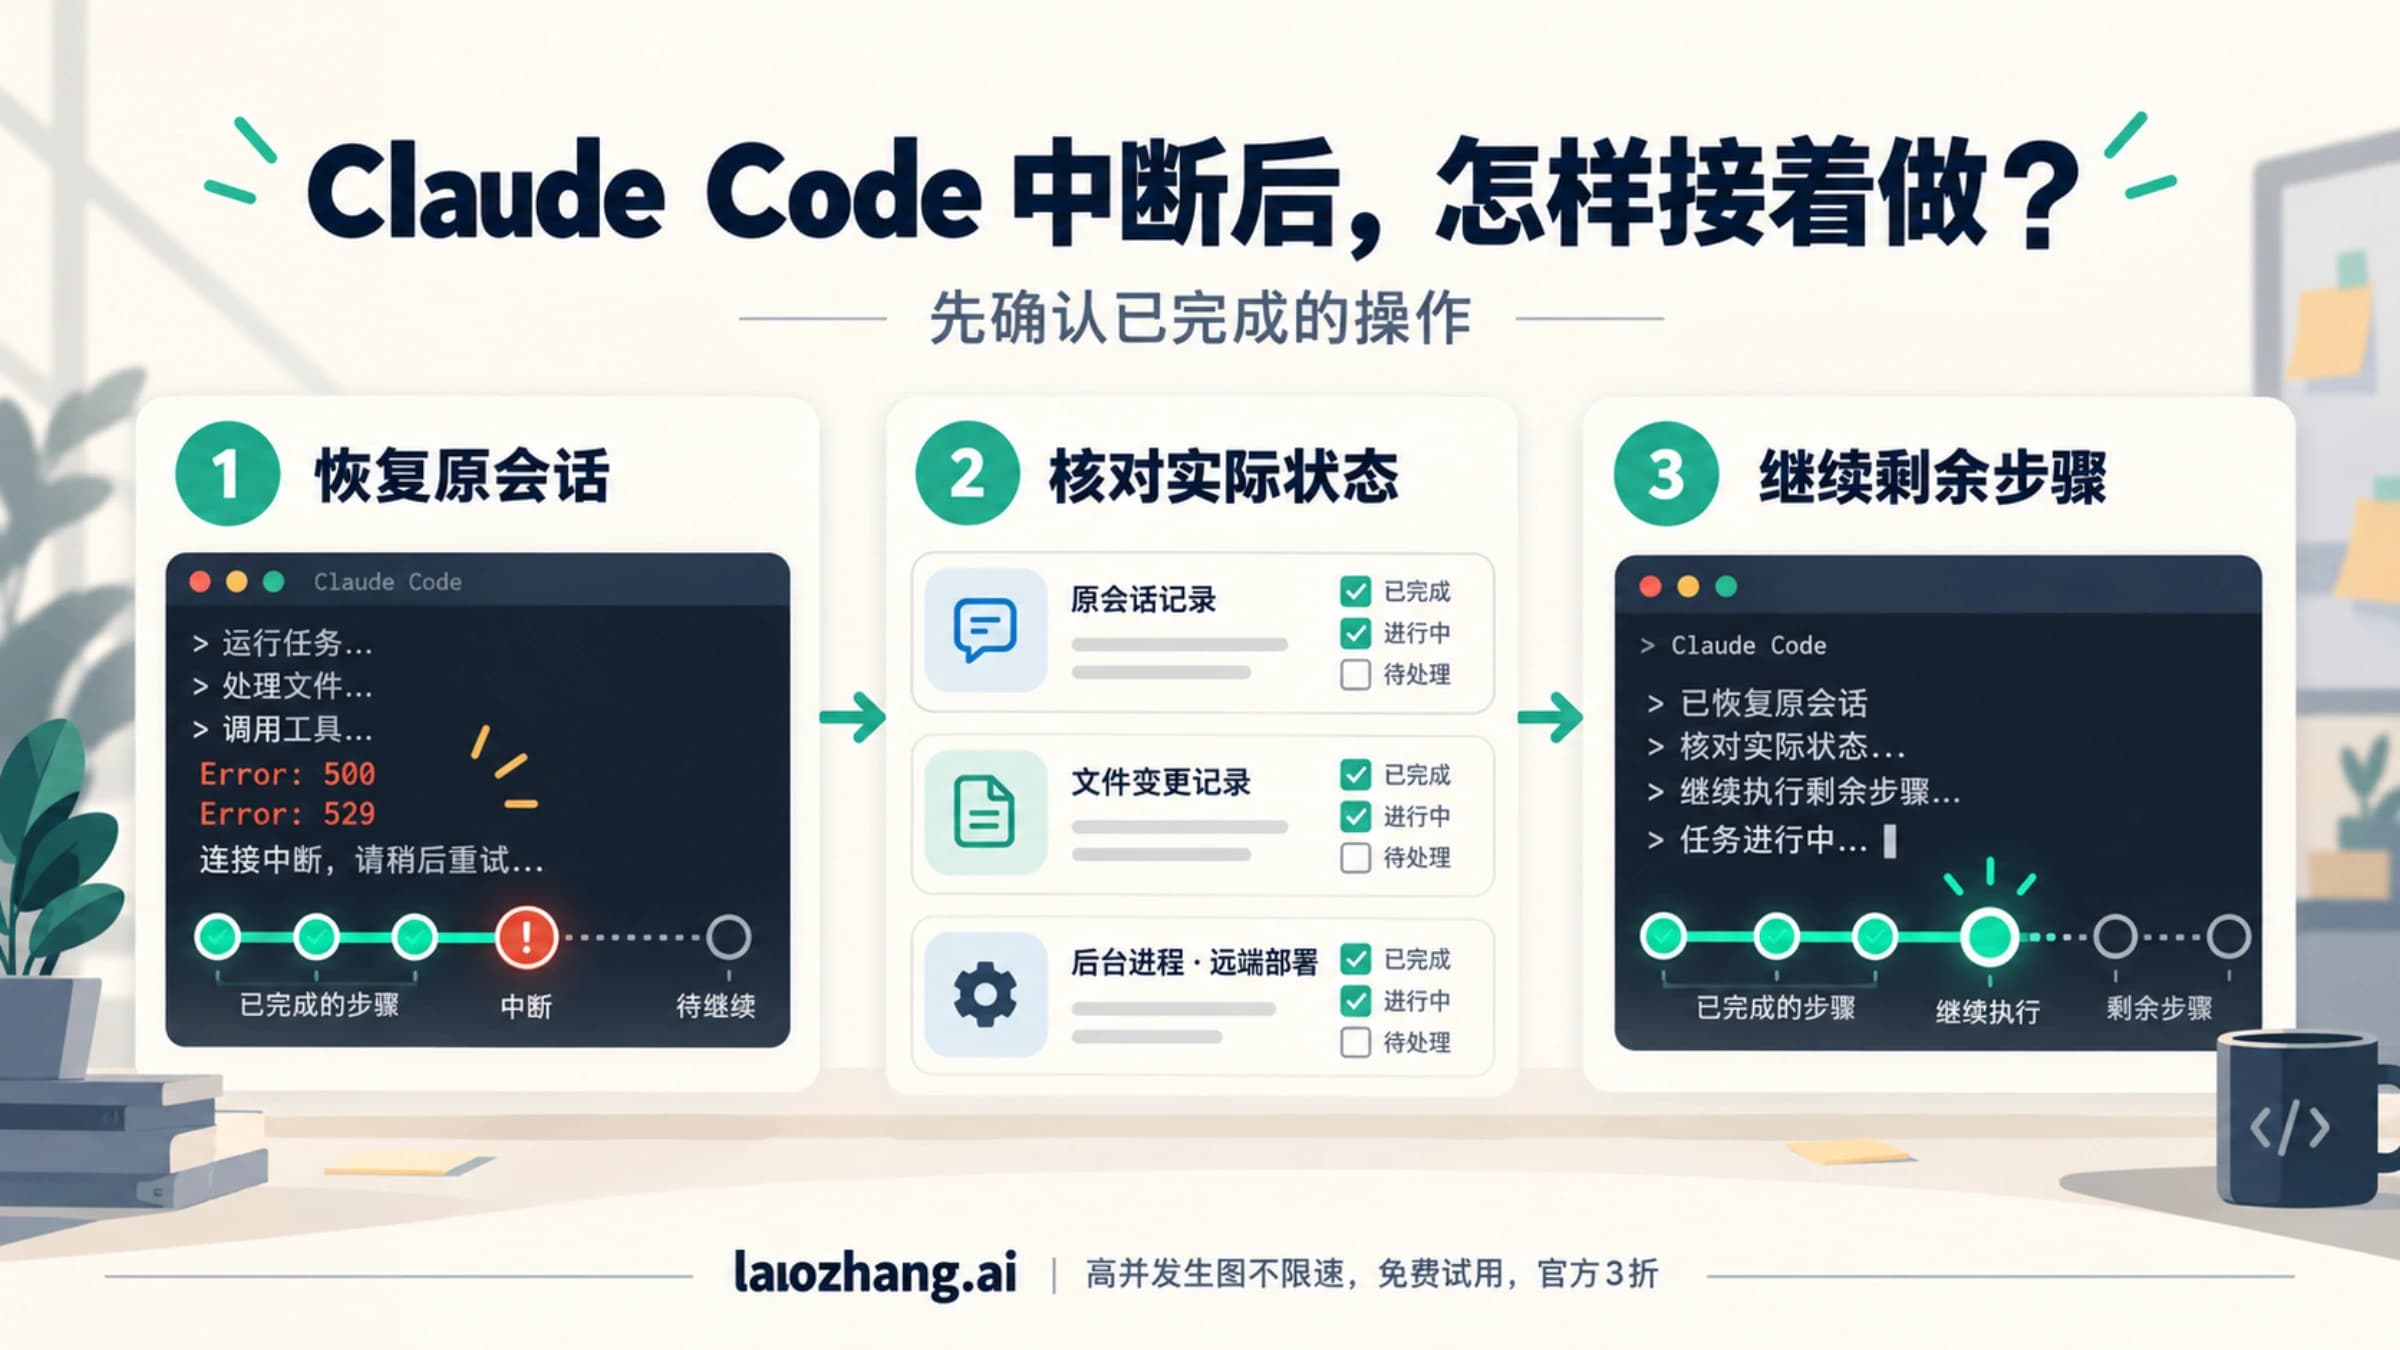
还有一种情况更麻烦:Claude 已经写完一段文字或执行完一个工具调用,这时遇到 529 或 5xx。v2.1.199 及以后,Claude Code 不会重发这次请求,因为重发可能把同一个工具调用再执行一遍。它会保留已经完成的输出,并在末尾追加:
API Error: Server error mid-response. The response above may be incomplete.这时别急着让它"重做一遍"。先确认哪些文件改动、命令、提交已经发生,再从断点接着交代。具体怎么核对副作用、续接会话,见 Claude Code API Error 500 怎么办:恢复原会话,不重做已完成操作。
什么时候停手上报
满足以下条件,就别再自己试了:
- 状态页,或提示里点名的云厂商、网关状态页,没有相关事故;
- 过了几分钟,并且换过至少一个其他模型,仍然反复报 529;
- 用
/status确认过,当前凭证就是你以为的那一个。
这时在 Claude Code 里运行 /feedback,它会把对话记录和你的描述发给 Anthropic,也可以顺手生成一个预填好的 GitHub issue。通过 Bedrock、Google Cloud Agent Platform、Foundry 或其他第三方服务连接,或者没有配置 Anthropic 凭证时,/feedback 只会在本地保存一个归档,需要你自己交给 Anthropic 的客户代表。在 shell 里运行 claude doctor 可以做一次只读的安装诊断;也可以先搜一下 GitHub 上的已有 issue。
描述里写清这些,排查会快很多:
- 完整的报错原文,以及出现时间和时区;
- 当时用的模型,换过哪些模型、结果如何;
/status显示的凭证和连接方式,是否设置了ANTHROPIC_BASE_URL;- 是否配置了备用模型链或
CLAUDE_CODE_RETRY_WATCHDOG; claude --version的输出。
常见问题
状态页显示全部正常,为什么还一直报 529?
状态页按产品列组件,不按模型拆分,单个模型的容量紧张不一定体现在组件颜色上。另外,如果你走的是云厂商或中转,status.claude.com 本来就不是该看的页面,以提示末尾点名的地址为准。无论哪种情况,先换一个模型试试。
把 CLAUDE_CODE_MAX_RETRIES 调大,能不能扛过去?
效果有限。v2.1.186 起这个值最多 15,只比默认的 10 多几次,而且换来的是更长的等待。交互使用时换模型更快;无人值守才需要 CLAUDE_CODE_RETRY_WATCHDOG=1,v2.1.199 起它会取消这个上限。
配了备用模型,会不会不知不觉多花钱?
取决于你的连接方式和备用链里放了哪个模型。走 API key 时,按实际使用的模型计费;走订阅时,Fable 的用量在部分套餐下从 usage credits 扣,而 -p 模式扣费前不会询问。备用链只在过载等服务端错误时生效,并且只管当前这一轮,下一条消息会回到主模型。
参考来源2
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年9月28日。
参考来源2
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年9月28日。