Grok Voice Agent API: подключение по WebSocket, звук, цена и аутентификация
Grok Voice Agent API работает через wss://api.x.ai/v1/realtime. Для первого голосового ответа настройте PCM 24 кГц, отправьте реплику и соберите аудиособытия в WAV. Сервер использует API-ключ, браузер — временный токен; 0,08 USD/мин рассчитываются по длительности сессии при VAD и по аудио при ручном управлении.
Содержание
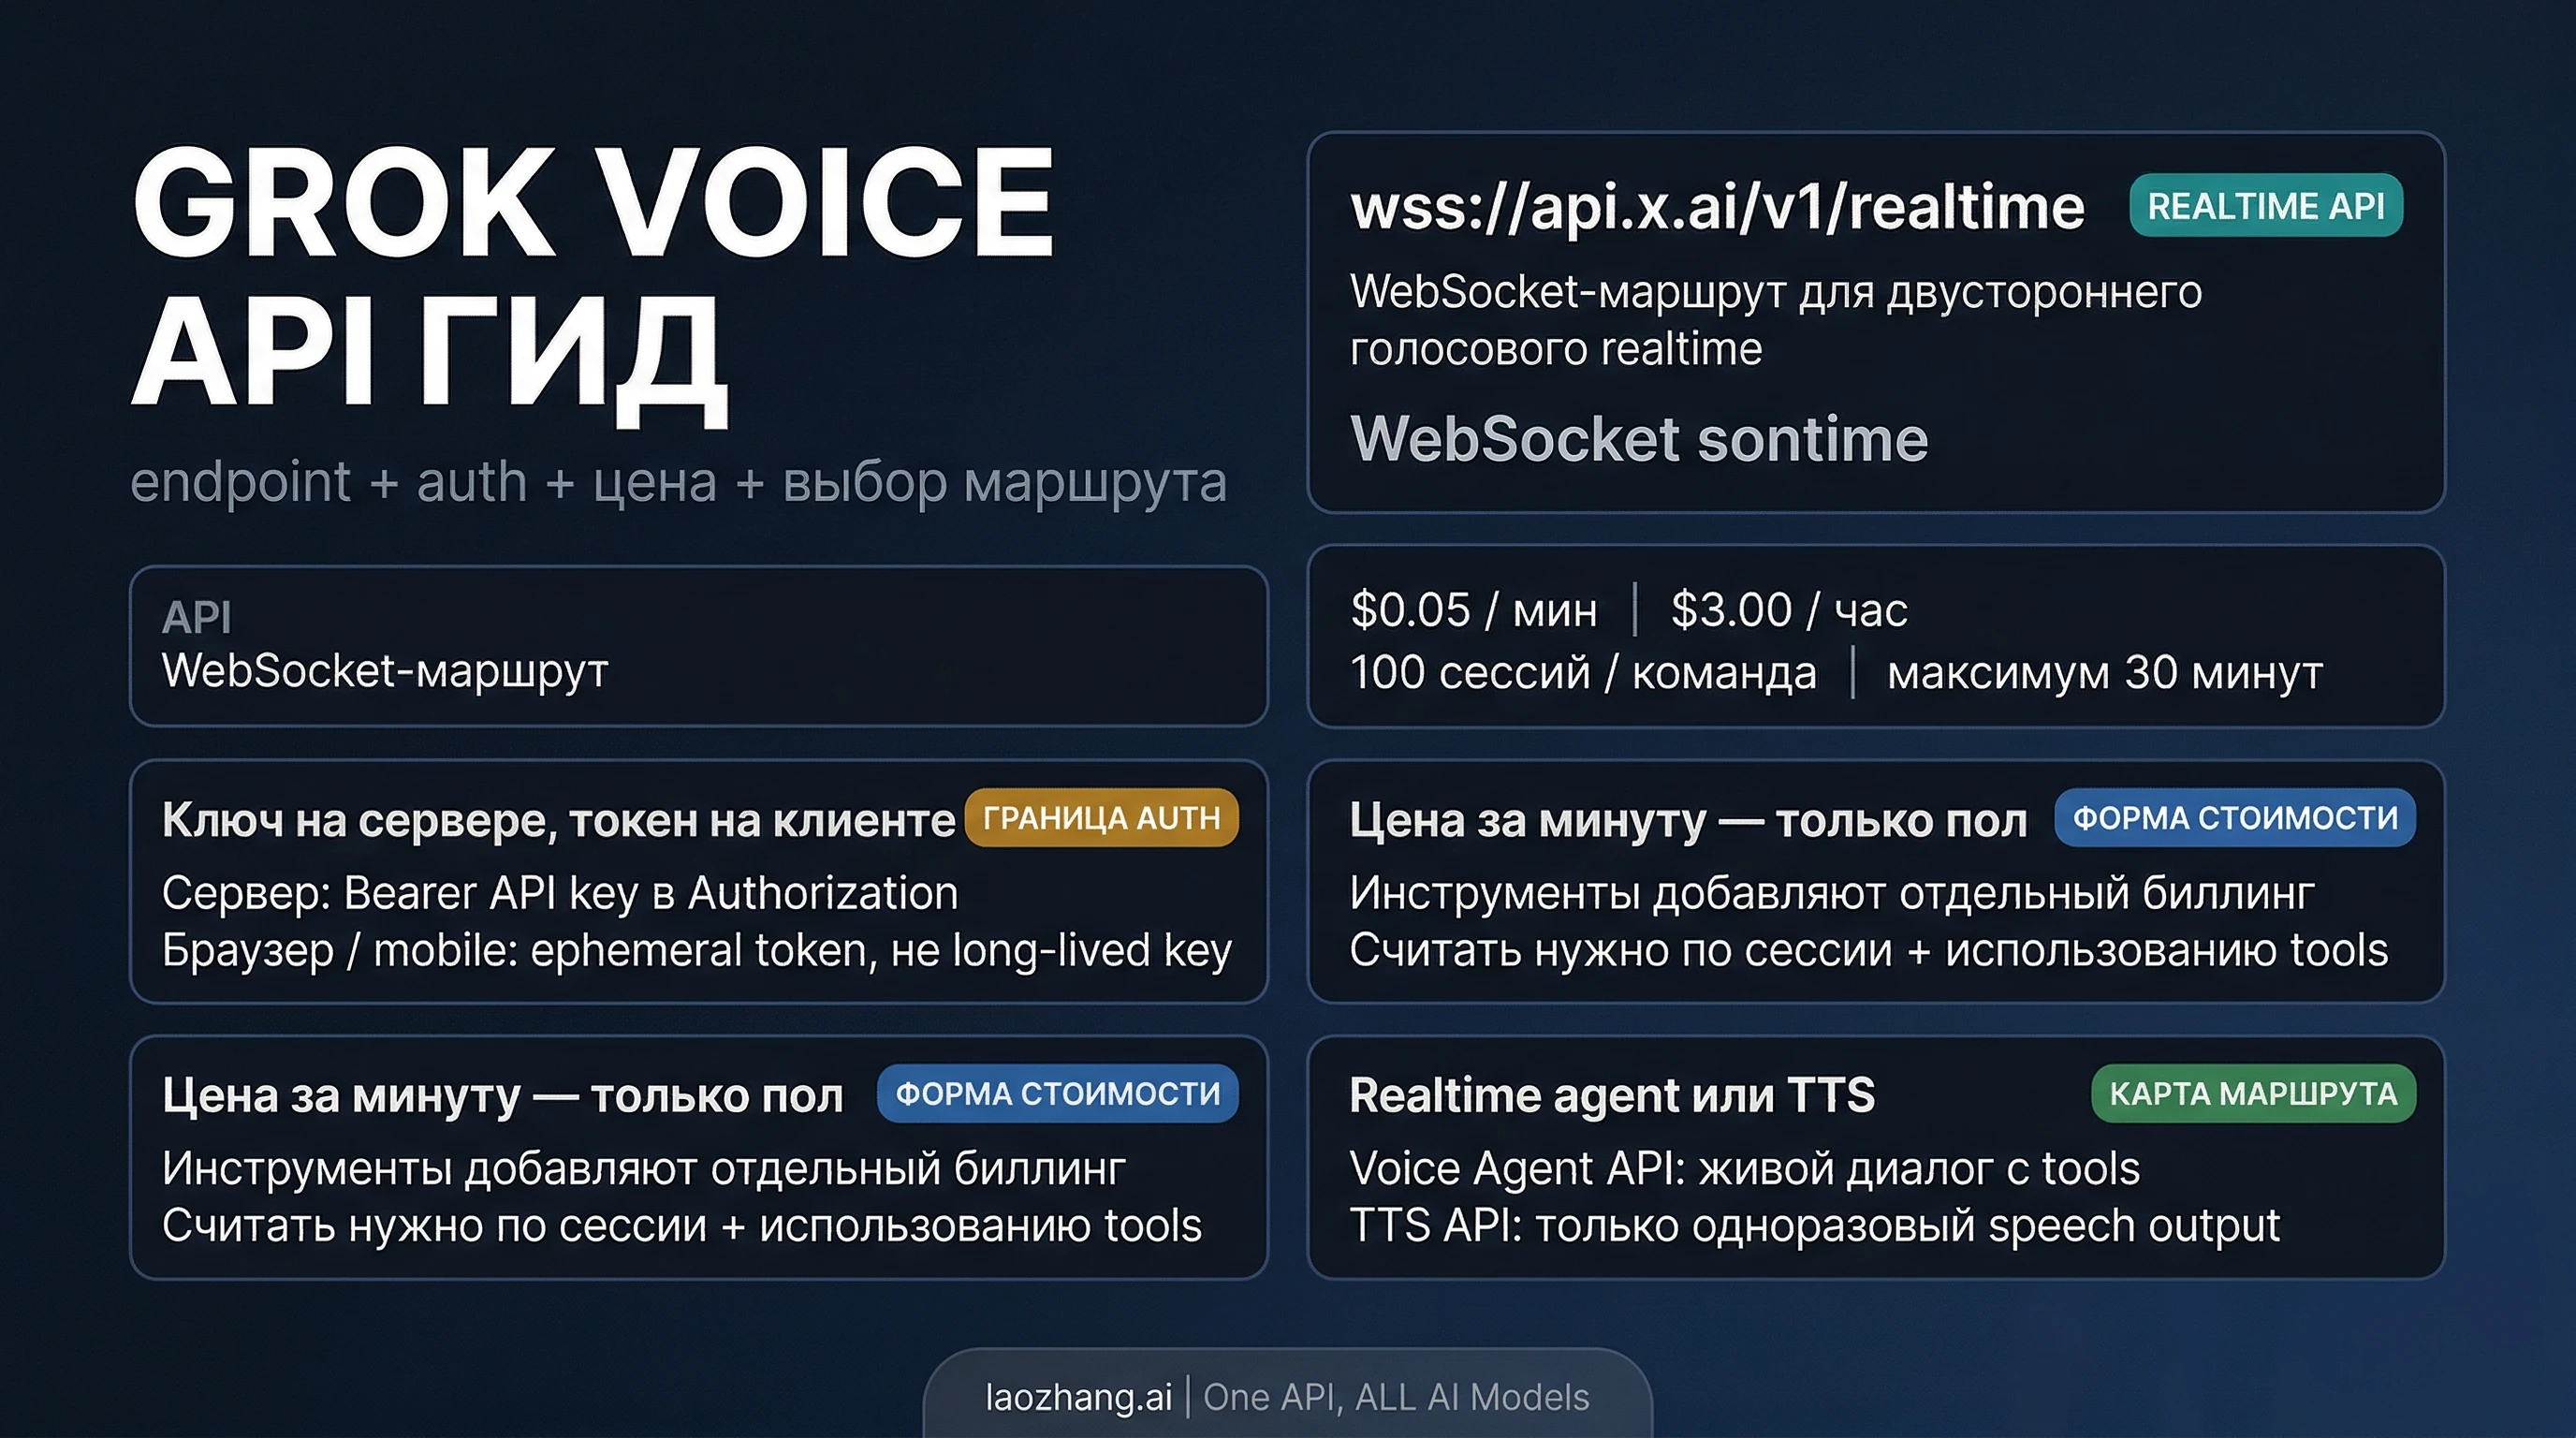
Для живого голосового диалога с Grok используйте wss://api.x.ai/v1/realtime. Сервер подключается с API-ключом, браузер — с временным токеном, который выдаёт ваш сервер. После session.update дождитесь session.updated, передайте реплику и обработайте response.output_audio.delta: одного успешного подключения недостаточно, чтобы пользователь услышал ответ. Документация подключения и событий xAI.
По состоянию на 7 октября 2026 года grok-voice-latest указывает на grok-voice-think-fast-2.0. Тариф составляет 0,08 USD/мин, но минуты считаются по-разному: в стандартном режиме server_vad оплачивается длительность сессии, включая паузы; при ручном управлении — входящее и исходящее аудио. Клиентские текстовые элементы имеют отдельную ставку 0,004 USD за элемент. Модель и правила оплаты.
Ниже — самостоятельный пример для Node.js: он принимает заранее подготовленный PCM или текст, получает голосовой ответ и сохраняет answer.wav. Такой первый шаг отделяет протокол xAI от захвата микрофона и воспроизведения в браузере. Пример основан на текущей документации; подключение к xAI, качество русской речи и реальное списание средств здесь не тестировались.
Первый голосовой ответ: PCM или текст на входе, WAV на выходе
Для примера нужны Node.js с поддержкой ES modules, пакет ws и API-ключ xAI, доступный только серверному процессу. Сохраните код как voice-once.mjs в отдельном каталоге проекта. Если передаёте аудио, файл question.pcm должен содержать моно PCM16 little-endian, 24 000 Гц, без заголовка контейнера. Переименование MP3 или WAV в .pcm формат не преобразует.
В этой реализации ходом управляет приложение: turn_detection.type равен null. Аудио передаётся через append → commit → response.create; для текста используются conversation.item.create → response.create. Формат ответа — тот же PCM16, а транспорт — JSON с base64. Эти условия следуют из руководства по аудио и справочника событий.
import WebSocket from "ws";
import { readFile, writeFile } from "node:fs/promises";
import { setTimeout as pause } from "node:timers/promises";

const sampleRate = 24_000;
const key = process.env.XAI_API_KEY;
if (!key) throw new Error("Серверу нужен XAI_API_KEY");

const inputPath = process.argv[2];
const input = inputPath ? await readFile(inputPath) : null;
if (input && (!input.length || input.length % 2)) {
  throw new Error("PCM16 должен быть непустым и содержать целые отсчёты");
}

function makeWav(pcm) {
  if (!pcm.length || pcm.length % 2) {
    throw new Error("Получен пустой или неполный PCM16");
  }
  const header = Buffer.alloc(44);
  header.write("RIFF", 0);
  header.writeUInt32LE(36 + pcm.length, 4);
  header.write("WAVE", 8);
  header.write("fmt ", 12);
  header.writeUInt32LE(16, 16);
  header.writeUInt16LE(1, 20); // PCM
  header.writeUInt16LE(1, 22); // моно
  header.writeUInt32LE(sampleRate, 24);
  header.writeUInt32LE(sampleRate * 2, 28);
  header.writeUInt16LE(2, 32);
  header.writeUInt16LE(16, 34);
  header.write("data", 36);
  header.writeUInt32LE(pcm.length, 40);
  return Buffer.concat([header, pcm]);
}

const socket = new WebSocket(
  "wss://api.x.ai/v1/realtime?model=grok-voice-think-fast-2.0",
  { headers: { Authorization: `Bearer ${key}` } },
);
const audioChunks = [];
let sentInput = false;
let finishing = false;
let activeResponse = false;
let hardClose;
const deadline = setTimeout(() => fail("Превышено время ожидания"), 60_000);

function send(event) {
  if (socket.readyState !== WebSocket.OPEN) {
    throw new Error("Соединение уже закрыто");
  }
  socket.send(JSON.stringify(event));
}

function shutdown() {
  clearTimeout(deadline);
  if (socket.readyState === WebSocket.OPEN) {
    socket.close(1000, "finished");
  }
  hardClose = setTimeout(() => socket.terminate(), 2_000);
  hardClose.unref();
}

function fail(message) {
  if (finishing) return;
  finishing = true;
  console.error(message);
  process.exitCode = 1;
  if (activeResponse && socket.readyState === WebSocket.OPEN) {
    send({ type: "response.cancel" });
  }
  shutdown();
}

async function submitInput() {
  if (sentInput || finishing) return;
  sentInput = true;
  if (input) {
    // 100 мс PCM16: 24 000 * 2 / 10 = 4 800 байт.
    for (let offset = 0; offset < input.length; offset += 4_800) {
      if (finishing) return;
      send({
        type: "input_audio_buffer.append",
        audio: input.subarray(offset, offset + 4_800).toString("base64"),
      });
      await pause(100);
    }
    send({ type: "input_audio_buffer.commit" });
  } else {
    send({
      type: "conversation.item.create",
      item: {
        type: "message",
        role: "user",
        content: [{
          type: "input_text",
          text: "Как подготовить короткое сообщение о переносе встречи?",
        }],
      },
    });
  }
  send({ type: "response.create", response: { modalities: ["audio"] } });
}

socket.on("open", () => {
  send({
    type: "session.update",
    session: {
      voice: "eve",
      instructions: "Отвечай по-русски. Предложи понятный вариант " +
        "сообщения в двух предложениях. Не придумывай дату и время встречи.",
      turn_detection: { type: null },
      audio: {
        input: { format: { type: "audio/pcm", rate: sampleRate }, transport: "json" },
        output: { format: { type: "audio/pcm", rate: sampleRate }, transport: "json" },
      },
    },
  });
});

socket.on("message", (data, isBinary) => {
  if (finishing) return;
  if (isBinary) return fail("Ожидался JSON-транспорт, получен бинарный кадр");
  let event;
  try {
    event = JSON.parse(data.toString());
  } catch {
    return fail("Не удалось разобрать событие сервера");
  }

  if (event.type === "session.updated") {
    submitInput().catch(error => fail(error.message));
  } else if (event.type === "response.created") {
    activeResponse = true;
  } else if (event.type === "response.output_audio.delta") {
    audioChunks.push(Buffer.from(event.delta, "base64"));
  } else if (event.type === "response.output_audio_transcript.delta") {
    process.stdout.write(event.delta);
  } else if (event.type === "response.text.delta" ||
             event.type === "response.output_text.delta") {
    process.stdout.write(event.delta);
  } else if (event.type === "error") {
    const error = event.error ?? {};
    console.error({ code: error.code, type: error.type,
      param: error.param, event_id: error.event_id });
    fail(error.message ?? "Ошибка API");
  } else if (event.type === "response.done") {
    activeResponse = false;
    const status = event.response?.status;
    if (status !== "completed") return fail(`Ответ завершён: ${status}`);
    finishing = true;
    clearTimeout(deadline);
    Promise.resolve().then(async () => {
      const pcm = Buffer.concat(audioChunks);
      await writeFile("answer.wav", makeWav(pcm));
      console.log(`\nЗаписан answer.wav: ${(pcm.length / 48_000).toFixed(2)} с`);
    }).catch(error => {
      process.exitCode = 1;
      console.error(error.message);
    }).finally(shutdown);
  }
});

socket.on("error", error => fail(`Ошибка соединения: ${error.message}`));
socket.on("close", (code, reason) => {
  clearTimeout(deadline);
  clearTimeout(hardClose);
  if (!finishing) fail(`Соединение закрылось до ответа: ${code}, ${reason}`);
});
process.once("SIGINT", () => fail("Остановлено пользователем"));
Чтобы установить зависимость и затем запустить пример в своём серверном окружении:
npm install ws
node voice-once.mjs question.pcm
Ключ задайте через механизм секретов вашего окружения, не добавляйте его в файл или команду, которая сохранится в истории. Запуск без аргумента — node voice-once.mjs — отправляет встроенный текст вместо аудио. Такой режим помогает проверить голосовой вывод отдельно от подготовки входного PCM.
Успешный результат: получено подтверждение настройки, затем аудиодельты, response.done со статусом completed и непустой файл answer.wav, который воспроизводится обычным аудиоплеером. Длительность PCM при этих настройках равна число байт / 48 000. Надпись «соединение открыто» или появившаяся расшифровка без звука этот результат не заменяют.
Это пример одного ответа с сохранением файла, а не готовый потоковый плеер. Он закрывает сессию после записи и завершает процесс с ошибкой при сбое. В длительном диалоге восстанавливаемые ошибки лучше обрабатывать по отдельности; WAV-накопление также заменяют ограниченной очередью воспроизведения, чтобы не хранить всю сессию в памяти.
Аутентификация браузера: временный токен вместо серверного ключа
В браузере постоянный API-ключ нельзя считать секретом: он доступен клиенту. Кроме того, стандартный браузерный WebSocket не позволяет задать произвольный заголовок Authorization. Для прямого браузерного подключения xAI документирует временный секрет и подпротокол xai-client-secret.<TOKEN>. Руководство по временным токенам.
Порядок следующий:
- Пользователь входит в ваше приложение. Ваш сервер проверяет его право начать голосовую сессию и доступный бюджет.
- Сервер обращается к
POST https://api.x.ai/v1/realtime/client_secrets, используя свойAuthorization: Bearer …. - Браузеру возвращаются только
valueиexpires_atиз ответа, без постоянного ключа. Ответ вашего сервера не кэшируется, секрет не пишется в журнал. - Браузер открывает соединение с временным секретом, затем выполняет настройку и обмен аудио.
Минимальное тело запроса на выпуск токена:
{
  "expires_after": { "seconds": 300 }
}
В браузерной части, после получения токена от уже защищённого сервера приложения, подключение выглядит так:
const socket = new WebSocket(
  "wss://api.x.ai/v1/realtime?model=grok-voice-think-fast-2.0",
  [`xai-client-secret.${token.value}`],
);
Здесь token — результат вашего серверного запроса, а не постоянный API-ключ. Сам обработчик выдачи токенов требует существующей аутентификации приложения и ограничения частоты запросов; открытый URL, выдающий секрет всем посетителям, позволяет расходовать ваш бюджет.
Срок токена и максимальная длительность сессии — разные параметры. В справочнике выпуска секретов указаны 600 секунд по умолчанию и максимум 3 600 секунд. Запрос выше выбирает 300 секунд. Не превращайте это значение в таймер разговора: опубликованный предел самой сессии — 120 минут.
Есть различие между документами: руководство по ephemeral tokens говорит, что поля session и anchor не поддерживаются, а текущий REST-справочник описывает опциональную начальную конфигурацию session. Для базового подключения используйте показанный минимальный запрос без этих полей. На таком основании нельзя обещать, что токен всегда привязан к выбранной модели или что дополнительные поля всегда будут отвергнуты.
Живой диалог: конец реплики, воспроизведение и прерывание
Выберите один способ завершать пользовательскую реплику
При server_vad сервер сам определяет начало и конец речи. Приложение отправляет input_audio_buffer.append; дополнительный commit или response.create после каждой паузы здесь не нужен. Для кнопки «говорить» используйте ручной режим из примера: отправьте накопленное аудио, затем один commit и один response.create. Управление аудиобуфером.
| Ввод | Кто завершает реплику | Что отправляет приложение |
|---|---|---|
Непрерывная речь, server_vad | Сервер | Аудиофрагменты через append |
Речь с кнопкой, type: null | Приложение | append, затем commit и response.create |
| Готовый текст | Приложение | Текстовый conversation.item.create, затем response.create |
В публичной JSON-схеме поле turn_detection.type описано как строка, хотя руководство и справочник явно разрешают null для ручного режима. Пример выше следует этому документированному режиму; расхождение схемы не является результатом проверки сервера.
Звук нужно действительно воспроизвести
response.output_audio.delta содержит звук, а response.output_audio_transcript.delta — текст того, что произносит ассистент. При JSON-транспорте декодируйте base64 в PCM16. Для потокового браузерного плеера преобразуйте signed 16-bit little-endian отсчёты в float-значения и подавайте их в очередь с частотой, совпадающей с audio.output.format.rate. Не отдавайте сырой PCM контейнерному декодеру как MP3.
Практичная очередь учитывает три величины: сколько аудио получено, сколько запланировано на воспроизведение и сколько уже услышал пользователь. Добавляйте каждый фрагмент после конца предыдущего, а не запускайте все фрагменты одновременно. В нашем файловом примере очередь заменена сборкой WAV; для разговора это увеличило бы задержку, поэтому звук обычно проигрывают по мере поступления.
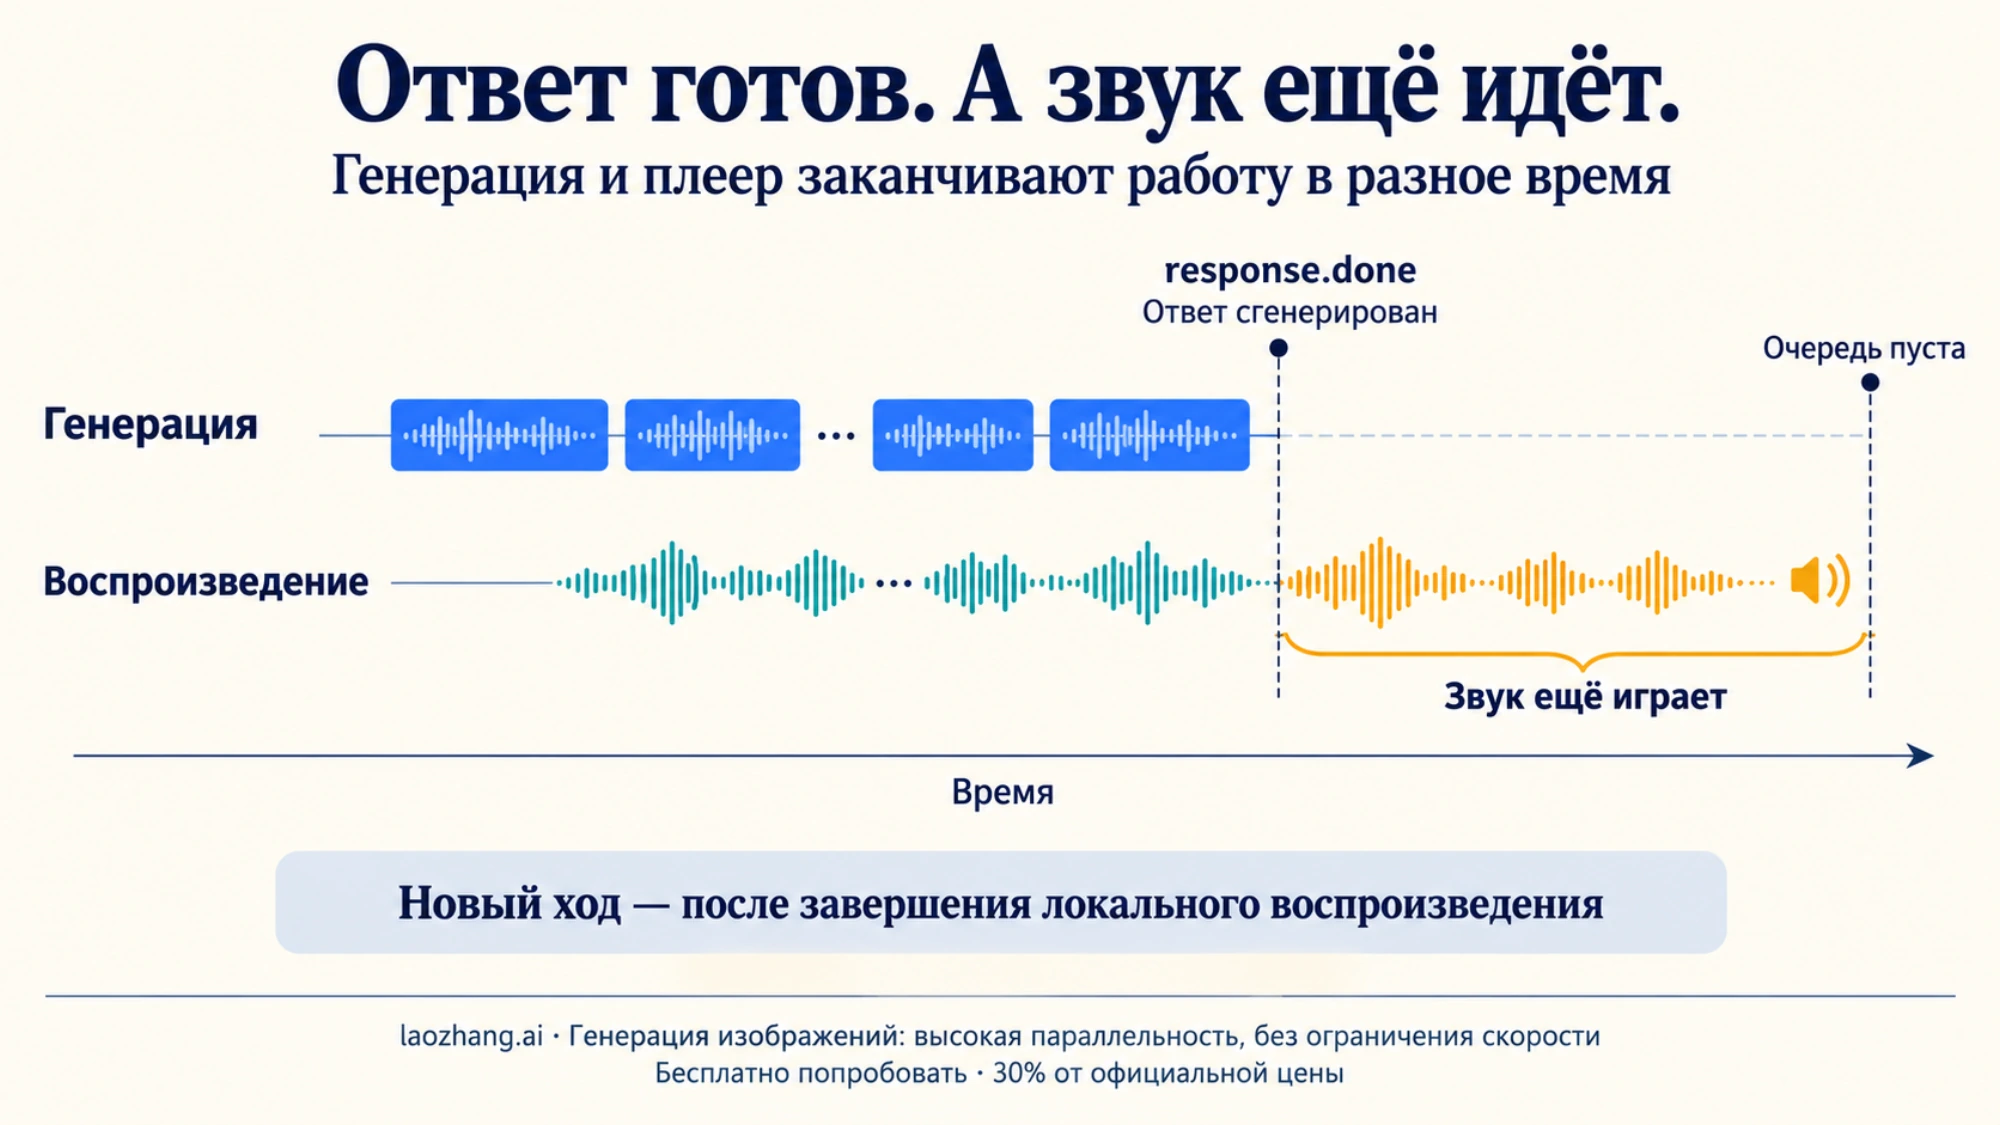
response.output_audio.done завершает генерацию аудио; response.done завершает ответ модели. Ни одно из этих событий не означает, что динамик уже доиграл очередь. Это важно при продолжении ответа после вызова функции и при показе состояния «можно говорить».
Если нужны живые субтитры пользовательской речи, настройте audio.input.transcription.model: "grok-transcribe" и language_hint: "ru". Событие conversation.item.input_audio_transcription.updated содержит накопленную расшифровку с возможными исправлениями: заменяйте отображаемый текст, а не дописывайте его как дельту. Язык распознавания не задаёт язык ответа — русский ответ задаётся отдельно в instructions. Особенности событий и языковых подсказок.
При перебивании остановите и генерацию, и локальный звук
Получив input_audio_buffer.speech_started в режиме VAD, остановите текущий звук и очистите локальную очередь: серверное прерывание не убирает уже полученные браузером фрагменты. В ручном режиме для отмены генерации используется response.cancel.
Чтобы история не сохраняла реплику так, будто пользователь услышал её полностью, отправьте conversation.item.truncate с ID сообщения ассистента, индексом аудиочасти и длительностью фактически воспроизведённого звука:
{
  "type": "conversation.item.truncate",
  "item_id": "assistant_item_id",
  "content_index": 0,
  "audio_end_ms": 1200
}
В этом примере 1 200 мс — условный результат счётчика плеера, не длительность всего полученного ответа. ID берите из событий реального сообщения. Сервер подтверждает действие событием conversation.item.truncated; аудио и расшифровка после указанной точки удаляются из элемента истории. Текущий API поддерживает это действие, поэтому старое утверждение о неподдерживаемом truncate больше не подходит. Текущий справочник.
Формат аудио и транспорт: что можно отправлять в WebSocket
Кодек определяет содержимое аудиобайтов, транспорт — способ их передачи. В примере выбран audio/pcm и transport: "json", то есть PCM передаётся внутри JSON как base64. Бинарный транспорт передаёт сырой аудиофрагмент отдельным бинарным кадром WebSocket; события жизненного цикла и расшифровки остаются JSON. Описание транспорта.
| Кодек | Данные на входе | Частота |
|---|---|---|
audio/pcm | Linear16 little-endian | Настраиваемая; пример использует 24 кГц |
audio/pcmu | Сырой G.711 μ-law | 8 кГц |
audio/pcma | Сырой G.711 A-law | 8 кГц |
audio/opus | Сырые Opus-пакеты, один пакет на payload | 24 кГц, моно |
Входной и выходной кодеки настраиваются независимо. Когда входной формат указан, сервер принимает и JSON append, и бинарные кадры этого кодека; на выходе используется только выбранный транспорт. Изменение выходного транспорта вступает в силу со следующего ответа, а не посередине текущей реплики.
В браузере запись через MediaRecorder часто даёт контейнер WebM/Opus. Это не тот же поток, что сырые Opus-пакеты. Либо подготовьте нужный PCM в аудиоконвейере, либо корректно извлеките и передайте подходящие пакеты. Для первой интеграции PCM с явной частотой обычно проще диагностировать.
В Node.js ws может возвращать Buffer и для текстового JSON-кадра. Проверяйте аргумент isBinary, как в примере, а не Buffer.isBuffer(data): тип объекта в памяти не определяет тип кадра на проводе.
Вызов функции: модель просит действие, приложение возвращает результат
Для доступа к вашей системе определите инструмент типа function в session.update. Например, голосовой помощник может проверить статус заявки через lookup_ticket с единственным обязательным параметром ticket_id. Ограничьте схему нужными полями, а на сервере повторно проверьте ID и право пользователя видеть заявку.
Обмен состоит из четырёх действий:
- Получить
response.function_call_arguments.doneсname,call_idи строкой JSONarguments. - Проверить имя по списку разрешённых функций, разобрать аргументы и выполнить разрешённый запрос в вашей системе.
- Вернуть результат через
conversation.item.createсitem.type: "function_call_output", тем жеcall_idи JSON-строкой вoutput. - После всех результатов текущего набора вызовов и завершения предыдущего воспроизведения отправить один
response.create.
Форма ответа приложения, где значения показаны как пример структуры:
{
  "type": "conversation.item.create",
  "item": {
    "type": "function_call_output",
    "call_id": "call_id_from_event",
    "output": "{\"ticket_id\":\"REQ-214\",\"status\":\"awaiting_documents\"}"
  }
}
Здесь нет доказательства, что REQ-214 существует или запрос выполнен. В рабочем приложении output формируется из результата вашего обработчика, включая явный отказ или ошибку. Фраза модели «я проверил заявку» также не заменяет выполнения функции. Документированный цикл custom functions.
Не запускайте продолжение по каждому параллельному вызову отдельно: сначала соберите результаты. И не путайте конец генерации с концом воспроизведения — иначе новая речь начнётся поверх старой. Для действий с побочными эффектами дополнительно храните результат по call_id или собственному ключу идемпотентности, чтобы повтор события не создал повторное действие.
Если нужно произнести заранее определённую фразу, force_message запускает синтез этой строки, а не новый ответ модели: после него не отправляют response.create. При interruptible: false входное аудио пользователя во время этой реплики отбрасывается. Это поведение нужно учитывать при построении диалога. Описание force message.
Ошибки, закрытие соединения и восстановление истории
Сохраняйте диагностические поля error.type, code, message, param, event_id и код закрытия WebSocket, но не ключи и временные секреты. Ошибка API и обрыв транспорта — разные события. Большинство ошибок API допускают продолжение сессии; наш одноразовый пример намеренно завершает её, чтобы не выдать неполный файл за результат. События и схема ошибок.
| Симптом | Что проверить первым | Признак, который поможет сузить причину |
|---|---|---|
| Соединение не открывается | Правильный endpoint, серверный заголовок или браузерный подпротокол | Ошибка подключения и HTTP upgrade; код 101 означает переход к WebSocket |
Пришёл invalid_request или invalid_event | Имя события, поля и текущий режим реплики | param и event_id, связанные с отправленным сообщением |
| Расшифровка есть, звука нет | Аудиодельты, audio.output.transport, кодек и плеер | Если байты пришли, проверяйте преобразование и воспроизведение; если нет — настройки ответа |
| Голос ускорен или замедлен | Совпадение частоты PCM и частоты плеера | 24 000 отсчётов моно PCM16 занимают 48 000 байт и одну секунду при 24 кГц |
response.done пришёл без готового ответа | response.status и полноту аудио | cancelled и incomplete не равны completed |
| Сессия оборвалась по времени | Собственный таймер, timeout/max_duration, код закрытия | Длительность соединения и событие ошибки, а не только срок токена |
При internal_error или временном обрыве повторное подключение делайте с ограниченным числом попыток и задержкой. Не повторяйте автоматически операции с побочными эффектами. Само имя ошибки не доказывает проблему ключа, региона или оплаты.
Для сохранения контекста при обрыве включите resumption: { enabled: true } в исходной сессии, сохраните conversation.id из conversation.created, а при повторном подключении передайте его через query-параметр conversation_id. В новой сессии снова включите resumption. Кэш хранит реплики, расшифровки и результаты функций и истекает после 30 минут бездействия; это не бессрочная память приложения. Восстановление сессии.
Руководство описывает повтор истории через conversation.item.created, а текущий справочник называет событие новых элементов conversation.item.added. Обработчик восстановления может принимать оба имени, сохраняя их назначение. Воспроизведённый элемент истории не является новой командой выполнить функцию: используйте сохранённый результат и не повторяйте действие.
Цена Grok Voice API: сколько оплачивается при VAD и ручном ходе
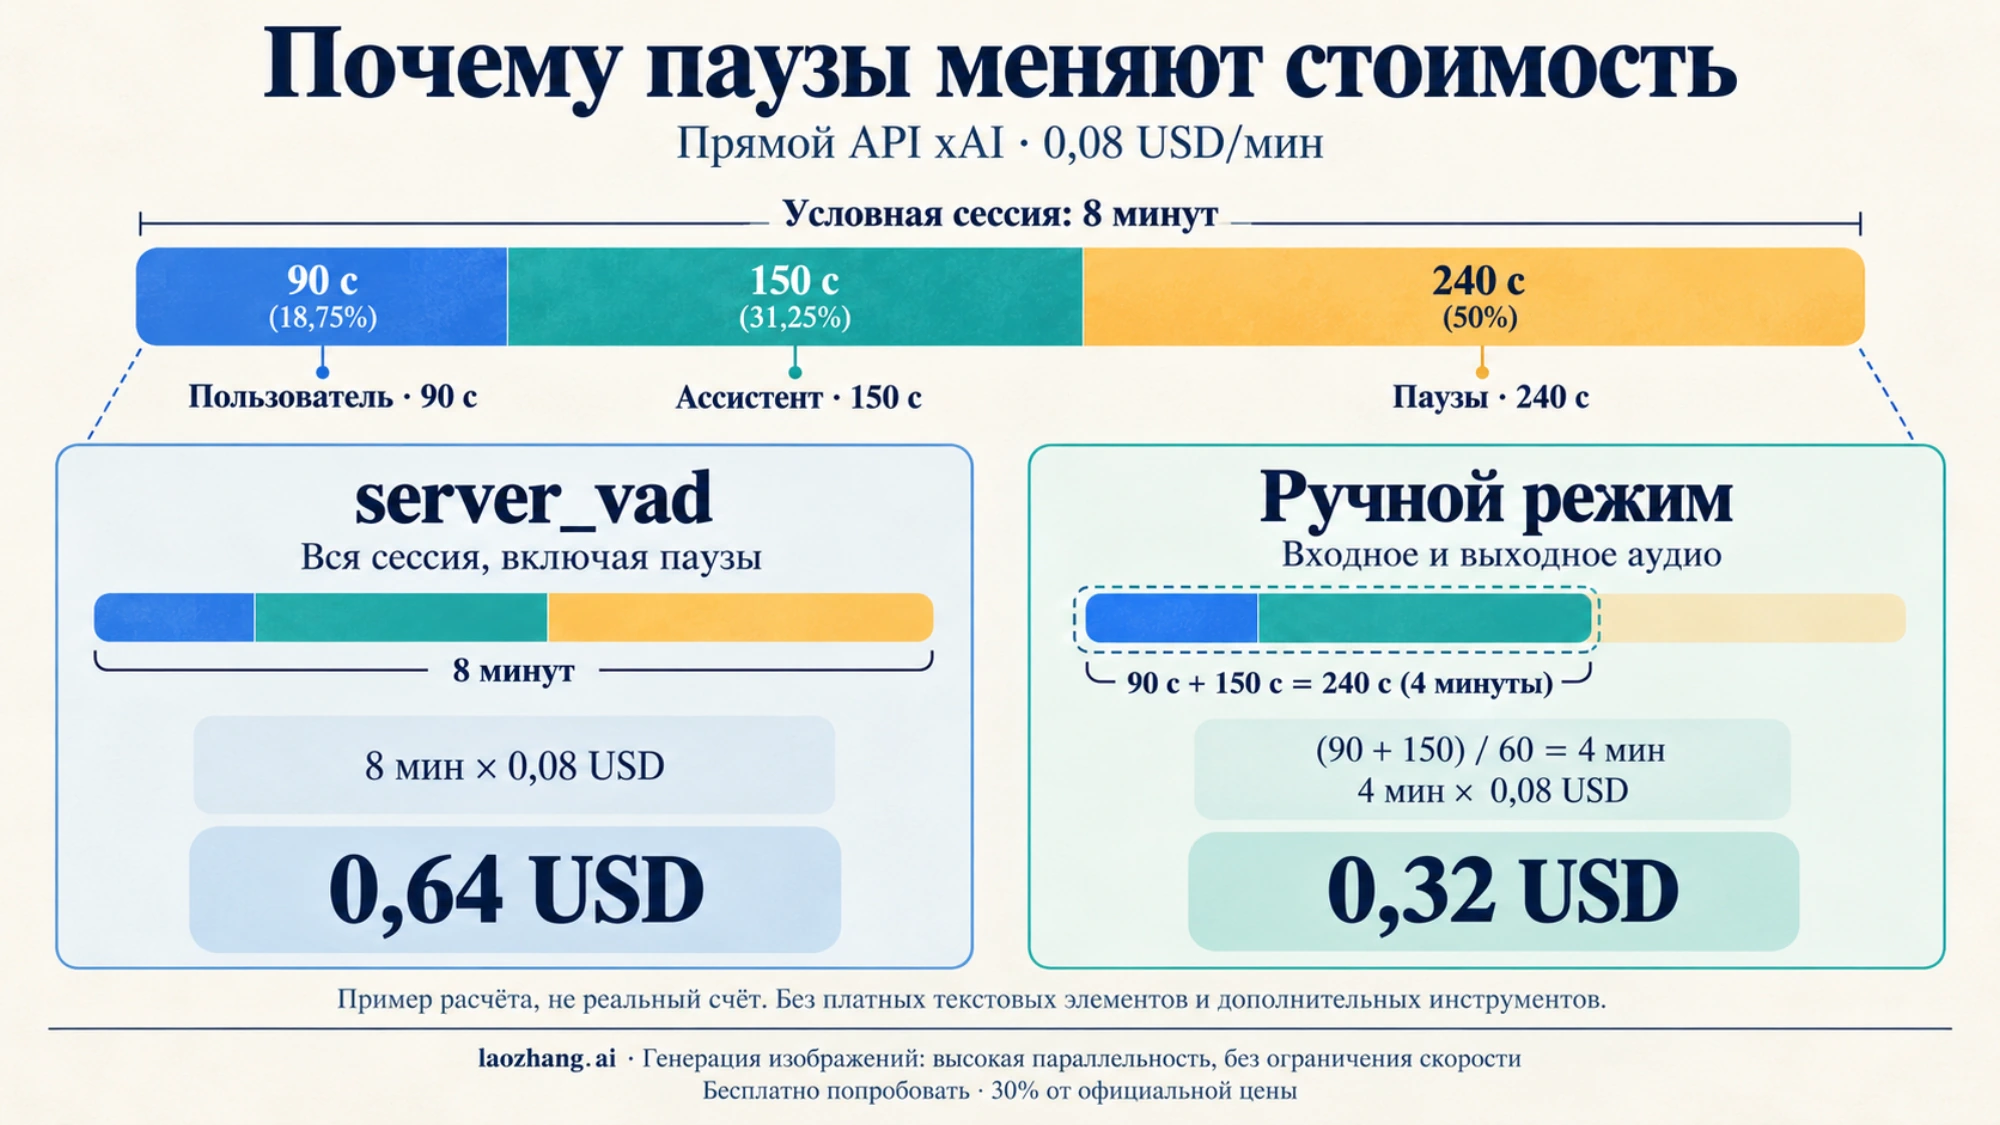
Ставка прямого API xAI — 0,08 USD за минуту, или 4,80 USD за час. В стандартном server_vad тарифицируется время сессии, включая тишину; при push-to-talk — длительность переданного входного и полученного выходного аудио. Текстовые conversation.item.create стоят 0,004 USD за элемент; исключены function_call_output и элементы с input_audio/audio, которые относятся к аудиотарификации. Сам response.create не является платным текстовым элементом, но возникшее в результате аудио оплачивается. Карточка модели, прайс xAI.
Для оценки можно взять условный разговор длительностью 8 минут: пользователь говорил 90 секунд, ассистент — 150 секунд. Без платных дополнительных инструментов и текстовых элементов:
| Режим | Расчёт голосовой части | Оценка |
|---|---|---|
server_vad | 8 × 0,08 USD | 0,64 USD |
| Ручное управление | (90 + 150) / 60 × 0,08 USD | 0,32 USD |
| Отдельные 12 клиентских текстовых элементов | 12 × 0,004 USD | 0,048 USD дополнительно |
Это арифметический пример по опубликованным правилам, а не реальный счёт. Он показывает цену пауз, но не доказывает, что ручной режим лучше для любого продукта: естественный разговор без кнопки и контролируемый ввод решают разные задачи. Для Node-примера без аудиофайла появляется один клиентский текстовый элемент; к его 0,004 USD добавляется голосовой ответ по соответствующей длительности.
В бюджете отдельно учитывайте встроенный поиск, внешние сервисы, телефонию и инфраструктуру приложения по применимым условиям. Общая таблица инструментов xAI не даёт оснований объявить каждый custom function платным по одной фиксированной ставке. Например, web search имеет единицу «вызов», а X search — «полученный пост» и «профиль»: универсальная цена «за вызов X» здесь неточна. Не переносите токенные ставки текстовых моделей в минутную тарификацию голоса.
Поля usage.input_tokens, output_tokens и total_tokens в response.done полезны для диагностики, но не являются окончательным денежным счётом. Публичная схема не обещает универсальные поля billable_audio_seconds или cost_in_usd_ticks. Для фактических расходов нужна сверка с учётом провайдера.
Опубликованные пределы этой модели — 10 одновременных сессий на команду, 120 минут на сессию, регион us-east-1. Это разные ограничения: срок временного токена не увеличивает параллелизм, а заявленная более широкая инфраструктура не подтверждает иной регион для вашего аккаунта. Лимиты модели.
Когда выбрать Voice Agent API, STT, TTS или готовый медиастек
Выбирайте Voice Agent API, если приложение должно слушать пользователя, управлять очередностью реплик, отвечать голосом и вызывать инструменты в контексте разговора. Для одного преобразования текста в речь или аудио в текст отдельный маршрут проще по смыслу и не требует истории диалога. Текущие голосовые продукты xAI.
| Задача | Маршрут | Что получает приложение |
|---|---|---|
| Живой двусторонний разговор | wss://api.x.ai/v1/realtime | События диалога, голосовой ответ, расшифровка и вызовы инструментов |
| Прочитать готовый текст | POST /v1/tts или потоковый TTS WebSocket | Синтезированную речь |
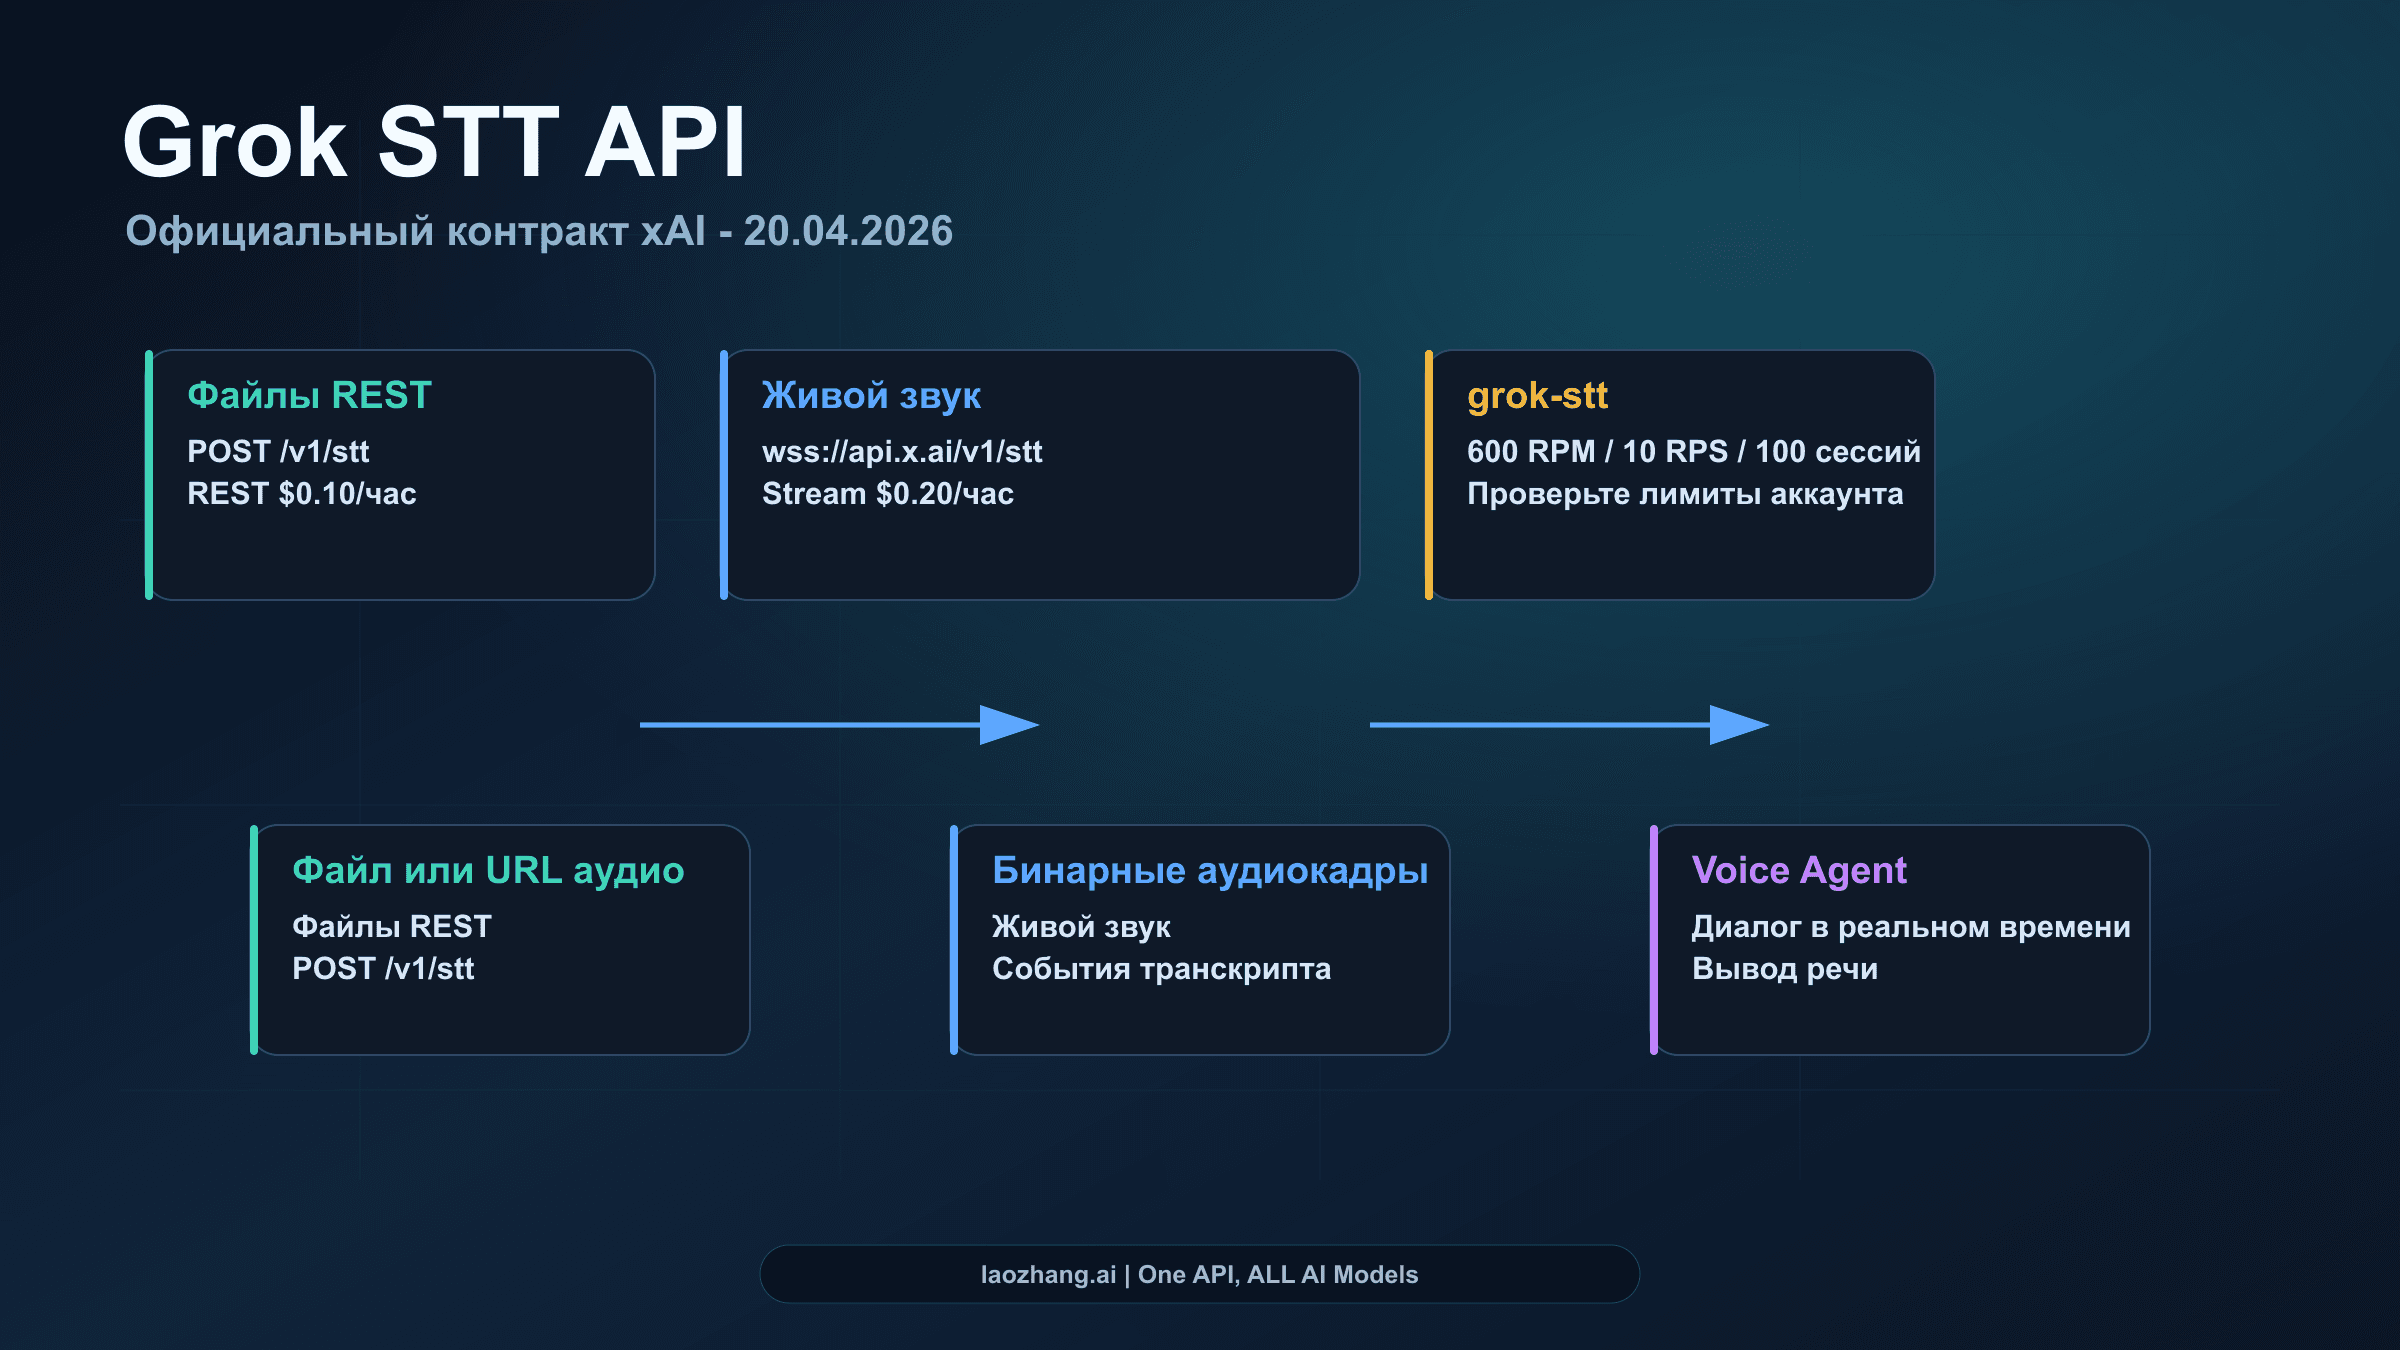
| Расшифровать файл или аудио по URL | POST /v1/stt | Текст из аудио |
| Расшифровывать поступающую речь | wss://api.x.ai/v1/stt | Поток распознавания без диалога с агентом |
У standalone STT текущая модель по умолчанию — grok-voice-transcribe-2.0; у встроенной расшифровки Voice используется настройка grok-transcribe. Не меняйте эти имена местами. Подробности актуальных запросов находятся в официальной справке STT и TTS.
Прямой realtime API не решает за вас захват микрофона, очередь воспроизведения, эхоподавление и телефонную маршрутизацию. Если именно эти задачи занимают большую часть разработки, изучите интеграции с готовыми медиаплатформами, на которые ссылается обзор xAI. Для SIP-сессии с call_id правила аутентификации другие: требуется постоянный API-ключ, ephemeral secret не поддерживается, параметр model игнорируется. Это отдельный путь, не продолжение браузерного примера.
При переносе клиента с OpenAI Realtime проверяйте конкретные события. Сейчас xAI поддерживает и response.text.delta, и response.output_text.delta; conversation.item.truncate тоже поддерживается. Входная расшифровка updated остаётся накопительной. Совместимая структура сессии помогает начать, но не подтверждает тождество всех событий или поведения клиента. Различия и совместимость.
FAQ
Какой endpoint и какую модель указать для Grok Voice API?
Для прямого голосового диалога — wss://api.x.ai/v1/realtime. Можно явно указать ?model=grok-voice-think-fast-2.0; grok-voice-latest сейчас указывает на эту модель, но остаётся обновляемым alias. reasoning.effort по умолчанию равен high, для отключения рассуждения предусмотрен none. Текущие модели и параметры.
Нужен ли SuperGrok для подключения к API?
В этой схеме нужны учётные данные API xAI. Вход в grok.com, потребительская подписка и URL https://grok.com/api/auth/session не заменяют API-ключ или временный realtime-токен. Для браузера используйте выпуск секрета на сервере приложения и документированный подпротокол. Аутентификация realtime.
Сколько стоит Grok Voice Agent API и оплачивается ли тишина?
Прямой xAI API стоит 0,08 USD/мин. В server_vad оплачивается длительность сессии, включая паузы, а в ручном режиме — входное и выходное аудио. Клиентские текстовые элементы стоят 0,004 USD каждый с указанными в карточке исключениями. Тариф стороннего провайдера, в том числе fal, нельзя автоматически переносить на прямой endpoint xAI. Правила расчёта.
Почему ответ модели завершён, а звук ещё идёт?
response.done сообщает о завершении генерации. Плеер мог накопить очередь, которая ещё не закончилась. Дождитесь завершения локального воспроизведения; при перебивании остановите очередь и при необходимости обрежьте историю по реально услышанной длительности через conversation.item.truncate.
Можно ли использовать русскую речь и прежние голоса eve или ara?
Да, русский указан среди поддерживаемых языков, а eve и ara остаются в текущем списке встроенных голосов; eve — голос по умолчанию. Язык ответа задавайте в инструкциях, подсказку ru для входной расшифровки — отдельно. Это документированная поддержка, а не оценка произношения в вашем сценарии. Языки и настройка, текущий список голосов.
Как понять, что первая интеграция действительно готова?
Проверьте весь цикл: конфигурация подтверждена, реплика отправлена один раз, получен непустой звук правильного формата, он воспроизводится, статус завершения обработан и соединение закрывается без зависания. После этого переходите к микрофону и потоковому плееру; успешный WebSocket handshake сам по себе ещё не означает работающий голосовой интерфейс.
Источники7
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 8 окт. 2026 г..
Источники7
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 8 окт. 2026 г..
- 1.Документация подключения и событий xAIdocs.x.ai/developers/rest-api-reference/inference/voice
- 2.Модель и правила оплатыdocs.x.ai/developers/models/speech-to-speech
- 3.руководства по аудиоdocs.x.ai/developers/model-capabilities/audio/speech-to-speech
- 4.Руководство по временным токенамdocs.x.ai/developers/model-capabilities/audio/ephemeral-tokens
- 5.События и схема ошибокdocs.x.ai/voice-realtime.ws.json
- 6.прайс xAIdocs.x.ai/developers/pricing
- 7.Текущие голосовые продукты xAIdocs.x.ai/developers/model-capabilities/audio/voice