Grok Voice Agent API 가이드: 웹소켓 접속부터 음성 입출력까지
Grok Voice Agent API는 wss://api.x.ai/v1/realtime에서 양방향 음성 대화를 제공합니다. 서버에서는 API 키, 브라우저에서는 단기 토큰으로 인증합니다. WAV 파일을 전송하고 응답을 재생 가능한 파일로 저장하는 예제로 시작한 뒤 자동 발화 감지와 중단 처리를 연결할 수 있습니다.
목차
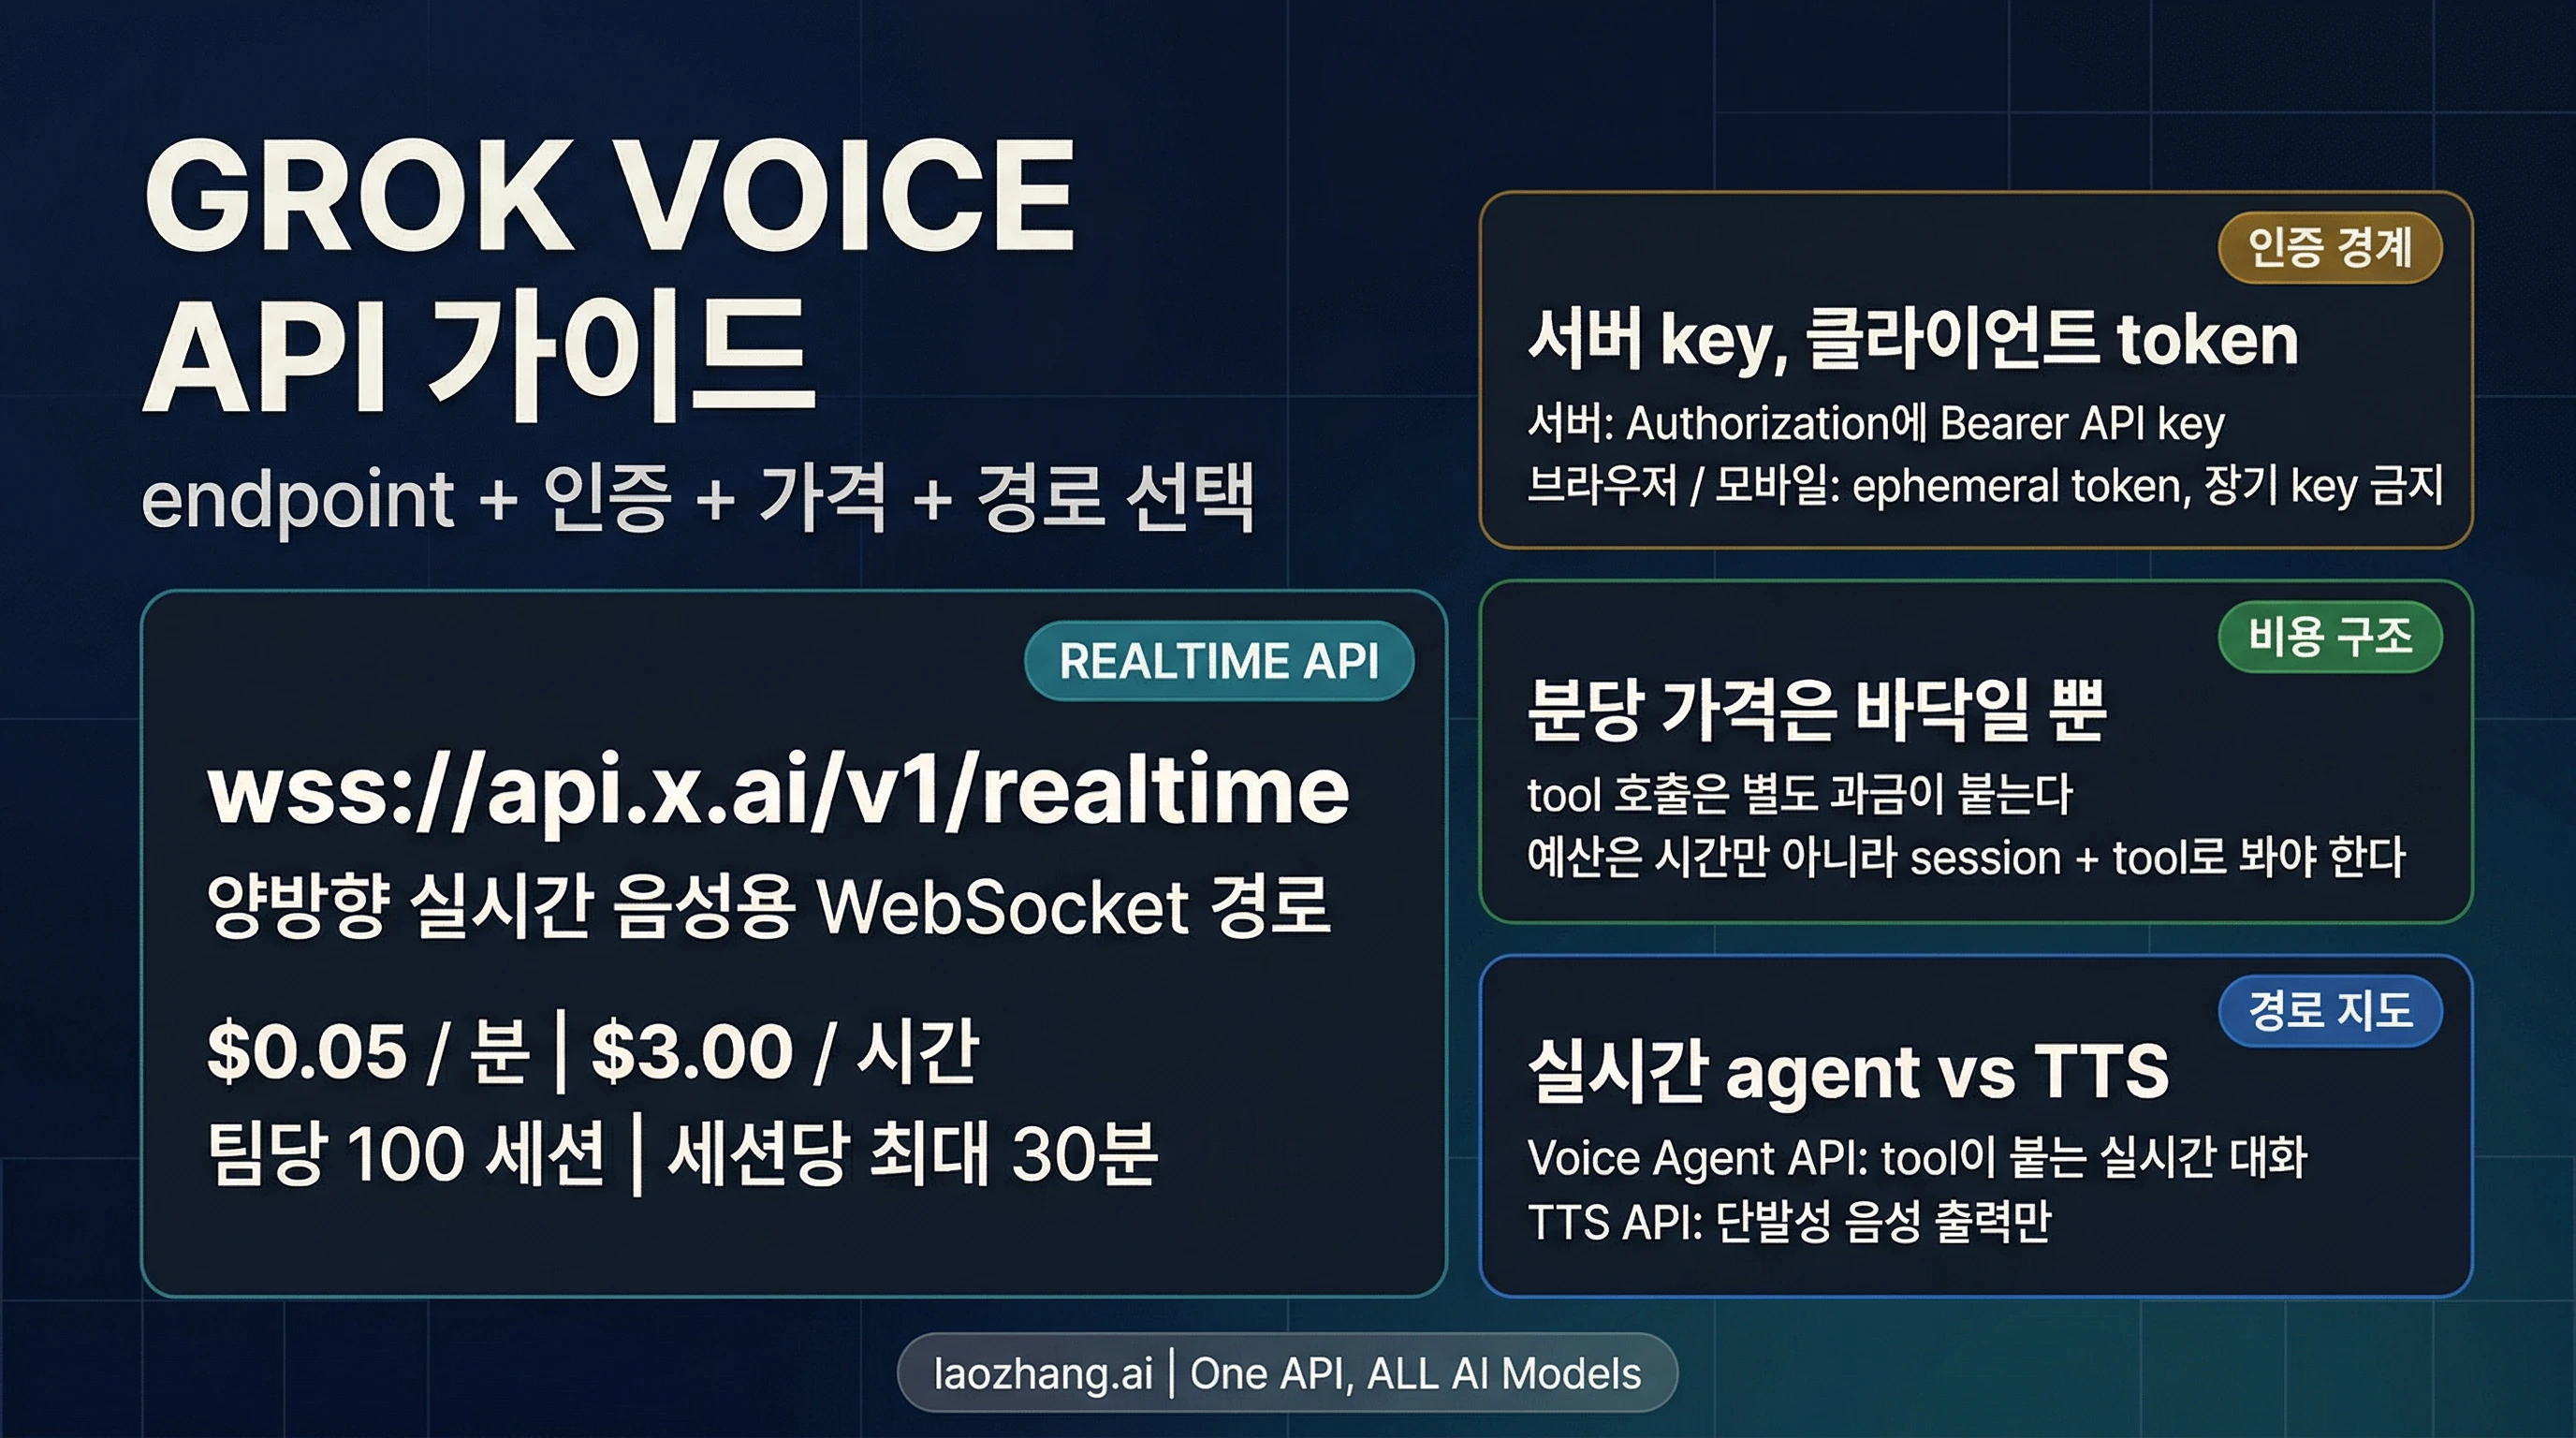
Grok Voice Agent API는 wss://api.x.ai/v1/realtime에 연결해 사용자 음성을 보내고 응답 음성을 받는 API입니다. 현재 grok-voice-latest는 grok-voice-think-fast-2.0을 가리킵니다. 버전을 고정하려면 웹소켓 주소에 ?model=grok-voice-think-fast-2.0을 붙입니다. 서버는 API 키로 인증하고, 브라우저에는 서버가 발급한 단기 토큰만 전달합니다. 공식 음성 대화 가이드, 인증 안내
처음에는 마이크와 실시간 재생을 동시에 붙이기보다 준비된 음성 파일 → 수동 발화 제출 → 응답 음성 파일의 흐름을 완성하면 문제가 생긴 위치를 구분하기 쉽습니다. 아래 예제는 연결 후 설정 확인을 기다리고, PCM 음성을 전송하며, 응답 오디오를 WAV로 저장하는 데까지 이어집니다. 그다음 같은 이벤트 처리에 마이크 입력과 재생 대기열을 연결하면 됩니다.
2026년 10월 7일 확인한 공개 요금은 오디오 분당 0.08달러입니다. 기본 자동 발화 감지 모드에서는 침묵을 포함한 세션 시간을 기준으로, 푸시투토크 방식에서는 입력·출력 오디오 시간을 기준으로 과금합니다. 클라이언트가 생성하는 텍스트 항목에는 별도 요금이 있습니다. 현재 모델 및 과금 기준
지금 공개된 접속 조건을 한 화면에 잡기
| 항목 | 현재 문서에서 확인할 내용 |
|---|---|
| 직접 음성 대화 주소 | wss://api.x.ai/v1/realtime |
| 현재 모델 | grok-voice-think-fast-2.0; grok-voice-latest는 이 모델의 별칭 |
| 추론 설정 | reasoning.effort: high가 기본값, none도 지원 |
| 기본 오디오 | 24kHz, 16비트 리틀엔디언 PCM |
| 오디오 요금 | 분당 0.08달러, 시간당 4.80달러 |
| 텍스트 항목 요금 | 클라이언트의 conversation.item.create 텍스트 항목당 0.004달러 |
| 공개 동시 접속 한도 | 팀당 10개 세션 |
| 세션 최대 길이 | 120분 |
| 공개 리전 | us-east-1 |
| 기본 음성 | eve; 현재 목록에는 28개 음성 제공 |
모델·추론·오디오 설정은 음성 대화 가이드, 요금과 한도는 모델 페이지, 음성 목록은 음성 제품 안내를 기준으로 했습니다. 동시 접속 수, 한 세션의 길이, 인증 토큰의 유효 시간은 서로 다른 제한입니다. 이 공개 한도만으로 특정 계정의 증설 여부까지 확인할 수는 없습니다.
가장 빨리 붙이면서도 안전한 접속 순서
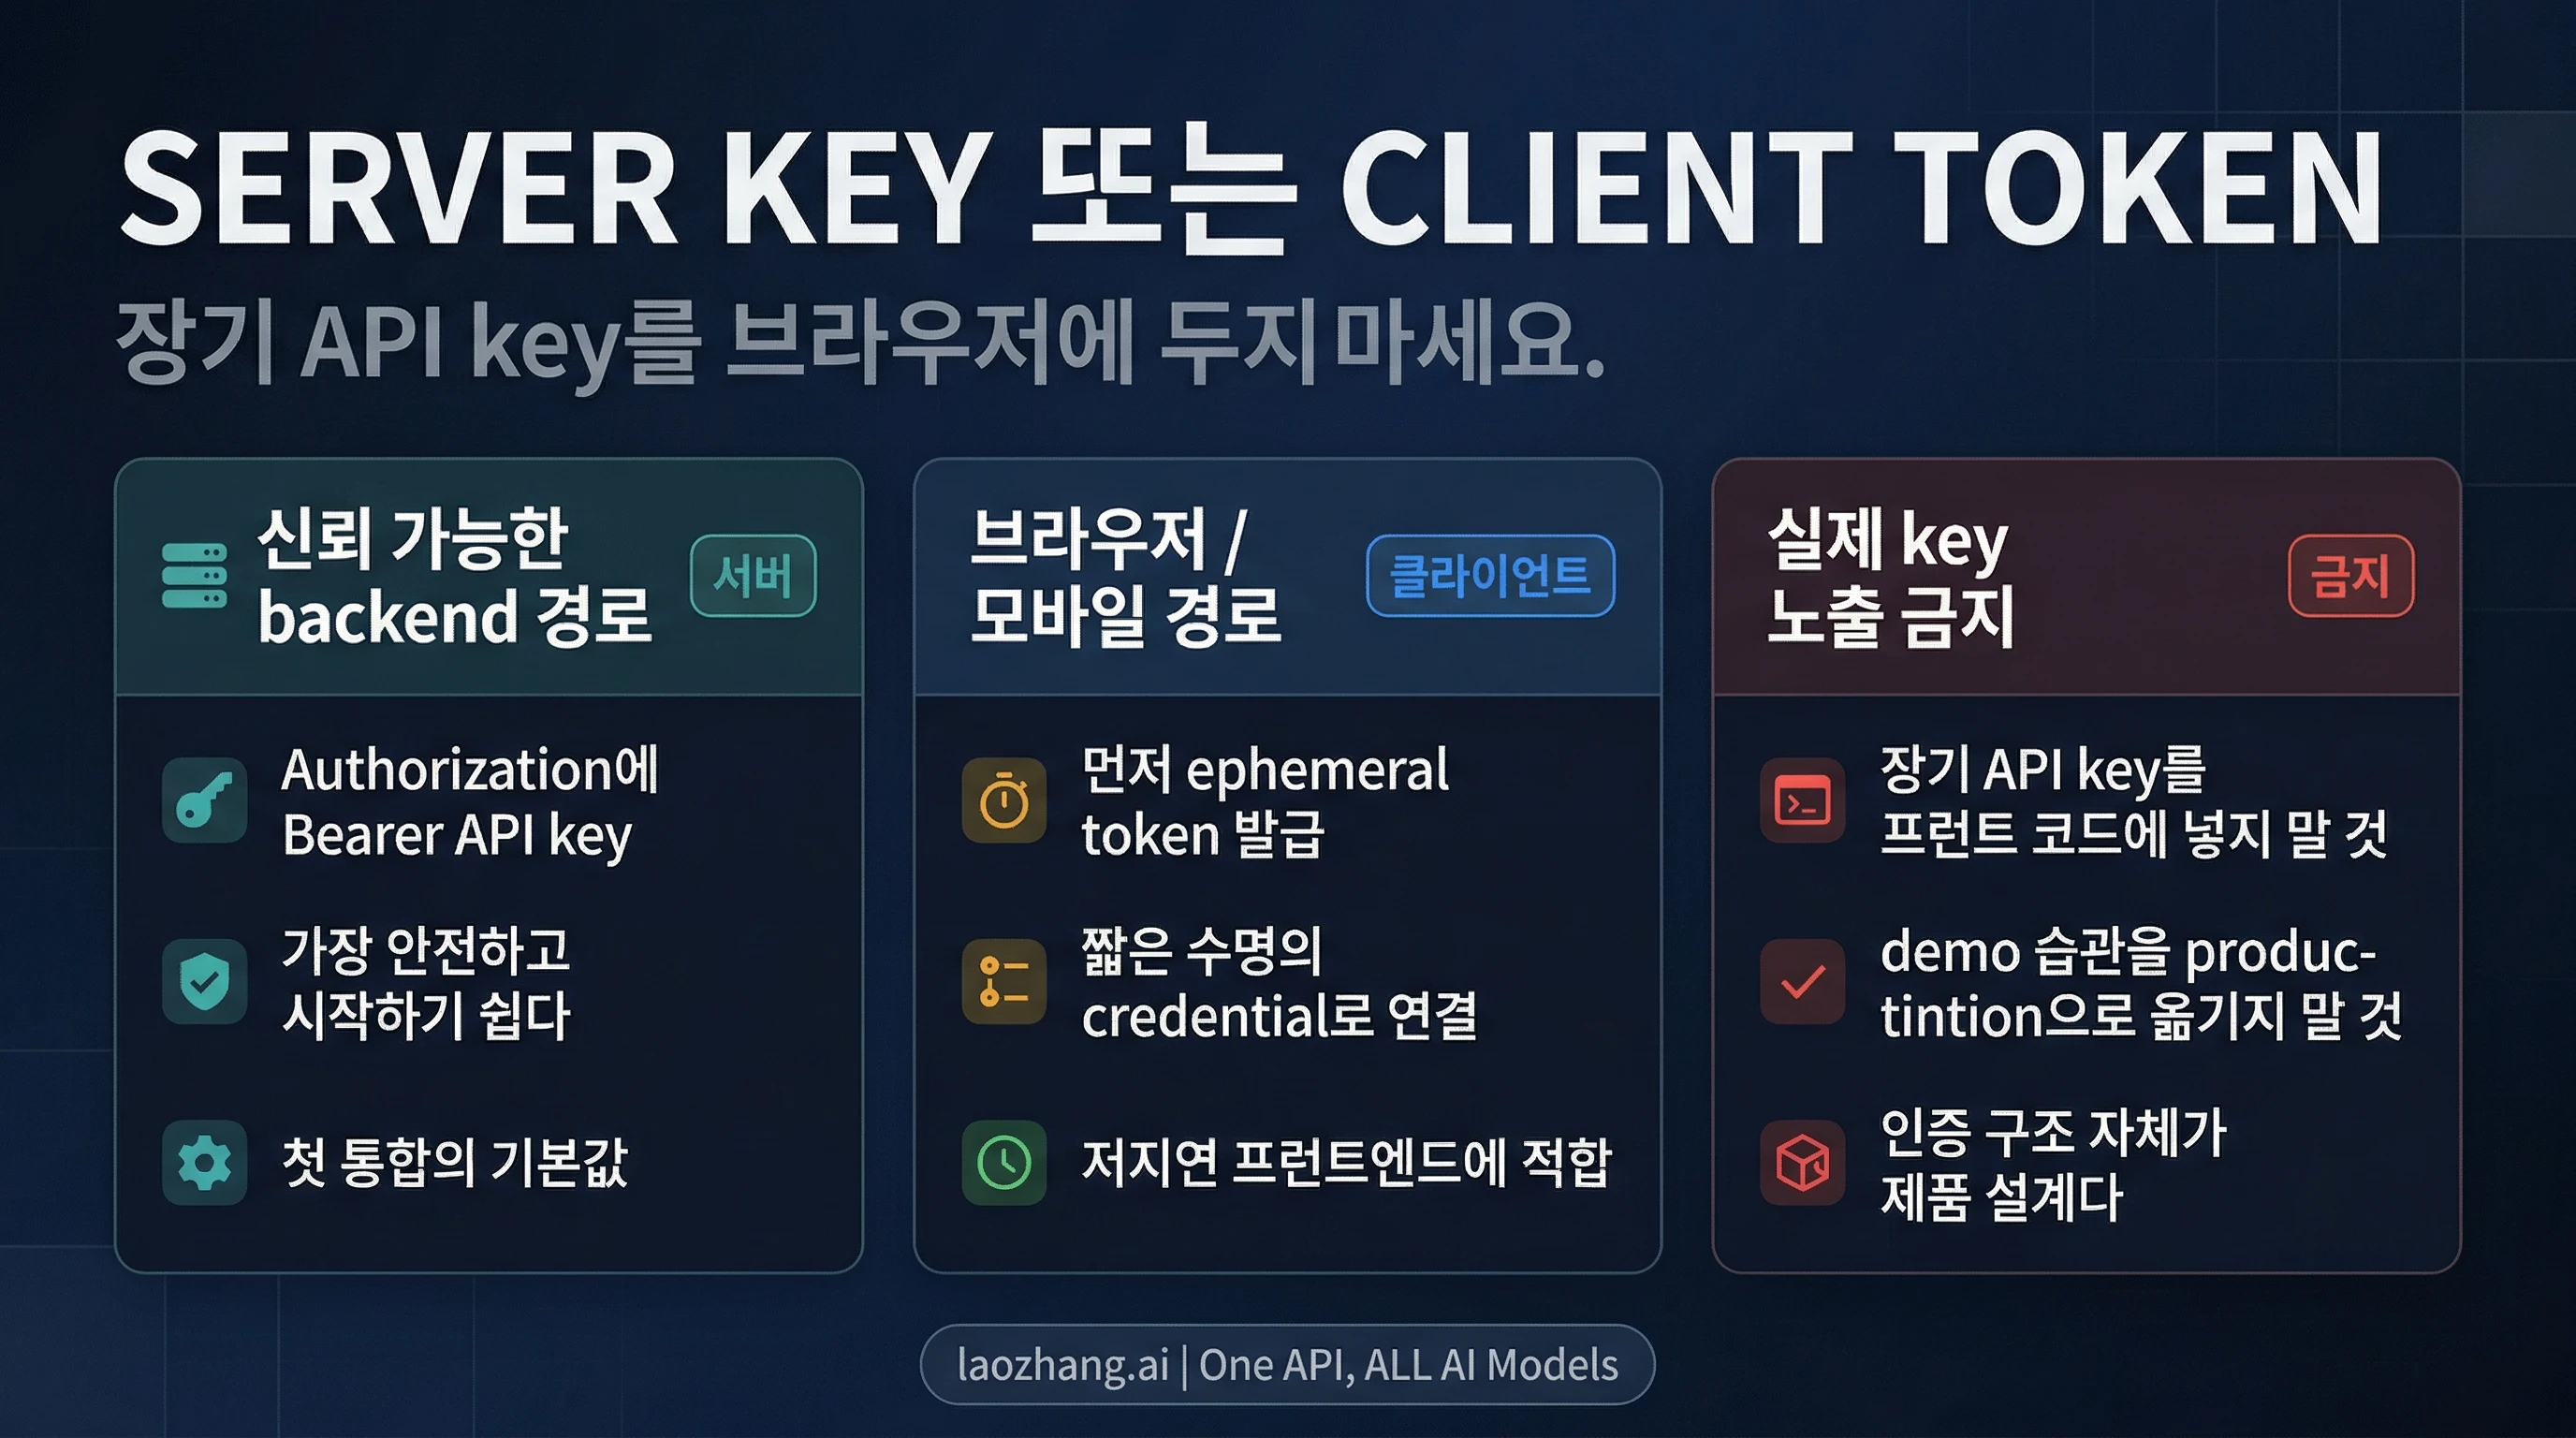
서버에서 접속할 때는 웹소켓의 Authorization 헤더에 Bearer <API_KEY>를 보냅니다. 여기서 Bearer는 인증 방식의 이름이고 뒤에 실제 키가 옵니다. 네이티브 브라우저 WebSocket은 임의의 Authorization 헤더를 지정할 수 없으므로 서버 코드의 접속 옵션을 그대로 옮기면 안 됩니다.
브라우저의 접속 순서는 다음과 같습니다.
- 로그인한 사용자가 자기 앱 서버에 음성 세션을 요청합니다.
- 앱 서버가 사용자 권한과 사용 예산을 확인합니다.
- 서버가 장기 API 키로
POST https://api.x.ai/v1/realtime/client_secrets를 호출합니다. - 응답의
value와expires_at을 클라이언트에 전달합니다. 키와 토큰은 로그에 남기지 않습니다. - 브라우저가 단기 토큰을 웹소켓 서브프로토콜에 넣어 접속합니다.
아래는 앱의 인증·예산 확인을 통과한 서버 핸들러 안에서 사용할 토큰 발급 부분입니다. 공개된 무인증 토큰 발급 서버를 만들라는 예제가 아닙니다. serverApiKey는 서버의 비밀 저장소에서 얻은 값이며 브라우저에 보내지 않습니다.
async function issueVoiceSecret(serverApiKey) {
  const result = await fetch("https://api.x.ai/v1/realtime/client_secrets", {
    method: "POST",
    headers: {
      Authorization: `Bearer ${serverApiKey}`,
      "Content-Type": "application/json",
    },
    body: JSON.stringify({ expires_after: { seconds: 300 } }),
  });
  if (!result.ok) throw new Error(`토큰 발급 실패: HTTP ${result.status}`);
  const secret = await result.json();
  if (typeof secret.value !== "string" || !Number.isFinite(secret.expires_at)) {
    throw new Error("토큰 응답 형식이 올바르지 않습니다.");
  }
  return { value: secret.value, expires_at: secret.expires_at };
}
앱 서버에서 위 응답을 받은 브라우저에서는 다음과 같이 연결합니다. secret은 인증된 앱 서버의 응답입니다.
const socket = new WebSocket(
  "wss://api.x.ai/v1/realtime?model=grok-voice-think-fast-2.0",
  [`xai-client-secret.${secret.value}`],
);
토큰 API 참조는 유효 시간의 기본값을 600초, 최대값을 3,600초로 설명합니다. 예제의 300초는 애플리케이션이 선택한 값입니다. 토큰 만료 시간과 세션 최대 120분을 같은 타이머로 취급하지 마세요.
한 가지 문서 차이가 있습니다. 단기 토큰 가이드는 session과 expires_after.anchor를 지원하지 않는다고 적지만, 현재 API 참조에는 선택적인 초기 session 설정이 있습니다. 위 예제는 양쪽에 공통으로 나온 expires_after.seconds만 사용합니다. 문서 차이를 근거로 모든 토큰이 모델에 고정된다거나 session이 반드시 거부된다고 단정할 수는 없습니다.
WAV 한 파일을 보내고 응답 음성을 저장하기
다음은 서버 또는 개발용 로컬 Node.js 환경에서 사용하는 파일 입출력 예제입니다. Node.js의 ESM과 ws 패키지가 필요합니다. 입력 파일은 24kHz·모노·16비트 PCM WAV여야 합니다. 녹음 앱의 기본 MP3나 WebM 파일을 확장자만 바꿔 넣으면 안 됩니다.
입력 WAV에서 RIFF 헤더를 제거한 PCM 바이트를 보내고, 응답 PCM에는 새 WAV 헤더를 붙입니다. 수동 발화 모드이므로 append → commit → committed 확인 → response.create 순서로 처리합니다. 오디오를 받았다는 이유만으로 성공 처리하지 않고 response.done의 상태도 확인합니다. 현재 메시지 흐름
아래 내용을 voice-file.mjs로 저장합니다. 사용자가 읽을 질문을 녹음해 question.wav로 준비하면 됩니다. 이 코드는 한 번의 음성 입력과 응답을 위한 예제이며 마이크 캡처나 스피커 스트리밍을 포함하지 않습니다.
import WebSocket from "ws";
import { readFileSync, writeFileSync } from "node:fs";

const RATE = 24000;
const [inputPath, outputPath = "answer.wav"] = process.argv.slice(2);
const key = process.env.XAI_API_KEY;
if (!key || !inputPath) {
  throw new Error("서버 환경의 XAI_API_KEY와 입력 WAV 경로가 필요합니다.");
}

function extractPcm(wav) {
  if (wav.length < 12 || wav.toString("ascii", 0, 4) !== "RIFF" ||
      wav.toString("ascii", 8, 12) !== "WAVE") {
    throw new Error("RIFF/WAVE 파일이 아닙니다.");
  }
  let format;
  let pcm;
  for (let offset = 12; offset + 8 <= wav.length;) {
    const id = wav.toString("ascii", offset, offset + 4);
    const size = wav.readUInt32LE(offset + 4);
    const start = offset + 8;
    if (start + size > wav.length) throw new Error("WAV 청크가 잘렸습니다.");
    if (id === "fmt ") {
      if (size < 16) throw new Error("WAV 형식 정보가 부족합니다.");
      format = {
        codec: wav.readUInt16LE(start),
        channels: wav.readUInt16LE(start + 2),
        rate: wav.readUInt32LE(start + 4),
        bits: wav.readUInt16LE(start + 14),
      };
    }
    if (id === "data") pcm = wav.subarray(start, start + size);
    offset = start + size + (size % 2);
  }
  if (!format || format.codec !== 1 || format.channels !== 1 ||
      format.rate !== RATE || format.bits !== 16 || !pcm?.length ||
      pcm.length % 2 !== 0) {
    throw new Error("24kHz 모노 16비트 PCM WAV가 필요합니다.");
  }
  return pcm;
}

function makeWav(pcm) {
  if (!pcm.length || pcm.length % 2 !== 0) {
    throw new Error("응답 PCM이 비었거나 샘플 경계가 맞지 않습니다.");
  }
  const header = Buffer.alloc(44);
  header.write("RIFF", 0);
  header.writeUInt32LE(36 + pcm.length, 4);
  header.write("WAVE", 8);
  header.write("fmt ", 12);
  header.writeUInt32LE(16, 16);
  header.writeUInt16LE(1, 20); // PCM
  header.writeUInt16LE(1, 22); // 모노
  header.writeUInt32LE(RATE, 24);
  header.writeUInt32LE(RATE * 2, 28);
  header.writeUInt16LE(2, 32);
  header.writeUInt16LE(16, 34);
  header.write("data", 36);
  header.writeUInt32LE(pcm.length, 40);
  return Buffer.concat([header, pcm]);
}

const input = extractPcm(readFileSync(inputPath));
const url = "wss://api.x.ai/v1/realtime?model=grok-voice-think-fast-2.0";
const socket = new WebSocket(url, {
  headers: { Authorization: `Bearer ${key}` },
});
const chunks = [];
let configured = false;
let submitted = false;
let requested = false;
let settled = false;

await new Promise((resolve, reject) => {
  // 예제 앱의 대기 제한이며 서비스의 세션 최대 길이가 아닙니다.
  const deadline = setTimeout(() => finish(new Error("응답 대기 시간 초과")), 120000);
  function finish(error) {
    if (settled) return;
    settled = true;
    clearTimeout(deadline);
    if (error) {
      socket.terminate();
      reject(error);
    } else {
      socket.close(1000, "file turn complete");
      resolve();
    }
  }
  function send(event) {
    socket.send(JSON.stringify(event));
  }
  socket.on("message", (data, isBinary) => {
    if (settled) return;
    try {
      if (isBinary) throw new Error("JSON 출력 설정에서 이진 프레임을 받았습니다.");
      const event = JSON.parse(data.toString());
      if (event.type === "session.created" && !configured) {
        configured = true;
        send({
          type: "session.update",
          session: {
            voice: "eve",
            instructions: "한국어로 답하세요. 질문에 먼저 답하고 설명은 짧게 덧붙이세요.",
            turn_detection: { type: null },
            audio: {
              input: { format: { type: "audio/pcm", rate: RATE }, transport: "json" },
              output: { format: { type: "audio/pcm", rate: RATE }, transport: "json" },
            },
          },
        });
      } else if (event.type === "session.updated" && !submitted) {
        submitted = true;
        // 4,800바이트는 이 형식에서 100ms입니다. 파일을 청크로 제출합니다.
        for (let pos = 0; pos < input.length; pos += 4800) {
          send({
            type: "input_audio_buffer.append",
            audio: input.subarray(pos, pos + 4800).toString("base64"),
          });
        }
        send({ type: "input_audio_buffer.commit" });
      } else if (event.type === "input_audio_buffer.committed" && !requested) {
        requested = true;
        send({ type: "response.create" });
      } else if (event.type === "response.output_audio.delta") {
        chunks.push(Buffer.from(event.delta, "base64"));
      } else if (event.type === "response.output_audio_transcript.delta" ||
                 event.type === "response.text.delta" ||
                 event.type === "response.output_text.delta") {
        process.stdout.write(event.delta);
      } else if (event.type === "response.done") {
        if (event.response?.status !== "completed") {
          throw new Error(`응답 종료 상태: ${event.response?.status ?? "unknown"}`);
        }
        writeFileSync(outputPath, makeWav(Buffer.concat(chunks)));
        process.stdout.write(`\n저장 완료: ${outputPath}\n`);
        finish();
      } else if (event.type === "error") {
        const e = event.error ?? {};
        console.error({ type: e.type, code: e.code, message: e.message,
          param: e.param, event_id: e.event_id ?? event.event_id });
        throw new Error("음성 요청을 중단했습니다. 위 오류 필드를 확인하세요.");
      }
    } catch (error) {
      finish(error);
    }
  });
  socket.on("error", finish);
  socket.on("close", (code, reason) => {
    if (!settled) finish(new Error(`완료 전 연결 종료: ${code} ${reason.toString()}`));
  });
});
서버 환경에 키와 의존성을 준비한 뒤 실행하는 명령은 다음과 같습니다. 장기 키를 명령 인자나 소스 파일에 직접 적지 않습니다.
npm install ws
node voice-file.mjs question.wav answer.wav
성공 판단은 session.updated를 받은 뒤 입력을 제출하고, 오디오 조각을 수신하며, response.done.response.status가 completed일 때 answer.wav가 만들어지는 것입니다. 파일 플레이어에서 응답 음성을 들을 수 있어야 최종 출력도 확인한 셈입니다. 예제는 문서에 따른 구현이며, 이 글을 작성하면서 실제 API 호출이나 음질·지연 테스트를 수행하지는 않았습니다.
파일을 미리 제출하므로 이 예제의 반복문에는 100ms 대기 시간이 없습니다. 실시간 마이크 입력에서는 캡처한 PCM 조각이 생길 때마다 전송하고, 긴 녹음 파일이나 지속적인 스트림에서는 웹소켓 전송 버퍼를 확인해 입력을 조절해야 합니다. 전체 입력과 출력을 메모리에 모으는 예제 구조를 장시간 세션에 그대로 쓰는 것은 적합하지 않습니다.
자동 발화 감지와 수동 제출은 다르게 처리하기
실시간 음성 에이전트에서 한 턴은 사용자가 말을 한 뒤 에이전트가 답하는 한 차례의 흐름입니다. 누가 발화 끝을 결정하는지에 따라 전송 순서가 달라집니다.
| 방식 | 클라이언트가 하는 일 | 응답 요청 |
|---|---|---|
자동 감지 server_vad | 음성이 들어오는 동안 input_audio_buffer.append 전송 | 서버가 발화 종료를 감지해 자동 생성 |
수동 음성 type: null | 음성 전송 후 input_audio_buffer.commit | 제출 확인 후 response.create |
| 수동 텍스트 | conversation.item.create로 사용자 텍스트 생성 | response.create |
위 표는 현재 API 참조에 따른 구분입니다. server_vad에 파일 예제의 commit과 response.create를 그대로 추가하면 안 됩니다. 자동으로 처리할 발화에 클라이언트가 응답을 중복 요청하지 않도록 모드별 코드를 나누세요.
음성 대신 텍스트로 한 턴을 넣고 싶다면 수동 모드에서 WAV 제출 부분을 다음 두 메시지로 바꿉니다. 설정 확인 이후에 보내며 출력 처리 코드는 그대로 사용합니다.
{
  "type": "conversation.item.create",
  "item": {
    "type": "message",
    "role": "user",
    "content": [{ "type": "input_text", "text": "웹소켓과 HTTP 요청의 차이를 짧게 설명해 주세요." }]
  }
}{ "type": "response.create" }기본 자동 감지 모드에서 잠깐 말을 멈추는 것과 연결을 끝내는 것은 다릅니다. 비용을 통제할 목적이라면 발화 감지 설정만 바꾸지 말고 사용자가 대화를 종료할 때 웹소켓도 닫으세요. 사용자가 버튼으로 발화를 제출하는 제품이라면 수동 모드의 입력·출력 시간 기준이 예산을 계산하기 쉽습니다.
turn_detection.idle_timeout_ms는 별도의 재참여 기능입니다. 설정하면 에이전트 응답 후 지정 시간 동안 말이 없을 때 다시 말을 걸며, 응답마다 타이머가 재설정됩니다. 기본값은 null입니다. 한 번만 실행되는 종료 타이머로 쓰지 마세요. 발화 감지 설정
실시간 재생, 자막과 끼어들기 처리
PCM 오디오를 재생 대기열에 넣기
파일 예제는 완성된 응답을 저장하지만, 대화형 제품은 response.output_audio.delta가 올 때마다 디코딩해 재생 대기열에 넣어야 합니다. 24kHz PCM16 모노라면 초당 48,000바이트입니다. 예를 들어 4,800바이트 조각은 0.1초에 해당합니다. 이 계산은 오디오 길이를 뜻하며 네트워크 지연이나 모델 응답 속도를 측정한 값은 아닙니다.
브라우저에서는 사용자의 시작 버튼 동작으로 AudioContext를 활성화하고 다음 순서로 처리할 수 있습니다.
- Base64를 바이트로 복원합니다.
- 두 바이트씩 리틀엔디언 signed 16비트 샘플을 읽어
sample / 32768로 실수 샘플을 만듭니다. - 설정한 입력이 아닌 출력 샘플레이트로
AudioBuffer를 만듭니다. - 직전 오디오의 예약 종료 시각부터 새 조각을 예약합니다. 도착할 때마다 즉시 동시에 재생하지 않습니다.
- 소스 노드와 재생 중인
item_id,content_index, 실제로 들려준 샘플 수를 기록합니다.
입력·출력 코덱은 서로 다르게 설정할 수 있습니다. PCM 외에 8kHz audio/pcmu·audio/pcma, 24kHz 모노 audio/opus도 문서에 있습니다. 코덱과 전송 방식은 별개입니다. JSON 방식은 Base64 오디오를 담고, 이진 방식은 원시 코덱 바이트를 웹소켓 프레임으로 보냅니다. 이진 출력에서도 세션·자막·종료 이벤트는 JSON입니다. 오디오 형식과 전송
MediaRecorder의 WebM 조각은 원시 Opus 패킷과 다릅니다. audio/opus를 골랐다는 이유로 컨테이너를 그대로 보낼 수는 없습니다. Node.js에서는 JSON 메시지도 Buffer로 전달될 수 있으므로 Buffer.isBuffer() 대신 ws 콜백의 isBinary로 프레임 종류를 구분합니다. 위 예제는 JSON 출력만 선택해 이 분기를 단순하게 만든 것입니다.
자막은 덧붙일지 교체할지 구분하기
에이전트가 말하는 문장은 response.output_audio_transcript.delta를 이어 붙여 표시합니다. 텍스트 출력도 처리한다면 response.text.delta와 response.output_text.delta를 모두 인식하도록 만드세요. 현재 참조는 두 이름을 같은 기능으로 설명합니다. 출력 이벤트
사용자가 말하는 중간 자막은 다른 계약입니다. 다음 입력 설정을 추가하면 conversation.item.input_audio_transcription.updated를 받을 수 있습니다.
{
  "transcription": {
    "model": "grok-transcribe",
    "language_hint": "ko"
  }
}
이 객체를 session.audio.input 안에 넣습니다. updated의 자막은 누적 내용이고 앞부분을 수정할 수 있으므로, 해당 입력 항목의 기존 자막을 새 내용으로 교체합니다. 응답 자막의 delta처럼 무조건 덧붙이면 문장이 중복됩니다. language_hint는 입력 인식의 힌트이며, 한국어로 답하게 하는 instructions와 역할이 다릅니다. 입력 자막 및 언어 힌트
생성 완료와 재생 완료를 나누고, 못 들은 부분은 잘라내기
response.done은 서버의 응답 생성이 끝났다는 신호입니다. 로컬 스피커 대기열에는 아직 재생하지 않은 오디오가 남을 수 있습니다. 다음 작업을 “답변을 다 들은 뒤” 시작해야 한다면 서버 이벤트가 아니라 로컬 재생 완료를 기다립니다.
자동 감지 모드에서 input_audio_buffer.speech_started를 받으면 사용자가 끼어든 상황에 맞춰 로컬 재생을 멈추고 대기열을 비웁니다. 수동 모드에서는 클라이언트가 response.cancel로 진행 중인 생성을 취소합니다. 이미 받은 오디오는 클라이언트가 별도로 멈춰야 합니다.
대화 기록에도 사용자가 실제로 들은 부분만 남기려면 conversation.item.truncate를 사용합니다. 다음 메시지의 ID는 현재 재생 중인 실제 응답 항목의 ID로 바꾸고, content_index도 해당 오디오 부분의 값을 사용합니다. 1,200ms는 설명을 위한 예입니다.
{
  "type": "conversation.item.truncate",
  "item_id": "실제_응답_항목_ID",
  "content_index": 0,
  "audio_end_ms": 1200
}audio_end_ms에는 수신하거나 예약한 전체 길이가 아니라 그 항목에서 실제로 재생한 길이를 넣습니다. 서버는 이후 오디오와 자막을 잘라내고 conversation.item.truncated로 확인합니다. 현재 API는 truncate를 지원합니다. 예전 클라이언트의 미지원 목록을 그대로 적용하면 사용자가 듣지 못한 내용을 에이전트가 이미 전달했다고 취급할 수 있습니다. truncate 계약과 스키마
도구 결과를 돌려준 뒤 대화를 이어가기
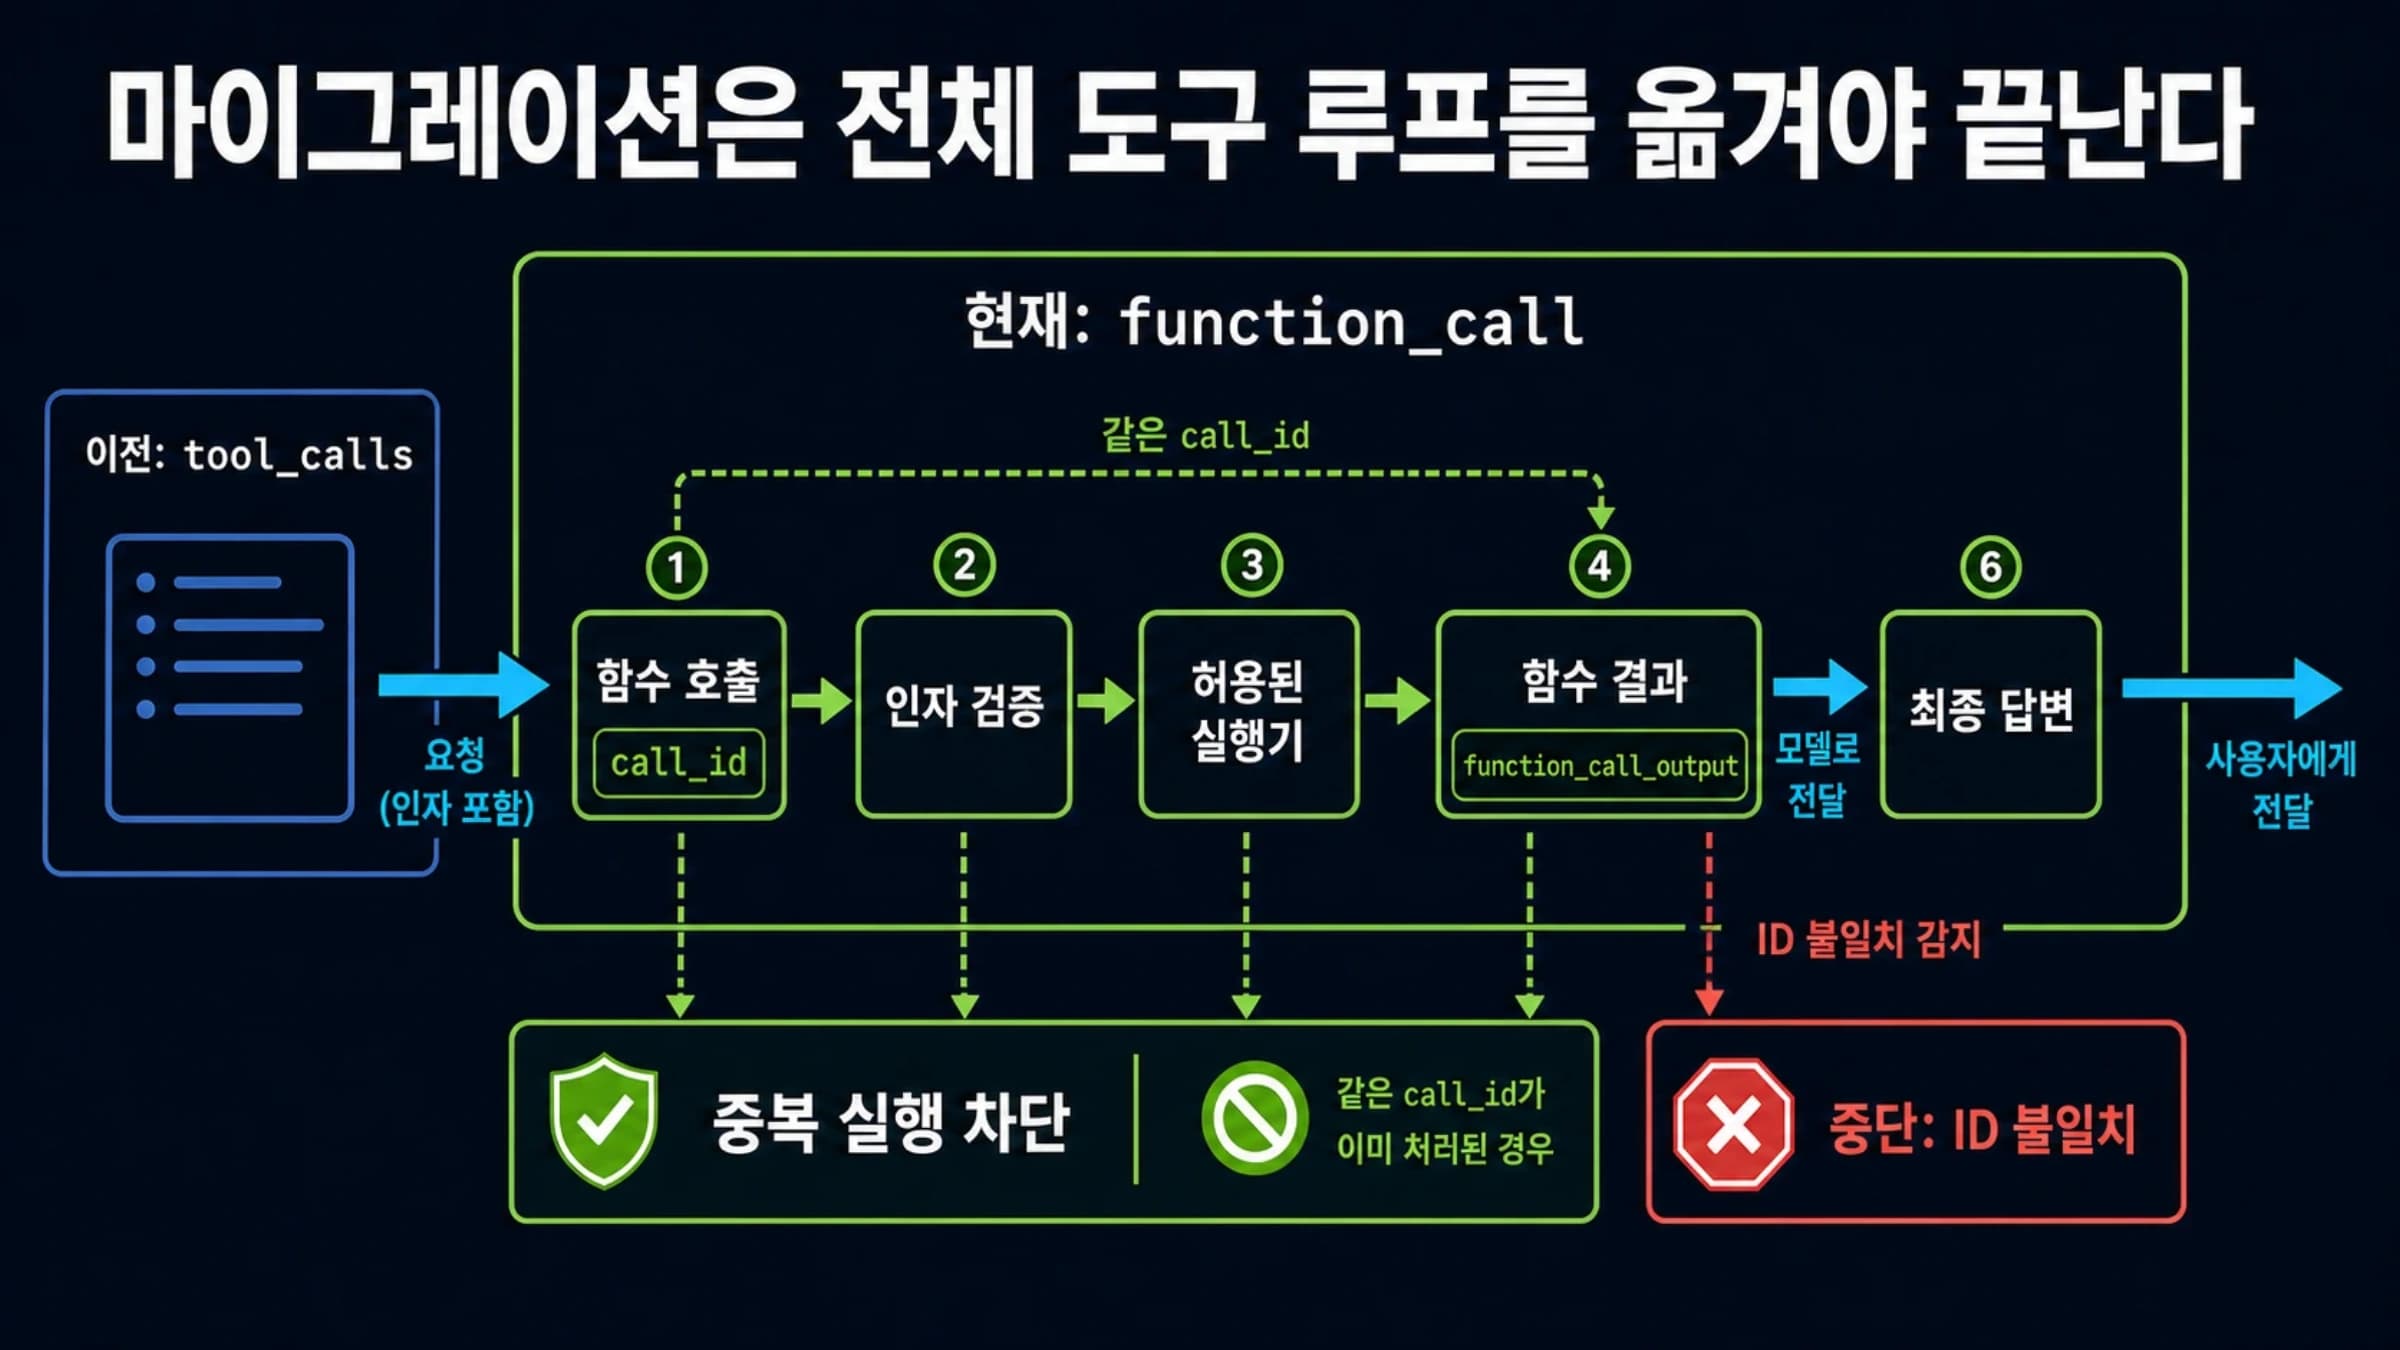
음성 에이전트가 앱 데이터를 조회하거나 계산해야 한다면 session.tools에 custom function을 등록할 수 있습니다. web_search, x_search, file_search, MCP 같은 서버 측 도구와 달리 custom function은 애플리케이션이 실행하고 결과를 돌려줍니다. 도구 연결 가이드
예를 들어 학습 타이머가 남은 시간을 설명하게 한다면 remaining_minutes라는 함수에 전체 시간과 경과 시간을 정수로 받도록 정의할 수 있습니다. response.function_call_arguments.done에서 name, call_id, JSON 문자열인 arguments를 읽고 다음을 처리합니다.
- 이름이 허용된 함수인지 확인합니다.
- JSON을 파싱하고 전체 시간과 경과 시간이 음수가 아닌 유효한 정수인지 검사합니다.
- 앱에서
max(0, 전체 시간 − 경과 시간)을 계산합니다. - 결과를 문자열로 직렬화해 같은
call_id의function_call_output으로 보냅니다. - 같은 응답의 모든 함수 호출 결과를 보낸 뒤
response.create를 한 번 보냅니다.
아래는 전체 25분 중 9분이 지났다는 가정에서 앱이 16분을 계산한 결과 메시지의 예입니다. 실제 도구 실행 기록은 아닙니다.
{
  "type": "conversation.item.create",
  "item": {
    "type": "function_call_output",
    "call_id": "이벤트에서_받은_call_id",
    "output": "{\"remaining_minutes\":16}"
  }
}
모델이 함수 호출을 요청했다는 사실만으로 계산이나 외부 작업이 실행된 것은 아닙니다. 실패한 함수는 성공한 것처럼 결과를 만들지 말고 오류 결과를 돌려줍니다. 결제·삭제처럼 권한이 필요한 작업을 나중에 붙인다면 모델의 요청과 별개로 앱에서 사용자 권한과 실행 승인을 검사해야 합니다.
여러 호출이 나오면 함수별로 즉시 response.create를 보내지 않습니다. 같은 응답에서 나온 호출들을 모으고 모든 결과를 제출한 뒤 한 번만 이어갑니다. 앞선 음성이 재생 중이었다면 로컬 재생 완료도 기다려 오디오가 겹치지 않게 합니다. 이 동작은 병렬 도구 호출 안내에 설명되어 있습니다.
비용을 읽는 법: 대화 시간과 텍스트 항목을 나눠 계산하기
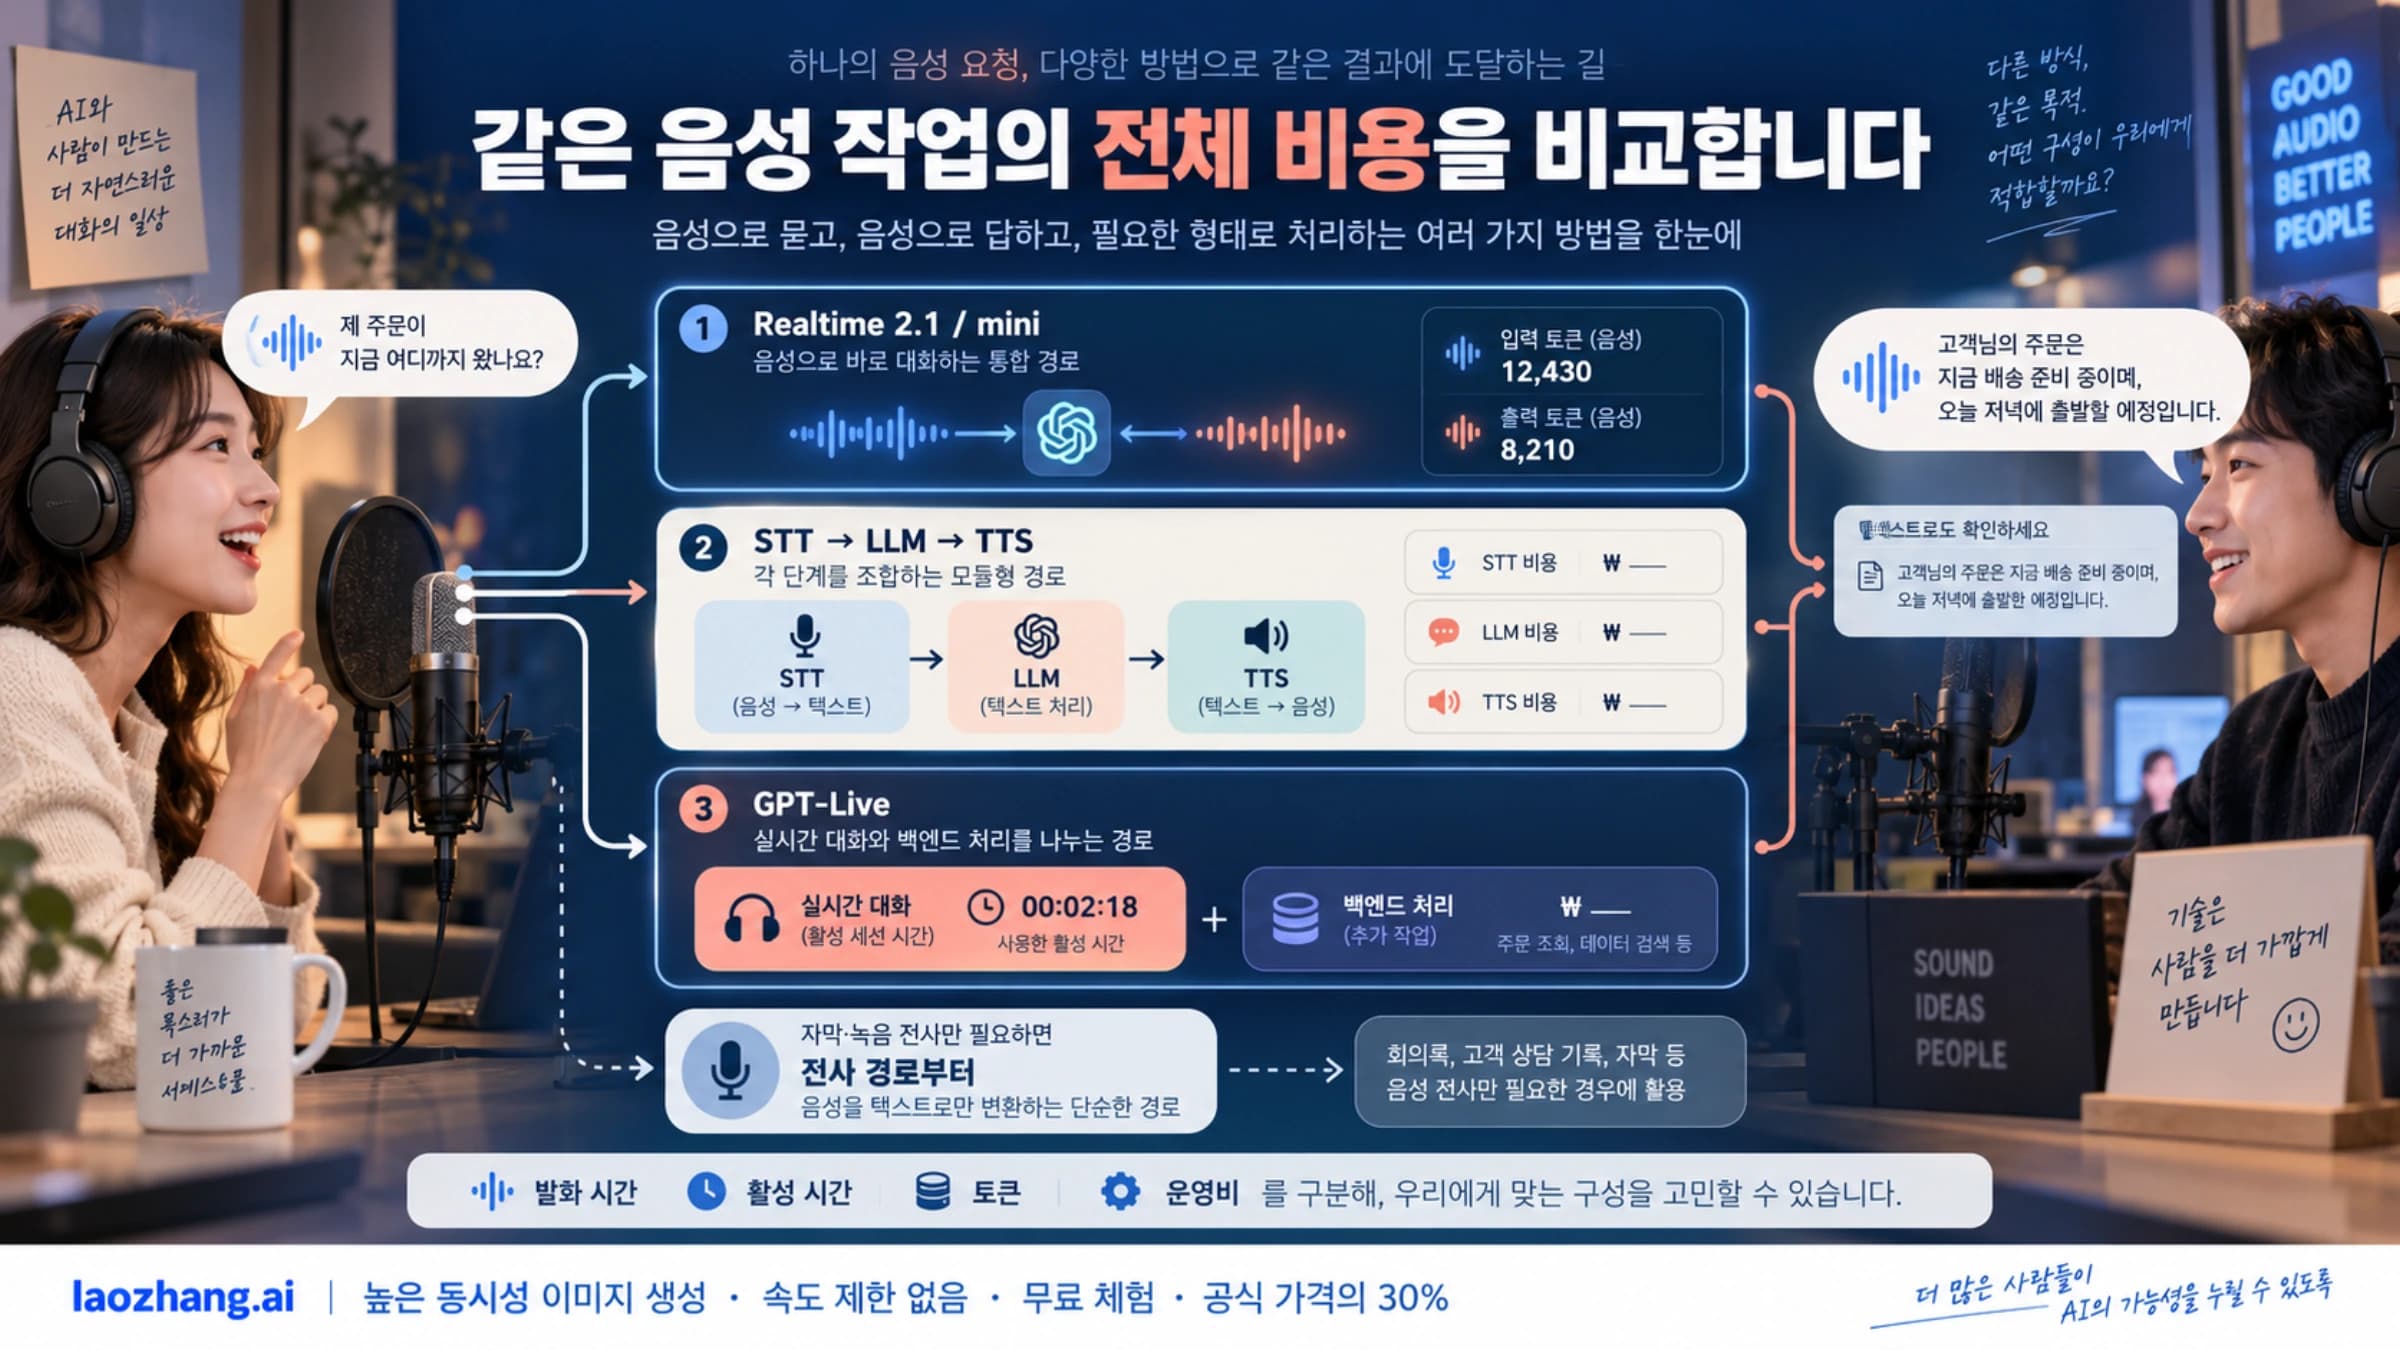
자동 감지 모드에서는 조용히 연결된 시간도 세션 요금에 포함됩니다. 푸시투토크에서는 보낸 오디오와 받은 오디오의 길이를 합산합니다. “사용자가 말한 시간 × 분당 요금”만 계산하면 두 모드 모두 예산을 잘못 잡을 수 있습니다. 음성 모델의 과금 설명
| 가정한 사용량 | 계산 | 오디오 요금 예시 |
|---|---|---|
server_vad로 15분 연결 | 15 × 0.08달러 | 1.20달러 |
| 수동 모드로 입력 4분, 출력 5분 | (4 + 5) × 0.08달러 | 0.72달러 |
| 오디오 1시간에 해당하는 사용량 | 60 × 0.08달러 | 4.80달러 |
위 값은 요금 단위로 계산한 가상 예산이며 실제 청구서가 아닙니다. 수동 모드로 15분을 켜 두고 그중 입력·출력이 위 표의 9분인 상황을 가정하면 오디오 요금 차이는 0.48달러입니다. 두 방식에서 같은 사용 경험이나 응답량이 보장된다는 비교는 아닙니다.
클라이언트가 conversation.item.create로 넣는 텍스트 항목은 항목당 0.004달러입니다. 예를 들어 텍스트 질문 30개를 넣으면 항목 요금은 0.12달러입니다. response.create 자체에는 이 항목 요금이 붙지 않지만, 생성되는 오디오는 여전히 과금됩니다. function_call_output과 오디오 과금 대상인 input_audio·audio 콘텐츠는 이 텍스트 항목 요금에서 제외됩니다. 현재 요금표, 항목별 예외
검색과 외부 서비스 비용은 추가로 확인해야 합니다. 일반 요금표에서 웹 검색은 1,000회당 5달러, X 검색은 가져온 게시물 1,000개당 5달러와 프로필 1,000개당 10달러로 단위가 다릅니다. 이를 모든 음성 함수 호출에 적용하는 고정 요금으로 읽으면 안 됩니다. 사용하는 도구의 적용 조건, 전화 연결 비용, 앱 서버 비용은 별도로 계산하세요. 도구 요금과 적용 범위
response.done에 나온 input_tokens, output_tokens, total_tokens는 토큰 사용 통계입니다. 이 수치에 일반 텍스트 모델 요금을 곱하거나, 문서에 보장되지 않은 billable_audio_seconds 같은 필드를 가정해 확정 청구액을 표시하지 않습니다. 위 예제의 PCM 바이트로 재생 시간을 계산할 수는 있어도 자동 감지 세션의 실제 청구 시간을 그 값으로 대체할 수는 없습니다.
오류와 재연결: 완료 여부와 대화 기록을 각각 관리하기
웹소켓이 열리는 단계의 성공 응답은 HTTP 101 업그레이드입니다. 연결이 열렸다는 사실만으로 설정, 음성 입력, 모델 응답까지 성공한 것은 아닙니다. 현재 연결 및 오류 참조
| 증상 | 먼저 확인할 것 | 다음 조치 |
|---|---|---|
| 접속 단계에서 인증 실패 | 서버 키·브라우저 단기 토큰 중 어느 경로인지, 토큰 만료 시각 | 브라우저라면 앱 서버에서 새 토큰을 발급받아 새 연결 생성 |
| 연결 후 오류 이벤트 | error.type, code, message, param, event_id | 잘못된 필드나 이벤트를 수정하고 해당 요청의 상태를 정리 |
| 응답 음성이 나오지 않음 | session.updated, 발화 모드, commit 확인, 출력 이벤트 종류 | 수동 모드는 response.create까지 갔는지, 이진 출력이라면 JSON만 기다리는지 확인 |
| 소리가 빠르거나 깨짐 | 출력 코덱, 샘플레이트, PCM 샘플 크기 | 수신 형식에 맞는 디코더와 재생 샘플레이트 사용 |
response.done은 왔지만 성공 처리하면 안 되는 상황 | response.status가 cancelled 또는 incomplete인지 | 완료 파일·성공 작업으로 처리하지 않고 취소·불완전 상태 표시 |
| 완료 전에 연결이 닫힘 | close 코드·이유, 마지막 응답 상태와 앱의 대기 제한 | 미완료 상태를 남기고 사용자가 재시도할 새 세션 준비 |
대부분의 API 오류는 세션을 유지할 수 있지만 모든 오류가 회복 가능한 것은 아닙니다. 한 번의 파일 요청을 다루는 위 예제는 오류를 받으면 종료하도록 단순화했습니다. 운영 앱에서는 입력 오류를 수정할지, 새 연결을 열지 구분하고 재시도 횟수를 제한합니다. timeout이나 max_duration이라는 코드 하나만으로 네트워크·권한·계정 상태의 원인을 확정하지 마세요. 오류 필드와 완료 상태
대화를 이어받아야 한다면 처음 연결에서 resumption.enabled: true를 설정하고 conversation.created.conversation.id를 저장합니다. 새 연결 주소에 conversation_id를 붙이고 새 세션에서도 같은 옵션을 켭니다. 캐시에는 이전 턴, 자막, 함수 호출과 함수 결과가 포함되며 30분 동안 활동이 없으면 기록이 사라집니다. 이 기능은 앱의 장기 기록 데이터베이스를 대신하지 않습니다. 세션 재개 안내
이전 항목이 다시 도착할 때 이미 실행한 작업을 반복해서는 안 됩니다. 재개 가이드는 재전송 항목을 conversation.item.created로, 현재 참조는 새 항목을 conversation.item.added로 설명합니다. 호환 처리에서는 두 이름을 인식하되, 재전송된 과거 기록을 새로운 함수 실행 요청과 구분합니다. 응답 ID와 call_id별 처리 기록을 앱에 남기는 이유입니다. 자동 재연결이 외부 작업의 중복 실행을 해결해 주는 것은 아닙니다.
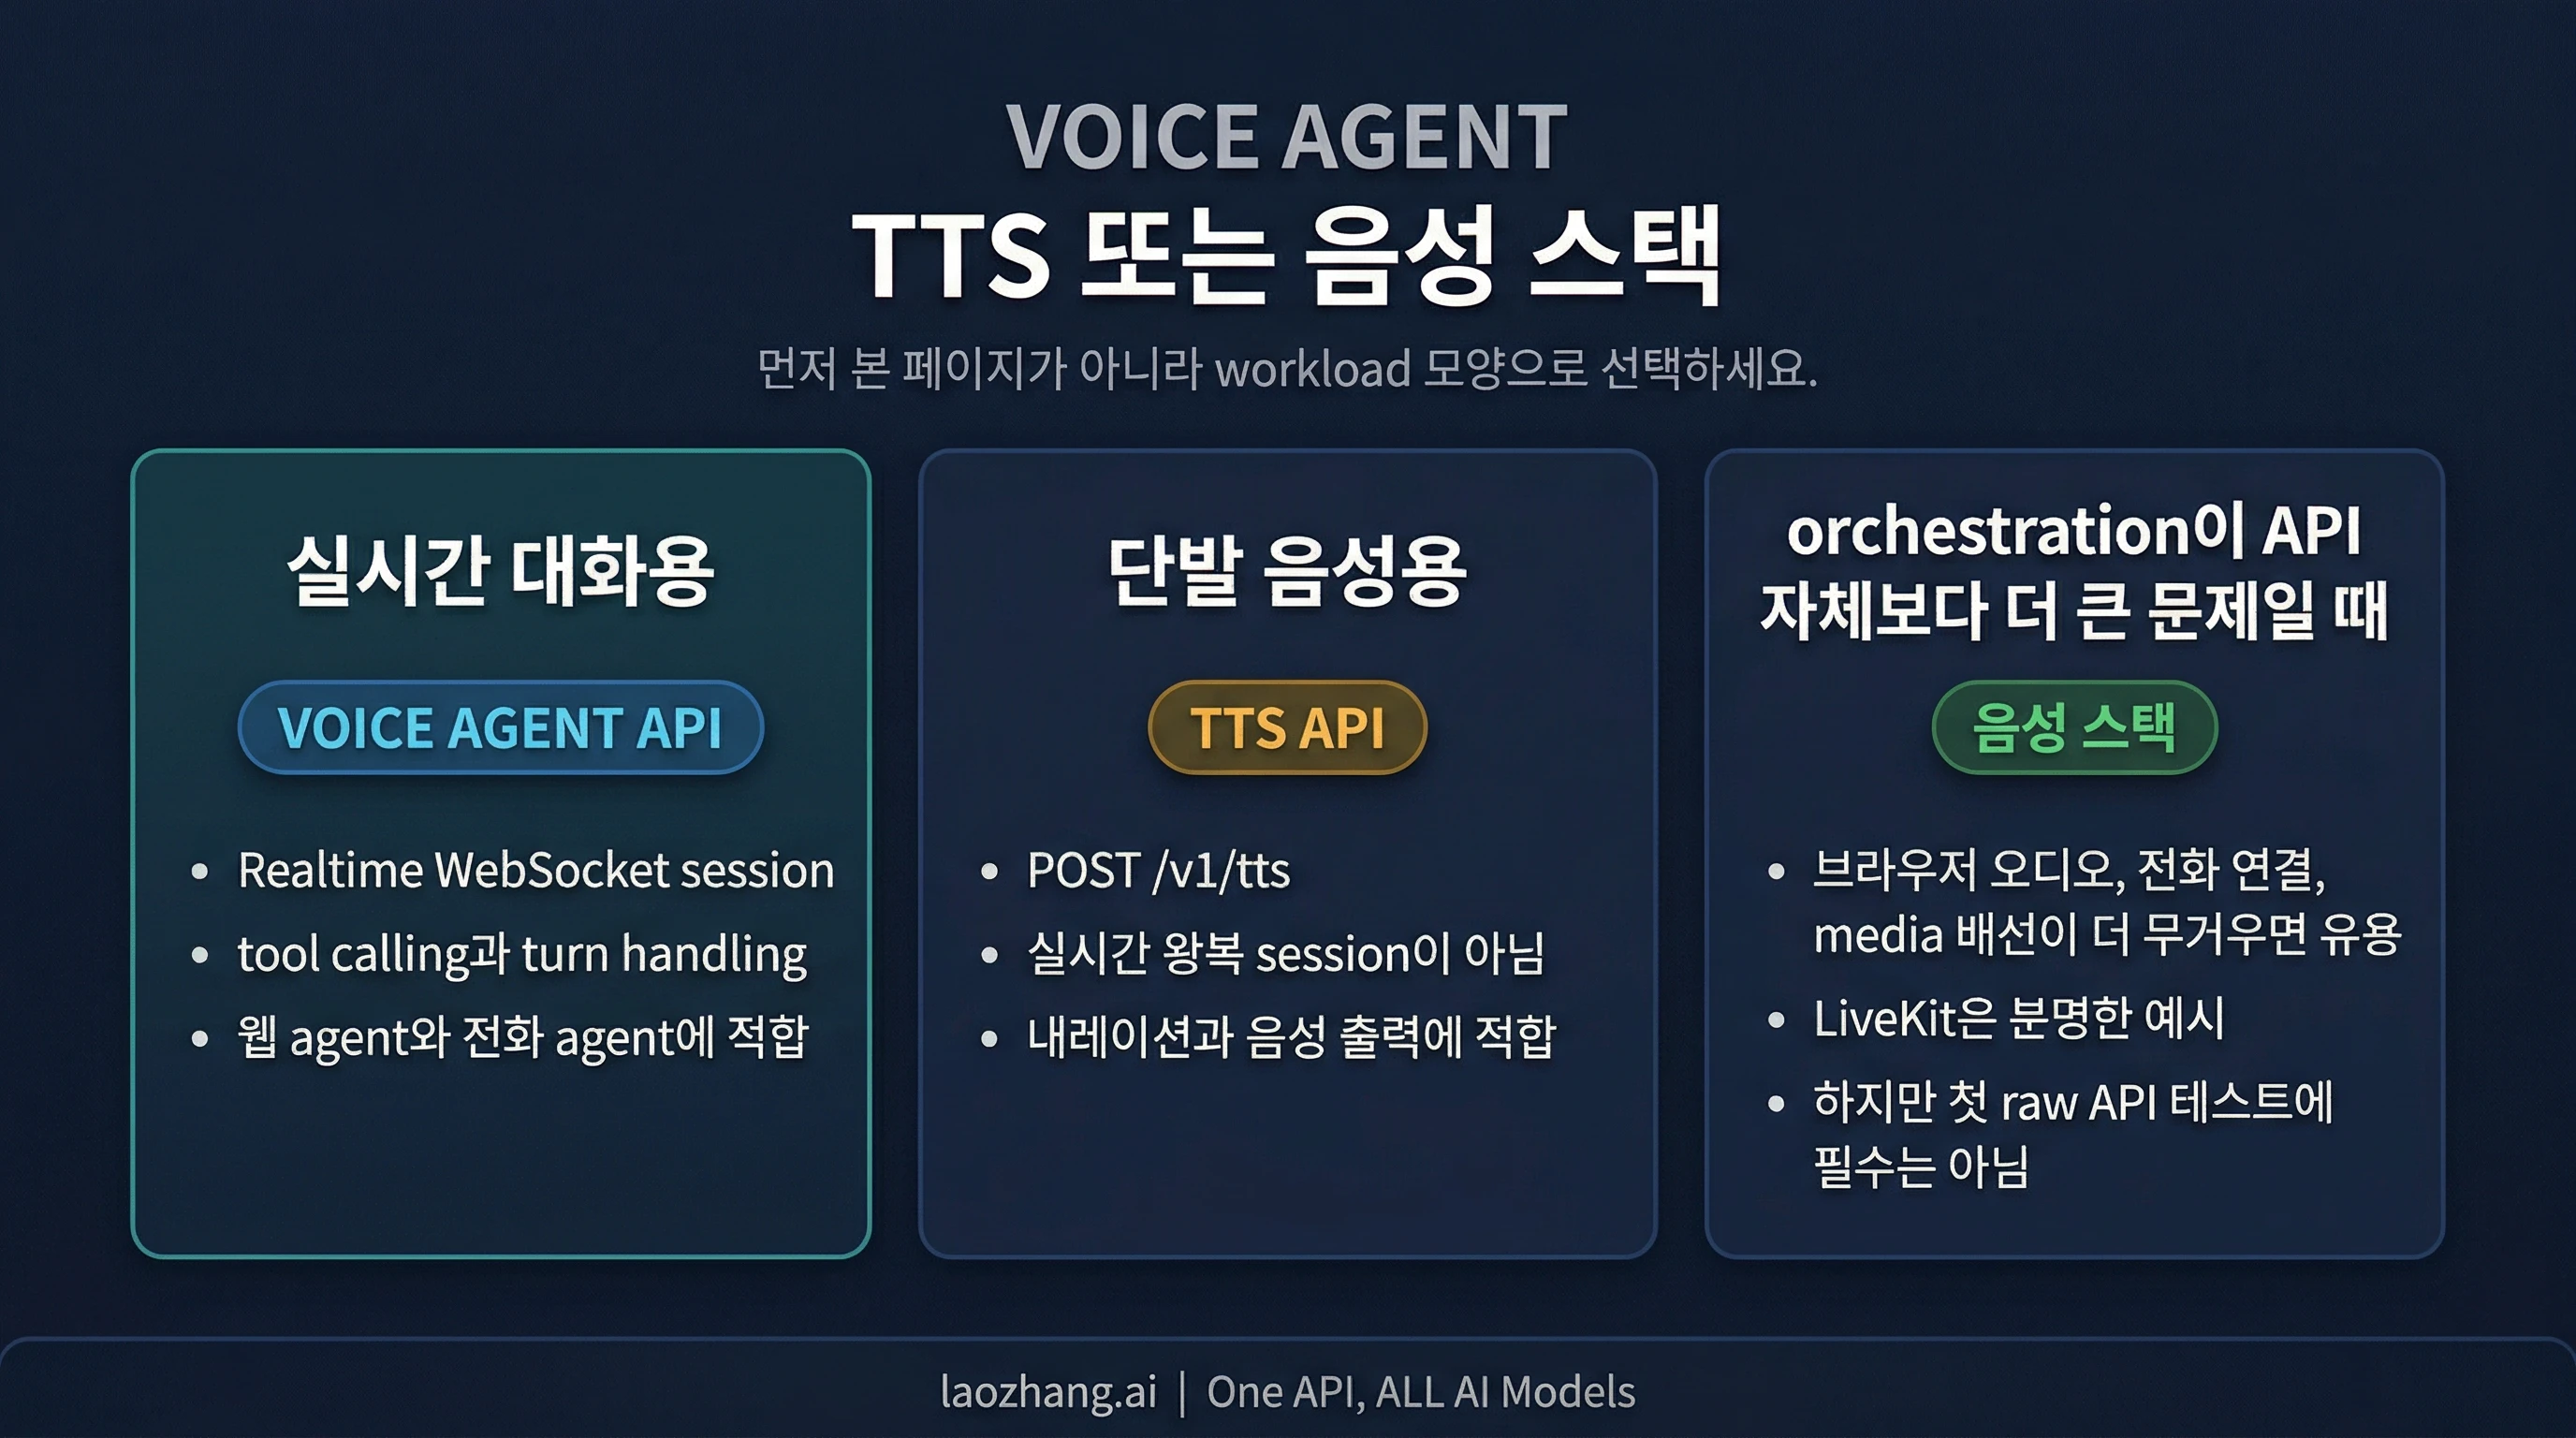
먼저, 지금 고르려는 음성 경로가 무엇인지 나누기
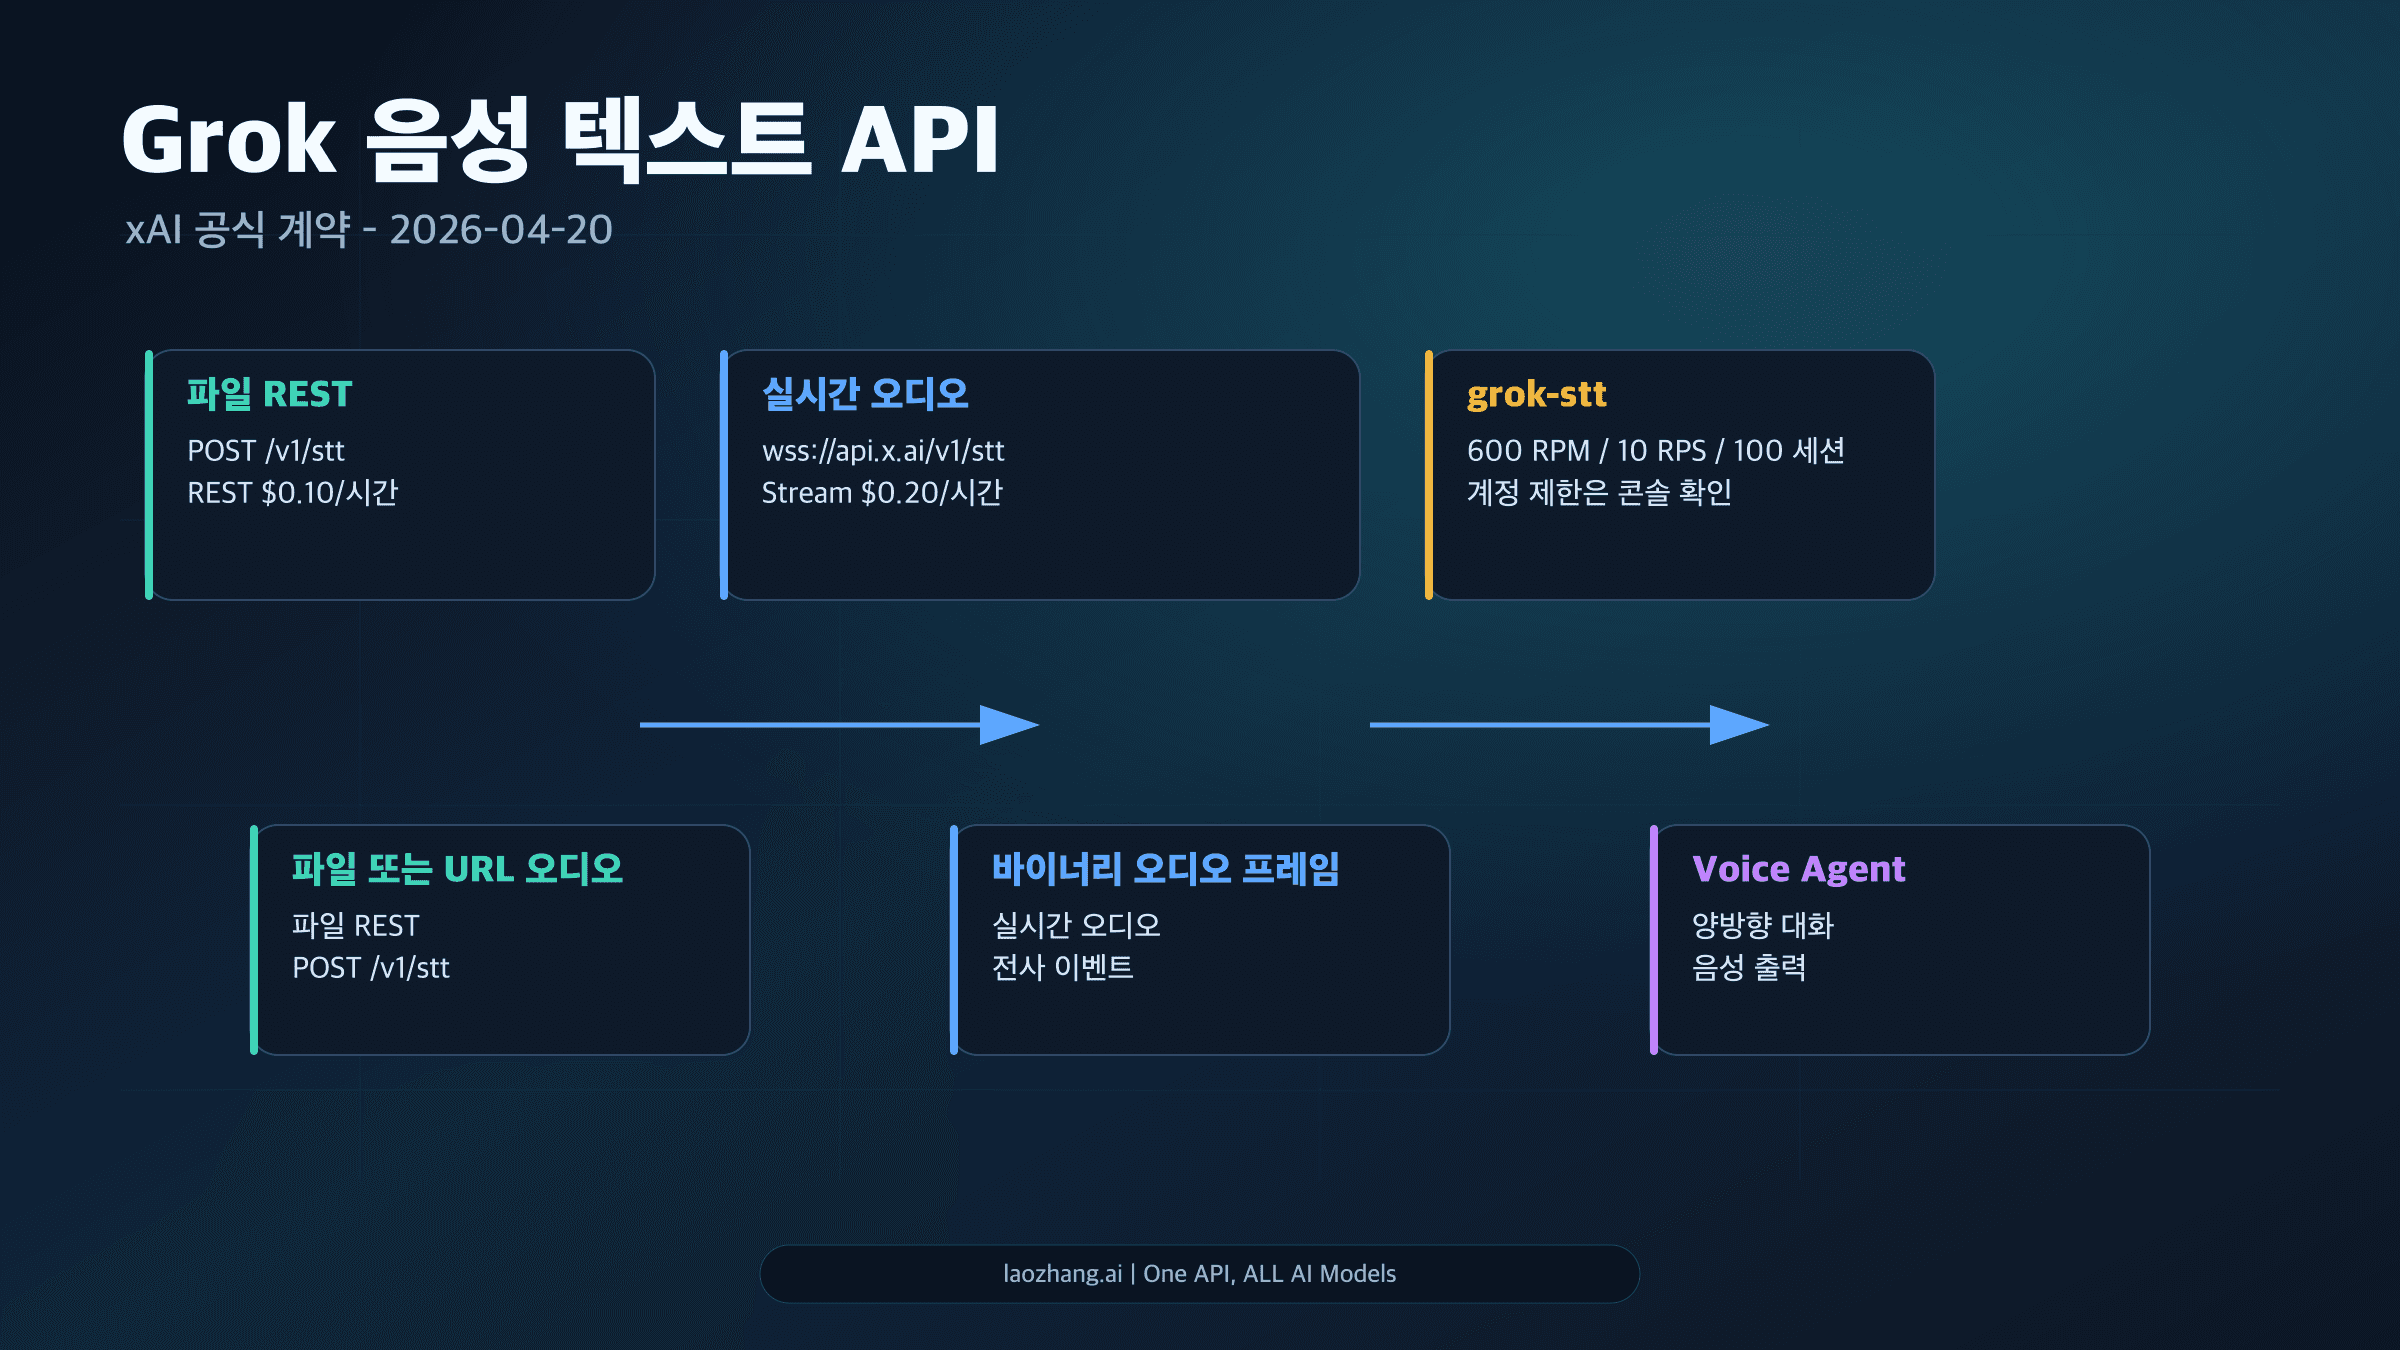
양방향 음성 대화가 필요하면 이 글의 /v1/realtime 흐름을 사용합니다. 입력을 받아 텍스트만 얻거나, 준비한 문장을 소리로 읽는 작업에는 별도 경로가 있습니다.
| 만들려는 기능 | 경로 | 결과 |
|---|---|---|
| 사용자와 에이전트가 음성으로 대화 | wss://api.x.ai/v1/realtime | 대화 응답 음성·자막·도구 이벤트 |
| 파일이나 음성 URL을 텍스트로 전사 | POST https://api.x.ai/v1/stt | 전사 텍스트 |
| 실시간 음성을 텍스트로 전사 | wss://api.x.ai/v1/stt | 스트리밍 전사 |
| 이미 정해진 텍스트를 음성으로 생성 | POST https://api.x.ai/v1/tts 또는 TTS 웹소켓 | 합성 음성 |
현재 음성 API 참조에 따르면 별도 STT의 기본 모델은 grok-voice-transcribe-2.0입니다. 이 글의 실시간 대화 안에서 입력 자막을 켜는 grok-transcribe와 구분합니다. TTS는 language를 지정하며, with_timestamps 설정에 따라 바이너리 오디오와 Base64 JSON 응답이 달라집니다. 새 전사·합성 기능의 구현은 각 공식 API 계약을 확인해 시작하세요.
마이크 캡처, 재생 대기열, 전화 라우팅이나 WebRTC 연결이 개발의 대부분을 차지하기 시작하면 음성 프레임워크도 검토할 수 있습니다. 프레임워크를 쓰더라도 서버 키와 클라이언트 토큰, 입력·출력 코덱, 생성 완료와 재생 완료의 구분은 유지해야 합니다. 공식 음성 제품별 안내
OpenAI Realtime에서 왔다면 이것부터 확인하기
연결 주소와 인증만 바꾸기 전에 이벤트 처리도 확인합니다. 현재 xAI API는 response.text.delta와 response.output_text.delta를 모두 설명하며, 입력 자막은 delta가 아닌 누적 updated입니다. conversation.item.truncate도 현재 지원됩니다. 현재 호환성 안내
반면 conversation.item.retrieve는 지원되지 않고, 직접 웹소켓에서 WebRTC/SIP용 output_audio_buffer.clear를 로컬 재생 중단 명령으로 사용할 수는 없습니다. 지원되지 않는 이벤트를 보내는 대신 앱의 재생 대기열과 기록 상태를 직접 관리합니다.
응답을 고정 문장으로 읽어 주는 force_message도 일반 모델 응답 요청과 다릅니다. 이 항목은 자체적으로 음성 응답을 만들므로 뒤에 response.create를 보내지 않습니다. interruptible: false는 재생 중 사용자 오디오를 버리는 설정입니다. 사용자 동의 확인 기능으로 해석하면 안 됩니다. 고정 안내 음성
자주 묻는 질문
Grok Voice API의 현재 모델 이름은 무엇인가요?
현재 직접 음성 대화 모델은 grok-voice-think-fast-2.0이며 grok-voice-latest가 이를 가리킵니다. 특정 버전의 동작을 유지하려면 버전이 붙은 이름으로 연결합니다. 과거 1.0이 계속 제공되거나 잘못된 모델 이름에 대한 기본 대체 모델이라고 가정하지 마세요. 현재 모델 목록
아무 말도 하지 않는 시간에도 과금되나요?
기본 server_vad 모드는 침묵을 포함한 세션 시간 기준으로 분당 0.08달러를 과금합니다. 푸시투토크는 입력·출력 오디오 시간을 기준으로 합니다. 연결을 끊지 않고 마이크만 끄는 동작은 자동 감지 세션의 종료와 다릅니다. 과금 모드 설명
텍스트로 질문해도 비용이 생기나요?
클라이언트가 conversation.item.create로 만드는 텍스트 항목당 0.004달러입니다. response.create는 이 항목 요금 자체를 발생시키지 않지만 응답 음성은 별도 오디오 과금 대상입니다. 함수 결과와 오디오 콘텐츠에는 문서의 예외가 적용됩니다. 항목 요금과 예외
단기 토큰으로 브라우저에서 바로 연결할 수 있나요?
네. 자기 앱 서버가 인증과 예산을 확인한 뒤 발급한 토큰을 xai-client-secret.<TOKEN> 서브프로토콜로 보냅니다. 장기 키를 브라우저 코드에 넣지 않습니다. 소비자용 Grok 로그인이나 구독이 이 API 인증을 대신하는 것도 아닙니다. 브라우저 인증 방법
response.done을 받으면 사용자가 답변을 다 들은 건가요?
아닙니다. 서버 생성이 끝난 상태이며, completed·cancelled·incomplete를 구분해야 합니다. 스피커가 다 재생했는지는 앱의 오디오 대기열에서 별도로 확인합니다. 완료 상태 스키마
음성 전사만 필요해도 Voice Agent API를 써야 하나요?
전사만 필요하면 별도 STT 경로를 사용합니다. 파일·URL은 POST /v1/stt, 실시간 전사는 wss://api.x.ai/v1/stt이며 현재 별도 STT의 기본 모델은 grok-voice-transcribe-2.0입니다. Voice Agent API는 응답을 생성하는 대화를 위한 경로입니다. 현재 STT 계약
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 8일.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 8일.
- 1.공식 음성 대화 가이드docs.x.ai/developers/model-capabilities/audio/speech-to-speech
- 2.인증 안내docs.x.ai/developers/model-capabilities/audio/ephemeral-tokens
- 3.현재 모델 및 과금 기준docs.x.ai/developers/models/speech-to-speech
- 4.음성 제품 안내docs.x.ai/developers/model-capabilities/audio/voice
- 5.토큰 API 참조docs.x.ai/developers/rest-api-reference/inference/voice
- 6.truncate 계약과 스키마docs.x.ai/voice-realtime.ws.json
- 7.현재 요금표docs.x.ai/developers/pricing