Claude API 500 api_error 해결: 재시도 설정과 요청 ID 확인
Claude API가 500 api_error를 반환하면 오류 응답과 요청 ID를 보존하고 SDK 재시도를 확인하세요. 제한된 백오프 후에도 실패할 때 작업 중단·연기와 지원 문의로 이어가는 절차를 안내합니다.
목차
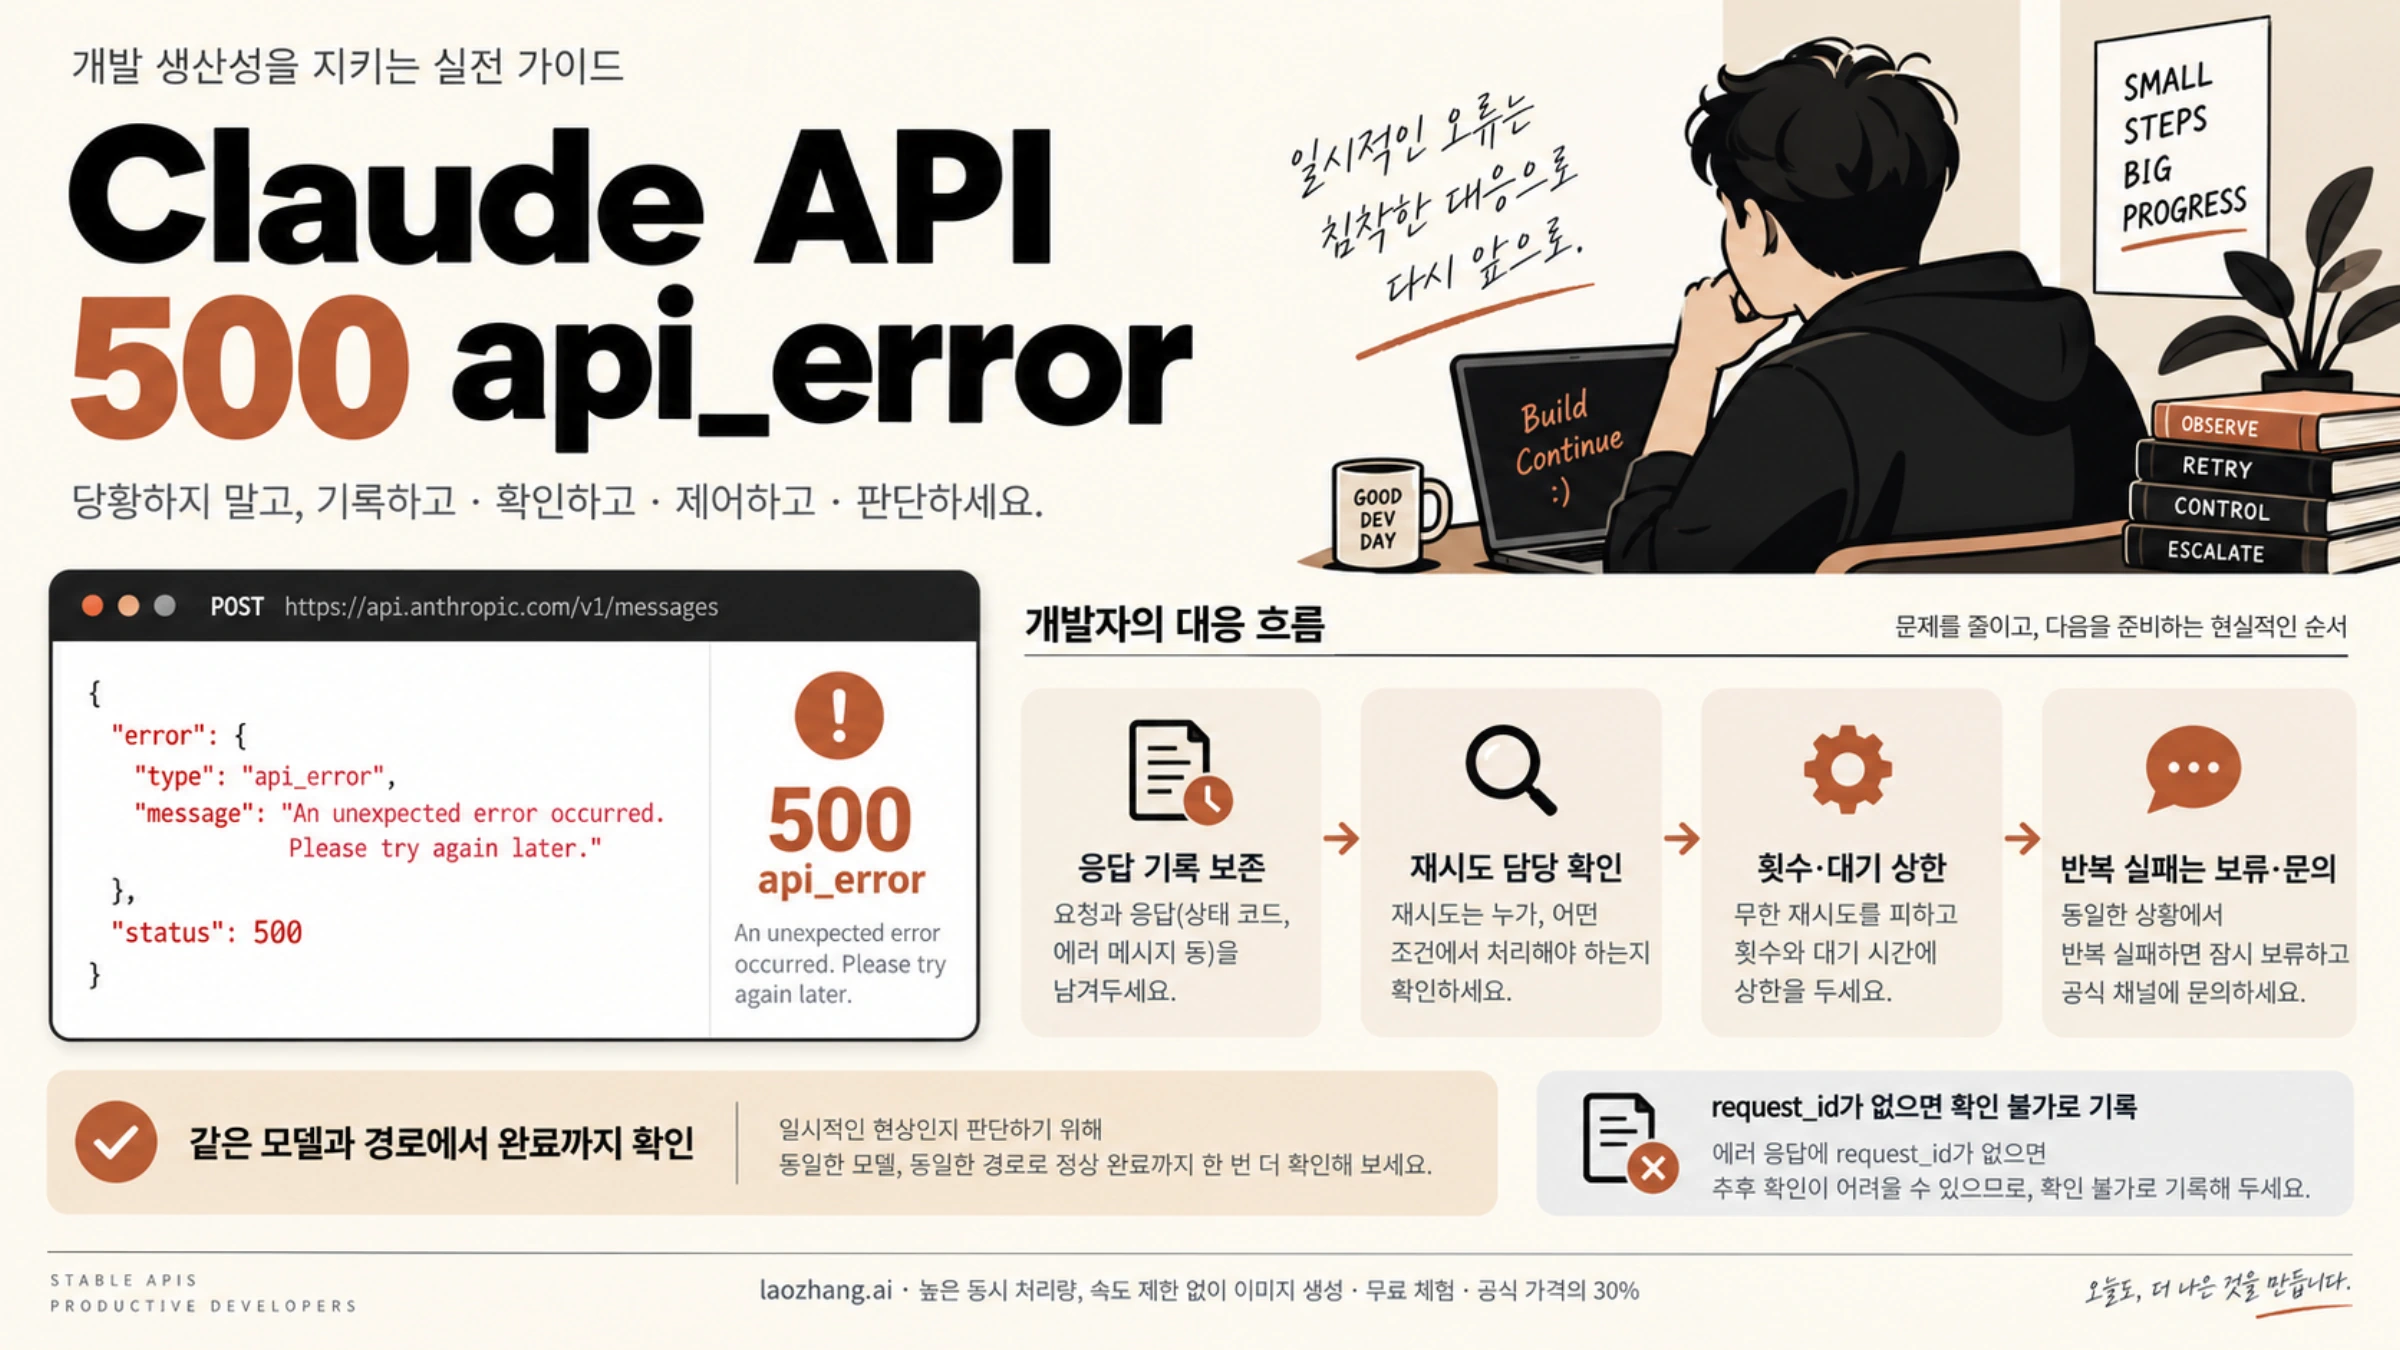
Claude API가 HTTP 500과 api_error를 반환했다면 요청 ID와 오류 응답을 남기고, 이미 설정된 재시도를 확인한 뒤 제한된 지수 백오프를 적용하세요. 공식 API 오류 문서는 이를 Anthropic 시스템 내부의 예상하지 못한 오류로 정의하며, 반복되면 요청 ID를 첨부해 지원팀에 문의하도록 안내합니다. 500만 보고 API 키를 교체하거나 프롬프트를 다시 작성할 필요는 없습니다.
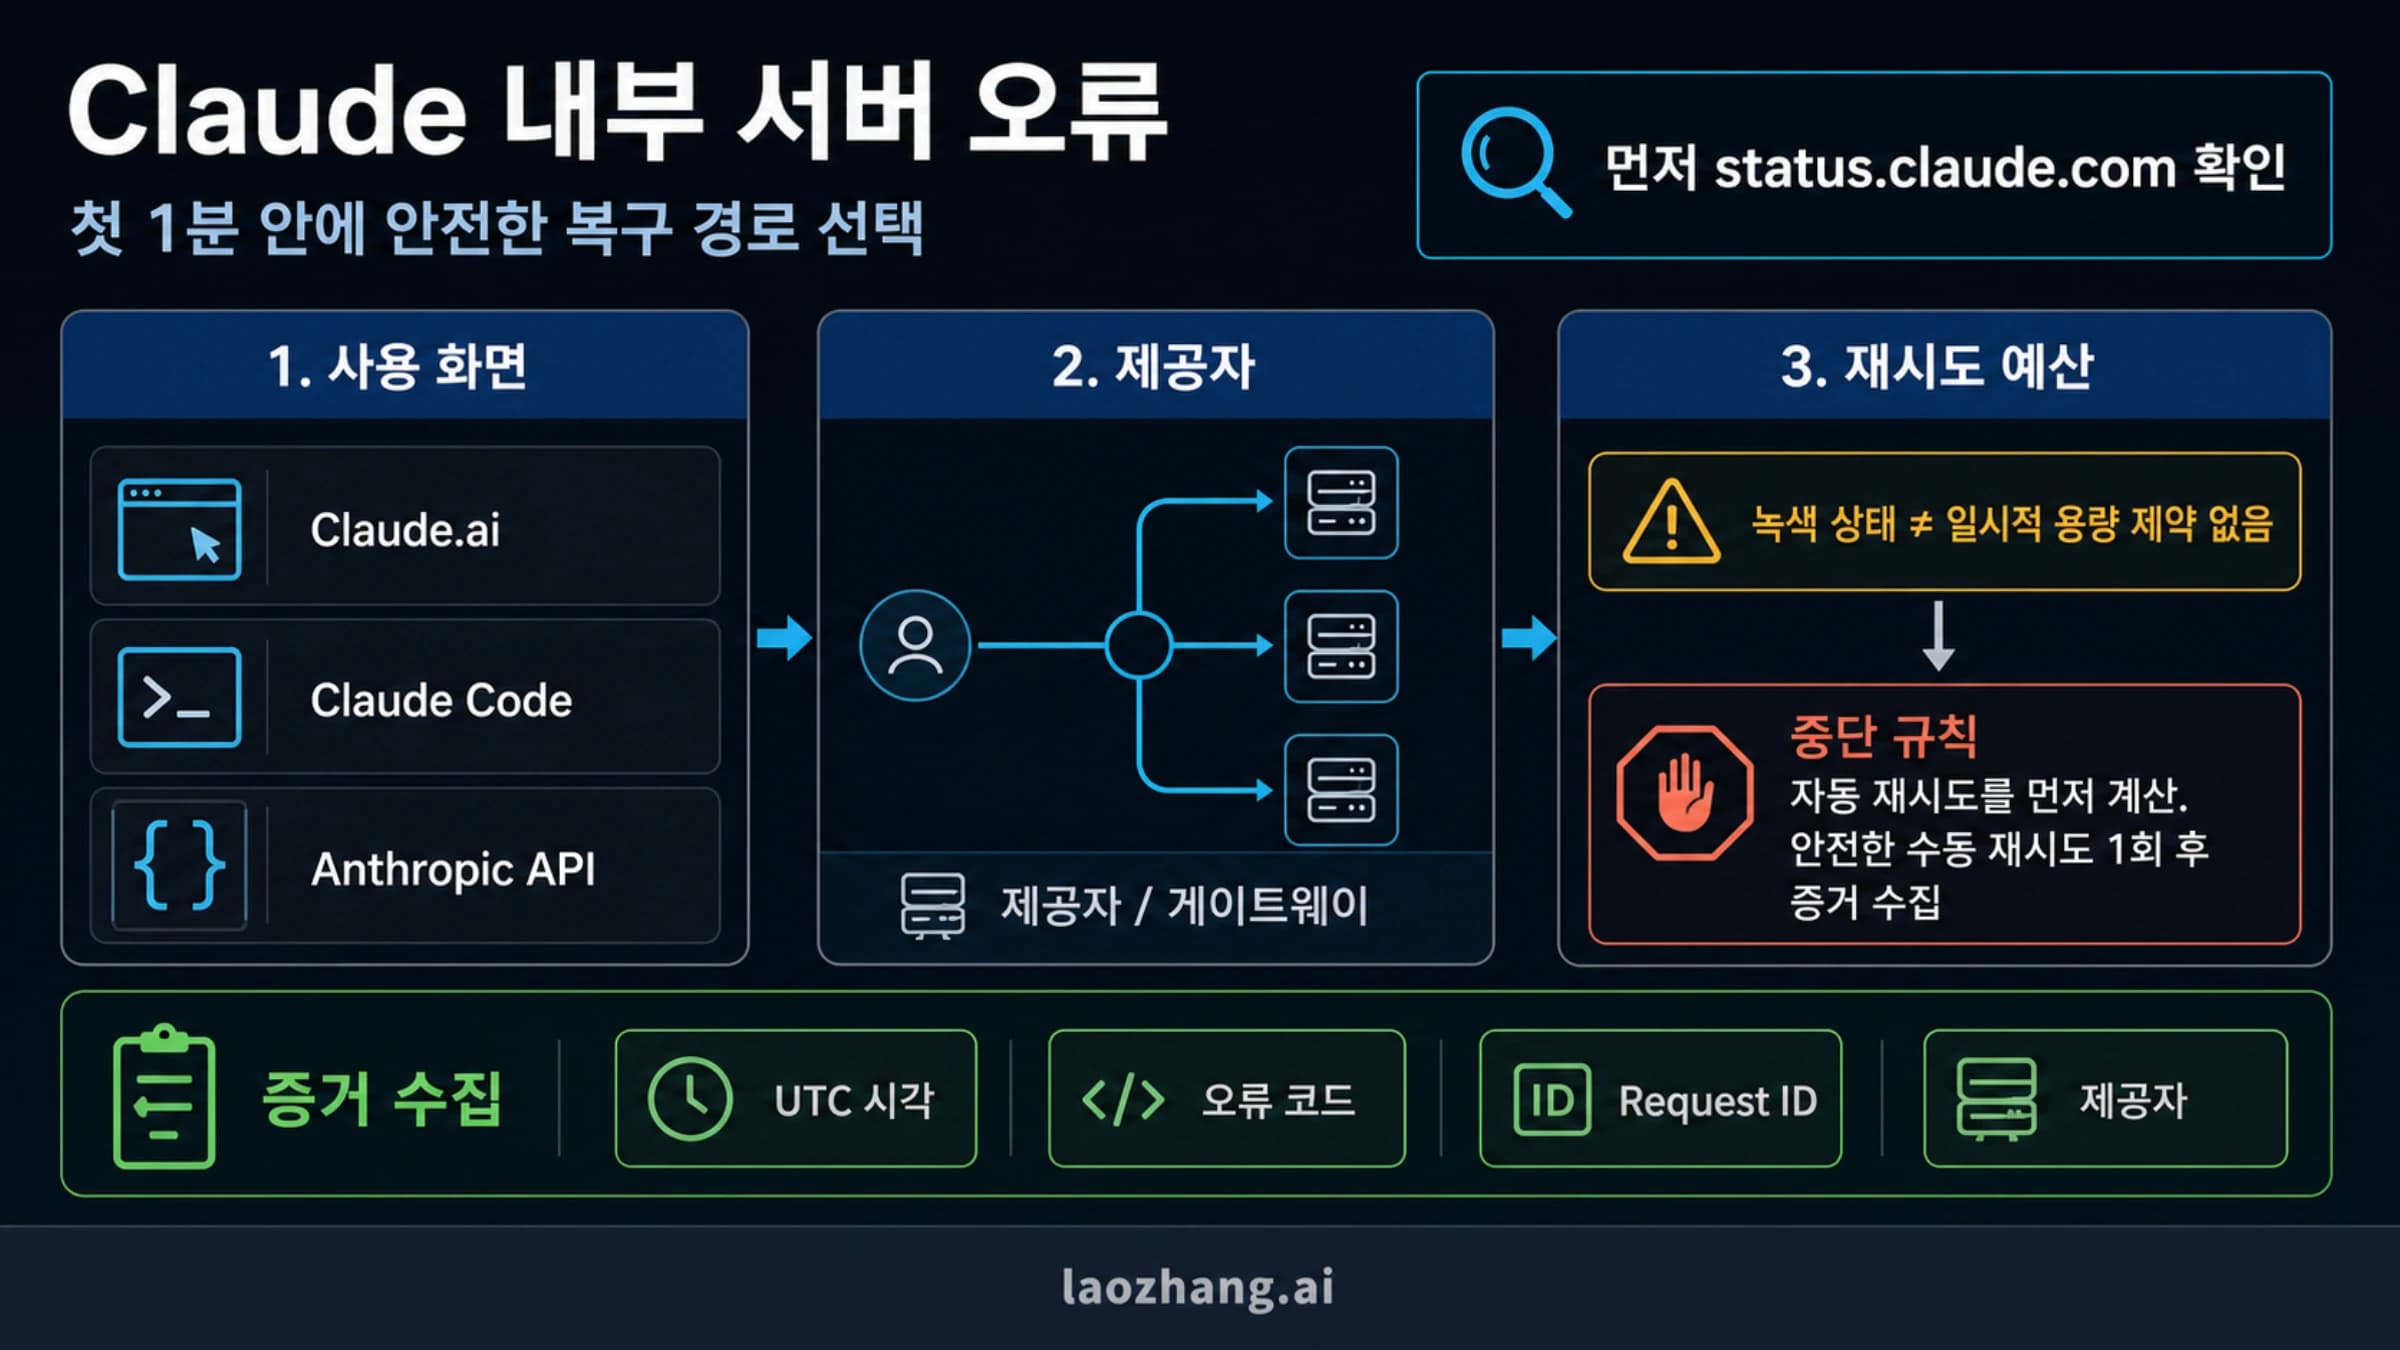
먼저 Claude Status에서 사용하는 서비스의 장애 여부를 확인합니다. 재전송해도 안전한 요청이라면 같은 모델·엔드포인트·입력으로 재시도하고, 허용한 횟수나 작업의 대기 시간이 끝나면 멈춥니다. 사용자 요청에는 명확한 실패 또는 보류 결과를 반환하고, 급하지 않은 작업은 저장해 나중에 처리하세요. 상태 페이지가 정상이어도 같은 요청이 계속 실패하면 기록을 모아 문의할 수 있습니다.
이 글은 앱이 실제로 받은 API 오류 응답을 처리하는 개발자를 위한 안내입니다. Claude Code 터미널에서 API Error: 500 Internal server error 또는 Error during compaction을 봤다면 자동 재시도와 완료한 작업을 확인하는 Claude Code 복구 절차도 확인하세요. 터미널의 표시 문구만으로 직접 Messages API의 응답이나 실패 원인을 확정할 수는 없습니다.
500 응답에서 먼저 보존할 정보
HTTP 상태, 오류 유형, 실제 요청 대상을 함께 기록하세요. 직접 Claude API의 오류는 JSON이며 error.type, error.message, request_id가 들어갑니다. 다음은 형식을 설명하기 위한 예시입니다. 요청 ID는 실제 실패 응답의 값으로 기록해야 합니다.
{
  "type": "error",
  "error": {
    "type": "api_error",
    "message": "Internal server error"
  },
  "request_id": "req_example"
}
요청 ID 안내에 따르면 API 응답의 request-id 헤더와 오류 본문의 request_id는 같은 요청을 가리킵니다. SDK가 응답 헤더를 제공한다면 이 값을 보존하세요. 성공한 Python 응답 객체의 _request_id와 실패 예외에서 읽는 요청 정보는 접근 방법이 다르므로, 성공 객체의 필드만 기록하는 로깅으로는 실패를 추적하기 어렵습니다.
요청 ID가 없다는 사실만으로 HTTP 응답을 받지 못했다고 판단하지 마세요. SDK가 ID를 노출하지 않거나 중간 게이트웨이가 헤더를 제거했을 수 있습니다. 받은 HTTP 상태·본문·헤더를 먼저 확인하고 ID는 없으면 “확인할 수 없음”으로 남깁니다. 임의의 요청 ID를 만들거나 다른 시도의 ID를 붙이면 지원팀이 잘못된 요청을 조사하게 됩니다.
HTML 오류 페이지를 받은 경우에도 반환 주체를 확인해야 합니다. 프록시나 로드 밸런서의 HTTP 500은 Anthropic의 JSON 500 api_error와 같은 근거로 진단할 수 없습니다. 게이트웨이를 이용한다면 앱이 받은 ID와 게이트웨이가 받은 제공자 ID를 각각 연결해 추적하세요.
다른 오류로 바뀌면 처리도 바꿉니다
공식 오류 분류를 기준으로 실제 응답을 구분합니다. 이 표는 웹 화면의 일반적인 “서버 오류” 표시를 분류하는 용도가 아닙니다.
| 확인한 응답 | 의미와 다음 행동 |
|---|---|
500 api_error | 예상하지 못한 내부 API 오류입니다. 응답 기록을 보존하고 제한된 백오프 후 반복되면 문의합니다. |
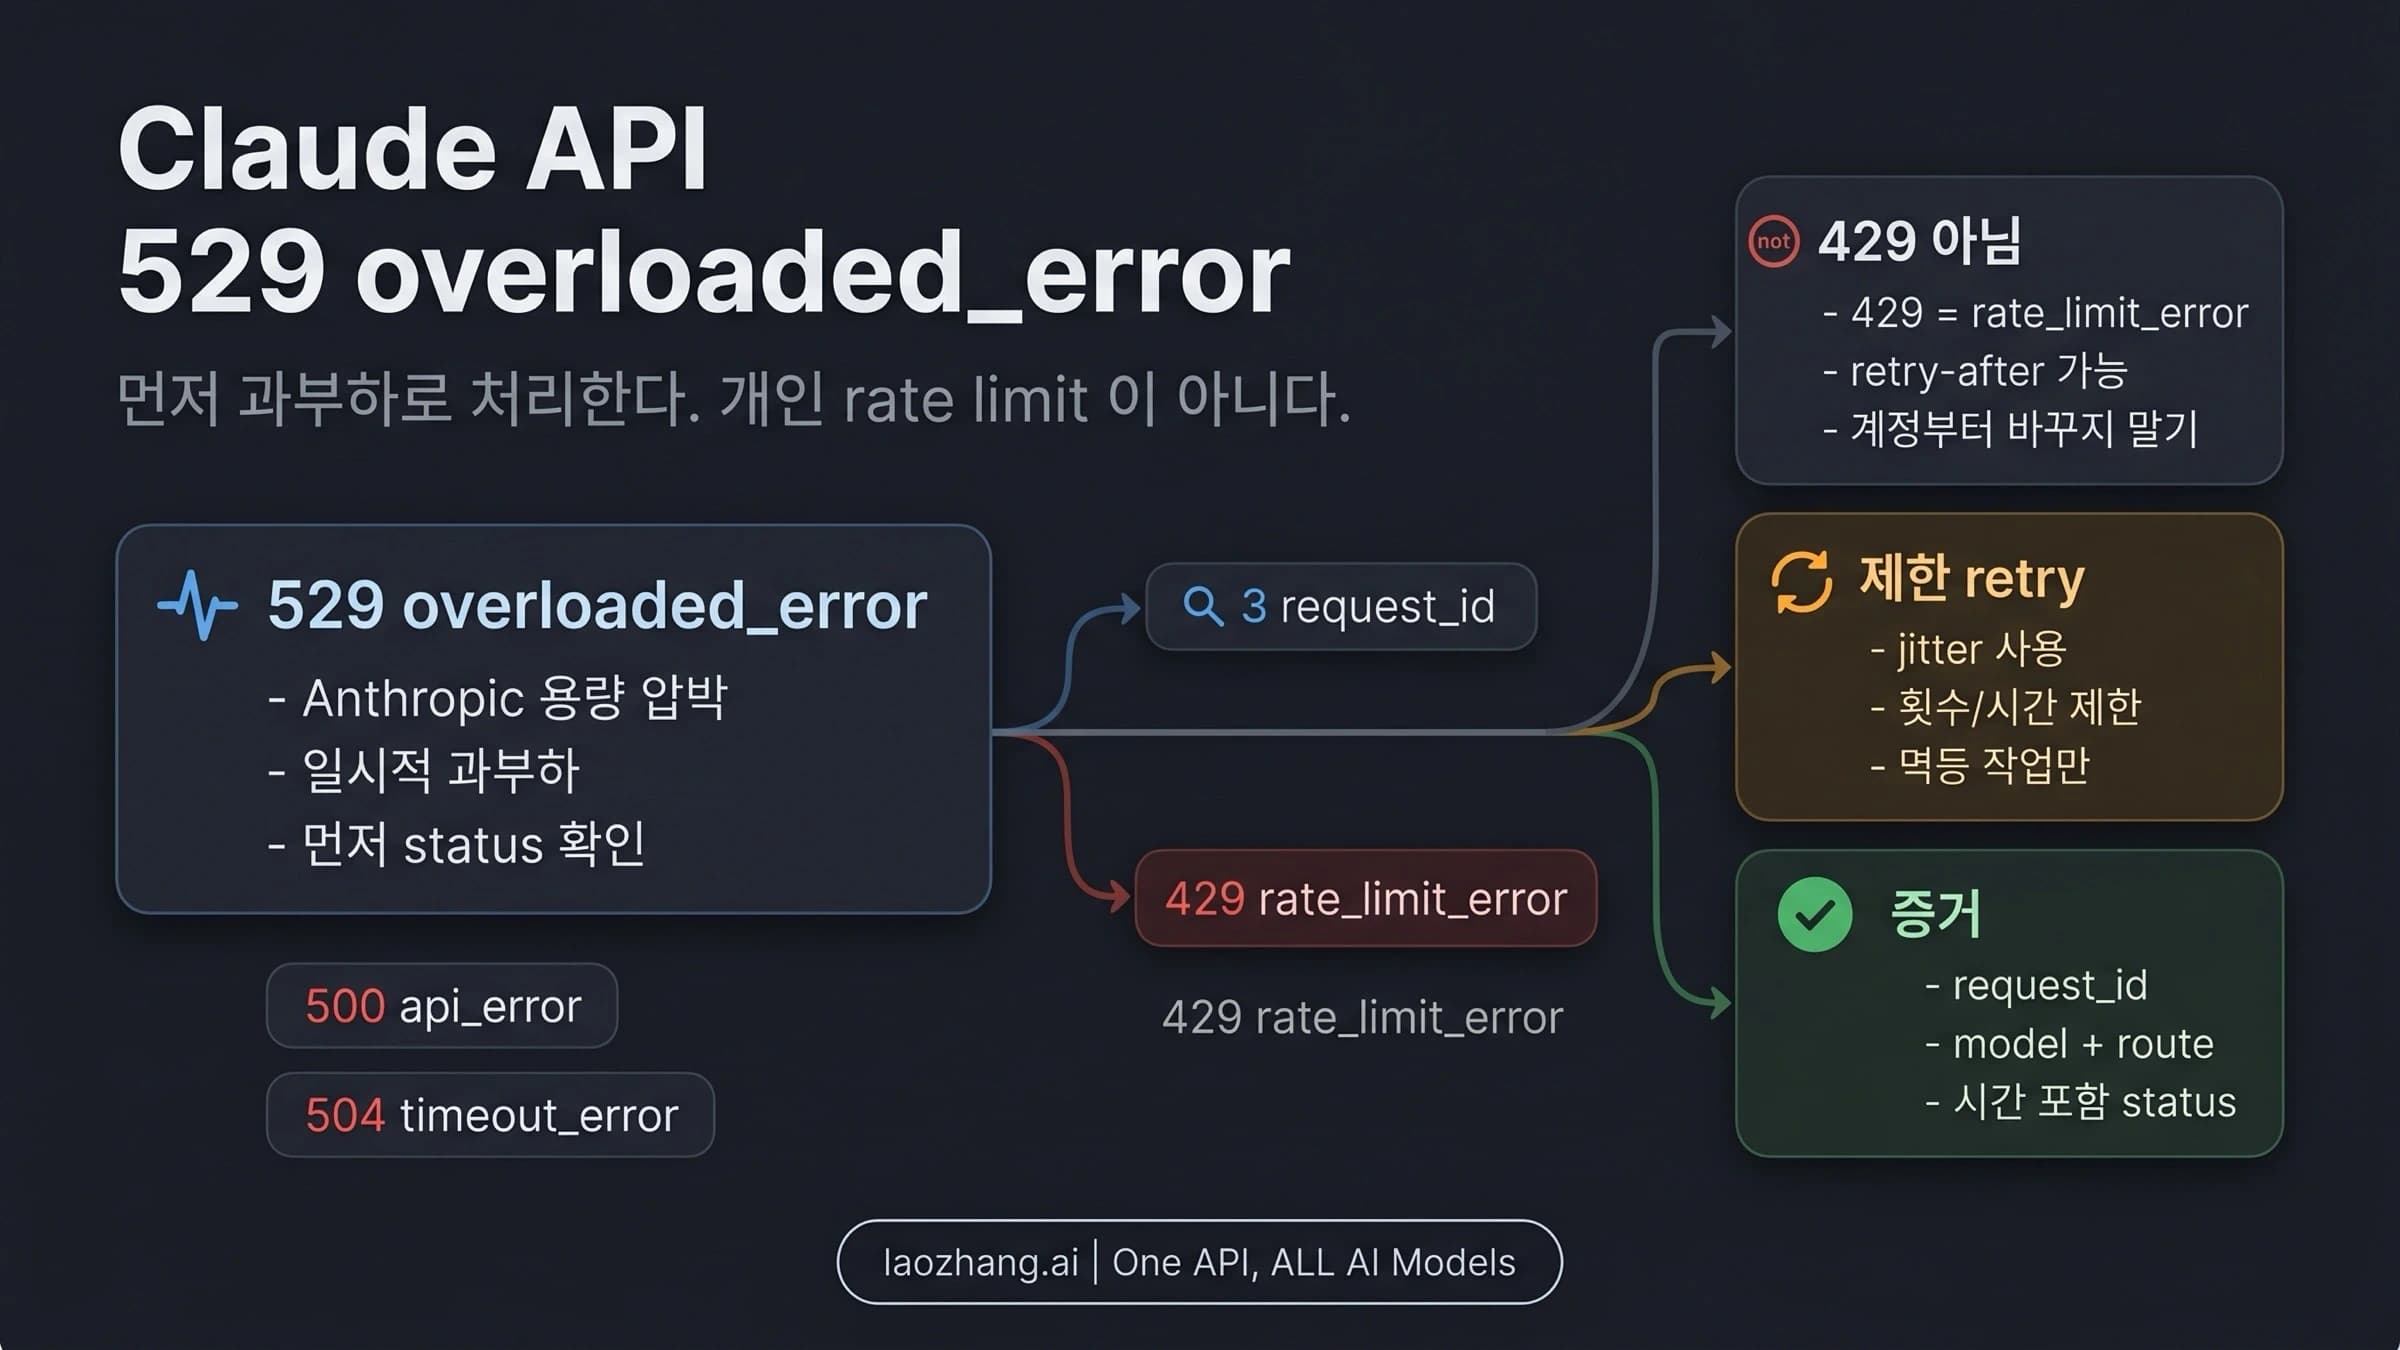
529 overloaded_error | 일시적 과부하입니다. 529 대응과 재시도 설정에서 대기와 동시 요청 조절을 확인합니다. |
429 rate_limit_error | 요청 속도 제한이나 특정 지출 상한일 수 있습니다. 오류 본문·한도·대기 지시를 확인합니다. |
504 timeout_error | 서버가 요청을 처리하다 시간이 초과됐습니다. 긴 요청의 스트리밍이나 작업 분할을 검토합니다. |
401 authentication_error, 402 billing_error, 403 permission_error | 인증·결제·접근 권한에 해당하는 응답입니다. 새로 나온 코드에 맞춰 조사합니다. |
| HTTP 응답 없이 연결·클라이언트 타임아웃 예외 | 연결과 전송 시간을 조사합니다. 반환된 500 api_error로 기록하지 않습니다. |
429 중 사용 등급의 월 지출 상한에 따른 오류에는 retry-after가 없고 접근이 복구될 때까지 실패할 수 있습니다. 모든 429를 500처럼 잠깐 기다렸다 반복하는 정책에 넣으면 안 됩니다. 반대로 500만으로 계정 잔액이나 API 키가 원인이라고 추정하지 마세요.
오류가 난 화면이나 응답 주체부터 불명확하다면 Claude 내부 서버 오류의 사용 화면별 대처에서 웹·Code·직접 API·중간 서비스를 구분할 수 있습니다. 이 페이지의 나머지 절차는 반환된 API 500에 집중합니다.
재시도는 SDK와 앱 중 누가 맡는지 먼저 정하세요
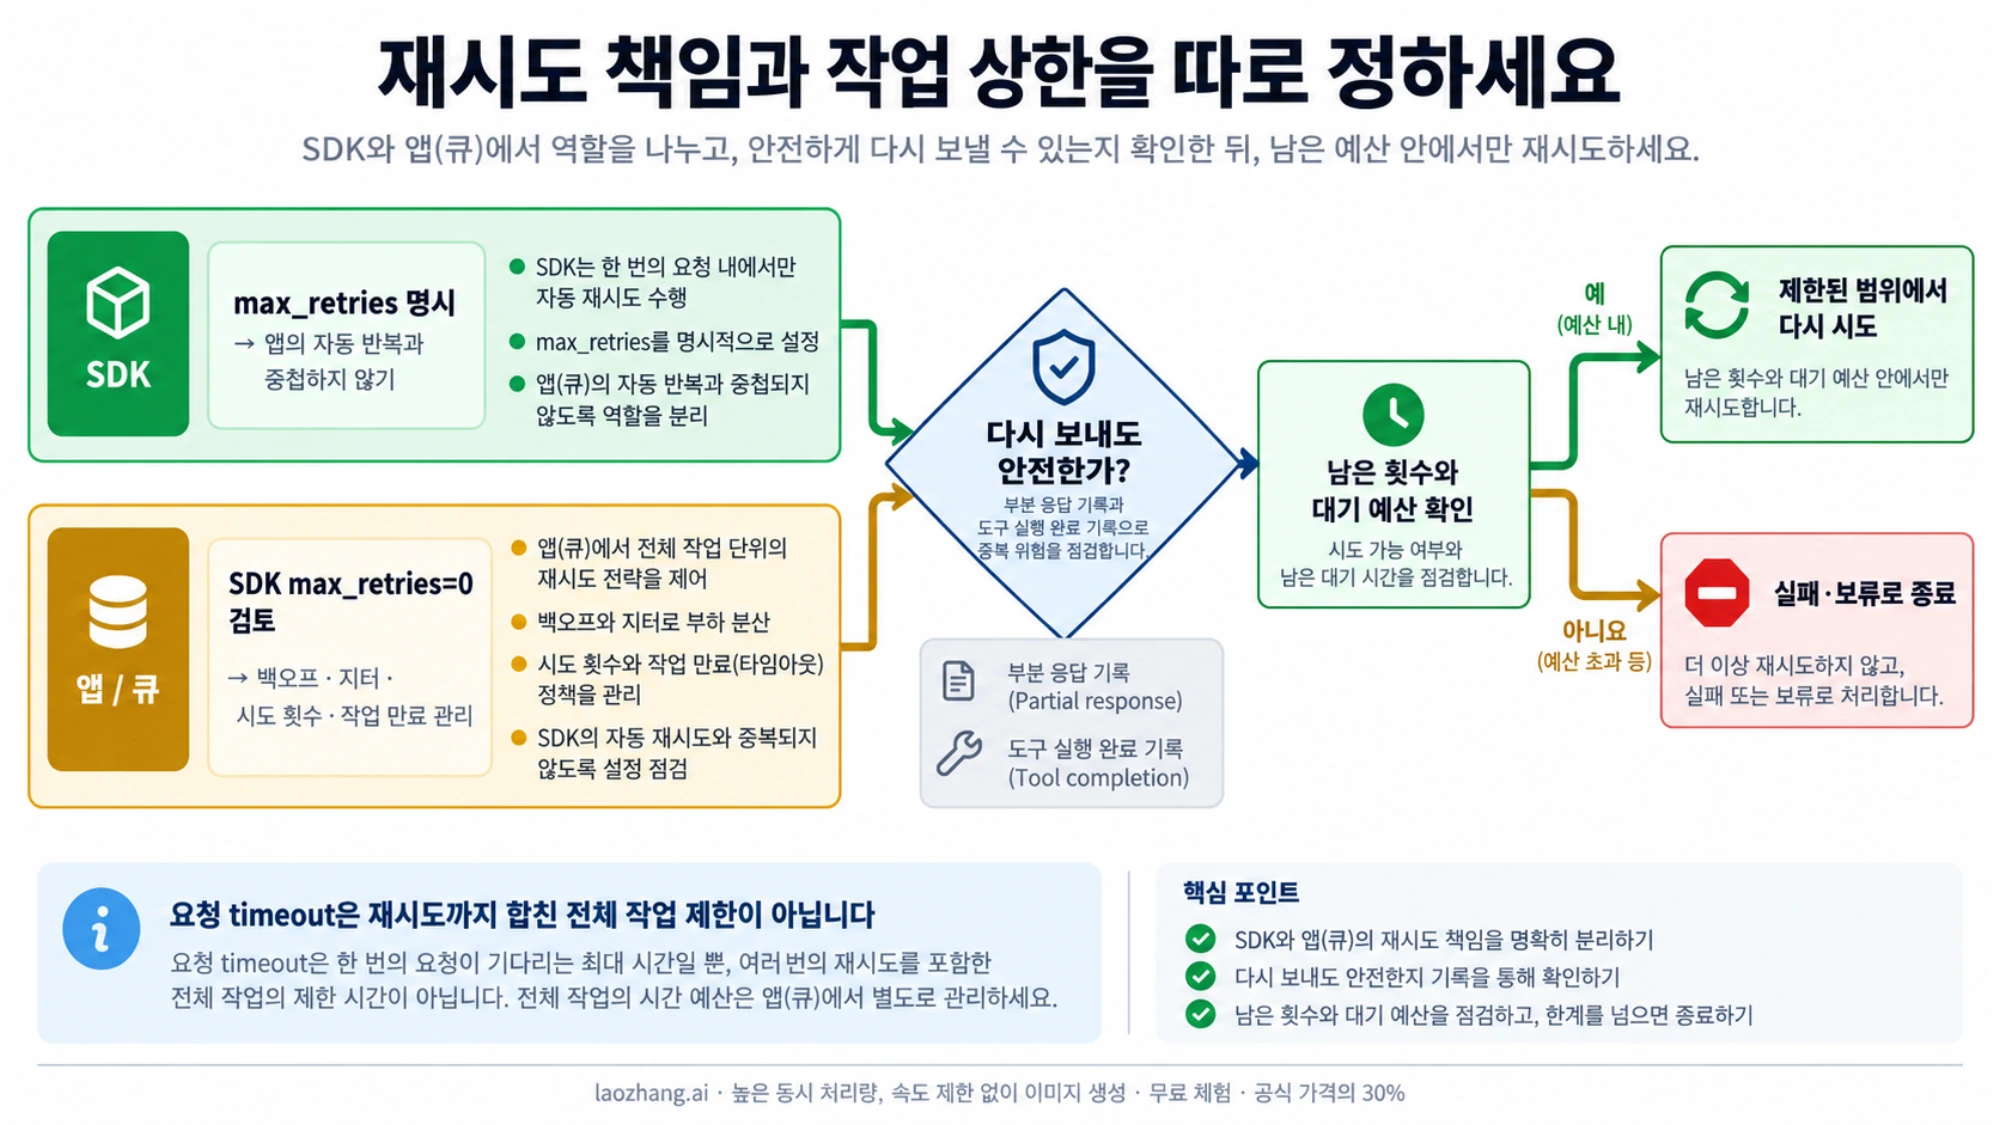
재시도를 추가하기 전에 SDK, 앱의 반복문, 작업 큐와 게이트웨이의 설정을 확인하세요. SDK가 이미 다시 보내는 동안 앱도 같은 작업을 반복하면 생각보다 많은 요청이 나갈 수 있습니다. 단순한 비스트리밍 호출은 SDK에 맡기고, 큐의 작업 만료와 재실행까지 관리해야 한다면 앱이 전체 정책을 맡는 방식으로 책임을 명확히 합니다.
Python SDK 문서에 따르면 연결 오류, 408, 409, 429 및 500 이상 내부 오류는 기본적으로 두 번 재시도합니다. 해당 실패가 계속 재시도 대상이라면 최초 전송 한 번에 재시도 두 번을 더해 최대 세 번 전송하는 설정입니다. max_retries로 조정하거나 0으로 끄고, with_options로 개별 호출에도 적용할 수 있습니다. Claude Code의 최대 10회 정책과는 별개입니다.
| 재시도를 맡는 곳 | 설정과 처리 |
|---|---|
| 공식 SDK | max_retries를 명시하고 바깥에서 같은 호출을 자동 반복하지 않습니다. 최종 실패는 앱의 실패·보류 처리로 보냅니다. |
| 앱 또는 작업 큐 | SDK의 max_retries=0을 검토하고 백오프·서버 대기 지시·횟수·작업 만료·중복 방지를 직접 관리합니다. |
| 중간 게이트웨이도 재시도 | 중간 서비스의 설정과 실제 시도 기록을 확인해 중첩을 줄입니다. |
앱이 직접 관리한다면 실패가 반복될수록 대기 간격을 늘리고 무작위 지연인 지터를 더합니다. 재전송 전에는 남은 횟수와 작업 만료 시각을 확인하세요. 마지막 실패 뒤에 다시 보낼 계획이 없는데도 재시도용 대기를 추가할 이유는 없습니다. 서버가 대기 시간을 알려 주었고 그 시간이 작업의 남은 대기 예산보다 길다면, 시간을 임의로 줄여 보내기보다 작업을 연기하는 편이 맞습니다.
Python에서 최종 500을 구분하는 예시
다음 함수는 인증과 접속 경로를 설정한 Anthropic 클라이언트, 실제 사용할 수 있는 모델 ID와 메시지 목록을 받습니다. SDK가 재시도하게 하고 이 함수 밖에는 자동 반복문을 두지 않는 예시입니다. 실패하면 원래 예외를 호출자에게 그대로 전달해 앱의 요청 처리기나 작업 큐가 실패·보류 상태를 정하게 합니다. 완성된 웹 서버나 큐 구현을 제공하는 코드는 아닙니다.
import logging
import anthropic

logger = logging.getLogger(__name__)


def create_message(client, *, model, messages, max_tokens=512):
    try:
        return client.with_options(
            max_retries=2,
            timeout=20.0,
        ).messages.create(
            model=model,
            messages=messages,
            max_tokens=max_tokens,
        )
    except anthropic.APIStatusError as exc:
        request_id = exc.response.headers.get("request-id")
        body = getattr(exc, "body", None)
        if not request_id and isinstance(body, dict):
            request_id = body.get("request_id")

        if exc.status_code == 500:
            logger.warning(
                "claude_final_500 model=%s request_id=%s",
                model,
                request_id,
            )
        else:
            logger.warning(
                "claude_other_http_error status=%s request_id=%s",
                exc.status_code,
                request_id,
            )
        raise
    except anthropic.APITimeoutError:
        logger.warning("claude_client_timeout model=%s", model)
        raise
    except anthropic.APIConnectionError:
        logger.warning("claude_connection_error model=%s", model)
raiseAPIStatusError의 HTTP 상태를 확인하므로 529나 504를 최종 500으로 잘못 기록하지 않습니다. 모든 APIError에 status_code가 있다고 가정해서도 안 됩니다. 이 예시는 상태와 ID만 간단히 기록하며, 지원 문의에 필요한 오류 본문과 헤더는 원래 예외의 응답에서 민감한 내용을 가린 뒤 별도로 보존합니다. SDK가 내부에서 재시도한 모든 요청 ID를 이 코드 하나가 수집하는 것은 아닙니다.
예시의 max_retries=2와 20초 타임아웃은 서비스에 맞춰 선택해야 하는 값입니다. timeout=20.0은 재시도와 백오프까지 합친 전체 작업이 20초 안에 끝난다는 보장이 아닙니다. 기본 요청 타임아웃은 10분이며 타임아웃 오류도 기본 재시도 대상입니다. 사용자에게 기다림을 끝내 주는 전체 제한이 필요하면 앱의 작업 만료·취소·큐 정책을 별도로 설계해야 합니다. 시작 전에 시각을 확인하는 것만으로 진행 중인 호출을 강제로 종료할 수도 없습니다.
이 함수의 성공, 최종 500, 다른 HTTP 오류, 연결 및 타임아웃 분기는 모의 클라이언트로 오프라인 확인했습니다. 실제 모델 호출이나 500 장애 복구를 시험한 결과는 아닙니다. SDK 동작은 설치한 버전의 문서와 설정도 확인하세요.
재전송 전에 부분 응답과 이미 실행한 작업을 확인하세요
API 오류 문서는 SSE 스트리밍에서 HTTP 200을 반환한 뒤에도 오류가 날 수 있다고 설명합니다. 따라서 최초 상태만 보고 작업을 성공 처리하면 안 됩니다. 위의 비스트리밍 함수와 HTTP 예외 분기만으로 스트리밍의 정상 종료까지 확인할 수도 없습니다.
스트림이 중단되면 받은 텍스트와 이벤트, 실행한 도구 결과를 보존하세요. 다음 요청의 응답을 이전 텍스트 뒤에 무조건 붙이거나, 이미 실행한 외부 작업을 통째로 다시 실행하지 않습니다. 최종 응답이 완성됐는지, 마지막 도구 호출이 완성·실행됐는지, 이어갈 단계가 무엇인지 앱이 확인해야 합니다.
업무용 작업 ID와 제공자의 요청 ID도 구분하세요. 한 작업이 여러 번 전송되면 제공자 요청 ID는 시도별로 달라질 수 있지만, 앱의 작업 ID는 같은 업무를 추적하는 기준이 됩니다. 예를 들어 답변 생성 후 알림을 보내는 처리에서는 알림의 실제 전송 기록을 확인하고, 이미 보냈다면 다시 보내지 않도록 앱에서 중복을 막아야 합니다. 이 방식은 앱의 안전한 재실행을 위한 권장 설계이며, Claude Messages API가 임의의 Idempotency-Key 헤더로 모든 중복을 막아 준다는 뜻은 아닙니다.
같은 500이 계속되면 작업을 중단하거나 연기합니다
상한에 도달했다면 “조금 더 재시도” 대신 다음 상태로 옮기세요. 오류를 조용히 무시하고 성공으로 저장하지 않고, 무엇이 완료됐고 무엇이 보류됐는지 남기는 것이 중요합니다.
| 현재 상황 | 사용할 수 있는 다음 조치 |
|---|---|
| 사용자 요청의 대기 한도를 넘김 | 실패를 명확히 알리고 다시 시도할 수 있는 동작을 제공합니다. 미완성 답변은 완성된 결과로 표시하지 않습니다. |
| 급하지 않은 작업이며 입력을 안전하게 저장할 수 있음 | 같은 작업 ID로 보류하고 다음 실행 시각을 정합니다. 재개 전 완료 여부와 만료를 확인합니다. |
| 관련 API 장애가 공지됨 | 불필요한 호출을 멈추고 공식 업데이트를 기다립니다. 복구 후 작은 규모로 같은 경로의 완료를 확인합니다. |
| 장애 공지는 없으나 같은 경로에서 반복 실패 | 실패 기록과 최소 재현 자료를 모아 해당 제공자 또는 게이트웨이 운영자에게 문의합니다. |
| 임시 대체 모델이나 서비스가 작업을 충족함 | 원래 오류 기록을 보존한 뒤 대체를 선택합니다. 결과 품질·도구 지원·데이터 처리·비용 차이도 함께 확인합니다. |
반복 500이 여러 작업에서 늘어난다면 일정 조건에서 새 호출을 잠시 차단하거나 작업 큐를 보류하는 방식을 검토할 수 있습니다. 모든 서비스에 맞는 “오류 세 번이면 모델 전환” 같은 고정 규칙은 없습니다. 서비스가 감당할 실패율, 업무의 긴급성, 안전한 재실행 조건에 맞춰 결정하세요.
상태 페이지의 녹색 표시나 다른 모델의 성공은 원래 요청의 복구를 증명하지 않습니다. 같은 모델·엔드포인트·제공자·요청 형태에서 응답이 끝까지 완료됐는지 확인한 뒤 호출량을 되돌립니다. 조건을 바꿔 성공했다면 무엇을 바꿨는지 기록하고, 이를 원래 경로의 복구와 구분하세요.
지원팀이 추적할 수 있는 요청 기록을 준비하세요
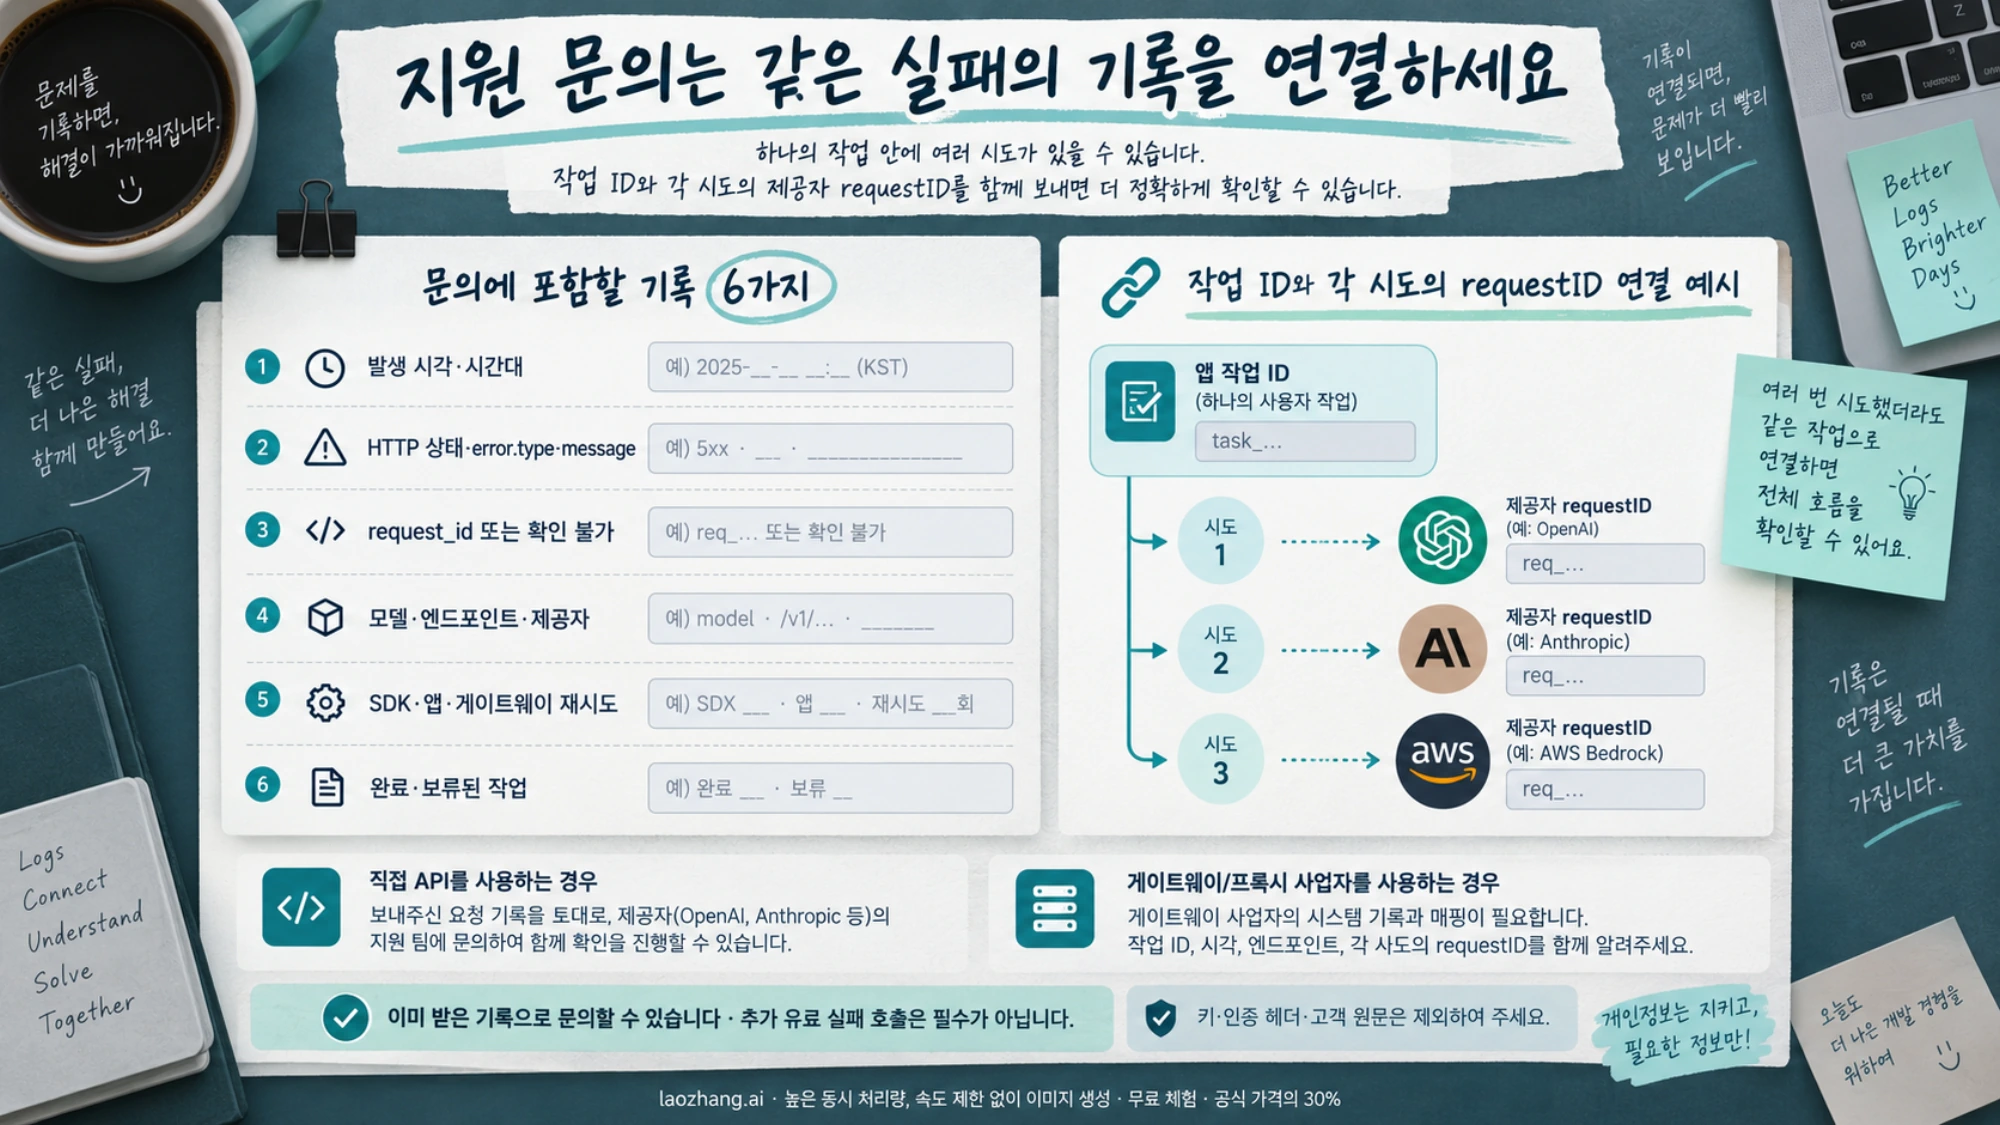
공식 안내의 핵심은 실패한 요청의 ID를 제공하는 것입니다. 화면 캡처에 “500”만 보이는 자료보다 다음 정보를 연결한 기록이 조사에 유용합니다.
- 발생 시각과 시간대, 실제 HTTP 상태 및
error.type·error.message. - 각 확인 가능한 실패의
request_id또는request-id. 없다면 실제 받은 상태·본문·헤더와 ID를 확인하지 못한 사실. - 모델 ID, 엔드포인트, 직접 API 또는 클라우드·게이트웨이 경로, SDK와 런타임 버전.
- 스트리밍 여부, 입력 크기와 사용 기능, SDK·앱·게이트웨이의 재시도 설정과 확인 가능한 시도별 결과.
- 당시 확인한 상태 페이지의 시각과 관련 장애, 영향받은 작업과 완료·보류 상태.
- 민감한 내용을 제거한 최소한의 유효한 요청 예시와 재현 순서.
재현 자료를 줄일 때는 실제 유효한 요청 구조를 유지하고 무엇을 제거했는지 설명합니다. 입력을 줄이거나 모델을 바꾼 뒤 성공했다고 해서 처음 실패가 잘못된 프롬프트 때문이었다고 결론 내릴 수는 없습니다. 새로운 비교 결과로 남겨야 합니다. 문의하려고 꼭 추가 유료 호출을 하거나 정해진 횟수만큼 실패를 만들어 낼 필요도 없습니다.
API 키, 인증 헤더, 세션 쿠키, 고객의 원문이나 전체 환경 변수 출력은 첨부하지 마세요. 게이트웨이를 쓰면 우선 운영자가 실제 제공자 응답과 요청 ID를 연결할 수 있는지 확인합니다. 직접 Anthropic API가 반환한 오류라면 Anthropic 지원팀에 해당 ID를 전달합니다. 오류가 지속되는 상황을 문의하면서도 보류 작업의 재개 담당자와 조건을 남겨 두면, 장애가 끝난 뒤 같은 일을 중복 실행하는 것을 줄일 수 있습니다.
자주 묻는 질문
500 api_error가 나오면 API 키를 새로 만들어야 하나요?
500만으로는 키 교체가 필요하다는 근거가 없습니다. 공식 오류 분류에서 인증 오류는 401, 권한 오류는 403으로 구분됩니다. 실제로 그 응답을 받았거나 키 노출을 확인한 경우에 해당 조치를 하세요. 500에서는 오류 응답 보존과 제한된 재시도가 먼저입니다.
요청 ID가 없으면 Anthropic에 요청이 도착하지 않은 건가요?
그렇게 단정할 수 없습니다. 중간 서비스나 SDK의 정보 노출 때문에 ID를 못 볼 수 있으므로 실제 HTTP 응답 유무를 따로 확인해야 합니다. 상태와 본문을 받았다면 그대로 기록하고, 게이트웨이 운영자에게 제공자 요청 ID를 연결해 달라고 요청하세요.
Claude Status가 정상인데 왜 계속 실패하나요?
상태 페이지는 공개된 서비스 상태와 장애 범위를 보여 줍니다. 개별 모델·경로·요청의 정상 완료를 보증하지는 않습니다. 원인을 추정해 설정을 계속 바꾸기보다 같은 조건의 실패 기록을 보존하고, 정한 상한 뒤에도 반복되면 문의하세요. 녹색 표시만으로 내 컴퓨터가 원인이라고 결론 내릴 수 없습니다.
Python SDK의 두 번 재시도는 총 두 번 전송인가요?
아닙니다. Python SDK 문서의 기본 두 번 재시도는 최초 전송 이후의 횟수입니다. 계속 재시도 가능한 실패라면 최대 세 번 전송합니다. 앱이나 게이트웨이가 추가 재전송하는지는 별도로 확인해야 하며, 요청 타임아웃을 설정해도 전체 작업 대기 시간이 같은 값으로 제한되지는 않습니다.
참고 자료3
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 5일.
참고 자료3
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 5일.