Grok Voice Agent API の実装ガイド:WebSocket・音声入出力・料金
Grok Voice Agent API の接続先は wss://api.x.ai/v1/realtime です。24kHz PCM を送り、応答音声を WAV に保存するところまで実装します。音声料金は1分0.08米ドルで、自動 VAD と手動送信では課金対象の時間が異なります。
目次
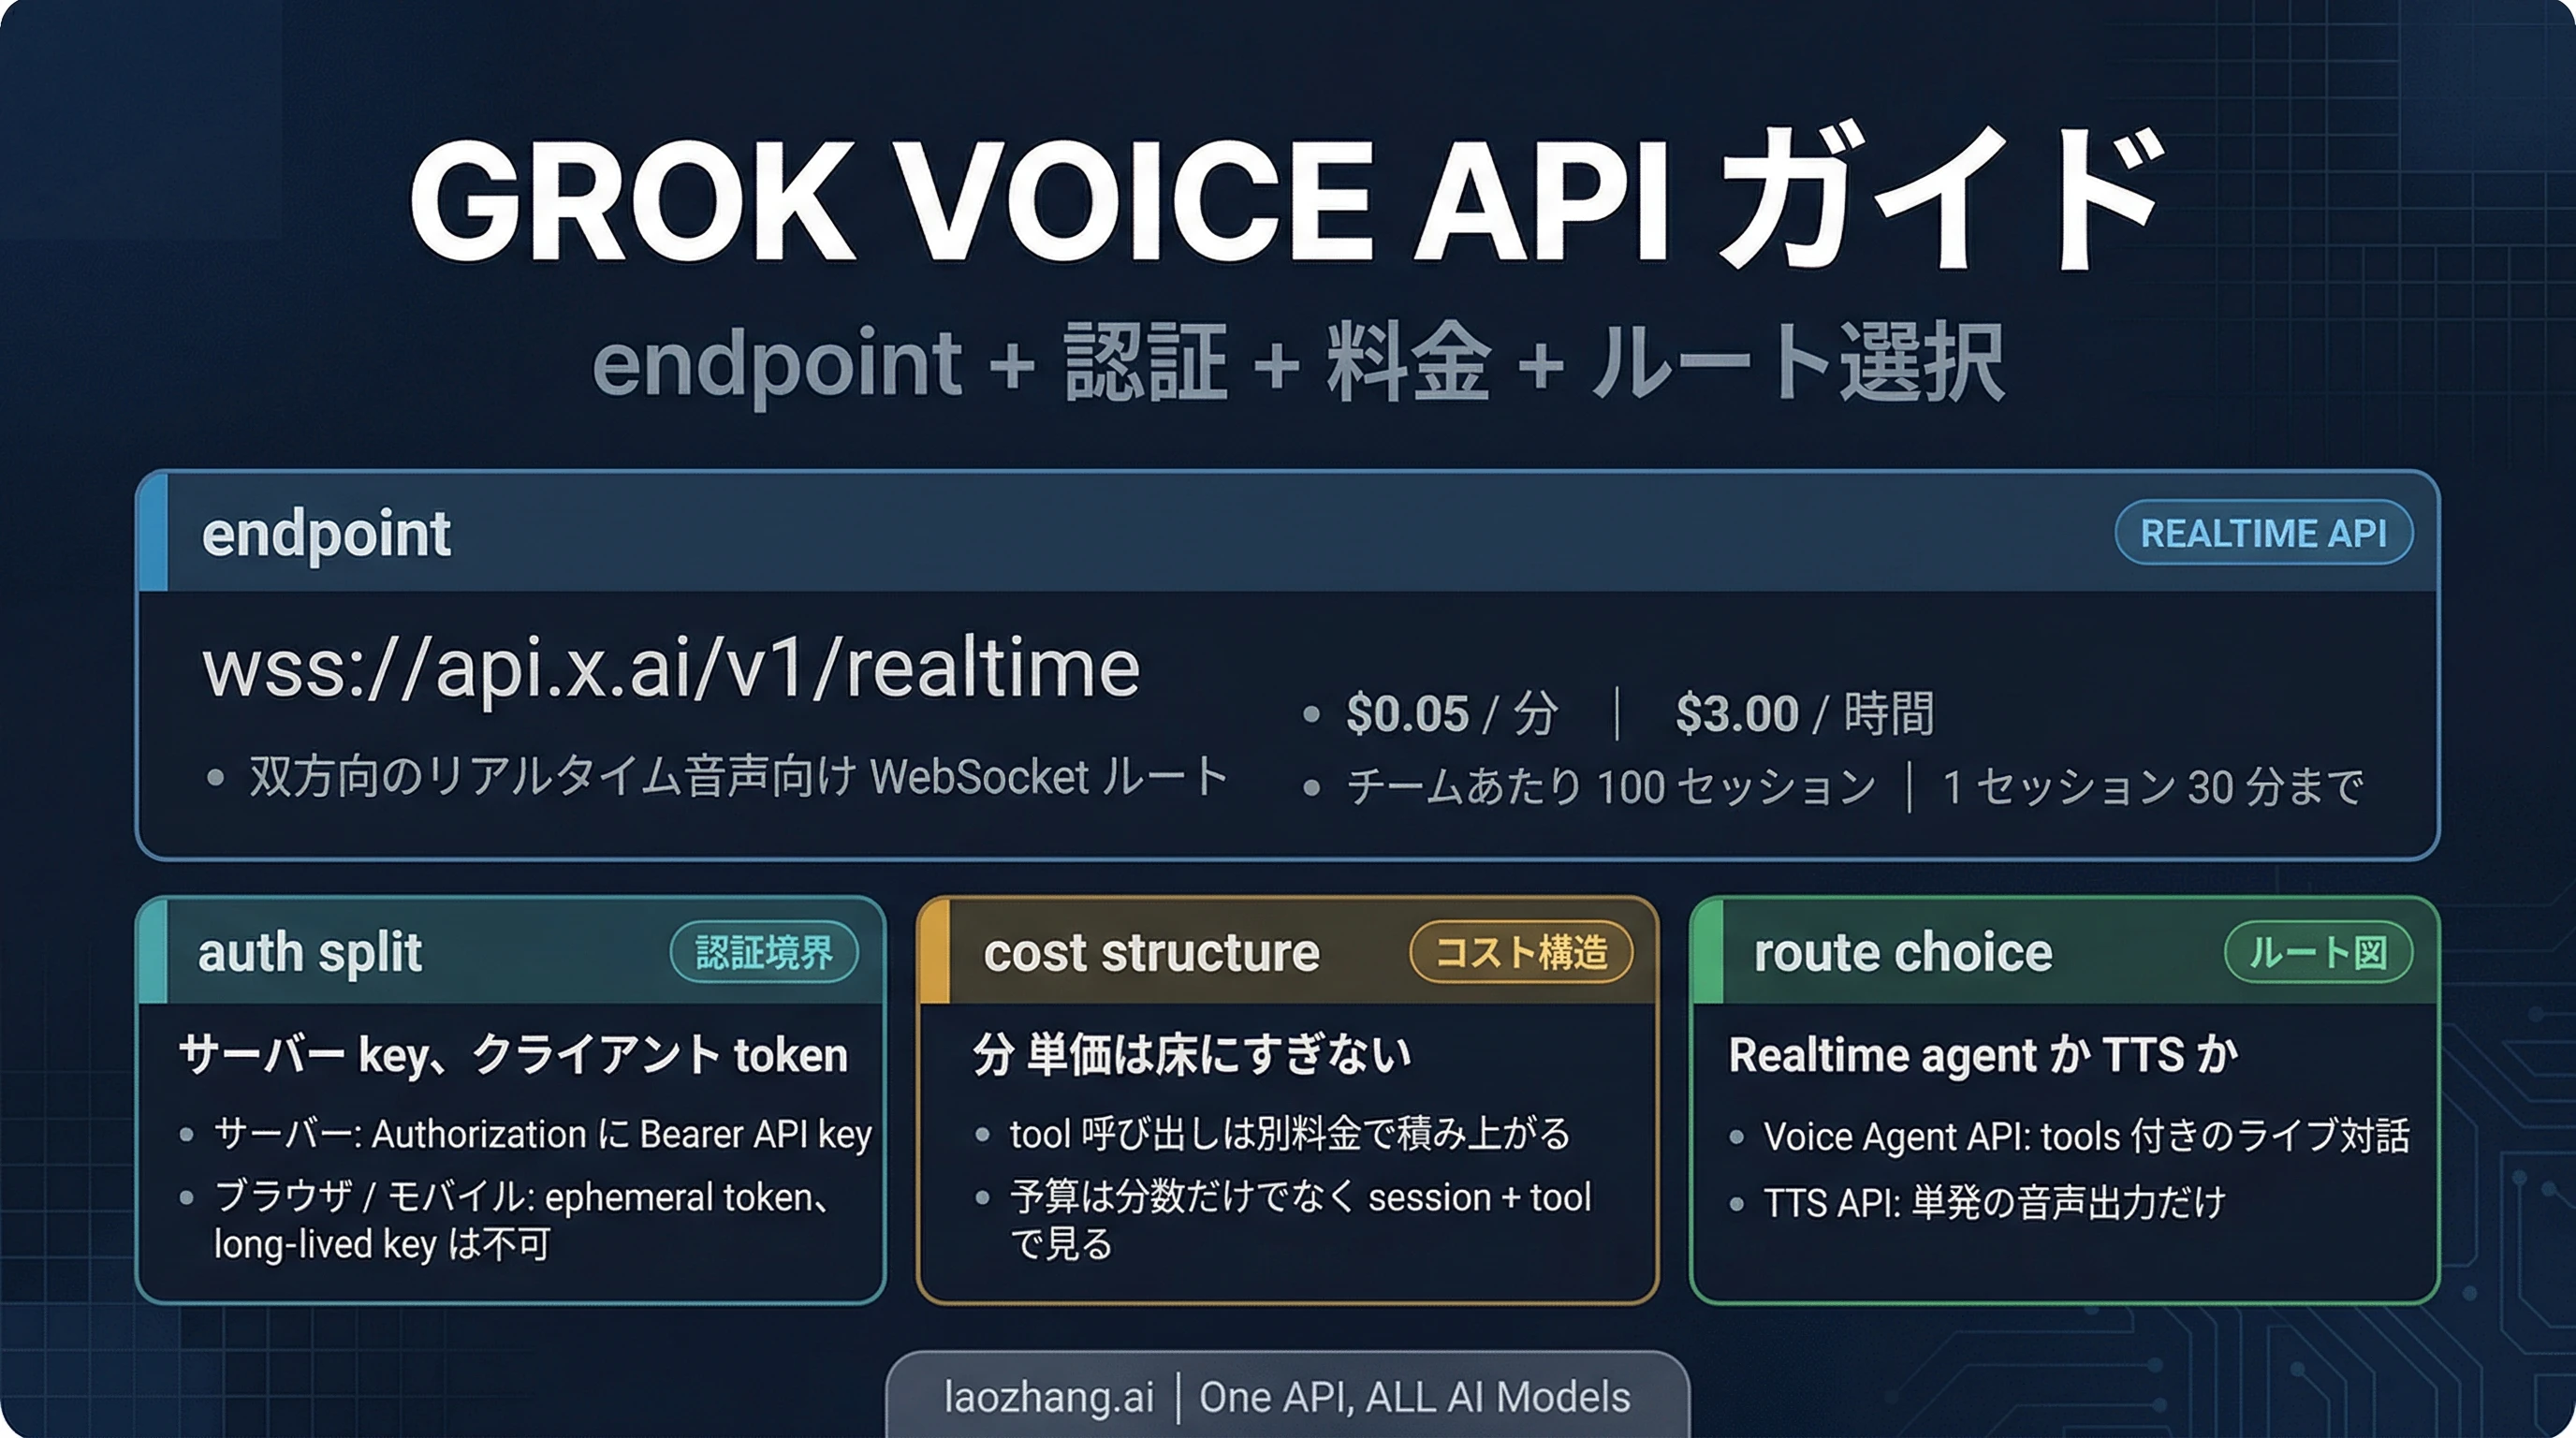
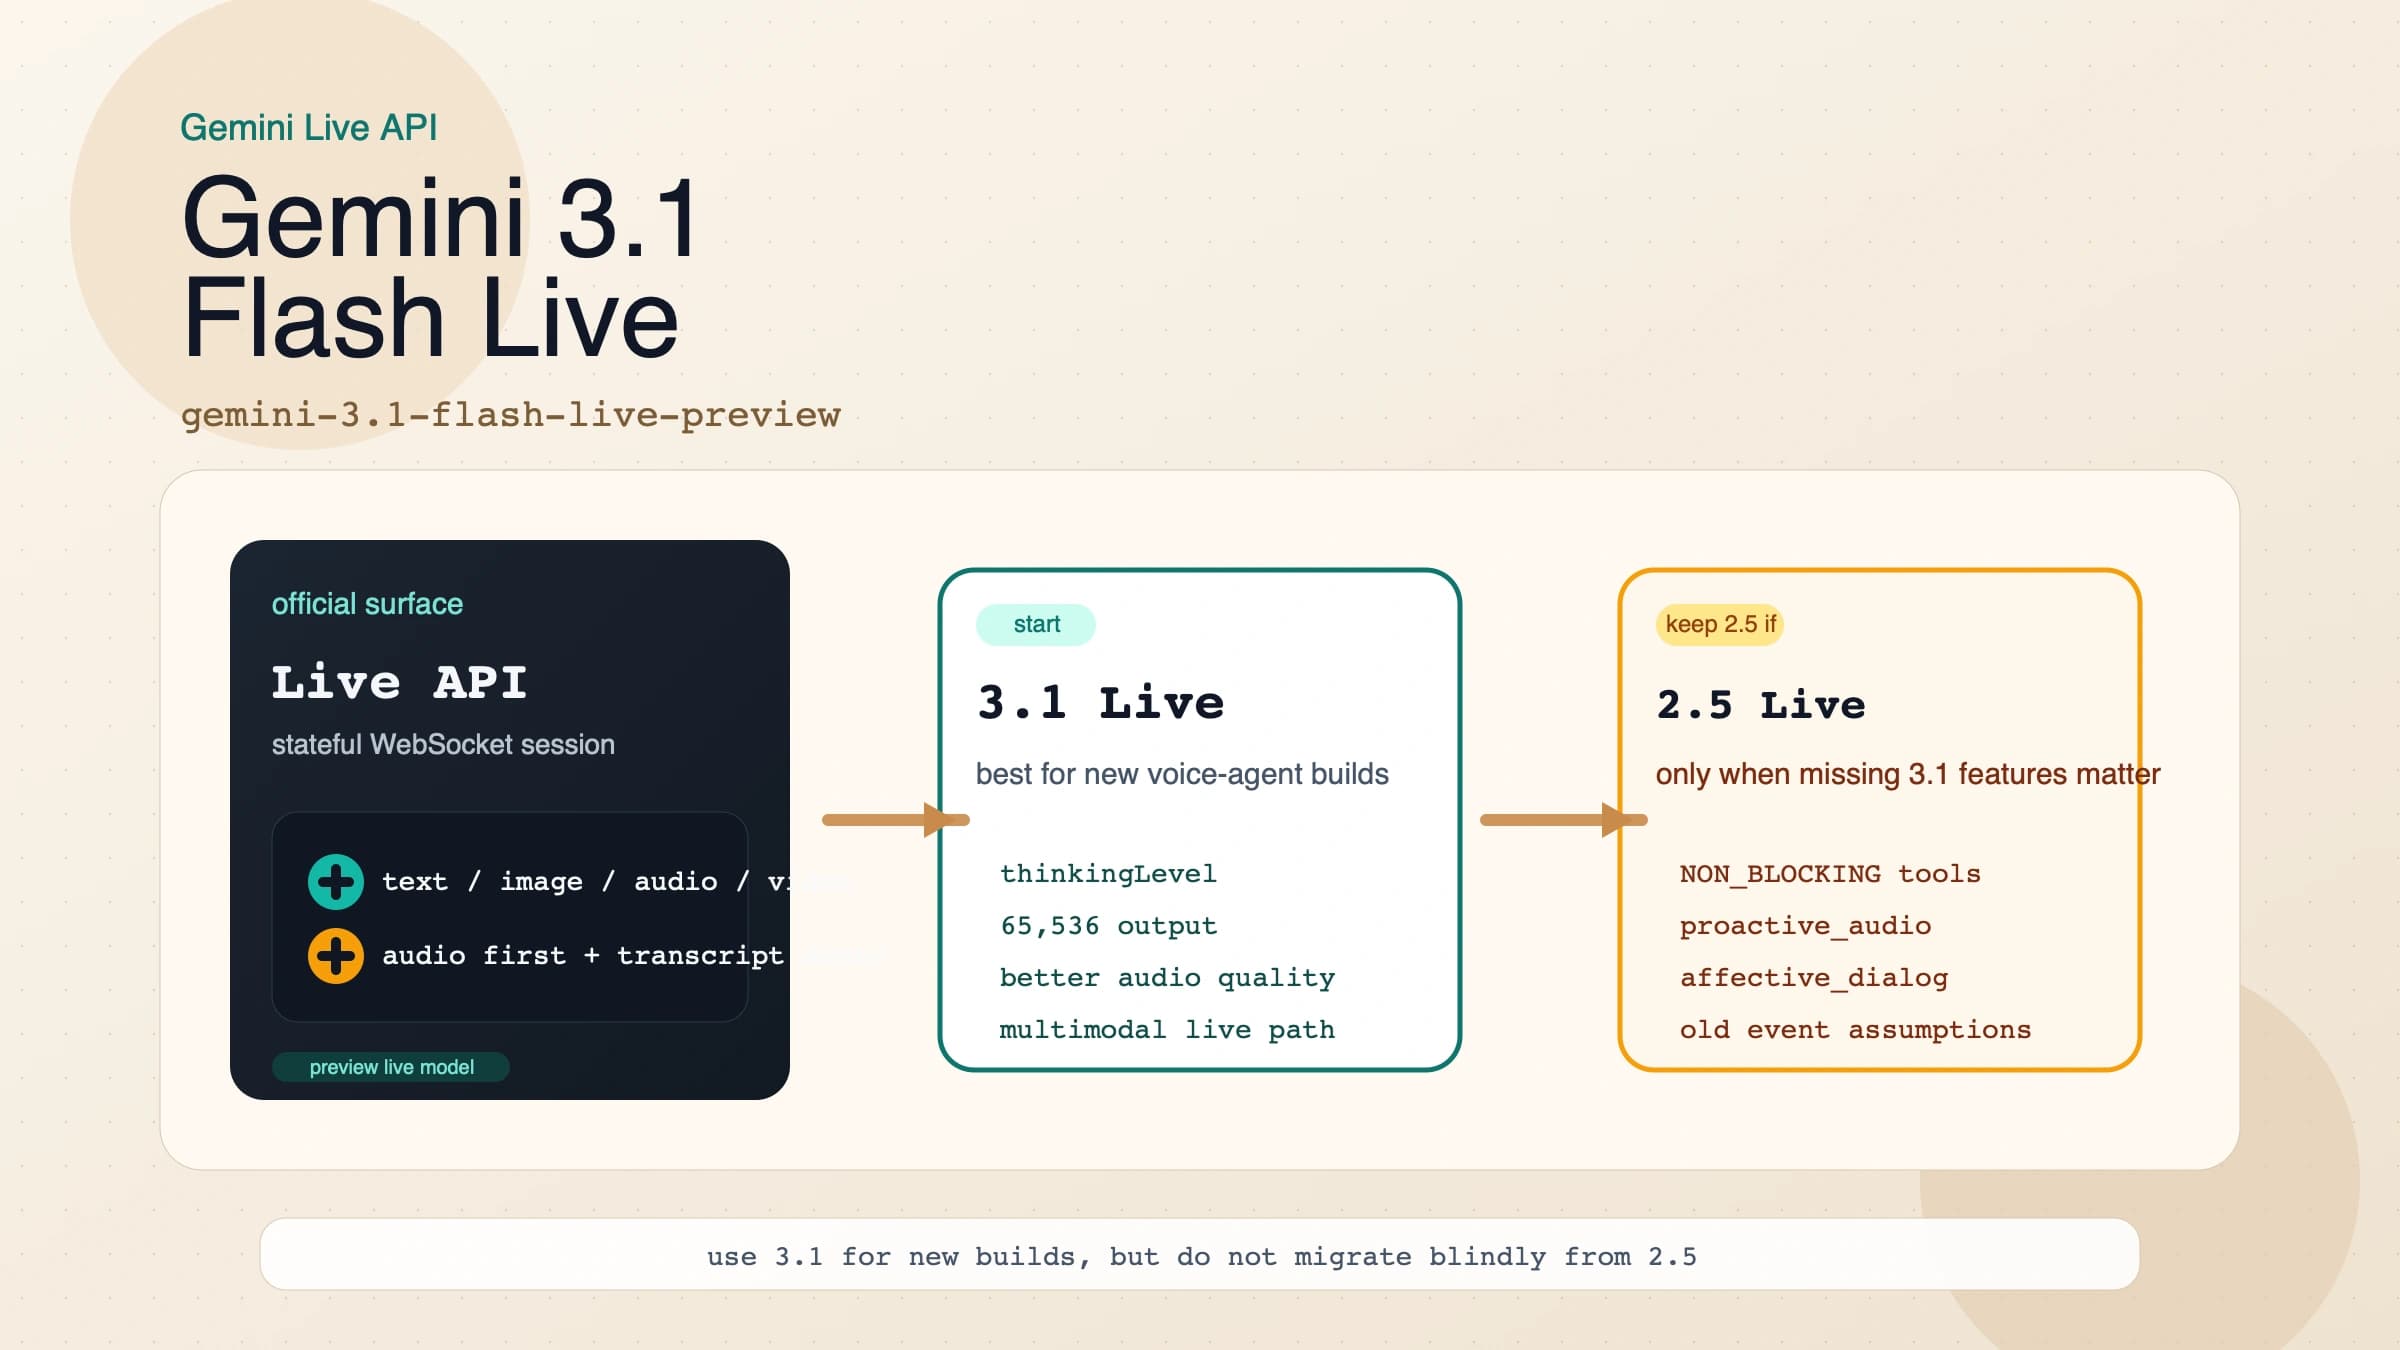
Grok Voice Agent API の接続先は wss://api.x.ai/v1/realtime です。 音声を送り、Grok の返答を音声と文字で受け取る双方向の WebSocket API で、現在の grok-voice-latest は grok-voice-think-fast-2.0 を指します。最初の接続ではモデルを固定し、入力・出力とも24kHzの16bit PCMにすると、音声形式とイベント処理を切り分けやすくなります。公式の Speech to Speech ガイド
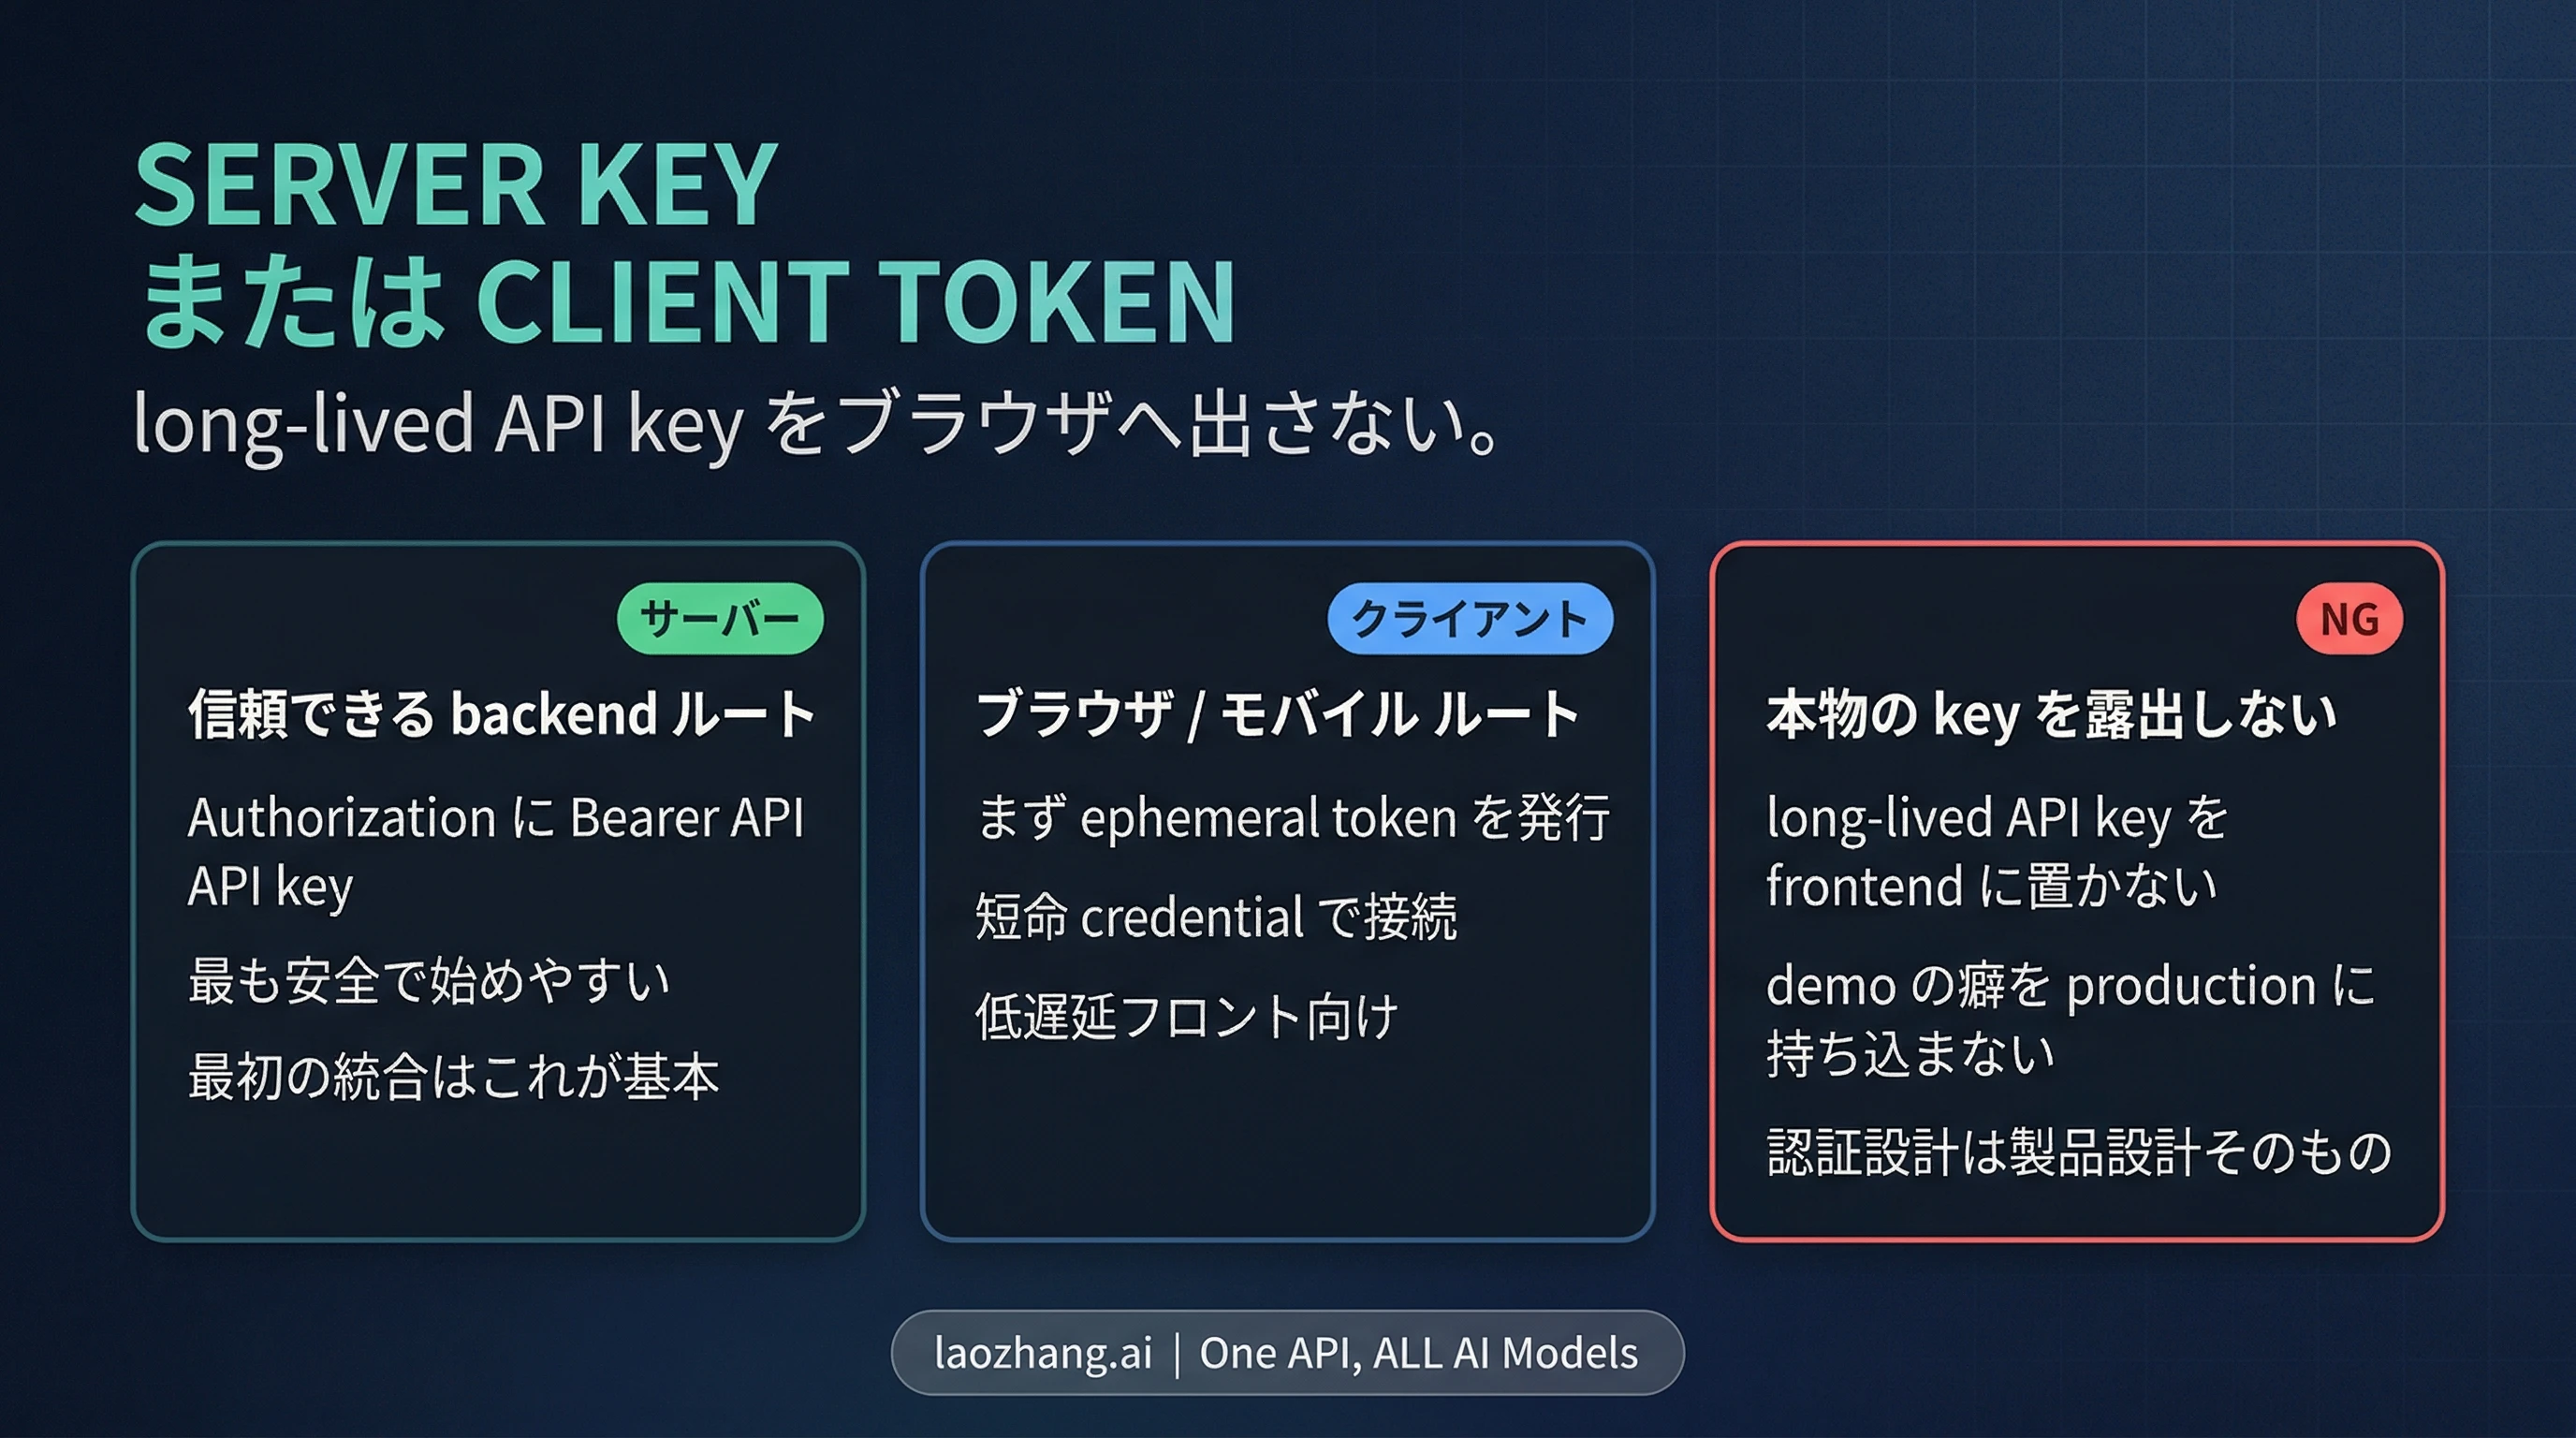
以下では、サーバー側から短い PCM ファイルを送り、返答の音声を再生可能な WAV に保存する例を示します。ブラウザに組み込む場合は、長期 API キーをアプリのサーバーに保管し、ブラウザへは短期トークンを渡します。接続できたかだけでなく、設定の受理、入力の確定、応答の終了、音声の保存までを確認する構成です。
2026年10月7日時点の公開音声料金は1分0.08米ドルです。自動で発話を区切る server_vad は待機を含むセッション時間、プッシュ・トゥ・トークは送受信した音声時間で計算します。この違いは、後述の実装方式を選ぶ際にも重要です。公式モデルページ、料金表
音声会話、Grok TTS API、文字起こしの使い分け
利用者の発言を聞いて、その場で声を返すなら Voice Agent API を使います。完成した文章を読み上げるだけなら TTS、録音から文字だけを取り出すなら STT が適しています。
| 作りたい機能 | 接続先・用途 |
|---|---|
| 利用者と声で対話する | wss://api.x.ai/v1/realtime:会話、音声の往復、会話中のツール利用 |
| 文章を音声にする | POST https://api.x.ai/v1/tts:TTS。ストリーミング用 WebSocket もあります |
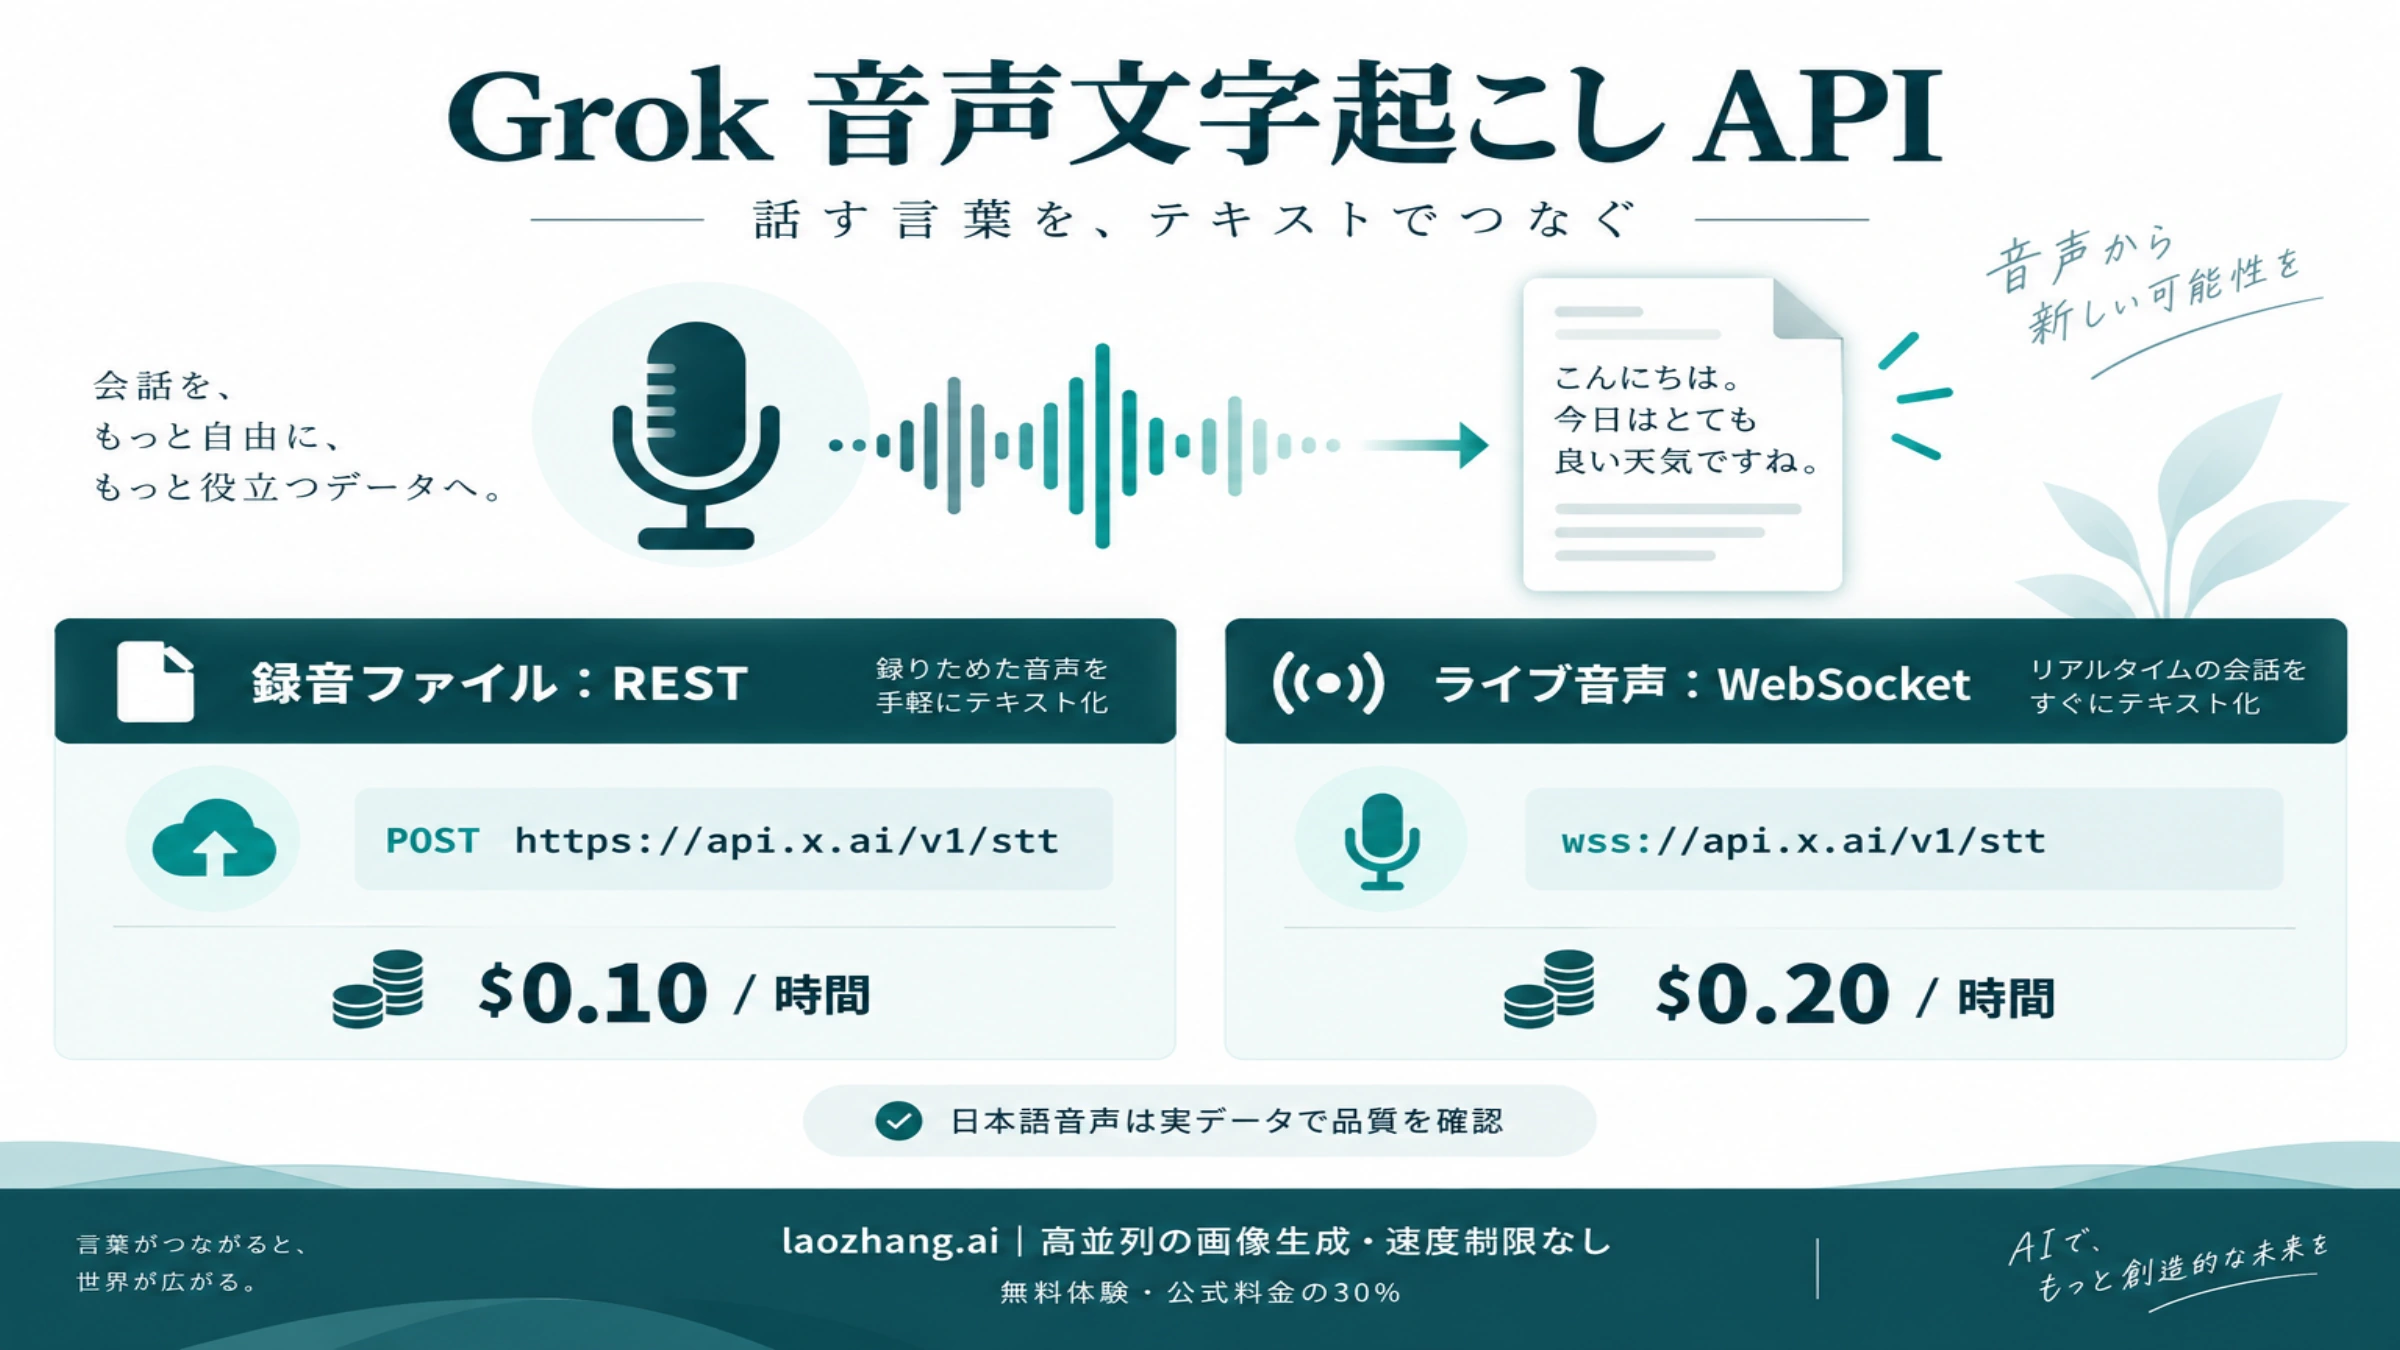
| 録音ファイルや音声 URL を文字にする | POST https://api.x.ai/v1/stt:STT |
| 音声を流しながら文字起こしする | wss://api.x.ai/v1/stt:STT のストリーミング |
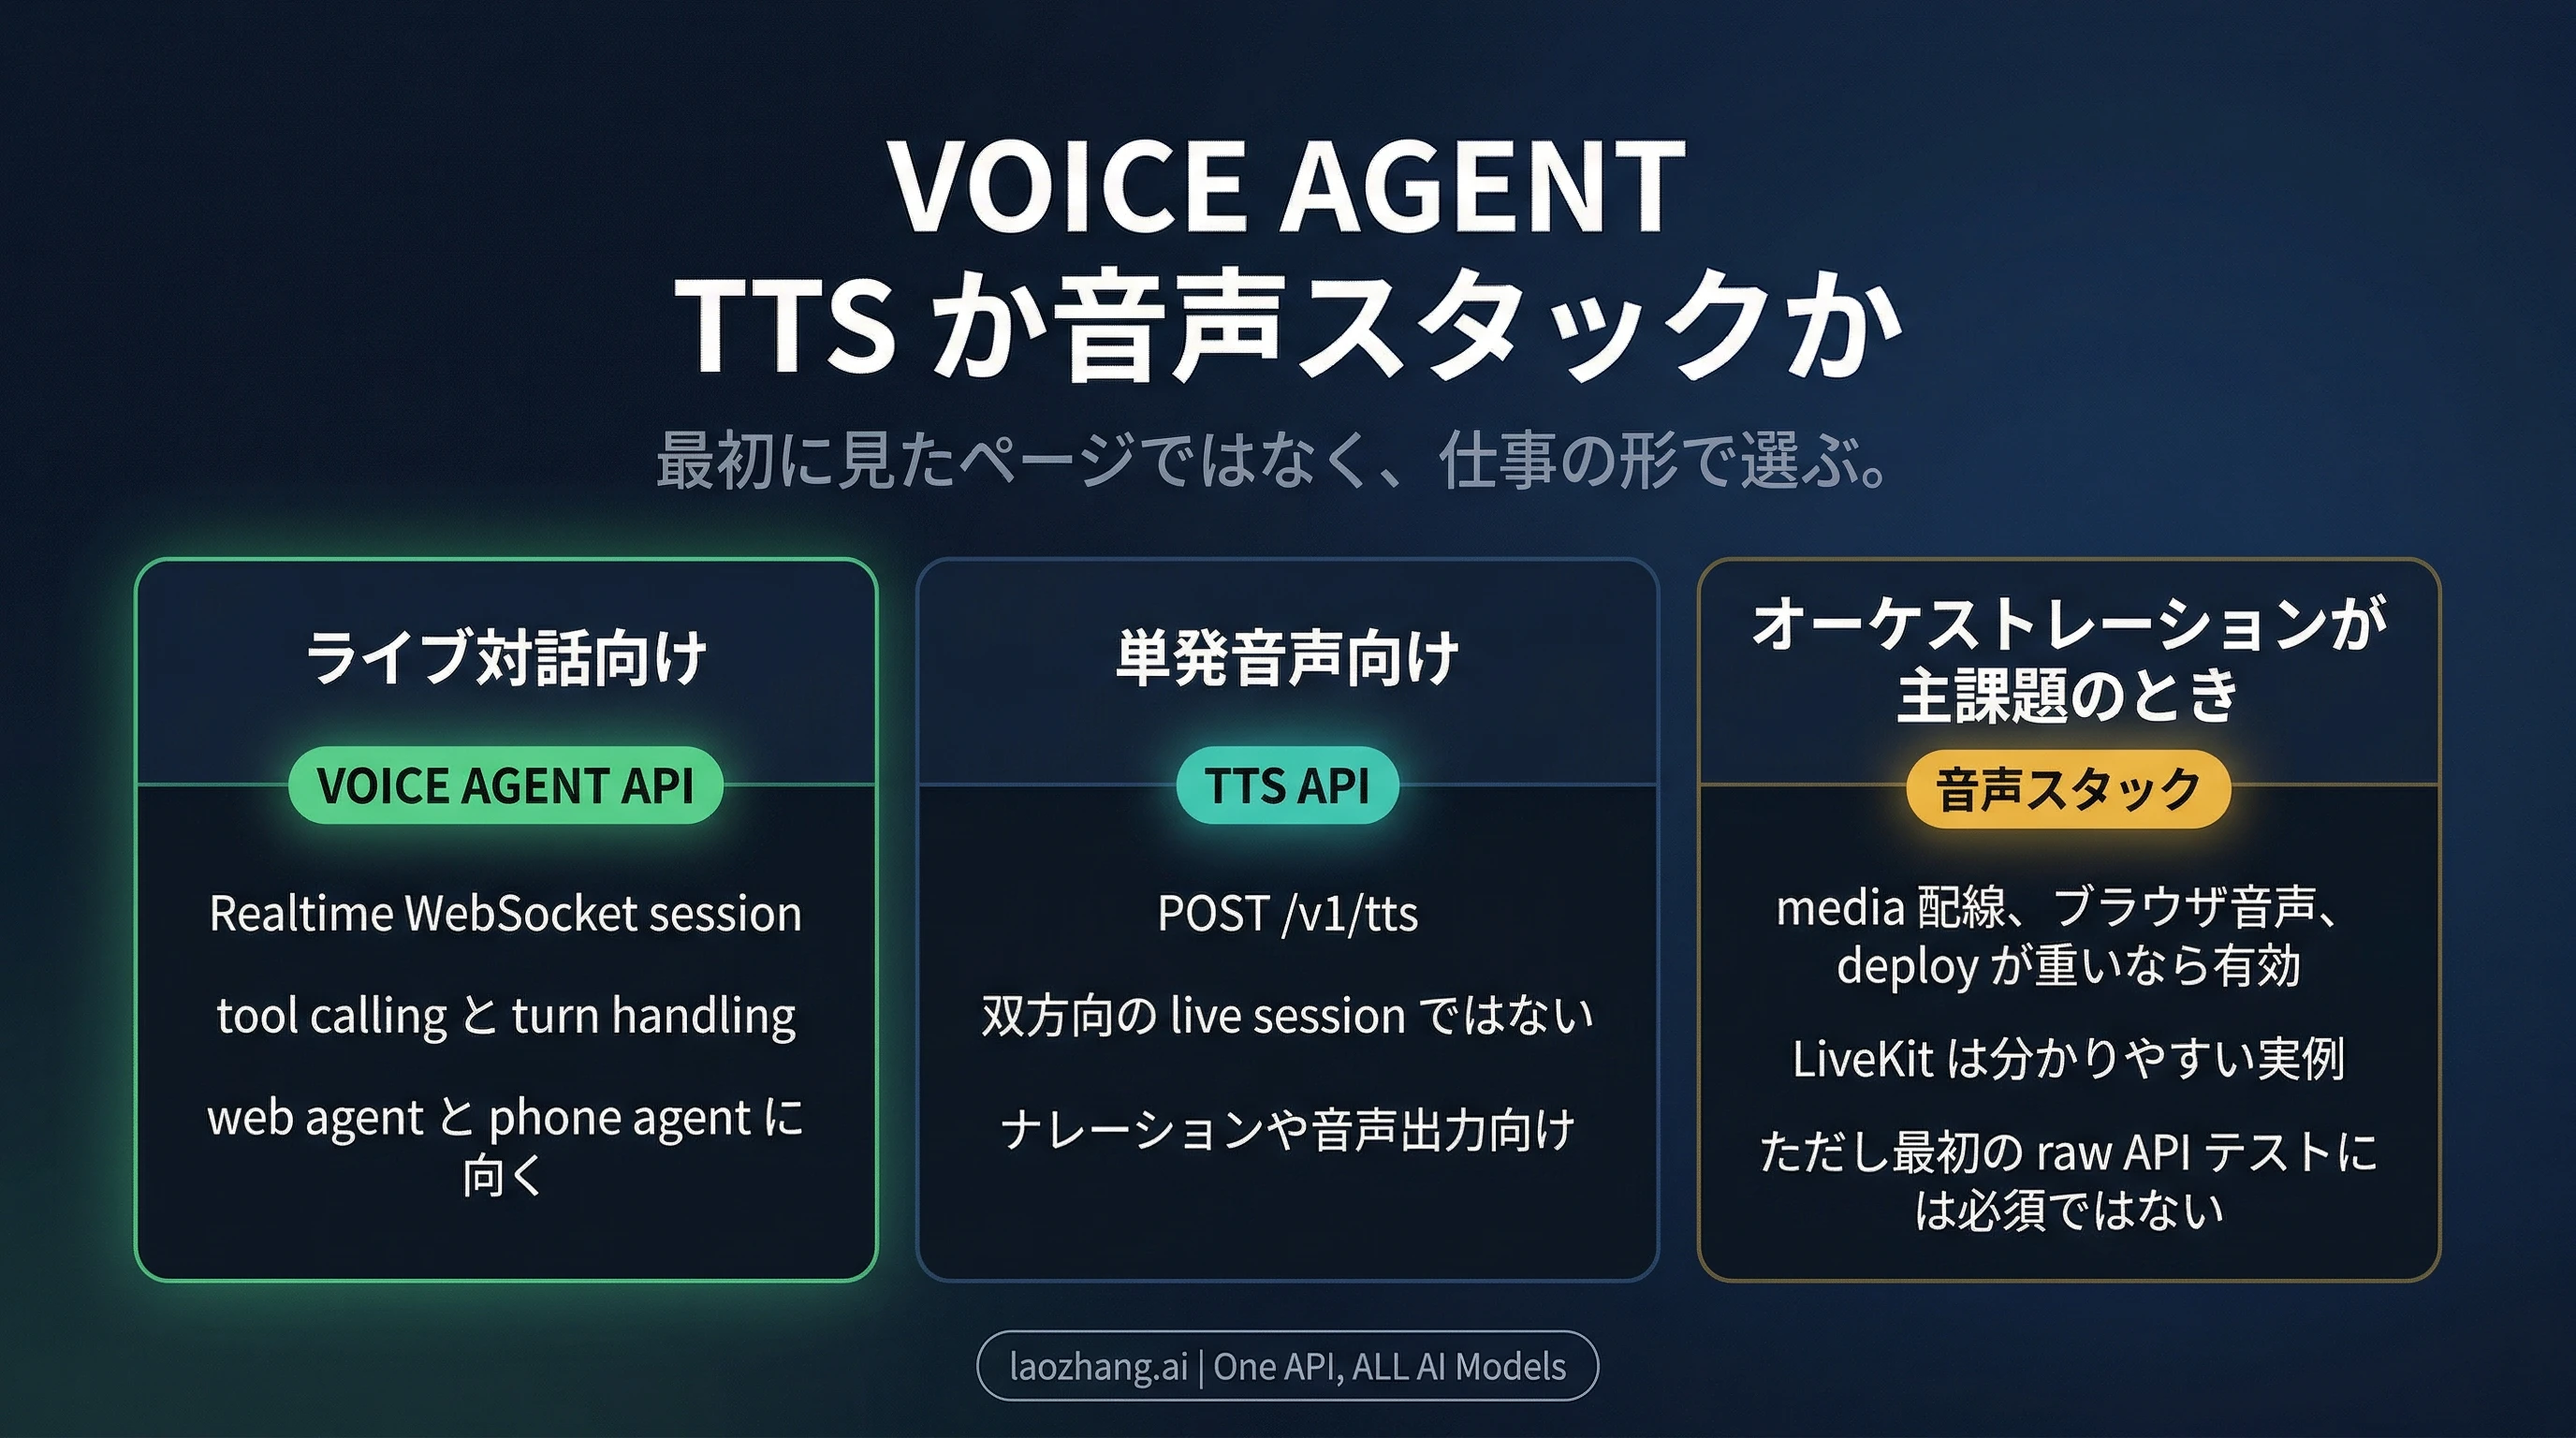
これらは同じ接続先の設定違いではありません。たとえば STT の現在の既定モデル grok-voice-transcribe-2.0 は、音声会話中の字幕で使う grok-transcribe とも別です。用途に合った公式の音声 API 一覧とAPI リファレンスを参照してください。
電話の着信処理や WebRTC、複数の音声接続の制御が主な作業になった場合は、メディア処理用のフレームワークを組み合わせる選択肢があります。その場合も、フレームワークの接続成功と xAI の応答音声を受け取れたことは分けて確認します。
サーバーの API キーとブラウザの短期トークンを分ける
サーバー側の WebSocket クライアントは、Authorization: Bearer <API_KEY> で認証します。一方、ブラウザ標準の WebSocket では任意の Authorization ヘッダーを設定できません。ブラウザ用には、アプリのサーバーが次のリクエストで短期トークンを取得します。短期トークンの公式説明
POST /v1/realtime/client_secrets HTTP/1.1
Host: api.x.ai
Authorization: Bearer <サーバーに保管した API キー>
Content-Type: application/json

{"expires_after":{"seconds":300}}
レスポンスの value が短期トークン、expires_at が有効期限です。アプリのサーバーでは、ログイン中の利用者とその利用予算を確認してから発行し、レスポンスをキャッシュせずに返します。API キーやトークンをログへ出力しないようにします。単に誰でも呼べるトークン発行 URL を用意すると、第三者に自分の利用枠を使わせてしまいます。
ブラウザでは、返された value を WebSocket のサブプロトコルに渡します。次の断片は、認証済みの自社サーバーからトークンを取得した後の接続部分です。
function connectVoice(tokenValue) {
  return new WebSocket(
    "wss://api.x.ai/v1/realtime?model=grok-voice-think-fast-2.0",
    [`xai-client-secret.${tokenValue}`],
  );
}トークンの既定の有効期間は600秒、設定可能な最大値は3,600秒です。上の例では300秒を指定しています。これはセッションの最大120分という制限とは別の値です。トークン取得後は接続直前に期限を確認し、再接続時には必要に応じて取得し直します。発行 API のリファレンス
なお、短期トークンのガイドは session フィールドを非対応と説明し、発行 API のリファレンスは任意の初期 session 設定を載せています。ここでは両方に共通する expires_after.seconds だけを使い、接続後に session.update で設定します。トークンが特定モデルや設定に必ず固定される、という前提では設計しません。
PCM を送信し、応答音声を WAV に保存する
音声入力がある最小の会話を作るため、ここでは短い録音を一度送信し、返答をファイルに保存する方式を使います。マイクの取り込みやリアルタイム再生は含みませんが、受け取った音声をプレーヤーで再生できるところまで進められます。
必要なものは Node.js、ws パッケージ、サーバー側で設定した XAI_API_KEY、それに input.pcm です。入力はモノラル・24,000Hz・符号付き16bit・リトルエンディアンの生 PCMにしてください。WAV のヘッダー、MP3、WebM をそのまま送る例ではありません。録音・変換ツールでこの形式に書き出してから使います。24kHz PCM は1秒48,000バイトなので、5秒の録音なら240,000バイトになります。
作業用ディレクトリで npm install ws を実行し、次の内容を voice-file.mjs に保存します。API キーはサーバーの秘密情報として環境変数へ設定し、ソースには埋め込みません。
import WebSocket from "ws";
import { readFileSync, writeFileSync } from "node:fs";

const rate = 24000;
const key = process.env.XAI_API_KEY;
const inputPath = process.argv[2] ?? "input.pcm";
const outputPath = process.argv[3] ?? "reply.wav";
if (!key) throw new Error("サーバーに XAI_API_KEY を設定してください");
const input = readFileSync(inputPath);
if (!input.length || input.length % 2 !== 0) {
  throw new Error("入力は空でない16bit PCMにしてください");
}
if (input.subarray(0, 4).toString() === "RIFF") {
  throw new Error("WAVヘッダーを除いた生PCMを指定してください");
}

function wavFromPcm(pcm) {
  const header = Buffer.alloc(44);
  header.write("RIFF", 0);
  header.writeUInt32LE(36 + pcm.length, 4);
  header.write("WAVE", 8);
  header.write("fmt ", 12);
  header.writeUInt32LE(16, 16);
  header.writeUInt16LE(1, 20); // PCM
  header.writeUInt16LE(1, 22); // モノラル
  header.writeUInt32LE(rate, 24);
  header.writeUInt32LE(rate * 2, 28);
  header.writeUInt16LE(2, 32);
  header.writeUInt16LE(16, 34);
  header.write("data", 36);
  header.writeUInt32LE(pcm.length, 40);
  return Buffer.concat([header, pcm]);
}

const ws = new WebSocket(
  "wss://api.x.ai/v1/realtime?model=grok-voice-think-fast-2.0",
  { headers: { Authorization: `Bearer ${key}` } },
);
const chunks = [];
let configured = false;
let inputCommitted = false;
let responseFinished = false;
let failed = false;

function fail(message) {
  if (failed || responseFinished) return;
  failed = true;
  console.error(message);
  process.exitCode = 1;
  ws.terminate();
}
const deadline = setTimeout(() => fail("応答待ちを打ち切りました"), 90000);
const send = (event) => new Promise((resolve, reject) => {
  ws.send(JSON.stringify(event), (error) => error ? reject(error) : resolve());
});

ws.on("open", () => {
  send({
    type: "session.update",
    session: {
      voice: "eve",
      instructions: "日本語で答えてください。質問に短く答え、聞き取れない部分は確認してください。",
      turn_detection: { type: null },
      audio: {
        input: {
          format: { type: "audio/pcm", rate },
          transport: "json",
          transcription: { language_hint: "ja" },
        },
        output: { format: { type: "audio/pcm", rate }, transport: "json" },
      },
    },
  }).catch((error) => fail(error.message));
});

ws.on("message", async (data, isBinary) => {
  try {
    if (failed || responseFinished) return;
    if (isBinary) throw new Error("JSON音声モードで予期しないバイナリを受信しました");
    const event = JSON.parse(data.toString());
    if (event.type === "session.updated" && !configured) {
      configured = true;
      // 100ms = 4,800バイト。分割は送信単位で、VADの設定ではありません。
      for (let offset = 0; offset < input.length; offset += 4800) {
        await send({
          type: "input_audio_buffer.append",
          audio: input.subarray(offset, offset + 4800).toString("base64"),
        });
      }
      await send({ type: "input_audio_buffer.commit" });
    } else if (event.type === "input_audio_buffer.committed" && !inputCommitted) {
      inputCommitted = true;
      await send({ type: "response.create", response: { modalities: ["audio"] } });
    } else if (event.type === "response.output_audio.delta") {
      chunks.push(Buffer.from(event.delta, "base64"));
    } else if (event.type === "response.output_audio_transcript.delta") {
      process.stdout.write(event.delta);
    } else if (["response.text.delta", "response.output_text.delta"].includes(event.type)) {
      process.stdout.write(event.delta);
    } else if (event.type === "error") {
      const e = event.error ?? {};
      fail(JSON.stringify({ type: e.type, code: e.code, message: e.message,
        param: e.param, event_id: e.event_id ?? event.event_id }));
    } else if (event.type === "response.done") {
      const status = event.response?.status;
      if (status !== "completed") throw new Error(`応答が完了しませんでした: ${status}`);
      const pcm = Buffer.concat(chunks);
      if (!pcm.length || pcm.length % 2 !== 0) throw new Error("有効な応答PCMを受信できませんでした");
      writeFileSync(outputPath, wavFromPcm(pcm));
      responseFinished = true;
      clearTimeout(deadline);
      console.log(`\n保存: ${outputPath} (${(pcm.length / (rate * 2)).toFixed(2)}秒)`);
      ws.close(1000, "one turn complete");
      const closeDeadline = setTimeout(() => ws.terminate(), 5000);
      ws.once("close", () => clearTimeout(closeDeadline));
    }
  } catch (error) {
    fail(error.message);
  }
});
ws.on("error", (error) => fail(`接続エラー: ${error.message}`));
ws.on("close", (code, reason) => {
  clearTimeout(deadline);
  if (!responseFinished && !failed) {
    process.exitCode = 1;
    console.error(`完了前に切断: ${code} ${reason.toString()}`);
  }
});
準備した PCM ファイルを渡して node voice-file.mjs input.pcm reply.wav を実行します。成功時には返答の文字が表示され、reply.wav と秒数が出力されます。WAV をプレーヤーで開き、返答内容と音声が対応しているか確認します。response.done の status が completed で、音声バイトが保存されたことを、この例の成功条件にしています。
このコードは現行イベントのリファレンスに沿った実装例です。構文、WAV ヘッダー、音声長の計算はオフラインで確認しましたが、xAI への実接続、応答内容や遅延の測定は行っていません。90秒の待機期限、100ms相当の分割、短い回答の指示は、この例で選んだ設定であり、サービスの既定値ではありません。長い音声を一括でメモリに載せる用途には、ファイルのストリーム処理と送信量の制御を追加してください。
発話の区切りは自動 VAD と手動で処理を変える
上のコードでは、ファイルの末尾を利用者の発話終了として扱います。手動モードの順序は次のとおりです。
session.updateでturn_detection: { type: null }を指定する。session.updatedを受けてからinput_audio_buffer.appendで音声を送る。- 送り終わったら
input_audio_buffer.commitを送る。 input_audio_buffer.committedを受け、response.createを一度送る。- 音声デルタを受け取り、
response.doneの状態を確認する。
自動で会話を続ける場合は turn_detection: { type: "server_vad" } に変更し、マイクから得た音声を append で送り続けます。サーバーが発話の終了を検出して応答するため、各発話に対する commit と response.create は不要です。両方式を混ぜて、自動応答の直後にもう一度応答を要求しないようにします。音声入力と VAD の説明
音声ではなく文字から会話を始める場合は、利用者の conversation.item.create に input_text を入れ、その後に response.create を送ります。文字入力の作成と、音声バッファの確定は別の操作です。
入力の文字起こしを画面に表示するなら、audio.input.transcription.model に grok-transcribe を指定します。conversation.item.input_audio_transcription.updated は、前の文字列を修正しうる累積の文字起こしなので、字幕を追記せず置き換えます。Grok が話す内容の response.output_audio_transcript.delta は差分であり、こちらは順に連結します。language_hint: "ja" は入力の認識を日本語に寄せる設定で、返答を日本語にする指示とは別です。文字起こしイベントの定義
音声形式と送信形式も分けて考えます。JSON モードなら PCM を base64 にして音声イベントへ入れます。バイナリモードなら生の音声バイトを WebSocket のバイナリフレームへ入れますが、設定や終了イベントは引き続き JSON です。Node.js の ws はテキストフレームも Buffer で渡すことがあるため、Buffer.isBuffer で判別せず、コールバックの isBinary を使います。Opus を選ぶ場合も、必要なのは24kHzモノラルの生 Opus パケットであり、ブラウザ録音の WebM コンテナそのものではありません。音声形式と転送方式
リアルタイム再生と割り込みで会話の状態を揃える
WAV 保存からリアルタイム会話へ進むときは、受信した PCM を再生キューへ追加し、出力と同じサンプルレートで再生します。PCM のチャンクは完成した WAV ファイルではないため、各チャンクを独立した音声ファイルとしてプレーヤーへ渡すのではなく、音声バッファとして順番に処理します。
ここで重要なのは、生成完了と再生完了を別に管理することです。response.done はサーバーの応答生成が終わったことを示します。受信済みの音声がスピーカーでまだ再生中なら、利用者が聞き終わったことにはなりません。さらに status には completed のほか cancelled、incomplete があります。応答終了のスキーマ
利用者が話し始めたときは、input_audio_buffer.speech_started を受けたアプリが再生を止め、未再生のキューを破棄します。手動モードで生成も止める場合は response.cancel を送ります。そのうえで、会話履歴を利用者が実際に聞いた位置まで揃えるため、conversation.item.truncate を使えます。
{
  "type": "conversation.item.truncate",
  "item_id": "msg_from_actual_output_item",
  "content_index": 0,
  "audio_end_ms": 1250
}
この例の item_id は実際に受信した応答アイテムの ID、content_index は対象音声の位置に置き換えます。audio_end_ms にはそのアイテムで実際に再生した時間を指定します。1,250msは説明用の値で、受信済み音声の総秒数ではありません。サーバーからの conversation.item.truncated を確認し、聞いていない続きが会話の前提に残らないようにします。現在のリファレンスでは truncate が対応済みです。切り詰め操作の定義
ツールの結果を返してから次の音声応答を作る
社内情報の検索や予約処理を会話に追加する場合、モデルが関数を要求したことと、アプリが処理を完了したことを区別します。カスタム関数の要求は response.function_call_arguments.done で届き、name、JSON 文字列の arguments、結果を対応付ける call_id が含まれます。ツール利用の公式説明
実装では、許可した関数名か、引数が期待する型・値か、利用者に操作権限があるかを確認してから処理します。読み取りと、予約確定のような変更操作も分けます。正常終了した場合も失敗した場合も、実際の結果を JSON 文字列にして返します。
{
  "type": "conversation.item.create",
  "item": {
    "type": "function_call_output",
    "call_id": "call_id_from_received_event",
    "output": "{\"ok\":false,\"error\":\"permission_denied\"}"
  }
}
上の例は権限確認で拒否した場合の形式です。予約ができたような架空の成功値を返しません。同じ応答から複数の関数要求が来たら、それぞれの call_id に結果を返し、全結果が揃った後に response.create を一度送ります。前の応答音声がまだ再生中なら、その終了も待って音声が重ならないようにします。
再接続で会話履歴が再送された場合は、既に処理した call_id と結果を照合します。過去の要求を見たという理由だけで、予約や決済などを再実行してはいけません。会話 ID や関数の結果は、必要な業務記録の代わりにはなりません。
Grok Voice Agent API の料金と待機時間の計算
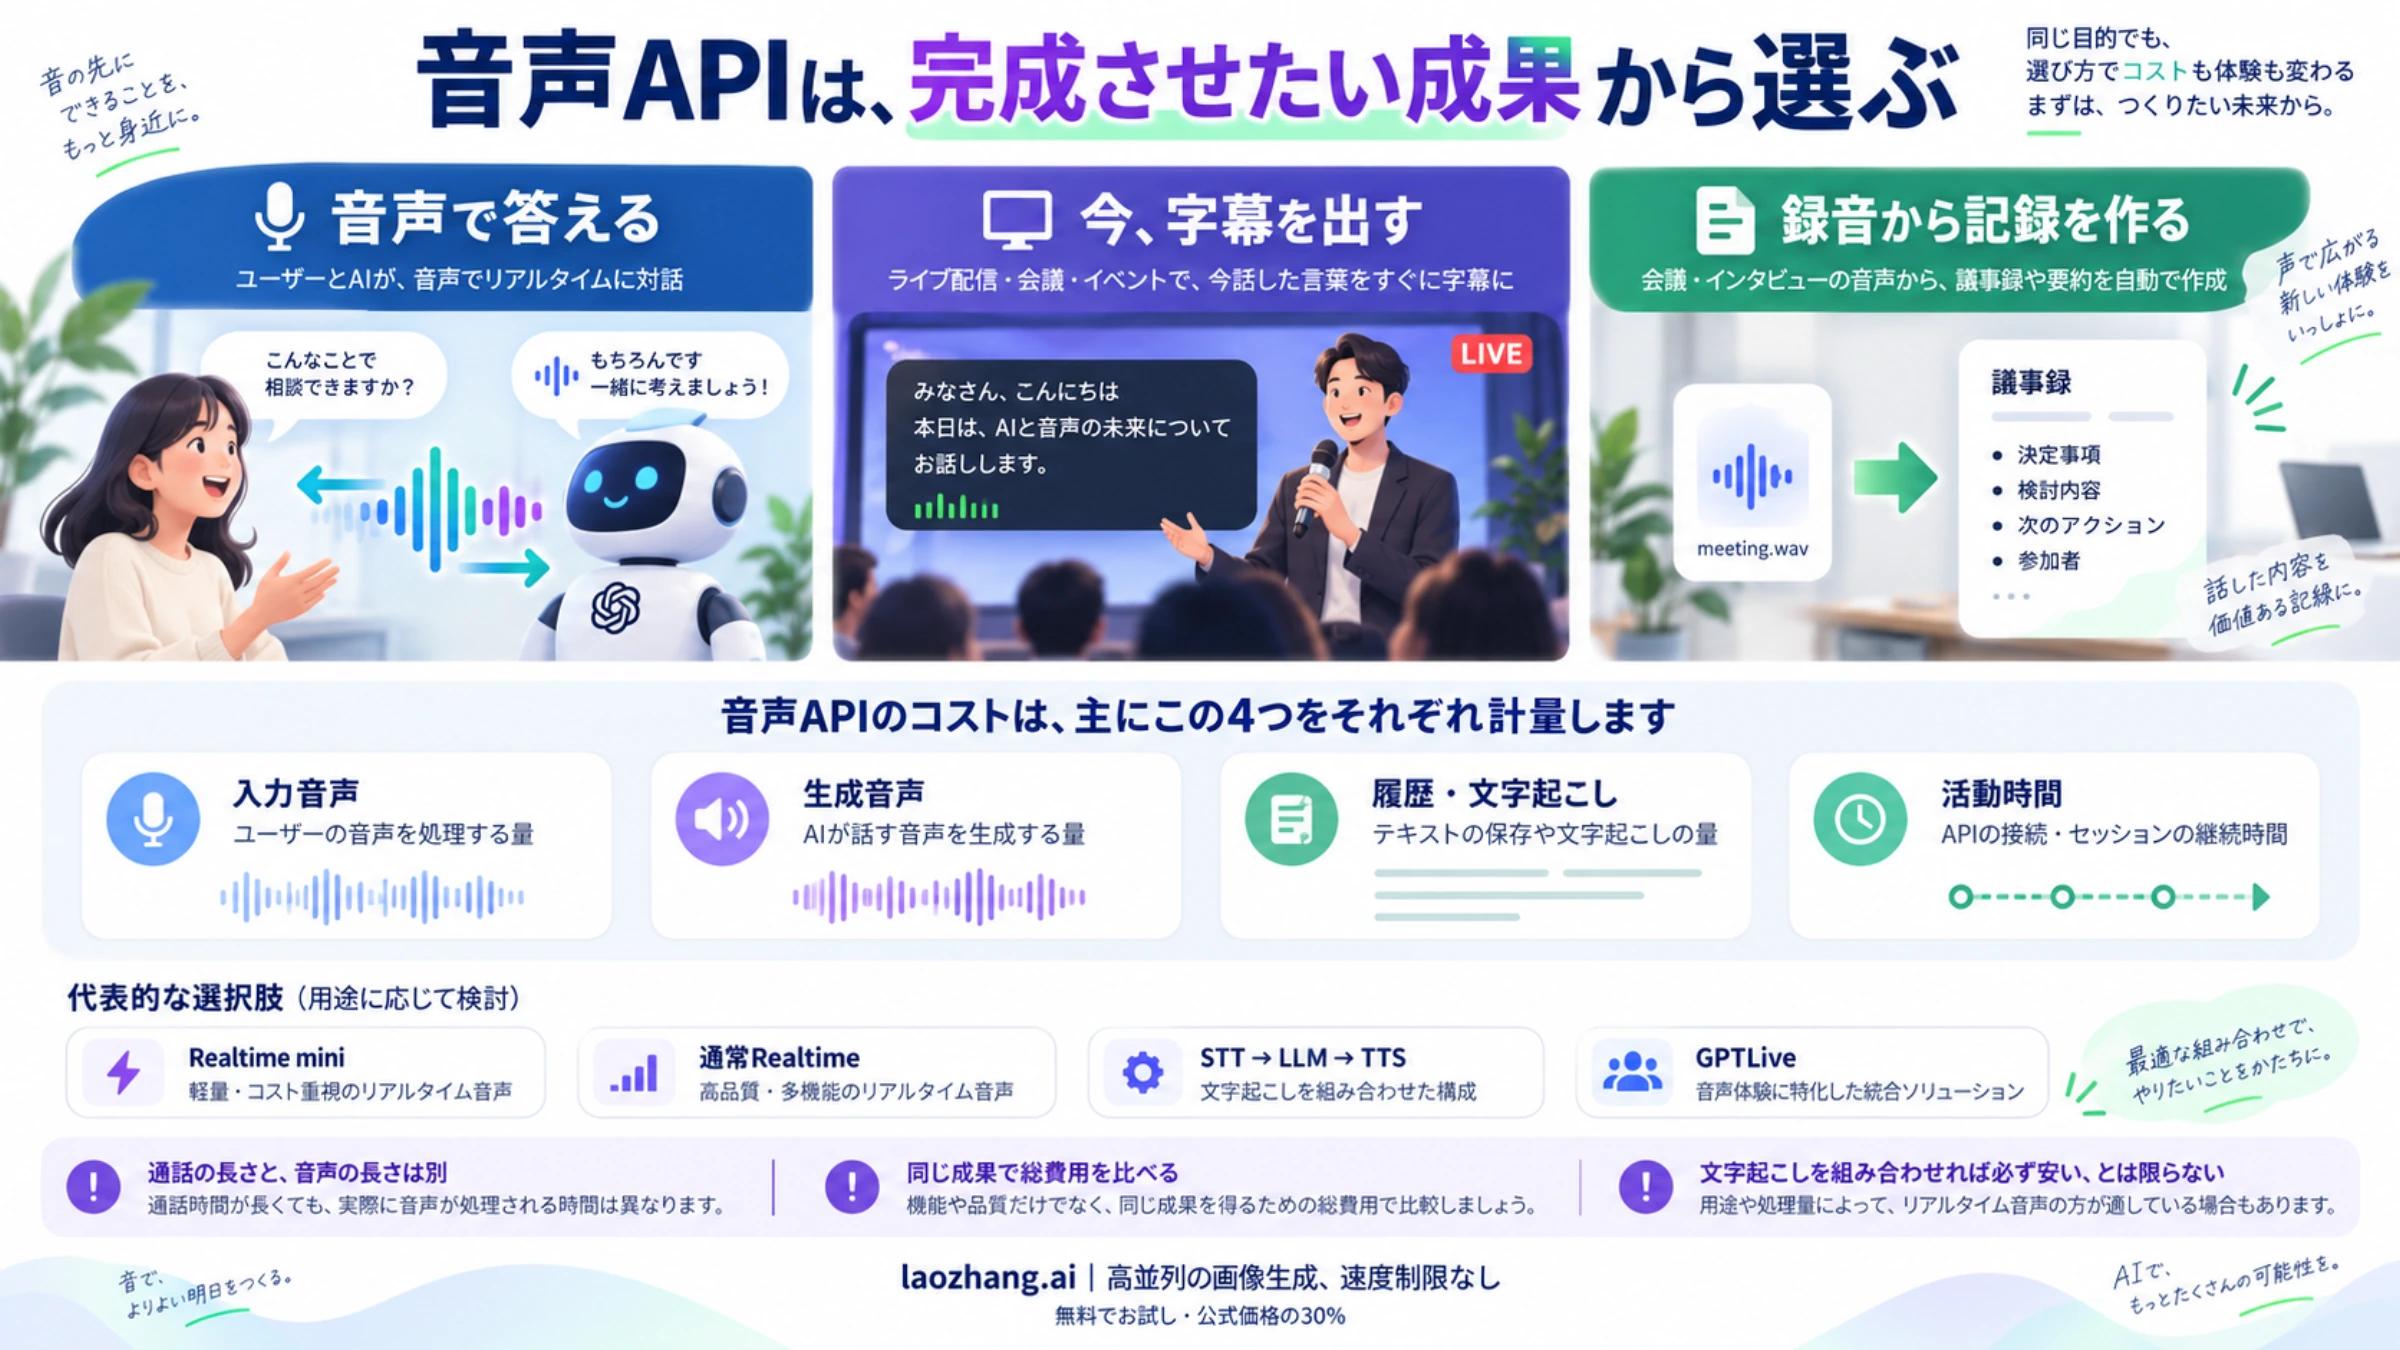
2026年10月7日時点では、音声は1分0.08米ドル、1時間4.80米ドルです。クライアントが送る文字入力の conversation.item.create は1件0.004米ドルで、function_call_output と音声を含む input_audio/audio はこの文字課金から除かれます。response.create 自体は文字入力として課金されませんが、生成される音声には音声料金がかかります。モデル別の計量方法、公式料金
| 仮定した利用 | 音声部分の計算 | 見積額 |
|---|---|---|
| 自動 VAD で接続を10分保持する | セッション10分 × 0.08米ドル | 0.80米ドル |
| 手動送信で入力合計2分、出力合計3分 | 音声5分 × 0.08米ドル | 0.40米ドル |
| 上の手動送信に文字入力を5件追加 | 0.40 + 5件 × 0.004米ドル | 0.42米ドル |
いずれも計量方法に基づく仮定の計算で、実際の請求記録ではありません。サーバーや通信、電話サービスなどの費用は含めていません。無言の待機が長いアプリでは、自動 VAD のまま接続を開き続ける費用と、手動で入力を確定する操作性を比較してください。
Web 検索、X 検索、Collections などを使う場合は、その利用単位も確認します。一般のツール料金表では Web 検索は1,000回あたり5米ドル、X 検索は取得投稿1,000件あたり5米ドルとプロフィール1,000件あたり10米ドルです。「X 検索を1回したら一定額」とは限りません。この一般表のトークン料金をそのまま Voice の音声分数に加算したり、自作関数がすべて一定額で課金されると解釈したりせず、利用するツールと適用される計量条件を個別に確認します。ツール料金の単位
公開モデルページの上限はチームあたり同時10セッション、1セッション最大120分、リージョンは us-east-1 です。公開上限は、このアプリで確認したアカウントの利用資格や性能測定を意味しません。接続数の管理では待機中のセッションも数え、使い終わった接続を閉じます。現在の上限
エラーと切断は、発生した段階から調べる
「返答がない」場合は、最後に成功したイベントを確認すると調べる場所を絞れます。長期キーや短期トークンを出力せず、応答 ID、イベント ID、エラーの type、code、message、param を記録します。
| 症状 | 先に確認する内容 |
|---|---|
| 接続が開かない | サーバーなら認証ヘッダー、ブラウザなら短期トークンの期限とサブプロトコル。HTTP upgrade の成功は101です |
session.updated が来ない | error の内容と送った設定。前の設定のまま入力を送り続けない |
| 手動モードで応答が始まらない | PCM の形式、append、commit、確定後の response.create の順序 |
| 文字は出るが音が保存されない | 出力が音声モードか、JSON/バイナリの選択、音声デルタの処理 |
| 音が速い、遅い、雑音になる | PCM の実際のサンプルレート、16bit、エンディアンと出力側の指定が一致しているか |
| 途中で終了する | response.done.status、WebSocket の close コードと理由。中断した応答を成功として扱わない |
多くの API エラーでは接続を維持して修正できますが、すべてが復旧可能とは限りません。上の一往復例はエラーで打ち切る方式です。継続型アプリでは、入力を止めて誤った設定やイベントを修正し、セッションが開いているかを確認してから再開します。原因不明のまま同じ要求を無制限に繰り返さないようにします。エラーと接続イベント
会話を切断後も続けるには、最初の接続と再接続の両方で resumption.enabled: true を設定します。conversation.created の conversation.id を保存し、次の接続 URL の conversation_id に渡します。公式ガイドによるキャッシュの期限は、操作がない状態が30分続くまでです。既定では再開は無効です。セッションの再開
ガイドは再送される履歴を conversation.item.created、現行リファレンスは新しい会話アイテムを conversation.item.added と呼んでいます。履歴表示用の受信処理はこの違いを考慮し、再送を新しい業務操作の指示と混同しないようにします。会話を再開できることは、無期限に保存されることや、アプリのデータベースが不要になることを意味しません。
FAQ
日本語で会話できますか?
日本語は公式ガイドの対応言語に含まれます。入力には language_hint: "ja"、応答には「日本語で答えてください」のような instructions を設定します。この2つは別の役割です。固有名詞や実際の環境での聞き取りやすさは、対象の音声で確認してください。対応言語の記載だけで、日本語の認識・発音品質を保証するものではありません。言語設定の説明
音声モデルと声は何を指定すればよいですか?
現行の音声モデルを固定するなら grok-voice-think-fast-2.0、更新を追うなら grok-voice-latest です。声は voice: "eve" から始められます。現在の一覧は28種類で、以前からの ara、leo、rex、sal も含まれます。音声モデル名と声の ID は別の設定です。推論設定の reasoning.effort は既定が high で、none も選べます。モデル選択、音声一覧
無言で待っている時間も料金がかかりますか?
既定の server_vad では、無言の待機を含むセッション時間で課金されます。プッシュ・トゥ・トークでは送受信した音声時間が対象です。どちらも音声の公開単価は1分0.08米ドルです。公式の課金条件
response.done が来たら、次の音声を再生してよいですか?
前の再生キューが空かどうかも確認してください。response.done は生成の終了で、スピーカーの再生終了ではありません。状態が cancelled や incomplete の場合もあるため、成功判定には status を使います。終了イベントの定義
短期トークンは120分有効ですか?
いいえ。短期トークンの有効期間は既定600秒、最大3,600秒で、セッション上限120分とは別です。ブラウザでは接続前に expires_at を確認します。SIP の call_id 付きセッションは短期トークンに対応せず、API キーが必要です。認証リファレンス
決まった案内文だけを読み上げられますか?
会話中に固定の文を読み上げる force_message が使えます。これはモデルに次の会話応答を作らせる操作とは異なり、直後に response.create を送る必要はありません。interruptible: false では再生中の利用者音声を受け付けない点に注意してください。文章の読み上げだけが目的なら、独立した TTS API を選ぶ方が構成を簡単にできます。固定メッセージの説明
参考資料7
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月8日。
参考資料7
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年10月8日。
- 1.公式の Speech to Speech ガイドdocs.x.ai/developers/model-capabilities/audio/speech-to-speech
- 2.公式モデルページdocs.x.ai/developers/models/speech-to-speech
- 3.料金表docs.x.ai/developers/pricing
- 4.公式の音声 API 一覧docs.x.ai/developers/model-capabilities/audio/voice
- 5.API リファレンスdocs.x.ai/developers/rest-api-reference/inference/voice
- 6.短期トークンの公式説明docs.x.ai/developers/model-capabilities/audio/ephemeral-tokens
- 7.応答終了のスキーマdocs.x.ai/voice-realtime.ws.json