Claude Codeの529過負荷エラー:待つか切り替えるか
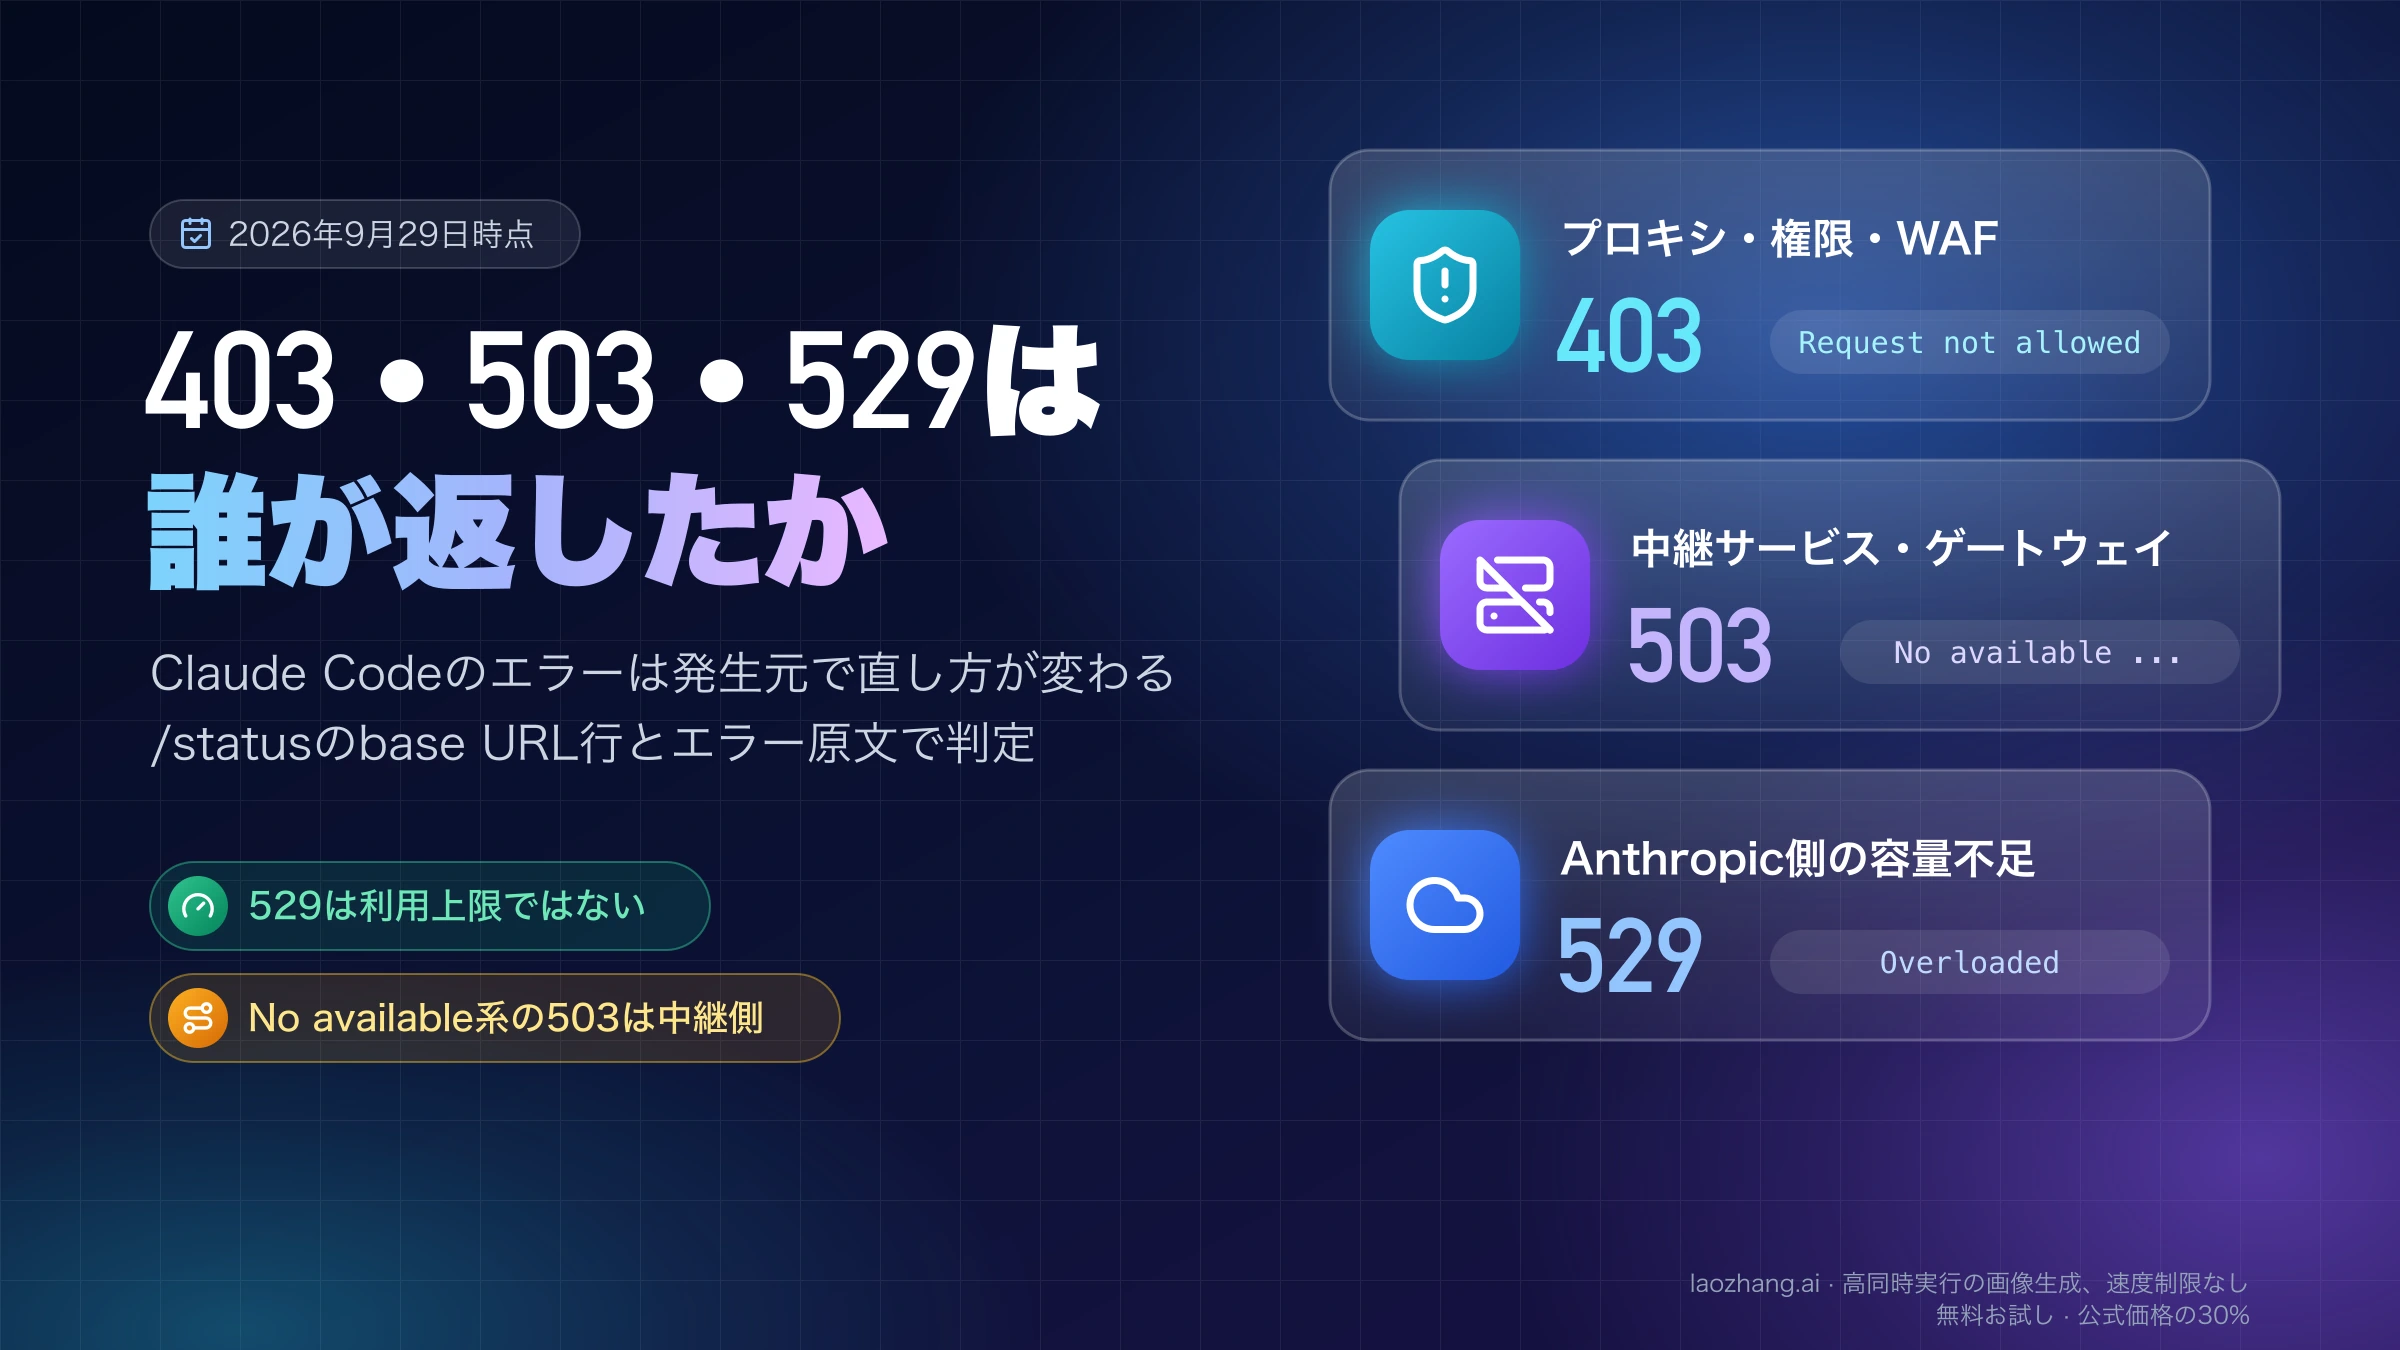
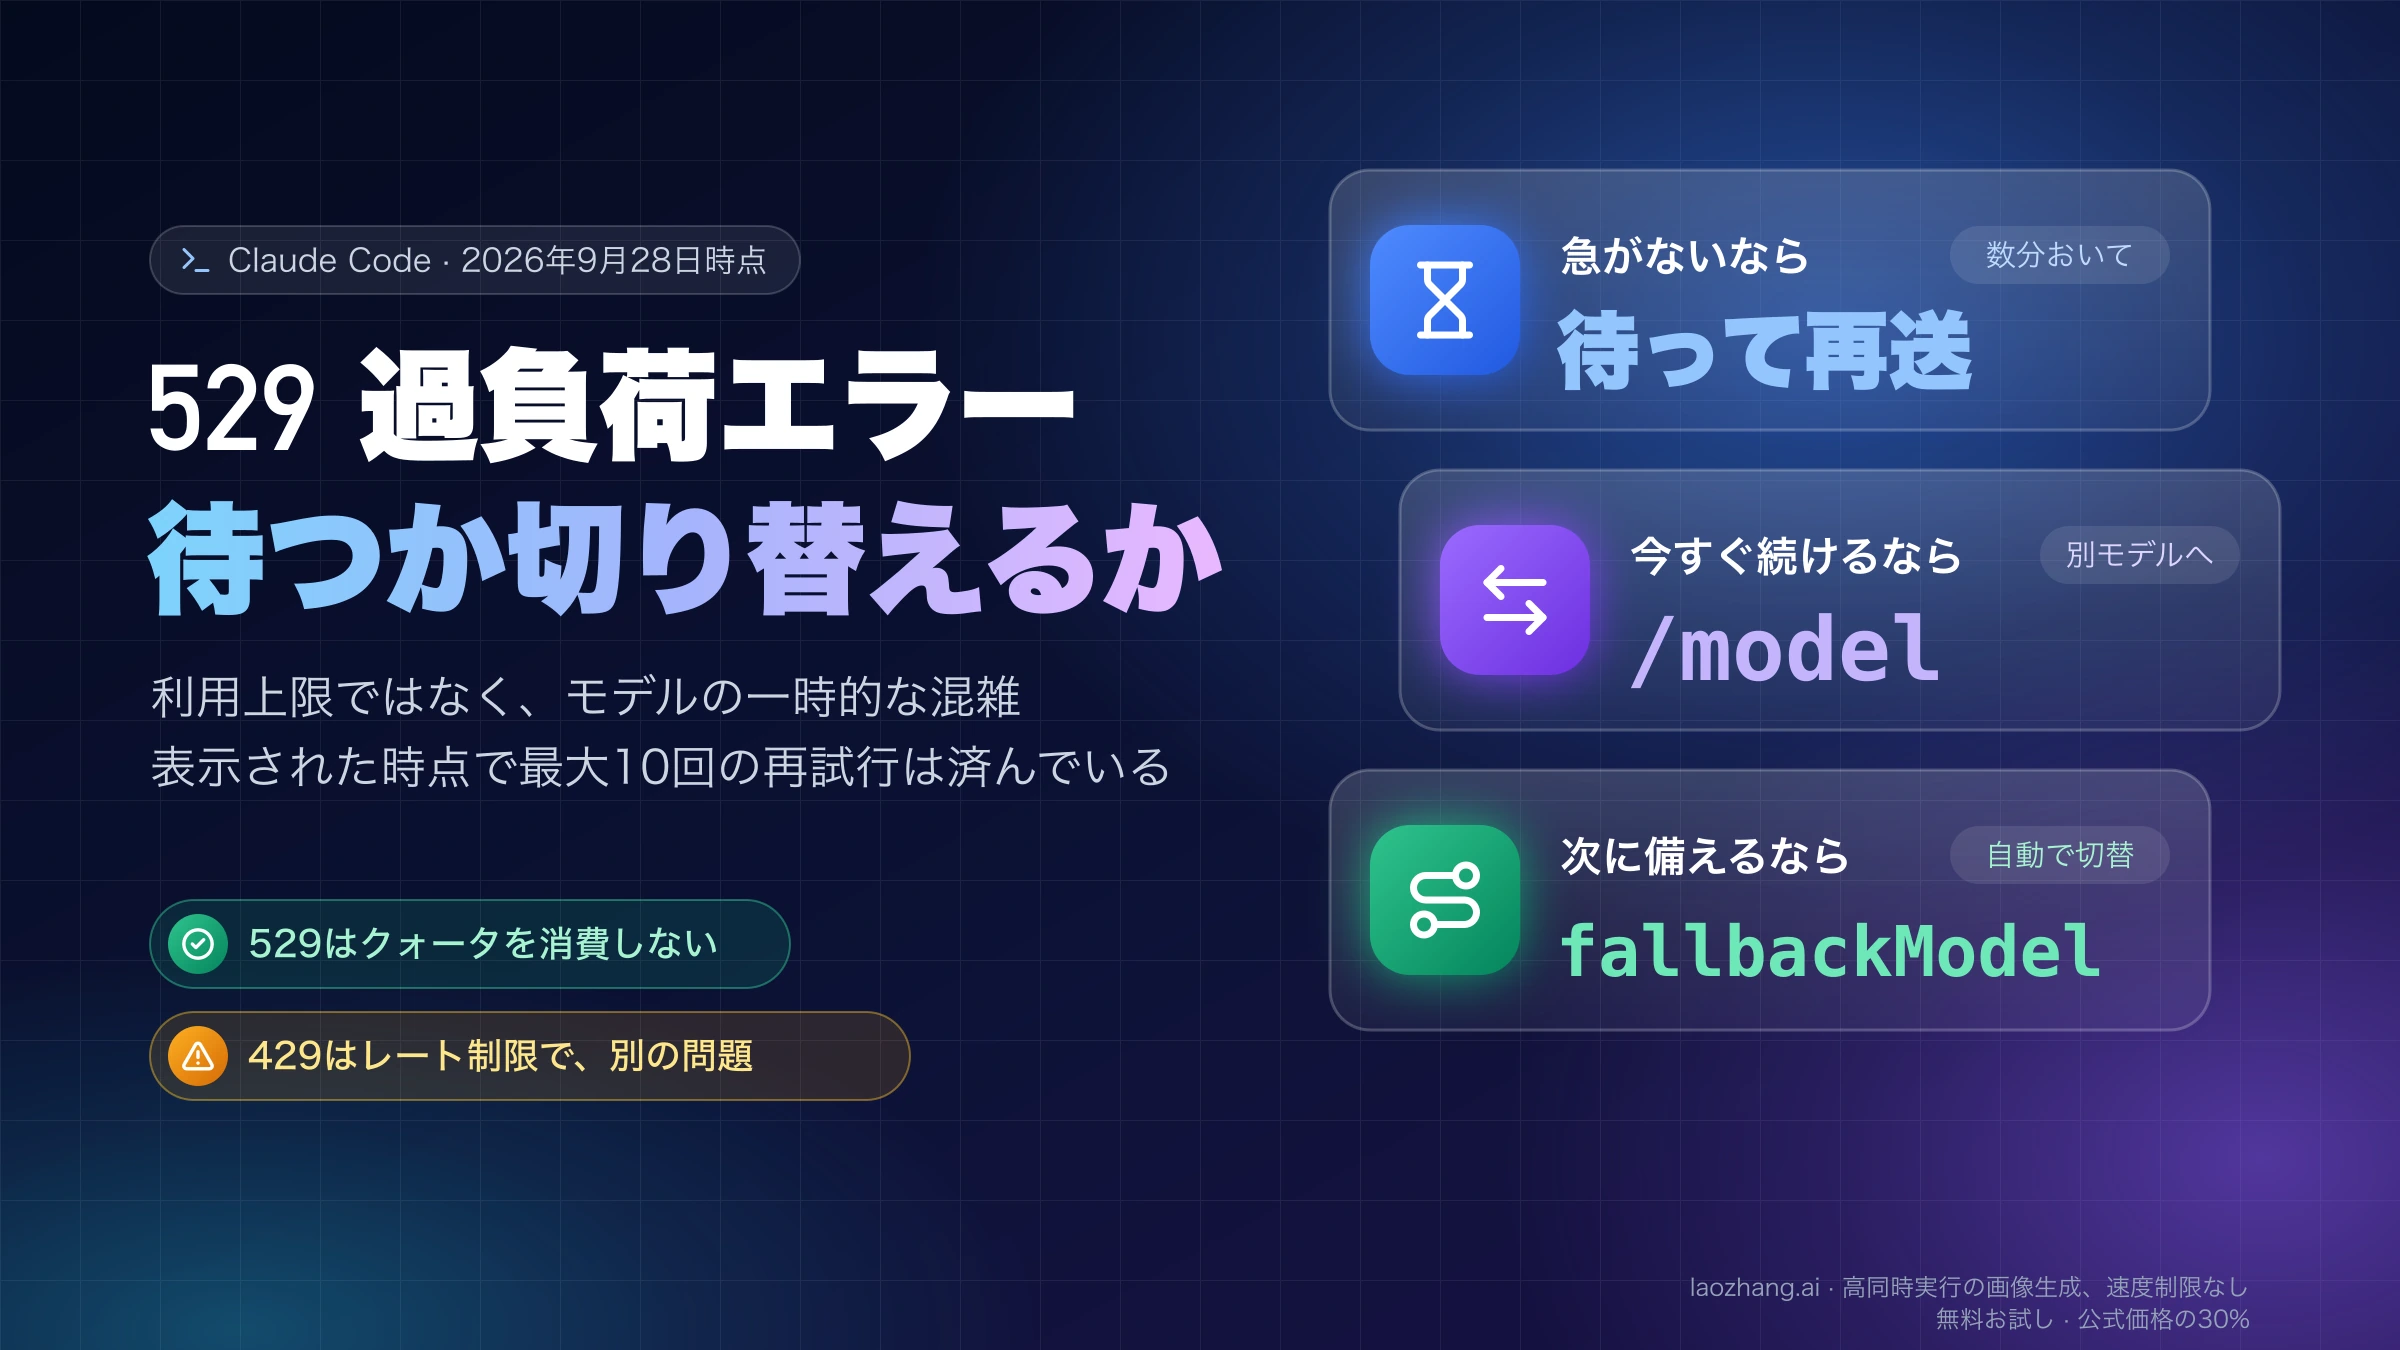
529 Overloadedは利用上限ではなくモデルの混雑で、表示前に最大10回再試行済みです。急ぐなら/modelで別モデルへ、次に備えるならフォールバックモデルを設定します。
目次
Claude Codeで次のメッセージが出たら、原因はあなたの利用上限ではありません。そのモデルの処理能力が、全利用者ぶんの需要で一時的に埋まっている状態です。529はクォータも消費しません。
API Error: Repeated 529 Overloaded errors. The API is at capacity — this is usually temporary. Try again in a moment. If it persists, check https://status.claude.com.このメッセージが表示された時点で、Claude Codeは指数バックオフで最大10回の再試行をすでに終えています。同じ依頼をすぐ送り直すより、状況に合わせて次のどれかを選ぶほうが早く作業に戻れます。
- いま作業を止めたくない:
/modelで別のモデルに切り替えます。容量はモデルごとに管理されているため、別のモデルなら通ることがあります。 - 急がない:数分おいてから送り直します。元のメッセージは会話に残っているので、長い指示でも「try again」と入力すれば足ります。
- 次の過負荷で止まりたくない:フォールバックチェーン(
fallbackModel)を設定しておくと、過負荷のときだけ自動で別モデルに切り替わります。 - CIやスクリプトで無人実行している:
CLAUDE_CODE_RETRY_WATCHDOG=1で、過負荷が解けるまで失敗させずに待たせられます。
以下は2026年9月28日時点のClaude Code公式ドキュメント(エラーリファレンス、モデル設定)に基づきます。バージョンで挙動が変わる箇所には、必要なバージョンを添えています。
画面の表示で分岐を決める
「過負荷っぽい」エラーでも、実際には429や500、応答途中の切断であることがあります。対処の行き先が違うので、まずメッセージの冒頭を確かめてください。
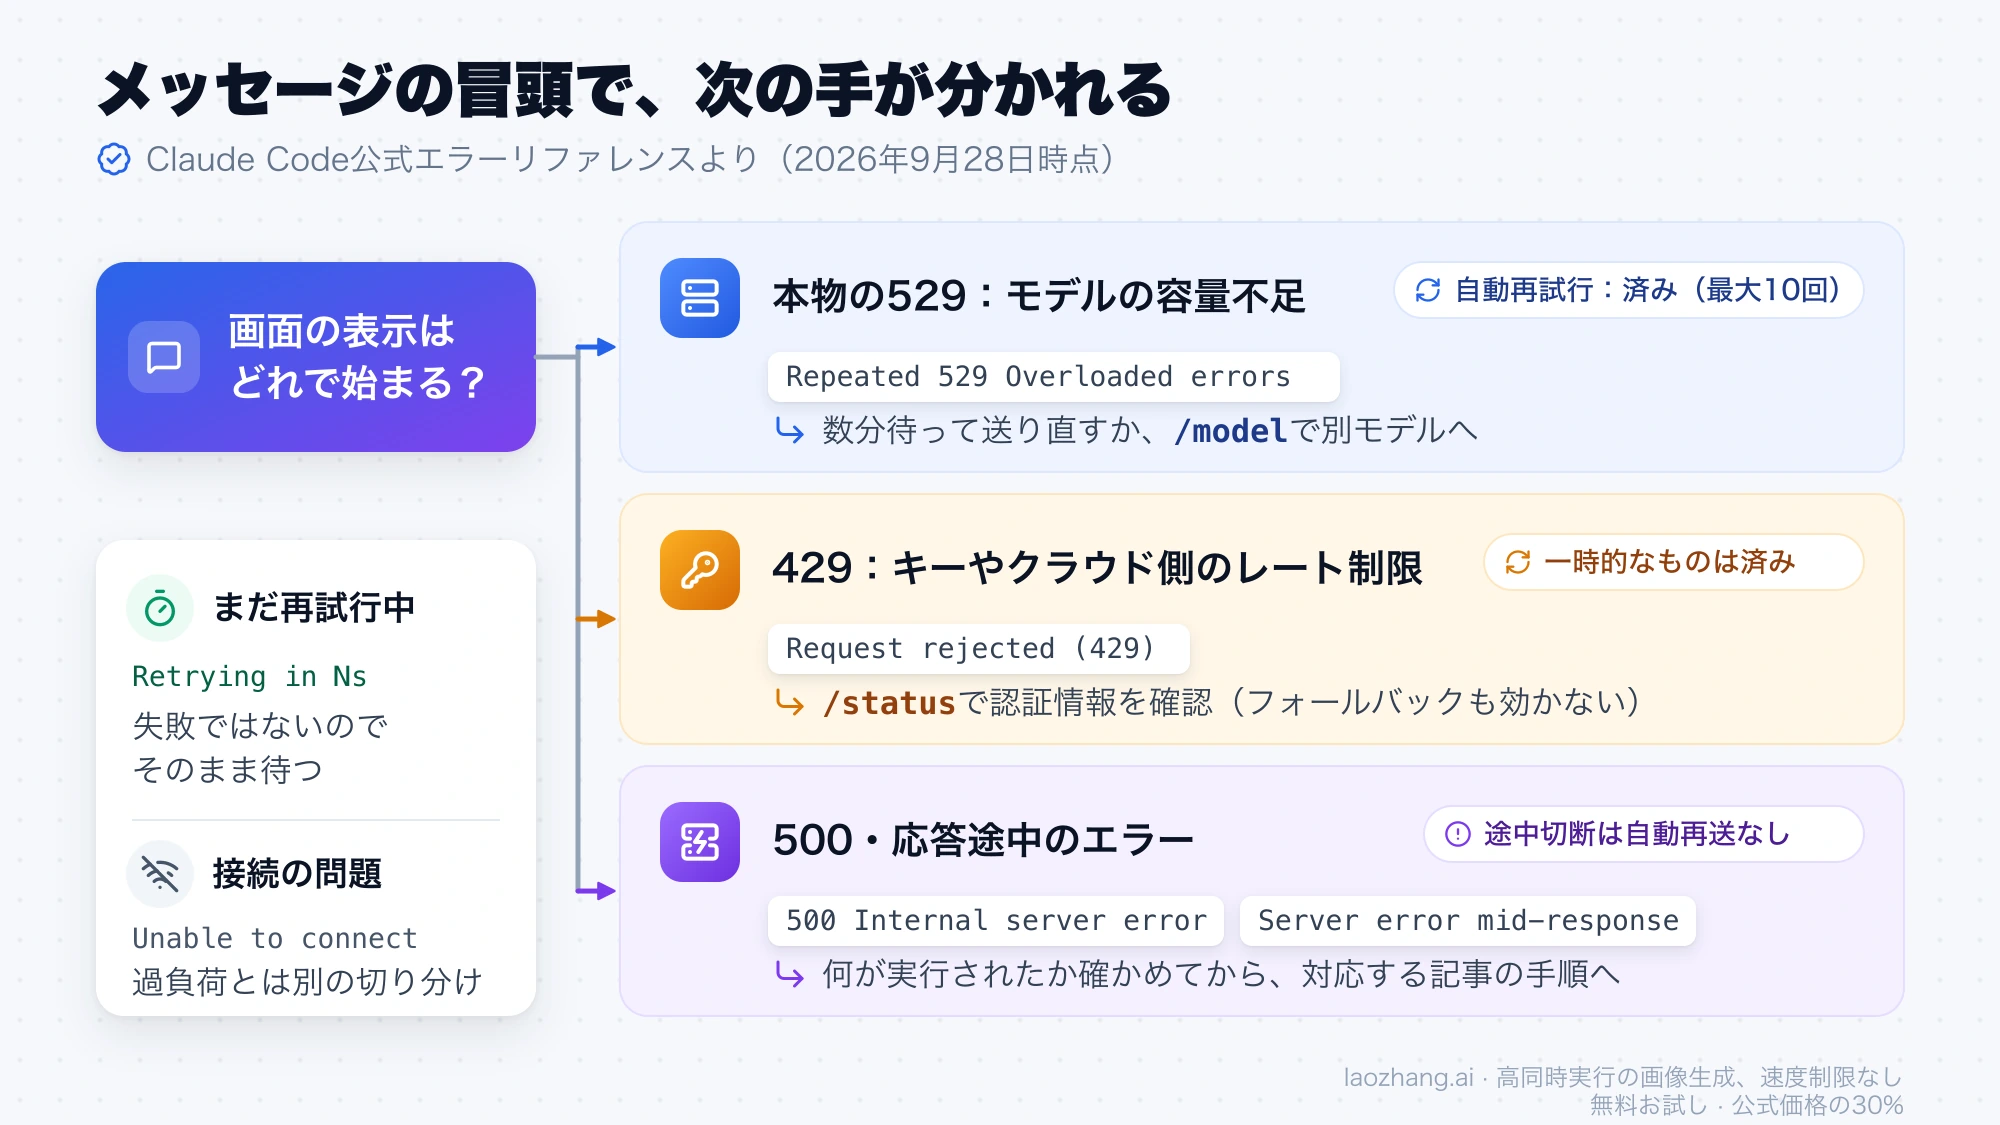
| 画面の表示(冒頭) | 意味 | 自動再試行 | 次の手 |
|---|---|---|---|
Retrying in Ns · attempt x/y | 再試行の最中で、まだ失敗していない | 進行中 | そのまま待つ |
API Error: Repeated 529 Overloaded errors | そのモデルの容量不足。利用上限とは無関係 | 済み(最大10回) | 数分待つか、/modelで切り替える |
Opus is experiencing high load, please use /model to switch to Sonnet | 特定のモデルに負荷が集中している | — | 案内どおり別モデルへ |
API Error: Request rejected (429) | APIキー、Bedrock、Google Cloudプロジェクトのレート制限 | 一時的なものは済み | /statusで認証情報を確認 |
API Error: Server is temporarily limiting requests (not your usage limit) | 短時間のスロットリング。プランの上限ではない | 済み(v2.1.199以降) | 少し待って送り直す |
API Error: 500 Internal server error | API内部の予期しない障害 | 済み | 500の手順へ |
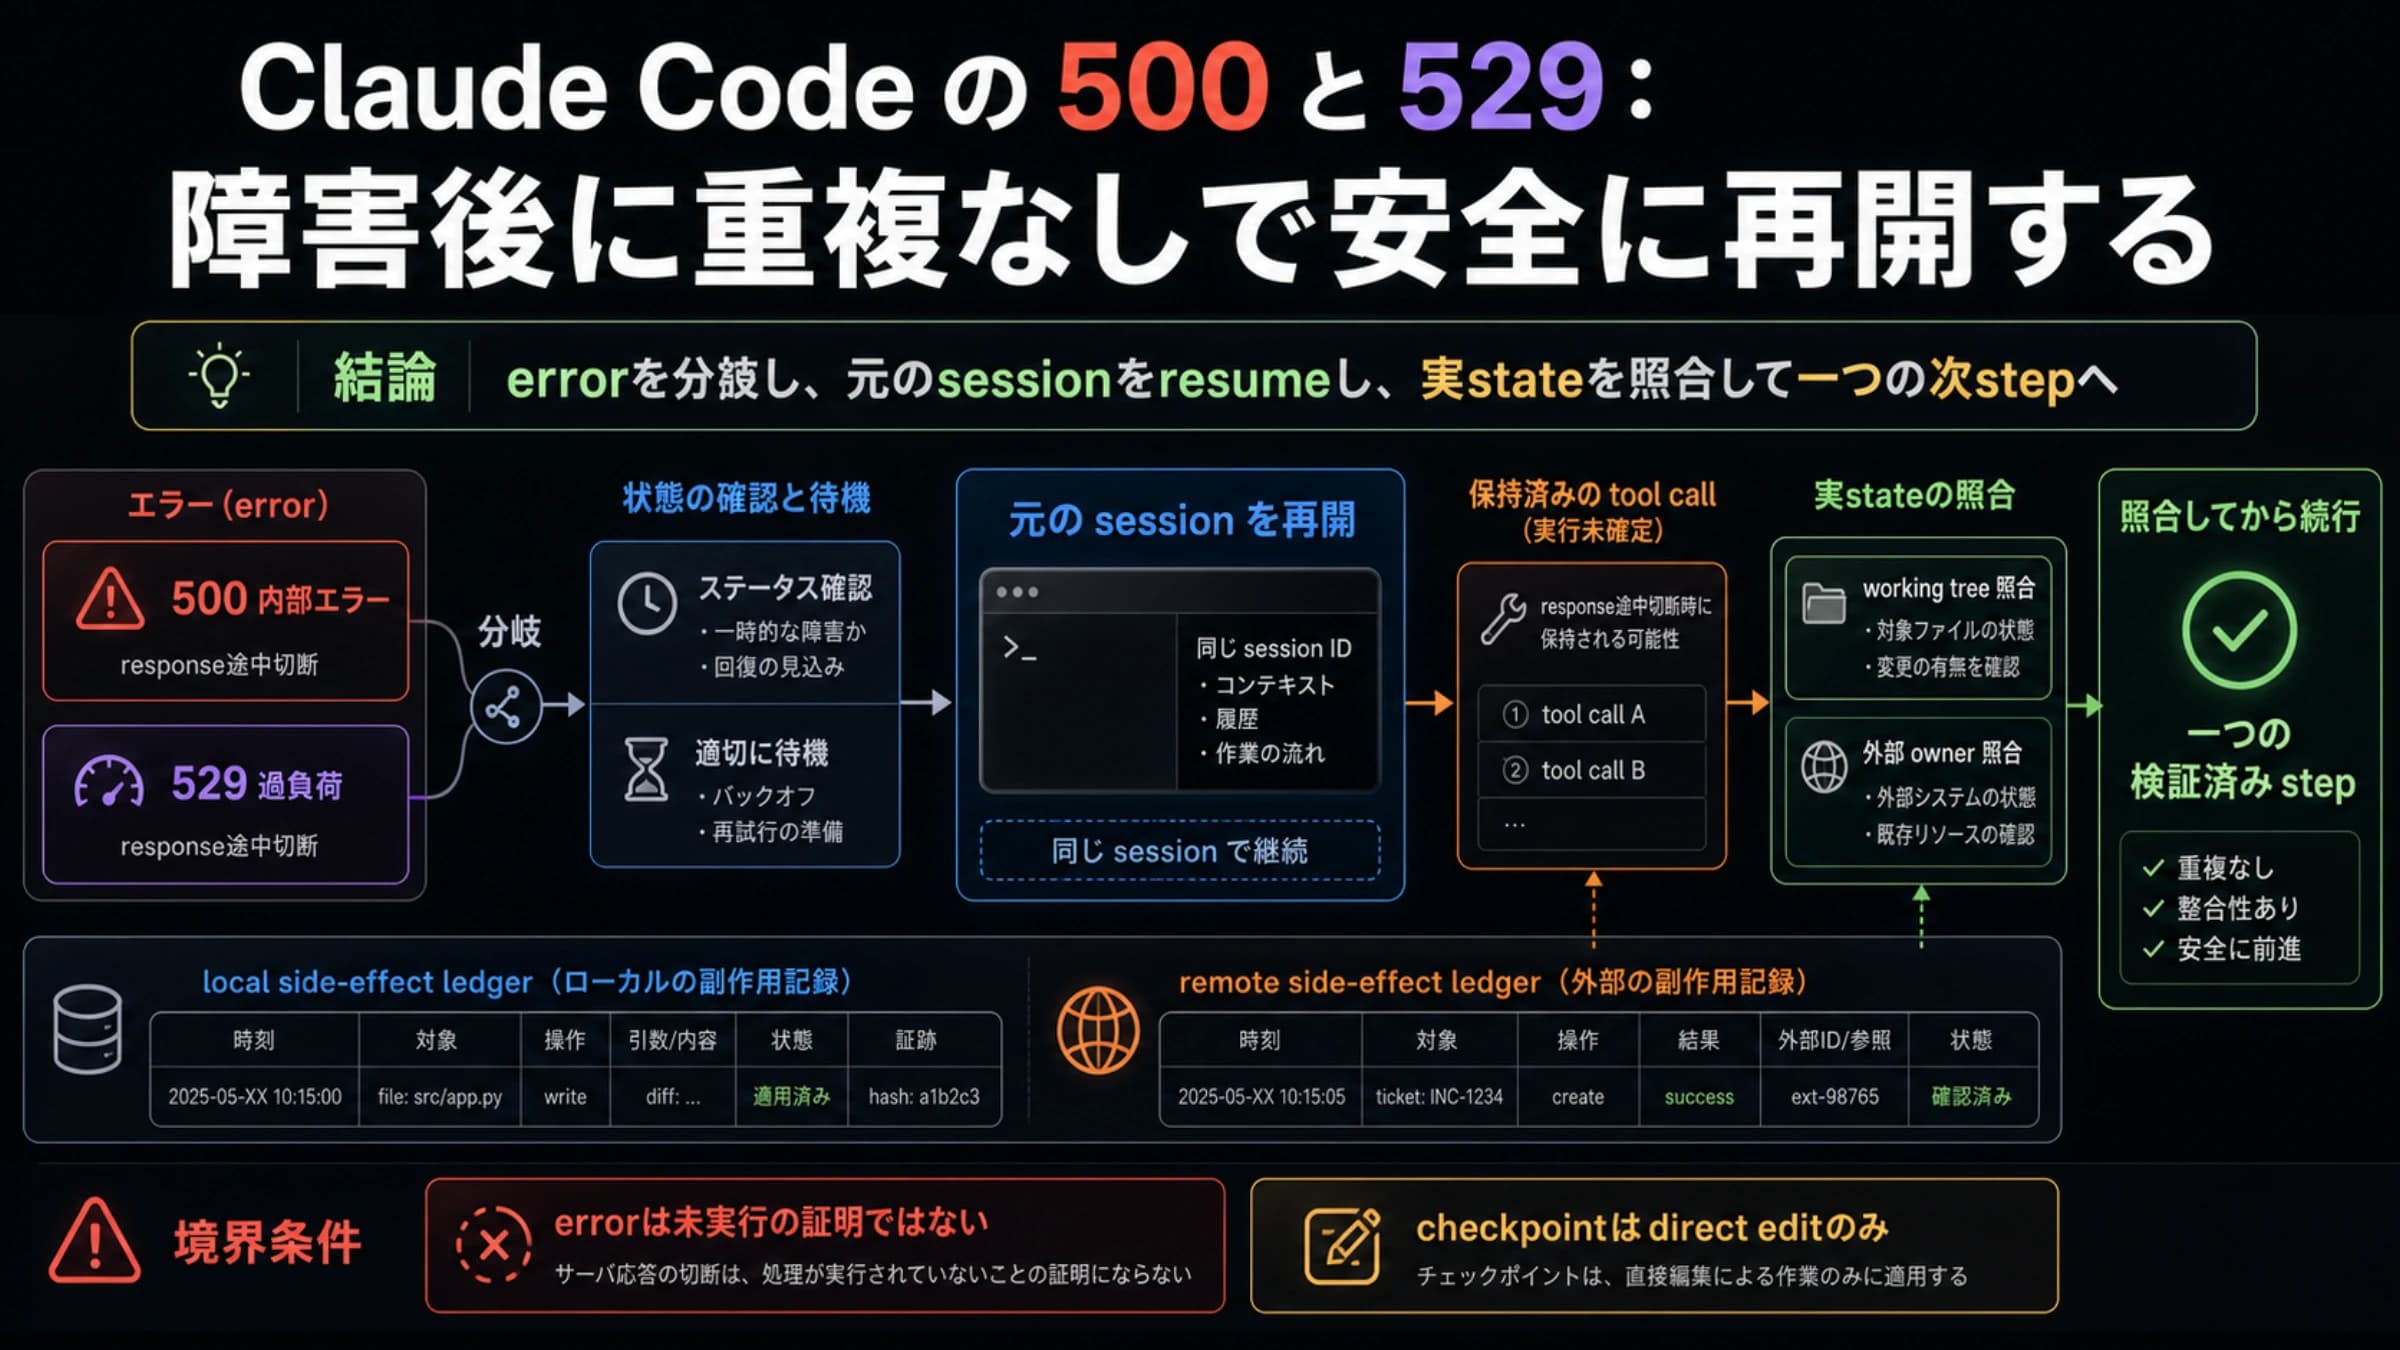
API Error: Server error mid-response. The response above may be incomplete. | 応答の途中で過負荷や5xxが起きた | あえて再送しない | 何が実行されたかを確認してから続ける |
429の行には注意が必要です。429のメッセージにはthis may be a temporary capacity issueという一文が付きますが、中身はあなたのAPIキーやクラウドプロジェクトに設定されたレート制限です。環境変数にANTHROPIC_API_KEYが残っていると、サブスクリプションではなく低いティアのAPIキーでリクエストが送られていることもあります。後述するフォールバックチェーンも429では切り替わりません。こちらはClaude Codeの429・使用量上限の対処ガイドで扱っています。
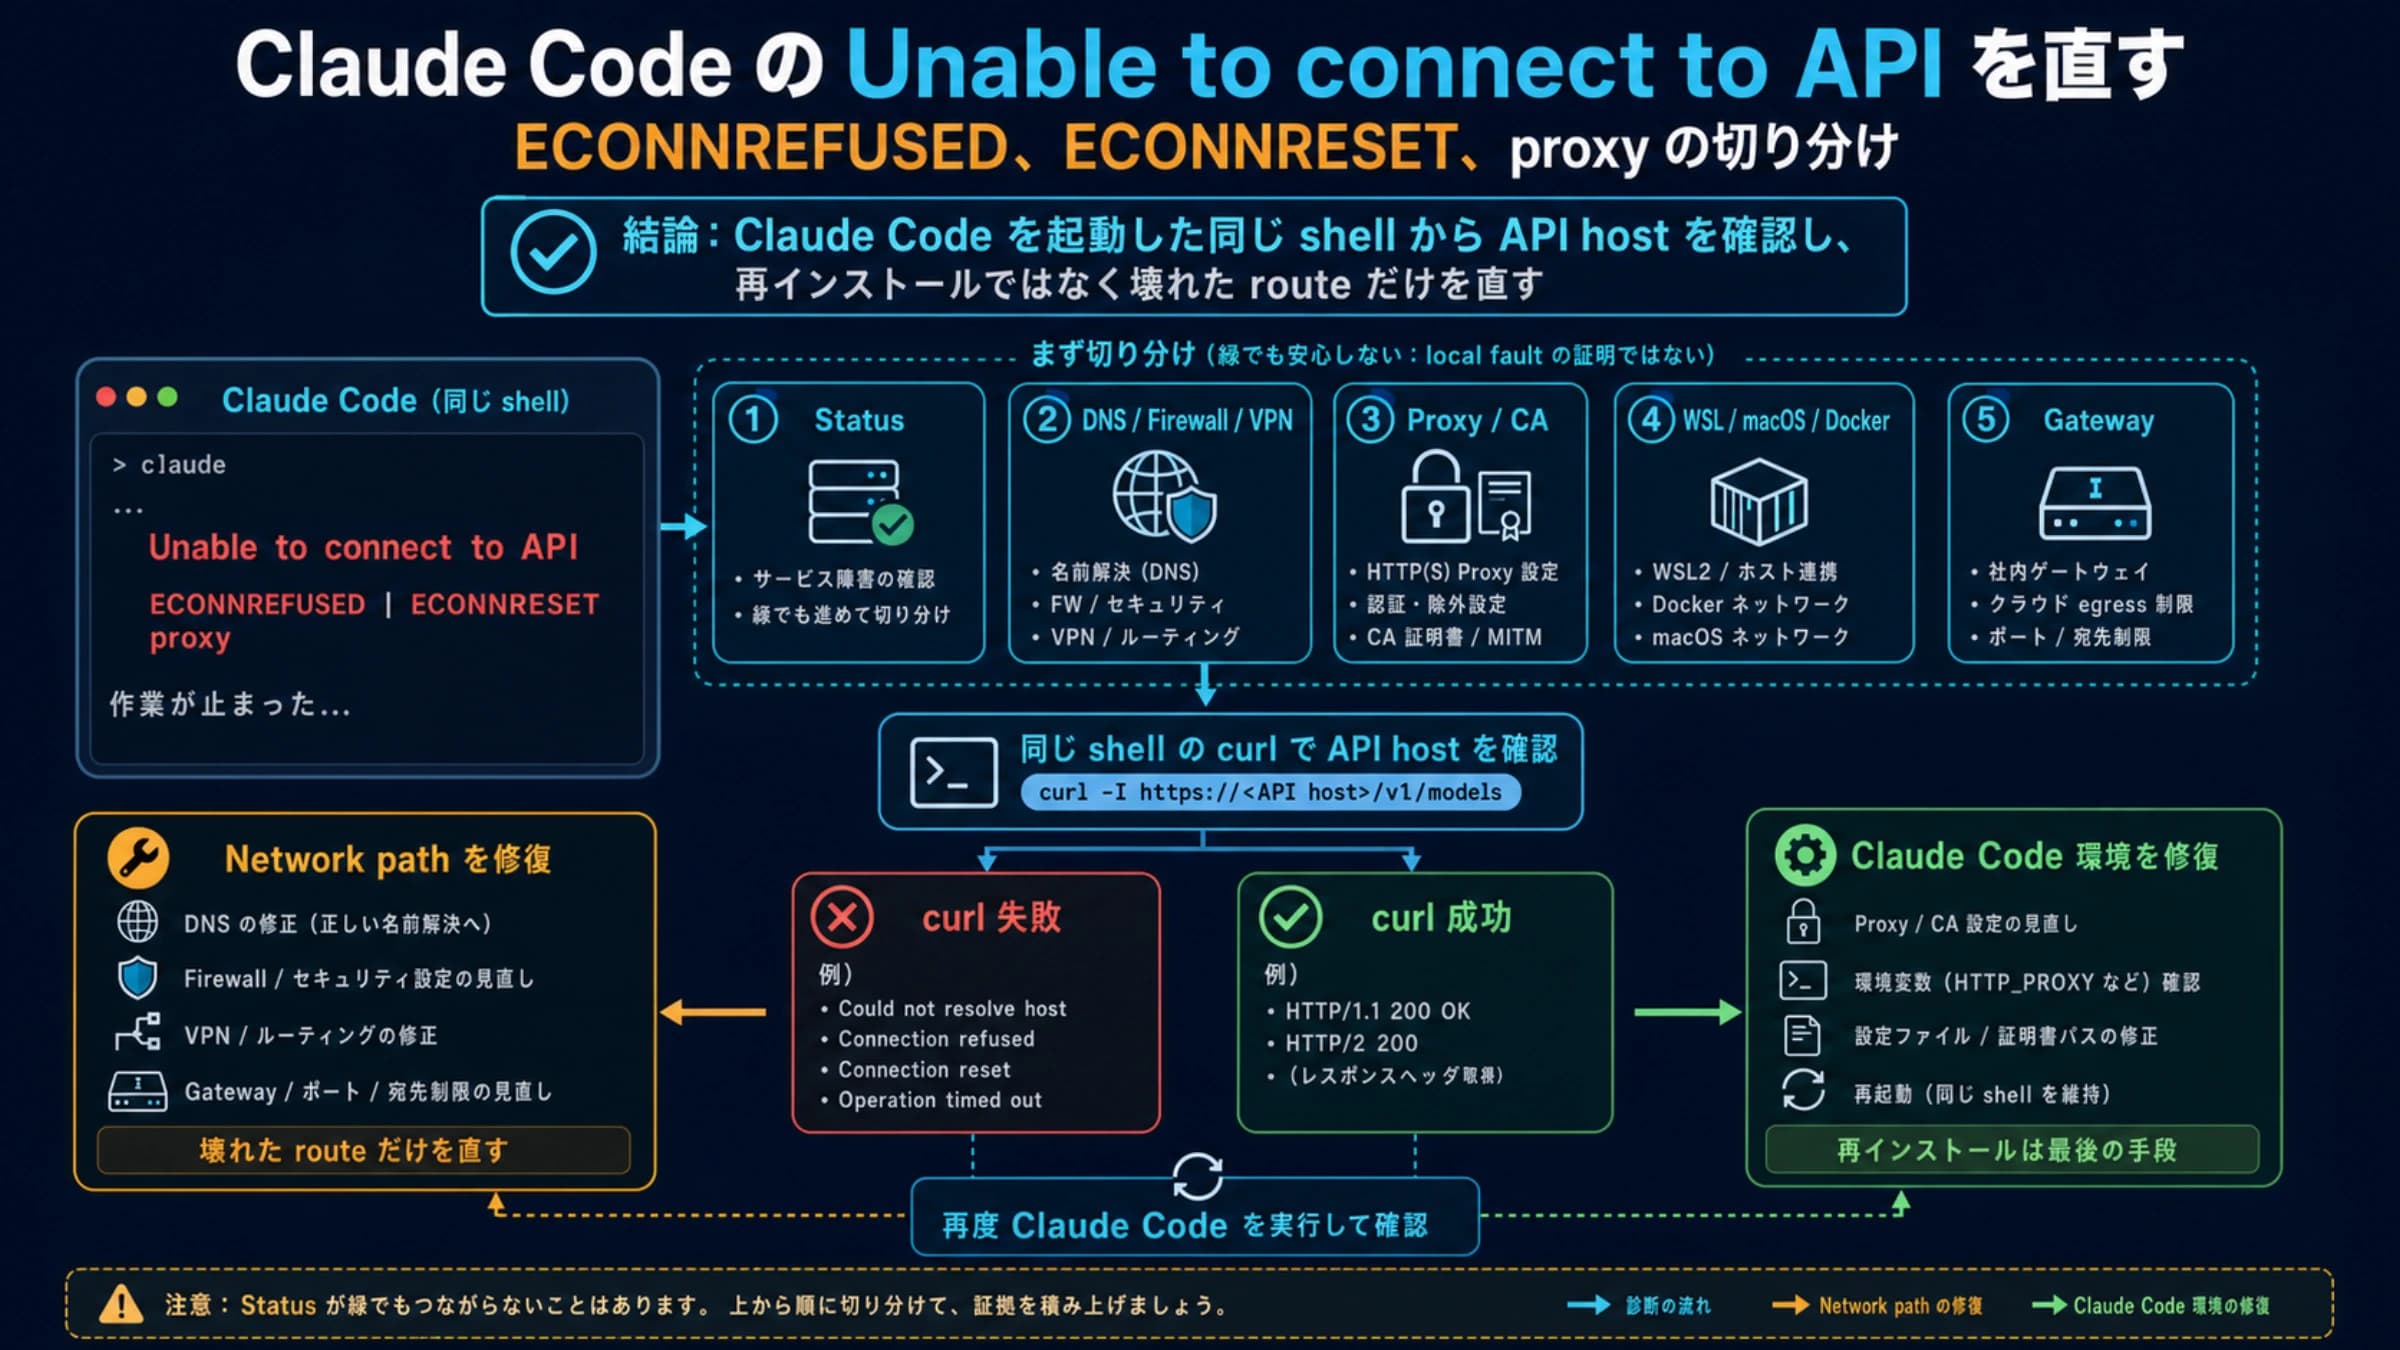
最後の行は、Claudeがテキストやツール呼び出しを1つ以上完成させた後に過負荷や5xxが起きたケースです(v2.1.199以降)。Claude Codeは完成した出力を残し、完成したツール呼び出しは実行してその結果からターンを続けます。自動で再送しないのは、同じツール呼び出しが二重に実行されるおそれがあるためです。続きを指示する前に、どのファイルが変わりどのコマンドが走ったかを確かめてください。手順と、500が繰り返し出る場合の切り分けはClaude Codeの500と529から重複なしで再開する方法にまとめています。Unable to connect to APIが出ている場合は過負荷ではなく接続の問題なので、Claude CodeのUnable to connect to APIの切り分けでネットワークやプロキシを確認します。
今すぐ続けたいとき:/modelで別のモデルに切り替える
公式ドキュメントは、529が続くときの対処として「/modelで別のモデルに切り替える」を挙げています。容量はモデル単位で管理されているため、あるモデルが混雑していても別のモデルは応答できることがあります。特定のモデルに負荷が集中しているときは、Claude Code自身が次のように切り替えを促します(Fable系のモデルではFableと表示されます)。
Opus is experiencing high load, please use /model to switch to SonnetデスクトップアプリのCodeタブやCoworkでは、表示がOpus is experiencing high load. Switch to Sonnet.になり、アプリのモデルピッカーから切り替えます。
ターミナル版で切り替えるときは、保存のされ方に気をつけてください。/modelのピッカーでEnterを押すと、選んだモデルが新しいセッションの既定値として~/.claude/settings.jsonに保存されます。/model sonnetのように名前を直接打った場合も同じです。混雑をしのぐための一時的な切り替えなら、ピッカーで対象の行にカーソルを合わせてsを押してください。このセッションだけが切り替わり、既定値はそのまま残ります。Enterで切り替えた場合は、混雑が収まってから/modelで元のモデルに戻します。
どのモデルが空いているかを事前に知る方法は、公式には用意されていません。手がかりになるのはステータスページのインシデント名です。インシデントのタイトルに今使っているモデルの名前が出ていれば、名前の挙がっていないモデルへ移るのが筋のよい選択です。切り替え先は性能や料金も異なるので、その作業を任せられるモデルかどうかも合わせて判断してください。
次の過負荷で止まらないように:フォールバックチェーンを設定する
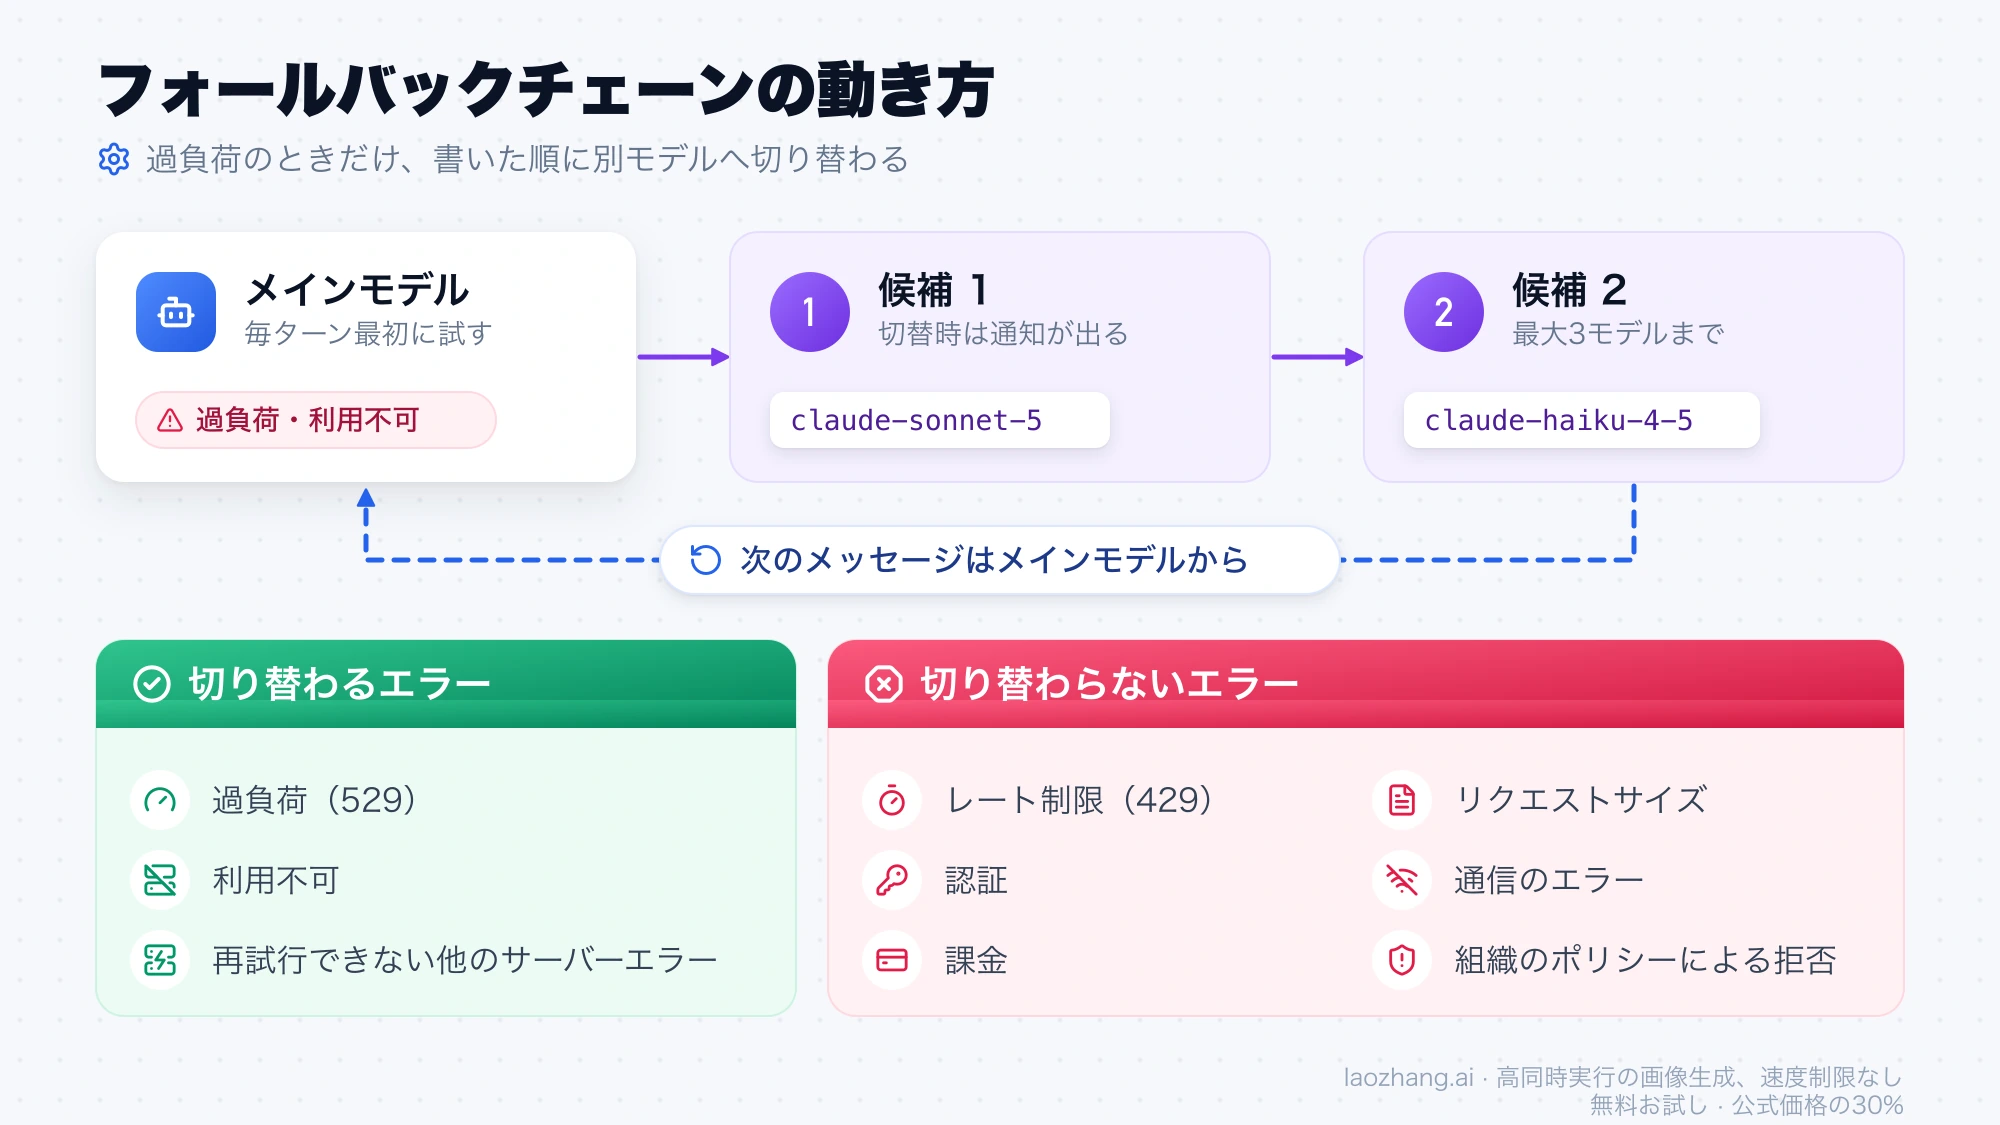
毎回手で/modelを打つ代わりに、メインのモデルが過負荷や利用不可のときに自動で切り替える先を決めておけます。これがフォールバックチェーンです。
そのセッションだけ使うなら、起動時にフラグで指定します。カンマ区切りで複数並べられます。
claude --fallback-model sonnet,haiku常に使うなら、設定ファイル(ユーザー設定は~/.claude/settings.json)に配列で書きます。モデルIDは2026年9月28日時点の公式ドキュメントの例です。
{
  "fallbackModel": ["claude-sonnet-5", "claude-haiku-4-5"]
}
設定する前に、次の挙動を知っておくと戸惑いません。
- 書いた順に試し、切り替わったときは通知が表示されます。
- 切り替えはそのターン限りです。次のメッセージでは、まずメインのモデルが再び試されます。
- 重複を除いて最大3モデルまでで、それ以降のエントリは無視されます。
--fallback-modelフラグがfallbackModel設定より優先されます。各エントリにはモデル名とエイリアスのどちらも使え、"default"は既定のモデルを指します。- 切り替わるのは、過負荷、利用不可、その他の再試行できないサーバーエラーのときだけです。認証、課金、レート制限(429)、リクエストサイズ、通信のエラー、組織のポリシーチェックによる拒否では切り替わりません。
- 起動時に設定の確認は表示されず、
/statusにも出ません。実際に切り替わったときの通知が、設定が効いていると分かる最初の手がかりです。 - 管理者が
availableModelsで許可モデルを絞っている場合、許可外のエントリは除外されます。 - 会話の圧縮(コンパクション)中は、メインよりコンテキストウィンドウが小さいモデルには切り替わりません。候補がすべて小さい場合は元のエラーが表示されるので、送り直してください。
- サブエージェントにも同じチェーンが適用されます(v2.1.247以降)。サブエージェントが切り替わっても、セッション本体のモデルは変わりません。
APIキーやクラウド経由の従量課金では、切り替わったターンはフォールバック先のモデルで処理されます。候補に入れるモデルの料金も、あらかじめコンソールで確認しておくと安心です。
CIやスクリプトでは、待たせるか早く失敗させるかを決める
対話で使う分には既定の10回で十分なことが多いものの、無人実行ではジョブの設計に合わせて再試行の方針を決めておく必要があります。
過負荷が解けるまで待たせたいなら、CLAUDE_CODE_RETRY_WATCHDOG=1を設定します。429と529の容量エラーを、CLAUDE_CODE_MAX_RETRIESの回数で打ち切らずに無期限で再試行し続けます。
export CLAUDE_CODE_RETRY_WATCHDOG=1
claude -p "テストを実行し、失敗したテストを修正してください"
この設定にはいくつか付随する挙動があります。
- v2.1.239以降は、支出上限や使用量クレジットの枯渇を示す429では待たずにすぐ失敗します。待っても解消しない種類のエラーだからです。
- v2.1.199以降は、サーバーエラー、タイムアウト、接続断など他の一時的なエラーの再試行回数の既定値も300回(バックオフ込みで約3時間)に上がり、
CLAUDE_CODE_MAX_RETRIESの上限15回も外れます。 - 無期限に待つので、実質的な上限はCI側のジョブタイムアウトになります。ジョブ側で上限時間を設定しておいてください。
逆に、失敗を早く検知して別の処理に回したいなら、CLAUDE_CODE_MAX_RETRIESを下げます。既定値は10回で、v2.1.186以降は15回が上限です。
export CLAUDE_CODE_MAX_RETRIES=3
claude -p "テストを実行し、失敗したテストを修正してください"無人実行ではどの認証情報が使われるかにも注意してください。-p(非対話モード)では、ANTHROPIC_API_KEYが設定されていれば常にそのAPIキーが使われます。そのジョブで出た429はそのキーのレート制限で、確認すべきステータスや上限もAPIキー側のものになります。
どのステータスページを見るか
見るべき場所は、メッセージの末尾に書かれています。529のメッセージの最後の一文は、使っている経路によって変わります。
- Anthropic API(サブスクリプションまたはAnthropicのAPIキー):status.claude.com
- Amazon Bedrock、Google CloudのAgent Platform、Microsoft Foundry:メッセージに、そのクラウドのサービスステータスが示されます
ANTHROPIC_BASE_URLでゲートウェイやプロキシを経由している場合:メッセージにゲートウェイのホスト名が出ます。まずそのゲートウェイの運営元の状況を確認してください
v2.1.198以降は、再試行中にエラーの種類が529と判明した時点で、カウントダウンの下にも同じ確認先が表示されます。
自分がどの経路にいるか自信がないときは、/statusで有効な認証情報を確認します。ANTHROPIC_API_KEYが設定されていると、ログイン済みでもPro、Max、Team、Enterpriseのサブスクリプションではなくそのキーが使われます(対話モードでは最初に一度だけ承認を求められます)。サブスクリプションで使いたい場合はunset ANTHROPIC_API_KEYで外します。
status.claude.comを読むときのポイントは、モデル単位の項目がないことです。2026年9月28日時点の項目はclaude.ai、Claude Console、Claude API、Claude Code、Claude Cowork、Claude for Governmentの6つで、モデル名はインシデントのタイトルに出てきます。たとえば2026年9月には次のようなインシデントが掲載されました。
- 9月2〜3日:Elevated errors for Claude Sonnet 5
- 9月15日:Intermittent error spikes for Claude Mythos 5.1 and Claude Fable 5.1
- 9月22日:Elevated errors for multiple models
タイトルに自分のモデルが挙がっていれば、待つか、挙がっていないモデルに切り替えます。一方、すべて正常と表示されていても529が出ることはあります。529は瞬間的な容量の問題なので、インシデントとして掲載されない短い混雑でも起こりえます。緑の表示を理由に自分の環境を疑う必要はありませんし、逆に1回の529だけで「障害中」と決めつけることもできません。
手を止めて報告する目安
529は全利用者に共通する容量の問題で、あなたのプロンプトや設定、アカウントの上限が原因ではありません。再インストールや再ログイン、設定の大きな変更で直るものではないので、そうした作業に時間を使う必要はありません。
判断の目安は次のとおりです。
- ステータスに自分のモデルや経路のインシデントが出ている:待つか、別のモデルで作業を続けます。報告は不要です。
- インシデントは出ていないのに、数分おいても同じモデルで529が続く:
/modelで別のモデルを試します。 - 別のモデルでも続き、インシデントも出ていない:ここで手を止めて報告します。ゲートウェイ経由なら、先にゲートウェイの運営元に問い合わせます。
報告はClaude Code内で/feedbackを実行するのが最短です。会話の記録と説明がAnthropicに送られ、内容を埋めたGitHub Issueを開くこともできます。Amazon Bedrock、Google CloudのAgent Platform、Microsoft Foundryなどのサードパーティ経由では、送信の代わりにローカルにアーカイブが保存されるので、それをAnthropicのアカウント担当者に送ります。インストール自体の状態を確かめたい場合は、シェルでclaude doctor(読み取り専用の診断)、Claude Code内で/doctorを実行します。GitHubの既存Issueに同じ症状が上がっていないかも確認してください。
報告には次の情報を添えると、調査が早く進みます。
- 末尾の一文まで含めたエラーメッセージの全文
- 発生した日時とタイムゾーン
- 529が出たモデルと、切り替えて試したモデル
/statusで確認した認証情報と経路(サブスクリプション、APIキー、クラウド、ゲートウェイ)claude --versionで確認したバージョン- その時点のステータスページの表示
よくある質問
ステータスページが正常なのに529が出るのはなぜですか
529は、そのモデルの処理能力が全利用者ぶん一時的に埋まったことを示します。短い混雑はインシデントとして掲載されないことがあり、ステータスページにはモデル単位の項目もありません。緑の表示は「大きな障害は起きていない」という意味で、特定のモデルがその瞬間に混んでいないことまでは保証しません。数分待つか、/modelで別のモデルに切り替えてください。
どのくらい待てば直りますか
公式ドキュメントに復旧までの目安時間は示されていません。案内されているのは「数分後に再試行する」ことだけです。インシデントが掲載されていれば、ステータスページの更新が目安になります。待てない作業なら、待つより別のモデルに切り替えるほうが確実です。
自分のアプリからClaude APIを呼んでいて529が出た場合も同じ対処ですか
エラーの意味は同じで、529はoverloaded_error、つまり全利用者のトラフィック増加によるAPIの一時的な過負荷です。ただし、再試行の仕組みはClaude Codeと異なります。公式SDKは5xxなどの一時的なエラーを既定で2回、指数バックオフで再試行し、max_retriesなどで回数を変えられます。また、組織の利用量を急に増やした場合は、529ではなく429(急増に対する制限)が返ることがあります。アプリ側での分岐と再試行の組み方はClaude APIの529 overloaded_errorの直し方で解説しています。
参考資料4
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年9月28日。
参考資料4
本文で参照している外部ページを、登場順に並べています。最終更新日:2026年9月28日。