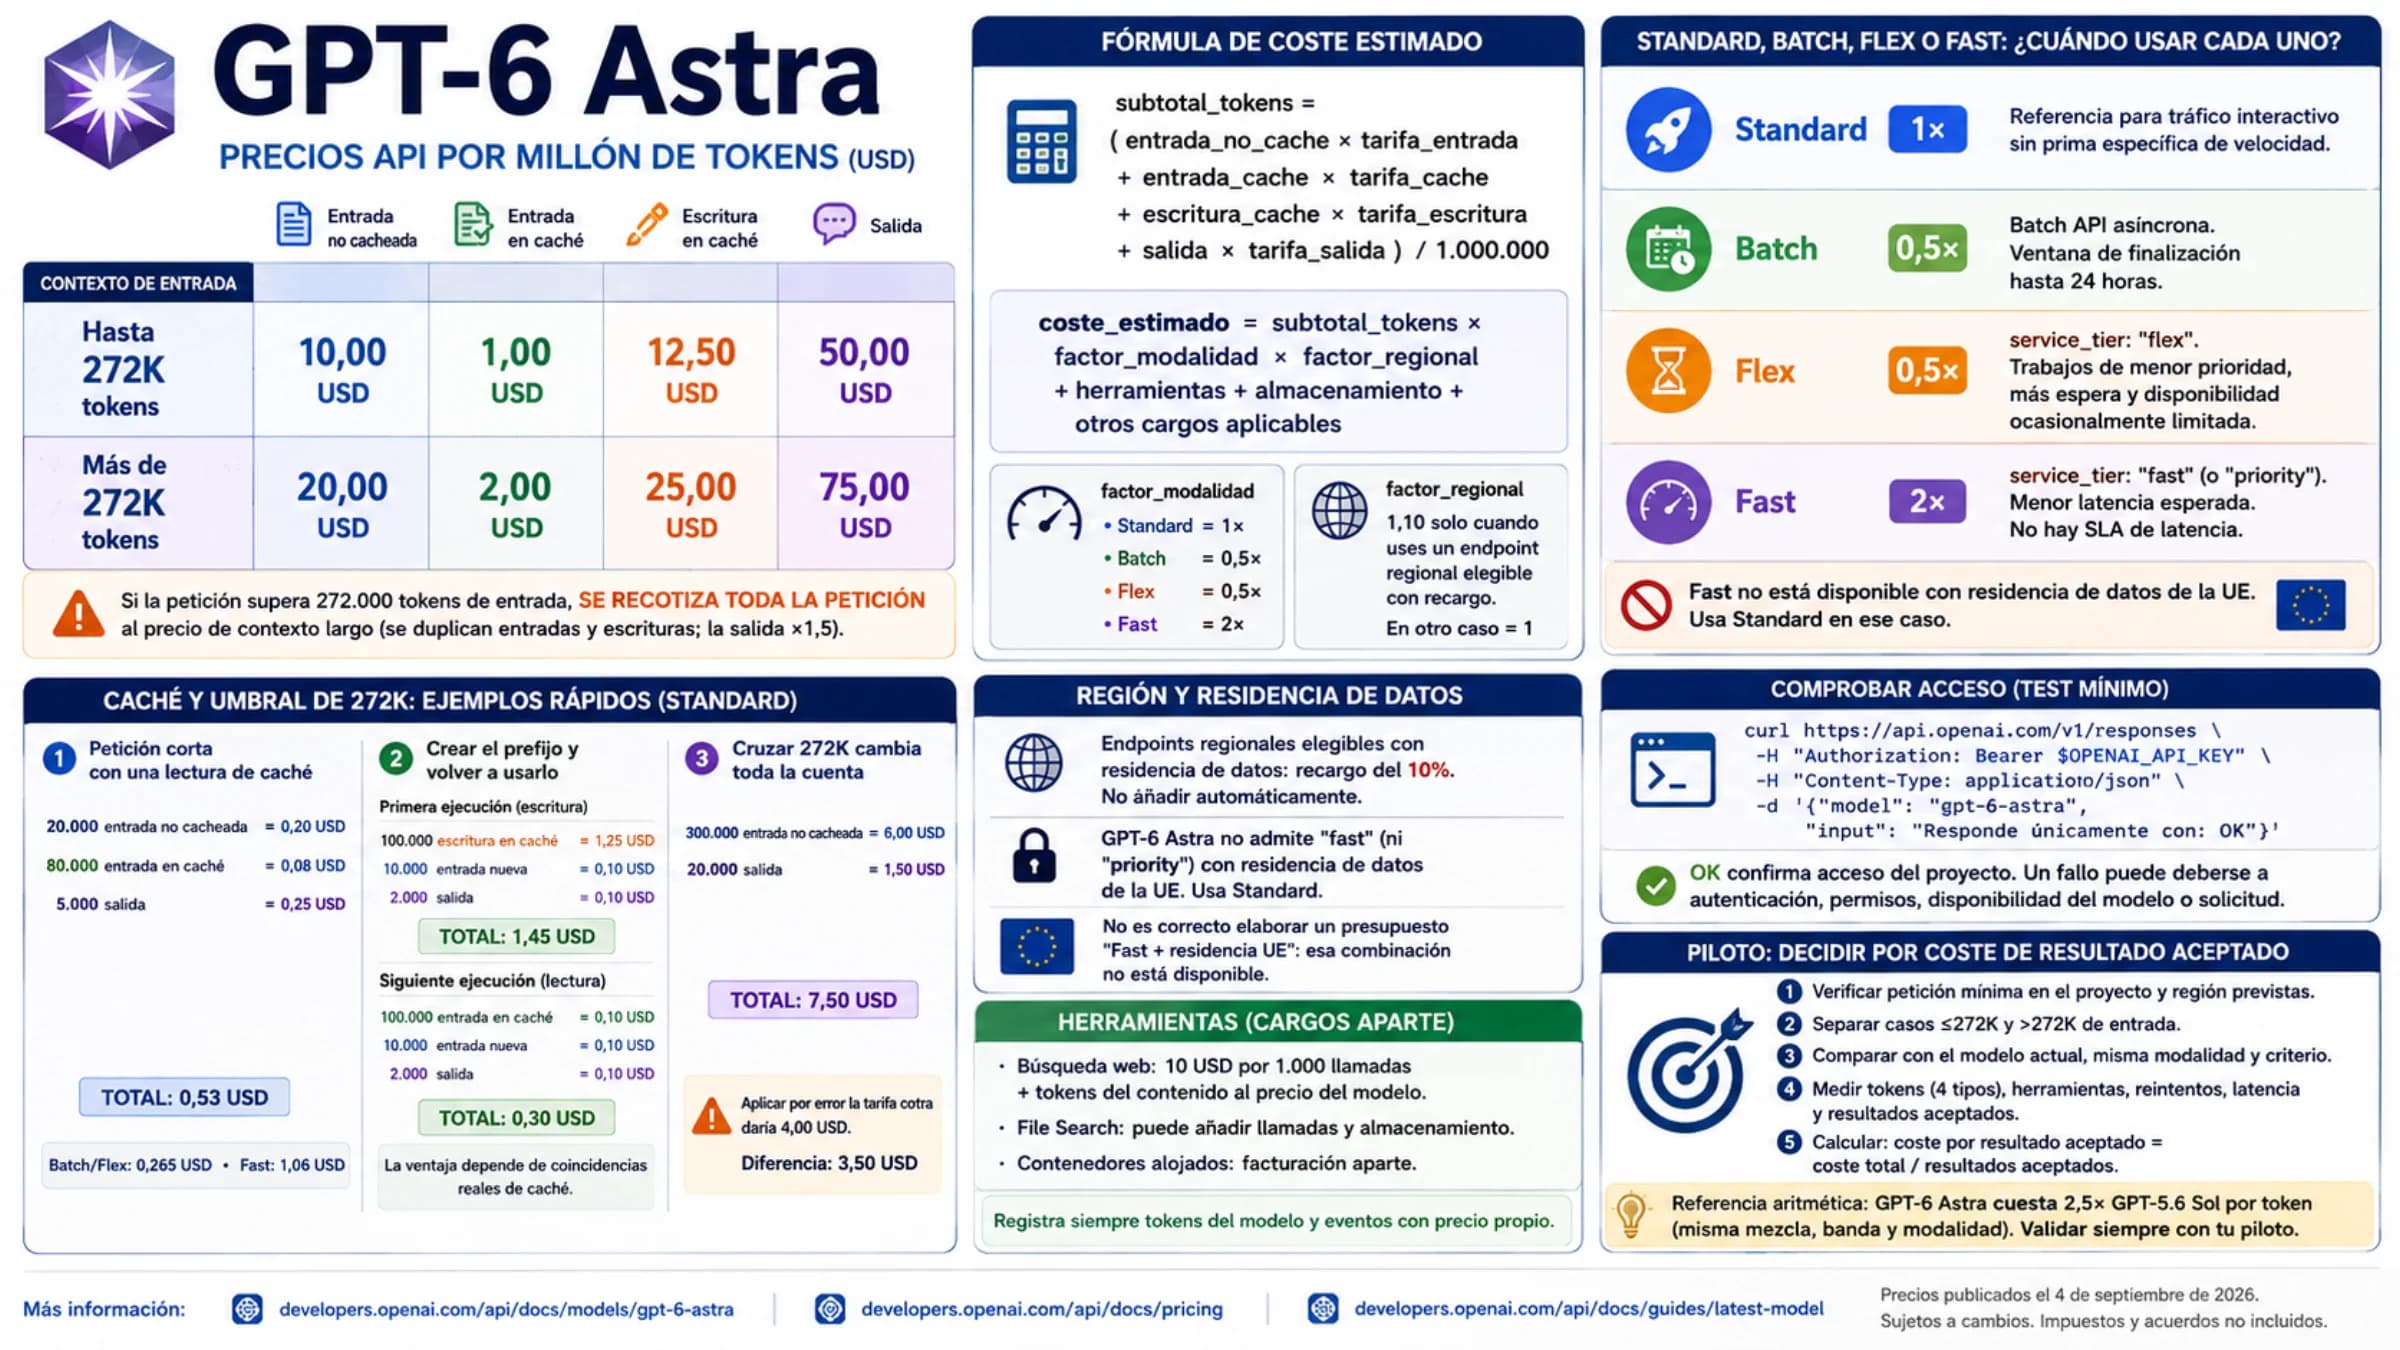
Realtime API o transcripción: cómo calcular el coste de tu aplicación de voz
Para elegir una ruta de voz, compara el coste por tarea completada. Realtime mini puede costar menos que una cadena completa; GPT-Live añade tiempo activo y trabajo del backend, y una transcripción solo sustituye a un asistente hablado si entrega lo que tu producto necesita.
En esta página
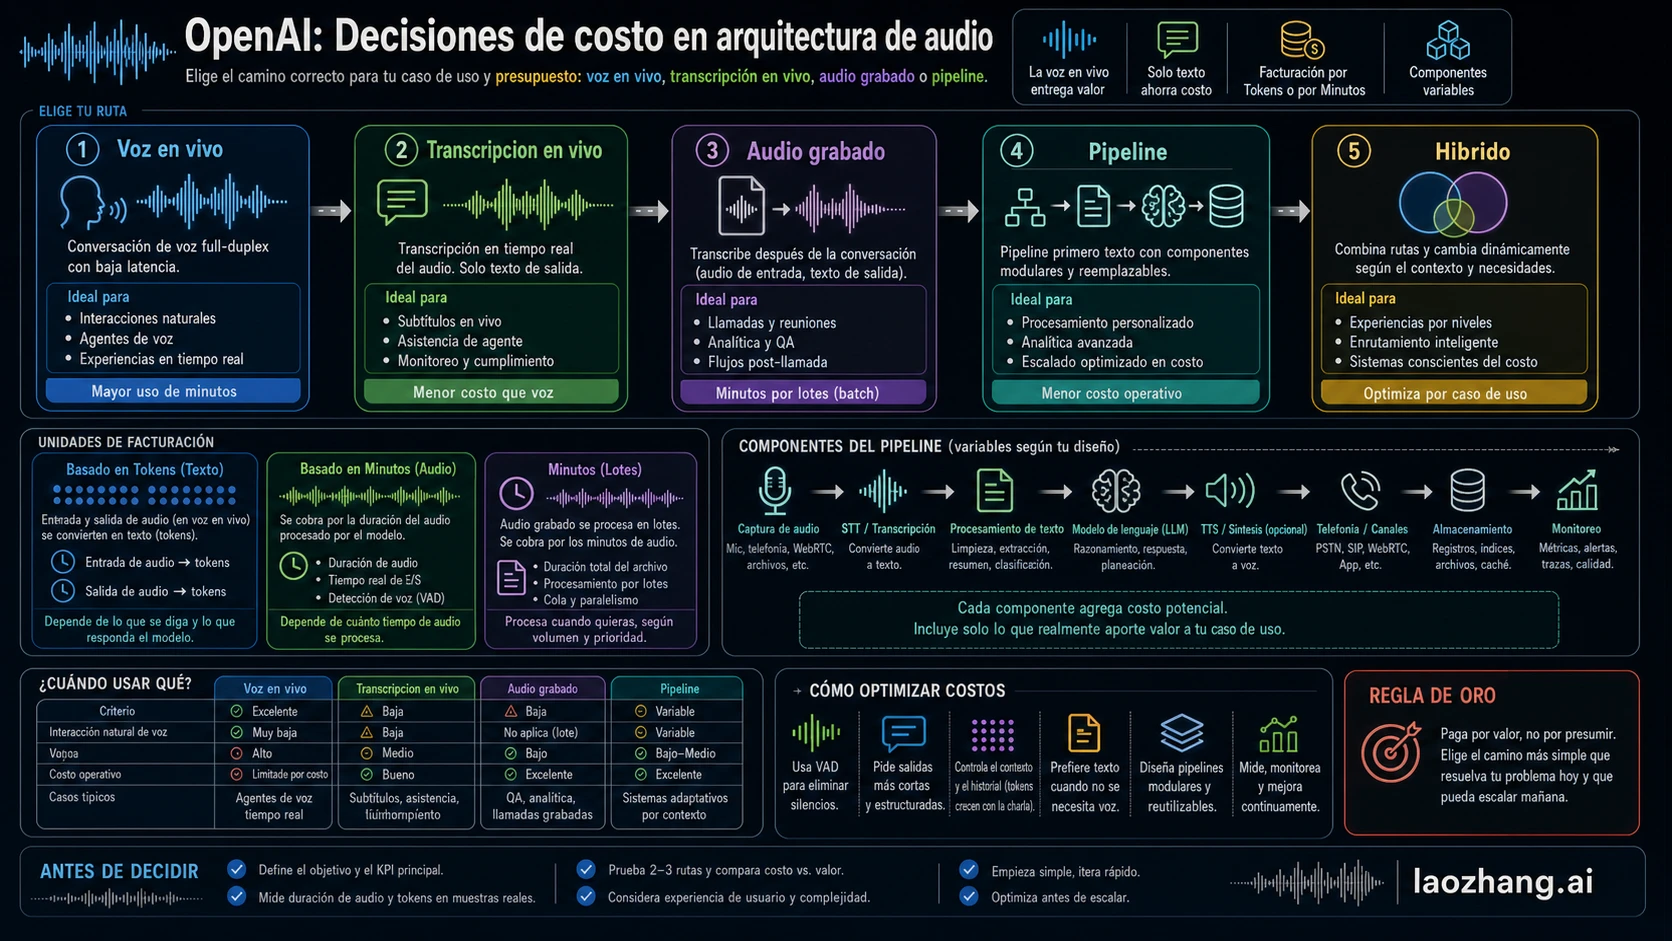
Si necesitas un asistente que responda hablando, presupuesta tanto Realtime como la cadena completa STT → modelo de texto → TTS. Si solo necesitas una transcripción, empieza por la ruta de transcripción adecuada. Comparar el precio de un asistente hablado con el de convertir audio en texto deja fuera buena parte del trabajo y puede llevarte a elegir mal.
Tampoco existe una regla por la que la cadena sea siempre más barata. Con las tarifas consultadas el 6 de octubre de 2026, gpt-realtime-2.1-mini reduce mucho el coste de audio frente a gpt-realtime-2.1 y gpt-realtime-2. Por su parte, GPT-Live cobra la duración activa de la sesión, además de los modelos y herramientas del backend. Son formas distintas de medir el consumo: necesitas una hoja que las mantenga separadas y termine en coste por tarea completada, no solo en coste por minuto.
Qué ruta comparar según el resultado que necesitas
Define primero una tarea que puedas dar por terminada: transcribir una reunión, responder una consulta por voz, tramitar un cambio de cita o generar un resumen revisable. Después decide si el resultado debe llegar mientras entra el audio, al acabar la grabación o durante una conversación con respuestas habladas.
| Resultado del producto | Ruta inicial que conviene presupuestar | Qué debes añadir para compararla |
|---|---|---|
| Texto mientras alguien habla | Transcripción en directo con gpt-live-transcribe | Procesamiento posterior y operación, si los necesitas; no incluye un asistente que hable |
| Transcripción de una grabación | Transcripción de archivo con gpt-transcribe | Resumen, extracción, revisión o almacenamiento cuando formen parte del resultado |
| Conversación con respuestas de voz | Realtime de audio a audio y cadena STT → modelo de texto → TTS | Las mismas herramientas, requisitos de respuesta y tareas completadas |
| Voz conectada a un backend que razona y ejecuta herramientas | GPT-Live, junto a las alternativas anteriores | Duración activa de voz más todo el trabajo del backend |
| Ayuda por voz seguida de archivo o análisis | Diseño híbrido | Separar la interacción hablada y el trabajo posterior, evitando procesar dos veces el mismo audio sin necesidad |
Los modelos de partida para transcripción proceden de la guía actual de OpenAI. La recomendación depende del flujo, no demuestra que un modelo sea el más preciso para cualquier acento o grabación. Una transcripción de archivo también puede devolver texto de forma incremental mientras procesa la grabación: recibir texto por partes no exige por sí solo una sesión Realtime.
Para comparar dos asistentes de voz, fija además qué respuestas son aceptables, qué ocurre cuando el usuario interrumpe, qué herramientas deben ejecutar y cuándo consideras resuelta la tarea. Reducir el precio quitando una función necesaria cambia el producto que estás presupuestando.
Tarifas que debes introducir en la hoja
Estos importes son tarifas de la API de OpenAI en USD, consultadas el 6 de octubre de 2026. No son precios de una plataforma de telefonía ni una cuota de ChatGPT. Usa las condiciones aplicables a tu cuenta, región y proveedor para añadir impuestos, recargos u otros servicios. La fuente para todas las filas de esta sección es la página oficial de precios.
Realtime: audio, texto e imágenes se cuentan por separado
| Modelo y modalidad | Entrada sin caché, USD por millón de tokens | Entrada en caché, USD por millón de tokens | Salida, USD por millón de tokens |
|---|---|---|---|
gpt-realtime-2.1 y gpt-realtime-2, audio | 32 | 0,40 | 64 |
gpt-realtime-2.1 y gpt-realtime-2, texto | 4 | 0,40 | 24 |
gpt-realtime-2.1 y gpt-realtime-2, imagen | 5 | 0,50 | — |
gpt-realtime-2.1-mini, audio | 10 | 0,30 | 20 |
gpt-realtime-2.1-mini, texto | 0,60 | 0,06 | 2,40 |
gpt-realtime-2.1-mini, imagen | 0,80 | 0,08 | — |
La fila de gpt-realtime-2 sigue siendo útil si tu integración utiliza ese modelo. Su tarifa no convierte automáticamente una migración a 2.1 o mini en un cambio equivalente de calidad. Compara cada configuración con las tareas de tu aplicación.
Transcripción, síntesis de voz y GPT-Live
| Componente | Tarifa publicada | Cómo llevarla al presupuesto |
|---|---|---|
gpt-live-transcribe | 0,017 USD por minuto de audio | Duración del audio facturable en directo × tarifa |
gpt-realtime-whisper | 0,017 USD por minuto de audio | Ruta existente de transcripción en directo; no es el modelo inicial recomendado para una nueva integración |
gpt-transcribe | 0,0045 USD por minuto de audio | Duración del audio enviado × tarifa |
gpt-4o-transcribe y gpt-4o-transcribe-diarize | 2,50 USD por millón de tokens de entrada y 10 USD de salida; estimación de 0,006 USD por minuto | Calcular con los tokens; el importe por minuto es una estimación |
gpt-4o-mini-transcribe | 1,25 USD por millón de tokens de entrada y 5 USD de salida; estimación de 0,003 USD por minuto | Calcular con los tokens; no tratar la estimación como una tarifa fija por duración |
gpt-4o-mini-tts | 0,60 USD por millón de tokens de texto de entrada y 12 USD por millón de tokens de audio de salida | Sumar las dos modalidades con sus contadores reales |
tts-1 / tts-1-hd | 15 / 30 USD por millón de caracteres | Contar caracteres enviados; no asumir un número fijo de minutos hablados |
gpt-live-1 | 0,05 USD por minuto de sesión activa, facturado por segundos | Segundos activos ÷ 60 × tarifa, más backend y herramientas |
Para una nueva integración, no elijas modelos antiguos únicamente porque su fila estimada por minuto sea menor. OpenAI ha anunciado la retirada de whisper-1, gpt-4o-transcribe, gpt-4o-mini-transcribe y gpt-4o-transcribe-diarize el 26 de febrero de 2027. tts-1, tts-1-hd y las versiones gpt-4o-mini-tts-2025-03-20 y gpt-4o-mini-tts-2025-12-15 tienen retirada prevista el 6 de enero de 2027. Son fechas futuras, no una afirmación de que hoy estén apagados; revisa los modelos exactos en los avisos de retirada.
Diez minutos de llamada no son diez minutos de cada canal
En una llamada de diez minutos, el usuario podría hablar cuatro, el asistente tres y el resto dedicarse a pausas o esperas. En Realtime, para una primera aproximación al audio nuevo, cuentan por separado los cuatro minutos de entrada y los tres de salida. En GPT-Live, una sesión activa durante los diez minutos incluye también las pausas y la espera del backend.
La guía de costes de Realtime indica un token por cada 100 ms de audio del usuario y uno por cada 50 ms de audio del asistente. Eso permite aproximar 600 tokens por minuto de entrada y 1.200 por minuto de salida. Hay pequeñas variaciones por tokens especiales, y el historial añade consumo en respuestas posteriores.
| Audio nuevo en la llamada de ejemplo | gpt-realtime-2.1 o gpt-realtime-2 | gpt-realtime-2.1-mini |
|---|---|---|
| 4 minutos del usuario: 2.400 tokens | 0,0768 USD | 0,024 USD |
| 3 minutos del asistente: 3.600 tokens | 0,2304 USD | 0,072 USD |
| Total de esos dos componentes | 0,3072 USD | 0,096 USD |
Es un cálculo de audio nuevo sin caché, no el total de la sesión. Faltan texto, historial que vuelva a entrar, herramientas, imágenes si las hay y transcripción de entrada si está activada. Para una cadena STT, los minutos facturables de transcripción también deben salir del audio que realmente envías y de su forma de medición, no de la duración de llamada copiada sin más.
La cifra de 5,76 USD que aparece en presupuestos de gpt-realtime-2 tiene otro supuesto: una hora completa de audio nuevo del usuario cuesta aproximadamente 1,152 USD y una hora de audio generado del asistente, 4,608 USD. Su suma no es el precio de una llamada de una hora, ni un mínimo universal. Con las tarifas de mini, esos mismos dos volúmenes darían 1,80 USD, también antes de los demás componentes. La tarifa oficial y los volúmenes de audio deben mantenerse juntos al reutilizar cualquiera de estas cifras.
Historial y caché: del cálculo inicial al consumo por respuesta
Realtime acumula consumo cuando se crea una respuesta. El contenido anterior de la conversación vuelve a formar parte de la entrada de las respuestas siguientes: contar el audio capturado una sola vez deja fuera esa reentrada. Las instrucciones, los esquemas y resultados de herramientas y las respuestas de texto también pueden aumentar el total.
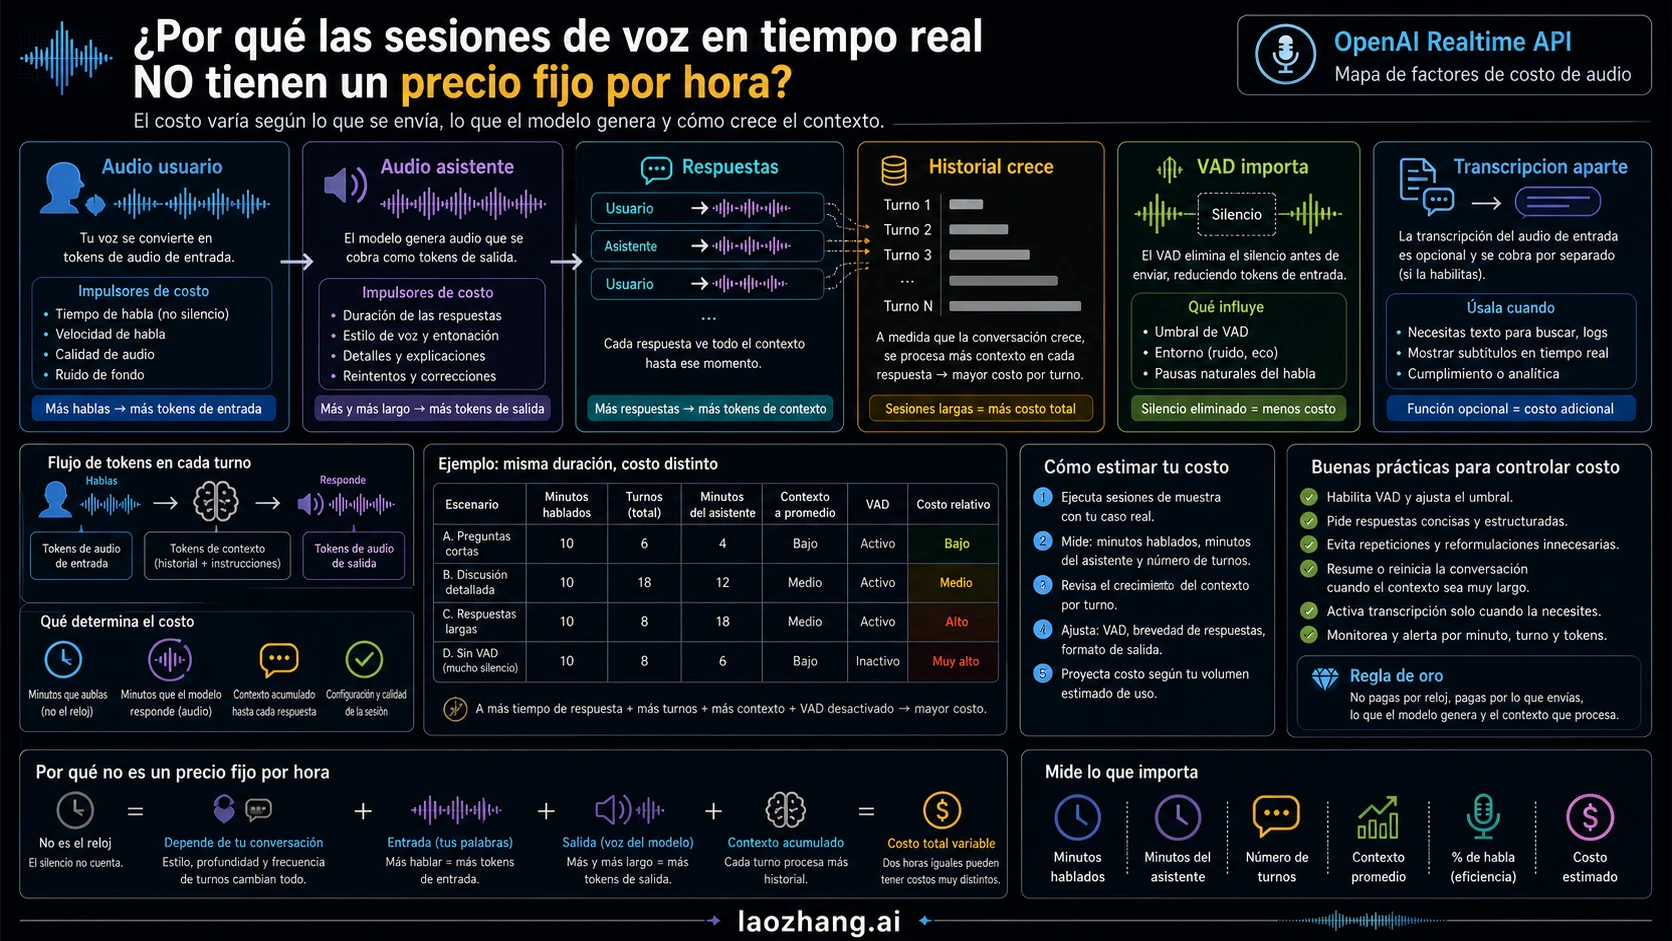
Para calcular una modalidad de entrada, utiliza esta fórmula:
Coste de entrada =
  ((tokens de entrada − tokens en caché) × tarifa de entrada
   + tokens en caché × tarifa de caché) / 1.000.000

Coste de salida = tokens de salida × tarifa de salida / 1.000.000
Los tokens en caché son un subconjunto de los tokens de entrada. No se suman como consumo adicional, ni se resta la caché de audio de los tokens de texto. Por ejemplo, 10.000 tokens de entrada de audio, de los que 8.000 están en caché, cuestan 0,0672 USD con la fila de audio de gpt-realtime-2.1: (2.000 × 32 + 8.000 × 0,40) / 1.000.000.
Según la documentación de consumo por respuesta, response.done.usage desglosa entradas y salidas, y la entrada incluye detalles de caché por modalidad. Suma cada respuesta una vez utilizando su identificador. total_tokens resume el consumo: no es otra línea que debas cobrar además de sus partes.
La caché se aplica cuando coincide la entrada y no está garantizada. Cambiar instrucciones, herramientas o historial puede reducir las coincidencias; truncar la conversación también afecta a la caché. Para prever el gasto, calcula un escenario con la caché observada y otro sin ese ahorro. Recortar o resumir contexto requiere conservar la información necesaria para completar la tarea.
Hay dos líneas que conviene revisar aparte:
- Silencio en Realtime: la detección de actividad de voz puede filtrar audio vacío; este no cuenta como entrada salvo que el cliente lo añada manualmente. La conexión y el ancho de banda no se cobran actualmente por sí mismos en esta ruta. Eso no describe el reloj de GPT-Live.
- Transcripción de entrada: activarla dentro de una conversación Realtime añade el coste de otro modelo. Su consumo se comunica mediante
conversation.item.input_audio_transcription.completed; no está incluido gratis por el hecho de que el asistente entienda audio.
Estas reglas proceden de la guía de costes de voz. Si una respuesta se cancela o una petición acaba en un tiempo de espera agotado, el estado del cliente no demuestra que el proveedor haya dejado de trabajar o que el consumo sea cero.
GPT-Live: el coste de esperar también entra en la cuenta
GPT-Live separa la conversación hablada del backend. El presupuesto de voz utiliza la duración activa de la sesión, incluyendo conversación, silencio y espera del modelo o de una herramienta:
Coste GPT-Live = segundos activos / 60 × 0,05 USD
                + modelos y herramientas del backend
                + otros servicios
La tarifa de 0,05 USD por minuto se factura por segundos, sin redondear al minuto entero, según los precios oficiales. Una sesión de 90 segundos tendría 0,075 USD de voz; si su backend consumiese 0,02 USD, sumarían 0,095 USD antes de otros servicios. El consumo del backend en este ejemplo es un supuesto, no una factura observada.
Para WebRTC, la creación de la sesión factura inicialmente 15 segundos, que se descuentan de la duración cuando la sesión empieza a funcionar. Una sesión de 90 segundos no pasa a ser de 105 segundos por ese inicio. Incluye, en cambio, los intentos de creación y reconexión que correspondan: no asumas que todo intento abandonado resulta gratuito. Silenciar el micrófono no cierra la sesión. La guía de GPT-Live explica ambos tratamientos.
Para registrar el consumo, session.usage.updated informa de segundos acumulados: cada actualización sustituye a la anterior. No sumes 12, 30 y 90 segundos como si fueran tres cargos. Conserva una vez el valor final de session.closed. Registra por separado los modelos y herramientas; para las respuestas delegadas, deduplica sus eventos response.completed por identificador y añade las llamadas que tu aplicación ejecute de manera independiente.
Esto cambia una decisión aparentemente sencilla. Si un backend más rápido encarece el procesamiento en 0,02 USD pero permite terminar y cerrar la sesión un minuto antes, el ahorro de voz sería 0,05 USD y la reducción neta, 0,03 USD. Es una relación aritmética condicionada a que ocurra esa reducción y se complete el mismo trabajo; no una medición de rendimiento. También debes incluir consultas especulativas que se ejecutan aunque su resultado no se utilice.
Una hoja de presupuesto que termina en tareas completadas
Crea una columna por alternativa y utiliza la misma muestra de tareas. En cada columna separa cantidades, tarifas y coste resultante. Así podrás cambiar un modelo o una duración sin esconder el efecto dentro de un único «precio por minuto».
| Fila | Qué introducir | Cómo obtener el importe |
|---|---|---|
| Transcripción | Minutos de audio facturables o tokens, según el modelo | Aplicar la tarifa de duración o las tarifas de entrada y salida |
| Realtime | Tokens por modalidad, entrada en caché y salida de cada respuesta | Aplicar las fórmulas anteriores y sumar respuestas únicas |
| GPT-Live | Segundos activos finales de cada sesión | Segundos ÷ 60 × tarifa; añadir intentos e inicialización según su tratamiento |
| Modelo de texto o backend | Entradas, caché, salidas y llamadas de herramientas | Aplicar las tarifas del modelo y de cada herramienta utilizada |
| Síntesis de voz | Caracteres o tokens de texto y audio, según el TTS | Aplicar su propio contador; no tomar la proporción de tokens de Realtime para otro modelo |
| Transcripción adicional | Audio transcrito dentro de Realtime o procesado después | Añadir solo el trabajo realmente necesario, con su modelo y consumo |
| Telefonía y operación | Transporte, números, almacenamiento, registros, supervisión y revisión humana | Tarifas y cantidades de tu proveedor; dejar una variable cuando no las conozcas |
| Fallos y reintentos | Todos los intentos, incluso los que no entregan un resultado útil | Añadir su consumo; conservar como desconocido lo pendiente de confirmar |
| Resultado final | Número de tareas completadas que cumplen tus criterios | Coste total de todos los intentos ÷ tareas completadas |
El coste de una cadena es STT + modelo de texto + TTS necesario + herramientas + operación. El de Realtime añade a sus tokens los servicios y procesos externos que utilices. El de GPT-Live suma voz activa y backend. No añadas de nuevo una fila que ya hayas incluido dentro de otra: una tarifa de plataforma podría agrupar componentes que tu hoja separa.
Para preparar un presupuesto mensual, usa al menos un volumen habitual y uno de carga alta. Varía el tiempo que habla el asistente, las respuestas por conversación, el historial, las esperas y los reintentos. Divide el gasto de cada escenario por sus tareas completadas y multiplica ese coste por el volumen previsto. Si no sabes cuánto cuesta la revisión humana, conserva esa celda como variable; escribir cero daría una certeza que no tienes.
Ejemplo: una consulta de voz de diez minutos
Retomemos cuatro minutos de audio del usuario y tres del asistente en una sesión de diez minutos. Supongamos que todas las alternativas entregan la misma respuesta aceptable y completan el mismo trámite. Para la cadena, se envían exactamente cuatro minutos facturables a gpt-live-transcribe. Estos son supuestos de presupuesto, no pruebas de calidad, latencia o consumo real:
| Línea por intento | Realtime 2.1 / 2 | Realtime 2.1 mini | STT → texto → TTS | GPT-Live |
|---|---|---|---|---|
| Audio nuevo Realtime | 0,3072 USD | 0,096 USD | — | — |
| Texto e historial Realtime, supuesto | 0,025 USD | 0,012 USD | — | — |
| STT en directo: 4 × 0,017 | — | — | 0,068 USD | — |
| Modelo de texto y herramientas, supuesto | — | — | 0,018 USD | 0,018 USD |
| TTS, supuesto de coste total | — | — | 0,045 USD | — |
| Voz GPT-Live: 10 × 0,05 | — | — | — | 0,50 USD |
| Operación, supuesto común | 0,01 USD | 0,01 USD | 0,01 USD | 0,01 USD |
| Total por intento | 0,3422 USD | 0,118 USD | 0,141 USD | 0,528 USD |
Las filas tarifadas usan los precios oficiales; las demás son cantidades elegidas para mostrar cómo funciona la hoja. En este caso no hay imágenes ni transcripción adicional dentro de Realtime. El supuesto de texto e historial tendría que sustituirse por el desglose real de respuestas y caché. El importe de TTS también tendría que salir de los contadores de la ruta elegida: no lo hemos convertido desde tres minutos de voz usando una equivalencia universal.
Aquí mini cuesta menos que la cadena, mientras que el modelo Realtime de mayor tamaño cuesta más. GPT-Live suma los diez minutos activos, aunque la conversación tenga solo siete de habla. El orden cambiará si cambian las cantidades, los servicios necesarios o los resultados aceptables. La tabla sirve para sustituir supuestos, no para declarar un ganador para todas las aplicaciones.
Ahora lleva la hoja a tareas completadas. Si cada alternativa acumulara 100 intentos al coste indicado y solo 95 completaran la tarea, el coste por tarea sería el gasto de los 100 intentos dividido por 95:
| Alternativa | Coste por tarea completada con ese supuesto |
|---|---|
| Realtime 2.1 / 2 | 0,3602 USD |
| Realtime 2.1 mini | 0,1242 USD |
| Cadena STT → texto → TTS | 0,1484 USD |
| GPT-Live | 0,5558 USD |
El 95 % es común e hipotético, no una tasa de éxito de esos modelos. En tu comparación, usa el número de tareas aceptables de cada alternativa, incluyendo el gasto de todos sus intentos. Si una configuración necesita más correcciones o intervención humana, la diferencia puede absorber su ahorro en tokens.
Ejemplo: una grabación de una hora que solo necesita texto
Para 60 minutos facturables, gpt-transcribe daría 0,27 USD de transcripción y gpt-live-transcribe, 1,02 USD, con las tarifas consultadas. La diferencia de 0,75 USD tiene sentido para elegir archivo cuando el producto admite esperar a disponer de la grabación. No demuestra que las rutas entreguen texto a la misma velocidad ni con la misma calidad.
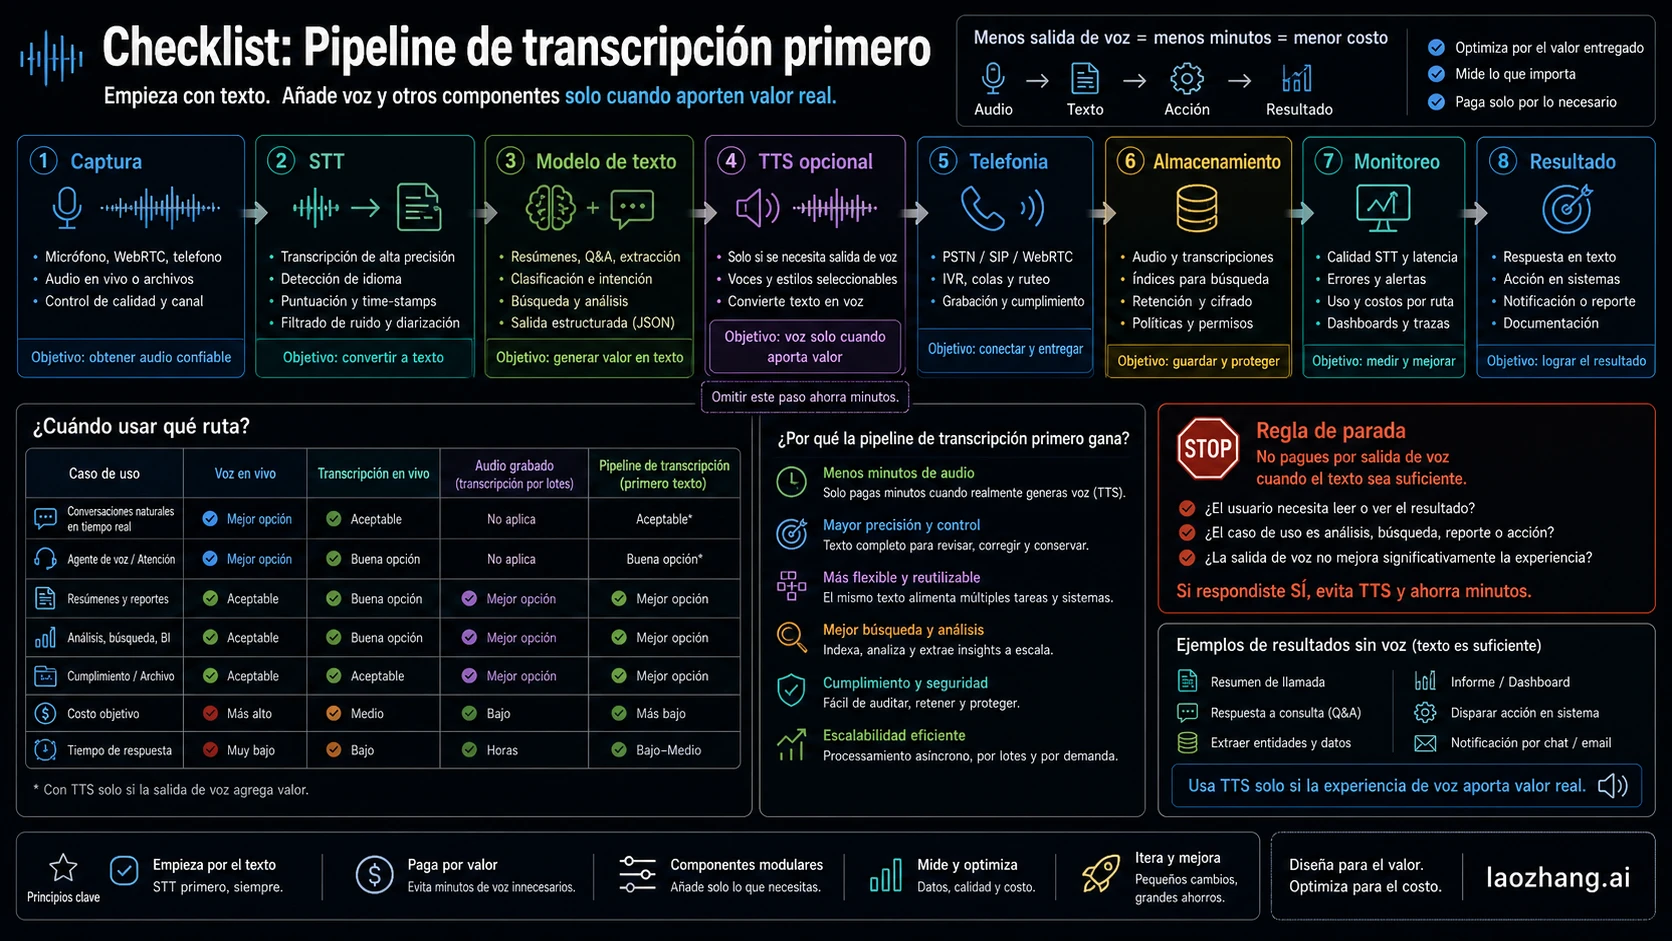
Si el resultado incluye resumen, añade el modelo de texto a ambas columnas. Si incluye identificación de hablantes o subtítulos con tiempos por palabra, comprueba la capacidad específica antes de usar la fila más barata: la guía de transcripción distingue estas necesidades. No añadas TTS cuando el resultado que se entrega sigue siendo texto.
Cómo tomar la decisión y aprovechar un diseño híbrido
Para archivos, resúmenes y análisis posterior, empieza por transcripción y añade solo el procesamiento necesario. Para texto que debe llegar durante una llamada, evalúa transcripción en directo. Para una respuesta hablada, compara Realtime y una cadena con TTS; incluye GPT-Live cuando quieras separar la conversación de un backend que ejecuta el trabajo.
Antes de escoger por precio, descarta las alternativas que no cumplen tu criterio de respuesta. Después compara coste por tarea completada, tiempo hasta la respuesta útil, interrupciones y necesidad de revisión o transferencia a una persona. Esta página calcula tarifas y escenarios; no contiene una prueba comparativa de calidad o latencia.
Un diseño híbrido puede resolver la frontera entre conversación y trabajo posterior. Por ejemplo, un asistente tramita una solicitud por voz, cierra la parte hablada y prepara después las notas o el informe con un modelo de texto. No necesitas mantener la voz activa mientras produces un documento que el usuario leerá más tarde. En GPT-Live, cerrar la sesión puede reducir tiempo activo; compara también el coste y la fricción de reanudarla.
Para el archivo posterior, aprovecha una transcripción que ya cumpla tu necesidad de conservación, si existe y puedes usarla. Si necesitas transcribir la grabación otra vez, añade ese coste. El híbrido no ahorra por su nombre: ahorra cuando elimina trabajo o tiempo activo que no aporta al resultado.
Cuando tengas tarifas, cantidades y márgenes, puedes pasar al control del presupuesto de un agente mediante un límite de gasto. Ese control necesita tratar los cargos todavía desconocidos y los reintentos; una estimación barata no impide por sí sola que el gasto se dispare.
Preguntas frecuentes
¿Un pipeline STT → LLM → TTS siempre cuesta menos que Realtime?
No. Debes sumar transcripción, modelo de texto, síntesis de voz y operación. gpt-realtime-2.1-mini tiene tarifas de audio inferiores a las de Realtime 2.1 y 2; con ciertos volúmenes puede costar menos que la cadena completa. La comparación requiere completar el mismo trabajo con una calidad aceptable, no solo contrastar las tarifas oficiales.
¿Cuánto cuesta una hora de Realtime API?
No hay una tarifa única por hora de llamada para una conversación Realtime de audio a audio. Cuenta entradas, salidas, caché, historial y servicios adicionales. Los 5,76 USD corresponden aproximadamente a una hora de audio nuevo del usuario más otra de audio del asistente con las tarifas de Realtime 2.1 o 2, antes de los demás componentes. No equivalen a una llamada de una hora; el cálculo combina las tarifas y la conversión de audio a tokens.
¿Se cobra el silencio de una sesión de voz?
Depende de la ruta. En Realtime, la detección de actividad de voz filtra audio vacío salvo que el cliente lo añada manualmente como entrada. En GPT-Live, el tiempo activo incluye silencio y espera del backend. Silenciar el micrófono no cierra esa sesión. Son reglas distintas descritas en la guía de costes de voz.
¿Necesito Realtime para recibir una transcripción por partes?
No si el audio ya está grabado. La transcripción de archivo puede entregar texto incremental durante el procesamiento. Si el audio llega en directo y necesitas texto a medida que se habla, el modelo inicial recomendado es gpt-live-transcribe, según la guía de flujos de transcripción. Ninguna de estas dos rutas incluye por sí sola una respuesta hablada del asistente.
¿La transcripción está incluida en una conversación Realtime?
La transcripción de entrada opcional se factura aparte con otro modelo. Incluye su consumo si la activas; no la confundas con los tokens de audio que utiliza el asistente para responder. La documentación de costes de transcripción de entrada explica cómo se comunica ese consumo.
¿Qué dato importa más para fijar el precio de mi producto?
El coste por tarea que cumple tus criterios de aceptación. Suma el gasto de intentos correctos, fallidos y repetidos, incluidos herramientas, voz, revisión y operación, y divídelo por las tareas completadas. Mantén también el tiempo de respuesta y la tasa de resolución: reducir gasto dejando más trabajo sin terminar no mejora el presupuesto del mismo servicio.
Fuentes4
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 7 oct 2026.
Fuentes4
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 7 oct 2026.