Error 429 en OpenAI API: cómo identificar la causa y recuperar el servicio
Un error 429 de OpenAI API puede exigir reducir el tráfico o resolver un bloqueo de facturación. El cuerpo del error indica por dónde empezar; las cabeceras ayudan a decidir cuándo volver a intentarlo.
En esta página
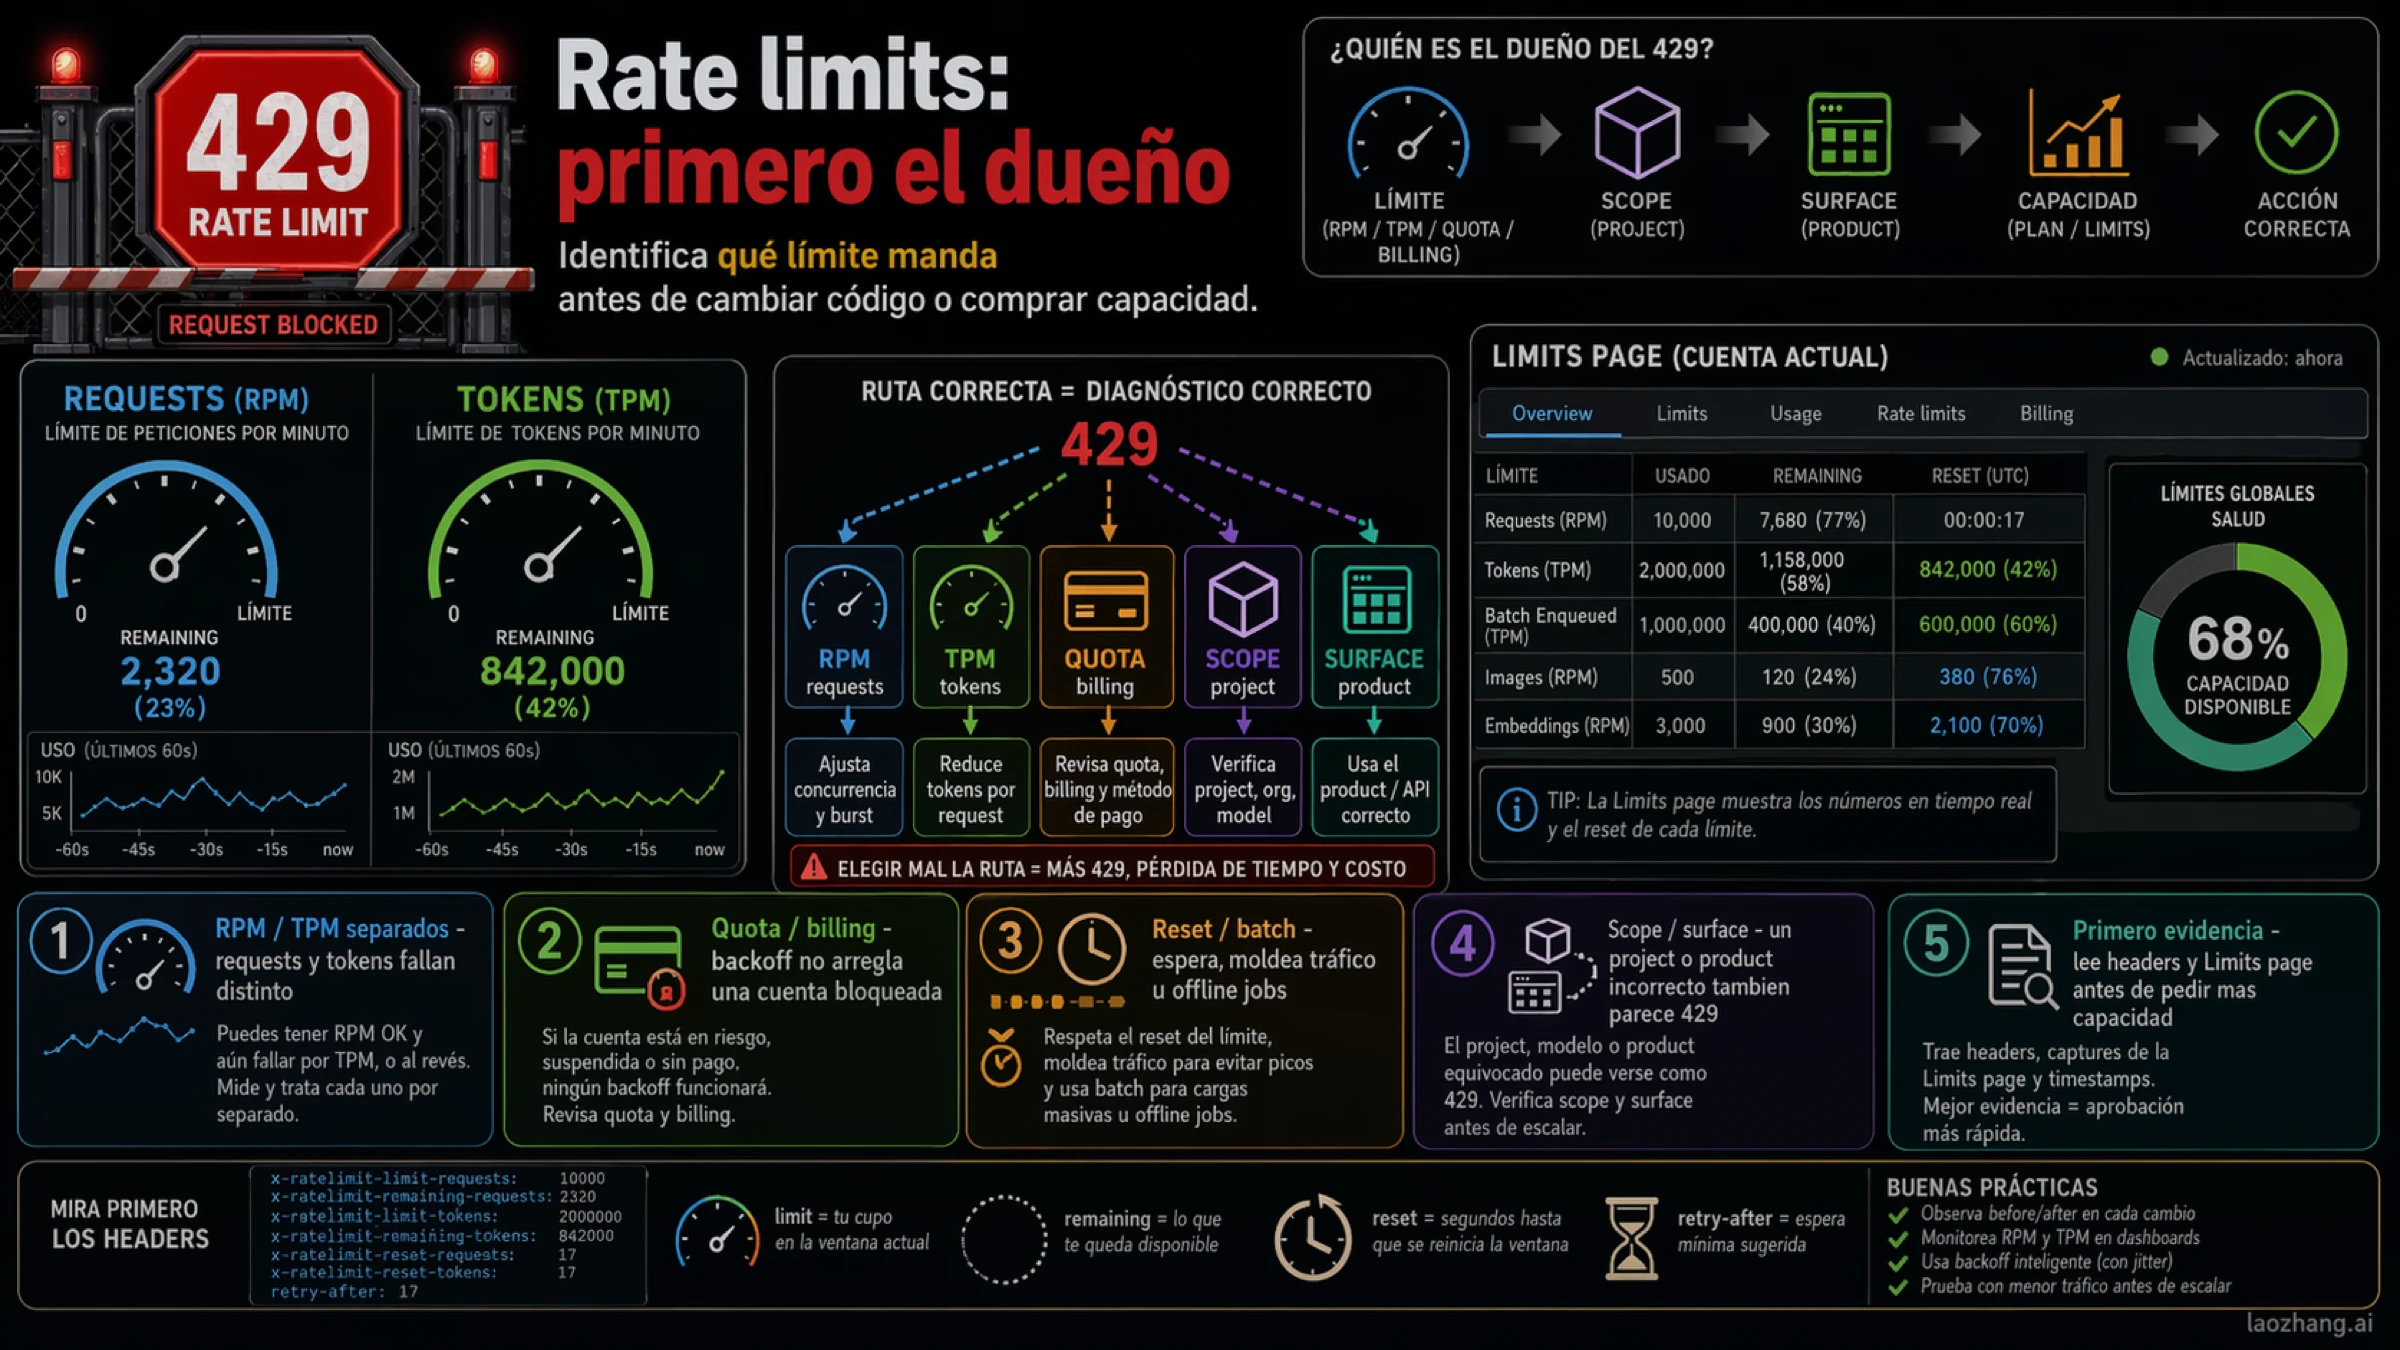
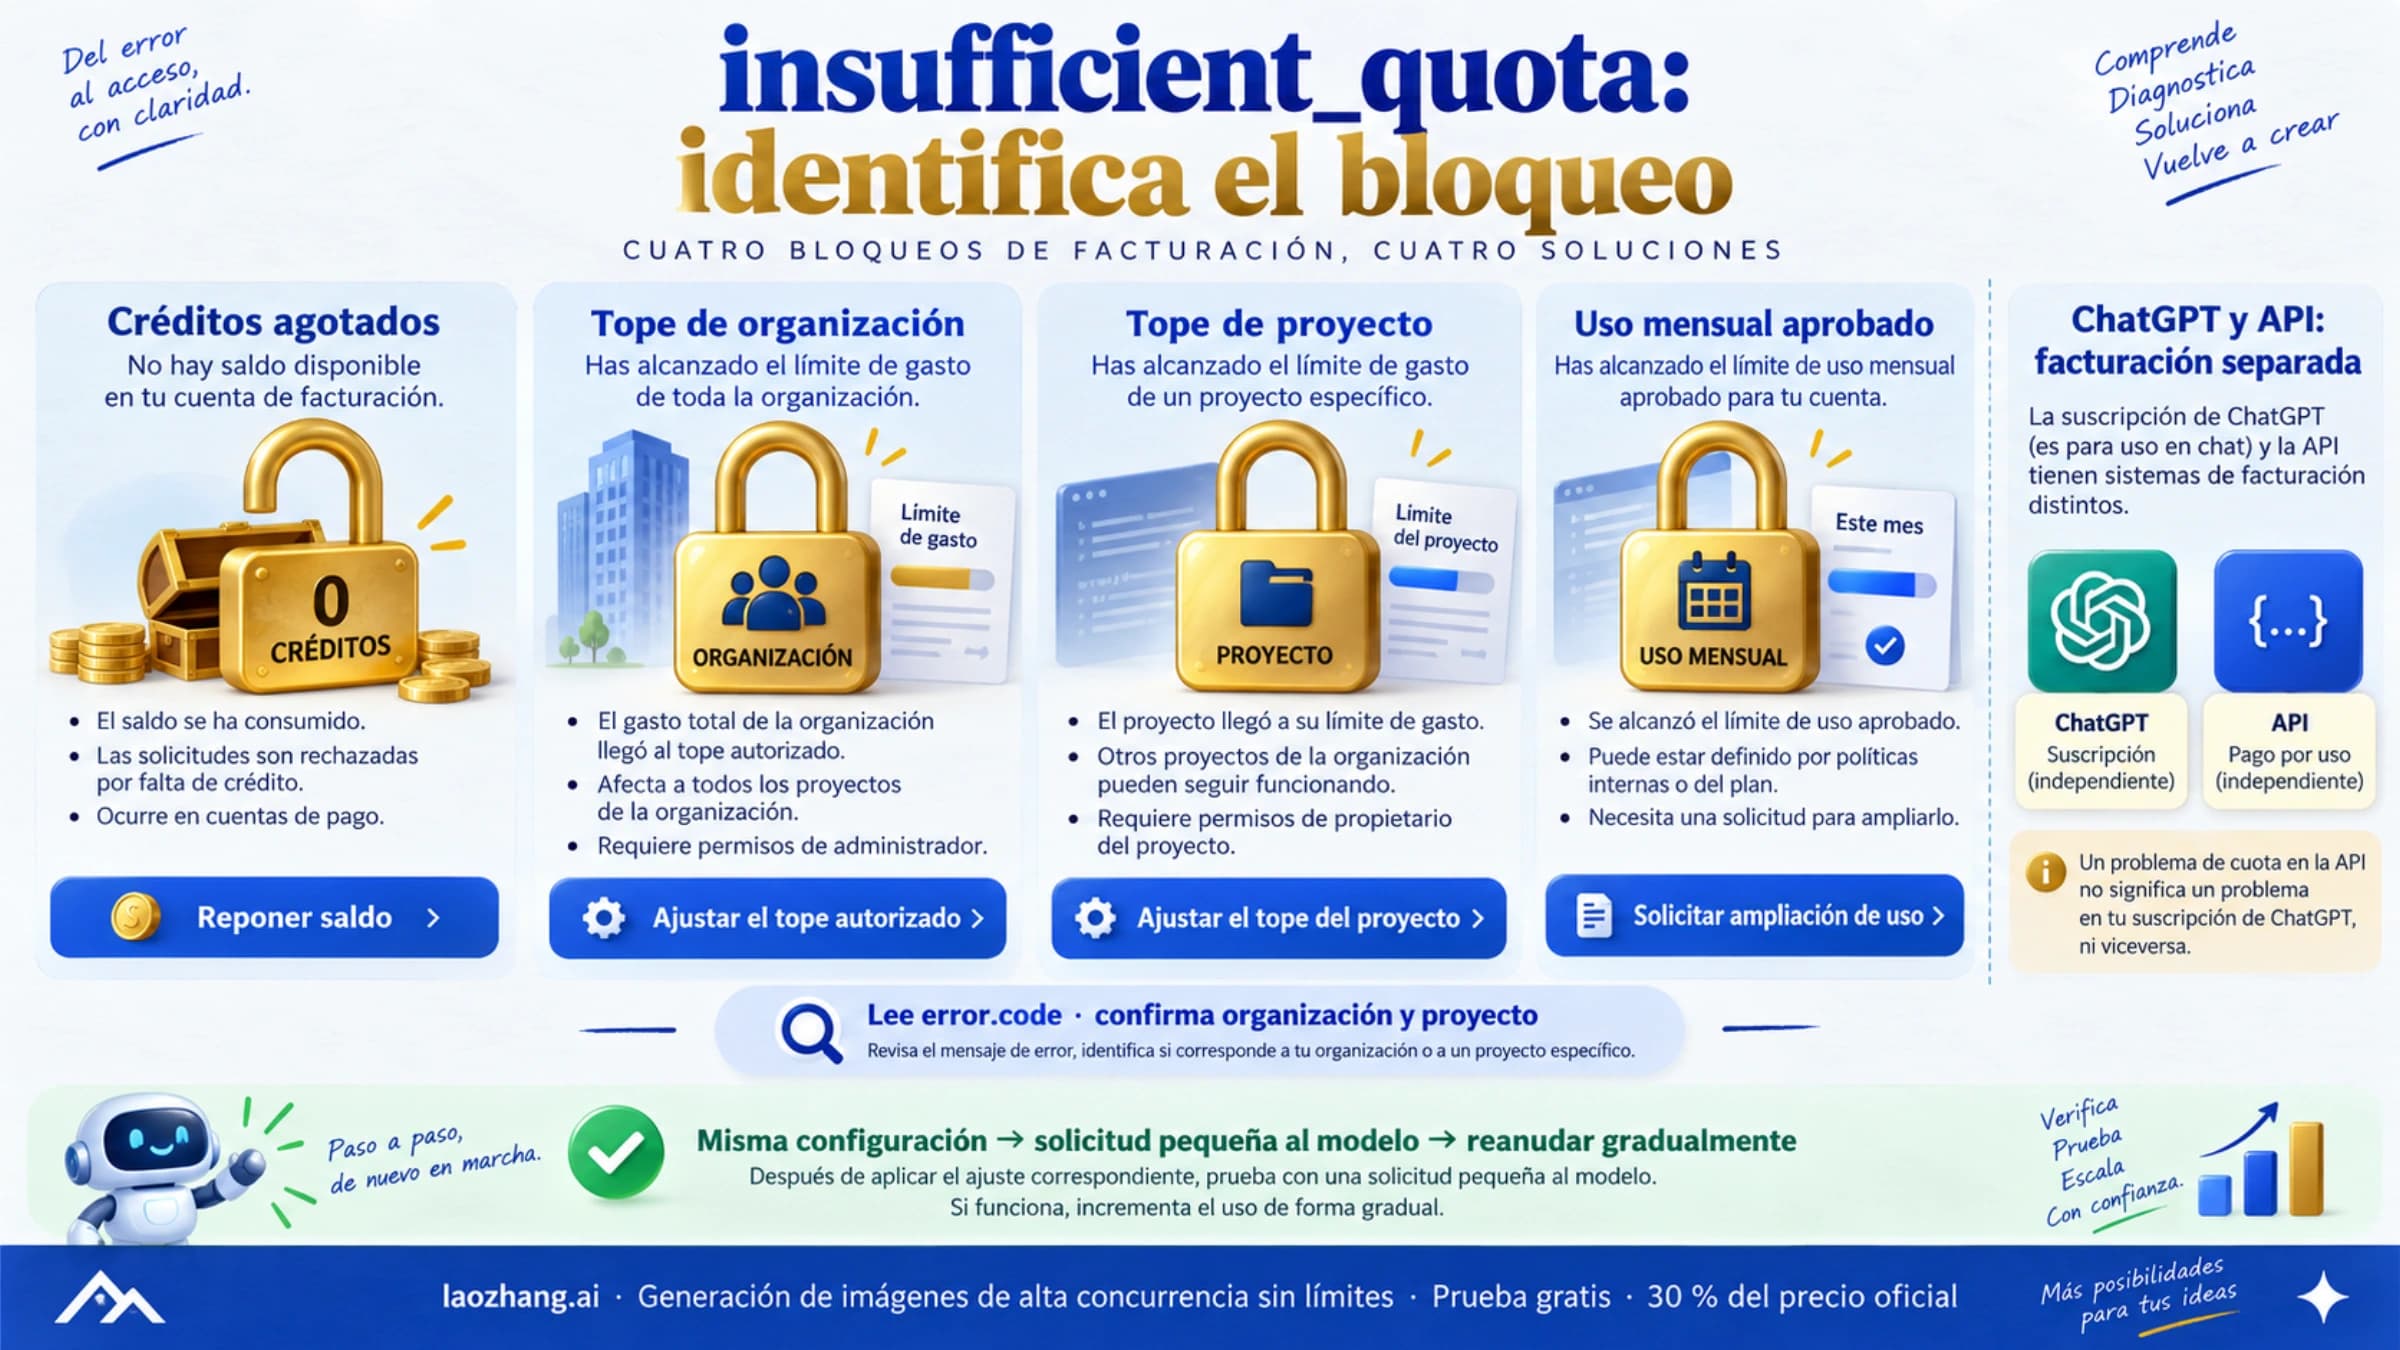
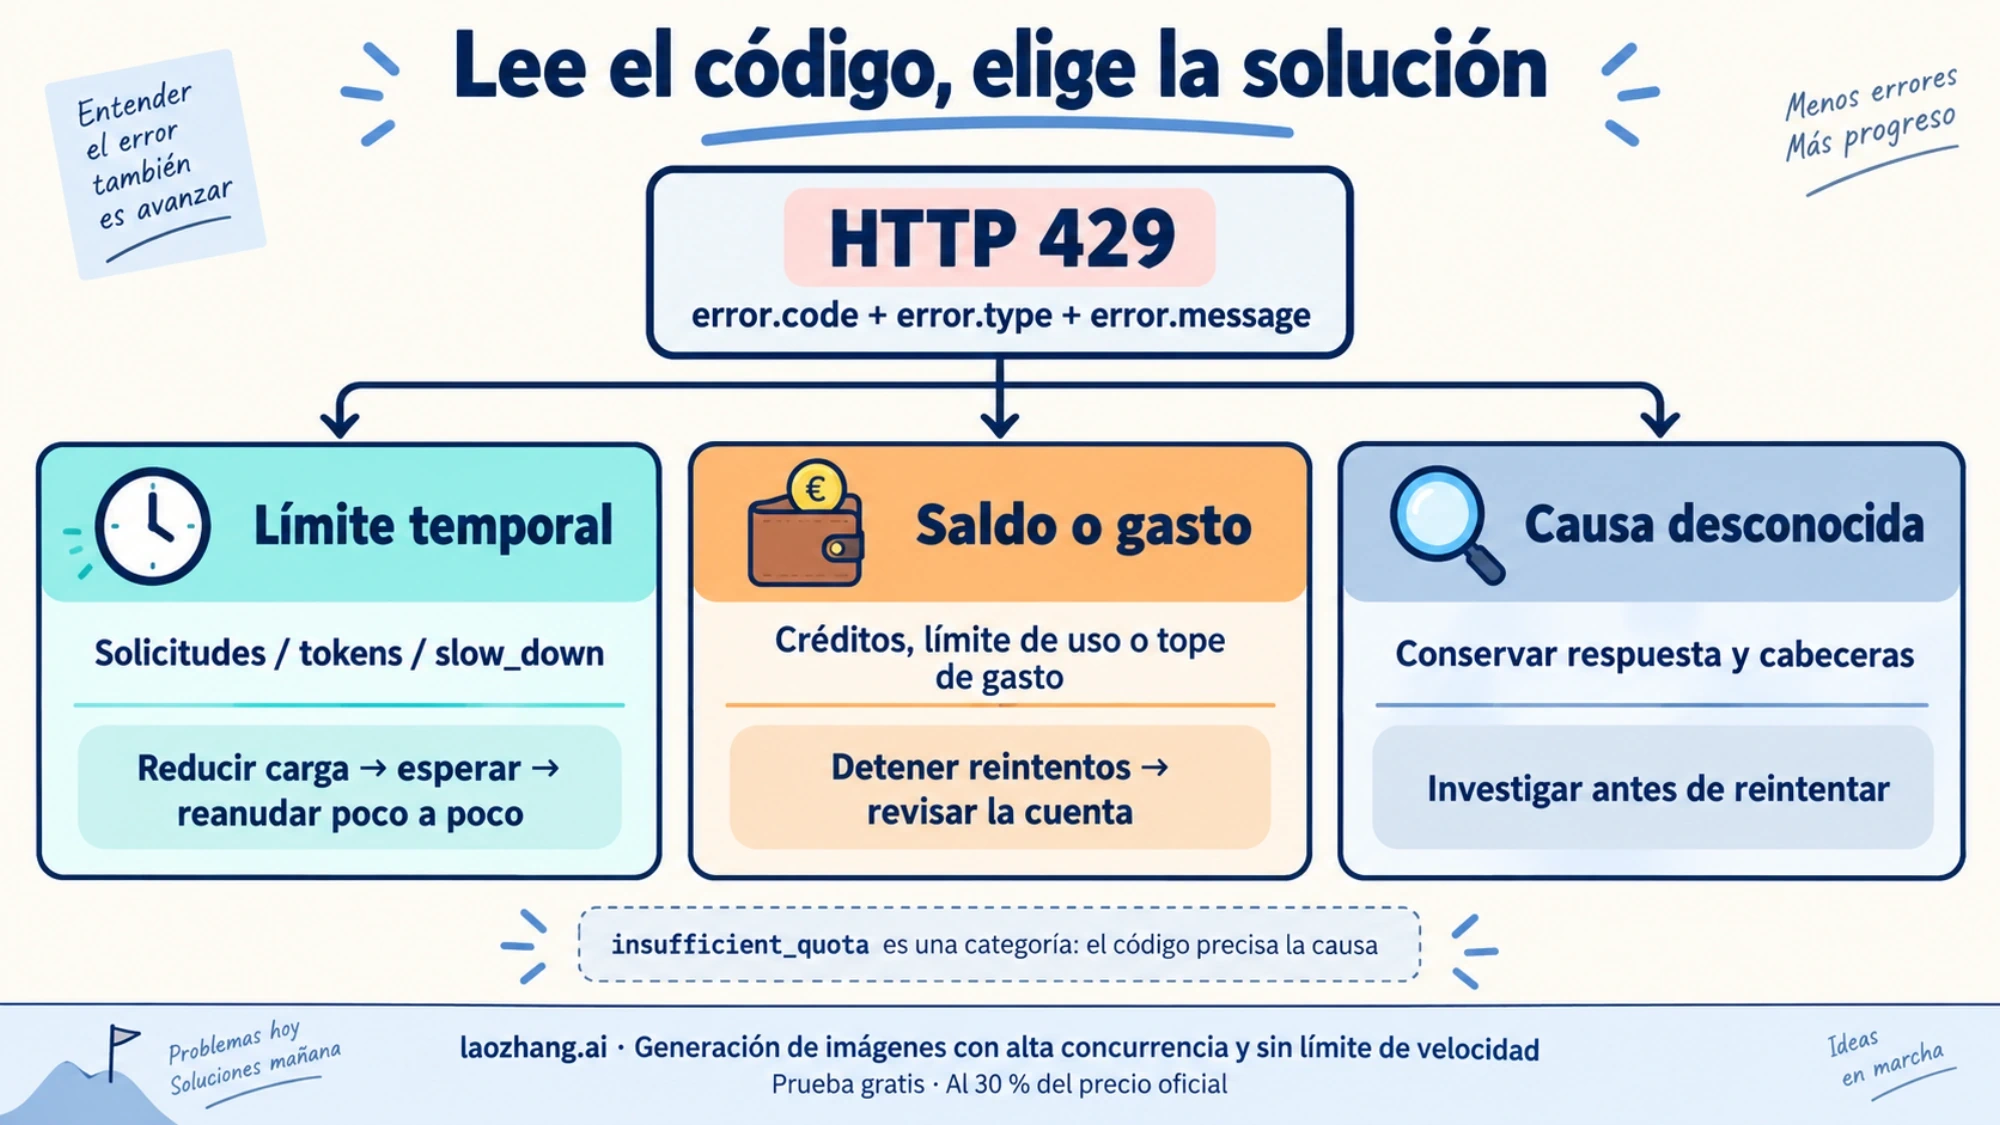
Un error 429 en OpenAI API no significa siempre que hayas enviado demasiadas solicitudes. También puede aparecer por saldo agotado, por un límite mensual de uso o por un tope de gasto de la organización o del proyecto. Antes de reintentar o recargar saldo, lee error.code, error.type y error.message. La medida correcta depende de esa combinación.
Si el error describe una limitación temporal de solicitudes o tokens, reduce la carga y respeta la espera indicada. Si identifica un bloqueo de facturación, detén los reintentos de ese trabajo y resuelve la causa en la cuenta correspondiente. La ayuda oficial de OpenAI en español distingue ambas situaciones. Esta guía se refiere a la API directa de OpenAI y utiliza documentación comprobada el 8 de septiembre de 2026.
Qué mirar en la respuesta antes de cambiar nada
El texto que muestra una herramienta puede ser solo un resumen. Recupera, cuando esté disponible, el cuerpo original de la respuesta y sus cabeceras. Guarda la hora con zona horaria, el modelo, el endpoint, el proyecto utilizado, el código HTTP y el identificador de solicitud. No incluyas la clave de API ni la cabecera de autorización en los registros.
Este es un ejemplo ilustrativo de un cuerpo de error de facturación:
{
  "error": {
    "type": "insufficient_quota",
    "code": "project_spend_limit_exceeded",
    "message": "..."
  }
}
En este caso, insufficient_quota es la categoría general; project_spend_limit_exceeded concreta que el proyecto ha alcanzado un tope de gasto. Interpretar solo el tipo como «falta saldo» llevaría a recargar la cuenta sin resolver necesariamente el bloqueo.
La documentación oficial sobre los errores 429 permite separar estas causas:
| Señal en la respuesta | Qué significa | Qué hacer primero |
|---|---|---|
| El mensaje identifica un límite de solicitudes o tokens | Se ha agotado la capacidad de una ventana de tráfico | Reducir el ritmo y consultar las cabeceras de espera y reinicio |
slow_down, con tipo rate_limit_error | El tráfico ha crecido demasiado deprisa | Frenar el aumento y reanudarlo gradualmente |
credit_balance_exhausted | Se han agotado los créditos de prepago de la organización | Revisar el saldo de esa organización |
organization_usage_limit_exceeded | Se ha alcanzado el límite mensual de uso asignado | Revisar el límite autorizado y las opciones de ampliación |
organization_spend_limit_exceeded | Se ha alcanzado un tope mensual de gasto de la organización | Revisar ese tope con quien administra la organización |
project_spend_limit_exceeded | Se ha alcanzado un tope mensual de gasto del proyecto | Revisar el tope del proyecto que utiliza la clave |
Solo aparece insufficient_quota o no reconoces el código | Falta información para elegir una solución | Leer el mensaje completo y comprobar facturación, proyecto y límites |
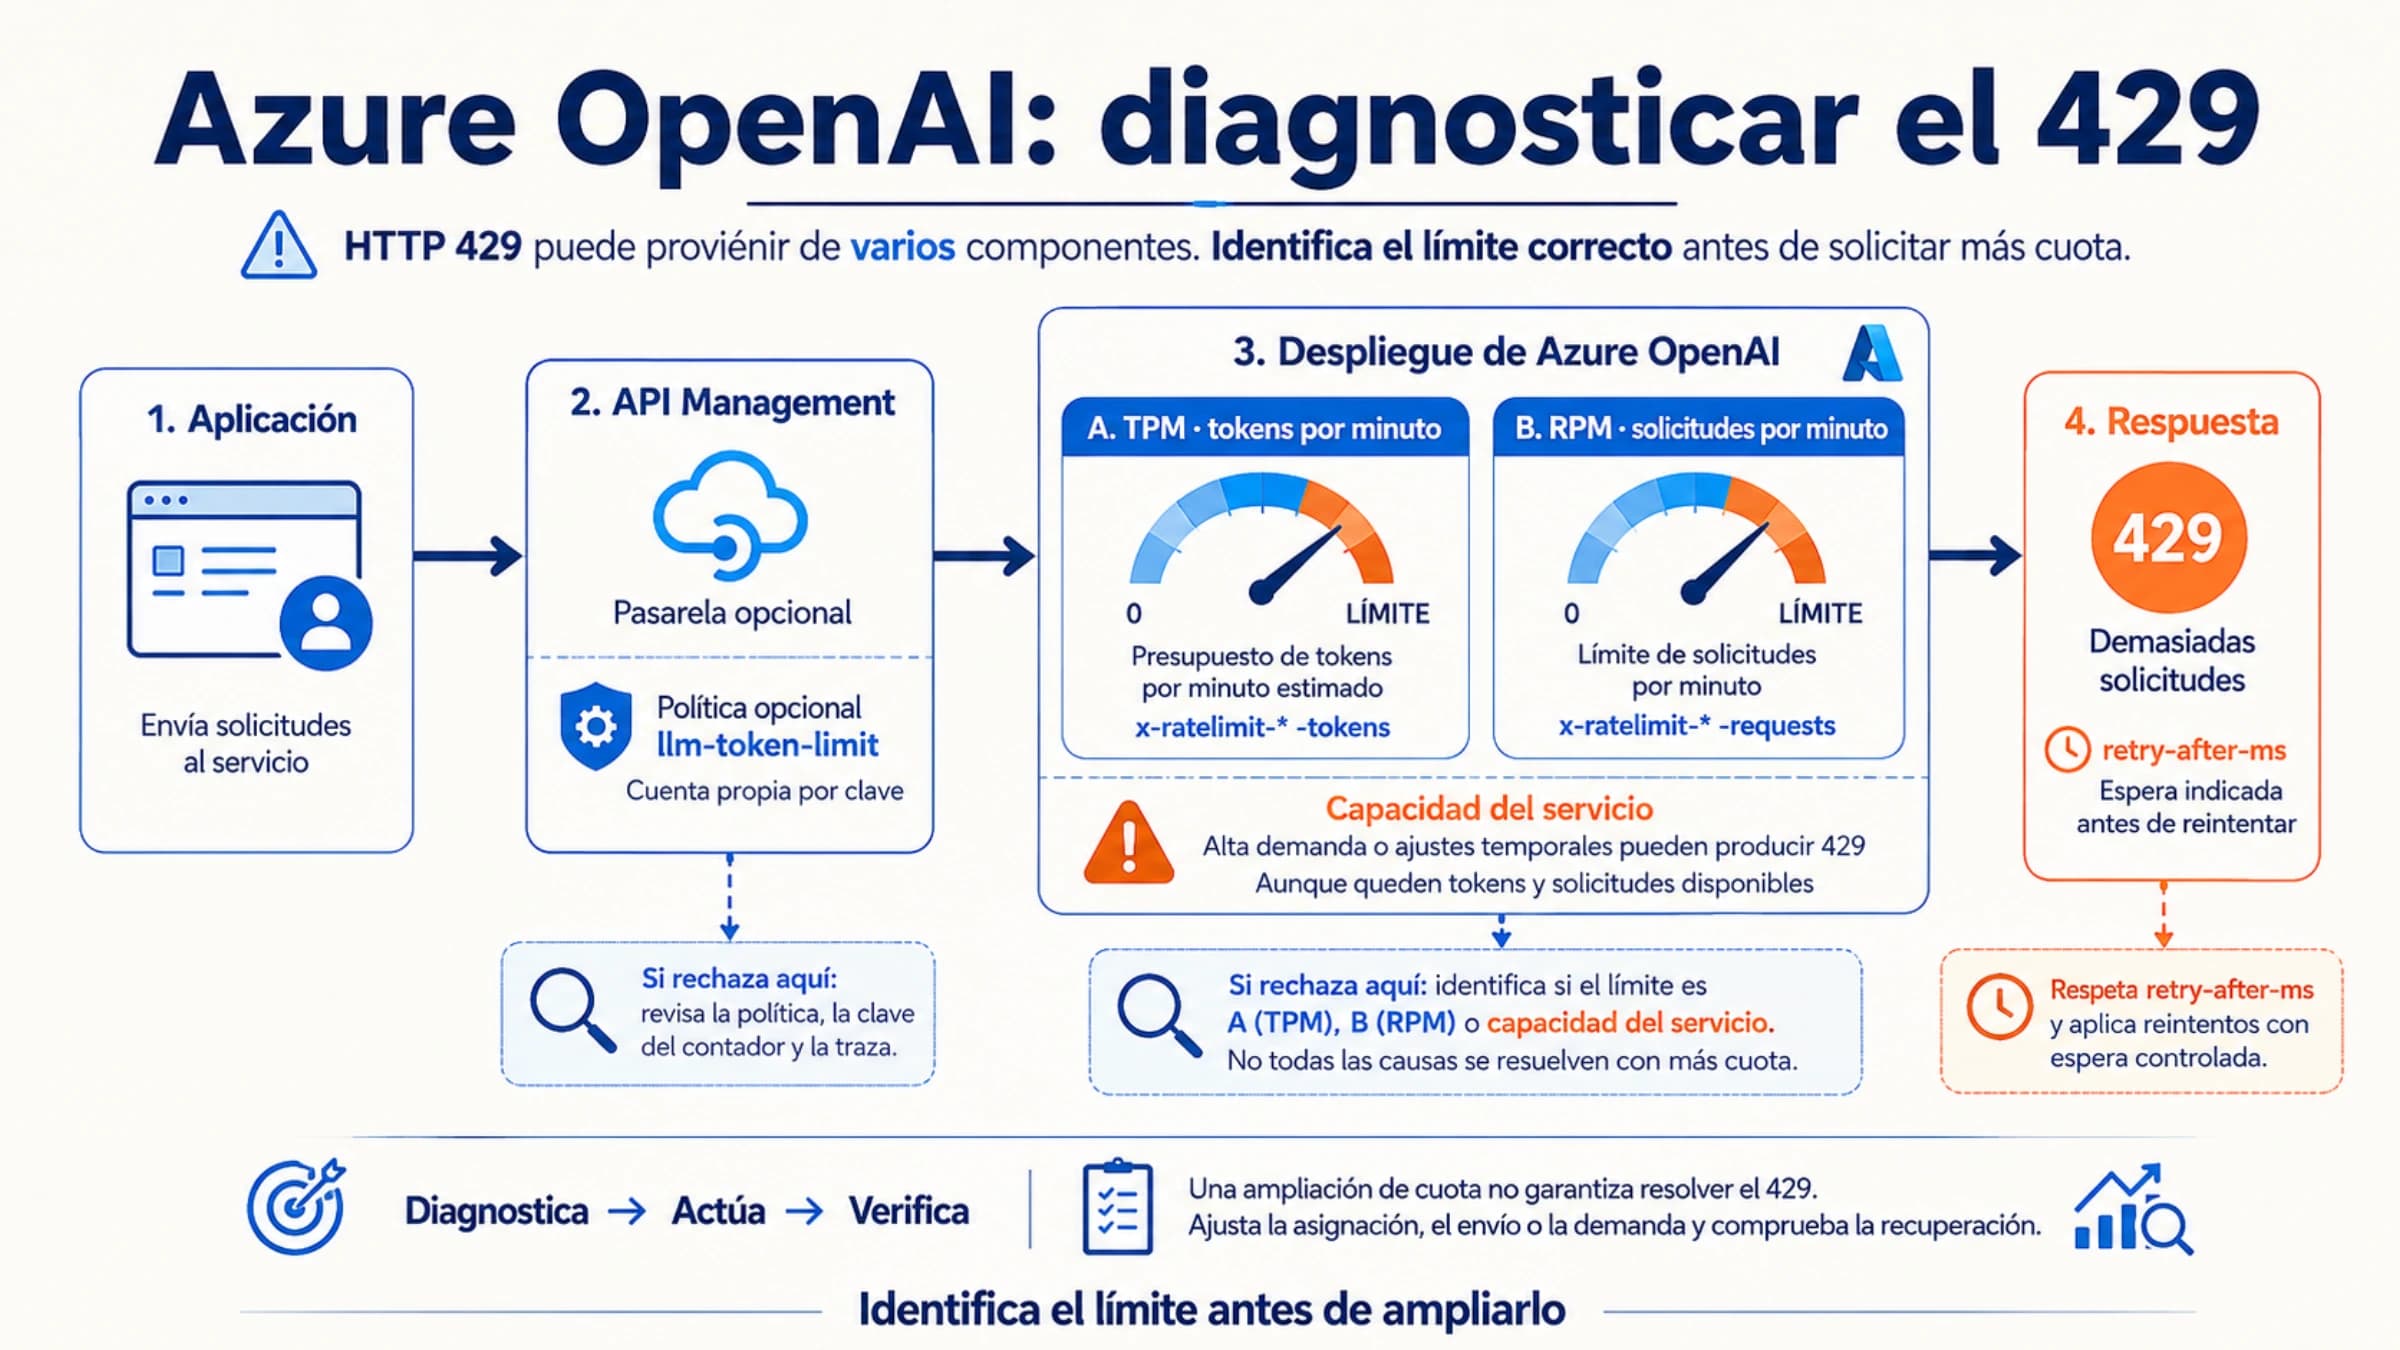
Un código desconocido no debe entrar automáticamente en un bucle de reintentos. Conserva la respuesta para investigarla. Si llamas a través de una pasarela, confirma además quién emitió el 429: sus códigos y cuotas pueden ser distintos de los de OpenAI.
Si el problema es de saldo o gasto, esperar unos segundos no lo arregla
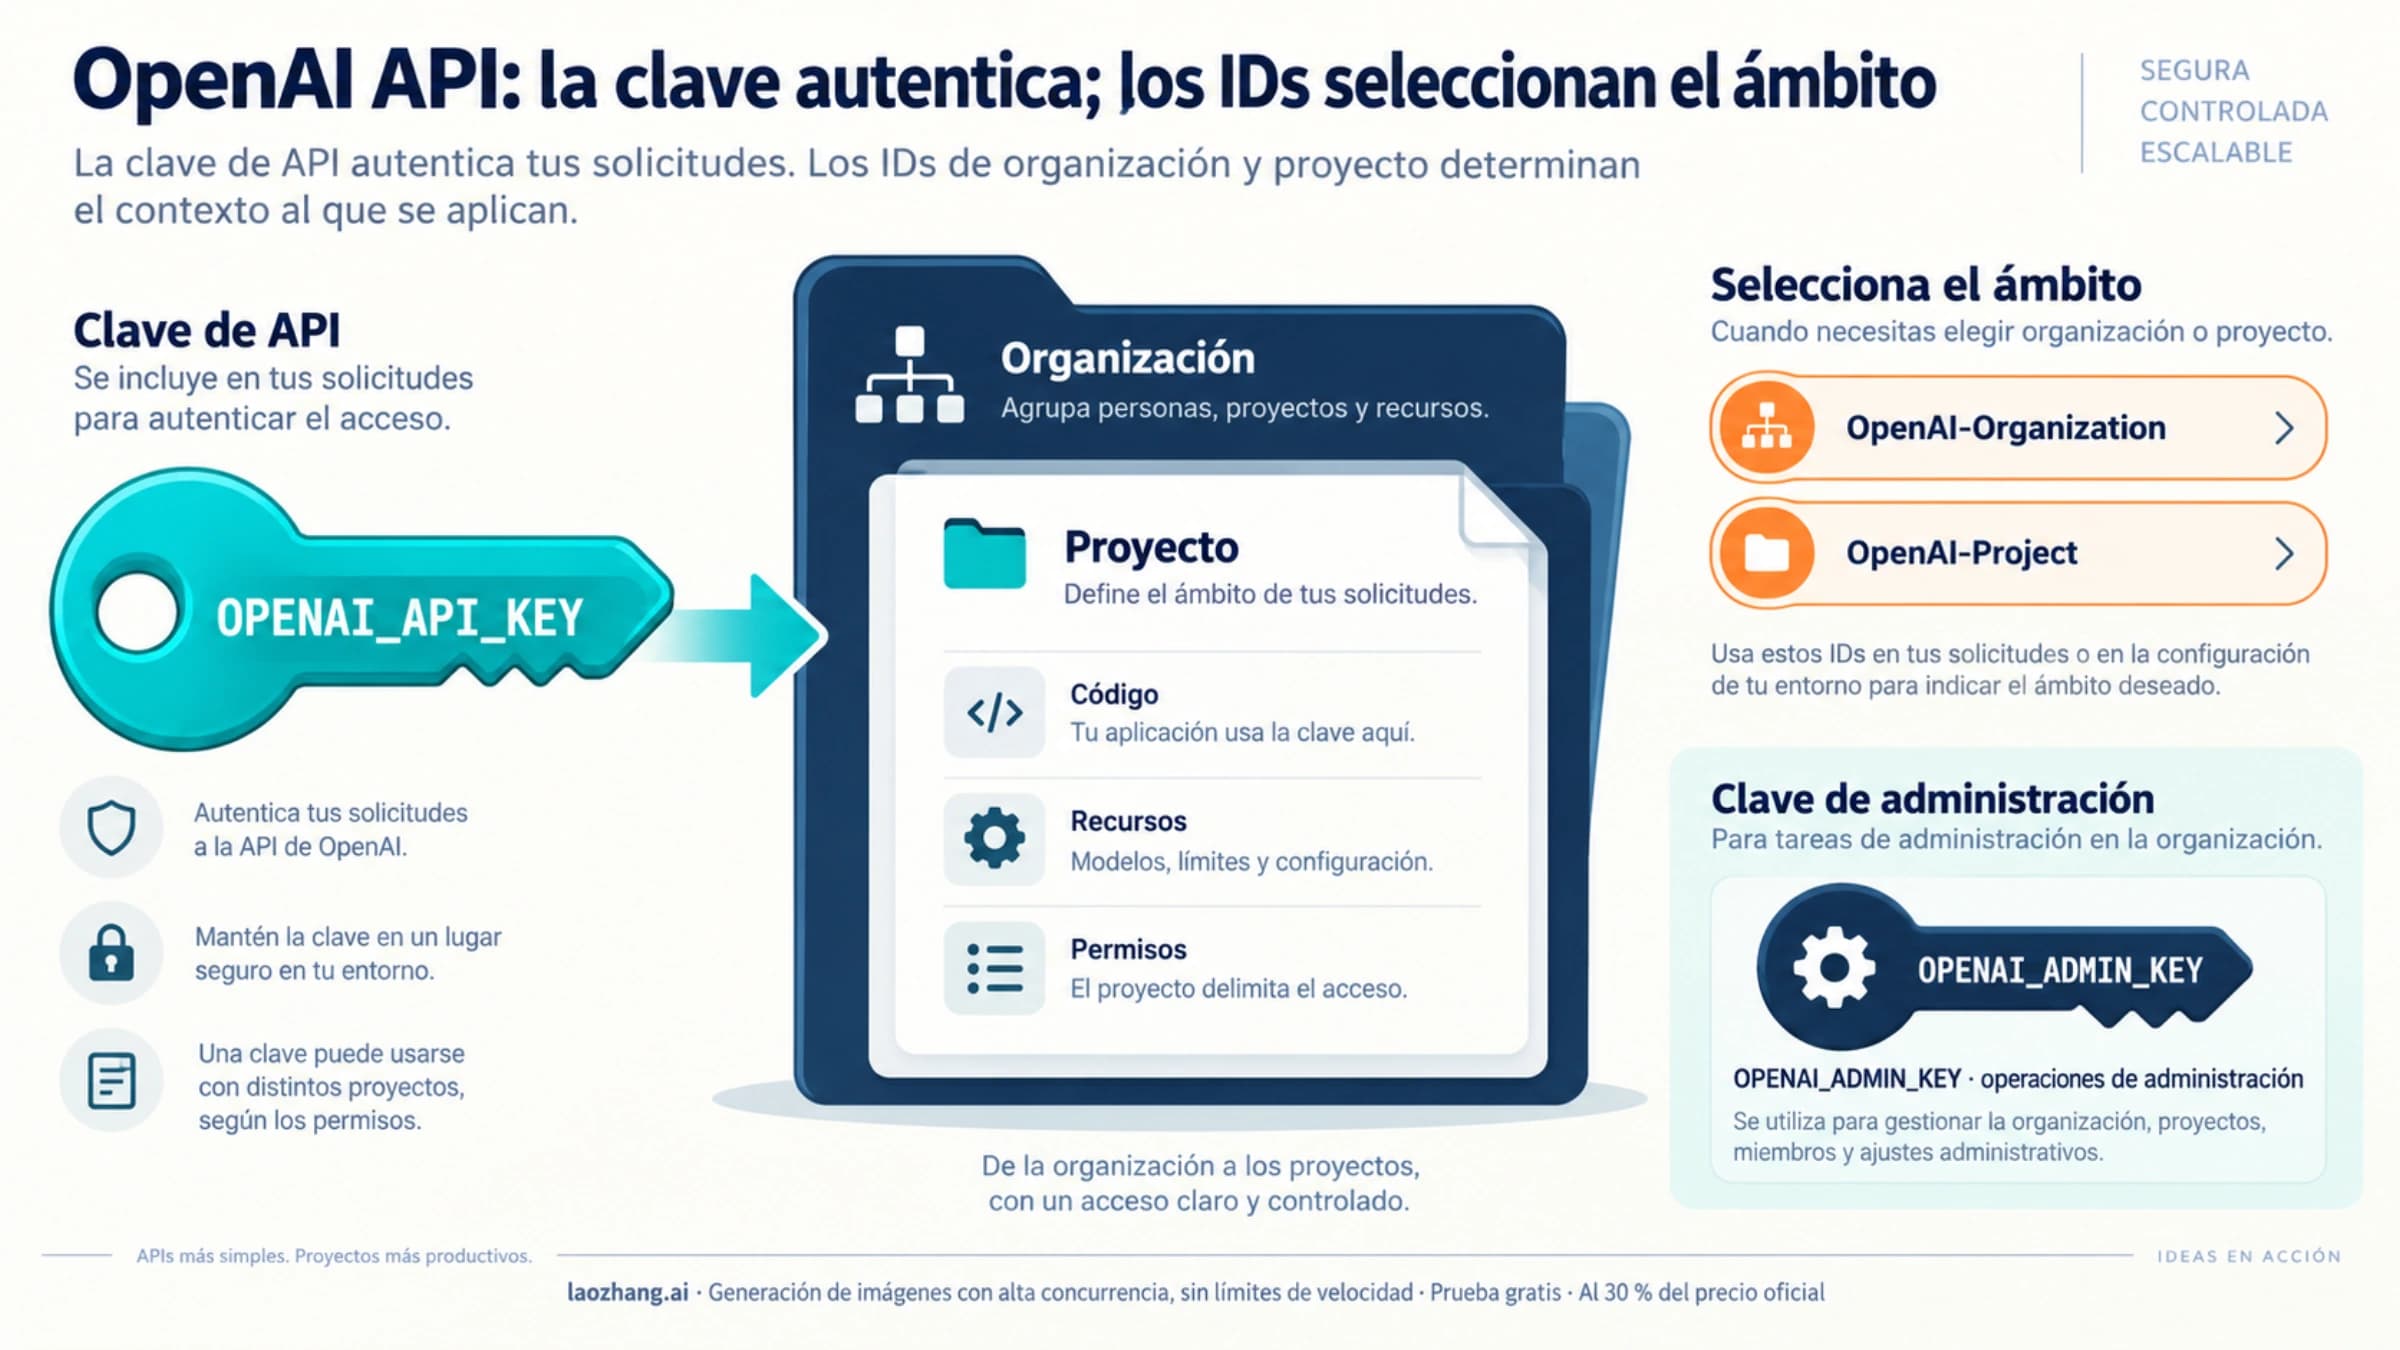
Comprueba que estás revisando la organización y el proyecto asociados a la clave que falla. Es frecuente mirar un panel con saldo disponible mientras la aplicación utiliza otra organización o un proyecto con su propio tope. La guía sobre claves, organizaciones y proyectos de OpenAI explica cómo identificar esa relación.
No todos los ajustes llamados «presupuesto» bloquean las solicitudes. Según la documentación de límites de gasto, las alertas avisan cuando se alcanza un umbral; los topes de gasto aplicados sí pueden detener el tráfico y devolver un código explícito. Un tope de organización afecta a todos sus proyectos. Un tope de proyecto afecta a ese proyecto.
La solución debe corresponder al código concreto:
- Si se agotan los créditos de prepago, revisa y repón el saldo de la organización afectada cuando proceda.
- Si se alcanza el límite mensual de uso asignado, revisa ese límite; cambiar una alerta de presupuesto no equivale a obtener más uso autorizado.
- Si se alcanza un tope de gasto, decide con el administrador si debe ampliarse o si el trabajo debe esperar al reinicio mensual correspondiente.
Si utilizas prepago y el saldo se ha agotado pese a tener activada la recarga automática, revisa su límite mensual y el intento de cobro. La guía sobre qué hacer si falla la recarga automática de OpenAI API explica cómo recuperar el saldo y comprobar después que las compras automáticas vuelven a funcionar.
Los cambios pueden tardar en propagarse. No hay un tiempo universal de recuperación que permita prometer que todo funcionará tras un número fijo de segundos. Evita lanzar todos los trabajos pendientes inmediatamente después de modificar la cuenta: primero comprueba la recuperación con una solicitud pequeña. Para profundizar en esta rama del diagnóstico, consulta la guía sobre cuota agotada en OpenAI API.
Si falta capacidad de tráfico, identifica qué contador se agota
OpenAI aplica límites por organización y proyecto, con valores que varían por modelo y posibles grupos de límites compartidos. Dos claves del mismo proyecto no deben tratarse como dos bolsas de capacidad independientes. Consulta Limits en la plataforma y compáralo con las cabeceras de las respuestas del modelo afectado, siguiendo la guía oficial de límites de frecuencia.
| Cabeceras | Cómo utilizarlas |
|---|---|
x-ratelimit-limit-requests y x-ratelimit-remaining-requests | Comparar la capacidad de solicitudes con lo que queda en la ventana |
x-ratelimit-reset-requests | Consultar cuándo se restablece el contador de solicitudes |
x-ratelimit-limit-tokens y x-ratelimit-remaining-tokens | Detectar presión sobre el volumen de tokens |
x-ratelimit-reset-tokens | Consultar el reinicio del contador de tokens |
| Cabeceras de límite, remanente y reinicio de tokens del proyecto, si aparecen | Detectar una restricción adicional del proyecto |
Retry-After | Respetar la espera indicada por el servidor para un fallo temporal |
Una cabecera ausente significa que no tienes ese dato en la respuesta. No significa que queden cero solicitudes ni que la capacidad sea ilimitada. Tampoco conviertas los valores de ejemplo de la documentación en constantes de tu aplicación.
RPM mide solicitudes por minuto; TPM mide tokens por minuto. Puedes estar muy por debajo de RPM y agotar TPM con pocas solicitudes grandes. Si se agotan las solicitudes, reduce el número de peticiones admitidas y distribúyelas en el tiempo. Si se agotan los tokens, reduce el contexto innecesario, el tamaño de las tareas o la frecuencia con la que las envías.
Ajusta también el máximo de salida a la tarea. En Responses se utiliza max_output_tokens; en Chat Completions, max_completion_tokens. Estos presupuestos incluyen los tokens de razonamiento además de la salida visible cuando corresponda, por lo que un máximo demasiado pequeño puede impedir que la respuesta termine correctamente. La ayuda oficial de límites y reintentos explica por qué conviene evitar máximos innecesariamente altos.
La media de un minuto puede ocultar ráfagas. Si un proceso envía de golpe todas las peticiones al empezar cada minuto, puede incumplir una ventana más corta aunque el promedio parezca aceptable. Limitar la concurrencia ayuda, pero también hace falta controlar la cadencia: varios procesos que terminan rápido pueden seguir generando muchas solicitudes por segundo.
slow_down puede aparecer aunque aún quede margen
El código slow_down indica que la carga está aumentando demasiado deprisa. No necesitas haber agotado el total de RPM o TPM para recibirlo. Por ejemplo, arrancar simultáneamente todos los procesos de una cola puede generar un salto de tráfico incompatible con el ritmo de crecimiento permitido. La respuesta útil es reducir la admisión de trabajo y escalonar el arranque.
No lo confundas con 503 server_is_overloaded, cuyo tipo es service_unavailable_error: ese error describe falta temporal de capacidad del modelo. OpenAI distingue ambas situaciones en su referencia de códigos de error. Un 503 no demuestra que falte saldo ni que debas subir de nivel.
Si persiste un problema de capacidad del servicio, consulta OpenAI Status. Un modelo alternativo puede ayudar si ya has validado su calidad, formato y herramientas para la tarea, pero puede compartir límites con el original. Conviene definir esa decisión antes del incidente; la guía de reintento frente a cambio de modelo desarrolla ese criterio.
Cómo reintentar sin multiplicar las solicitudes fallidas
Reintenta únicamente los errores que hayas identificado como temporales. Para ellos, un Retry-After válido establece una espera mínima. Si el servidor indica 90 segundos y tu trabajo solo dispone de 30 segundos más, devuelve el control o aplázalo en una cola. Reducir la espera a 30 segundos para encajar en tu plazo supondría reintentar antes de lo indicado.
Cuando Retry-After falta o no puede interpretarse, utiliza una espera exponencial con aleatoriedad, un máximo de intentos y un plazo total. El límite que apliques a la espera calculada localmente no debe acortar una espera válida del servidor. Las solicitudes fallidas también cuentan para los límites, de modo que insistir sin pausas puede prolongar el incidente, como advierte la guía de límites de OpenAI.
Una política de aplicación puede seguir esta secuencia:
- Leer el estado y el cuerpo; detener el trabajo si el código identifica facturación, configuración o una causa desconocida.
- Para una causa temporal, comprobar cuántos intentos y cuánto tiempo quedan.
- Respetar
Retry-Aftersi es válido; en su ausencia, calcular una espera creciente con aleatoriedad. - Aplazar o terminar si la espera no cabe en el plazo restante. No adelantar la petición.
- Volver a intentarlo bajo el mismo control de admisión que las solicitudes nuevas.
- Al agotar el presupuesto, devolver un error útil o guardar el trabajo pendiente con su estado.
Antes de implementar esa política, revisa lo que ya hace tu cliente. El SDK oficial de Python reintenta por defecto dos veces los fallos aptos para reintento. Además, agrupa las respuestas 429 en RateLimitError, incluso cuando debes inspeccionar el cuerpo para descubrir un problema de cuota. Capturar esa excepción no basta para decidir que otro intento será útil.
Si la aplicación controla todos los reintentos, puede desactivar los del SDK con max_retries=0. Si conserva los del SDK, debe incluirlos en el presupuesto global. Tres intentos de una cola, cada uno con un intento inicial del SDK y dos reintentos, pueden acabar en nueve solicitudes al proveedor. Es una cuenta ilustrativa, no una medición de rendimiento. Añadir más procesos durante un 429 puede multiplicar todavía más esa carga.
Para el diagnóstico, el SDK expone la respuesta y request_id a través de APIStatusError. Guarda los datos útiles del fallo, sin credenciales, para poder relacionar los intentos con las cabeceras observadas.
Comprueba la recuperación antes de vaciar la cola
Como procedimiento operativo, tras corregir saldo, gasto o tráfico, envía una sola solicitud pequeña con la misma clave, organización, proyecto y modelo que fallaban. Cambiar de modelo o de proyecto en esa prueba podría ocultar que la causa original sigue activa.
Si funciona, revisa las cabeceras disponibles y aumenta la carga en pasos pequeños. Una solicitud correcta confirma que ese intento pasó; no demuestra que la aplicación pueda volver directamente a su volumen máximo. Mantén pausados los trabajos duplicados y vigila la proporción de 429, la longitud de la cola y el contador que antes se agotaba.
Si vuelve a fallar, compara el nuevo código y mensaje con el anterior. Resolver un tope de gasto puede dejar al descubierto un problema independiente de TPM al reanudar el trabajo. Conserva los identificadores de ambas respuestas: ayudan a distinguir un bloqueo persistente de una segunda causa.
Planificar capacidad: el ejemplo de GPT-6 Astra
La ficha oficial de GPT-6 Astra, comprobada el 8 de septiembre de 2026, publica estos límites por nivel. Son referencias de planificación; la capacidad efectiva y el acceso del proyecto deben comprobarse en la cuenta.
| Nivel | Solicitudes por minuto | Tokens por minuto | Tokens de entrada pendientes en Batch |
|---|---|---|---|
| T1 | 500 | 500.000 | 1.500.000 |
| T2 | 5.000 | 1.000.000 | 3.000.000 |
| T3 | 5.000 | 2.000.000 | 100.000.000 |
| T4 | 10.000 | 4.000.000 | 200.000.000 |
| T5 | 15.000 | 40.000.000 | 15.000.000.000 |
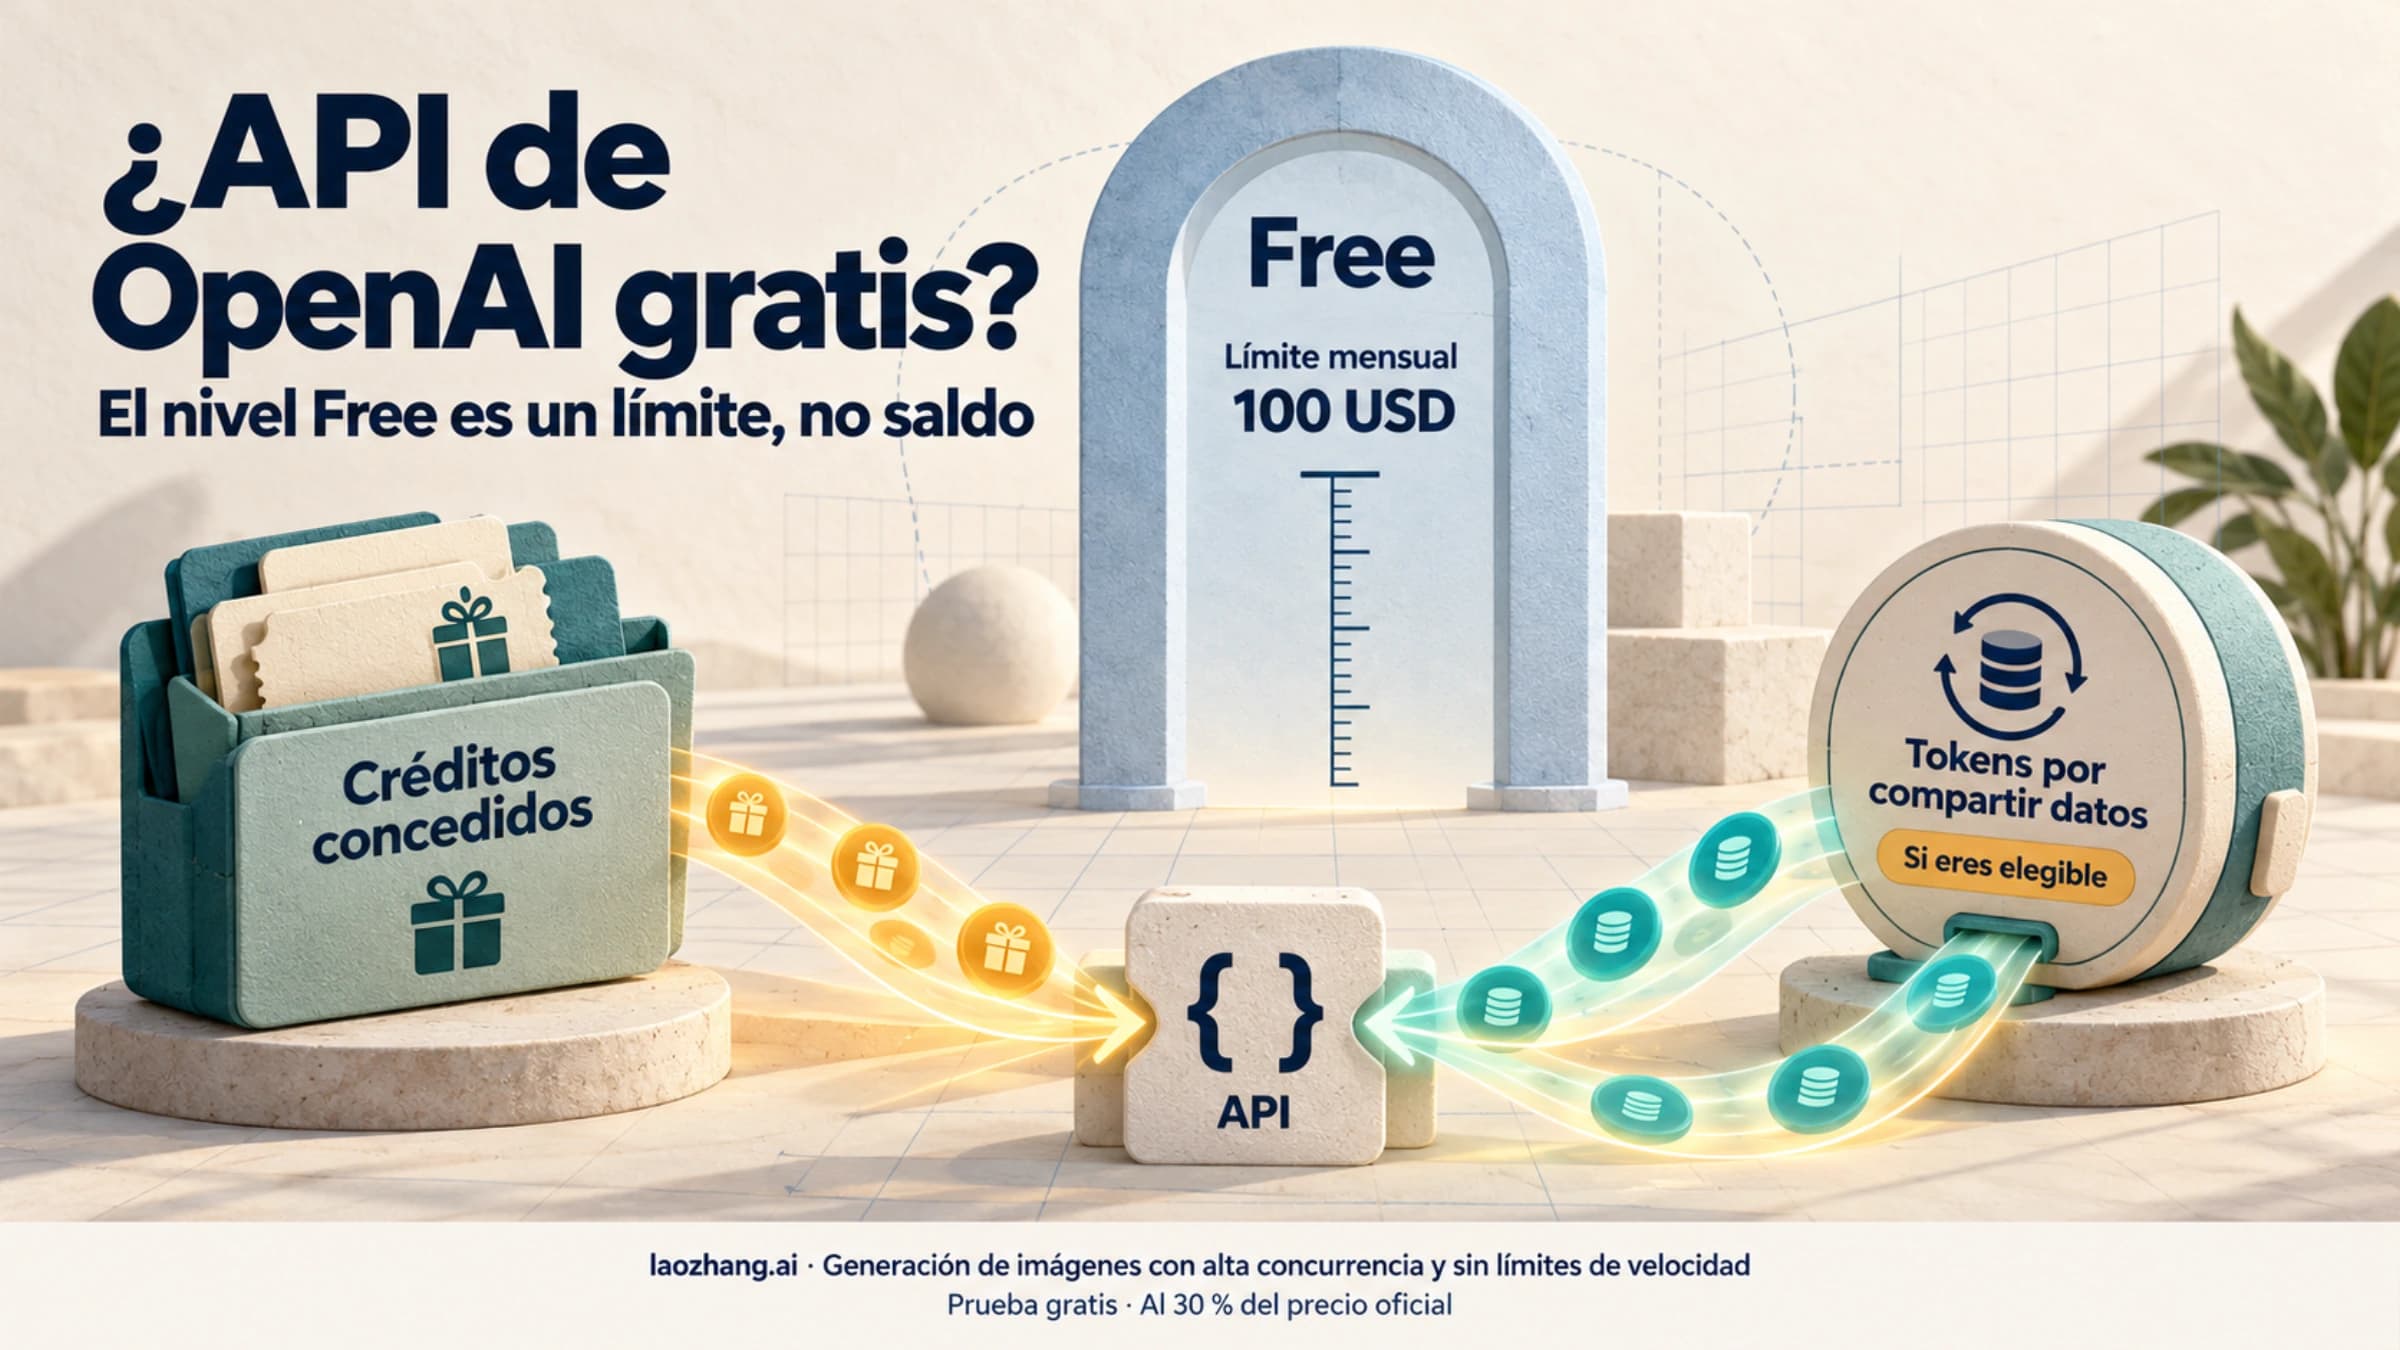
El nivel gratuito no admite Astra. Estar en un nivel de pago tampoco demuestra por sí solo que una clave tenga acceso al modelo ni que sus límites coincidan exactamente con una fila pública.
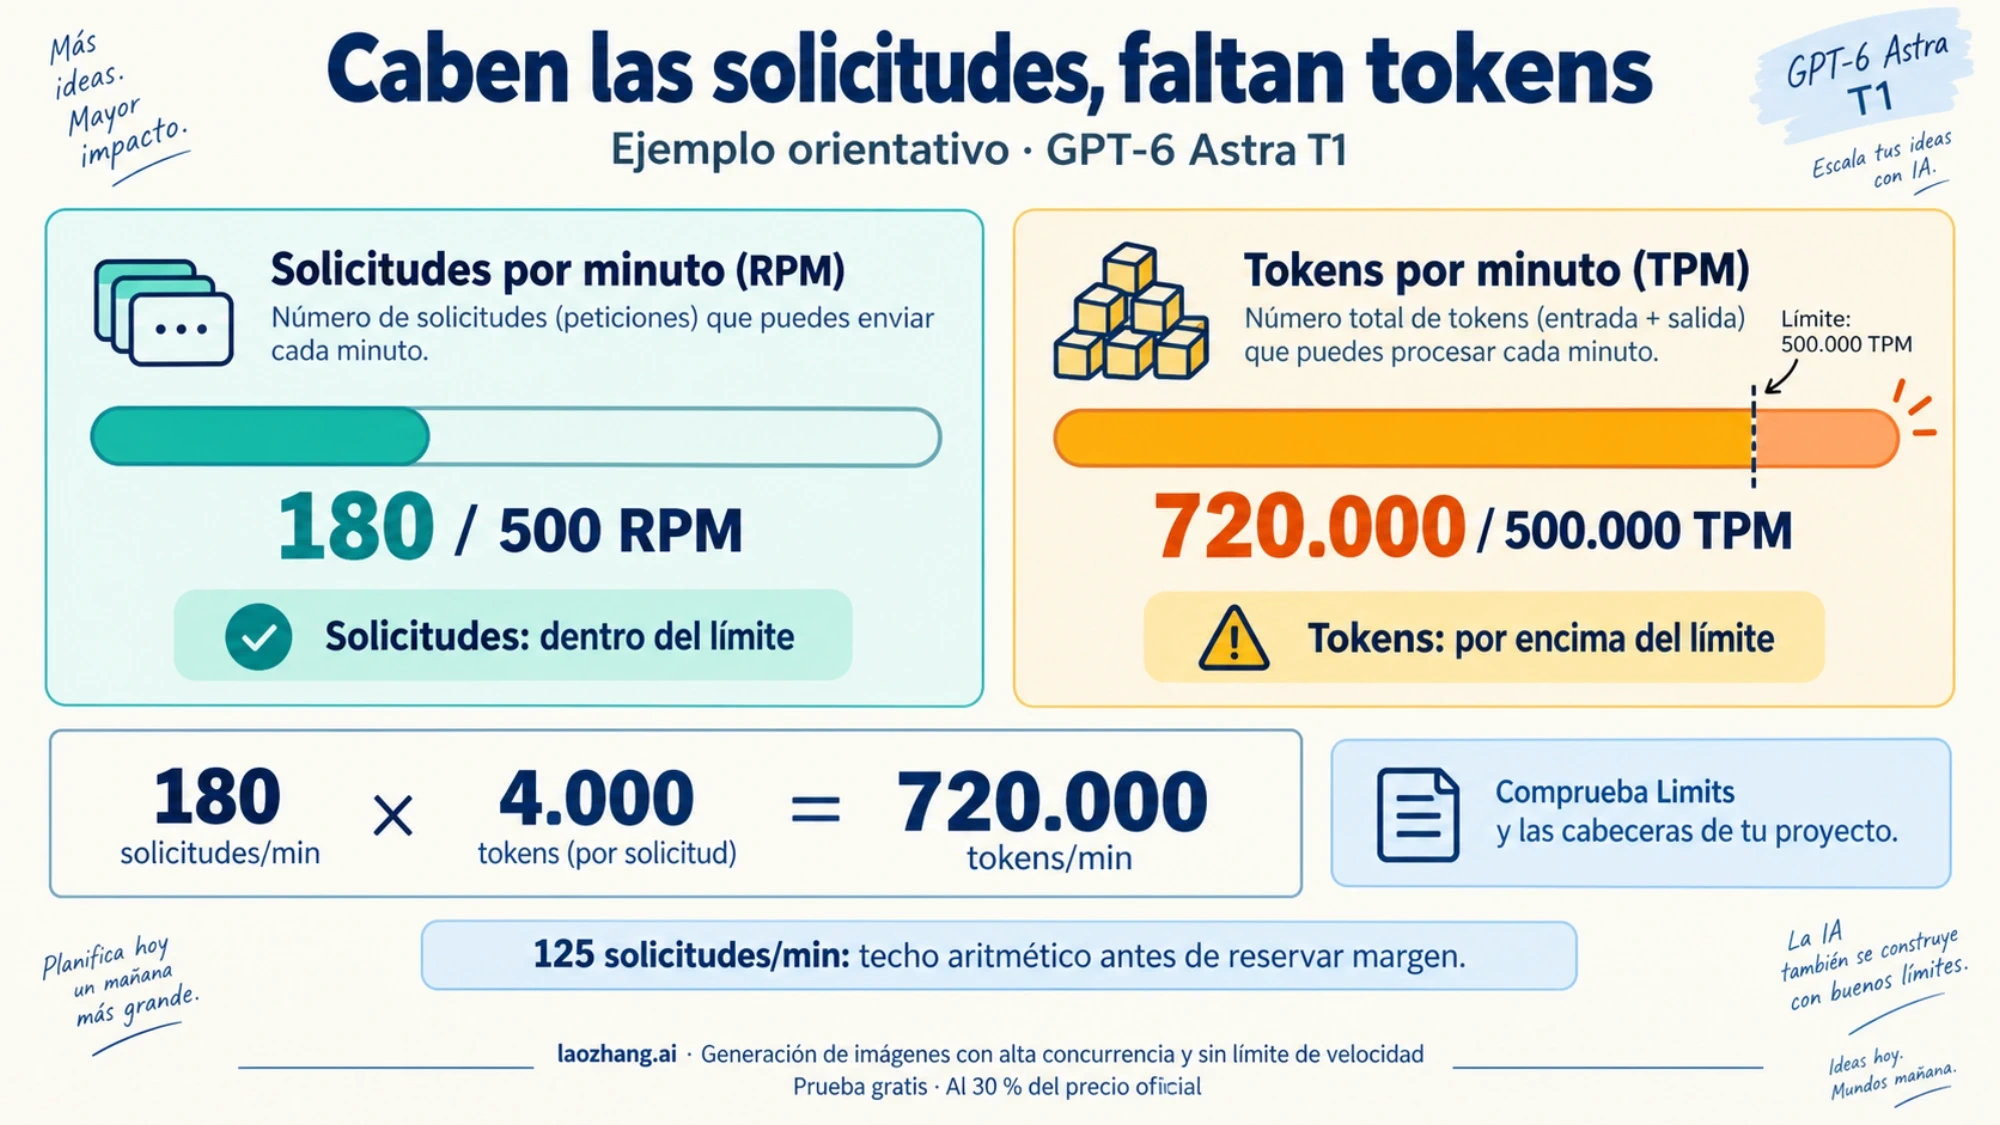
Supón una carga de 180 solicitudes por minuto con 4.000 tokens de media por solicitud. El cálculo orientativo es:
180 solicitudes/min × 4.000 tokens/solicitud = 720.000 tokens/minLas 180 solicitudes caben en la referencia de 500 RPM de T1, pero los 720.000 tokens superan sus 500.000 TPM. Con una media de 4.000 tokens, dividir 500.000 entre 4.000 da 125 solicitudes por minuto como techo aritmético antes de reservar margen. El ritmo operativo debe ser menor y tener en cuenta variaciones, estimaciones del límite, ráfagas y reintentos. No uses esa división como un rendimiento garantizado.
Mide el consumo real de las tareas y compáralo con las cabeceras, sin olvidar el máximo de salida solicitado. Si la carga optimizada sigue superando el límite efectivo, reúne picos y promedios de RPM/TPM, tamaño de las solicitudes, modelo, endpoint y tiempos de espera para solicitar más capacidad.
Batch resulta útil cuando la respuesta puede esperar. Su cola cuenta tokens de entrada pendientes, no lotes ni una cuota diaria: debes sumar los trabajos que aún ocupan la cola. Trasladar tareas a Batch exige comprobar ese límite por separado, según la documentación de límites.
Hay otras dos cifras que no debes mezclar con TPM. Standard y Fast comparten el mismo límite para un modelo, de acuerdo con la guía de Fast; activar Fast no añade RPM o TPM. Por otra parte, el umbral de más de 272K tokens de entrada de Astra corresponde a un cambio de precio para contexto largo, no a un umbral que por sí solo provoque un 429. Los detalles económicos están en la guía de precios de GPT-6 Astra en la API.
Dudas frecuentes al resolver un 429
¿Una suscripción de ChatGPT soluciona la cuota de la API?
No debes utilizar el estado de la suscripción como prueba de saldo o capacidad de OpenAI API. Para este diagnóstico cuentan la organización, el proyecto y los límites de la clave utilizada. Si el aviso aparece dentro de Codex, identifica primero el método de acceso y sigue la guía específica de límite de reintentos y error 429 en Codex.
¿Crear otra clave elimina el límite?
Una nueva clave del mismo proyecto no crea una asignación independiente de RPM o TPM. Antes de cambiar credenciales, comprueba el ámbito del límite: organización, proyecto, modelo o grupo compartido. Rotar claves sin corregir la carga o la facturación no resuelve esa causa.
¿Sirve esta tabla para Azure OpenAI?
No. Esta tabla y estos códigos describen la API directa de OpenAI. Azure tiene su propia configuración de recursos, despliegues y capacidad. Si ese es tu proveedor, utiliza la guía de límites TPM de Azure OpenAI.
¿Cuánto tarda en desaparecer el error?
Depende de la causa. Una restricción temporal exige respetar la espera y reducir la presión; un bloqueo de saldo o gasto exige resolver ese estado o esperar al reinicio aplicable. Comprueba la recuperación con una solicitud pequeña y después aumenta gradualmente el tráfico, en lugar de asumir que un temporizador fijo garantiza que el servicio esté recuperado.
Fuentes9
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 5 oct 2026.
Fuentes9
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 5 oct 2026.
- 1.ayuda oficial de OpenAI en españolhelp.openai.com/es-es/articles/5955604-solucionar-límites-de-solicitudes-y-errores-429-de-la-api
- 2.documentación oficial sobre los errores 429help.openai.com/en/articles/5955604-troubleshooting-api-rate-limits-and-429-errors
- 3.documentación de límites de gastodevelopers.openai.com/api/docs/guides/spend-limits
- 4.guía oficial de límites de frecuenciadevelopers.openai.com/api/docs/guides/rate-limits
- 5.referencia de códigos de errordevelopers.openai.com/api/docs/guides/error-codes
- 6.OpenAI Statusstatus.openai.com
- 7.SDK oficial de Pythondevelopers.openai.com/api/reference/python
- 8.ficha oficial de GPT-6 Astradevelopers.openai.com/api/docs/models/gpt-6-astra
- 9.guía de Fastdevelopers.openai.com/api/docs/guides/fast-mode