OpenAI Codex: exceeded retry limit 429, 401 y Stream Disconnected
En Codex, «exceeded retry limit, last status: 429» no es el aviso de plan agotado, que usa otro texto. Mira paralelismo, incidencias y proxy antes de repetir.
En esta página
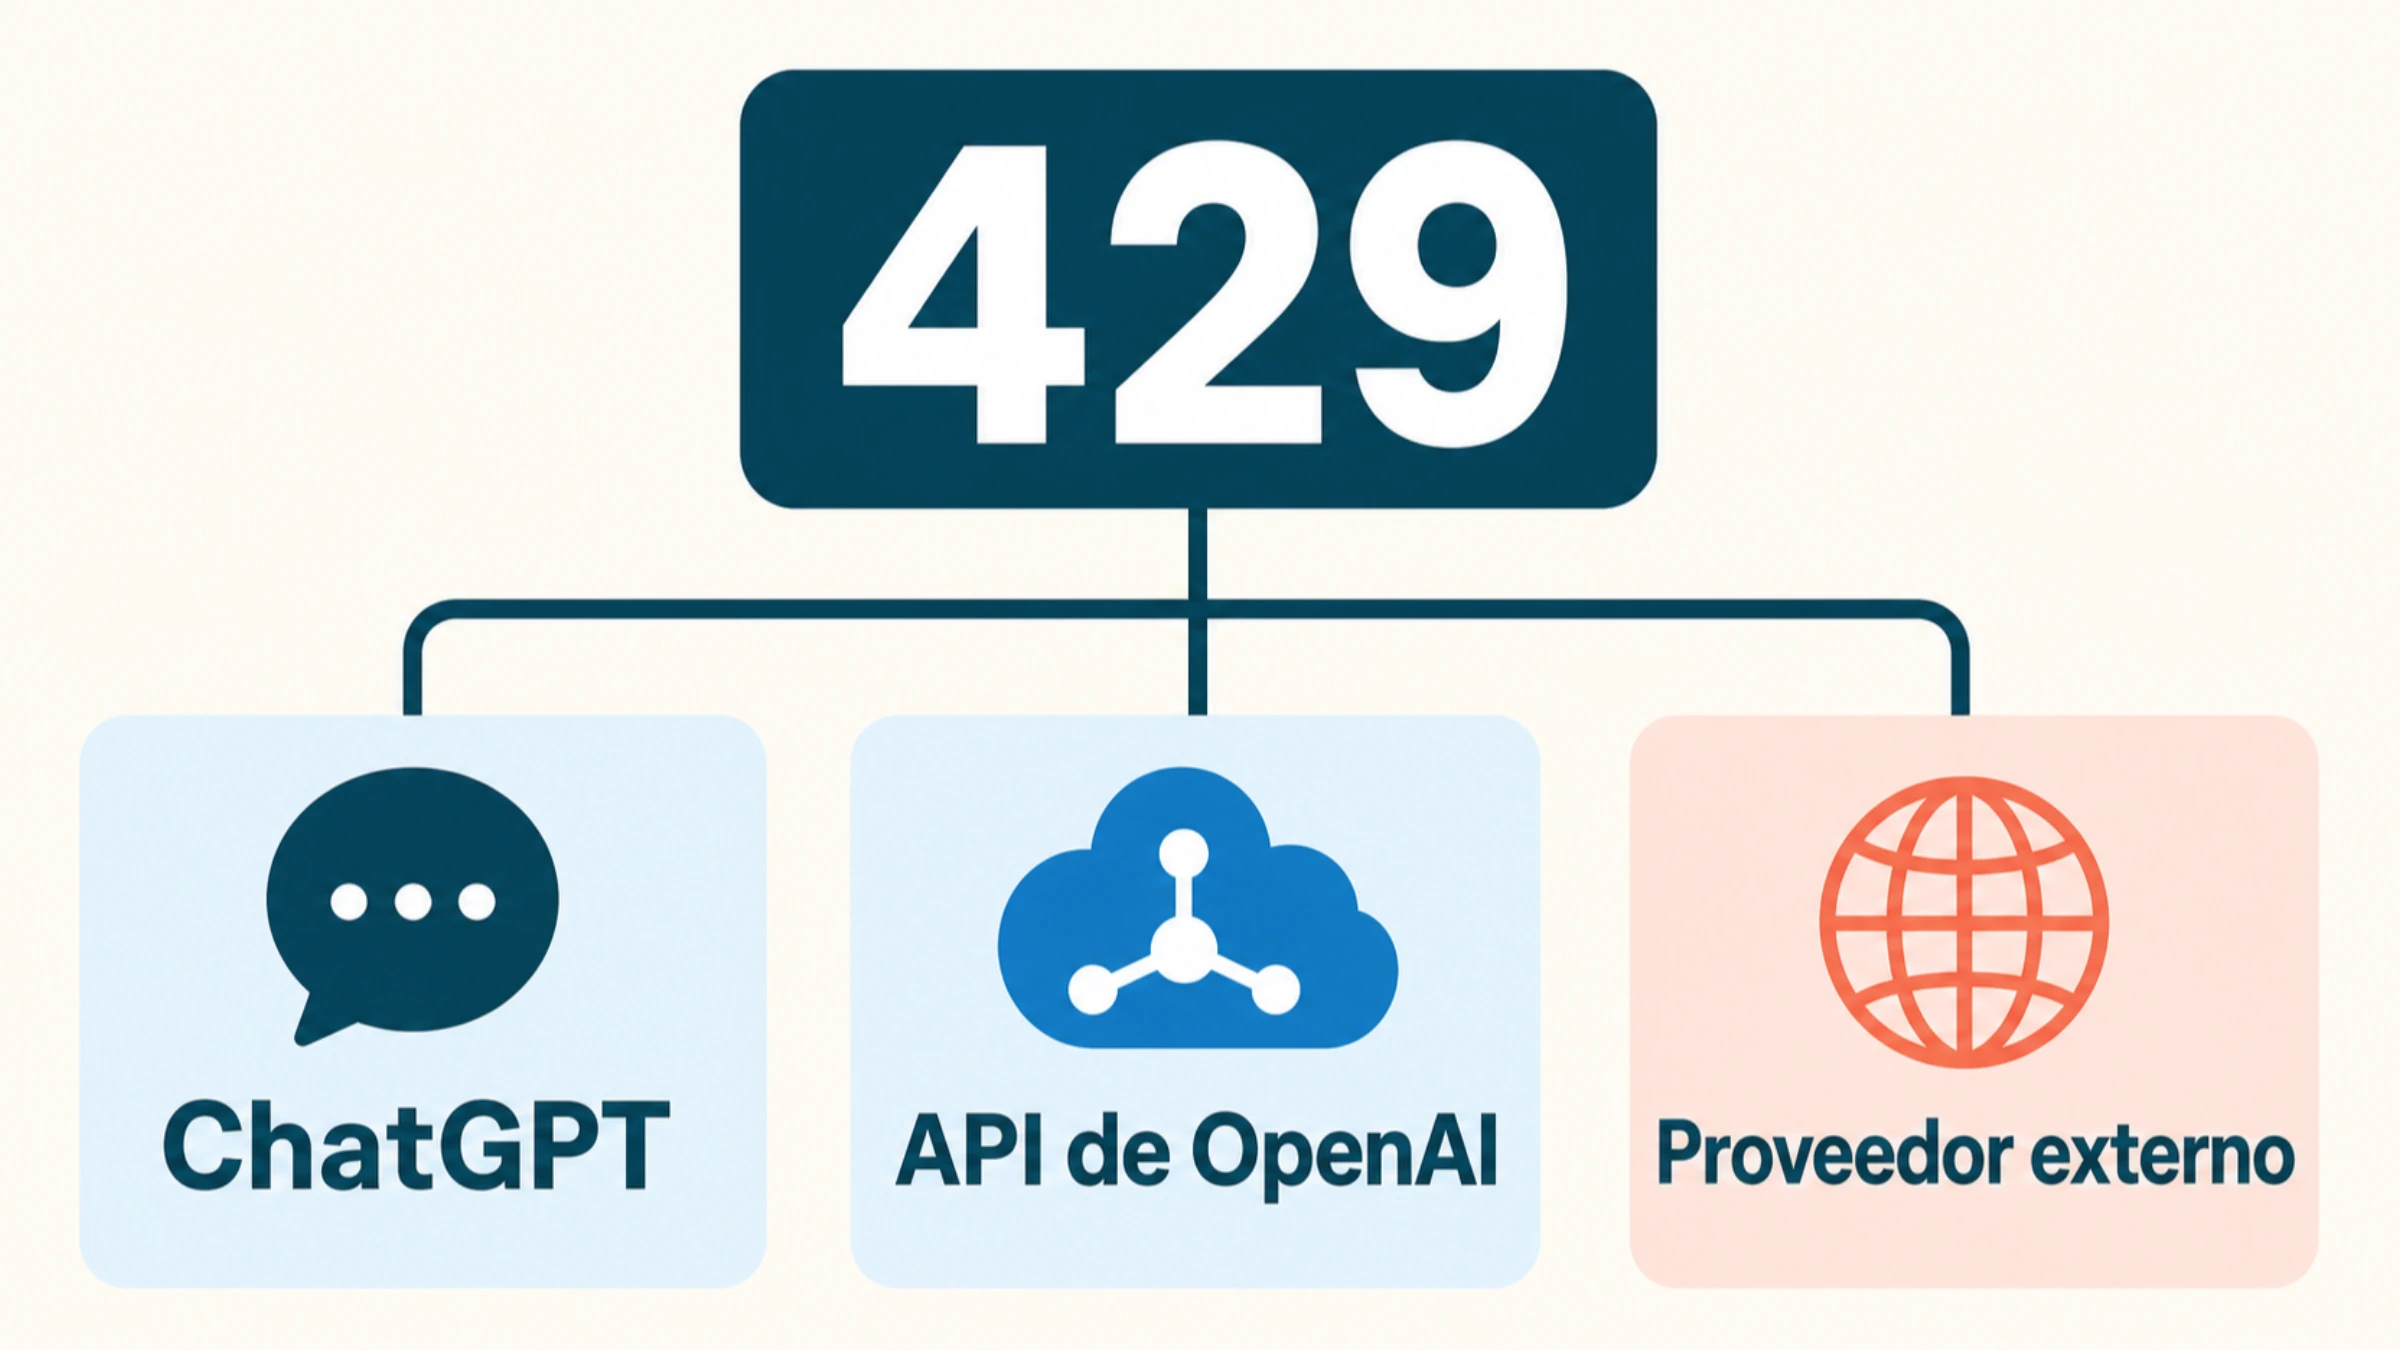
Una ejecución de OpenAI Codex puede terminar con mensajes distintos:
exceeded retry limit, last status: 429 Too Many Requests
stream disconnected before completion
exceeded retry limit, last status: 401 Unauthorized
Si ves la primera línea (a veces con , request id: … al final o precedida de «■»), el servidor de OpenAI, o un proxy que esté en medio, devolvió un 429 que Codex no reconoció como límite de uso de tu plan ni como falta de saldo. En el cliente actual de Codex (rust-v0.162.1, octubre de 2026), cuando se agota el uso del plan aparece otro texto: «You’ve hit your usage limit…», con la hora de reinicio si el servidor la envía. Así que esta cadena no te dice «has gastado tu plan», aunque tampoco demuestra que te quede uso disponible.
La palabra retry también engaña: en ese mismo cliente un 429 no se reintenta en la capa HTTP, y el turno solo se repite si el servidor indica una espera con Retry-After (por defecto, hasta 5 veces, es decir, 6 peticiones en total). Puede que no haya habido ningún reintento.
Lo útil en los dos primeros minutos: fíjate en el texto exacto y en su prefijo, cuenta cuántas sesiones o subagentes estaban trabajando a la vez, abre /status y mira la página de estado de OpenAI. Si con una sola sesión, sin subagentes y sin incidencia abierta el error vuelve, deja de reintentar y envía un informe con /feedback.
Qué significa exceeded retry limit, last status: 429 en Codex
Cuando Codex recibe un HTTP 429, primero lee el cuerpo de la respuesta y elige uno de estos mensajes. La lógica está en api_bridge.rs del repositorio openai/codex y los textos en error.rs del mismo repositorio:
| Texto que ves | Qué ha detectado el cliente | Qué hacer |
|---|---|---|
You’ve hit your usage limit… (a veces con Try again at …) | El servidor marcó el 429 como límite de uso del plan (usage_limit_reached) | Esperar al reinicio o comprar créditos; reintentar antes no sirve |
To use Codex with your ChatGPT plan, upgrade to Plus… | Tu plan no incluye Codex (usage_not_included) | Cambiar de plan o de forma de acceso |
Quota exceeded. Check your plan and billing details. | Cuota o gasto agotado: insufficient_quota, credit_balance_exhausted o límites de gasto o uso de la organización o del proyecto | Revisar facturación; reintentar no sirve |
exceeded retry limit, last status: 429 Too Many Requests | Cualquier otro 429: el cuerpo no encaja en los casos anteriores | Seguir el diagnóstico de las secciones siguientes |
La última fila es la del error que buscas. Indica que la respuesta que llegó a Codex no traía la marca de «plan agotado», pero no aclara qué la provocó: un límite de velocidad del servidor, una saturación temporal o un proxy que convierte otro fallo en su propio 429 pueden producir el mismo texto. El sufijo , request id: … solo aparece cuando la respuesta trae un identificador de seguimiento; guárdalo, porque es lo primero que se pide en un informe.
Otro aviso distinto es «Selected model is at capacity. Please try a different model.» (en español, algo como «el modelo seleccionado está al límite de su capacidad»). No es la cadena de reintentos: el propio mensaje propone cambiar de modelo.
Con versiones antiguas de Codex el reparto puede ser diferente, y el código cambia de una versión a otra. Si tu codex --version es antiguo, actualiza antes de sacar conclusiones.
Dos comprobaciones antes de modificar nada
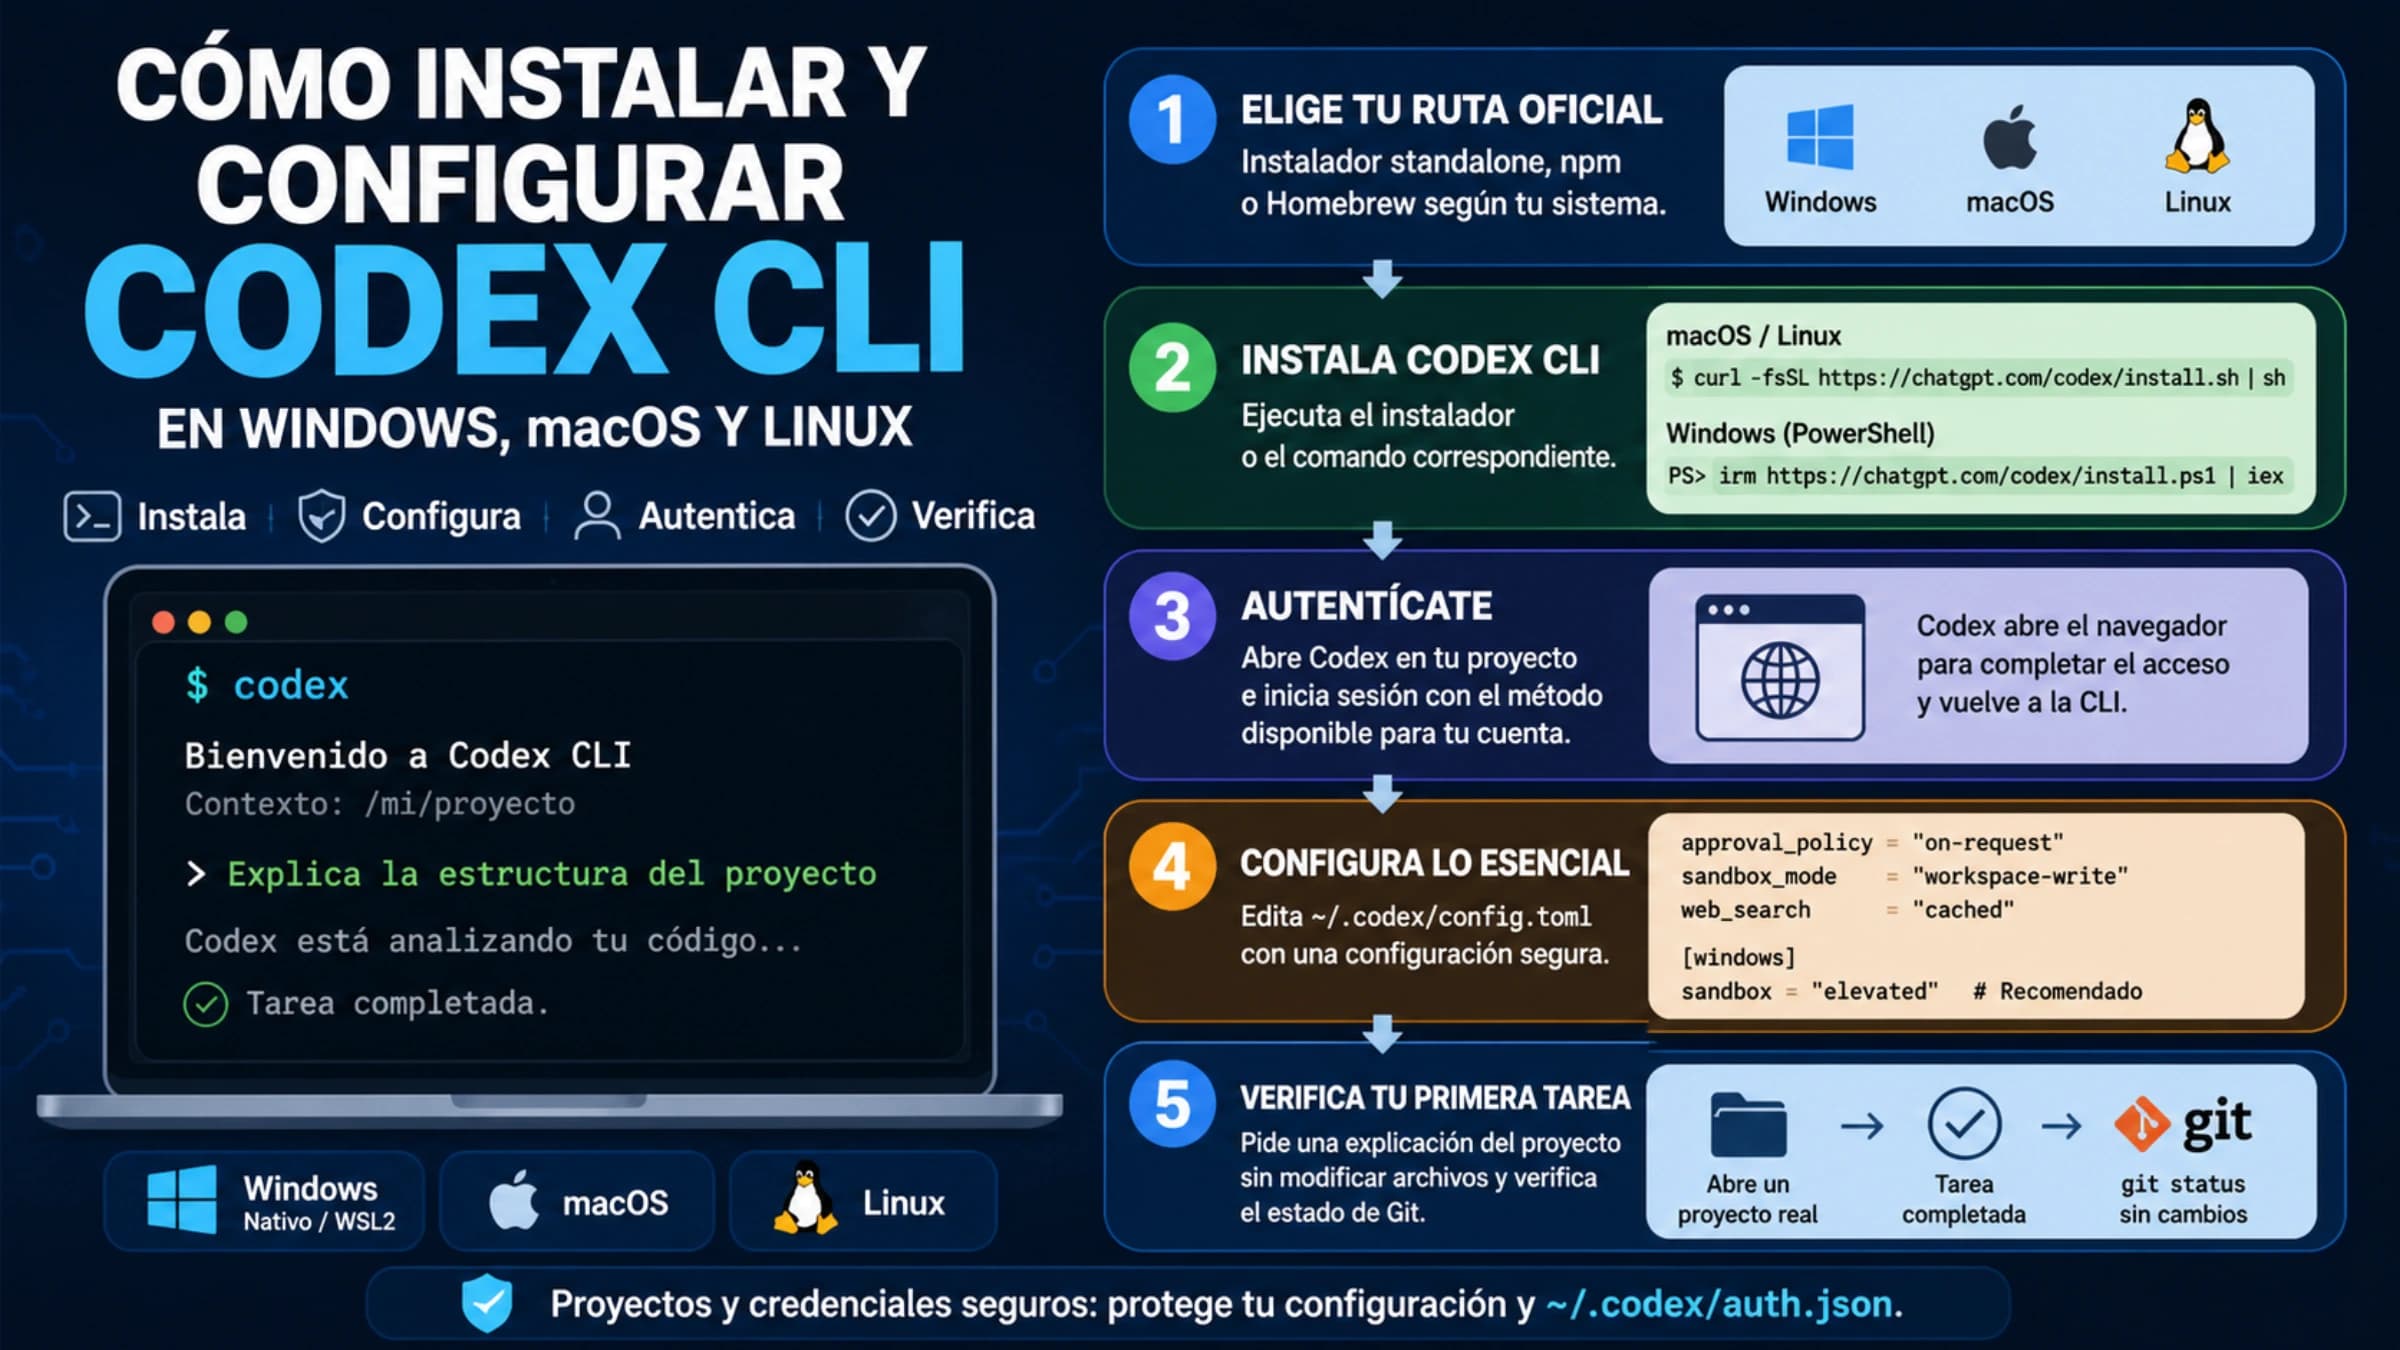
En Codex CLI, empieza con comandos de solo lectura:
codex --version
codex login status
codex login status dice si has iniciado sesión con ChatGPT o con una API key; no demuestra que todos los permisos posteriores sean válidos. Dentro de una sesión activa, /status muestra el ID del chat, el uso de contexto y los límites restantes, según la referencia de comandos con barra de Codex. Con inicio de sesión de ChatGPT, /usage abre la configuración de uso y facturación.
Guarda el mensaje completo con su prefijo, la hora y zona horaria, la superficie (CLI, app de escritorio o extensión del IDE), el modelo, el request id y cuántas sesiones o subagentes estaban trabajando en ese momento. Si usas un proveedor personalizado (custom provider), confirma también qué proveedor y qué base URL atendieron la petición, sin imprimir credenciales ni el fichero de configuración completo.
La clasificación de errores de Codex App Server separa Unauthorized, los fallos HTTP del servicio de origen, ResponseStreamConnectionFailed, ResponseStreamDisconnected y ResponseTooManyFailedAttempts. Aunque tu interfaz solo muestre la última línea, conviene conservar esas categorías por separado.
Qué cuenta y qué provider son responsables
El mismo 429 tiene lecturas distintas según cómo hayas iniciado sesión:
| Forma de acceso | Dónde mirar | Lo que no sirve como prueba |
|---|---|---|
| Codex con cuenta de ChatGPT | /status, /usage, sesiones y subagentes activos, página de estado | saldo o límites RPM/TPM de OpenAI Platform |
| OpenAI API key | error estructurado, organización y proyecto, facturación y límites de Platform | el estado de tu suscripción Plus o Pro |
| Proxy, intermediario o proveedor propio | registros del proxy, cuenta del proveedor, base URL efectiva | un panel de OpenAI que nunca recibió la petición |
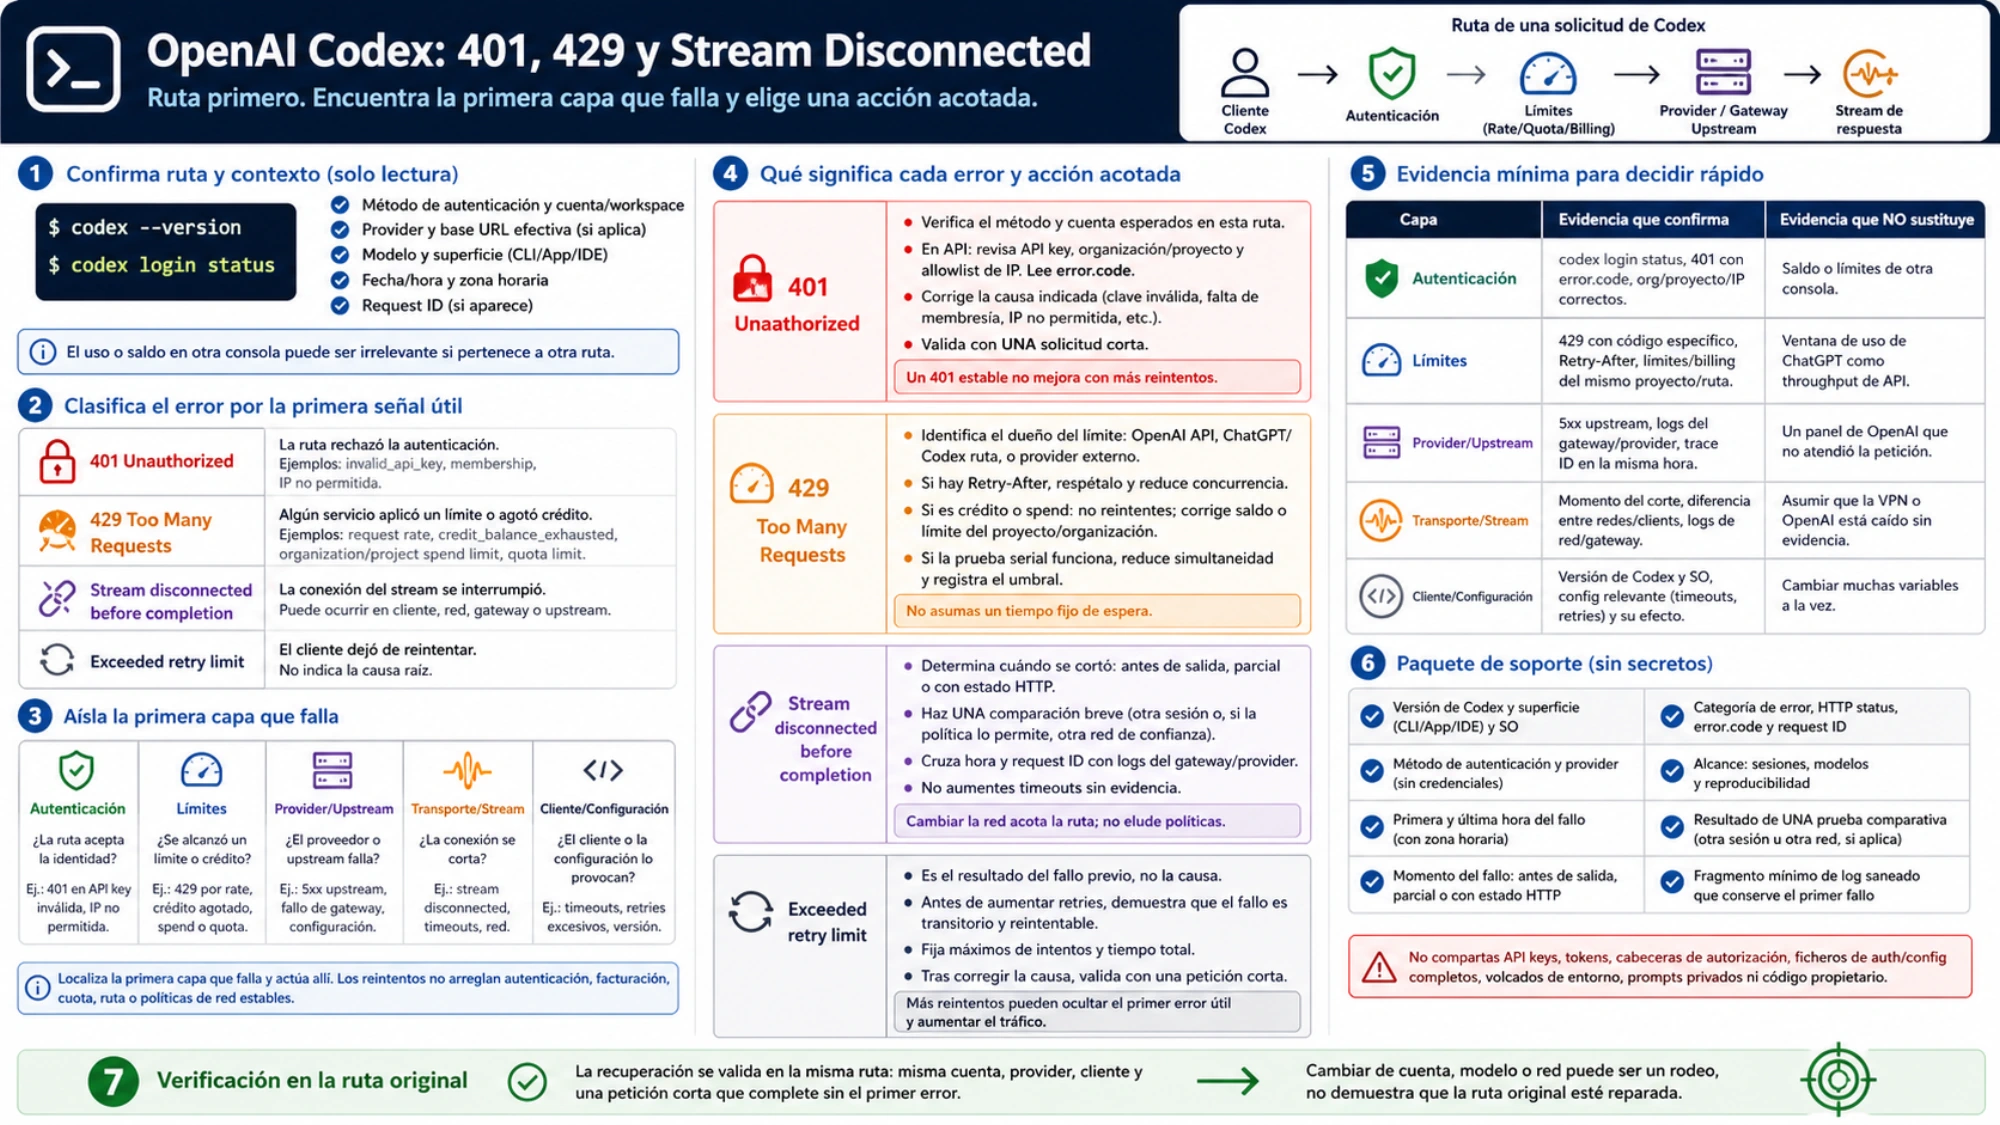
Este gráfico es anterior a la actualización de octubre de 2026; el texto está al día.
Un panel puede mostrar «uso disponible» y no tener nada que ver con el fallo si corresponde a otra forma de acceso. Alinea el método de autenticación, el proveedor y la consola que estás consultando antes de decidir.
Error 429 en Codex: identifica quién lo devolvió antes de esperar
Recorre estas preguntas en orden; la primera que encaje suele decidir la acción:
- ¿El texto es «You’ve hit your usage limit» o «Quota exceeded»? Entonces no es este error. Es el límite del plan o la facturación: consulta Límite semanal de Codex: cuándo se restablece y cómo seguir.
- ¿Empieza por «Error running remote compact task:» o «Automatic approval review failed:»? Falló una tarea auxiliar, no tu turno principal. Ve a la tabla de variantes más abajo.
- ¿Había varias sesiones, chats o subagentes trabajando a la vez? Reduce a uno y repite una sola vez.
- ¿La página de estado muestra una degradación de Codex a esa hora? Espera a que se resuelva en lugar de lanzar la tarea en bucle.
- ¿Usas una API key? Pasa a los límites de OpenAI Platform.
- ¿Pasas por un proxy, intermediario o proveedor propio? Mira primero sus registros.
- ¿Nada de lo anterior y el error vuelve con una sola sesión? Deja de reintentar y prepara el informe.
Varias sesiones o subagentes a la vez
Es el patrón de varios informes recientes con cuenta de ChatGPT: las peticiones de una sola sesión funcionan y el 429 aparece al sumar trabajo en paralelo, con el medidor de uso lejos de cero. En el issue #41702 de openai/codex, abierto el 30 de agosto de 2026, un usuario Pro describe 429 repetidos con 4–5 subagentes repartidos entre dos sesiones, y señala que el límite parece aplicarse a toda la cuenta, no por sesión. El 14 de octubre de 2026 llegaron varios informes parecidos: en el issue #54017 falla el tercer chat simultáneo de la app de escritorio con el medidor semanal al 57 %; en el issue #54010, la CLI en WSL falla con 3 sesiones activas y un 69 % restante; en el issue #53978, la app de Windows falla con cerca de un 70 % del uso semanal disponible.
Son informes de usuarios, no una regla publicada. A 15 de octubre de 2026 OpenAI no ha publicado un límite de concurrencia para Codex ni ha respondido en esos issues, y la documentación de precios no menciona subagentes ni tareas paralelas. No tomes ninguna de esas cifras como el tope de tu cuenta.
Lo que sí puedes probar:
- Cierra los chats paralelos o espera a que terminen los subagentes y repite la petición en una sola sesión.
- Si lanzas subagentes, baja
agents.max_concurrent_threads_per_sessionenconfig.toml. La referencia de configuración de Codex la define como el máximo de hilos de agentes abiertos a la vez, sin contar el principal. Es un tope del cliente: sirve para comprobar si el paralelismo es el problema, no garantiza que el servidor acepte esa carga. - Si con una sola sesión funciona y con varias falla, anota el número de sesiones o subagentes con el que empieza a fallar. Ese dato es lo más útil para un informe.
Si tienes Pro y te preguntas si es tu límite: la página de precios de Codex indica que Pro no tiene ahora límite de cinco horas, aunque puede aplicarse un límite semanal. Para ver lo que te queda y cuándo se reinicia, consulta Límites de Codex en ChatGPT Pro: cómo comprobar uso y reset; en Plus, Límites de Codex en ChatGPT Plus: ventana de 5 horas y créditos.
Degradación del servicio en status.openai.com
La misma cadena ha tenido causas del lado del servicio. En enero de 2026 un mantenedor de OpenAI cerró el issue #9135 diciendo que la causa de fondo estaba resuelta y que cualquier repetición posterior era otro problema que debía reportarse con /feedback. El 3 de junio de 2026 se abrieron muchos issues idénticos que se cerraron en dos días.
En el historial de status.openai.com constan degradaciones de Codex el 13 y el 14 de octubre de 2026, ya resueltas, y varios episodios de errores elevados el 6 de octubre. Ninguno de esos avisos menciona el 429, y la oleada de informes del 14 de octubre coincide en fecha con una de esas degradaciones sin que nadie haya confirmado la relación. Si ves una incidencia abierta a la hora de tu fallo, espera a que se marque como resuelta y repite una petición corta. No hay un tiempo de recuperación publicado; desconfía de cualquier cifra fija de minutos.
Inicio de sesión con API key
Con una API key, Codex se factura a precios de la API y los límites de los planes de ChatGPT no se aplican, según la página de precios de Codex. Un 429 de OpenAI Platform puede ser un límite de velocidad temporal, saldo prepago agotado o un límite de gasto o uso. Los códigos de saldo y gasto los muestra Codex como «Quota exceeded», así que la cadena exceeded retry limit con API key apunta más bien a otros 429, como el límite de velocidad. Lee el detalle en Error 429 en OpenAI API: cómo identificar la causa y recuperar el servicio.
Pasarte a una API key para esquivar un 429 con cuenta de ChatGPT no es gratis: cambias a otros límites y pagas cada token.
Proxy, intermediario o proveedor propio
Un proxy puede devolver su propio 429 aunque el fallo real sea otro. En proyectos de terceros hay casos documentados: CLIProxyAPI registró un error 520 del servicio de origen como 429, y con CC Switch se repetían 429 cuando el fallo de fondo era un 400 por conversión de tool_call_id. En esos casos la cadena de Codex solo describe lo que dijo el proxy.
El mensaje «Codex account warmup failed. Reauthenticate the account and try again.», a veces con (http_status:429), no existe en el código de openai/codex: lo emiten proxies de terceros que agrupan varias cuentas. Si lo ves, el problema está en ese proxy y en sus cuentas, no en tu instalación de Codex.
Revisa los registros del proxy a la misma hora y, si puedes, repite una petición corta por el acceso oficial. Para revisar qué base URL usa Codex, consulta Custom Provider en Codex: API Key, Base URL y config.toml.
Variantes del mensaje: remote compact task, auto-review y account warmup
| Texto completo | Qué falló | Qué hacer |
|---|---|---|
■ exceeded retry limit, last status: 429 Too Many Requests | Lo mismo que la cadena sin símbolo; «■» no cambia el significado | Diagnóstico de la sección anterior |
…, request id: req_… | La misma cadena con el identificador de la petición | Guárdalo para /feedback |
Error running remote compact task: exceeded retry limit, last status: 429… | La compactación del contexto en el servidor, que Codex ya no usa | Actualiza Codex; si persiste, /feedback |
Automatic approval review failed: exceeded retry limit, last status: 429… | La petición de revisión automática de aprobaciones (codex-auto-review), no tu turno | La acción no se ejecutó; repítela más tarde |
Codex account warmup failed… (http_status:429) | Un proxy de terceros con cuentas agrupadas | Revisa ese proxy |
Sobre la compactación: el 29 de junio de 2026 un mantenedor de OpenAI explicó en el issue #15468 que la compactación pasó a ejecutarse en local con el mismo servicio que los turnos normales, lo que elimina los errores de «remote compaction», y pidió abrir un informe nuevo con /feedback si aparecen otros problemas. Si todavía ves ese prefijo, tu cliente es anterior al cambio.
Sobre la revisión automática: en el issue #53324, del 12 de octubre de 2026, el mensaje completo añade que la acción no se ejecutó porque la revisión no pudo completarse, y que eso no es un juicio de que la acción sea insegura. El chat normal seguía funcionando. OpenAI no ha dado una solución. Desactivar temporalmente la revisión automática puede servir para comprobar si el 429 viene solo de ella, pero entonces las acciones dejan de pasar por esa revisión; no lo dejes así como arreglo.
Error 401: cambia el estado de autenticación, no el número de reintentos
En OpenAI Platform, un 401 puede significar autenticación inválida, API key incorrecta, falta de pertenencia a la organización o una IP que no coincide con la lista permitida. La referencia de códigos de error de la API de OpenAI distingue estas causas. Lee error.code y confirma que miras el mismo proyecto antes de actuar.
Con cuenta de ChatGPT, comprueba si codex login status muestra el método y la cuenta esperados. Volver a iniciar sesión tiene sentido cuando la sesión guardada está realmente invalidada o se ha seleccionado otra cuenta. No es una prueba inocua: codex logout elimina las credenciales guardadas. La guía de autenticación de Codex también distingue workload identity, que depende del entorno del proceso.
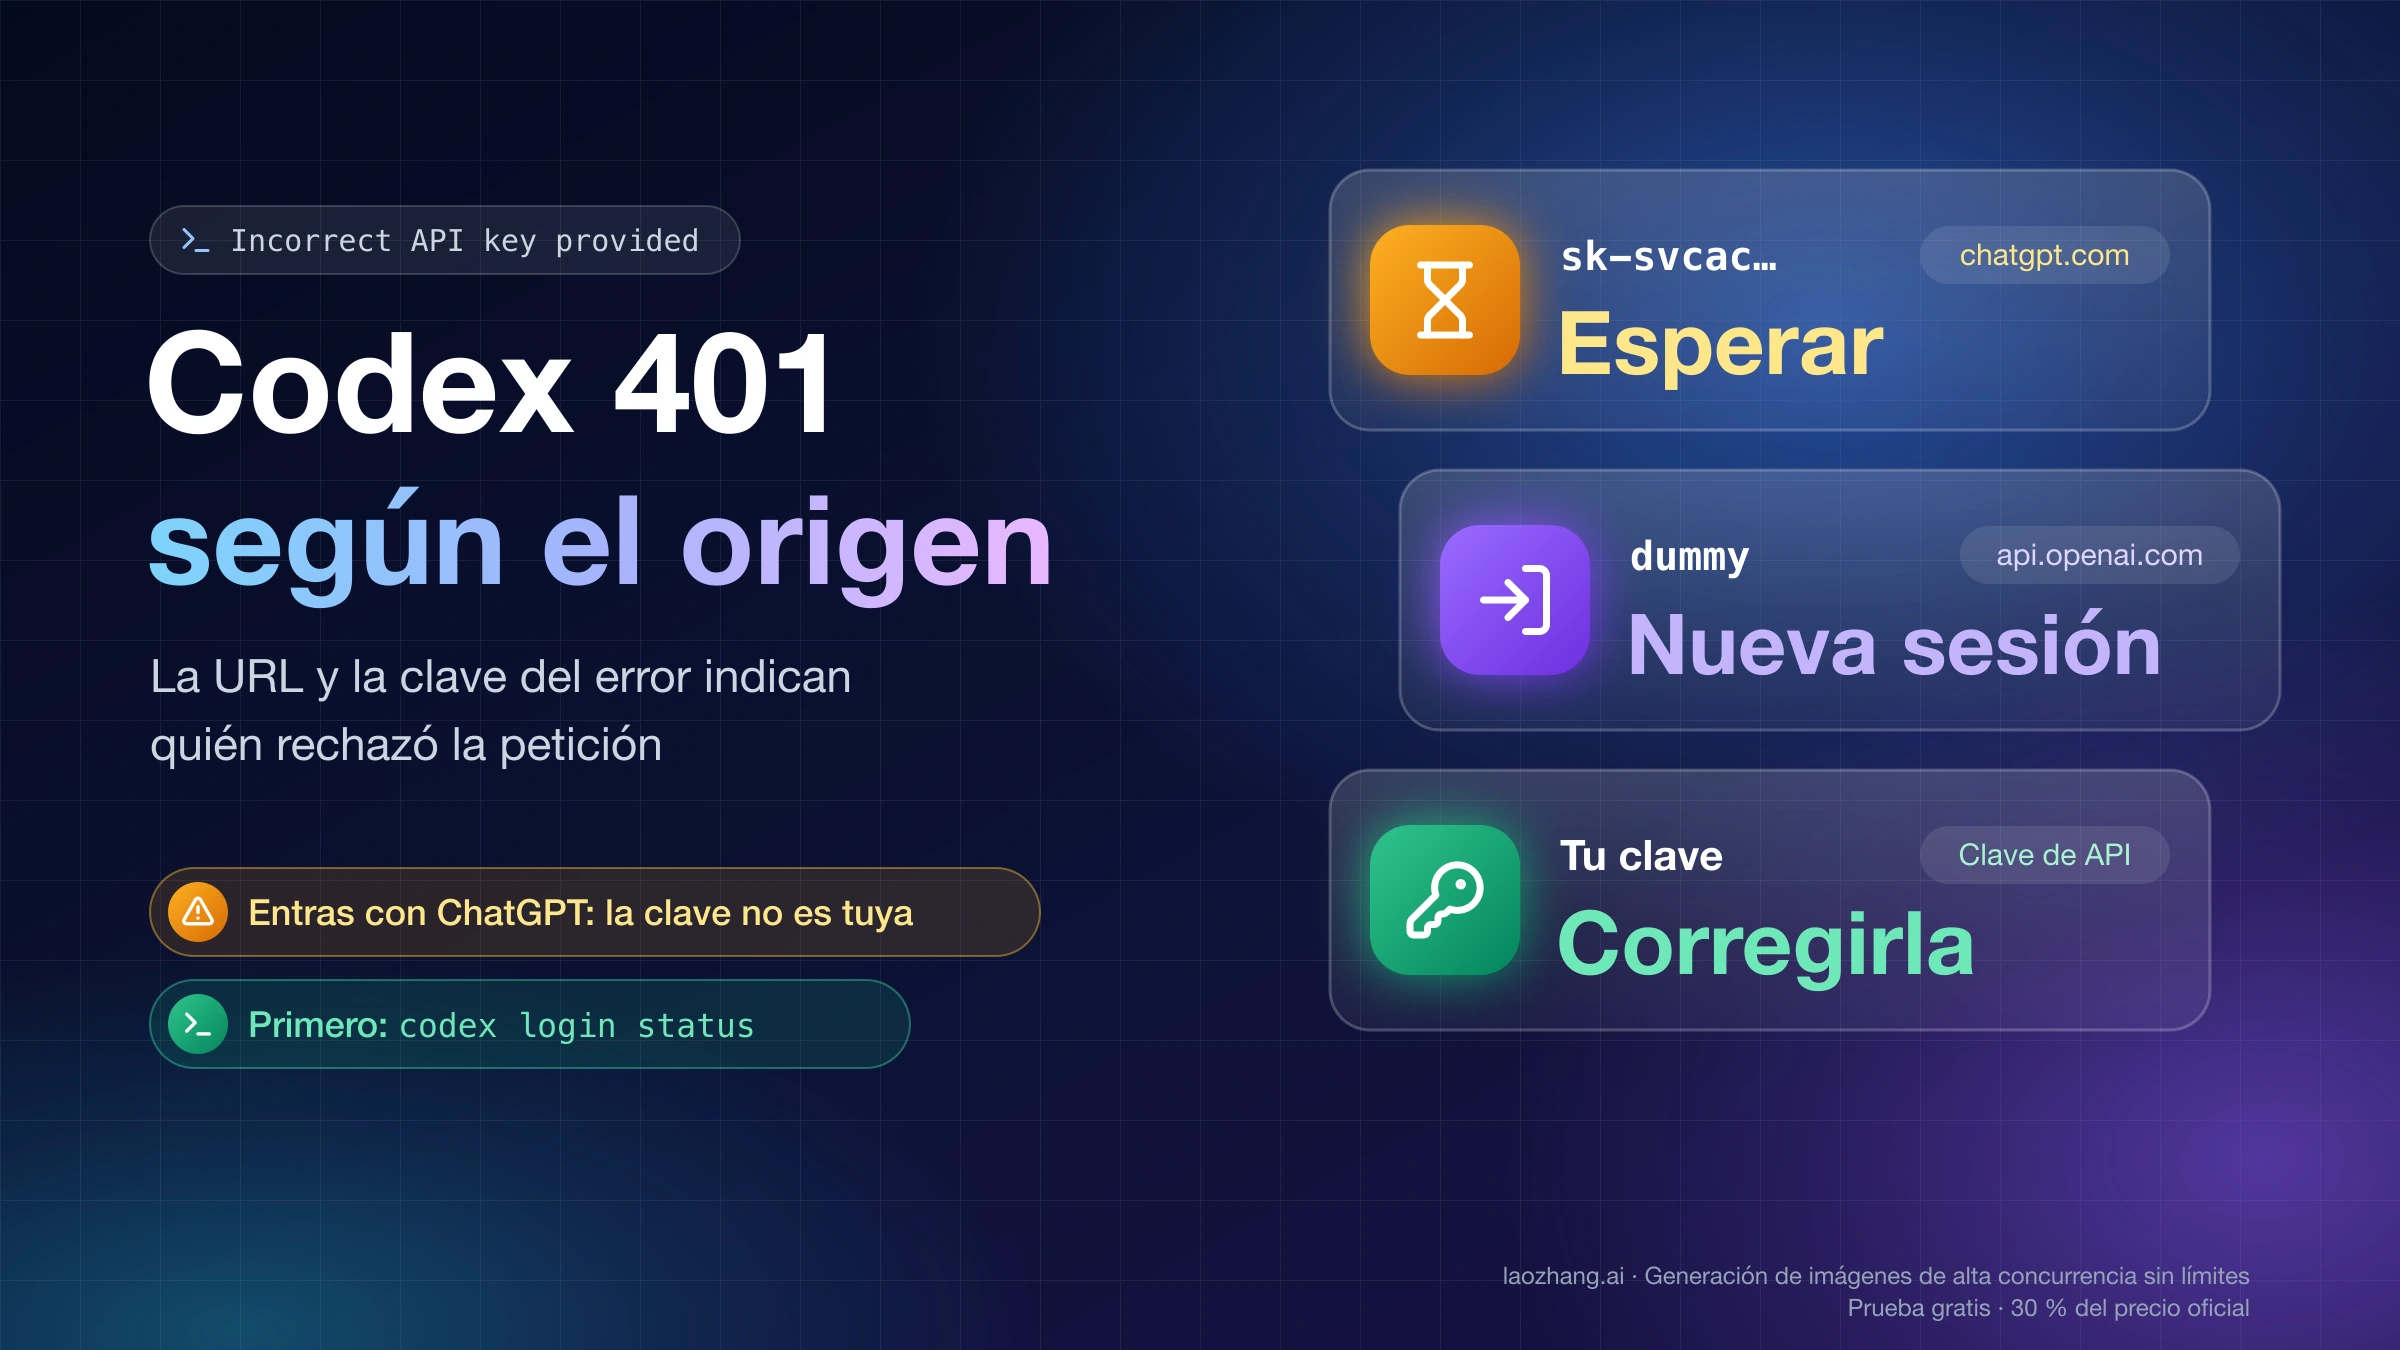
Con una API key, confirma que el proceso usa una clave del mismo endpoint, organización, proyecto y política de IP que estás revisando, sin mostrar la clave, el entorno completo ni auth.json. Corrige lo que indique el error y haz una sola petición corta. Un 401 estable no mejora esperando. Si el texto es Incorrect API key provided, sigue Codex 401 Incorrect API key provided: solución según el origen.
Detrás de un proxy, el 401 puede venir del acceso al proxy o del servicio al que este reenvía la petición. Cruza el request id con los registros de la misma hora. Si el proxy aceptó tu credencial pero falló al autenticarse más allá, rotar tu clave no arregla nada.
Stream disconnected: averigua cuándo se interrumpió
Un stream puede cortarse en el cliente, en un proxy o en una inspección TLS, en una red gestionada, en el servicio de origen o durante un cambio de red local. El texto por sí solo no demuestra que la causa sea una VPN ni que OpenAI esté caído. Si después de stream disconnected before completion: aparece un motivo concreto, como falta de créditos, ese motivo manda sobre el corte.
Haz una única comparación pequeña:
- Abre una sesión nueva con la misma cuenta, proveedor, modelo y una petición breve sin datos sensibles.
- Anota si falla antes de cualquier salida, después de una respuesta parcial o con un estado HTTP explícito.
- Solo si la política de tu empresa lo permite, repite esa misma petición una vez en otra red de confianza.
- Cruza hora y
request idcon los registros del proxy o del proveedor. - Si solo falla un cliente o una versión, anota la diferencia y no cambies varias cosas a la vez.
Que otra red funcione acota el problema; no autoriza a desactivar controles de seguridad corporativos. Si ambas redes fallan a la vez, pesan más la cuenta, el proveedor y la página de estado.
No subas stream_idle_timeout_ms (300.000 ms por defecto) como primera medida. Un timeout solo cambia cuánto espera el cliente: no corrige una base URL equivocada, un 401, créditos agotados ni una conexión cerrada a propósito por un proxy.
Aumentar retries no cambia el 429: retry_429 está desactivado
En el código actual de Codex (rust-v0.162.1), la política de reintentos HTTP de los proveedores se construye con retry_429: false, mientras que los errores 5xx y de transporte sí se reintentan, según model-provider-info en openai/codex. request_max_retries (4 por defecto) y stream_max_retries (5 por defecto) admiten hasta 100, pero ninguno añade reintentos para un 429 que llega sin Retry-After. A nivel de turno, el error de reintentos agotados solo se repite tras la espera que indique el servidor en Retry-After, y en ese caso el número de repeticiones lo marca stream_max_retries; sin esa cabecera, el turno termina. Para el 429 a secas que describen los usuarios con sesión de ChatGPT, subir estos números no sirve. En el issue #42685, el autor no encontró Retry-After en los registros de sus 429.
El issue #30471, abierto el 28 de junio de 2026, pide que Codex reintente los 429 o que cambie el mensaje. Sigue abierto y sin respuesta de OpenAI. Cualquier «ajuste de una línea» que suba el número de reintentos no afecta a este error.
Subir los reintentos sí cambia algo en fallos 5xx o de red: puede alargar un fallo que no es temporal, multiplicar el tráfico si un proxy también reintenta y ocultar el primer error útil. Solo tiene sentido cuando has demostrado una condición temporal de transporte y has fijado un máximo de intentos y de tiempo total. La referencia de configuración de Codex recuerda además que model_providers y las claves de proveedor y autenticación son ajustes de usuario; un .codex/config.toml del proyecto no los sustituye.
Prueba local: qué hace Codex con un 429 a secas, con Retry-After y con un 5xx
Qué se ejecutó: Codex CLI 0.162.0-alpha.17.2 (la versión incluida en la app de escritorio de ChatGPT), con un CODEX_HOME desechable y un proveedor propio en model_providers cuyo base_url apuntaba a un pequeño servidor Python en el mismo ordenador. Ese servidor contestaba a cada POST /v1/responses con un estado fijo, un cuerpo JSON y la cabecera x-request-id, y anotaba cada petición recibida. Cada escenario se lanzó una sola vez con este comando:
codex exec --skip-git-repo-check "say hi" < /dev/nullQué no se ejecutó: el inicio de sesión con ChatGPT, así que no se vio ninguna respuesta real de OpenAI; una API key contra la API real; proxies o intermediarios; la app de escritorio y la extensión del IDE; los cuerpos que Codex sí reconoce (límite de uso, cuota) y los cortes de conexión a mitad de respuesta. La prueba muestra cómo reacciona el cliente ante una respuesta concreta, no qué devuelven los servidores de OpenAI a una cuenta de ChatGPT, y cubre una sola versión.
| Respuesta del servidor de prueba | Ajuste en el proveedor | Peticiones recibidas | Lo que mostró Codex |
|---|---|---|---|
429 con code rate_limit_exceeded, sin Retry-After | por defecto | 1, en 0,3 s | exceeded retry limit, last status: 429 Too Many Requests, request id: req_mock_429_test |
| El mismo 429 | request_max_retries = 10 y stream_max_retries = 10 | 1, en 0,15 s | La misma línea |
429 con Retry-After: 3 | por defecto | 6, separadas exactamente 3 s (15 s en total) | Reconnecting... 1/5 … 5/5 y, al final, la misma línea del 429 |
429 con Retry-After: 3 | stream_max_retries = 2 | 3, cada 3 s | Reconnecting... 1/2, 2/2 y la misma línea del 429 |
| 503 | por defecto | 30, en unos 24 s | unexpected status 503 Service Unavailable: server overloaded, url: …/v1/responses, request id: … |
| 500 | por defecto | 30, en unos 25 s | We’re currently experiencing high demand, which may cause temporary errors. |
Lo que se deduce de esos resultados:
- El 429 sin
Retry-Afterno se reintentó ni una vez. La líneaexceeded retry limit, last status: 429apareció tras una única petición, y subir los dos ajustes a 10 no añadió ninguna. La palabra retry del mensaje no significa que haya habido varios intentos. - Con
Retry-After, Codex esperó justo lo indicado y repitió el turno tantas veces como marcastream_max_retries. El mensaje final fue idéntico; la diferencia está en las líneasReconnecting... n/5que lo preceden en la CLI. Si en tu terminal el 429 aparece sin esas líneas antes, en esta versión eso indica que el servidor no envió una espera. - Un 5xx real se reintenta mucho más: 5 intentos HTTP con espera creciente en cada una de 6 rondas, 30 peticiones en total, y termina con otro texto. Ni el 503 ni el 500 produjeron
exceeded retry limit, last status: 500; según el código, esa variante sale del límite de reintentos de la capa de red de Codex, que se notifica como un 500 sin request id; esta prueba no llegó a ese caso.
La conclusión práctica para quien usa Codex con cuenta de ChatGPT no cambia: con el 429 a secas, el cliente se rinde a la primera y tocar los reintentos no sirve. Lo que no se sabe es si OpenAI envía Retry-After en esos 429; el autor del issue #42685 no lo encontró en sus registros. Para montar tú un proveedor propio como el de la prueba, mira Custom Provider en Codex: API Key, Base URL y config.toml.
Si lo reproduces en un script, cierra la entrada estándar con < /dev/null. Sin eso, codex exec muestra Reading additional input from stdin... y se queda esperando sin enviar ninguna petición, lo que parece un bloqueo de red y no lo es.
Cuándo dejar de reintentar el 429 en Codex
Reintentar a mano tiene sentido una vez, después de cambiar algo que pueda explicar el fallo. Para:
- De inmediato, si el texto es «You’ve hit your usage limit» o «Quota exceeded»: solo cambia con el reinicio, créditos o facturación.
- Tras una sola prueba con un único stream: si funciona, el paralelismo era el problema; vuelve a escalar poco a poco. Si falla igual, no repitas.
- Mientras haya una incidencia abierta: espera a que la página de estado la marque como resuelta.
- Si falla en una sesión nueva, con el cliente actualizado, sin trabajo en paralelo y sin incidencia: ya no hay nada que probar desde tu lado. Envía
/feedbackcon registros y abre un issue nuevo si hace falta.
No dejes scripts o tareas relanzándose en bucle contra un 429. Si el límite es de velocidad, solo lo prolongas.
Qué incluir al escalar el problema
/feedback abre el cuadro de comentarios y permite adjuntar registros. Prepara un informe si la petición mínima falla en sesiones nuevas, si el medidor de uso contradice el error o si solo una combinación de versión y proveedor reproduce el fallo:
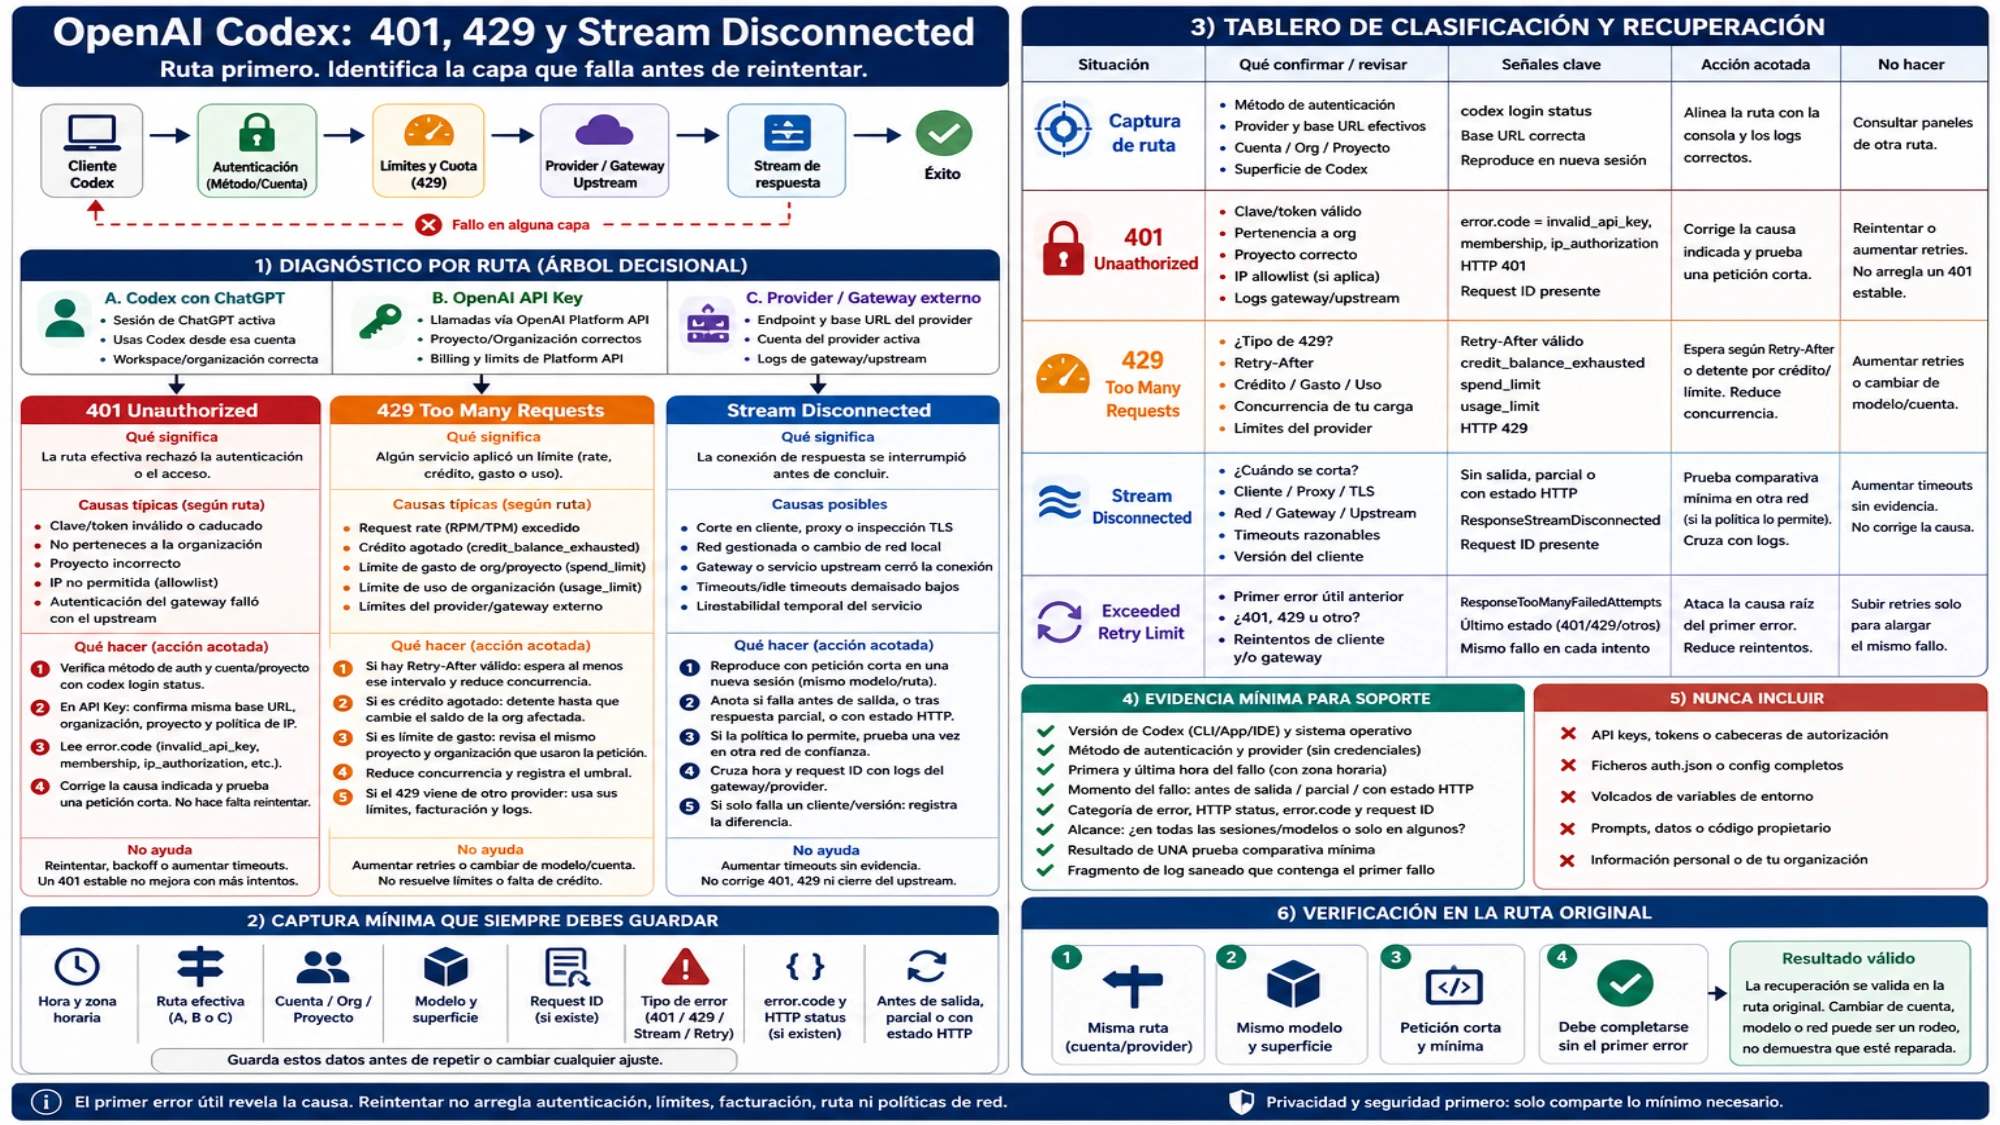
- el texto completo del error, con su prefijo y el
request id; - versión de Codex, superficie (CLI, app o IDE) y sistema operativo;
- método de autenticación y proveedor, sin credenciales;
- primera y última hora del fallo con zona horaria;
- cuántas sesiones, chats o subagentes trabajaban a la vez y qué mostraba
/status; - si ocurrió antes de la primera salida o tras una respuesta parcial;
- resultado de la prueba con una sola sesión;
- fragmento mínimo de registro, sin datos sensibles, que conserve el primer fallo.
No envíes API keys, tokens, cabeceras de autorización, ficheros de autenticación o configuración completos, volcados de entorno, prompts privados ni código propietario.
La recuperación se comprueba en las mismas condiciones del fallo: misma cuenta, proveedor, cliente y una petición corta que termine sin el error. Cambiar de cuenta, modelo o red puede servir para seguir trabajando, pero no demuestra que el problema original esté resuelto.
Preguntas frecuentes sobre el error 429 en Codex
¿Cómo quitar el error 429 exceeded retry limit en Codex?
No hay un ajuste que lo elimine. Reduce el trabajo a una sola sesión sin subagentes, comprueba la página de estado, actualiza Codex y repite una petición corta. Si sigue fallando así, envía /feedback con el request id. Subir request_max_retries no cambia nada para un 429.
¿Exceeded retry limit significa que he agotado mi plan Plus o Pro?
No directamente. En el cliente actual, el plan agotado se anuncia con «You’ve hit your usage limit» y, si el servidor la envía, con la hora de reinicio. La cadena exceeded retry limit indica otro tipo de 429, aunque tampoco garantiza que te quede uso: revísalo con /status.
¿Cuánto tiempo hay que esperar tras un 429 en Codex?
Solo hay una hora fiable cuando el mensaje incluye «Try again at…». Con la cadena exceeded retry limit no hay un plazo publicado: si hay una incidencia abierta, espera a que se resuelva; si no, cambia algo (menos paralelismo, cliente actualizado) antes de repetir.
Fuentes19
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 15 oct 2026.
Fuentes19
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 15 oct 2026.
- 1.la página de estado de OpenAIstatus.openai.com/history
- 2.api_bridge.rs del repositorio openai/codexgithub.com/openai/codex/blob/rust-v0.162.1/codex-rs/codex-api/src/api_bridge.rs
- 3.error.rs del mismo repositoriogithub.com/openai/codex/blob/rust-v0.162.1/codex-rs/protocol/src/error.rs
- 4.referencia de comandos con barra de Codexlearn.chatgpt.com/codex/reference/slash-commands
- 5.clasificación de errores de Codex App Serverlearn.chatgpt.com/docs/app-server
- 6.issue #41702 de openai/codexgithub.com/openai/codex/issues/41702
- 7.issue #54017github.com/openai/codex/issues/54017
- 8.issue #54010github.com/openai/codex/issues/54010
- 9.issue #53978github.com/openai/codex/issues/53978
- 10.referencia de configuración de Codexlearn.chatgpt.com/docs/config-file/config-reference
- 11.página de precios de Codexlearn.chatgpt.com/docs/pricing
- 12.issue #9135github.com/openai/codex/issues/9135
- 13.issue #15468github.com/openai/codex/issues/15468
- 14.issue #53324github.com/openai/codex/issues/53324
- 15.referencia de códigos de error de la API de OpenAIdevelopers.openai.com/api/docs/guides/error-codes
- 16.guía de autenticación de Codexlearn.chatgpt.com/docs/auth
- 17.model-provider-info en openai/codexgithub.com/openai/codex/blob/rust-v0.162.1/codex-rs/model-provider-info/src/lib.rs
- 18.issue #42685github.com/openai/codex/issues/42685
- 19.issue #30471github.com/openai/codex/issues/30471