Coste de tokens de Codex CLI: estima el gasto diario de API antes de una tarea larga
Para prever el gasto diario de Codex CLI, calcula cada petición con su modelo, velocidad y contexto, y suma el trabajo previsto. La lectura y la escritura de caché ya forman parte de la entrada total.
En esta página
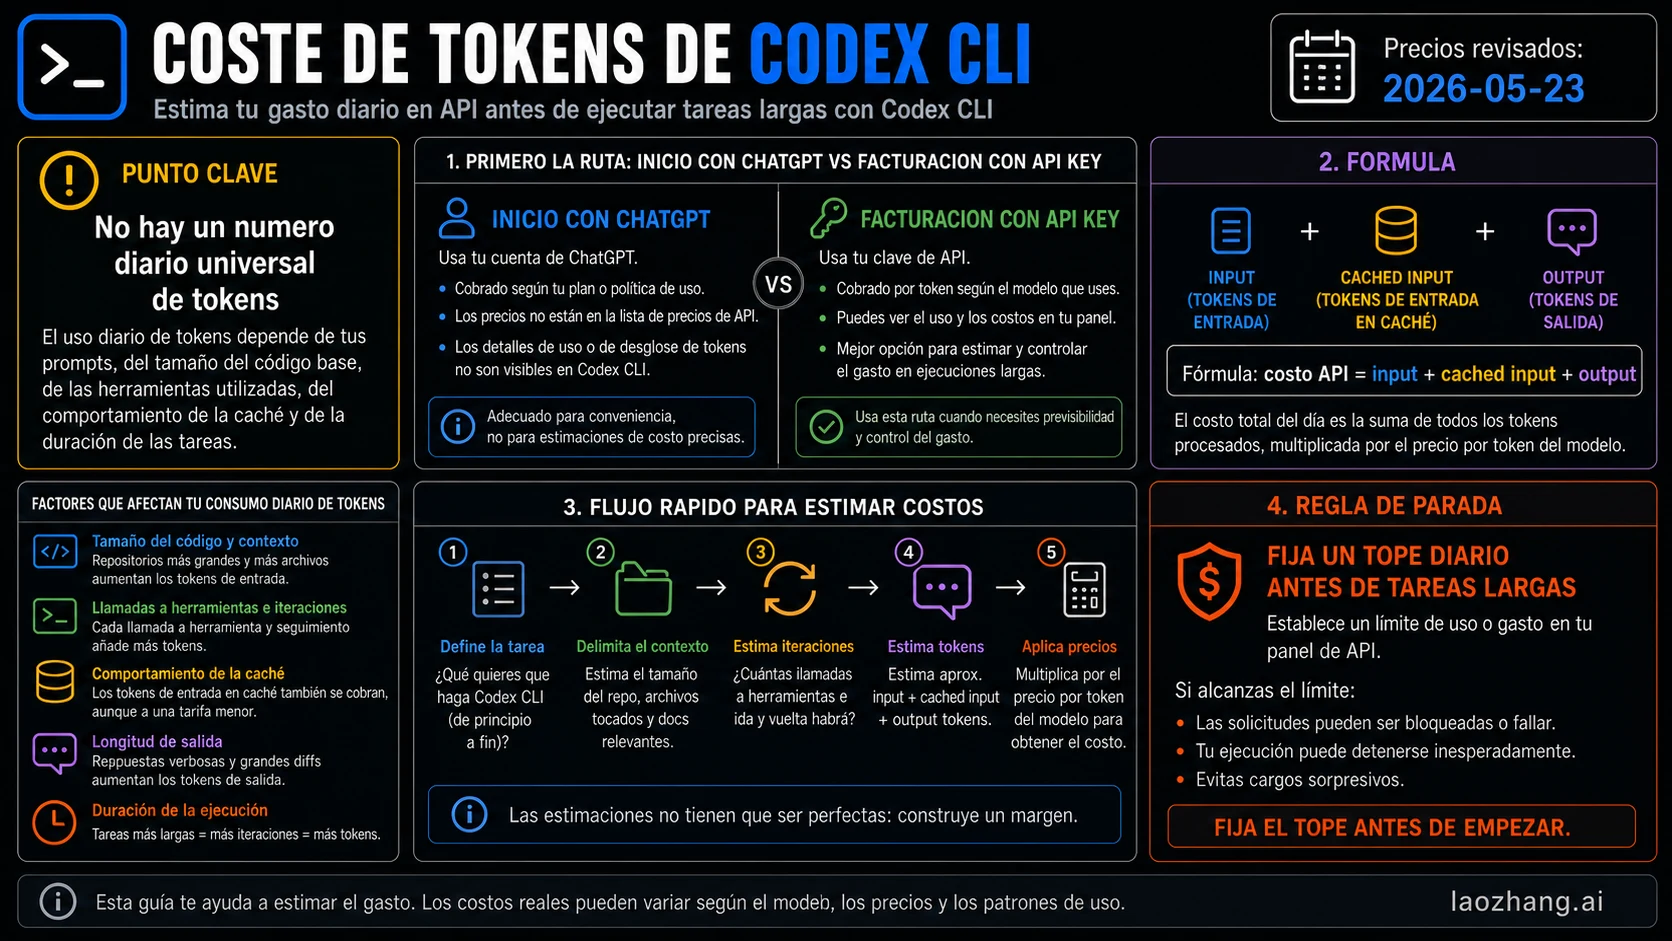
El gasto diario de Codex CLI se estima sumando el coste de las peticiones API que esperas hacer, con el modelo y las tarifas que realmente utilizarás. Antes de una tarea larga, separa entrada ordinaria, lectura de caché, escritura de caché y salida; calcula varios escenarios de trabajo y compáralos con el presupuesto que queda. Si inicias sesión con ChatGPT, consulta el uso incluido y los créditos del plan: esta fórmula en dólares no mide esa capacidad.
Con las tarifas de API revisadas el 7 de octubre de 2026, un supuesto de 40 peticiones a gpt-6.1-sol, cada una con 180.000 tokens de entrada total, 120.000 de lectura de caché, 30.000 de escritura y 8.000 de salida, cuesta 9,08 USD en Standard, procesamiento global y contexto corto. Con Fast serían 18,16 USD, si esa modalidad está disponible y es la elegida. Son cálculos con datos ficticios, no un consumo medido ni una factura. Las tarifas oficiales de API permiten comprobar y sustituir estos supuestos.
Estimador rápido en dos minutos
Para presupuestar una migración, una depuración larga o varios cambios de código, rellena estos cinco datos antes de empezar:
- Quién factura: OpenAI Platform, tu plan o espacio de ChatGPT, o un proveedor distinto.
- La tarifa completa: modelo exacto, Standard o Fast, región y precios de las cuatro categorías de tokens.
- El trabajo previsto: número aproximado de peticiones por tipo de tarea, tamaño de entrada por petición y salida esperada.
- Los gastos adicionales: ayudantes, reintentos, cambios de modelo y herramientas de pago que entren en el mismo presupuesto.
- La decisión: cuánto puedes gastar hoy y en qué punto vas a revisar el alcance antes de continuar.
Empieza con un escenario central y otro más caro: por ejemplo, más peticiones, menos lecturas de caché o alguna petición con contexto largo. Si el segundo ya supera tu presupuesto, reduce el alcance antes de lanzar el trabajo. Un porcentaje añadido sin saber qué puede cambiar no sustituye ese cálculo.
Qué medidor está activo
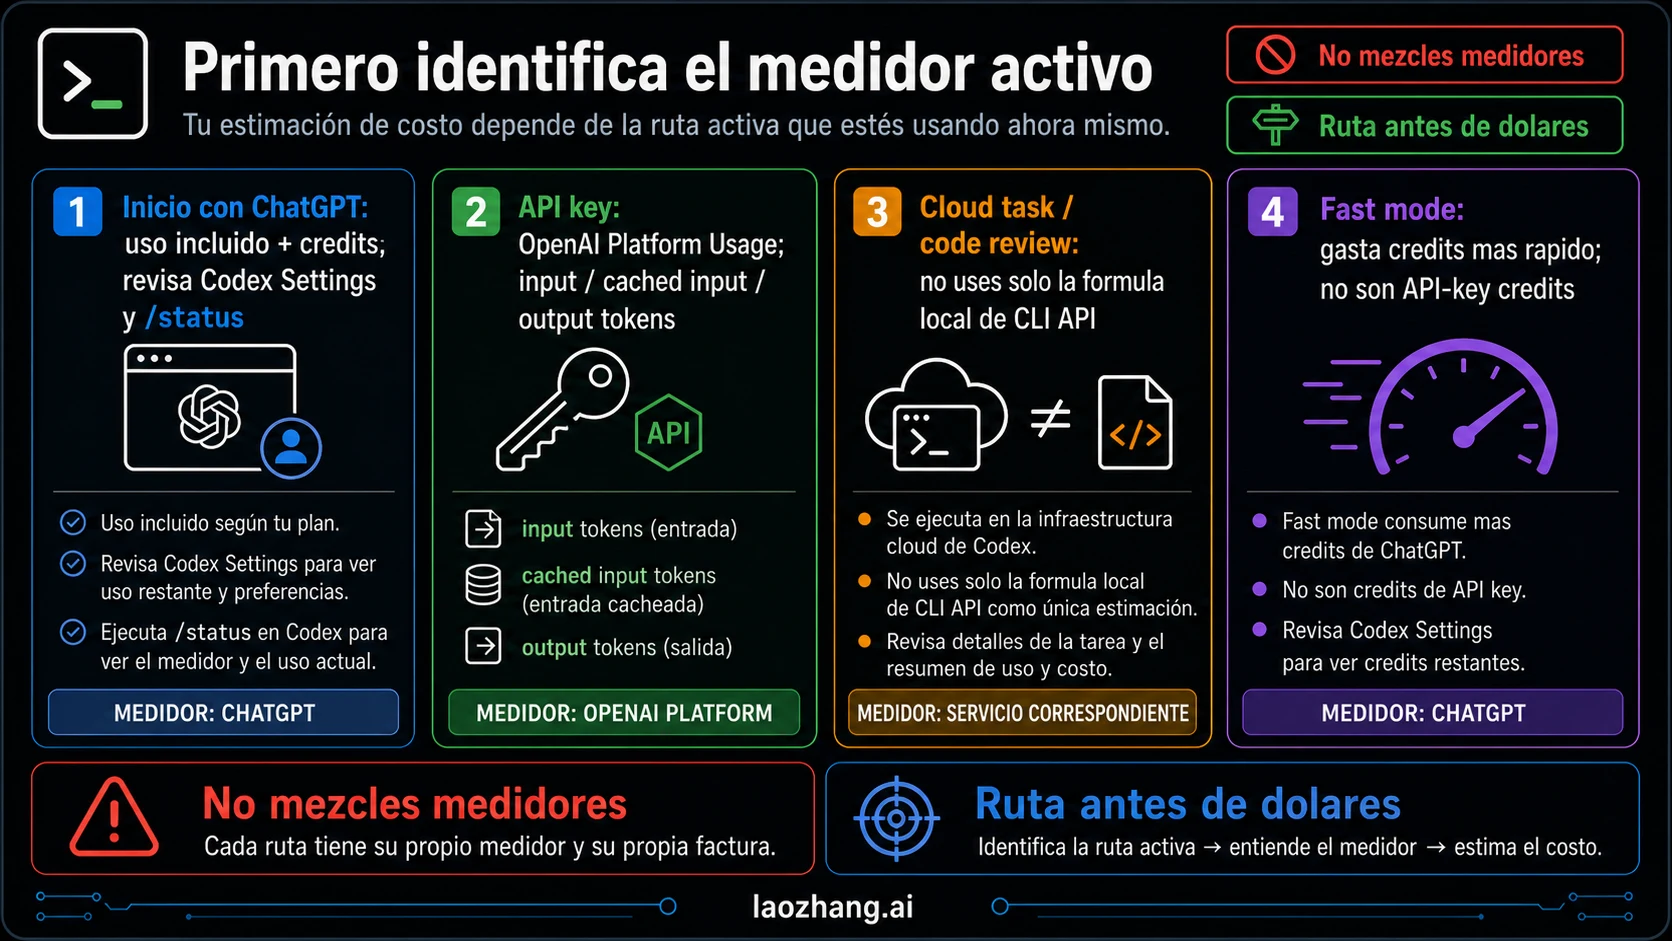
El mismo CLI puede usar distintos sistemas de facturación. Comprueba el método de autenticación de la ejecución concreta; el comando documentado para la autenticación guardada es codex login status. Una automatización puede reutilizar esa autenticación o seleccionar otra clave para una invocación. Por eso, saber que el proceso corre en CI no basta para concluir que paga por API. La documentación de autenticación y la de automatización explican estas diferencias.
| Acceso utilizado | Qué presupuesto consume | Qué dato sirve para decidir |
|---|---|---|
| API key de OpenAI en un flujo local | Uso facturado en OpenAI Platform | Tokens por categoría, tarifa aplicada y registros de gasto de Platform |
| Inicio de sesión con ChatGPT | Uso incluido y, cuando corresponda, créditos del plan o espacio de trabajo | Uso y límites de Codex/ChatGPT, según las condiciones del plan |
| Automatización con acceso gestionado de una empresa | Condiciones del espacio de trabajo y de su acceso | La configuración y el medidor definidos por la empresa |
| Tarea en la nube de Codex | Acceso de ChatGPT; requiere ese inicio de sesión | Condiciones de Codex y del plan, sin convertirlas directamente a tarifas API |
| Gateway o proveedor externo | La tarifa del proveedor o el contrato de la empresa | Su desglose de uso, cargos y descuentos |
Un endpoint compatible con OpenAI no demuestra que OpenAI emita la factura. Tampoco los créditos de ChatGPT sustituyen el saldo de facturación de Platform. La página de precios de Codex distingue expresamente las tarifas de tokens API del uso incluido en las suscripciones. Dividir la cuota mensual de Plus o Pro entre un precio API no permite calcular cuántas tareas te caben en el plan.
Precios actuales que debes usar
Esta tabla recoge USD por un millón de tokens de texto, a fecha de 7 de octubre de 2026, en Standard, procesamiento global y contexto corto. Para gpt-6.1-sol, corto significa hasta 272.000 tokens de entrada por petición, inclusive. No incluye impuestos, comisiones del proveedor ni cargos adicionales de herramientas. Comprueba también que el modelo esté disponible para tu clave y tu flujo: aparecer en la tabla de precios no garantiza ese acceso.
| Modelo | Entrada ordinaria | Lectura de caché | Escritura de caché | Salida |
|---|---|---|---|---|
gpt-6.1-sol | 2,00 | 0,10 | 2,50 | 10,00 |
gpt-6-sol | 2,00 | 0,20 | 2,50 | 10,00 |
gpt-6-luna | 0,10 | 0,01 | 0,125 | 0,50 |
gpt-5.6-sol | 4,00 | 0,40 | 5,00 | 20,00 |
gpt-5.4-mini | 0,75 | 0,075 | Sin cargo separado | 4,50 |
gpt-5.4 | 2,50 | 0,25 | Sin cargo separado | 15,00 |
Fuente: precios oficiales de API. La tarifa promocional publicada de gpt-5.6-sol está prevista al menos hasta el 21 de noviembre de 2026; compruébala de nuevo cuando planifiques un trabajo posterior. Las tarifas de GPT-5.4 siguen siendo referencias válidas para sus condiciones, pero su fórmula sin escritura separada no sirve sin cambios para GPT-5.6 y posteriores.
Velocidad, región y contexto cambian el cálculo
En gpt-6.1-sol, una petición con más de 272.000 tokens de entrada se factura entera con el precio de contexto largo: las tarifas de entrada, lectura y escritura se duplican, y la salida cuesta 1,5 veces la tarifa corta. No se aplica solo a los tokens que excedan el umbral. Tampoco se activa porque el total diario supere 272.000 tokens. Consulta las notas de precios del modelo.
Para ese modelo, Fast cuesta el doble de Standard. Batch y Flex tienen tarifas un 50 % inferiores a Standard, pero no puedes asumir que un trabajo interactivo de Codex utilice esos servicios. El procesamiento regional añade un 10 % donde esté disponible; Fast no está disponible con residencia de datos en la UE para gpt-6.1-sol. Confirma una combinación compatible antes de aplicar multiplicadores. La ficha del modelo y la tabla de API especifican las condiciones.
Los multiplicadores de créditos de Codex son otra unidad de medida. El multiplicador aplicado al uso incluido de Fast no debe trasladarse a la factura API.
La fórmula: no cobres dos veces la misma entrada
Para una respuesta de API Responses, usa estas cantidades:
| Símbolo | Qué representa | Campo de uso |
|---|---|---|
| I | Entrada total, incluida la caché | input_tokens |
| R | Entrada leída de caché | input_tokens_details.cached_tokens |
| W | Entrada escrita en caché | input_tokens_details.cache_write_tokens |
| O | Salida total | output_tokens |
| U | Entrada ordinaria, calculada como I − R − W | No se suma otra vez a I |
Las tres categorías de entrada son excluyentes. La guía de caché establece que la escritura es una categoría alternativa, no un recargo sobre tokens ya cobrados como entrada ordinaria. Comprueba que R y W no sean negativos y que R + W no supere I.
U = I - R - W
Coste de la petición en USD =
  (U × precio_entrada
 + R × precio_lectura
 + W × precio_escritura
 + O × precio_salida) / 1000000

Coste diario previsto = suma de peticiones previstas
                     + otros cargos aplicables
Si tu hoja ya llama «entrada» a los tokens ordinarios U, trabaja directamente con U, R y W: no vuelvas a restar la caché. El problema aparece al tratar una entrada total I como si fuese ordinaria y añadir después R y W.
No añadas los tokens de razonamiento a O otra vez. En API Responses, output_tokens ya los incluye; output_tokens_details.reasoning_tokens es un desglose. El ejemplo oficial de métricas lo explica. La longitud de la respuesta visible no mide por sí sola la salida facturable.
En el supuesto de la introducción, U = 180.000 − 120.000 − 30.000 = 30.000. El cálculo por petición es:
(30000 × 2 + 120000 × 0.10 + 30000 × 2.50 + 8000 × 10)
/ 1000000 = 0.227 USD

40 × 0.227 = 9.08 USD
Escenarios diarios de coste
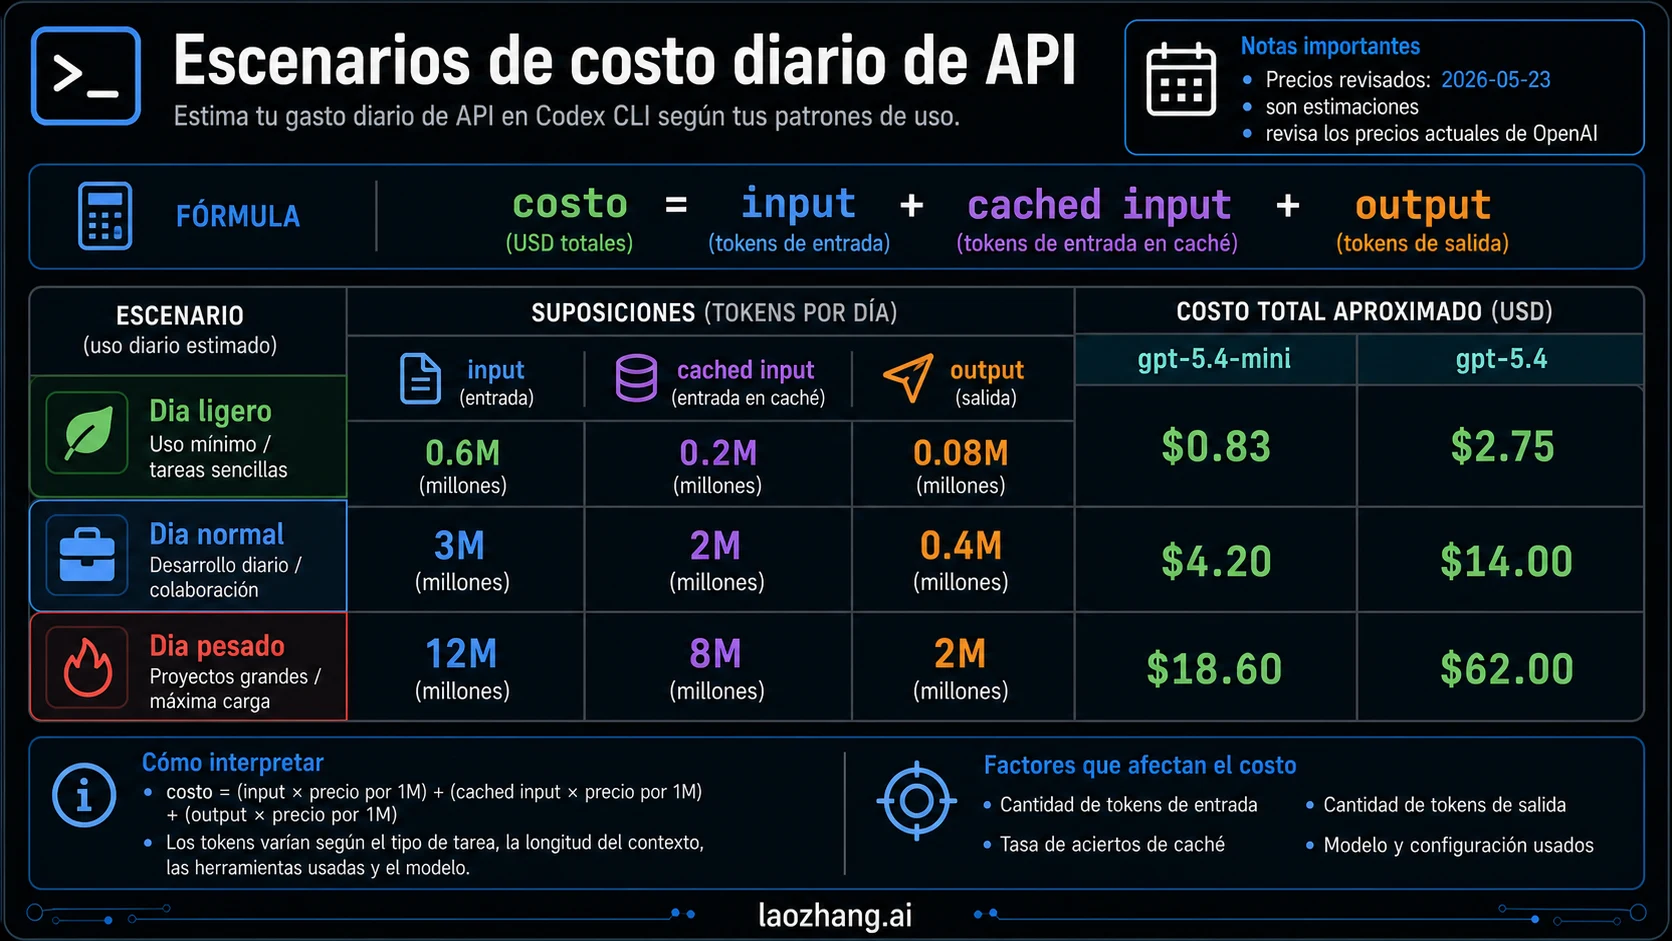
La figura de escenarios se conserva de la versión inicial de mayo. Para las tarifas y las categorías del cálculo actualizado, usa las tablas y fórmulas del texto.
Los siguientes escenarios son supuestos de planificación, no una clasificación de usuarios ni pruebas de rendimiento. Cada fila supone peticiones con la mezcla indicada a gpt-6.1-sol, Standard y procesamiento global. En un día real puedes combinar filas y sumar sus importes. Una tarea de Codex puede requerir muchas peticiones, por lo que «40 peticiones» no significa «40 tareas terminadas».
| Trabajo supuesto | Peticiones en el día | I por petición | R por petición | W por petición | O por petición | Coste por petición | Total diario |
|---|---|---|---|---|---|---|---|
| Cambios acotados con contexto breve | 60 | 20.000 | 10.000 | 5.000 | 2.000 | 0,0435 USD | 2,61 USD |
| Revisión y edición con contexto estable | 40 | 180.000 | 120.000 | 30.000 | 8.000 | 0,227 USD | 9,08 USD |
| Investigación con contexto largo | 25 | 320.000 | 200.000 | 60.000 | 12.000 | 0,76 USD | 19,00 USD |
La tercera fila aplica las tarifas largas a toda la petición: U = 60.000; el coste es (60000 × 4 + 200000 × 0.20 + 60000 × 5 + 12000 × 15) / 1000000 = 0.76 USD. Aplicar las tarifas cortas daría 0,41 USD y dejaría el presupuesto por debajo de lo necesario para ese supuesto.
Para adaptar el estimador, divide el trabajo en bloques reconocibles: explorar el problema, modificar el código y comprobar el resultado. Estima las peticiones de cada bloque, asigna su modelo y mezcla de tokens, y suma. Si un ayudante hace otras diez peticiones, inclúyelas; si un reintento llega al proveedor, no lo borres por haber fallado la tarea. Añade las herramientas de pago con su propia unidad y precio.
Una tarifa inferior solo abarata una mezcla de tokens equivalente. Si el modelo necesita más intentos o no completa el trabajo, el coste por tarea útil puede aumentar. Elige el modelo que cumpla tus criterios de aceptación y compara el gasto de ese trabajo, sin deducir calidad de la tabla de precios.
Si no conoces la escritura de caché, calcula un intervalo
El ejemplo documentado de turn.completed de Codex CLI en modo JSON muestra entrada, entrada en caché, salida y razonamiento, pero no un contador de escritura de caché. Esa ausencia no demuestra W = 0 en un modelo que la cobra. Los campos de CLI y los de Responses tampoco deben intercambiarse sin comprobar su definición y cobertura.
Cuando I, R y O son conocidos, no hay otras categorías de entrada y la tarifa de escritura es mayor o igual que la ordinaria, puedes acotar el coste: asigna toda la entrada restante I − R a ordinaria para el extremo inferior y toda a escritura para el superior. Con I = 180.000, R = 120.000 y O = 8.000, las tarifas cortas de gpt-6.1-sol dan 0,212–0,242 USD por petición, o 8,48–9,68 USD para 40 peticiones iguales. El supuesto W = 30.000 produce los 9,08 USD intermedios.
Este intervalo solo cubre los tokens y condiciones indicados; no pone un techo al número de llamadas, a herramientas de pago o a un cambio de modelo. Si aparece una categoría sin tarifa comprobada —por ejemplo, escritura con otra duración de retención—, consigue esa tarifa o el registro de coste correspondiente. Una categoría desconocida no equivale a uso gratuito.
Cómo medir tu propio día de Codex
Para sustituir supuestos por datos, elige un bloque representativo que ya tengas medido o que decidas ejecutar con su coste previsto. Conserva el mismo modelo, modalidad, región y alcance que usarás después. Un bloque de 45 minutos puede ser práctico para organizarte, pero el tiempo no fija el consumo: lo fijan las peticiones y los tokens. Los ejemplos de esta página no proceden de un piloto de pago.
- Anota el alcance de la medición: periodo, proyecto, modelo, modalidad y qué procesos o ayudantes incluye.
- Recoge uso completo por petición cuando esté disponible. Guarda I, R, W y O y la condición corta/larga. No sumes una instantánea acumulada y su total final como si fueran usos distintos.
- Compara periodos equivalentes en Platform. El panel de uso trabaja en UTC y tiene su propio selector de proyectos. Para conciliar un día local, convierte sus límites a UTC y mantén el mismo proyecto o conjunto de proyectos.
- Separa cantidad de tokens y gasto registrado. Usa los contadores para comprender la mezcla y los registros de costes para comprobar el importe de ese ámbito.
- Recalcula el trabajo restante. Ajusta cuántos bloques semejantes faltan y construye otro escenario si el contexto o los fallos están creciendo.
La ayuda oficial del panel de uso y costes describe los permisos necesarios, UTC y el selector de proyectos. Si necesitas localizar el contador adecuado de CLI, el contexto o el uso de la cuenta, consulta cómo ver el uso de tokens de Codex.
En una exportación agregada de la API de Usage, input_tokens también incluye caché y escrituras. Los campos de lectura, escritura de 30 minutos y escritura de 12 horas son distintos. Agrupa por modelo y service_tier, además del proyecto o clave que corresponda, y consume todas las páginas del periodo: inicio inclusivo y fin exclusivo. No añadas los desgloses de modalidades otra vez al total. Un agregado diario no revela cuáles de sus peticiones cruzaron el umbral de contexto largo.
Si solo dispones de gasto agregado, úsalo como referencia para bloques comparables. Por ejemplo, cuatro bloques parecidos a uno de 2 USD permiten una base de 8 USD; escoger un margen del 25–50 % daría 10–12 USD. Ese margen es una decisión de planificación, no una regla oficial ni un intervalo estadístico. No puedes reconstruir una mezcla única de entrada y salida a partir de esos 2 USD.
Reglas de parada para ejecuciones largas
Continúa cuando el trabajo restante, los cargos pendientes y el margen elegido caben en el presupuesto disponible. Revisa antes de empezar el siguiente bloque, cuando cambie el modelo o cuando la tarea salga del alcance previsto. No esperes únicamente a que el gasto ya registrado llegue al total del día.
Ejemplo de decisión, con un presupuesto escogido de 15 USD para hoy:
| Situación | Cálculo | Decisión para el siguiente bloque |
|---|---|---|
| Gasto confirmado de 6 USD; quedan 20 peticiones del escenario central | 6 + 20 × 0,227 + 2 USD de margen = 12,54 USD | Cabe en el presupuesto bajo esos supuestos; revisa si cambian |
| Gasto confirmado de 10,50 USD; queda el mismo trabajo | 10,50 + 4,54 + 2 = 17,04 USD | Pausa y reduce alcance, revisa el plan o pospón trabajo |
| Faltan registros de llamadas ya enviadas | El importe pendiente no está cerrado | Mantén una reserva para ellas antes de admitir más trabajo |
El margen de 2 USD y el punto de revisión de 10,50 USD —el 70 % de 15 USD— son decisiones del ejemplo. No convierten el cálculo en una garantía de gasto máximo. Acotar archivos, concretar el resultado esperado y frenar reintentos repetidos reduce trabajo innecesario; no elimines pruebas o contexto necesarios para aceptar el resultado.
Las alertas de gasto de Platform avisan y permiten que el tráfico siga. Los límites duros de organización o proyecto son mensuales, requieren Enforce a hard limit y pueden tener un pequeño exceso por el retraso de propagación. Cuando se alcanza uno aplicable, las peticiones afectadas reciben 429 con organization_spend_limit_exceeded o project_spend_limit_exceeded. La guía oficial de límites de gasto, consultada el 6 de octubre de 2026, explica estas condiciones. No confundas esa protección con un tope diario instantáneo.
Si necesitas que tu aplicación impida la siguiente llamada de pago al agotar el presupuesto diario, el siguiente paso es implementar un kill switch de gasto API antes del proveedor. La estimación ayuda a decidir cuánto admitir; el control debe actuar antes de enviar nuevas llamadas y considerar las que ya están en curso.
Si la factura sale más alta de lo esperado
Comprueba primero que estés comparando el mismo periodo UTC, proyecto y sistema de facturación. Después revisa el modelo y la modalidad realmente usados, las peticiones con contexto largo, las escrituras de caché, los reintentos y los ayudantes que no entraron en la previsión.
La entrada contiene instrucciones, historial, archivos y resultados de herramientas. Un log que imprime un test y vuelve al contexto del modelo cuenta como entrada de una petición posterior; no es automáticamente salida generada por el modelo. A la vez, pedir un resumen corto no elimina el razonamiento ya incluido en la salida facturable.
La caché reduce el precio de lecturas elegibles, pero necesita un prefijo coincidente y una entrada conservada. Compactar o reiniciar puede cambiar ese prefijo. La guía de caché no permite asumir que todo el historial se lea a precio reducido ni que empezar de nuevo siempre abarate el trabajo.
Para conciliar importes, los registros de Costs proporcionan amount.value y currency. La cantidad asociada a una partida puede expresarse en tokens, miles de tokens, tiempo, imágenes u otras unidades; no la trates siempre como tokens. Descuentos, créditos, impuestos y contratos deben compararse en su ámbito. Con Scale Tier puedes tener uso positivo y gasto incremental de proyecto igual a cero, mientras el paquete se factura a la organización, según la ayuda del panel.
Una ejecución interrumpida sin recibo completo queda pendiente de conciliación. La ausencia de un total final, o cancelar el cliente, no demuestra que todas las peticiones enviadas hayan sido gratuitas. Resuelve esa diferencia antes de repetir una tarea larga con el mismo presupuesto.
Preguntas frecuentes
¿Cuántos tokens usa Codex CLI al día?
No hay una cantidad diaria universal. Estima el número de peticiones y su entrada, caché y salida para tu trabajo, incluyendo ayudantes y reintentos. Una migración que amplía el contexto puede consumir una mezcla muy distinta de una serie de cambios pequeños.
¿Cómo calculo el coste con una API key?
Confirma quién factura y la tarifa aplicable. Para API Responses, resta lectura y escritura de caché de la entrada total; cobra cada categoría una vez y añade la salida. Suma las peticiones y otros cargos del día. Las tarifas de API y la guía de caché permiten comprobar las categorías.
¿Los tokens de razonamiento se cobran aparte de output_tokens?
En API Responses ya están incluidos en output_tokens; no los sumes otra vez. El campo de razonamiento desglosa esa salida, según el ejemplo oficial de métricas. Esto no establece por sí solo cómo convertir cualquier contador de CLI en una factura completa.
¿Un día con un millón de tokens activa el precio de contexto largo?
No por el total diario. Para gpt-6.1-sol, la condición es más de 272.000 tokens de entrada en una petición, y el precio largo afecta a esa petición entera. Ve las notas del modelo.
¿Puedo considerar cero una escritura de caché que no aparece?
Solo si las condiciones de la tarifa y del contador lo justifican. La ausencia del campo en un ejemplo de CLI no demuestra cero escrituras en un modelo que las cobra. Con datos suficientes puedes calcular el intervalo condicional explicado arriba; sin tarifa para una categoría, el cálculo queda incompleto.
¿La API es más barata que una suscripción de ChatGPT?
El gasto API previsto no basta para decidirlo. Debes comparar tareas que puedas completar, uso incluido disponible y condiciones de cada acceso. Los precios de Codex separan expresamente los tokens API de la capacidad de la suscripción; no hay una conversión automática de la cuota mensual en tareas.
¿Una alerta de gasto detiene Codex al llegar a mi presupuesto diario?
No. La alerta avisa; un límite duro aplicable de Platform actúa sobre el gasto mensual y puede propagarse con retraso. Para un control diario antes de cada llamada, necesitas comprobar y reservar presupuesto en tu aplicación. Consulta la guía de límites de gasto y el kill switch para agentes.
Fuentes11
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 8 oct 2026.
Fuentes11
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 8 oct 2026.
- 1.tarifas oficiales de APIdevelopers.openai.com/api/docs/pricing
- 2.documentación de autenticaciónlearn.chatgpt.com/docs/auth
- 3.automatizaciónlearn.chatgpt.com/docs/non-interactive-mode
- 4.página de precios de Codexlearn.chatgpt.com/docs/pricing
- 5.notas de precios del modelodevelopers.openai.com/api/docs/models/gpt-6.1-sol
- 6.guía de cachédevelopers.openai.com/api/docs/guides/prompt-caching
- 7.ejemplo oficial de métricasdevelopers.openai.com/cookbook/examples/agent_optimization/optimizing_agents_for_cost_and_quality
- 8.ayuda oficial del panel de uso y costeshelp.openai.com/es-es/articles/10478918-reviewing-api-usage-and-costs
- 9.API de Usagedevelopers.openai.com/api/reference/resources/admin/subresources/organization/subresources/usage/methods/completions
- 10.guía oficial de límites de gastodevelopers.openai.com/api/docs/guides/spend-limits
- 11.Costsdevelopers.openai.com/api/reference/resources/admin/subresources/organization/subresources/usage/methods/costs