Cómo detener un agente de IA atrapado en un bucle de herramientas
Para detener un agente que repite herramientas, bloquea primero nuevas ejecuciones. Después comprueba qué cambió realmente y qué operaciones llegaron a confirmarse antes de decidir si terminar, reintentar o pedir intervención.
En esta página
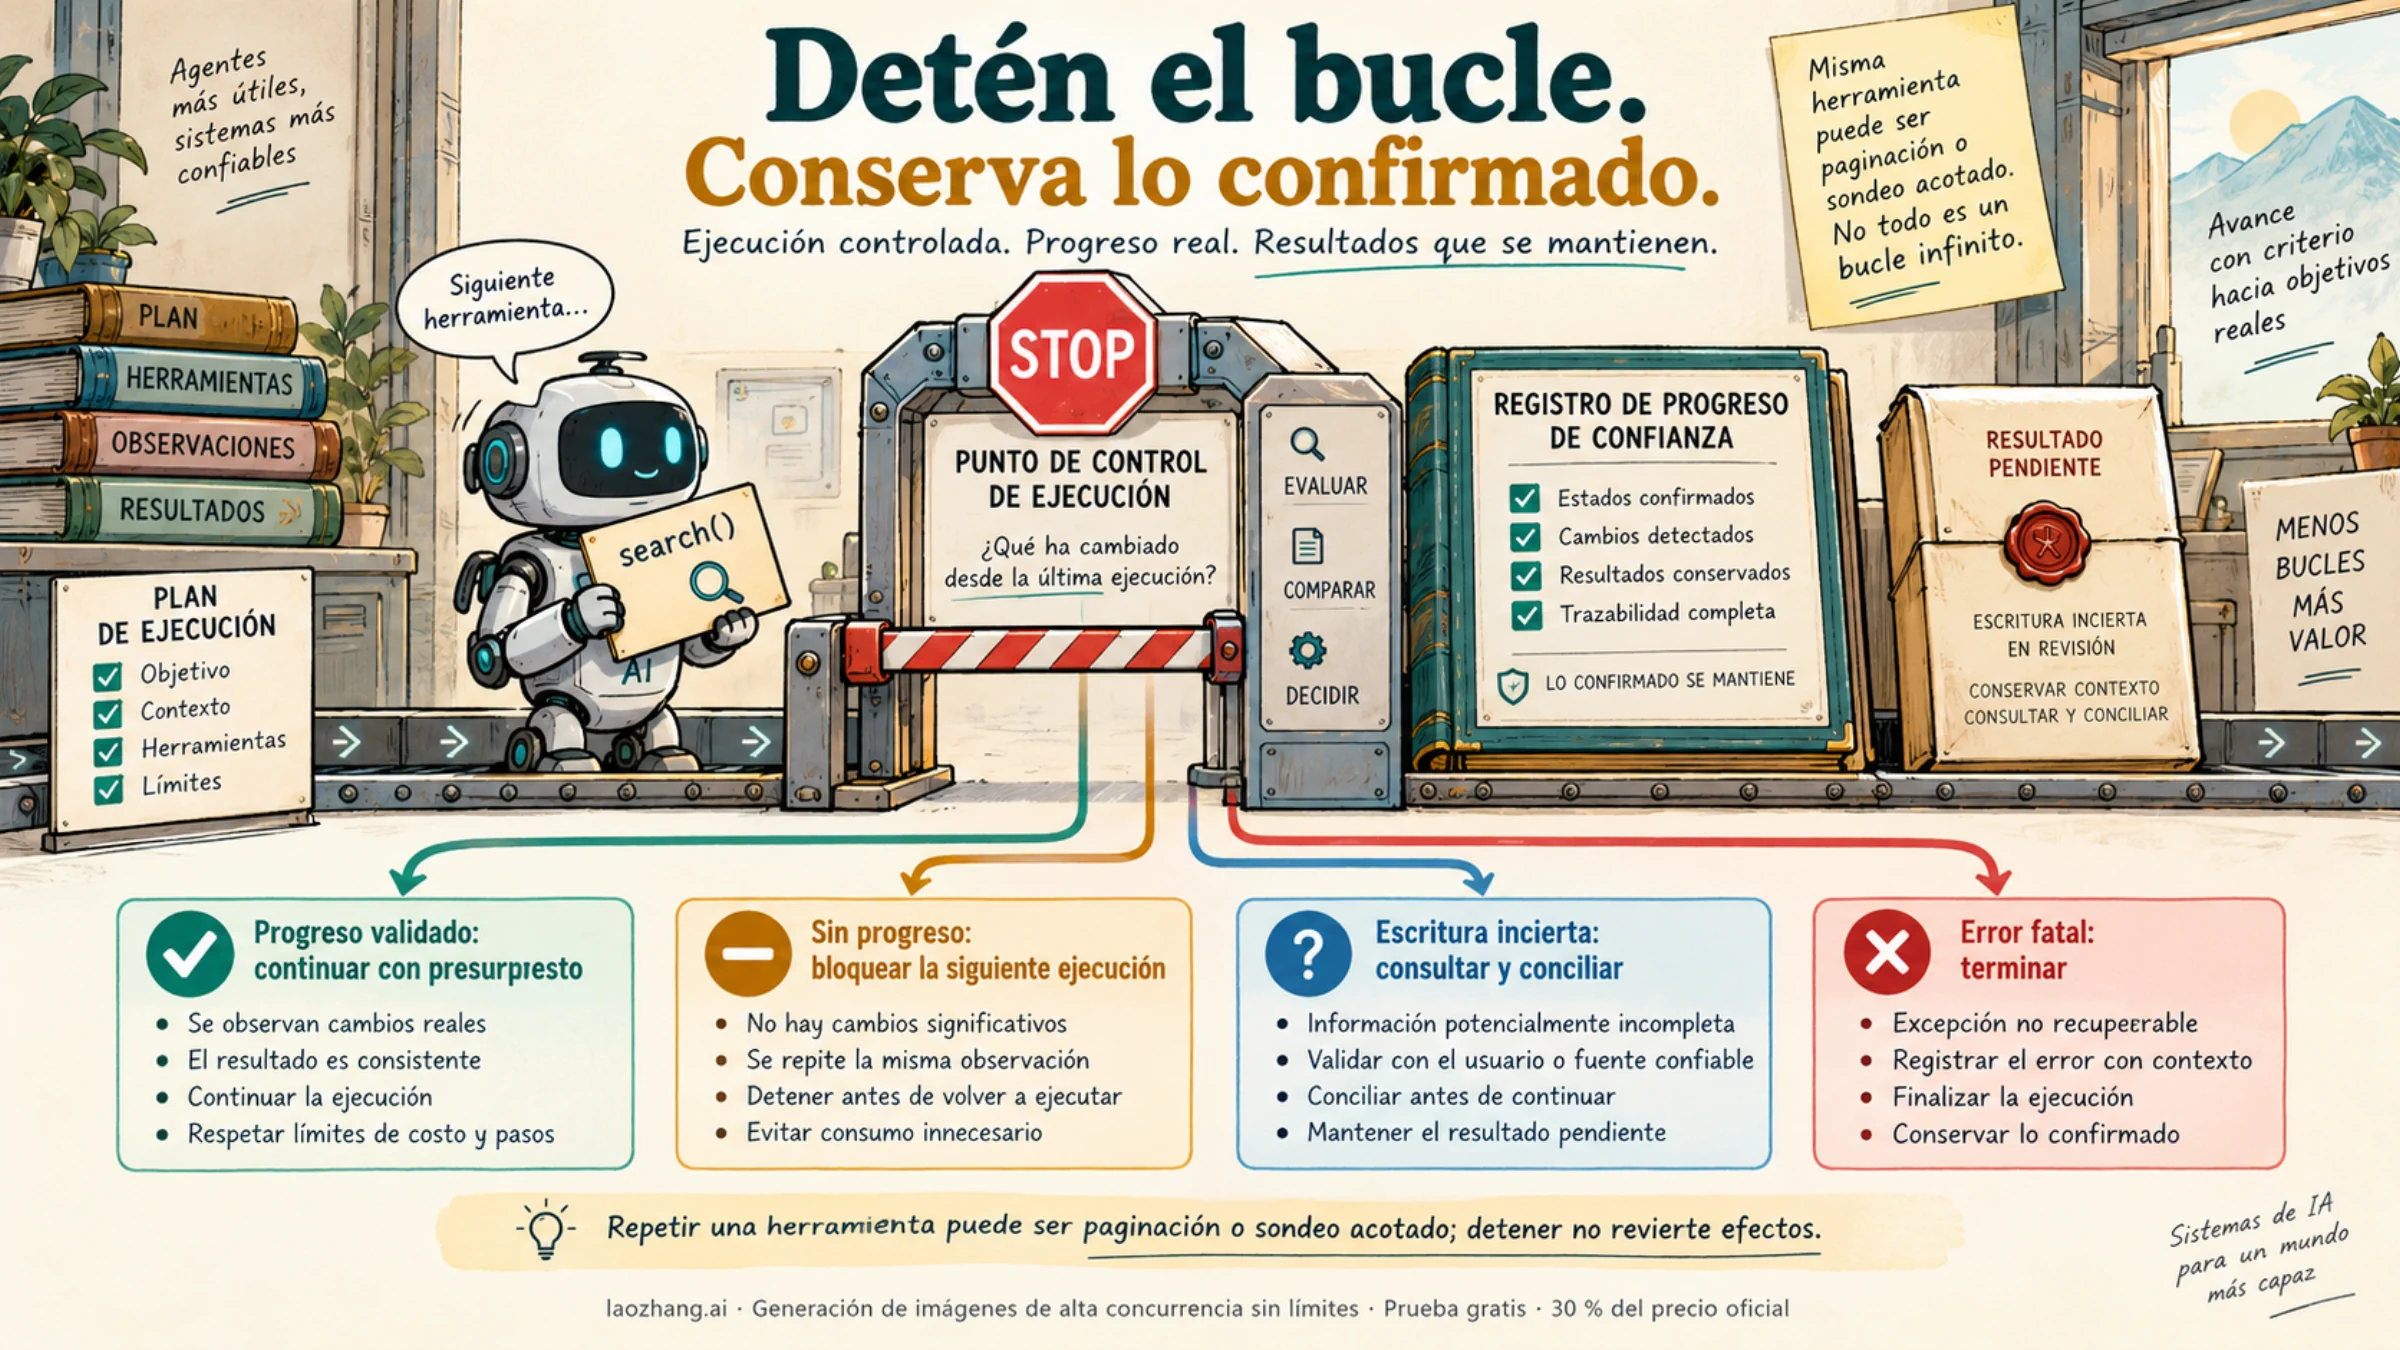
Si un agente de IA vuelve a llamar a la misma herramienta sin avanzar, bloquea la siguiente ejecución desde la aplicación que lo controla. Conserva los resultados ya validados y el estado de las operaciones en curso; solicita la cancelación al entorno de ejecución y comprueba su efecto. Después decide si la tarea está terminada, admite un resultado parcial o necesita intervención. Añadir «no repitas herramientas» al prompt puede ayudar al modelo, pero el límite debe aplicarse antes de ejecutar.
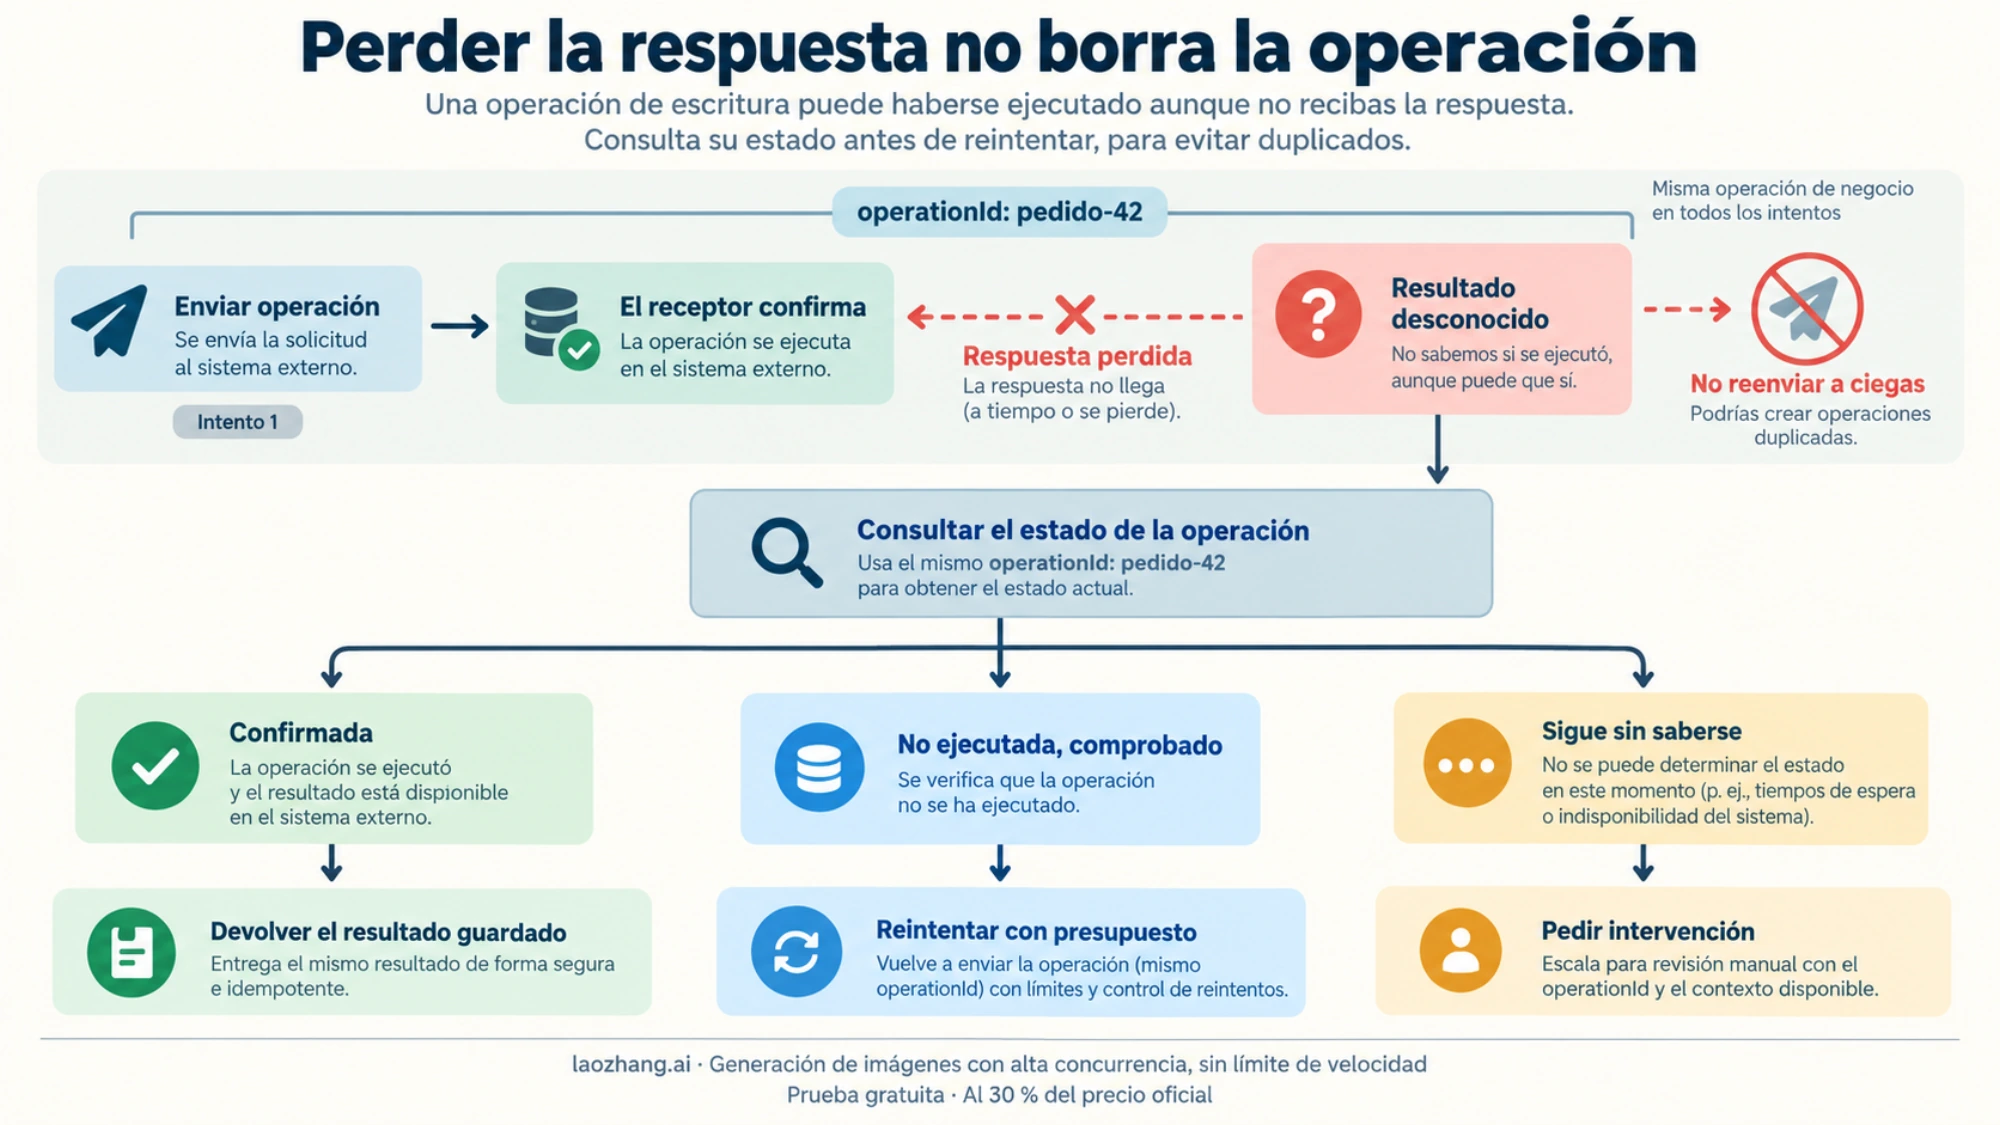
La precaución decisiva es esta: un timeout no demuestra que una escritura haya fallado. Si se perdió la respuesta después de guardar un cambio, repetirlo puede duplicar una operación válida. Detener el agente tampoco deshace lo que ya se haya confirmado.
Cómo contener el bucle sin perder el estado útil
El punto de corte debe estar en el código que autoriza y despacha las llamadas, no solo en la ventana de chat. Para un sistema que administras, sigue este orden:
- Impide nuevas ejecuciones. Marca la tarea como detenida y haz que el despachador consulte esa marca antes de cada llamada. Incluye herramientas, trabajos pendientes y subagentes. Si hay varios trabajadores, la marca debe ser compartida.
- Conserva una traza suficiente. Guarda el identificador de tarea, contadores consumidos, herramienta, argumentos relevantes normalizados, clase de resultado y último avance validado. Para una operación que modifica datos, conserva además su identificador de negocio y su estado. Retira credenciales y datos sensibles de los registros.
- Cancela la ejecución activa mediante su mecanismo autorizado. Comprueba si el trabajador terminó y qué llamadas seguían en curso. Cerrar una pestaña o dejar de mostrar el texto no acredita que el servidor se haya detenido.
- Comprueba los efectos antes de reanudar. Una operación confirmada se recupera desde su registro. Una operación de resultado desconocido requiere consultar el sistema receptor o resolver la ambigüedad antes de enviarla otra vez.
El corte está contenido cuando una nueva propuesta no consigue ejecutar otra acción y el llamador recibe un resultado explícito, por ejemplo stopped, partial o needs_reconciliation. Llegar a un máximo de iteraciones no prueba que la tarea se haya completado.
Si usas Amazon Bedrock AgentCore, su API StopRuntimeSession ofrece una operación de parada de sesión. Esa solicitud tiene su propia identidad y requisitos de autorización: no sustituye la clave de una operación de negocio ni acredita una devolución, una reversión o la cancelación de una escritura ya aceptada. En otro entorno, utiliza su mecanismo de cancelación y observa el resultado real.
Distingue el bucle de un reintento y de una repetición necesaria
Repetir el nombre de una herramienta puede ser normal. Leer varias páginas exige varias llamadas; consultar un trabajo asíncrono también. El problema aparece cuando se repite trabajo sin obtener un cambio que justifique continuar.
| Qué ves | Qué comprobar | Próxima acción |
|---|---|---|
| Misma llamada y mismo resultado | Argumentos normalizados y estado sin cambios | Bloquear la próxima repetición |
| Cambian filtros o el texto, pero vuelve la misma información | Resultado validado y avance de la tarea | Aplicar el límite sin progreso, aunque cambie la huella |
| Dos herramientas se alternan | Secuencia A → B → A sin nuevo resultado útil | Cortar el ciclo y elegir otra estrategia |
| La herramienta tuvo éxito y vuelve a ejecutarse | Registro de operación y condición de fin de la tarea | Recuperar el resultado guardado y cerrar la transición |
| Repite un error de permiso o una entrada inválida | La precondición sigue igual | Terminar o pedir intervención |
| Hay un fallo transitorio | Clasificación del error, presupuesto y plazo | Reintentar de forma acotada |
| Avanza una página o cambia el estado de un trabajo | Cursor válido o transición confirmada | Continuar dentro del límite global |
Para detectar una llamada idéntica, normaliza el JSON: el orden de las claves no cambia la acción. La huella debe conservar los campos que alteran su significado. Quitar un identificador de cliente o un importe porque «parece ruido» confundiría operaciones distintas. Un hash tampoco vuelve anónimos los datos: entradas predecibles pueden reconstruirse por comparación.
El progreso lo determina una comprobación de la aplicación: una página nueva con un cursor coherente, un artefacto que pasa su validación o una transición confirmada por el sistema receptor. «He avanzado», un contador inventado por el modelo y el mero paso del tiempo no cumplen esa función.
En un sondeo, varias respuestas «pendiente» pueden ser aceptables durante una espera limitada; no son progreso por sí mismas. Usa una política de espera con plazo y número máximo de consultas, separada de la política de pasos productivos. En paginación, un cursor distinto tampoco basta si vuelve a los mismos registros o forma un ciclo.
En n8n hay dos bucles que requieren cortes diferentes
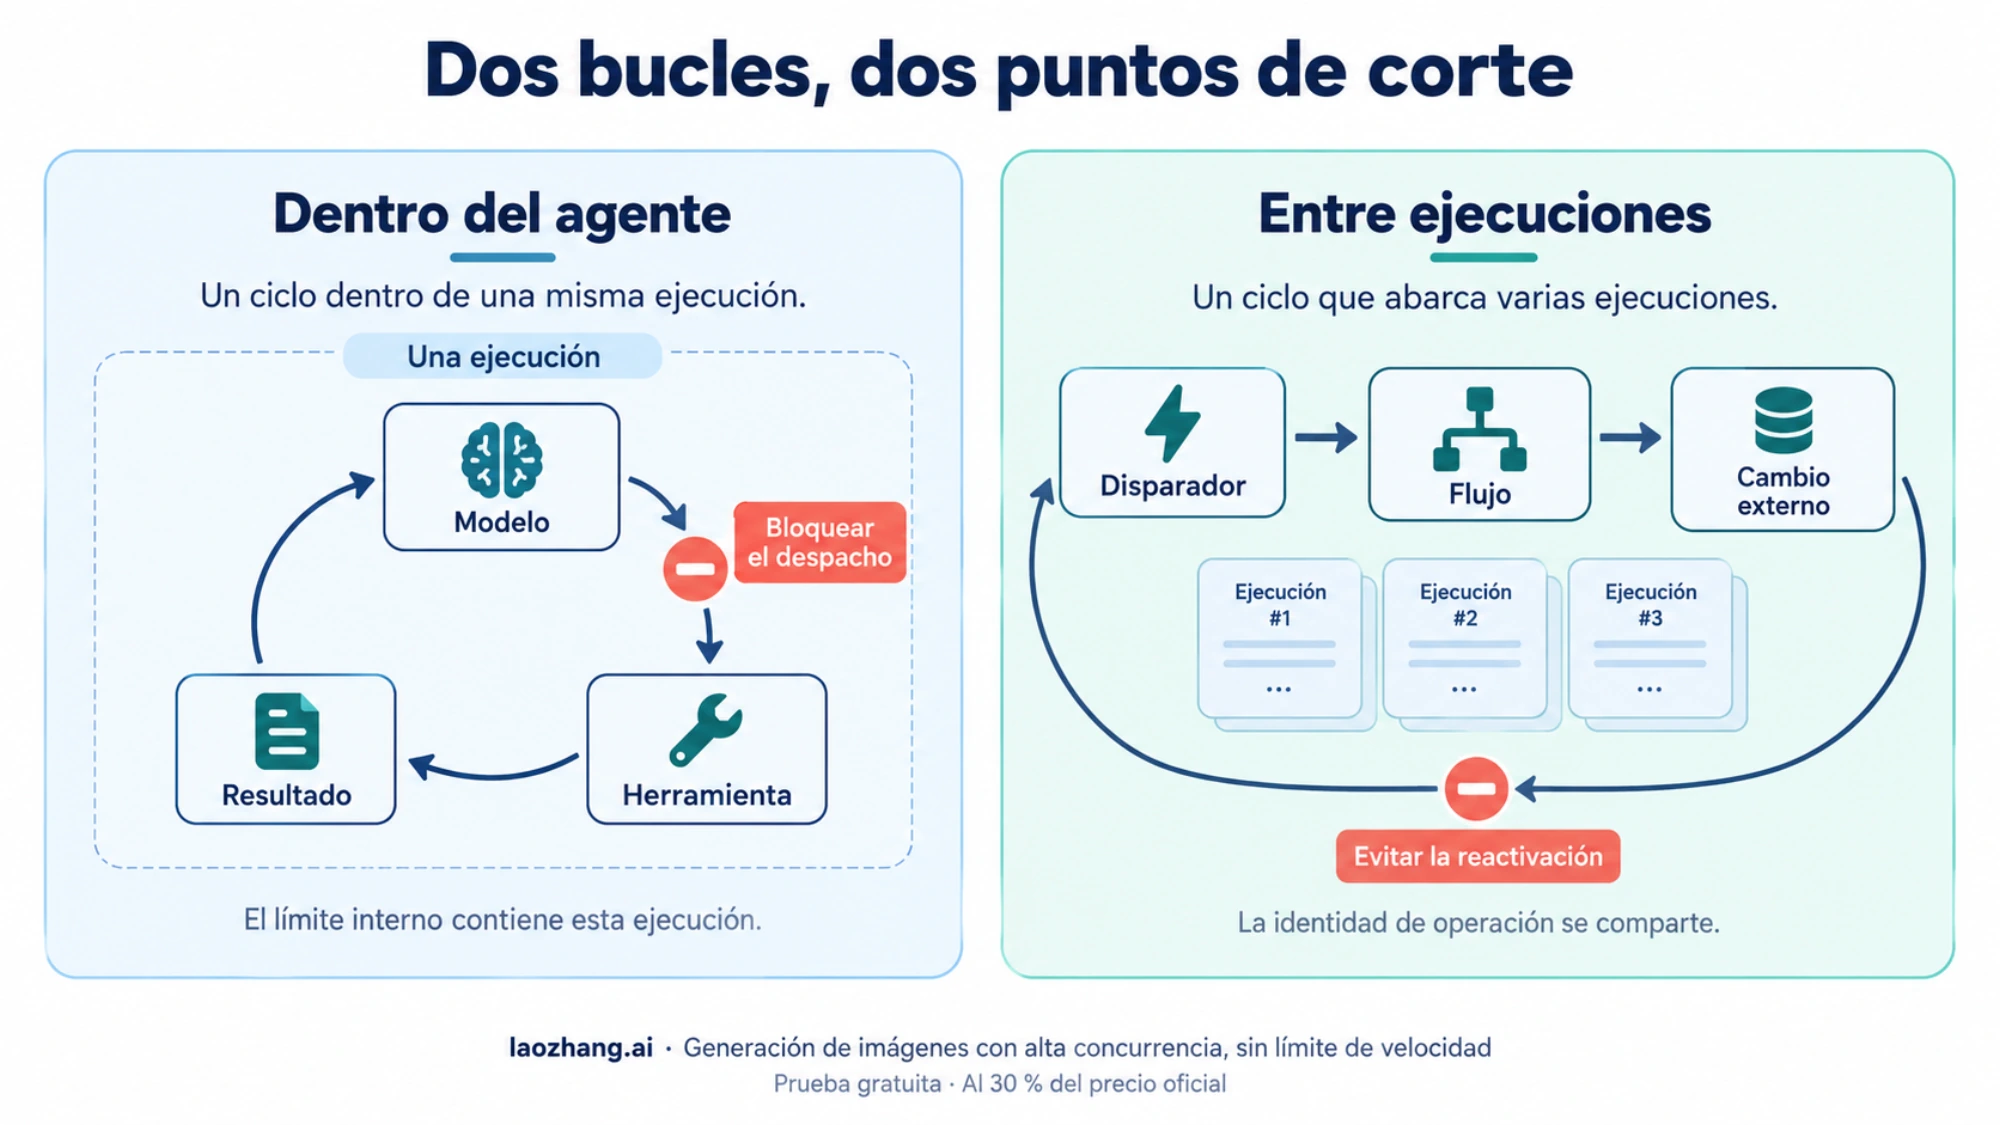
Un flujo puede activarse otra vez por el efecto que acaba de producir: escribe una fila y el cambio dispara el mismo flujo, o envía un correo que vuelve a entrar por el disparador. Cada ejecución individual puede terminar correctamente mientras el conjunto se autoalimenta. En ese caso, el corte debe alcanzar el disparador o la ruta que vuelve a entrar, con una identidad de operación compartida entre ejecuciones.
El otro caso sucede dentro de una ejecución de Tools Agent: el modelo vuelve a proponer una herramienta. La documentación de Tools Agent de n8n indica que Max Iterations tiene un valor predeterminado de 10 y cuenta ejecuciones del modelo. No equivale a diez operaciones de herramientas ni limita cuántas veces puede activarse el flujo externo.
La explicación de Kepa Tecnología sobre los bucles en agentes n8n distingue estos problemas y propone condiciones de salida, topes y deduplicación. Para aplicar esa idea, comprueba dónde vive el contador: una variable que empieza otra vez en cada activación no limita una cadena de activaciones.
También necesitas una condición de salida comprobable. Un JSON del modelo con completado: true tiene un formato claro, pero no demuestra que se haya guardado el pedido ni que estén todas las páginas. Valida el resultado de negocio y haz que el flujo termine por una rama que no vuelva a activar el mismo trabajo.
Qué límite configurar y qué debe cerrar el llamador
Cuenta por separado lo que necesitas contener:
| Límite | Unidad | Frontera que debes comprobar |
|---|---|---|
| Llamadas al modelo | Solicitudes de inferencia o turnos definidos por el entorno | Antes de solicitar la siguiente respuesta |
| Llamadas a herramientas | Ejecuciones, incluidos reintentos del adaptador | Antes de despachar cada ejecución |
| Ejecución individual | Pasos y tiempo de una invocación | Puede reiniciarse en una invocación nueva |
| Hilo o tarea completa | Trabajo acumulado entre turnos y reanudaciones | Requiere identidad y estado compartidos |
| Operación de negocio | Una modificación concreta sobre una entidad | Debe conservarse aunque cambie el intento del modelo |
Una respuesta del modelo puede proponer varias herramientas. Y una llamada lógica puede provocar varios intentos en el adaptador. Por eso un contador de turnos no sustituye un contador de ejecuciones ni un presupuesto de la tarea completa.
En LangChain para JavaScript, los límites de modelo y herramienta admiten ámbitos de ejecución y de hilo; el de hilo necesita persistencia mediante un checkpointer. El límite de herramientas usa continue como comportamiento predeterminado: bloquea llamadas que exceden el límite, pero permite que el modelo y otras herramientas continúen. No lo interpretes como una terminación de toda la tarea. Su modo end tiene restricciones cuando hay varias herramientas pendientes; el modo error necesita que tu aplicación gestione el error como una salida.
La misma documentación distingue los reintentos: maxRetries: 2 son dos reintentos después del intento inicial, tres intentos en total. El comportamiento predeterminado onFailure: "continue" devuelve el fallo al modelo, que puede volver a proponer una llamada. Cuenta también esos nuevos intentos; encadenar reintentos del adaptador y del agente puede multiplicar las ejecuciones.
La guía de ejecución de OpenAI Agents SDK describe la continuidad entre respuestas, herramientas y transferencias. Trata el resultado final, los fallos de límite y las interrupciones por aprobación como casos distintos. Una pausa para aprobar una acción no es éxito ni autoriza a crear una ejecución nueva con el presupuesto intacto.
En Google ADK, el patrón LoopAgent combina ciclos máximos y una salida explícita. Sus ciclos no cuentan necesariamente todas las llamadas a modelos y herramientas. La documentación sitúa ese patrón como plantilla anterior frente a los flujos más flexibles de ADK 2.0 para Python y Go; no lo adoptes como requisito de cualquier agente actual.
Comprueba además el controlador de herramientas. Según la documentación de function calling de OpenAI, tool_choice: "required" exige una o más llamadas; forzar una función exige esa función. Si lo mantienes cuando ya no queda trabajo que requiera herramientas, esa solicitud restringe la posibilidad de una respuesta final ordinaria. Es una causa que debes comprobar en tu configuración, no una explicación universal de todos los bucles.
Una protección ejecutable que devuelve un resultado terminal
Este prototipo JavaScript separa repetición, avance validado, presupuesto y operaciones confirmadas. Es síncrono y serial, con propuestas, reloj, ejecutor y comprobador de dominio simulados. No usa un SDK ni llama a un proveedor.
verify es código de confianza de tu aplicación: comprueba un recibo contra el estado del dominio. No debe limitarse a devolver los campos que haya escrito el modelo. El registro ledger conserva la identidad de la operación y distingue committed, not_committed y unknown.
Los valores de dos repeticiones y tres resultados sin avance son umbrales de demostración. Elige los tuyos según trayectorias correctas y el riesgo de la herramienta.
export function canonical(value) {
  if (Array.isArray(value)) return `[${value.map(canonical).join(',')}]`;
  if (value !== null && typeof value === 'object') {
    return `{${Object.keys(value).sort().map(k =>
      `${JSON.stringify(k)}:${canonical(value[k])}`).join(',')}}`;
  }
  if (value === null || typeof value === 'string' ||
      typeof value === 'boolean' || (typeof value === 'number' &&
      Number.isFinite(value))) return JSON.stringify(value);
  throw new Error('Solo JSON válido');
}

// Prototipo síncrono: JSON, un ejecutor serial y un reloj inyectado.
export function createRunner({ budget, ledger, now, execute, verify,
  initialRevision = 0 }) {
  let terminal = null, revision = initialRevision, idle = 0, lastGood = null;
  const repetitions = new Map();
  const finish = (status, reason, value = lastGood) => terminal ??= {
    status, reason, revision, value,
    used: { models: budget.models, tools: budget.tools }
  };
  return function run(proposals) {
    if (terminal) return terminal;
    for (const call of proposals) {
      if (now() >= budget.deadline) return finish('stopped', 'deadline');
      if (budget.models >= budget.maxModels)
        return finish('stopped', 'model_budget');
      budget.models++; // Reserva antes del siguiente turno simulado.
      if (!call || typeof call.tool !== 'string' || !call.args ||
          !['read', 'write'].includes(call.kind))
        return finish('stopped', 'invalid_call');
      let payload;
      try { payload = canonical({ tool: call.tool, args: call.args }); }
      catch { return finish('stopped', 'invalid_call'); }
      let old = null;
      if (call.kind === 'write') {
        if (typeof call.operationId !== 'string' || !call.operationId)
          return finish('stopped', 'missing_operation_id');
        old = ledger.get(call.operationId);
        if (old && old.payload !== payload)
          return finish('stopped', 'operation_conflict');
        if (old && !['committed', 'not_committed'].includes(old.state))
          return finish('needs_reconciliation', 'unknown_commit');
      }
      let result;
      const cached = old?.state === 'committed';
      if (cached) {
        result = old.result;
      } else {
        const fingerprint = `${payload}@${revision}`;
        const seen = repetitions.get(fingerprint) ?? 0;
        if (seen >= 2) return finish('stopped', 'same_call');
        if (budget.tools >= budget.maxTools)
          return finish('stopped', 'tool_budget');
        repetitions.set(fingerprint, seen + 1);
        budget.tools++; // Reserva antes de ejecutar, incluso si falla.
        if (call.kind === 'write') ledger.set(call.operationId,
          { payload, state: 'unknown' });
        try { result = execute(call); }
        catch {
          return finish(call.kind === 'write' ? 'needs_reconciliation'
            : 'stopped', 'executor_exception');
        }
      }
      if (!result || !['ok', 'retryable', 'fatal', 'needs_human']
          .includes(result.status))
        return finish(call.kind === 'write' ? 'needs_reconciliation'
          : 'stopped', 'invalid_result');
      let checked;
      try { checked = verify(call, result); }
      catch { checked = null; }
      if (!checked || !Number.isSafeInteger(checked.revision) ||
          checked.revision < revision || typeof checked.done !== 'boolean' ||
          !['none', 'committed', 'not_committed', 'unknown']
            .includes(checked.effect) ||
          (checked.done && result.status !== 'ok'))
        return finish(call.kind === 'write' ? 'needs_reconciliation'
          : 'stopped', 'invalid_evidence');
      if (call.kind === 'write') {
        if (!['committed', 'not_committed'].includes(checked.effect) ||
            (cached && checked.effect !== 'committed') ||
            (checked.done && checked.effect !== 'committed'))
          return finish('needs_reconciliation', 'unknown_commit');
        ledger.set(call.operationId, { payload, state: checked.effect, result });
      }
      if (now() >= budget.deadline) return finish('stopped', 'deadline');
      if (result.status === 'fatal') return finish('stopped', 'fatal');
      if (result.status === 'needs_human')
        return finish('needs_human', 'approval');
      if (result.status === 'ok') lastGood = result;
      if (checked.revision > revision) { revision = checked.revision; idle = 0; }
      else idle++;
      if (checked.done) return finish('completed', 'validated_done', result);
      if (result.status === 'retryable' && call.kind === 'write' &&
          checked.effect !== 'not_committed')
        return finish('needs_reconciliation', 'retry_after_commit');
      if (idle >= 3) return finish('stopped', 'no_progress');
    }
    return finish('partial', 'plan_exhausted');
  };
}
El llamador usa el resultado y sale del bucle. Si recibe needs_reconciliation, no vuelve a ejecutar automáticamente. Si alguien vuelve a invocar el mismo runner, obtiene el mismo resultado terminal; la protección no se borra al capturar un error.
Este pequeño ejemplo completa las dependencias anteriores con un ejecutor falso. Puedes guardar ambos bloques en un mismo archivo demo.mjs y ejecutarlo con Node.js. Cada recibo se comprueba contra un registro sintético; no corresponde a un pedido real.
let clock = 0;
const receipts = new Map();
const budget = {
  models: 0, tools: 0, maxModels: 6, maxTools: 4, deadline: 100
};
const ledger = new Map();
const run = createRunner({
  budget, ledger, now: () => clock,
  execute(call) {
    clock += 1;
    const receipt = "fake-order-42";
    receipts.set(receipt, {
      payload: canonical({ tool: call.tool, args: call.args }),
      revision: 1, done: true, effect: "committed"
    });
    return { status: "ok", receipt };
  },
  verify(call, result) {
    const proof = receipts.get(result.receipt);
    if (!proof || proof.payload !==
        canonical({ tool: call.tool, args: call.args })) {
      throw new Error("Recibo no válido");
    }
    return proof;
  }
});
const proposals = [
  { tool: "save", kind: "write",
    operationId: "order-42-confirm", args: { amount: 5 } },
  { tool: "save", kind: "write",
    operationId: "order-42-confirm", args: { amount: 5 } }
];
const outcome = run(proposals);
console.log(outcome.status, outcome.reason, budget.tools);
// completed validated_done 1
// Aquí el llamador devuelve outcome; no solicita otra propuesta.
En la simulación, models reserva un turno por propuesta procesada. Como las propuestas ya están en un array, no limita inferencias que se hayan hecho antes de llamarlo. Al integrar el patrón, reserva el turno antes de llamar al modelo y la ejecución antes de llamar a la herramienta; conserva ambos contadores en la tarea compartida. El control de coste necesita además un presupuesto monetario y una reserva apropiada.
El reloj se comprueba antes y después del ejecutor. Si el ejecutor síncrono no devuelve el control, ese chequeo posterior no puede interrumpirlo. Para trabajo asíncrono necesitas cancelación cooperativa o aislamiento de ejecución, además de un estado que impida nuevos despachos. Un timeout o Promise.race puede dejar de esperar una respuesta sin cancelar la escritura subyacente.
La idempotencia depende de la operación, no del intento
operationId debe identificar una acción estable de negocio, por ejemplo «confirmar el pedido 42 en su versión 3». El identificador de la llamada del modelo cambia entre intentos y no sirve por sí solo para detectar ese duplicado. Comprueba también los argumentos: reutilizar la misma clave con un importe distinto es un conflicto.
El prototipo permite devolver una operación guardada sin ejecutarla otra vez. Pero su Map solo sirve para la simulación serial y mientras se conserve ese objeto. No asegura ejecución única entre procesos, llamadas simultáneas ni reinicios.
Para una integración con efectos externos, necesitas que dos trabajadores no puedan reservar la misma operación simultáneamente: una restricción única o reserva atómica en un registro persistente, junto con la idempotencia que soporte el receptor. Consultar primero si existe una fila y escribir después deja una carrera. Y aunque reserves atómicamente, aún debes resolver el intervalo entre «el receptor confirmó» y «guardé la respuesta».
Por eso unknown bloquea el envío. Consulta el estado del receptor con la identidad estable. Si está confirmado, registra y devuelve el resultado. Si puedes demostrar que no se ejecutó, permite un reintento dentro del presupuesto restante. Si no puedes demostrar ninguna de las dos cosas, mantén la tarea pendiente de reconciliación.
Qué verificamos con el ejecutor falso
Ejecutamos el prototipo y sus casos de control localmente, con reloj inyectado, respuestas sintéticas y un registro serial de operaciones. Las comprobaciones cubren estas fronteras:
| Situación simulada | Resultado observado |
|---|---|
| Lectura idéntica sin avance | Dos ejecuciones; la siguiente se bloqueó antes de llamar al ejecutor |
| Alternancia de herramientas sin avance | Parada por falta de progreso tras tres ejecuciones |
| Páginas con avance validado | Se permitieron tres ejecuciones y terminó al validar el resultado final |
| Solo transcurre tiempo | El reloj avanzó, pero se activó la parada sin progreso |
| Resultado desconocido o revisión que retrocede | Salida segura, sin nuevas ejecuciones |
| Error fatal o aprobación pendiente | Terminación o pausa explícita en la primera ejecución |
| Excepción de escritura o registro en estado desconocido | Reconciliación, sin repetir la escritura |
| Operación ya confirmada | Resultado recuperado con cero ejecuciones nuevas |
| Misma clave con otros argumentos | Conflicto antes de ejecutar |
| Reintento con ausencia de efecto comprobada | Segundo intento permitido y cierre tras la confirmación |
| Plazo agotado después de una escritura confirmada | Parada conservando el registro de la operación |
| Nueva instancia con presupuesto compartido agotado | No pudo ejecutar más herramientas ni eludir el límite de turnos |
También comprobamos que volver a llamar a un runner terminado devuelve el mismo objeto terminal y no aumenta las ejecuciones. Estos resultados validan las ramas del prototipo y esas entradas; no miden la convergencia de un modelo, la cancelación de trabajadores reales ni la seguridad de transacciones paralelas.
La comprobación de «solo transcurre tiempo» usa registros de dominio sin avance, aunque cambien las consultas. El detector no toma el cambio de argumentos como progreso. Para un sondeo válido, adapta deliberadamente la política de espera sin borrar el límite total.
Cómo recuperar la tarea sin empezar desde cero
Guarda una salida de recuperación con estado, avance validado, presupuesto consumido y operaciones pendientes. Puede tener esta forma; los números son ilustrativos:
{
  "task_id": "task-42",
  "status": "needs_reconciliation",
  "reason": "unknown_commit",
  "validated_revision": 3,
  "used": { "models": 4, "tools": 2 },
  "operation_id": "order-42-confirm",
  "allowed_next_actions": ["query_operation_status", "human_review"]
}
Elige la siguiente acción por evidencia:
- La tarea está completa: devuelve el resultado validado y termina. No hace falta otra llamada para que el modelo «se convenza».
- Solo terminó una herramienta: conserva ese resultado y continúa con otra transición necesaria, siempre que quede presupuesto.
- Falló una lectura y el límite la bloqueó: entrega la información ya comprobada como resultado parcial, prueba una alternativa admitida o explica qué dato falta. No subas el límite automáticamente.
- Hay un fallo transitorio sin efecto: reintenta con espera acotada, clasificación del error y presupuesto restante. Esperar no reinicia el contador.
- Hay una operación de resultado desconocido: reconcilia primero; la siguiente acción permitida es consultar su estado, no volver a escribir.
- Faltan autorización, contexto o aprobación: pausa y pide la intervención correspondiente. Un error de permiso no se arregla con más intentos.
- No queda presupuesto ni alternativa segura: cierra con una razón explícita y conserva lo obtenido.
Si una persona autoriza una reanudación, crea la transición de recuperación y enlázala con la tarea detenida. Conserva el presupuesto global y el registro de operaciones. El runner terminado permanece terminado; la recuperación tiene su propia decisión explícita y no consiste en vaciar contadores.
En un caso publicado en la comunidad de n8n, una herramienta de HubSpot devolvía éxito y el agente seguía repitiéndola. Su autor informó de una mejora al aclarar las instrucciones. Esa observación apoya revisar la condición de salida del prompt; no demuestra que un prompt garantice la idempotencia. La aplicación sigue teniendo que reconocer el resultado y cerrar la transición.
Preguntas frecuentes
¿Basta con aumentar el máximo de iteraciones?
No. Si la tarea no avanza, aumentar el máximo permite más trabajo inútil y puede repetir efectos. Primero determina si el límite cortó una tarea productiva o un ciclo. Amplíalo solo mediante una decisión explícita, con evidencia y presupuesto disponible.
¿Por qué el agente sigue llamando después de que una herramienta devuelva éxito?
Porque el éxito de una herramienta y el fin de la tarea son estados distintos. Comprueba la condición de salida, el registro de la operación y si el controlador sigue forzando herramientas. Cuando la tarea esté validada, el llamador debe devolver un resultado final y dejar de pedir propuestas.
¿Se puede reintentar una escritura después de un timeout?
Solo cuando la identidad estable de la operación y la comprobación del receptor permitan hacerlo sin duplicarla. Un timeout significa que no llegó una respuesta a tiempo, no que el receptor no actuó. Con resultado desconocido, consulta y reconcilia antes de repetir.
¿Hay que bloquear toda repetición para evitar un bucle infinito?
No. La paginación, los lotes y el sondeo pueden necesitar repeticiones. Exige avance verificable o una espera deliberadamente acotada, y mantén el presupuesto total. Un cursor que cambia, un mensaje optimista o un retraso entre llamadas no justifican por sí solos seguir.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 7 oct 2026.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 7 oct 2026.
- 1.API StopRuntimeSessiondocs.aws.amazon.com/bedrock-agentcore/latest/APIReference/API_StopRuntimeSession.html
- 2.Tools Agent de n8ndocs.n8n.io/integrations/builtin/cluster-nodes/root-nodes/n8n-nodes-langchain.agent/tools-agent
- 3.Kepa Tecnología sobre los bucles en agentes n8nkepatecnologia.com/blog/como-evitar-bucles-infinitos-agente-n8n.html
- 4.LangChain para JavaScriptdocs.langchain.com/oss/javascript/langchain/middleware/built-in
- 5.guía de ejecución de OpenAI Agents SDKdevelopers.openai.com/api/docs/guides/agents/running-agents
- 6.patrón LoopAgentadk.dev/agents/workflow-agents/loop-agents
- 7.documentación de function calling de OpenAIdevelopers.openai.com/api/docs/guides/function-calling
- 8.caso publicado en la comunidad de n8ncommunity.n8n.io/t/agent-goes-into-infinite-tool-call-loop/174472