Grok Voice Agent API 接入指南:端点、价格、鉴权与音频收发
Grok Voice Agent API 使用 wss://api.x.ai/v1/realtime,当前模型是 grok-voice-think-fast-2.0,音频每分钟 0.08 美元,另有文本消息费。接入时要完成会话配置、音频输入和输出处理;长期密钥留在服务端,浏览器使用短期令牌。
文章目录
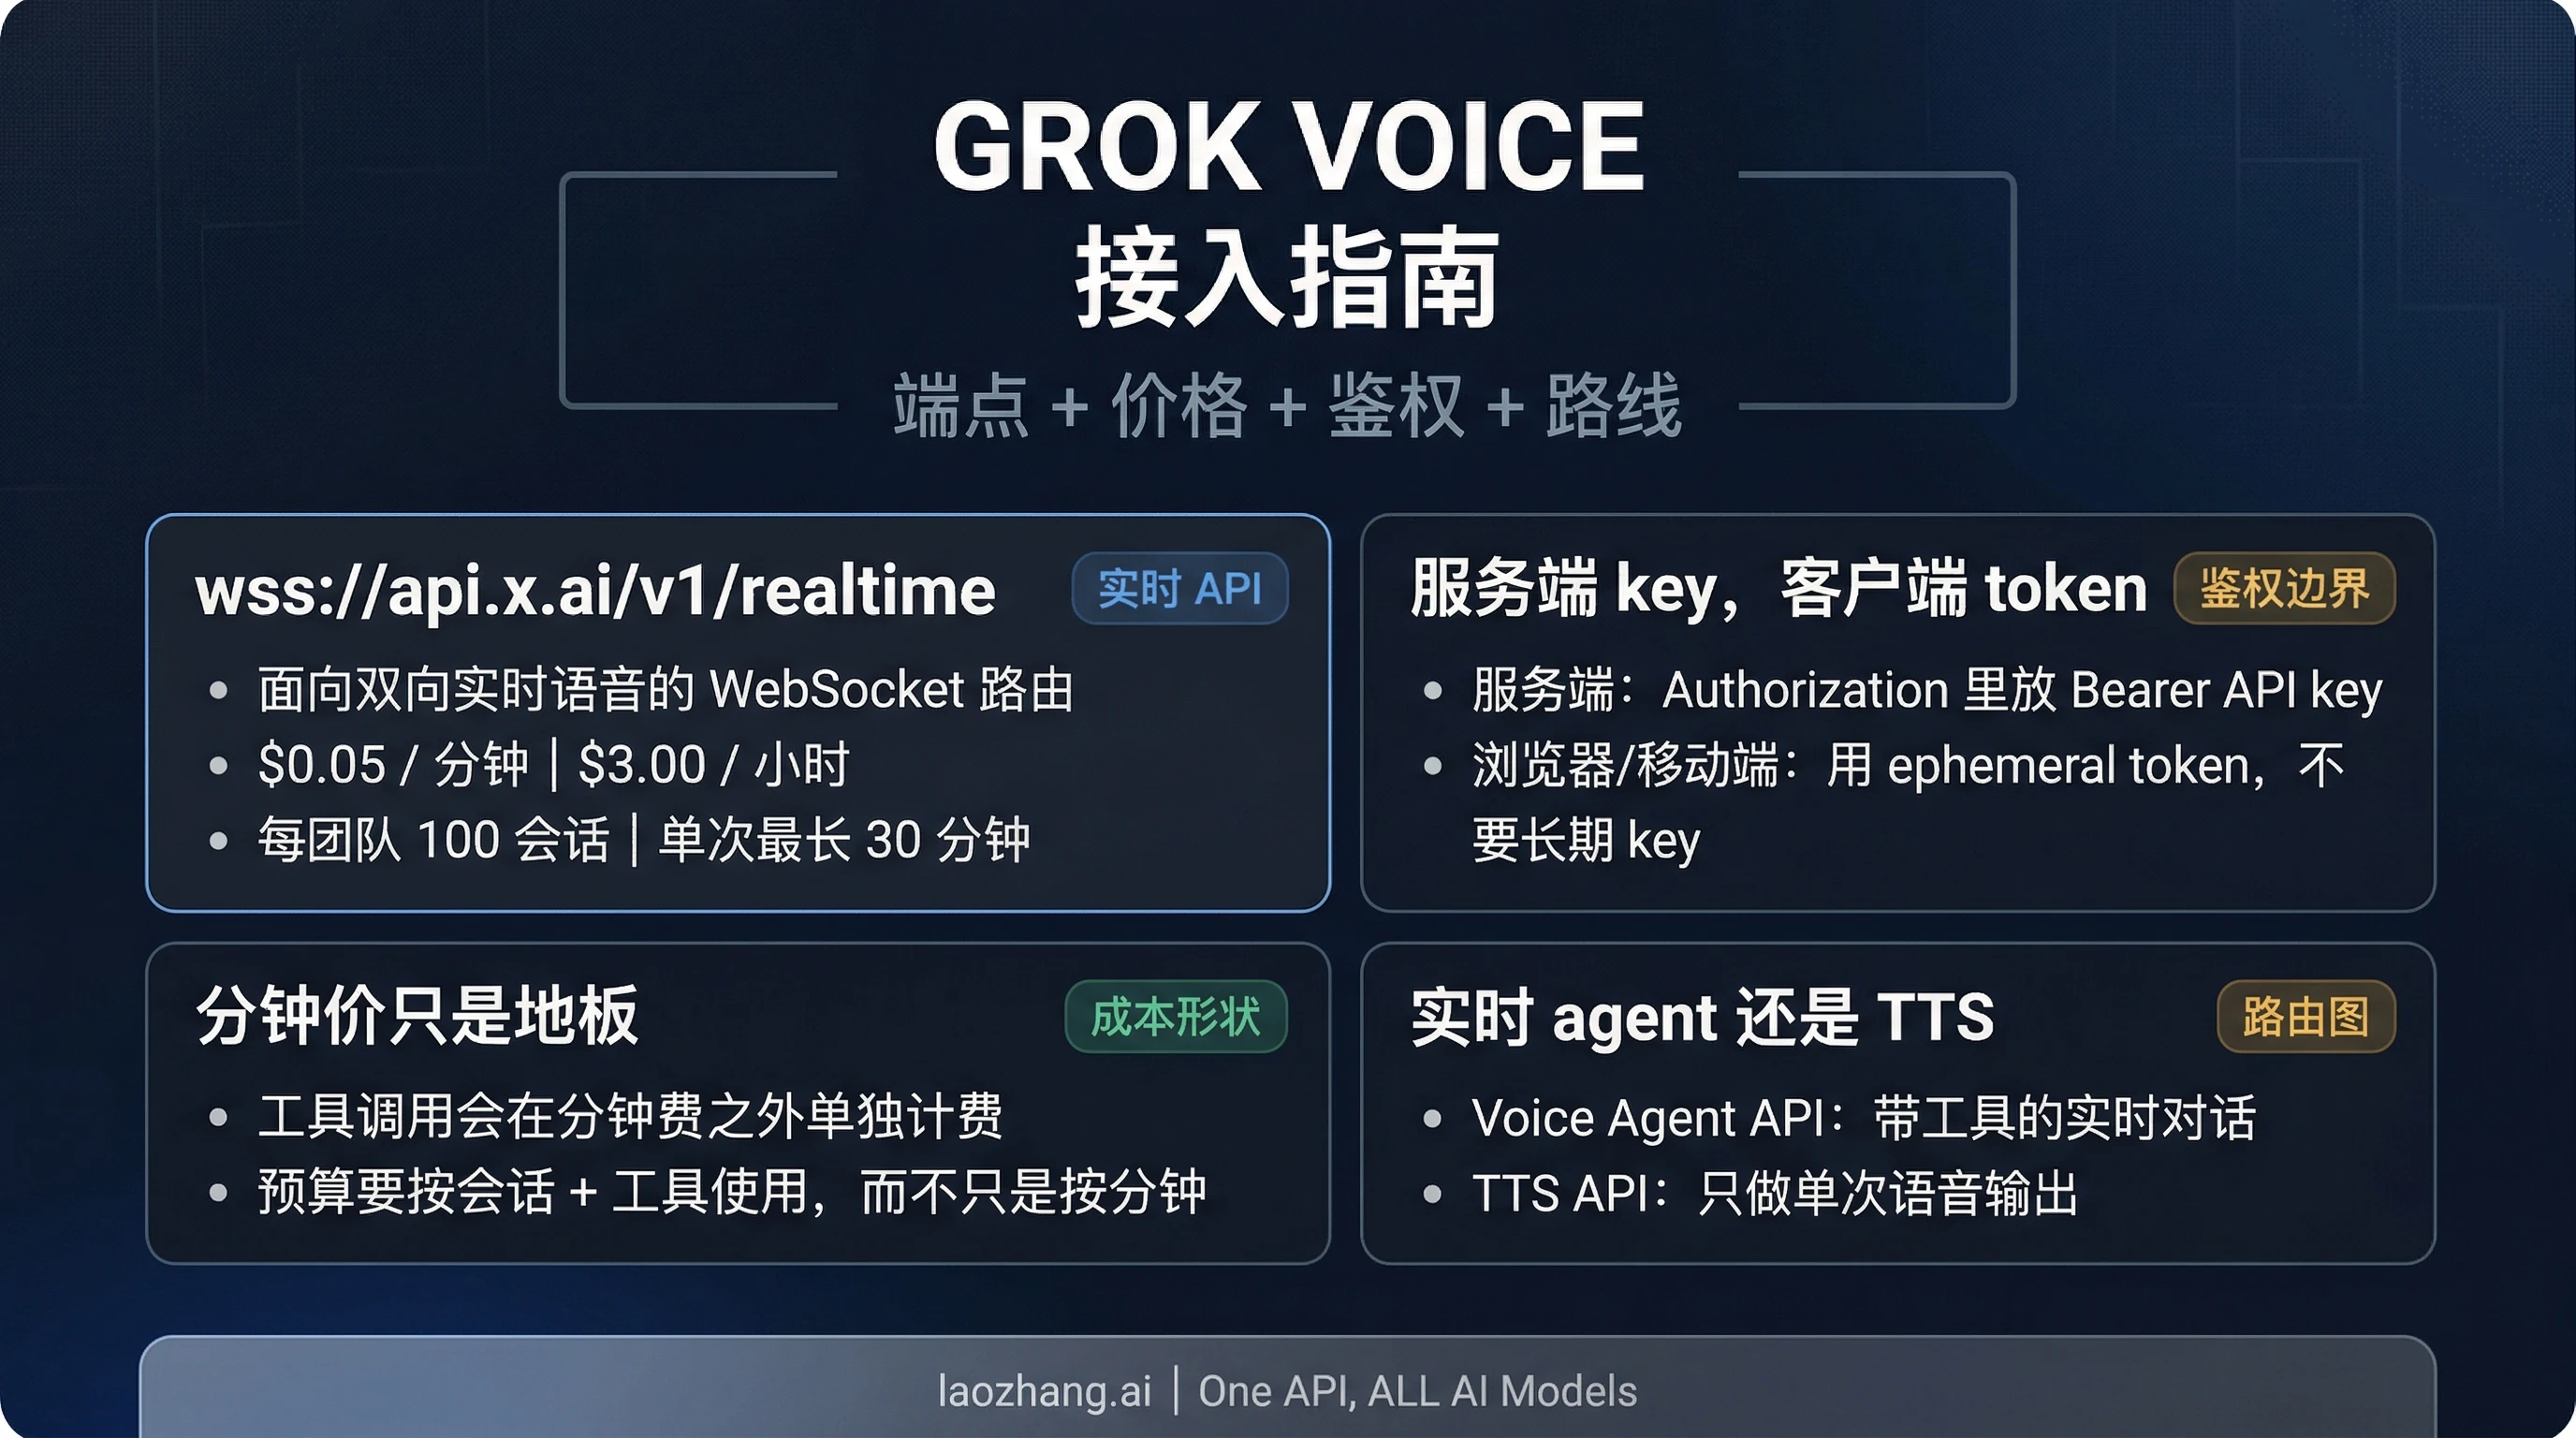
接入 Grok Voice Agent API,可以先在服务端完成一轮“输入一句话或一段音频,拿到可播放的 WAV 文件”,再接浏览器录音和实时回放。实时端点是 wss://api.x.ai/v1/realtime;当前 grok-voice-latest 指向 grok-voice-think-fast-2.0,需要固定版本时直接使用后者。音频费率为 每分钟 0.08 美元,客户端创建的文本消息另按 每条 0.004 美元计费。模型与会话配置、价格与计量说明
真正跑通的判断应包括:收到 session.updated,输入进入会话,接到音频增量,最终响应状态为 completed,并且输出文件能播放。只看到 WebSocket 已连接,或者只收到文字,都还没有完成音频链路。下面的程序按当前公开协议编写,并做了离线语法与音频封装检查;没有实际调用 xAI,也没有测量延迟或账单。
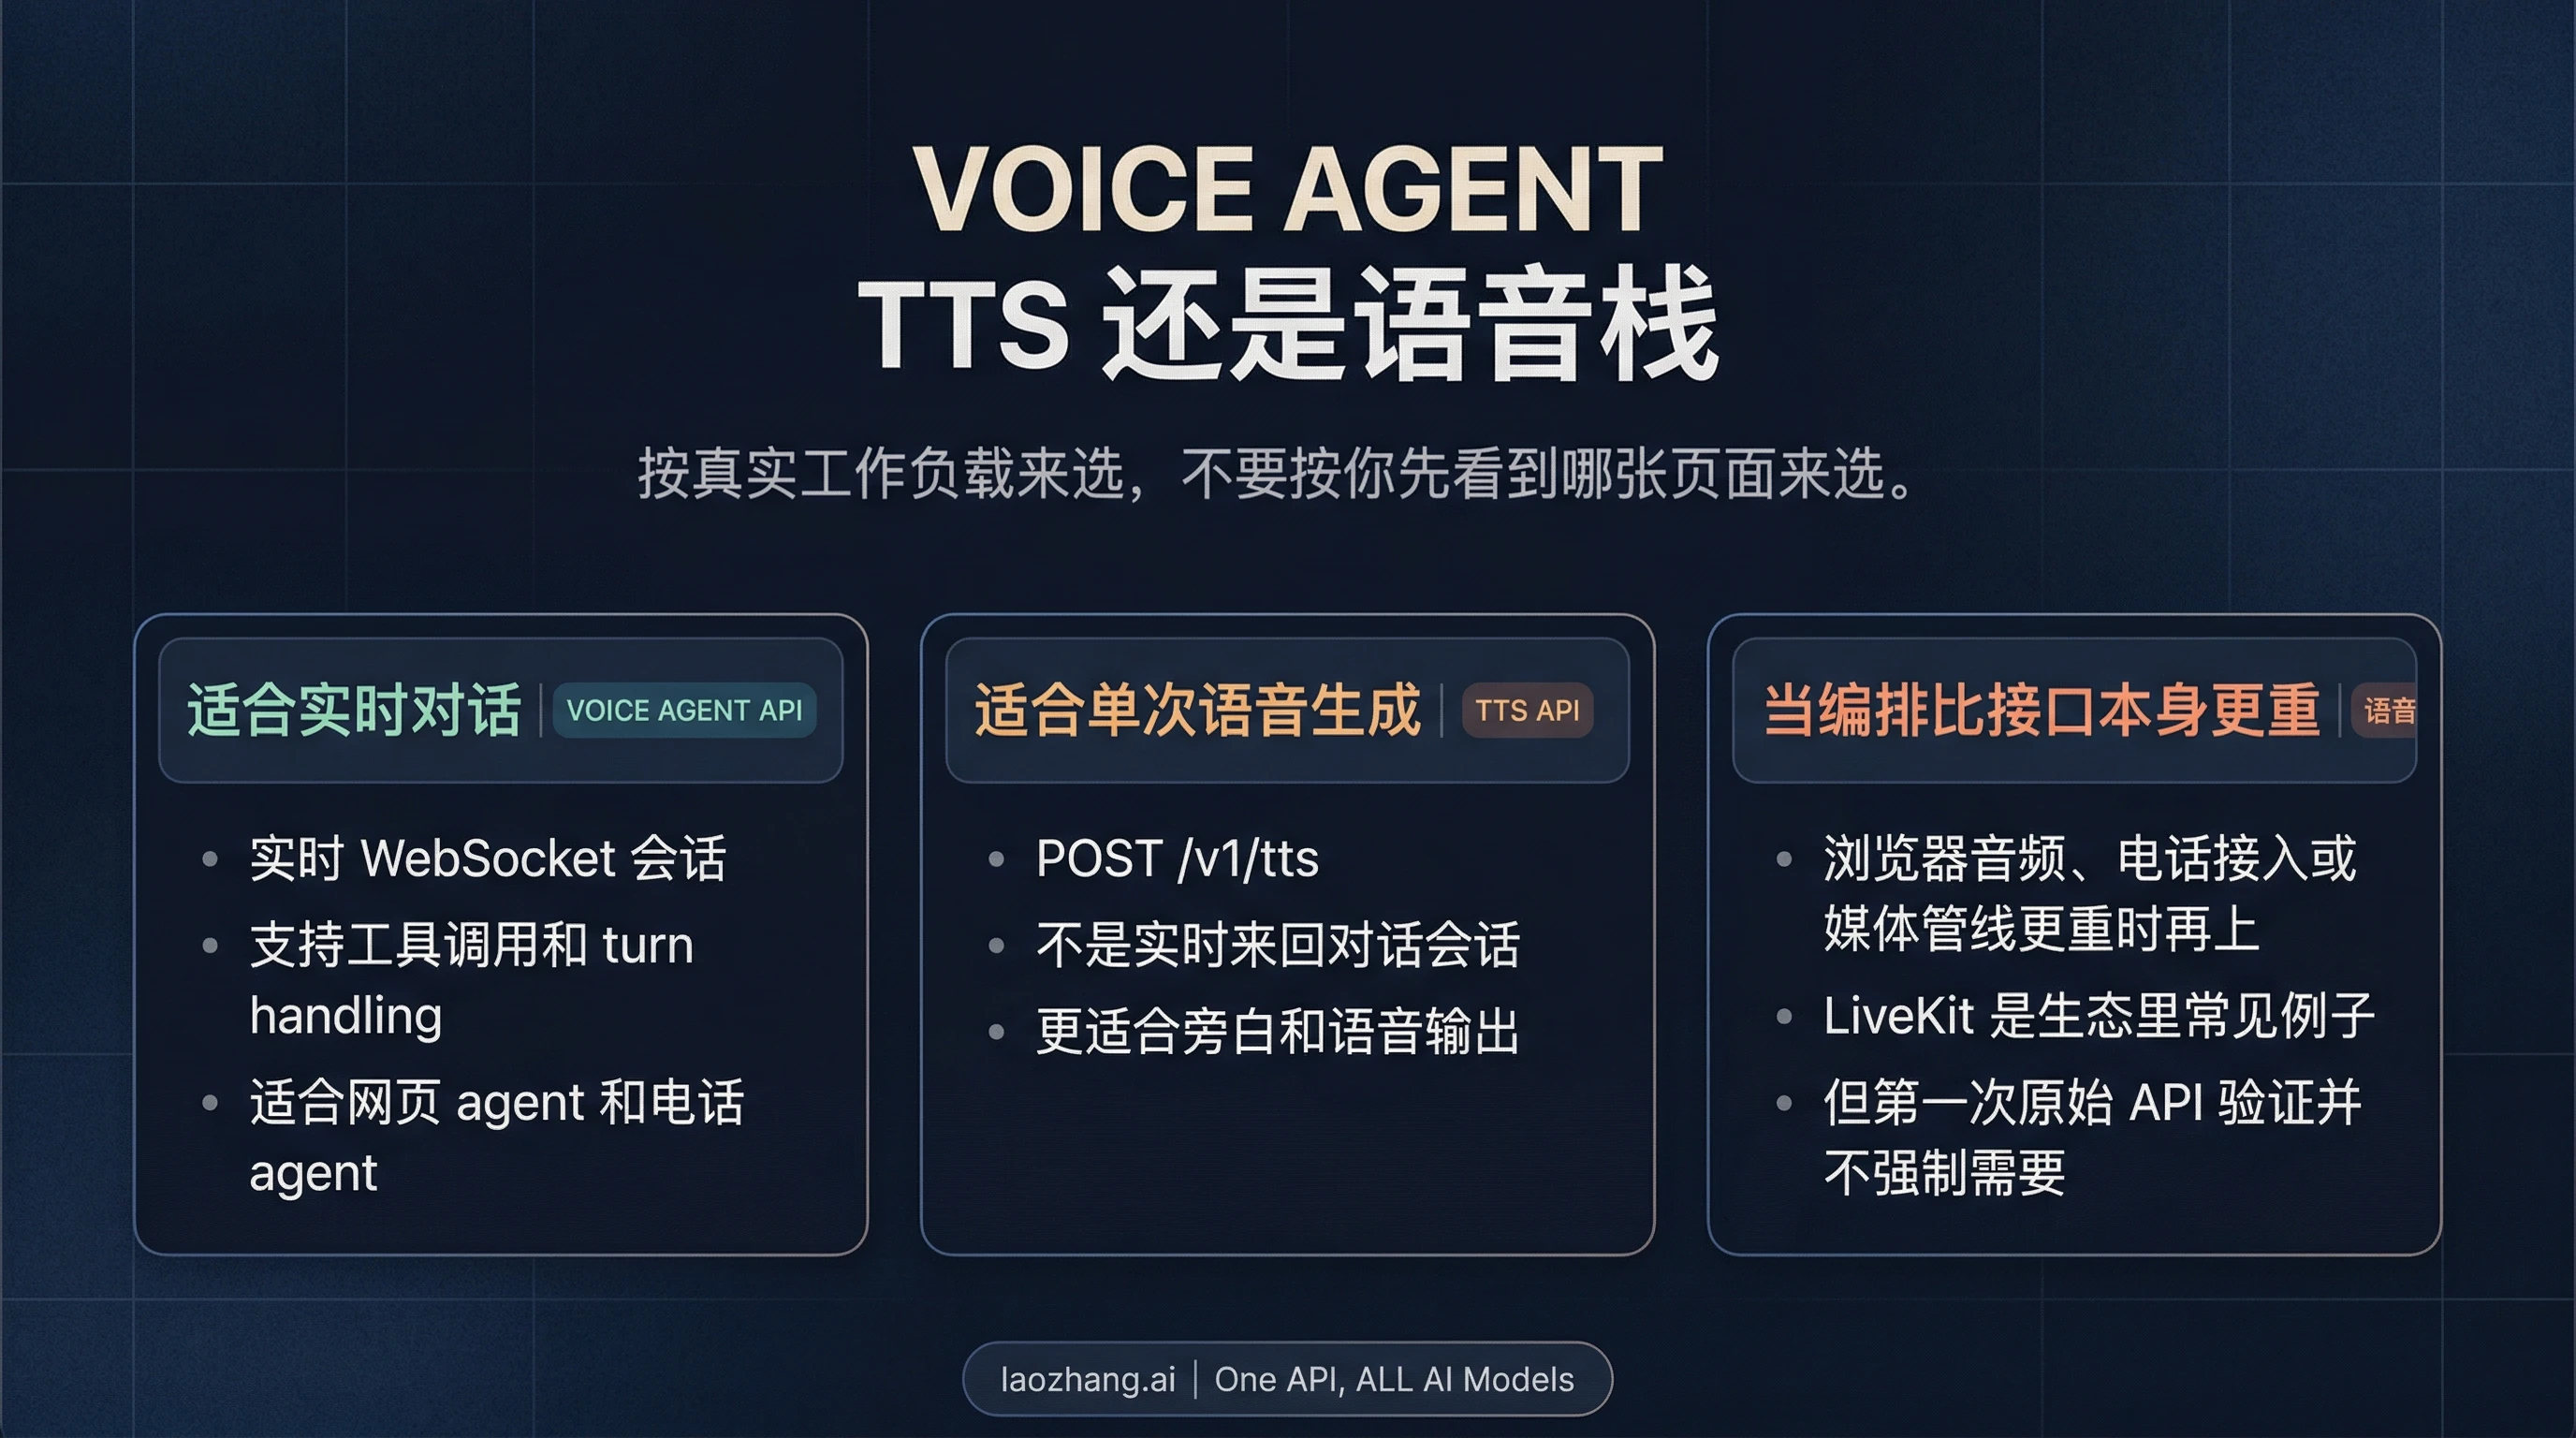
先判断你到底要接哪条语音路
| 需求 | 接入路线 | 最终输出 |
|---|---|---|
| 用户说话,助手理解后立即回答 | Voice Agent API:wss://api.x.ai/v1/realtime | 对话中的语音、文字及工具事件 |
| 给一段文字配音 | 独立 TTS:POST /v1/tts,也有 WebSocket 流式路线 | 合成音频 |
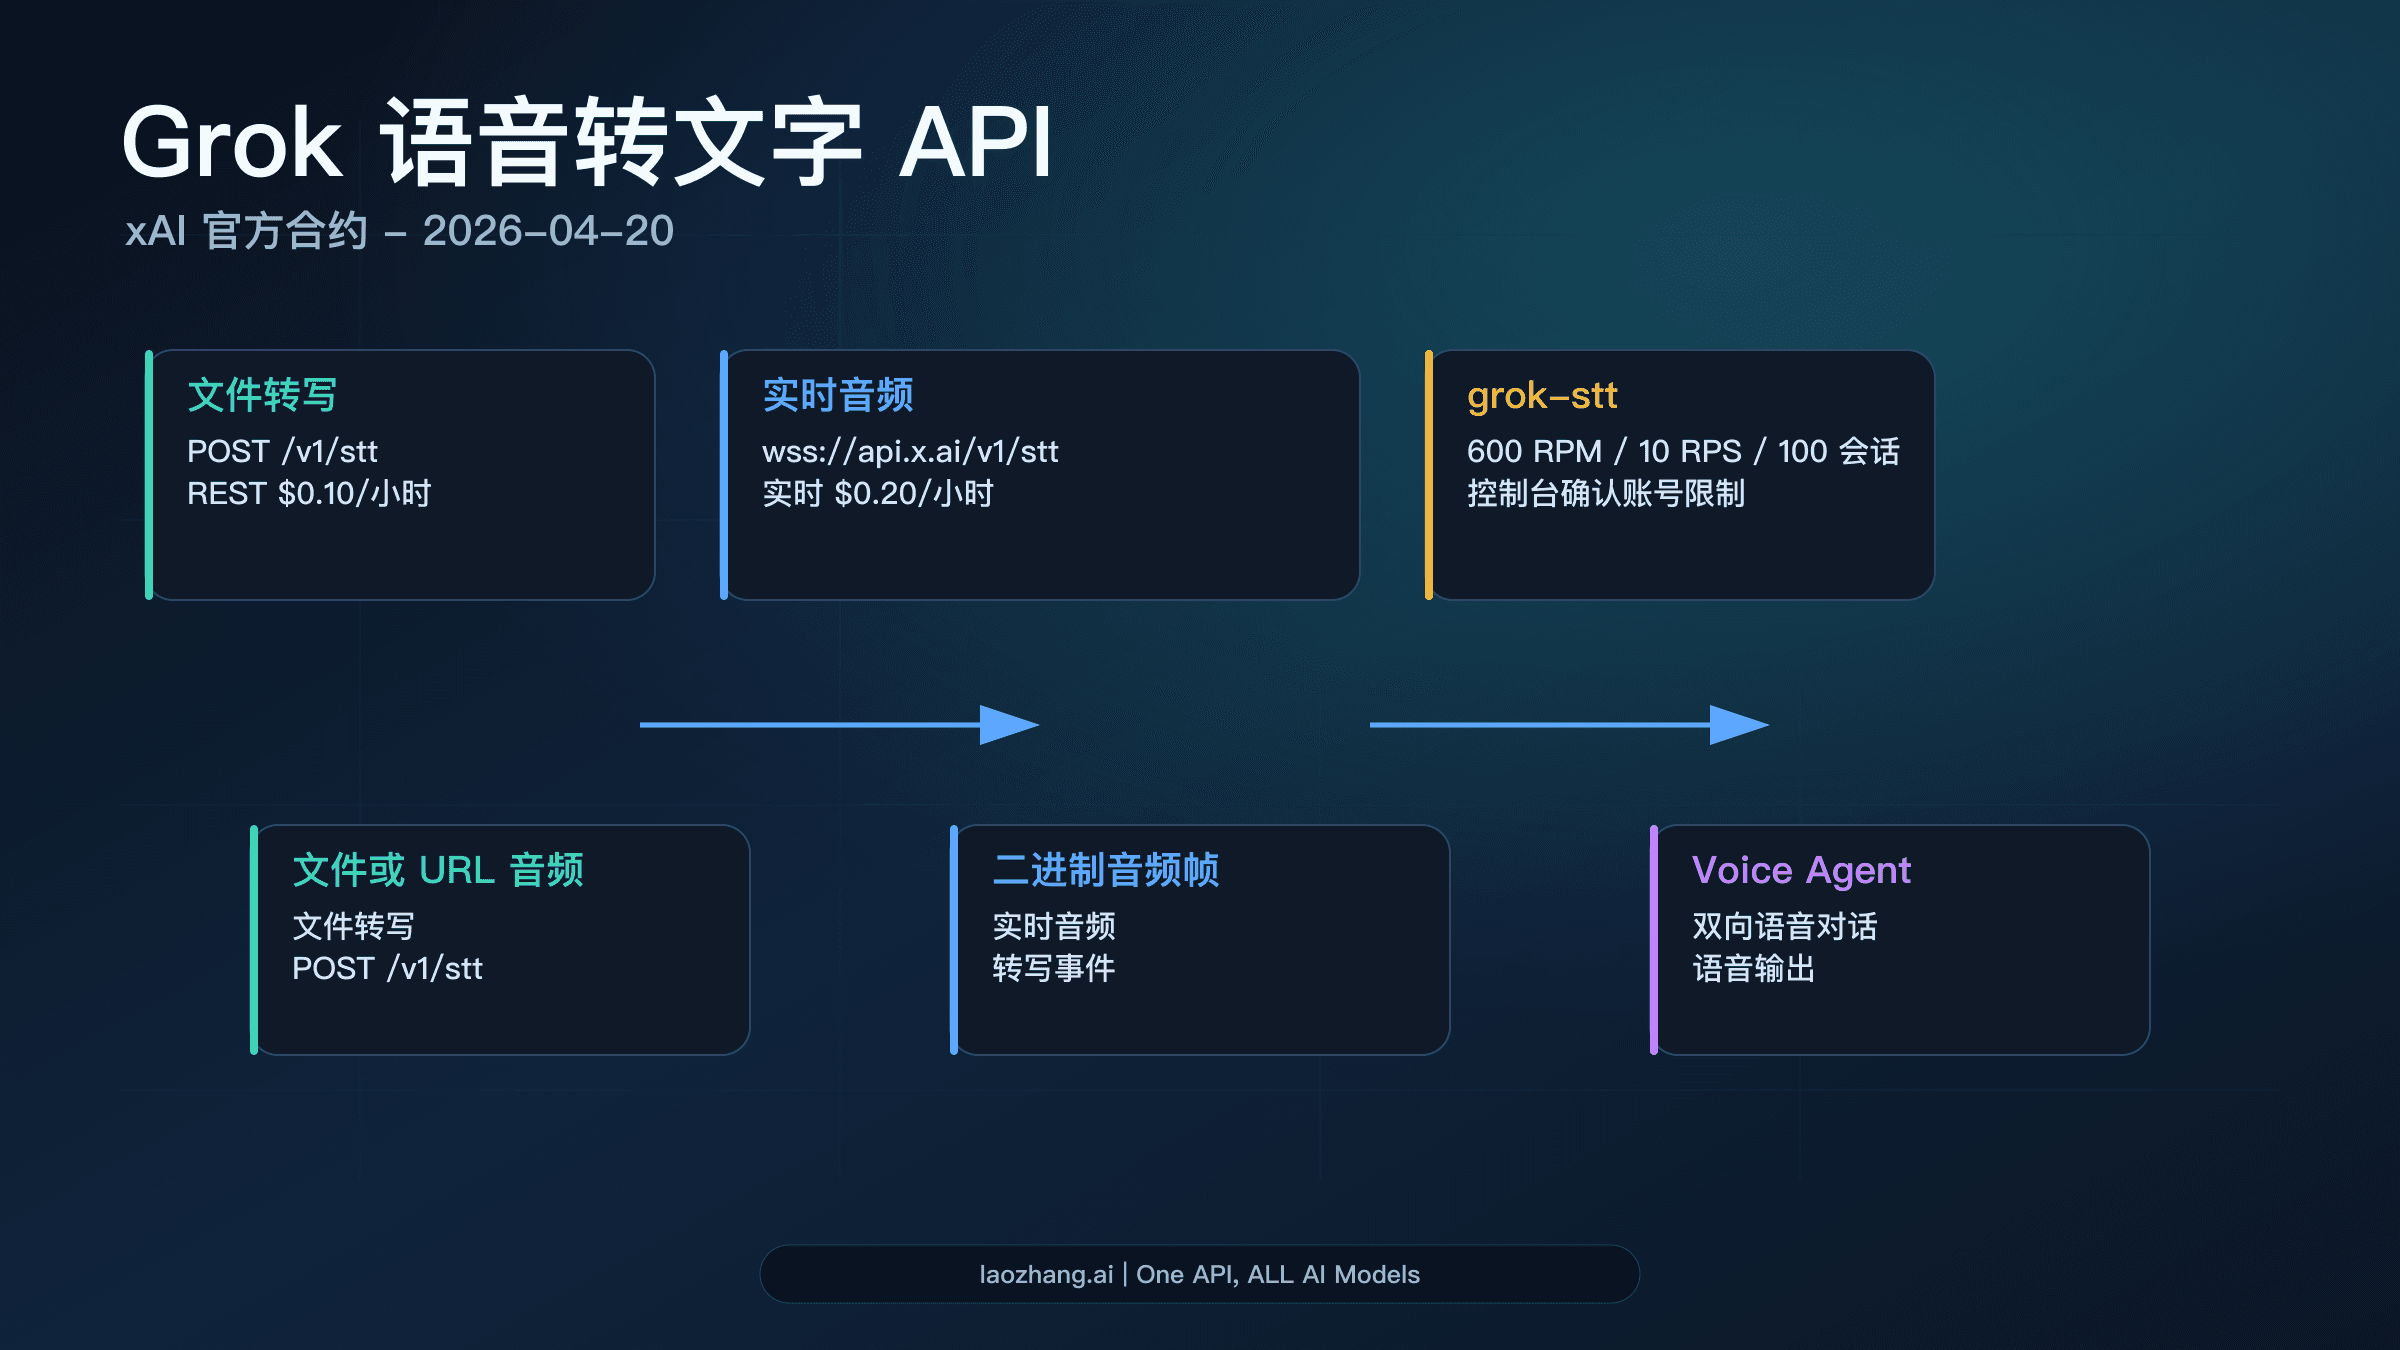
| 把录音、音频 URL 或实时声音转成文字 | 独立 STT:POST /v1/stt 或 wss://api.x.ai/v1/stt | 转写文本 |
| 已经卡在电话接入、媒体转发或多人音频编排 | 在上述接口外接媒体框架或电话平台 | 由应用组织的媒体会话 |
TTS 流式返回音频,并不等于它承担双向对话。STT 只做转写,也不负责生成助手回答。实时会话中的输入转写使用 grok-transcribe;独立 STT 当前默认模型是 grok-voice-transcribe-2.0,两者的配置不能互换。只做转写或配音时,直接查官方语音路线说明和对应接口参考,无需先建立一个对话循环。
一屏看懂今天能直接用的公开接入信息
以下规格核对于 2026 年 10 月 7 日,适用于文档描述的直接 WebSocket 语音会话。
| 项目 | 当前公开说明 |
|---|---|
| 实时端点 | wss://api.x.ai/v1/realtime,握手成功升级状态为 101 |
| 模型 | grok-voice-latest 或固定版本 grok-voice-think-fast-2.0 |
| 推理设置 | reasoning.effort 为 high 或 none,默认 high |
| 音频费率 | 每分钟 0.08 美元,折算每小时 4.80 美元 |
| 文本消息费 | 客户端发送的 conversation.item.create 每条 0.004 美元,适用例外见费用章节 |
| 公开运行上限 | 每团队 10 个并发会话;单会话最长 120 分钟 |
| 自助区域 | us-east-1 |
| 默认音频 | 24 kHz、16 位小端 PCM;输入、输出可分别配置 |
| 服务端鉴权 | Authorization: Bearer <API_KEY> |
| 浏览器鉴权 | 后端签发短期令牌,通过 xai-client-secret.<TOKEN> 子协议传入 |
出处:实时接口参考、模型卡、音频配置。并发上限、单会话时长和令牌有效期是三个不同的约束,不能互相替代。
最快又安全的接入顺序
第一次接入,建议在可信服务端完成完整的一轮收发。这样可以先排除浏览器录音格式和播放队列的问题:
- 使用长期密钥建立连接。
- 发送
session.update,等session.updated后再发输入。 - 手动音频回合发送
append → commit,收到committed后发送response.create;文本输入则创建消息后直接请求响应。 - 解码音频增量,同时显示语音转录。
- 在
response.done检查状态,封装输出音频,然后关闭连接。
这些步骤使用手动回合,即 turn_detection: { type: null }。自动 VAD 的步骤不同,下一节单独说明。官方回合与消息流程
完整示例:文本或 PCM 输入,保存为 WAV
准备 Node.js 运行环境与 ws 包,将以下代码保存为 voice-once.mjs。密钥通过服务端环境变量 XAI_API_KEY 提供;不要把此脚本及密钥搬进网页。默认输入是一句中文文本,使用 --pcm 可以改成音频输入。音频文件必须事先转换为单声道、24 kHz、16 位小端的原始 PCM,不能把 WAV 文件头或 MP3 文件直接当原始数据发送。
import WebSocket from "ws";
import { readFileSync, writeFileSync } from "node:fs";

const rate = 24000;
const key = process.env.XAI_API_KEY;
if (!key) throw new Error("服务端缺少 XAI_API_KEY");
const args = process.argv.slice(2);
const pcmMode = args[0] === "--pcm";
if (pcmMode && !args[1]) throw new Error("请提供原始 PCM 文件路径");
const pcm = pcmMode ? readFileSync(args[1]) : null;
if (pcm && (pcm.length === 0 || pcm.length % 2 !== 0)) {
  throw new Error("PCM 文件不能为空,16 位采样的字节数必须为偶数");
}
const text = args.join(" ") || "请用中文说一句欢迎语,并介绍你能做什么。";

function asWav(body) {
  const header = Buffer.alloc(44);
  header.write("RIFF", 0);
  header.writeUInt32LE(body.length + 36, 4);
  header.write("WAVE", 8);
  header.write("fmt ", 12);
  header.writeUInt32LE(16, 16);
  header.writeUInt16LE(1, 20); // PCM
  header.writeUInt16LE(1, 22); // 单声道
  header.writeUInt32LE(rate, 24);
  header.writeUInt32LE(rate * 2, 28);
  header.writeUInt16LE(2, 32);
  header.writeUInt16LE(16, 34);
  header.write("data", 36);
  header.writeUInt32LE(body.length, 40);
  return Buffer.concat([header, body]);
}

const ws = new WebSocket(
  "wss://api.x.ai/v1/realtime?model=grok-voice-think-fast-2.0",
  { headers: { Authorization: `Bearer ${key}` } },
);
const audio = [];
let transcript = "";
let textOutput = "";
let submitted = false;
let ended = false;

function send(event) {
  if (ws.readyState !== WebSocket.OPEN) {
    throw new Error("连接已关闭,不能发送事件");
  }
  ws.send(JSON.stringify(event), (error) => {
    if (error) stop(error);
  });
}
function stop(error) {
  if (ended) return;
  ended = true;
  clearTimeout(deadline);
  if (error) {
    process.exitCode = 1;
    console.error(error.message);
  }
  if (ws.readyState === WebSocket.OPEN) ws.close(1000, "done");
  else ws.terminate();
}
function requestAudio() {
  send({ type: "response.create", response: { modalities: ["audio"] } });
}
const deadline = setTimeout(() => {
  stop(new Error("90 秒内未完成,本地结束等待"));
}, 90000);

ws.on("open", () => {
  send({
    type: "session.update",
    session: {
      voice: "eve",
      instructions: "请用自然的中文回答,回答简短、具体。",
      turn_detection: { type: null },
      audio: {
        input: { format: { type: "audio/pcm", rate }, transport: "json" },
        output: { format: { type: "audio/pcm", rate }, transport: "json" },
      },
    },
  });
});
ws.on("message", (data, isBinary) => {
  if (ended) return;
  try {
    if (isBinary) throw new Error("配置为 JSON 输出,却收到了二进制帧");
    const event = JSON.parse(data.toString());
    if (event.type === "session.updated" && !submitted) {
      submitted = true;
      if (pcm) {
        // 每块 100 ms:24000 × 0.1 × 2 = 4800 字节。
        for (let offset = 0; offset < pcm.length; offset += 4800) {
          send({
            type: "input_audio_buffer.append",
            audio: pcm.subarray(offset, offset + 4800).toString("base64"),
          });
        }
        send({ type: "input_audio_buffer.commit" });
      } else {
        send({
          type: "conversation.item.create",
          item: {
            type: "message", role: "user",
            content: [{ type: "input_text", text }],
          },
        });
        requestAudio();
      }
    } else if (event.type === "input_audio_buffer.committed" && pcm) {
      requestAudio();
    } else if (event.type === "response.output_audio.delta") {
      audio.push(Buffer.from(event.delta, "base64"));
    } else if (event.type === "response.output_audio_transcript.delta") {
      transcript += event.delta;
      process.stdout.write(event.delta);
    } else if (["response.text.delta", "response.output_text.delta"].includes(event.type)) {
      textOutput += event.delta;
    } else if (event.type === "error") {
      const e = event.error || {};
      stop(new Error(JSON.stringify({
        type: e.type, code: e.code, message: e.message,
        param: e.param, event_id: e.event_id,
      })));
    } else if (event.type === "response.done") {
      if (event.response?.status !== "completed") {
        throw new Error(`响应未完成:${event.response?.status || "unknown"}`);
      }
      const body = Buffer.concat(audio);
      if (body.length === 0 || body.length % 2 !== 0) {
        throw new Error("没有收到完整 PCM;检查输出模态、格式和音频事件");
      }
      writeFileSync("answer.wav", asWav(body));
      console.log(`\n已保存 answer.wav,音频 ${(body.length / (rate * 2)).toFixed(2)} 秒`);
      if (!transcript && textOutput) console.log(textOutput);
      stop();
    }
  } catch (error) {
    stop(error);
  }
});
ws.on("error", (error) => stop(error));
ws.on("unexpected-response", (_request, response) => {
  response.resume();
  stop(new Error(`WebSocket 握手失败,HTTP ${response.statusCode}`));
});
ws.on("close", (code) => {
  if (!ended) stop(new Error(`响应结束前连接关闭,code=${code}`));
});
process.on("SIGINT", () => stop(new Error("用户中止")));
由你在自己的服务端执行:
npm install ws
node voice-once.mjs "用中文解释什么是实时语音对话。"
# 或者发送已经准备好的原始 PCM 文件:
node voice-once.mjs --pcm question.pcm
正常结果是控制台出现助手的语音转录,当前目录产生 answer.wav。completed 加上非空 PCM 是程序的成功条件;最终是否可听,还要播放文件确认。如果连接中断或响应为 cancelled、incomplete,程序报错退出,不把残缺音频写成成功结果。这里选择一轮结束即关闭,并将所有协议错误按失败处理;长连接应用可以根据具体错误恢复,而不是照搬这一收尾策略。
这个例子将音频收完后保存文件,没有实时播放,也没有采集麦克风。把它接进产品时,音频增量应进入自己的播放队列,录音端应提供符合配置的采样数据。Node ws 的文本帧也可能以 Buffer 提供,判断二进制音频要看 isBinary,不能只看 Buffer.isBuffer(data)。
手动回合、自动 VAD 与音频格式怎么配
按钮按住说话、松开提交,适合手动回合:设置 turn_detection.type 为 null,上传音频后提交,再请求回答。自然交谈则用 server_vad:持续发送 input_audio_buffer.append,服务器识别说话结束后自动生成回答,不要重复发送 commit 或每轮再补一次 response.create。音频与回合说明
自动模式可以把上例会话配置改为 turn_detection: { type: "server_vad" },但也必须同时改变发送逻辑和连接生命周期:麦克风持续供给音频,不发送手动提交事件,每次 response.done 完成当前回答后继续等待下一轮。仅改一个配置值,却保留上例的“提交、请求、退出”,不能成为连续对话程序。
format 决定编码,transport 决定编码后的字节怎么传:
| 编码或传输 | 正确输入形态 | 需要注意什么 |
|---|---|---|
audio/pcm | 16 位小端采样,示例使用 24 kHz 单声道 | 原始帧不包含 WAV 文件头;播放端按配置采样率解释 |
audio/pcmu / audio/pcma | 8 kHz G.711 μ-law / A-law | 不能按 PCM16 解码 |
audio/opus | 24 kHz 单声道原始 Opus 包,每个载荷一个包 | 浏览器录音产生的 WebM 容器块不等于原始 Opus 包 |
transport: "json" | JSON 事件中的 Base64 字段 | 音频增量解码为字节后,再交给音频解码器 |
transport: "binary" | WebSocket 二进制帧中的原始编码数据 | 生命周期和转录事件仍为 JSON 文本帧 |
输入和输出格式可以不同。输出会严格走已选的传输方式;会话中切换输出传输方式,从下一次响应边界开始生效,当前一句话不会混合两种方式。格式与传输契约
中文实时字幕可在 audio.input 中增加:
{
  "transcription": {
    "model": "grok-transcribe",
    "language_hint": "zh"
  }
}
输入事件 conversation.item.input_audio_transcription.updated 是到目前为止的完整字幕,可能修正前面的字,应替换对应消息的字幕,不应每次追加。助手的 response.output_audio_transcript.delta 才是增量追加。language_hint 帮助输入识别;希望助手始终说中文,应在 instructions 中说明,两者作用不同。转写事件、语言提示
浏览器鉴权:短期令牌由自己的后端签发
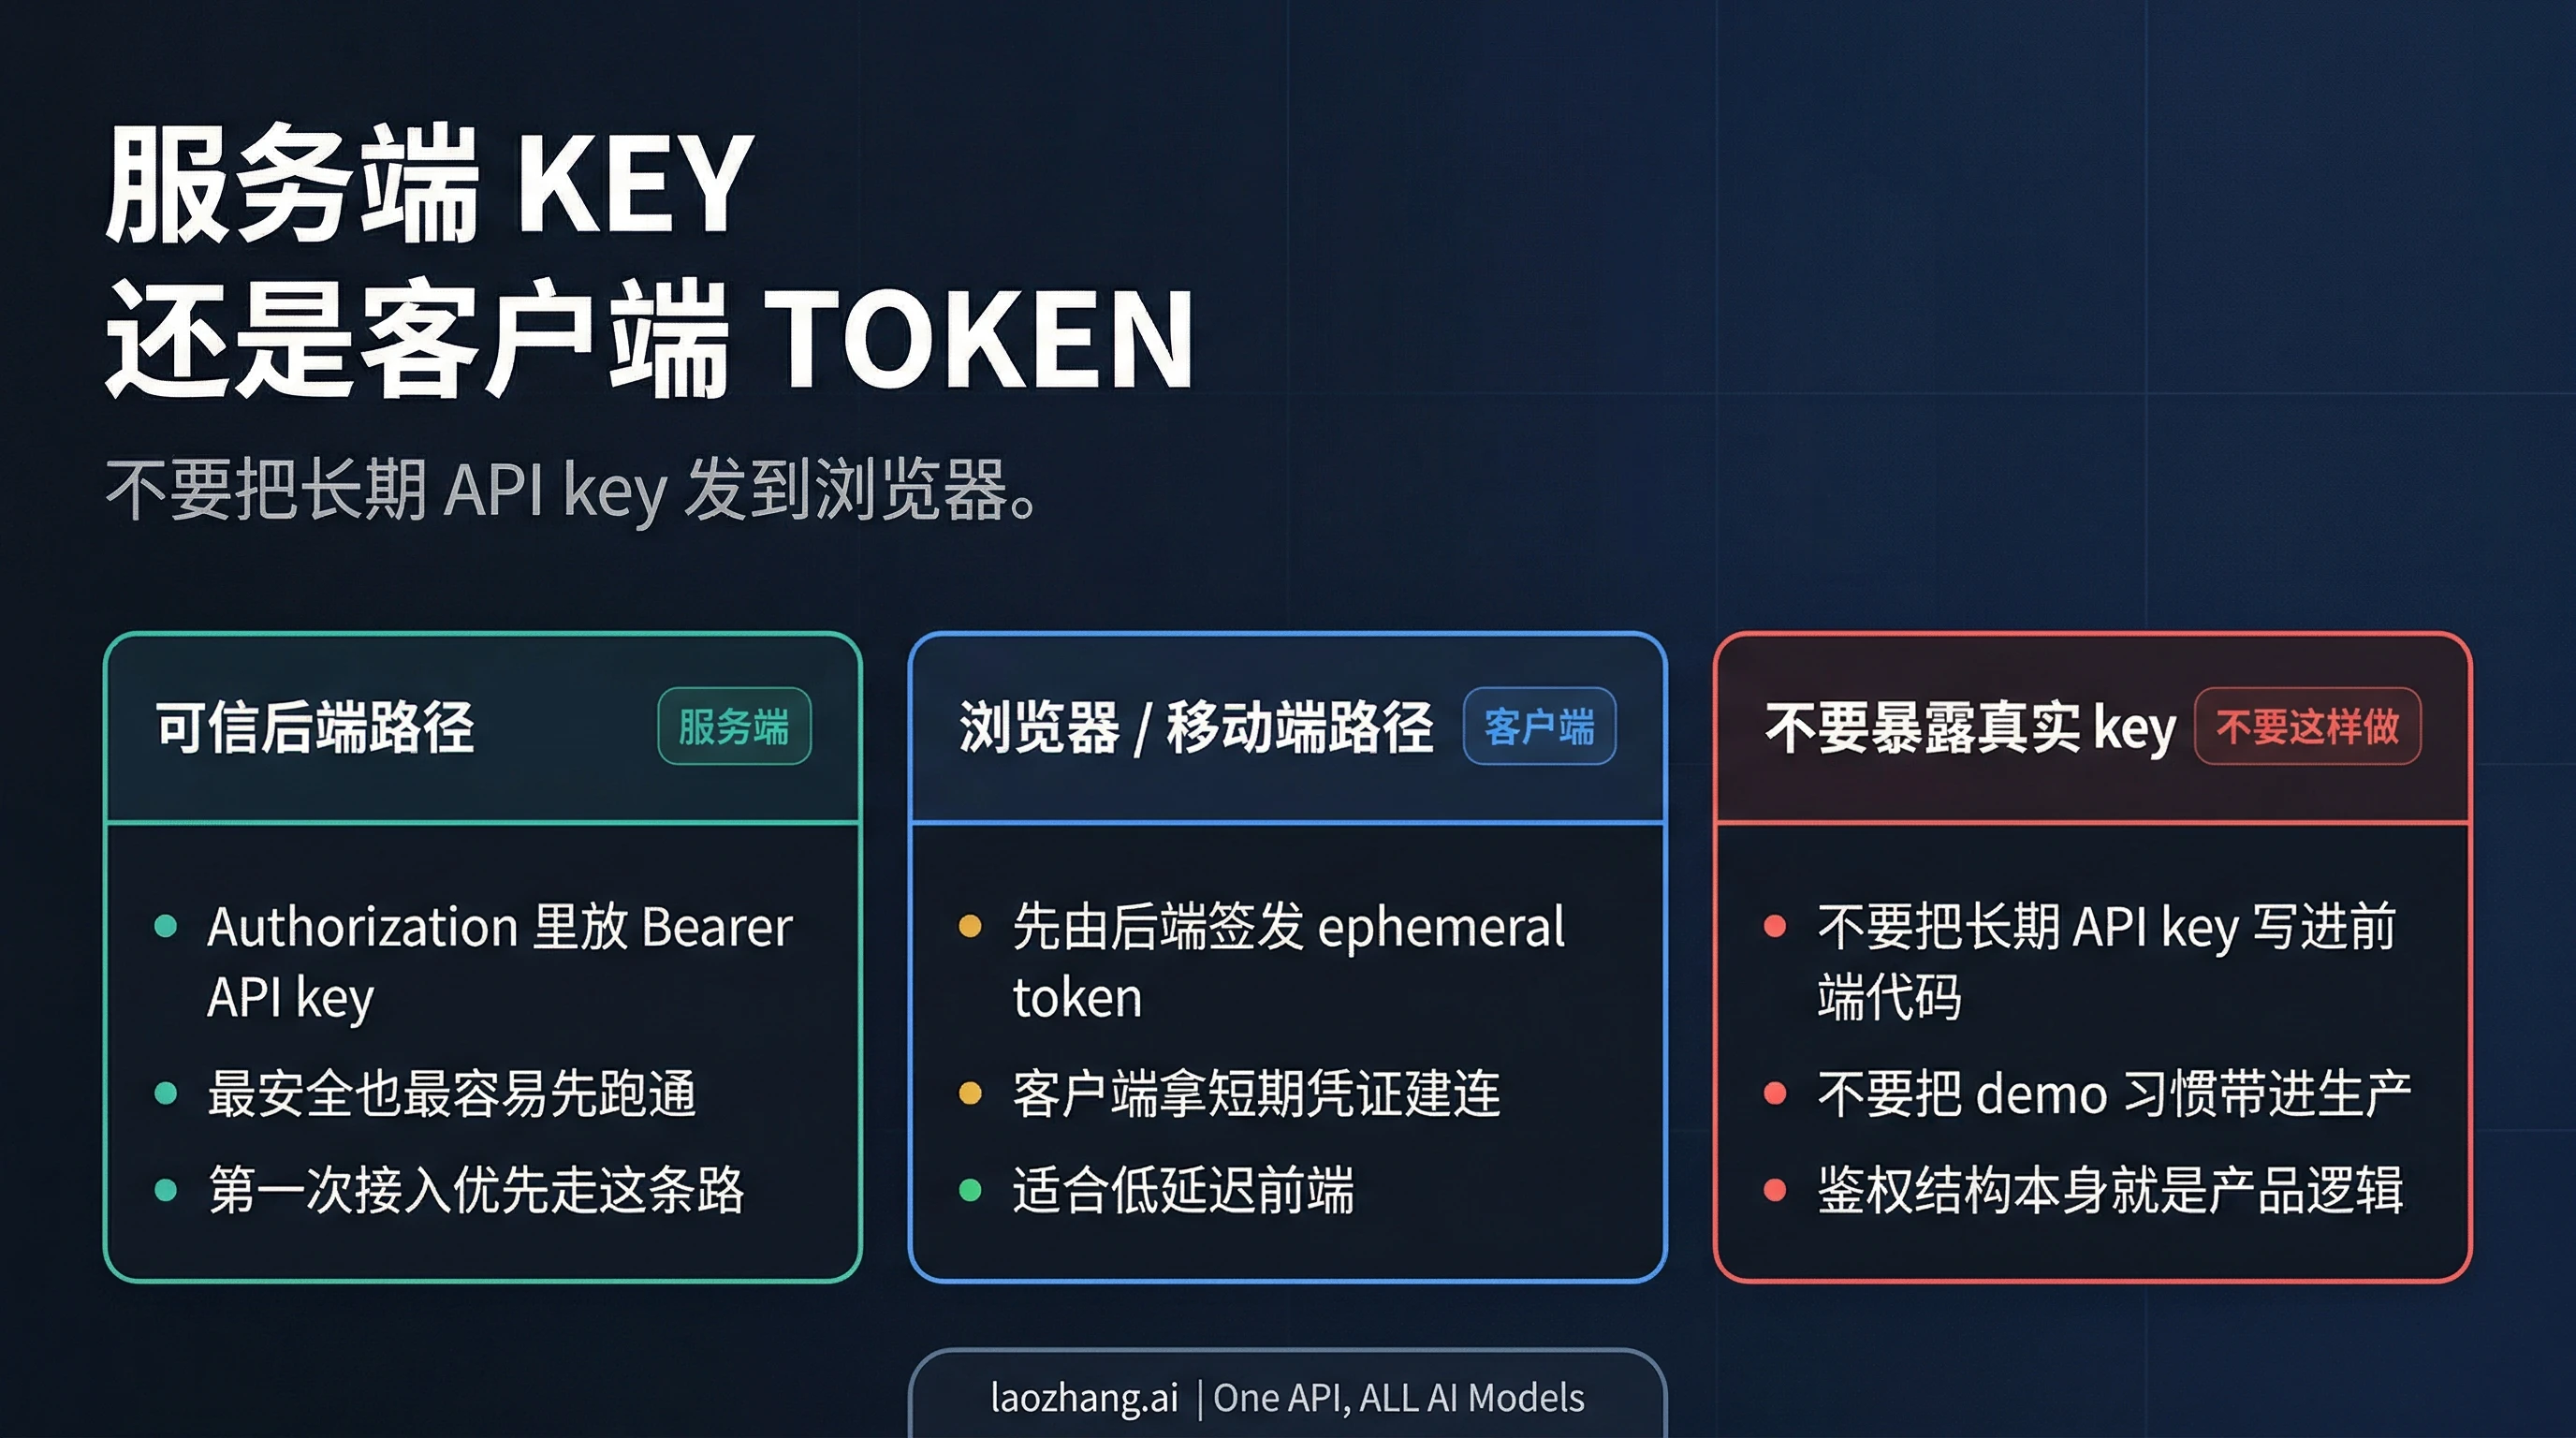
长期 API key 只留在服务端。浏览器原生 WebSocket 无法像 Node 客户端那样任意设置 Authorization 请求头,应先向自己的后端获取短期令牌,再通过子协议连接。令牌签发接口是 POST https://api.x.ai/v1/realtime/client_secrets,返回字段是 value 和 expires_at。官方短期令牌流程
下面的函数供已有后端调用。userId 必须来自服务器已经验证的登录会话,reserveSession 必须是应用自己的用量检查与预留函数;它们不是从客户端请求体中取来的可信值。这是签发函数,不是完整的登录或路由实现。
export async function issueVoiceSecret({ userId, apiKey, reserveSession }) {
  if (!userId) throw new Error("需要登录");
  if (!apiKey) throw new Error("服务端缺少密钥");
  await reserveSession(userId); // 由应用检查额度、并发和请求频率
  const response = await fetch("https://api.x.ai/v1/realtime/client_secrets", {
    method: "POST",
    headers: {
      Authorization: `Bearer ${apiKey}`,
      "Content-Type": "application/json",
    },
    body: JSON.stringify({ expires_after: { seconds: 300 } }),
    signal: AbortSignal.timeout(10000),
  });
  if (!response.ok) throw new Error(`令牌签发失败,HTTP ${response.status}`);
  const data = await response.json();
  if (typeof data.value !== "string" || !Number.isInteger(data.expires_at)) {
    throw new Error("令牌响应字段不完整");
  }
  return { value: data.value, expires_at: data.expires_at };
}
将它接到自己经过登录校验的 POST /api/voice-secret 路由,响应设置 Cache-Control: no-store,失败时按应用规则释放用量预留。不要把上游密钥、令牌值或完整鉴权头写入日志。前端的建连部分如下;音频处理仍需接入上一节的收发逻辑及浏览器播放队列:
async function connectVoice() {
  const response = await fetch("/api/voice-secret", {
    method: "POST",
    credentials: "same-origin",
  });
  if (!response.ok) throw new Error(`获取令牌失败,HTTP ${response.status}`);
  const secret = await response.json();
  if (typeof secret.value !== "string" || secret.expires_at * 1000 <= Date.now()) {
    throw new Error("令牌缺失或已过期");
  }
  return new WebSocket(
    "wss://api.x.ai/v1/realtime?model=grok-voice-think-fast-2.0",
    [`xai-client-secret.${secret.value}`],
  );
}
短期令牌默认有效期为 600 秒,允许的最大值为 3,600 秒,上例主动请求 300 秒。它与单会话 120 分钟上限不同,不能据此推断“令牌五分钟后一定踢掉正在运行的会话”。签发指南说不支持 session 字段,当前接口参考却列出了可选初始 session 配置;以上示例只发送两处文档都描述的 expires_after.seconds,不依赖尚有文档分歧的会话绑定行为。签发指南、签发接口字段
费用怎么估:先确定静默是否计费,再数文本消息
当前音频费率是 0.08 美元/分钟。默认 server_vad 按会话持续时间计费,因此连接着但暂时没有人说话,也在计时;push-to-talk 按发送与接收的音频时长计费。文本 conversation.item.create 每条 0.004 美元,function_call_output 不收这项消息费,音频内容走音频计量。response.create 本身不算文本输入消息,但随后生成的音频仍收费。官方计量说明
假设没有搜索、电话和外部工具费用,可以按下面两种情况估算:
| 假设 | 计算 | 语音与文本费用估算 |
|---|---|---|
| 自动 VAD 连接 10 分钟,其中只有 4 分钟有人说话;另发送 5 条文本消息 | 10 × 0.08 + 5 × 0.004 | 0.82 美元 |
| 手动回合,累计发送 2 分钟音频、收到 3 分钟音频;另发送 5 条文本消息 | (2 + 3) × 0.08 + 5 × 0.004 | 0.42 美元 |
这是按公开计量规则进行的预算演算,不是实际账单。上例脚本用文字发起回答,会产生一条文本输入消息费和输出音频费用;用 PCM 发起时,音频输入不再作为文本消息计费。不要把静默时间从 VAD 会话费用里扣掉,也不要拿文本模型的每百万 token 单价套到这里。
工具费用要按工具自己的单位另外核对。通用价格页目前列出的 Web Search 是每 1,000 次调用 5 美元;X Search 按获取的帖子和资料数计量,分别为每 1,000 条帖子 5 美元、每 1,000 份资料 10 美元,不能写成所有 X 搜索都按一次调用收固定费用。该通用表含不同 API 的适用说明,不能直接拼出语音应用的“全包价”;自定义函数调用也不等于统一收取一种搜索费。电话平台、自己的数据库与服务器有独立成本。工具计费表
response.done 中的 token 使用量可用于记录调用,但它不是官方承诺的美元账单字段。预算应先按已声明的分钟与消息计量计算,真实对账再使用账户账单,不从未声明的 cost_in_usd_ticks 或音频秒数字段自行推导必然收费结果。
工具调用要完成返回,不能只收到请求
工具请求通过 response.function_call_arguments.done 给出 name、call_id 和 JSON 参数。应用校验允许的函数与参数后执行,把结果以 JSON 字符串写入 function_call_output,保留原 call_id,最后请求助手继续回答。模型请求调用工具,并不证明库存已查到、订单已创建或操作已成功。官方函数调用流程
例如,要让助手计算一段 PCM 的时长,可以定义一个不访问外部服务的工具:
const pcmTool = {
  type: "function",
  name: "pcm_duration",
  description: "计算单声道 PCM16 音频的秒数",
  parameters: {
    type: "object",
    properties: {
      bytes: { type: "integer", minimum: 0 },
      rate: { type: "integer", enum: [24000] },
    },
    required: ["bytes", "rate"],
    additionalProperties: false,
  },
};
function executeCall(event) {
  try {
    const args = JSON.parse(event.arguments);
    if (event.name !== "pcm_duration" || args === null ||
        !Number.isSafeInteger(args.bytes) || args.bytes < 0 ||
        args.bytes % 2 !== 0 || args.rate !== 24000 ||
        Object.keys(args).some((k) => !["bytes", "rate"].includes(k))) {
      throw new Error("函数或参数不允许");
    }
    return { ok: true, seconds: args.bytes / (args.rate * 2) };
  } catch (error) {
    return { ok: false, error: error.message };
  }
}
function returnCall(send, event) {
  send({
    type: "conversation.item.create",
    item: {
      type: "function_call_output",
      call_id: event.call_id,
      output: JSON.stringify(executeCall(event)),
    },
  });
}
这是一段加入既有客户端的工具处理代码:把 pcmTool 放入 session.update.session.tools,参数完成事件到达时执行 returnCall(send, event)。同一响应中可能有多个函数调用,必须先把这一批调用收齐、返回全部结果,再发一次 response.create;不要在每个 returnCall 内立刻请求继续。可按 response_id 收集参数完成事件,在该响应的 response.done 后处理这一批,并检查响应状态、去重 call_id。音频实时播放应用还应等当前播放队列结束,避免下一句覆盖上一句。并行工具顺序
不要将这个工具片段直接塞进上面的单轮程序而保留其退出条件:单轮程序在首次 response.done 后收尾;工具客户端需要区分“等待工具结果的响应”和“已有最终语音的响应”。涉及业务写入时,授权、参数校验和操作去重由应用实现,提示词不能替代这些检查。
收到 done 却没声音、打断或断线时怎么处理
收到文字,却没有可播放的音频
先检查响应请求是否包含音频模态,再核对输出 transport。JSON 路线要处理 response.output_audio.delta 并进行 Base64 解码;二进制路线要从二进制帧取音频字节。随后确认解码器的编码、采样率和声道与 audio.output.format 一致。response.output_audio_transcript.delta 只是助手说的话,不是声音数据。
response.done 表示生成这一轮结束;状态还可能是 cancelled 或 incomplete。即使状态为 completed,也不等于扬声器已播完,播放队列必须自己记录结束时间。消息与响应状态
用户打断后,助手还记得没有播出的句子
自动 VAD 检测到 input_audio_buffer.speech_started 时,应用先停掉本地播放并清空未播音频。手动模式需要取消生成时,发送 response.cancel。如果助手生成了一段音频,但用户只听了一部分,当前接口支持截断历史消息:
{
  "type": "conversation.item.truncate",
  "item_id": "实际助手音频消息的 ID",
  "content_index": 0,
  "audio_end_ms": 1250
}
audio_end_ms 是实际已经播出的时长;示例 1,250 毫秒只是占位演示,不能由已收到的音频总长度代替。item_id 取自相应输出消息,content_index 取自该音频内容的位置。服务器以 conversation.item.truncated 确认,把之后的音频和转录从对话历史移除。旧资料将 conversation.item.truncate 写成不支持,已不符合当前实时接口参考。
错误或连接关闭后,先保留能区分原因的字段
协议 error 记录 type、code、message、param、event_id;连接失败则分别记录握手 HTTP 状态、客户端错误和关闭码。字段名不能单独证明根因:同一个握手状态不能一概归因于余额或地区,timeout 与 max_duration 也不应无限原样重试。
多数协议错误允许连接继续存在,但当前输入是否还能完成,需要看具体错误和后续状态。重试前先判断这轮是否已有响应或工具执行,避免再次提交产生重复操作。为单轮脚本设置本地等待上限,是让应用及时结束等待,并不是声称服务端一定在该秒数超时。
断线重连需要显式启用上下文恢复
默认关闭连接就丢失该连接的对话历史。要恢复,原会话和重连后的会话都要发送 resumption: { enabled: true };保存 conversation.created.conversation.id,重连 URL 带 conversation_id。文档声明历史在 30 分钟没有活动后清除,这不是无限期的业务数据保存。会话恢复说明
恢复指南把历史重放事件称为 conversation.item.created,当前接口参考把新消息事件列为 conversation.item.added。客户端可以兼容处理两种消息名称,以消息 ID 去重;不要因历史里再次出现工具调用就重新执行副作用。对话恢复负责补上下文,业务操作是否完成仍要由自己的记录判断。
从 OpenAI Realtime 迁过来,先改这些地方
可以复用“配置会话、发送输入、消费增量、处理工具”的客户端结构,但要逐项核对端点、模型和事件名。当前参考明确支持 response.text.delta 与 response.output_text.delta;旧稿把二者写成必须二选一,已不准确。截断消息也已支持,不能照抄旧的“不支持事件”列表。兼容说明、当前事件参考
还要识别 xAI 扩展的两种行为:force_message 直接合成指定台词,不经过模型推理,发送后不要再发 response.create;interruptible: false 会在播放期间丢弃用户音频,不能当作已经确认用户同意。response.create.response.instructions 仅覆盖这一轮回答,随后恢复会话级指令。强制台词与单轮指令
什么时候该从原始接口切到现成语音框架
当难点是音频格式、事件处理和业务工具返回,直接 API 能让你清楚看到每一步。等到浏览器采集与回放、电话号码路由、媒体转发或部署编排占据主要开发时间,再考虑现成媒体框架。框架不会免除模型配置、业务授权和费用核对,只是承接部分媒体工作。
电话 SIP 会话也不能照搬浏览器鉴权:接口参考说明,带 call_id 的 SIP 连接要求 API key,不支持短期 client secret,并忽略模型查询参数。直接 WebSocket 示例与电话接入是不同路径,不要把换一个 URL 当成完整电话部署。SIP 参数说明
FAQ
Grok Voice Agent API 的准确端点和模型是什么?
直接实时会话使用 wss://api.x.ai/v1/realtime。省略模型时默认 grok-voice-latest,当前指向 grok-voice-think-fast-2.0;希望固定版本就显式选择后者。官方模型选择
现在还是每分钟 0.05 美元、100 并发、30 分钟吗?
当前模型卡写的是每分钟 0.08 美元、每团队 10 个并发会话、单会话最长 120 分钟,另有每条 0.004 美元的适用文本消息费。旧文章或缓存中的 0.05 美元、100 并发和 30 分钟不能作为当前预算与接入规格。模型卡
不说话时也收费吗?
默认自动 server_vad 按会话时长计费,静默也计入;push-to-talk 按发送与接收音频时长计费。因此只算用户开口的秒数,会低估自动对话成本。官方计量规则
浏览器里可以直接使用长期 API key 吗?
应使用自己的后端签发的短期令牌,浏览器通过 xai-client-secret.<TOKEN> 子协议建连。长期密钥留在服务端;短期令牌也需要应用登录与用量控制,不能把签发接口公开给任意人调用。短期令牌指南
令牌 300 秒到期,会话最多就只能运行五分钟吗?
不能这样推断。300 秒是示例令牌有效期,120 分钟是公开单会话上限,两者描述不同约束。现有文档不足以把令牌到期直接等同于已建立连接的强制断开时刻。令牌字段、会话上限
只想转写中文,需要 Voice Agent API 吗?
不需要双向回答时,可以直接使用独立 STT 的文件或流式转写路线。需要对话中的实时字幕,才在实时会话配置 grok-transcribe 和 language_hint: "zh";字幕更新事件是累计文本,不是逐字追加。语音路线、实时转写事件
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月8日。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月8日。
- 1.模型与会话配置docs.x.ai/developers/model-capabilities/audio/speech-to-speech
- 2.价格与计量说明docs.x.ai/developers/models/speech-to-speech
- 3.官方语音路线说明docs.x.ai/developers/model-capabilities/audio/voice
- 4.对应接口参考docs.x.ai/developers/rest-api-reference/inference/voice
- 5.官方短期令牌流程docs.x.ai/developers/model-capabilities/audio/ephemeral-tokens
- 6.工具计费表docs.x.ai/developers/pricing