Codex CLI Token 成本:长任务前先估算每日 API 支出
Codex CLI 每日 API 费用要按实际模型和互斥的 Token 类别计算。先分清订阅与 API 计费,再用场景演算、用量核对和剩余预算决定长任务能否继续。
文章目录
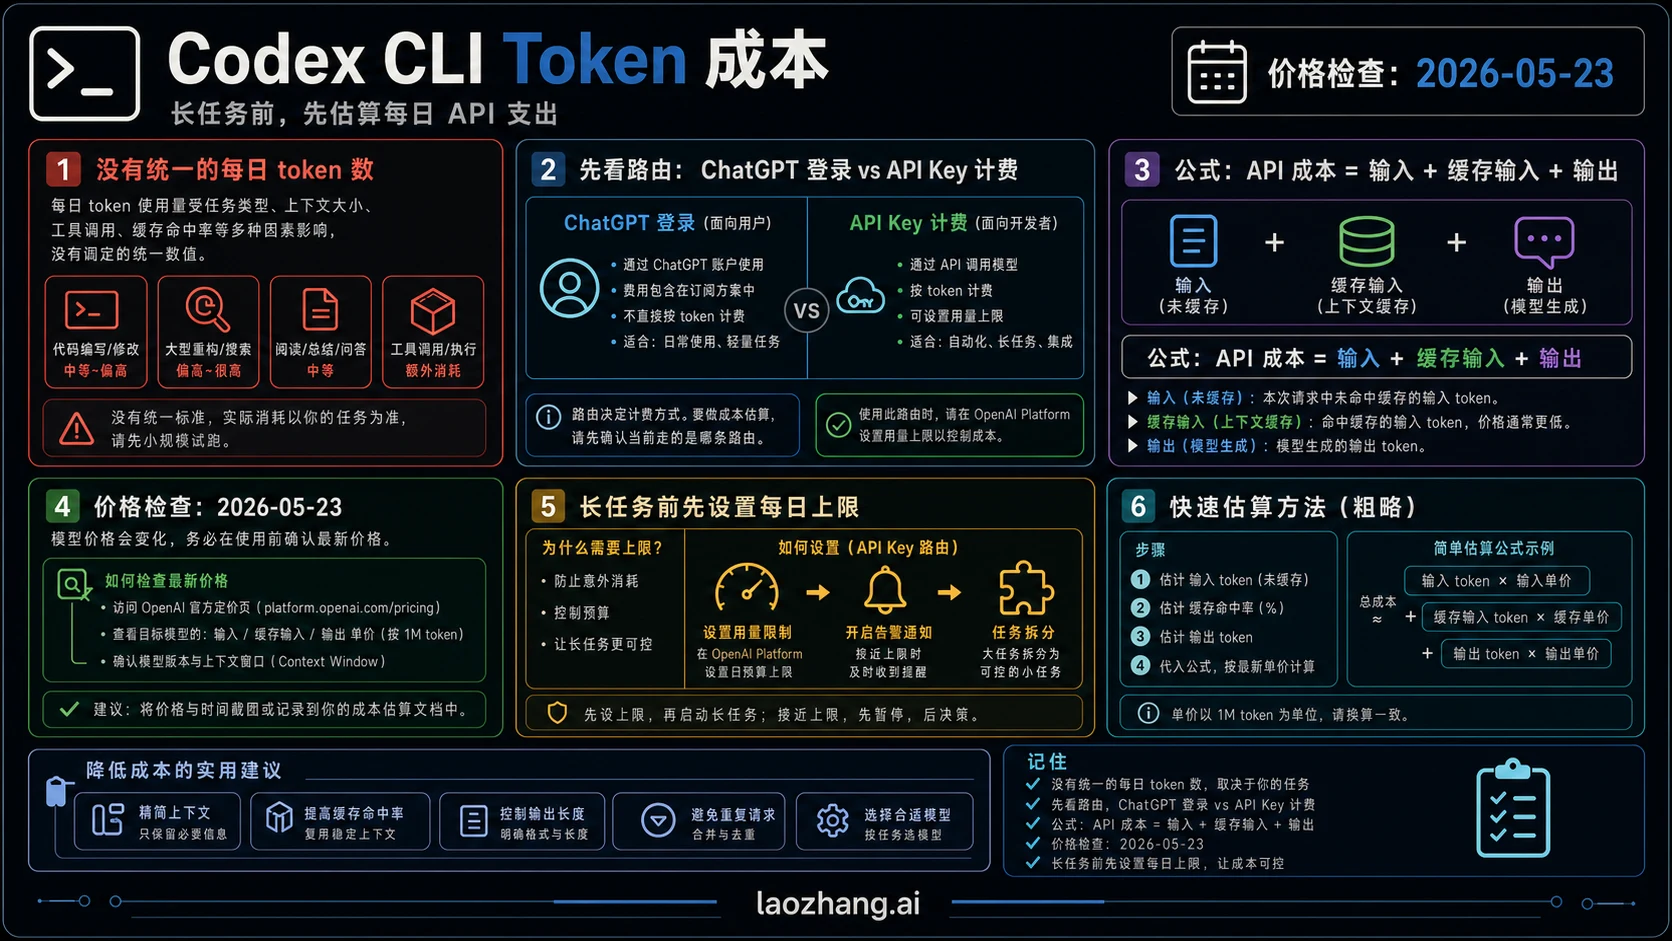
Codex CLI 一天花多少钱,取决于谁付费、每次请求用什么报价,以及任务会产生多少轮输入和输出。确认走 OpenAI API-key 计费后,把输入拆成普通输入、缓存读取、缓存写入,再加上输出费用;先按每次请求计价,最后汇总当天。ChatGPT 登录的套餐用量和 credits,要查对应账户的用量页,不能用 API 美元单价直接换算剩余任务数。
按 2026 年 10 月 7 日的标准文字报价,假设一天累计有 300 万普通输入、200 万缓存读取、50 万缓存写入、40 万输出,且每次请求都处于短上下文标准计价范围,gpt-6.1-sol 的 Token 费用为 11.45 美元。这是明确假设下的演算;后文给出公式、其他日常场景,以及用自己的用量记录校准的方法。单价来自 OpenAI API 定价,工具、税费及网关等额外收费需另计。
先用两分钟估算器定边界
长任务开始前,先填清楚这五项:
- 计费账户:本轮使用 ChatGPT/工作区用量,还是 OpenAI Platform API 项目?第三方网关使用其自己的报价。
- 完整报价:实际模型、Standard 或 Fast、地区处理方式,以及单次输入是否超过长上下文门槛。
- 任务量:预计多少个相似工作块,包括重试、辅助 Agent 和回退模型。
- Token 结构:普通输入、缓存读取、缓存写入、输出分别是多少;未知项留作未知。
- 继续条件:当天已用费用、在途请求预留、剩余任务预测和暂停线。
能确定前四项,就可以算费用;拿预测与第五项比较,才能决定继续整个任务、缩小范围,还是先停下来核对。无法确定计费账户或实际报价时,先补齐它们,避免把一个看似精确的数字用于预算决策。
先判断当前是哪一个计费表
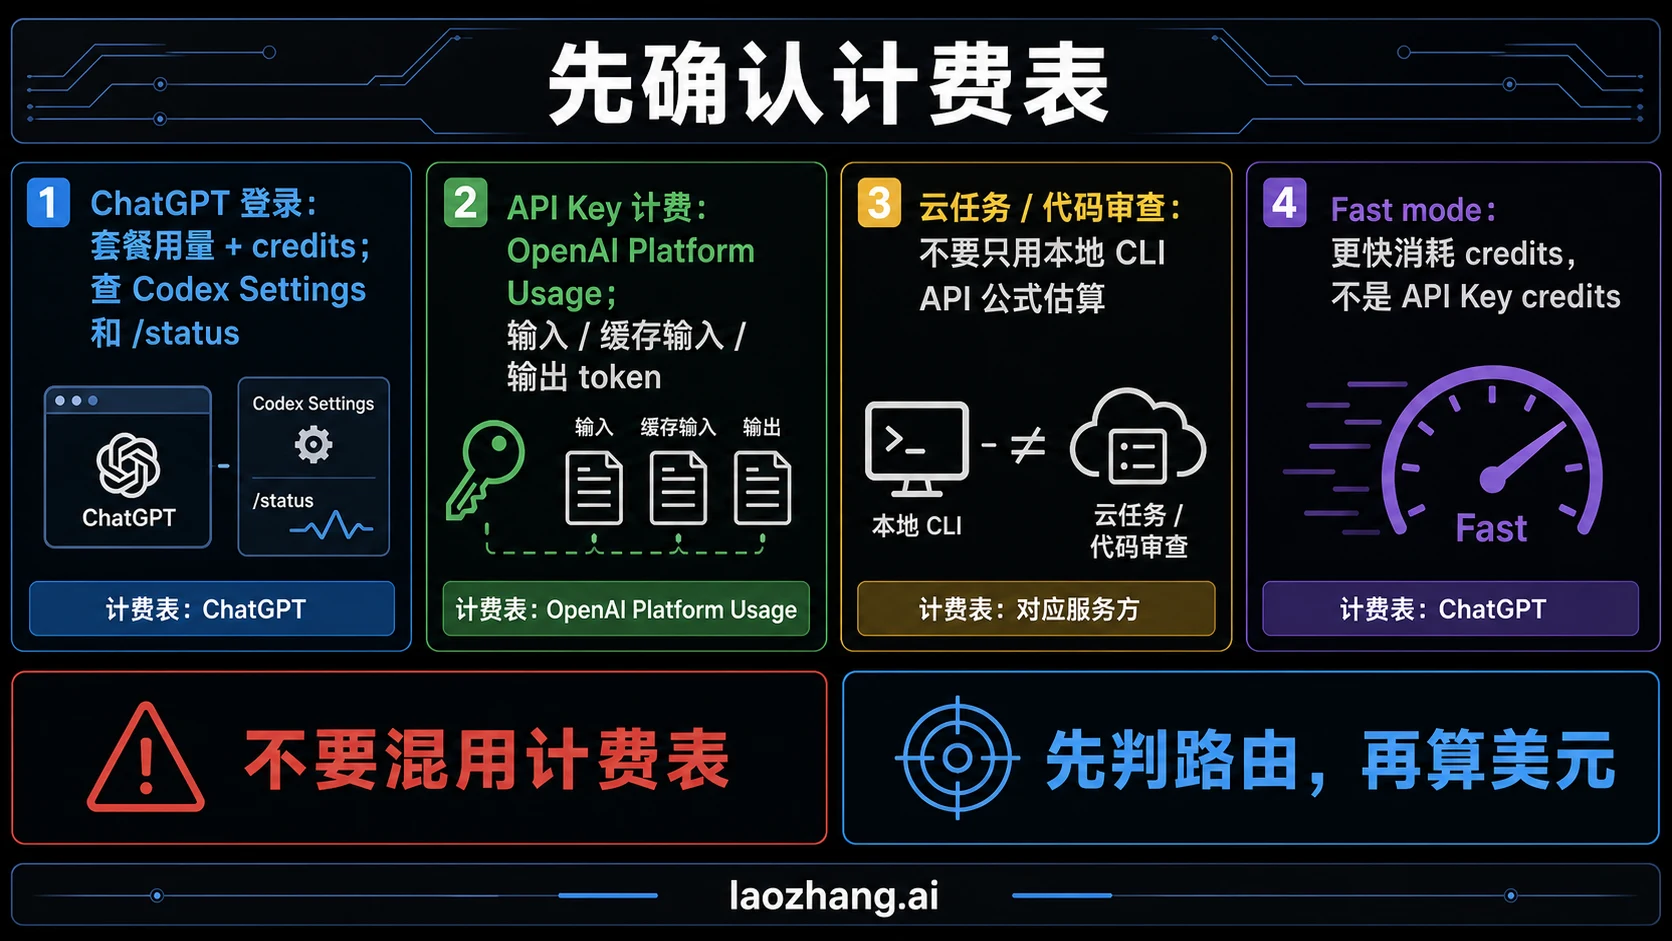
同样是在终端里使用 Codex,付费账户也可能不同。先确认身份,再看对应的记录。
| 使用方式 | 应查看的用量或费用 | 这篇美元公式是否适用 |
|---|---|---|
| ChatGPT 登录的本地 CLI | 当前套餐/工作区的用量、limits 和 credits | 不直接适用 |
| OpenAI Platform API key | 该组织、项目和 key 对应的 API Usage/Costs | 按适用 API 报价计算 |
| Codex 云端任务 | ChatGPT/工作区下的 Codex 用量 | 不能只套本地 API 公式 |
| 企业管理的可信自动化 | 实际凭证所关联的工作区或 API 项目 | 先确定付费账户 |
| 第三方模型网关或自定义供应商 | 网关/供应商自己的计量与费用记录 | 使用该供应商的报价 |
官方认证说明明确区分 ChatGPT 登录与 API-key 按量计费。本地 CLI 可使用这两种身份,Codex cloud 需要 ChatGPT 登录。CLI 的 codex login status 可查看当前认证方式;但自动化还应核对该次启动选择的身份,因为 codex exec 默认复用已有认证,也支持为单次调用选择 API key。企业可信自动化还可以使用 Codex access token。因此,“在 CI 运行”本身不能证明它计入 Platform API 账单。相关条件见 非交互模式认证。
Fast 是速度选择,还要结合付费方式看价格。目前 Codex Fast 对套餐包含用量按 Standard 的 2.5 倍消耗,对购买的 credits 和企业按量用量按 2 倍计;API 的 gpt-6.1-sol Fast 则有自己的 2 倍 Standard 美元报价。两种倍数不能混用。Codex credits 也没有单独的缓存写入费,不能把 API 的四类单价搬过去。依据分别是 Codex 价格与用量说明和 API 定价。
使用当前价格锚点,不要套旧表
以下价格核对于 2026 年 10 月 7 日,单位均为美元/100 万文字 Token,适用于表中短上下文、Standard、普通全球处理报价。实际模型需在你所用 API key 和客户端中受支持;这张表不代表你的默认模型或账户可用性。
| 模型 ID | 普通输入 | 缓存读取 | 缓存写入 | 输出 |
|---|---|---|---|---|
gpt-6.1-sol | 2.00 | 0.10 | 2.50 | 10.00 |
gpt-6-sol | 2.00 | 0.20 | 2.50 | 10.00 |
gpt-6-luna | 0.10 | 0.01 | 0.125 | 0.50 |
gpt-5.6-sol | 4.00 | 0.40 | 5.00 | 20.00 |
gpt-5.4-mini | 0.75 | 0.075 | 无单列写入费 | 4.50 |
gpt-5.4 | 2.50 | 0.25 | 无单列写入费 | 15.00 |
来源:API 价格表。gpt-5.6-sol 当前促销价的官方说明为至少持续至 2026 年 11 月 21 日;未来任务仍需重新核对价格。表中“无单列写入费”只对应所列旧模型报价,不代表所有模型都可以忽略缓存写入。
对 gpt-6.1-sol,单次输入超过 272,000 Token,整个请求的输入、缓存读取和缓存写入按短上下文价格的 2 倍计,输出按 1.5 倍计。恰好 272,000 仍在短上下文范围。门槛看单次请求的总输入,不能把一天的 500 万输入当作一次长请求,也不能只给超出门槛的那部分加价。Fast 为 Standard 的 2 倍;适用的地区处理有 10% 加价。具体可用性与组合应以 模型价格说明为准。
Batch/Flex 的折扣有各自适用条件,不能因为价格页列出半价,就假设当前交互式 Codex CLI 已经使用它们。选定实际模型、速度和地区后,把这一整套报价记入估算表,避免计算途中混用几张表。
API 成本公式:输入只能拆分,不能重复相加
读取 API 用量时,input_tokens 是总输入,已经包含缓存读取和缓存写入。正确做法是先拆分为互斥类别,再分别乘单价。官方缓存计费说明给出了相同的字段关系。
设:
I:总输入input_tokens。R:缓存读取input_tokens_details.cached_tokens。W:缓存写入input_tokens_details.cache_write_tokens。U:普通输入,等于I - R - W。O:输出output_tokens。
先检查:I、R、W、O 均非负,且 R + W ≤ I
普通输入 U = I - R - W

单次 Token 费用(美元)=
  (U × 普通输入单价
 + R × 缓存读取单价
 + W × 缓存写入单价
 + O × 输出单价) ÷ 1,000,000

每日预测 = 各次请求费用之和 + 适用的其他收费
这里的单价都以“美元/100 万 Token”为单位。缓存写入使用写入价替代普通输入价,不是在普通输入付过一次之后再叠加一笔写入费。 如果你的计划表已经列的是普通输入 U,就直接使用它,不再减一次缓存。
例如,一条虚构的短请求记录有总输入 200,000、缓存读取 120,000、缓存写入 50,000、输出 10,000,则普通输入为 30,000。按 gpt-6.1-sol Standard 计算:
(30,000 × 2 + 120,000 × 0.10
 + 50,000 × 2.50 + 10,000 × 10) ÷ 1,000,000
= 0.297 美元
若错把 200,000 全部按普通输入计,再加缓存费用,就会错把普通输入费用算成 0.40 美元,最终错算成 0.637 美元。
推理 Token 也不能重复加。API 的 output_tokens 已包含推理输出,output_tokens_details.reasoning_tokens 是其明细;按输出总数计价一次即可。依据:OpenAI Cookbook 的用量字段说明。这个 API 定义不能直接证明所有 CLI 显示字段都具有相同口径。
缓存写入缺失,怎样仍给出可用范围?
如果只知道 I、R、O,又确认剩余输入只可能属于普通输入或缓存写入,可以按两端假设计算。以短上下文 gpt-6.1-sol 为例,普通输入价 2.00,写入价 2.50:
条件下界:((I-R) × 2.00 + R × 0.10 + O × 10) ÷ 1,000,000
条件上界:((I-R) × 2.50 + R × 0.10 + O × 10) ÷ 1,000,000
在前面的虚构记录中,若只缺 W,已知 I=200,000、R=120,000、O=10,000,可得 0.272~0.312 美元。已知的 0.297 美元落在这个范围内。
这个区间只界定这些已知数量的文字 Token 费用。它要求输入类别、模型、短上下文及报价都已确认;不包含未来请求、工具费或其他未计价类别。如果连某次请求是否超过长上下文门槛也不知道,应先补记录,或分别列出短/长价格假设。缺字段不能随手填 0,也不能把条件上界称为整个 CLI 任务的最高账单。
一次长请求会怎样改变结果?
假设一次请求总输入为 300,000,其中缓存读取 200,000、缓存写入 50,000、普通输入 50,000,输出 10,000。它已超过 gpt-6.1-sol 的门槛,整次适用输入 4.00、读取 0.20、写入 5.00、输出 15.00 的报价:
(50,000 × 4 + 200,000 × 0.20
 + 50,000 × 5 + 10,000 × 15) ÷ 1,000,000
= 0.64 美元
误用短上下文报价会得到 0.345 美元。这也是为什么只拿全日输入总数套一个价格,无法准确处理混有长请求的工作日。需要先把各次请求或已确认采用同一报价的片段分开计算,再加总。
用日常场景给预算做上限
以下是为预算编制设定的三种工作量,不是实测日均用量,也不表示不同模型能完成同样质量的工作。所有请求均假设按短上下文、Standard、全球文字报价计价,不含额外费用;U/R/W/O 均为互斥类别,单位为百万 Token。
| 场景 | 普通输入 U | 缓存读取 R | 缓存写入 W | 输出 O | gpt-6.1-sol 美元 | gpt-6-luna 美元 |
|---|---|---|---|---|---|---|
| 轻量日:少量定位与修补 | 0.6 | 0.2 | 0.1 | 0.08 | 2.27 | 0.1145 |
| 普通日:多轮修改与验证 | 3 | 2 | 0.5 | 0.4 | 11.45 | 0.5825 |
| 重度日:长时间连续迭代 | 12 | 8 | 2 | 2 | 49.80 | 2.53 |
普通日 gpt-6.1-sol 的演算是:
3 × 2.00 + 2 × 0.10 + 0.5 × 2.50 + 0.4 × 10.00
= 6.00 + 0.20 + 1.25 + 4.00 = 11.45 美元
如果这一整天的请求都改用该模型 Fast 报价,同样数量的 Token 为 22.90 美元;一旦其中出现长上下文请求,就需要先重算这些请求,不能继续直接用这张短上下文表。
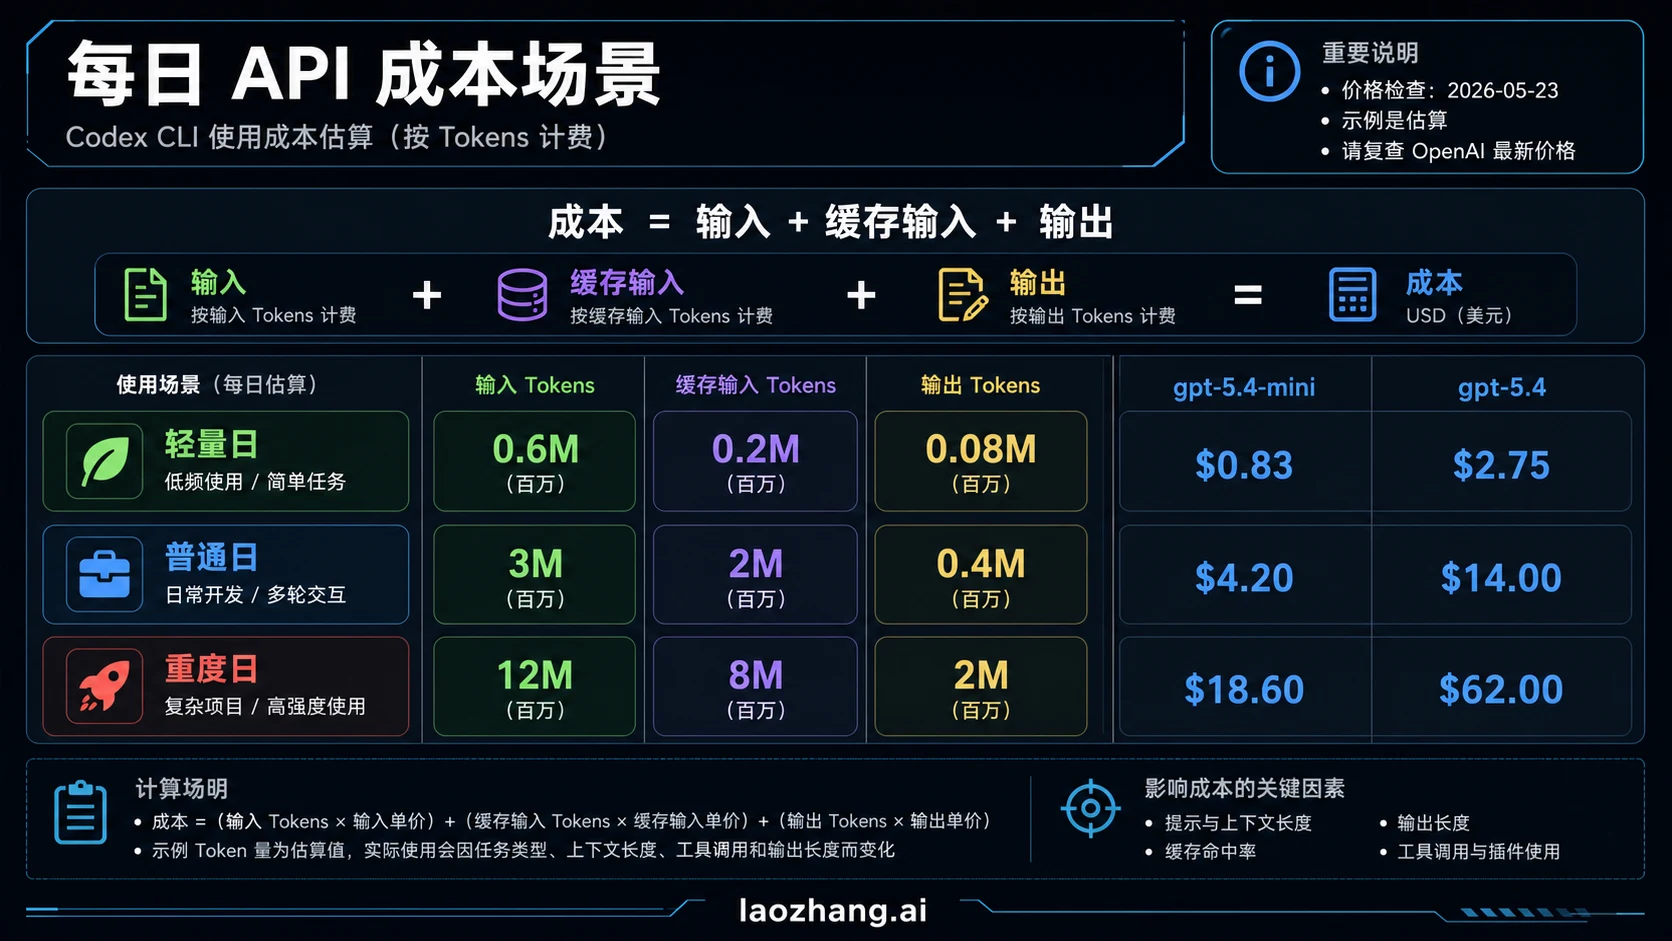
保留的旧图展示 gpt-5.4-mini/gpt-5.4 的三类演算。图里的“输入”应理解为普通输入,不是 API 字段 input_tokens。例如普通输入 300 万、缓存读取 200 万、输出 40 万,在这两个模型所列无单独缓存写入费的短请求报价下,分别仍可算出 4.20 和 14.00 美元。GPT-5.6 及以后的模型应使用上面的四类计算,不能把这组旧图直接作为新模型报价表。单价来源:API 定价。
日常预算应先选择能满足验收标准的模型,再比较完成任务的总费用。较低 Token 单价并不保证更便宜的交付:若需要更多失败重试、返工或回退模型,实际成本可能上升。当前模型是否胜任你的任务,需要自己的工作记录来校准。
用自己的 30 到 60 分钟样本校准
已有代表性工作记录时,优先使用它;没有时,可以在自己许可的预算内选一段小任务作为样本。30~60 分钟只是便于观察的长度,不是官方要求,任务相似程度比计时更有价值。
先记录同一工作块的计费账户、模型、速度、地区、目标路径、验收标准、请求数量、各类 Token 与其他付费工具。辅助 Agent、重试和回退请求也归入同一个工作块。把读取、修改和测试失败较多的工作分开,不要用改一处文档的样本预测整仓重构。
随后做三步:
- 算样本费用。 按各次请求适用的报价加总;若只有相同条件下的费用记录,也可以直接使用费用。
- 估剩余工作。 相似工作块的数量乘以代表性样本费用,再单列预计重试、辅助任务和其他收费。
- 对照预算。 把已发生费用、在途请求预留和剩余预测一起比较;每完成一个工作块就更新,而不是一开始乘完后整天不再看。
假设一个虚构工作块的全量 Token 费用为 1.65 美元,还剩四个类似工作块,并另留一个工作块的重试费用、0.80 美元的辅助任务费用:
剩余预测 = 4 × 1.65 + 1.65 + 0.80 = 9.05 美元
若当天已用 3.20 美元、在途预留 1.00 美元:
当天预计合计 = 3.20 + 1.00 + 9.05 = 13.25 美元
这份估算为相似任务提供决策起点。若后续请求的输入明显增长、缓存命中下降、模型改变或新增付费工具,就重新定价和估量,不继续沿用 1.65 美元。
只能看到总费用时,可用“同条件工作块费用”预测剩余支出;不能从一个总金额反推唯一的输入/缓存/输出组合。自行选择的缓冲比例也应写明理由:25%~50% 可以作为一种试算假设,不能称为官方规则或统计上保证覆盖风险的区间。
核对用量时,CLI 记录和 API 账单各做什么
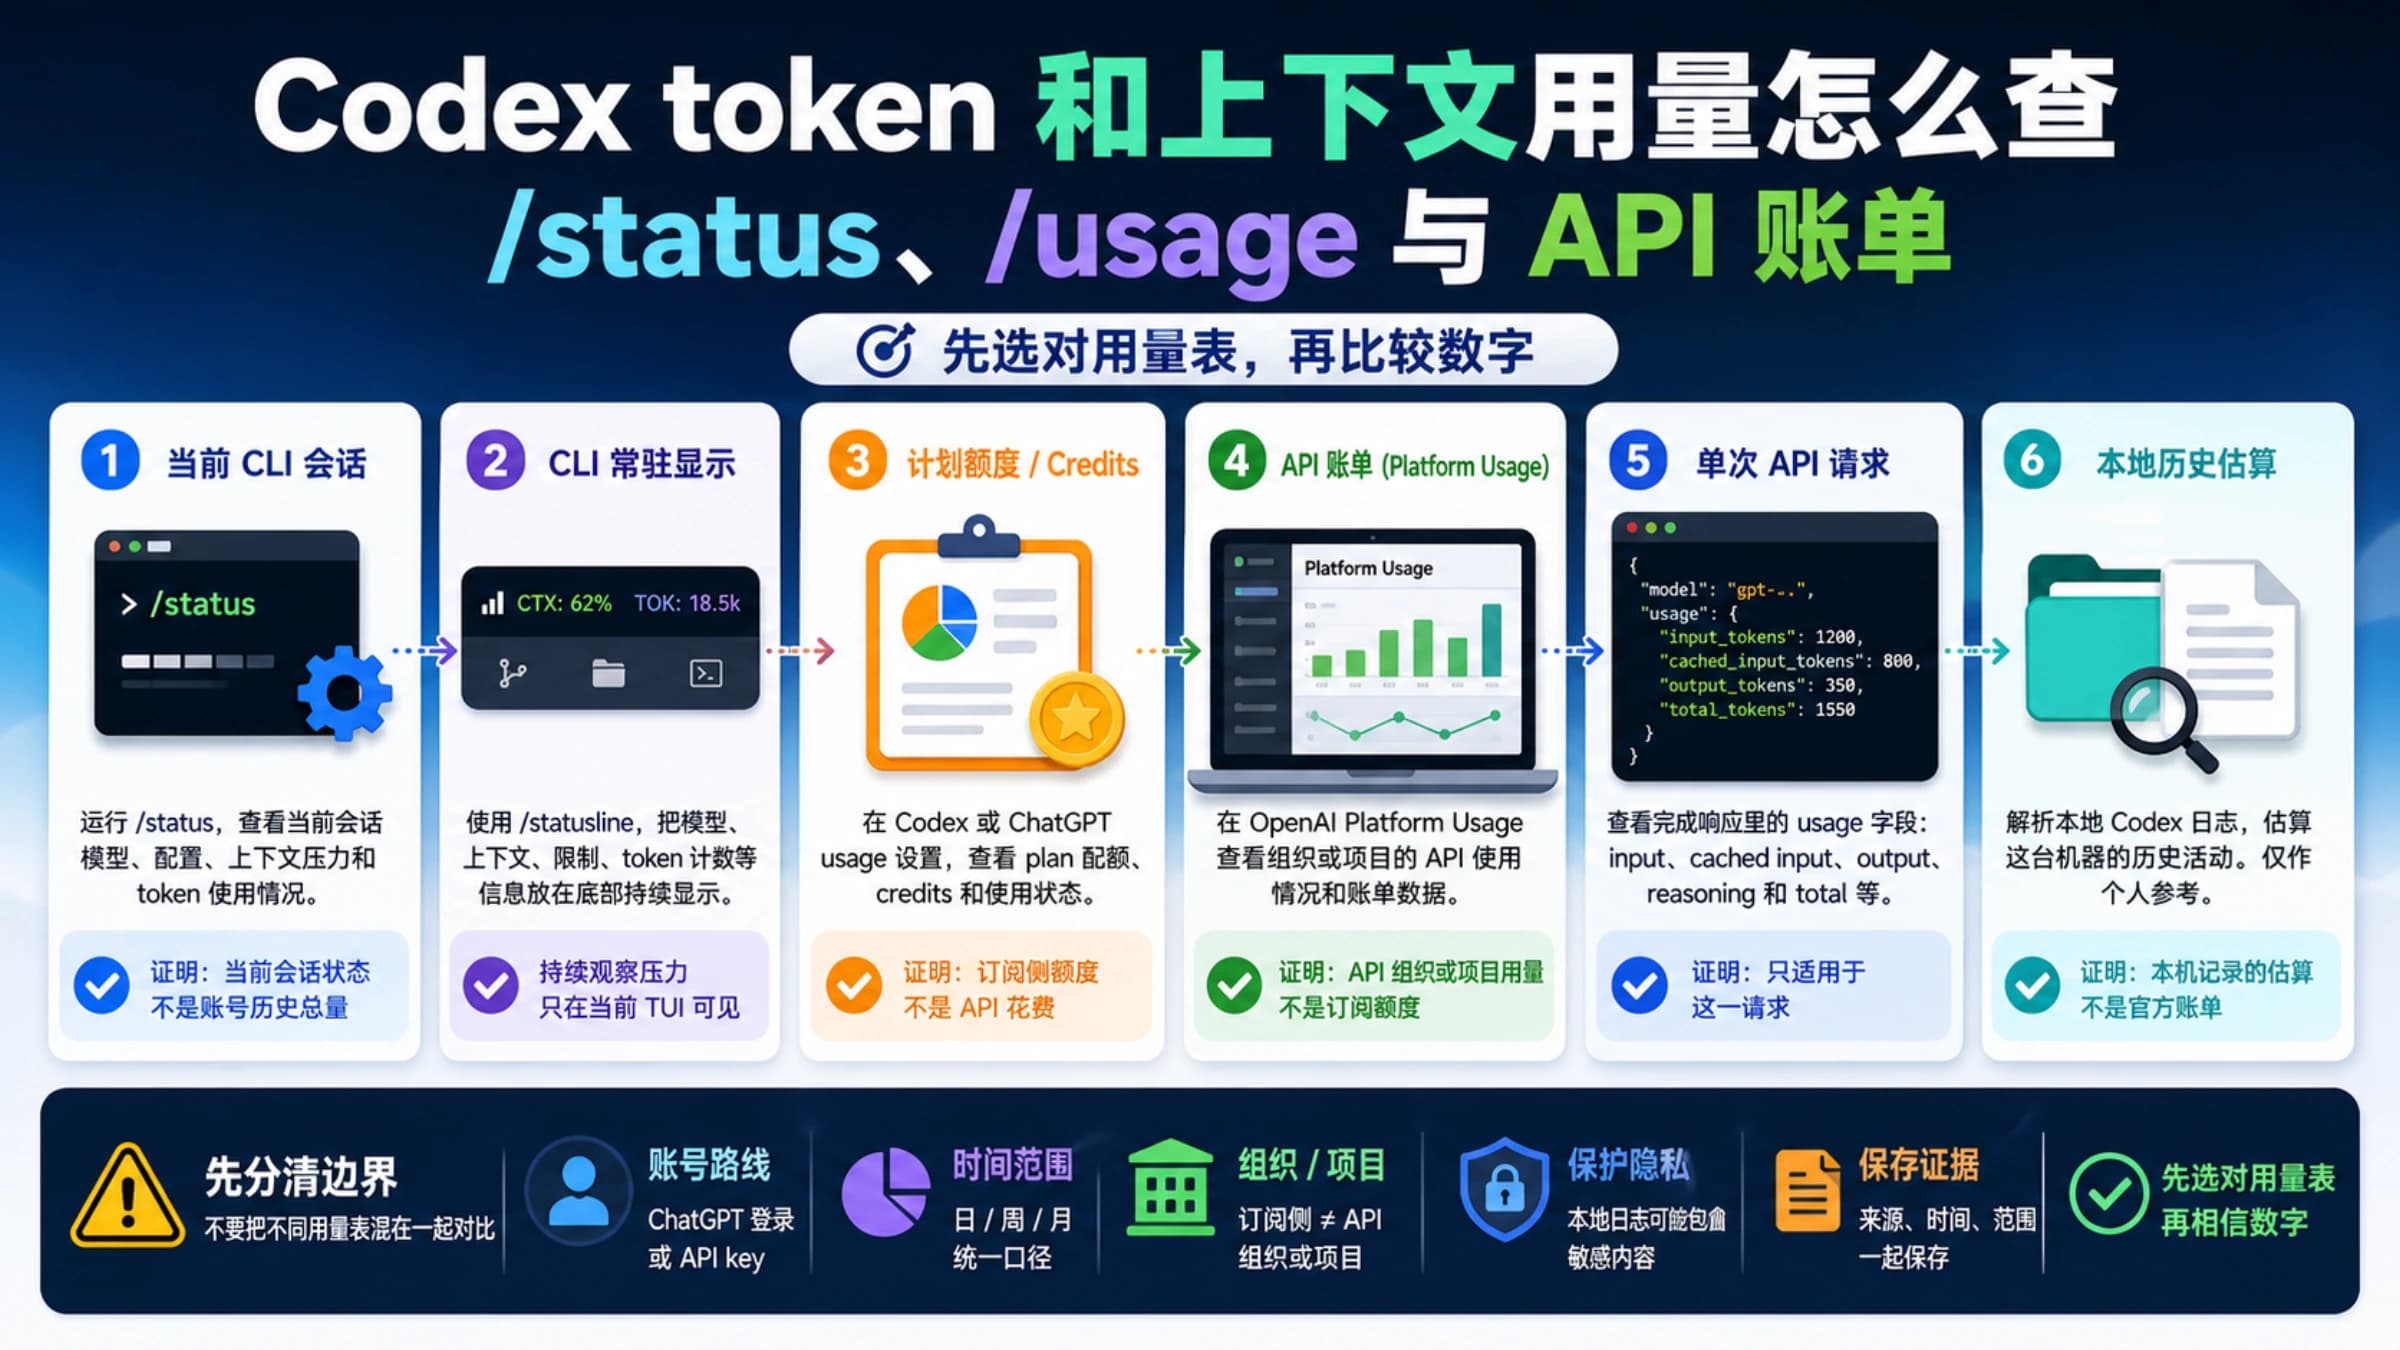
CLI 计数适合帮助理解这一轮任务,API Usage/Costs 适合核对实际 API 项目。先把日期、组织、项目、模型及服务档位对齐,再比较数字。若需要了解会话计数和上下文压力,参见 Codex token 与上下文用量怎么查。
| 记录来源 | 可用于什么 | 汇总时要处理的边界 |
|---|---|---|
CLI JSONL 的 turn.completed | 查看已完成轮次所报告的用量 | 当前官方示例没有缓存写入字段,不能据此认定写入为零 |
完成的 API 响应 usage | 计算该响应的输入类别与输出 | 字段口径与 CLI 不同;输出已含推理明细 |
| Organization Usage | 按组织/项目/模型/服务档位核对聚合用量 | 日/小时总量不能还原每次请求的长上下文门槛 |
| Organization Costs/费用页 | 核对相应范围的金额和币种 | 金额、credits、合同折扣及其他收费应按记录本身解释 |
非交互模式文档说明 --json 输出 JSONL 事件,其用量示例包括 input_tokens、cached_input_tokens、output_tokens 和 reasoning_output_tokens。这份示例没有提供缓存写入数量,也没有保证它覆盖所有辅助请求、失败请求或中断后的费用。不要把重复的累计快照、终端总数和逐轮记录相加;也不要仅因两条记录的数字相同就删除其中一次真实请求。缺失、中断和仍在途的用量单列待核对。
按 Organization Usage 参考,聚合的 input_tokens 含缓存读取和写入;读取字段为 input_cached_tokens,30 分钟写入与 12 小时写入分别有自己的字段。input_uncached_tokens 则排除了写入。不能把几种接口的字段名混用,也不能在总输入之外再次加上模态明细。若记录出现当前估算未覆盖的 12 小时写入等类别,先取得对应价格和适用条件,不能默认免费或套用 30 分钟写入价。
对账时重点核对:
- 时间:API 用量页按 UTC 显示。若使用北京时间的自然日,要先换成对应 UTC 起止;例如北京时间 10 月 7 日 00:00 至 10 月 8 日 00:00,对应 UTC 10 月 6 日 16:00 至 10 月 7 日 16:00。接口起点包含、终点不包含,跨日桶还要按所需范围处理。
- 范围:查看正确组织与项目;用量页自身的项目选择不一定等于其他设置页当前项目。共享项目里还应区分本任务与其他工作。
- 报价:模型、服务档位、Batch 状态及特殊合同不能混在一行之后统一按 Standard 乘。
- 完整性:导出或接口分页要读完;未分组时身份字段为
null,不表示没有费用。 - 金额单位:Costs 的
amount.value与currency表示对应费用记录;quantity可能是 Token、千 Token、时长、图片或其他单位,不能一律当作 Token。
依据:API 用量与费用页说明、Costs 参考。Scale Tier 还有特殊口径:项目可显示有用量而没有新增项目费用,因为套餐费用记在组织层级,不能据此判断整段工作免费。
哪些行为最容易烧 Token
先看自己的输入和输出费用各占多少,再处理最大的一项。输入单价较低,也可能因为反复携带大量上下文而成为主要支出;屏幕上的回答很短,也可能有计入输出的推理 Token。
| 现象 | 成本增加的位置 | 可采取的动作 |
|---|---|---|
| 整仓读取和反复附带长历史 | 每轮请求输入变多 | 明确相关路径,避开无关生成物;保留验收所需上下文 |
| 测试日志反复进入上下文 | 工具结果成为后续输入 | 保留影响诊断的错误与上下文,减少无关回显 |
| 长解释、整文件输出和重复总结 | 模型输出变多 | 约定需要的补丁、结论与必要解释 |
| 多个辅助任务或自动重试 | 新增独立付费请求 | 合并任务范围内的费用,限定重试次数 |
| 缓存失效或新写入增多 | 输入从读取价变为普通/写入价 | 比较实际读取与写入数量,再决定是否调整上下文 |
| 模型、速度或单次输入门槛改变 | 适用单价变化 | 暂停原估算,按新报价重算 |
本地命令打印的测试日志,进入模型上下文后属于输入,并不会因为它显示在终端上就自动变成模型输出。工具本身若另行收费,还应列入其他费用。
缓存复用也不是“历史从此免费”。命中需要匹配可用的上下文前缀;GPT-5.6 及以后有 1,024 个可见输入 Token 的最低缓存长度,当前默认至少保留至最近写入或复用后 30 分钟。压缩、重写历史或重开会话可能改变前缀并失去复用。因此,“越短越省”或“重开一定省钱”都应通过你自己的费用结构比较,不能只看上下文长度。依据:Prompt caching。
给长任务写预算停止规则
用明确金额和检查点表达停止条件,才能让估算影响实际工作。以下是一个自行选择的每日 15 美元预算示例:
适用范围:今天这个 API 项目的 Codex 任务及其辅助请求
日预算:15.00 美元
人工暂停线:10.50 美元(自行选择的 70%)
检查点:每个工作块结束,或模型、速度、任务范围改变时
继续条件:已发生 + 在途预留 + 剩余任务预测 ≤ 15.00 美元
暂停条件:已发生费用或整段任务预测达到暂停线;报价/用量不明;同类失败连续两次
前面算出的 13.25 美元小于 15 美元日预算,但已经高于 10.50 美元的暂停线。合理安排是先批准一个较小工作块,到检查点核对后再决定剩余部分;不能把“预测未超总预算”当成整晚无人看管的通行证。70% 和连续两次失败都是这个例子的选择,你可以按任务风险和观察延迟调整。
真正的自动停止还要区分两种机制。OpenAI spend limits 文档说明:
- Spend alert 发送通知,API 请求仍可继续。
- 启用 Enforce a hard limit 的组织/项目限额可阻止适用的后续流量,按月累计;组织限额覆盖其项目,项目限额只约束记到该项目的费用。
- 触发时会返回
429,对应organization_spend_limit_exceeded或project_spend_limit_exceeded。状态传播存在延迟,记录金额可略超设置值。
所以平台月度硬限额可以作后备约束,但它不会自动实现上面的每日 15 美元规则,也不是精确到分、零超额的保证。每日自动执行需要在下一次付费请求派发前检查和预留预算,连同在途请求、重试和辅助 Agent 一起控制;实现方法见 LLM Agent API 花费熔断开关。
账单突然变高时按这个顺序排查
先把变化归到“用量增加”还是“报价改变”,再决定下一步。
- 付费账户变了没有? 比较实际启动身份和费用归属,避免把订阅用量、Platform API 与网关记录放在一起。
- 模型/速度/地区变了没有? 核对请求实际使用的报价。若用了 Fast,就用 Fast 价格复算。
- 是否跨过长上下文门槛? 找单次请求记录;全日总数不足以判断。
- 输入结构变了没有? 普通输入、缓存写入增加,或读取减少,都会改变原预测。
- 新增了多少输出和轮次? 计入推理输出、重试、辅助任务及回退请求,不只看最终回答字数。
- 对账口径一致吗? 核对 UTC 时间、组织/项目、分页、币种、合同与其他收费。
如果计费账户或报价与原估算不一致,先停止新任务派发,保存已有工作并重新估算。若只是一类测试不断失败,缩小范围先诊断原因;重复同一付费流程通常不会让预算变得更可靠。
常见问题
Codex CLI 一天会用多少 Token?
没有通用日均值。一天的输入包括每轮带入的上下文,不等于仓库只读了一遍;输出也不等于屏幕显示的文字数。先记录代表性工作块,再按剩余工作量预测,比套用他人的每日 Token 数更有用。
Codex CLI API 成本怎么估算?
先确认 API 计费和实际报价,再用普通输入、缓存读取、缓存写入、输出四个互斥类别计算,按请求汇总。API 总输入已包含读取和写入,不能重复收费。旧模型没有单列写入费时使用其对应的三类报价。字段和公式依据:缓存用量说明。
CLI 没显示缓存写入,是不是没有这笔费用?
不能这样判断。当前官方 JSONL 示例没有写入字段,示例字段缺失并不证明实际写入为零。对有写入报价的模型,需要相应 API 用量,或在输入类别和其他条件已确认后给出费用区间。依据:CLI JSONL 示例。
reasoning tokens 要再加一次输出费用吗?
对于 API 响应,不需要。output_tokens 已包含 reasoning tokens,明细用来分析组成;再加一次会重复计算。CLI 的字段应先确认自身定义,不能仅凭字段名套用。依据:API 输出计数说明。
API key 一定比 ChatGPT Plus 或 Pro 便宜吗?
不一定。API 费用取决于实际用量与报价,订阅还有套餐用量、工作区规则及 credits。不能拿月费除以 API 单价推算可完成多少任务,也不能把相同 Token 数当作相同交付质量。两种计价分开说明于 Codex pricing。
设置预算提醒后,API 会自动停止吗?
单独的 spend alert 不会。平台月度停止需要启用适用的硬限额,并且传播可能有延迟;每日任务预算要另行实施派发前检查。依据:Spend limits。
取消一个长任务,就能确定不会再收费吗?
不能据此确定。取消后应停止新的付费派发,并核对已经完成、仍在途或缺少结果的请求。结果没返回不等于请求免费;在费用尚未确认时保留预留,再对账。
本文的 Token 数、工作块和金额示例均为公开报价下的离线算术演练,未以实际 Codex 调用或账户账单验证。用它们建立自己的估算表,再用相同条件的工作记录更新预测。
参考来源11
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月8日。
参考来源11
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月8日。
- 1.OpenAI API 定价developers.openai.com/api/docs/pricing
- 2.官方认证说明learn.chatgpt.com/docs/auth
- 3.非交互模式认证learn.chatgpt.com/docs/non-interactive-mode
- 4.Codex 价格与用量说明learn.chatgpt.com/docs/pricing
- 5.模型价格说明developers.openai.com/api/docs/models/gpt-6.1-sol
- 6.官方缓存计费说明developers.openai.com/api/docs/guides/prompt-caching
- 7.OpenAI Cookbook 的用量字段说明developers.openai.com/cookbook/examples/agent_optimization/optimizing_agents_for_cost_and_quality
- 8.Organization Usage 参考developers.openai.com/api/reference/resources/admin/subresources/organization/subresources/usage/methods/completions
- 9.API 用量与费用页说明help.openai.com/es-es/articles/10478918-reviewing-api-usage-and-costs
- 10.Costs 参考developers.openai.com/api/reference/resources/admin/subresources/organization/subresources/usage/methods/costs
- 11.OpenAI spend limits 文档developers.openai.com/api/docs/guides/spend-limits