Grok Voice Agent API: integración WebSocket, audio y precio
Grok Voice Agent API recibe y devuelve audio por wss://api.x.ai/v1/realtime. Para empezar, fija el modelo grok-voice-think-fast-2.0, mantén la clave en el servidor y completa un turno con PCM de entrada y audio de salida. En el navegador utiliza un token efímero; el precio es de 0,08 USD/min, con una base de facturación distinta según el control de turnos.
En esta página
Para integrar Grok Voice Agent API, abre una conexión a wss://api.x.ai/v1/realtime, configura la sesión y envía audio o texto. El resultado útil llega cuando recibes los fragmentos de audio, puedes escucharlos y sabes si el turno terminó correctamente. Una conexión abierta por sí sola no demuestra que ese recorrido funcione.
El modelo por defecto, grok-voice-latest, apunta actualmente a grok-voice-think-fast-2.0. Puedes fijar esta versión en la URL para que una futura actualización del alias no cambie tu integración sin que lo hayas decidido. El ejemplo de esta guía usa Node.js, un turno manual y un archivo PCM: devuelve un WAV reproducible sin mezclar todavía la captura del micrófono con la conexión. Después veremos qué cambia al pasar a conversación continua y al navegador. Guía oficial de Speech to Speech.
A 7 de octubre de 2026, el precio publicado es 0,08 USD/min de audio y 0,004 USD por mensaje de texto enviado mediante conversation.item.create, con excepciones para audio y resultados de funciones. Con server_vad se factura la duración de la sesión; al pulsar para hablar se factura el audio enviado y recibido. Esta diferencia importa más para el presupuesto que el número de turnos. Modelo y facturación, precios.
Completa primero un turno: entrada PCM, respuesta y WAV
Necesitas Node.js, el paquete ws, una clave API de xAI disponible solo en el servidor y un archivo de voz en PCM sin cabecera: mono, 16 bits con signo, little-endian y 24.000 Hz. No renombres un MP3 o un WAV a .pcm: un contenedor y sus datos de audio no son lo mismo. La documentación de formatos explica las opciones; aquí fijamos el mismo formato en entrada y salida para facilitar la primera integración.
Guarda el siguiente programa como turno.mjs. El modo audio envía un archivo; el modo texto permite comprobar la salida de voz sin preparar una grabación. Ambos usan turnos manuales y producen respuesta.wav si reciben audio completo. Las órdenes de instalación y ejecución son para tu entorno de desarrollo:
npm install ws
node turno.mjs audio pregunta.pcm
# Alternativa de entrada, usando la misma salida de voz:
node turno.mjs texto "¿Qué diferencia hay entre una señal analógica y una digital?"
Configura XAI_API_KEY mediante el mecanismo de secretos de tu servidor. No la añadas al archivo, al repositorio ni a una variable pública del frontend.
// turno.mjs — Node.js, paquete ws; no necesita un servidor HTTP.
import WebSocket from "ws";
import { readFileSync, writeFileSync } from "node:fs";

const modo = process.argv[2];
const entrada = process.argv[3];
const clave = process.env.XAI_API_KEY;
if (!clave || !entrada || !["audio", "texto"].includes(modo)) {
  console.error("Falta la clave del servidor o el argumento audio/texto.");
  process.exit(1);
}

const pcm = modo === "audio" ? readFileSync(entrada) : null;
if (pcm && (pcm.length === 0 || pcm.length % 2 !== 0)) {
  throw new Error("El PCM debe contener muestras completas de 16 bits.");
}
// La longitud no demuestra que el archivo sea mono/24 kHz: prepara
// ese formato antes de ejecutarlo.
const frecuencia = 24000;
const trozoBytes = 960; // 20 ms × 24.000 muestras/s × 2 bytes.
const audio = [];
let enviada = false;
let terminado = false;
let envio;
let cierreForzado;
let texto = "";

function wav(datos) {
  const cabecera = Buffer.alloc(44);
  cabecera.write("RIFF", 0);
  cabecera.writeUInt32LE(36 + datos.length, 4);
  cabecera.write("WAVE", 8);
  cabecera.write("fmt ", 12);
  cabecera.writeUInt32LE(16, 16);
  cabecera.writeUInt16LE(1, 20); // PCM
  cabecera.writeUInt16LE(1, 22); // mono
  cabecera.writeUInt32LE(frecuencia, 24);
  cabecera.writeUInt32LE(frecuencia * 2, 28);
  cabecera.writeUInt16LE(2, 32);
  cabecera.writeUInt16LE(16, 34);
  cabecera.write("data", 36);
  cabecera.writeUInt32LE(datos.length, 40);
  return Buffer.concat([cabecera, datos]);
}

const ws = new WebSocket(
  "wss://api.x.ai/v1/realtime?model=grok-voice-think-fast-2.0",
  { headers: { Authorization: `Bearer ${clave}` } }
);
const enviar = (evento) => ws.send(JSON.stringify(evento));

function finalizar(estado) {
  if (terminado) return;
  terminado = true;
  clearInterval(envio);
  clearTimeout(plazo);
  const datos = Buffer.concat(audio);
  if (datos.length) {
    const nombre = estado === "completed"
      ? "respuesta.wav" : "respuesta-parcial.wav";
    writeFileSync(nombre, wav(datos));
    console.log("\nAudio guardado:", nombre);
  }
  console.log("\nEstado:", estado, "\nTexto:", texto);
  if (estado !== "completed" || !datos.length) process.exitCode = 1;
  if (ws.readyState === WebSocket.OPEN) ws.close(1000, "Fin del turno");
  else if (ws.readyState === WebSocket.CONNECTING) ws.terminate();
  if (ws.readyState !== WebSocket.CLOSED) {
    cierreForzado = setTimeout(() => ws.terminate(), 3000);
  }
}

const plazo = setTimeout(() => finalizar("timeout-local"), 120000);
process.once("SIGINT", () => {
  if (ws.readyState === WebSocket.OPEN) enviar({ type: "response.cancel" });
  finalizar("cancelled-local");
});

ws.on("open", () => {
  enviar({
    type: "session.update",
    session: {
      voice: "eve",
      instructions:
        "Habla en español de España. Explica con claridad y responde " +
        "en dos o tres frases. Si falta información, pide una aclaración.",
      turn_detection: { type: null },
      audio: {
        input: {
          format: { type: "audio/pcm", rate: frecuencia },
          transport: "json",
          transcription: { model: "grok-transcribe", language_hint: "es-ES" }
        },
        output: {
          format: { type: "audio/pcm", rate: frecuencia },
          transport: "json"
        }
      }
    }
  });
});

ws.on("message", (datos, isBinary) => {
  if (terminado) return;
  // ws puede entregar el JSON como Buffer. isBinary indica el tipo
  // de trama; Buffer.isBuffer no distingue texto de audio.
  if (isBinary) {
    console.error("Trama binaria inesperada: la salida está en modo JSON.");
    finalizar("formato-inesperado");
    return;
  }
  let evento;
  try { evento = JSON.parse(datos.toString()); }
  catch {
    finalizar("json-invalido");
    return;
  }

  if (evento.type === "session.updated" && !enviada) {
    enviada = true;
    if (modo === "texto") {
      enviar({
        type: "conversation.item.create",
        item: {
          type: "message", role: "user",
          content: [{ type: "input_text", text: entrada }]
        }
      });
      enviar({ type: "response.create", response: { modalities: ["audio"] } });
    } else {
      let posicion = 0;
      envio = setInterval(() => {
        if (terminado || ws.readyState !== WebSocket.OPEN) {
          clearInterval(envio);
          return;
        }
        if (ws.bufferedAmount > 256000) return;
        if (posicion < pcm.length) {
          const parte = pcm.subarray(posicion, posicion + trozoBytes);
          posicion += parte.length;
          enviar({
            type: "input_audio_buffer.append",
            audio: parte.toString("base64")
          });
        } else {
          clearInterval(envio);
          enviar({ type: "input_audio_buffer.commit" });
          enviar({ type: "response.create", response: { modalities: ["audio"] } });
        }
      }, 20);
    }
  } else if (evento.type === "response.output_audio.delta") {
    audio.push(Buffer.from(evento.delta, "base64"));
  } else if (
    evento.type === "response.output_audio_transcript.delta" ||
    evento.type === "response.text.delta" ||
    evento.type === "response.output_text.delta"
  ) {
    texto += evento.delta;
    process.stdout.write(evento.delta);
  } else if (
    evento.type === "conversation.item.input_audio_transcription.updated"
  ) {
    console.log("\nEntrada reconocida:", evento.transcript);
  } else if (evento.type === "response.done") {
    finalizar(evento.response?.status ?? "estado-ausente");
  } else if (evento.type === "error") {
    const e = evento.error ?? {};
    console.error("Error:", e.type, e.code, e.message, e.param, e.event_id);
    // Este diagnóstico de un turno se detiene; una app puede conservar
    // la sesión si el error es recuperable y corregir el evento.
    finalizar("error-api");
  }
});

ws.on("error", (error) => {
  console.error("Conexión:", error.message);
  finalizar("error-conexion");
});
ws.on("close", (codigo, motivo) => {
  clearTimeout(cierreForzado);
  if (!terminado) {
    console.error("Cierre antes del fin:", codigo, motivo.toString());
    finalizar("cierre-inesperado");
  }
});
El flujo de audio es append → commit → response.create: commit convierte la entrada acumulada en un turno y response.create solicita la respuesta. Esperar session.updated evita enviar el primer turno antes de que se haya confirmado la configuración. No hace falta suponer si el primer evento recibido será session.created o conversation.created: la prosa y el ejemplo de secuencia de la referencia presentan ese orden de forma distinta. Eventos y secuencia oficial.
Comprueba tres resultados: que haya una entrada reconocible, que response.done indique completed y que puedas abrir respuesta.wav y escuchar la respuesta. El programa conserva lo recibido con el nombre respuesta-parcial.wav si se interrumpe; ese archivo no convierte un turno cancelado en uno correcto. El límite local de dos minutos es una decisión del ejemplo, no el máximo de la API.
El ejemplo se basa en la documentación actual y su sintaxis y cabecera WAV se han comprobado sin conexión. No se ha ejecutado una llamada a xAI para acreditar sonido, latencia, consumo o comportamiento de una cuenta. Una salida vacía, por tanto, requiere revisar los eventos de tu ejecución; no se presupone un resultado sonoro.
De un turno manual a una conversación con VAD
Para una interfaz de «pulsar para hablar», conserva turn_detection: { type: null }. Mientras se pulsa, envía las muestras con input_audio_buffer.append; al soltar, envía input_audio_buffer.commit y después response.create. Si el usuario descarta la grabación antes de enviarla como turno, utiliza input_audio_buffer.clear.
Para conversación continua, cambia a turn_detection: { type: "server_vad" } y envía el audio a medida que llega. El servidor detecta el final del habla y solicita la respuesta automáticamente. No añadas el commit y el response.create del ejemplo manual a cada silencio: mezclar ambos recorridos puede provocar peticiones redundantes. Control de turnos.
La entrada y la salida no tienen por qué compartir formato. PCM es cómodo para la primera implementación; pcmu y pcma usan 8 kHz, y Opus admite paquetes sin contenedor, a 24 kHz y mono. El transporte se configura aparte: JSON envía audio en base64; el transporte binario envía bytes del códec como tramas WebSocket. Los eventos de configuración y ciclo de vida siguen siendo JSON. Un fragmento WebM de MediaRecorder no equivale a un paquete Opus crudo. Formatos y transporte.
Si muestras subtítulos de entrada, conversation.item.input_audio_transcription.updated contiene el texto acumulado y puede corregir palabras anteriores. Sustituye el subtítulo del usuario con cada actualización, en lugar de concatenarlas. La transcripción de la respuesta hablada, response.output_audio_transcript.delta, sí llega por fragmentos que puedes añadir. La configuración grok-transcribe del ejemplo habilita esa transcripción de entrada; no es el nombre del modelo de la API STT independiente. Referencia de los eventos.
Conecta el navegador con un token efímero
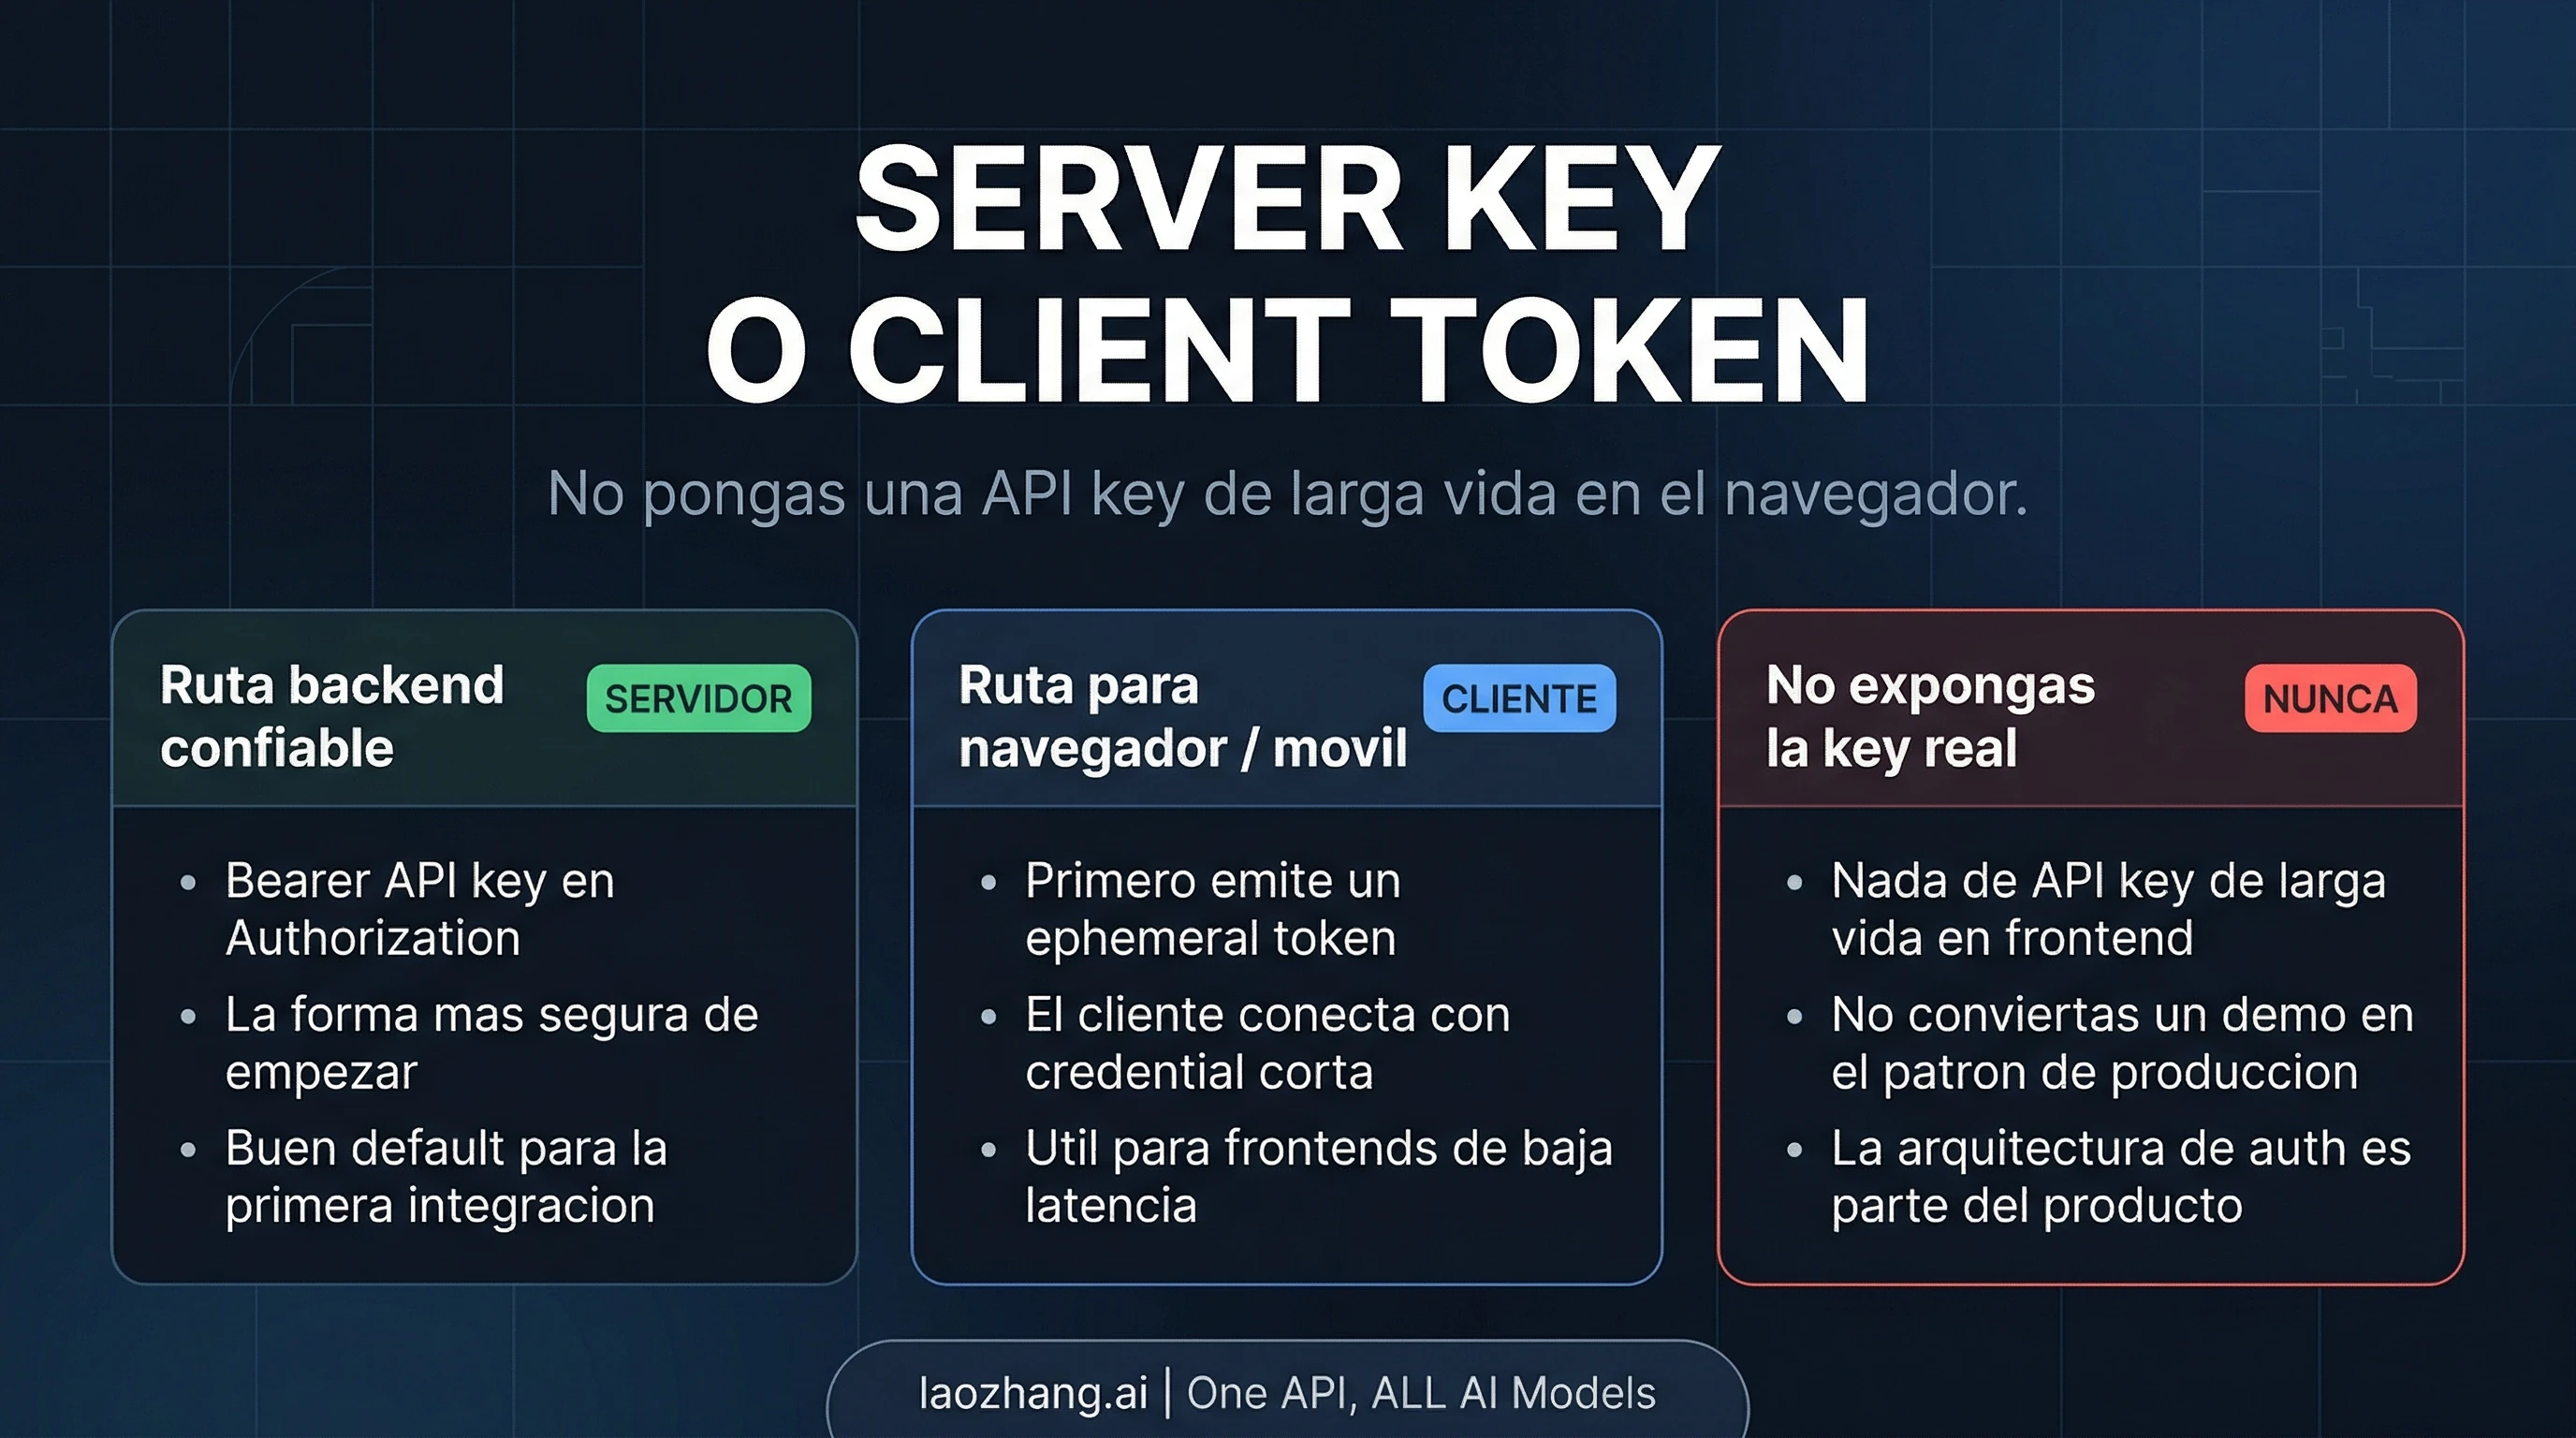
La clave de larga duración permanece en tu backend. El navegador recibe una credencial corta de tu propio servidor, que debe comprobar quién la solicita, aplicar un presupuesto de uso y evitar registrar el token. El WebSocket nativo del navegador no permite añadir libremente una cabecera Authorization; xAI documenta el subprotocolo xai-client-secret.<TOKEN> para ese caso. Autenticación del navegador.
Tu endpoint protegido solicita el secreto con POST https://api.x.ai/v1/realtime/client_secrets, una cabecera Authorization: Bearer <clave-del-servidor> y este cuerpo mínimo:
{
  "expires_after": {
    "seconds": 300
  }
}
La respuesta contiene value y expires_at. Devuelve esos campos al usuario autorizado, con Cache-Control: no-store, sin exponer la clave original. En tu cliente, después de que un endpoint de tu aplicación —por ejemplo, /api/voz/token— haya realizado esos controles:
// Fragmento para el navegador; /api/voz/token es tu endpoint,
// no una ruta de xAI. Requiere autenticación y presupuesto en el backend.
const r = await fetch("/api/voz/token", {
  method: "POST",
  credentials: "same-origin"
});
if (!r.ok) throw new Error("No se pudo obtener el token de voz");
const secreto = await r.json();
if (!secreto.value || Date.now() >= secreto.expires_at * 1000) {
  throw new Error("Token ausente o caducado");
}
const socket = new WebSocket(
  "wss://api.x.ai/v1/realtime?model=grok-voice-think-fast-2.0",
  [`xai-client-secret.${secreto.value}`]
);
// Añade session.update, envío de audio y los manejadores de eventos
// del flujo anterior usando addEventListener en lugar de ws.on.
Este fragmento resuelve la conexión autenticada del navegador; la captura y reproducción siguen siendo trabajo del cliente. Protege también el endpoint contra peticiones desde otros orígenes según el mecanismo de sesión de tu aplicación. Un endpoint público que entrega tokens a cualquiera traslada tu presupuesto a cualquiera.
La referencia establece 600 segundos por defecto y un máximo de 3.600 segundos para el token. La guía de tokens dice que no se admiten session ni expires_after.anchor, mientras que la referencia sí describe un campo session opcional. El cuerpo mínimo anterior evita depender de esa discrepancia. La duración del token y el límite de una sesión de voz son conceptos distintos: no uses uno como temporizador del otro. Referencia de client secrets.
Reproduce los fragmentos sin solaparlos y permite interrumpir
El programa inicial guarda el turno completo. Para escuchar mientras se genera, decodifica cada response.output_audio.delta y colócalo en una cola de reproducción. Si cada fragmento empieza inmediatamente, las voces se solapan; programa el siguiente después del anterior.
Con salida PCM mono de 24 kHz, este fragmento transforma las muestras de 16 bits en un AudioBuffer. Crea el AudioContext y llama a resume() desde una acción del usuario para habilitar la reproducción en el navegador:
// Fragmento de reproducción: solo PCM16 little-endian, mono, 24 kHz.
const contexto = new AudioContext();
let siguiente = 0;
const pendientes = new Set();

function reproducirPCM(base64) {
  const bytes = Uint8Array.from(atob(base64), c => c.charCodeAt(0));
  if (bytes.length % 2) throw new Error("Fragmento PCM incompleto");
  const vista = new DataView(bytes.buffer);
  const buffer = contexto.createBuffer(1, bytes.length / 2, 24000);
  const canal = buffer.getChannelData(0);
  for (let i = 0; i < canal.length; i++) {
    canal[i] = vista.getInt16(i * 2, true) / 32768;
  }
  const fuente = contexto.createBufferSource();
  fuente.buffer = buffer;
  fuente.connect(contexto.destination);
  siguiente = Math.max(siguiente, contexto.currentTime + 0.01);
  pendientes.add(fuente);
  fuente.onended = () => pendientes.delete(fuente);
  fuente.start(siguiente);
  siguiente += buffer.duration;
}

function vaciarReproduccion() {
  for (const fuente of pendientes) fuente.stop();
  pendientes.clear();
  siguiente = contexto.currentTime;
}
Llama a reproducirPCM(evento.delta) en el manejador de audio. Al cerrar la interfaz, detén la captura, vacía la cola, cierra el socket y libera el contexto de audio. response.done significa que la generación ha terminado; los fragmentos programados pueden seguir sonando. El último onended de la cola indica el final de la reproducción local.
Cuando recibas input_audio_buffer.speech_started en modo VAD, vacía la cola para que el usuario pueda interrumpir. En modo manual, response.cancel detiene la generación. Para que el contexto de conversación refleje lo que realmente se escuchó, envía además:
{
  "type": "conversation.item.truncate",
  "item_id": "ID_DEL_ITEM_DEL_ASISTENTE",
  "content_index": 0,
  "audio_end_ms": 820
}
Los 820 ms son ilustrativos: calcula la duración reproducida de ese item y esa parte de contenido, no la duración total recibida ni el tiempo que lleva abierto el socket. Conserva los IDs de los eventos de salida y contabiliza las muestras que han sonado; el fragmento de cola anterior, por sí solo, no implementa esa contabilidad. La API confirma el recorte con conversation.item.truncated y elimina el audio y la transcripción posteriores. Esta operación está soportada actualmente, aunque integraciones antiguas la hayan tratado como una incompatibilidad. Referencia de truncate.
Gestiona errores y reanuda sin repetir acciones
No interpretes cualquier response.done como éxito: su estado puede ser completed, cancelled o incomplete. Registra el ID de respuesta y el estado junto con los eventos necesarios para diagnosticar el turno, evitando credenciales y audio privado en los registros. El esquema público expone contadores input_tokens, output_tokens y total_tokens; no convierte esos contadores en una factura de voz ni garantiza campos como billable_audio_seconds. Esquema de WebSocket.
| Lo que observas | Qué revisar y qué hacer |
|---|---|
| La conexión no llega a abrirse | Distingue el error de red del rechazo de autenticación; comprueba la URL y la credencial utilizada sin imprimirla. |
Evento error con invalid_request_error o invalid_event | Conserva code, message, param y event_id; corrige el evento señalado antes de reenviarlo. |
Turno con cancelled o incomplete | No lo presentes como respuesta completa; conserva el estado y lo recibido para decidir si procede un nuevo turno. |
done con audio guardado, pero sin sonido en el navegador | Revisa formato, frecuencia, estado del AudioContext y cola. El fin de generación no confirma que el altavoz haya reproducido nada. |
timeout, max_duration o cierre inesperado | Detén el envío, informa al usuario y decide si necesitas una nueva sesión. Un cierre no demuestra una causa única. |
La referencia indica que muchos errores son recuperables y la sesión puede seguir abierta. El programa inicial se detiene para que el primer diagnóstico sea claro; en una aplicación persistente, decide según el error concreto, con reintentos limitados y sin repetir operaciones con efectos. Errores y cierre del flujo.
Por defecto, al cerrar el socket se pierde el historial de esa conexión. Para reanudar, activa resumption: { enabled: true } en la sesión original, guarda conversation.created.conversation.id y reconecta añadiendo conversation_id a la URL. La nueva sesión también debe activar resumption.enabled. El historial caduca tras 30 minutos de inactividad; no sustituye la base de datos de tu aplicación. La guía llama conversation.item.created a los items reproducidos al reanudar, y la referencia enumera conversation.item.added para los items nuevos: un cliente compatible puede reconocer ambos sin asumir que cada item recibido acaba de ocurrir. Reanudación.
Añade funciones cuando el turno de voz ya esté resuelto
Una función personalizada necesita un recorrido separado del texto del asistente. Al recibir response.function_call_arguments.done, obtienes name, call_id y arguments en JSON. Valida el nombre contra una lista permitida y valida los argumentos antes de ejecutar nada. La solicitud del modelo no demuestra que una acción se haya realizado.
Por ejemplo, un asistente de formación puede solicitar una función propia que consulte la disponibilidad de una sala. Tras obtener un resultado real de tu aplicación, devuelve un conversation.item.create con esta forma:
{
  "type": "conversation.item.create",
  "item": {
    "type": "function_call_output",
    "call_id": "EL_CALL_ID_RECIBIDO",
    "output": "{\"available\":true,\"room\":\"A2\"}"
  }
}
Es una muestra de formato, no una consulta realizada ni una reserva. Vincula el resultado al call_id exacto y distingue «consultar» de «reservar»: una reserva necesita la autorización y la confirmación de tu sistema.
Si se solicitan varias funciones en paralelo, entrega todos los resultados antes de enviar un solo response.create para continuar. Si todavía hay audio en reproducción, espera también a que termine para no solapar respuestas. Guarda los resultados asociados a los IDs de llamada para que una reanudación del historial no vuelva a ejecutar una reserva, un cargo u otro efecto. Funciones y llamadas paralelas.
Las herramientas integradas web_search, x_search, file_search y MCP tienen su propia configuración. No se manejan todas como funciones personalizadas. Si necesitas una frase fija —por ejemplo, un saludo—, force_message produce una línea mediante TTS y no requiere un response.create posterior. Con interruptible: false, se descarta el audio del interlocutor durante esa reproducción; no lo uses si necesitas escuchar una respuesta en ese momento. Force message.
Calcula el precio según el modo de conversación
La tarifa actual de Grok Voice Agent API es 0,08 USD/min, equivalente a 4,80 USD/h sobre la base de audio que corresponda. Los mensajes de texto del cliente cuestan 0,004 USD por conversation.item.create; no se aplica esa tarifa a function_call_output ni a items con contenido input_audio o audio. response.create no cuenta como mensaje de texto facturable, aunque el audio que genere sí se factura. Reglas de facturación, tarifa publicada.
Estas dos estimaciones usan la misma tarifa, pero distintos supuestos:
| Escenario hipotético | Cálculo del audio | Estimación |
|---|---|---|
| Sesión VAD abierta 12 minutos, incluidos silencios | 12 × 0,08 USD | 0,96 USD |
| Pulsar para hablar: 2 minutos enviados y 3 recibidos | (2 + 3) × 0,08 USD | 0,40 USD |
Si añades diez mensajes de texto facturables, suma 10 × 0,004 = 0,04 USD. No son resultados de una factura ni de una prueba de consumo. Tampoco incluyen servicios de tu aplicación, telefonía u otras herramientas.
Para presupuestar búsquedas, revisa sus unidades por separado. La tabla general de xAI publica 5 USD por 1.000 llamadas de búsqueda web; para X son 5 USD por 1.000 publicaciones y 10 USD por 1.000 perfiles, no una tarifa única por llamada. Esa tabla contiene condiciones de otras API y no constituye una cotización total de una sesión de voz. No sumes precios de tokens de un modelo de chat como si fueran la tarifa de este audio. Precios de herramientas.
La ficha del modelo publica 10 sesiones concurrentes por equipo, 120 minutos como duración máxima de sesión y us-east-1 como región. Son dimensiones distintas: diez conexiones simultáneas no equivalen a diez turnos; 120 minutos no son el TTL del token; una región publicada no acredita residencia legal de todos los datos de tu aplicación. Comprueba los límites que corresponden a tu cuenta antes de dimensionar el servicio. Límites del modelo.
Elige Voice Agent, STT o TTS según el resultado
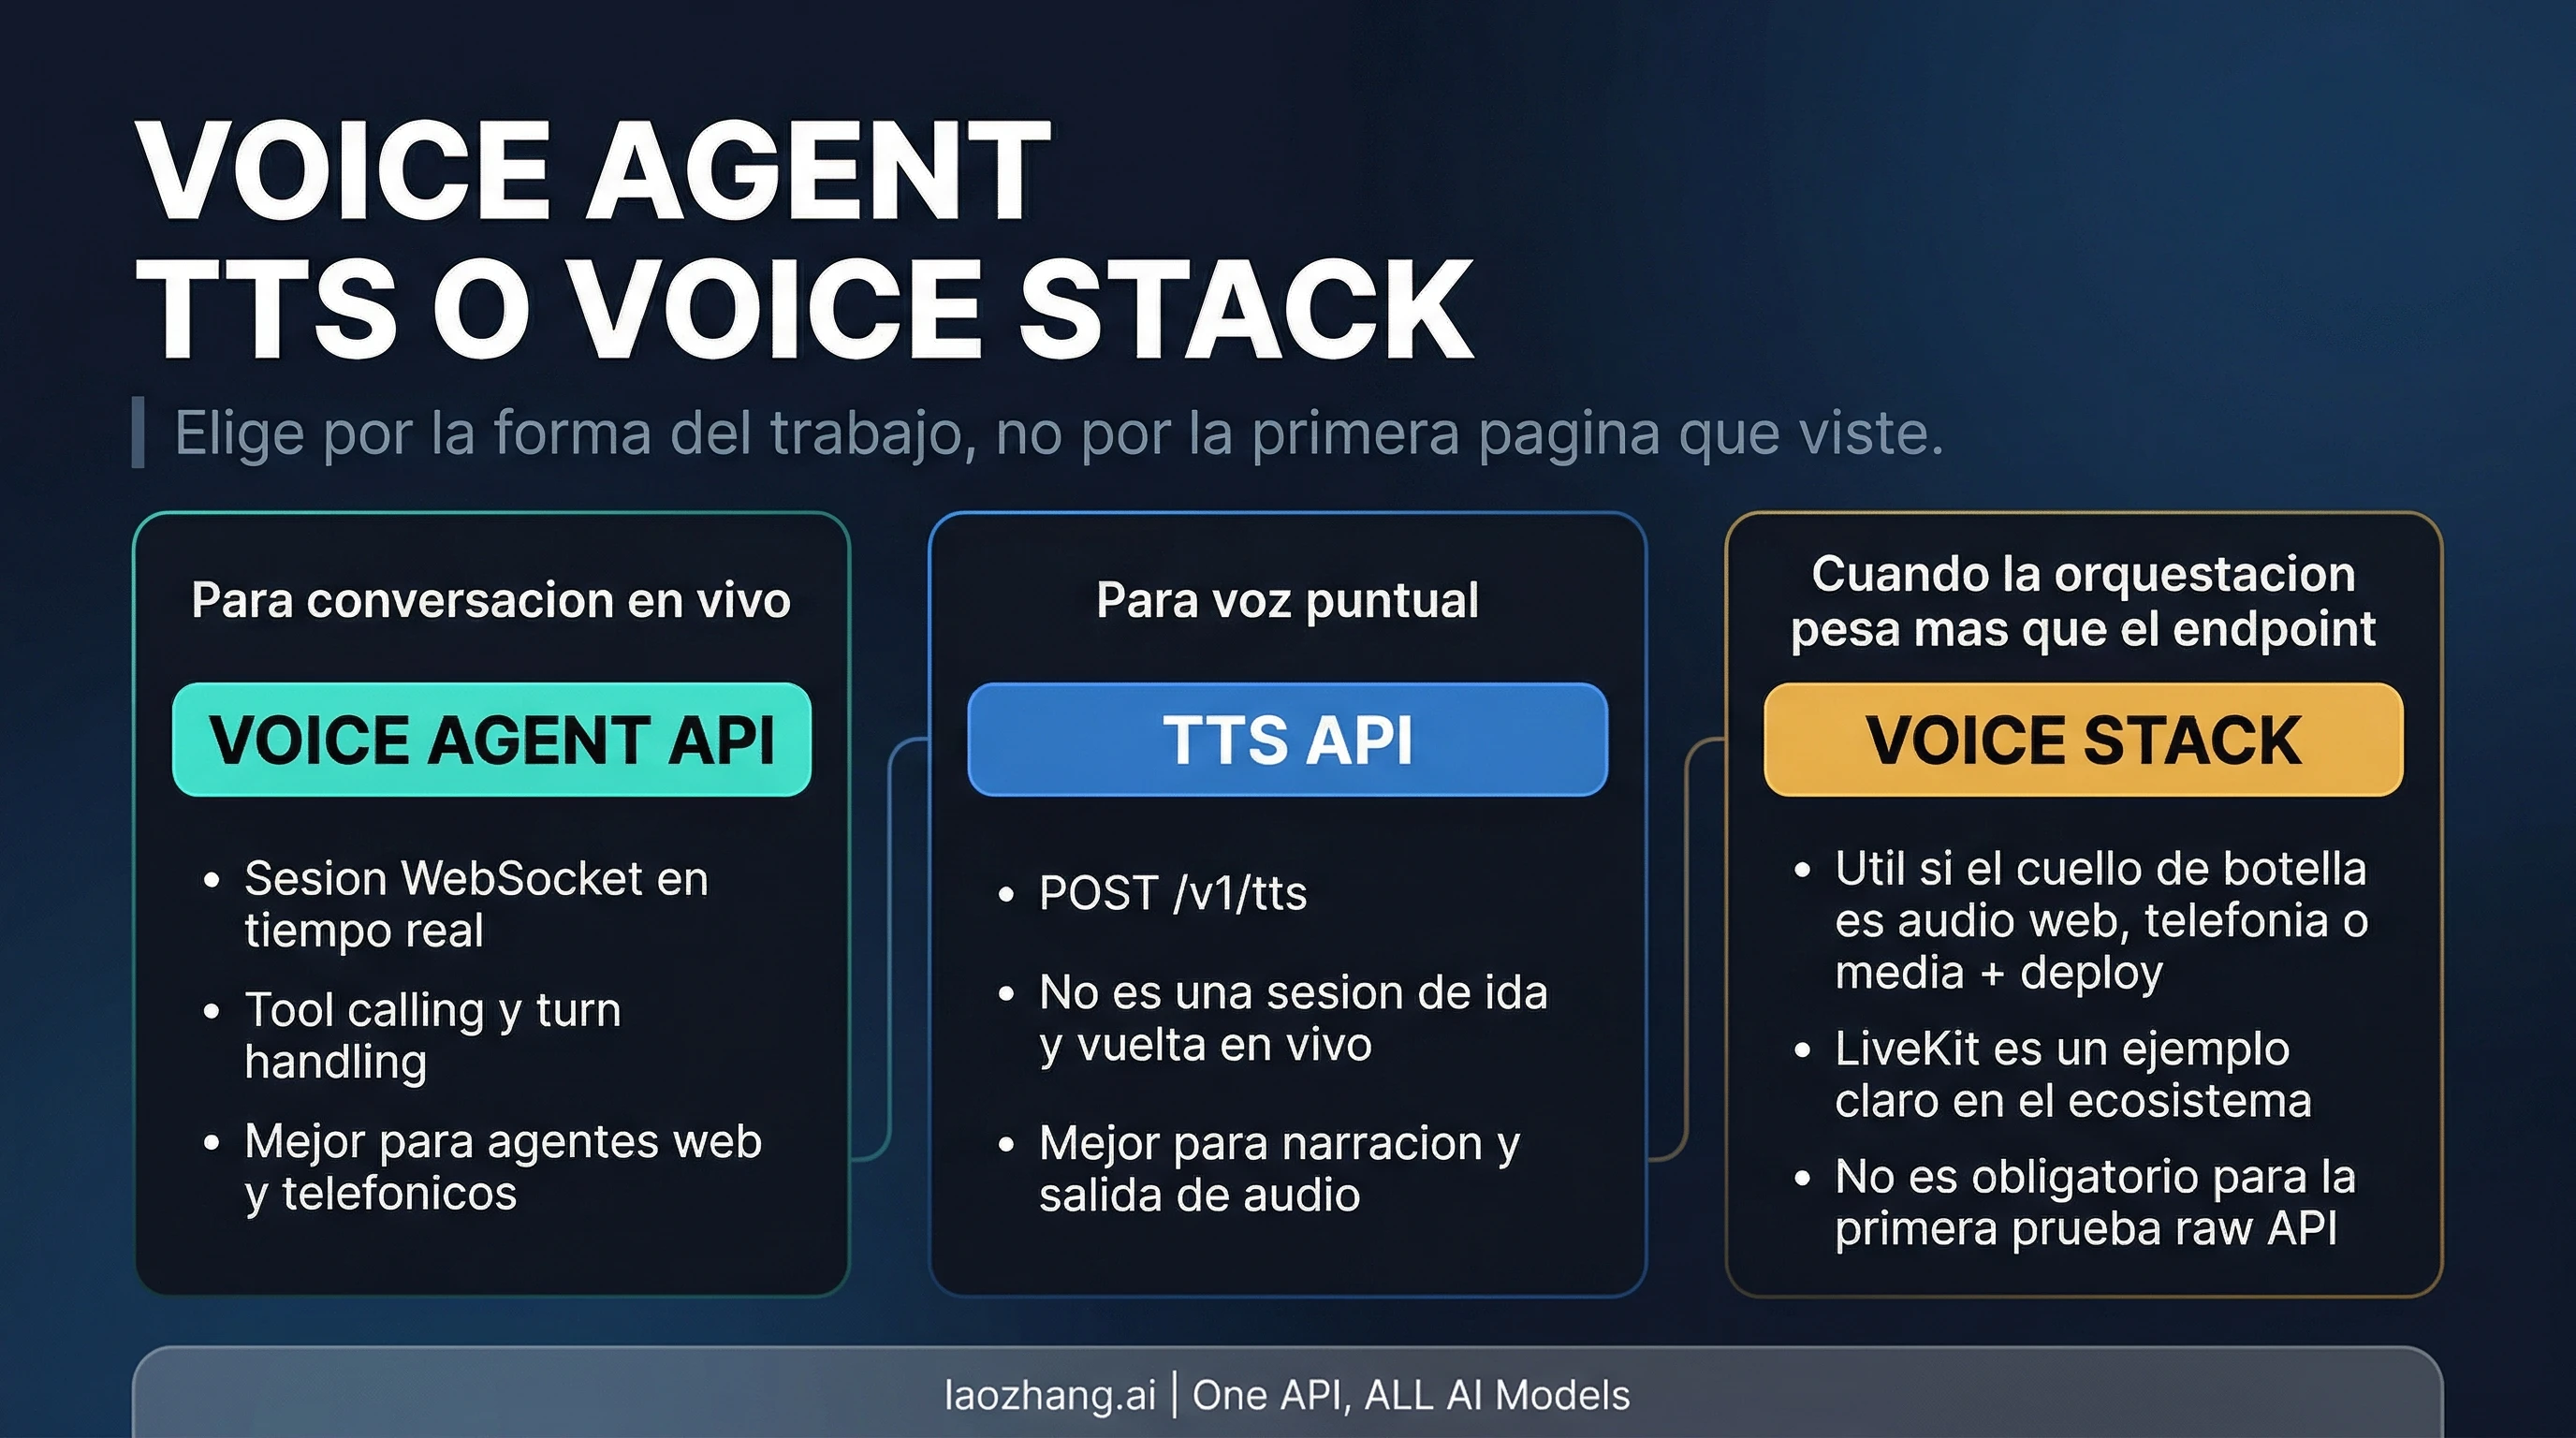
Usa Voice Agent API cuando una persona deba hablar con un asistente que entiende el turno y responde. Si lo único que necesitas es una transcripción, la API STT devuelve texto mediante POST /v1/stt para archivos o URL y wss://api.x.ai/v1/stt para audio en streaming. Su modelo independiente actual es grok-voice-transcribe-2.0; no lo confundas con grok-transcribe en la transcripción interna de una sesión de voz. Referencia STT actual.
Si tu aplicación ya tiene el texto y solo necesita leerlo en voz alta, usa TTS. xAI ofrece POST /v1/tts y una opción WebSocket de streaming. En el endpoint REST, language es obligatorio —código admitido o auto— y voice_id tiene eve como valor por defecto; with_timestamps cambia el formato de respuesta a JSON con audio base64 y marcas de tiempo. Referencia TTS.
Un framework de voz puede ayudarte cuando la dificultad principal sea capturar y distribuir medios, trabajar con WebRTC o integrar telefonía. No reemplaza la gestión de credenciales, turnos o resultados de funciones. La visión general de voz de xAI permite situar esas opciones sin convertir el primer turno WebSocket en un proyecto de telefonía.
Preguntas frecuentes
¿Puedo usar Grok Voice Agent API gratis con una cuenta de Grok?
Una cuenta del producto de consumo no demuestra que tengas saldo o acceso a la API. La integración utiliza credenciales de desarrollador y facturación de la API; no presupongas que un plan de chat incluye estos minutos. El coste publicado del audio es de 0,08 USD/min bajo las reglas de VAD o pulsar para hablar. Facturación del modelo.
¿Qué modelo debo poner en la URL?
Usa grok-voice-think-fast-2.0 si quieres fijar la versión actual, o grok-voice-latest si aceptas las actualizaciones del alias. Actualmente ambos corresponden al mismo modelo. La versión antigua 1.0 no aparece en la lista vigente de opciones de esta guía oficial; no la uses como supuesto atajo de precio. Modelos admitidos.
¿La API entiende y habla español?
La documentación incluye español de España y de México. Para orientar la transcripción utiliza es-ES o es-MX; es no es uno de los hints admitidos y los valores no reconocidos se ignoran. Para la respuesta hablada, indica el idioma en instructions. El hint de reconocimiento y las instrucciones de respuesta cumplen funciones distintas; la calidad para tu audio concreto se evalúa con ese audio. Idiomas y hints.
¿Por qué recibo response.done pero no escucho nada?
Porque response.done cierra la generación, no la reproducción. Comprueba si llegaron response.output_audio.delta, si el turno está completed, si decodificas el formato configurado y si el navegador permite reproducir audio. En el ejemplo de Node.js, el resultado se guarda en un WAV: debes abrir ese archivo para escucharlo. Eventos de salida.
¿Un token de cinco minutos corta la conversación a los cinco minutos?
No confundas el plazo de la credencial con la duración máxima de una sesión. expires_after.seconds configura la caducidad del token; la ficha del modelo publica un máximo de 120 minutos por sesión. Las páginas consultadas no justifican usar el TTL como un temporizador de desconexión de una sesión ya abierta. Token efímero, límite de sesión.
¿Basta cambiar la URL de un cliente OpenAI Realtime?
El diseño general de sesión y eventos es reutilizable, pero debes adaptar autenticación, formatos y manejadores. Acepta response.text.delta y response.output_text.delta; trata la transcripción de entrada de xAI como acumulativa y utiliza el soporte actual de conversation.item.truncate. Valida el recorrido completo —entrada, audio, fin e interrupción—, además de la apertura del socket. Compatibilidad y migración.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 8 oct 2026.
Fuentes7
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 8 oct 2026.
- 1.Guía oficial de Speech to Speechdocs.x.ai/developers/model-capabilities/audio/speech-to-speech
- 2.Modelo y facturacióndocs.x.ai/developers/models/speech-to-speech
- 3.preciosdocs.x.ai/developers/pricing
- 4.Eventos y secuencia oficialdocs.x.ai/developers/rest-api-reference/inference/voice
- 5.Autenticación del navegadordocs.x.ai/developers/model-capabilities/audio/ephemeral-tokens
- 6.Esquema de WebSocketdocs.x.ai/voice-realtime.ws.json
- 7.visión general de voz de xAIdocs.x.ai/developers/model-capabilities/audio/voice